Le 20 octobre 2026, une panne de courant a touché une zone de disponibilité de Google Cloud à Londres pendant près de 8 heures. Cinq jours plus tôt, DeepSeek avait également été hors service pendant une bonne partie de la matinée. De nombreux développeurs se demandent si leur application d’IA subira le même sort la prochaine fois.
Une panne chez un fournisseur en amont peut survenir à tout moment. Si vous utilisez uniquement l’API d’un modèle, inutile de déménager vos serveurs, mais ne faites pas reposer toute votre activité sur un seul modèle.
Ce que vous allez retenir : à la fin de cet article, vous saurez distinguer les situations qui nécessitent une intervention de celles qui n’en nécessitent pas, et vous saurez comment prévoir une solution de repli pour vos modèles.
Ce qui a été touché par les deux interruptions de cette semaine
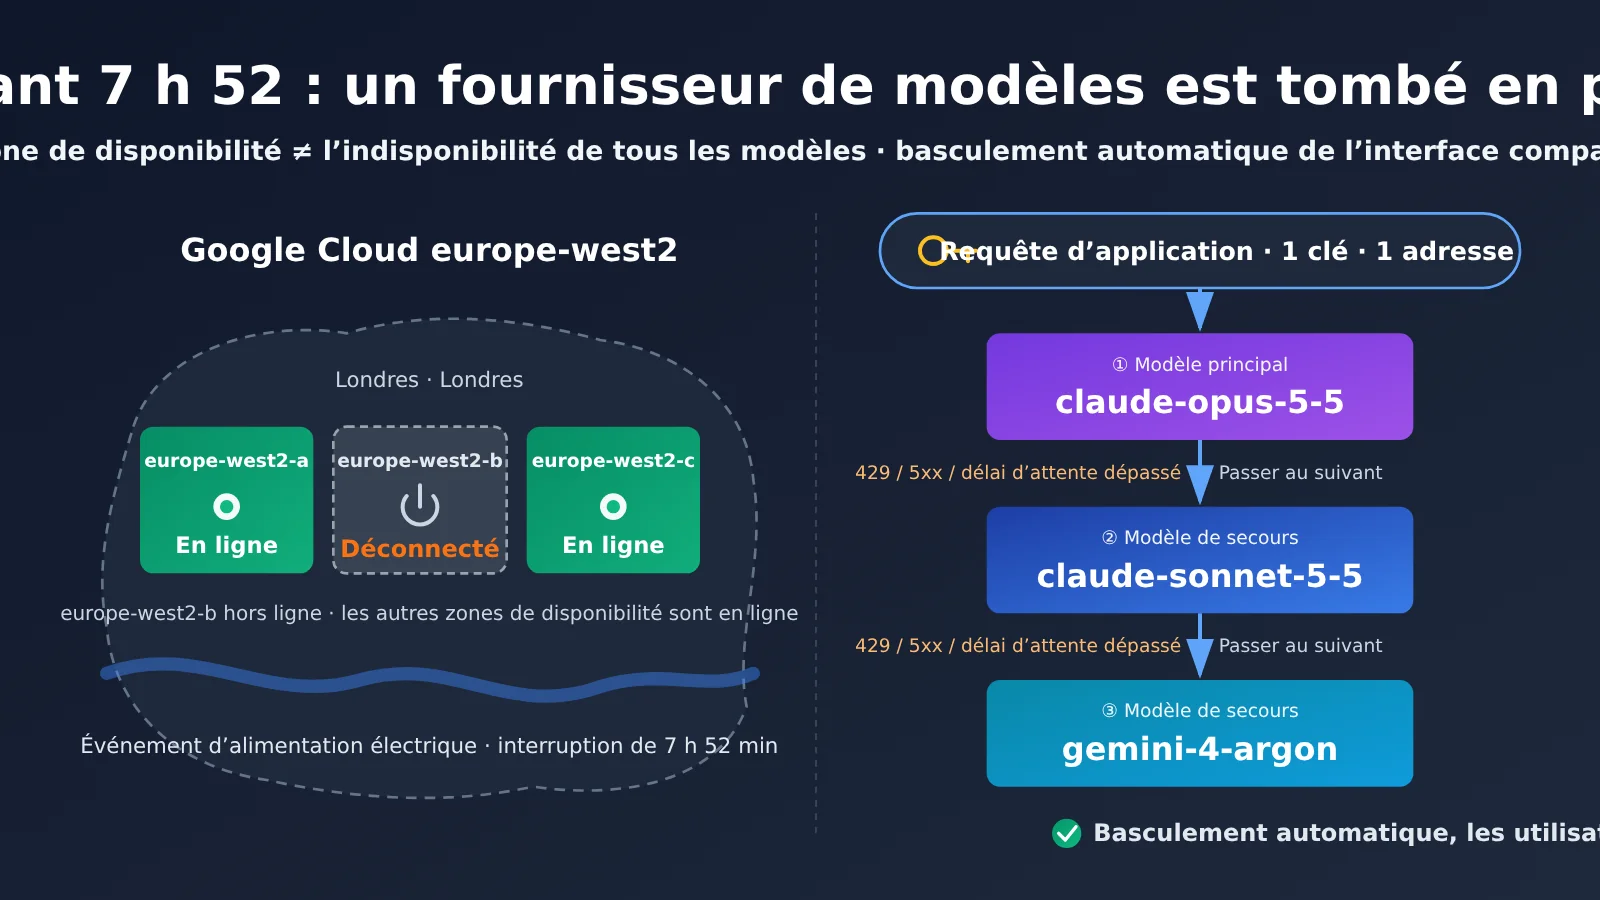
Commençons par Google Cloud. Le 20 octobre 2026, de 14 h 08 à 22 h 00, heure de Pékin, une panne d’alimentation a interrompu le fonctionnement de la zone de disponibilité europe-west2-b, à Londres, pendant 7 heures et 52 minutes. Les ressources touchées étaient les services de calcul, de stockage, de base de données et de réseau déployés dans cette zone. Les personnes qui se contentaient d’appeler une API de modèle à distance n’étaient pas directement concernées. Mais si votre service tournait justement dans cette zone, les tâches en arrière-plan, les connexions à la base de données et les interfaces externes ont dû attendre tout l’après-midi. Impossible de faire le travail à leur place en attendant.
Passons à DeepSeek. À partir du 15 octobre 2026, à 8 h 11, heure de Pékin, le site Web, les conversations et une partie des API de V4 Pro et V4.1 Flash ont été interrompus. La page d’état officielle indique une durée de 4 heures et 52 minutes, avec un rétablissement à 13 h 04 le même jour. Caixin et le South China Morning Post ont parlé de « près de cinq heures », mais cette durée vient des médias : retenons celle de l’historique officiel. DeepSeek a ensuite crédité les comptes des montants consommés entre le 8 et le 14 octobre. L’entreprise n’a pas communiqué la cause ; nous n’allons donc pas spéculer. Pour les utilisateurs, ce matin-là, la question était de savoir s’ils avaient une autre solution, pas de connaître la cause de la panne.
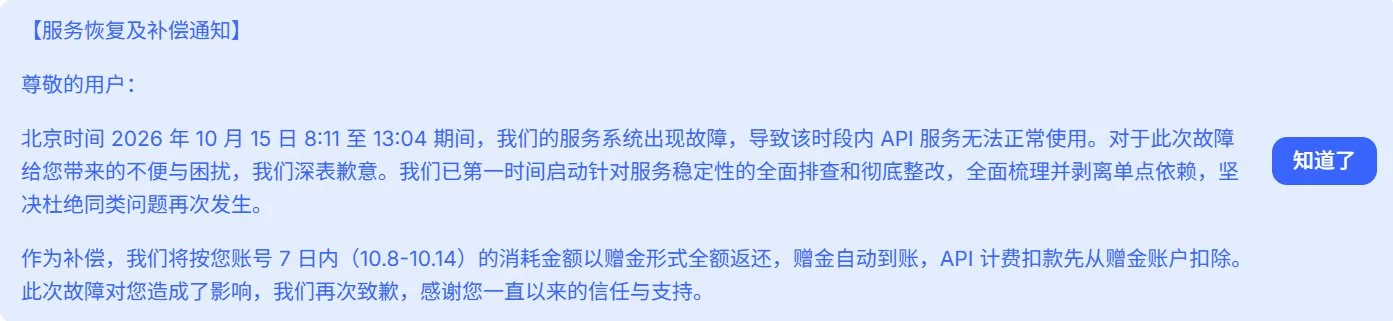
Image : notification de DeepSeek concernant le rétablissement du service et le dédommagement des utilisateurs. Le service API a été indisponible de 8 h 11 à 13 h 04, heure de Pékin, le 15 octobre. Le montant consommé par chaque compte du 8 au 14 octobre sera intégralement remboursé sous forme de crédits offerts, crédités automatiquement. Les frais liés aux appels API seront d’abord prélevés sur le solde de crédits offerts.
Les deux incidents ont le même point douloureux : le modèle fait partie du flux de travail quotidien. Dès que l’API tombe, la rédaction de code, la recherche d’informations et les traitements par lots s’arrêtent. Le temps que le service amont soit rétabli, une demi-journée a déjà filé. Les crédits compensent la facture, pas le travail interrompu. Si une équipe devait livrer un lot de traductions, lancer une série d’évaluations ou mettre en ligne une fonctionnalité ce jour-là, la compensation ne fera pas le travail à sa place. Tout sera simplement repoussé, au prix d’un agenda encore plus chargé le lendemain.
| Élément | Faits vérifiés sur l’incident Google Cloud |
|---|---|
| Numéro de l’incident | Xs2XTHzAVC9YnafnPyzj |
| Périmètre touché | Zone de disponibilité europe-west2-b dans la région europe-west2 |
| Cause | Incident d’alimentation électrique, sans autre détail communiqué par Google |
| Début | 20 octobre 2026, 14 h 08, heure de Pékin |
| Fin | 20 octobre 2026, 22 h 00, heure de Pékin ; durée de 7 heures et 52 minutes |
| Service non touché | Looker Studio |
Quelle différence entre une zone de disponibilité et une région ?
Quand on entend parler d’une « panne à Londres », on imagine souvent que tout Google Cloud à Londres est hors service. Ce n’est pas le cas. Une région (europe-west2) correspond à l’ensemble des centres de données de Google à Londres. Les zones de disponibilité (europe-west2-a, b et c) sont des bâtiments séparés au sein de cet ensemble. Chacun est conçu pour avoir sa propre alimentation électrique et sa propre connexion réseau, afin que les autres puissent prendre le relais si l’un d’eux rencontre un problème. Cette fois, un des trois bâtiments s’est retrouvé dans le noir ; les deux autres sont restés en ligne.
Les équipes les plus touchées sont donc celles qui hébergeaient leur service uniquement dans la zone b. Si le service était déjà réparti entre les zones a et c, le trafic pouvait être redirigé vers les zones encore opérationnelles, ce qui limitait les dégâts. Quant aux personnes qui se contentaient d’appeler une API de modèle à distance, elles ont à peine senti la panne électrique.
Comparaison des deux interruptions
| Élément de comparaison | Google Cloud à Londres | DeepSeek |
|---|---|---|
| Horaire (heure de Pékin) | Du 20 octobre 2026, 14 h 08 à 22 h 00 | Du 15 octobre 2026, 8 h 11 à 13 h 04 |
| Durée | 7 h 52 | 4 h 52 |
| Services touchés | Calcul, stockage, bases de données et réseau dans europe-west2-b | Site Web, conversations et API de V4 Pro et V4.1 Flash |
| Cause | Incident d’alimentation électrique, sans autre détail | Non communiquée officiellement |
| Mesure prise après l’incident | Google recommande, si possible, de migrer vers une autre zone de disponibilité ou une autre région | Crédits correspondant à la consommation du 8 au 14 octobre |
| Personnes qui utilisent uniquement les API de modèles | Pas directement concernées | Directement touchées ; sans solution de secours, elles n’ont plus qu’à attendre |
La comparaison fait ressortir la différence : lors de l’incident Google, les équipes qui hébergeaient leurs machines dans la zone b ont été touchées. La solution consiste à déployer les services dans plusieurs zones de disponibilité. Lors de l’incident DeepSeek, ce sont les personnes qui n’utilisaient qu’un seul fournisseur de modèles qui ont été touchées. La solution consiste à préparer à l’avance un modèle de secours. Le premier problème concerne les centres de données, le second les appels aux modèles. C’est de ce deuxième cas qu’il sera question ci-dessous.
Les leçons à tirer de cette panne
Un fournisseur peut tomber en panne : prévoyez donc une deuxième, voire une troisième solution, de préférence chez un autre fournisseur. Passer à une formule moins chère chez le même fournisseur ne constitue pas une solution de secours. Si toute l’entreprise rencontre un problème, les deux formules seront touchées.
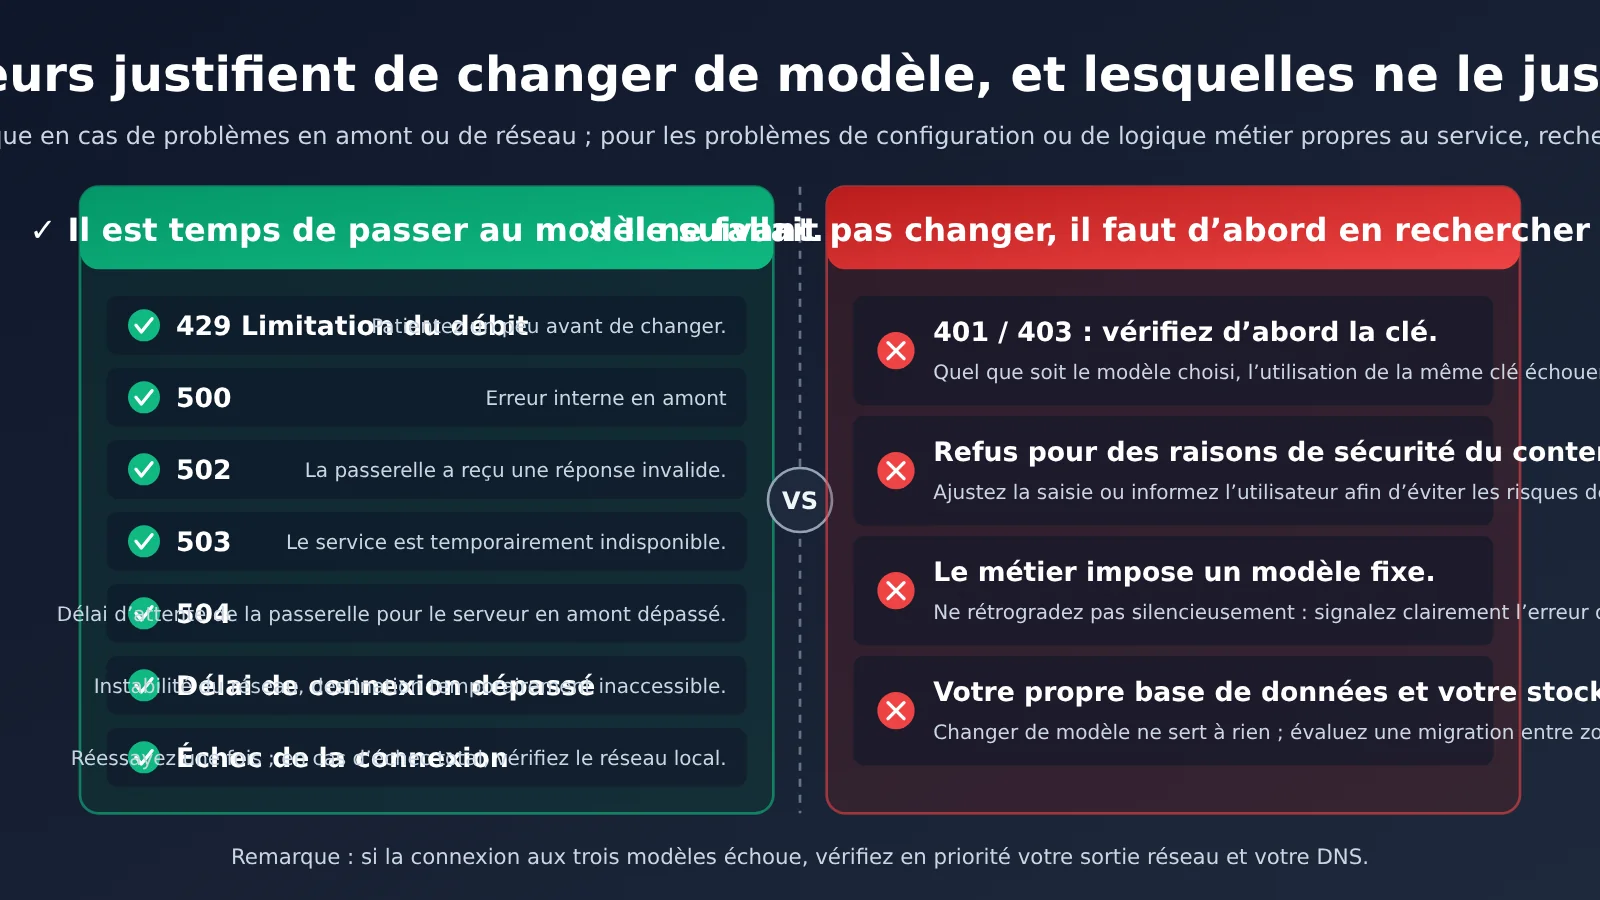
Il faut aussi savoir quand basculer : changez de modèle uniquement en cas d’erreur 429, 500, 502, 503 ou 504, ou de délai d’attente dépassé. Ces erreurs indiquent que le fournisseur ne peut momentanément pas traiter la demande ; essayer un autre modèle peut alors fonctionner. En revanche, ne changez pas de modèle en cas d’erreur 401 ou 403, ni si le contenu est refusé pour des raisons de sécurité. Le problème vient alors de la clé ou du contenu lui-même : changer de modèle dix fois n’y changera rien. Autre point important : si la base de données et le stockage que vous hébergez vous-même se trouvent dans une zone de disponibilité hors service, changer de modèle ne vous aidera pas. Il faut alors envisager un déploiement dans plusieurs zones. Le modèle de secours et la reprise après sinistre des centres de données sont deux sujets distincts : ne les confondez pas.
Une fois le système de secours en place, ne le désactivez pas à la fin de la panne. Il ne génère aucune requête supplémentaire en temps normal : si le modèle principal fonctionne, il n’est pas utilisé. Mais dès qu’un nouvel incident survient, il prend automatiquement le relais, sans qu’il soit nécessaire de se lever au milieu de la nuit pour modifier le code. Avant de mettre tout cela en place, envoyez une requête toute simple à chaque modèle séparément pour vérifier que son nom est correct et qu’il répond normalement. Vous pourrez ensuite réfléchir à la façon de les enchaîner. Les réponses peuvent varier d’un modèle à l’autre. Si votre activité exige un format de sortie précis, indiquez-le clairement dans le prompt system pour réduire les différences après le changement de modèle.
Comment définir les paramètres de la chaîne de secours ?
Savoir qu’il faut « basculer en cas d’échec » ne suffit pas. Si le basculement est trop rapide ou trop lent, vous risquez d’avoir des problèmes. Voici les questions les plus fréquentes et quelques repères pour adapter les réglages à votre activité. Il n’existe pas de réponse universelle.
| Paramètre | Recommandation | Pourquoi |
|---|---|---|
| Nombre de nouvelles tentatives sur un même modèle | Une seule au maximum, puis passer au suivant en cas d’échec | Quand le fournisseur rencontre un problème, réessayer plusieurs fois le même modèle revient souvent à faire la queue une fois de plus |
| Délai d’attente par requête | Plutôt court pour une conversation, plus long pour la génération de longs textes | Si l’attente s’éternise, l’utilisateur risque de fermer la page avant que le basculement ait lieu |
| Que faire en cas d’erreur 429 ? | Attendre une ou deux secondes, puis passer au modèle suivant | Le dépassement de limite peut être dû à un pic passager et se résorber rapidement |
| Durée maximale d’attente pour toute la chaîne | La somme des délais des trois niveaux ne doit pas dépasser le temps d’attente acceptable pour l’utilisateur | Évite qu’une requête reste bloquée si les trois niveaux sont lents |
| Quelles informations journaliser ? | Pour chaque requête : quel niveau a réussi ou échoué, et quel code d’erreur a été renvoyé | Permet de savoir après coup quel fournisseur rencontre des problèmes et s’il faut modifier l’ordre |
| Quand alerter l’équipe ? | Lorsque la proportion d’utilisation du modèle de secours augmente brusquement | Le basculement est transparent pour les utilisateurs, mais l’équipe peut aussi ne rien remarquer. Quelqu’un doit être averti lorsque le modèle principal rencontre des problèmes |
Ce dernier point est souvent négligé. Plus le mécanisme de secours fonctionne bien, moins les problèmes du modèle principal sont visibles. Sans suivi des journaux, le modèle principal peut être hors service depuis une journée entière alors que tout le monde pense que tout va bien — jusqu’à ce que la facture révèle une multitude d’appels aux modèles de secours.
Changer de modèle sans changer de clé
Le plus difficile avec une solution de secours, c’est d’éviter une refonte trop lourde. Si chaque modèle exige un compte distinct, une nouvelle adresse et un format de requête différent, la plupart des équipes attendront la prochaine panne pour s’y mettre.
Avec APIYI, on utilise la même adresse, https://api.apiyi.com/v1/chat/completions, et la même clé. Il suffit de changer model dans le corps de la requête. On commence avec claude-opus-5-5, puis, en cas d’échec, on passe à claude-sonnet-5-5, puis à gemini-4-argon. Les deux premiers modèles viennent du même fournisseur ; le troisième, d’un autre. Si l’un des fournisseurs rencontre un problème général, il reste donc une autre option.
La modification est légère : il suffit d’ajouter à votre code métier une liste de noms de modèles à essayer dans l’ordre. Le format des requêtes, l’authentification et la structure des réponses restent inchangés, ce qui simplifie aussi les tests.
| Ordre | Nom du modèle | Prix d’entrée | Prix de sortie | Rôle |
|---|---|---|---|---|
| 1 | claude-opus-5-5 | 4 | 20 | Modèle principal |
| 2 | claude-sonnet-5-5 | 2 | 10 | Première solution de secours, modèle moins cher du même fournisseur |
| 3 | gemini-4-argon | 2 | 10 | Deuxième solution de secours, autre fournisseur |
| Remplaçable | gpt-6-astra | 10 | 50 | Solution de secours plus chère, accessible uniquement via l’interface OpenAI |
| Remplaçable | deepseek-v4.1-flash | 0.30 | 1.20 | Solution de secours économique |
Les prix du tableau sont en dollars par million de tokens. Ils sont basés sur la page des tarifs du 2026-10-21, avec un multiplicateur de 1. Les tarifs peuvent évoluer : consultez la page des prix sur api.apiyi.com pour connaître les tarifs en vigueur.
Ajouter une solution de secours en trois étapes
Étape 1 : obtenir une clé. Inscrivez-vous sur api.apiyi.com et créez une clé. La facturation se fait à l’usage, et le service est directement accessible depuis la Chine, sans carte bancaire étrangère. Cette même clé permet d’appeler tous les modèles du tableau.
Étape 2 : tester chaque modèle. Renseignez l’adresse https://api.apiyi.com/v1. Elle est compatible avec le format de l’interface OpenAI : si votre code utilise déjà la bibliothèque officielle d’OpenAI, il vous suffit de remplacer l’adresse et la clé. Avec la même invite, testez claude-opus-5-5, claude-sonnet-5-5 et gemini-4-argon, puis vérifiez que chacun renvoie une réponse correcte au format attendu.
Étape 3 : définir l’ordre et faire un exercice. Ajoutez les trois noms de modèles à votre configuration dans l’ordre choisi et décidez quand basculer en suivant les règles de la section précédente. Une fois le tout configuré, ne le déployez pas tout de suite : réduisez temporairement le délai d’attente du modèle principal pour provoquer un délai d’expiration. Vérifiez que la requête passe bien au deuxième modèle et que l’événement apparaît dans les journaux. Ce n’est qu’une fois ce test réussi que votre solution de secours est réellement prête. Pour connaître les paramètres précis, consultez la documentation d’intégration sur docs.apiyi.com.
Adapter l’ordre aux différents usages
L’ordre proposé ici privilégie la qualité, mais ce n’est pas la seule possibilité. Selon votre activité, vous pouvez choisir un autre modèle en première position.
| Type d’activité | Ordre suggéré | Justification |
|---|---|---|
| Programmation, raisonnement complexe | claude-opus-5-5 → claude-sonnet-5-5 → gemini-4-argon | La qualité d’abord : c’est l’ordre proposé par défaut dans cet article |
| Service client, conversations courantes | claude-sonnet-5-5 → gemini-4-argon → deepseek-v4.1-flash | Le volume d’appels est élevé et le prix unitaire compte : inutile de commencer par le modèle le plus cher |
| Traduction et résumé en lots | deepseek-v4.1-flash → gemini-4-argon → claude-sonnet-5-5 | Pour les tâches nombreuses, on commence par le modèle économique et on monte en gamme en cas d’échec |
| Sorties au format très contraint | Les deux modèles d’un même fournisseur d’abord, puis l’autre fournisseur | Les modèles d’un même fournisseur ont généralement un style plus proche, ce qui réduit les écarts lors du basculement |
Deux principes suffisent pour choisir l’ordre : si possible, la dernière solution de secours doit venir d’un autre fournisseur ; et le prix unitaire doit être proportionnel à la valeur de la tâche. La ligne consacrée à la traduction en lots illustre bien l’intérêt d’une solution de secours : si DeepSeek, en première position, était tombé en panne le 15 octobre, les requêtes seraient automatiquement passées aux deux autres fournisseurs et les tâches auraient quand même abouti.
À noter : le changement de modèle permet de maintenir la disponibilité de l’étape d’appel au modèle, mais il ne peut pas résoudre une panne de courant dans un centre de données.
Les fournisseurs amont peuvent tomber en panne : prévoyez une autre option
Un exemple rendu public est la panne officielle de DeepSeek du 15 octobre 2026 : APIYI est alors passé sur le canal pleine puissance de Volcano Engine. Aucun changement de nom de modèle n’a été nécessaire et l’environnement de production est revenu à la normale. Source : les actualités en temps réel sur docs.apiyi.com.
Les fournisseurs amont peuvent tomber en panne, et ce n’est la faute de personne. Prévoir une autre option à l’avance est plus utile que d’attendre des heures. En temps normal, cela ne coûte presque rien et ne mobilise pas de ressources humaines : il suffit de le faire avant l’incident. Si vous attendez la panne, vous devrez effectuer les changements dans l’urgence.
En cas de panne, que vérifier en premier ?
Si les requêtes échouent soudainement à grande échelle, ne vous précipitez pas sur le code. Prenez deux minutes pour vérifier trois choses : premièrement, Google Cloud Service Health, pour savoir s’il s’agit d’un incident au niveau du centre de données ; deuxièmement, la page d’état officielle du fournisseur du modèle concerné, comme celle de DeepSeek dans ce cas ; troisièmement, les actualités en temps réel de docs.apiyi.com, où APIYI signale les changements de route vers les fournisseurs amont.
Si les trois sources indiquent que tout fonctionne normalement, vérifiez alors votre propre configuration : la clé a-t-elle expiré ? Votre solde est-il suffisant ? Y a-t-il un problème de sortie réseau ou de DNS ? Si vous commencez par ces vérifications, vous risquez de chercher longtemps dans votre code avant de découvrir que le problème vient du fournisseur amont.
Quatre choses à faire dès aujourd’hui
- Recensez tous les endroits où votre activité appelle un modèle et repérez ceux qui ne dépendent que d’un seul fournisseur.
- Pour chacun de ces cas, ajoutez au moins un modèle de secours d’un autre fournisseur.
- Suivez les règles indiquées plus haut : ne basculez qu’en cas d’erreur 429, 5xx ou de délai d’expiration, et consignez chaque basculement dans les journaux.
- Provoquez volontairement un délai d’expiration du modèle principal et vérifiez que la requête passe bien au modèle de secours.
Une fois ces quatre étapes terminées, que la prochaine panne soit due à une coupure de courant dans un centre de données ou à l’indisponibilité d’un fournisseur de modèles, votre application ralentira tout au plus de quelques secondes au lieu de s’arrêter pendant des heures.
Questions fréquentes
Q1 : Après la coupure de courant à Londres chez Google Cloud, faut-il immédiatement quitter Londres ?
Pas nécessairement. La recommandation officielle dit « si possible », elle n’exige pas que tout le monde déménage immédiatement. Les équipes dont la charge de travail se trouve dans europe-west2-b peuvent envisager de passer à une autre zone ou région. Les équipes qui se contentent d’appeler des API de modèles n’ont pas besoin de migrer : elles peuvent commencer par configurer une solution de secours pour leurs modèles.
Q2 : Changer de modèle risque-t-il de coûter plus cher ?
Avec l’ordre proposé ci-dessus, cela revient au contraire moins cher. Le modèle principal claude-opus-5-5 coûte 4 en entrée et 20 en sortie, tandis que les deux modèles de secours coûtent 2 en entrée et 10 en sortie. Les coûts n’augmentent que si vous ajoutez à votre liste de secours un modèle comme gpt-6-astra, qui coûte 10 en entrée et 50 en sortie.
Q3 : Une seule clé permet-elle d’appeler les modèles de ces différents fournisseurs ?
Oui. Ces modèles utilisent tous la même adresse compatible avec OpenAI et la même clé ; seul `model` change. Notez toutefois que gpt-6-astra est accessible uniquement via l’interface OpenAI.
Q4 : La qualité des réponses risque-t-elle de baisser si je passe à un modèle de secours ?
Il peut y avoir des différences, surtout si vous passez du modèle le plus puissant à une option moins chère. Mais pour la plupart des usages, une réponse un peu plus lente et légèrement moins bonne vaut mieux qu’une erreur. Si le format est important, précisez-le clairement dans l’invite système, puis comparez à l’avance les réponses de plusieurs modèles avec la méthode de la deuxième étape. Vous saurez ainsi à quoi vous attendre avant la mise en production.
Q5 : Est-ce que garder des modèles de secours entraîne des frais quand tout fonctionne normalement ?
Non. Avec la facturation à l’usage, vous ne payez que les requêtes effectivement envoyées. Si le modèle principal réussit, les modèles de secours ne sont pas appelés et ne génèrent aucuns frais. Le seul coût réel correspond au temps nécessaire à l’intégration et aux quelques requêtes de test pendant l’exercice.
Points essentiels
- Deux interruptions : coupure de courant de 7 h 52 dans europe-west2-b chez Google Cloud ; interruption de 4 h 52 enregistrée par DeepSeek.
- Ce que les faits permettent d’affirmer : toute l’Europe n’a pas été touchée et les modèles ne sont pas devenus indisponibles pour autant. DeepSeek n’a pas publié la cause de l’incident.
- Quand basculer : uniquement en cas d’erreur 429, 500, 502, 503 ou 504, ou de délai d’expiration. Ne basculez pas en cas d’erreur 401 ou 403, ni de refus lié à la sécurité du contenu.
- Comment faire : privilégiez un fournisseur différent pour le modèle de secours ; gardez la même adresse et la même clé, et ne changez que
model. - Comment valider : après l’intégration, provoquez un délai d’expiration du modèle principal et vérifiez que la requête passe bien au modèle de secours et que l’événement est consigné dans les journaux.
Un remboursement de crédits peut compenser une facture, mais pas rattraper le travail interrompu. Définissez à l’avance l’ordre des modèles : la prochaine fois que le fournisseur amont aura un problème, les utilisateurs ne remarqueront au pire qu’un léger ralentissement.
Références
- Google Cloud Service Health : incident touchant plusieurs services dans europe-west2 (Xs2XTHzAVC9YnafnPyzj), 2026-10-20
- Google Cloud Service Health : incident touchant les produits de sécurité Google SecOps dans europe-west2 (signalement distinct), 2026-10-20
- BBC : article sur les répercussions de la panne de Google Cloud sur les banques et les services publics britanniques, 2026-10-20
- Page d’état officielle de DeepSeek : interruption de service du 2026-10-15
- Documentation officielle : actualités en temps réel sur docs.apiyi.com
Auteur : équipe technique d’APIYI
Échanges techniques : si vous rencontrez des difficultés en mettant en place une solution de secours pour vos modèles, n’hésitez pas à en discuter dans les commentaires.