El 20 de octubre de 2026, un apagón dejó sin servicio durante casi 8 horas una zona de disponibilidad de Google Cloud en Londres. Cinco días antes, DeepSeek también estuvo caído durante buena parte de la mañana. Muchos desarrolladores se preguntan si la próxima vez les pasará lo mismo a sus aplicaciones de IA.
Nunca se sabe cuándo puede fallar un proveedor. Si solo llamas a la API de un modelo, no tienes que trasladar tus centros de datos, pero tampoco puedes depender de un único modelo para todo el negocio.
Valor principal: Al terminar de leer, sabrás distinguir cuándo hay que actuar y cuándo no, y cómo preparar una alternativa para tus modelos.
Qué se interrumpió en cada uno de los dos incidentes de esta semana
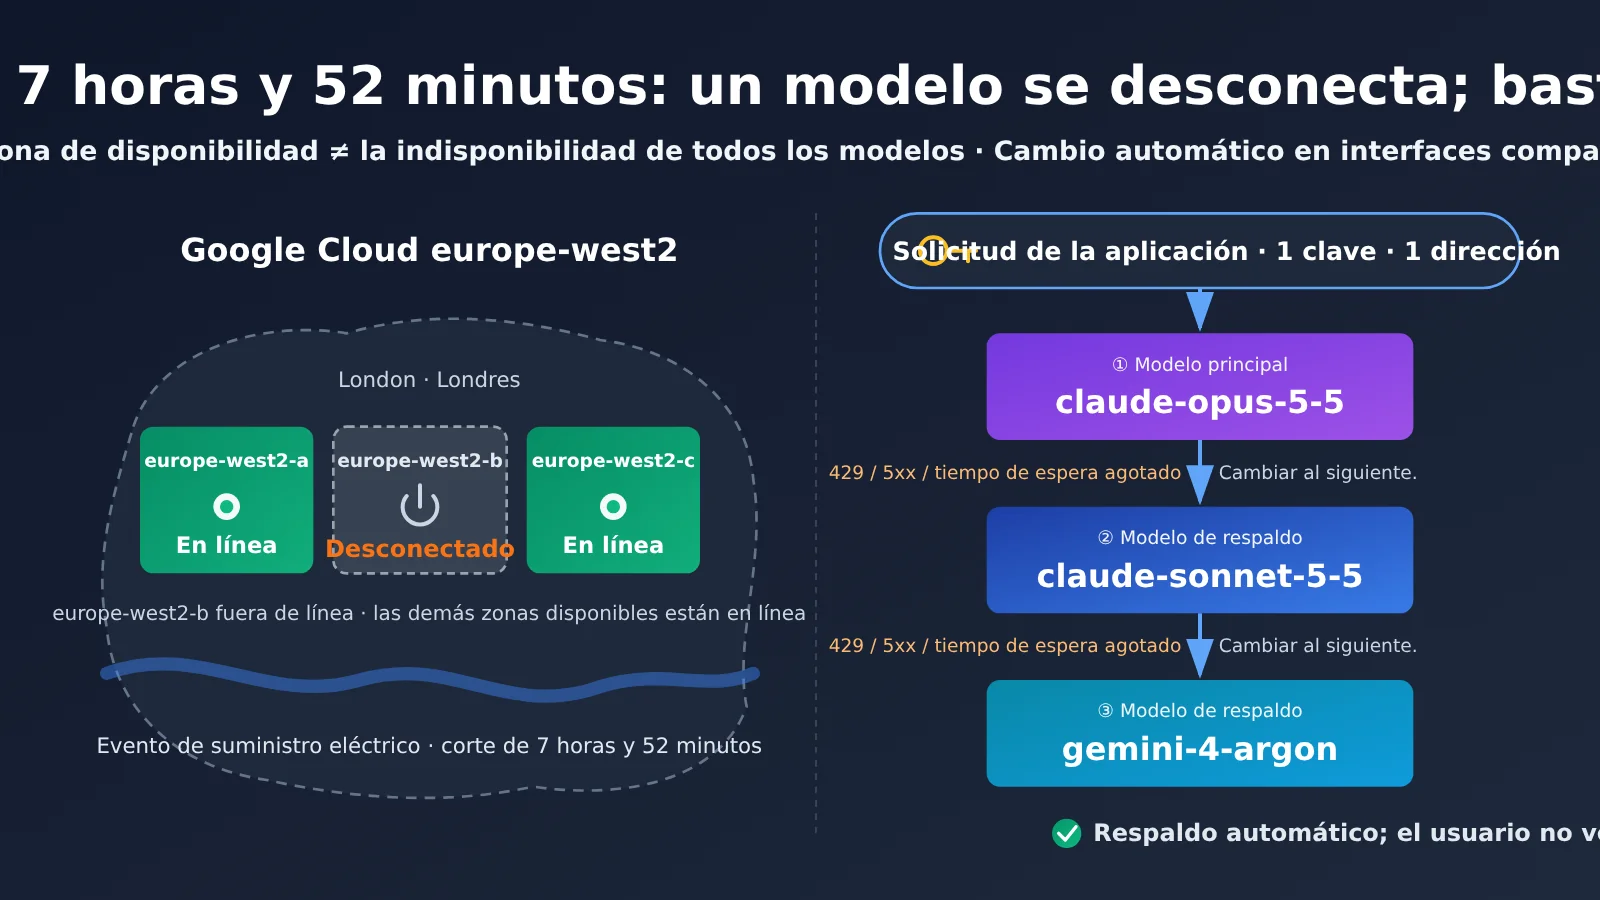
Empecemos por Google Cloud. El 20 de octubre de 2026, entre las 14:08 y las 22:00, hora de Pekín, se produjo un corte por un incidente de suministro eléctrico en la zona de disponibilidad europe-west2-b, en Londres. Duró 7 horas y 52 minutos. Se vieron afectados los servicios de computación, almacenamiento, bases de datos y redes desplegados en esa zona. Quienes solo llamaban de forma remota a una API de modelos no estuvieron directamente afectados. Pero si tu servicio se ejecutaba precisamente en esa zona, durante toda esa tarde las tareas en segundo plano, las conexiones a la base de datos y las interfaces externas tuvieron que quedarse esperando. Nadie podía hacer ese trabajo por adelantado.
Ahora, DeepSeek. A partir del 15 de octubre de 2026, a las 08:11, hora de Pekín, se produjeron interrupciones parciales en el sitio web, las conversaciones y las API de V4 Pro y V4.1 Flash. La página oficial de estado registra una duración de 4 horas y 52 minutos; el servicio se restableció ese mismo día a las 13:04. Caixin y el South China Morning Post dijeron «casi 5 horas», pero esa es la cifra de los medios: la duración oficial es la que cuenta. Más tarde, DeepSeek devolvió como saldo el importe consumido entre el 8 y el 14 de octubre. La empresa no ha publicado la causa, así que no vamos a especular. Para los usuarios, lo que determinó si podían trabajar esa mañana fue tener o no una segunda alternativa, no conocer la causa.
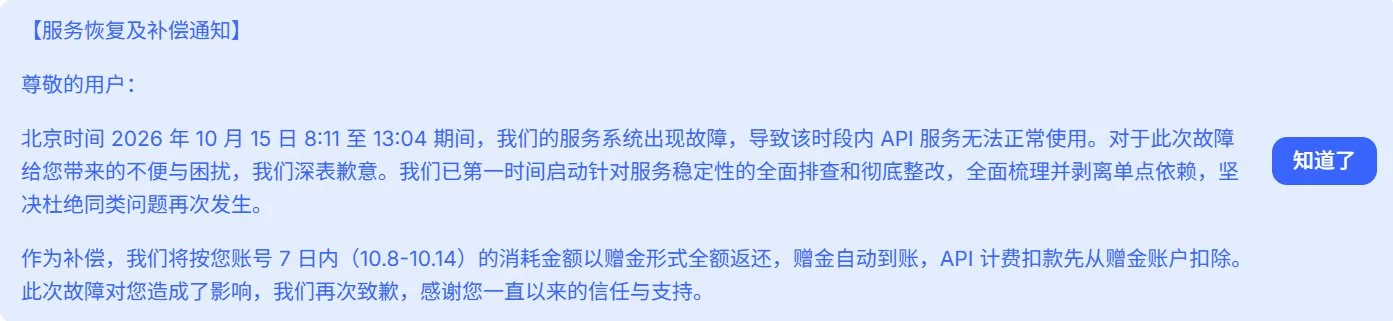
Imagen: aviso de DeepSeek sobre la restauración del servicio y la compensación para los usuarios. El servicio de API no estuvo disponible correctamente entre las 8:11 y las 13:04 del 15 de octubre, hora de Pekín. Se reembolsará el importe total gastado por cada cuenta entre el 8 y el 14 de octubre en forma de crédito, que se abonará automáticamente. Los cargos de la API se descontarán primero del saldo de crédito.
Ambos incidentes dolieron por lo mismo: el modelo es una pieza del flujo de trabajo del día y, cuando se cae la interfaz, se paralizan tareas como escribir código, consultar información o ejecutar procesos por lotes. Para cuando el proveedor lo soluciona, ya se ha perdido medio día. El crédito devuelto compensa la factura, pero no recupera el trabajo interrumpido. Si un equipo tenía previsto entregar una tanda de traducciones, ejecutar una ronda de evaluaciones o preparar un lanzamiento ese día, nada de eso se completa por sí solo gracias a la compensación posterior. Todo se pospone y acaba ocupando espacio en la planificación del día siguiente.
| Elemento | Datos confirmados del incidente de Google Cloud |
|---|---|
| ID del incidente | Xs2XTHzAVC9YnafnPyzj |
| Alcance del impacto | La zona de disponibilidad europe-west2-b, dentro de la región europe-west2 |
| Causa | Incidente de suministro eléctrico; no se han publicado más detalles |
| Inicio | 20 de octubre de 2026, 14:08, hora de Pekín |
| Fin | 20 de octubre de 2026, 22:00, hora de Pekín; duración de 7 horas y 52 minutos |
| Sin impacto | Looker Studio |
¿Qué diferencia hay entre una zona de disponibilidad y una región?
Al leer «corte de electricidad en Londres», mucha gente piensa que todo Google Cloud en Londres dejó de funcionar, pero no fue así. Una región (europe-west2) puede entenderse como todo un conjunto de centros de datos de Google en Londres. Las zonas de disponibilidad (europe-west2-a, b y c) son edificios separados dentro de ese conjunto. Están diseñados para tener suministro eléctrico y conexión de red independientes, de modo que los demás puedan seguir funcionando si uno sufre un incidente. Esta vez, de las tres zonas, una se quedó a oscuras y las otras dos siguieron funcionando con normalidad.
Por eso, los equipos más afectados fueron los que tenían sus servicios únicamente en la zona b. Si los servicios ya estaban distribuidos entre las zonas a y c, el tráfico podía redirigirse a los edificios que seguían operativos y el impacto era mucho menor. Quienes solo llamaban de forma remota a una API de modelos casi no notaron el corte.
Los dos incidentes, comparados
| Aspecto | Google Cloud en Londres | DeepSeek |
|---|---|---|
| Hora (hora de Pekín) | Del 20 de octubre de 2026, 14:08 a las 22:00 | Del 15 de octubre de 2026, 08:11 a las 13:04 |
| Duración | 7 horas y 52 minutos | 4 horas y 52 minutos |
| Qué se interrumpió | Computación, almacenamiento, bases de datos y redes en europe-west2-b | El sitio web, las conversaciones y las API de V4 Pro y V4.1 Flash |
| Causa | Incidente de suministro eléctrico; sin más detalles | No publicada por la empresa |
| Medidas posteriores | La empresa recomendó migrar a otra zona de disponibilidad o región, si era posible | Se devolvió como saldo el importe consumido entre el 8 y el 14 de octubre |
| Usuarios que solo llaman a una API de modelos | No estuvieron directamente afectados | Fueron los más afectados; sin una alternativa, solo quedaba esperar |
Al comparar ambos incidentes, la diferencia queda clara: el de Google afectó a quienes tenían sus máquinas en la zona b; la solución es desplegar los servicios en varias zonas de disponibilidad. El de DeepSeek afectó a quienes dependían de un único proveedor de modelos; la solución es tener preparada de antemano una alternativa. El primero es un problema de centros de datos y el segundo, de llamadas a modelos. A continuación hablaremos del segundo.
Lecciones que deja este incidente
Un proveedor puede caerse, así que conviene tener preparadas una segunda y hasta una tercera alternativa. Lo ideal es que no pertenezcan al mismo proveedor. Cambiar a un plan más económico de la misma empresa no cuenta como alternativa: si falla toda la empresa, los dos planes caerán a la vez.
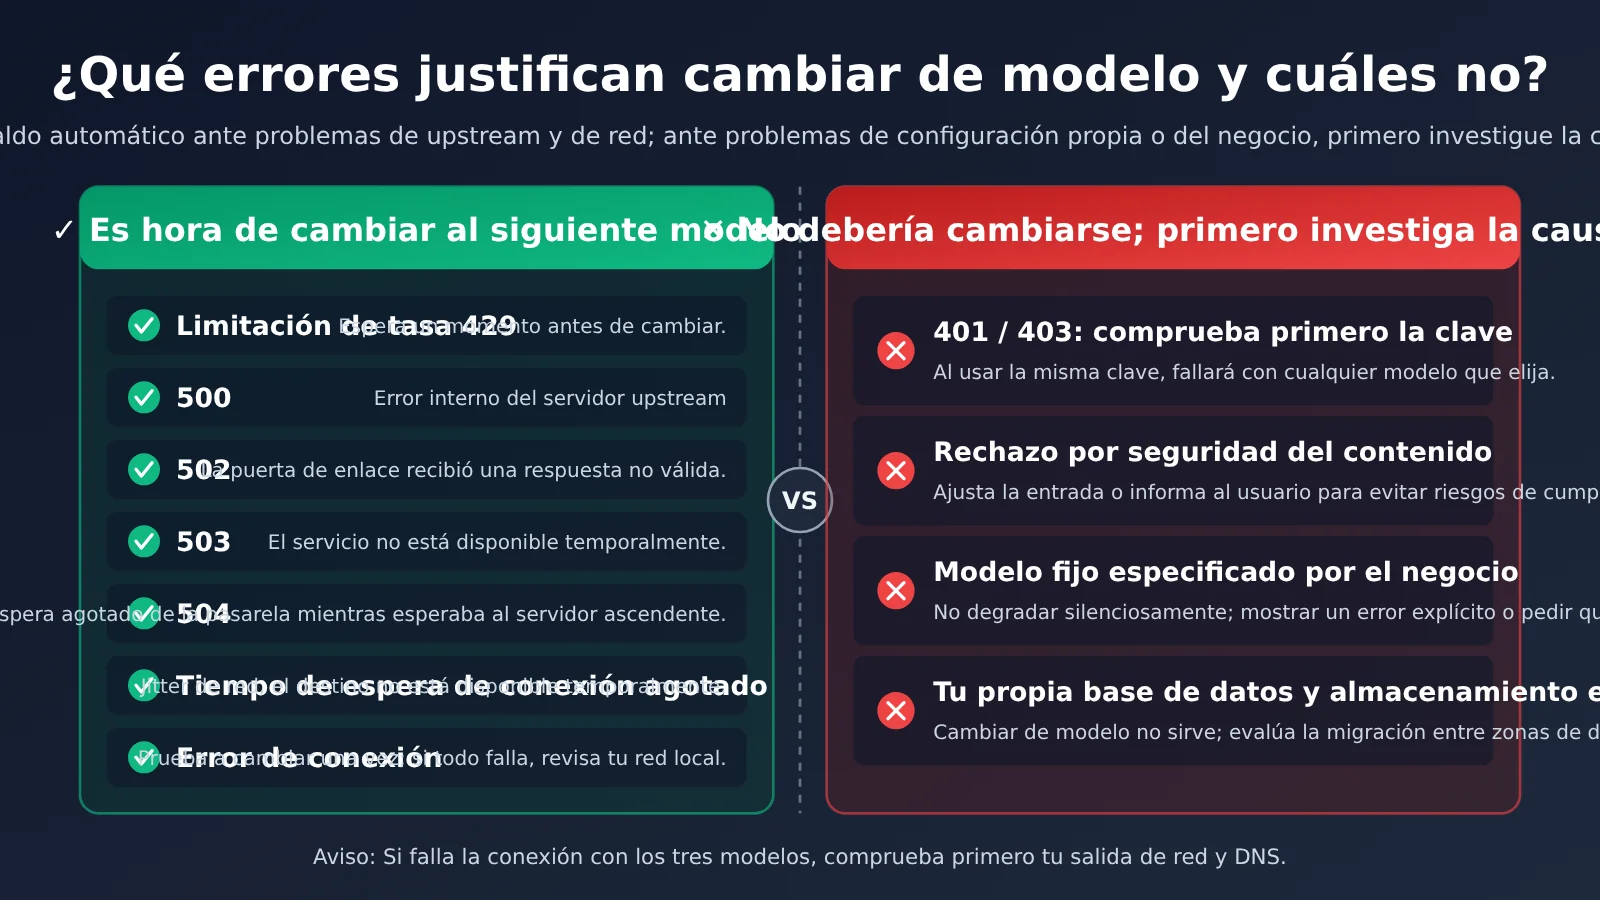
También importa cuándo cambiar de modelo: hazlo solo ante errores 429, 500, 502, 503, 504 o tiempos de espera agotados. Estos errores indican que el proveedor no puede atender la solicitud en ese momento; probar con otro modelo puede funcionar. No cambies ante errores 401 o 403 ni ante un rechazo por seguridad del contenido: el problema está en la clave o en el propio contenido, y cambiar entre diez modelos no lo resolverá. Y no olvides que cambiar de modelo no salvará una base de datos o un sistema de almacenamiento que hayas desplegado en una zona de disponibilidad caída. En ese caso, hay que evaluar el despliegue en varias zonas. La redundancia de modelos y la recuperación ante incidentes del centro de datos son cosas distintas; no las confundas.
Una vez configurada la alternativa, no la desactives cuando termine el incidente. No genera solicitudes adicionales en condiciones normales: si el modelo principal responde correctamente, no hace falta usarla. Pero, cuando vuelva a ocurrir algo, se activará automáticamente y no tendrás que levantarte en mitad de la noche para modificar el código. Antes de ponerte manos a la obra, envía a cada modelo una solicitud sencilla por separado para confirmar que el nombre está bien escrito y que responde correctamente. Después, piensa en cómo encadenarlos. Las respuestas de cada modelo pueden tener estilos distintos. Si el formato de salida es importante para tu aplicación, puedes especificarlo de forma estricta en la indicación del sistema para reducir las diferencias al cambiar de modelo.
Cómo configurar algunos parámetros de la cadena de respaldo
No basta con saber que «si falla, se cambia». Cambiar demasiado rápido o demasiado tarde puede causar problemas. Estas son algunas de las preguntas más habituales. No hay una respuesta universal: adapta las recomendaciones a tu caso.
| Configuración | Recomendación | Motivo |
|---|---|---|
| Cuántas veces reintentar con el mismo modelo | Como máximo, 1 vez; si vuelve a fallar, pasar al siguiente | Cuando el proveedor tiene problemas, volver a probar con el mismo modelo suele limitarse a hacer otra vez la cola |
| Cuánto esperar por cada solicitud | Menos para conversaciones y más para generar textos largos | Si esperas demasiado, el usuario puede cerrar la página antes de que se produzca el cambio |
| Qué hacer ante un error 429 | Esperar uno o dos segundos antes de cambiar | A veces, la limitación de solicitudes se debe a un pico puntual y se resuelve al poco tiempo |
| Cuánto esperar como máximo por toda la cadena | La suma de los tiempos de los tres modelos no debe superar lo que el usuario está dispuesto a esperar | Evita que la solicitud quede esperando indefinidamente si los tres modelos responden lento |
| Qué registrar en los logs | Qué modelo respondió correctamente, cuál falló y qué código de error devolvió cada uno | Así podrás ver después qué proveedor tuvo problemas y decidir si conviene cambiar el orden |
| Cuándo avisar al equipo | Cuando aumente de repente el porcentaje de uso de los modelos de respaldo | Cuando entra en funcionamiento la alternativa, el usuario no lo nota; el equipo tampoco. Alguien tiene que enterarse de que el modelo principal tiene problemas |
El último punto es el que más se suele pasar por alto. Cuanto mejor funciona la alternativa, menos se nota que el modelo principal tiene problemas. Si nadie revisa los logs, puede que el modelo principal lleve caído todo el día y todos crean que funciona con normalidad, mientras la factura acumula un montón de llamadas a los modelos de respaldo.
Cambiar de modelo no implica cambiar de clave API
La mayor preocupación al preparar un plan de respaldo es que requiera demasiados cambios. Si cada modelo exige crear una cuenta por separado, cambiar la dirección y modificar el formato de las solicitudes, la mayoría de los equipos lo dejará para la próxima vez que algo falle.
Con APIYI, se usa la misma dirección, https://api.apiyi.com/v1/chat/completions, y la misma clave API. Solo hay que cambiar model en el cuerpo de la solicitud. El modelo principal es claude-opus-5-5; si falla, se pasa a claude-sonnet-5-5 y, si vuelve a fallar, a gemini-4-argon. Los dos primeros pertenecen al mismo proveedor; el tercero, a otro. Así, si un proveedor tiene un problema general, queda otra opción disponible. Los cambios necesarios son mínimos: solo hay que añadir a la lógica de la aplicación una lista ordenada de nombres de modelos para probar. No hace falta cambiar el formato de las solicitudes, el método de autenticación ni la estructura de las respuestas, y las pruebas son sencillas.
| Orden | Nombre del modelo | Precio de entrada | Precio de salida | Función |
|---|---|---|---|---|
| 1 | claude-opus-5-5 | 4 | 20 | Modelo principal |
| 2 | claude-sonnet-5-5 | 2 | 10 | Primer respaldo, opción más económica del mismo proveedor |
| 3 | gemini-4-argon | 2 | 10 | Segundo respaldo, de otro proveedor |
| Reemplazable | gpt-6-astra | 10 | 50 | Respaldo más caro; solo funciona con la interfaz de OpenAI |
| Reemplazable | deepseek-v4.1-flash | 0.30 | 1.20 | Respaldo económico |
Los precios de la tabla están expresados en dólares por millón de tokens. Se organizaron según los precios del 2026-10-21 y con un multiplicador de 1. Los precios pueden cambiar; consulta la página de precios de api.apiyi.com para ver los vigentes.
Configura el respaldo en tres pasos
Paso 1: consigue una clave API. Regístrate en api.apiyi.com y crea una clave API. El servicio se factura según el uso, se puede usar directamente desde China y no hace falta vincular una tarjeta de crédito extranjera. Con esa única clave puedes llamar a todos los modelos de la tabla.
Paso 2: prueba cada modelo. Configura la dirección de la interfaz como https://api.apiyi.com/v1. Es compatible con el formato de la interfaz de OpenAI, así que, si ya usas la biblioteca oficial de OpenAI, basta con cambiar la dirección y la clave API. Usa la misma indicación para probar claude-opus-5-5, claude-sonnet-5-5 y gemini-4-argon. Comprueba que todos respondan correctamente y que el formato sea el esperado.
Paso 3: define el orden y haz un simulacro. Añade los nombres de los tres modelos a la configuración, en el orden elegido, y decide cuándo cambiar de uno a otro según las reglas de la sección anterior. Una vez configurado, no lo pongas en producción de inmediato: reduce temporalmente el tiempo de espera del modelo principal para provocar un timeout y comprueba si la solicitud pasa al segundo modelo y si queda registrada en los logs. Cuando el simulacro salga bien, sabrás que la ruta de respaldo funciona. Consulta la documentación de integración en docs.apiyi.com para ver los parámetros concretos.
Cómo ordenar los modelos según el tipo de negocio
El orden predeterminado de este artículo prioriza la calidad, pero no es la única opción. Según el negocio, también se puede elegir otro modelo para empezar.
| Tipo de negocio | Orden de referencia | Motivo |
|---|---|---|
| Programación y razonamiento complejo | claude-opus-5-5 → claude-sonnet-5-5 → gemini-4-argon | Se prioriza la calidad; es el orden predeterminado de este artículo |
| Atención al cliente y conversaciones cotidianas | claude-sonnet-5-5 → gemini-4-argon → deepseek-v4.1-flash | Hay muchas llamadas y el precio por unidad importa; no hace falta empezar por el modelo más caro |
| Traducción y resúmenes por lotes | deepseek-v4.1-flash → gemini-4-argon → claude-sonnet-5-5 | Como se procesan muchas solicitudes, se empieza por la opción económica y, si falla, se pasa a modelos más potentes |
| Respuestas con requisitos estrictos de formato | Primero, dos modelos del mismo proveedor; al final, uno de otro proveedor | Los modelos del mismo proveedor suelen tener estilos más parecidos, así que el cambio se nota menos |
El orden se rige por dos principios: procura que el último modelo sea de otro proveedor y adapta el precio unitario al valor de la tarea. El ejemplo de la traducción por lotes también muestra bien la utilidad del respaldo: si el 15 de octubre DeepSeek, el modelo inicial, hubiera dejado de funcionar, las solicitudes habrían pasado automáticamente a los otros dos proveedores y las tareas habrían podido completarse.
Conviene dejar algo claro: cambiar de modelo permite que «el paso de invocación del modelo no se interrumpa», pero no puede solucionar un corte de electricidad en el centro de datos.
Los proveedores pueden fallar: prepara otra ruta con antelación
Un caso documentado es la interrupción oficial de DeepSeek del 2026-10-15: en ese momento, APIYI cambió al canal de la versión completa de Volcano Engine. No hubo que cambiar el nombre del modelo y el entorno de producción volvió a funcionar con normalidad. Fuente: novedades en tiempo real de docs.apiyi.com.
Los proveedores pueden fallar; no es culpa de nadie. Preparar otra ruta con antelación es mucho mejor que esperar sin hacer nada durante horas. Normalmente, esto no cuesta casi nada ni requiere tiempo del equipo: basta con dejarlo listo antes de que ocurra un problema. Si se espera a que ocurra, solo quedará hacer cambios con prisas.
Cuando ocurra un problema, ¿qué conviene revisar primero?
Si de repente falla una gran cantidad de solicitudes, no te apresures a cambiar el código. Dedica dos minutos a revisar estos tres sitios: primero, Google Cloud Service Health, para comprobar si hay un problema en el centro de datos; segundo, la página de estado oficial del proveedor del modelo correspondiente, como la de DeepSeek en este caso; y tercero, las actualizaciones en tiempo real de docs.apiyi.com, donde APIYI informa de los cambios en las rutas de sus proveedores.
Si los tres indican que todo funciona con normalidad, revisa tu propia configuración: comprueba si la clave API ha caducado, si hay saldo suficiente y si hay problemas con la salida de red o el DNS. Si sigues el orden inverso, puedes pasar mucho tiempo buscando el problema en tu código y acabar descubriendo que estaba en el proveedor.
Cuatro cosas que puedes hacer hoy mismo
- Haz una lista de todos los lugares de la aplicación que llaman a modelos y comprueba cuáles dependen de un solo proveedor.
- Añade al menos un modelo de otro proveedor como respaldo en cada lugar que dependa de uno solo.
- Según las reglas anteriores, cambia de modelo únicamente ante errores 429, 5xx y timeouts, y registra cada cambio en los logs.
- Provoca un timeout del modelo principal y confirma que la solicitud pasa realmente al modelo de respaldo.
Cuando hayas completado estas cuatro tareas, la próxima vez que haya un corte de electricidad en el centro de datos o una interrupción del proveedor del modelo, tu aplicación se ralentizará unos segundos como mucho, en lugar de quedar fuera de servicio durante horas.
Preguntas frecuentes
P1: Después del corte de electricidad en Londres de Google Cloud, ¿hay que migrar de Londres de inmediato?
No necesariamente. La recomendación oficial dice «si es posible»; no exige que todos migren de inmediato. Los equipos con cargas de trabajo en europe-west2-b pueden evaluar la posibilidad de trasladarlas a otra zona o región. Si solo llaman a la API de un modelo, no necesitan migrar: basta con preparar el respaldo de modelos.
P2: ¿Cambiar de modelo puede resultar más caro?
Con el orden de arriba, en realidad sale más barato. El modelo principal, claude-opus-5-5, cuesta 4 por la entrada y 20 por la salida; los dos modelos de respaldo cuestan 2 por la entrada y 10 por la salida. El costo solo aumentará si añades a la lista de respaldo un modelo como gpt-6-astra, que cuesta 10 por la entrada y 50 por la salida.
P3: ¿Se puede usar una sola clave API para llamar a los modelos de todos estos proveedores?
Sí. Todos estos modelos usan la misma dirección compatible con OpenAI y la misma clave API. Solo hay que cambiar `model`. Ten en cuenta que gpt-6-astra solo funciona con la interfaz de OpenAI.
P4: ¿La calidad de las respuestas puede empeorar al pasar al modelo de respaldo?
Es posible que haya diferencias, sobre todo al pasar del modelo más potente a uno más económico. Pero para la mayoría de los negocios, una respuesta un poco más lenta y de calidad algo menor es preferible a recibir un error. Si el formato es muy importante, puedes especificarlo claramente en la indicación del sistema y comparar de antemano las respuestas de varios modelos con el método del paso 2. Así sabrás qué esperar antes de ponerlo en producción.
P5: Si normalmente no hay problemas, ¿tener modelos de respaldo genera costos adicionales?
No. Con la facturación por uso solo pagas las solicitudes que realmente envías. Si el modelo principal responde correctamente, no se llama a los modelos de respaldo y no generan ningún costo. El único gasto real es el tiempo necesario para integrar la solución y el costo de las pocas solicitudes de prueba que envíes durante el simulacro.
Puntos clave
- Dos interrupciones: el corte de electricidad en Google Cloud europe-west2-b duró 7 horas y 52 minutos; la interrupción registrada por DeepSeek duró 4 horas y 52 minutos.
- Alcance de los hechos: no se interrumpió todo el servicio en Europa ni dejaron de funcionar los modelos. DeepSeek no ha publicado la causa.
- Cuándo cambiar de modelo: solo ante errores 429, 500, 502, 503, 504 y timeouts; no ante errores 401 o 403 ni rechazos por seguridad del contenido.
- Qué hacer: procura que los modelos de respaldo sean de otro proveedor. Usa la misma dirección y la misma clave API; solo cambia
model. - Cómo verificarlo: una vez configurado, provoca un timeout del modelo principal y comprueba si la solicitud pasa al modelo de respaldo y si queda registrada en los logs.
Un reembolso de saldo puede cubrir la factura, pero no recuperar el trabajo que se detuvo. Deja preparado el orden de los modelos y, la próxima vez que falle un proveedor, los usuarios apenas notarán unos segundos de demora.
Fuentes
- Google Cloud Service Health: incidente que afectó a varios servicios en europe-west2 (Xs2XTHzAVC9YnafnPyzj), 2026-10-20
- Google Cloud Service Health: incidente independiente en los productos de seguridad de Google SecOps en europe-west2, 2026-10-20
- BBC: reportaje sobre cómo el fallo de Google Cloud afectó a bancos y servicios públicos del Reino Unido, 2026-10-20
- Página oficial de estado de DeepSeek: registro de la interrupción del servicio del 2026-10-15
- Documentación oficial: actualizaciones en tiempo real de docs.apiyi.com
Autor: equipo técnico de APIYI
Intercambio técnico: Si tienes problemas al configurar el respaldo de modelos, deja un comentario y lo hablamos.