Zusammenfassung: Die Google Decisions API bewertet feste Optionen direkt per Scoring, ohne Text zu generieren. Dieser Artikel schätzt anhand öffentlicher Preise die Kosten für Klassifizierungs-, Moderations- und Routing-Aufgaben und erläutert mit offiziellen sowie Drittanbieter-Daten, wo die Grenzen der Einsatzfähigkeit liegen.
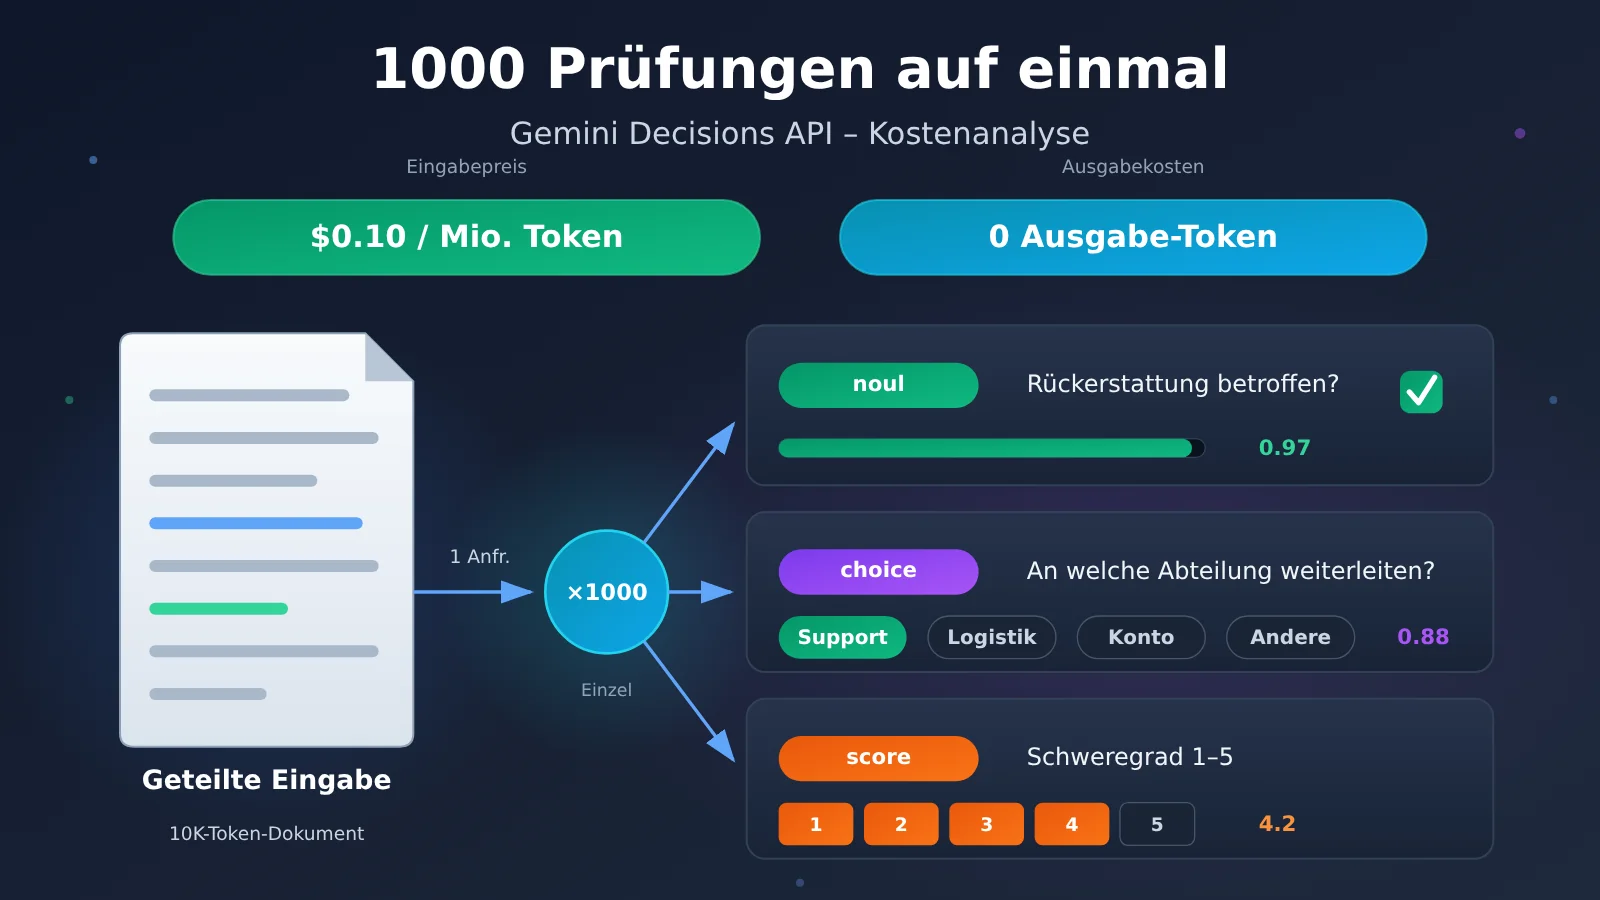
Fazit vorweg: Google hat am 11. November 2026 die Gemini Decisions API veröffentlicht (Modell-ID gemini-decision-1). Sie kann in einer einzigen Anfrage 1 bis 1.000 unabhängige Bewertungen für dieselbe Eingabe durchführen. Der Eingabepreis liegt bei 0,10 US-Dollar pro Million Token, es fallen keine Kosten für generative Ausgabe-Token an. Nach öffentlichen Preisen kostet die Prüfung eines 10K-Token-Dokuments gegen 1.000 Regeln etwa 1/20 von Gemini 3.5 Flash-Lite – eine theoretische Einsparung von 94,9 %. Klassifiziert man 1.000 Nachrichten jeweils einmal, beträgt die theoretische Einsparung 73,1 %. Die offiziellen Google-Tests ergeben einen Kostenvorteil von etwa dem 4,7-fachen. In unabhängigen Einzeltests von Drittanbietern liegt dieser Vorteil bei etwa dem 1,5-fachen. Für Aufgaben, die ausschließlich Klassifizierung, Moderation oder Routing betreffen und deren Antworten sich im Voraus auf feste Optionen eingrenzen lassen, eignet sich die API am besten zur Kostensenkung.
Im Folgenden erläutere ich zunächst die Funktionsweise dieser Schnittstelle und die drei Bewertungstypen, berechne dann mit einer nachvollziehbaren Formel die Kosten für drei typische Geschäftsfälle und erkläre die Diskrepanz zwischen den offiziellen „etwa 5-fach“-Angaben und den Messungen von Drittanbietern. Anschließend vergleiche ich die von Google veröffentlichten Geschwindigkeitsdaten mit der unabhängigen Bewertung von Artificial Analysis und diskutiere, ob die Genauigkeit den Produktionsanforderungen genügt. Zum Schluss folgen ein minimales Aufrufbeispiel, eine Auswahltabelle und eine Kostenprüfliste vor dem Produktivstart.
To Know: Grundbegriffe vorab
| Begriff | Erläuterung |
|---|---|
| Decisions API | Von Google bereitgestellte Entscheidungs-API, die für fest vorgegebene Optionen direkt ein Ergebnis und Wahrscheinlichkeiten liefert. |
| Gemini Decision 1 | Das spezielle Modell hinter dieser Schnittstelle; die Modell-ID lautet gemini-decision-1. |
| Token | Grundeinheit für Verarbeitung und Abrechnung durch das Modell; Text, Bilder usw. werden in Token umgerechnet. |
| Shared Input | Eingabeinhalt, der bei einer Anfrage von allen Entscheidungen gemeinsam genutzt wird. |
| Closed-set Decision | Entscheidung mit vorab festgelegtem Antwortbereich, z. B. „Ja/Nein“ oder „A/B/C“. |
| noul | Binäre Entscheidung, die die Wahrscheinlichkeit für „Yes“ zurückgibt. |
| choice | Auswahl einer Option aus 2–255 vorgegebenen Optionen. |
| score | Bewertung anhand vordefinierter geordneter Stufen; das Ergebnis ist ein gewichteter Erwartungswert. |
| Confidence | Wahrscheinlichkeitsschätzung des Modells, dass das gewählte Ergebnis korrekt ist. |
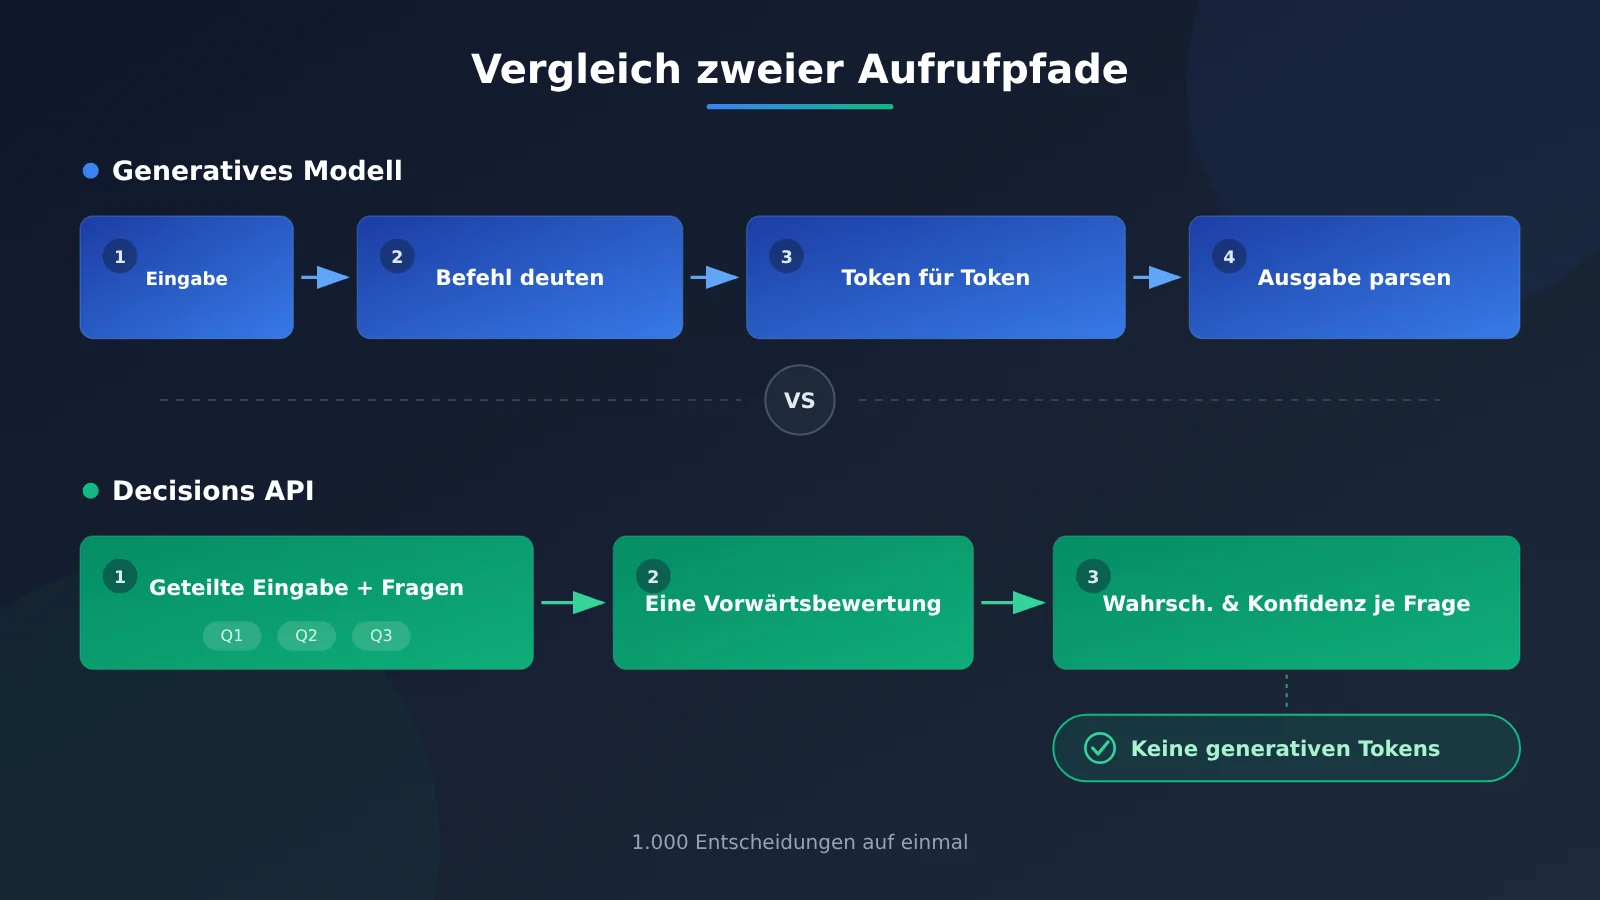
| Single Forward Pass | Das Modell liefert in einem einzigen Berechnungsdurchlauf Scores für alle Optionen, ohne Text Zeichen für Zeichen zu generieren. |
| Kontextfenster (Context Window) | Gesamtmenge an Inhalt, die eine einzelne Anfrage aufnehmen kann; bei diesem Modell 262.144 Token. |
| TPM / RPM | Anzahl der Token bzw. Anfragen, die pro Minute verarbeitet werden können; das ist die Obergrenze für den Durchsatz. |
1 Was Google veröffentlicht hat: Die Gemini Decisions API beantwortet gezielt Entscheidungsfragen
1.1 Der Unterschied zwischen Gemini Decision 1 und klassischen generativen Modellen
Die Gemini Decisions API wurde am 11. November 2026 über die Gemini Developer API v1beta freigegeben; der REST-Endpunkt lautet POST https://generativelanguage.googleapis.com/v1beta/decisions. Ihre Kernfunktion besteht darin, für vordefinierte Optionen eine probabilistische Entscheidung zu treffen und das Entscheidungsergebnis, die Wahrscheinlichkeit der einzelnen Optionen, die Konfidenz sowie den Token-Verbrauch zurückzugeben. Die Eingabe unterstützt Text, Bilder, Audio, Video und PDF.
Bei klassischen generativen Modellen sieht der Ablauf für Klassifizierungsaufgaben so aus: Inhalte einlesen, Anweisung verstehen, dann Token für Token eine Antwort generieren — und diese Antwort muss der Entwickler anschließend noch auswerten. Die Decisions API ändert den Ablauf: gemeinsame Inhalte einlesen und dann für jede Frage die vordefinierten Optionen direkt bewerten. Aufgaben wie Klassifizierung, Moderation oder Routing brauchen nur ein Label oder ein „Ja/Nein“. Eine lange generierte Antwort kostet Ausgabegebühren und verlangsamt die Reaktion. Genau dieser Schritt entfällt — daher kommen die geringeren Kosten und die niedrigere Latenz.
1.2 Welche Aufgaben die drei Entscheidungsarten der Decisions API abdecken
Nehmen wir eine Kundenservice-Nachricht als Beispiel: „Die Kopfhörer, die ich letzte Woche gekauft habe, haben am linken Ohr keinen Ton mehr. Ich habe vor drei Tagen eine Rückerstattung beantragt, und niemand hat reagiert. Wenn das nicht bearbeitet wird, beschwere ich mich auf der Plattform.“ Für diese eine Nachricht lassen sich im selben Request gleichzeitig drei voneinander unabhängige Fragen stellen.
| Entscheidungstyp | Beispiel-Frage | Rückgabe | Typische Aufgaben |
|---|---|---|---|
| noul | Betrifft diese Nachricht eine Rückerstattung? | Die Wahrscheinlichkeit für „Yes“, z. B. 0.97 | ob ein Verstoß vorliegt, ob ein Preis genannt wird, ob eine Eskalation zur Prüfung nötig ist |
| choice | An welche Abteilung weiterleiten: After-Sales / Logistik / Konto / Sonstiges? | „After-Sales“ wird ausgewählt, plus Wahrscheinlichkeit je Option | Ticket-Routing, Artikelklassifizierung, Auswahl von Agent-Tools |
| score | Wie schwerwiegend ist die Beschwerde auf einer Skala von 1–5? | gewichteter Erwartungswert aus den Wahrscheinlichkeiten der Stufen, z. B. 4.2 | Bewertung von Relevanz, Schweregrad und Lead-Priorität |
choice unterstützt 2–255 Optionen, score unterstützt 2–255 Stufen. score gibt einen Erwartungswert zurück, der aus den Wahrscheinlichkeiten der einzelnen Stufen berechnet wird; damit lässt er sich direkt zum Sortieren oder zum Festlegen von Schwellenwerten nutzen, ohne einen Score aus einem Bewertungstext herausziehen zu müssen.
2 Wie viel die Google Decisions API wirklich einspart: drei Geschäftsszenarien durchgerechnet
2.1 Warum gemeinsam genutzte Eingaben den Token-Verbrauch senken können
Die Abrechnungsstruktur der Decisions API hat drei Besonderheiten: Gemeinsam genutzte Eingaben werden bei einer Anfrage nur einmal berechnet, die Anweisungen für jede einzelne Frage werden weiterhin als Eingabe-Token abgerechnet, und die Entscheidungsergebnisse verursachen keine Kosten für generative Ausgaben. Zum Vergleich: Für Gemini 3.5 Flash-Lite gilt laut offizieller Standardpreisliste ein Preis von 0,30 US-Dollar pro Million Eingabe-Token und 2,50 US-Dollar pro Million Ausgabe-Token (offizielle Preisliste vom 13. November 2026).
Sei S die Token-Anzahl einer gemeinsam genutzten Eingabe, Q die Anzahl der unabhängigen Fragen zu dieser Eingabe, Tq die durchschnittliche Token-Anzahl pro Frage, To die durchschnittliche Anzahl der Ausgabe-Token des generativen Modells pro Frage und N die Anzahl der Eingaben. Unter der vereinfachenden Annahme, dass beide Schnittstellen dieselbe Anzahl abrechenbarer Eingabe-Token haben:
Decisions-API-Kosten  C_D = N × (S + Q×Tq) × 0.10 / 1,000,000
Flash-Lite-Kosten     C_F = N × [ (S + Q×Tq) × 0.30 + Q×To × 2.50 ] / 1,000,000
Ersparnisrate              = (1 − C_D / C_F) × 100%
Dies ist ein Rechenmodell zum Verständnis des Mechanismus; Google gibt keine feste Ersparnisrate an. Beide Schnittstellen haben jeweils eigene Anweisungskodierung und Formatierungsaufwände; die tatsächlichen Kosten richten sich nach den jeweils zurückgemeldeten abgerechneten Token.
2.2 Von einer Entscheidung zu 1.000 Entscheidungen – wie verändern sich die Kosten?
Die folgende Tabelle ist ein theoretisches Beispiel, das aus öffentlich einsehbaren Preisen abgeleitet wurde – ein echter Lasttest fand nicht statt. In Szenario ① beziehen sich alle 1.000 Entscheidungen auf dasselbe Dokument, es handelt sich also um 1.000 unabhängige Fragen zu einer einzigen Eingabe. Das ist eine ganz andere Last als „1.000 Dokumente jeweils einmal analysieren“.
| Geschäftsszenario | Wesentliche Annahmen | Decisions API | Flash-Lite | Theoretische Ersparnis |
|---|---|---|---|---|
| ① Ein Dokument wird gegen 1.000 Regeln geprüft | Dokument mit 10K Token, 20 Token pro Regel, Flash-Lite gibt 20 Token pro Regel aus, beides wird zu einer Anfrage zusammengefasst | $0.003 | $0.059 | 94,9 % |
| ② 1.000 Nachrichten werden je einmal klassifiziert | Je 300 Token, Klassifizierungsanweisung 50 Token, Flash-Lite gibt 10 Token aus | $0.035 | $0.130 | 73,1 % |
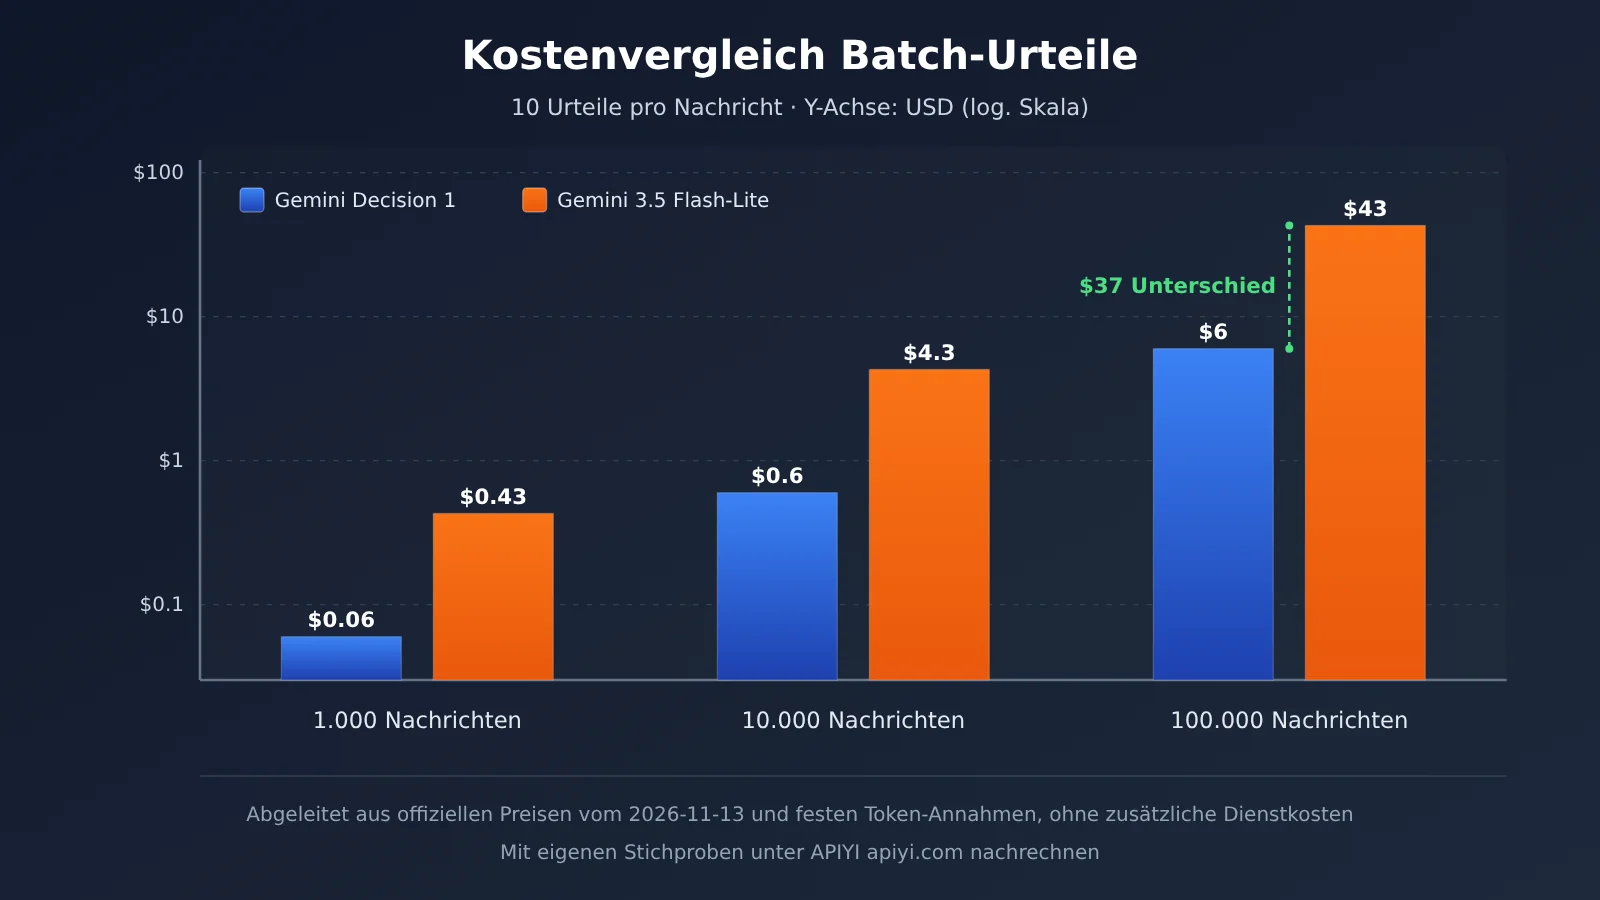
| ③ 1.000 Nachrichten mit je 10 Prüfungen | Je 300 Token, 30 Token pro Prüfung, Flash-Lite gibt 10 Token pro Prüfung aus, eine Anfrage pro Nachricht | $0.060 | $0.430 | 86,0 % |
Die drei Szenarien zeigen zwei Dinge. In Szenario ② gibt es pro Anfrage nur eine einzige Frage, trotzdem bleiben 73,1 % theoretische Ersparnis – Ursache dafür ist der auf ein Drittel gesunkene Eingabepreis und die auf null reduzierten Ausgabekosten. In den Szenarien ① und ③ fällt die Ersparnis höher aus, weil die gemeinsame Eingabe auf mehrere Fragen verteilt wird, während Flash-Lite für jede einzelne Frage eine Ausgabe erzeugen muss.
Skaliert man mit den Parametern aus Szenario ③ nach oben: Bei 100.000 Nachrichten und insgesamt 1 Million Entscheidungen kostet der Modellaufruf über die Decisions API 6 US-Dollar, bei Flash-Lite 43 US-Dollar – ein Unterschied von 37 US-Dollar. Diese Zahl enthält ausschließlich die Modellaufrufgebühren. Nicht eingerechnet sind Wiederholungsversuche, manuelle Prüfung nach Fehlentscheidungen, das Upgrade auf ein stärkeres Modell, Übertragung und Speicherung sowie der Aufwand für den Umbau der Pipeline.
Wer mit eigenen Geschäftsdaten nachrechnen möchte, kann zunächst denselben Datensatz durch ein generatives Modell laufen lassen, die tatsächlich verbrauchten Eingabe- und Ausgabe-Token notieren und diese dann in die obige Formel einsetzen. Bei APIYI apiyi.com lassen sich mit einem einzigen Key mehrere generative Modelle wie Gemini, GPT und Claude aufrufen – so lässt sich diese Kostenbasis schnell aufbauen.
2.3 Warum Googles „etwa 5-fach“ keine allgemeingültige Antwort ist
Zum Launch gab Google bekannt, dass Decision 1 in offiziellen Tests etwa 1/4,7 der Kosten von Gemini 3.5 Flash-Lite verursacht. Der unabhängige Tester RanThis lieferte am 12. November 2026 mit echten API-Aufrufen eine andere Zahlenreihe: 100 englische Nachrichten, 20 vietnamesische Nachrichten, wobei jede Anfrage nur eine binäre Entscheidung trifft.
- Genauigkeit: Von 100 englischen Entscheidungen beantwortete Decision 1 99 richtig, Flash-Lite 98.
- Kosten: Die hochgerechneten Kosten pro 1.000 englische Entscheidungen belaufen sich auf $0.0113 bzw. $0.0166 – Decision 1 liegt rund 32 % niedriger, was einem Unterschied von etwa dem 1,5-Fachen entspricht.
- Latenz: Der Median der Latenz pro Anfrage beträgt 0,18 Sekunden bzw. 0,58 Sekunden.
- Token-Aufwand: Decision 1 rechnet im Schnitt etwa 113 Eingabe-Token pro Anfrage ab, Flash-Lite etwa 47 Eingabe-Token plus 1 Ausgabe-Token.
Die Ursache für den Unterschied ist klar: Der Overhead durch die eigenen Instruktionen und das Format der Decisions-Schnittstelle verdoppelt die abgerechneten Eingabe-Token und hebt einen Teil des Vorteils beim Stückpreis wieder auf. Ist die Eingabe sehr kurz, wird jedes Mal nur eine Frage gestellt und muss das generative Modell nur ein Token ausgeben, fällt die Ersparnis am geringsten aus. Als RanThis die 10 Fragen derselben E-Mail in eine einzige Decision-1-Anfrage bündelte und mit 10 separaten Flash-Lite-Anfragen verglich, wuchs der Unterschied auf etwa das 5,4-Fache; in diesem Vergleich hat Flash-Lite keine entsprechende Bündelung vorgenommen, es handelt sich also um einen Vergleich zwischen unterschiedlichen Anfragemethoden.
Die Variablen, die die tatsächliche Ersparnis beeinflussen, sind daher: die Länge der gemeinsamen Eingabe, die Anzahl der Fragen pro Eingabe, die Ausgabelänge des generativen Modells, ob beide Seiten eine Anfragenbündelung durchgeführt haben, sowie der feste Overhead der Schnittstelle selbst. Formelherleitungen, offizielle Benchmarks und Messungen Dritter stammen aus unterschiedlichen Bedingungen und sollten bei der Auswahl getrennt betrachtet werden.
3 1,000 Entscheidungen in einem Durchgang: Wofür eignet sich die Decisions API in der Praxis?
3.1 Dokumentenprüfung: Ein Dokument, viele Regeln
Der größte Vorteil der gemeinsamen Eingabe zeigt sich bei „langem Dokument + vielen Regeln“. Bei einem Vertrag, Ausschreibungsunterlagen oder einem Produkthandbuch muss jede Position gegen eine Compliance-Checkliste geprüft werden: ob Vertragsstrafenklauseln enthalten sind, ob eine Datenübermittlung ins Ausland vorgesehen ist, ob die Zahlungsfrist 60 Tage überschreitet, ob ein Unterzeichnungsdatum fehlt usw. Je länger das Dokument und je zahlreicher die Regeln, desto stärker amortisiert sich die gemeinsame Eingabe. Die theoretische Einsparung von 94.9 % aus Szenario ① ist genau das Ergebnis dieser Struktur.
Ein weiterer Vorteil dieser Aufgabenart: Die Ergebnisse lassen sich direkt in eine Tabelle übernehmen. Jede Regel entspricht einer noul-Entscheidung, die Wahrscheinlichkeit und Konfidenz zurückgibt. Das Programm kann anhand von Schwellenwerten „Bestanden / Nicht bestanden / Zur Prüfung“ markieren. Die Prüfenden sehen dann nur noch die Einträge, die eine Nachprüfung benötigen.
3.2 Agent-Routing und Inhaltsklassifizierung
Ein Agent muss bei jedem Schritt entscheiden, welche Aktion als Nächstes folgt: ob eine Websuche nötig ist, ob Code ausgeführt werden muss oder ob an ein anderes Tool übergeben werden soll. Solche Entscheidungen haben feste Optionen, werden häufig aufgerufen und sind latenzempfindlich. Deshalb eignen sie sich dafür, mit choice in einem Durchgang erledigt zu werden. Auch die von Google offengelegten internen Anwendungsfälle konzentrieren sich hier: Gemini Notebook nutzt die Funktion, um je nach Art der Frage das Modell und die Denkstufe auszuwählen; bei normalen Abfragen sinkt die Latenz um bis zu 40 %. Google Search verwendet sie für Sicherheitsprüfungen von MCP-Tools und zur Erkennung adversarischer Inhalte. CC wählt aus über 200 möglichen Emojis schnell eine Reaktion aus. Dies sind Googles eigene Daten; die tatsächlichen Ergebnisse externer Entwickler hängen von ihrer jeweiligen Last ab.
Ein weiterer angrenzender Anwendungsfall ist der Workflow zur Inhaltserstellung. Nachdem eine KI-Nachricht gesammelt wurde, muss das System entscheiden, ob es sich um ein neues Ereignis handelt, ob sie für Entwickler relevant ist, ob sie API-Preise betrifft, ob eine offizielle Quelle vorliegt und ob sie sich für ein Tutorial eignet – und anschließend den inhaltlichen Wert bewerten. Diese sechs Bedingungen sind voneinander unabhängig und lassen sich in einer einzigen Decisions-Anfrage zusammenfassen, um die Auswahl zu filtern. Die Themen, die den Filter passieren, werden anschließend an ein generatives Modell zur Recherche, zum Schreiben und zur Überarbeitung übergeben. Dies ist ein Beispiel für ein Konzept, das auf den Fähigkeiten der Schnittstelle basiert. Im nachgelagerten Generierungsschritt können über APIYI apiyi.com bei Bedarf verschiedene Modelle gewechselt werden, um Schreibqualität und Kosten zu vergleichen.
3.3 Drei Grenzen bei 1,000 Fragen
- Die Fragen müssen voneinander unabhängig sein. Entscheidungen innerhalb derselben Anfrage können die Ergebnisse der jeweils anderen nicht lesen. Bei Abläufen mit sequenzieller Abhängigkeit wie „Zuerst prüfen, ob es sich um eine Beschwerde handelt, dann nach Beschwerdetyp einstufen“ muss das Programm die Ergebnisse zusammenführen und bei Bedarf eine weitere Anfrage starten.
- 1,000 Fragen teilen sich ein Kontextfenster von 262,144 Token. Die gemeinsame Eingabe und alle Fragen belegen zusammen dieses Fenster. Je länger die Anweisung für eine einzelne Frage, desto kürzer das Material, das hineinpasst.
- Die offiziellen Daten zur niedrigen Latenz gelten nur für kleine Anfragen. In Googles Tests blieb die Latenz etwa im Bereich von 1–100 Fragen pro Anfrage und einem Kontextfenster von bis zu 16K Token stabil. Bei 1,000 Fragen mit nahezu ausgelastetem Kontext muss die Latenz selbst gemessen werden.
4 Jenseits des Preises: Können Genauigkeit und Geschwindigkeit der Gemini Decisions API den Produktionsanforderungen genügen?
4.1 Von Google veröffentlichte Geschwindigkeits- und interne Anwendungsdaten
Google gibt als Median der Modellrechenzeit 50–100 ms an, die End-to-End-Latenz mit 150–250 ms – unter Testbedingungen von 1–100 Fragen pro Aufruf und einem Kontext von höchstens 16K Token. Diese Werte zeigen, dass sich das Modell gut in Echtzeit-Pipelines einfügen lässt, etwa für das Routing bei jedem Agent-Schritt oder die sofortige Weiterleitung von Nutzernachrichten. Die von RanThis bei Einzelfragen gemessene Medianlatenz von 0.18 Sekunden liegt ebenfalls in diesem Bereich.
4.2 Was uns Drittanbieter-Benchmarks sagen
Die ersten Ergebnisse des Decision Index v2.1 von Artificial Analysis werden aus einer Mischung aus Rohpunkten und tatsächlichen Aufgaben berechnet. Die Kosten in der folgenden Tabelle sind die gemischten Kosten dieser Benchmark-Aufgaben und damit eine andere Bezugsgröße als der „Preis pro Million Token“.
| Entscheidungsmodell | Gesamtpunktzahl | Zeit pro Aufgabe | Geschätzte Kosten pro Million Aufgaben | AA-Paperclip: Anteil mit allen 15 Treffern |
|---|---|---|---|---|
| Drex Max v1.1 | 72.62 | 283 ms | $103 | 63% |
| TypeSafe Jev 1.14 | 66.23 | 92 ms | $156 | 35.5% |
| Gemini Decision 1 | 65.98 | 211 ms | $345 | 33% |
| GPT-6 Luna (Decisions) | 60.25 | 206 ms | $339 | — |
Zwei Punkte sind bemerkenswert. Erstens: Der Token-Preis von Gemini Decision 1 ist niedrig, doch unter dieser Aufgabenverteilung liegen die geschätzten Kosten pro Million Aufgaben höher als bei Drex Max und Jev – das zeigt, dass Anfrageform und Aufgabenstruktur die tatsächliche Wirtschaftlichkeit verändern. Zweitens: Im AA-Paperclip-Dokumenttest lag der Anteil der Dokumente, bei denen Decision 1 alle 15 Urteile in einem Durchgang und sämtlich korrekt erledigte, bei 33 %. Mehrere Urteile auf einmal zu erledigen spart Kosten, die Genauigkeit jedes einzelnen Urteils muss aber weiterhin separat geprüft werden.
4.3 Mit Konfidenz verhindern, dass Fehler automatisch ausgeführt werden
Die Konfidenz ist die Wahrscheinlichkeitsschätzung des Modells für sein eigenes Ergebnis; mit ihr lässt sich entscheiden, welche Ergebnisse automatisch ausgeführt und welche an Menschen übergeben werden. Für den Produktivbetrieb empfehlen sich drei begleitende Maßnahmen:
- Konfidenzschwellen festlegen: Liegt die Konfidenz einer Rückerstattungsentscheidung beispielsweise unter 0.85, wird sie an einen Menschen übergeben; erst oberhalb des Schwellenwerts wird automatisch ein Label gesetzt oder ein Ticket zugewiesen.
- Für choice eine Option „other“ ergänzen: Passt keine der Optionen, wählt das Modell trotzdem eine davon aus; ein „Andere / nicht beurteilbar“ fängt einen Teil der Ausreißer-Eingaben ab. Alternativ lässt sich ein separater „noul“-Wert für die Bereichsprüfung hinzufügen.
- Bei risikoreichen Aktionen weiterhin Code-Beschränkungen beibehalten: Bei Aktionen wie Rückerstattungsbeträgen, Kontosperrungen oder Compliance-Blockaden sollten neben dem Modellurteil auch fest codierte Regeln und eine manuelle Prüfung greifen.
5 Wie Entwickler die Gemini Decisions API nutzen und auswählen sollten
5.1 Wie man die erste Anfrage sendet
Laut offizieller Vorgabe wird das Python-google-genai-SDK ab Version 3.2 benötigt; außerdem werden das JavaScript-SDK und REST unterstützt. Für den Zugang ist ein API-Schlüssel aus Google AI Studio erforderlich. Das folgende Beispiel orientiert sich an der offiziellen SDK-Struktur und führt für dieselbe Nachricht sowohl eine binäre Entscheidung als auch eine kategorische Klassifizierung durch. Es wurde in diesem Artikel nicht tatsächlich aufgerufen und verifiziert; die Feldnamen entnehmen Sie bitte dem offiziellen Entwicklerleitfaden.
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    # input: gemeinsame Eingabe für alle Fragen, wird nur einmal abgerechnet
    input="Google released a new AI API with official pricing and developer documentation.",
    # questions: voneinander unabhängige Entscheidungen, der Schlüsselname ist die Frage-ID
    questions={
        "has_api_pricing": {
            "type": "noul",
            "instructions": "Does this news mention API pricing?",
        },
        "category": {
            "type": "choice",
            "instructions": "Which news category fits best?",
            "criteria": {
                "model": "An AI model launch",
                "api": "An API or developer tool",
                "business": "Business or finance news",
            },
        },
    },
)

print(result.answers)  # Entscheidungsergebnis je Frage, Wahrscheinlichkeit je Option und Konfidenz
print(result.usage)    # abgerechnete Token-Nutzung, maßgeblich für die Kostenkalkulation
Die vier Schlüsselfelder haben folgende Funktion: input enthält den gemeinsamen Inhalt, questions die unabhängigen Fragen (die Schreibweise der Stufendefinition für den Typ score finden Sie im offiziellen Leitfaden), answers liefert die Entscheidungsergebnisse und Wahrscheinlichkeiten, und usage enthält die abgerechneten Token. Bei der Kostenberechnung sollten Sie unbedingt die tatsächlichen Werte aus usage verwenden; Abschnitt 2.3 hat bereits erläutert, dass die fixen Overheadkosten der Schnittstelle die Kosten pro Frage deutlich beeinflussen.
Für einen Kostenvergleich benötigen Sie zusätzlich eine Baseline mit einem generativen Modell. Im Folgenden wird über die OpenAI-kompatible Schnittstelle von APIYI das Flash-Lite-Modell für dieselbe Klassifizierung aufgerufen und dabei die Token-Nutzung erfasst:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible Schnittstelle von APIYI
)

resp = client.chat.completions.create(
    model="gemini-3.5-flash-lite",  # richtet sich nach dem tatsächlichen Namen in der Modellliste der Plattform
    messages=[{
        "role": "user",
        "content": "News: Google released a new AI API with official pricing.\n"
                   "Q1 mentions API pricing? Answer yes/no.\n"
                   "Q2 category: model/api/business. Answer one word each line."
    }],
    max_tokens=10,
)
print(resp.choices[0].message.content)
print(resp.usage)  # Eingabe- und Ausgabe-Token, einzusetzen in die Formel aus Abschnitt 2.1
Batch-Vergleichsskript ansehen: Kosten der beiden Schnittstellen für dieselbe Stichprobe getrennt erfassen
import openai

PRICE_IN, PRICE_OUT = 0.30, 2.50   # Offizieller Standardpreis von Flash-Lite, US-Dollar pro Million Token
DECISION_IN = 0.10                 # Eingabepreis von Decision 1, Ausgabe wird nicht berechnet

gen_client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def flash_lite_cost(samples, questions, model="gemini-3.5-flash-lite"):
    """Fasst alle Fragen jeder Stichprobe in einer einzigen generativen Anfrage zusammen und summiert die tatsächlich abgerechneten Kosten"""
    total = 0.0
    for text in samples:
        prompt = text + "\n" + "\n".join(
            f"Q{i+1}: {q} Answer briefly." for i, q in enumerate(questions)
        )
        r = gen_client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
            max_tokens=10 * len(questions),
        )
        total += (r.usage.prompt_tokens * PRICE_IN
                  + r.usage.completion_tokens * PRICE_OUT) / 1_000_000
    return total

def decision_cost(usage_input_tokens_list):
    """Übergibt die von der Decisions API bei jedem Aufruf zurückgegebenen usage-Eingabe-Token und berechnet die Gesamtkosten"""
    return sum(t * DECISION_IN for t in usage_input_tokens_list) / 1_000_000
🚀 Tipp für den schnellen Einstieg: Wählen Sie zunächst 200–500 echte Geschäftsstichproben aus, ermitteln Sie mit dem generativen Modell eine Baseline-Genauigkeit und den Token-Verbrauch und vergleichen Sie diese dann mit dem
usageder Decisions API. APIYI apiyi.com bietet eine OpenAI-kompatible Schnittstelle sowie ein kostenloses Testkontingent für neue Nutzer – ideal, um diesen Baseline-Test schnell abzuschließen.
5.2 Wann man die Decisions API wählt und wann man beim generativen Modell bleibt
| Aufgabentyp | Empfohlene Lösung | Grund |
|---|---|---|
| Dasselbe lange Dokument gegen mehrere Regeln prüfen | Decisions API | Gemeinsame Eingabe senkt die Kosten, die Urteile sind voneinander unabhängig |
| Agent-Tool-Routing, Modellauswahl | Decisions API | Feste Optionen, geringe Latenz |
| Inhaltsicherheit und Prüfung auf Regelverstöße | Decisions API | Mehrere unabhängige noul-Bedingungen, Aufteilung nach Konfidenz möglich |
| Klassifizierung von Support-Tickets, After-Sales-Tags im E-Commerce | Decisions API | Feste Tag-Gruppe |
| Themenauswahl, Priorisierung von Leads | Decisions API | Geeignet für Score mit vordefinierter Skala |
| Zusammenfassung, Umschreiben, Schreiben | Generatives Modell | Natürlichsprachige Ausgabe erforderlich |
| Komplexe Recherche, Argumentation, neue Standpunkte entwickeln | Generatives Modell | Offenes Reasoning erforderlich |
| Abläufe, bei denen Urteile voneinander abhängen | Programm-Orchestrierung + mehrere Anfragen, oder generatives Modell | Fragen innerhalb derselben Anfrage können nicht aufeinander verweisen |
Auch die strukturierte Ausgabe generativer Modelle (JSON Schema) kann Antworten auf ein festes Format beschränken. Sie erzeugt den Inhalt aber weiterhin Token für Token und wird nach der Ausgabelänge abgerechnet; die Wahrscheinlichkeiten müssen zusätzlich aufbereitet werden, um sie zu erhalten. Die Decisions API liefert direkt die Wahrscheinlichkeit und die Konfidenz jeder Option zurück, und die Ausgabe wird nicht abgerechnet. Der Preis dafür: Sie kann nur Fragen beantworten, deren Optionen vorab festgelegt wurden.
5.3 Welche Kosten vor dem Go-live noch kalkuliert werden müssen
Neben dem Stückpreis beeinflussen die folgenden Punkte direkt die „Gesamtkosten pro korrekter Entscheidung“:
- Tatsächlicher Token-Verbrauch: Maßgeblich ist
usage. Bei kurzen Eingaben und Einzelfragen ist der Anteil der Fixkosten am höchsten. - Anfrage-Limits: Der Free-Tier erlaubt 200 RPM, 50,000 TPM und 10,000 RPD; der kostenpflichtige Tier 1 erlaubt 1,500 RPM, 1 Mio. TPM und 50,000 RPD. Anfragen mit langem Kontext stoßen häufig zuerst an das TPM-Limit.
- Fehlende Caching- und Batch-Funktionen: Context Caching, Batch API sowie Flex-/Priority-Inferenz werden nicht unterstützt. Wenn dasselbe lange Dokument wiederholt verwendet wird, kann kein Caching-Rabatt genutzt werden.
- Funktionale Einschränkungen: In der Fragestellung dürfen keine Medieninhalte enthalten sein, und der vollständige Gesprächsverlauf, Thinking- oder Tool-Call-Blöcke können nicht direkt übergeben werden. Mehrstufige Dialoge müssen zunächst als Texteingabe aufbereitet werden.
- Fehlentscheidungen und manuelle Prüfung: Der Anteil der Fälle mit niedriger Konfidenz, die an Menschen übergeben werden, sowie die Nacharbeitskosten nach Fehlentscheidungen müssen in die Kosten pro Einheit einfließen.
- Datenverarbeitungsbedingungen: Bei Nutzung des Free-Tier können Daten möglicherweise zur Verbesserung von Google-Produkten verwendet werden; laut offizieller Preisliste gilt dies für die kostenpflichtige Stufe nicht. Vor der Verarbeitung von Kundendokumenten sollte die verwendete Stufe bestätigt werden.
- Technische Anpassungen: Generative Prompts in Fragen des Typs noul / choice / score umzuwandeln sowie Schwellenwerte und Fallback-Logik einzurichten, erfordert Entwicklungsaufwand.
Wenn Sie den Zugang über eine Drittanbieter-API-Plattform planen, müssen Sie prüfen, ob die Plattform den dedizierten Endpunkt /v1beta/decisions unterstützt. Plattformen, die nur Chat Completions unterstützen, können die Decisions API nicht direkt aufrufen. Bevor Sie APIYI apiyi.com nutzen, können Sie die Modell- und Endpunktliste im Dokumentationszentrum prüfen oder beim Anbieter nachfragen, ob dies unterstützt wird.
6 Fazit: Klassifizierungs-, Prüf- und Routing-Aufgaben lassen sich an die Gemini Decisions API delegieren
Zurück zur Frage im Titel – drei Schlussfolgerungen:
- Aufgaben mit festen Antwortoptionen sind ein guter Kandidat für die Decisions API. Aus den öffentlichen Preisen ergibt sich theoretisch eine Ersparnis von rund 73 % pro Klassifizierungsfrage; bei einer Prüfung mit tausend Regeln auf demselben langen Dokument sind es theoretisch etwa 95 %. In unabhängigen Einzeltests lag der Vorteil bei rund 32 %.
- „Ein Input, mehrere unabhängige Fragen“ ist die Struktur mit dem größten Kostensenkungspotenzial. Der gemeinsame Input wird nur einmal berechnet – je mehr Fragen, je länger der Input und je länger die Ausgabe des generativen Modells, desto größer wird der Unterschied.
- Der entscheidende Maßstab sind die Gesamtkosten pro korrekter Entscheidung im Produktivbetrieb. Token-Einzelpreis und das Limit von 1.000 Fragen sind nur der Ausgangspunkt; Genauigkeit, der Anteil manueller Nacharbeit nach dem Vertrauens-Splitting, Quoten und Engineering-Kosten bestimmen gemeinsam den tatsächlichen Nutzen.
Ein solider Weg ist: zuerst mit echten Stichproben eine Baseline des generativen Modells erstellen, dann auf der Decisions API usage und Genauigkeit vergleichen und die Entscheidungsschicht getrennt von der Generierungsschicht konzipieren. Die Modellauswahl und der Kostenvergleich für die Generierungsschicht lassen sich über APIYI apiyi.com mit einer einheitlichen Schnittstelle umsetzen.
📚 Referenzen
- Google Gemini Decisions API – Entwicklerhandbuch und Preistabelle: Fähigkeiten der Schnittstelle, Grenzen, Quoten und offizielle Preise
- Link:
ai.google.dev -
Erläuterung: Modell-IDs, Fragetypen, Kontextfenster, Ratenlimits und SDK-Nutzung
-
Offizieller Google-Blogbeitrag zur Veröffentlichung: Erscheinungsdatum, Latenzdaten und interne Anwendungsfälle
- Link:
blog.google -
Erläuterung: 50–100 ms Berechnungszeit, rund 4,7-facher Kostenvorteil, Fälle wie Gemini Notebook
-
Gemini Decisions API REST-Endpunkt
- Link:
generativlangua.googleapis.com/v1beta/decisions -
Erläuterung: offizieller Endpunkt für REST-Aufrufe
-
Artificial Analysis Decision Index v2.1: Bewertung von Entscheidungsmodellen durch Dritte
- Link:
artificialanalysis.ai -
Erläuterung: Gesamtwertung, Aufgabenlatenz, Kosten pro Million Aufgaben und die Volltrefferquote bei AA-Paperclip
-
Unabhängiger Test von RanThis (2026-11-12): klein angelegter Test auf Basis echter Aufrufe
- Erläuterung: Vergleich von Kosten, Latenz und Token-Aufwand pro Frage sowie die Ergebnisse zusammengefasster Mehrfachanfragen
Autor: APIYI Technikteam
Technischer Austausch: Kontaktieren Sie uns gern über die Startseite von APIYI apiyi.com. Weitere Integrationsmaterialien finden Sie im Dokumentationszentrum docs.apiyi.com