Anmerkung des Autors: Basierend auf den von Google DeepMind veröffentlichten 10 modellübergreifenden Benchmarks analysiert dieser Beitrag, wo Gemini 4 Hydrogen, GPT-6.1 Terra und Claude Sonnet 5.5 bei Programmierung, Agent-Automatisierung und Computerbedienung stark oder schwach sind, und gibt Empfehlungen zur Auswahl nach Aufgabe.
Zusammenfassung in einem Satz: Die von Google veröffentlichten modellübergreifenden Benchmarks zeigen, dass Gemini 4 Hydrogen und Claude Sonnet 5.5 bei unterschiedlichen Programmier- und Agent-Aufgaben jeweils Vorteile haben, während GPT-6.1 Terra durch Kosten und visuelle Bedienung punktet. Die tatsächliche Auswahl sollte Testbedingungen, Aufgabentyp und Kosten berücksichtigen.
To know: 5 Begriffe, die Sie vor dem Lesen kennen sollten
- Harness: Ein Testframework, das Modelleingaben, Tool-Ausführung und Aufgabenbewertung organisiert. Dasselbe Modell kann mit einem anderen Harness deutlich andere Ergebnisse erzielen.
- Benchmark-Version: Die Version von Daten, Aufgaben und Regeln einer Evaluierung. Terminal-Bench 4.0 und 4.1 sind beispielsweise unterschiedliche Versionen; die Ergebnisse müssen getrennt interpretiert werden.
- Agent: Ein System, in dem ein Modell zusammen mit einer Tool-Ausführungsumgebung mehrstufige Aufgaben erledigt. Das Ergebnis spiegelt die Gesamtleistung von „Modell + Tool-Kette“ wider.
- Token: Die Maßeinheit dafür, wie Modelle Text und andere Informationen verarbeiten. API-Preise werden üblicherweise pro Million Token abgerechnet.
- API: Eine Schnittstelle, über die Programme Dienste aufrufen. Entwickler binden darüber Modelle in ihre Anwendungen oder Agenten ein.
Am 12. November 2026 veröffentlichte Google offiziell Gemini 4 Hydrogen und stellte es in der offiziellen Modellkarte zusammen mit GPT-6.1 Terra und Claude Sonnet 5.5 in dieselbe Benchmark-Tabelle. Diese Tabelle umfasst Programmierung, Agent-Automatisierung, Computerbedienung und multimodale Wissensarbeit. Sie enthält die derzeit konzentriertesten öffentlichen Vergleichsdaten zu den drei Modellen.
Dies ist keine Kompromissanalyse, bei der scheinbar jedes Modell irgendwo glänzt. Wir schlüsseln Punkt für Punkt auf, was jeder Test misst und unter welchen Bedingungen er erzielt wurde, ziehen dann für die drei Bereiche Programmierung, Agenten und Computerbedienung jeweils ein Fazit und liefern schließlich eine direkt anwendbare Auswahlmatrix.
Ihr Mehrwert: Nach diesem Artikel wissen Sie genau, bei welchen Aufgaben Gemini 4 Hydrogen führt, bei welchen es hinter Sonnet 5.5 zurückliegt und an welcher Stelle im Team-Workflow Terra am besten passt.
Warum Gemini 4 Hydrogen, Terra und Sonnet 5.5 zusammen verglichen werden
Die drei Modelle wurden innerhalb von weniger als zwei Monaten veröffentlicht, und ihre Positionierung überschneidet sich stark: Keines ist das schwerste Flaggschiff-Reasoning-Modell des jeweiligen Anbieters. Vielmehr handelt es sich um die „Arbeitspferde“, die auf Entwickler, Agent-Ausführung und häufig anfallende professionelle Aufgaben ausgerichtet sind. Für Teams, die täglich viele Aufrufe absetzen, sind sie genau die Ebene, die Kosten und Effizienz tatsächlich bestimmt.
Gemini 4 Hydrogen ist das neue hocheffiziente Modell von Google DeepMind. Offiziell ist es für alltägliches Programmieren und die Ausführung durch KI-Agenten positioniert; es kann eigenständig laufen und in Multi-Modell-Systemen die Rolle des Ausführenden oder Prüfers übernehmen. GPT-6.1 Terra wurde am 26. Oktober 2026 von OpenAI veröffentlicht und legt den Schwerpunkt auf visuelles Reasoning, Computerbedienung und hocheffiziente alltägliche Arbeit. Claude Sonnet 5.5 wurde am 28. September 2026 von Anthropic veröffentlicht; offiziell hebt Anthropic alltägliches Programmieren, Bugfixing, die Erstellung professioneller Dokumente und komplexes UI-Design hervor.
| Modell | Anbieter | Veröffentlichungsdatum | Offizielle Positionierung | Standard-API-Preis (pro Million Token, Eingabe/Ausgabe) | Preisquelle |
|---|---|---|---|---|---|
| Gemini 4 Hydrogen | Google DeepMind | 2026-11-12 | Alltägliches Programmieren, Aufrufe mehrerer Tools, Agent-Ausführung | $1.50 / $7.50 | Preisseite von Google AI Studio, geprüft am 2026-11-13 |
| GPT-6.1 Terra | OpenAI | 2026-10-26 | Visuelles Reasoning, Computerbedienung, alltägliche Arbeit | $1 / $5 | OpenAI-Veröffentlichungsunterlagen, 2026-10-26 |
| Claude Sonnet 5.5 | Anthropic | 2026-09-28 | Alltägliches Programmieren, Bugfixing, professionelle Dokumente, UI-Design | In den Referenzunterlagen nicht enthalten; offizielle Preisseite maßgeblich | Anthropic (offiziell) |
Zu beachten ist, dass bei Hydrogen die Reasoning-Token in den Ausgabepreis einfließen; die tatsächlichen Kosten lassen sich daher nicht allein anhand des letztlich sichtbaren Textes schätzen. Außerdem liegen die Preise für den Batch- und Flex-Modus von Hydrogen bei $0.75 / $3.75, was sich für Offline-Batch-Aufgaben eignet.
Der quantitative Vergleich in diesem Artikel stützt sich vor allem auf die Modellkarte von Google DeepMind in der Version vom November 2026 sowie die zugehörigen Dokumente zur Evaluierungsmethodik. Das bedeutet: Die Daten wurden von Google zusammengestellt; einige Ergebnisse von Wettbewerbern stammen aus öffentlichen Anbieterberichten oder Ranglisten. In Abschnitt 5 gehen wir gesondert darauf ein, wie sich dies auf die Schlussfolgerungen auswirkt.
Gemini 4 Hydrogen Programmierfähigkeiten im Vergleich: Wer löst reale Probleme besser?
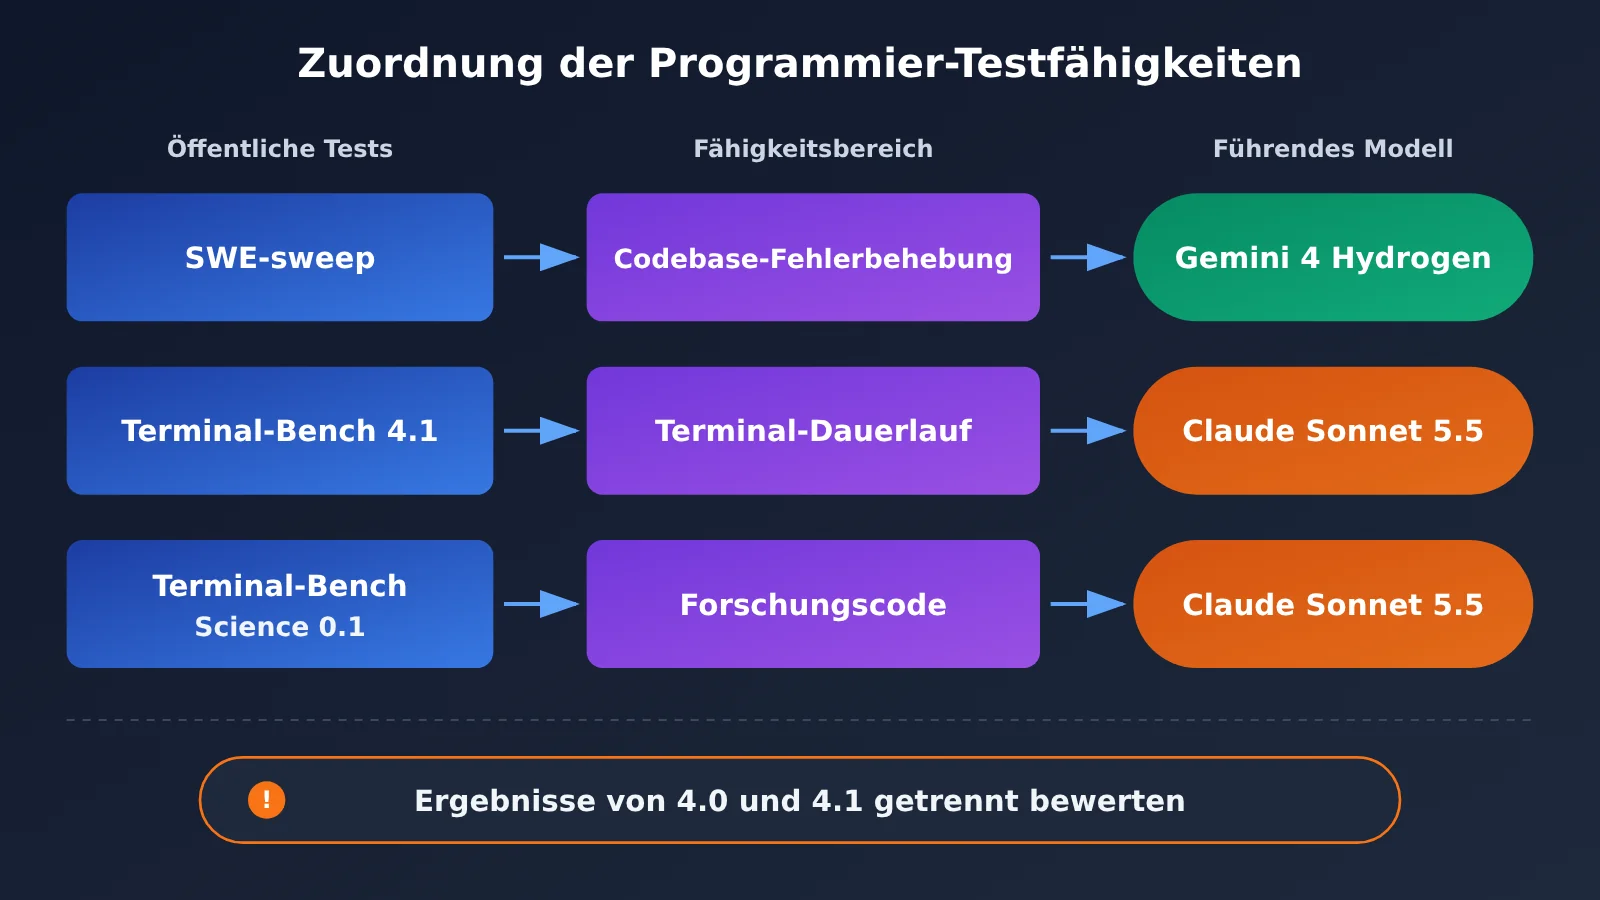
Programmier-Benchmarks lassen sich in zwei Arten von Fähigkeiten unterteilen: zum einen das Finden und Beheben von Problemen in einer echten Codebasis, zum anderen das kontinuierliche Ausführen von Befehlen in einer Terminalumgebung zur Erledigung von Engineering-Aufgaben. SWE-sweep tendiert zum ersten Bereich, die Terminal-Bench-Reihe zum zweiten, während Terminal-Bench-Science die Fähigkeit prüft, wissenschaftliche Aufgaben mit Code zu lösen.
| Benchmark (Version) | Metrik | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra | Spitzenreiter |
|---|---|---|---|---|---|
| SWE-sweep | Gewichtete Belohnung pro Teilaufgabe | 13,5 % | 3,1 % | 5,8 % | Hydrogen |
| Terminal-Bench 4.1 | Durchschnittliche Belohnung | 57,0 % | 63,9 % | — | Sonnet |
| Terminal-Bench-Science 0.1 | Aufgabenpunktzahl | 51,4 % | 59,9 % | 58,3 % | Sonnet |
Quelle: Google DeepMind „Gemini 4 Hydrogen Model Evaluation“ und Modellkarte, November 2026.
Interpretation der Programmier-Testergebnisse
Die absoluten Werte bei SWE-sweep sind insgesamt niedrig, was zeigt, dass es sich um einen sehr anspruchsvollen Benchmark handelt. Hydrogens 13,5 % sind etwa mehr als das Doppelte von Terra und mehr als das Vierfache von Sonnet – in diesem Punkt ist der Abstand am deutlichsten. Allerdings wurde Hydrogen hier mit Googles eigenem Antigravity-CLI 1.4.8 ausgeführt, während die Ausführungsbedingungen der Wettbewerber nicht unbedingt identisch waren. Ein Teil des Abstands könnte daher auf die Harness-Anpassung zurückzuführen sein.
Bei Terminal-Bench 4.1 führt Sonnet 5.5 mit 63,9 % vor Hydrogens 57,0 %; Terra hat in Googles Tabelle keine Wertung für diesen Benchmark. Hydrogen wurde hier mit dem mini-swe-agent vision Harness und dem „High“-Denkmodus ausgeführt, wobei jeder Task fünfmal lief und der durchschnittliche Reward gemittelt wurde. Bei Terminal-Bench-Science 0.1 liegt Sonnet weiterhin vorn, Terra folgt mit 58,3 % dicht dahinter, während Hydrogen auf dem dritten Platz landet.
Fazit im Programmierbereich: Hydrogen hat deutliche Vorteile bei Codebasis-Reparaturtests wie SWE-sweep; Sonnet 5.5 ist bei Terminal-Ausführungsaufgaben stabiler; Terra zeigt bei wissenschaftlichen Code-Aufgaben eine ähnliche Leistung wie Sonnet. Kein einziges Modell führt bei Programmier-Benchmarks durchgängig.
Von den Anbietern selbst gemeldete Hintergrunddaten zu Terminal-Bench 4.0
OpenAI und Anthropic haben jeweils eigene Ergebnisse für Terminal-Bench 4.0 veröffentlicht. Da 4.0 und 4.1 unterschiedliche Benchmark-Versionen sind, werden sie in der folgenden Tabelle separat aufgeführt; sie dürfen nicht mit den 4.1-Ergebnissen in der obigen Tabelle vermischt oder direkt verglichen werden.
| Benchmark (Version) | Modell | Ergebnis | Testbedingungen | Quelle |
|---|---|---|---|---|
| Terminal-Bench 4.0 | Claude Sonnet 5.5 | 70,6 % | vom Anbieter selbst getestet | Anthropic-Veröffentlichung, 2026-09-28 |
| Terminal-Bench 4.0 | GPT-6.1 Terra | 50,3 % | höchste Inferenzeinstellung | OpenAI-Veröffentlichung, 2026-10-26 |
Der Nutzen dieser Daten liegt in einem Referenzpunkt: Unter den jeweiligen Testbedingungen der Anbieter sind die Fähigkeiten von Sonnet 5.5 bei Terminal-Aufgaben deutlich besser als die von Terra – konsistent mit der Tendenz in der Google-Tabelle, wonach Sonnet bei terminalbezogenen Tests vorne liegt.
Kann Gemini 4 Hydrogen in Agenten- und Automatisierungstests vollständige Aufgaben erledigen?
Der größte Unterschied zwischen Agententests und Single-Turn-Fragen besteht darin, dass das Modell seine Schritte selbst planen, kontinuierlich Tools aufrufen, nach Fehlern die Strategie anpassen und das Ergebnis abschließend validieren muss. Solche Tests ähneln realen Automatisierungsworkflows und stellen auch die „Ausführungsdisziplin“ des Modells stärker auf die Probe.
Die folgende Tabelle fasst alle modellübergreifenden Ergebnisse aus den Google-Evaluierungen zu Agentenautomatisierung, Computerbedienung und multimodaler Wissensarbeit zusammen. Die Abschnitte drei und vier verwenden diese Tabelle gemeinsam.
| Evaluation (Version) | Fähigkeitsbereich | Metrik | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|---|---|
| Agents‘ Last Exam v1.1 | Professionelle mehrstufige Agenten | Aufgaben-Score | 71.6% | 60.4% | 69.8% |
| AutomationBench-AA | Workflow-Automatisierung | Aufgaben-Score | 76.1% | 71.8% | 60.2% |
| Vending-Bench 2 | Langfristige simulierte Geschäftsführung | Endgültiger Kontostand | $14,549 | $11,165 | $9,107 |
| OSWorld-2.1 | Computer-/GUI-Bedienung | Aufgaben-Erfolgsrate | 77.6% | 83.9% | 74.2% |
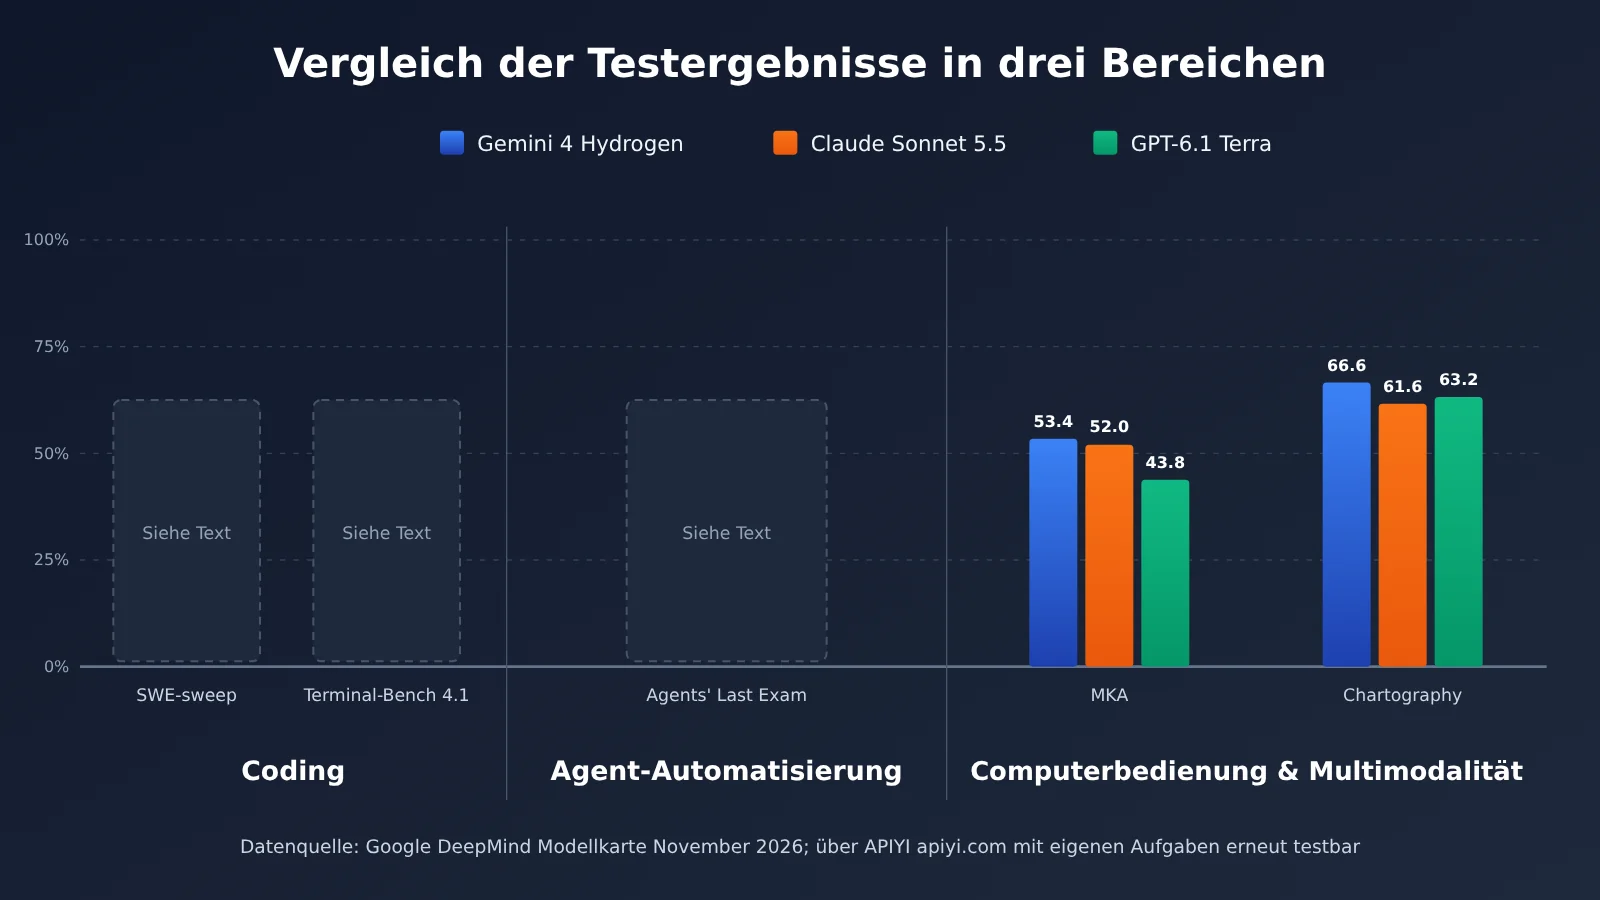
| MKA | Multimodale Wissensarbeit | Aufgaben-Score | 53.4% | 52.0% | 43.8% |
| Chartography | Diagrammverständnis (ohne Tools) | Genauigkeit | 66.6% | 61.6% | 63.2% |
| HLE-Diamond | Hochanspruchsvolle Wissensschlussfolgerung | Genauigkeit | 58.8% | 53.3% | 47.3% |
Quelle: Google DeepMind Modellkarte und „Gemini 4 Hydrogen Model Evaluation“, November 2026.
Agenten- und Automatisierungsergebnisse interpretieren
Agents‘ Last Exam v1.1 umfasst 122 Aufgaben und ein Zeitfenster von 5 Stunden; Hydrogen wird ebenfalls mit Antigravity-CLI 1.4.8 ausgeführt. Hydrogen führt mit 71.6%, doch bemerkenswert ist, dass Terra mit 69.8% dicht folgt und damit fast 10 Prozentpunkte vor Sonnet liegt. Das zeigt: Bei professionellen mehrstufigen Aufgaben ist Terra nicht schwach.
AutomationBench-AA zeigt ein anderes Bild: Hydrogen 76.1%, Sonnet 71.8%, Terra 60.2% deutlich zurück. Wenn Ihr Geschäft aus umfangreicher systemübergreifender Prozessautomatisierung besteht, ist dieser Unterschied wichtig.
Vending-Bench 2 ist eine langfristige simulierte Geschäftsaufgabe; die Metrik ist der endgültige Kontostand, nicht die Genauigkeit. Hydrogens $14,549 liegt deutlich vorn und kann als ergänzende Beobachtung für die „Stabilität langfristiger Entscheidungen“ dienen, aber es ist eine einzelne Simulationsumgebung und sollte nicht direkt auf alle langen Aufgaben verallgemeinert werden.
Fazit im Agentenbereich: In den von Google aufgeführten Agenten- und Automatisierungstests liegt Hydrogen durchweg vorn; Terra ist bei professionellen mehrstufigen Aufgaben nahe an Hydrogen, hängt aber bei der Prozessautomatisierung zurück; Sonnet liegt in der Mitte.
🚀 Schnellstart: Agenten-Ergebnisse hängen stark vom Harness und den Tooldefinitionen ab; öffentliche Scores sind nur ein Ausgangspunkt. Wir empfehlen, über APIYI apiyi.com mit derselben Toolchain und denselben realen Aufgaben alle drei Modelle separat laufen zu lassen – mit nur einem API-Schlüssel können Sie wechseln und so Vergleichsdaten für Ihr eigenes Szenario erhalten.
Gemini 4 Hydrogen vs. Sonnet 5.5: Wer ist bei Computerbedienung und multimodaler Wissensarbeit stärker?
Tests zur Computerbedienung verlangen von Modellen, dass sie „den Bildschirm ansehen, mit der Maus klicken und Tastaturanschläge ausführen“. Das entspricht direkt Szenarien wie Browserbedienung oder der Automatisierung von Office-Software. Multimodale Wissensarbeit prüft dagegen das Lesen komplexer Dokumente und das Verstehen von Diagrammen – etwa für Finanzberichtsanalysen oder das Aufbereiten von Research-Berichten.
OSWorld-2.1: Sonnet 5.5 liegt bei der GUI-Bedienung vorn
In der Google-Evaluierung verwendet OSWorld 2.1 82 Offline-Aufgaben bei 1080p-Auflösung und maximal 500 Schritten. Das Modell beobachtet per Screenshot und führt Aktionen über PyAutoGUI aus. Sonnet 5.5 liegt mit 83.9 % vorn, Hydrogen erreicht 77.6 %, Terra 74.2 %.
Hier gibt es eine wichtige Frage der Messmethodik: Die von Anthropic selbst veröffentlichten Ergebnisse für den OSWorld-2.1-Teil von Sonnet 5.5 liegen bei 80.1 %, während die Vergleichstabelle von Google 83.9 % angibt. Der letztgenannte Wert wurde von Google unter festgelegten Bedingungen getestet und ist das höchste Ergebnis aus mehreren Durchläufen. Ein Test mit demselben Namen kann bei unterschiedlichen Anbietern also zu unterschiedlichen Werten führen. Beim Vergleich muss man daher eine Quelle fest vorgeben.
MKA und Chartography: Hydrogen liegt knapp vorn
Im MKA-Test zur multimodalen Wissensarbeit liegen Hydrogen mit 53.4 % und Sonnet mit 52.0 % sehr nah beieinander; Terra liegt mit 43.8 % etwa 10 Prozentpunkte zurück. Chartography testet das Diagrammverständnis ohne Werkzeugeinsatz. Hier führt Hydrogen mit 66.6 %. Interessant ist, dass Terra mit 63.2 % den zweiten Platz belegt und damit vor Sonnet mit 61.6 % liegt – das passt zu OpenAIs Positionierung von Terra als Modell für „visuelles Reasoning“.
Fazit zu Computerbedienung und Multimodalität: Bei der Bedienung grafischer Oberflächen sollte man Sonnet 5.5 den Vorzug geben. Beim Lesen komplexer Dokumente und bei multimodaler Wissensintegration liegen Hydrogen und Sonnet nah beieinander, wobei Hydrogen leicht vorn liegt. Beim reinen Diagrammverständnis führt Hydrogen, und Terra ist ebenfalls wettbewerbsfähig.
Wie man die öffentlich zugänglichen Benchmark-Daten von Gemini 4 Hydrogen richtig liest
Der häufigste Fehler beim Lesen öffentlicher Benchmarks besteht darin, eine Tabelle als Ergebnisliste eines „gemeinsamen Prüfungsraums mit identischen Regeln“ zu verstehen. Tatsächlich nennt Googles Dokument zur Evaluierungsmethodik mehrere entscheidende Voraussetzungen:
- Reasoning-Stufe: Hydrogen wird üblicherweise mit der höchsten Reasoning-Einstellung getestet, doch für manche Benchmarks gelten andere Vorgaben; Terminal-Bench 4.1 etwa verwendet die Stufe High.
- Ausführungs-Harness: SWE-sweep und Agents‘ Last Exam verwenden Antigravity-CLI 1.4.8, Terminal-Bench 4.1 verwendet den mini-swe-agent vision Harness, und OSWorld 2.1 nutzt Screenshots plus PyAutoGUI.
- Anzahl der Testläufe: Bei Terminal-Bench 4.1 wird jede Aufgabe fünfmal ausgeführt und der durchschnittliche Reward verwendet, während für die OSWorld-Werte der Wettbewerber der Bestwert aus mehreren Läufen herangezogen wurde. Schon diese beiden Statistikmethoden unterscheiden sich grundlegend.
- Quelle der Ergebnisse: Die Ergebnisse der Wettbewerber stammen überwiegend aus öffentlichen Berichten und Ranglisten der jeweiligen Anbieter; nicht alle Modelle wurden vom selben Team einheitlich ausgeführt.
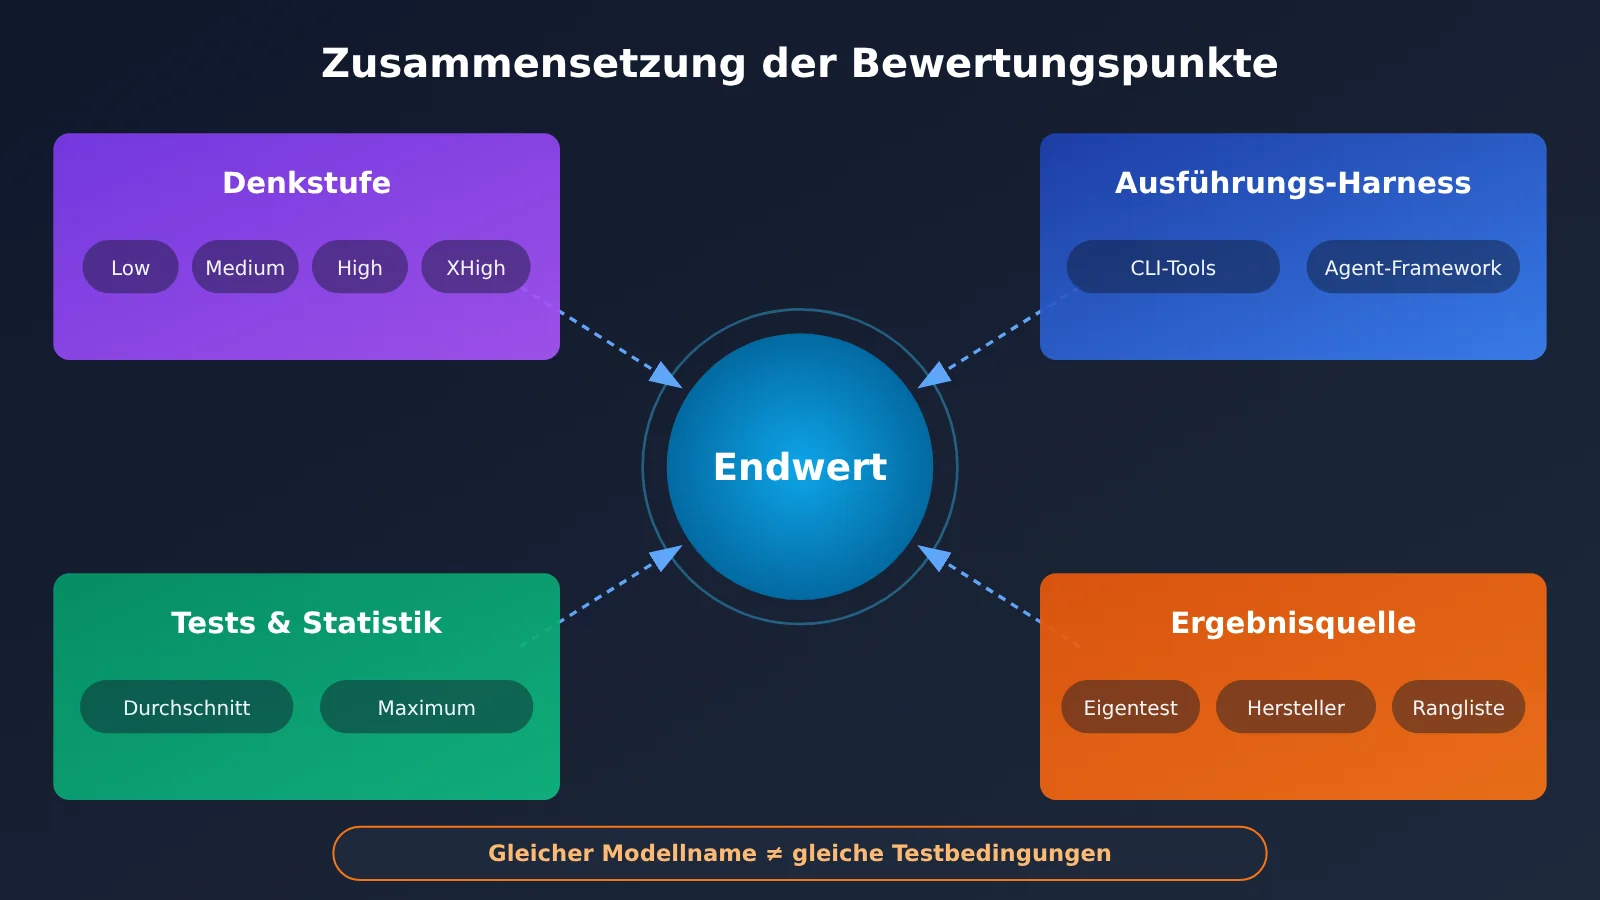
Die Reasoning-Stufe hat besonders großen Einfluss. Artificial Analysis hat am 12. November eine unabhängige Bewertung der vier Stufen von Hydrogen veröffentlicht: Der Intelligenzindex beträgt 27 für Low, 41 für Medium, 51 für High (Standard) und 54 für XHigh; die durchschnittlichen Kosten für die jeweiligen standardisierten Benchmark-Aufgaben liegen zwischen $0.29 und $3.16. Das sind Ergebnisse für ihre Benchmark-Aufgaben, nicht die tatsächlichen Kosten pro Aufruf für normale Nutzer, aber sie zeigen deutlich, dass dasselbe Modell je nach Stufe stark variiert: XHigh liegt nur 3 Punkte über High, verursacht aber spürbar höhere Kosten.
Behalten Sie beim Lesen der Ergebnisse in diesem Artikel daher zwei Punkte im Hinterkopf: Erstens beziehen sich die Schlussfolgerungen ausschließlich auf die aufgeführten öffentlichen Tests; zweitens sollte man nicht die jeweils vorteilhaftesten Daten aus Googles Tabelle, den Eigenangaben von OpenAI und den Eigenangaben von Anthropic zu einer „Gesamtrangliste“ zusammenkleben.
Schnellstart mit Gemini 4 Hydrogen: Drei Modelle mit demselben Code vergleichen
Die zuverlässigste Art der Auswahl besteht darin, die drei Modelle einmal mit Ihren eigenen Aufgaben laufen zu lassen. Das folgende Beispiel verwendet die OpenAI-kompatible Schnittstelle; Sie müssen nur den Parameter model ändern, um das Modell zu wechseln.
Minimalbeispiel
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI-kompatible Schnittstelle
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "找出这段 Python 代码中的 Bug 并给出最小修改"}]
)
print(response.choices[0].message.content)
Vollständigen Implementierungscode ansehen: Vergleichsskript für drei Modelle mit derselben Aufgabe
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Modell-IDs richten sich nach der Modellliste der Plattform; gemini-4-hydrogen ist die offizielle Google-ID
MODELS = [
    "gemini-4-hydrogen",
    "gpt-6.1-terra",       # Beispiel-ID, bitte im Dashboard bestätigen
    "claude-sonnet-5.5",   # Beispiel-ID, bitte im Dashboard bestätigen
]

def compare(prompt: str, system: str = "你是资深工程师,只修改必要代码"):
    results = []
    for model in MODELS:
        start = time.time()
        try:
            resp = client.chat.completions.create(
                model=model,
                messages=[
                    {"role": "system", "content": system},
                    {"role": "user", "content": prompt},
                ],
            )
            usage = resp.usage
            results.append({
                "model": model,
                "seconds": round(time.time() - start, 1),
                "prompt_tokens": usage.prompt_tokens if usage else None,
                "completion_tokens": usage.completion_tokens if usage else None,
                "answer": resp.choices[0].message.content[:300],
            })
        except Exception as e:
            results.append({"model": model, "error": str(e)})
    return results

if __name__ == "__main__":
    for r in compare("修复:函数在空列表输入时抛出 IndexError ..."):
        print(r)
Bei der Migration zu Hydrogen gibt es einige Punkte zu beachten: Benutzerdefinierte Werte für temperature, top_p und top_k werden ignoriert; thinking_budget und MINIMAL werden nicht unterstützt; die standardmäßige Denkstufe ist High; bei Tool-Aufrufen über mehrere Runden müssen Thought Signatures korrekt zurückgegeben werden. Wenn Ihr Agent bisher auf eine niedrige Temperatur zur Steuerung der Ausgabe angewiesen war, müssen Sie stattdessen auf strukturierte Ausgaben oder klarere Anweisungen umsteigen.
Empfehlung: Verwenden Sie zunächst 10–20 echte Tickets oder Aufgaben als Evaluationsset und rufen Sie die drei Modelle jeweils über APIYI (apiyi.com) auf. Erfassen Sie dabei Erfolgsquote, Laufzeit und Anzahl der Ausgabe-Tokens. Neue Nutzer erhalten ein kostenloses Testkontingent, sodass Sie vor der endgültigen Beschaffung eine kleine Validierung durchführen können.
Szenario-Empfehlungen und Auswahlmatrix für Gemini 4 Hydrogen, Terra und Sonnet 5.5
Wann Sie Gemini 4 Hydrogen wählen sollten
- Fehlerbehebung in Codebasen und Abhängigkeits-Upgrades: Der größte Vorsprung bei SWE-sweep, und der Anbieter hat gezielt das präzise Editieren verbessert.
- Mehrstufige Agenten und Prozessautomatisierung: Führt bei Agents‘ Last Exam, AutomationBench-AA und Vending-Bench 2.
- Komplexe Dokument- und Diagrammanalyse: Führt bei MKA und Chartography und unterstützt mehrere Eingabeformate wie PDF und Office-Dokumente.
Wann Sie Claude Sonnet 5.5 wählen sollten
- Terminalintensive Engineering-Aufgaben: Führt bei Terminal-Bench 4.1 und Terminal-Bench-Science 0.1.
- Desktop- und GUI-Bedienung: OSWorld-2.1 erreicht den höchsten Wert in Google Sheets.
- Professionelles Dokument- und Interface-Design: Ein Schwerpunkt, den Anthropic offiziell besonders betont.
Wann Sie GPT-6.1 Terra wählen sollten
- Kostenempfindliche Aufgaben mit großem Volumen: Standardpreis $1 / $5 – der niedrigste unter den bekannten Preisen der drei.
- Visuelles Reasoning und alltägliche Automatisierung: Chartography auf Platz zwei, Agents‘ Last Exam dicht an Hydrogen.
| Aufgabentyp | Erste Wahl | Alternative | Kostenempfindlichkeit | Empfohlene Ausführung | Zugangskanal |
|---|---|---|---|---|---|
| Codebase-Wartung, Bug-Fixes | Hydrogen | Sonnet 5.5 | Mittel | Hydrogen ändert den Code, Sonnet übernimmt die Terminal-Validierung | APIYI apiyi.com einheitliche Schnittstelle |
| Terminal-Betrieb, Forschungscode | Sonnet 5.5 | Terra | Mittel | Einzelmodell in langer Sitzung | Wie oben |
| Mehrstufige Agent-Workflows | Hydrogen | Terra | Mittel | Start im High-Modus, bei Fehlschlag auf XHigh hochstufen | Wie oben |
| Desktop-/Browser-GUI-Bedienung | Sonnet 5.5 | Hydrogen | Niedrig | Screenshot-Beobachtung + Bedienwerkzeuge | Wie oben |
| Diagramm- und Dokumentanalyse | Hydrogen | Terra | Mittel | Ohne Tools oder mit Retrieval-Augmentierung | Wie oben |
| Alltagsautomatisierung in großem Volumen | Terra | Hydrogen (Batch) | Hoch | Asynchrone Stapelverarbeitung | Wie oben |
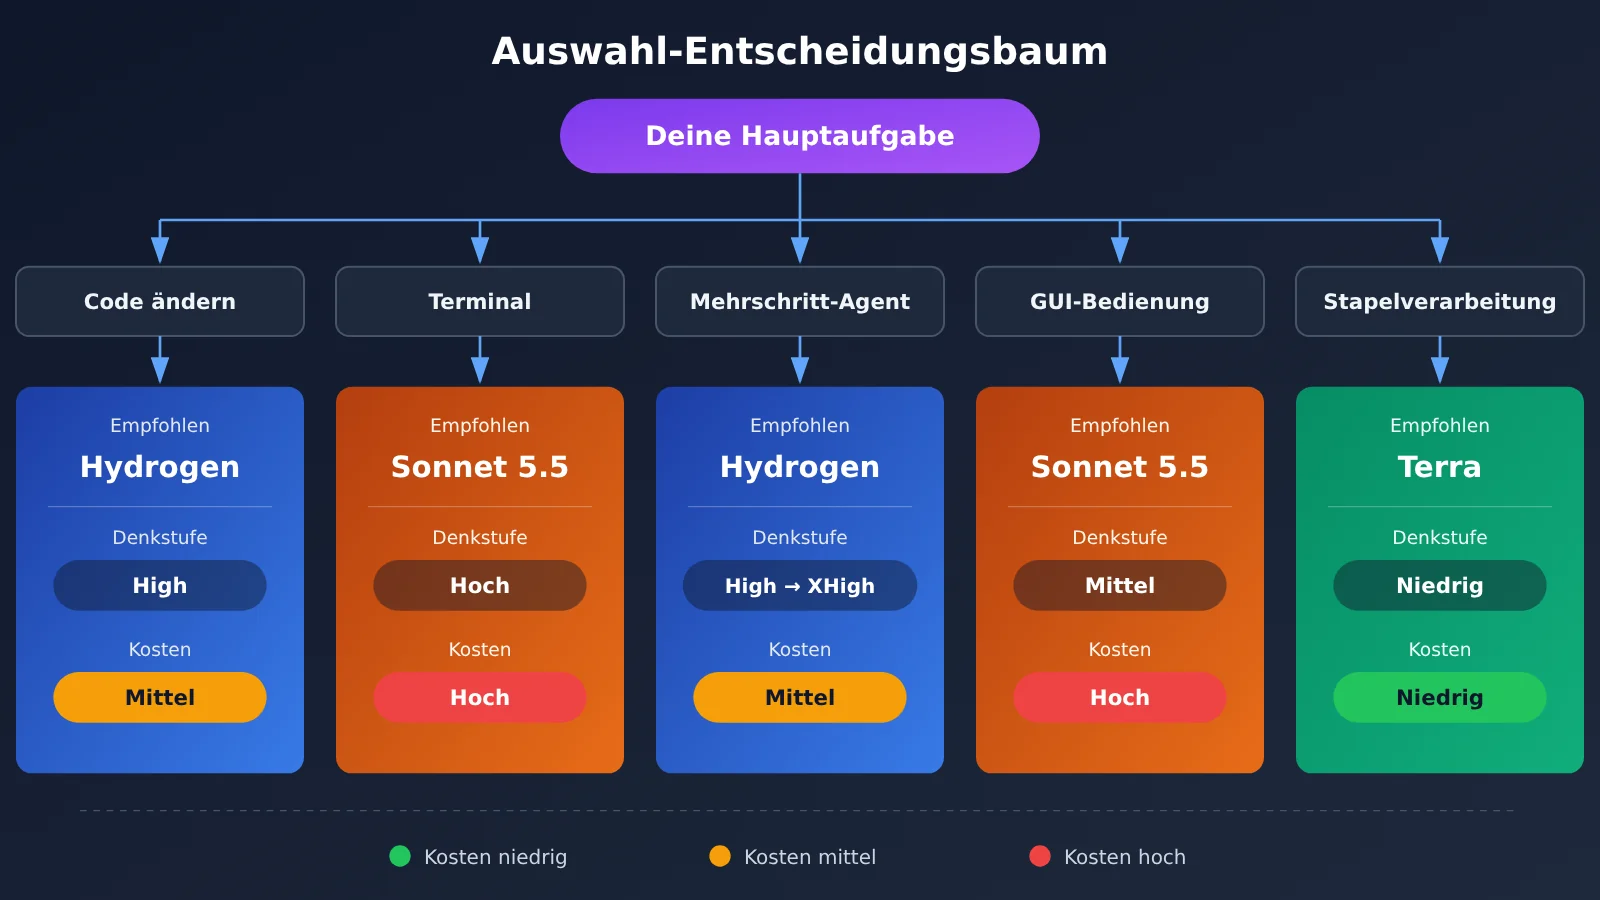
💡 Empfehlung zur Auswahl: Wenn ein Team sowohl Programmierung als auch GUI-Automatisierung benötigt, muss es nicht auf ein einziges Modell setzen, sondern kann sich an der Idee des Google Antigravity Orchestrator orientieren und die Arbeit phasenweise aufteilen. Über APIYI apiyi.com lassen sich mit demselben Key mehrere Modelle aufrufen – für den Wechsel der Route muss nur ein Parameter geändert werden.
Häufige Fragen (FAQ)
F1: Was ist Gemini 4 Hydrogen?
Gemini 4 Hydrogen ist ein hocheffizientes Modell, das Google DeepMind am 12. November 2026 veröffentlicht hat. Die API-Modell-ID lautet `gemini-4-hydrogen` und ist für den alltäglichen Programmierbetrieb sowie die Agent-Ausführung ausgelegt. Es unterstützt ein einheitliches Kontextfenster von 1.048.576 Token und bietet vier Denkstufen: Low, Medium, High und XHigh, standardmäßig High.
F2: Wer ist beim Programmieren stärker – Gemini 4 Hydrogen oder Claude Sonnet 5.5?
Das hängt von der Art der Aufgabe ab. Hydrogen liegt beim SWE-sweep-Test zur Reparatur von Codebasen deutlich vorn; Sonnet 5.5 führt bei terminalbasierten Ausführungstests wie Terminal-Bench 4.1 und Terminal-Bench-Science 0.1. Für alltägliche Codeänderungen ist Hydrogen die bessere Wahl, bei terminalintensiver Entwicklungsarbeit eher Sonnet.
F3: GPT-6.1 Terra hat in keiner Kategorie den ersten Platz belegt – lohnt es sich trotzdem?
Es ist eine Überlegung wert. In den von Google veröffentlichten Dreier-Vergleichstabellen erzielt Terra tatsächlich keinen Spitzenwert in einer einzelnen Kategorie, liegt aber beim Agents‘ Last Exam nahe an Hydrogen, belegt in Chartography den zweiten Platz und hat den niedrigsten Standard-API-Preis. Für kostensensible Szenarien mit Schwerpunkt auf visuellen Operationen und routinemäßiger Automatisierung ist es ein wichtiger Kandidat.
F4: Warum gibt es für die OSWorld-Werte von Sonnet 5.5 zwei Versionen – 80,1 % und 83,9 %?
Die 80,1 % sind ein von Anthropic selbst veröffentlichter Teilwert aus eigenen Tests; die 83,9 % stammen aus Tests von Google unter festgelegten Bedingungen, wobei das beste Ergebnis mehrerer Durchläufe verwendet wurde. Da die Testbedingungen unterschiedlich sind, sollte man beim Vergleich eine Quelle konsequent verwenden und nicht mischen.
F5: Wie lassen sich die drei Modelle schnell per API vergleichen?
Empfohlen wird eine API-Aggregationsplattform, die mehrere Modelle unterstützt:
1. Besuchen Sie APIYI apiyi.com, registrieren Sie ein Konto und holen Sie sich einen API-Schlüssel;
2. Prüfen Sie in der Modellliste der Konsole die verfügbaren IDs der drei Modelle;
3. Setzen Sie `base_url` im Code dieses Artikels auf `https://api.apiyi.com/v1` und rufen Sie die Modelle mit derselben Aufgabenreihe getrennt auf.
APIYI bietet eine OpenAI-kompatible Schnittstelle mit nutzungsbasierter Abrechnung, sodass sich ein horizontaler Vergleich bequem in einem einzigen Skript erledigen lässt.
F6: Welche bekannten Einschränkungen hat Gemini 4 Hydrogen?
Die offizielle Modellkarte nennt einige Punkte: Es kann weiterhin Halluzinationen erzeugen; höhere Denkstufen erhöhen Zeitaufwand und Kosten deutlich; der Wissensstand endet im März 2026; die Kennzahl für unbegründete Ablehnungen ist im Vergleich zu 3.8 Flash um 5,57 Prozentpunkte schlechter geworden; der vollständige Sicherheitsbericht war zum Zeitpunkt der Prüfung noch nicht veröffentlicht. Zudem berichten Entwickler von übermäßiger Ausführung bei manchen Agent-Aufgaben. Darüber hinaus liegt der Standardpreis pro Token beim Doppelten des aktuellen Preises von 3.8 Flash; für Batch-Aufgaben kann der Batch-Modus eine Überlegung wert sein.
Gemini 4 Hydrogen im Vergleich – die wichtigsten Erkenntnisse
- Kein Alleskönner beim Programmieren: Hydrogen glänzt bei der Reparatur von Codebasen, Sonnet 5.5 bei Terminal-Aufgaben.
- Agent-Automatisierung: Hydrogen vorn: In allen von Google aufgeführten Agent- und Automatisierungstests liegt Hydrogen an der Spitze.
- GUI-Bedienung: Sonnet 5.5: Auf OSWorld-2.1 führt Sonnet mit 83.9 %, wobei die unterschiedliche Messmethodik zu beachten ist.
- Terra punktet bei Kosten und visuellen Aufgaben: niedrigster Listenpreis, und bei Diagrammverständnis sowie professionellen Agent-Aufgaben keineswegs schwach.
- Versionen und Quellen nicht vermischen: Terminal-Bench 4.0 und 4.1 sowie Herstellerangaben und Google-Eigentests müssen getrennt betrachtet werden.
- Die Denkstufe macht enorm viel aus: Hydrogen High und XHigh unterscheiden sich im Intelligenzindex nur um 3 Punkte, kosten aber deutlich mehr.
- Eigene Aufgaben entscheiden: Über APIYI apiyi.com können Sie mit einem einzigen API-Schlüssel alle drei Modelle im Quervergleich testen.
Zusammenfassung
Die zentralen Erkenntnisse aus dem Vergleich von Gemini 4 Hydrogen, GPT-6.1 Terra und Claude Sonnet 5.5:
- Programmierung: Hydrogen führt bei SWE-sweep, Sonnet 5.5 liegt bei zwei Terminal-Tests vorn, Terra kommt bei wissenschaftlichen Code-Aufgaben nahe an Sonnet heran.
- Agent-Bereich: Hydrogen führt bei mehrstufigen Agent-Aufgaben, Prozessautomatisierung und langfristigen Simulations-Szenarien durchgehend, Terra folgt bei Fachaufgaben dicht dahinter.
- Computerbedienung und Multimodalität: Sonnet 5.5 dominiert die Bedienung grafischer Oberflächen, Hydrogen liegt bei multimodaler Wissensarbeit und Diagrammverständnis leicht vorn.
Öffentliche Benchmarks zeigen Ihnen, „wer unter bestimmten Bedingungen stärker ist“ – nicht, „wer in Ihrem Geschäftsumfeld besser passt“. Sinnvoll ist es, anhand der oben genannten Auswahlmatrix ein bis zwei Kandidaten einzugrenzen und dann mit eigenen realen Aufgaben, einer festen Denkstufe und der eigenen Toolchain einen kleinen Nachtest durchzuführen.
Empfohlen: Verifizieren Sie die Ergebnisse schnell über APIYI apiyi.com – die Plattform bietet kostenloses Testkontingent und eine einheitliche Schnittstelle für mehrere Modelle. Ideal für Teams, die vor dem Produktivstart eine horizontale Bewertung abschließen wollen.
📚 Referenzen
- Google Offizieller Blog – Introducing Gemini 4 Hydrogen: Ankündigung und Partner-Fallbeispiele
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
Beschreibung: Offizielle Positionierung, Fähigkeitsumfang und frühe Testdaten
-
Google DeepMind Modellkarte: Vergleichstabelle der modelübergreifenden Evaluierung
- Link:
deepmind.google/models/model-cards/gemini-4-hydrogen/ -
Beschreibung: Hauptquelle der quantitativen Daten in diesem Artikel
-
Google DeepMind Modell-Evaluierungs-PDF: Detaillierte Beschreibung der Testausführungsbedingungen
- Link:
storage.googleapis.com/deepmind-media/gemini/gemini_4_hydrogen_model_evaluation.pdf -
Beschreibung: Harness, Denkstufen, Anzahl der Läufe sowie ergänzende Ergebnisse wie Vending-Bench 2
-
Google Cloud Technische Dokumentation: Hydrogen-Spezifikationen und Migrationshinweise
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-hydrogen -
Beschreibung: Kontextlimits, Parameterverhalten und Kompatibilitätshinweise
-
Google AI Studio Preisseite: Offizielle API-Preise
- Link:
aistudio.google.com/docs/pricing -
Beschreibung: Preise für die Modi Standard, Batch, Flex und Priority
-
OpenAI – Introducing GPT-6.1 Terra: Veröffentlichungsmaterialien zu Terra
- Link:
openai.com/index/introducing-gpt-6-1-terra/ -
Beschreibung: Selbstberichtete Ergebnisse für Terminal-Bench 4.0 und API-Preise
-
Anthropic – Introducing Claude Sonnet 5.5: Veröffentlichungsmaterialien zu Sonnet 5.5
- Link:
anthropic.com/claude-sonnet-5-5 -
Beschreibung: Selbstberichtete Ergebnisse für Terminal-Bench 4.0 und OSWorld 2.1
-
Artificial Analysis – Gemini 4 Hydrogen: Unabhängige Bewertung der vier Denkstufen
- Link:
artificialanalysis.ai/models/gemini-4-hydrogen - Beschreibung: Intelligence Index v5.0.1 – Index, Laufzeit und Kosten je Stufe
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI. Weitere Materialien zur Modellintegration finden Sie im Dokumentationszentrum unter docs.apiyi.com.