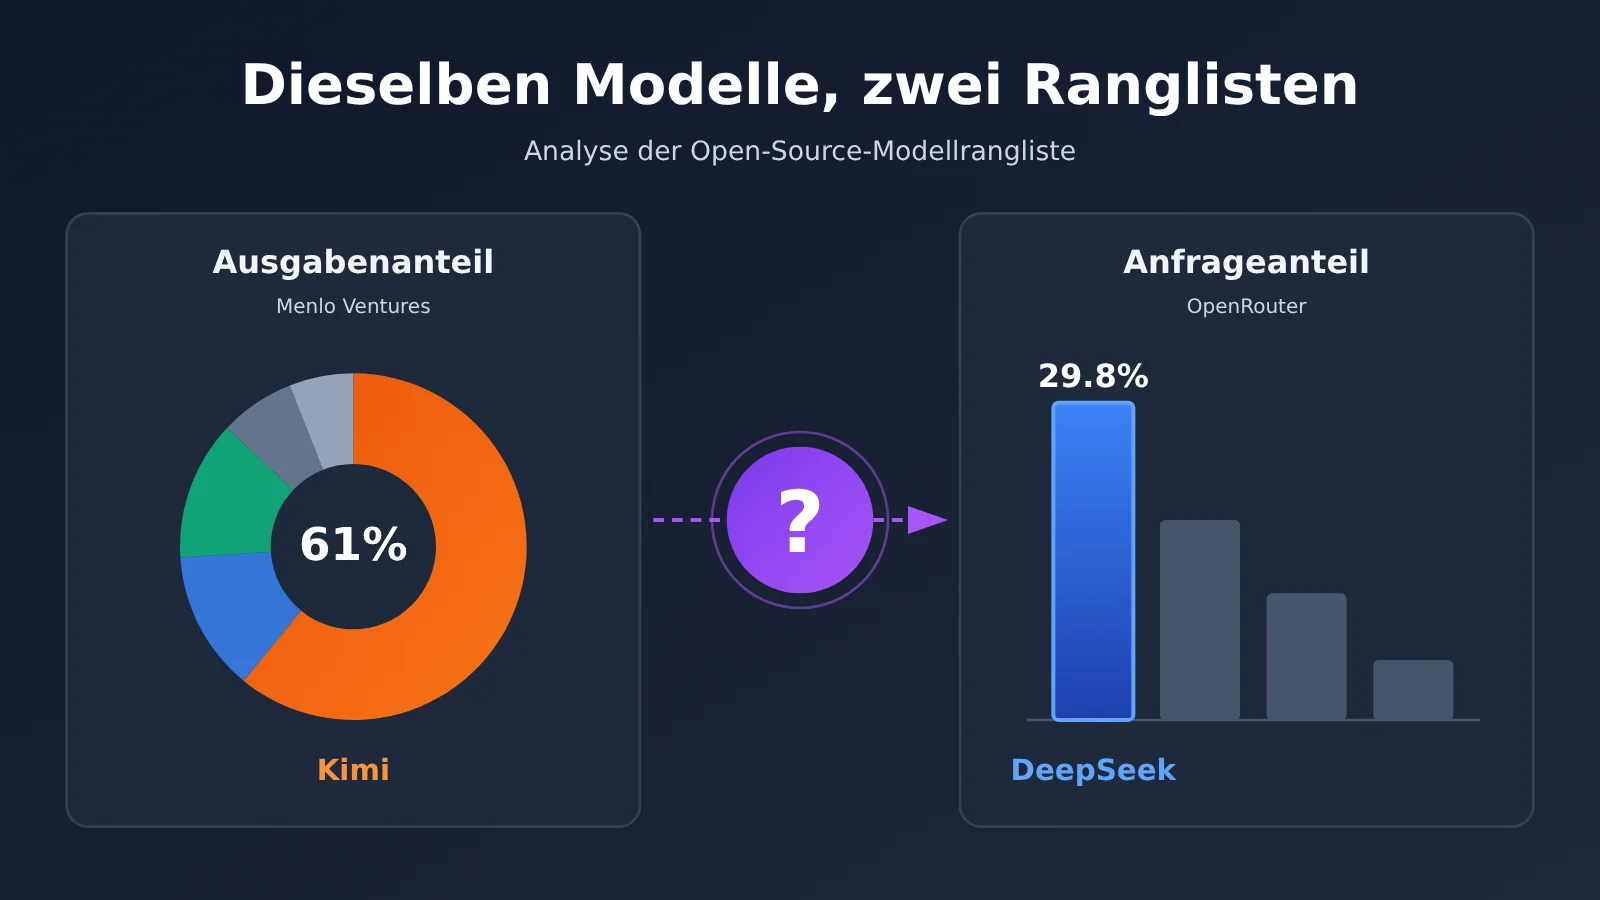
Anmerkung des Autors: Dieselben chinesischen Open-Source-Modelle landen auf der Ausgabenrangliste von Menlo Ventures und der Anfragenrangliste von OpenRouter in umgekehrter Reihenfolge. Dieser Artikel erklärt, wie die beiden Ranglisten zustande kommen, und stellt eine direkt umsetzbare Auswahlmethode in fünf Schritten vor.
Anfang November erschienen zwei Datenauswertungen. Der Bericht von Menlo Ventures zeigt, dass 61 % der Ausgaben US-amerikanischer Unternehmen für Open-Source-Modelle auf Kimi entfallen. Die Wochenrangliste von OpenRouter zeigt dagegen, dass 29,8 % der Textanfragen auf der Plattform an DeepSeek gehen. Auf Platz eins stehen also unterschiedliche Anbieter, die Reihenfolge ist nahezu umgekehrt. Viele technische Verantwortliche fragen sich da zuerst: Welcher Liste soll man glauben?
Die Antwort: Die beiden Ranglisten widersprechen sich nicht, denn sie messen Unterschiedliches. Die Ausgabenrangliste zeigt, „an wen Unternehmen Geld zahlen“, die Anfragenrangliste dagegen, „welche Modelle Entwickler auf einer bestimmten Plattform aufrufen“. Bei der Auswahl sollte man daher nicht einfach eine Rangliste übernehmen, sondern nach eigenen Aufgabentypen und Kostenmaßstäben entscheiden. Ranglisten können die Auswahl eingrenzen, aber sie nehmen sie dir nicht ab.
Das ist keine weitere Nacherzählung von Rankings. Dieser Artikel erläutert Stichprobe, Zeitraum und Grenzen der beiden Ranglisten. Anschliessend geht es darum, wie sinkende Stückpreise und steigende Nutzung die Kostenstruktur beeinflussen. Zum Schluss gibt es eine Checkliste für die Modellauswahl in fünf Schritten.
Open-Source-Modellrankings im Überblick: Warum Kimi und DeepSeek jeweils auf Platz eins stehen
Das Wichtigste vorweg: Menlo Ventures misst Unternehmensausgaben, OpenRouter die Anfragen auf seiner Plattform. Stichproben, Zeiträume und Messgrössen unterscheiden sich.
Die beiden Erhebungen werden häufig gemeinsam diskutiert, haben aber völlig unterschiedliche Bezugsgrössen. Die Daten von Menlo Ventures stammen aus einer Befragung von KI-Verantwortlichen in US-Unternehmen. Sie sind also Schätzungen aus einer Umfrage und keine geprüften Abrechnungsdaten. Die Zahlen von OpenRouter beruhen auf den Anfragen der eigenen Plattform. Sie zeigen das Verhalten ihrer Nutzer, stehen aber nicht für den Gesamtmarkt.
| Ranking | Messgrösse | Stichprobe/Zeitraum | Wichtigste Platzierungen | Geeignet zur Einschätzung von |
|---|---|---|---|---|
| Menlo Ventures: Bericht zur Lage der Unternehmens-KI 2026 | Ausgabenanteil für Open-Source-Modelle in US-Unternehmen | Rund 400 KI-Verantwortliche in US-Unternehmen, befragt vom 8. bis 26. September 2026, veröffentlicht am 3. November | Kimi 61 %, DeepSeek 15 %, GLM 11 %, Meta Llama 7 %, Qwen 3 % | Beschaffungspräferenzen, Budgetverteilung und Modelle in formellen Verträgen |
| OpenRouter-Wochenranking | Anteil an Textanfragen auf der Plattform | OpenRouter-Plattform, 26. Oktober bis 1. November | DeepSeek 29,8 %, OpenAI 18,8 %, Z.ai 11,9 %, Qwen 5,6 % (Platz sechs) | Entwickleraktivität, preissensible Aufrufe und Beliebtheit in der Community |
Schon die Tabelle zeigt: Die beiden Rankings betrachten nicht einmal dieselben Teilnehmer. Menlo zählt nur Open-Source-Modelle, während OpenRouter auch Anbieter proprietärer Modelle wie OpenAI und Google einbezieht. Die Prozentwerte direkt zu vergleichen, wäre deshalb irreführend.
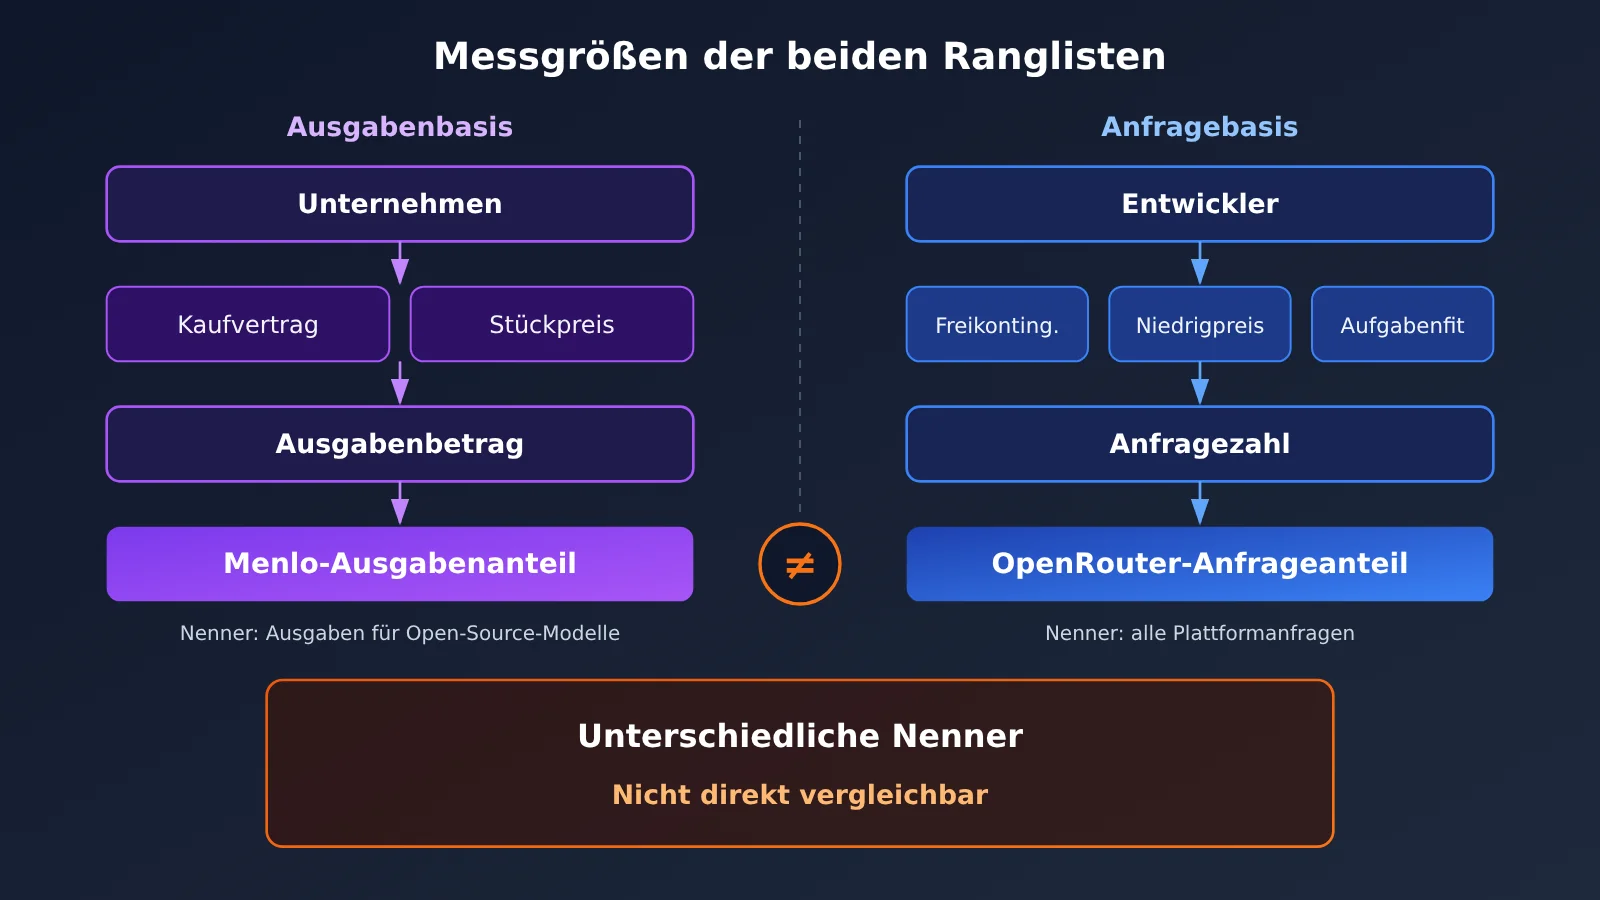
So liest man die Ausgabenrangliste von Menlo Ventures: Auf Kimi entfallen 61 % der Ausgaben für Open-Source-Modelle
Das Wichtigste vorweg: Die Daten von Menlo Ventures zeigen, dass chinesische Open-Source-Modelle inzwischen in den Budgets US-amerikanischer Unternehmen auftauchen. Sie sind aber eine Umfrageschätzung und keine Rangliste der Modellfähigkeiten.
Die meistbeachtete Zahl im Bericht: Auf chinesische Modelle entfallen 89 % der Ausgaben US-amerikanischer Unternehmen für Open-Source-Modelle. Kimi allein kommt auf 61 %, DeepSeek auf 15 %, GLM auf 11 % und Qwen auf 3 %. Unter den nicht chinesischen Modellen erreicht Meta Llama 7 %.
| Modell | Anteil an den Ausgaben US-amerikanischer Unternehmen für Open-Source-Modelle | Einordnung |
|---|---|---|
| Kimi | 61 % | Höchster Anteil, möglicherweise beeinflusst durch Beschaffungskanäle und Stückpreise |
| DeepSeek | 15 % | Platz zwei bei den Ausgaben, aber häufiger aufgerufen |
| GLM | 11 % | Fest in Unternehmensbudgets vertreten |
| Meta Llama | 7 % | Höchster Anteil unter den nicht chinesischen Open-Source-Modellen |
| Qwen | 3 % | Geringerer Ausgabenanteil, aber bei Modellaufrufen durchaus vertreten |
Im Gesamtbild werden die Zahlen verständlicher. Der Bericht schätzt die weltweiten Unternehmensausgaben für den KI-Einsatz auf jährlich rund 176,8 Milliarden US-Dollar – mehr als das Hundertfache des Werts von vor drei Jahren. Führende KI-Labore machen 69 % der Ausgaben für den KI-Einsatz aus, während Open-Source-Modelle nur 4 % der gesamten Modellausgaben auf sich vereinen. „Kimi erreicht 61 %“ bedeutet also: 61 % dieses kleinen Open-Source-Segments, nicht 61 % des gesamten Unternehmensmarkts für KI.
Außerdem beruhen die Umfragedaten auf den Schätzungen der Befragten zu den Budgets ihrer eigenen Unternehmen. Die knapp 400 Befragten repräsentieren zudem nur US-amerikanische Unternehmen. Eine sinnvolle Lesart ist daher: Die Daten zeigen einen Trend bei der Beschaffung durch Unternehmen. Die konkreten Anteile sind Umfrageschätzungen, die durch weitere Daten bestätigt werden müssen.
So lesen Sie die OpenRouter-Rangliste: 29,8 % der Anfragen gehen an DeepSeek
Das Wichtigste vorweg: Die OpenRouter-Wochenrangliste zeigt, welche Modelle Entwickler auf dieser Plattform häufig aufrufen. Sie macht Trends sichtbar, steht aber nicht für den Marktanteil insgesamt.
In der Woche vom 26. Oktober bis zum 1. November belegte DeepSeek mit einem Anteil von 29,8 % an den Textanfragen den ersten Platz – ein Plus von 7 % gegenüber der Vorwoche. OpenAI lag mit 18,8 % auf Platz zwei, Googles Anteil sank von 14,4 %. Z.ai erreichte mit 11,9 % den vierten Platz, Qwen mit 5,6 % den sechsten.
| Rang | Anbieter | Anteil an den Anfragen | Veränderung |
|---|---|---|---|
| Platz 1 | DeepSeek | 29,8 % | +7 % gegenüber der Vorwoche |
| Platz 2 | OpenAI | 18,8 % | — |
| Rückgang | Rückgang von 14,4 % | Anteil gesunken | |
| Platz 4 | Z.ai | 11,9 % | — |
| Platz 6 | Qwen | 5,6 % | — |
Zwei weitere Trends sind bemerkenswert: Das Token-Aufrufvolumen chinesischer Modelle liegt seit 27 Wochen in Folge über dem amerikanischer Modelle. Unter den fünf meistaufgerufenen Einzelmodellen der Woche stammen vier aus China. Im selben Zeitraum aktualisierte DeepSeek sein Modell auf DeepSeek V4.1-Flash-1017, ohne die Art des API-Aufrufs oder die Preise zu ändern. Für Entwickler, die DeepSeek bereits eingebunden haben, ist der Umstieg damit wenig aufwendig.
Auch die Stabilität sollte man im Blick behalten: Am 3. November waren die DeepSeek-Weboberfläche und die API rund eine Stunde lang teilweise nicht verfügbar. Ein hohes Aufrufvolumen bedeutet nicht, dass ein Dienst immer erreichbar ist – deshalb lohnt es sich, wie später beschrieben, ein Ersatzmodell bereitzuhalten. Nach Einführung einer neuen Version sind die konkreten Modell-IDs und Abrechnungskonditionen in der Modellliste der Konsole von APIYI unter apiyi.com maßgeblich.
Warum die Ranglisten nach Ausgaben und Anfragen bei Open-Source-Modellen gegenläufig sind
Kurz gesagt: Die unterschiedlichen Platzierungen entstehen vor allem durch Preise, Beschaffungswege, kostenlose Kontingente, passende Einsatzgebiete und unterschiedliche Erhebungsgrundlagen. Das bedeutet nicht, dass eine der beiden Ranglisten „falsch“ ist.
Der Ausgabenanteil entspricht ungefähr „Nutzungsmenge × Einzelpreis“, wobei auch Verträge und Beschaffungswege eine Rolle spielen. Der Anfrageanteil zählt nur die Anzahl der Aufrufe, unabhängig von den Kosten pro Aufruf. Ist ein Modell teurer und sind Unternehmen bereit, dafür Beschaffungsverträge abzuschließen, landet es in der Ausgabenrangliste weiter oben. Ist ein Modell günstiger und wird es von vielen Entwicklern genutzt, liegt es bei den Anfragen weiter vorn.
| Einflussfaktor | Wirkung auf den Ausgabenanteil | Wirkung auf den Anfrageanteil |
|---|---|---|
| Einzelpreis | Ein höherer Preis führt bei gleicher Nutzung zu höheren Kosten und vergrößert den Ausgabenanteil | Ein niedriger Preis lädt zum Ausprobieren ein und erhöht die Zahl der Anfragen |
| Unternehmensbeschaffung | Verträge, private Deployments und Servicevereinbarungen zählen zu den Ausgaben | Läuft nicht unbedingt über OpenRouter und ist daher auf der Plattform nicht sichtbar |
| Kostenlose Kontingente | Kostenlose Aufrufe verursachen keine Ausgaben | Kostenlose Aufrufe zählen zu den Anfragen |
| Passende Einsatzgebiete | Tokenintensive Aufgaben wie lange Dokumente oder Agenten erhöhen die Kosten | Kurze Gespräche und viele kleine Aufgaben erhöhen die Anzahl der Anfragen |
| Erhebungsgrundlage | Erfasst nur die befragten US-Unternehmen | Erfasst nur Nutzer von OpenRouter |
Vor diesem Hintergrund könnte Kimi bei den Beschaffungswegen für Unternehmen und beim Einzelpreis einen Vorteil haben, was seinen hohen Ausgabenanteil erklären würde. DeepSeek ist günstiger und hat eine aktive Entwickler-Community, was die hohe Zahl der Anfragen erklären könnte. Das ist eine plausible Vermutung auf Basis der unterschiedlichen Erhebungsgrundlagen. Die beiden Berichte selbst liefern keine Aufschlüsselung nach diesen Faktoren.
Ein oft übersehenes Detail: Auch verschiedene Versionen desselben Modells, unterschiedliche Zugangswege und Cache-Trefferquoten können dazu führen, dass Ausgaben und Aufrufzahlen auseinandergehen. Erzielt ein Team viele Cache-Treffer, werden die Anfragen weiterhin gezählt, während die tatsächlichen Ausgaben deutlich niedriger ausfallen.
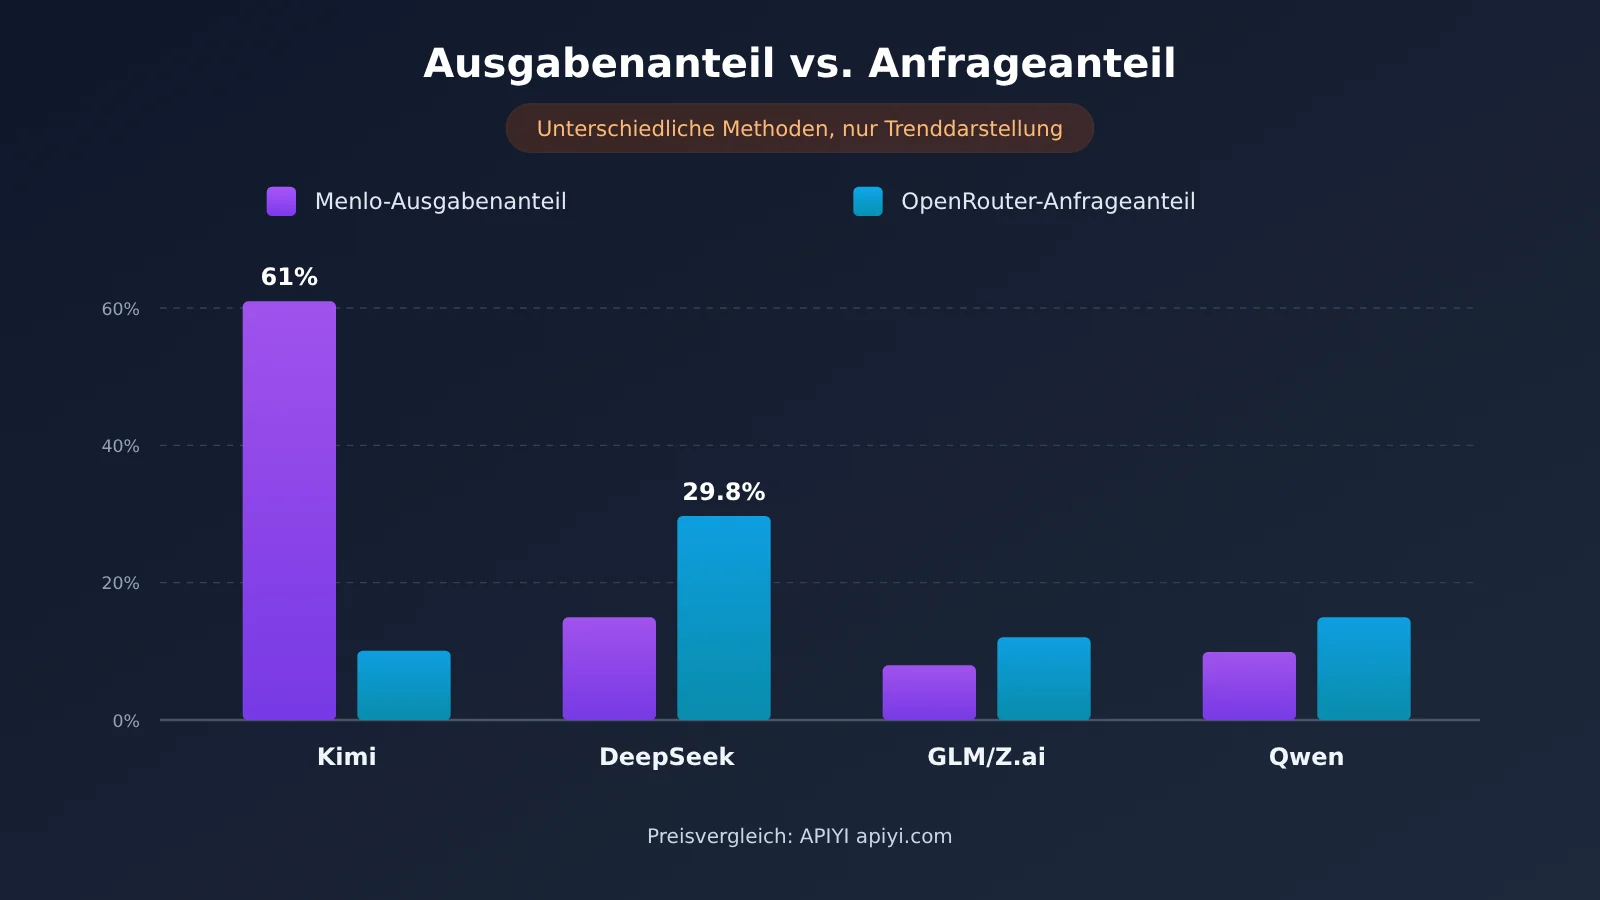
Preise und Nutzung offener Modelle: Was bedeuten rund 70 % niedrigere Stückpreise bei 22,5-facher Nutzung?
Das Fazit vorweg: Ein niedrigerer Stückpreis bedeutet nicht automatisch geringere Gesamtkosten. Ein Vergleich anhand der „Kosten pro erledigter Aufgabe“ ist zuverlässiger als ein Vergleich der Preise pro Million Token.
Der Menlo-Bericht enthält einige wichtige Zahlen: Der durchschnittliche Token-Preis sank von 0,45 US-Dollar/Million Token auf 0,13 US-Dollar/Million Token, also um rund 70 %. Gleichzeitig stieg die Nutzung auf das 22,5-Fache. Rechnet man mit diesen beiden Zahlen grob nach, sind die Gesamtausgaben nicht gesunken, sondern auf etwa das 6,5-Fache gestiegen. Das ist nur eine Beispielrechnung auf Grundlage der Durchschnittswerte aus dem Bericht – die tatsächliche Situation kann sich von Team zu Team unterscheiden.
Bei offenen Modellen zeigt sich ein besonders deutliches Bild: Sie machen 19 % der Token-Nutzung in Unternehmen aus, aber nur 4 % der Ausgaben für Modelle. Anders gesagt: Viele Token werden mit günstigen offenen Modellen verarbeitet, das meiste Geld fliesst aber weiterhin an führende proprietäre Modelle.
Für Entwickler führt ein niedrigerer Stückpreis oft zu mehr Aufrufen – besonders bei Agenten und Batch-Aufgaben. Für die tatsächlichen Kosten sind ausserdem folgende Faktoren wichtig:
- Cache-Treffer: Ob wiederkehrende System-Eingabeaufforderungen und lange Kontexte im Cache gefunden werden, wirkt sich direkt auf den tatsächlichen Preis aus.
- Kontextlänge: Bei Aufgaben mit langen Dokumenten fallen oft deutlich mehr Eingabe- als Ausgabe-Token an.
- Wiederholungsversuche: Instabile Ausgaben oder Formatfehler können erneute Aufrufe nötig machen und die Kosten vervielfachen.
- Anzahl der Werkzeugaufrufe: Bei einer Agentenaufgabe können durchaus mehr als zehn Aufrufrunden zusammenkommen – auch wenn der Einzelpreis niedrig ist.
Beim Preisvergleich lohnt sich zunächst ein Blick in die APIYI-Konsole auf apiyi.com: Prüfen Sie dort die Listenpreise und Abrechnungsmodelle der infrage kommenden Modelle und klären Sie, wie Eingabe, Ausgabe und Cache jeweils berechnet werden. Testen Sie dann eine kleine Stichprobe Ihrer eigenen Aufgaben und ermitteln Sie die „Kosten pro erledigter Aufgabe“. Dieser Wert ist aussagekräftiger als der Listenpreis allein.
Open-Source-Modelle auswählen: Bestenlisten für die Vorauswahl, Aufgaben für die Entscheidung
Das Wichtigste vorweg: Bestenlisten liefern eine Vorauswahl. Die endgültige Entscheidung hängt von der Eignung für die Aufgabe, den Kosten, der Stabilität und Tests mit einer kleinen Stichprobe ab.
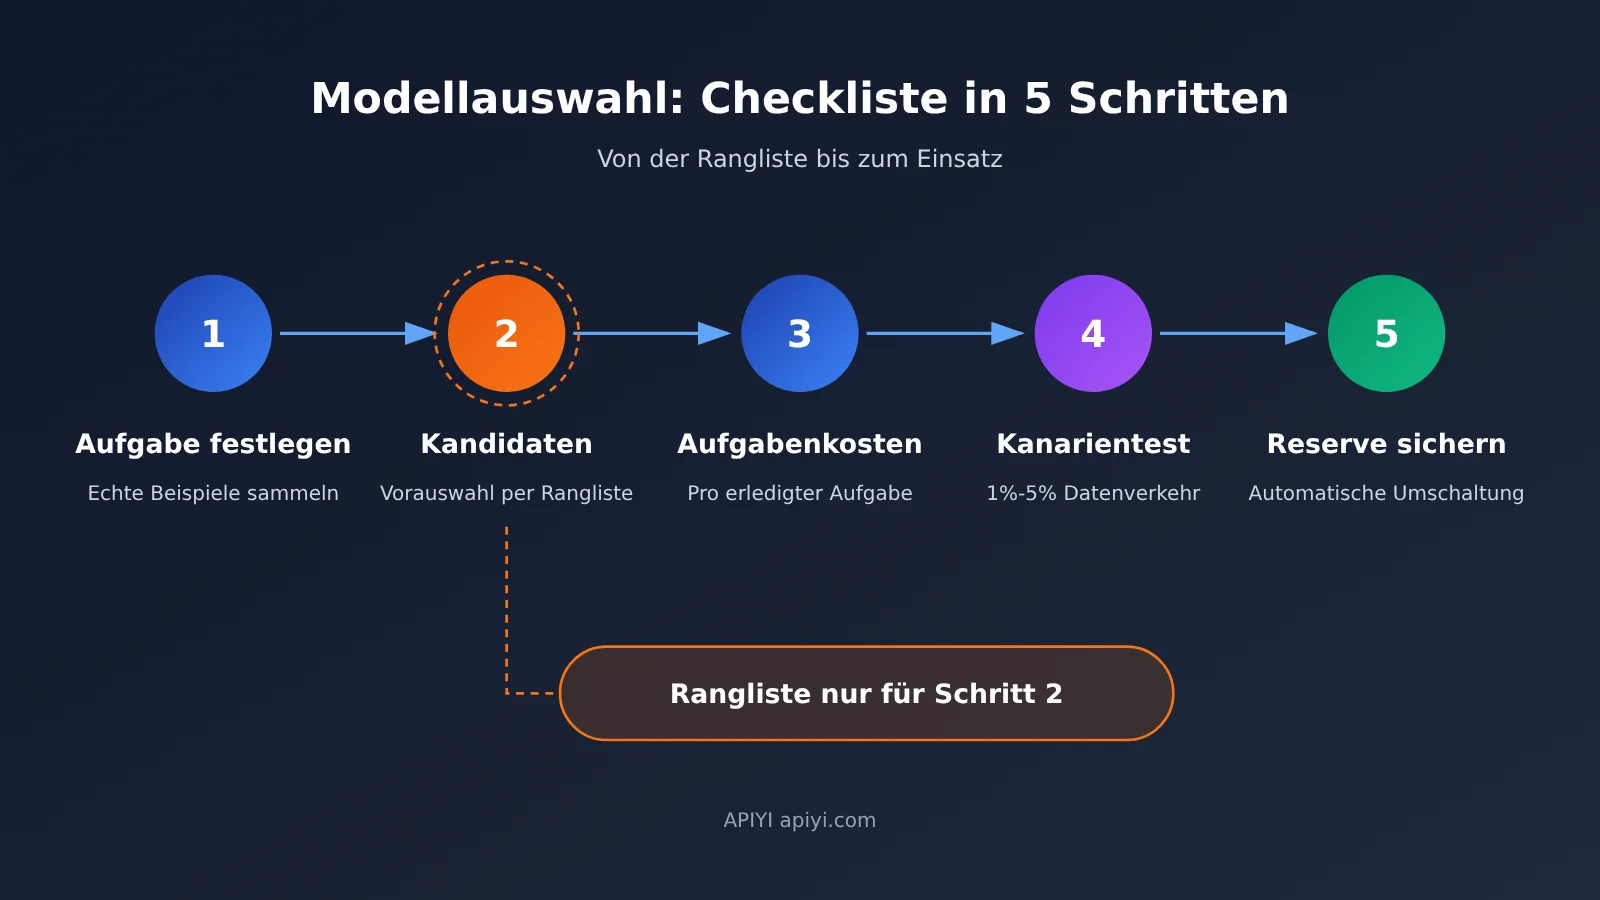
Gehen Sie bei der Auswahl in dieser Reihenfolge vor: „Aufgabe → Kosten → Stabilität → Validierung → Ersatzmodell“. Die folgende Tabelle zeigt, welche Fragen Sie zu den einzelnen Aspekten stellen und wie Sie sie überprüfen können.
| Aspekt | Wichtige Fragen | Überprüfung | Auswirkung auf die Kosten |
|---|---|---|---|
| Eignung für die Aufgabe | Geht es hauptsächlich um Programmierung, lange Dokumente, multimodale Aufgaben oder Agent-Tool-Aufrufe? | 30–100 Beispiele aus echten Aufgaben vorbereiten und die Ergebnisse manuell bewerten | Eine geringe Eignung führt zu mehr Wiederholungsversuchen und manuellen Korrekturen |
| Einzelpreise und Caching | Was kosten Eingabe, Ausgabe und Cache-Treffer jeweils? | Modellliste und Abrechnungshinweise in der Konsole prüfen und die Cache-Trefferquote erfassen | Bestimmt den tatsächlichen Preis pro Million Token |
| Kontext | Wie lang ist die längste Eingabe? Lässt die Qualität bei sehr langen Eingaben nach? | Abschneiden und Wiederfinden von Informationen mit den längsten echten Dokumenten testen | Langer Kontext erhöht direkt die Zahl der Eingabe-Token |
| Ratenbegrenzung | Reichen die Limits für gleichzeitige und für Anfragen pro Minute aus? | Lasttests anhand des Spitzenverkehrs durchführen | Bei Ratenbegrenzung sind Warteschlangen oder ein Wechsel nötig, was die Latenz beeinflusst |
| Regionale Verfügbarkeit | Ist das Modell aus der Bereitstellungsregion stabil erreichbar? | Tatsächliche Modellaufrufe aus der Produktionsregion durchführen | Bei Nichtverfügbarkeit ist ein anderer Zugangsweg nötig |
| Stabilität | Gab es kürzlich Ausfälle? Wie lange dauert die Wiederherstellung? | Frühere Störungen prüfen und Fehlerquoten in den Logs beobachten | Ausfälle verursachen Kosten für Wiederholungsversuche und geschäftliche Verluste |
Der Vergleich mehrerer Modelle ist bei diesem Schritt am zeitaufwendigsten. Wenn Sie sich für jedes Modell einzeln registrieren und jeweils ein SDK anbinden müssen, kann allein die Integration mehrere Tage dauern. Über APIYI apiyi.com können Sie mit einem einzigen API-Schlüssel Modelle verschiedener Anbieter aufrufen, darunter OpenAI, Claude, Gemini, DeepSeek und Kimi. Die Schnittstelle ist mit dem OpenAI-Format kompatibel: Setzen Sie base_url auf https://api.apiyi.com/v1 und ändern Sie den Parameter model in der Anfrage, um das Modell zu wechseln. So lässt sich dieselbe Stichprobe schnell für einen direkten Vergleich durchlaufen.
Bei der Stabilität sollten Sie sich nicht allein auf Ankündigungen der Anbieter verlassen. Der DeepSeek-Ausfall vom 3. November zeigt, dass jedes einzelne Modell vorübergehend nicht verfügbar sein kann. In der Konsole von APIYI apiyi.com lassen sich Nutzung und Aufruf-Logs nach Modell anzeigen. Fehlerquote, Latenz und Token-Verbrauch werden erfasst – hilfreich, um die tatsächliche Leistung der Kandidaten in der Canary-Phase zu beobachten. Die Plattform nutzt eine Bereitstellung über mehrere Knoten und intelligentes Routing und bietet automatisches Fallback. Wenn Sie zusätzlich für Ihre Anwendung ein Ersatzmodell konfigurieren und bei Fehlern des Hauptmodells dorthin wechseln, lassen sich die Auswirkungen eines Single Point of Failure begrenzen.
Beginnen Sie beim Canary-Release mit 1%–5% des echten Datenverkehrs und beobachten Sie Fehlerquote, Latenz und Kosten pro Aufgabe über mehrere Tage. Erst wenn die Werte stabil sind, sollten Sie den Anteil schrittweise erhöhen. Stellen Sie nicht allein aufgrund einer Bestenliste sofort den gesamten Datenverkehr um.
Häufige Fragen zu Ranglisten offener Modelle
Das Wichtigste vorweg: Die folgenden fünf Fragen behandeln die häufigsten Missverständnisse beim Lesen von Ranglisten offener Modelle.
F1: Bedeutet Kimis Ausgabenanteil von 61 %, dass Kimi die besseren Modelle hat?
Nein. Der Ausgabenanteil zeigt, an wen das Geld fliesst. Er hängt unter anderem von Stückpreisen, Einkaufsverträgen und Vertriebskanälen ab und lässt keinen direkten Rückschluss auf die Leistungsfähigkeit eines Modells zu. Zudem beruhen die Menlo-Daten auf einer Umfrageschätzung und erfassen nur die Ausgaben US-amerikanischer Unternehmen für offene Modelle. „Platz eins bei den Ausgaben“ bedeutet nicht „Platz eins bei der Leistung“. Die Leistung solltest du anhand deiner eigenen Aufgaben bewerten.
F2: Lässt die Rangliste der Anfragen auf OpenRouter Rückschlüsse auf die Beschaffung durch Unternehmen zu?
Nein. OpenRouter erfasst den Anteil der Anfragen auf seiner eigenen Plattform, die vor allem Entwickler und kleinere bis mittlere Teams nutzen. Direktverträge von Unternehmen, private Deployments und andere Kanäle sind nicht enthalten. Die Daten eignen sich, um die Beliebtheit bei Entwicklern und Trends bei preissensiblen Modellaufrufen zu beobachten – nicht aber, um auf die Verteilung von Unternehmensbudgets zu schliessen.
F3: Ist ein Modell mit niedrigem Stückpreis insgesamt immer günstiger?
Nicht unbedingt. Wenn ein günstigeres Modell mehr Wiederholungsversuche, längere Eingabeaufforderungen oder mehr Runden von Tool-Aufrufen benötigt, kann der gesamte Token-Verbrauch sogar höher ausfallen. Berechne die Kosten am besten pro abgeschlossener Aufgabe: In der Konsole von APIYI apiyi.com kannst du den Token-Verbrauch und die Kostenprotokolle für jeden Aufruf einsehen und die Gesamtkosten verschiedener Modelle für dieselben Aufgaben vergleichen.
F4: Können offene Modelle geschlossene Modelle vollständig ersetzen?
Das hängt von der Aufgabe ab. Laut den Menlo-Daten entfallen 19 % der von Unternehmen genutzten Token auf offene Modelle, aber nur 4 % der Ausgaben. Das deutet darauf hin, dass viele Teams offene Modelle für umfangreiche Routineaufgaben einsetzen und komplexe Aufgaben weiterhin führenden geschlossenen Modellen überlassen. Ein pragmatischer Ansatz ist die Kombination beider Varianten: Über APIYI apiyi.com kannst du mit demselben API-Schlüssel offene und geschlossene Modelle nutzen und Aufgaben je nach Schwierigkeitsgrad zuweisen.
F5: Wie oft sollte man Ranglisten offener Modelle prüfen?
Ein Blick auf Wochenranglisten einmal im Monat reicht aus, um Trends zu erkennen, ohne sich von Schwankungen einzelner Wochen ablenken zu lassen. Jahres- oder Quartalsberichte lohnt es sich bei Erscheinen genauer zu lesen. Achte dabei darauf, ob sich Definitionen und Stichproben verändert haben. Für deine Entscheidungen ist vor allem die laufende Überwachung eigener Geschäftskennzahlen wichtig, etwa Fehlerrate, Kosten pro Aufgabe und Nutzerfeedback. Diese solltest du möglichst wöchentlich auswerten.
Open-Source-Modellrankings verstehen: Checkliste zur Auswahl in 5 Schritten
Das Wichtigste vorweg: Die beiden Rankings messen unterschiedliche Dinge. Fragen Sie zuerst nach der Messgröße, prüfen Sie dann die Stichprobe und testen Sie die Modelle schließlich mit Ihren eigenen Aufgaben.
Die wichtigsten Punkte im Überblick:
- Ausgaben ≠ Aufrufe: Menlo misst die Ausgaben von Unternehmen, OpenRouter die Anfragen auf seiner Plattform. Die Bezugsgrößen unterscheiden sich und lassen sich nicht direkt vergleichen.
- Umfrage ≠ Prüfung: Die Menlo-Daten beruhen auf Schätzungen aus einer Umfrage unter knapp 400 Entscheidungsträgern US-amerikanischer Unternehmen. OpenRouter bildet nur die eigene Plattform ab.
- Günstig ≠ kostensparend: Sinkt der Einzelpreis um etwa 70 %, während die Nutzung auf das 22,5-Fache steigt, nehmen die Gesamtausgaben trotzdem zu. Entscheidend sind die Kosten pro Aufgabe.
- Beliebt ≠ stabil: Auch das Modell mit den meisten Aufrufen kann ausfallen. Eine Ausweichlösung sollte deshalb im Voraus bereitstehen.
- Rankings grenzen die Auswahl ein, ersetzen aber nicht die eigene Prüfung.
Die folgende Checkliste können Sie direkt bei Ihrer nächsten Modellauswahl nutzen:
- Aufgabe festlegen: Halten Sie die wichtigsten Aufgabentypen fest, etwa Programmierung, lange Dokumente, multimodale Aufgaben oder Agenten. Stellen Sie 30-100 reale Beispiele und passende Bewertungskriterien zusammen.
- Kandidaten auswählen: Wählen Sie aus dem Ausgaben- und dem Anfragenranking jeweils 2-3 Modelle und ergänzen Sie ein Closed-Source-Modell als Vergleichsbasis. Begrenzen Sie die Auswahl auf 3-5 Kandidaten.
- Kosten pro Aufgabe berechnen: Testen Sie alle Kandidaten mit denselben Beispielen. Erfassen Sie Token-Verbrauch, Cache-Treffer und Wiederholungsversuche und berechnen Sie die Kosten pro Aufgabe sowie eine Qualitätsbewertung.
- Canary-Test durchführen: Lassen Sie das ausgewählte Modell zunächst 1%-5% des tatsächlichen Datenverkehrs bearbeiten. Beobachten Sie einige Tage lang Fehlerrate, Latenz und Kosten und erhöhen Sie den Anteil erst, wenn die Werte stimmen.
- Ausweichmodell bereithalten: Richten Sie mindestens ein Ausweichmodell eines anderen Anbieters ein, legen Sie Umschaltregeln fest und testen Sie den Wechsel regelmässig.
Wenn Sie die Schritte 3 bis 5 über einen einzigen Zugang abwickeln möchten, können Sie über APIYI apiyi.com mit einem API-Schlüssel auf die Kandidaten zugreifen. In der Konsole lassen sich Preise, Verbrauch und Protokolle vergleichen; über die automatische Fallback-Funktion der Plattform können Sie den Wechsel zum Ausweichmodell einrichten. Neue Nutzer erhalten ein kostenloses Testkontingent, mit dem sich zunächst kleine Stichproben prüfen lassen.
Datenquellen dieses Artikels
- Menlo Ventures, State of Enterprise AI 2026: veröffentlicht am 3. November 2026
- Link:
menlovc.com -
Hinweis: Ausgaben von Unternehmen für KI, Ausgabenanteil von Open-Source-Modellen und Veränderungen der Token-Preise; die Angaben beruhen auf Umfrageschätzungen.
-
OpenRouter-Modellrankings: Wochenranking vom 26. Oktober bis 1. November 2026
- Link:
openrouter.ai/rankings - Hinweis: Anteil der Textanfragen und Entwicklung der Token-Nutzung auf der Plattform; die Angaben beziehen sich ausschliesslich auf OpenRouter.
Autor: Technikteam von APIYI
Technischer Austausch: Bei Fragen zu Preisen, Ratenbegrenzungen oder Modellwechseln können Sie uns über die Startseite von APIYI apiyi.com kontaktieren. Weitere Informationen zur Anbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com.