Anmerkung des Autors: Dass am Tag einer Modellveröffentlichung Kontingente ausgeschöpft werden und es zu Rate Limits und Zeitüberschreitungen kommt, ist vorhersehbar. Dieser Artikel stellt fünf wichtige Bausteine vor: Modellabstufung und Fallback-Zuordnung, Prioritätswarteschlangen, zeitversetzte Planung sowie Monitoring und Budgetierung. Dazu gibt es eine Checkliste für die Kapazitätsplanung am Veröffentlichungstag.
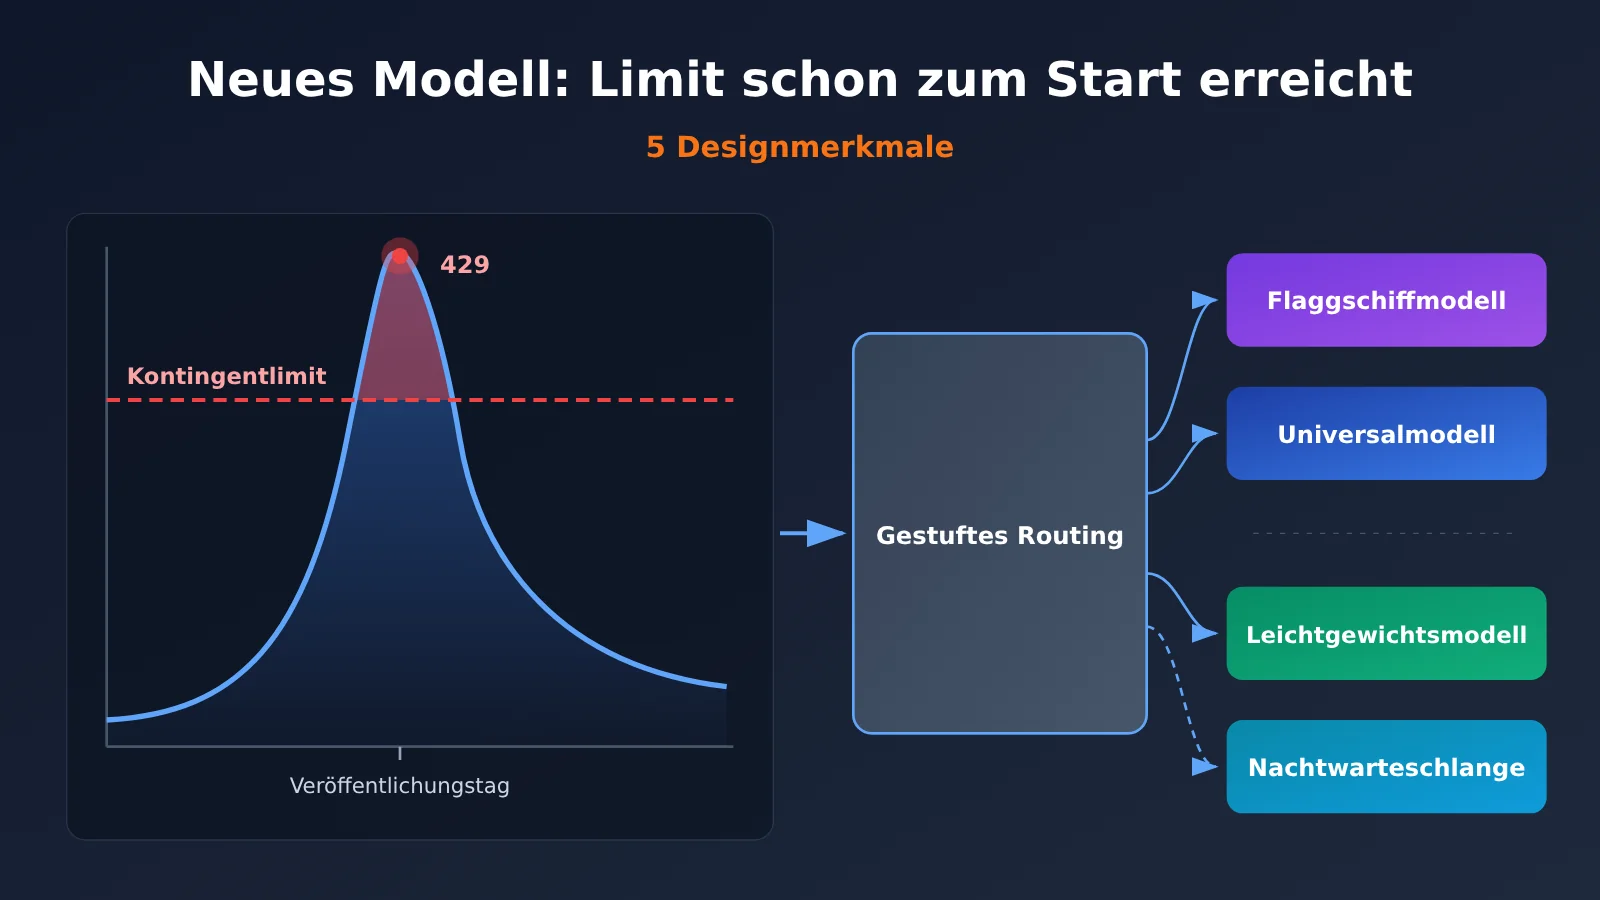
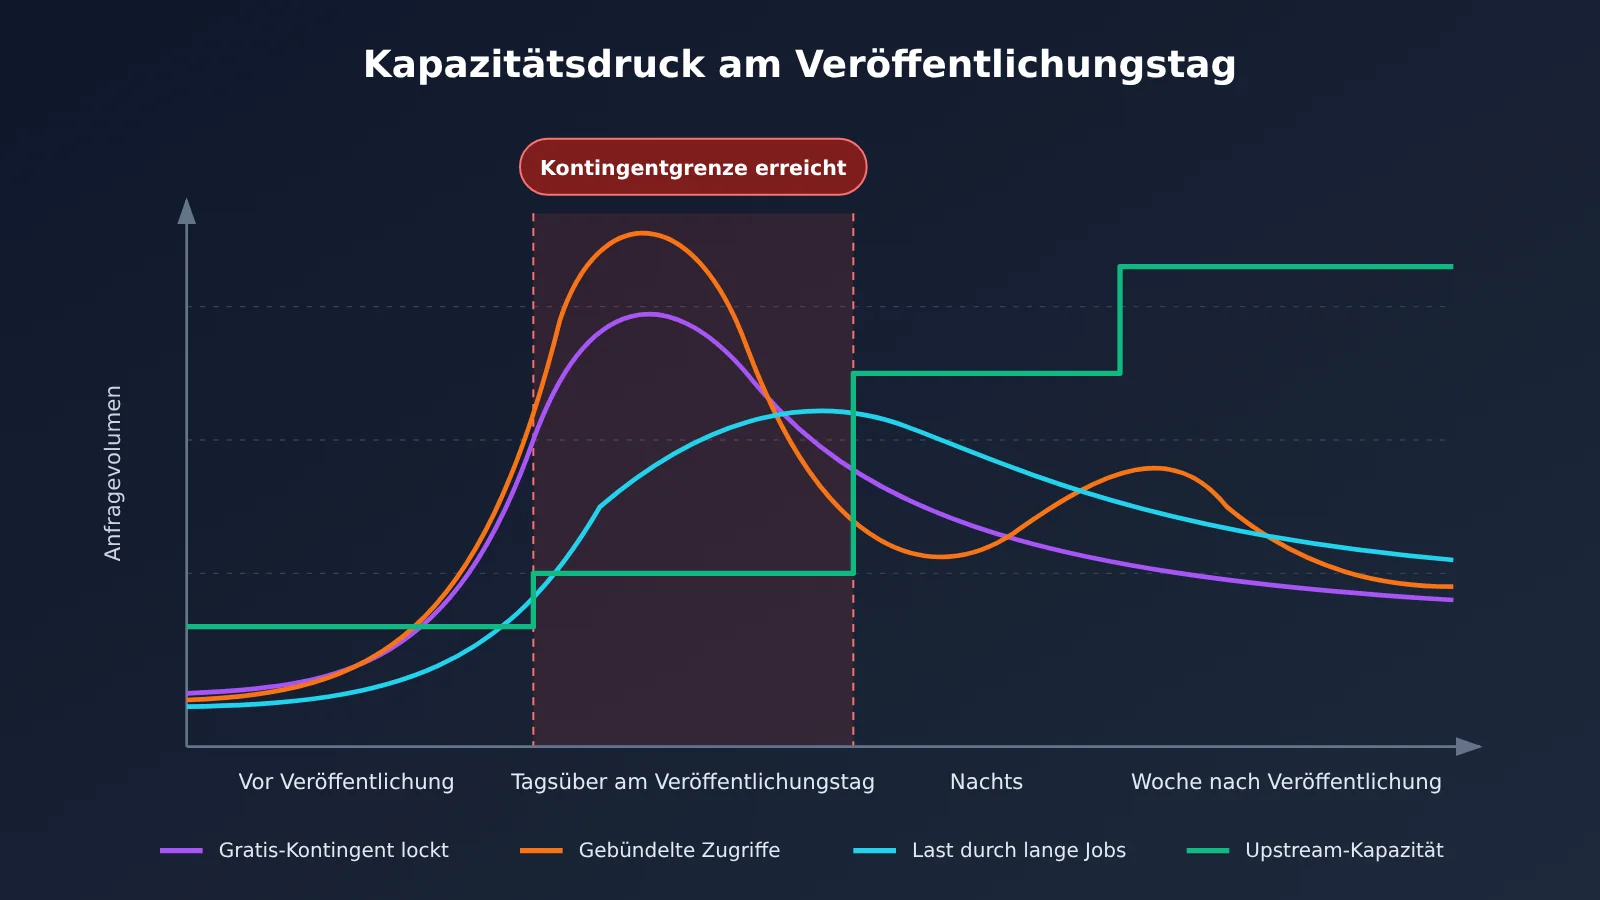
Das Wichtigste vorweg: Dass ein neues Modell direkt nach dem Start an Kontingentgrenzen stößt, ist kein Zufall, sondern Teil des Produktzyklus. Kostenlose Kontingente locken viele Nutzer zum Ausprobieren an, der Datenverkehr konzentriert sich auf den Veröffentlichungstag, und der Ausbau der Kapazitäten beim Anbieter braucht Zeit. Zusammengenommen führen diese Faktoren fast zwangsläufig zu Engpässen. Auf Anwendungsseite kommt es darauf an, den Wechsel zwischen mehreren Modellen und eine zeitversetzte Planung schon vor der Veröffentlichung vorzusehen – statt erst bei einem 429 immer wieder neue Versuche zu starten.
Dieser Artikel erklärt nicht, wie Sie „einfach öfter wiederholen“. Wiederholungsversuche können kurze Schwankungen abfangen, aber weder erschöpfte Kontingente noch eine Überlastung beim Anbieter beheben. Am Veröffentlichungstag kommt es nicht auf die Zahl der Versuche an, sondern auf eine vorausschauende Abstufung und Warteschlangenplanung. Nach der Lektüre kennen Sie einen praxistauglichen Ansatz für die Kapazitätsplanung: Modellabstufung, Fallback-Zuordnung, Prioritätswarteschlangen, zeitversetzte Planung sowie Monitoring und Budgetierung. Außerdem wissen Sie, wann Sie wechseln, Anfragen einreihen oder auf weitere Versuche verzichten sollten.
Warum neue Modelle am Veröffentlichungstag schnell an Limits stoßen
Fazit: Am Veröffentlichungstag trifft ein plötzlicher Nachfrageschub auf Kapazitäten, die oft erst mit Verzögerung ausgebaut werden. Anwendungen sollten deshalb von vornherein darauf ausgelegt sein.
Ein Beispiel dafür ist Tencent Hy4. Laut öffentlichen Angaben von Tencent startete Hy4 am 4. November zunächst in WorkBuddy. Schon am ersten Tag erreichten viele Nutzer ihr Nutzungslimit. Daraufhin vergrößerte Tencent den Inferenzcluster auf das Zehnfache und erhöhte das kostenlose Kontingent. Die Empfehlung von Tencent: Bei Erreichen des Limits auf Hy3 wechseln oder nicht dringende Aufgaben am Abend erledigen. Gleichzeitig verlängerte Tencent den zeitlich begrenzten kostenlosen Zugang zu Hy3 bis zum 15. November um 23:59 Uhr.
Wichtig ist dabei: Dieses Kontingentproblem trat auf der Produktebene von WorkBuddy auf und betraf das Nutzungskontingent für Endnutzer. Es ist nicht direkt mit einer API-Ratenbegrenzung gleichzusetzen. Produktkontingente richten sich meist nach Konto oder Mitgliedschaftsstufe. API-Limits begrenzen dagegen Anfragerate und Parallelität anhand von Key, Organisation oder Modell. Auslöser und Gegenmaßnahmen unterscheiden sich also. Das Beispiel zeigt jedoch ein allgemeines Muster: Sobald ein neues Modell startet, strömt die Nachfrage innerhalb kürzester Zeit geballt herein.
Auch das Ausmaß der Nachfrage wächst schnell. Ebenfalls am 4. November gab DeepSeek an, dass Harness täglich rund 1,54 Millionen aktive Nutzer und einen täglichen Verbrauch von rund 92 Billionen Token verzeichnet. Diese Zahlen stammen vom Anbieter selbst und sind nicht unabhängig geprüft. Sie helfen, die Größenordnung einzuschätzen, eignen sich aber nicht als präzise Grundlage für die Kapazitätsplanung. Dennoch zeigen sie, dass Agent-Anwendungen inzwischen deutlich mehr Token verbrauchen als gewöhnliche Chats.
Vier Gründe, warum neue Modelle an Limits stoßen
| Ursache | Konkrete Ausprägung | Auswirkungen auf Anwendungen |
|---|---|---|
| Kostenloses Kontingent oder Testkontingent | Neue Modelle werden oft mit einem Testkontingent angeboten, das viele Nutzer gleichzeitig anzieht | Das Kontingent ist schnell aufgebraucht, es treten 402– oder 429-Fehler auf |
| Gebündelte Zugriffe | Veröffentlichungstag, Aktionszeitraum und Zugriffe tagsüber an Werktagen fallen zusammen | Spitzen können das 3- bis 10-Fache des normalen Aufkommens erreichen |
| Ressourcenbindung durch lange Aufgaben | Mehrstufige Agent-Abläufe, Tool-Aufrufe und langer Kontext | Einzelne Anfragen verbrauchen viele Token und belegen Inferenzressourcen lange |
| Verzögerter Kapazitätsausbau beim Anbieter | Der Ausbau von Inferenzclustern braucht Zeit | 5xx-Fehler, Warteschlangen, Timeouts und sogar Schwankungen der Ausgabequalität |
Von diesen vier Ursachen können Anwendungsbetreiber nur die Gestaltung und Steuerung ihrer eigenen Anfragen direkt beeinflussen. Statt darauf zu hoffen, dass der Anbieter dem Ansturm standhält, sollten sie deshalb selbst für Lastverteilung und Pufferung sorgen.
Fünf Arten von Kapazitätsproblemen bei neuen Modellen
Fazit: Wenn ein Modell an seine Grenzen stößt, kann das fünf unterschiedliche Kapazitätsprobleme bedeuten. Die Behandlung muss sich nach der jeweiligen Ursache richten.
Viele Teams behandeln alle Fehler mit derselben Wiederholungslogik. Genau das kann Vorfälle am Veröffentlichungstag verschlimmern: Ist das Kontingent aufgebraucht, schlagen weitere Versuche ebenfalls fehl. Ist der vorgelagerte Dienst überlastet, können häufige Wiederholungen den Engpass sogar verstärken. Die folgende Tabelle unterscheidet fünf Problemarten als Grundlage für passende Behandlungswege.
| Problem | Typische Statuscodes | Ursache | Behandlung |
|---|---|---|---|
| Kontingent aufgebraucht | 402, 429 |
Kostenloses Kontingent, Testkontingent oder Kontoguthaben aufgebraucht | Wiederholungen stoppen, auf ein Ersatzmodell wechseln oder zum Aufladen auffordern |
| Raten- oder Parallelitätslimit | 429, häufig mit Retry-After |
RPM-, TPM- oder Parallelitätslimit pro Schlüssel oder Modell überschritten | Gemäß Retry-After warten; überschreitet die Wartezeit den Schwellenwert, wechseln oder in die Warteschlange stellen |
| Unzureichende Kapazität beim Anbieter | 500, 502, 503, 529 |
Inferenzcluster überlastet oder teilweise ausgefallen | Wenige Wiederholungen mit exponentiellem Backoff; nach anhaltenden Fehlern auf ein Ersatzmodell wechseln |
| Kapazitätsbindung durch langlaufende Aufgaben | Zeitüberschreitung, Verbindungsabbruch | Mehrstufige Agent-Abläufe, Tool-Aufrufe oder langer Kontext machen einzelne Anfragen zu aufwendig | Aufgaben aufteilen, Kontext begrenzen und für langlaufende Aufgaben einen separaten Parallelitätspool einrichten |
| Lastspitzen | 429 und 5xx treten gemischt auf |
Überlagerung von Anfragen tagsüber, an Veröffentlichungstagen oder während Aktionen | Prioritätswarteschlange und zeitversetzte Planung einsetzen; nicht dringende Aufgaben verschieben |
Zwei Details sind wichtig: Erstens ist 429 nicht eindeutig. Der Code kann sowohl ein überschrittenes Ratenlimit als auch ein aufgebrauchtes Kontingent anzeigen. Zur Unterscheidung braucht es die Fehlermeldung im Antwortkörper und gegebenenfalls Retry-After. Zweitens zeigt ein Überlastungscode wie 529, dass der vorgelagerte Dienst vorübergehend keine Anfragen bedienen kann. In diesem Fall ist es wirksamer, die Anfragerate zu senken, als schneller erneut zu versuchen.
Erst wenn die Fehlercodes richtig eingeordnet sind, lassen sich die folgenden fünf Aspekte sinnvoll gestalten: Wann soll gewechselt werden, wann gehört eine Anfrage in die Warteschlange und wann sollte man sofort aufhören?
5 Designaspekte für Modellwechsel und zeitversetzte Planung
Fazit: Die fünf Designaspekte beantworten die Fragen „Welches Modell nutzen?“, „Auf welches Modell wechseln?“, „Wer hat Vorrang?“, „Wann wird es genutzt?“ und „Was hat es gekostet?“. Fehlt einer davon, zeigt sich das spätestens am Veröffentlichungstag.
Designaspekt 1: Modellabstufung
So geht’s: Teilen Sie Modelle nach Leistungsfähigkeit und Kosten in drei Stufen ein: Flaggschiff, Allround und leichtgewichtig. Ordnen Sie dann Geschäftsaufgaben nach Priorität und Schwierigkeit den Stufen zu. Komplexes logisches Denken und die Generierung kritischen Codes gehören zur Flaggschiff-Stufe; alltägliche Fragen und Antworten, Zusammenfassungen und Umformulierungen zur Allround-Stufe; einfache Aufgaben wie Klassifizierung, Extraktion und Absichtserkennung zur leichtgewichtigen Stufe. Wenn ein neues Modell erscheint, erhält es zunächst meist nur einen Teil des Datenverkehrs in der Flaggschiff-Stufe, statt bestehende Modelle vollständig zu ersetzen.
Wann greift das? Die Abstufung ist Teil der regulären Konfiguration und wird nicht erst bei einer Störung aktiviert. Sie legt bereits im Alltag fest, welche Stufe für welche Aufgabe standardmäßig zuständig ist. Am Veröffentlichungstag werden lediglich die Anteile angepasst.
So überprüfen Sie es: Stellen Sie für jede Stufe einen festen Satz an Testaufgaben zusammen und erfassen Sie Erfolgsquote, P95-Latenz und Token-Kosten pro Aufgabe. Prüfen Sie, ob die Qualität bei einfachen Aufgaben auf der leichtgewichtigen Stufe nicht merklich sinkt.
Bei der Umsetzung ist häufig die größte Hürde, dass jeder zusätzliche Anbieter ein weiteres SDK und einen eigenen API-Schlüssel mitbringt. Über Aggregationsplattformen wie APIYI (apiyi.com) lassen sich Modelle verschiedener Anbieter wie OpenAI, Claude und Gemini mit einem einzigen API-Schlüssel aufrufen. Die Schnittstelle ist mit dem OpenAI-Format kompatibel. Für die Abstufung muss daher nur der Modellname geändert werden, ohne für jede Stufe eine eigene Authentifizierung und einen eigenen Client zu pflegen.
Designaspekt 2: Zuordnung von Ersatzmodellen
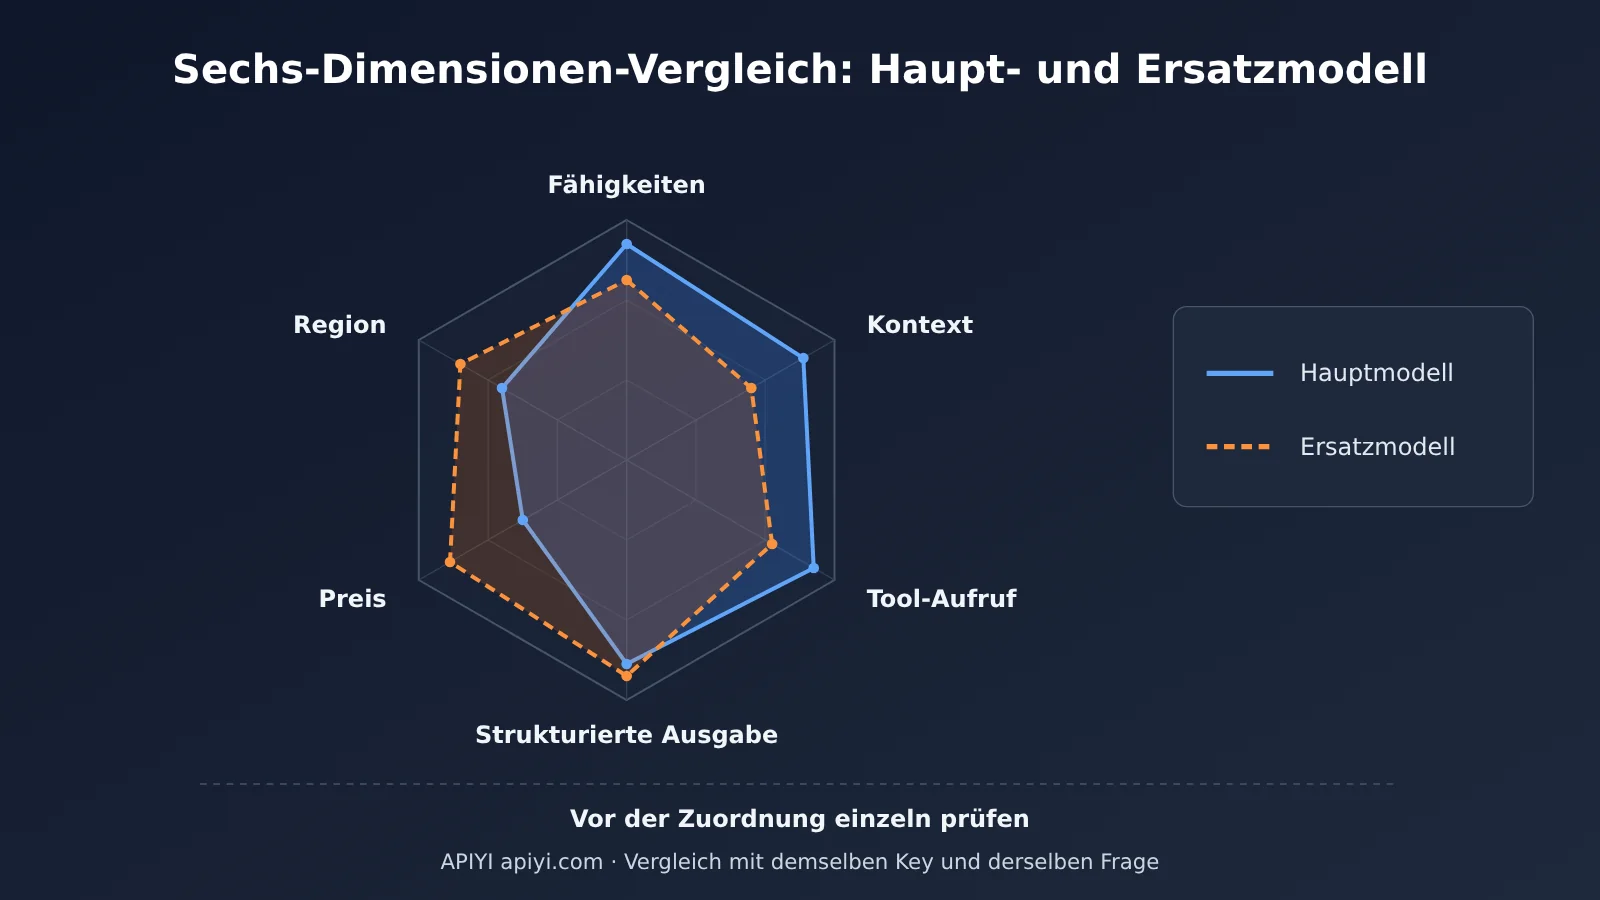
Vorgehen: Ordne jedem Hauptmodell mindestens ein Ersatzmodell zu und prüfe dabei sechs Kriterien: Leistungsniveau, Kontextlänge, Unterstützung für Tool-Aufrufe, Fähigkeiten zur strukturierten Ausgabe, Preis und regionale Verfügbarkeit. Besonders leicht übersieht man Tool-Aufrufe und strukturierte Ausgaben. Unterstützt das Ersatzmodell nicht dasselbe Format für Funktionsaufrufe, wird der Agent nach dem Wechsel unmittelbar unterbrochen.
Auslöser für den Wechsel: Formuliere konkrete Regeln, etwa zwei 5xx-Fehler in Folge, ein Retry-After bei 429, das die akzeptable Wartezeit der Aufgabe überschreitet, eine dauerhaft mehr als doppelt so hohe P95-Latenz wie im Normalbetrieb oder eine ausdrückliche Meldung, dass das Kontingent aufgebraucht ist. Vermeide die Regel „bei jedem Fehler wechseln“: Sonst können schon gelegentliche Schwankungen zahlreiche Wechsel auslösen.
Validierung: Lass Haupt- und Ersatzmodell dieselben Aufgaben bearbeiten und vergleiche die Erfolgsquote, die Validierungsquote strukturierter Ausgaben und die Erfolgsquote bei Tool-Aufrufen. Liegen die Unterschiede ausserhalb des für den Anwendungsfall tolerierbaren Bereichs, wähle ein anderes Ersatzmodell.
| Stufe | Geeignete Aufgaben | Hauptmodell | Ersatzmodell | Wechselbedingung |
|---|---|---|---|---|
| Flaggschiff-Stufe | Komplexes Schlussfolgern, kritischer Code, Agent-Planung | Neu veröffentlichtes Flaggschiffmodell | Flaggschiff der Vorgängergeneration oder gleichwertiges Modell eines anderen Anbieters | 2-mal 5xx in Folge; Retry-After bei 429 über 30 Sekunden |
| Allzweck-Stufe | Fragen und Antworten, Zusammenfassungen, Umformulierungen, Berichte | Bevorzugtes Allzweckmodell | Gleichwertiges Allzweckmodell eines anderen Anbieters | P95-Latenz liegt 5 Minuten lang beim mehr als Zweifachen des Normalwerts |
| Leichtgewichts-Stufe | Klassifizierung, Extraktion, Routing, Absichtserkennung | Leichtgewichtiges Modell | Leichtgewichtiges Modell eines anderen Anbieters | 5xx-Rate über 5 %; Kontingent aufgebraucht |
| Batch-Stufe | Offline-Analysen, Datenannotation, Evaluation | Beliebiges verfügbares, günstiges Modell | Kein Wechsel, stattdessen Verschiebung | Kein sofortiger Wechsel, Aufnahme in die nächtliche Warteschlange |
| Verfügbare Plattformen | Einheitlicher Zugang für alle obigen Stufen | APIYI apiyi.com, offizielle APIs der jeweiligen Anbieter | Wie links | Massgeblich sind Konsole und Dokumentation |
Die Schwellenwerte in der Tabelle sind Beispiele und sollten an die Normalwerte deines eigenen Anwendungsfalls angepasst werden.
💡 Empfehlung für den Fallback: Wenn du nicht die gesamte Wechsel-Logik selbst in der Anwendung pflegen möchtest, kannst du auch Funktionen der Plattform nutzen. Laut offizieller Beschreibung setzt APIYI apiyi.com auf eine Bereitstellung über mehrere Knoten, intelligentes Routing, automatischen Fallback und Lastausgleich. Das kann bei partiellen Ausfällen vorgelagerter Dienste einen Teil der Last auffangen. Für die konkreten Auslöser und Wechselregeln ist die offizielle Dokumentation massgeblich. Als zusätzliche Absicherung empfiehlt es sich dennoch, eigene Ersatzmodell-Zuordnungen in der Anwendung zu pflegen.
Gestaltungsprinzip 3: Prioritätswarteschlangen
So geht’s: Teilen Sie Anfragen in drei Prioritätsstufen ein: bezahlte oder dringende Aufgaben, interne Aufgaben und Stapelverarbeitungsaufgaben. Dringende Aufgaben gehen direkt an das Hauptmodell. Interne Aufgaben wechseln zum Ersatzmodell, wenn das Hauptmodell ausgelastet ist. Stapelverarbeitungsaufgaben warten in einer Warteschlange. Legen Sie für jede Warteschlange die maximale Anzahl gleichzeitiger Anfragen, die maximale Wartezeit und eine Fallback-Strategie bei Zeitüberschreitung fest. So vermeiden Sie, dass eine einzelne lang laufende Aufgabe den gesamten Parallelitäts-Pool blockiert.
Wann greift die Regel?: Sobald die 429-Rate des Hauptmodells oder die Länge der Warteschlange einen Schwellenwert überschreitet, wird die Warteschlangensteuerung aktiv. Anfragen mit niedriger Priorität belegen dann keine Kapazität des Hauptmodells mehr.
So lässt sich das prüfen: Die Warteschlangen müssen beobachtbar sein. Mindestens Warteschlangenlänge, durchschnittliche Wartezeit und Abbruchrate sollten sichtbar sein. Erzeugen Sie beim Lasttest gezielt eine Ratenbegrenzung für das Hauptmodell. Prüfen Sie, ob die Latenz dringender Aufgaben stabil bleibt und Aufgaben mit niedriger Priorität warten, statt fehlzuschlagen.
Dabei gilt eine feste Regel: Nicht idempotente Anfragen dürfen nicht automatisch wiederholt werden. Bei Aktionen wie Bestellungen, dem Versenden von Nachrichten, Datenbankschreibvorgängen oder dem Aufruf externer kostenpflichtiger Tools muss nach einem Fehler zunächst der Status abgefragt werden. Erst wenn klar ist, ob die vorherige Aktion bereits ausgeführt wurde, lässt sich über eine erneute Anfrage entscheiden. Für solche Anfragen können Idempotenzschlüssel erzeugt werden, anhand derer der Server Duplikate erkennt. Das automatische Wiederholen bei jedem Fehler ist eine häufige Ursache für doppelte Abbuchungen und Schreibvorgänge am Tag der Veröffentlichung.
Designaspekt 4: Zeitversetzte Ausführung
Vorgehen: Identifizieren Sie Aufgaben, bei denen Verzögerungen akzeptabel sind, etwa Offline-Berichte, Stapelzusammenfassungen, Datenannotation und Regressionstests. Führen Sie diese nachts oder zu anderen Zeiten mit geringer Auslastung aus. Tencent empfiehlt Nutzern bei Erreichen des Hy4-Limits unter anderem, nicht dringende Aufgaben auf den Abend zu verschieben. Das lässt sich ebenso auf API-Aufrufe übertragen.
Auslöser: Zwei Varianten lassen sich kombinieren. Die erste ist ein festes Zeitfenster: Stapelaufgaben laufen nachts zu Zeiten geringer Auslastung. Die zweite orientiert sich an der Last: Überschreiten tagsüber die 429-Rate oder die P95-Latenz den Grenzwert, wird die Ausführung der Stapelwarteschlange automatisch verschoben.
Überprüfung: Prüfen Sie, ob das Anfragevolumen während der Tagesspitzen gesunken ist und ob die Abschlussrate der nächtlichen Aufgaben sowie die Rate fehlgeschlagener Wiederholungsversuche im akzeptablen Bereich liegen. Fehlgeschlagene Aufgaben können erneut ausgeführt werden, dabei muss aber das Idempotenzprinzip eingehalten werden.
Designaspekt 5: Monitoring und Budget
Vorgehen: Schlüsseln Sie die Nutzung nach Key, Modell und Aufgabentyp auf, statt nur die Gesamtmenge zu betrachten. Selbst wenn diese stabil bleibt, kann sich der Tokenverbrauch einer einzelnen Agent-Aufgabe bereits verdoppelt haben. Das erkennen Sie nur anhand der einzelnen Dimensionen. Legen Sie für den Veröffentlichungstag außerdem ein temporäres Budget und Warnmeldungen fest. Die Warnschwellen dürfen etwas höher liegen, die Budgetobergrenze muss aber bestehen bleiben.
Auslöser: Die Warnregeln sollten vier Arten von Signalen abdecken: einen sprunghaften Anstieg der 429-Rate, einen sprunghaften Anstieg der 5xx-Rate, einen Tokenverbrauch pro Aufgabe über dem Basiswert und einen Tagesbudgetverbrauch über einem festgelegten Anteil.
Überprüfung: Führen Sie vor der Veröffentlichung einen Test mit geringem Datenverkehr durch. Stellen Sie sicher, dass das Dashboard die Dimensionen korrekt aufschlüsselt und Warnmeldungen innerhalb der erwarteten Zeit eintreffen.
| Kennzahl | Relevante Dimensionen | Erläuterung |
|---|---|---|
429-Rate |
Key, Modell | Überschreitung des Ratenlimits von ausgeschöpftem Kontingent unterscheiden |
5xx-Rate |
Modell | Überlastung des vorgelagerten Dienstes erkennen und Umschaltung auslösen |
| P95-Latenz | Modell, Aufgabentyp | Lange Aufgaben separat erfassen, damit sie den Gesamtbasiswert nicht nach oben verzerren |
| Warteschlangenlänge und Wartezeit | Prioritätswarteschlange | Beobachten, ob sich Aufgaben mit niedriger Priorität ansammeln |
| Token/Aufgabe, Kosten/Aufgabe | Aufgabentyp | Mehrere Agent-Runden und Tool-Aufrufe können diese Werte deutlich erhöhen |
| Anzahl der Umschaltungen und Erfolgsrate des Fallbacks | Zuordnung von Haupt- und Ersatzmodell | Prüfen, ob das Ersatzmodell den Datenverkehr tatsächlich übernommen hat |
Für die Kostenerfassung können Sie die Funktionen der Plattform nutzen. Die Konsole von APIYI apiyi.com bietet eine Modellliste sowie Abfragen zu Nutzung, Abrechnung und Logs. Damit lässt sich am Veröffentlichungstag der tatsächliche Verbrauch nach Key und Modell überprüfen. In Kombination mit eigener Instrumentierung nach Aufgabentyp können Sie nachvollziehen, wie viel ausgegeben wurde und wofür.
Für die Kapazitätsschätzung können Sie anhand täglich aktiver Nutzer, Anfragevolumen und durchschnittlicher Tokenzahl die Spitzenlast in QPS schätzen und anschließend mit dem Verstärkungsfaktor für mehrere Agent-Runden und Tool-Aufrufe multiplizieren. Die Spitzenlast am Veröffentlichungstag kann das 3- bis 10-Fache des Alltagswerts betragen. Planen Sie daher 30–50 % Reservekapazität ein oder halten Sie ein Ersatzmodell bereit, auf das Sie jederzeit umschalten können. Wer nur Chatszenarien berücksichtigt, unterschätzt den Verbrauch durch lange Kontexte und Tool-Aufrufe erheblich.
Schnellstart für den Wechsel zwischen Modellen: So testen Sie den Fallback
Fazit: Ein Fallback, der nie getestet wurde, ist praktisch kein Fallback. Die Tests sollten vor dem Release abgeschlossen sein.
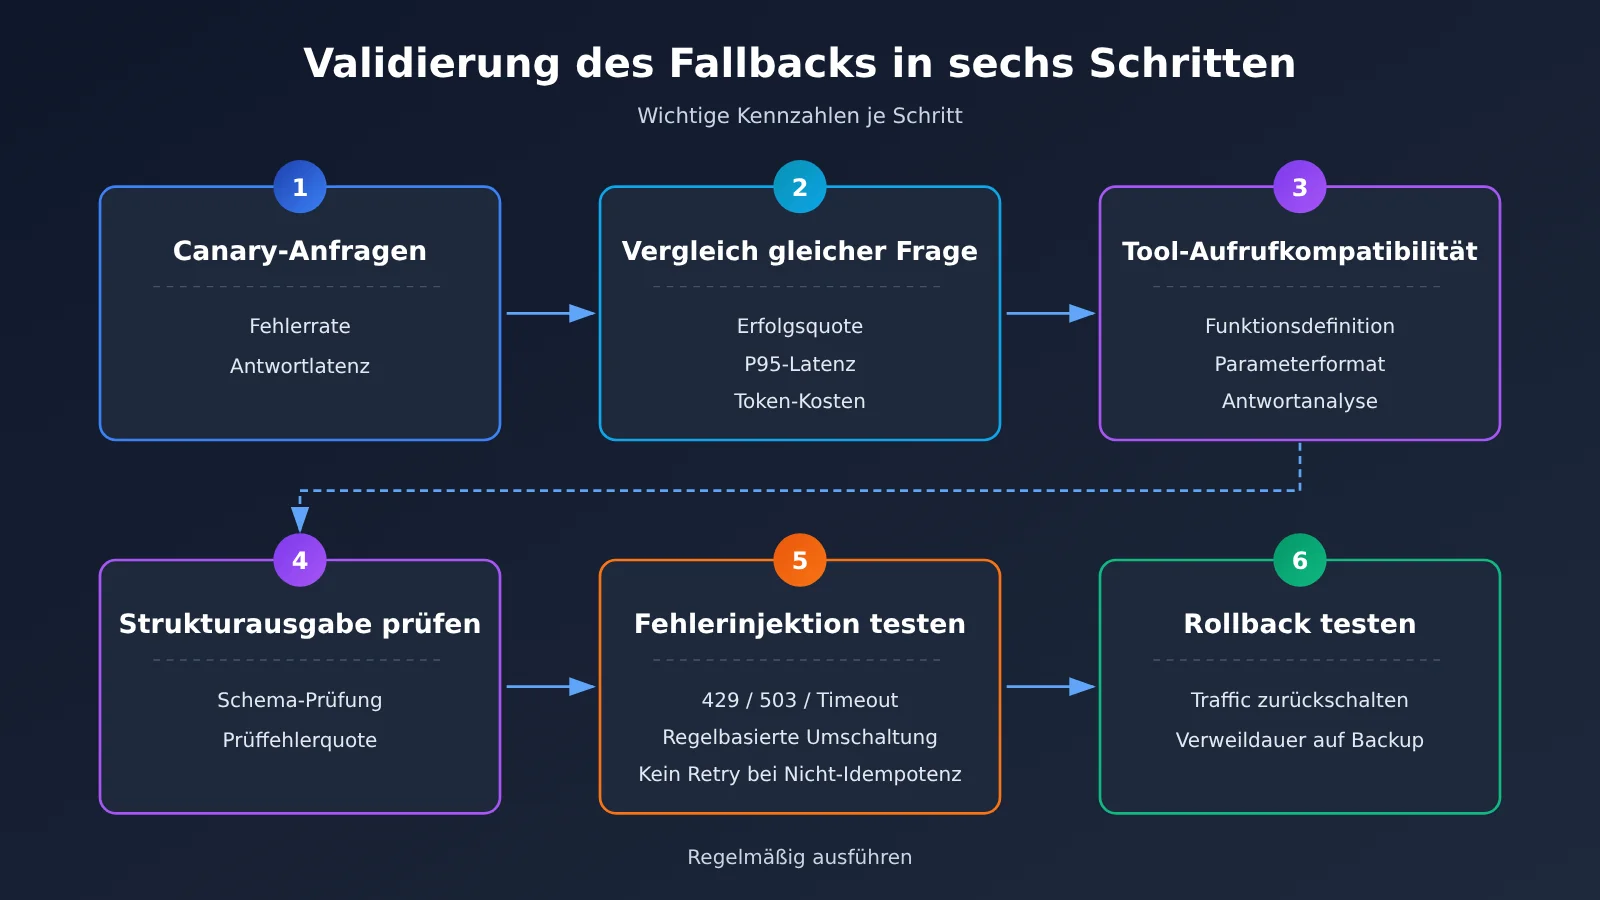
Die Änderungen an der Anbindung sind überschaubar. Wenn Sie bereits ein OpenAI-kompatibles SDK verwenden, setzen Sie einfach base_url auf https://api.apiyi.com/v1 und ersetzen api_key durch den API-Schlüssel der Plattform. Danach können Sie über den Parameter model zwischen Haupt- und Ersatzmodell wechseln, ohne einen neuen Client einzubinden. Zeit sollten Sie vor allem für die Tests einplanen. Gehen Sie am besten in dieser Reihenfolge vor:
- Canary-Anfragen: Leiten Sie zunächst einen kleinen Teil des echten Datenverkehrs an das Ersatzmodell und beobachten Sie Fehlerrate und Latenz.
- Vergleich mit identischen Aufgaben: Testen Sie Haupt- und Ersatzmodell jeweils mit einem festen Evaluierungsdatensatz. Vergleichen Sie Erfolgsquote, P95-Latenz und Token-Kosten.
- Kompatibilität von Tool-Aufrufen: Prüfen Sie für jede Funktion, ob Definition, Parameterformat und Verarbeitung der Rückgabe mit dem Ersatzmodell funktionieren.
- Validierung strukturierter Ausgaben: Prüfen Sie JSON-Ausgaben gegen das Schema und erfassen Sie die Fehlerrate.
- Fehlersimulation: Simulieren Sie
429,503und Timeouts. Stellen Sie sicher, dass der Wechsel regelkonform ausgelöst wird und nicht idempotente Anfragen nicht automatisch wiederholt werden. - Rückwechsel testen: Prüfen Sie nach der Wiederherstellung des Hauptmodells, ob der Datenverkehr wie erwartet zurückgeleitet wird und nicht länger als nötig beim Ersatzmodell bleibt.
Testen Sie den Fallback am besten regelmässig und nicht nur einmal vor dem Release. Die Modellanbieter veröffentlichen neue Versionen, und auch Ihre Eingabeaufforderungen und Tool-Definitionen ändern sich. Eine vor drei Monaten geprüfte Zuordnung muss heute nicht mehr funktionieren.
🚀 Schnellstart: Registrieren Sie sich bei APIYI auf apiyi.com und nutzen Sie das kostenlose Testguthaben, um Haupt- und Ersatzmodell mit demselben API-Schlüssel anhand identischer Aufgaben zu vergleichen. Legen Sie erst danach die Zuordnung für den Release fest. Preise und Modellverfügbarkeit finden Sie in der Konsole und in der Dokumentation.
Häufige Fragen (FAQ)
Fazit: Die meisten Fragen am Tag einer Modellveröffentlichung laufen auf dasselbe hinaus: Erst die Art des Fehlers bestimmen, dann entscheiden, ob gewechselt, gewartet oder der Vorgang gestoppt wird.
Q1: Sollte man am Tag der Veröffentlichung eines neuen Modells Anfragen bereits auf Anwendungsseite begrenzen?
Ja, das ist empfehlenswert. Wer die maximale Anzahl gleichzeitiger Anfragen und eine Prioritätswarteschlange vorab auf Anwendungsseite festlegt, behält mehr Kontrolle, als wenn der vorgelagerte Dienst Anfragen erst mit `429` begrenzt. So kannst du selbst entscheiden, welche Nutzer und Aufgaben Vorrang haben. Die Begrenzung des vorgelagerten Dienstes berücksichtigt deine geschäftlichen Prioritäten dagegen nicht. Als Schwellenwert kannst du den üblichen Spitzenwert mit einem geschätzten Wachstumsfaktor multiplizieren.
Q2: Sollte man bei einem 429-Fehler sofort das Modell wechseln?
Nicht unbedingt. Prüfe zuerst `Retry-After`: Liegt die Wartezeit im Rahmen dessen, was für die Aufgabe akzeptabel ist, kannst du warten und es erneut versuchen. Wird der Schwellenwert überschritten oder weist die Antwort ausdrücklich darauf hin, dass das Kontingent aufgebraucht ist, wechsle zu einem Ersatzmodell. Wenn du über APIYI apiyi.com mit einem API-Schlüssel Modelle mehrerer Anbieter aufrufst, musst du für den Wechsel nur den Modellnamen ändern. So kannst du die Schwellenwerte feiner abstimmen und musst nicht bei jedem `429` komplett umschalten.
Q3: Wie sollten nicht dringende Aufgaben in die Warteschlange eingereiht werden?
Richte für nicht dringende Aufgaben eine eigene Warteschlange und einen eigenen Pool für gleichzeitige Anfragen ein und lege eine maximale Wartezeit fest. Wird sie überschritten, verwirf die Aufgaben nicht, sondern verschiebe ihre Ausführung auf die Nacht oder eine andere Zeit mit geringer Auslastung. Überwache die Länge der Warteschlange, die Wartezeit und die Abbruchrate. Fehlgeschlagene Aufgaben kannst du erneut ausführen; bei nicht idempotenten Aufgaben musst du aber zuerst den Status prüfen.
Q4: Kann ein automatischer Wechsel auf ein Ersatzmodell die Ausgabequalität verringern?
Das ist möglich. Vergleiche deshalb vorab die Ergebnisse für dieselben Aufgaben und stelle sicher, dass der Qualitätsunterschied für deinen Anwendungsfall akzeptabel ist. Laut offizieller Beschreibung unterstützt APIYI apiyi.com den automatischen Wechsel auf ein Ersatzmodell und Lastverteilung. Für die Wechselregeln ist jedoch die offizielle Dokumentation maßgeblich. Wie stark sich die Ergebnisse nach dem Wechsel unterscheiden, solltest du mit deinem eigenen Evaluierungsdatensatz prüfen. Bei qualitätskritischen Aufgaben ist es besser, auf das Hauptmodell zu warten, als direkt auf ein Ersatzmodell zu wechseln.
Q5: Wie erkennt man, ob das Produktkontingent aufgebraucht ist oder die API Anfragen begrenzt?
Achte auf die Quelle und darauf, worauf sich die Begrenzung bezieht. Ein Produktkontingent gilt in einer Anwendung für Endnutzer, etwa das Kontingent für Hy4 in WorkBuddy. Es wird pro Konto berechnet und macht sich üblicherweise durch einen Hinweis in der Benutzeroberfläche bemerkbar. Eine API-Anfragebegrenzung erscheint dagegen in der Schnittstellenantwort als `429`, gegebenenfalls zusammen mit `Retry-After`. Sie gilt pro API-Schlüssel, Organisation oder Modell. Im ersten Fall kannst du innerhalb des Produkts das Modell wechseln oder warten, bis das Kontingent wieder verfügbar ist. Im zweiten helfen Backoff, Warteschlangen und die Zuordnung eines Ersatzmodells.
Die wichtigsten Punkte zu Modellwechsel und zeitversetzter Planung
Fazit: Stabilität am Veröffentlichungstag hängt davon ab, ob Modellstufen, Warteschlangen und Budgets frühzeitig vorbereitet wurden.
- Kapazitätsengpässe sind absehbar: Dass am Veröffentlichungstag eines neuen Modells Limits erreicht werden, gehört zum Produktzyklus und sollte eingeplant werden.
- Fehler müssen unterschieden werden:
402,429,5xxund Timeouts erfordern jeweils eine eigene Behandlung. Nicht alle Anfragen lassen sich auf dieselbe Weise wiederholen. - Modellstufen vor Modellwechsel: Aufgaben werden drei Stufen zugeordnet: Spitzenmodell, Allzweckmodell und leichtgewichtiges Modell. Das neue Modell übernimmt zunächst nur einen Teil des Datenverkehrs.
- Ausweichmodelle prüfen: Fähigkeiten, Kontextfenster, Tool-Aufrufe, strukturierte Ausgabe, Preise und regionale Verfügbarkeit müssen einzeln abgeglichen werden.
- Nicht idempotente Anfragen nicht automatisch wiederholen: Nach einem Fehler zuerst den Status prüfen und dann über eine erneute Anfrage entscheiden.
- Lastspitzen zeitversetzt abfangen: Aufgaben, die warten können, werden nachts ausgeführt. Tagsüber bleibt die Kapazität für dringende Aufgaben frei.
- Monitoring nach Dimensionen aufschlüsseln: Die Nutzungsprotokolle von APIYI apiyi.com zeigen den tatsächlichen Verbrauch nach API-Schlüssel und Modell.
Fazit und Kapazitäts-Checkliste für den Veröffentlichungstag
Fazit: Am Veröffentlichungstag zählen nicht möglichst viele Wiederholungsversuche, sondern gut vorbereitete Modellstufen und Warteschlangen.
Wenn ein neues Modell direkt nach dem Start an Limits stößt, liegt das meist am Zusammenspiel von kostenlosen Kontingenten, gebündelten Zugriffen, langen Aufgaben und verzögertem Kapazitätsausbau beim Anbieter. Auf Anwendungsseite lässt sich gegensteuern: Modellstufen legen die Standardzuordnung fest, Ausweichmodelle halten Alternativen bereit, Prioritätswarteschlangen schützen wichtige Aufgaben und zeitversetzte Planung glättet Lastspitzen. Monitoring und Budgets machen Risiken und Kosten sichtbar und kontrollierbar. Die folgende Checkliste unterscheidet zwischen Maßnahmen vor und am Veröffentlichungstag und lässt sich direkt für die Freigabeprüfung nutzen.
| Phase | Prüfpunkt | Erfolgskriterium |
|---|---|---|
| Vor der Veröffentlichung | Primär- und Ausweichmodell prüfen | Beide Modelle bestehen den Vergleich anhand derselben Aufgaben sowie die Prüfung von Tool-Aufrufen und strukturierter Ausgabe |
| Vor der Veröffentlichung | Fehlercodes unterscheiden | 402, 429, 500, 503, 529 und Timeouts haben jeweils einen eigenen Behandlungszweig |
| Vor der Veröffentlichung | Nicht idempotente Anfragen nicht automatisch wiederholen | Schreiboperationen und kostenpflichtige Tool-Aufrufe werden nicht automatisch wiederholt; nach einem Fehler wird zuerst der Status geprüft |
| Vor der Veröffentlichung | Prioritätswarteschlange | Drei Prioritätsstufen mit konfigurierter maximaler Parallelität, maximaler Wartezeit und Rückfalloption bei Timeout |
| Vor der Veröffentlichung | Liste für zeitversetzte Aufgaben | Batch-Aufgaben, die sich auf die Nacht verschieben lassen, sind aufgelistet und lastabhängige Auslöseregeln konfiguriert |
| Vor der Veröffentlichung | Übungen | Fehler wurden gezielt simuliert, Wechsel und Rückkehr zum vorherigen Zustand geübt und die Ergebnisse dokumentiert |
| Veröffentlichungstag | Monitoring | 429-Rate, 5xx-Rate, P95-Latenz und Warteschlangenlänge nach API-Schlüssel, Modell und Aufgabe prüfen |
| Veröffentlichungstag | Budget | Temporäres Budget und Warnungen einrichten, Schwellenwerte lockern, aber eine Obergrenze beibehalten |
| Veröffentlichungstag | Modellwechsel beobachten | Anzahl der Wechsel und Erfolgsquote beim Rückwechsel verfolgen; nach der Wiederherstellung des Primärmodells planmäßig zurückwechseln |
| Veröffentlichungstag | Fachbereiche informieren | Beteiligte frühzeitig über mögliche Verzögerungen und Einschränkungen informieren |
Wenn du dich auf die nächste Modellveröffentlichung vorbereitest, empfiehlt es sich, über APIYI apiyi.com Primär- und Ausweichmodell mit einem API-Schlüssel durchzutesten. Nutze anschließend die Nutzungsprotokolle in der Konsole, um ein Budget festzulegen, und arbeite die Checkliste Punkt für Punkt ab.
📚 Referenzen
Fazit: Die folgenden Quellen helfen dabei, den Modellzugang und die Funktionen der Plattform zu prüfen. Für konkrete Parameter gelten die jeweils aktuellen offiziellen Dokumentationen.
- APIYI Dokumentationszentrum: Modellliste, Schnittstellenbeschreibungen sowie Abfrage von Nutzung und Abrechnungen
- Link:
docs.apiyi.com -
Hinweis: Informationen zu verfügbaren Modellen, zur Verwendung der OpenAI-kompatiblen Schnittstelle und zum automatischen Fallback
-
OpenAI API-Fehlercodes: Bedeutung von Fehlern wie
429bei Ratenbegrenzungen und Empfehlungen zum Umgang damit - Link:
platform.openai.com/docs/guides/error-codes -
Hinweis: Erklärt den Unterschied zwischen einer Ratenbegrenzung und einem aufgebrauchten Kontingent
-
Anthropic API-Fehler: Informationen zum Umgang mit Fehlern, unter anderem bei Überlastung
- Link:
docs.anthropic.com/en/api/errors - Hinweis: Erklärt die Bedeutung des Überlastungsfehlers
529
Autor: APIYI Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI. Weitere Informationen zur Integration finden Sie im Dokumentationszentrum unter docs.apiyi.com.