Anmerkung des Autors: Worin unterscheidet sich DeepSeeks quelloffener Super-Agent-Forschungsprototyp wirklich von Claude Code und Codex? Dieser Artikel vergleicht sechs Dimensionen auf drei Ebenen – Modell, Programmierwerkzeug und Steuerungssystem – und gibt Empfehlungen für unterschiedliche Arbeitsweisen.
Am 31. Oktober 2026 veröffentlichte das DeepSeek-Harness-Team den technischen Artikel „Super-Agent-Design erkunden: Auf dem Weg zu autonomeren Agent-Systemen“ und stellte den zugehörigen Prototyp dsh-superagent-prototype auf dem offiziellen GitHub-Account unter MIT-Lizenz als Open Source bereit. Die zweistufige Steuerungsarchitektur mit dauerhaft aktivem Router und unabhängigen Workern löste schnell Diskussionen aus. Medien wie Bloomberg und die South China Morning Post berichteten darüber im Zusammenhang mit dem Wettbewerb gegen Claude Code und Codex.
Dies ist kein weiterer Artikel nach dem Motto „Wer ersetzt wen?“ Das Repository selbst ist ausdrücklich als Forschungsprototyp gekennzeichnet, und Claude Code und Codex sind längst keine Werkzeuge mehr, die auf eine einzelne Sitzung beschränkt sind. Beim Vergleich von DeepSeek Super-Agent mit Claude Code und Codex lohnt sich vielmehr die Frage: Entstehen die Unterschiede durch das zugrunde liegende Modell oder durch das Steuerungssystem des Agenten?
Das nehmen Sie mit: Nach der Lektüre können Sie einordnen, auf welcher Ebene sich die drei Angebote bewegen, was DeepSeeks Designschwerpunkt in der Praxis bedeutet und welche Werkzeugkombination zu Ihrer Arbeitsweise passt.
DeepSeek Super-agent: Das Wichtigste auf einen Blick
Zunächst zur Einordnung: DeepSeek Super-agent ist kein neues Basismodell, sondern eine Agentenarchitektur, die auf einem großen Sprachmodell aufbaut. Öffentlich verfügbar ist bisher nur ein Forschungsprototyp, kein offizielles kommerzielles Produkt.
| Information | Details |
|---|---|
| Veröffentlichungsdatum | 31. Oktober 2026 (technischer Artikel und Repository wurden am selben Tag veröffentlicht) |
| Herausgeber | DeepSeek-Harness-Team |
| Projektname | deepseek-ai/dsh-superagent-prototype, hauptsächlich in TypeScript entwickelt |
| Open-Source-Lizenz | MIT; kostenlos herunterladbar und veränderbar, bei Einhaltung der Lizenzbedingungen auch für kommerzielle Projekte nutzbar |
| Projektstatus | Forschungsprototyp; ein Veröffentlichungsdatum für ein fertiges Produkt und ein gesonderter Abonnementpreis wurden nicht bekannt gegeben |
| Voraussetzungen | DeepSeek-Harness-Umgebung und ein konfigurierter Modellanbieter |
| Aktueller Umfang | Überwacht ein einzelnes GitHub-Repository, mit optionaler Feishu-Anbindung, und bearbeitet Aufgaben vom Issue bis zum PR |
Am 2. November zeigte die Projektseite rund 8.900 Stars und 898 Forks; diese Zahlen ändern sich laufend. Wichtig: Die Zahl der Stars zeigt lediglich das Interesse am Projekt. Sie sagt weder etwas über die tatsächliche Zahl der Installationen noch über die Erfolgsquote beim Programmieren aus.
Welches Problem will DeepSeek Super-agent lösen?
Der Ausgangspunkt des DeepSeek-Teams ist interessant: Je leistungsfähiger Modelle bei einzelnen Aufgaben werden, desto mehr verschiebt sich der Engpass von den Fähigkeiten des Modells zur menschlichen Aufmerksamkeit. Nach Erfahrung des Teams kann eine Person meist nur etwa drei bis fünf aktive Agenten-Sitzungen effektiv betreuen. Gründe dafür sind unter anderem verstreuter Kontext, häufige Fensterwechsel, manuelle Anweisungen für den nächsten Schritt nach Abschluss einer Aufgabe, blockierte Sitzungen durch Tool-Aufrufe und unterbrochene Aufgaben, wenn das lokale Gerät in den Ruhezustand wechselt.
Die Zahl von drei bis fünf Sitzungen beruht auf der Erfahrung des DeepSeek-Teams und ist keine Branchenstatistik. Sie macht aber die Forschungsrichtung von Super-agent deutlich: Es geht nicht darum, das Modell intelligenter zu machen, sondern die Steuerung von Sitzungen, die Verarbeitung von Ereignissen und das Kontextmanagement vom Menschen auf das System zu übertragen. Dafür nennt das Team vier angestrebte Eigenschaften: Continuous (Kontinuität), Productive (hohe Produktivität), Proactive (Eigeninitiative) und Persistent (Dauerhaftigkeit). Das sind Designziele und bedeutet nicht, dass der Prototyp sie bereits vollständig erreicht.
DeepSeek Super-agent im Vergleich zu Claude Code und Codex: Drei Ebenen auseinanderhalten
Bevor wir fragen, „wer besser ist“, müssen wir festhalten: Die drei Angebote liegen nicht auf derselben Produktebene. Claude Code und Codex sind Agent-Produkte mit zugehörigem Ökosystem für Programmieraufgaben. Super-agent konzentriert sich dagegen auf eine übergeordnete Betriebsschicht für Agents, die dauerhaft online ist, auf Ereignisse reagiert und mehrere Aufgaben koordiniert. Das eigentliche Reasoning und die Ausführung von Tools hängen weiterhin vom zugrunde liegenden Modell und dem DeepSeek Harness ab.
Der Vergleich lässt sich deshalb in drei Ebenen aufteilen: Die Modellfähigkeit bestimmt die Qualität einzelner Reasoning-Schritte und des generierten Codes. Die Programmierwerkzeuge entscheiden darüber, ob Dateien gelesen und geschrieben, Tests ausgeführt und Pull Requests erstellt werden können. Das Scheduling-System bestimmt, wie mehrere Aufgaben entgegengenommen, verteilt, verfolgt und ausgeliefert werden. Wer diese Ebenen vermischt, kommt leicht zu irreführenden Schlussfolgerungen.
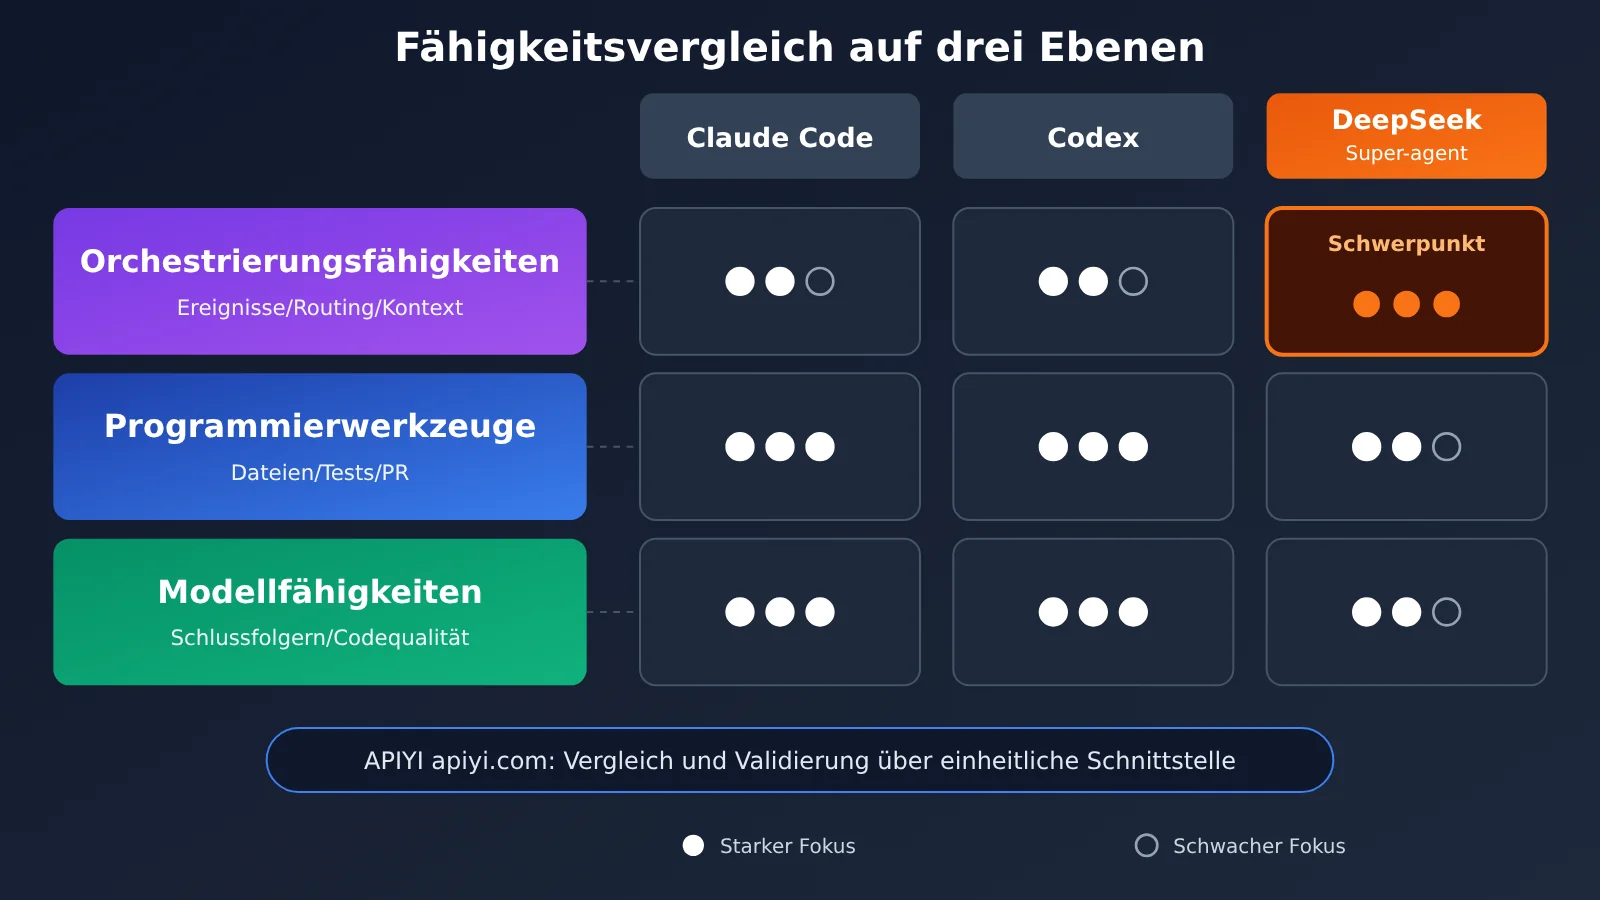
Im Folgenden vergleichen wir die derzeit öffentlich bekannten Mechanismen anhand von sechs Kriterien. Wichtig: Die Tabelle vergleicht Mechanismen, keine Leistungsrangfolge unter gleichen Bedingungen.
| Vergleichskriterium | DeepSeek-Super-agent-Prototyp | Claude-Code-Ökosystem | Codex-/OpenAI-Ökosystem |
|---|---|---|---|
| Einzelne Programmieraufgaben | Abhängig vom Harness und dem gewählten Modell; Ausführung durch Worker | Ausgereifter Programmier-Agent mit CLI, Desktop- und Cloud-Version | Ausgereifter Programmier-Agent für lokale und Cloud-Nutzung |
| Zusammenarbeit mehrerer Agents | Zwei Ebenen: Router + Worker | Subagents, experimentelle Agent Teams | Parallele Sessions, Worktrees; Multi-Agent-Funktionen über die API |
| Ereignisgesteuerte Auslösung | GitHub, optional Feishu | GitHub Actions, Channels (Forschungsvorschau) | Automatisierung durch Ereignisse unterstützter Anwendungen, GitHub-Actions-Workflows |
| Dauerhafter Betrieb im Hintergrund | Worker-Sessions; geräteübergreifender Dauerbetrieb wird noch konzeptionell untersucht | Hintergrund-Agents, geplante Cloud-Aufgaben | Cloud-Aufgaben, geplante Hintergrundaufgaben |
| Kontextverwaltung | Dauerhaft laufender Router verwaltet den globalen Kontext, Worker sind isoliert | Unabhängige Kontexte für Subagents, gemeinsame Aufgabenliste im Team | Cloud-Aufgaben mit isolierten Arbeitsbereichen, Zusammenfassung durch den Haupt-Agent |
| Bereitstellungsaufwand | Selbst gehostet; benötigt unter anderem Node.js, tmux und ein dediziertes GitHub-Konto | Fertiges Produkt mit niedriger Einstiegshürde | Fertiges Produkt mit niedriger Einstiegshürde |
Jede Zeile hat eine andere praktische Bedeutung. „Einzelne Programmieraufgaben“ bestimmt, wie sich das tägliche Arbeiten mit Code anfühlt. „Ereignisgesteuerte Auslösung“ und „Betrieb im Hintergrund“ entscheiden, ob Agents auch ohne Ihre Aufsicht arbeiten können. Die „Kontextverwaltung“ beeinflusst, ob sich viele Aufgaben gegenseitig stören. Und der „Bereitstellungsaufwand“ entscheidet unmittelbar darüber, ob ein Team bereit ist, zunächst Zeit zu investieren.
Claude Code bietet starke Multi-Agent-Funktionen
Laut der offiziellen Dokumentation von Anthropic verfügen Subagents in Claude Code über ein eigenes Kontextfenster. Sie lassen sich mit eigenen Systemanweisungen, eingeschränktem Tool-Zugriff und unterschiedlichen Modellen konfigurieren. Außerdem können sie im Hintergrund parallel recherchieren und Teile der Implementierung übernehmen. Die experimentellen Agent Teams gehen noch weiter: Ein Lead und mehrere Teammates arbeiten jeweils in einer eigenen Claude-Code-Sitzung, teilen sich eine Aufgabenliste und können sich direkt Nachrichten schicken. Die Funktion ist standardmäßig deaktiviert. Anthropic weist außerdem darauf hin, dass sie den Koordinationsaufwand und den Token-Verbrauch erhöht.
Für ereignisgesteuerte und länger laufende Aufgaben gibt es ebenfalls mehrere Möglichkeiten: claude-code-action kann auf @claude in Issues und PR-Kommentaren reagieren und bei entsprechender Konfiguration aus einem Issue einen PR erstellen. Channels leitet als Research Preview Chat-Nachrichten, Webhooks und CI-Ergebnisse über MCP an eine laufende Sitzung weiter. Die Sitzung muss dafür geöffnet bleiben. Hinzu kommen /loop innerhalb einer Sitzung sowie zeitgesteuerte Aufgaben in der Desktop-App und in der Cloud. Einige Aufgaben können in der Cloud weiterlaufen, nachdem der lokale Rechner ausgeschaltet wurde. Die Vorstellung, Claude Code könne nur passiv auf Eingaben warten, ist also längst überholt.
Codex und parallele Aufgaben: Produkt und API getrennt betrachten
Mit Git Worktree kann Codex für dasselbe Projekt mehrere unabhängige Arbeitsverzeichnisse erstellen. So können verschiedene Sitzungen parallel unterschiedliche Branches bearbeiten. Codex Cloud analysiert Code, implementiert Änderungen und führt Tests in isolierten Arbeitsumgebungen aus. Cloud-Aufgaben laufen auch weiter, wenn der lokale Rechner ausgeschaltet ist. Das ChatGPT- und Codex-Ökosystem unterstützt außerdem zeitgesteuerte Hintergrundaufgaben. Berechtigte Nutzer können zudem Ereignisse aus Anwendungen wie GitHub als Auslöser verwenden und PR-Aktivitäten filtern.
Ein Punkt führt leicht zu Verwechslungen: Die Multi-Agent-Funktionen der OpenAI Agents API und der Responses API – etwa wenn ein übergeordneter Agent Aufgaben an Subagents mit eigenem Kontext delegiert – sind API-Funktionen. Sie sind nicht automatisch mit den Standardfunktionen aller Codex-Oberflächen gleichzusetzen. Ebenso ist der im OpenAI Cookbook beschriebene Ansatz, nach einem fehlgeschlagenen CI-Lauf per GitHub Actions die Codex CLI aufzurufen und einen PR mit einem Fix zu erstellen, eine Möglichkeit, einen Workflow einzurichten. Es handelt sich nicht um eine integrierte Funktion, die die Codex CLI von Haus aus mitbringt.
Router- und Worker-Steuerung bei DeepSeek Super-agent
Der Kernablauf des DeepSeek-Prototyps lässt sich als Source → Trigger → Eval → Ticket → Assignment → Executor → Result zusammenfassen. Ereignisse kommen über GitHub oder Feishu herein und werden zunächst anhand deterministischer Regeln auf Berechtigungen geprüft. Anschliessend entscheidet ein Modell, ob eine Aufgabe angelegt werden soll. Für jede angenommene Aufgabe wird ein eigenes Ticket erstellt und einem Worker mit separatem Arbeitsverzeichnis zugewiesen. Das Ergebnis geht über den ursprünglichen Kanal zurück, beispielsweise als GitHub-PR.
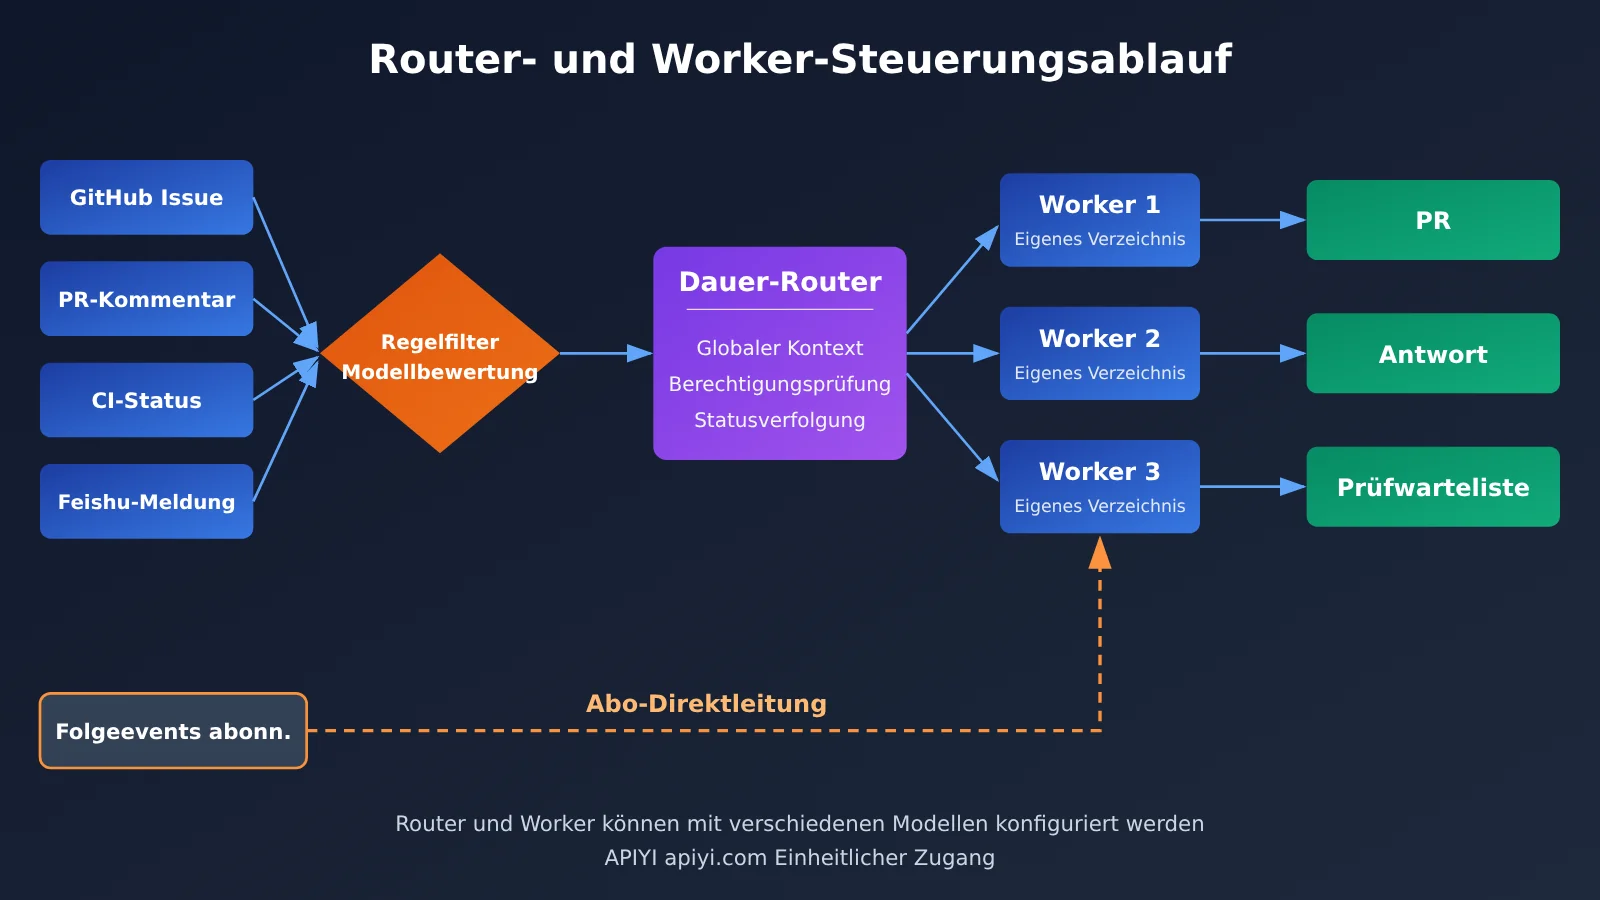
Der Router ist die dauerhaft laufende Hauptsitzung. Er nimmt Nachrichten entgegen, verwaltet den globalen Kontext, entscheidet über das Anlegen von Aufgaben, prüft Berechtigungen und weist Aufgaben zu und verfolgt sie. Komplexe Programmierarbeit übernimmt er grundsätzlich nicht. Laut offizieller Darstellung kann der Router deshalb in manchen Fällen ein schlankeres Modell nutzen, um die Steuerungskosten zu senken. Der Worker erhält dagegen klar definierte Aufträge, schreibt Code in einem isolierten Verzeichnis, führt Tests aus, bearbeitet anschliessendes Feedback und liefert das Ergebnis ab.
Der eigentliche Unterschied: Worauf das DeepSeek-Super-Agent-System bei der Aufgabensteuerung setzt
Claude Code und Codex bieten bereits Multi-Agent-, Hintergrund- und Ereignisfunktionen. Worin unterscheidet sich also DeepSeek? Die Antwort liegt nicht darin, ob diese Funktionen vorhanden sind, sondern darin, wer die Aufgaben verwaltet und wie weit diese Verwaltung reicht.
Ein herkömmlicher Haupt-Agent, der Teilaufgaben delegiert, oder der Team Lead eines Agent Teams ist meist eng an Planung, Koordination und Zusammenführung der Ergebnisse einer einzelnen komplexen Aufgabe beteiligt. DeepSeeks Router legt dagegen mehr Gewicht auf die übergeordnete Koordination über mehrere Aufgaben hinweg: Ein dauerhaft aktiver Router verwaltet mehrere weitgehend unabhängige Vorgänge gleichzeitig. Für Nutzer erscheint das System als ein einziger logischer Super-Agent, mit dem sie direkt über Arbeitskanäle wie GitHub oder Feishu interagieren. Die einzelnen Worker-Sitzungen müssen sie nicht selbst verwalten.
DeepSeek räumt auch offen ein, dass sich eine ähnliche zweistufige Architektur aufbauen lässt, wenn der Haupt-Agent eines Agent Teams nur für die übergreifende Interaktion und Delegation zuständig ist und selbst keine Aufgaben ausführt. Router + Worker ist also keine Fähigkeit, die andere nicht umsetzen könnten. Der eigentliche Unterschied liegt darin, wie systematisch dauerhafte Ereignisüberwachung, aufgabenübergreifendes Routing und ein einheitlicher Arbeitskontext umgesetzt werden. Das zeigt sich an drei Punkten:
- Dauerhaft aktiver Router: Er existiert als langfristig aktive Hauptsitzung, statt für jede Aufgabe vorübergehend als Koordinator gestartet zu werden. So bleibt der globale Kontext über mehrere Aufgaben hinweg erhalten.
- Direkte Ereigniszustellung: Ein Worker, der einen Thread abonniert hat, kann Folgeereignisse direkt empfangen, etwa neue Kommentare zu demselben PR. Dadurch muss der Router diese nicht wiederholt zuweisen.
- Zurückhaltende Eigeninitiative: Aufgaben werden in Explicit (ausdrückliche Anfragen) und Inferred (abgeleitete Aufgabenkandidaten) unterteilt. Für abgeleitete Aufgaben gilt standardmässig der Modus
observe: Sie werden nur protokolliert, nicht ausgeführt. Das automatische Zusammenführen von PRs ist standardmässig deaktiviert.
So lesen Sie die offiziellen Versuchsdaten zum DeepSeek Super-agent
DeepSeek führte synthetische Scheduling-Experimente durch: Pro Durchlauf gab es rund 300 Nachrichten, davon etwa 20 Arbeitsaufträge. Der Rest bestand aus Smalltalk, Rückmeldungen, Stornierungen und CI-Nachrichten. Die Programmierarbeit wurde durch zeitintensive simulierte Tools ersetzt. Jede Variante lief fünfmal.
| Variante | P50-Abschlusszeit | P95-Abschlusszeit | Gelesene Cache-Token pro Durchlauf |
|---|---|---|---|
| Super-agent | 12,4 Minuten | 15,7 Minuten | ca. 23,2 Mio. |
| Super-agent ohne Subscription-Passthrough | 12,6 Minuten | 15,5 Minuten | ca. 31,8 Mio. |
| Einzelne Session + Subagent, neutrale Eingabeaufforderung | 20,4 Minuten | 29,5 Minuten | ca. 6,1 Mio. |
| Einzelne Session + Subagent, Delegation bevorzugt | 13,8 Minuten | 29,0 Minuten | ca. 10,8 Mio. |
Zwei Erkenntnisse sind besonders wertvoll. Erstens: Verglichen mit der Lösung mit einer einzelnen Session, die Delegation bevorzugt, ist der P50-Vorteil des Super-agent gering. Der P95-Wert fällt jedoch deutlich niedriger aus. Der Nutzen der zweistufigen Architektur liegt also vor allem darin, bei vielen Aufgaben besonders lange Verzögerungen zu vermeiden. Zweitens: Ohne Subscription-Passthrough bleibt die Abschlusszeit nahezu unverändert, während die Zahl der gelesenen Cache-Token von rund 23,2 auf 31,8 Millionen steigt. Subscription-Passthrough reduziert also vor allem die wiederholte Verarbeitung durch den Router, statt die Ausführung zu beschleunigen.
Wichtig ist aber die Abgrenzung: Das ist ein Scheduling-Experiment und kein Qualitätstest für die Codegenerierung. Die Vergleichsgruppe ist eine einzelne Session mit Subagent unter bestimmten Eingabeaufforderungen – kein Praxistest der vollständigen Produkte Claude Code oder Codex unter denselben Bedingungen. Die Daten belegen daher weder eine um 39 % noch eine um 47 % höhere Produktivität beim Programmieren. Ebenso wenig eignen sie sich für eine Geschwindigkeitsrangliste der drei Produkte. Ein weiterer offizieller Test zur Stapelverarbeitung im Router zeigt: Bei rund 40 Ereignissen pro Minute stieg die durchschnittliche Stapelgröße auf 2,8, während die anteilige Inferenzzeit pro Entscheidung auf 1,6 Sekunden sank. Auch das belegt lediglich die Nutzbarkeit unter der jeweiligen Testlast.
Kosten und Sicherheitsgrenzen von DeepSeek Super-agent
Mehr Tempo kostet mehr Token. In synthetischen Tests las Super-agent etwa 3,8-mal so viele Token aus dem Cache wie eine neutrale Lösung mit einer einzelnen Sitzung. Das bedeutet aber nicht, dass auch die Gesamtkosten um das 3,8-Fache steigen. Sie hängen unter anderem von den Modellpreisen, Cache-Treffern, der Anzahl der Eingabe- und Ausgabe-Token sowie den Modellen ab, die Router und Worker jeweils verwenden. Offizielle Angaben zu den durchschnittlichen Kosten pro realem Ticket gibt es bislang nicht.
Zur Orientierung folgen die offiziellen API-Preise von DeepSeek am 2. November 2026 (US-Dollar pro 1 Million Token). Es handelt sich um Modelltarife, nicht um ein Preispaket für Super-agent:
| Modell und Zeitraum | Eingabe ohne Cache-Treffer | Eingabe mit Cache-Treffer | Ausgabe |
|---|---|---|---|
| DeepSeek V4.1 Flash, Nebenzeit | $0.15 | $0.003 | $0.60 |
| DeepSeek V4.1 Flash, Spitzenzeit | $0.30 | $0.006 | $1.20 |
| DeepSeek V4 Pro, Nebenzeit | $0.66 | $0.022 | $1.98 |
| DeepSeek V4 Pro, Spitzenzeit | $1.32 | $0.044 | $3.96 |
Hinzu kommen für Search und Fetch jeweils $0.75 pro 1.000 erfolgreiche Anfragen. Die Abrechnung gilt seit dem 1. November 2026 um 00:00 Uhr Pekinger Zeit; Kosten entstehen nur bei tatsächlicher Nutzung. Wer Super-agent betreibt, muss außerdem Serverressourcen, laufende Betriebskosten und den Aufwand für die manuelle Wartung einkalkulieren. Bei Claude Code und Codex gibt es wiederum verschiedene Tarife für Abonnements, API-Nutzung und Cloud-Ausführung. Eine einheitliche Vergleichsgröße für die „Kosten pro qualifiziertem PR“ existiert für die drei Lösungen derzeit nicht.
💰 Tipp zum Kostenmanagement: Bei einer Multi-Agent-Architektur hängt ein großer Teil der Kosten davon ab, welche Rolle welches Modell nutzt. Wer selbst mit einem schlanken Modell für den Router und einem leistungsstarken Modell für die Worker experimentieren möchte, kann über APIYI apiyi.com mit einem API-Schlüssel auf Modelle mehrerer führender Anbieter zugreifen. Die nutzungsbasierte Abrechnung macht es einfacher, den Token-Verbrauch verschiedener Kombinationen auf derselben Rechnung zu beobachten.
Auch die Sicherheit darf nicht zu kurz kommen. Die offizielle Dokumentation weist darauf hin, dass die speziellen Voreinstellungen für Router und Worker im Modus danger-full-access laufen. Standardmäßig werden sie unter dem Systembenutzer des Betreibers ausgeführt und können damit unter Umständen Dateien im Home-Verzeichnis lesen, lokale Programme ausführen und auf lokale Zugangsdaten zugreifen. DeepSeek empfiehlt einen separaten Systembenutzer und ein separates GitHub-Bot-Konto. Das Überwachen externer Kommentare und Nachrichten bringt außerdem das Risiko von Prompt-Injection mit sich. In der Community ist zudem ein unabhängiger Auditbericht zum Commit 6337fc8 erschienen, der auf mögliche Probleme etwa bei der Validierung der Verwaltungsschnittstelle hinweist. Der vollständige Angriffsablauf wurde jedoch nicht unabhängig reproduziert. Die Befunde sind daher als „potenzielle Risiken“ und nicht als bereits eingetretene Vorfälle zu betrachten.
Auswirkungen von DeepSeek Super-agent
Auswirkungen auf Entwickler
- Bewertungskriterien erweitern: Bei der Tool-Auswahl reicht es nicht mehr, nur die Ergebnisse des zugrunde liegenden Modells zu betrachten. Entscheidend ist auch, ob Ereignisanbindung, Aufgabenisolierung, Hintergrundbetrieb und menschliche Prüfung zu den Abläufen im Team passen.
- Der Prototyp ist nutzbar, aber nicht reibungslos: Community-Nutzer xxxxkkkqq konnte in einem privaten Repository ein Issue bis zum Pull Request bringen. Dabei traten aber auch Probleme auf: Benachrichtigungen kamen nicht an, obwohl die Deployment-Prüfung erfolgreich war, und eine chinesische Systemsprache führte dazu, dass Test-Assertions fehlschlugen. Ein weiterer Nutzer entdeckte unter WSL2 innerhalb einer Stunde zwei Fehler: bei der Erkennung von Node.js-24-Prozessen und beim Empfang von GitHub-Kommentaren.
- Nützliche Grundlage für die Weiterentwicklung: Für Teams, die TypeScript, GitHub-Integrationen und Modell-APIs betreuen können, bietet der Prototyp eine vollständige Referenzimplementierung für Router, Ereignisse, Tickets, Worker und Berechtigungsregeln.
Auswirkungen auf die Branche
- Der Wettbewerb verlagert sich: Beim KI-gestützten Programmieren geht es nicht mehr nur um Modell gegen Modell. Agent Harness, Workflow-Design und Entwicklererfahrung werden zu ebenso wichtigen Faktoren.
- „Proaktive Agenten“ bekommen klare Regeln: DeepSeek verknüpft „proaktives Arbeiten“ mit Berechtigungsrichtlinien, einem Observe-Modus und menschlicher Abnahme. Damit greift das Projekt eine reale Sorge auf: Könnten Agenten die Aufmerksamkeit des Teams unnötig beanspruchen?
Auf Basis dieser Fähigkeiten bieten sich je nach Arbeitsmodus folgende Optionen an:
| Arbeitsmodus | Empfohlene Kombination | Grund |
|---|---|---|
| Einzelne Programmieraufgaben im Alltag | Claude Code oder Codex | Etablierte Produkte, einfacher Einstieg, kein Scheduling-System nötig |
| Mehrere unabhängige Aufgaben parallel | Claude Code Agent Teams / Hintergrund-Agenten, Codex Worktrees / Cloud-Aufgaben | Ausgereifte Mechanismen für Parallelität und Isolierung |
| Forschung zu dauerhafter Ereignisüberwachung und einheitlichem Routing | DeepSeek-Super-agent-Prototyp | Veranschaulicht am direktesten das Design eines dauerhaft laufenden Routers mit Ereignisabonnements |
| Eigenes Agent-Orchestrierungssystem | Open-Source-Prototyp + APIs mehrerer Modelle | Scheduling-Logik und Aufgabenverteilung zwischen Modellen lassen sich anpassen |
| Sensible Produktions-Repositories | Forschungsprototyp vorerst nicht direkt einsetzen | Der Betrieb mit weitreichenden Berechtigungen und Sicherheitsfragen müssen noch verbessert werden |
🎯 Empfehlung: Die Tool-Kombinationen schließen sich nicht gegenseitig aus. Viele Teams nutzen Claude Code oder Codex für die tägliche Programmierarbeit und eine selbst entwickelte Steuerungsschicht für Ereignisse und Routing. Beim Aufbau dieser Schicht können Sie zunächst über APIYI auf apiyi.com kostenloses Testguthaben erhalten und vergleichen, wie sich verschiedene Modelle als Router und Worker schlagen.
Das Router-Prinzip von DeepSeek Super-agent per API nachbauen
Am besten versteht man ein Steuerungssystem, indem man selbst eine Minimalversion baut. Das folgende Beispiel nutzt eine OpenAI-kompatible Schnittstelle, um ein leichtgewichtiges Modell über das Routing entscheiden zu lassen. Es veranschaulicht nur das Prinzip und zeigt keinen tatsächlichen Code des DeepSeek-Prototyps:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

event = "PR #42 评论:CI 在 test_auth.py 失败,请帮忙看看"
resp = client.chat.completions.create(
    model="ROUTER_MODEL",  # 替换为控制台中可用的轻量模型名
    messages=[{"role": "user", "content": f"判断该事件是否需要建任务,只回答 YES/NO:{event}"}]
)
print(resp.choices[0].message.content)
Vollständigen Beispielcode für Router und Worker anzeigen
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 一个 Key 接入多家模型
)

ROUTER_MODEL = "ROUTER_MODEL"   # 轻量模型:负责路由判断
WORKER_MODEL = "WORKER_MODEL"   # 强模型:负责具体任务
AUTHORIZED_USERS = {"alice", "bob"}  # 确定性规则:授权名单

@dataclass
class Ticket:
    thread_id: str
    task: str
    history: list = field(default_factory=list)

tickets: dict[str, Ticket] = {}

def router_eval(event: dict) -> bool:
    """先规则过滤,再由模型判断是否建任务"""
    if event["user"] not in AUTHORIZED_USERS:
        return False  # 未授权:仅观察,不执行
    resp = client.chat.completions.create(
        model=ROUTER_MODEL,
        messages=[
            {"role": "system", "content": "你是任务路由器,只回答 YES 或 NO。"},
            {"role": "user", "content": f"该消息是否是需要执行的工作请求?\n{event['text']}"}
        ],
        max_tokens=5
    )
    return "YES" in resp.choices[0].message.content.upper()

def worker_run(ticket: Ticket, text: str) -> str:
    """Worker 使用独立上下文处理任务"""
    ticket.history.append({"role": "user", "content": text})
    resp = client.chat.completions.create(
        model=WORKER_MODEL,
        messages=[{"role": "system", "content": "你是代码修复助手,给出修复思路。"}] + ticket.history
    )
    answer = resp.choices[0].message.content
    ticket.history.append({"role": "assistant", "content": answer})
    return answer

def handle(event: dict) -> str:
    tid = event["thread_id"]
    # 订阅直通:已有 Ticket 的后续事件直接交给对应 Worker
    if tid in tickets:
        return worker_run(tickets[tid], event["text"])
    if router_eval(event):
        tickets[tid] = Ticket(thread_id=tid, task=event["text"])
        return worker_run(tickets[tid], event["text"])
    return "已记录,未建任务"

print(handle({"thread_id": "pr-42", "user": "alice", "text": "CI 在 test_auth.py 失败"}))
print(handle({"thread_id": "pr-42", "user": "alice", "text": "补充:只在 Python 3.12 下失败"}))
Das Beispiel zeigt drei Prinzipien: Deterministische Regeln greifen vor der Modellentscheidung, Router und Worker nutzen unterschiedliche Modelle, und weitere Ereignisse desselben Threads gelangen direkt in den bestehenden Kontext des Workers. Ein reales System benötigt darüber hinaus isolierte Arbeitsverzeichnisse, eine Berechtigungs-Sandbox, dauerhafte Zustandsspeicherung und menschliche Prüfung. Genau an diesen Punkten wird beim Prototyp noch gearbeitet.
🚀 Schnellstart: Um den obigen Code auszuführen, müssen Sie nur den API-Schlüssel und den Modellnamen ersetzen. Eine Liste der aktuell verfügbaren Modelle finden Sie in der Konsole von APIYI unter apiyi.com. Neue Nutzer erhalten kostenloses Testguthaben. Damit können Sie Ihren Ansatz für die Aufgabensteuerung zunächst kostengünstig prüfen, bevor Sie in die Weiterentwicklung investieren.
Häufige Fragen (FAQ)
Q1: Ist DeepSeek Super-agent ein neues Modell?
Nein. Super-agent ist eine Agenten-Systemarchitektur, die außerhalb des Modells arbeitet. Als Open Source veröffentlicht wurde ein Forschungsprototyp auf Basis von DeepSeek Harness. Er ist nicht an ein bestimmtes DeepSeek-Modell gebunden: Für Router und Worker lassen sich Modellanbieter und Modell jeweils in den Einstellungen festlegen.
Q2: Wird DeepSeek Super-agent Claude Code und Codex ersetzen?
Dafür gibt es derzeit keine Grundlage. Die drei Lösungen setzen auf unterschiedlichen Ebenen an: Claude Code und Codex sind ausgereifte Coding-Agent-Produkte, während Super-agent sich auf die übergeordnete, kontinuierliche Aufgabensteuerung konzentriert. Stand 2. November gibt es zudem keine öffentlichen Coding-Vergleiche in grossem Massstab unter gleichen Bedingungen. Die offiziellen synthetischen Experimente eignen sich nicht als Leistungsvergleich zwischen den drei Lösungen.
Q3: Können Claude Code und Codex ereignisgesteuert arbeiten und Hintergrundaufgaben ausführen?
Ja. Claude Code bietet GitHub Actions, Channels als Forschungsvorschau, Hintergrund-Agenten und zeitgesteuerte Aufgaben in der Cloud. Im Codex-Ökosystem gibt es Cloud-Aufgaben, Worktrees, zeitgesteuerte Hintergrundaufgaben und ereignisgesteuerte Automatisierungen für unterstützte Anwendungen. Die Unterschiede liegen in den jeweiligen Zugängen, Voraussetzungen und technischen Umsetzungen – nicht darin, ob diese Funktionen grundsätzlich vorhanden sind.
Q4: Ist der DeepSeek-Super-agent-Prototyp kostenlos?
Der Code ist unter der MIT-Lizenz kostenlos als Open Source verfügbar. Modellaufrufe werden jedoch weiterhin nach Token abgerechnet. Dazu kommen Kosten für Server, Wartung und menschliche Prüfung. Open Source bedeutet nicht automatisch, dass die Gesamtkosten pro Aufgabe niedriger sind. Wer die API-Kosten mehrerer Modelle zentral verwalten möchte, kann über APIYI unter apiyi.com nutzungsbasiert abrechnen und den Verbrauch gesammelt einsehen.
Q5: Wie kann ich die Aufgabenteilung zwischen mehreren Modellen mit Router und Worker kostengünstig testen?
Nutzen Sie den Beispielcode aus diesem Artikel, setzen Sie `base_url` auf `https://api.apiyi.com/v1` und lassen Sie ein leichtgewichtiges Modell das Routing übernehmen, während ein leistungsstarkes Modell die Aufgaben ausführt. Nach der Registrierung bei APIYI unter apiyi.com erhalten Sie kostenloses Testguthaben. Mit einem API-Schlüssel können Sie zwischen gängigen Modellen wie OpenAI, Claude und Gemini wechseln und sie vergleichen.
Q6: Welche Einschränkungen des DeepSeek-Super-agent-Prototyps sind bekannt?
Derzeit kann der Prototyp nur ein einzelnes Repository auf github.com überwachen; GitHub Enterprise Server wird nicht unterstützt. Für die Bereitstellung sind Node.js 22.19+ oder 24+, tmux, GitHub CLI 2.48+ und ein separates Bot-Konto erforderlich. Worker laufen standardmässig mit weitreichenden Berechtigungen, wodurch Risiken durch Prompt Injection und den Umgang mit Zugangsdaten entstehen. Aus der Community wurden ausserdem Probleme wie verlorene Benachrichtigungen und Kompatibilitätsprobleme mit Node.js 24 gemeldet. Für den direkten Einsatz in sensiblen Produktions-Repositories ist der Prototyp daher nicht zu empfehlen.
DeepSeek Super-agent im Vergleich zu Claude Code und Codex: Die wichtigsten Erkenntnisse
- Unterschiedliche Ebenen: Super-agent ist der Prototyp eines Koordinationssystems; Claude Code und Codex sind Produkte für Programmier-Agenten.
- Multi-Agent-Funktionen sind kein Alleinstellungsmerkmal: Claude Code und Codex bieten bereits Sub-Agenten, parallele Sitzungen sowie Hintergrund- und Ereignisfunktionen.
- Der eigentliche Unterschied liegt im Systemansatz: Ein dauerhaft aktiver Router, aufgabenübergreifendes Routing, direkter Zugriff auf Abonnements und ein gemeinsamer Kontext stehen im Mittelpunkt des Designs.
- Die Aussagekraft der Versuchsdaten ist begrenzt: Das synthetische Koordinationsexperiment zeigt nur die Koordinationsleistung – nicht die Codequalität oder eine Rangfolge der drei Lösungen.
- Geschwindigkeit kostet Tokens: Die Zahl der Cache-Lesevorgänge liegt beim rund 3,8-Fachen einer Lösung mit nur einer Sitzung. Die Kosten müssen für jede Modellkombination einzeln berechnet werden.
- Sicherheit von Anfang an berücksichtigen: Hohe Berechtigungen und das Risiko von Injection-Angriffen über externe Eingaben erfordern ein separates Konto und eine manuelle Abnahme.
- Selbst testen ist zuverlässiger: Über APIYI apiyi.com lässt sich mit einem API-Schlüssel die Aufgabenteilung zwischen Router und Workern mit mehreren Modellen ausprobieren.
Fazit
Die zentralen Erkenntnisse aus dem Vergleich von DeepSeek Super-agent mit Claude Code und Codex:
- Der erste Unterschied liegt auf der Systemebene: Modellfähigkeiten, Funktionen von Programmierwerkzeugen und Koordinationsfähigkeiten sind drei verschiedene Dinge. Sie miteinander zu vermischen, ergibt keinen sinnvollen Vergleich.
- DeepSeeks Stärke liegt im Koordinationsdesign: Der Ansatz systematisiert die dauerhafte Überwachung, das aufgabenübergreifende Routing und einen gemeinsamen Kontext. Zugleich begrenzen Berechtigungen und ein Observe-Modus, wie eigenständig das System handelt.
- Der Unterschied im Reifegrad ist real: Für den Prototyp gibt es bereits ein Praxisbeispiel, das von einem Issue bis zu einem PR reicht. Installation, Zuverlässigkeit und Sicherheit müssen aber noch verbessert werden. Claude Code und Codex bleiben für die tägliche Programmierarbeit die verlässlichere Wahl.
Der Wettbewerb beim KI-gestützten Programmieren dreht sich längst nicht mehr nur darum, welches Modell am stärksten ist. Auch Agent-Harness, Workflows und das Entwicklererlebnis spielen eine Rolle. Für die meisten Teams ist es pragmatischer, ausgereifte Produkte für die tägliche Arbeit zu nutzen und parallel eine selbst entwickelte Koordinationsschicht in kleinem Rahmen zu testen.
Über APIYI apiyi.com lassen sich mehrere führende Modelle einheitlich anbinden. So können Teams schnell testen, wie sich verschiedene Modelle in den Rollen Router und Worker schlagen und welche Kosten dabei entstehen.
📚 Quellen
- Offizielles Repository des DeepSeek-Super-Agent-Prototyps: Projektstatus, Quellcode und Einsatzbereich
- Link:
github.com/deepseek-ai/dsh-superagent-prototype -
Hinweis: Enthält die README-Datei sowie Dokumente zu Deployment, Autorisierungsmechanismus und Designphilosophie
-
Offizielle Preise der DeepSeek API: Modellpreise und Kosten für Search/Fetch
- Link:
api-docs.deepseek.com/quick_start/pricing -
Hinweis: Grundlage für die Berechnung der Kosten von Router- und Worker-Modellen
-
Dokumentation zu Claude Code Subagents und Agent Teams: Multi-Agent-Funktionen
- Links:
code.claude.com/docs/en/sub-agents、code.claude.com/docs/en/agent-teams -
Hinweis: Erläutert die unabhängigen Kontexte von Subagents und die Zusammenarbeit im Team
-
Dokumentation zu Claude Code Channels und geplanten Aufgaben: Ereignisübermittlung und Dauerbetrieb
- Links:
code.claude.com/docs/en/channels、code.claude.com/docs/en/scheduled-tasks -
Hinweis: Erläutert die Voraussetzungen und Einschränkungen der Funktionen in der Forschungsvorschau
-
Dokumentation zu Codex Cloud und Worktrees: Cloud-Aufgaben und parallele Arbeitsbereiche
- Links:
help.openai.com/en/articles/20001545-using-codex-cloud、learn.chatgpt.com/docs/environments/git-worktrees -
Hinweis: Offizielle Grundlage zur Abgrenzung der Codex-Produktfunktionen
-
Multi-Agent-Leitfaden zur OpenAI Agents API: Multi-Agent-Orchestrierung auf API-Ebene
- Link:
developers.openai.com/api/docs/guides/agents-api/multi-agent -
Hinweis: Getrennt von den Codex-Produktfunktionen zu betrachten
-
Community-Diskussion zu Praxistests mit DeepSeek Harness: End-to-End-Bericht vom Issue bis zum Pull Request
- Link:
github.com/deepseek-ai/deepseek-harness/discussions/11706 - Hinweis: Einblicke in den praktischen Betrieb des Prototyps und häufige Probleme
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI. Weitere Informationen zur Anbindung mehrerer Modelle und zur Agent-Orchestrierung finden Sie im Dokumentationszentrum unter docs.apiyi.com.