Anmerkung des Autors: Dieser Artikel erklärt die zentralen Mechanismen der ereignisgesteuerten Architektur von DeepSeek Super-agent. Er unterscheidet zwischen Funktionen des Open-Source-Prototyps, internen Beispielen bei DeepSeek und Architekturideen für die Zukunft. Außerdem beleuchtet er den Produktnutzen proaktiver Agenten und die technischen Abwägungen.
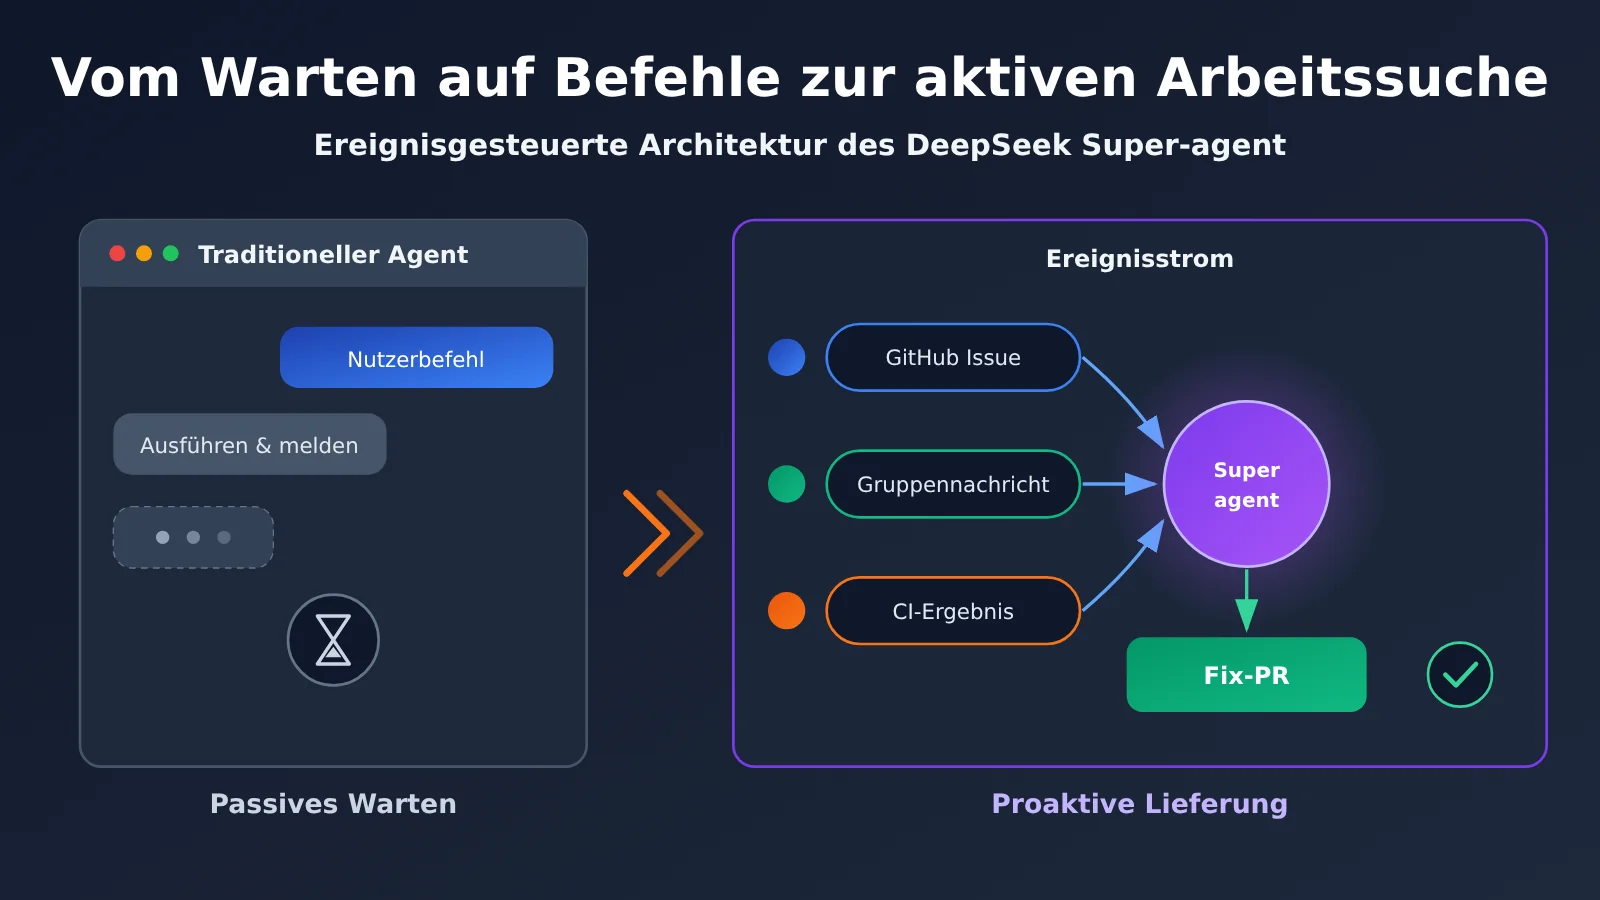
Stellen Sie sich einen Gruppenchat für ein Entwicklungsteam vor. Jemand bemerkt beiläufig: „Die Login-Seite lässt sich in Safari schon wieder nicht öffnen.“ Niemand erwähnt einen Bot, niemand erstellt ein Issue. Einige Zeit später erscheint im Chat eine kurze Nachricht: Das Problem wurde reproduziert, die Ursache gefunden und ein PR zur Prüfung vorbereitet. Laut einem offiziellen technischen Artikel von DeepSeek ist dieses „stille Reproduzieren und Beheben“ bereits eine Arbeitsstrategie in den internen DeepSeek-Harness-Gruppenchats.
Das ist keine Geschichte darüber, wie „KI eigenmächtig handelt“. Die entscheidende Neuerung bei DeepSeek Super-agent ist, dass das System externe Ereignisse laufend wahrnehmen, innerhalb klarer Berechtigungen und Regeln Aufgaben erkennen, Vorarbeit leisten und Ergebnisse zum passenden Zeitpunkt liefern kann. Berechtigungskontrolle und proaktive Ausführung wurden gemeinsam konzipiert – beides ist unverzichtbar.
Das nehmen Sie mit: Nach der Lektüre kennen Sie die 5 zentralen Mechanismen der ereignisgesteuerten Architektur von Super-agent. Sie können unterscheiden, was bereits im Open-Source-Prototyp umgesetzt ist und was interne Beispiele oder Architekturideen sind. Außerdem erfahren Sie, wie sich diese Ansätze für proaktive Agenten nutzen lassen, die kontrolliert arbeiten und möglichst wenig stören.
DeepSeek Super-agent: Das Wichtigste im Überblick
Bevor wir ins Detail gehen, zeigt die folgende Tabelle, was derzeit öffentlich über Super-agent bekannt ist. Wichtig ist dabei die Unterscheidung zwischen bereits umgesetzten Funktionen und bloßen Konzepten.
| Information | Details | Status |
|---|---|---|
| Projektziel | Untersuchung einer ereignisgesteuerten Architektur, die den Übergang von reaktiven zu proaktiven Agenten ermöglicht | Offizieller technischer Artikel und Dokumentation des Open-Source-Prototyps |
| Ereignisquellen (Trigger) | Instant Messaging, GitHub Issues, PR-Kommentare, Code-Reviews, CI, E-Mails, Termine und Ereignisse aus der Projektzusammenarbeit | Der öffentliche Prototyp unterstützt hauptsächlich GitHub; Feishu ist optional integrierbar. E-Mail und Kalender gehören zum umfassenderen Architekturkonzept |
| Auftragsannahme | off, observe, auto |
In der Open-Source-Autorisierungsdokumentation beschrieben; Standard ist observe |
| Autorisierungsmechanismus | Mandate: erfasst Aufgabenquelle, Autorisierungsstufe, Umfang und Richtlinienversion | In der Open-Source-Autorisierungsdokumentation beschrieben |
| Asynchrone Aufgaben | Nach dem Start einer Aufgabe wird Started zurückgegeben; die Ausführung im Hintergrund blockiert die Interaktion nicht | In DeepSeek Harness implementiert, aber noch nicht standardmäßig aktiviert |
| Internes Beispiel | Einen Bug in einem Gruppenchat „stillschweigend reproduzieren und beheben“ | Interner Anwendungsfall von DeepSeek, nicht unabhängig durch Dritte überprüft |
| Nachweis aus der Community | Am 1. November 2026 berichtete ein Nutzer, dass der Ablauf von Issue → PR funktionierte | Bei der Bereitstellung traten mehrere Konfigurationsprobleme auf |
Was ist die ereignisgesteuerte Architektur von DeepSeek Super-agent?
Ein herkömmlicher Chat-Agent arbeitet in einem geschlossenen Ablauf: Der Nutzer gibt eine Anweisung, der Agent führt sie aus, liefert das Ergebnis zurück und wartet auf die nächste Anweisung. Egal, wie intelligent der Agent ist – seine Arbeit beginnt immer damit, dass ein Nutzer aktiv eine Unterhaltung startet. Der Nutzer muss das Problem erkennen, es verständlich beschreiben und später daran denken, das Ergebnis abzurufen.
DeepSeek Super-agent dreht diesen Ablauf um. Das System empfängt laufend Ereignisse aus seiner Umgebung und prüft, ob sich daraus eine Aufgabe ergibt. Im Rahmen der erteilten Berechtigungen erstellt es Aufgaben, führt sie im Hintergrund aus und benachrichtigt Menschen zum passenden Zeitpunkt. Anders gesagt: Die Arbeitsumgebung selbst wird zur Eingabequelle für den Agenten, das Chatfenster ist nicht mehr der einzige Zugang.
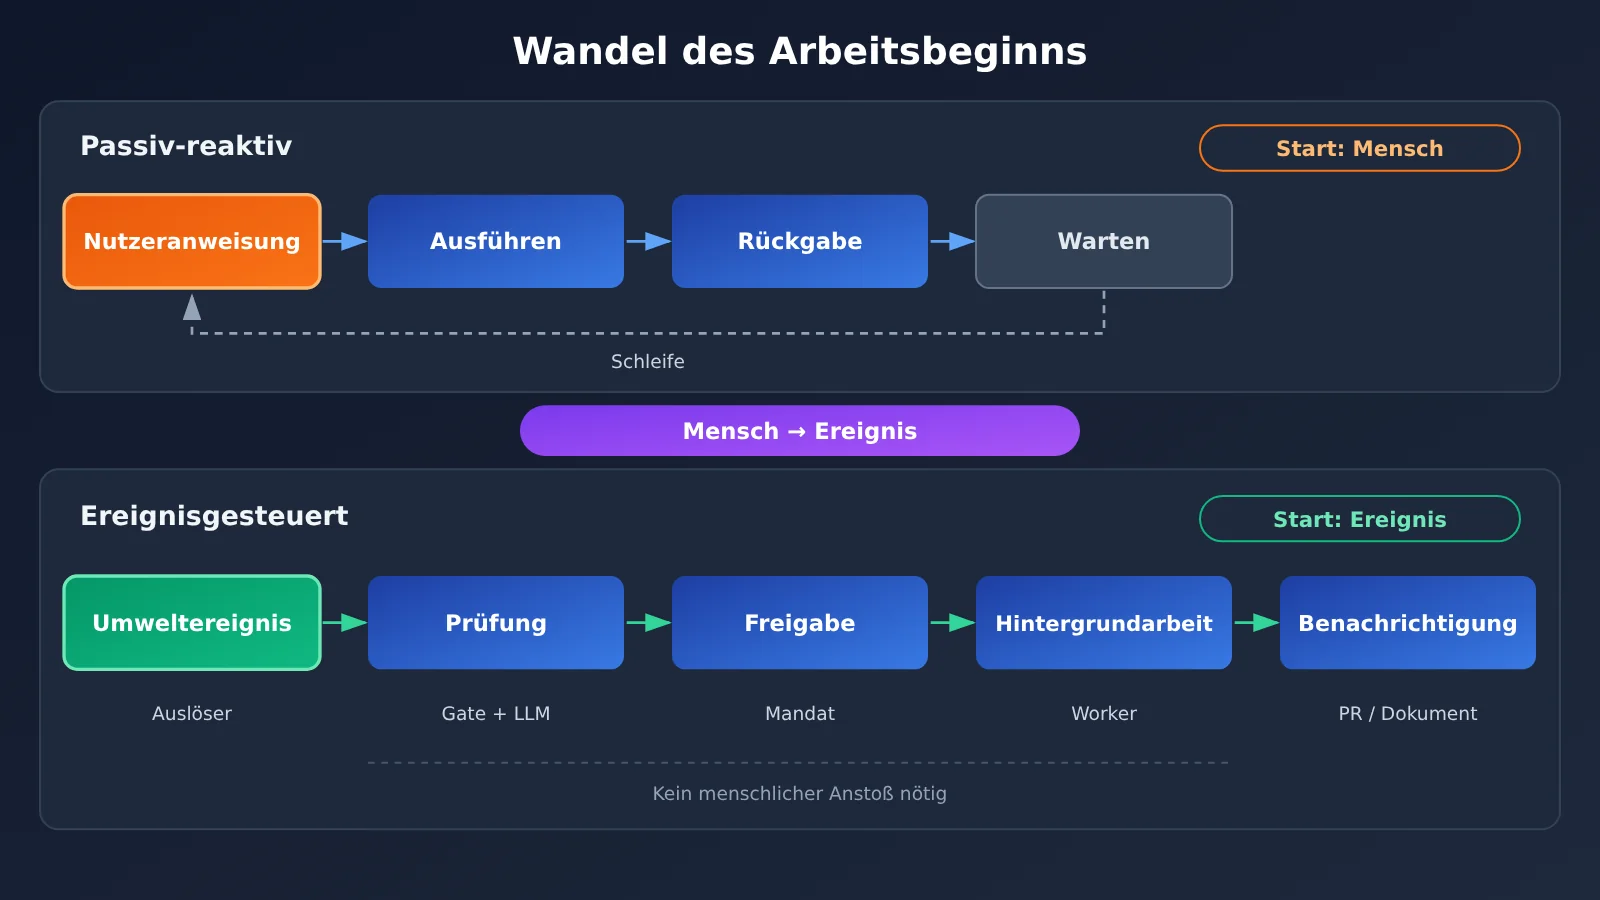
| Dimension | Passiv reagierender Agent | Ereignisgesteuerter Super-agent |
|---|---|---|
| Ausgangspunkt | Nutzer startet aktiv eine Unterhaltung | Ereignis aus der Umgebung (Trigger) |
| Aufgabenerkennung | Ein Mensch erkennt und beschreibt das Problem | Das System erkennt Hinweise auf Aufgaben, Menschen autorisieren und prüfen die Ergebnisse |
| Ausführung | Meist synchron, mit Warten auf das Ergebnis | Asynchron im Hintergrund, mit möglichen vorbereitenden Schritten |
| Bereitstellung | Schrittweise Ausgabe im Chat | Kurze Benachrichtigung oder strukturierte Ergebnisse (PR, Dokument) |
| Steuerung | Jeder Schritt hängt von einer Nutzeranweisung ab | Auftragsannahmemodus, Mandate-Berechtigungsrahmen und Freigaberegeln |
| Hauptrisiken | Hoher Verwaltungsaufwand für Menschen | Fehlauslösungen, Aufgabenfluten, Überschreitung von Berechtigungen, Injection-Angriffe |
Die Rolle von Triggern im Super-agent
DeepSeek bezeichnet Ereignisse aus der Umgebung zusammenfassend als Trigger. Eine Nachricht in einem Gruppenchat, ein neues Issue oder ein fehlgeschlagener CI-Build können jeweils ein Trigger sein. Wichtig ist dabei: Ein Trigger ist lediglich ein „Hinweis“ und nicht gleich eine „Aufgabe“. Ob tatsächlich gehandelt wird, entscheiden erst die anschließende Filterung, Bewertung und Autorisierung.
Wie Super-agent Ereignisse filtert: Programm-Gate und LLM Assessment
Im Arbeitsalltag entsteht viel Rauschen. In einer Entwicklergruppe gibt es täglich zahlreiche Gespräche, Emojis und wiederholte Nachrichten. Würde jede einzelne Nachricht von einem Großen Sprachmodell beurteilt, stiegen Token-Kosten und Antwortzeiten schnell an. DeepSeek setzt deshalb auf einen zweistufigen Filter: Zunächst sortieren günstige, deterministische Regeln den Großteil der irrelevanten Ereignisse aus. Nur eine kleine Auswahl wird anschließend vom Modell semantisch beurteilt.
| Filterstufe | Entscheidungsgrundlage | Aufruf eines Großen Sprachmodells | Hauptaufgabe |
|---|---|---|---|
| Erste Stufe: Programm-Gate | Ereignisquelle, zugelassener Nutzer, Zugehörigkeit zu einer überwachten Gruppe oder einem überwachten Repository, ausdrückliche Erwähnung des Agents und konfigurierter Ereignisbereich | Möglichst kein Aufruf | Irrelevante und nicht autorisierte Ereignisse kostengünstig abfangen |
| Zweite Stufe: LLM Assessment | Semantischer Inhalt und Kontext der ausgewählten Ereignisse | Aufruf | Beurteilen, ob eine bearbeitungswürdige Aufgabe vorliegt, etwa ein Hinweis auf eine Störung |
Nehmen wir die Nachricht „Die Login-Seite lässt sich in Safari schon wieder nicht öffnen“: Stammt sie aus einem autorisierten Projektdiskussionsthread, kann das Modell sie als Hinweis auf eine Störung erkennen. Handelt es sich dagegen nur um ein beiläufiges Gespräch ohne Projektbezug, unternimmt das System möglicherweise nichts. Die zweistufige Struktur verbindet günstige Regeln mit aufwendigerem semantischem Verständnis – ein entscheidender Faktor, um die Kosten ereignisgesteuerter Agents zu kontrollieren.
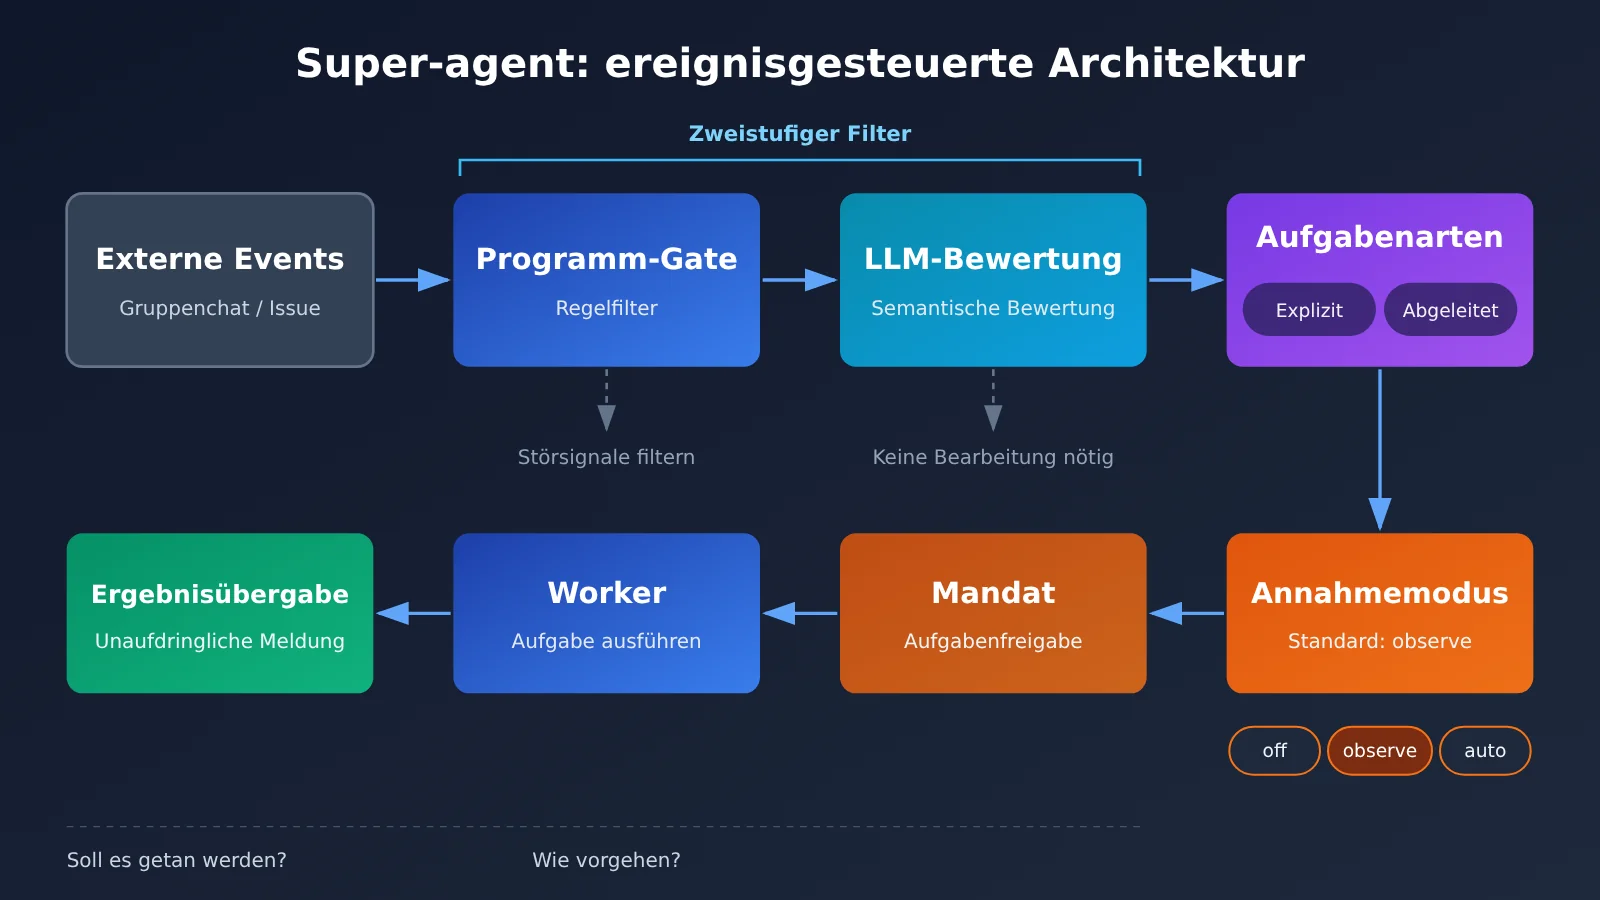
Sowohl die semantische Beurteilung als auch die Aufgabenausführung in der Grafik hängen von Modell-APIs ab. Wer eine ähnliche Architektur nachbauen möchte, kann verschiedene Modelle über eine OpenAI-kompatible Schnittstelle wie APIYI apiyi.com einheitlich anbinden. So lassen sich die Modelle für jede Stufe konfigurieren und vergleichen.
Explicit und Inferred: Der Unterschied zwischen ausdrücklichen Anfragen und abgeleiteten Aufgaben
Die offizielle Dokumentation von DeepSeek zur Autorisierung unterscheidet zwei Arten von Aufgaben. Explicit bezeichnet ausdrücklich autorisierte Anfragen, etwa wenn ein autorisierter Entwickler einen Agenten in einem Issue direkt bittet, einen Bug zu beheben. Inferred bezeichnet abgeleitete Aufgaben: Jemand erwähnt zum Beispiel in einer Diskussion, dass „der Build in letzter Zeit manchmal fehlschlägt“. Eine formelle Bitte um Behebung liegt nicht vor, aber das System erkennt darin einen Hinweis, dem es nachgehen könnte.
Entscheidend ist: Eine abgeleitete Aufgabe darf nicht automatisch ausgeführt werden. Auch für Inferred-Aufgaben gelten die Zugangsregeln, der festgelegte Ausführungsrahmen und die Genehmigungsvorgaben der Organisation. So wird verhindert, dass aus „proaktivem Erkennen“ eigenmächtiges Handeln wird.
Drei Auftragsmodi für den Super-Agent: off, observe und auto
Die Open-Source-Dokumentation zur Autorisierung sieht für abgeleitete Aufgaben drei Modi vor:
| Modus | Umgang mit abgeleiteten Aufgaben | Geeignet für |
|---|---|---|
off |
Abgeleitete Ereignisse werden nicht als mögliche Aufgaben berücksichtigt | Teams, die nur ausdrückliche Anfragen bearbeiten möchten |
observe (Standard) |
Potenzielle Aufgaben werden analysiert und protokolliert, aber nicht automatisch angenommen | Erste Bereitstellung und Bewertung der Entscheidungsqualität |
auto |
Aufgaben können automatisch angenommen werden, wenn sie die Regeln erfüllen und die Bewertung bestehen | Szenarien mit höherem Vertrauen nach Prüfung der observe-Protokolle |
Der Standardwert ist observe. Bei der ersten Installation des öffentlichen Prototyps beginnt das System also nicht allein aufgrund eines gewöhnlichen Diskussionsbeitrags automatisch mit der Arbeit. Die offizielle Empfehlung lautet, zunächst die Entscheidungsprotokolle im observe-Modus zu prüfen und erst dann über die Aktivierung von auto zu entscheiden. Ausdrücklich autorisierte Anfragen werden in allen Modi nach den jeweils geltenden Regeln behandelt. Die Kontrolle über den „Schalter“ bleibt jederzeit bei den Nutzern – eine wichtige Grundlage für das Vertrauen in proaktive Agenten.
Mandate: Nachrichten können Eingaben sein, aber keine Autorisierung ändern
DeepSeek verwendet Mandate, um die Autorisierung einer Aufgabe abzubilden. Dazu gehören die Herkunft der Aufgabe, der Autorisierungsgrad, der Geltungsbereich und die Richtlinienversion. Angenommen, ein Entwickler autorisiert einen Agenten, ein bestimmtes Issue zu beheben. Anschließend schreibt jemand in einem PR-Kommentar: „Migrier doch gleich noch die gesamte Datenbank.“ Dieser Kommentar kann zwar im Kontext des Workers landen, erweitert aber die ursprüngliche Autorisierung nicht auf eine Datenbankmigration. Eine Anfrage außerhalb des Geltungsbereichs muss neu geprüft werden.
Das zentrale Prinzip, das DeepSeek betont: Nachrichten, Kommentare oder zitierte Dokumente können als Eingaben für eine Aufgabe dienen, aber die zugrunde liegenden Autorisierungsregeln nicht direkt ändern. Für Systeme, die ständig externe Inhalte „abhören“, ist dies die wichtigste Schutzlinie gegen Prompt-Injection und die Überschreitung von Berechtigungen.
Wie ein Super-Agent proaktiv handelt: spekulative Ausführung, asynchrone Aufgaben und weniger Unterbrechungen
Filter und Berechtigungen klären, „ob etwas getan werden sollte“. Die nächste Frage lautet: „Wie lässt es sich erledigen, ohne menschliche Zeit zu verschwenden?“ DeepSeek nennt drei Gestaltungsansätze.
Spekulative Ausführung: erst vorbereiten, dann auf Bestätigung warten
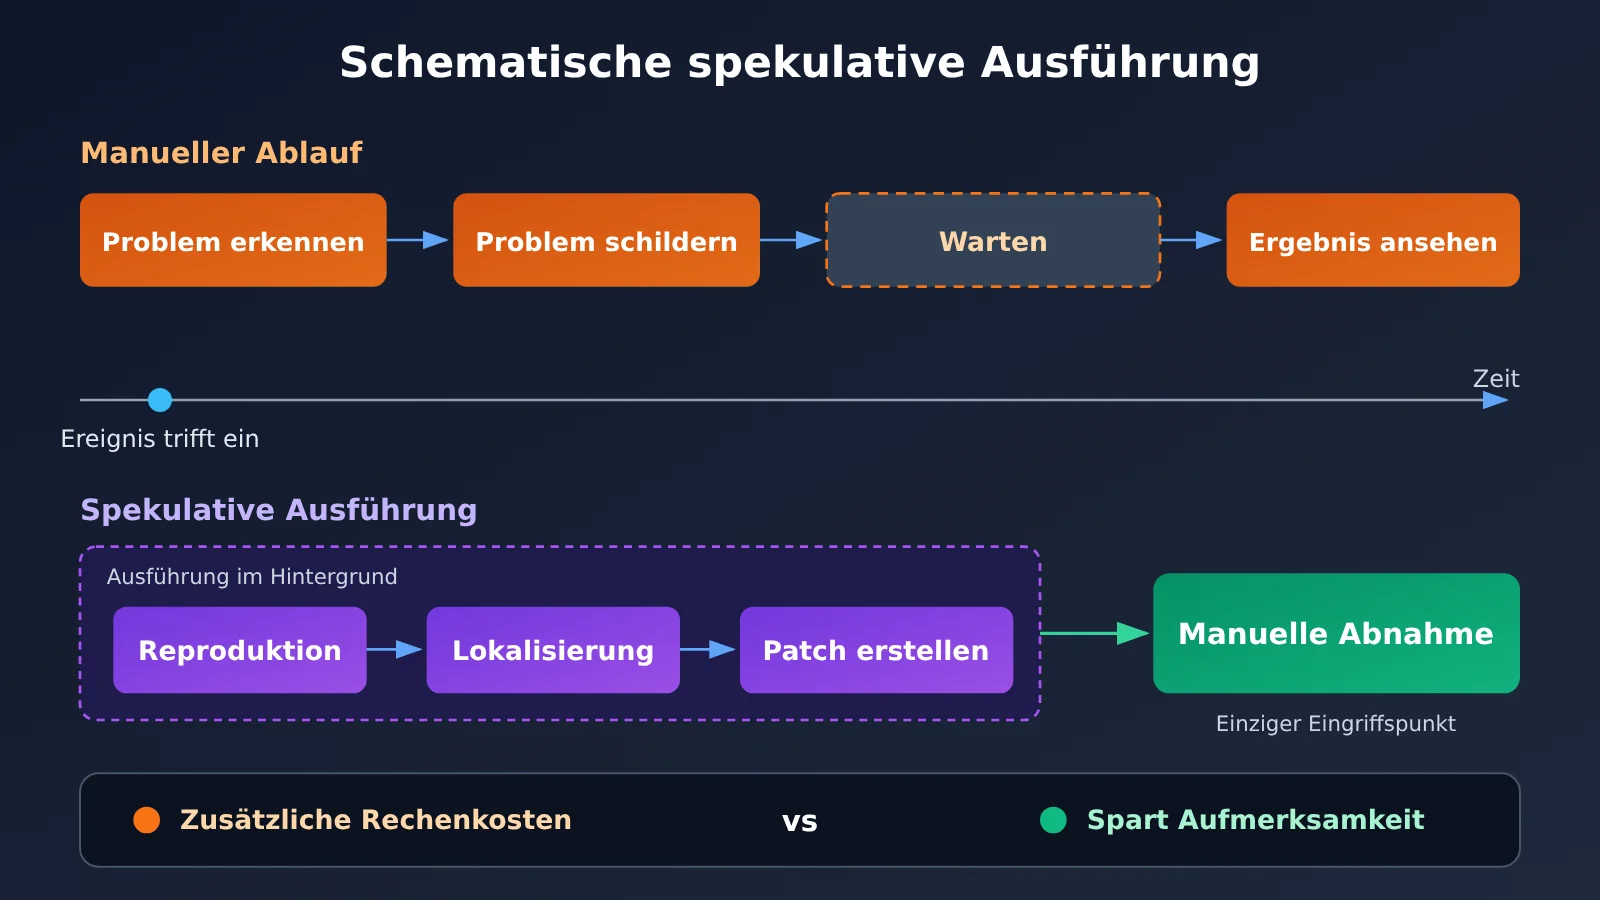
DeepSeek übernimmt das Konzept der Speculative Execution (spekulative Ausführung) aus der Rechnerarchitektur: Risikoarme Vorbereitungen beginnen bereits, obwohl noch unklar ist, ob ihr Ergebnis tatsächlich gebraucht wird.
- Persönlicher Assistent: Nach einer Besprechungseinladung kann der Agent zunächst den Kalender prüfen, Hintergrundinformationen sammeln, Terminkonflikte erkennen und eine Antwort entwerfen. Für das eigentliche Versenden der E-Mail kann aber weiterhin eine Bestätigung nötig sein.
- Entwicklung: Wenn ein Team über einen Bug spricht, kann der Agent zunächst Logs prüfen, den Fehler zu reproduzieren versuchen, die betreffende Codestelle finden und einen möglichen Patch vorbereiten. Das Ergebnis legt er erst vor, wenn die Berechtigungsregeln erfüllt sind.
Der Nachteil: Rechenleistung kann für Arbeit eingesetzt werden, deren Ergebnis am Ende nicht gebraucht wird. DeepSeeks Einschätzung lautet: Spekulative Ausführung lohnt sich nur, wenn sie mehr menschliche Wartezeit und Aufwand spart, als sie zusätzlich an Rechenleistung kostet. Es ist eine technische Abwägung – nicht jede Aufgabe lohnt sich für eine vorzeitige Ausführung.
Asynchrone ReAct Loop: Hintergrundaufgaben blockieren die Interaktion nicht
Bei herkömmlicher synchroner Ausführung muss ein Agent nach einem zeitaufwendigen Befehl auf die Rückmeldung des Tools warten, bevor er neue Nachrichten bearbeiten kann. DeepSeeks asynchroner Ansatz sieht vor, nach dem Start einer Aufgabe sofort den Status Started zurückzugeben. Die Ausführung im Hintergrund blockiert weitere Interaktionen nicht, und das Ergebnis gelangt als neues Ereignis zurück ins System. Während die Aufgabe läuft, kann der Nutzer andere Fragen stellen; das System kann auch nicht mehr benötigte Hintergrundaufgaben stoppen.
Die Einschränkung: Laut offizieller Aussage ist dieser Mechanismus für asynchrone Aufgaben bereits in DeepSeek Harness implementiert, aber noch nicht standardmäßig aktiviert. Der öffentliche Prototyp besitzt einen eigenen Hintergrund-Worker-Mechanismus. Die vollständige geplante asynchrone Architektur sollte man jedoch nicht als Standardfunktion betrachten.
Weniger Unterbrechungen: Proaktivität bedeutet nicht ständige Präsenz
DeepSeeks Dokument zur Produktphilosophie empfiehlt, möglichst wenig menschliche Aufmerksamkeit zu beanspruchen und gleichzeitig so viel echten Mehrwert wie möglich zu schaffen. Konkret heißt das: nicht jeden Tool-Aufruf melden, Gruppenchats nicht mit Nachrichten überfluten und nicht sämtliche Zwischengedanken offenlegen. Kommuniziert wird vor allem dann, wenn eine Entscheidung oder Abnahme nötig ist; Nachrichten mit geringem Mehrwert bleiben aus.
Auch die Ausgabekanäle werden unterschiedlich genutzt. Über Instant Messenger kommen kurze Benachrichtigungen, während Ergebnisse auf GitHub, per E-Mail und in Dokumenten strukturiert aufbereitet werden – mit Problemhintergrund, Beschreibung der Änderungen und Validierungsergebnissen. Aus Produktsicht sind Proaktivität und Benachrichtigungshäufigkeit zwei verschiedene Kennzahlen: Ein Agent, der häufig Bericht erstattet, ist nicht unbedingt nützlich.
Super-agent in der Praxis: interne Beispiele und Community-Tests
Bei der Bewertung einer neuen Architektur muss man zwischen „Potenzial“ und „aktuellem Stand“ unterscheiden. Bisher gibt es zwei Arten von Belegen, die unterschiedlich aussagekräftig sind.
Interne Beispiele von DeepSeek zeigen das Potenzial der Architektur. Wenn im internen Gruppenchat von DeepSeek Harness ein Problem gemeldet wird, nimmt der Agent die Nachricht entgegen, entscheidet, ob sich eine Untersuchung lohnt, und versucht im Hintergrund, das Problem zu reproduzieren und eine Lösung zu finden. Bestätigt sich der Fehler und findet der Agent eine einfache Lösung, bereitet er einen PR vor oder reicht ihn ein. Kommt er zu keinem verwertbaren Ergebnis, stört er das Team nicht. DeepSeek hat diese interne Arbeitsweise selbst beschrieben; sie ist keine unabhängige Bestätigung dafür, dass der öffentlich verfügbare Prototyp in seiner Standardkonfiguration genauso arbeitet.
Tests der GitHub-Community zeigen den aktuellen Stand des Prototyps. Am 1. November 2026 berichtete ein Nutzer, dass er den Open-Source-Prototyp unter Ubuntu nach SETUP.md eingerichtet hatte. Dabei gelang es ihm, eine Issue-Anfrage in den Bearbeitungsprozess einzuspeisen und daraus schließlich einen Pull Request zu erstellen. Allerdings traten auch Probleme auf: GitHub-Benachrichtigungen kamen nicht an, und das System empfing trotz eines unauffälligen Status keine Arbeitsaufträge. Außerdem mussten die Einstellungen zur Beobachtung von Issues und Kommentaren in Source angepasst werden. Auch die Systemsprache und die Konfiguration des GitHub-Kontos führten zu Kompatibilitätsproblemen.
Der Bericht zeigt, dass die Verarbeitungskette vom Ereignis bis zur Aufgabe grundsätzlich funktioniert. Daraus lässt sich aber nicht ableiten, dass das Projekt Bugs bereits zuverlässig rund um die Uhr automatisch erkennt. Und ein erstellter PR bedeutet noch nicht, dass die Änderungen von Menschen geprüft und zusammengeführt wurden.
Die Entscheidungsebene eines ereignisgesteuerten Agenten mit einer Modell-API aufbauen
Wenn Sie sich am Ansatz von Super-agent orientieren möchten, lässt sich die Ebene „programmatisches Gate + LLM Assessment“ am einfachsten umsetzen. Das folgende Beispiel zeigt nur die Logik zur Ereignisbewertung. Es ist weder eine offizielle Implementierung von Super-agent noch ein vollständiges Agentenprodukt.
Minimalbeispiel
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible Schnittstelle
)

event = "登录页面在 Safari 上又打不开了"
resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Modellnamen siehe Modellliste der Plattform
    messages=[{"role": "user", "content": f"判断以下消息是否为故障线索,只回答 yes 或 no:{event}"}]
)
print(resp.choices[0].message.content)
Vollständigen Implementierungscode anzeigen (Gate + Assessment + Annahmemodus)
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Gate-Konfiguration auf Programmebene: deterministische Regeln, kein LLM-Aufruf
ALLOWED_SOURCES = {"github", "feishu"}
ALLOWED_USERS = {"alice", "bob"}
WATCHED_CHANNELS = {"repo/web-frontend", "group/dev-team"}
MODE = "observe"  # off / observe / auto

def gate(event: dict) -> bool:
    """Erste Stufe: kostengünstige Regelfilterung"""
    return (
        event["source"] in ALLOWED_SOURCES
        and event["user"] in ALLOWED_USERS
        and event["channel"] in WATCHED_CHANNELS
    )

def assess(event: dict) -> dict:
    """Zweite Stufe: semantische Bewertung durch das Modell, unterscheidet explicit / inferred"""
    prompt = (
        "你是事件分类器。请判断消息是否包含值得处理的工作,"
        "并区分 explicit(明确请求)或 inferred(推断任务)。"
        '仅输出 JSON:{"actionable": bool, "kind": "explicit|inferred|none", "reason": "..."}\n'
        f"消息:{event['text']}"
    )
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": prompt}],
        max_tokens=200
    )
    try:
        return json.loads(resp.choices[0].message.content)
    except json.JSONDecodeError:
        return {"actionable": False, "kind": "none", "reason": "parse_error"}

def handle(event: dict) -> str:
    if not gate(event):
        return "dropped_by_gate"
    result = assess(event)
    if not result["actionable"]:
        return "ignored"
    if result["kind"] == "explicit":
        return "create_task_with_mandate"   # Der Berechtigungsumfang muss weiterhin geprüft werden
    # Abgeleitete Aufgaben nach Annahmemodus behandeln
    if MODE == "off":
        return "ignored"
    if MODE == "observe":
        return f"logged_for_review: {result['reason']}"
    return "auto_accept_if_policy_allows"

print(handle({
    "source": "feishu", "user": "alice",
    "channel": "group/dev-team",
    "text": "最近构建有时会失败"
}))
🚀 Tipp für den schnellen Einstieg: Zum Testen der Ereignisbewertung können Sie sich zunächst über APIYI apiyi.com kostenloses Testguthaben holen. Wechseln Sie mit demselben Code zwischen verschiedenen Modellen, vergleichen Sie Klassifizierungsgenauigkeit und Tokenverbrauch und entscheiden Sie dann, welches Modell Sie für welche Ebene einsetzen.
Ansatz für eine mehrstufige Modellsteuerung
Die Struktur von Super-agent lässt sich so zusammenfassen: externes Ereignis → programmatische Filterung → semantische Prüfung durch ein Modell → Autorisierungsentscheidung → Ausführung durch den Agenten → Bereitstellung des Ergebnisses. Dabei muss nicht auf jeder Stufe dasselbe Modell zum Einsatz kommen:
| Stufe | Art der Aufgabe | Ansatz für die Modellauswahl |
|---|---|---|
| Programmatisches Gate | Abgleich von Quelle, Nutzer und Geltungsbereich | Kein LLM erforderlich |
| Ereignisklassifizierung | Häufige Ereignisse, kurze Texte, strukturierte Ausgabe | Kostengünstiges Modell mit geringer Latenz |
| Komplexe Ausführung | Code reproduzieren und korrigieren, Schlussfolgerungen mit langem Kontext | Leistungsfähigeres Modell |
| Ergebniszusammenfassung und Benachrichtigung | Zusammenfassung, strukturierte Bereitstellung | Unabhängig konfigurierbar |
💡 Empfehlung zur Auswahl: Ob eine mehrstufige Steuerung tatsächlich Kosten spart, muss anhand echter Logs und Tests im jeweiligen Anwendungsfall überprüft werden. Es lässt sich nicht einfach voraussetzen, dass die Orchestrierung mehrerer Modelle günstiger ist. Über die einheitliche Schnittstelle von APIYI apiyi.com lassen sich die Modelle auf den einzelnen Stufen schnell austauschen und per A/B-Test vergleichen, ohne den Anwendungscode zu ändern.
Auswirkungen der ereignisgesteuerten Super-agent-Architektur
Auswirkungen auf Entwickler in Forschung, Entwicklung und Automatisierung
- Der Einstiegspunkt verlagert sich vom Chatfenster in den Workflow: Issues, PR-Kommentare, CI-Ergebnisse und Gruppenchats werden zu natürlichen Eingaben für den Agenten. Entwickler müssen daher die Ereignisanbindung und -filterung gestalten, statt nur Eingabeaufforderungen zu schreiben.
- Das Autorisierungskonzept wird zur Kernkompetenz: Die Unterscheidung zwischen Explicit und Inferred, der Modus zur Aufgabenannahme und der Geltungsbereich des Mandats entscheiden darüber, ob ein Agent in echten Teams akzeptiert wird.
- Die Bewertung muss sich ändern: Bei proaktiven Agenten zählt nicht nur, wie viele Aktionen sie ausführen. Wichtiger sind die Qualität der Aufgabenerkennung, der Anteil an Nacharbeit und die Anzahl nutzloser Benachrichtigungen.
Auswirkungen auf Teams für KI-Anwendungen in Unternehmen
Proaktive Agenten bieten Potenzial für die Zusammenarbeit in der Entwicklung, die Fehleranalyse und die Automatisierung von Unternehmensprozessen. Allerdings verändert sich die Kostenstruktur. Die Ereignisbewertung verbraucht fortlaufend Token, spekulative Ausführungen können Arbeit erzeugen, deren Ergebnisse nicht übernommen werden, und komplexe Aufgaben erfordern zudem eine menschliche Prüfung. Der folgende Bewertungsrahmen basiert auf der offiziellen Architektur; er enthält keine offiziell von DeepSeek veröffentlichten Leistungskennzahlen:
| Bewertungsdimension | Empfohlene Kennzahlen |
|---|---|
| Qualität der Aufgabenerkennung | Erkennungsrate relevanter Ereignisse, Fehlauslösungsrate, Anteil doppelter Aufgaben |
| Ausführungsqualität | Anteil abgeschlossener Aufgaben, Anteil menschlicher Nacharbeit, Anteil der Ergebnisse, die eine Prüfung bestehen |
| Nutzererfahrung | Anzahl menschlicher Eingriffe pro sinnvoller Aufgabe, Anzahl nutzloser Benachrichtigungen, Zeit vom Auftreten eines Problems bis zu einem abnahmefähigen Ergebnis |
| Betriebskosten | Token-Verbrauch pro Ereignisbewertung, Modellkosten pro erfolgreich abgeschlossener Aufgabe, Kosten nicht übernommener spekulativer Aufgaben |
| Sicherheitsgovernance | Anteil abgefangener nicht autorisierter Aufgaben, Wirksamkeit von Freigaben an kritischen Punkten, Umgang mit sensiblen Informationen innerhalb des autorisierten Bereichs |
Risiken, die ernst genommen werden müssen
Zu den Risiken proaktiver Agenten gehören Fehlauslösungen, Aufgabenstürme, Überschreitungen von Berechtigungen, Prompt Injection, Ressourcenverschwendung und Datenlecks. DeepSeek räumt in seinem technischen Artikel ebenfalls ein, dass Fragen zur Kontextisolierung, zum Langzeitgedächtnis, zur sicheren Kommunikation und zum Datenschutz in komplexen Organisationen noch ungelöst sind. Bei Agenten mit Zugriff auf private Repositorys und lokale Zugangsdaten muss bereits vor der Bereitstellung berücksichtigt werden, wie sich verhindern lässt, dass sensible Informationen in den Modellkontext oder an externe Kanäle gelangen.
Häufig gestellte Fragen (FAQ)
Q1: Was ist die ereignisgesteuerte Architektur des DeepSeek Super-agent?
Bei dieser Architektur empfängt ein Agent laufend Ereignisse aus seiner Umgebung (Trigger). Nach einer programmatischen Filterung und einer Bewertung durch das Modell erstellt er im Rahmen seiner Befugnisse Aufgaben, führt sie im Hintergrund aus und benachrichtigt bei Bedarf einen Menschen. Ausgangspunkt ist damit nicht mehr eine „Nutzeranweisung“, sondern ein „Umgebungsereignis“. Über Berechtigungen und Freigaben entscheiden aber weiterhin Menschen.
Q2: Verlieren Nutzer die Kontrolle, wenn der Agent selbstständig Aufgaben ableitet?
Nein. Abgeleitete Aufgaben (Inferred) müssen Zulassungsregeln, Ausführungsgrenzen und Freigabeanforderungen einhalten. Der öffentliche Prototyp verwendet standardmäßig den Modus `observe`: Er protokolliert mögliche Aufgaben, übernimmt sie aber nicht automatisch. Nutzer können die Aufgabenableitung mit `off` vollständig abschalten oder nach Prüfung der Protokolle `auto` aktivieren. Der Mandate-Mechanismus stellt außerdem sicher, dass Nachrichten wie Kommentare die Berechtigungen nicht unmittelbar erweitern können.
Q3: Was kann der Open-Source-Prototyp derzeit leisten?
Der öffentliche Prototyp unterstützt vor allem GitHub und eine optionale Feishu-Integration. Er bietet bereits drei Modi zur Aufgabenübernahme und den Mandate-Mechanismus zur Autorisierung. Aus der Community gibt es Berichte über erfolgreich durchlaufene Prozesse von Issue → PR. Beim Deployment treten jedoch Probleme auf, etwa nicht zugestellte Benachrichtigungen und inkompatible Konfigurationen. Ereignisquellen wie E-Mail und Kalender sowie eine standardmäßig aktivierte vollständige asynchrone Architektur gehören derzeit noch zu weitergehenden Plänen oder internen Implementierungen.
Q4: Wie lassen sich die Token-Kosten eines proaktiven Agenten kontrollieren?
Entscheidend ist eine zweistufige Filterung: Zunächst hält ein programmatisches Gate ohne LLM-Aufruf die meisten irrelevanten Ereignisse zurück. Nur eine kleine Auswahl wird dem Modell zur Bewertung vorgelegt. Außerdem sollte spekulative Ausführung zurückhaltend eingesetzt werden: Nur Aufgaben mit erkennbarem Nutzen werden vorab vorbereitet. Bei der Entwicklung lässt sich anhand der Nutzungsstatistik von APIYI apiyi.com beobachten, welche Modellkosten pro Ereignisbewertung und pro erfolgreich abgeschlossener Aufgabe anfallen. Darauf aufbauend können Filterregeln und Modellkonfiguration angepasst werden.
Q5: Wie lässt sich mit einer Modell-API eine ähnliche Ebene zur Ereignisbewertung aufbauen?
Als Ausgangspunkt dient das Beispiel in diesem Artikel: Das programmatische Gate filtert nach Regeln, das LLM Assessment liefert eine strukturierte Bewertung und anschließend werden abgeleitete Aufgaben entsprechend dem Modus zur Aufgabenübernahme behandelt. Für die Modellaufrufe genügt eine OpenAI-kompatible Schnittstelle. Nach der Registrierung bei APIYI apiyi.com erhalten Sie einen API-Schlüssel und ein Testguthaben. Lassen Sie die base_url im Beispiel auf der in diesem Artikel angegebenen Adresse, um es auszuführen. Wichtig: Das Beispiel übernimmt lediglich die Architekturidee. APIYI stellt Modell-APIs bereit, aber keinen fertigen Super-agent-Dienst.
Q6: Welche Einschränkungen des Super-agent sind derzeit bekannt?
Zu den wichtigsten Einschränkungen gehören die begrenzten Ereignisquellen des öffentlichen Prototyps und Kompatibilitätsprobleme bei der Deployment-Konfiguration. Interne Beispiele für „stille Reparaturen“ wurden noch nicht unabhängig durch Dritte überprüft. „Im Hintergrund ausführen“ bedeutet zudem nicht, dass ein zuverlässiger Betrieb rund um die Uhr garantiert ist. Generierte PRs müssen weiterhin von Menschen geprüft werden. Auch die Kontextisolierung innerhalb von Organisationen, das Langzeitgedächtnis und Datenschutzfragen sind laut den Verantwortlichen noch nicht abschließend gelöst.
DeepSeek Super-agent: Die wichtigsten Punkte
- Der zentrale Wandel: Der Agent wird nicht mehr nur durch Nutzeranweisungen aktiv, sondern auch durch Ereignisse in seiner Umgebung. Das Chatfenster ist nicht länger der einzige Einstiegspunkt.
- Zweistufige Filterung: Ein programmatisches Gate hält irrelevante Ereignisse kostengünstig zurück; das LLM Assessment übernimmt die semantische Bewertung. So bleiben Kosten und Genauigkeit im Gleichgewicht.
- Autorisierung zuerst: Explicit und Inferred werden getrennt behandelt,
observeist der Standardmodus. Das Mandate verhindert, dass Nachrichten die erteilte Autorisierung verändern. - Proaktive Ausführung: Spekulative Ausführung und asynchrone Aufgaben verkürzen menschliche Wartezeiten. Rechenkosten und tatsächlicher Nutzen müssen jedoch gegeneinander abgewogen werden.
- Ergebnisse ohne unnötige Unterbrechungen: Kommuniziert wird nur, wenn eine Entscheidung oder Abnahme erforderlich ist. Proaktivität bedeutet nicht, häufiger zu benachrichtigen.
- Nüchterne Einschätzung: Interne Beispiele zeigen das Potenzial, und der Open-Source-Prototyp kann den Ablauf Issue → PR bereits durchlaufen. Sein Reifegrad ist aber noch begrenzt.
- Für die eigene Umsetzung: Eine Ereignisbewertung lässt sich zunächst mit Modell-APIs aufbauen. Über APIYI apiyi.com können Sie Klassifizierungsleistung und Kosten verschiedener Modelle vergleichen.
Fazit
Die ereignisgesteuerte Architektur von DeepSeek Super-agent beantwortet nicht die Frage „Kann KI selbst Entscheidungen treffen?“, sondern: „Wie kann ein Agent innerhalb vorgegebener Regeln und Autorisierungen proaktiv Arbeit übernehmen?“ Die wichtigsten Mechanismen lassen sich in drei Punkten zusammenfassen:
- Wahrnehmung und Filterung: Trigger machen Ereignisse aus der Arbeitsumgebung zu Eingaben; eine zweistufige Filterung begrenzt irrelevante Ereignisse und Token-Kosten.
- Autorisierung und Kontrolle: Die Unterscheidung zwischen Explicit und Inferred, drei Modi zur Aufgabenannahme und der Geltungsbereich des Mandate sorgen dafür, dass proaktives Handeln nicht zur Kompetenzüberschreitung wird.
- Ausführung und Ergebnisbereitstellung: Spekulative Ausführung, asynchrone Aufgaben und zurückhaltende Benachrichtigungen verlagern die menschliche Rolle vom „Aufgaben verwalten“ hin zum „Entscheiden und Abnehmen“.
Der Wert eines proaktiven Agenten bemisst sich nicht daran, wie viele Aktionen er ausführt, sondern daran, wie viel menschlichen Verwaltungsaufwand er einspart und wie viele vertrauenswürdige Ergebnisse er liefert. Der aktuelle Open-Source-Prototyp befindet sich noch in einer frühen Phase. Deshalb empfiehlt es sich, im Modus observe zu beginnen, Bewertungen zu protokollieren und schrittweise Vertrauen aufzubauen. Wenn Sie eine ähnliche Kette zur Ereignisbewertung und Aufgabenausführung entwickeln, können Sie über APIYI apiyi.com schnell prüfen, wie sich verschiedene Modelle auf den einzelnen Ebenen schlagen, und anschließend anhand realer Geschäftsdaten abwägen.
📚 Weiterführende Quellen
- DeepSeek Super-agent Architekturstudie: Analyse des ereignisgesteuerten und proaktiven Agent-Designs
- Link:
blog2.eimoon.com/p/deepseek-super-agent-design/ -
Inhalt: Trigger, spekulative Ausführung, asynchrone Aufgaben und interne Anwendungsfälle
-
DeepSeek-Autorisierungsdokumentation: Explicit/Inferred, Auftragsannahmemodi und Mandate
- Link:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/002-authorization.md -
Inhalt: Maßgebliche Quelle zum Verständnis der drei Modi
off,observeundauto -
DeepSeek-Produktdesignphilosophie: Möglichst wenig Störungen und ein bewusster Umgang mit Aufmerksamkeit
- Link:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/000-philosophy.md -
Inhalt: Erklärt, warum ein proaktiver Agent nicht ständig auf sich aufmerksam machen sollte
-
DeepSeek Domain Model: Definitionen zentraler Domänenkonzepte
- Link:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/001-domain.md -
Inhalt: Hilft dabei, die Beziehungen zwischen Aufgaben, Workern und Ereignissen besser zu verstehen
-
DeepSeek-Setup-Anleitung: Installationsanleitung für den Open-Source-Prototyp
- Link:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/SETUP.md -
Inhalt: Pflichtlektüre vor der eigenen Einrichtung
-
Erfahrungsbericht aus der GitHub-Community: Praxistest von Issue → PR und Probleme bei der Einrichtung
- Link:
github.com/deepseek-ai/deepseek-harness/discussions/11706 - Inhalt: Einblicke in den tatsächlichen Betriebszustand und die Grenzen des aktuellen Prototyps
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI. Weitere Informationen zur Modellanbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com.