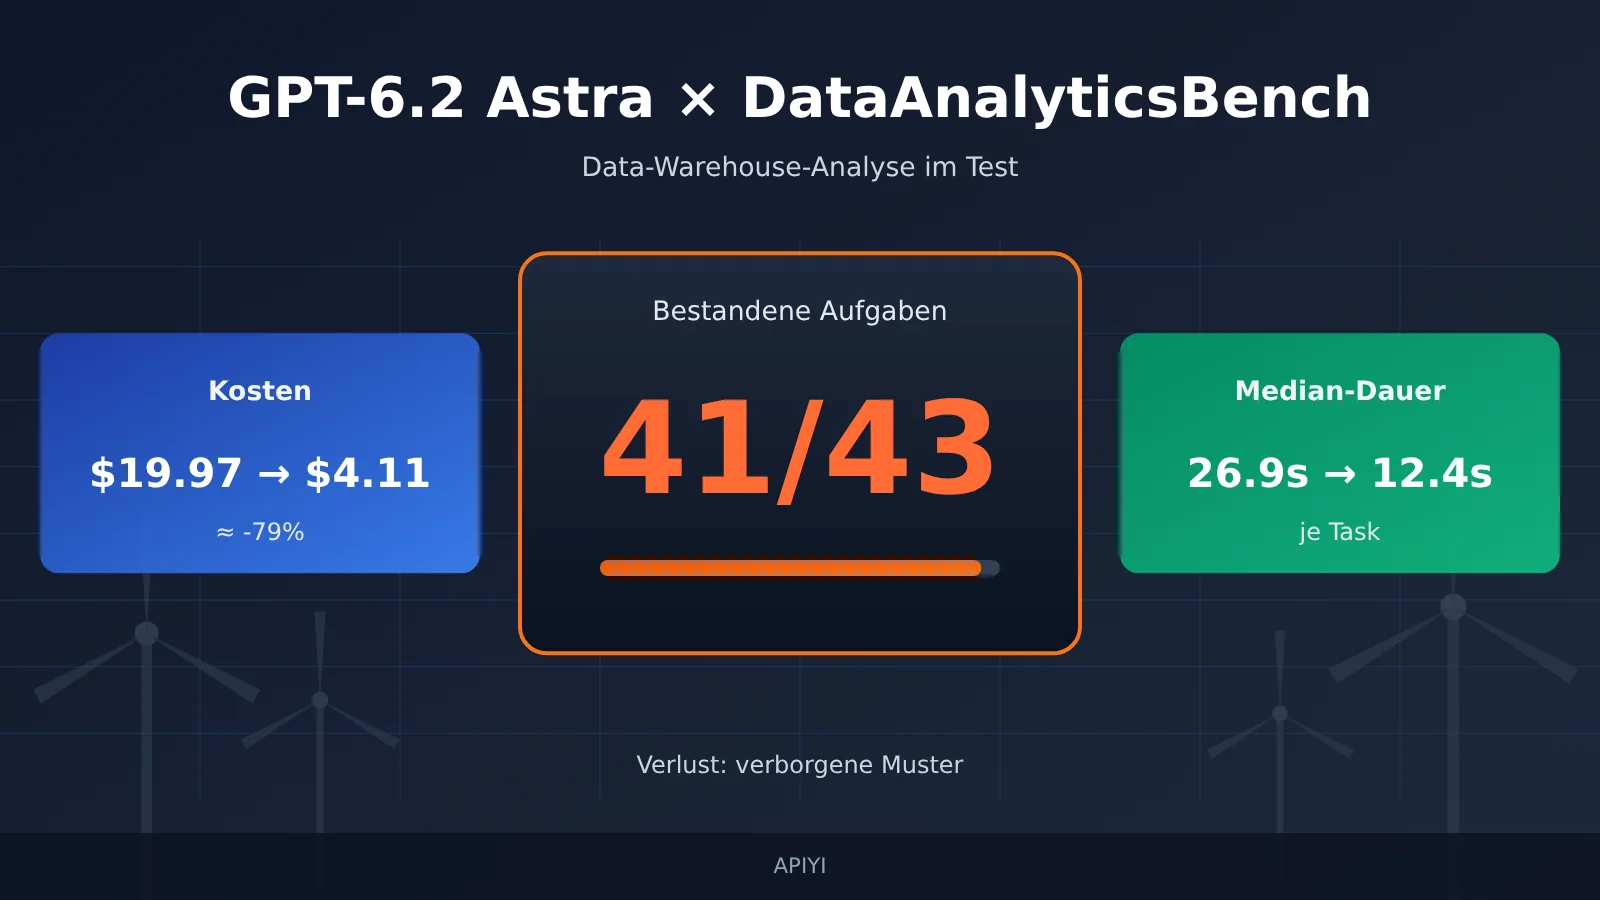
Kernaussage: Im DataAnalyticsBench-Praxistest von Plotly besteht GPT-6.2 Astra 41 von 43 Datenanalyseaufgaben. Die Vorgängergeneration GPT-6 Astra erreichte 43/43. Beide verlorenen Punkte entfallen auf die Aufgabenkategorie „verborgene Muster“; die übrigen fünf Kategorien werden vollständig bestanden. Gleichzeitig sanken die Kosten für den gesamten Durchlauf von $19.97 auf $4.11 und der Median der Bearbeitungszeit pro Aufgabe von 26.9 Sekunden auf 12.4 Sekunden. Die neue Astra-Generation erkauft sich mit dem Verlust von zwei Aufgaben Kosten von weniger als einem Viertel und Wartezeiten von weniger als der Hälfte der Vorgängergeneration. Ob sie bei der proaktiven Suche nach Anomalien wirklich Rückschritte macht, lässt sich mit nur einer Datenrunde nicht sagen; dafür braucht es Nachtests mit eigenen Daten.
Was Sie aus diesem Artikel mitnehmen können:
- Was DataAnalyticsBench misst, wie bewertet wird und wo die Grenzen der 41/43-Punktzahl liegen.
- Die Punktzahlen in den sechs Aufgabenkategorien und wie die beiden verlorenen Aufgaben jeweils scheiterten.
- Die zwei Quellen des Kostenrückgangs um rund 79 %: niedrigere Tarife und geringerer Aufwand – und wie viel jeweils dazu beiträgt.
- Die Abwägungen zwischen GPT-6.2 Astra und GPT-6 Astra, GPT-6.1 Sol sowie GPT-6.2 Sol bei Punktzahl, Kosten und Latenz.
- Eine direkt anpassbare Nachtest-Methodik und Python-Code, mit denen Sie die Schlussfolgerungen in Ihrem eigenen Data Warehouse überprüfen können.
Index: Die To-Know-Tabelle erklärt die im Benchmark verwendeten Fachbegriffe; der Impact-Überblick fasst die Bedeutung dieser Nachricht je nach Zielgruppe zusammen. Im Abschnitt „Objektive Fakten“ werden nacheinander Testumgebung und Bewertungsregeln, die Punktzahlen in den sechs Aufgabenkategorien, Kosten- und Laufzeitdaten sowie die offizielle Modellidentität und Preislogik von OpenAI dargestellt. Der Abschnitt „Analyse und Einschätzung“ interpretiert die Bedeutung von 41/43, stellt Erklärungshypothesen für die verlorenen Punkte bei den Aufgaben zu verborgenen Mustern auf, zerlegt die Quellen des Kostenrückgangs und gibt Empfehlungen zur Auswahl sowie Code für den Nachtest.
GPT-6.2 Astra DataAnalyticsBench – die wichtigsten Grundbegriffe
| Begriff | Kurze Erklärung |
|---|---|
| DataAnalyticsBench | 43 Data-Warehouse-Analyseaufgaben, entworfen von Forschern von Plotly und Mila, die die Analysefähigkeit von Modellen an simulierten Windkraftbetriebsdaten prüfen |
| Testlaufumgebung | Ein Evaluierungssystem, das jedem Modell dasselbe Data Warehouse sowie schreibgeschützte Werkzeuge zum Abfragen, Zeichnen und Anzeigen von Tabellen bereitstellt |
| Bewertungsregeln | Für jede Aufgabe wird festgelegt, welche Antwort die Aufgabenstellung hinreichend erfüllt; es gibt nur bestanden oder nicht bestanden, keine Teilpunkte |
| Datenqualitätsprobleme | Eingabeprobleme wie fehlende, doppelte oder anomale Datensätze, die die Analyseergebnisse beeinflussen können und absichtlich in die Aufgaben eingebaut wurden |
| Statistische Fallstricke | Aufgaben, bei denen intuitive Algorithmen oder Aggregationsmethoden zu falschen Schlussfolgerungen führen können |
| Versteckte Muster | Anomale Muster oder Ursachen, die in der Aufgabenstellung nicht genannt werden und die das Modell aktiv aufspüren muss |
| Median der Bearbeitungszeit pro Aufgabe | Der Median der tatsächlichen Bearbeitungszeit der 43 Aufgaben; diese Rangliste enthält die Zeit für Tool-Abfragen |
| Kosten pro vollständigem Durchlauf | Die kumulierten Aufrufkosten eines Modells für alle 43 Aufgaben |
| Cache-Treffer | Der Teil der Eingabe-Token, der nach dem serverseitigen Caching eines wiederholten Eingabe-Präfixes zu einem niedrigeren Preis abgerechnet wird |
Auswirkungen der DataAnalyticsBench-Bewertung von GPT-6.2 Astra auf verschiedene Zielgruppen im Überblick
- API-Auswahlentscheider: Bei GPT-6.2 Astra haben sich die Kosten pro Einheit und die Antwortgeschwindigkeit deutlich verbessert. Aufgaben wie Standardberichte oder die Klärung von Kennzahlen-Definitionen können vorrangig in Betracht gezogen werden. Bei Aufgaben zur Anomalieanalyse sollten die Benchmark-Ergebnisse derzeit noch nicht direkt übernommen werden.
- Entwickler von Datenprodukten: Bei Produkten wie „Natural-Language-Query“ oder BI-Assistenten wirkt sich die Halbierung der medianen Latenz stark auf das Interaktionserlebnis aus. Allerdings sollte die „Geduld“ des Modells bei mehrstufigen Explorationen separat bewertet werden; bei Bedarf sollten in der Eingabeaufforderung oder im Workflow zusätzliche Prüfschritte erzwungen werden.
- Analyseteams: Das Modell kann als schneller Analyst für erste Entwürfe dienen, aber Schlussfolgerungen aus Ursachenanalysen müssen weiterhin manuell überprüft werden. Mit einer OpenAI-kompatiblen Aggregationsschnittstelle wie APIYI apiyi.com lassen sich die vier Modelle in derselben Codebasis für Vergleichstests umschalten.
GPT-6.2 Astra DataAnalyticsBench – objektive Fakten
GPT-6.2 Astra: Testumgebung und Bewertungsregeln
DataAnalyticsBench wurde von Forschenden von Plotly und Mila entwickelt und nutzt ein simuliertes Data Warehouse für den Betrieb von Windenergieanlagen. Das Warehouse umfasst 44 Tabellen, rund 19,9 Millionen Zeilen und 554 Spalten, mit Daten aus Anlagen-Telemetrie, Alarmen, Wartungsaufträgen, Inspektionen und Wetter. Jede Aufgabe läuft in Plotly Studio Embedded, wobei das Modell über OpenRouter aufgerufen wird. Dem Modell stehen nur vier schreibgeschützte Werkzeuge zur Verfügung: Datensätze auflisten, SQL ausführen, Diagramme erstellen und Tabellen anzeigen.
Das Modell entscheidet selbst über den Abfrageweg und den Zeitpunkt der Antwort – die Testseite gibt ihm keine Schritte vor. Das bedeutet, die Evaluierung prüft nicht nur das Schreiben von SQL, sondern auch die Einschätzung, „bis zu welchem Punkt man genug nachgeforscht hat“.
Bei der Bewertung wird jede Aufgabe einzeln anhand des Lösungsschlüssels und der Bewertungsregeln als bestanden oder nicht bestanden gewertet, Teilpunkte gibt es nicht. Das Bewertermodell ist Claude Sonnet 5 mit Temperatur 0. Der Veranstalter erzeugt die Antworten unabhängig auf drei Wegen – per SQL, pandas und Polars – und gleicht sie gegenseitig ab, außerdem prüft er fehlgeschlagene Verläufe manuell und kontrolliert auch die Ergebnisse mit voller Punktzahl. Zwei Sondertypen von Aufgaben haben klare Bestehensbedingungen:
- Mehrdeutige Aufgaben: Das Modell besteht, wenn es die Frage klärt oder seine Annahmen offenlegt und eine alternative Lösung anbietet.
- Aufgaben mit nicht beantwortbaren Daten: Das Modell besteht, wenn es die Grenzen der vorhandenen Daten korrekt benennt.
Der Aufgabenpool hat ebenfalls klare Grenzen: eine einzige Geschäftsdomäne (Windenergiebetrieb), Englisch, eine gemeinsame Testumgebung, jeder Modelllauf nur eine Runde. Aufgaben, Daten und Lösungsschlüssel behält der Veranstalter zurück, sie werden nicht öffentlich gemacht.
Quelle: Plotly, Introducing DataAnalyticsBench, veröffentlicht am 14.10.2026, aktualisiert am 19.11.2026, plotly.com/blog/introducing-dataanalyticsbench/
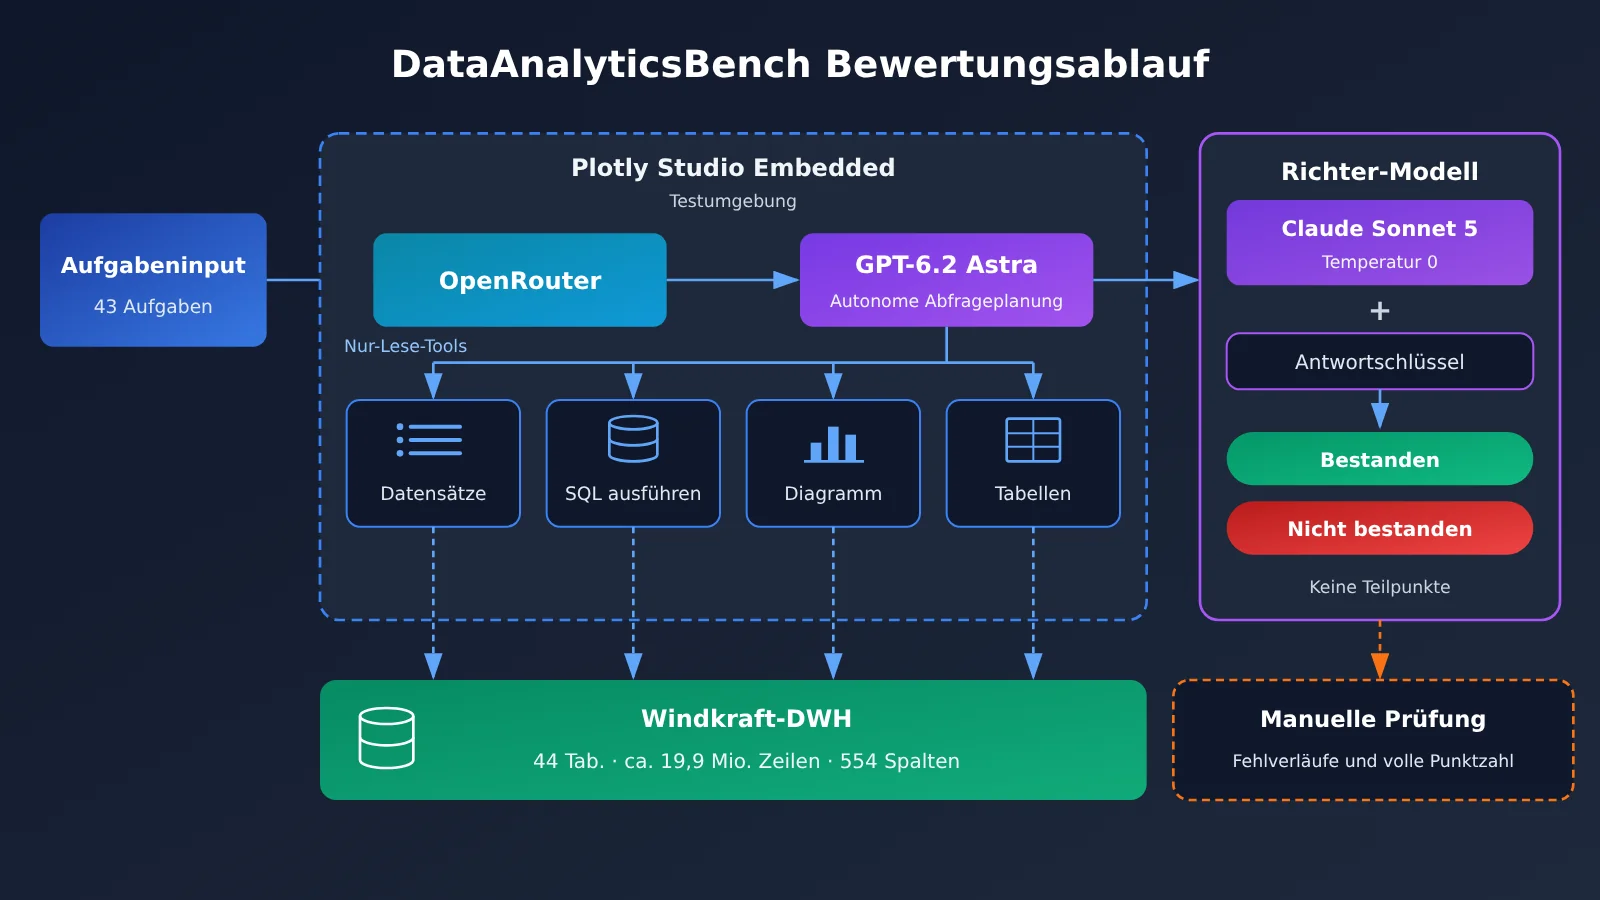
Erläuterung zur Grafik: Diese Struktur aus „Modell plant seine Abfragen selbst + schreibgeschützte Werkzeuge + Bestanden/Nicht-bestanden pro Aufgabe“ lässt sich in der eigenen Umgebung näherungsweise mit der OpenAI-kompatiblen Schnittstelle von APIYI apiyi.com nachbauen, um interne Vergleichstests durchzuführen.
Punktzahlen von GPT-6.2 Astra in sechs Aufgabenkategorien: Verluste konzentrieren sich auf versteckte Muster
Der von Plotly am 17. November 2026 veröffentlichte Astra-Spezialbericht liefert die Punktzahlen nach Kategorien:
| Aufgabenkategorie | GPT-6.2 Astra | GPT-6 Astra | Prüfpunkt |
|---|---|---|---|
| Routineanalyse | 20/20 | 20/20 | mehrstufige SQL-Abfragen, Tabellen-Joins und Zeitintervalle |
| Mehrdeutigkeitsbeurteilung | 5/5 | 5/5 | Definition klären oder plausible Annahmen darlegen |
| Nicht beantwortbare Datenfragen | 5/5 | 5/5 | nicht beantwortbare Fragen anhand der vorhandenen Daten erkennen |
| Datenqualität | 3/3 | 3/3 | eingepflanzte Qualitätsprobleme erkennen |
| Statistische Fallstricke | 5/5 | 5/5 | mögliche Irreführung durch intuitive Algorithmen erkennen |
| Versteckte Muster | 3/5 | 5/5 | nicht ausdrücklich genannten anomalen Mustern aktiv nachgehen |
| Gesamt | 41/43 | 43/43 | alle Aufgaben gleich gewichtet, Aufgabe für Aufgabe auf Bestehen geprüft |
Die ersten fünf Kategorien ergeben zusammen 38/38, beide Generationen schneiden hier völlig identisch ab. Der gesamte Unterschied stammt aus den Aufgaben zu versteckten Mustern: Die neue Generation erreicht 3/5, die vorherige 5/5.
Beide Aufgaben mit Punktverlust wurden von Plotly manuell nachgeprüft; die Fehlerarten unterscheiden sich:
- In einer Aufgabe gelang es dem Modell nie, das eingepflanzte Muster zu lokalisieren.
- In der anderen Aufgabe fand das Modell die Stelle, die untersucht werden sollte, schloss aber die eigentliche Ursache aus.
Der Bericht nennt außerdem eine Prozesskennzahl: Bei den Aufgaben zu versteckten Mustern führte GPT-6.2 Astra im Durchschnitt etwa 9 Datenbankabfragen pro Aufgabe aus, GPT-6 Astra etwa 15.
Quelle: Plotly, GPT-6.2 Astra Benchmark Results for Data Analysis, 17.11.2026, plotly.com/blog/gpt-6-2-astra-plotly-data-analytics-bench/
GPT-6.2 Astra: Kosten und Laufzeit – zwei Generationen und Varianten desselben Anbieters im Vergleich
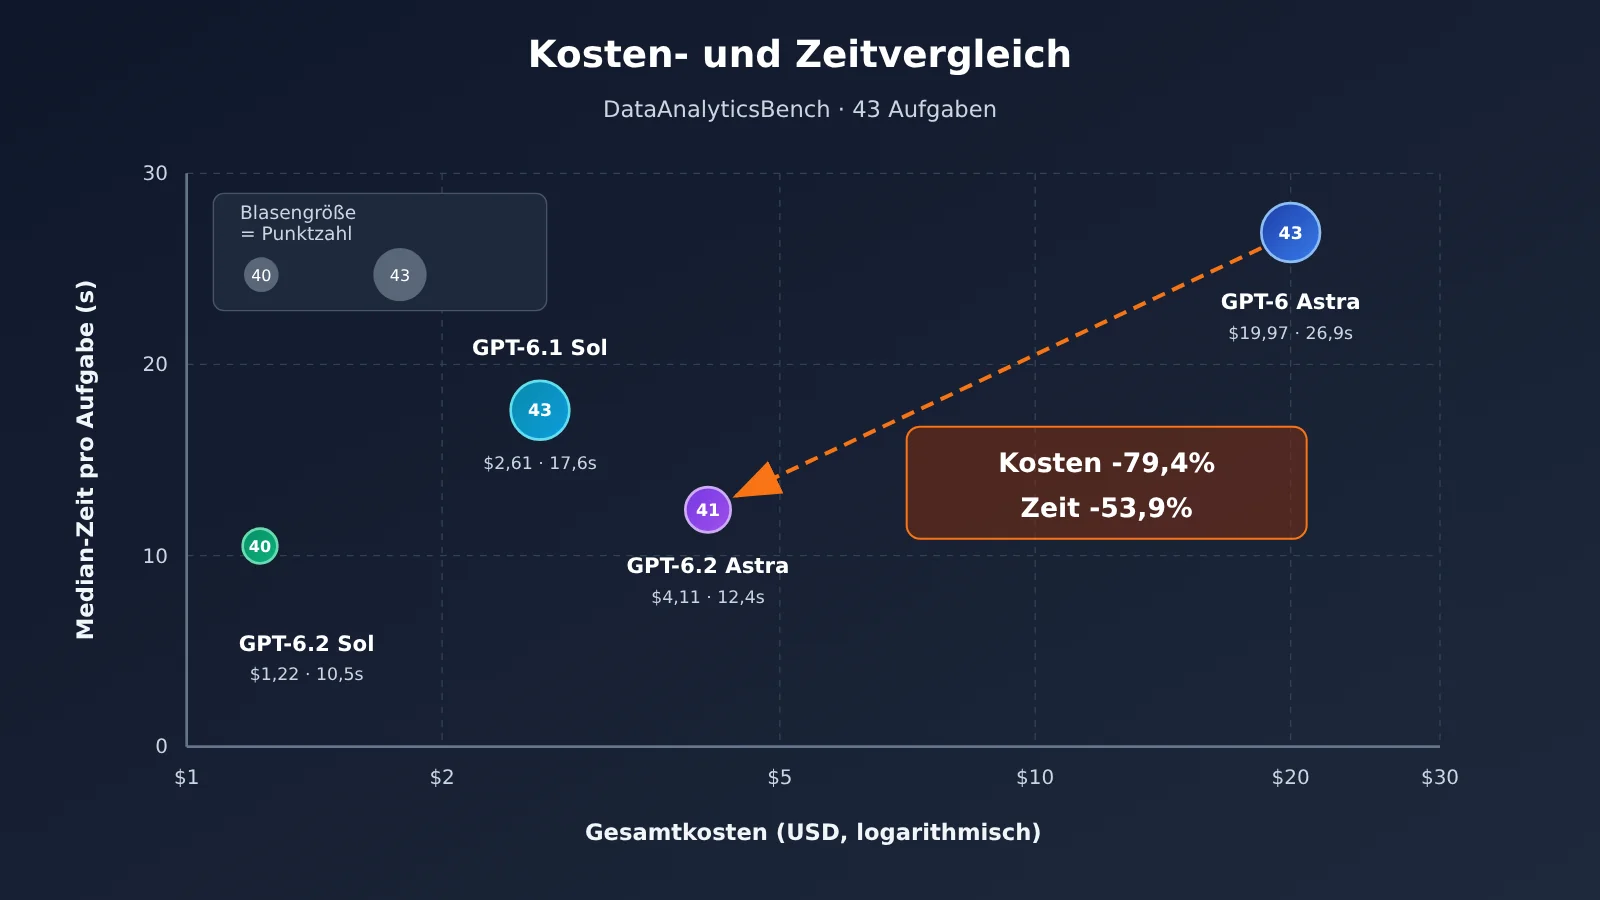
| Modell | Punktzahl | Kosten pro Durchlauf | Medianzeit pro Aufgabe |
|---|---|---|---|
| GPT-6.2 Astra | 41/43 | $4.11 | 12.4 Sekunden |
| GPT-6 Astra | 43/43 | $19.97 | 26.9 Sekunden |
| GPT-6.1 Sol | 43/43 | $2.61 | 17.6 Sekunden |
| GPT-6.2 Sol | 40/43 | $1.22 | 10.5 Sekunden |
Rechnet man mit der ursprünglichen Tabelle, so sinken bei GPT-6.2 Astra die Kosten für einen vollständigen Durchlauf gegenüber der Vorgängergeneration um rund 79,4 %, die mediane Zeit pro Aufgabe verkürzt sich um etwa 53,9 %. In den eigenen Messungen des Autors dauert ein kompletter Durchlauf mit 6.2 Astra etwa 13 Minuten, mit der Vorgängergeneration etwa 32 Minuten. Die angegebene Zeit ist die tatsächlich verstrichene Zeit inklusive der Tool-Abfragen – nicht die reine Inferenzzeit des Modells.
Für die Kosten pro Aufgabe gibt es zwei Bezugsgrößen, die man getrennt betrachten muss: $4.11 ÷ 43 ergibt umgelegt etwa $0.096 pro Aufgabe; die aktualisierte Gesamtrangliste weist dagegen $0.066 als Median der Kosten pro Aufgabe in diesem Durchlauf aus. Der Durchschnittswert liegt über dem Median – das heißt, einige wenige Aufgaben waren deutlich teurer und haben den Mittelwert nach oben gezogen.
Plotly stellt außerdem die Arbeitsumfangs-Details der ursprünglichen Durchläufe beider Generationen bereit:
| Kennzahl zum Arbeitsumfang | GPT-6 Astra (Vorgänger) | GPT-6.2 Astra |
|---|---|---|
| Anzahl Tool-Aufrufe | 266 | 148 |
| Anzahl Modellaufrufe | 249 | 171 |
| Input-Token | ca. 9,1 Mio. | ca. 4,4 Mio. |
| Output-Token | ca. 78.000 | ca. 34.000 |
| Anteil Cache-Treffer beim Input | 93 % | 98 % |
Rechnet Plotly den unveränderten Verbrauch der Vorgängergeneration mit den neuen Tarifen nach, kommt eine Schätzung von etwa $11 heraus. Zu beachten ist dabei: Diese Kosten beruhen auf den OpenRouter-Preisen zum Zeitpunkt von Plotlys Tests und sind keine direkte Umrechnung der offiziellen OpenAI-Preisliste.
Quelle: Plotly-Spezialreport zu Astra plotly.com/blog/gpt-6-2-astra-plotly-data-analytics-bench/; Plotly-Gesamtranking plotly.com/blog/introducing-dataanalyticsbench/#full-results
Modellidentität und offizielle Preisangaben zu GPT-6.2 Astra
OpenAI hat am 17. November 2026 GPT-6.2 Astra und GPT-6.2 Sol veröffentlicht. Astra richtet sich an komplexe Schlussfolgerungen, Programmierung und professionelle Arbeit; die API-Modell-ID lautet gpt-6.2-astra. Die Bewertungen in der OpenAI-Ankündigung folgen der Herstellerperspektive, während Plotlys DataAnalyticsBench ein separates Bewertungsset eines Drittanbieters ist – beides darf nicht miteinander vermischt verglichen werden.
Laut Modellkarte akzeptiert Astra Text- und Bildeingaben und gibt Text aus, bei einem Kontextfenster von 1,050,000 Tokens, maximal 922,000 Eingabe-Tokens und maximal 128,000 Ausgabe-Tokens. Es unterstützt sowohl die Responses API als auch die Chat Completions API; Funktionen wie integrierte Tools, Multi-Agent und Hintergrund-Completion-Fenster richten sich nach der Responses API. Die Modellkarte weist außerdem darauf hin, dass Anfragen mit reasoning.effort auf none abgelehnt werden.
Die Standardpreise von OpenAI für kurzen Kontext und reinen Text (pro Million Tokens) lauten: reguläre Eingabe $8, Eingabe mit Cache-Treffer $0.40, Ausgabe $40. Laut OpenAI sind die Stückpreise für reguläre Eingabe und Ausgabe im Vergleich zur Vorgängergeneration um 20 % gesunken, der Stückpreis für Eingaben mit Cache-Treffer um 60 %.
Quellen: OpenAI-Ankündigung openai.com/index/introducing-gpt-6-2-astra-sol/; Modellkarte developers.openai.com/api/docs/models/gpt-6.2-astra; API-Changelog developers.openai.com/api/docs/changelog; Preistabelle developers.openai.com/api/docs/pricing
GPT-6.2 Astra DataAnalyticsBench – Analyse und Einschätzung
Wie 41/43 zu lesen ist: nicht „insgesamt schwächer“
Schlüsselt man 41/43 auf, zeigt sich: GPT-6.2 Astra hat bei den fünf Aufgabentypen Routineanalyse, Mehrdeutigkeit, unbeantwortbare Fragen, Datenqualität und statistische Fallstricke keine Punkte verloren. Diese fünf Typen decken einen Großteil der Szenarien ab, die im Alltagsreporting und beim Abgleich von Kennzahlen-Definitionen auftauchen. Wenn es im Geschäft vor allem um solche Fragen geht, deutet diese Datenrunde darauf hin, dass die Qualität der neuen Astra-Generation mit der Vorgängergeneration vergleichbar ist – bei Kosten und Geschwindigkeit aber deutlich besser.
Die Lücke von zwei Aufgaben muss man im Kontext der Schwankungsbreite betrachten. Laut Plotly-Bericht gab es bei Wiederholungsläufen mit anderen Modellen Schwankungen von bis zu drei Aufgaben. 41 gegenüber 43 ist daher eher als Beobachtungswert dieser Runde zu verstehen, nicht als stabiler Unterschied in der Fähigkeit. Genauer gesagt: In der Kategorie der verborgenen Muster gibt es ein Signal, das es wert ist, weiterverfolgt zu werden. Die Daten einer einzelnen Runde reichen aber nicht aus, um einen Leistungsabfall zu bestätigen.
Warum sich eine erneute Prüfung von Aufgaben mit verborgenen Mustern lohnt: Die Erklärungshypothese zur Explorationstiefe
Das Folgende sind Erklärungshypothesen auf Basis der Berichtsdaten und keine Schlussfolgerungen von Plotly. Bei den Aufgaben mit verborgenen Mustern kommt die neue Generation im Durchschnitt auf etwa 9 Abfragen pro Aufgabe, die vorherige Generation auf etwa 15. Die beiden Aufgaben mit Punktverlust zeigten zwei unterschiedliche Muster: Bei der einen wurde „nichts gefunden“, bei der anderen „die Stelle gefunden, aber die wahre Ursache ausgeschlossen“. Beide wirken wie „aufgehört, bevor tief genug gesucht wurde“: Bei der ersten war der Explorationsbereich zu klein, bei der zweiten wurde in der Verifikationsphase zu früh eine negative Schlussfolgerung gezogen.
Dies könnte auf dieselbe Verhaltensänderung zurückgehen wie der Rückgang von Kosten und Latenz, nämlich dass das Modell eher nach weniger Abfragen antwortet. Bei Routineaufgaben schlägt sich diese Neigung direkt in Effizienz nieder; bei Ursachenaufgaben, die wiederholtes Aufstellen und Überprüfen von Hypothesen erfordern, kann sie dagegen zum Risiko werden. Um diese Hypothese zu überprüfen, muss man in den eigenen Daten das Verhältnis von Abfrageanzahl und Erfolgsquote gegenüberstellen, statt nur die Gesamtpunktzahl zu betrachten.
Warum Kosten und Geschwindigkeit von GPT-6.2 Astra gleichzeitig sinken
Der Rückgang von 19,97 $ auf 4,11 $ lässt sich anhand der neu berechneten Daten von Plotly in zwei Teile zerlegen:
- Tariffaktor: Rechnet man den unveränderten Verbrauch der vorherigen Generation mit den neuen Tarifen nach, ergeben sich etwa 11 $. Allein durch die Preissenkung sinken die Kosten also von rund 19,97 $ auf etwa 11 $, ein Rückgang um etwa 45 %. Der offizielle Stückpreis für gecachte Eingaben wurde um 60 % gesenkt; in Szenarien mit einer Cache-Trefferquote von 93 bis 98 % macht sich dieser Effekt besonders deutlich bemerkbar.
- Arbeitsaufwandsfaktor: Von etwa 11 $ auf 4,11 $ geht es über die Verringerung des Arbeitsaufwands. Die Tool-Aufrufe sanken von 266 auf 148, die Eingabe-Token von etwa 9,1 Millionen auf rund 4,4 Millionen, die Ausgabe-Token gingen um mehr als die Hälfte zurück, und der Anteil der Cache-Treffer stieg von 93 % auf 98 %.
Rechnet man den Verbrauch der neuen Generation grob mit den offiziellen Stückpreisen nach, liegt das Ergebnis ebenfalls in derselben Größenordnung wie 4,11 $: Von den rund 4,4 Millionen Eingabe-Token laufen 98 % zum Cache-Preis, der Rest zum normalen Eingabepreis, dazu kommen etwa 34.000 Ausgabe-Token. Das deutet darauf hin, dass in Szenarien wie der Datenanalyse, mit langem Kontext und mehreren Tool-Aufrufrunden, Cache-Trefferquote und Anzahl der Aufrufrunden die Kosten stärker beeinflussen können als der Stückpreis selbst. Bei der Geschwindigkeit ist es genauso: weniger Abfragen, weniger Modellaufrufe, und die verstrichene Zeit verkürzt sich von selbst.
💰 Kostenhinweis: Bei der Bewertung der Kosten für solche Agent-artigen Aufgaben sollte man die Cache-Treffer-Token und die Anzahl der Tool-Aufrufrunden erfassen und nicht nur die Stückpreistabelle betrachten. Wenn Sie über APIYI apiyi.com nach Verbrauch aufrufen, können Sie die Rechnung mit dem usage-Feld in den Logs abgleichen und prüfen, ob das Caching greift.
Die Abwägung zwischen GPT-6.2 Astra, GPT-6.1 Sol und GPT-6.2 Sol
Die vier Modelle nehmen ganz unterschiedliche Positionen ein:
- GPT-6.1 Sol: Erreicht unter diesem Setup mit $2.61 die volle Punktzahl von 43/43 und ist damit die „günstigste Option unter den Volltreffern“ dieser Runde – der Preis dafür ist eine mediane Laufzeit von 17.6 Sekunden, also langsamer als 6.2 Astra.
- GPT-6.2 Astra: 41/43, $4.11, 12.4 Sekunden. Sein Vorteil zeigt sich erst, wenn man Punktzahl und Geschwindigkeit zusammen betrachtet. Schaut man nur auf Kosten und Punktzahl, ist es nicht überlegen.
- GPT-6.2 Sol: $1.22, 10.5 Sekunden – am günstigsten und am schnellsten, aber mit 40/43 die niedrigste Punktzahl.
- GPT-6 Astra: Volle Punktzahl, doch Kosten und Latenz liegen deutlich höher; in dieser Vergleichsgruppe findet sich kaum noch ein Grund, es zu bevorzugen.
Die Punktunterschiede zwischen ihnen liegen allesamt innerhalb der von Plotly erwähnten Schwankungsbreite von höchstens drei Aufgaben. Das heißt: Allein anhand der Gesamtpunktzahl lässt sich keine verlässliche Rangfolge ableiten – die wirklich verlässlichen Unterscheidungsmerkmale sind Kosten und Latenz. Für die praktische Auswahl gilt: Interaktive Produkte zur Datenabfrage reagieren empfindlich auf Latenz, hier sollte man vorrangig 6.2 Astra und 6.2 Sol vergleichen. Offline-Batch-Analysen sind gegenüber Latenz unempfindlich, dort lohnt sich eher ein Blick auf das Preis-Leistungs-Verhältnis von 6.1 Sol.
Wie Sie GPT-6.2 Astra mit eigenen Daten erneut testen
Die folgende Vorgehensweise zum Nachtest ist eine redaktionelle Empfehlung. DataAnalyticsBench deckt nur den Windparkbetrieb, englischsprachige Daten und eine einzige Umgebung ab und unterscheidet sich damit deutlich von den echten Data-Warehouse-Umgebungen der meisten Teams. Sinnvoller ist ein kleiner Aufgabensatz mit eigenen Daten: Daten, Tools und Eingabeaufforderungen bleiben fest, das Modell läuft mehrere Runden, und die Leistung wird für unterschiedliche Aufgabentypen getrennt ausgewertet.
| Teilmenge | Empfohlene Anzahl Aufgaben | Wichtig zu erfassen | Wozu die Auswertung dient |
|---|---|---|---|
| Routineberichte | 15–20 Aufgaben | Erfolgsquote, Median-Latenz | ob alltägliche Datenabfragen bedenkenlos an das Modell übergeben werden können |
| Mehrdeutige Berechnungsdefinitionen | etwa 5 Aufgaben | ob aktiv nachgefragt oder Annahmen offengelegt werden | verhindert, dass stillschweigend eine Definition gewählt wird |
| Statistische Verzerrungen | etwa 5 Aufgaben | ob Fallstricke wie das Simpson-Paradoxon erkannt werden | Vertrauenswürdigkeit der Ergebnisse |
| Ursachen von Anomalien | 5–8 Aufgaben | Erfolgsquote, Anzahl der Abfragen, P90-Latenz | Fehlersignale bei Aufgaben mit verborgenen Mustern prüfen |
| Alle Aufgaben | — | Gesamtkosten pro Runde, Cache-Trefferquote | Kostenbudget |
Für jedes Modell sollten mindestens 3 Runden laufen; Mittelwert und Schwankung werden festgehalten. Die Tail-Latenz (P90) sollte separat erfasst werden: Ein guter Median bedeutet nicht, dass die langsamsten Aufgaben akzeptabel sind.
Hier ein minimales Aufrufbeispiel. Als Modell-ID wird das von OpenAI veröffentlichte gpt-6.2-astra verwendet; maßgeblich ist die Modellliste der Plattform:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-6.2-astra",
    reasoning_effort="medium",  # Laut Modellkarte werden Anfragen mit effort = none abgelehnt
    messages=[{"role": "user", "content": "上月各风场故障工单数环比变化最大的是哪个?请说明计算口径。"}],
)
print(resp.choices[0].message.content)
Vollständiges Nachtest-Skript ansehen: Erfolgsquote, Kosten und P50/P90-Latenz nach Teilmengen
import time
import statistics
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODELS = ["gpt-6.2-astra", "gpt-6-astra", "gpt-6.1-sol", "gpt-6.2-sol"]

# Selbst zusammengestelltes Aufgabenset: category entspricht der Teilmenge in der Nachtest-Tabelle; den checker implementierst du anhand des Antwortschlüssels
TASKS = [
    {"id": "r01", "category": "常规报表", "prompt": "...", "checker": lambda a: "..." in a},
    {"id": "h01", "category": "异常根因", "prompt": "...", "checker": lambda a: "..." in a},
]

# Offizielle Direktpreise (USD pro Million Token), nur als grobe Schätzung; maßgeblich ist die tatsächliche Plattformabrechnung
PRICE = {"input": 8.0, "cached": 0.40, "output": 40.0}

def estimate_cost(usage):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    fresh = usage.prompt_tokens - cached
    return (fresh * PRICE["input"] + cached * PRICE["cached"]
            + usage.completion_tokens * PRICE["output"]) / 1_000_000

def p90(values):
    values = sorted(values)
    return values[max(0, int(len(values) * 0.9) - 1)]

def run(model, rounds=3):
    stats = {}
    for _ in range(rounds):
        for t in TASKS:
            start = time.perf_counter()
            resp = client.chat.completions.create(
                model=model,
                reasoning_effort="medium",
                messages=[{"role": "user", "content": t["prompt"]}],
            )
            elapsed = time.perf_counter() - start
            answer = resp.choices[0].message.content or ""
            s = stats.setdefault(t["category"], {"pass": 0, "n": 0, "lat": [], "cost": 0.0})
            s["n"] += 1
            s["pass"] += int(t["checker"](answer))
            s["lat"].append(elapsed)
            s["cost"] += estimate_cost(resp.usage)
    for cat, s in stats.items():
        print(f"{model} | {cat} | 通过率 {s['pass']}/{s['n']} | "
              f"P50 {statistics.median(s['lat']):.1f}s | P90 {p90(s['lat']):.1f}s | "
              f"估算费用 ${s['cost']:.3f}")

for m in MODELS:
    run(m)
Dieses Skript führt nur einen einzelnen Frage-Antwort-Durchlauf aus. Um näher an das Setup von DataAnalyticsBench heranzukommen, muss man noch ein schreibgeschütztes SQL-Tool anbinden, das Modell autonom mehrere Abfragen in mehreren Runden durchführen lassen und zusätzlich pro Aufgabe die Anzahl der Tool-Aufrufe erfassen, um die zuvor aufgestellte Hypothese „Abfrageanzahl und Punktverlust“ zu prüfen.
🎯 Empfehlung für den Nachtest: Alle vier Modelle nutzen das OpenAI-kompatible Protokoll. Über APIYI apiyi.com kannst du mit demselben API-Schlüssel wechseln. Das kostenlose Testkontingent für neue Nutzer reicht aus, um zunächst eine kleine Runde Aufgaben laufen zu lassen und dann zu entscheiden, ob du den Umfang erweiterst.
Die Rangliste gibt die Richtung vor. Für das eigene Data Warehouse und die eigenen Anomalie-Typen muss man die Antworten selbst herausfinden. Lu You schrieb in „Lesen bei Nacht im Winter für Ziyu“: „Was man auf dem Papier lernt, ist letztlich seicht; um eine Sache wirklich zu verstehen, muss man sie selbst tun.“
Autor: APIYI-Team
Technischer Austausch: Kontaktiere uns gerne über die Startseite von APIYI apiyi.com; weitere Integrationsmaterialien findest du im Dokumentationszentrum docs.apiyi.com.