Anmerkung des Autors: In der ersten GDPx-Auswertung bestand in den Bereichen Finanzen und Recht kein Modell die strenge binäre Abnahme vollständig. Dieser Artikel zeigt die konkreten Fehler anhand zweier öffentlich dokumentierter Fälle und erklärt, warum „rechnen und Verträge schreiben können“ nicht gleichbedeutend damit ist, ein Ergebnis abzuliefern, das die Abnahme besteht.
Am 2. November 2026 veröffentlichte SemiAnalysis GDPx v1.0, einen Benchmark für anspruchsvolle Fachaufgaben. In 11 Fachbereichen wurden Modelle getestet. In den Bereichen Finanzen und Recht bestand nach dem ursprünglich vorgesehenen binären Bewertungsschema keines der getesteten Modelle die Abnahme vollständig. Das Forschungsteam griff daher auf die „durchschnittliche Teilpunktzahl“ zurück, um die Unterschiede zwischen den Modellen sichtbar zu machen.
Das ist kein emotionales Fazit nach dem Motto „KI taugt nichts“. Einige Modelle erreichten im Rechtsfall eine durchschnittliche Teilpunktzahl von 44 % und erfüllten im Finanzfall etwa die Hälfte der Abnahmekriterien. Die entscheidende Frage lautet: Warum reicht es trotzdem nicht für eine Abnahme, wenn die Hälfte richtig ist?
Das nehmen Sie mit: Nach der Lektüre kennen Sie die wichtigsten Beträge, die Zahl der Fehlversuche und die Bewertungsmaßstäbe der Finanzaufgabe Bellwood-QoE und der Aufgabe zur Satzungsänderung für eine Serie-B-Finanzierungsrunde. Außerdem können Sie besser unterscheiden, wobei KI unterstützen kann und wann sie ein Ergebnis eigenständig und in eigener Verantwortung abliefern könnte.
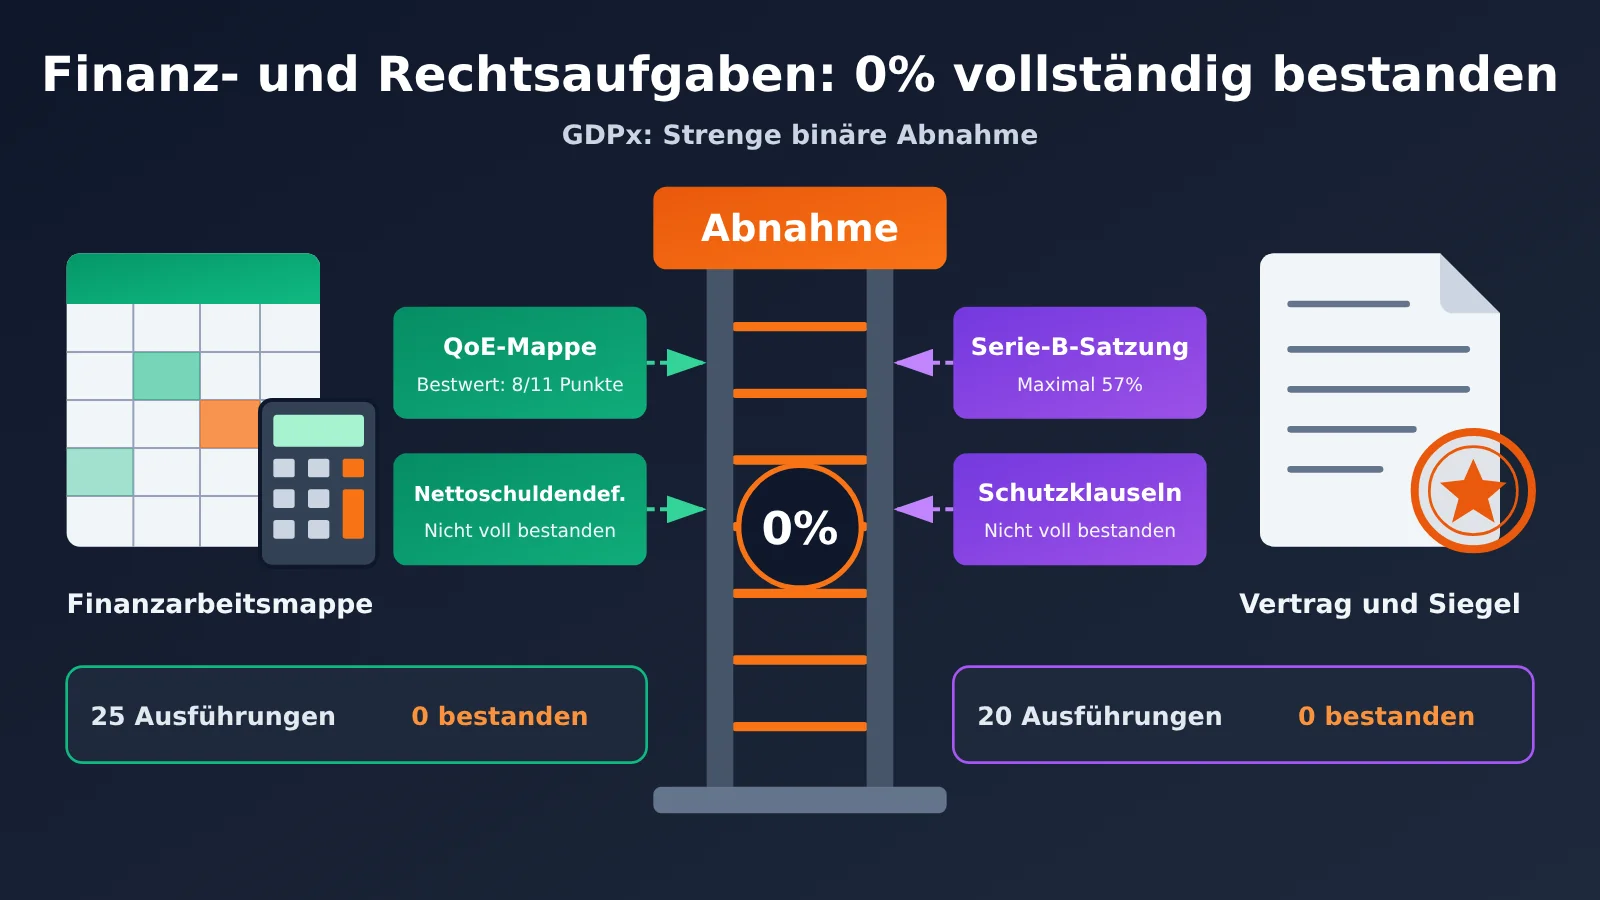
Finanz- und Rechtsaufgaben durchweg nicht bestanden: GDPx auf einen Blick
Die erste Ausgabe von GDPx umfasst 206 Aufgaben aus 11 Fachgebieten. Für jede Aufgabe sind standardmäßig höchstens 8 Stunden vorgesehen. Getestet wird die Gesamtleistung aus „Modell + Agent-Framework + Tools + Arbeitsumgebung“. Selbst Claude Opus 5.5 auf Platz eins der Gesamtwertung erreicht nur 12,0 %. Vor diesem Hintergrund stechen die Finanz- und Rechtsbereiche besonders hervor.
| Kennzahl | Finanzbereich | Rechtsbereich |
|---|---|---|
| Anzahl der Aufgaben | 24 | 20 |
| Fachpartner | Living Context | Chakra |
| Öffentliches Fallbeispiel | Bellwood-QoE (Arbeitsmappe zur Analyse der Ertragsqualität) | quillon-series-b-redline (Überarbeitung der Satzung für eine Series-B-Finanzierung) |
| Durchläufe des öffentlichen Fallbeispiels | 25 ausgewählte Durchläufe | 20 Durchläufe mit insgesamt 4 Modellen |
| Vollständig bestanden | 0 | 0 |
| Strenge binäre Bewertung | 0 % | 0 % |
| Teilergebnisse | Bester Einzeldurchlauf erfüllte 8 von 11 Prüfkriterien | Durchschnittlich 18 %, bester Einzeldurchlauf 57 % |
Beim Lesen der Tabelle sind zwei Punkte wichtig. Erstens bedeutet eine binäre Bewertung von 0 % nicht, dass alle Ergebnisse wertlos sind: Die Teilbewertungen liegen durchaus über null. Zweitens beziehen sich die 25 beziehungsweise 20 Durchläufe auf jeweils ein einzelnes öffentliches Fallbeispiel. Sie sind nicht die Gesamtzahl der Durchläufe für alle 24 Finanz- beziehungsweise 20 Rechtsaufgaben.
Warum Finanz- und Rechtsaufgaben streng abgenommen werden
Die Ergebnisse in beiden Bereichen sind „Dokumente, die sich direkt in einen realen Transaktionsprozess einbringen lassen“ – keine blossen Empfehlungen. Bei einer Due-Diligence-Prüfung für eine Übernahme oder in Finanzierungsverhandlungen kann ein Fehler bei der Berechnung der Nettoverschuldung oder eine Schutzklausel, die sich umgehen lässt, das gesamte Dokument unbrauchbar machen. Deshalb setzt GDPx auf strenge Abnahmekriterien, die sich an professionellen Arbeitsergebnissen orientieren. Das erklärt auch unmittelbar, warum die Bewertung bei 0 % liegt.
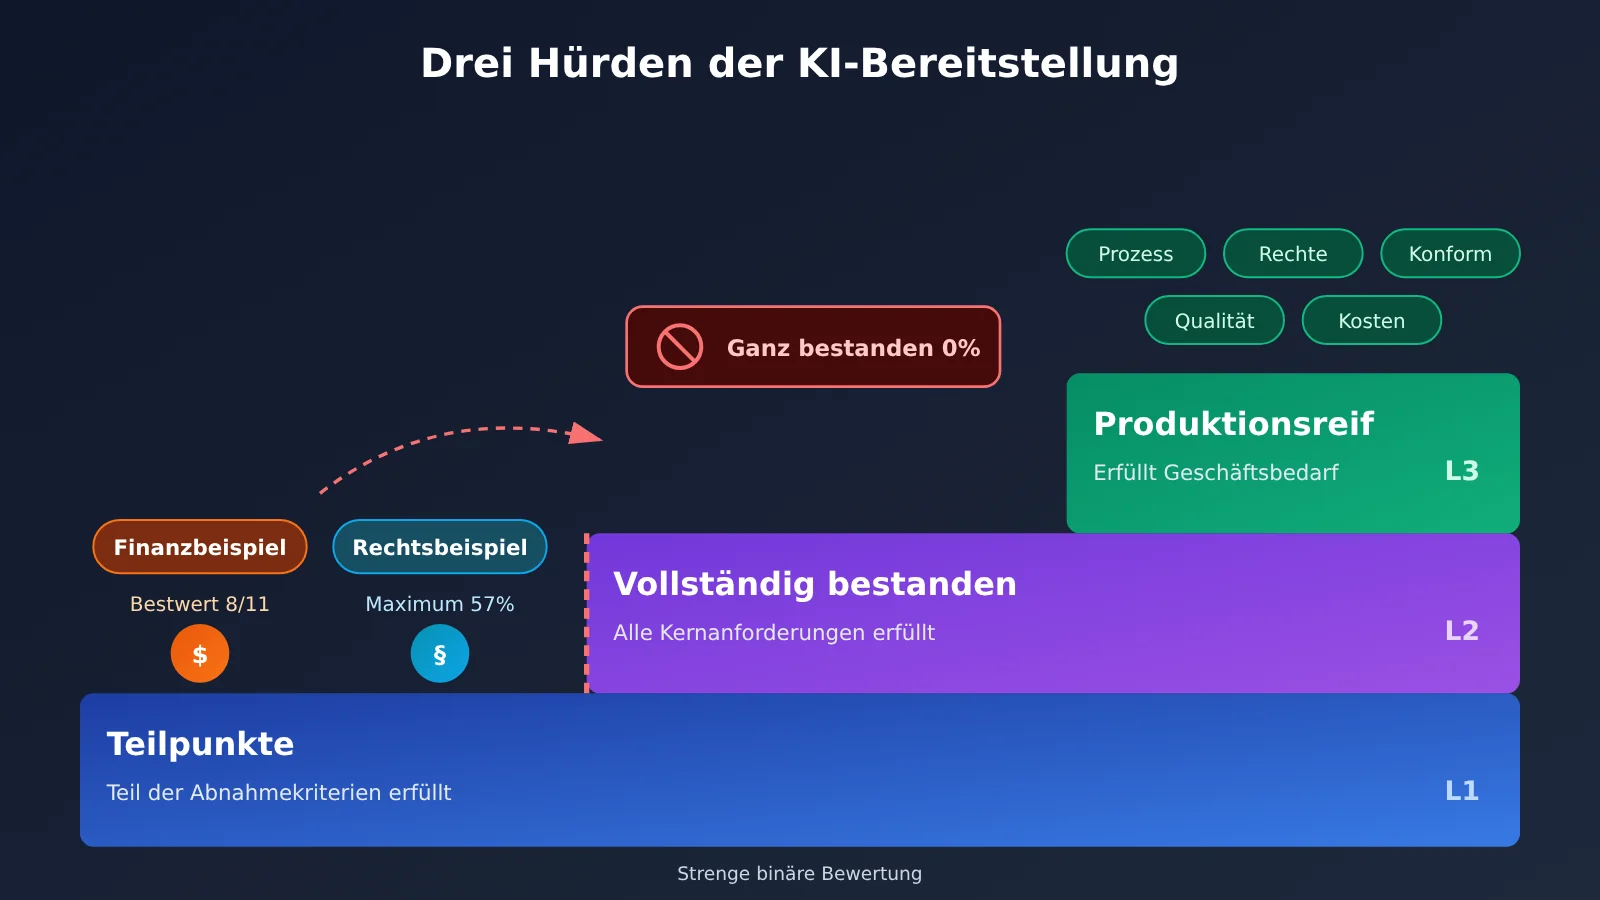
Fallbeispiel aus dem Finanzbereich: Wie Bellwood-QoE KI richtig rechnen lässt, ohne ein brauchbares Ergebnis zu liefern
Transaktionshintergrund und Aufgabenstellung
Living Context hat reale Transaktionserfahrungen in eine anonymisierte Testumgebung übertragen: Der Private-Equity-Fonds Bannock Capital übernimmt rund 62 % der Anteile an der Haverly Snack Company für etwa 880 Millionen US-Dollar. Hinzu kommt eine Vereinbarung über eine bedingte Kaufpreiszahlung. Die Umgebung umfasst rund 4.000 anonymisierte Dokumente, darunter Hauptbuchdaten, Kontoauszüge, Gehaltsunterlagen, Fälligkeitsübersichten der Forderungen, Vertragskorrespondenz, Transaktionsverträge, historische Anpassungstabellen und Arbeitsunterlagen verschiedener Berater.
Das Modell soll eine unvollständige Arbeitsmappe zur Analyse der Ergebnisqualität (Quality of Earnings, QoE) übernehmen. Es muss erkennen, welche vorhandenen Daten korrekt sind, fehlerhafte Zahlen und Zuordnungen korrigieren und zugleich korrekte Einträge und die Berechnungsstruktur erhalten. Außerdem soll es EBITDA-Anpassungen prüfen, das Working Capital für zwölf Monate abstimmen, die Abgrenzung der Nettoverschuldung bearbeiten, jede Anpassung anhand von Dokumenten belegen und sicherstellen, dass die Verweise zwischen den Tabellen konsistent sind. Das geforderte Ergebnis ist die überarbeitete Arbeitsmappe selbst.
Bellwood-QoE: Ergebnisse im Praxistest
| Modell | Durchschnittlich bestandene Prüfungen von 11 | Vollständig bestanden |
|---|---|---|
| GPT-6.1 Sol | 5,6 | Nein |
| Claude Opus 5.5 | 5,4 | Nein |
| GPT-6 Astra | 5,4 | Nein |
| GLM 5.3 | Weniger als 2 | Nein |
| Grok 4.7 | Weniger als 2 | Nein |
| Bester Einzeldurchlauf | 8 | Nein |
Die stärksten Modelle bestanden im Durchschnitt etwa die Hälfte der Prüfungen, der beste Einzeldurchlauf bestand 8. Sobald sich unter den verbleibenden Fehlern jedoch ein gravierender Finanzfehler befindet, kann die gesamte Arbeitsmappe nicht ausgeliefert werden. Die folgenden drei Fehlerarten zeigen, wo das Problem liegt.
Finanzfehler eins: Eine Anpassung von 418 US-Dollar wird zu weit ausgelegt
Eine bereits erlassene Anpassung von 418 US-Dollar aus einer Versicherungsprüfung wurde von einigen Modellen so verstanden, als seien „sämtliche Verpflichtungen aus der bisherigen Arbeitsunfallversicherung erloschen“. Infolgedessen wurde das EBITDA der vergangenen 12 Monate um 4728 US-Dollar zu niedrig ausgewiesen. Bei 10 von 15 relevanten Durchläufen mit Opus, Astra und Sol trat diese Fehleinschätzung auf.
Das war kein Multiplikationsfehler. Die Modelle übertrugen die buchhalterische und rechtliche Bedeutung einer konkreten Anpassung auf die gesamte frühere Versicherungsverpflichtung. Die Abweichung von 4728 US-Dollar war eine Folge dieser Fehleinschätzung und kein Vielfaches der 418 US-Dollar. Solche Fehler lassen sich durch wiederholtes Nachrechnen schwer aufdecken, weil die Rechnung selbst korrekt sein kann.
Finanzfehler 2: Transaktionskosten in die Nettoverschuldung eingerechnet
In 15 Durchläufen wurde das Erfolgshonorar der Investmentbank zur Nettoverschuldung gerechnet. Der Unternehmenskaufvertrag legte jedoch bereits fest, dass dieses Honorar als separate Transaktionskosten zu behandeln war. Das Modell fand die Kosten und beherrschte die Addition und Subtraktion, übernahm aber nicht die verbindliche Einordnung aus dem Vertrag.
Daran zeigt sich der Unterschied zwischen „Daten sind vorhanden“ und „geschäftlich korrekt eingeordnet“. Bei Fusionen und Übernahmen beeinflusst die Nettoverschuldung in der Regel den tatsächlich vom Käufer gezahlten Betrag. Eine falsche Zuordnung wirkt sich also nicht nur auf die Tabelle aus.
Finanzfehler 3: Übersehen, dass Kosten angepasst werden müssen
Das Forschungsteam fand auch eine Reihe weniger offensichtlicher Probleme:
- In 17 Durchläufen wurden Vergütungen für Familienmitglieder, die tatsächlich nicht im Unternehmen arbeiteten, weiterhin als normale Betriebskosten behandelt.
- In den meisten Durchläufen wurden persönliche Ausgaben des Eigentümers nicht erkannt, die nur im Bemerkungsfeld des Hauptbuchs vermerkt waren.
- In 10 von 15 Durchläufen des leistungsstärksten Modells wurde eine Anpassung für historische Werbekosten in Höhe von 9192 US-Dollar übersehen. Dadurch wurden Kosten, die in einen anderen Zeitraum gehörten, den aktuellen zwölf Monaten zugerechnet.
Diese Fehler betreffen zugleich die Rechnungsperiode, die Art der Kosten, die Quellen der Nachweise und den wirtschaftlichen Gehalt der Transaktion. Die Analyse der Ergebnisqualität soll genau solche Posten herausrechnen, die wie Betriebskosten aussehen, aber keine sind. Werden sie übersehen, kann das EBITDA die tatsächliche Ertragskraft des Unternehmens nicht widerspiegeln.
Fallbeispiel aus dem Rechtsbereich: Warum alle 20 Versuche zur Überarbeitung einer Satzung für eine Serie-B-Finanzierung unbrauchbar waren
Anforderungen der juristischen Aufgabe
In der Aufgabe quillon-series-b-redline sollte die KI im Auftrag des federführenden Investors einer Serie-B-Finanzierung die zur Unterzeichnung vorgesehene Gesellschaftssatzung überarbeiten. Zu den Unterlagen gehörten ein unterzeichnetes Term Sheet, eine Übersicht über die Beteiligungsstruktur, Kunden-E-Mails, der Satzungsentwurf und weitere Transaktionsunterlagen. Erfolgreich wäre die Aufgabe gelöst, wenn die berechtigten Interessen des Investors geschützt würden, ohne bereits ausgehandelte wirtschaftliche Bedingungen grundlos zu ändern. Dafür waren mehrere Dokumente abzugleichen und juristisch zu bewerten – es ging nicht bloß um sprachliche Überarbeitung.
Ergebnisse des Rechtsfalls und drei zentrale Fehler
| Kennzahl | Ergebnis |
|---|---|
| Nutzbarkeitsstandard vollständig erreicht | 0/20 Durchläufe |
| Durchschnittliche Teilpunktzahl | 18 % |
| Teilpunktzahl je Modell | Opus 5.5: 44 %, GPT-6 Astra: 25 %, Gemini 4 Argon: 2 %, GLM 5.3: 0,5 % |
| Höchste Teilpunktzahl in einem einzelnen Durchlauf | 57 % (Opus 5.5) |
| Nicht erkannt, dass Aktionäre die Schutzklauseln per Abstimmung aufheben können | 13/20 Durchläufe |
| Umgehung über Tochtergesellschaften nicht verhindert | 20/20 Durchläufe |
| Widerspruch zwischen Kunden-E-Mail und Term Sheet nicht aufgezeigt | 14/20 Durchläufe |
Die 18 % sind die durchschnittliche Teilpunktzahl der Durchläufe für diesen Fall, nicht die einheitliche Gesamtpunktzahl für den Rechtsbereich von GDPx.
Fehler eins: Klauseln lesen, aber Stimmen nicht zählen. In 13 Durchläufen wurde übersehen, dass die übrigen Aktionäre über genügend Stimmrechte verfügen, um die vom Lead-Investor benötigten Schutzklauseln aufzuheben. Dass Schutzklauseln in der Satzung stehen, bedeutet noch nicht, dass dieser Schutz tatsächlich Bestand hat. Ob sie aufgehoben werden können, lässt sich nur durch eine Berechnung der Stimmrechte anhand der Beteiligungsstruktur beurteilen.
Fehler zwei: Nur den Wortlaut ändern, ohne Umgehungen zu verhindern. In keinem der 20 Durchläufe wurde wirksam verhindert, dass das Unternehmen die Schutzbeschränkungen für Investoren in der Satzung über Tochtergesellschaften umgeht. Wenn die Klauseln nur für das Unternehmen selbst gelten und Tochtergesellschaften nicht erfassen, können Geschäfte über eine andere Gesellschaft abgewickelt werden. Den Wortlaut einer Klausel zu verstehen, ist nicht dasselbe, wie einen realistischen Weg zu ihrer Umgehung zu erkennen.
Fehler drei: Die E-Mail als endgültige Vereinbarung behandeln. In 14 Durchläufen wurden die in der Kunden-E-Mail gewünschten Klauseln direkt übernommen, ohne auf ihren Widerspruch zum unterzeichneten Term Sheet hinzuweisen. Eine solche Änderung käme einer einseitigen Neuverhandlung bereits festgelegter Geschäftsbedingungen gleich. Angemessen wäre es, den Widerspruch zu erkennen und den Nutzer darauf hinzuweisen, statt die Wünsche ungeprüft zu übernehmen.
Wie wird die Zuverlässigkeit der juristischen Bewertung sichergestellt?
Chakras Bewertungsverfahren umfasst mehrere Schritte: Juristische Fachkräfte legen die Anforderungen fest, die Bewertungskriterien werden anhand gültiger, ungültiger und teilweise korrekter Beispiele kalibriert, strittige Entscheidungen werden manuell überprüft und das Bewertungsmodell wird auf Verzerrungen untersucht. Jede Ausgabe wird fünfmal bewertet. Dabei wird erfasst, wie konsistent die Ergebnisse für die einzelnen Abnahmekriterien ausfallen. Das sind jedoch interne Qualitätskontrollen, wie sie der Partner beschreibt. Sie bedeuten nicht, dass eine vollständig unabhängige Institution bestätigt hat, dass die Bewertung frei von Fehlurteilen ist.
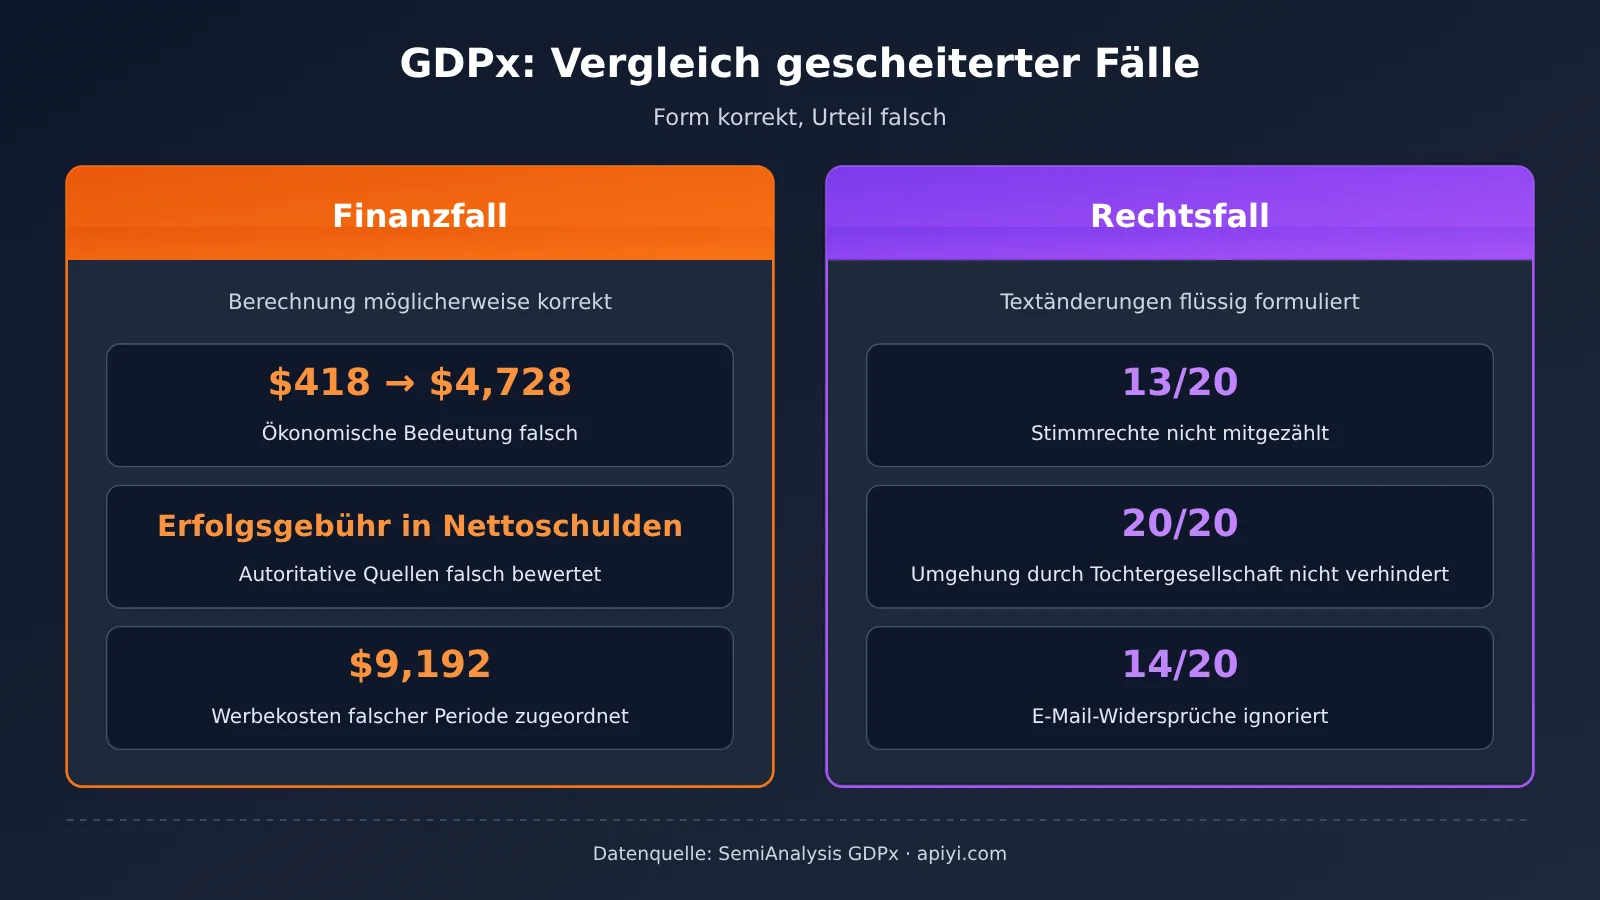
Gemeinsame Ursachen für Fehler bei Finanz- und Rechtsaufgaben: Nicht das Schreiben ist das Problem, sondern die Beurteilung
Living Context fasst die häufigsten Fehler im Finanzfall in vier Kategorien zusammen. Sie decken sich weitgehend mit den Beobachtungen im Rechtsfall:
| Fehlermuster | Ausprägung im Finanzfall | Entsprechung im Rechtsfall | Konsequenz für die Praxis |
|---|---|---|---|
| Autorität der Unterlagen falsch eingeschätzt | Einer alten Tabelle mit besonders klaren Zahlen wird zu viel Gewicht gegeben, eine unterzeichnete Vereinbarung wird ignoriert | Die E-Mail des Mandanten wird über die Liste der Vertragsbedingungen gestellt | Zunächst eine „Rangfolge der Dokumentenverbindlichkeit“ festlegen |
| Folgen zweiter Ordnung übersehen | Die Berechnung ist abgeschlossen, Auswirkungen auf Steuern, Schulden und Transaktionspflichten fehlen jedoch | Eine Schutzklausel wird geändert, ohne die Auswirkungen auf die Stimmrechtsstruktur zu prüfen | Bei jeder Änderung nach den Folgeauswirkungen fragen |
| Nur die Rechnung prüfen, nicht die Annahmen | Die Rechenschritte werden wiederholt überprüft, die geschäftliche Grundlage ist jedoch falsch | Der Text ist präzise, berücksichtigt aber nicht den Weg über eine Tochtergesellschaft | Die Prüfung der Annahmen ist wichtiger als die Prüfung der Berechnung |
| Bestehende Struktur durch Änderungen beschädigen | Formeln werden durch fest eingetragene Zahlen ersetzt und Verknüpfungen zwischen Tabellenblättern unterbrochen | Bereits ausgehandelte Geschäftsbedingungen werden geändert | Das Ergebnis muss „richtig geändert werden, ohne Bestehendes zu beschädigen“ |
Dies sind Fehlermuster, die das Forschungsteam zusammengefasst hat. Sie stellen keine allgemeingültige Fehlerquote für Finanzmodelle oder Rechtsdokumente von Unternehmen dar. Ihr gemeinsamer Nenner: Die entscheidende Schwierigkeit liegt oft nicht im Generieren von Text, sondern in der Auswahl der Unterlagen, der fachlichen Schlussfolgerung, impliziten Vorgaben, der Konsistenz über mehrere Dokumente hinweg und der abschliessenden Abnahme. Je flüssiger ein Modell antwortet, desto leichter werden diese Probleme übersehen.
Auswirkungen von KI-Anwendungen in Finanzwesen und Recht: Unterstützung und eigenständige Lieferung unterscheiden
Auswirkungen für KI-Verantwortliche und Entwickler in Unternehmen
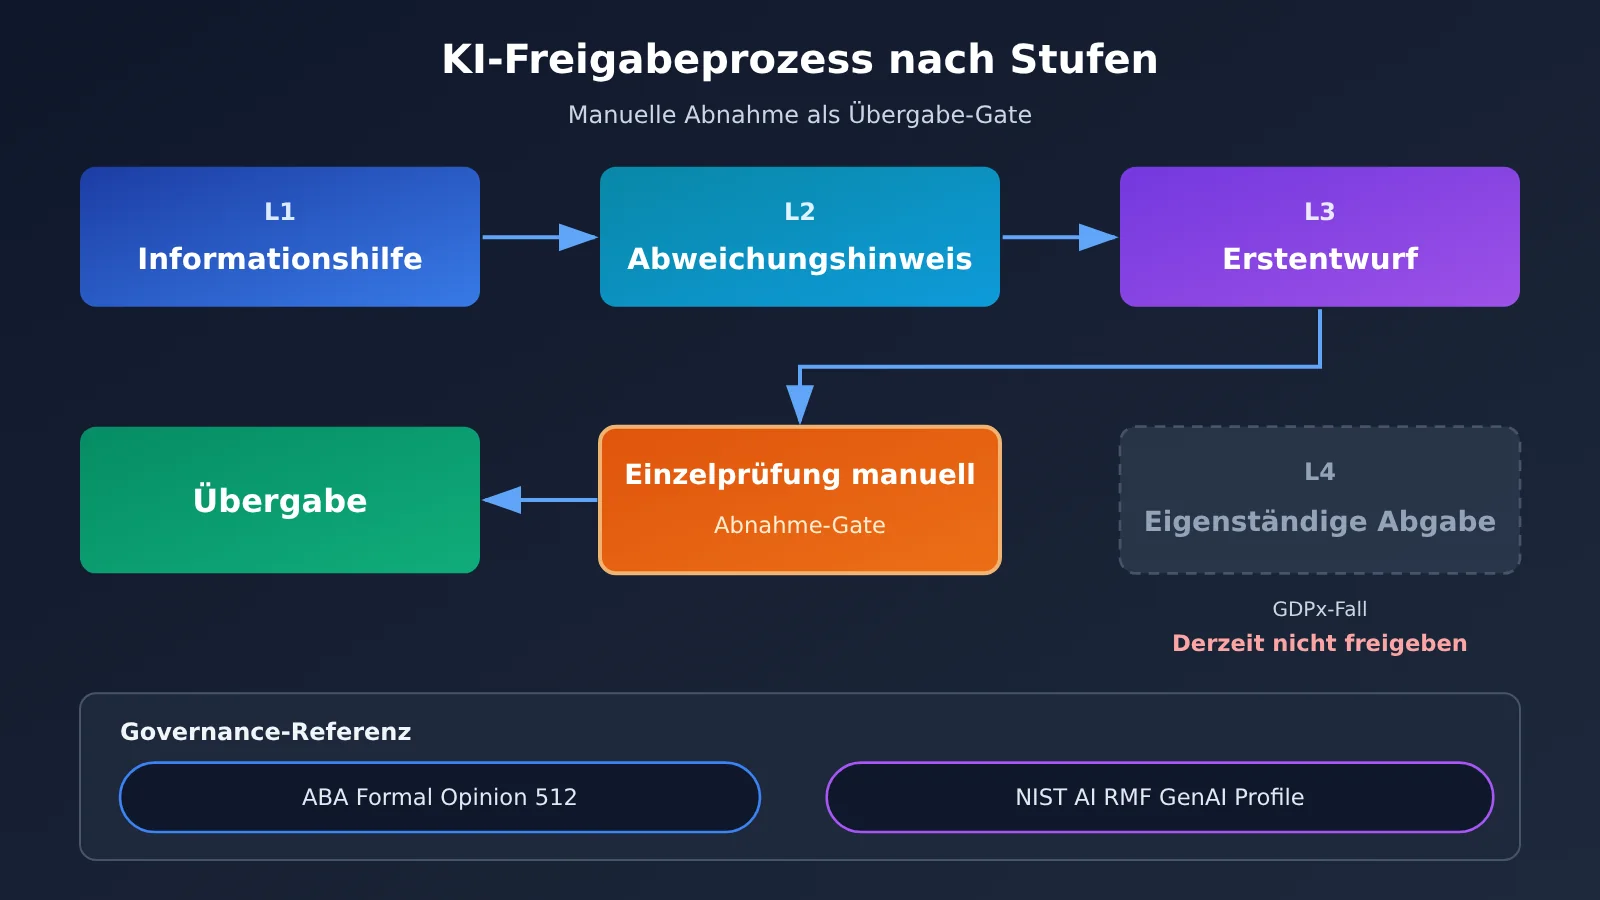
GDPx stellt den Wert von KI-Unterstützung bei Fachaufgaben nicht grundsätzlich infrage. Die Teilergebnisse zeigen, dass die Modelle bereits einen Teil der Abnahmekriterien erfüllen können. Die Studie liefert jedoch keine Grundlage dafür, wie viel Zeit oder Kosten sich durch menschliche Beteiligung einsparen lassen. Deshalb sollten die Ergebnisse der Fallstudien nicht direkt in einen ROI umgerechnet werden. Praktischer ist es, den Handlungsspielraum nach Risiko zu staffeln:
| Berechtigungsstufe | Typische Anwendungen | Rolle des Menschen | Abnahme |
|---|---|---|---|
| L1 Unterstützung bei der Materialaufbereitung | Erste Sichtung und Aufbereitung von Unterlagen, Prüfung auf auffällige Daten | Stichprobenprüfung | Ergebnisse dienen nur als Hinweise |
| L2 Hinweise auf Abweichungen | Hinweise auf Unterschiede in Klauseln und Daten, Konfliktlisten | Einzelne Bestätigung | Fachleute beurteilen, ob die Hinweise zutreffen |
| L3 Erstellung von Erstentwürfen | Erstentwürfe für die Überarbeitung von Arbeitsmappen oder Redline-Entwürfe für Satzungen | Vollständige Prüfung | Abnahme anhand einer Checkliste |
| L4 Eigenständige Lieferung | Direkte externe Unterzeichnung oder Einreichung | — | Die GDPx-Fallstudien zeigen, dass diese Berechtigung derzeit nicht ratsam ist |
Diese Einteilung steht im Einklang mit externen Leitlinien. Die American Bar Association (ABA) wies in ihrer am 29. Juli 2024 veröffentlichten Formal Opinion 512 darauf hin, dass Anwälte beim Einsatz generativer KI weiterhin unter anderem ihre Pflichten zu beruflicher Kompetenz, Vertraulichkeit von Mandanteninformationen, Kommunikation, Aufsicht und angemessener Vergütung beachten müssen. Sie sollten die Fähigkeiten und Grenzen der Werkzeuge verstehen und deren Ergebnisse nicht ungeprüft übernehmen. Auch das am 26. Juli 2024 veröffentlichte Generative AI Profile zum AI RMF des US-amerikanischen NIST betont, dass Organisationen menschliche Aufsicht, Bewertung, Dokumentation und Governance passend zum jeweiligen Anwendungskontext gestalten sollten. Dabei ist zu beachten: Die ABA-Stellungnahme ist eine berufsethische Orientierungshilfe für Anwälte in den USA, und das NIST-Dokument enthält keine GDPx-Testergebnisse. Beide können daher nur als fachübergreifende Orientierung dienen.
Einen API-gestützten Workflow zur Konflikterkennung aufbauen
Einer der häufigsten Fehler im GDPx-Rechtsfall war, Konflikte zwischen der Kunden-E-Mail und den unterzeichneten Bedingungen nicht aufzuzeigen. Aufgaben dieser Art – Unterschiede finden und Fragen stellen – eignen sich gut für Unterstützung auf L2-Niveau. Voraussetzung ist, dass die Ausgabe nur als Hinweis für eine menschliche Prüfung dient. Das folgende Beispiel lässt das Modell zwei Texte vergleichen und Konflikte sowie offene Fragen auflisten:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible API von APIYI
)

resp = client.chat.completions.create(
    model="claude-sonnet-4-20250514",
    messages=[{"role": "user", "content": "对照【已签署条款清单】与【客户邮件】,只列出冲突项和需人工确认的问题,不要直接修改条款。\n条款清单:...\n客户邮件:..."}]
)
print(resp.choices[0].message.content)
Vollständigen Implementierungscode anzeigen (Abgleich mehrerer Modelle + Checkliste für die menschliche Prüfung)
import openai
from typing import List, Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Modelle mehrerer Anbieter mit einem Schlüssel aufrufen
)

SYSTEM = (
    "你是交易文件审查助手。你的输出只作为专业人员的审查线索,"
    "必须遵守:1) 已签署文件效力优先于邮件和旧表格;"
    "2) 发现冲突时提示,不得自行改写商业条款;"
    "3) 每条结论标注依据的文件名和段落;"
    "4) 无法确认的事项明确写'需人工确认'。"
)

CHECKS = [
    "客户邮件中的要求是否与已签署条款清单冲突",
    "结合股权结构,其他股东能否凭投票权移除保护条款",
    "保护条款是否覆盖子公司,是否存在绕行路径",
]

def review(docs: str, models: List[str]) -> Dict[str, str]:
    """Lässt mehrere Modelle unabhängig Prüfhilfen erzeugen, um den manuellen Abgleich zu erleichtern."""
    prompt = "请逐项检查:\n" + "\n".join(f"- {c}" for c in CHECKS) + f"\n\n材料:\n{docs}"
    results = {}
    for m in models:
        try:
            r = client.chat.completions.create(
                model=m,
                messages=[{"role": "system", "content": SYSTEM},
                          {"role": "user", "content": prompt}],
                temperature=0
            )
            results[m] = r.choices[0].message.content
        except Exception as e:
            results[m] = f"调用失败: {e}"
    return results

if __name__ == "__main__":
    out = review("条款清单:...\n股权结构表:...\n客户邮件:...\n章程草稿:...",
                 ["claude-sonnet-4-20250514", "gpt-4o"])
    for model, text in out.items():
        print(f"===== {model} =====\n{text}\n")
    # Ob die Ergebnisse übernommen werden, entscheiden Rechts- oder Finanzfachleute anhand der Abnahmecheckliste.
🚀 Tipp für den schnellen Einstieg: Für einen solchen Workflow können Sie zunächst über APIYI apiyi.com mit demselben API-Schlüssel auf mehrere gängige Modelle zugreifen. Vergleichen Sie anhand Ihrer eigenen anonymisierten Beispiele, wie viele Konflikte die Modelle erkennen. Neue Nutzer können das kostenlose Testkontingent für eine kleine Validierung nutzen und danach entscheiden, ob sie den Workflow im Pilotbetrieb einsetzen möchten.
Auswirkungen auf die Finanz- und Legal-Tech-Branche
Die Ergebnisse von GDPx zeigen: Bei der Bewertung professioneller KI-Produkte reicht es nicht, auf flüssige Dialoge in Demos zu achten. Entscheidend ist, ob die fertigen Arbeitsergebnisse einer fachlichen Prüfung standhalten. Für Anbieter wird sich die Wettbewerbsfähigkeit stärker in technischen Details zeigen: etwa darin, ob maßgebliche Dokumente Vorrang erhalten, Konflikte angezeigt, bestehende Formelstrukturen erhalten und Belege zurückverfolgt werden können. Käufer sollten Produkte unabhängig anhand von Aufgaben testen, die ihrem eigenen Geschäftsalltag nahekommen. GDPx hat selbst nur einen Teil der Aufgaben und Ausführungsprotokolle veröffentlicht. Deshalb sind weitere externe Prüfungen und Reproduktionen nötig.
💡 Tipp zur Auswahl: Die Leistung verschiedener Modelle unterscheidet sich je nach Fachgebiet deutlich. Eine einzelne Gesamtrangliste sagt daher wenig über den Nutzen für das eigene Geschäft aus. Testen Sie mehrere Modelle parallel über die einheitliche Schnittstelle von APIYI apiyi.com mit Ihren eigenen Aufgaben. Erfassen Sie dabei auch Teilbewertungen und ob kritische Prüfpunkte bestanden wurden – nicht nur den Durchschnittswert. Welche Modelle verfügbar sind, zeigt die aktuelle Liste auf der Plattform.
Häufige Fragen (FAQ)
Q1: Bedeutet das „vollständige Scheitern“ bei Finanz- und Rechtsaufgaben, dass die KI gar nichts richtig gemacht hat?
Nein. Die 0 % sind das Ergebnis einer strengen Ja-Nein-Bewertung: Kein einziger Durchlauf erfüllte alle wesentlichen Anforderungen. Im Finanzfall bestand der beste einzelne Durchlauf 8 von 11 Prüfungen. Im Rechtsfall erreichte Opus 5.5 im Durchschnitt eine Teilpunktzahl von 44 %. Teilweise erledigte Aufgaben und eine abnahmefähige Leistung sind zwei verschiedene Maßstäbe.
Q2: Warum kann eine KI richtig rechnen und trotzdem zu einem falschen Ergebnis kommen?
Weil der Fehler oft in den fachlichen Annahmen liegt, nicht in der Rechnung selbst. So wurde eine Anpassung des Verzichtsbetrags um 418 US-Dollar fälschlich als Ende der Verpflichtungen aus der gesamten Police interpretiert. Dadurch wurde das EBITDA um 4.728 US-Dollar zu niedrig angesetzt. In einem anderen Fall wurde der Betrag für das Erfolgshonorar der Bank korrekt ermittelt, aber den Nettoschulden zugeordnet. Solche Fehler lassen sich durch wiederholtes Nachrechnen nicht aufdecken.
Q3: Lassen sich die Ergebnisse von GDPx auf alle KI-Anwendungen im Finanz- und Rechtsbereich übertragen?
Nein. Die Ergebnisse stammen aus bestimmten anspruchsvollen Aufgaben und basieren auf spezifischen Bewertungsregeln. Auch die aus den Fällen abgeleiteten Fehlerursachen lassen sich nicht auf die gesamte Branche übertragen. Weniger anspruchsvolle Anwendungen oder solche mit menschlicher Mitwirkung müssen separat bewertet werden.
Q4: Welche Finanz- und Rechtsaufgaben kann KI derzeit sinnvoll übernehmen?
Sinnvolle Einsatzmöglichkeiten sind unter anderem die erste Aufbereitung von Unterlagen, Hinweise auf Unterschiede in Klauseln und Daten, das Erstellen von Entwürfen, die Prüfung auffälliger Daten und die Unterstützung beim Erstellen von Prüflisten. Ob sich KI für einen konkreten Anwendungsfall eignet, sollte anhand des Risikos und fachlicher Abnahmekriterien separat getestet werden.
Q5: Wie lässt sich kostengünstig prüfen, wie gut ein Modell im eigenen Anwendungsfall abschneidet?
Sie können wie folgt vorgehen:
1. Bereiten Sie einige anonymisierte echte Beispiele vor und erstellen Sie für jedes eine detaillierte Abnahme-Checkliste;
2. Registrieren Sie sich bei APIYI auf apiyi.com, holen Sie sich einen API-Schlüssel und nutzen Sie das kostenlose Testguthaben;
3. Setzen Sie im Code dieses Artikels `base_url` auf `https://api.apiyi.com/v1` und rufen Sie mehrere Modelle parallel auf;
4. Erfassen Sie jeweils die Teilpunktzahl und ob die wesentlichen Kriterien erfüllt wurden; die endgültige Bewertung übernehmen Fachleute.
Q6: Lassen sich die Aufgabenkosten aus dem GDPx-Bericht als Orientierung für API-Preise nutzen?
Nein. Die Dollarbeträge in GDPx sind die durchschnittlichen Kosten pro Aufgabe unter den Bedingungen des Benchmarks, keine einheitlichen Gebühren einer Plattform. Die tatsächlichen Kosten hängen von den aktuellen Preisen der verwendeten Plattform und dem eigenen Nutzungsumfang ab. In der Konsole von APIYI auf apiyi.com finden Sie die Details zur nutzungsbasierten Abrechnung.
KI-Bewertung bei Finanz- und Rechtsaufgaben: Die wichtigsten Erkenntnisse
- Kein vollständiges Bestehen bei strenger Abnahme: In den Finanz- und Rechtsbereichen von GDPx bestand kein Modell nach dem binären Bewertungsmaßstab vollständig.
- Teilergebnisse waren dennoch möglich: Im Finanzfall bestand der beste Einzeldurchlauf 8 von 11 Prüfungen, im Rechtsfall lag das höchste Einzelergebnis bei 57 %.
- Der Fehler lag im Urteil, nicht in der Rechnung: Eine Anpassung um 418 US-Dollar wurde falsch interpretiert, wodurch das EBITDA um 4728 US-Dollar zu niedrig ausfiel.
- Die Rangfolge der Dokumente ist entscheidend: In 14 von 20 Durchläufen wurde eine Kunden-E-Mail höher gewichtet als eine unterzeichnete Konditionenliste.
- Implizite Einschränkungen sind besonders schwer abzudecken: Das Risiko einer Umgehung über Tochtergesellschaften wurde in keinem der 20 Durchläufe verhindert.
- Drei Konzepte sind getrennt zu bewerten: Teilergebnisse, vollständiges Bestehen und Produktionstauglichkeit dürfen nicht gleichgesetzt werden.
- Erst unterstützen, dann pilotieren: Über die einheitliche Schnittstelle für mehrere Modelle von APIYI apiyi.com lassen sich abgestufte Tests mit eigenen Beispielen durchführen.
Fazit
Die wichtigsten Erkenntnisse aus den Finanz- und Rechtsaufgaben von GDPx lassen sich in drei Punkten zusammenfassen:
- Flüssig ist nicht gleich fachlich korrekt: Selbst wenn Tabellenrechnungen stimmen und Klauseln gut formuliert sind, können Fehler bei der wirtschaftlichen Substanz, der Rechteverteilung und widersprüchlichen Dokumenten auftreten;
- Professionelle Ergebnisse erfordern Urteilsvermögen: Entscheidend sind die Autorität der Unterlagen, indirekte Auswirkungen, implizite Einschränkungen und die Konsistenz über mehrere Dokumente hinweg;
- Befugnisse abstufen und Abnahmekriterien klären: In Anlehnung an die Ansätze von ABA und NIST sollte die menschliche Prüfung erhalten bleiben und KI vor allem zur Unterstützung und für erste Entwürfe eingesetzt werden.
KI kann bei komplexen Fachaufgaben bereits wertvolle Teilarbeit leisten. Bis sie Ergebnisse eigenständig und unter eigener Verantwortung liefern kann, ist es aber noch ein gutes Stück. Wer KI-Lösungen für Finanz- oder Rechtsszenarien bewertet, sollte über APIYI apiyi.com mehrere Modelle mit eigenen Geschäftsbeispielen vergleichen – sowohl anhand ihrer Teilergebnisse als auch der Bestehensquote bei kritischen Prüfpunkten. Erst danach sollten die Grenzen ihrer Befugnisse festgelegt werden.
📚 Quellen
- SemiAnalysis: ursprünglicher GDPx-Bericht: Kapitel zu Finanzen und Recht, Fallbeispiele und Fehlermuster
- Link:
newsletter.semianalysis.com/p/gdpx-measuring-frontier-model-capabilities -
Hinweis: Primärquelle für die Daten zu den Fällen Bellwood-QoE und quillon-series-b-redline
-
GDPx-Domänenbeschreibung und öffentliche Ausführungsverläufe: Anzahl der Aufgaben, Partner und Agent-Verläufe
- Links:
gdpx.semianalysis.com/domains,gdpx.semianalysis.com/rollouts -
Hinweis: Hier lässt sich die Ausführung einiger öffentlich zugänglicher Aufgaben nachvollziehen
-
Pressemitteilung zur ABA Formal Opinion 512: Berufsethische Leitlinien für den Einsatz generativer KI durch Anwälte
- Link:
americanbar.org/news/abanews/aba-news-archives/2024/07/aba-issues-first-ethics-guidance-ai-tools/ -
Hinweis: Gilt für die Anwaltschaft in den USA und kann als Orientierung für Grundsätze der menschlichen Prüfung dienen
-
NIST AI RMF Generative AI Profile: Rahmenwerk für das Risikomanagement bei generativer KI
- Link:
nist.gov/publications/artificial-intelligence-risk-management-framework-generative-artificial-intelligence - Hinweis: Branchenübergreifende Orientierung zu menschlicher Aufsicht, Evaluierung und Governance-Maßnahmen
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der offiziellen APIYI-Website. Weitere Informationen zur Anbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com.