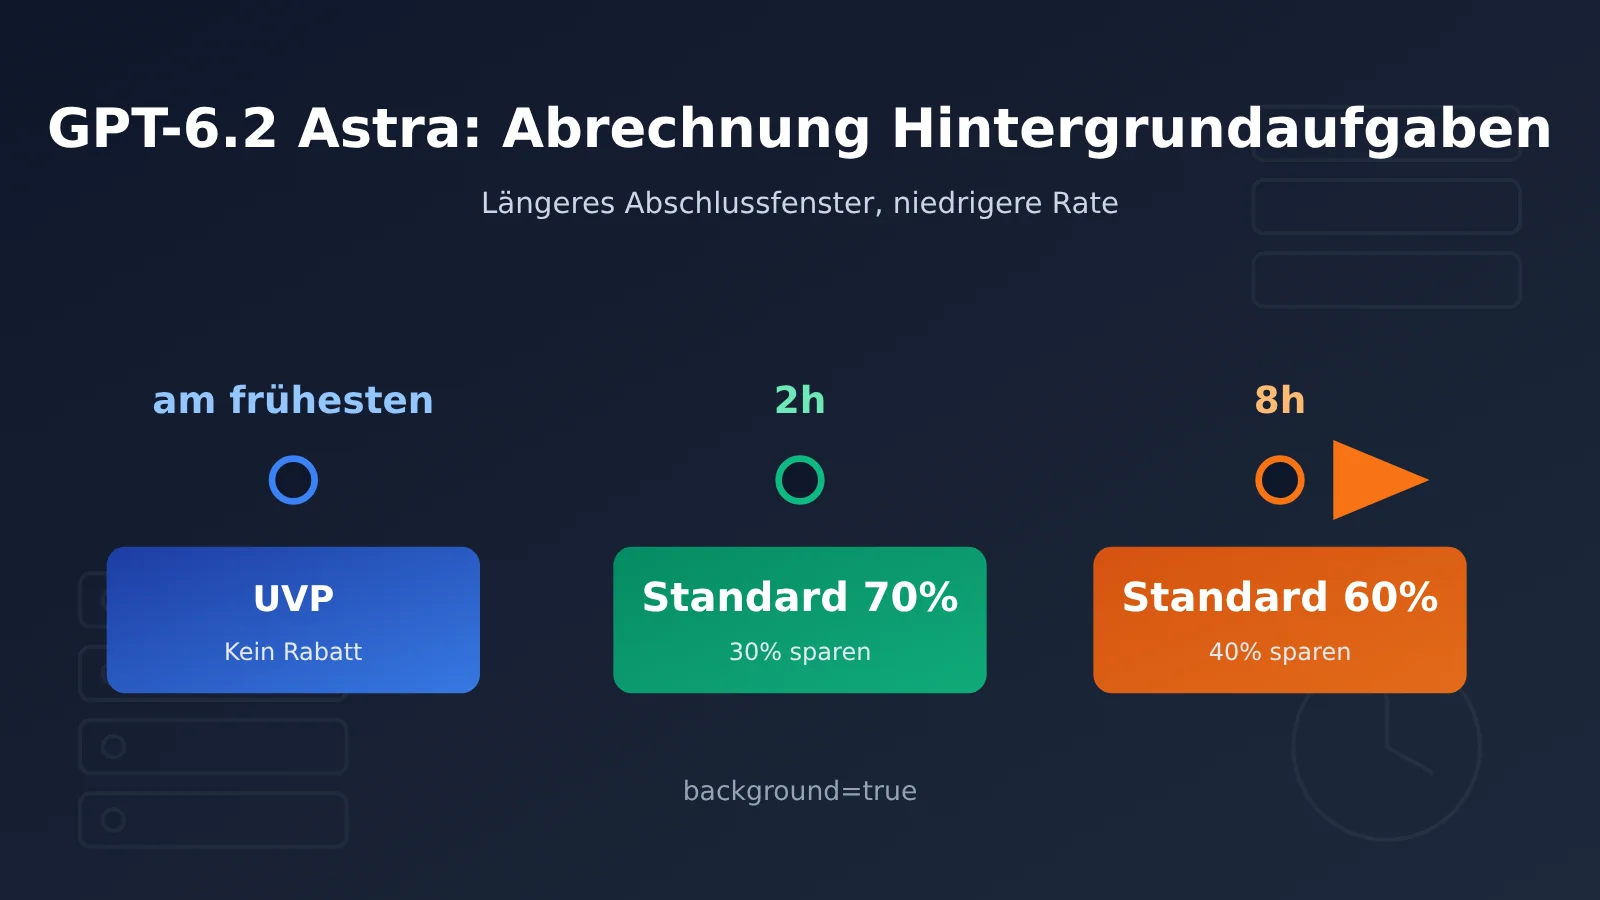
Die Abrechnungsregeln für Hintergrundaufgaben von GPT-6.2 Astra lassen sich in einem Satz zusammenfassen: Wer warten kann, zahlt weniger. Ab dem 17. November 2026 gehen die Hintergrund-Fertigstellungsfenster der Responses API in die öffentliche Beta. Das standardmäßige soonest-Fenster wird zum regulären Preis der verwendeten Verarbeitungsstufe abgerechnet. Bei Wahl des 2h-Fensters werden qualifizierte Anfragen mit 70 % des Token-Satzes des Standard-Modells abgerechnet, im 8h-Fenster mit 60 %, also 30 % bzw. 40 % günstiger.
Welche Stufe Sie wählen, hängt von zwei Fragen ab: Wann müssen die Ergebnisse spätestens vorliegen, und müssen Anfragen auf Zwischenergebnisse des jeweils vorherigen Schritts warten? Beantworten Sie zuerst diese beiden Fragen und schätzen Sie dann die Kosten anhand des Verbrauchs – das ist zuverlässiger, als einfach die Stückpreise zu vergleichen.
Was Sie nach dem Lesen dieses Artikels wissen werden:
- Definitionen, Startpunkt der Zeitmessung und Preisbasis der drei Fertigstellungsfenster soonest, 2h und 8h
- Die konkreten Kosten für denselben Verbrauch (100.000 Eingabe- und 10.000 Ausgabe-Token) in 7 Modi
- Die Parameterbedingungen, die erfüllt sein müssen, damit eine Anfrage den Rabatt erhält, sowie die Grenzen von Warteschlangenkontingent und Cache-Wiederverwendung
- Welche Übermittlungsart für interaktive Frage-und-Antwort-Sitzungen, Ticket-Zusammenfassungen, Über-Nacht-Prüfungen und unabhängige Klassifizierungsaufgaben jeweils geeignet ist
Gliederung: Eine Begriffstabelle und ein Kurzüberblick über die Auswirkungen helfen zunächst, die Terminologie zu vereinheitlichen. Im Abschnitt „Objektive Fakten“ werden nacheinander die Regeln für Fertigstellungsfenster, die Preise der einzelnen Stufen, die Rabattbedingungen und die Behandlung von Folgeschritten in mehrstufigen Workflows erläutert. Der Abschnitt „Analyse und Einschätzung“ behandelt, ob Rabatte kombinierbar sind, das Zeitbudget für mehrstufige Aufgaben, die Kompromisse durch Cache und Warteschlangenkontingent sowie Empfehlungen zur Stufenwahl je nach Workload.
GPT-6.2 Astra Abrechnung von Hintergrundaufgaben: Wissenswertes
| Konzept | Kurze Erklärung |
|---|---|
| Standard | Die Standardverarbeitungsstufe der OpenAI API. Die Rabatte für die Hintergrundfenster von 2 h und 8 h beziehen sich auf ihren Modelltarif. |
| Fast | Die aktuelle Beschleunigungsstufe von Astra. Der Modell-Token-Tarif ist doppelt so hoch wie bei Standard. |
| Ultrafast | Eine noch schnellere Verarbeitungsstufe. Während der Promotionsphase 3× Standard, danach beträgt der Listenpreis 6×. |
| Hintergrundmodus | Die Anfrage liefert zunächst eine Antwort-ID zurück. Die Anwendung fragt später den Status ab und ruft das Ergebnis ab. |
| Abschlussfenster | Das nach Annahme einer Hintergrundantwort geltende Ziel für die Planung der Fertigstellung; unterteilt in soonest, 2 h und 8 h. |
| soonest | Das Standardfenster für Hintergrundanfragen. Die Ausführung erfolgt so schnell wie möglich und nutzt den Modelltarif der jeweiligen Verarbeitungsstufe. |
| Batch API | Packt voneinander unabhängige Anfragen in eine JSONL-Datei und führt sie asynchron als einen Job aus. |
| continuation_id | Eine von der Anwendung für denselben Hintergrundworkflow vergebene Kennung, mit der zulässige Folgeanfragen verknüpft werden. |
| Modell-Token-Tarif | Der jeweilige Stückpreis für Abrechnungspositionen wie normale Eingabe, Eingabe mit Cache-Treffer und Ausgabe. |
GPT-6.2 Astra Abrechnung von Hintergrundaufgaben: Auswirkungen im Überblick
- API-Entwickler: Bei asynchronen Aufgaben gibt es zwei zusätzliche Rabattoptionen zwischen Echtzeitaufrufen und Batch. Dafür muss die Anwendung auf den Hintergrundmodus umgestellt und Polling oder Webhooks müssen verarbeitet werden.
- Produktmanager: In den Anforderungen muss klar festgelegt werden, „wann das Ergebnis spätestens verfügbar sein muss“. Bei Funktionen, die eine Lieferung nach 2 oder 8 Stunden akzeptieren können, sinken die Modell-Token-Kosten um 30 % bzw. 40 %.
- Verantwortliche für Kosten und Betrieb: 2 h, 8 h und Batch nutzen gemeinsam ein Warteschlangenkontingent. Große Batch-Jobs und Aufgaben mit Hintergrundrabatt müssen gemeinsam geplant werden; die Kapazität darf nicht getrennt voneinander geschätzt werden.
Faktenlage: Abrechnungsregeln für Hintergrundaufgaben von GPT-6.2 Astra
Welche drei Abschlussfenster gibt es bei den Hintergrundaufgaben von GPT-6.2 Astra?
OpenAI hat am 17. November 2026 GPT-6.2 Astra und GPT-6.2 Sol veröffentlicht. Astra ist für komplexes Reasoning, Coding und professionelle Arbeit ausgelegt; die API-Modell-ID lautet gpt-6.2-astra. Am selben Tag wurde im OpenAI-API-Changelog festgehalten, dass die Hintergrund-Abschlussfenster der Responses API in die öffentliche Beta gingen.
Asynchrone Anfragen für Astra erfordern background=true; es gibt drei Fensterarten:
- soonest (Standard): So schnell wie möglich ausführen; Modell-Token werden zum tatsächlich verwendeten Verarbeitungstarif abgerechnet, ohne Rabatt.
- 2h: Qualifizierte Anfragen werden mit 70 % des Standard-Modell-Token-Tarifs abgerechnet.
- 8h: Qualifizierte Anfragen werden mit 60 % des Standard-Modell-Token-Tarifs abgerechnet.
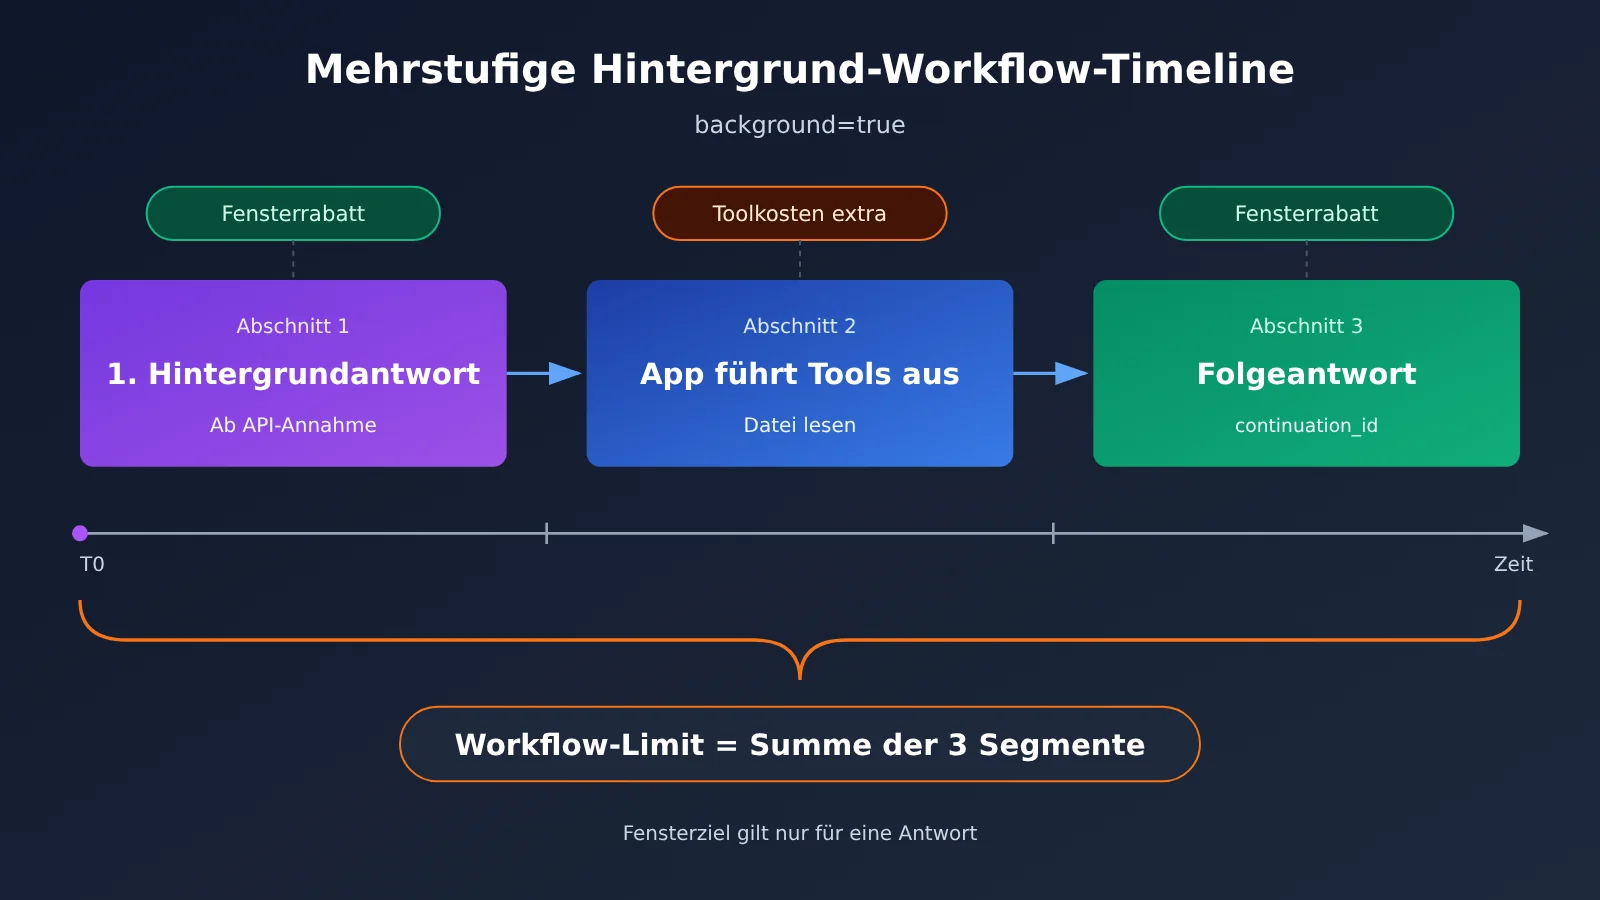
Die Zeitmessung beginnt in dem Moment, in dem die API die ursprüngliche Anfrage annimmt; das Fensterziel bezieht sich auf genau diese Antwort. Muss die Anwendung zwischendurch Tools ausführen und danach eine weitere Antwort anstoßen, werden die Ausführungs- und Fortsetzungszeit dieser Teile zusätzlich innerhalb des Zeitlimits des gesamten Workflows verrechnet.
Ein Beispiel: „Zuerst Dateien prüfen, dann die Prüfung fortsetzen“. Die erste Antwort wird innerhalb des Fensters abgeschlossen und liefert einen Tool-Aufruf, den die Anwendung ausführen muss. Nachdem die Anwendung die Datei gelesen hat, reicht sie das Ergebnis als Folgeanfrage ein, und das Modell setzt die Prüfung fort. Die Dauer des gesamten Vorgangs entspricht der Summe aus der ersten Antwort, der Tool-Ausführung und der Fortsetzungsantwort – nicht nur einem Fenster.
Was kostet dieselbe Anfrage in den einzelnen Stufen von GPT-6.2 Astra?
Die folgende Tabelle zeigt die Tarife von GPT-6.2 Astra für kurzen Kontext, angegeben in US-Dollar pro Million Token. Die Zeilen für 2h und 8h wurden anhand der offiziellen Rabattfaktoren umgerechnet; die Datumsangaben für die Ultrafast-Preise beziehen sich auf US-Pazifikzeit.
| Modus | Relativ zu Standard | Normale Eingabe | Eingabe bei Cache-Treffer | Ausgabe |
|---|---|---|---|---|
| Standard | 1× | $8.00 | $0.40 | $40.00 |
| Fast | 2× | $16.00 | $0.80 | $80.00 |
| Ultrafast (bis 2027-02-28) | 3× | $24.00 | $1.20 | $120.00 |
| Ultrafast (ab 2027-03-01) | 6× | $48.00 | $2.40 | $240.00 |
| Hintergrund 2h | 0.70× | $5.60 | $0.28 | $28.00 |
| Hintergrund 8h | 0.60× | $4.80 | $0.24 | $24.00 |
| Batch | 0.50× | $4.00 | $0.20 | $20.00 |
Für den Vergleich nutzen wir eine feste Nutzungsmenge: 100,000 normale Eingabe-Token + 10,000 abgerechnete Ausgabe-Token. Für Standard ergibt sich 0.1 × $8 + 0.01 × $40 = $1.20; die übrigen Stufen werden nach derselben Methode berechnet:
| Modus | Modell-Token-Kosten pro Anfrage | Differenz zu Standard |
|---|---|---|
| Ultrafast Listenpreis | $7.20 | +$6.00 |
| Ultrafast Aktionspreis | $3.60 | +$2.40 |
| Fast | $2.40 | +$1.20 |
| Standard | $1.20 | Referenz |
| Hintergrund 2h | $0.84 | −$0.36 |
| Hintergrund 8h | $0.72 | −$0.48 |
| Batch | $0.60 | −$0.60 |
Dieses Beispiel berechnet nur Modell-Token. Kosten für Web Search-Aufrufe, Shell-/Code-Interpreter-Container und Ähnliches werden nach ihren jeweiligen Posten separat abgerechnet; auch Cache-Schreibvorgänge werden separat berechnet.
Außerdem weist die Modellkarte darauf hin: Wenn die Eingabe 272K Token überschreitet, gilt für die gesamte Anfrage der Langkontext-Tarif. Eingabe- und Cache-Preise werden mit 2 multipliziert, der Ausgabepreis mit 1.5; anschließend wird die gewählte Stufe bzw. der qualifizierte Rabatt angewendet. Nach dieser Regel ergibt sich für eine Langkontext-Anfrage im 8h-Fenster eine normale Eingabe von $16 × 0.6 = $9.6 und eine Ausgabe von $60 × 0.6 = $36 (pro Million Token).
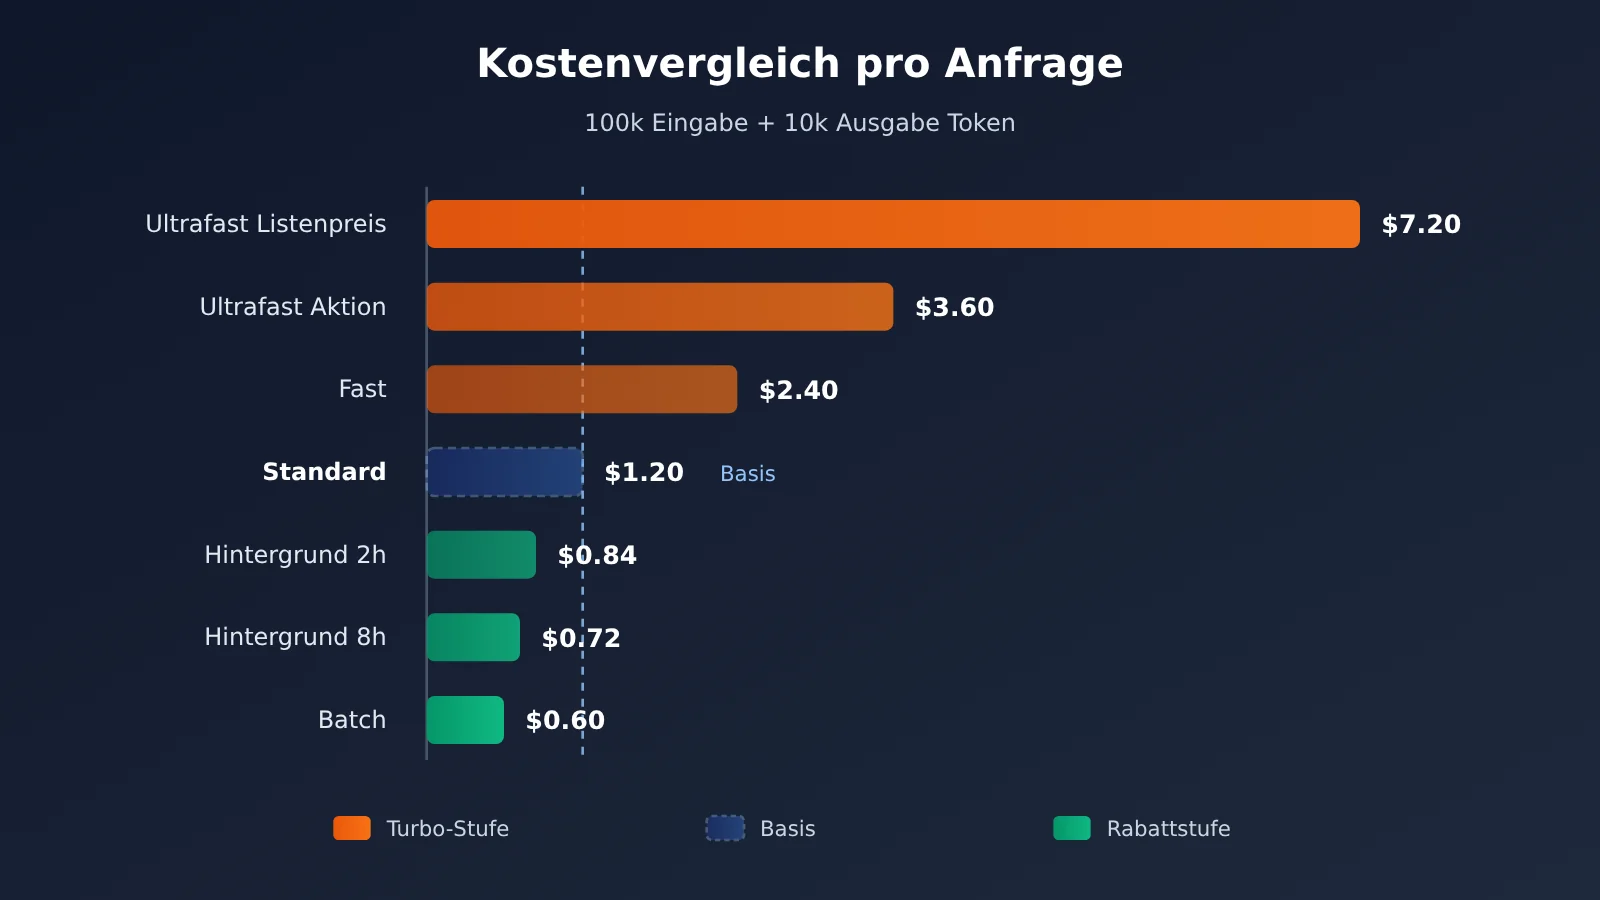
Die Tarife in der obigen Abbildung basieren auf der offiziellen OpenAI-Preisliste und den Rabattfaktoren. Wenn du den Dienst über APIYI apiyi.com nutzt, richtet sich die tatsächliche Abrechnung nach der Abrechnungsseite der Plattform. Es empfiehlt sich, zuerst mit geringem Volumen die Abrechnung zu prüfen und erst danach in die Produktionsumgebung zu übernehmen.
So erfüllen Anfragen an GPT-6.2 Astra die Bedingungen für den Rabatt bei der Hintergrundabrechnung
Der Rabatt greift nicht automatisch – dafür müssen alle folgenden Bedingungen gleichzeitig erfüllt sein:
| Parameter / Bedingung | Zulässiger Wert | Erläuterung |
|---|---|---|
| Endpunkt | /v1/responses |
Maßgeblich für das Hintergrund-Fenster ist die Responses API |
background |
true |
Wechselt in den Hintergrundmodus, es wird zuerst eine Response-ID zurückgegeben |
background_options.completion_window |
2h oder 8h |
Standardmäßig soonest – dann kein Rabatt |
service_tier |
default (Standard) |
auto erfüllt die Bedingung nur, wenn am Ende tatsächlich Standard verwendet wird |
stream |
weggelassen oder false |
Streaming-Ausgabe erfüllt die Rabattbedingung nicht |
Beim Kontingent gilt: 2h, 8h und Batch teilen sich das Warteschlangenkontingent für Batch/Background, wobei beim Einreihen die Input-Token gezählt werden; soonest nutzt die regulären Limits für Anfragenzahl und Token. Beim Caching gibt es eine Einschränkung: Reguläre Standard-Anfragen können den Prompt-Cache nicht wiederverwenden, der von diesen beiden Rabattfenstern erzeugt wurde. Außerdem sei darauf hingewiesen, dass laut Modellkarte Anfragen mit reasoning.effort = none abgelehnt werden.
Hier ein minimales Beispiel. background_options ist möglicherweise noch nicht in den Typdefinitionen des SDK enthalten, deshalb wird es über extra_body übergeben:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI – OpenAI-kompatible Schnittstelle
)

resp = client.responses.create(
    model="gpt-6.2-astra",
    input="请汇总以下 50 张支持工单的共性问题……",
    background=True,
    service_tier="default",          # Standard verwenden, erfüllt die Rabattbedingung
    extra_body={"background_options": {"completion_window": "2h"}},
)
print(resp.id, resp.status)  # Response-ID speichern und später abrufen
Sobald Sie die Response-ID haben, können Sie den Status per Webhook oder Polling abfragen. Solange der Status queued oder in_progress lautet, fragen Sie mit derselben ID weiter ab; Kapazitätsfehler, die den Kriterien entsprechen, werden von der API automatisch erneut versucht – die Anwendung muss die Anfrage nicht selbst noch einmal senden.
Vollständiges Beispiel für Polling und Folgeanfragen anzeigen
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitlicher Zugang über APIYI
)

WINDOW = "8h"

def submit(input_items, previous_id=None):
    """Reicht eine Anfrage für den Hintergrund-Rabatt ein.
    Die genaue Stelle, an der continuation_id übergeben wird, entnehmen Sie bitte der
    OpenAI-Anleitung zum Background-Modus."""
    return client.responses.create(
        model="gpt-6.2-astra",
        input=input_items,
        background=True,
        service_tier="default",
        previous_response_id=previous_id,
        extra_body={
            "background_options": {"completion_window": WINDOW},
            # "continuation_id": "audit-2026-11-19-batch-01",  # im selben Workflow konstant halten
        },
    )

def wait(response_id, interval=60):
    """Fragt ab, bis der Vorgang beendet ist; bei queued / in_progress wird mit derselben ID weiter abgefragt."""
    while True:
        r = client.responses.retrieve(response_id)
        if r.status not in ("queued", "in_progress"):
            return r
        time.sleep(interval)

first = wait(submit("审核合同,需要时调用 read_file 工具读取附件").id)

# Gibt die Antwort einen Tool-Aufruf zurück, den die Anwendung ausführen muss:
# Anwendung führt das Tool aus und startet danach mit demselben Projekt, Modell,
# Service-Tier, Fenster und continuation_id eine Folgeanfrage –
# der Folgeschritt erhält Vorrang in der Warteschlange
for item in first.output:
    if item.type == "function_call":
        tool_result = "……read_file 的实际返回内容……"
        follow = submit(
            [{"type": "function_call_output",
              "call_id": item.call_id,
              "output": tool_result}],
            previous_id=first.id,
        )
        print(wait(follow.id).output_text)
In mehrstufigen Workflows müssen Folgeschritt-Anfragen dasselbe Projekt, dasselbe Modell, dieselbe Verarbeitungsstufe, dasselbe Fenster und dieselbe continuation_id verwenden, um für die bevorzugte Warteschlange zu qualifizieren. Qualifizierte Folgeanfragen werden jeweils mit dem entsprechenden Rabatt abgerechnet.
🚀 Empfehlung zur Einbindung: Das Hintergrund-Abschlussfenster ist derzeit eine Public-Beta-Funktion der OpenAI Responses API. Beim Aufruf über Aggregator-Plattformen wie APIYI apiyi.com empfiehlt es sich, zuerst mit dem kostenlosen Testkontingent zu prüfen, ob die Parameter
backgroundundcompletion_windowvollständig durchgereicht werden und ob die Abrechnung tatsächlich mit dem Rabatt erfolgt – erst danach sollten Produktionsaufgaben migriert werden.
Analyse und Einschätzung: So nutzt man die Abrechnung für Hintergrundaufgaben von GPT-6.2 Astra optimal
GPT-6.2 Astra: Hintergrundrabatt und Beschleunigungsstufe lassen sich nicht kombinieren
Die Rabattbedingung verlangt, dass service_tier auf default steht oder dass auto letztlich bei Standard landet. Daraus lässt sich ableiten: Fast und Ultrafast kommen nicht gleichzeitig in den Genuss der 2h- und 8h-Rabatte. Der Kompromiss ist eindeutig: Die Beschleunigungsstufe tauscht höhere Kosten gegen kürzere Latenz, das Hintergrundfenster tauscht längeres Warten gegen einen niedrigeren Preis – zwei gegenläufige Richtungen.
Ein weiteres Detail, das leicht übersehen wird: soonest ist zwar ebenfalls ein Hintergrundmodus, der Preis richtet sich aber nach der Verarbeitungsstufe. Wer soonest mit Fast kombiniert, zahlt weiterhin den Fast-Preis – nur die Interaktion wird asynchron. soonest sorgt dafür, dass die Oberfläche die Kontrolle vorzeitig an den Nutzer zurückgibt; es selbst spart kein Geld.
Mehrstufige Aufgaben brauchen ein Zeitbudget für den „gesamten Workflow“
Das Fensterziel beschränkt nur eine einzelne Antwort, nicht den gesamten Workflow. Eine Prüfaufgabe mit drei Runden von Tool-Aufrufen kann theoretisch drei Fensterplanungen durchlaufen, dazu kommt die Zeit, die die Anwendung selbst für die Tool-Ausführung benötigt. Wenn im Geschäftskontext „Ergebnis vor 9 Uhr morgens“ zugesagt wird, muss man bei der Bearbeitung von Über-Nacht-Aufgaben mit einem 8h-Fenster beim Einreichungszeitpunkt einen Puffer für Folgeschritte einplanen und darf nicht exakt auf die 8-Stunden-Grenze aufsetzen.
Genau hier liegt der Wert von continuation_id. Es verlängert oder verschmilzt die Fenster nicht, verschafft Folgeschritten aber eine bevorzugte Einreihung und verkürzt die Wartezeit am Ende mehrstufiger Abläufe. Aus technischer Sicht empfiehlt es sich, continuation_id eins zu eins der Geschäftsaufgaben-ID zuzuordnen – das erleichtert auch die Protokollsuche und die Kostenzuordnung.
8h vs. Batch: 10 Prozentpunkte Preisunterschied, unterschiedliche Einsatzszenarien
Bei der Beispielnutzung kostet 8h $0.72 und Batch $0.60 – der Unterschied beträgt nur $0.12. Batch ist günstiger, setzt aber voraus, dass sich die Anfragen vorab als JSONL zusammenstellen lassen, voneinander unabhängig sind und ein Lieferfenster von 24 Stunden akzeptiert wird. 8h erlaubt es dagegen, auf Basis von Tool-Ergebnissen weiter zu schlussfolgern.
Die Entscheidung richtet sich also nicht danach, was billiger ist, sondern nach der Aufgabenstruktur:
- Anfragen hängen voneinander ab (der nächste Schritt benötigt das Ergebnis des vorherigen): 8h oder 2h wählen
- Anfragen sind voneinander unabhängig und lassen sich auf einmal auflisten: Batch wählen
Der 50-%-Rabatt von Batch und der Rabatt des Hintergrundfensters sind zwei unabhängige Abrechnungspfade und addieren sich nicht gegenseitig.
Versteckte Kosten durch Cache und Warteschlangen-Kontingent
Der im Rabattfenster erzeugte Eingabeaufforderungs-Cache kann von regulären Standard-Anfragen nicht wiederverwendet werden. Wird dieselbe lange System-Eingabeaufforderung sowohl für Echtzeit-Q&A als auch für die Hintergrund-Batchverarbeitung genutzt, werden auf beiden Seiten getrennte Caches angelegt, sodass die Kosten für das Schreiben des Caches doppelt anfallen können. Außerdem ist die Cache-Treffer-Eingabe ohnehin schon günstig: Standard $0.40, 8h $0.24. Bei Workloads mit hoher Cache-Trefferquote fällt die Einsparung durch den Hintergrundrabatt bezogen auf die Gesamtrechnung geringer aus als bei ausgabeintensiven Aufgaben.
Auch das Teilen des Warteschlangen-Kontingents muss vorab geplant werden. 2h, 8h und Batch nutzen gemeinsam das Batch/Background-Kontingent, wobei die Einreihung nach Eingabe-Tokens gezählt wird. Werden nachts gleichzeitig große Batch-Jobs und 8h-Review-Streams eingereicht, konkurrieren beide um dasselbe Kontingent.
💡 Kostenhinweis: Bevor Sie die Stufe festlegen, können Sie die Kosten der einzelnen Stufen anhand der Token-Verteilung einer echten Eingabeaufforderung (Anteil von normaler Eingabe, Cache-Treffer-Eingabe und Ausgabe) getrennt abschätzen. Mit der einheitlichen Schnittstelle von APIYI apiyi.com müssen Sie im selben Code nur die Parameter ändern, um die Abrechnungsunterschiede zwischen dem Echtzeit- und dem asynchronen Pfad zu vergleichen.
GPT-6.2 Astra-Servicestufen in echte Workloads einordnen
Die folgenden Workload-Beispiele dienen als Orientierung. Die Entscheidungskriterien sind der Reihe nach: Wie lange kann man warten, hängt man von Zwischenergebnissen ab, fallen Tool-Gebühren an.
| Workload | Empfohlene Übermittlungsart | Begründung |
|---|---|---|
| Interaktive Sofort-Fragen, Analysen bei denen jemand wartet | Mit Standard starten; nach Validierung von Latenz und Kosten Fast / Ultrafast erwägen | Nutzer warten, ein Aufpreis für Geschwindigkeit braucht eine Datengrundlage |
| Asynchrone Oberfläche, Ergebnis soll erst zurückgegeben und später angezeigt werden | soonest | Kontrolle zurückgeben, der Preis folgt der genutzten Verarbeitungsstufe |
| Support-Ticket-Zusammenfassung, die vor dem Nachmittag fertig sein muss | Hintergrund 2h | Lieferung innerhalb weniger Stunden, Modell-Token-Kosten sinken um 30 % |
| Mehrstufige Prüfung, die über Nacht laufen darf und Tools aufrufen muss | Hintergrund 8h + continuation_id | 40 % günstiger, und Zeit für Tool-Ausführung und Folgeschritte ist eingeplant |
| Unabhängige Klassifizierungsaufgaben, die vorab zusammengestellt werden können | Batch (JSONL) | Voneinander unabhängig und ein 24-Stunden-Fenster wird akzeptiert, 50 % günstiger |
Zu beachten: Sobald eine Aufgabe Web Search oder einen Code-Interpreter-Container nutzt, gilt für diesen Kostenanteil kein Rabatt auf Modell-Token. Je höher der Anteil der Tool-Gebühren, desto geringer die Gesamtersparnis durch das Hintergrund-Fenster.
🎯 Auswahlempfehlung: Fahren Sie zunächst bei APIYI apiyi.com dieselbe Stichprobe jeweils mit Standard, 2h und 8h und protokollieren Sie die tatsächlichen Fertigstellungszeiten und Rechnungen. Erst danach legen Sie die Standardstufe für jede Aufgabeklasse fest. Das kommt den realen Kosten näher, als nur die Preisliste zu betrachten.
Entwicklungen, die im Blick bleiben sollten
Das Backend-Abschlussfenster befindet sich weiterhin in der Public Beta. Parameternamen, Anspruchsvoraussetzungen und Rabattsätze können sich vor der offiziellen Veröffentlichung noch ändern; vor dem Launch sollte man sich an der offiziellen OpenAI-Anleitung orientieren. Zwei weitere Zeitpunkte sollte man sich ebenfalls merken: Der Ultrafast-Aktionspreis gilt bis zum 28. Februar 2027 (Pazifikzeit); ab dem 1. März steigt der Tarif von 3× auf 6×. Produkte, die langfristig auf Ultrafast setzen, sollten ihr Budget frühzeitig prüfen. GPT-6.2 Astra und Sol haben derzeit keine Flex-Stufe. Sollten diese später eingeführt werden, wird die Auswahl für asynchrone Aufgaben größer.
Für Teams, die gerade asynchrone Funktionen für Astra planen, lohnt es sich, zunächst bei APIYI apiyi.com mit Testguthaben den Background-Modus und die Polling-Logik end-to-end zu testen, Deadlines und Aufgabenabhängigkeiten in das Anforderungsdokument aufzunehmen und erst danach über die passende Stufe zu sprechen.
In den „Analekten“ (Lunyu), Kapitel Zilu, heißt es: „Wer überstürzt, erreicht sein Ziel nicht.“ Auf der Preisliste von GPT-6.2 Astra hat dieser Satz plötzlich einen Preis: Wer bereit ist, ein paar Stunden länger zu warten, kann 30 bis 40 Prozent der Modellkosten sparen.
📚 Referenzen
-
OpenAI-Ankündigung: Introducing GPT-6.2 Astra and Sol (2026-11-17)
- Link:
openai.com/index/introducing-gpt-6-2-astra-sol/ - Beschreibung: Modellpositionierung und Erläuterung der Preisanpassung
- Link:
-
GPT-6.2 Astra Modellkarte: Spezifikationen, Tarife für kurzen und langen Kontext
- Link:
developers.openai.com/api/docs/models/gpt-6.2-astra - Beschreibung: Kontextlänge, Preisregeln für 272K langen Kontext
- Link:
-
OpenAI API-Änderungsprotokoll: Einträge zu Modellveröffentlichung und Backend-Fenster vom 2026-11-17
- Link:
developers.openai.com/api/docs/changelog - Beschreibung: Public Beta des Backend-Abschlussfensters und Rabattsätze
- Link:
-
OpenAI API-Preisliste: Einzelpreise je Verarbeitungsstufe
- Link:
developers.openai.com/api/docs/pricing - Beschreibung: Tarife Standard, Fast, Ultrafast, Batch
- Link:
-
Background-Modus-Leitfaden: Background-Modus, Abschlussfenster und Folgeanfragen
- Link:
developers.openai.com/api/docs/guides/background - Beschreibung: Rabattbedingungen, continuation_id, Queue-Kontingent und Cache-Grenzen
- Link:
-
Batch API / Fast / Ultrafast-Leitfäden
- Link:
developers.openai.com/api/docs/guides/batch,developers.openai.com/api/docs/guides/fast-mode,developers.openai.com/api/docs/guides/ultrafast-mode - Beschreibung: Voraussetzungen für die einzelnen Übermittlungsarten
- Link:
Autor: APIYI-Team
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI apiyi.com; weitere Integrationsunterlagen finden Sie im Dokumentationszentrum docs.apiyi.com