
Anmerkung des Autors: Eine Einordnung der von OpenAI Signals v3.0 veröffentlichten ChatGPT-Nutzungsdaten zu 165 Arbeitsaktivitäten – wir klären die statistische Abgrenzung und analysieren, welchen praktischen Wert sie für Entwickler und Unternehmen bei KI-Anwendungen haben.
Am 26. Oktober 2026 veröffentlichte das Economic Research Team von OpenAI die Studie „ChatGPT’s expanding world of work“ (offizieller chinesischer Titel: „ChatGPTs sich stetig erweiternde Arbeitswelt“) und veröffentlichte ChatGPT-Nutzungsdaten aus fast 100 Ländern und Regionen, zu 165 Arbeitsaktivitäten und über sieben aufeinanderfolgende Quartale. Diese Daten gehören zum Programm OpenAI Signals v3.0, stehen kostenlos unter der Lizenz CC BY 4.0 zum Download bereit, und Forschende können die CSV-Dateien direkt für eigene Auswertungen nutzen.
Dies ist keine Veröffentlichung eines neuen Modells oder einer neuen Funktion, sondern ein Satz wirtschaftlicher Nutzungsdaten für die Forschung. Offizielle Ankündigung, Datenwörterbuch und Prüfungen der Roh-CSV durch Drittmedien liegen bereits gleichzeitig vor; die Zahlen sind konsistent und lassen sich gegenseitig verifizieren. Dieser Artikel trennt offizielle Schlussfolgerungen klar von Berechnungen Dritter, damit der „Nachrichtenanteil“ nicht fälschlich als „Jobersatz“ gelesen wird.
Der Kernnutzen: In wenigen Minuten verstehen, was die OpenAI-Daten zu 165 Arbeitsaktivitäten tatsächlich erfassen, welche Erkenntnisse sie liefern und welche praktische Bedeutung sie für Entwickler von KI-Anwendungen haben.
Die wichtigsten Informationen zu OpenAIs Daten zu 165 Arbeitsaktivitäten auf einen Blick
Zuerst eine Tabelle mit den grundlegenden Fakten zur Veröffentlichung der ChatGPT-Nutzungsdaten:
| Information | Details |
|---|---|
| Veröffentlichungsdatum | 26. Oktober 2026 |
| Herausgeber | OpenAI-Wirtschaftsforschungsteam (OpenAI Signals v3.0) |
| Klassifikationssystem | US-amerikanisches O*NET (Intermediate Work Activities, IWA) |
| Abdeckung | Knapp 100 Länder und Regionen, 165 Kategorien von Arbeitsaktivitäten |
| Zeitraum | Q1 2025 bis Q3 2026, insgesamt 7 Quartale |
| Stichprobenquelle | Persönliche Konten von Free, Go, Plus und Pro, angegebenes Alter ab 18 Jahren |
| Ausschluss | ChatGPT Enterprise, Codex, gelöschte Konten, Stichproben, deren Daten nicht für Training verwendet werden dürfen |
| Datenlizenz | CC BY 4.0, kostenlose Einsicht und CSV-Download, Namensnennung erforderlich |
165 Arbeitsaktivitäten sind keine 165 Berufe
Das ist der Punkt, an dem bei der Interpretation dieser OpenAI-Daten die meisten Fehler passieren. O*NET ist eine offiziell geförderte US-Datenbank mit Berufsinformationen, die „Berufe“ in mehrere Ebenen von „Arbeitsaktivitäten“ aufteilt. So taucht die Aktivität „schriftliches Material redigieren“ sowohl in der Arbeit von Redakteuren als auch im Alltag von Lehrkräften, Anwälten, Ingenieuren und Finanzfachleuten auf.
OpenAI zählt also, „was Menschen mit ChatGPT machen“, und nicht, „welche Berufsgruppen ChatGPT nutzen“. IWA (Intermediate Work Activities, Arbeitsaktivitäten auf mittlerer Ebene) liegen zwischen allgemeinen Arbeitsverhaltensweisen und sehr konkreten Aufgaben; im O*NET-Referenzsystem gibt es insgesamt 332 IWA-Einträge.
OpenAI berichtet einzeln nur über die häufigen Aktivitäten, die die Stichprobenschwelle erfüllen; seltene Aktivitäten wurden zusammengefasst. Laut einer Prüfung der Roh-CSV durch PPC Land besteht die öffentliche Tabelle tatsächlich aus 164 benannten Kategorien plus einer zusammengefassten Kategorie „Other IWA“, also insgesamt 165 Klassifikationsergebnissen. Man kann also nicht sagen, OpenAI habe alle 332 IWA-Kategorien vollständig erfasst.
Wie die Daten erhoben und klassifiziert werden
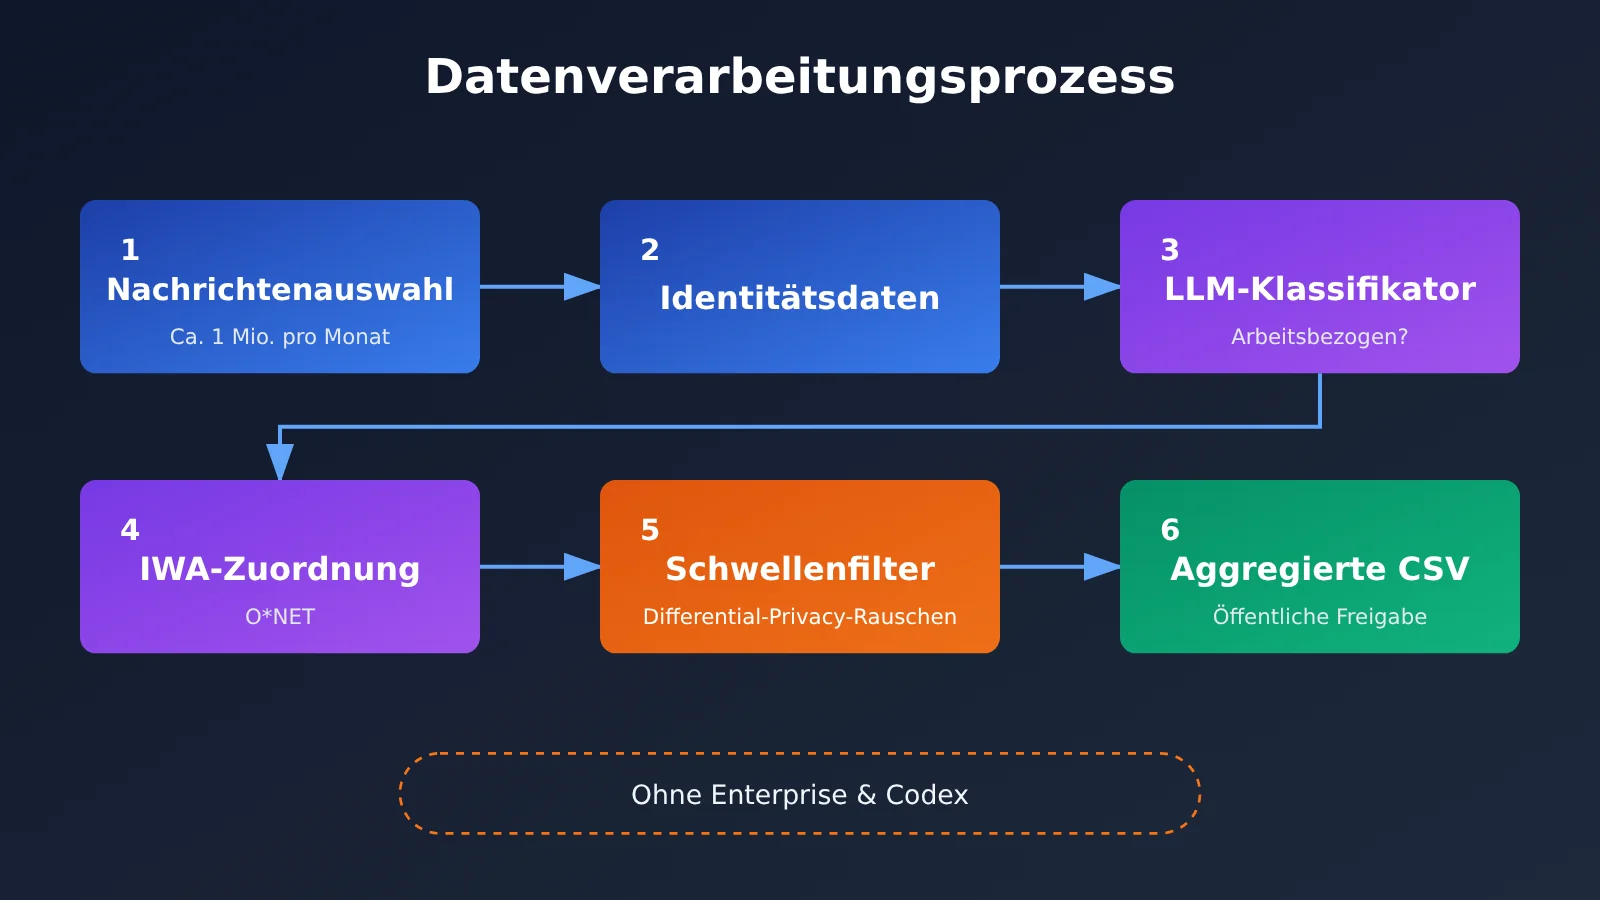
Signals v3.0 zieht monatlich eine Stichprobe von etwa 1 Million ChatGPT-Nachrichten; insgesamt umfasst der Zeitraum von Juli 2024 bis September 2026 27 Monate und rund 27 Millionen klassifizierte Stichproben. Wichtig: Die 27 Millionen sind die Summe der monatlichen Stichproben. Sie entsprechen weder der Zahl unabhängiger Nutzer noch sind alle Nachrichten beruflich veranlasst.
Die Klassifizierung übernimmt ein automatisierter Sprachmodell-Klassifikator: Zuerst wird geprüft, ob eine Nachricht beruflich relevant ist, dann wird sie einer O*NET-Arbeitsaktivität zugeordnet; zugleich werden Dimensionen wie Thema, Absicht, Zeit und Region markiert. Zum Datenschutz erklärt OpenAI, dass Forschende die Rohchats nicht direkt lesen, dass Identitätsinformationen vor der Klassifizierung behandelt werden, dass nur aggregierte Ergebnisse veröffentlicht werden und dass kleine Stichproben ausgeblendet und mit Rauschen aus differenzieller Privatsphäre versehen werden. Verteilungen von Arbeitsaktivitäten nach Land und Quartal werden erst veröffentlicht, wenn mindestens 1.000 gültige Nachrichten vorliegen.
Die zentrale Erkenntnis aus den ChatGPT-Nutzungsdaten: Arbeitsbezogene Nutzung wird vielfältiger
Die offizielle Schlagzeile von OpenAI lautet: Privatnutzer setzen ChatGPT für immer mehr unterschiedliche Arten von Arbeit ein. In den 74 Ländern und Regionen, für die über sieben Quartale hinweg vollständige Daten vorliegen, ist der durchschnittliche Anteil der zehn häufigsten Arbeitsaktivitäten an allen klassifizierten arbeitsbezogenen Nachrichten des jeweiligen Landes deutlich gesunken.
| Zeitraum | Durchschnittlicher Anteil der zehn häufigsten Arbeitsaktivitäten je Land |
|---|---|
| Q1 2025 | 56,0 % |
| Q3 2026 | 51,1 % |
| Veränderung | −4,9 Prozentpunkte |
Zwei Dinge muss man hier klar auseinanderhalten. Erstens: Die 51,1 % sind nicht der Anteil einer weltweit einheitlichen Top-10-Liste. Vielmehr wird zuerst für jedes Land eine eigene Top 10 berechnet und dann über die 74 Länder gemittelt – die zehn häufigsten Aktivitäten können von Land zu Land unterschiedlich sein. Zweitens: Ein sinkender Anteil bedeutet nicht, dass die Zahl der Nachrichten zurückgeht. Wenn die Gesamtnutzung wächst, kann die absolute Zahl der Anfragen bei den Spitzenaktivitäten trotzdem steigen.
Anders gesagt: Mehr „Long-Tail“-Arbeitsaktivitäten bekommen einen größeren Anteil ab. Zu beachten ist außerdem, dass die 74 Länder und die knapp 100 Länder zwei unterschiedliche Stichprobenbereiche sind – beim Zitieren darf man sie nicht vermischen.
Welche konkreten Arbeitsaktivitäten sind am häufigsten?
PPC Land hat am 27. Oktober 2026 auf Basis aller öffentlich verfügbaren CSV-Dateien eine unabhängige Berechnung durchgeführt und dabei für 74 Länder jeweils separate Statistiken erstellt und anschließend den Durchschnitt gebildet. Die folgenden sechs benannten Arbeitsaktivitäten waren im dritten Quartal 2026 am häufigsten (Berechnung eines Drittanbieters, nicht direkt in einer OpenAI-Ankündigung aufgeführt):
| Rang | Arbeitsaktivität | Durchschnittlicher Nachrichtenanteil in 74 Ländern |
|---|---|---|
| 1 | Bearbeiten von schriftlichen Materialien oder Dokumenten | 15,0 % |
| 2 | Erstellen von visuellen Designs oder Präsentationsinhalten | 7,9 % |
| 3 | Entwickeln von Marketing- oder Werbematerialien | 5,1 % |
| 4 | Erklären von sprachlichen oder kulturellen Informationen | 4,0 % |
| 5 | Vorbereiten von Informations- oder Lehrmaterialien | 3,2 % |
| 6 | Programmieren von Computersystemen oder Produktionsanlagen | 3,1 % |
Das Bearbeiten von Dokumenten bleibt der am weitesten verbreitete berufliche Anwendungsfall; visuelles Design ist auf den zweiten Platz vorgerückt. Marketinginhalte, Lehrmaterialien und sprachübergreifendes Verständnis sind deutlich gefragt, während Programmieren zwar wichtig ist, in dieser Stichprobe persönlicher Konten aber nicht den größten Anteil ausmacht.
Visuelles Design legt zu, Programmierung verliert Anteil
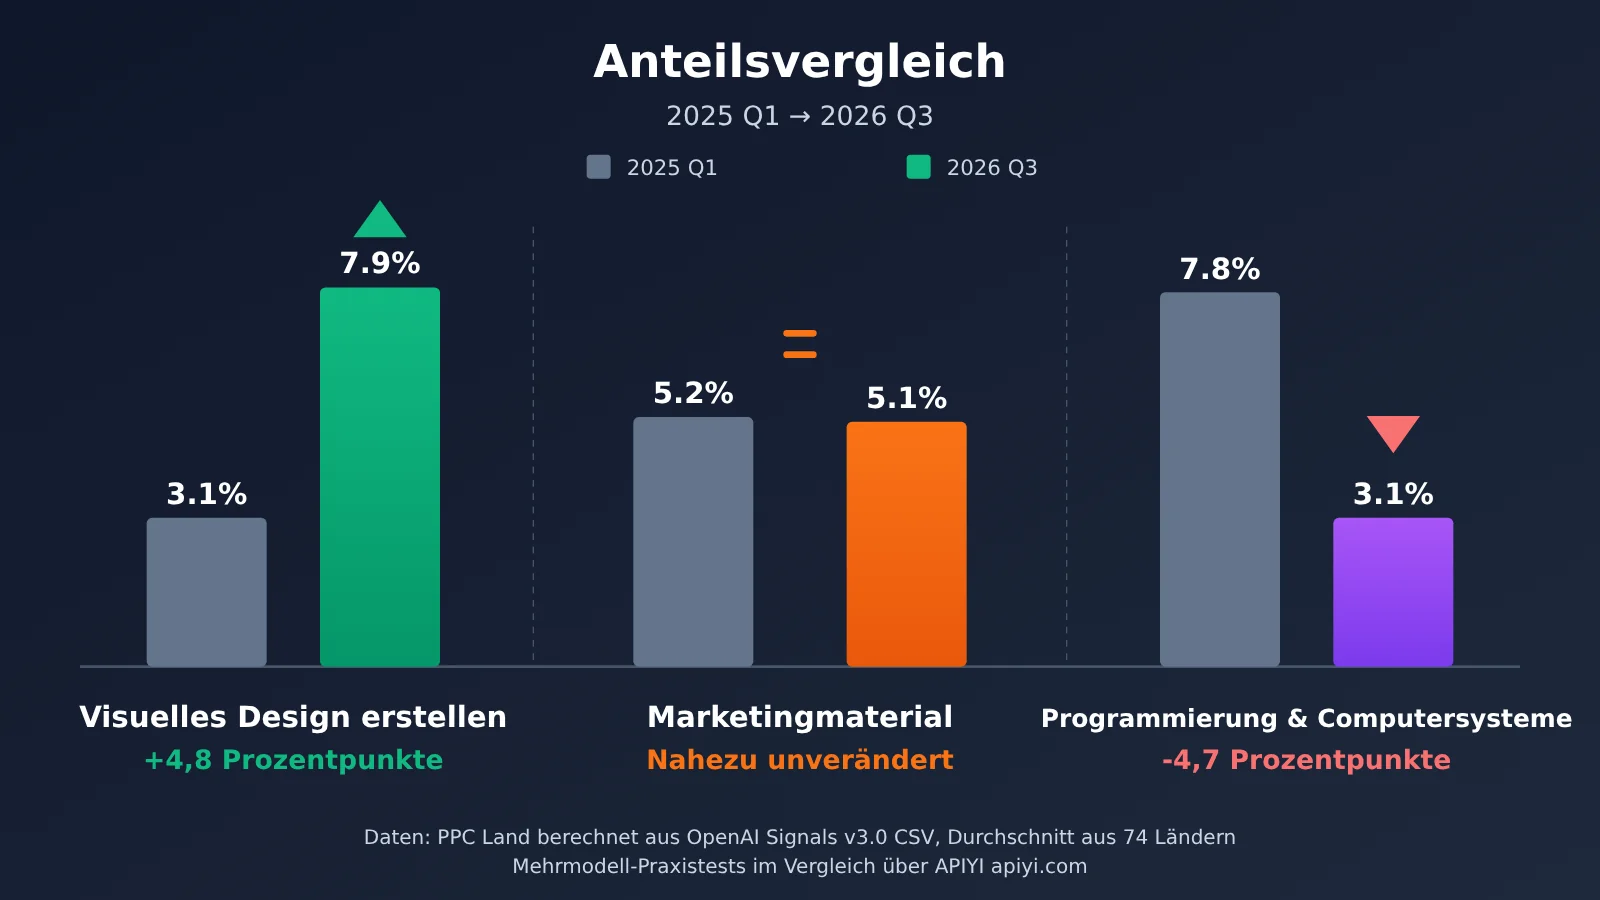
Laut Berechnungen von PPC Land stieg der über 74 Länder gemittelte Anteil für „visuelles Design oder Präsentationsinhalte erstellen“ von 3,1 % im ersten Quartal 2025 auf 7,9 % im dritten Quartal 2026 – ein Plus von 4,8 Prozentpunkten und damit der stärkste Zuwachs unter allen 165 konkreten Aktivitätskategorien. In den USA kletterte der Wert im selben Zeitraum von 2,4 % auf 7,6 %, Brasilien erreichte im dritten Quartal 2026 11,2 %, Indien 8,7 %.
Umgekehrt fiel „Computersysteme oder Produktionsanlagen programmieren“ von 7,8 % auf 3,1 %, in den USA von 6,7 % auf 2,4 %, während Indien im dritten Quartal 2026 noch 5,8 % hielt. Auch verwandte Aktivitäten wie das Lösen von Computerproblemen oder die Recherche zu technischen Designs gingen parallel zurück. Eine naheliegende Hypothese ist, dass Entwicklerinnen und Entwickler auf spezialisierte Programmieragenten wie Codex umgestiegen sind – doch die Daten selbst belegen diese Verschiebung nicht. Vorsichtiger formuliert: In diesem Datensatz, der Codex und Unternehmenskonten ausklammert, ist der Anteil programmierbezogener Arbeitsnachrichten deutlich gesunken.
Marketing ist ein weiteres Signal, das Aufmerksamkeit verdient. Der durchschnittliche Anteil von „Marketing- oder Werbematerial erstellen“ blieb mit 5,2 % zu 5,1 % praktisch unverändert; Länder wie Argentinien, Pakistan und Nigeria kamen im dritten Quartal 2026 auf rund 9 %. Das zeigt: Der Anteil allgemeinen Schreibens sinkt zwar, die Nachfrage nach spezialisierten Marketinginhalten bleibt jedoch stabil.
📊 Hinweis zur Grafik: Die Daten im obigen Chart stammen aus einer Sekundärauswertung der öffentlich verfügbaren OpenAI-CSV durch PPC Land. Wer im eigenen Geschäft prüfen möchte, welches Modell für Design-, Text- oder Programmieranfragen jeweils am besten passt, kann über APIYI apiyi.com mit einem einzigen API-Schlüssel zwischen OpenAI, Claude, Gemini und weiteren Modellen wechseln und kleine Vergleichstests fahren.
Vergleich der Arbeitsstruktur von ChatGPT in den USA und Deutschland
PPC Land hat außerdem die breiter gefassten „Generalized Work Activities“ aus den interaktiven Diagrammen von OpenAI Punkt für Punkt ausgelesen (Achtung: Diese stehen nicht auf derselben Ebene wie die oben genannten IWA und dürfen nicht mit ihnen vermischt werden). Die Statistik bezieht sich auf den Anteil arbeitsbezogener Nachrichten in den jeweiligen Ländern:
| Breit gefasste Arbeitsaktivität | USA Q1 2025 | USA Q1 2026 | Deutschland Q1 2025 | Deutschland Q1 2026 |
|---|---|---|---|---|
| Entscheidungen treffen und Probleme lösen | 22,8 % | 21,6 % | 22,0 % | 19,4 % |
| Kreatives Denken | 11,8 % | 15,6 % | 11,3 % | 13,1 % |
| Informationen erfassen | 10,6 % | 11,8 % | 10,3 % | 11,4 % |
| Computer nutzen | 11,7 % | 6,7 % | 12,7 % | 8,4 % |
| Beratung und Empfehlungen geben | 5,5 % | 9,0 % | 7,1 % | 11,7 % |
| Informationen für andere erklären | 5,1 % | 4,0 % | 9,5 % | 8,6 % |
In beiden Ländern zeigt sich, dass „Entscheidungen treffen und Probleme lösen“ eine wichtige Verwendung ist, während die Anteile von „kreativem Denken“ und „Beratung und Empfehlungen“ deutlich gestiegen sind. Das beschreibt die Art der Nutzeranfragen – es bedeutet weder, dass ChatGPT bereits eigenständig geschäftliche Entscheidungen trifft, noch, dass es geprüfte Expertenberatung liefert.
Zwischen den Ländern ist der von PPC Land ausgelesene Indikator für die Verteilungsunterschiede (Total Variation Distance) von etwa 22,2 % leicht auf etwa 23,0 % gestiegen. OpenAI räumt ebenfalls ein, dass diese Unterschiede auf Arbeitsstrukturen, Sprachkultur, die Verfügbarkeit von Werkzeugen und Nutzungsgewohnheiten zurückgehen könnten – die vorliegenden Daten reichen nicht aus, um einen kausalen Zusammenhang zu belegen.
Analyse der Auswirkungen von 165 Kategorien von Arbeitsaktivitäten auf Entwickler
Auswirkungen auf Entwickler von KI-Anwendungen
- Die Anforderungen werden breiter: Nutzer verwenden ChatGPT längst nicht mehr nur zum Bearbeiten von Dokumenten – visuelles Design, Marketing, Unterrichtsmaterialien und Beratungsempfehlungen machen einen erheblichen Anteil aus. KI-Tools mit nur einer Funktion sollten daher Mehrzweck-Szenarien berücksichtigen.
- Multimodalität wird wichtiger: Visuelles Design ist die Aktivität mit dem größten Zuwachs. Gleichzeitig stieg der Themenbereich „Multimedia“ unter allen persönlichen Nachrichten im selben Zeitraum von 2,0 % auf 8,8 % (Berechnung von PPC Land). Bildfähigkeiten sollten deshalb in die Produktplanung einfließen.
- Programmierszenarien werden spezialisierter: Der Anteil der Programmiernachrichten im allgemeinen Chat sinkt. Das deutet darauf hin, dass Entwicklungsbedarf künftig häufiger in spezialisierten Agenten oder Unternehmensumgebungen entsteht – ideal, um ihn mit eigens dafür vorgesehenen Code-Modellen und Workflows aufzufangen.
- Wiederverwendbare Klassifizierungsmethode: OpenAI ordnet Nachrichten mithilfe eines LLM-Klassifikators einem standardisierten Aufgabenkatalog zu. Dieser Ansatz lässt sich ebenso auf die Analyse der eigenen Produkt-Logs anwenden.
Auswirkungen auf die Unternehmens-AI-Einführung
Daten aus privaten Konten sind nicht repräsentativ für die Unternehmensnutzung. Eine weitere Auswertung von OpenAI – die „Enterprise Signals“ – zeigt: Bis Juni 2026 entfielen bei den analysierten Unternehmenskunden 64 % der von ChatGPT und Codex gemeinsam ausgegebenen Token auf Codex. Das deutet darauf hin, dass sich die Nutzungsstruktur auf Unternehmensseite deutlich von der privater Konten unterscheiden kann. Wer interne AI-Lösungen bewertet, sollte deshalb die eigenen Aufgabenprotokolle zugrunde legen und nicht einfach die persönlichen Signals-Daten übernehmen.
🚀 Schnellstart: Wenn Sie Ihre eigenen Geschäftsanfragen wie OpenAI mit dem Label „Arbeitsaktivität“ versehen möchten, können Sie mit APIYI apiyi.com schnell einen Prototyp bauen. Die Plattform bietet OpenAI-kompatible Schnittstellen, neue Nutzer erhalten ein kostenloses Testkontingent, und das folgende Beispiel läuft in wenigen Minuten.
Die Idee der „Arbeitsaktivitäts-Klassifizierung“ per API nachbauen
Hier ist ein minimalistisches Beispiel, das einen Nutzerwunsch mit einem großen Sprachmodell einer kleinen Auswahl von Arbeitsaktivitäts-Labels zuordnet. Das Prinzip entspricht dem Klassifizierer von OpenAI (die Labels sind vereinfacht und nicht das vollständige O*NET-System):
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI-kompatible Schnittstelle
)

labels = "Dokumente bearbeiten, Visuelles Design, Marketing, Spracherklärung, Unterrichtsmaterial, Programmierung, Entscheidungsanalyse, Sonstiges"
resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": f"Wähle aus [{labels}] ein Label, das diese Arbeitsanfrage beschreibt, und gib nur das Label aus: Schreib mir einen WeChat-Beitrag zur Produkteinführung eines neuen Produkts"}]
)
print(resp.choices[0].message.content)
Vollständigen Code für Batch-Klassifizierung und Anteilsstatistik anzeigen
import openai
from collections import Counter
from typing import List

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Ein Key, mehrere Modelle umschaltbar
)

LABELS = ["Dokumente bearbeiten", "Visuelles Design", "Marketing", "Spracherklärung",
          "Unterrichtsmaterial", "Programmierung", "Entscheidungsanalyse", "Nicht-Arbeit", "Sonstiges"]

SYSTEM = (
    "Du bist ein Klassifizierer für Arbeitsaktivitäten. Prüfe zuerst, ob die Anfrage arbeitsbezogen ist, "
    f"und wähle dann eines der folgenden Labels: {', '.join(LABELS)}. Gib nur das Label selbst aus."
)

def classify(text: str, model: str = "gpt-4o-mini") -> str:
    try:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "system", "content": SYSTEM},
                      {"role": "user", "content": text}],
            temperature=0,
            max_tokens=10,
        )
        label = r.choices[0].message.content.strip()
        return label if label in LABELS else "Sonstiges"
    except Exception as e:
        print(f"Fehler: {e}")
        return "Sonstiges"

def activity_share(messages: List[str]) -> dict:
    counts = Counter(classify(m) for m in messages)
    work = {k: v for k, v in counts.items() if k != "Nicht-Arbeit"}
    total = sum(work.values()) or 1
    return {k: round(v / total * 100, 1) for k, v in work.most_common()}

if __name__ == "__main__":
    logs = [
        "Bitte poliere diesen Quartalsbericht",
        "Gib mir Kompositionsvorschläge für eine Reihe von Event-Postern",
        "Warum kann dieser Python-Code die Daten nicht lesen",
        "Wo kann man am Wochenende gut campen",
    ]
    print(activity_share(logs))
Wie beim Ansatz von OpenAI kommt es auch bei dieser automatischen Klassifizierung zu Fehleinschätzungen, und eine Aufgabe kann sich auf mehrere Nachrichten verteilen. Die ermittelte „Nachrichtenverteilung“ lässt sich daher nicht direkt mit Arbeitsaufwand oder Geschäftswert gleichsetzen.
Modellauswahl nach Arbeitsaktivität – eine Orientierung
Für die Aktivitäten mit hohem Anteil in den Daten lässt sich eine erste Auswahl nach Aufgabentyp treffen. Die tatsächliche Leistung muss man jedoch immer an den eigenen Daten testen:
| Arbeitsaktivität | Schwerpunkt der Fähigkeiten | Auswahlansatz | Verfügbare Plattform |
|---|---|---|---|
| Schriftliche Materialien bearbeiten | Textverständnis und Umformulierung | Preis-Leistungs-starkes Allzweck-Chatmodell | APIYI apiyi.com, offizielle API |
| Visuelles Design und Präsentation | Bilderzeugung und Bildverständnis | Multimodal / Bildmodell | APIYI apiyi.com, offizielle API |
| Marketing- und Werbematerialien | Kreativität und Stilsteuerung | Flaggschiffmodell mit stabilem Schreibstil | APIYI apiyi.com, offizielle API |
| Programmierung und Fehlersuche | Code-Reasoning | Modell mit starken Code-Fähigkeiten oder spezialisierter Agent | APIYI apiyi.com, offizielle API |
| Entscheidungsfindung und Beratung | Reasoning über lange Kontexte | Reasoning-Modell mit manueller Prüfung | APIYI apiyi.com, offizielle API |
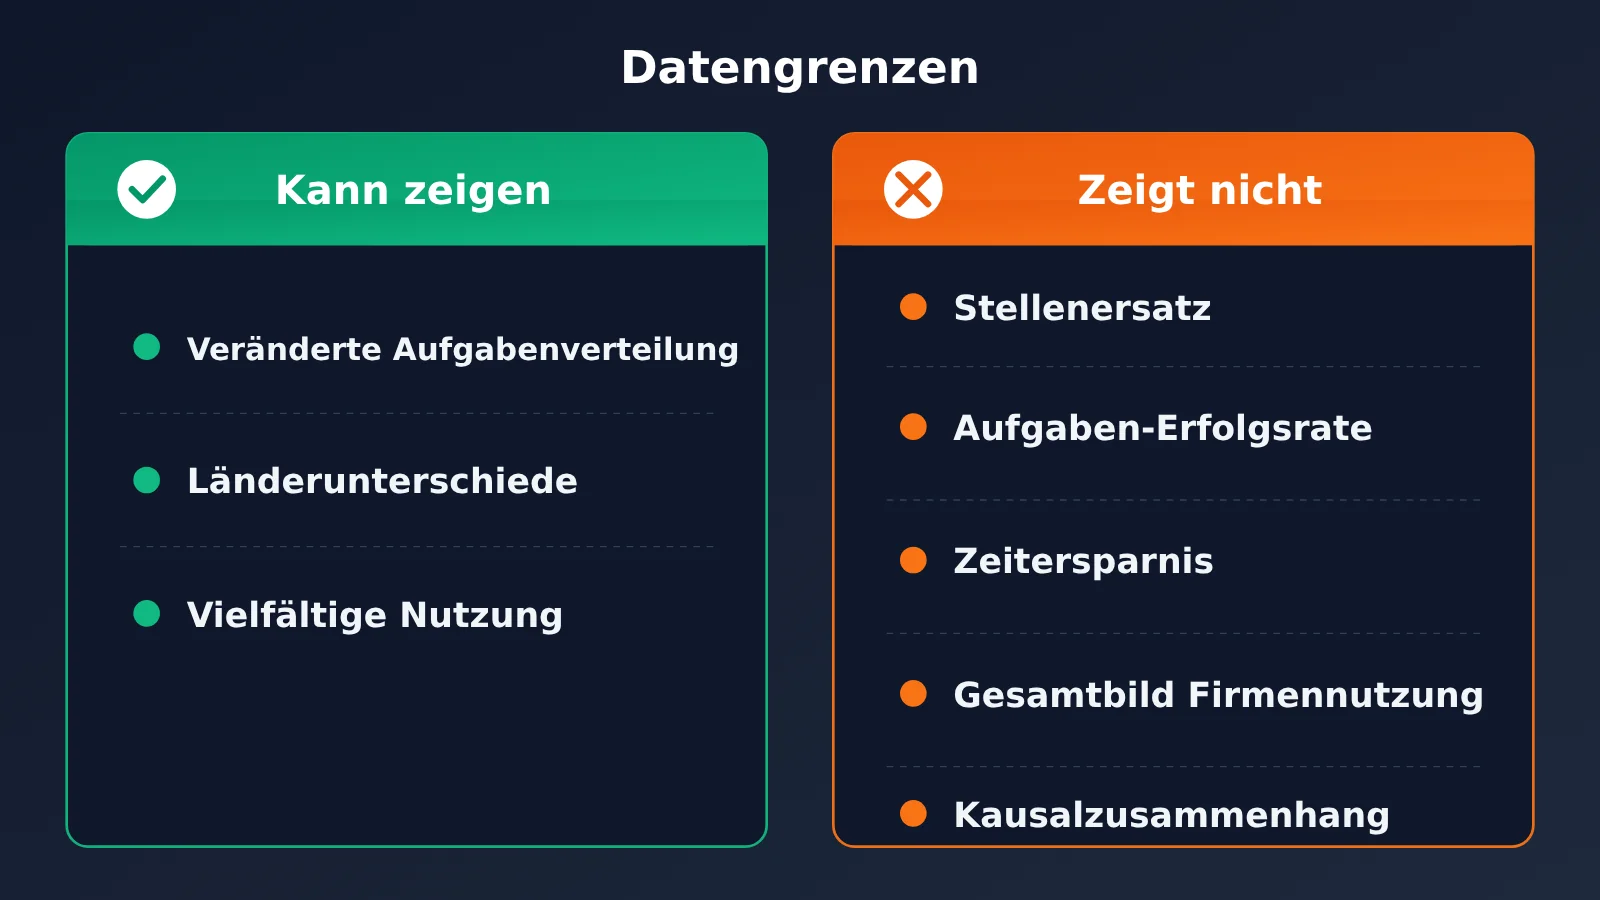
Die Grenzen der OpenAI-Daten zu 165 Arbeitsaktivitäten
Diese Daten sind wertvoll, aber ihre Grenzen sind ebenso klar. Die folgenden Punkte sollte man beim Zitieren besonders beachten:
- Die Stichprobe umfasst nur private Konten von Erwachsenen: Enterprise und Codex sind ausgeschlossen. Die Daten repräsentieren daher nicht die gesamte berufliche Nutzung von OpenAIs Unternehmensprodukten.
- Die Klassifizierung erfolgt automatisch: Ein LLM-Klassifikator kann Absichten falsch interpretieren. „Eine Kampagne für eine Veranstaltung entwerfen“ kann echte Marketingarbeit sein – oder ein privates Interesse.
- Nachrichtenanteile sind nicht gleichbedeutend mit Output: Sie sagen nichts über Aufgabenmenge, Arbeitszeit, Nutzerzahl, eingesparte Arbeitsstunden oder Erfolgsquote aus.
- Datenschutzrauschen und Mindeststichprobengrößen: Ergebnisse aus kleinen Stichproben werden ausgeblendet, zusätzlich wird differentielles Datenschutzrauschen eingefügt.
- Keine Eins-zu-eins-Entsprechung zur realen Wirtschaft: Gewichtet man nach der Zahl der Beschäftigten, fallen in den USA etwa 43 % der realen Arbeitsaktivitäten in die Kategorie „Other IWA“. Das heißt weder, dass KI 43 % der Arbeit nicht erledigen kann, noch, dass ChatGPT die restlichen 57 % bereits abdeckt.
Außerdem zeigt eine Berechnung von PPC Land: Der Anteil aller persönlichen Nachrichten, die als arbeitsbezogen eingestuft wurden, sank von etwa 51,6 % im Juli 2024 auf etwa 32,2 % im September 2026. Das dürfte eher daran liegen, dass viele Nutzer außerhalb der Arbeitswelt hinzugekommen sind und ein Teil der professionellen Arbeit auf Unternehmenskonten und spezialisierte Agenten ausgewichen ist. Daraus lässt sich nicht schließen, dass ChatGPT für den Arbeitsalltag unwichtiger geworden ist.
Häufig gestellte Fragen (FAQ)
F1: Was sind die von OpenAI veröffentlichten Daten zu den 165 Arten von Arbeitsaktivitäten?
Das ist ein aggregierter Datensatz, den das Programm OpenAI Signals v3.0 öffentlich bereitstellt. Er ordnet arbeitsbezogene Nachrichten privater ChatGPT-Nutzer den 165 mittleren Ebenen der Arbeitsaktivitäten von O*NET zu. Der Datensatz deckt fast 100 Länder und Regionen sowie sieben Quartale vom ersten Quartal 2025 bis zum dritten Quartal 2026 ab und lässt sich kostenlos als CSV herunterladen.
F2: Worin unterscheiden sich die 165 Arten von Arbeitsaktivitäten von den 165 Berufen?
Arbeitsaktivitäten beschreiben, *was* getan wird – Berufe beschreiben, *welche Position* jemand innehat. Dieselbe Aktivität (etwa das Bearbeiten von Dokumenten) kann in vielen Berufen auftauchen. Die Daten beschreiben also, für welche Arten von Arbeit ChatGPT eingesetzt wird, nicht die Nutzungsrate einzelner Berufe – und schon gar nicht lässt sich daraus ableiten, welche Berufe ersetzt werden.
F3: Wann wurden diese Daten veröffentlicht, und werden sie künftig aktualisiert?
OpenAI hat sie am 26. Oktober 2026 veröffentlicht, die Daten reichen bis zum dritten Quartal 2026. Offiziell werden die Veränderungen quartalsweise erfasst; ob es später weitere Aktualisierungen geben wird, richtet sich nach den Ankündigungen auf der Datenseite von OpenAI Signals. Dieser Artikel spekuliert nicht darüber.
F4: Der Anteil der Programmier-Nachrichten sinkt – heißt das, die Nachfrage nach KI-gestütztem Programmieren geht zurück?
So lässt sich das nicht schlussfolgern. Die Daten schließen Codex und Unternehmenskonten aus, während Enterprise Signals zeigt, dass auf Unternehmensseite der Anteil der von Codex ausgegebenen Token sehr hoch ist. Die Programmiernachfrage könnte sich auf spezialisierte Agenten verlagert haben oder mit einer veränderten Nutzerstruktur zusammenhängen – die Daten allein können das nicht auseinanderhalten.
F5: Wie lässt sich eine ähnliche Analyse der Arbeitsaktivitätsklassifizierung mit der API nachbauen?
Sie können den Beispielcode aus diesem Artikel verwenden, um Ihre eigenen Nutzeranfragen mit einem großen Sprachmodell zu labeln und anschließend die Anteile zu berechnen:
1. Besuchen Sie APIYI apiyi.com, registrieren Sie ein Konto und holen Sie sich einen API-Schlüssel
2. Nutzen Sie das kostenlose Testguthaben für neue Nutzer
3. Setzen Sie im Code `base_url` auf `https://api.apiyi.com/v1`, um verschiedene Modelle zu wechseln und ihre Klassifizierungsergebnisse zu vergleichen
F6: Gibt es eine einfache Möglichkeit, die Leistung verschiedener Modelle bei Design-, Text- und Programmieraufgaben zu vergleichen?
Am unkompliziertesten ist es, mehrere Modelle über eine einheitliche Schnittstelle aufzurufen, dieselbe Sammlung von Eingabeaufforderungen einmal durchlaufen zu lassen und die Ergebnisse anschließend manuell zu bewerten. Mit einem einzigen Schlüssel von APIYI apiyi.com lassen sich Modelle wie OpenAI, Claude und Gemini aufrufen, abgerechnet wird nach Verbrauch – ideal für solche kleinen Vergleichstests.
OpenAI-Daten zu 165 Arbeitsaktivitäten: Die wichtigsten Erkenntnisse
- Gegenstand der Statistik sind Aktivitäten, nicht Berufe: Die 165 Kategorien beziehen sich auf O*NET-Arbeitsaktivitäten, einschließlich einer zusammengefassten Kategorie „Sonstiges“.
- Die Nutzung wird breiter gestreut: Der durchschnittliche Anteil der Top-10-Aktivitäten in 74 Ländern sank von 56,0 % auf 51,1 %.
- Visuelles Design legt am stärksten zu: Berechnungen Dritter zufolge stieg der Anteil von 3,1 % auf 7,9 %.
- Der Programmieranteil sinkt, ist aber mit Vorsicht zu interpretieren: Die Stichprobe schließt Codex und Unternehmenskonten aus.
- Die Marketingnachfrage ist stabil: Der Anteil an Marketing- und Werbematerial liegt weitgehend konstant bei rund 5 %.
- Der Nachrichtenanteil ist nicht gleich Output: Daraus lassen sich keine Aussagen über Arbeitsplatzverdrängung, eingesparte Arbeitsstunden oder Erfolgsquoten ableiten.
- Die Klassifizierungsmethode ist wiederverwendbar: Mit den Multi-Modell-Schnittstellen von APIYI apiyi.com lässt sich schnell eine eigene Analyse zur Aufgabenklassifizierung aufbauen.
Zusammenfassung
Die Kernaussagen der ChatGPT-Nutzungsdaten von OpenAI zu 165 Arbeitsaktivitäten:
- Art der Daten: Ein frei zugänglicher, vierteljährlich erhobener Forschungsdatensatz, der erfasst, „welche Arbeitsaktivitäten in persönlichen Konten mit ChatGPT erledigt werden“.
- Zentrale Befunde: Die berufliche Nutzung wird breiter gestreut; visuelles Design, Beratung und kreatives Denken nehmen zu, während der Anteil allgemeiner Programmiernachrichten sinkt.
- Grenzen der Interpretation: Die Daten enthalten keine Unternehmenskonten und kein Codex; der Nachrichtenanteil ist nicht gleichzusetzen mit Arbeitsvolumen, Auswirkungen auf Stellen oder wirtschaftlichem Wert.
Was diese Daten wirklich zeigen, ist nicht, welche 165 Berufe bald verschwinden werden, sondern dass KI auf immer feinere und vielfältigere Weise in unterschiedliche Arbeitsabläufe eindringt – und das je nach Land und Aufgabentyp unterschiedlich. Für Entwickler ist es sinnvoller, statt der Frage „Wen wird KI ersetzen?“ genau hinzusehen, welche Aktivitäten Nutzer tatsächlich mit KI erledigen, und für diese Aktivitäten das richtige Modell und den passenden Workflow zu wählen.
Wir empfehlen, über APIYI apiyi.com schnell zu testen, wie sich verschiedene Modelle in deinem Geschäftsszenario schlagen – die Plattform bietet kostenloses Testguthaben und eine einheitliche Schnittstelle für mehrere Modelle.
📚 Referenzen
- OpenAI offizielle Ankündigung: ChatGPT’s expanding world of work: Die zentrale Quelle dieser Veröffentlichung
- Link:
openai.com/index/chatgpt-expanding-world-of-work -
Beschreibung: Offizielle Aussagen zu 165 Aktivitätstypen, fast 100 Ländern sowie den Werten von 56,0 % auf 51,1 %
-
OpenAI Signals Daten-Download und Methodik: Einstieg zu den Original-CSV-Dateien und zum Datenwörterbuch
- Link:
openai.com/signals/data-download -
Beschreibung: Hinweise zu Stichprobenumfang, Datenschutzbehandlung und CC-BY-4.0-Lizenzierung
-
PPC Land: Writing drops from 34% to 21% of ChatGPT requests since July 2024: Drittanbieter-Analyse der CSV-Daten
- Link:
ppc.land/writing-drops-from-34-to-21-of-chatgpt-requests-since-july-2024 -
Beschreibung: Konkretes Aktivitäts-Ranking, Veränderungen der Anteile bei visuellem Design und Programmierung
-
PPC Land: Americans use ChatGPT at work most to make decisions: Auswertung der interaktiven US-Diagramme
- Link:
ppc.land/americans-use-chatgpt-at-work-most-to-make-decisions-1-in-5-requests -
Beschreibung: Ländervergleichsdaten zu breit gefassten Arbeitsaktivitäten
-
O*NET offizielle Website: Systematik der Arbeitsaktivitäten und Berufsklassifikation
- Link:
onetcenter.org -
Beschreibung: Zum Verständnis der IWA-Definitionen und der 332 Referenzeinträge
-
OpenAI Enterprise Signals: Nutzungsdaten von Unternehmenskonten
- Link:
openai.com/signals/enterprise-data - Beschreibung: Dient der Abgrenzung zwischen Daten von Privatpersonen und Unternehmen
Autor: APIYI Technik-Team
Technischer Austausch: Kontaktieren Sie uns gern über die Startseite von APIYI. Weitere Integrationsmaterialien finden Sie im Dokumentationszentrum unter docs.apiyi.com




