Hinweis des Autors: Wenn Ihr Agent noch client.chat.completions.create mit tools nutzt, stoßen Sie nach dem Wechsel auf GPT-6.1 auf eine ganz konkrete Weggabelung: Reiner Text läuft weiter, aber für Tool-Aufrufe brauchen Sie einen anderen Endpunkt.
Warum Tool-Aufrufe nach dem Upgrade auf GPT-6.1 am Endpunkt scheitern
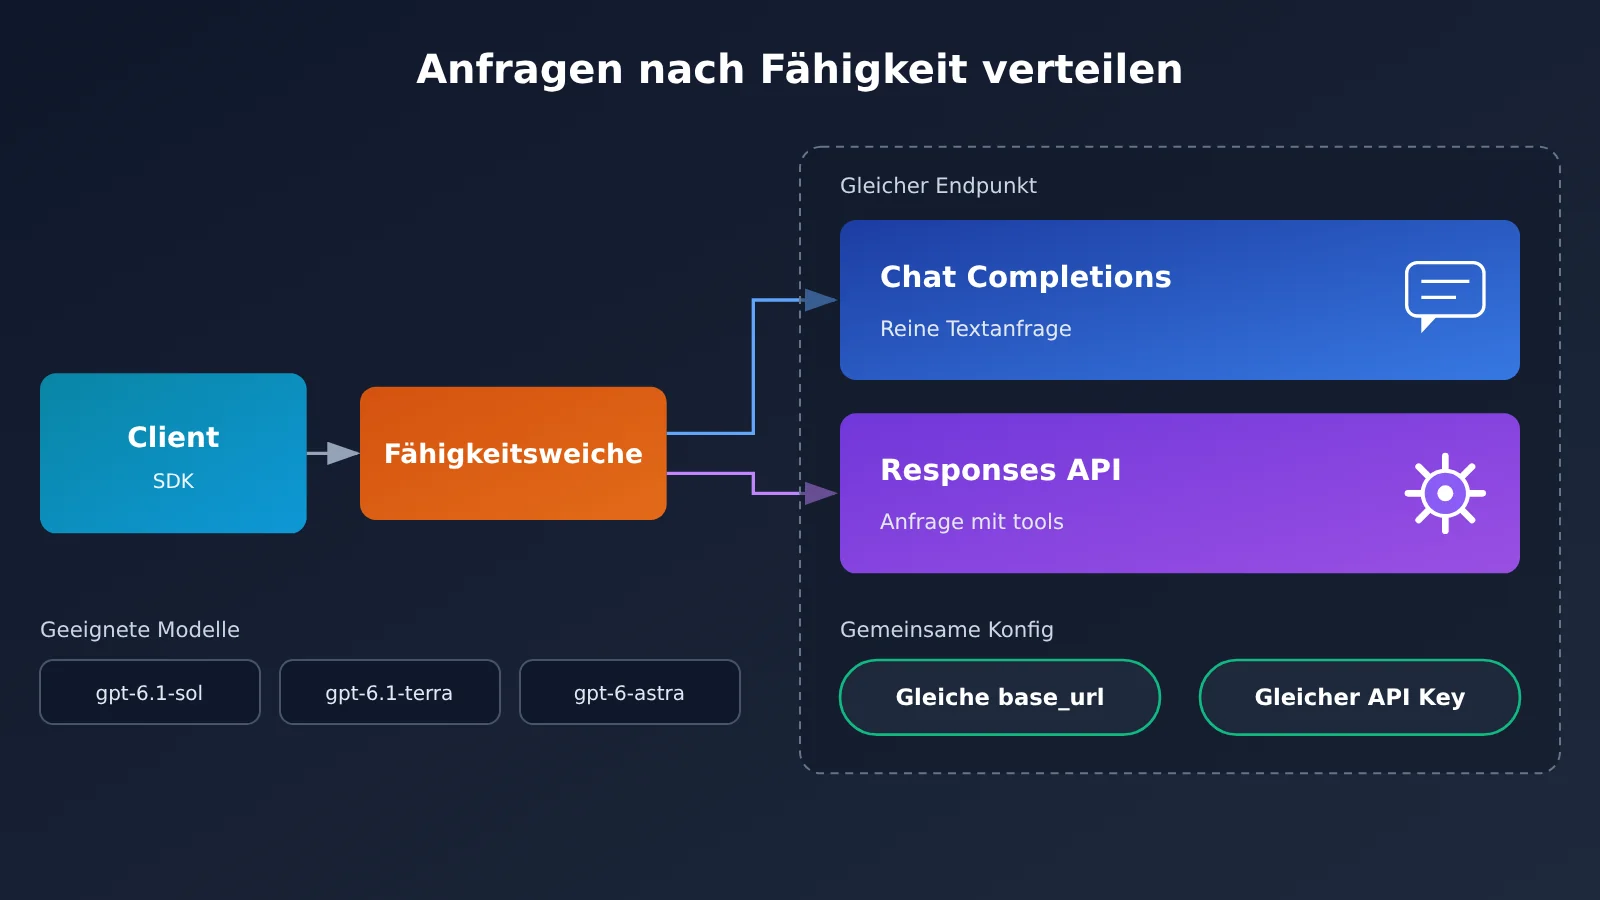
Vorab das Ergebnis: GPT-6 Astra, GPT-6.1 Sol und GPT-6.1 Terra unterstützen alle Chat Completions, aber Tool-Aufrufe laufen zwingend über die Responses API. Im selben Code kann reiner Dialog also weiter über Chat laufen. Sobald Sie aber Funktionen einbinden, Tool-Ergebnisse auslesen oder mehrstufige Tool-Schleifen bauen wollen, muss die Anfrage an den Responses-Endpunkt gehen.
Das ist kein Kompatibilitätsproblem, das sich mit einem anderen Parameter umgehen ließe. Eine andere Schreibweise für tools hilft nicht, und auch tool_choice ändert nichts: Chat Completions bietet für diese drei Modelle schlicht keine Tool-Aufrufe an. Ändern müssen Sie den Endpunkt selbst und die gesamte Request- und Response-Struktur drumherum. Wenn Sie beide Endpunkte zunächst mit Ihrem eigenen API-Schlüssel gegeneinander testen möchten, nutzen Sie den einheitlichen Zugang von APIYI (apiyi.com): Setzen Sie base_url auf https://api.apiyi.com/v1, dann genügt es, die Modell-ID auszutauschen.
Ein weiterer Stolperstein betrifft GPT-6 Sol und GPT-6 Luna. Beide können in Chat Completions Funktionsaufrufe ausführen, aber nur, wenn reasoning_effort auf none steht. Anders gesagt: Sie können Tools über Chat aufrufen, bezahlen dafür aber mit abgeschalteter Reasoning-Stärke. Wenn Sie das Reasoning behalten wollen, müssen Sie ebenfalls zu Responses wechseln. Dieses Detail wird oft übersehen. Das Ergebnis: Der Code läuft durch, aber die Qualität stimmt nicht.
Kernnutzen: Nach der Lektüre können Sie einschätzen, zu welcher Kategorie Ihre Tool-Aufruf-Kette gehört. Und Sie können die Anfragen vom Chat-Endpunkt auf den Responses-Endpunkt verlagern, ohne Ihre Gesamtarchitektur umzuwerfen.
Die wichtigsten Punkte zum Tool-Calling bei GPT-6.1
Die folgende Tabelle zeigt, welcher Endpunkt zu welchem der drei Modelle (plus zwei älteren Varianten) gehört. Am besten ordnen Sie Ihr Modell zuerst hier ein und gehen danach die Migrationsschritte durch.
| Modell | Chat Completions: reiner Text | Chat Completions: Tool-Calling | Endpunkt für Tool-Calling |
|---|---|---|---|
| gpt-6.1-sol | Unterstützt | Nicht unterstützt | Responses |
| gpt-6.1-terra | Unterstützt | Nicht unterstützt | Responses |
| gpt-6-astra | Unterstützt | Nicht unterstützt | Responses |
| gpt-6-sol | Unterstützt | Nur unterstützt, wenn reasoning_effort auf none steht |
Responses (wenn das Reasoning erhalten bleiben soll) |
| gpt-6-luna | Unterstützt | Nur unterstützt, wenn reasoning_effort auf none steht |
Responses (wenn das Reasoning erhalten bleiben soll) |
Aufgabenteilung bei den Endpunkten: Chat für Text, Responses für Tools
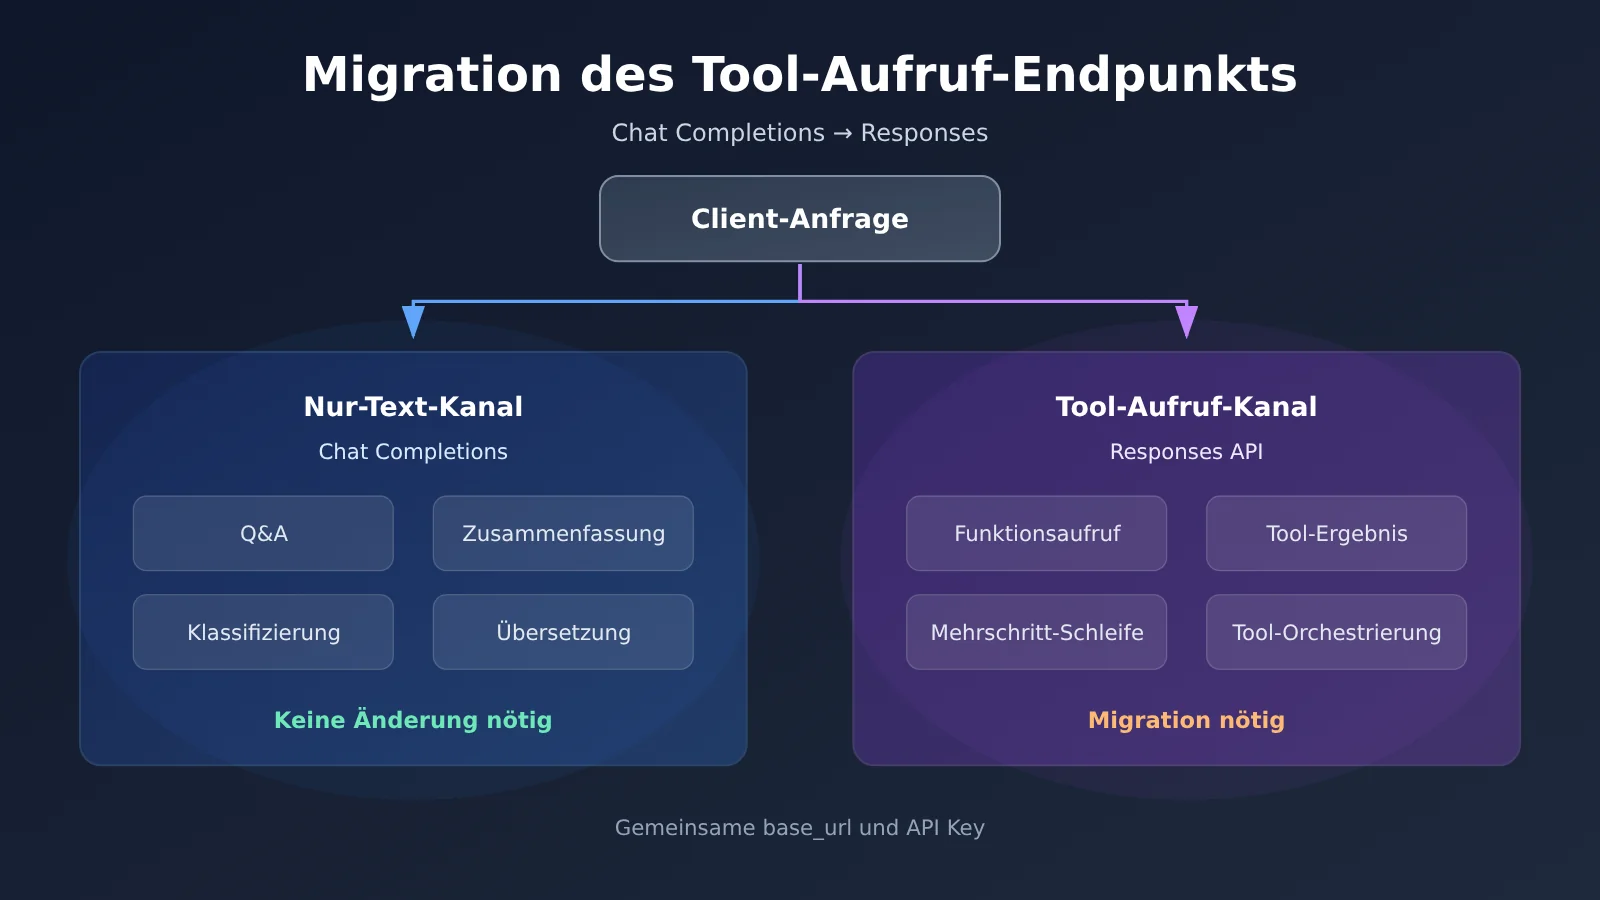
Die Tabelle lässt sich in einem Satz zusammenfassen: Bei der GPT-6-Serie ist Chat Completions zu einem reinen Textkanal geworden, während der Tool-Kanal separat in die Responses-API ausgelagert wurde. Für bestehende Projekte bedeutet das je nach Einsatzzweck unterschiedlich viel Aufwand. Dienste, die nur Fragen beantworten, zusammenfassen oder klassifizieren, müssen kaum angepasst werden. Wer dagegen Agenten, Funktionsaufrufe oder mehrstufige Tool-Orchestrierung betreibt, kommt um die Migration nicht herum.
Wenn Ihr Team bereits eine eigene SDK-Schicht gebaut hat, ist der Umstieg zum Glück kleiner als gedacht. Die Modell-ID bleibt gleich, die Authentifizierung ebenfalls, und auch die base_url ändert sich nicht. Anpassen müssen Sie vor allem die Struktur des Request-Bodys und die Art, wie Tool-Ergebnisse zurückgegeben werden. Der eigentliche Aufwand liegt also nicht im „Modellwechsel“, sondern in der veränderten Art des Aufrufs.
So wählen Sie unter den drei Hauptmodellen aus
GPT-6.1 Sol und GPT-6.1 Terra sind das Hauptduo dieser Generation. Sie unterscheiden sich vor allem in Positionierung und Kosten. GPT-6 Astra war das Flaggschiff der vorherigen Generation und unterstützt weiterhin reinen Text über Chat sowie Tool-Calling über Responses. Es passt zu Projekten, die bereits stabil laufen und nicht grundlegend umgebaut werden sollen. Schauen Sie bei der Auswahl zuerst darauf, wie häufig Sie Tools aufrufen, dann auf die Kontextlänge pro Anfrage und erst zuletzt auf den Einzelpreis. Tool-Calling bringt meist mehrere Hin-und-her-Runden mit sich, wodurch sich der Token-Verbrauch vervielfacht.
Konkrete Preise finden Sie in der Preistabelle weiter unten. Alternativ können Sie die aktuell gültige Abrechnung direkt in der Dokumentation von APIYI (apiyi.com) prüfen, damit Sie Ihr Budget nicht mit veralteten Preisen kalkulieren.
GPT-6.1 Tool Calling: Diese 5 Stellen müssen Sie ändern
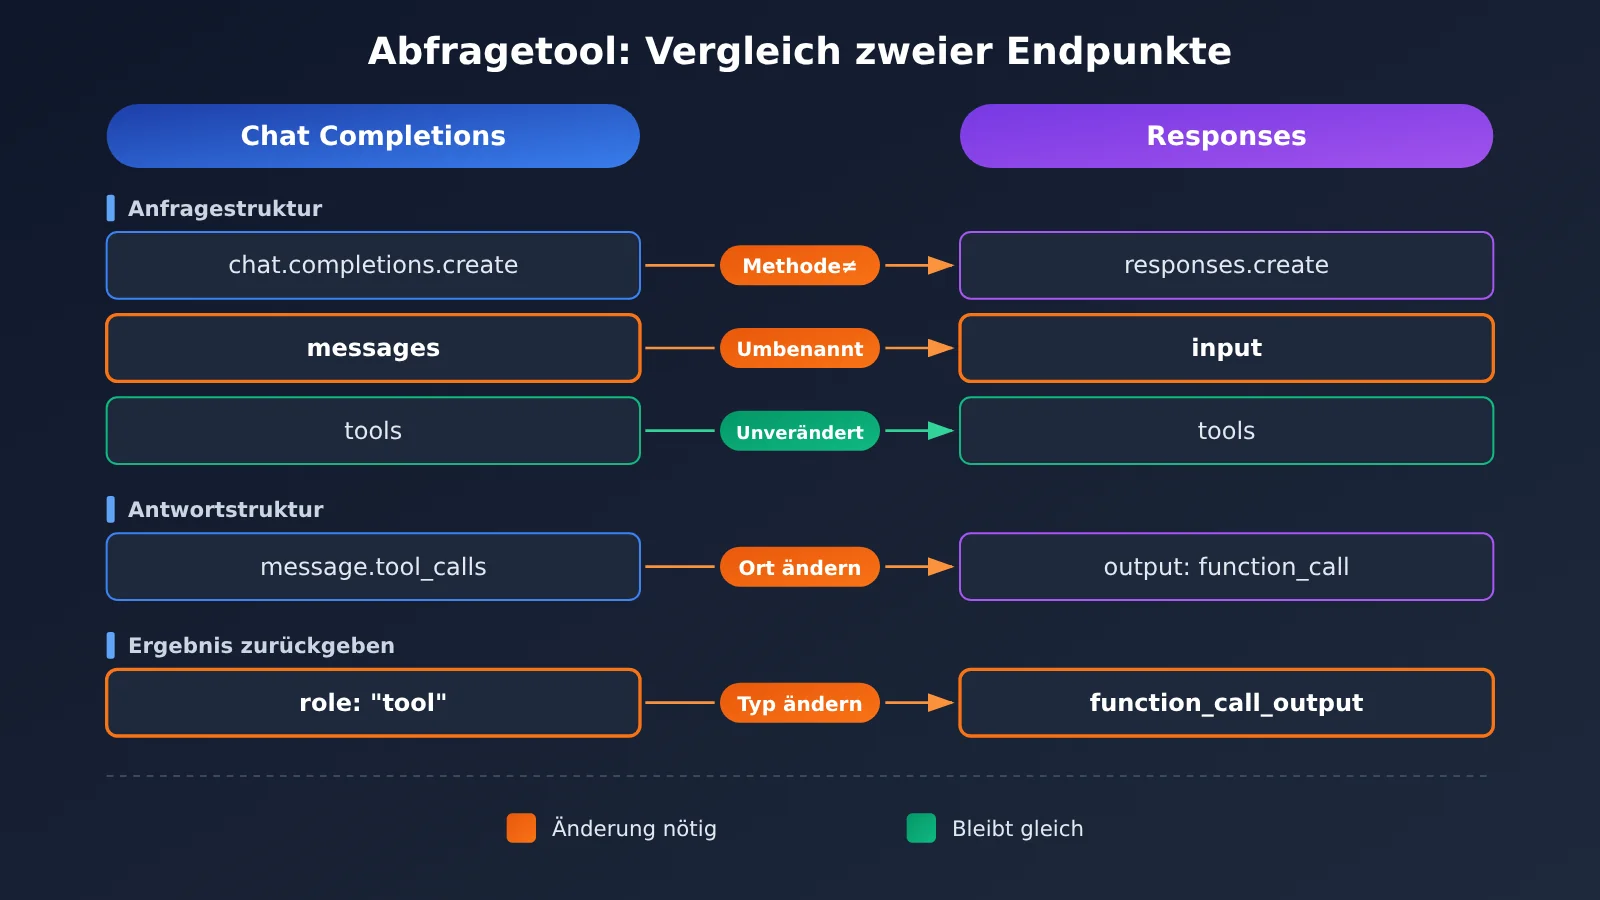
Dieser Abschnitt ist der praktischste im ganzen Artikel. Wenn Sie die folgenden 5 Stellen anpassen, lässt sich eine typische Tool-Calling-Schleife vom Chat-Endpunkt auf den Responses-Endpunkt umstellen.
| Nr. | Änderung | Chat-Completions-Schreibweise | Responses-Schreibweise |
|---|---|---|---|
| 1 | Aufrufmethode | client.chat.completions.create |
client.responses.create |
| 2 | Eingabeträger | messages-Array |
input-Parameter |
| 3 | Tool-Deklaration | tools (bleibt) |
tools (Struktur im Wesentlichen identisch) |
| 4 | Rückgabe der Tool-Ergebnisse | Nachricht mit role: "tool" |
Eintrag vom Typ function_call_output |
| 5 | Mehrrundiger Kontext | messages manuell vollständig zusammensetzen |
Verkettung per previous_response_id möglich |
Punkt 1 und 2 werden am leichtesten übersehen. Viele denken, die Migration sei fertig, sobald die tools-Struktur angepasst ist, und stellen dann fest, dass sich die SDK-Methode gar nicht geändert hat und die Anfrage weiterhin an chat.completions geht. Der Endpunkt hängt an der Methode: Solange Sie die Methode nicht ändern, ändert sich auch der Endpunkt nicht.
Punkt 4 ist die Stelle, an der die Migration am häufigsten hängen bleibt. Bei Chat schieben Sie das Ergebnis der Tool-Ausführung als Nachricht mit role: "tool" zurück in messages. Bei Responses geben Sie dagegen die vom Modell zurückgelieferten Aufrufeinträge unverändert mit und ergänzen einen function_call_output-Eintrag. Fehlt ein Eintrag oder stimmt die Reihenfolge um eine Position nicht, kann es passieren, dass das Modell denselben Aufruf erneut auslöst.
Punkt 5 gehört in die Kategorie „muss nicht sein, ist aber empfehlenswert“. Responses unterstützt previous_response_id, um an die vorherige Runde anzuknüpfen. So sparen Sie sich, bei jedem Aufruf den gesamten bisherigen Verlauf erneut zu senden. Bei Agenten mit vielen Tool-Runden wirkt sich das spürbar stärker auf die Kosten aus als ein Modellwechsel.
🎯 Technischer Tipp: Am einfachsten validieren Sie die Migration, indem Sie alte und neue Pipeline parallel mit denselben Anfragen laufen lassen und die Trefferquote der Tools sowie die Rückgabestruktur vergleichen. Über die einheitliche Schnittstelle von APIYI (apiyi.com) sparen Sie sich die Verwaltung mehrerer Plattform-Schlüssel – einmal konfiguriert, können Sie die tatsächlichen Unterschiede zwischen Responses und Chat direkt gegenüberstellen.
GPT-6.1 Tool-Calling: Schnellstart
Ein minimales Beispiel mit Tool-Aufruf
Angenommen, Sie haben eine Funktion zum Abfragen des Bestellstatus, die als Tool eingebunden werden soll. Sie heißt get_order_status und erhält die Bestellnummer als Parameter. Anpassen müssen Sie nur zwei Stellen: den Aufruf selbst und die Rückgabe des Ergebnisses.
- Die Client-Initialisierung bleibt, wie sie ist. Für
api_keyverwenden Sie Ihren eigenen Schlüssel,base_urlsetzen Sie aufhttps://api.apiyi.com/v1. So lassen sich alle Modelle hinter der OpenAI-kompatiblen Schnittstelle direkt aufrufen. - Als Modell-ID tragen Sie
gpt-6.1-solein (odergpt-6.1-terra,gpt-6-astra). Alle drei nutzen für Tool-Aufrufe die Responses-Schnittstelle. - Ersetzen Sie das bisherige
client.chat.completions.create(...)durchclient.responses.create(...)und den Parametermessagesdurchinput. toolsübergeben Sie wie gehabt. Tool-Beschreibung und Parameter-Schema müssen nicht neu geschrieben werden.- Suchen Sie in der zurückgegebenen
outputden Eintrag vom Typfunction_call, lesen Sie Tool-Name und Argumente aus und führen Sie Ihre Funktion zur Bestellabfrage lokal aus. - Hängen Sie das Ergebnis als
function_call_outputwieder an und senden Sie eine zweite Anfrage, um die endgültige Antwort zu erhalten.
Von diesen 6 Schritten sind nur Schritt 3 und Schritt 6 wirklich „Pflicht“. Schritt 1 und 2 sind reine Konfiguration, und in Schritt 4 und 5 lesen Sie die gewohnten Daten aus der Chat-Zeit nur an einer anderen Stelle aus.
🚀 Schnellstart: Wenn Sie keine eigene Testumgebung aufsetzen möchten, holen Sie sich auf APIYI (apiyi.com) ein kostenloses Testkontingent und spielen das Beispiel zur Bestellabfrage einmal durch. Erst danach passen Sie Ihren Produktivcode an – so ist das Risiko am geringsten.
Noch bequemer wird es, wenn Sie die Tool-Schicht von der Modellschicht entkoppeln: Die Tool-Definitionen liegen an einer zentralen Stelle, und der Aufruf ist in einer einzigen Funktion gekapselt. Diese entscheidet intern: „Reiner Text geht über Chat, Anfragen mit Tools über Responses.“ Die Migration findet dann nur in der Kapselungsschicht statt, und am Business-Code ändern Sie keine einzige Zeile.
GPT-6.1 Modellpreise und Auswahlhilfe (12.11.2026)
Die folgende Tabelle gibt die ab dem 12.11.2026 gültigen Preise wieder, jeweils in US-Dollar pro 1 Mio. Tokens.
| Modell | Eingabe | Ausgabe | Cache-Lesen | Empfohlener Endpunkt |
|---|---|---|---|---|
| gpt-6.1-sol | $2 | $10 | $0.1 | responses |
| gpt-6.1-terra | $1 | $5 | $0.05 | responses |
| gpt-6-luna | $0.1 | $0.5 | $0.01 | chat (reasoning_effort auf none) oder responses |
Aus der Tabelle lässt sich ein ziemlich praktisches Fazit ziehen: GPT-6.1 Terra kostet bei Ein- und Ausgabe genau die Hälfte von Sol. Bei Szenarien mit vielen Tool-Runden und einem hohen Anteil wiederholter Kontexte ist Terra deshalb oft die bessere Standardwahl. GPT-6 Luna ist sogar um eine Größenordnung günstiger und eignet sich für leichte Aufgaben wie Klassifikation und Extraktion. Sol oder Terra heben Sie sich dann für die Tool-Orchestrierung auf, die wirklich Reasoning braucht.
Die Spalte „Cache-Lesen“ verdient einen eigenen Blick. Tool-Aufrufe erzeugen ganz automatisch viele wiederholte Präfixe – Systemprompt, Tool-Definitionen, bisheriger Gesprächsverlauf. Wird dieser Teil aus dem Cache bedient, kostet er nur etwa ein Zwanzigstel des normalen Eingabepreises. Wer in der Responses-API den Kontext über previous_response_id fortführt, spart daher nicht nur Datenverkehr, sondern auch echtes Geld.
💰 Kostentipp: Wenn Sie Budgets nach Projekten aufteilen müssen, können Sie über den einheitlichen Schlüssel von APIYI (apiyi.com) die Nutzung mehrerer Modelle an einer Stelle erfassen. In Kombination mit der nutzungsbasierten Abrechnung lassen sich die tatsächlichen Kosten von Tool-Aufrufen leichter nachvollziehen.
FAQ zu Tool-Aufrufen mit GPT-6.1
Q1: Was ist GPT-6.1 und wie steht es zu GPT-6?
GPT-6.1 ist eine Weiterentwicklung der GPT-6-Reihe und umfasst derzeit zwei Modelle: GPT-6.1 Sol und GPT-6.1 Terra. Zur GPT-6-Reihe gehören GPT-6 Astra, GPT-6 Sol und GPT-6 Luna. Alle nutzen denselben Responses-Kanal für Tool-Aufrufe und unterscheiden sich vor allem in Leistungsprofil und Preis.
Q2: Warum funktionieren Tool-Aufrufe über Chat Completions nicht? Habe ich einen Parameter falsch gesetzt?
Nein, an den Parametern liegt es nicht. GPT-6 Astra, GPT-6.1 Sol und GPT-6.1 Terra bieten über Chat Completions nur reine Textfunktionen, Tool-Aufrufe sind auf die Responses API beschränkt. Änderungen an `tools` oder `tool_choice` bringen nichts. Stattdessen müssen Sie im SDK die Methode `chat.completions.create` durch `responses.create` ersetzen.
Q3: Können GPT-6 Sol und GPT-6 Luna in Chat Function Calling nutzen?
Ja, aber nur, wenn `reasoning_effort` auf `none` gesetzt ist. Wenn Sie die Reasoning-Stärke beibehalten möchten, müssen auch diese beiden Modelle über Responses laufen. Diese Einschränkung übersieht man bei der Migration leicht: Es gibt keine Fehlermeldung, die Ergebnisse weichen nur von Ihren Erwartungen ab.
Q4: Muss ich bei der Migration zu Responses die Modell-ID ändern?
Nein. Die Modell-IDs bleiben `gpt-6.1-sol`, `gpt-6.1-terra` und `gpt-6-astra`, auch `base_url` und Authentifizierung ändern sich nicht. Anpassen müssen Sie nur die Aufrufmethode, den Eingabe-Container und die Struktur, mit der Tool-Ergebnisse zurückgegeben werden.
Q5: Wie prüfe ich schnell, ob die Tool-Aufrufe nach der Migration korrekt funktionieren?
Wir empfehlen einen Smoke-Test mit einem einfachen Tool, etwa einer Bestellabfrage. Prüfen Sie zuerst, ob die Anfrage tatsächlich am Responses-Endpunkt ankommt. Dann kontrollieren Sie, ob die zurückgegebene `output` einen `function_call`-Eintrag enthält. Zum Schluss schauen Sie, ob das Modell nach der Rückgabe von `function_call_output` eine finale Antwort liefert. Wenn alle drei Schritte klappen, ist die Kette in Ordnung. Einen Test-Schlüssel für diese Prüfung erhalten Sie bei APIYI unter apiyi.com.
Q6: Muss ich auch reine Textdienste auf Responses umstellen?
Nicht unbedingt. Die reinen Textfunktionen von Chat Completions bleiben für alle drei Hauptmodelle verfügbar. Dienste, die nur Fragen beantworten, zusammenfassen oder übersetzen, können unverändert bleiben. Nur Anfragen mit `tools` müssen umziehen. Deshalb betrifft die Änderung die einzelnen Dienste unterschiedlich stark.
Q7: Wie halte ich bei mehrstufigen Tool-Aufrufen die Kontextkosten im Griff?
Nutzen Sie am besten `previous_response_id`, um an die vorherige Runde anzuknüpfen, statt in jeder Runde den kompletten Verlauf neu zu senden. So lässt sich der wiederholte Präfix leichter aus dem Cache bedienen, und der Preis für Cache-Lesezugriffe liegt deutlich unter dem Eingabepreis. Bei `gpt-6.1-sol` kosten Eingabe-Token $2, Cache-Treffer nur $0,1. Der Unterschied ist erheblich.
Q8: Gibt es bekannte Stolperfallen bei der Migration zu Responses?
Zwei Fehler treten besonders häufig auf: Erstens wird nur die `tools`-Struktur angepasst, nicht aber die Aufrufmethode, sodass die Anfrage weiterhin am Chat-Endpunkt landet. Zweitens wird beim Zurückgeben der Tool-Ergebnisse die alte Schreibweise mit `role: „tool“` beibehalten. Das Modell bekommt dann keine Ausgabe zu sehen und startet den Aufruf immer wieder neu. Wenn in Ihrem Team außerdem Modelle wie GPT-6 Sol gemischt zum Einsatz kommen, die `reasoning_effort` auf `none` verlangen, lohnt sich eine einheitliche Vorgabe in der Wrapper-Schicht. So vermeiden Sie, dass dasselbe Tool bei manchen Modellen funktioniert und bei anderen nicht.
GPT-6.1 Tool-Calling: Die wichtigsten Punkte (Key Takeaways)
- Getrennte Endpunkte: Bei GPT-6.1 Sol, Terra und GPT-6 Astra läuft Text über Chat, Tools müssen dagegen über Responses laufen.
- Eine Ausnahme: GPT-6 Sol und GPT-6 Luna können Funktionsaufrufe auch über Chat ausführen, verlangen dafür aber
reasoning_effortaufnone. - Fünf Änderungen: Aufrufmethode,
inputals Träger,tools-Deklaration, Rückgabe perfunction_call_outputund Verkettung überprevious_response_id. - Modell-ID bleibt gleich:
base_urlund Schlüssel ändern sich nicht, die Migration betrifft nur die Wrapper-Schicht. - Kosten im Blick (Cache): Bei Tool-Aufrufen wiederholt sich das Präfix oft, und der Preis für gecachte Lesezugriffe liegt bei etwa einem Zwanzigstel des Eingabepreises.
- Validierung in drei Schritten: Endpunkt prüfen, sicherstellen, dass
outputeinenfunction_callenthält, und kontrollieren, dass nach der Rückgabe die finale Antwort ankommt. - Einstieg: Nutzen Sie das kostenlose Kontingent von APIYI (apiyi.com), um zuerst ein kleines Tool zur Bestellabfrage zum Laufen zu bringen, und stellen Sie danach Ihre Produktivstrecke um.
Zusammenfassung
Der Kern der Änderung passt in einen Satz: GPT-6.1 verlagert Tool-Aufrufe von Chat Completions zu Responses, während reine Textfähigkeiten dort bleiben, wo sie sind. Daraus ergeben sich drei Dinge, die Sie sich merken sollten:
- Erst klassifizieren, dann migrieren: Dienste, die nur Text verarbeiten, müssen Sie nicht anfassen. Anfragen mit
toolsmüssen dagegen auf den neuen Endpunkt umziehen. - Die Methode ändern, nicht die Parameter: Der eigentliche Endpunkt-Schalter ist
client.responses.create. Dietools-Struktur ist nur das Zubehör dazu. - Die Rückgabe der Ergebnisse ist die größte Fehlerquelle:
function_call_outputersetztrole: "tool", und dabei müssen Reihenfolge und Vollständigkeit stimmen.
Wenn Ihr Projekt Tool-Aufrufe bereits produktiv nutzt, sollten Sie zunächst ein einzelnes minimales Tool im Rahmen eines schrittweisen Rollouts umstellen. Erst wenn die Kette durchgängig funktioniert, schalten Sie vollständig um. Wenn Sie sich den Aufwand für mehrere Plattform-Schlüssel und Umgebungskonfigurationen sparen möchten, können Sie über APIYI (apiyi.com) mit demselben Schlüssel die tatsächlichen Antworten von Responses und Chat direkt vergleichen. Setzen Sie dafür base_url einheitlich auf https://api.apiyi.com/v1.
Referenzen
- Offizielle OpenAI-Modelldokumentation: Beschreibung der Endpunkt-Fähigkeiten der GPT-6- und GPT-6.1-Serie, einschließlich der Einschränkung, dass Tool-Aufrufe über Responses laufen müssen
- Link:
developers.openai.com/api/docs/guides/latest-model -
Hinweis: Die maßgebliche Quelle, um zu klären, ob ein Modell Funktionsaufrufe in Chat Completions unterstützt
-
APIYI-Dokumentation zu Modellen und Preisen: Preise für Eingabe, Ausgabe und Cache-Lesezugriffe sowie empfohlene Endpunkte je Modell
- Link:
docs.apiyi.com/models - Hinweis: Zum Abgleich der ab dem 12.11.2026 geltenden Abrechnung und der Endpunktempfehlungen
Autor: APIYI-Technikteam
Fachaustausch: Sie erreichen uns gerne über die Startseite von APIYI (apiyi.com). Weitere Informationen zu den Schnittstellen finden Sie im Dokumentationscenter unter docs.apiyi.com