Anmerkung des Autors: „Schnell“ lässt sich bei Gemini 4 Neon auf mindestens drei Arten messen. Dieser Artikel trennt die Zeit bis zum ersten Token, die Ausgabemenge pro Sekunde und die Zeit pro abgeschlossener Aufgabe und gibt zu jeder Zahl die Quelle an.
Gemini 4 Neon wurde am 2026-11-18 veröffentlicht. In Sundar Pichais Ankündigungsbeitrag heißt es, das Modell erledige Aufgaben in komplexer Softwareentwicklung, Wissensarbeit und wissenschaftlichen Abläufen schneller. Viele haben diesen Satz als „durchweg am schnellsten“ gelesen. Tatsächlich gibt es mindestens drei Messmethoden, und deren Rangfolgen stimmen nicht überein.
Alle Geschwindigkeitszahlen in diesem Artikel stammen von der Modellseite und den Artikeln von Artificial Analysis; die Benchmark-Ergebnisse stammen aus offiziellen Selbstauskünften und den Modellkarten. Keine einzige Zahl haben wir selbst gemessen. Zahlen aus unterschiedlichen Quellen und mit unterschiedlichen Messmethoden werden nebeneinandergestellt – nicht gemittelt und nicht zu neuen Werten zusammengerechnet.
Der Kernnutzen: Nach dem Lesen dieses Artikels kannst du unterscheiden, wie hoch die Zeit bis zum ersten Token, die Ausgabemenge pro Sekunde und die Zeit pro Aufgabe bei Gemini 4 Neon jeweils sind. Du weißt außerdem, wie sich die vier Denkstufen auf Geschwindigkeit und Punktzahl auswirken und welchen Kennwert du bei der Modellauswahl heranziehen solltest.
Die Kernpunkte zur Geschwindigkeit von Gemini 4 Neon
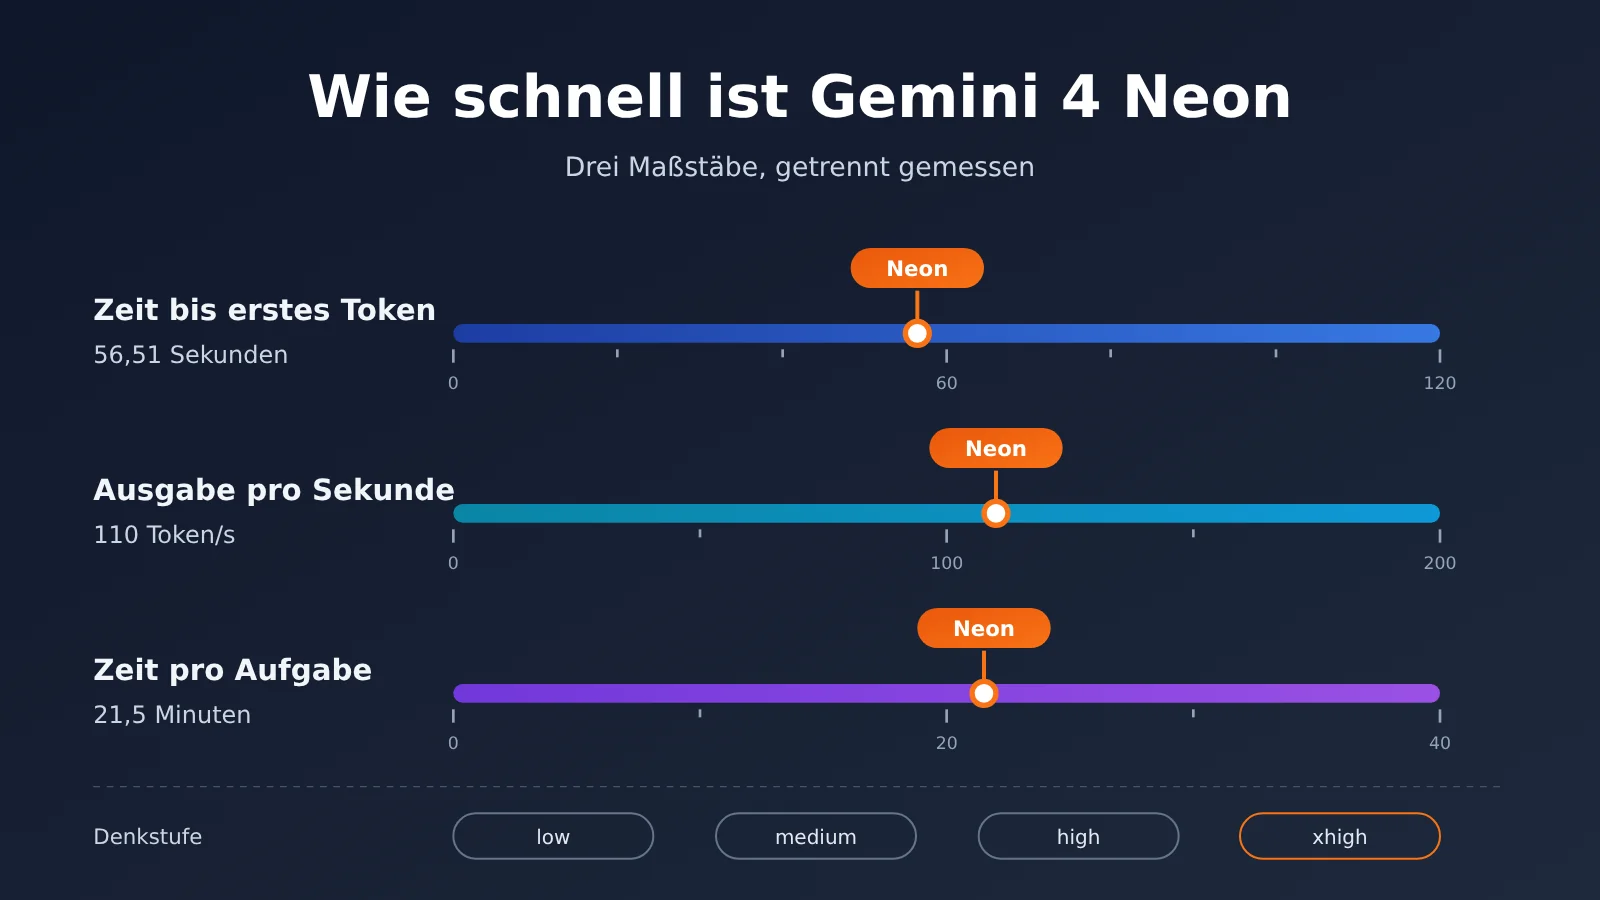
Zuerst trennen wir die drei Kennzahlen, die leicht miteinander verwechselt werden. Die Werte für Neon in der folgenden Tabelle beziehen sich alle auf die Stufe xhigh und stammen von der Modellseite von Artificial Analysis (abgerufen am 2026-11-19, Index v5.0.1).
| Kennzahl | Bedeutung | Wert für Gemini 4 Neon xhigh | Nutzererfahrung |
|---|---|---|---|
| Zeit bis zum ersten Token | Wartezeit von der Anfrage bis zum ersten Antwort-Token | 56,51 Sekunden | Wie lange es bei der Interaktion dauert, bis die Ausgabe beginnt |
| Ausgabe pro Sekunde | Wie viele Token nach Beginn der Ausgabe pro Sekunde generiert werden | 110 Token/Sekunde | Wie schnell die Streaming-Ausgabe läuft |
| Zeit pro Aufgabe | Durchschnittliche Dauer für die Bearbeitung einer Aufgabe im Index | 21,5 Minuten | Wie lange es dauert, bis eine Aufgabe abgeschlossen ist |
| Ausgabemenge beim Index-Durchlauf | Wie viele Token beim vollständigen Durchlauf des Index insgesamt ausgegeben werden | 283 Millionen Token | Der zweite Faktor, der die Zeit pro Aufgabe bestimmt |
Warum die drei Geschwindigkeitskennzahlen von Gemini 4 Neon getrennt betrachtet werden sollten
Die Zeit bis zum ersten Token wirkt sich am stärksten auf Chat-Interaktionen aus. Reasoning-Modelle müssen erst einen Reasoning-Schritt abschließen, bevor sie das erste Antwort-Token ausgeben. Daher liegt die Zeit bis zum ersten Token oft im Sekunden- oder sogar Minutenbereich und hängt stark von der Reasoning-Stufe ab.
Die Ausgabe pro Sekunde misst nur den Durchsatz nach Beginn der Ausgabe; sie hängt nicht davon ab, wie viel das Modell insgesamt ausgeben will. Die Zeit pro Aufgabe wird von zwei Dingen gleichzeitig beeinflusst: davon, wie viele Token pro Sekunde ausgegeben werden, und davon, wie viele Token für diese Aufgabe insgesamt nötig sind. Ein Modell kann eine hohe Ausgaberate pro Sekunde haben und trotzdem für eine Aufgabe langsamer sein, wenn es dazu neigt, sehr lange Reasoning-Prozesse zu schreiben. Genau dieser Fall zeigt sich im späteren Vergleich von Neon mit GPT-6.2 Sol und GPT-6.2 Astra.
Gemini 4 Neon: Kernfunktionen, Familienpositionierung und vier Denkstufen
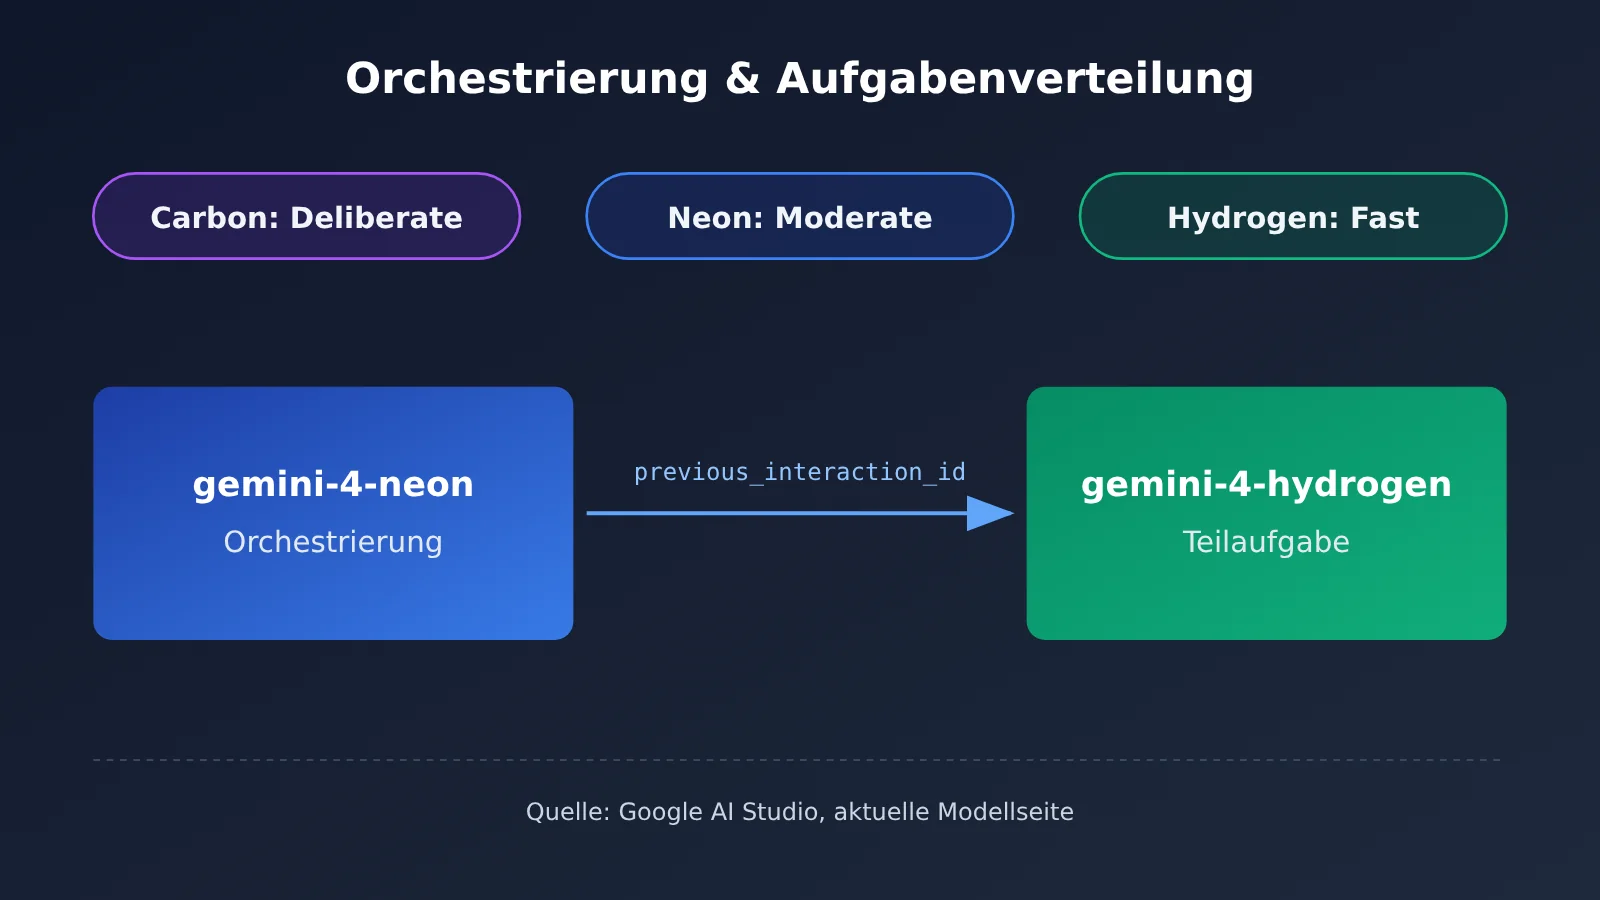
Die neueste Modelübersicht in Google AI Studio vergibt den drei Gemini-4-Modellen qualitative Geschwindigkeitslabels: Carbon ist Deliberate, Neon ist Moderate, Hydrogen ist Fast. Das heißt: In der eigenen Einordnung von Google liegt Neon in der Mitte der Familie, während Hydrogen das Modell ist, das als Fast gekennzeichnet ist. Der Google-Blog positioniert Carbon ebenfalls als das Modell für die schwierigsten langlaufenden Aufgaben, Hydrogen für die schnelle Ausführung im Alltag und Neon als Kompromiss für hochfrequente, komplexe Abläufe.
| Modell | Geschwindigkeitscharakterisierung in AI Studio | Denkstufe | Standardstufe | Familienpositionierung (Google-Blog / Entwicklerhandbuch) |
|---|---|---|---|---|
| Gemini 4 Carbon | Deliberate | low, medium, high | medium | Komplexe langlaufende Aufgaben |
| Gemini 4 Neon | Moderate | low, medium, high, xhigh | high | Kompromiss, hochfrequente komplexe Abläufe |
| Gemini 4 Hydrogen | Fast | In den Materialien nicht ausgeführt | In den Materialien nicht ausgeführt | Schneller Alltagszyklus |
Fähigkeiten und Spezifikationen von Gemini 4 Neon
Laut Modellkarte ist Gemini 4 Neon aus Gemini 4 Carbon abgeleitet, der Wissensstand reicht bis März 2026, die Eingabe unterstützt Text, Bilder, Audio und Video, und das einheitliche Kontextfenster fasst bis zu 1 Million Token. Die standardmäßige synchrone Ausgabe umfasst bis zu 64.000 Token, die lange Decodierung im Hintergrund bis zu 1 Million Token. Die Model-ID im Google-Cloud-Entwicklerhandbuch lautet gemini-4-neon, das einheitliche Limit liegt bei 1048576 Token, einschließlich Eingabe und Ausgabe; die Ausgabe wiederum enthält Denkprozess, Funktionsaufrufe und die endgültige Antwort.
Was die Fähigkeiten betrifft, liegt der offiziell selbst gemeldete Artificial Analysis Intelligence Index in der xhigh-Stufe bei 61, im Gesamtvergleich Platz 3; der Blog räumt außerdem ein, dass es hinter größeren, langsameren Modellen zurückliegt. Die Vergleichstabelle in der Modellkarte hat nur drei Spalten – Neon, Claude Opus 5.5 und GPT-6.2 Sol –, wobei die Ergebnisse für Nicht-Gemini-Modelle standardmäßig aus den Selbstauskünften der jeweiligen Anbieter stammen. Diese Tabelle ist daher eine offizielle Zusammenstellung und kein am selben Tag vom selben Labor erneut durchgeführter Test. In der Tabelle gibt es auch Bereiche, in denen Neon zurückliegt, zum Beispiel bei Terminal-bench 4.1: Die betrugsbereinigte Genauigkeit von Opus 5.5 liegt bei 65,8 % und damit über den 65,2 % von Neon.
Das Entwicklerhandbuch beschreibt außerdem ein Orchestrierungsmuster: gemini-4-neon übernimmt die Steuerung und übergibt previous_interaction_id an gemini-4-hydrogen, damit dieses schnellere Teilaufgaben ausführt. Wenn Sie Neon nicht schnell genug finden, ist dieser Weg erwägenswerter, als einfach die Denkstufe herunterzudrehen (das ist unsere Einschätzung, nicht der Wortlaut des Handbuchs).
Gemini 4 Neon Geschwindigkeitsdaten: Die vier Denkstufen im Detail
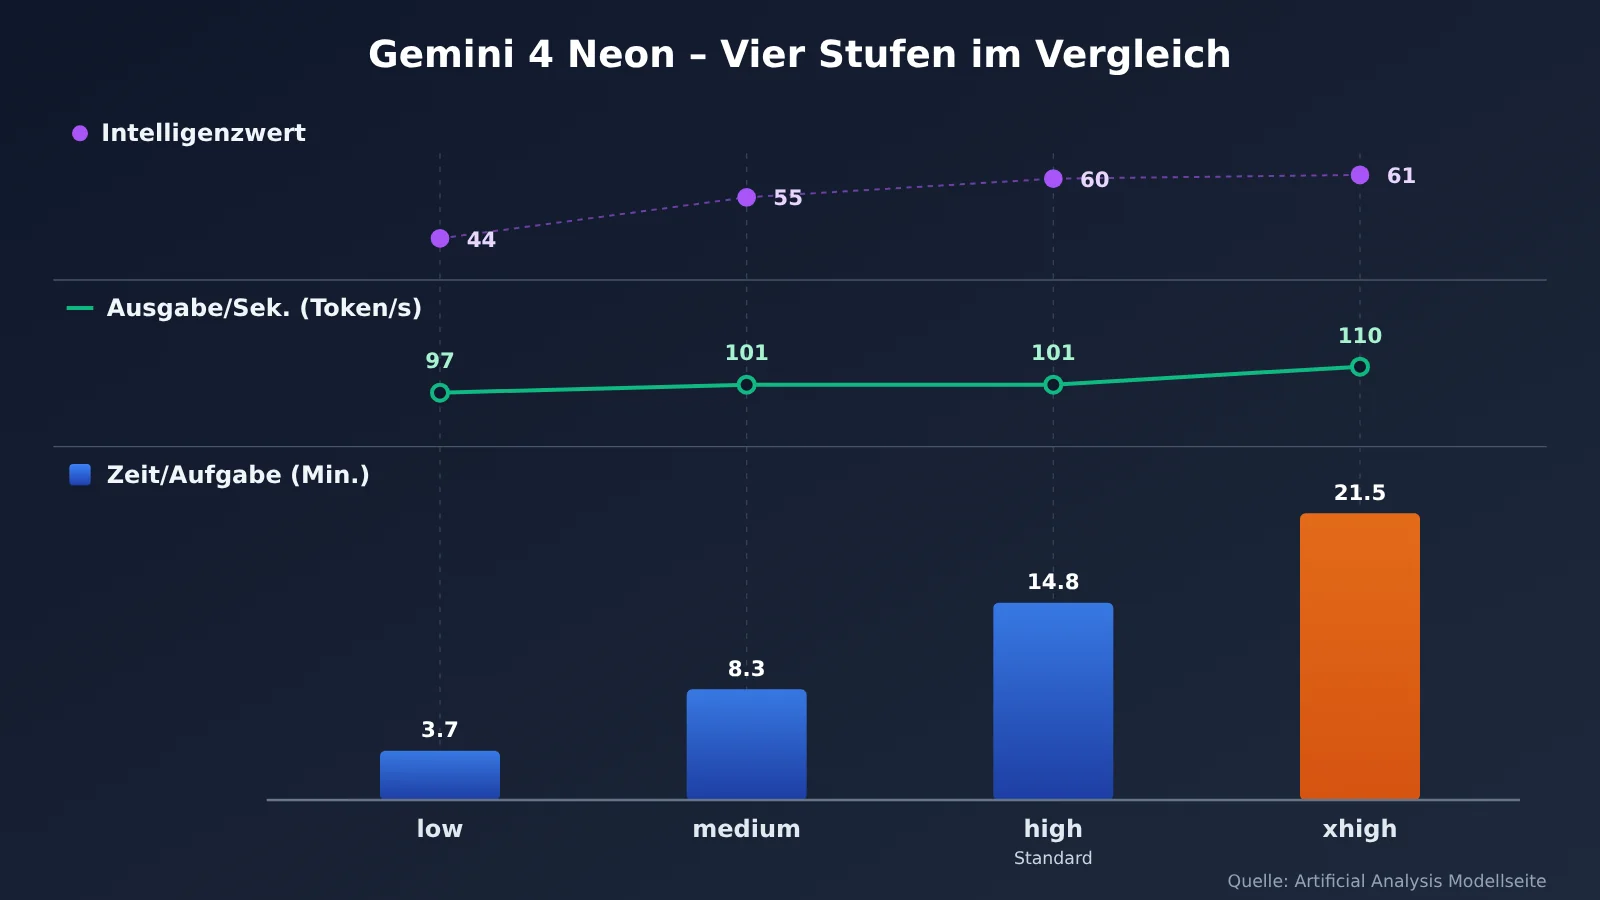
Die folgende Tabelle stammt von der Modellseite von Artificial Analysis. Die Spalte ganz rechts mit der Zeit bis zum ersten Token muss gesondert erläutert werden: Die Übersichtstabelle auf der Seite gibt nur für xhigh 56,51 Sekunden an. Die Werte für high, medium und low stammen aus dem FAQ-Bereich derselben Seite und stehen nicht in derselben Spalte wie die Übersichtstabelle. Bitte geben Sie diese Quelle bei Zitaten an.
| Denkstufe | Intelligenzwert | Zeit pro Aufgabe | Ausgabe pro Sekunde | Zeit bis zum ersten Token (FAQ-Bereich der Modellseite) |
|---|---|---|---|---|
| xhigh | 61 | 21,5 Minuten | 110 Token/s | 56,51 Sekunden |
| high (Standard) | 60 | 14,8 Minuten | 101 Token/s | 40,64 Sekunden |
| medium | 55 | 8,3 Minuten | 101 Token/s | 20,14 Sekunden |
| low | 44 | 3,7 Minuten | 97 Token/s | 13,93 Sekunden |
Aus dieser Tabelle geht hervor, dass die Ausgabe pro Sekunde über die vier Stufen nur zwischen 97 und 110 Token/s schwankt, während die Zeit pro Aufgabe von 3,7 Minuten auf 21,5 Minuten steigt. Die Wahl der Stufe ändert vor allem, „wie viel nachgedacht“ wird; auf „wie schnell pro Sekunde geschrieben wird“ hat sie kaum Einfluss. Das ist eine Schlussfolgerung aus den Zahlen in der Tabelle; die Modellseite selbst formuliert es nicht so.
Der Punktverlust ist ebenfalls deutlich. Von der Standardeinstellung high mit 60 Punkten auf medium verliert man nur 5 Punkte; auf low fällt man auf 44 Punkte. xhigh bringt 1 Punkt mehr als high, kostet aber fast 7 Minuten zusätzliche Zeit pro Aufgabe. Ob sich das lohnt, hängt von Ihrer Aufgabe ab.
Gemini 4 Neon ist pro Sekunde schneller – warum eine Aufgabe trotzdem länger dauern kann
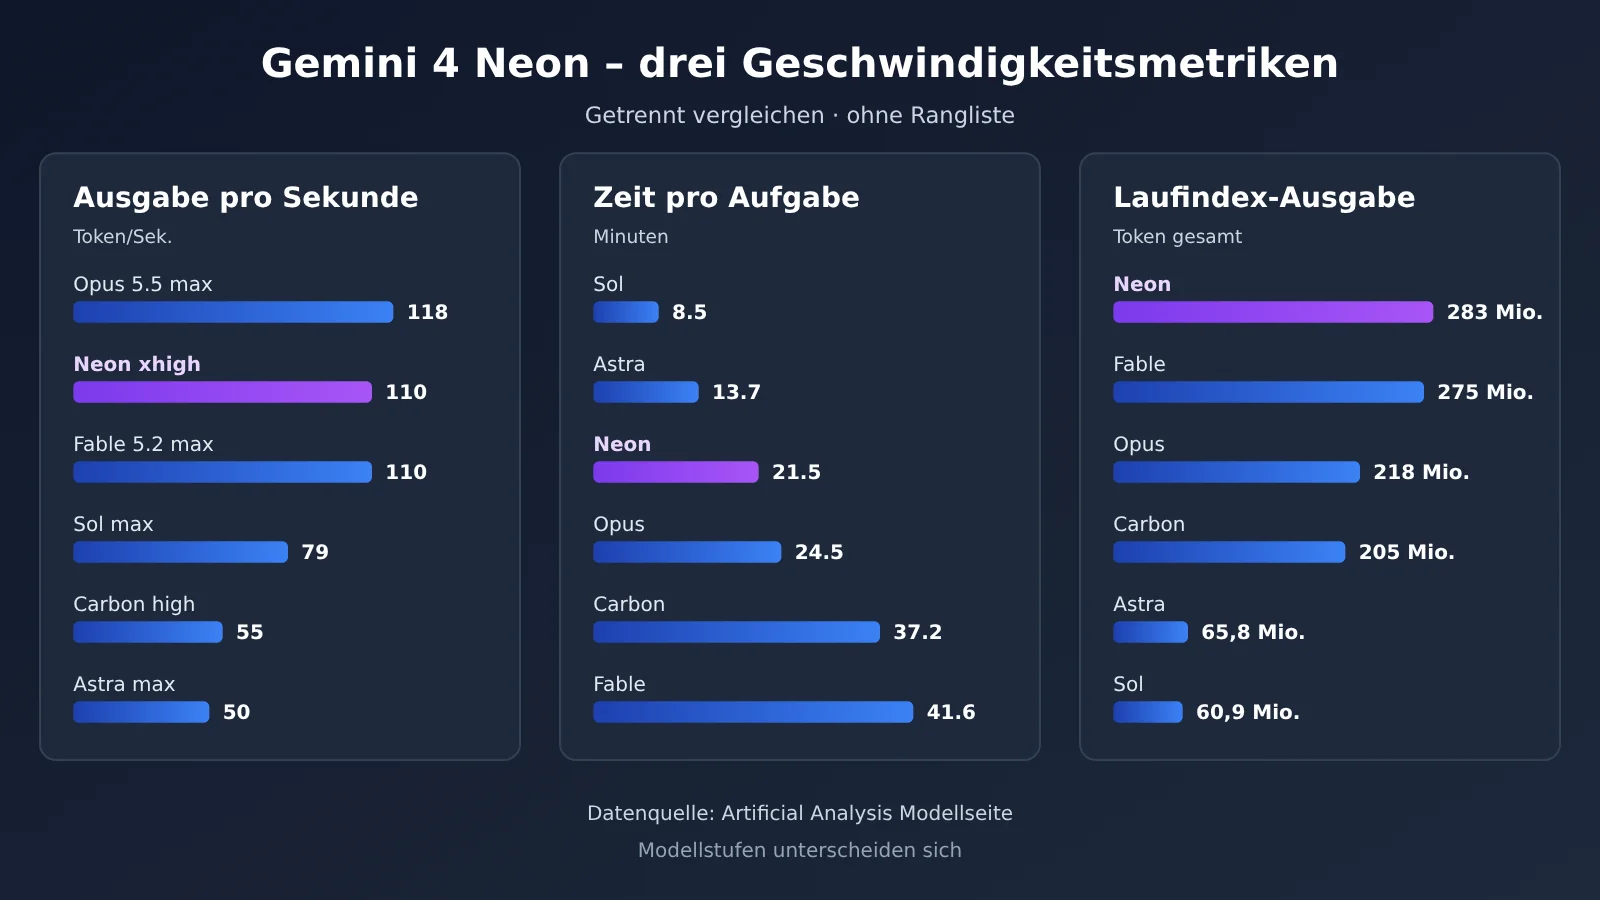
Auf der Modellseite von Artificial Analysis ist festgehalten, dass Neon xhigh beim Durchlauf des kompletten Index insgesamt 283 Millionen Token ausgibt und 8,12 Milliarden Token eingibt. Je mehr Ausgabe-Token anfallen, desto länger wird die Gesamtdauer – selbst bei 110 Token pro Sekunde. GPT-6.2 Astra kommt in der max-Stufe nur auf 50 Token pro Sekunde, gibt beim Indexlauf aber lediglich 65,8 Millionen Token aus; eine einzelne Aufgabe dauert damit 13,7 Minuten. GPT-6.2 Sol schafft in der max-Stufe 79 Token pro Sekunde, gibt 60,9 Millionen Token aus und braucht pro Aufgabe 8,5 Minuten.
„Mehr Ausgabe-Token pro Sekunde“ und „eine Aufgabe früher abschließen“ sind also zwei verschiedene Dinge. Vergleicht man Neon mit diesen beiden GPT-Modellen, fällt auf: Neon liefert pro Sekunde mehr Ausgabe, braucht für eine einzelne Aufgabe aber trotzdem länger – der Grund ist einfach, dass Neon deutlich mehr Token produziert.
Gemini 4 Neon: getrennter Vergleich mit den Referenzmodellen
Alle Zahlen in der folgenden Tabelle stammen von den Modellseiten von Artificial Analysis. Die Modelle laufen in unterschiedlichen Stufen (Neon mit xhigh, Carbon mit high, die übrigen mit max). Man kann daraus nur die relativen Verhältnisse innerhalb einer Spalte ablesen, es ist kein Vergleich unter identischen Bedingungen.
| Modell (Stufe) | Intelligenz-Score | Zeit pro Aufgabe | Output pro Sekunde | Zeit bis zum ersten Token | Output-Token beim Index-Lauf |
|---|---|---|---|---|---|
| Gemini 4 Neon (xhigh) | 61 | 21.5 Minuten | 110 | 56.51 Sekunden | 283 Mio. |
| Gemini 4 Carbon (high) | 60 | 37.2 Minuten | 55 | 73.04 Sekunden | 205 Mio. |
| Claude Opus 5.5 (max) | 59 | 24.5 Minuten | 118 | 335.85 Sekunden | 218 Mio. |
| Claude Fable 5.2 (max) | 65 | 41.6 Minuten | 110 | 247.46 Sekunden | 275 Mio. |
| GPT-6.2 Astra (max) | 62 | 13.7 Minuten | 50 | 197.65 Sekunden | 65.8 Mio. |
| GPT-6.2 Sol (max) | 57 | 8.5 Minuten | 79 | 75.06 Sekunden | 60.9 Mio. |
Schauen wir uns die drei Kennzahlen einzeln an:
- Output pro Sekunde: Claude Opus 5.5 max liegt mit 118 Token/s über den 110 von Neon xhigh; Claude Fable 5.2 max erreicht mit 110 denselben Wert wie Neon.
- Zeit pro Aufgabe: GPT-6.2 Sol max mit 8.5 Minuten und GPT-6.2 Astra max mit 13.7 Minuten sind beide schneller als Neon xhigh mit 21.5 Minuten.
- Zeit bis zum ersten Token: Die 56.51 Sekunden von Neon xhigh sind der kleinste Wert in dieser Tabelle, aber weil die Zeilen auf unterschiedlichen Stufen laufen, lässt sich daraus kein umfassender Vorsprung ableiten.
Für den Geschwindigkeitsgewinn von Neon gegenüber Carbon gibt es zwei unterschiedliche Rechnungen. Die Modellseiten von Artificial Analysis nennen für Carbon high 55 Token/s und 37.2 Minuten. Der Artikel von Artificial Analysis nennt Näherungswerte: Neon braucht pro Aufgabe etwa 21 Minuten, rund 40 % weniger als die etwa 36 Minuten von Carbon; der Gewinn kommt von der Ausgabegeschwindigkeit von etwa 110 gegenüber etwa 57 Token/s, während Neon pro Aufgabe zugleich etwa 15 % mehr Output-Token erzeugt. Die beiden Carbon-Zahlenreihen beruhen auf unterschiedlichen Erhebungsgrundlagen und werden hier deshalb nicht voneinander abgezogen.
Schnellstart: Gemini 4 Neon – Stufenauswahl und Geschwindigkeitsmessung
gemini-4-neon lässt sich derzeit nur über die offiziellen Google-Kanäle aufrufen. Die folgenden Schritte bestehen aus zwei Teilen: Zuerst erkläre ich, wie man die Neon-Stufen wählt, danach richten wir einen Geschwindigkeitstest mit den bei APIYI bereits verfügbaren Gemini-4-Modellen ein. Sobald Neon verfügbar ist, muss nur noch die Modell-ID geändert werden.
Schritt 1: Die vier Denkstufen von Neon verstehen. Im Google-Cloud-Entwicklerleitfaden steht, dass gemini-4-neon nur die Denkstufen low, medium, high und xhigh kennt; Standard ist high. Übergibt man thinking_budget oder MINIMAL, wird HTTP 400 zurückgegeben. Genau hier stolpern Codebasen, die von älteren Gemini-Versionen migriert wurden, am häufigsten.
Schritt 2: Je nach Geschwindigkeitsbedarf eine Stufe herunterschalten. Wenn es zu langsam ist, kann man von der Standardstufe high auf medium oder low wechseln. Laut der Modellseite von Artificial Analysis sinkt die Zeit pro Aufgabe von 14,8 Minuten bei high auf 8,3 Minuten bzw. 3,7 Minuten; der Intelligenzscore fällt von 61 bei xhigh (Standard high: 60) auf 55 oder 44. Der Punktverlust bei low ist groß; bevor man herunterschaltet, sollte man am besten eine Stichprobe mit den eigenen Aufgaben machen und das Ergebnis prüfen.
Schritt 3: APIYI-Konto und API-Schlüssel vorbereiten. Registrieren Sie sich bei APIYI unter apiyi.com und holen Sie sich einen API-Schlüssel. Legen Sie den Schlüssel in eine Umgebungsvariable (zum Beispiel APIYI_API_KEY) und lesen Sie ihn im Code ausschließlich aus der Umgebungsvariable – schreiben Sie ihn nicht im Klartext hinein.
Schritt 4: Aufrufart wählen. Beim OpenAI-kompatiblen Interface tragen Sie als base_url https://api.apiyi.com/v1 ein und als Modellnamen gemini-4-carbon oder gemini-4-hydrogen, sofern verfügbar. Wenn Sie das native Gemini-Protokoll nutzen, verwenden Sie die Adresse https://api.apiyi.com mit API-Version v1beta.
Schritt 5: Drei Kennzahlen getrennt erfassen. Aktivieren Sie die Streaming-Ausgabe über stream, und notieren Sie separat die Zeit bis zum Eintreffen des ersten Antwort-Tokens, die Token pro Sekunde nach Ausgabebeginn und die Gesamtdauer bis zum Abschluss der Aufgabe. Erfassen Sie außerdem die Gesamtzahl der Token in dieser Ausgabe. Erst mit der Anzahl der Ausgabe-Token lässt sich beurteilen, ob die lange Dauer daran liegt, dass langsam geschrieben wird, oder daran, dass viel geschrieben wird.
🚀 Empfehlung für den Schnellstart: Am besten lässt man den Geschwindigkeitstest zuerst mit einem bereits verfügbaren Gemini-4-Modell durchlaufen. APIYI deckt mit einem einzigen API-Schlüssel gleichzeitig die Gemini-, Claude- und GPT-Serien ab. Das Skript zur Erfassung der drei Kennzahlen schreibt man einmal und kann damit mehrere Modelle direkt vergleichen. Sobald Neon verfügbar ist, muss nur noch die Modell-ID geändert werden.
Gemini 4 Neon: Preis und Modellabgleich bei APIYI
Der offizielle Listenpreis von Gemini 4 Neon (Preisseite von Google AI Studio) liegt bei 3 US-Dollar pro Million Eingabe-Token und 15 US-Dollar pro Million Ausgabe-Token.
Bei APIYI haben wir zwei Quellen geprüft: die APIYI-Übersichtstabelle (docs.apiyi.com/models.md, Seitenstand laut Angabe 2026-11-16 09:39, UTC+8) sowie die am 2026-11-19 abgefragte Preis-Schnittstelle (api.apiyi.com/api/pricing, Version shell-api-modelmak-v1, insgesamt 285 Modelle). Die in beiden Quellen vergleichbaren, bereits verfügbaren Modelle stehen unten – Angaben in US-Dollar pro Million Token.
| Modell-ID | Eingabe | Cache-Lesen | Ausgabe | Endpunkt | Hinweis (Quelle) |
|---|---|---|---|---|---|
gemini-4-carbon |
2 | 0.1 | 10 | chat, gemini | entspricht Googles Einführungspreis bis 2026-11-30 (APIYI-Übersichtstabelle) |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | chat, gemini | APIYI-Übersichtstabelle |
claude-opus-5-5 / claude-opus-5-5-thinking |
4 | 0.2 | 20 | chat, messages | APIYI-Übersichtstabelle |
claude-fable-5-2 / claude-fable-5-2-thinking |
8 | 0.2 | 40 | chat, messages | APIYI-Übersichtstabelle |
gpt-6.2-sol |
2 (über 272000: 3) | 0.1 | 10 (Preis-Schnittstelle, höhere Stufe ca. 11.25) | responses (empfohlen), chat | Übersichtstabelle nennt nur die Eingabe-Staffel |
gpt-6.2-astra |
8 (über 272000: 16) | 0.4 | 40 (Preis-Schnittstelle, höhere Stufe ca. 60) | responses, chat | Übersichtstabelle nennt nur die Eingabe-Staffel |
Ein paar Details sollte man im Blick behalten. Der Listenpreis von gemini-4-carbon entspricht Googles Einführungspreis und nicht dem späteren Standardpreis von 4/20. Auch die Gruppennamen sind in beiden Quellen nicht ganz einheitlich geschrieben: Gemini-Modelle heißen in der Übersichtstabelle Default, SVIP, in der Preis-Schnittstelle dagegen default, svip; Claude-Modelle heißen in der Übersichtstabelle ClaudeCode, Claude_Reverse, Claude_Enterprise, Default, SVIP, in der Preis-Schnittstelle ClaudeCode, ClaudeCodeReverse, ClaudeOfficial, default, svip. Der höhere Ausgabepreis der GPT-Modelle zeigt sich nur in der Preis-Schnittstelle; dort wechselt die CompletionRatio bei mehr als 272000 Token von 5 auf 3,75.
gemini-4-neon ist weder in der APIYI-Übersichtstabelle noch in der Preis-Schnittstelle erfasst und derzeit nicht verfügbar. Wir werden dieses Modell so schnell wie möglich aufnehmen; maßgeblich sind die Modellliste und die Preise auf der Plattform.
Gemini 4 Neon: Vor- und Nachteile im Überblick
Stärken
- Höherer Durchsatz pro Sekunde als frühere Modelle der Familie: Die Modellseite von Artificial Analysis zeigt für Neon xhigh 110 Token/Sekunde, für Carbon high 55 Token/Sekunde.
- Relativ kurze Wartezeit bis zum ersten Token: Bei xhigh liegt sie bei 56,51 Sekunden und damit im obigen Vergleich am niedrigsten (unterschiedliche Stufen, nur als Anhaltspunkt).
- Feine Abstufung der Stufen: Vier Denkstufen, von 3,7 Minuten bei low bis 21,5 Minuten bei xhigh – je nach Aufgabe lässt sich die passende wählen.
- Vollständige Spezifikationen: Die Modellkarte listet Text-, Bild-, Audio- und Videoeingaben sowie ein einheitliches Kontextfenster von 1 Mio. Token; der Entwicklerleitfaden erklärt, dass implizites Caching für gemeinsam genutzte Präfixe über 4096 Token automatisch greift.
Einschränkungen
- Viele Ausgabe-Token: Der Benchmark-Lauf erzeugt 283 Mio. Ausgabe-Token, wodurch ein einzelner xhigh-Task länger dauert als bei Sol und Astra. Gegenmaßnahme: eine Stufe herunterschalten oder Teilaufgaben an Hydrogen übergeben.
- Offiziell nur als „Moderate“ eingestuft: AI Studio vergibt das Fast-Label an Hydrogen. Wer die schnellste Interaktion will, sollte zuerst Hydrogen testen.
- Einige Konfigurationen werden nicht unterstützt: Der Entwicklerleitfaden legt fest, dass explizites Kontext-Caching nicht unterstützt wird und
thinking_budgetzusammen mitMINIMALeinen400-Fehler auslöst. - Keine kostenlose Stufe: Auf der Preisseite von AI Studio steht, dass es für
gemini-4-neonkeine kostenlose Stufe gibt. - Gemischte Benchmark-Grundlagen: Der Coding Agent Index liegt im Google-Blog bei 58,6, im Artikel von Artificial Analysis bei 59; die 12,8 % und 39,0 % von SWE-sweep stammen aus zwei unterschiedlichen Harnesses. Beim Lesen der Daten also immer auf die Quelle achten.
Häufig gestellte Fragen (FAQ)
F1: Ist Gemini 4 Neon das schnellste Modell der Gemini-4-Familie?
Laut der aktuellen Modellübersicht in Google AI Studio gilt Hydrogen als Fast, Neon als Moderate und Carbon als Deliberate. Das offizielle „schneller fertig“ bezieht sich vor allem auf den Vergleich mit Carbon.
F2: Wie lange dauert es bei Gemini 4 Neon bis zum ersten Token?
Die Übersichtstabelle auf der Modellseite von Artificial Analysis nennt für xhigh 56,51 Sekunden bis zum ersten Token. Im FAQ-Bereich derselben Seite stehen zusätzlich 40,64 Sekunden für high, 20,14 Sekunden für medium und 13,93 Sekunden für low – diese drei Werte stammen aus dem FAQ-Bereich und nicht aus derselben Spalte wie die Übersichtstabelle.
F3: Warum liefert Gemini 4 Neon 110 Token pro Sekunde und braucht trotzdem 21,5 Minuten pro Aufgabe?
Weil es deutlich mehr Token ausgibt. Die Modellseite von Artificial Analysis verzeichnet für Neon xhigh bei der Index-Aufgabe 283 Millionen ausgegebene Token, Sol max nur 60,9 Millionen und Astra max nur 65,8 Millionen. Deshalb sind die beiden Letztgenannten pro Sekunde langsamer, brauchen aber weniger Zeit pro Aufgabe.
F4: Welche Stufe nutzt Gemini 4 Neon standardmäßig? Wie stelle ich es schneller ein?
Der Entwicklerleitfaden legt high als Standard fest. Für mehr Tempo lässt sich auf medium oder low herunterschalten; laut der Modellseite von Artificial Analysis liegen die Zeiten pro Aufgabe dann bei 8,3 bzw. 3,7 Minuten, und der Intelligenz-Score sinkt von 61 bei xhigh (high: 60) auf 55 oder 44.
F5: Kann ich Gemini 4 Neon derzeit über APIYI aufrufen?
Stand 2026-11-19 ist `gemini-4-neon` noch nicht in der APIYI-Übersichtstabelle und der Preis-API aufgeführt, also noch nicht verfügbar – wir werden es so bald wie möglich anbieten. Derzeit kann man sich bei apiyi.com registrieren und mit den bereits verfügbaren Modellen `gemini-4-carbon` oder `gemini-4-hydrogen` den Geschwindigkeitstest aufsetzen; die OpenAI-kompatible Adresse ist dieselbe wie im obigen Schnellstart.
F6: Wie viel günstiger ist Gemini 4 Neon als Carbon?
Hier gibt es drei Rechnungen: Der Google-Blog sagt, dass eine Aufgabe mit dem Standard high 32 % weniger kostet als bei Carbon; der Artikel von Artificial Analysis sagt, es seien rund 17 % weniger als der nicht reduzierte Preis von Carbon; die Modellseite von Artificial Analysis rechnet mit dem Einführungspreis 4,90 US-Dollar pro Aufgabe für Carbon high. Die drei Grundlagen unterscheiden sich, man kann sie nicht zu einer einzigen Zahl zusammenfassen.
F7: Kann ich die Benchmark-Ergebnisse von Gemini 4 Neon direkt mit Wettbewerbern vergleichen?
Mit Vorsicht. Die Modellkarte weist darauf hin, dass Ergebnisse von Nicht-Gemini-Modellen standardmäßig von den jeweiligen Anbietern selbst stammen, also eine offizielle Zusammenfassung sind und kein am selben Tag wiederholter Test; auch der Vergleich von Artificial Analysis hat Unterschiede bei den Stufen (xhigh, high und max sind gemischt).
Gemini 4 Neon: Die wichtigsten Erkenntnisse
- Geschwindigkeit ist nicht gleich Geschwindigkeit: Time-to-First-Token, Ausgaberate pro Sekunde und Zeit pro Aufgabe sind drei unabhängige Kennzahlen – ihre Ranglisten können sich durchaus widersprechen.
- Die offizielle Einstufung liegt in der Mitte: AI Studio stuft Neon als „Moderate“ ein, wirklich „Fast“ ist erst Hydrogen.
- Die xhigh-Werte: Die Modellseite von Artificial Analysis nennt 61 Punkte, 21,5 Minuten, 110 Token/s und 56,51 Sekunden bis zum ersten Token.
- Viel Output kostet Zeit: 283 Millionen Output-Token sorgen dafür, dass Neon pro Aufgabe länger braucht als Sol und Astra.
- Nicht die höchste Ausgaberate: Opus 5.5 max kommt auf 118 Token/s und liegt damit über den 110 von Neon.
- Eine Stufe runter, mehr Tempo: medium 8,3 Minuten und 55 Punkte, low 3,7 Minuten und 44 Punkte – Standard ist high.
- Stand beim Zugang: Neon ist bei APIYI noch nicht verfügbar. Mit den bereits gelisteten Gemini-4-Modellen lässt sich der Messablauf aber schon vorab aufsetzen.
Fazit
Die Kernaussagen zur Geschwindigkeit von Gemini 4 Neon:
- Gegenüber Carbon tatsächlich schneller: Beide Datensätze von Artificial Analysis zeigen, dass Neon rund die doppelte Ausgaberate von Carbon erreicht und pro Aufgabe deutlich weniger Zeit benötigt.
- Im größeren Feld aber nicht überall vorn: Die Ausgaberate liegt unter der von Opus 5.5 max, die Zeit pro Aufgabe über der von Sol max und Astra max.
- Die Stufe ist der wichtigste Regler: Die Ausgaberate ändert sich zwischen den vier Stufen nur wenig, die Unterschiede bei der Laufzeit kommen vor allem aus der Menge der Thinking-Token.
Unsere Einschätzung: In interaktiven Szenarien zählt zuerst die Time-to-First-Token, bei der Batch-Verarbeitung die Zeit pro Aufgabe – und erst fürs Streaming-Erlebnis ist die Ausgaberate pro Sekunde entscheidend. Ob Neon „schnell genug“ ist, hängt also davon ab, worauf Sie Wert legen. Mein Tipp: Setzen Sie zuerst über APIYI (apiyi.com) mit den vorhandenen Gemini-4-Modellen einen sauberen Ablauf auf, um alle drei Kennzahlen zu erfassen. Sobald Neon verfügbar ist, tauschen Sie einfach das Modell aus und vergleichen direkt.
📚 Referenzen
-
Sundar Pichais Ankündigungspost: Veröffentlichung von Gemini 4 Neon und der verfügbare Umfang
- Link:
x.com/sundarpichai/status/2123167780988125621 - Hinweis: Ankündigungskanal und die offizielle Formulierung „schneller fertig werden“
- Link:
-
Google-Blog „Introducing Gemini 4 Neon“: offiziell selbst gemeldete Benchmark-Werte, Preise und Positionierung innerhalb der Modellfamilie
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Hinweis: Alle Zahlen sind offizielle Eigenangaben
- Link:
-
DeepMind-Modellkarte: Spezifikationen und dreispaltige Vergleichstabelle
- Link:
deepmind.google/models/model-cards/gemini-4-neon/ - Hinweis: Ergebnisse von Nicht-Gemini-Modellen stammen standardmäßig aus den Eigenangaben der jeweiligen Anbieter
- Link:
-
Google-Cloud-Entwicklerhandbuch: Modell-ID, Denkstufen und Erläuterung der Fehlermeldungen
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Hinweis: vier Denkstufen, Standard
high, Auslösebedingungen für HTTP 400
- Link:
-
Google AI Studio – Preisseite und Seite zum neuesten Modell: offizielle Listenpreise und qualitative Geschwindigkeitsangaben
- Link:
aistudio.google.com/docs/pricing,aistudio.google.com/docs/latest-model - Hinweis: qualitative Einordnung in die drei Stufen Deliberate, Moderate und Fast
- Link:
-
Artificial-Analysis-Artikel: Drittanbieter-Vergleich von Neon und Carbon
- Link:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Hinweis: Näherungswerte wie etwa 21 Minuten, etwa 36 Minuten, etwa 57 Token/s
- Link:
-
Artificial-Analysis-Modellseite: vier Geschwindigkeitsstufen und Daten der Vergleichsmodelle
- Link:
artificialanalysis.ai/models/gemini-4-neon - Hinweis: abgerufen am 2026-11-19, Index v5.0.1, der FAQ-Bereich enthält zusätzlich die Zeit bis zum ersten Token je Stufe
- Link:
-
APIYI-Übersichtstabelle: bereits verfügbare Modelle und Preise
- Link:
docs.apiyi.com/models.md - Hinweis: Modelle und Preise richten sich nach der Modellliste der Plattform
- Link:
Autor: APIYI-Technikteam
Technischer Austausch: Bei Fragen zum Verfügbarkeitsstatus und zu den Modellbezeichnungen von Gemini 4 Neon könnt ihr uns gerne über die Startseite von APIYI auf apiyi.com kontaktieren