ملاحظة من الكاتب: يمكن قياس «سرعة» Gemini 4 Neon بثلاث طرق على الأقل. يعرض هذا المقال هذه القياسات منفصلةً: زمن أول رمز، وعدد الرموز المخرجة في الثانية، والزمن اللازم لإتمام مسألة واحدة، ويبيّن مصدر كل رقم.
أُطلق Gemini 4 Neon في 2026-11-18. وقال Sundar Pichai في منشور الإطلاق إن النموذج يستطيع إتمام المهام بسرعة أكبر في هندسة البرمجيات المعقدة والعمل المعرفي والعمليات العلمية، وقد فهم كثيرون من هذه العبارة أنه «الأسرع على الإطلاق». في الواقع، هناك ثلاثة مقاييس مختلفة على الأقل للسرعة، وهي لا تعطي الترتيب نفسه.
كل أرقام السرعة في هذا المقال مأخوذة من صفحة نموذج Artificial Analysis ومقالات Artificial Analysis، أما درجات التقييم فهي من الإفصاح الرسمي ومن بطاقة النموذج، ولم نقس أي رقم بأنفسنا. ستُعرض الأرقام ذات المصادر والمقاييس المختلفة جنبًا إلى جنب، دون حساب متوسط، ودون دمجها في أرقام جديدة.
القيمة الأساسية: بعد قراءة هذا المقال ستتمكن من التمييز بين زمن أول رمز لدى Gemini 4 Neon وعدد الرموز المخرجة في الثانية وزمن المهمة الواحدة، وتعرف تأثير مستويات التفكير الأربعة على السرعة والدرجات، وتعرف أي مؤشر يجب أن تنظر إليه عند اختيار النموذج.
النقاط الأساسية لسرعة Gemini 4 Neon
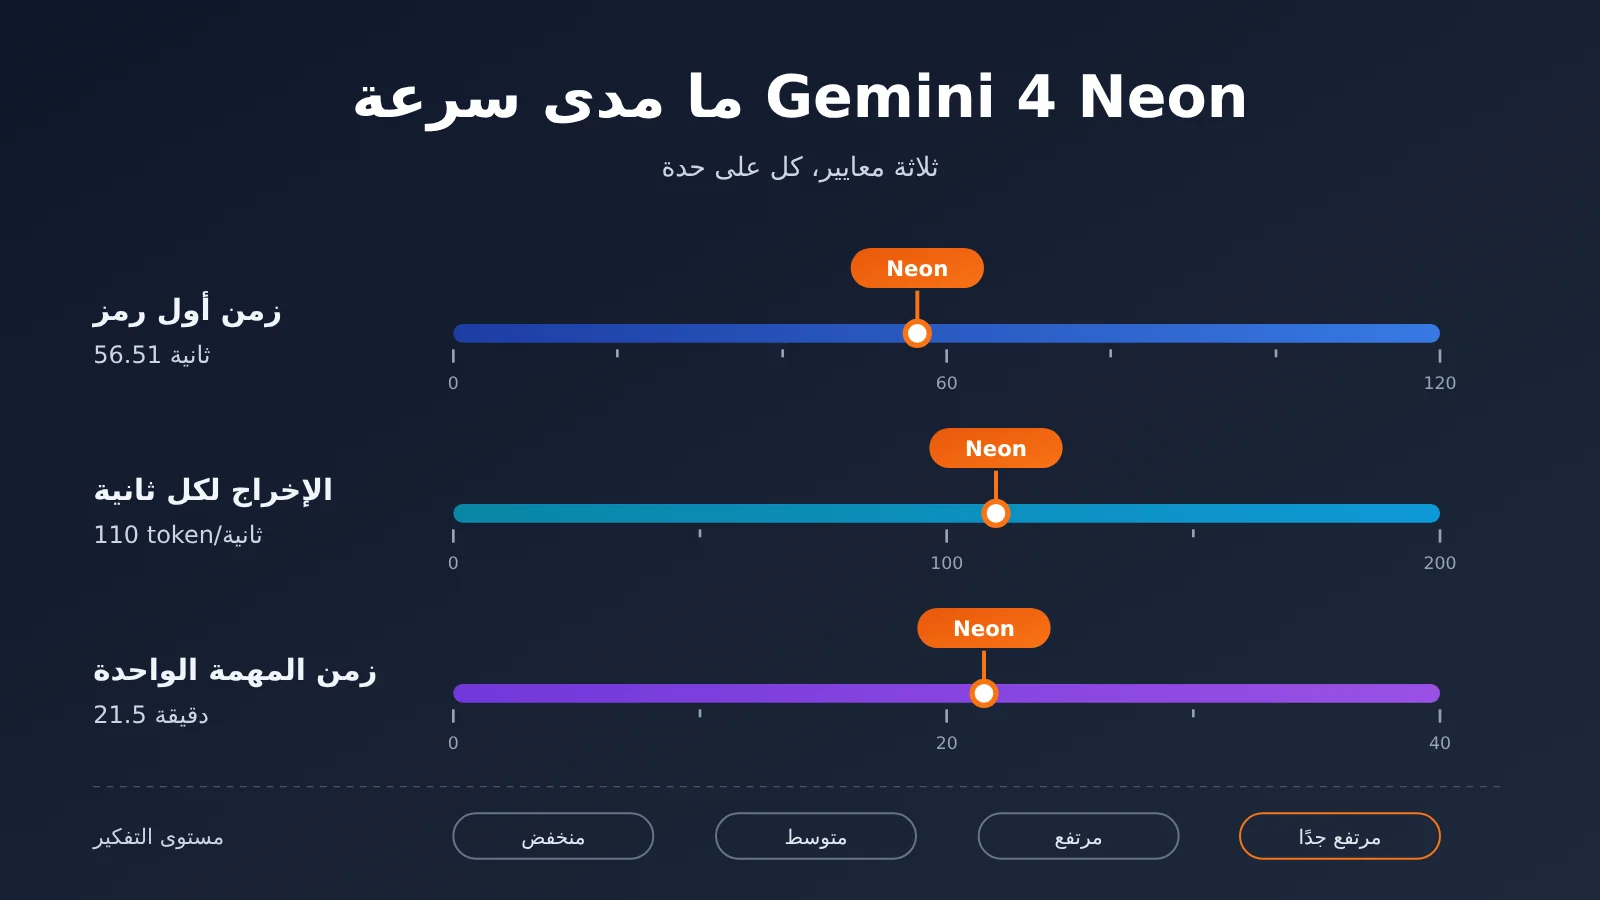
لنفصل أولاً بين ثلاثة مؤشرات يسهل الخلط بينها. جميع قيم Neon في الجدول أدناه من فئة xhigh، وهي مأخوذة من صفحة النموذج على Artificial Analysis (قُرئت في 2026-11-19، الفهرس v5.0.1).
| المؤشر | المعنى | قيمة Gemini 4 Neon xhigh | ما يشعر به المستخدم |
|---|---|---|---|
| زمن أول رمز | الانتظار من لحظة إرسال الطلب حتى ظهور أول رمز إجابة | 56.51 ثانية | “كم سيتوقف قبل أن يبدأ بإخراج الحروف” أثناء التفاعل |
| الإخراج في الثانية | عدد الرموز المولّدة في الثانية بعد بدء الإخراج | 110 رمز/ثانية | هل “يتدفق الإخراج بسرعة” في الوضع التدفقي |
| زمن المهمة الواحدة | متوسط الوقت اللازم لإنجاز مسألة واحدة من مسائل الفهرس | 21.5 دقيقة | “كم يستغرق الأمر لتسليم مهمة ما” |
| حجم إخراج تشغيل الفهرس | إجمالي الرموز المخرجة عند تشغيل الفهرس كاملاً | 283 مليون رمز | يحدد النصف الآخر من زمن المهمة الواحدة |
لماذا يجب النظر إلى مؤشرات السرعة الثلاثة في Gemini 4 Neon بشكل منفصل
زمن أول رمز هو الأكثر تأثيراً على التفاعلات الشبيهة بالمحادثة. فالنموذج التفّاعي يحتاج إلى إتمام جزء من الاستدلال قبل أن يخرج أول رمز إجابة، لذا غالباً ما يُقاس زمن أول رمز بالثواني أو حتى بالدقائق، ويرتبط ارتباطاً قوياً بمستوى التفكير المختار.
الإخراج في الثانية يقيس فقط معدل التدفق “بعد بدء إخراج الحروف”، ولا علاقة له بكمية الكلام التي يريد النموذج قوله. أما زمن المهمة الواحدة فيتأثر بأمرين في آن واحد: عدد الرموز التي يمكن إخراجها في الثانية، وإجمالي عدد الرموز التي تتطلبها هذه المسألة. فالنموذج قد يكون إخراجه في الثانية مرتفعاً، لكن إن اعتاد كتابة عمليات تفكير طويلة جداً فقد يظل أبطأ في إنجاز مسألة واحدة. والمقارنة بين Neon وكل من GPT-6.2 Sol وGPT-6.2 Astra لاحقاً هي بالضبط هذه الحالة.
الميزات الأساسية في Gemini 4 Neon: التموضع العائلي ومستويات التفكير الأربعة
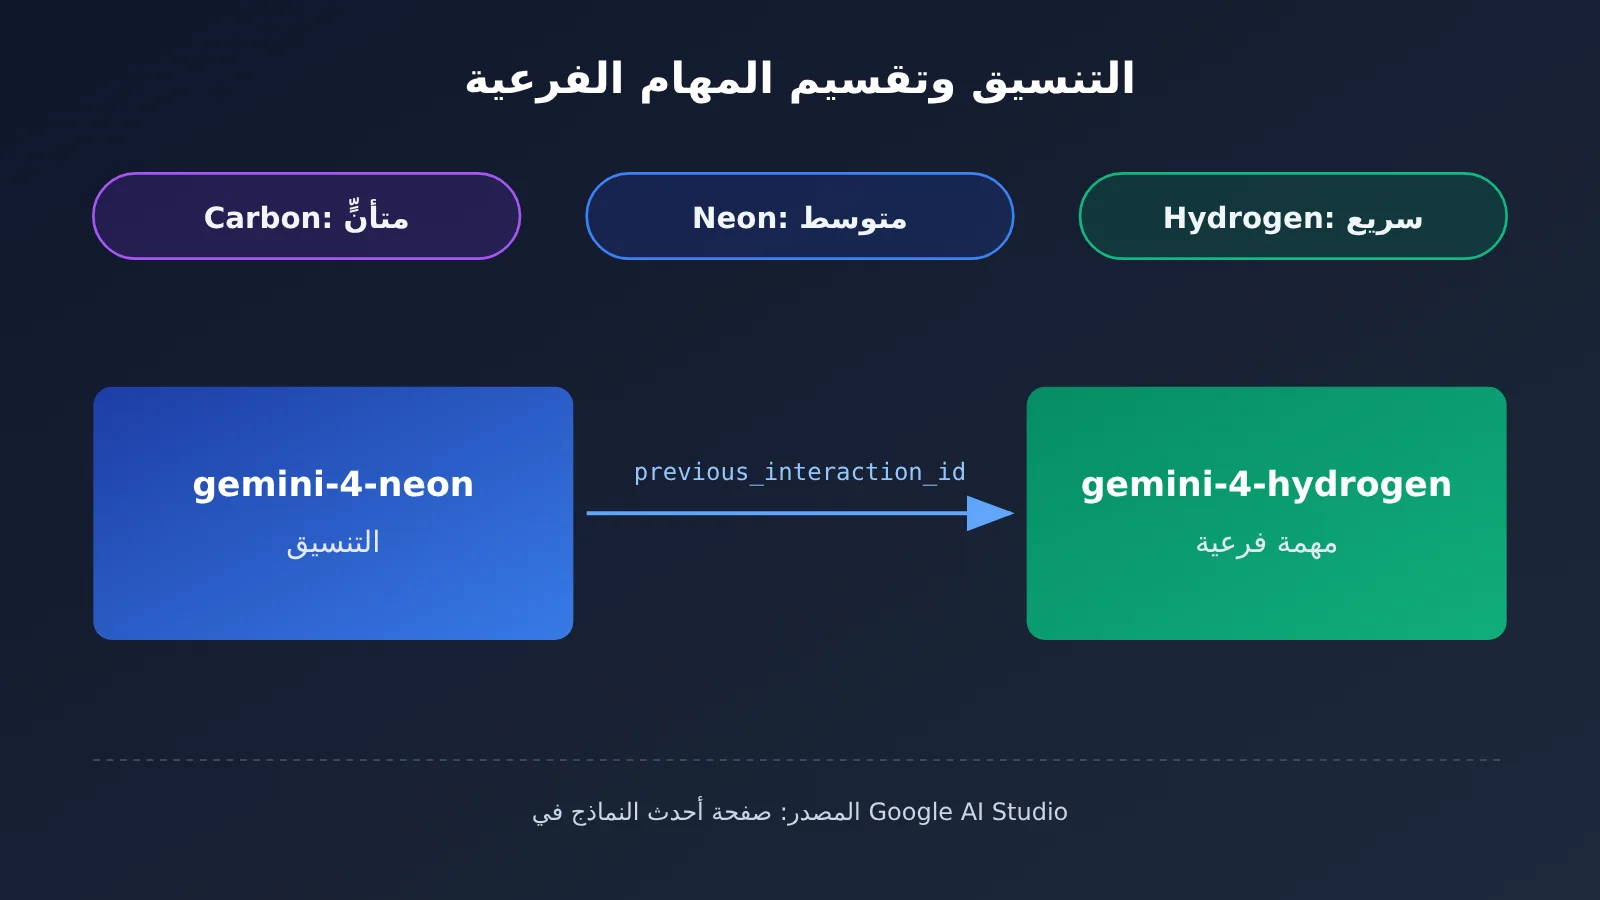
أعطت أحدث صفحة نماذج في Google AI Studio تسميات وصفية للسرعة لثلاثة نماذج من Gemini 4: Carbon هو Deliberate، وNeon هو Moderate، وHydrogen هو Fast. أي أن Neon يقع في المنتصف داخل العائلة بحسب التصنيف الرسمي نفسه، بينما Hydrogen هو النموذج الموسوم فعلاً بـ Fast. كذلك تصنّف مدونة Google كلاً من Carbon بأنه الأصعب في المهام الطويلة المدى، وHydrogen بأنه التنفيذ السريع اليومي، وNeon بأنه الحل الوسط الموجّه لسير العمل المعقّد عالي التكرار.
| النموذج | تصنيف السرعة في AI Studio | مستوى التفكير | المستوى الافتراضي | التموضع العائلي (مدونة Google / دليل المطورين) |
|---|---|---|---|---|
| Gemini 4 Carbon | Deliberate | low، medium، high | medium | مهام طويلة معقدة |
| Gemini 4 Neon | Moderate | low، medium، high، xhigh | high | حل وسط، سير عمل معقّد عالي التكرار |
| Gemini 4 Hydrogen | Fast | لم توضّح المصادر | لم توضّح المصادر | دورة يومية سريعة |
قدرات Gemini 4 Neon ومواصفاته
وفق بطاقة النموذج، فإن Gemini 4 Neon مقتبس من Gemini 4 Carbon، وتنتهي معرفته في مارس 2026، ويدعم الإدخال النصي والصوري والصوتي والمرئي، مع نافذة موحدة تصل إلى مليون token كحد أقصى. الإخراج المتزامن الافتراضي يصل إلى 64 ألف token، أما فك الترميز الطويل في الخلفية فيصل إلى مليون token. ويذكر دليل مطوري Google Cloud أن معرّف النموذج هو gemini-4-neon، وأن السقف الموحد 1048576 token، ويشمل الإدخال والإخراج، كما يشمل الإخراج التفكير واستدعاءات الدوال والرد النهائي.
من حيث القدرات، يبلغ مؤشر Artificial Analysis Intelligence Index المعلن رسمياً 61 عند مستوى xhigh، وهو الثالث إجمالاً، وتعترف المدونة أيضاً بأنه متأخر عن نماذج أكبر وأبطأ. جدول المقارنة في بطاقة النموذج يضم ثلاث أعمدة فقط: Neon وClaude Opus 5.5 وGPT-6.2 Sol، ونتائج غير Gemini مأخوذة افتراضياً من التصريحات الذاتية لكل جهة، لذا فذلك الجدول تجميع رسمي وليس إعادة اختبار من المعمل نفسه في اليوم نفسه. ويضم الجدول أيضاً بنوداً يتأخر فيها Neon، مثل دقة Terminal-bench 4.1 بعد تعديل الغش، حيث بلغت لدى Opus 5.5 نسبة 65.8%، وهي أعلى من 65.2% لدى Neon.
ويقدّم دليل المطورين أيضاً طريقة تنسيق: استخدام gemini-4-neon كمنسّق رئيسي، وتمرير previous_interaction_id إلى gemini-4-hydrogen لتشغيل مهام فرعية أسرع. وإذا رأيت أن Neon ليس سريعاً بما يكفي، فإن هذا المسار يستحق التفكير فيه أكثر من مجرد خفض مستوى التفكير باستمرار (هذا تقييمنا، وليس نص الدليل الحرفي).
بيانات سرعة Gemini 4 Neon: تفصيل المستويات الأربعة للتفكير
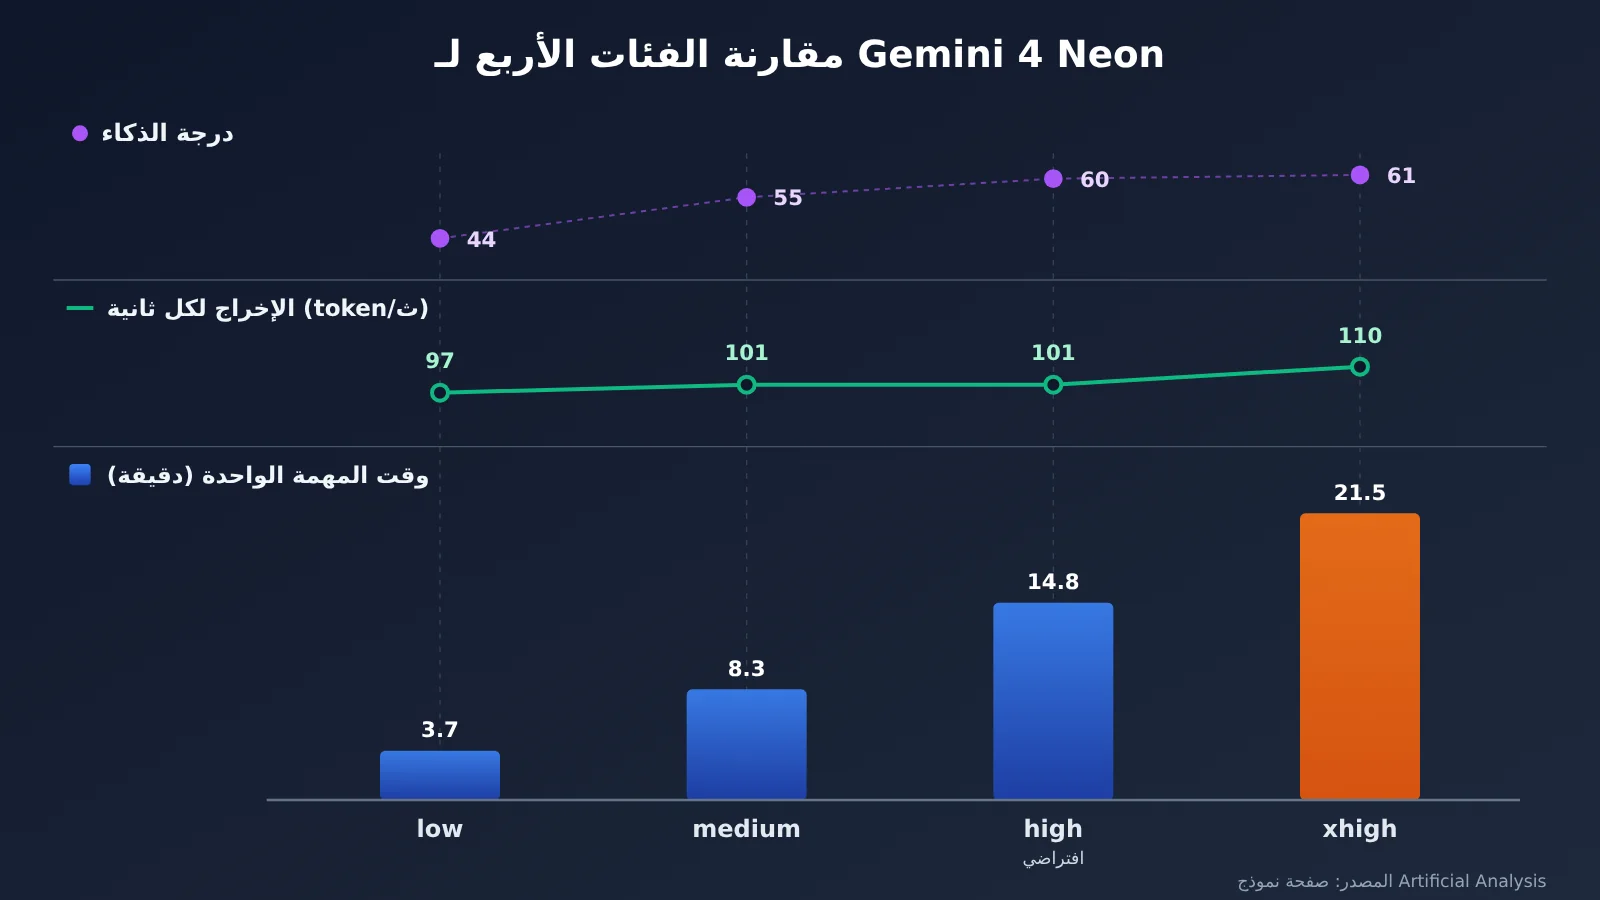
الجدول التالي مأخوذ من صفحة نموذج Artificial Analysis. عمود زمن أول رمز في أقصى اليمين يحتاج توضيحًا منفصلًا: الجدول الملخص في الصفحة يعطي فقط 56.51 ثانية لمستوى xhigh، بينما قيم زمن أول رمز لمستويات high وmedium وlow مأخوذة من قسم الأسئلة الشائعة FAQ في الصفحة نفسها، وليست في العمود نفسه ضمن الجدول الملخص. لذلك عند الاقتباس يجب الحفاظ على هذا المصدر.
| مستوى التفكير | درجة الذكاء | زمن المهمة الواحدة | الرموز في الثانية | زمن أول رمز (قسم FAQ في صفحة النموذج) |
|---|---|---|---|---|
| xhigh | 61 | 21.5 دقيقة | 110 token/ثانية | 56.51 ثانية |
| high (الافتراضي) | 60 | 14.8 دقيقة | 101 token/ثانية | 40.64 ثانية |
| medium | 55 | 8.3 دقيقة | 101 token/ثانية | 20.14 ثانية |
| low | 44 | 3.7 دقيقة | 97 token/ثانية | 13.93 ثانية |
بالنظر إلى هذا الجدول، نجد أن الرموز في الثانية تتراوح فقط بين 97 و110 token/ثانية، بينما يمتد زمن المهمة الواحدة من 3.7 دقيقة إلى 21.5 دقيقة. ما يغيّره ضبط المستوى بشكل أساسي هو «مقدار التفكير المطلوب»، وليس «سرعة الكتابة في الثانية». هذا استنتاج مستخرج من أرقام الجدول، ولم تصغه صفحة النموذج بهذه الطريقة.
كما أن كلفة الدرجة واضحة أيضًا. الانتقال من high الافتراضي بدرجة 60 إلى medium يفقد 5 درجات فقط، بينما الانتقال إلى low يهبط بالدرجة إلى 44. أما xhigh فيمنح درجة إضافية واحدة فوق high، لكنه يضيف قرابة 7 دقائق إلى زمن المهمة الواحدة. لذا تعتمد قيمة ذلك على نوع مهمتك.
Gemini 4 Neon أسرع في الثانية، فلماذا قد يستغرق إكمال مسألة واحدة وقتًا أطول؟
تسجل صفحة النموذج على Artificial Analysis أن Neon بإعداد xhigh، عند تشغيله مجموعة الاختبارات القياسية كاملة، أخرج 283 مليون توكن واستقبل 8.12 مليار توكن. وكلما زاد عدد التوكنات المُخرجة، فحتى لو بلغ معدلها 110 توكنات في الثانية، فإن الزمن الكلي سيطول. أما GPT-6.2 Astra فعند إعداد max ينتج 50 توكنًا فقط في الثانية، لكنه عند تشغيل الاختبار القياسي لا يُخرج سوى 65.8 مليون توكن، وزمن المهمة الواحدة 13.7 دقيقة. ويعمل GPT-6.2 Sol عند إعداد max بمعدل 79 توكنًا في الثانية، ويُخرج 60.9 مليون توكن، وزمن المهمة الواحدة 8.5 دقائق.
لذا فإن «ارتفاع عدد التوكنات المُخرجة في الثانية» و«انتهاء المهمة في وقت أبكر» أمران مختلفان. وعند مقارنة Neon بهذين النموذجين من GPT، نجد أن Neon ينتج في الثانية أكثر، لكن زمن المهمة الواحدة أطول؛ والسبب أن Neon يُخرج توكنات أكثر بكثير.
مقارنة Gemini 4 Neon مع نماذج المرجع بشكل منفصل
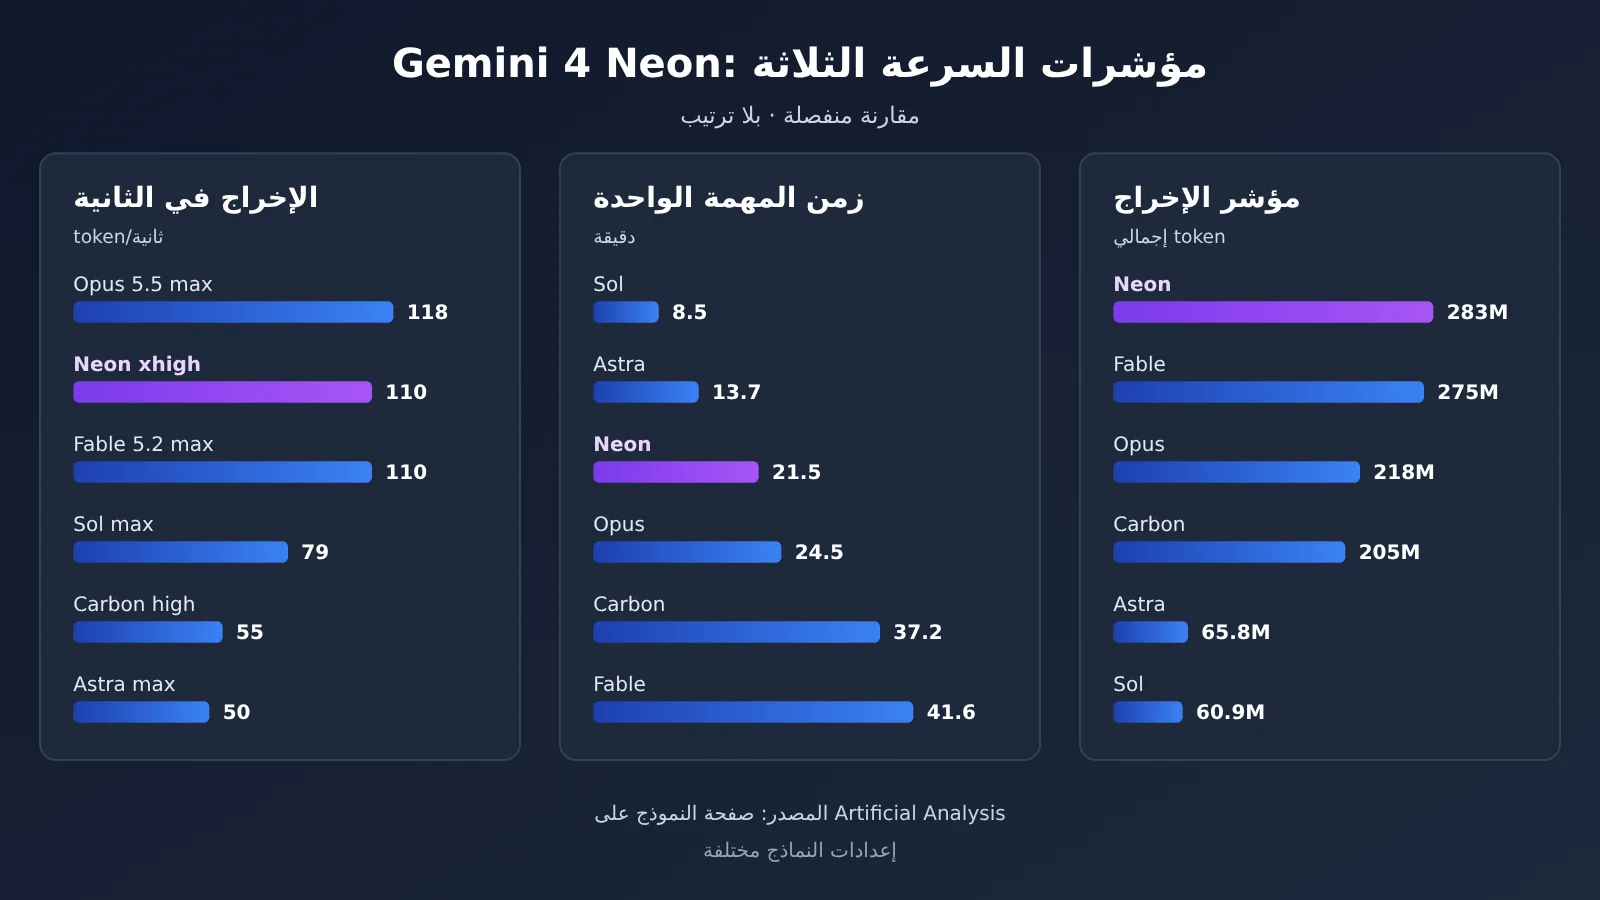
كل الأرقام في الجدول التالي مأخوذة من صفحة النماذج على Artificial Analysis. مستويات النماذج مختلفة (Neon يستخدم xhigh، وCarbon يستخدم high، والباقي يستخدم max)، لذا يمكنك فقط قراءة العلاقات النسبية داخل العمود نفسه، ولا يمكن اعتبارها مسابقة في ظروف متساوية.
| النموذج (المستوى) | درجة الذكاء | زمن المهمة الواحدة | الإخراج في الثانية | زمن أول توكن | توكنات الإخراج عند تشغيل المؤشر |
|---|---|---|---|---|---|
| Gemini 4 Neon (xhigh) | 61 | 21.5 دقيقة | 110 | 56.51 ثانية | 283 مليون |
| Gemini 4 Carbon (high) | 60 | 37.2 دقيقة | 55 | 73.04 ثانية | 205 مليون |
| Claude Opus 5.5 (max) | 59 | 24.5 دقيقة | 118 | 335.85 ثانية | 218 مليون |
| Claude Fable 5.2 (max) | 65 | 41.6 دقيقة | 110 | 247.46 ثانية | 275 مليون |
| GPT-6.2 Astra (max) | 62 | 13.7 دقيقة | 50 | 197.65 ثانية | 65.8 مليون |
| GPT-6.2 Sol (max) | 57 | 8.5 دقيقة | 79 | 75.06 ثانية | 60.9 مليون |
لنفحص المؤشرات الثلاثة واحدًا واحدًا:
- الإخراج في الثانية: يبلغ Claude Opus 5.5 max نحو 118 توكن/ثانية، وهو أعلى من 110 لدى Neon xhigh؛ أما Claude Fable 5.2 max فيساوي Neon عند 110.
- زمن المهمة الواحدة: 8.5 دقيقة لـGPT-6.2 Sol max و13.7 دقيقة لـGPT-6.2 Astra max، وكلاهما أقصر من 21.5 دقيقة لـNeon xhigh.
- زمن أول توكن: قيمة Neon xhigh البالغة 56.51 ثانية هي الأصغر في هذا الجدول، لكن مستويات كل صف مختلفة، لذا لا يمكن الاستنتاج من ذلك أنه متقدم في كل شيء.
لتفوق Neon في السرعة على Carbon روايتان مختلفتان. صفحة النماذج على Artificial Analysis تعطي Carbon high نحو 55 توكن/ثانية و37.2 دقيقة. أما مقالة Artificial Analysis فتعطي أرقامًا تقريبية: مهمة Neon الواحدة تستغرق نحو 21 دقيقة، أي أقل بنحو 40% من نحو 36 دقيقة لـCarbon، ويأتي هذا التسريع من سرعة الإخراج التي تبلغ نحو 110 مقابل نحو 57 توكن/ثانية، مع إخراج Neon لعدد توكنات أكبر بنحو 15% في المهمة الواحدة. معيار أرقام Carbon في المجموعتين مختلف، لذلك لا نطرحهما هنا.
كيف تبدأ سريعًا: اختيار مستويات Gemini 4 Neon وطرق قياس السرعة
حاليًا، يجب استدعاء gemini-4-neon عبر قنوات Google الرسمية. تنقسم الخطوات التالية إلى جزئين: أولاً كيفية اختيار مستوى Neon، ثم إعداد عملية قياس السرعة باستخدام نماذج Gemini 4 المتاحة بالفعل على APIYI، بحيث يمكنك تبديل معرّف النموذج مباشرة بعد إطلاق Neon.
الخطوة الأولى: فهم مستويات التفكير الأربعة في Neon. يوضح دليل مطوري Google Cloud أن مستوى التفكير في gemini-4-neon يقتصر على low وmedium وhigh وxhigh، والافتراضي هو high. تمرير thinking_budget أو MINIMAL سيعيد HTTP 400، وهذه النقطة هي الأكثر عرضة للخطأ عند ترحيل الشيفرة من إصدارات Gemini القديمة.
الخطوة الثانية: خفض المستوى حسب متطلبات السرعة. إذا وجدت السرعة غير مرضية، يمكنك خفض المستوى من high الافتراضي إلى medium أو low. وفقًا لصفحة نموذج Artificial Analysis، سينخفض وقت المهمة الواحدة من 14.8 دقيقة في high إلى 8.3 دقائق أو 3.7 دقائق، بينما تنخفض درجة الذكاء من 61 في xhigh (الافتراضي high هو 60) إلى 55 أو 44. الانخفاض في درجة low كبير، لذا يُفضّل تأكيد ذلك على عينة من مهامك قبل خفض المستوى.
الخطوة الثالثة: تجهيز حساب APIYI ومفتاح API. سجّل في APIYI على apiyi.com واحصل على مفتاح API، ثم ضع المفتاح في متغير بيئة (مثل APIYI_API_KEY)، واقرأ من متغير البيئة فقط في الشيفرة، ولا تكتبه نصًا صريحًا.
الخطوة الرابعة: اختيار طريقة الاستدعاء. بالنسبة للواجهة المتوافقة مع OpenAI، املأ base_url بـ https://api.apiyi.com/v1، واسم النموذج بـ gemini-4-carbon أو gemini-4-hydrogen المتاحين بالفعل؛ وإذا كنت تستخدم بروتوكول Gemini الأصلي، فاستخدم العنوان https://api.apiyi.com وإصدار api v1beta.
الخطوة الخامسة: تسجيل ثلاثة مؤشرات بشكل منفصل. فعّل الإخراج المتدفق stream، وسجّل بشكل منفصل وقت وصول أول token للإجابة، وعدد tokens في الثانية بعد بدء الإخراج، والوقت الإجمالي لانتهاء المهمة، ثم سجّل العدد الإجمالي لـ tokens في هذا الإخراج. بوجود عدد tokens الناتجة، يمكنك تحديد ما إذا كان الوقت الطويل بسبب “الكتابة البطيئة” أم “الكتابة الكثير”.
🚀 نصيحة للبدء السريع: يُفضّل تشغيل عملية قياس السرعة أولاً على نماذج Gemini 4 المتاحة بالفعل. يغطي APIYI بمفتاح واحد عائلات Gemini وClaude وGPT في آن واحد، ويكفي كتابة سكريبت تسجيل المؤشرات الثلاثة مرة واحدة للمقارنة الأفقية بين عدة نماذج، وبعد إطلاق Neon يكفي تعديل معرّف النموذج.
أسعار Gemini 4 Neon ومطابقة النماذج في APIYI
السعر الرسمي المعلن لـ Gemini 4 Neon (صفحة تسعير Google AI Studio) هو 3 دولارات لكل مليون token من المدخلات، و15 دولارًا لكل مليون token من المخرجات.
من جهة APIYI، راجعنا مصدرين: الجدول العام لـ APIYI (docs.apiyi.com/models.md، وتشير الصفحة إلى تحديث بتاريخ 2026-11-16 09:39، UTC+8)، وواجهة التسعير التي استعلمنا عنها في 2026-11-19 (api.apiyi.com/api/pricing، الإصدار shell-api-modelmak-v1، وتضم 285 نموذجًا). فيما يلي النماذج المتاحة التي يمكن مقارنتها بين المصدرين، والوحدة هي دولار لكل مليون token.
| معرف النموذج | المدخلات | قراءة التخزين المؤقت | المخرجات | نقطة النهاية | ملاحظة (المصدر) |
|---|---|---|---|---|---|
gemini-4-carbon |
2 | 0.1 | 10 | chat، gemini | يطابق سعر Google التعريفي حتى 2026-11-30 (الجدول العام لـ APIYI) |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | chat، gemini | الجدول العام لـ APIYI |
claude-opus-5-5 / claude-opus-5-5-thinking |
4 | 0.2 | 20 | chat، messages | الجدول العام لـ APIYI |
claude-fable-5-2 / claude-fable-5-2-thinking |
8 | 0.2 | 40 | chat، messages | الجدول العام لـ APIYI |
gpt-6.2-sol |
2 (يصبح 3 عند تجاوز 272000) | 0.1 | 10 (الفئة العليا في واجهة التسعير نحو 11.25) | responses (موصى به)، chat | الجدول العام يذكر تدرج المدخلات فقط |
gpt-6.2-astra |
8 (يصبح 16 عند تجاوز 272000) | 0.4 | 40 (الفئة العليا في واجهة التسعير نحو 60) | responses، chat | الجدول العام يذكر تدرج المدخلات فقط |
هناك عدة تفاصيل يجب الانتباه إليها. سعر gemini-4-carbon المدرج يطابق سعر Google التعريفي، وليس السعر القياسي اللاحق 4/20. وأسماء المجموعات مكتوبة بشكل غير متطابق تمامًا بين المصدرين: نماذج Gemini مكتوبة في الجدول العام بصيغة Default وSVIP، وفي واجهة التسعير بصيغة default وsvip. أما نماذج Claude فمكتوبة في الجدول العام بصيغة ClaudeCode وClaude_Reverse وClaude_Enterprise وDefault وSVIP، وفي واجهة التسعير بصيغة ClaudeCode وClaudeCodeReverse وClaudeOfficial وdefault وsvip. ولا يظهر سعر المخرجات للفئة العليا لنماذج GPT إلا في واجهة التسعير؛ وفيها يتغير CompletionRatio من 5 إلى 3.75 عند تجاوز 272000 token.
لم يُدرج gemini-4-neon في الجدول العام لـ APIYI ولا في واجهة التسعير، فهو غير متاح على المنصة حاليًا، وسنعمل على إتاحته في أقرب وقت؛ وتبقى أسماء النماذج وأسعارها خاضعة لقائمة النماذج على المنصة.
تحليل نقاط القوة والضعف في Gemini 4 Neon
المزايا
- سرعة إخراج أعلى من الطرازات السابقة في العائلة: تُظهر صفحة النموذج على Artificial Analysis أن Neon xhigh ينتج 110 توكن/ثانية، بينما ينتج Carbon high نحو 55 توكن/ثانية.
- زمن انتظار أول توكن أقصر نسبيًا: يبلغ زمن أول توكن لدى xhigh نحو 56.51 ثانية، وهو أصغر قيمة في جدول المقارنة أعلاه (مع اختلاف المستويات، لذا يُستخدم كمرجع فقط).
- مستويات تفكير دقيقة التدرج: توجد أربعة مستويات للتفكير، من 3.7 دقائق عند low إلى 21.5 دقيقة عند xhigh، ما يتيح الاختيار بحسب المهمة.
- مواصفات شاملة: تسرد بطاقة النموذج مدخلات النص والصورة والصوت والفيديو، ونافذة سياق موحدة بسعة مليون توكن؛ ويوضح دليل المطور أن التخزين المؤقت الضمني يعمل تلقائيًا مع البادئات المشتركة التي يزيد طولها على 4096 توكن.
القيود
- عدد توكنات الإخراج مرتفع نسبيًا: أنتج الاختبار 283 مليون توكن إخراج، ما يجعل زمن المهمة الواحدة في xhigh أطول من Sol وAstra. والحل هو خفض المستوى، أو تسليم المهام الفرعية إلى Hydrogen.
- التصنيف الرسمي هو Moderate فقط: منحت AI Studio وسم Fast إلى Hydrogen، لذا ينبغي لمن يبحث عن أسرع تفاعل أن يجرّب Hydrogen أولًا.
- بعض الإعدادات غير مدعومة: يوضح دليل المطور أن التخزين المؤقت الصريح للسياق غير مدعوم، وأن استخدام
thinking_budgetوMINIMALيؤدي إلى إرجاع الخطأ400. - لا توجد فئة مجانية: توضح صفحة الأسعار في AI Studio أن
gemini-4-neonلا يوفر فئة مجانية. - تختلف منهجيات قياس الأداء: تظهر قيمة Coding Agent Index عند 58.6 في مدونة Google، وعند 59 في مقال Artificial Analysis؛ كما أن نسبة 12.8% و39.0% في SWE-sweep تأتي من أداتي اختبار (harness) مختلفتين. لذا ينبغي التحقق من المصدر عند قراءة البيانات.
الأسئلة الشائعة
س1: هل Gemini 4 Neon هو الأسرع في عائلة Gemini 4؟
بحسب التوصيف في أحدث صفحة نماذج على Google AI Studio، فإن Hydrogen هو Fast (سريع)، وNeon هو Moderate (متوسط)، وCarbon هو Deliberate (متأنٍّ). وما تقصده الجهة الرسمية بعبارة «إنجاز أسرع» هو أساسًا المقارنة مع Carbon.
س2: كم ينتظر Gemini 4 Neon حتى يظهر أول رمز؟
يعطي الجدول الموجز في صفحة نموذج Artificial Analysis قيمة 56.51 ثانية لزمن أول رمز عند المستوى xhigh. وفي قسم الأسئلة الشائعة بالصفحة نفسها أرقام أخرى: high 40.64 ثانية، وmedium 20.14 ثانية، وlow 13.93 ثانية؛ وهذه الأرقام الثلاثة مأخوذة من قسم الأسئلة الشائعة وليست من الجدول الموجز نفسه.
س3: لماذا ينتج Gemini 4 Neon نحو 110 رموز في الثانية، ومع ذلك تستغرق المهمة الواحدة 21.5 دقيقة؟
لأنه ينتج عددًا أكبر بكثير من الرموز. تسجّل صفحة نموذج Artificial Analysis أن Neon بمستوى xhigh أنتج 283 مليون رمز في الاختبار، بينما أنتج Sol max نحو 60.9 مليون فقط وAstra max نحو 65.8 مليون؛ ولهذا فإن الأخيرين أبطأ في معدل الرموز في الثانية، لكن زمن المهمة الواحدة عندهما أقصر.
س4: ما المستوى الافتراضي في Gemini 4 Neon؟ وكيف أضبطه ليكون أسرع؟
يوضح دليل المطوّرين أن الافتراضي هو high. ولزيادة السرعة يمكن النزول إلى medium أو low؛ وبحسب صفحة نموذج Artificial Analysis يصبح زمن المهمة الواحدة 8.3 دقائق و3.7 دقائق على الترتيب، بينما ينخفض مؤشر الذكاء من 61 عند xhigh (و60 عند high) إلى 55 أو 44.
س5: هل يمكن الآن استدعاء Gemini 4 Neon عبر APIYI؟
حتى تاريخ 2026-11-19، لم يظهر `gemini-4-neon` في جدول APIYI العام ولا في واجهة التسعير، أي أنه لم يُطرح بعد، وسنعمل على طرحه في أقرب وقت. في الوقت الحالي يمكنك التسجيل في apiyi.com وبناء مسار لاختبار السرعة باستخدام `gemini-4-carbon` أو `gemini-4-hydrogen` المتاحين، مع العنوان المتوافق مع OpenAI نفسه المذكور في شرح البدء السريع أعلاه.
س6: كم يكون Gemini 4 Neon أرخص من Carbon؟
هناك ثلاث حسابات مختلفة هنا: مدونة Google تقول إن تكلفة المهمة الواحدة بالمستوى الافتراضي high أقل بنسبة 32% من Carbon؛ ومقال Artificial Analysis يقول إنها أقل بنحو 17% مقارنة بسعر Carbon غير المخفّض؛ أما صفحة نموذج Artificial Analysis فتحسب تكلفة المهمة الواحدة لـ Carbon بمستوى high بـ4.90 دولار وفق سعر التعريف. المعايير مختلفة ولا يمكن دمجها في رقم واحد.
س7: هل يمكن أخذ نتائج تقييم Gemini 4 Neon ومقارنتها مباشرة بالمنافسين؟
يجب الحذر. فبطاقة النموذج توضح أن نتائج النماذج غير التابعة لـ Gemini تأتي افتراضيًا من إفصاحات كل جهة، وهي تجميع رسمي وليست إعادة اختبار في اليوم نفسه؛ كما أن مقارنات Artificial Analysis فيها فروق في المستويات (xhigh وhigh وmax مختلطة معًا).
Gemini 4 Neon: النقاط الأساسية
- السرعة لها ثلاثة أوجه: زمن أول توكن، والإخراج في الثانية، وزمن المهمة الواحدة، وكل منها مستقل، وقد تتعارض ترتيباتها.
- التصنيف الرسمي في المنتصف: يصنف AI Studio نموذج Neon على أنه Moderate، بينما Hydrogen هو Fast.
- بيانات xhigh: تعرض صفحة نموذج Artificial Analysis 61 نقطة، و21.5 دقيقة، و110 توكن/ثانية، وزمن أول توكن 56.51 ثانية.
- حجم الإخراج يطيل المدة: 283 مليون توكن إخراج تجعل زمن المهمة الواحدة لـ Neon أطول من Sol وAstra.
- الإخراج في الثانية ليس الأعلى: 118 توكن/ثانية لدى Opus 5.5 max أعلى من 110 لدى Neon.
- خفض المستوى مقابل السرعة: medium يستغرق 8.3 دقيقة ويعطي 55 نقطة، وlow يستغرق 3.7 دقيقة ويعطي 44 نقطة، والافتراضي high.
- وضع الوصول الحالي: لم تُدرج APIYI Neon بعد، ويمكن حاليًا استخدام نماذج Gemini 4 المدرجة لبناء مسار قياس السرعة.
الملخص
الاستنتاجات الأساسية حول سرعة Gemini 4 Neon:
- أسرع فعلًا مقارنة بـ Carbon: تُظهر مجموعتا بيانات Artificial Analysis أن إخراج Neon في الثانية يعادل نحو ضعف Carbon، وأن زمن المهمة الواحدة أقصر بوضوح.
- لكن الصورة الأوسع لا تجعله متصدرًا في كل شيء: إخراجه في الثانية أقل من Opus 5.5 max، وزمن المهمة الواحدة أطول من Sol max وAstra max.
- المستوى هو الرافعة الرئيسية: الإخراج في الثانية لا يتغير كثيرًا بين المستويات الأربعة، بينما يأتي اختلاف المدة أساسًا من عدد توكنات التفكير.
رأينا أن نبدأ في السيناريوهات التفاعلية بزمن أول توكن، وفي المعالجة بالجملة بزمن المهمة الواحدة، وأن نركز على الإخراج في الثانية فقط عند تقييم تجربة التدفق. وهل Neon “سريع بما يكفي” يعتمد على المؤشر الذي يهمك. نقترح أولًا تشغيل عملية تسجيل المؤشرات الثلاثة عبر APIYI apiyi.com باستخدام نماذج Gemini 4 المتاحة، ثم استبدال النموذج مباشرة بـ Neon بعد إدراجه للمقارنة.
📚 المراجع
-
منشور Sundar Pichai: إطلاق Gemini 4 Neon ونطاق التوفّر
- الرابط:
x.com/sundarpichai/status/2123167780988125621 - الوصف: قناة الإطلاق والصياغة الرسمية لعبارة “إتمام العمل بشكل أسرع”
- الرابط:
-
مدونة Google — Introducing Gemini 4 Neon: نتائج القياس التي أعلنتها الشركة عن نفسها، والأسعار، وموقع النموذج داخل العائلة
- الرابط:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - الوصف: جميع الأرقام صادرة عن الجهة الرسمية نفسها
- الرابط:
-
بطاقة نموذج DeepMind: المواصفات وجدول المقارنة ثلاثي الأعمدة
- الرابط:
deepmind.google/models/model-cards/gemini-4-neon/ - الوصف: نتائج النماذج غير التابعة لـ Gemini تأتي افتراضيًا من إعلان كل جهة عن نفسها
- الرابط:
-
دليل مطوّري Google Cloud: معرّفات النماذج ومستويات التفكير وشرح الأخطاء
- الرابط:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - الوصف: أربعة مستويات للتفكير، والافتراضي هو high، وشروط تفعيل الخطأ HTTP 400
- الرابط:
-
صفحة الأسعار وأحدث النماذج في Google AI Studio: الأسعار الرسمية والتصنيف النوعي للسرعة
- الرابط:
aistudio.google.com/docs/pricing،aistudio.google.com/docs/latest-model - الوصف: التصنيفات الثلاثة Deliberate وModerate وFast
- الرابط:
-
مقال Artificial Analysis: مقارنة خارجية بين Neon وCarbon
- الرابط:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - الوصف: أرقام تقريبية مثل 21 دقيقة و36 دقيقة و57 token/ثانية
- الرابط:
-
صفحة نموذج Artificial Analysis: السرعات الأربع وبيانات النماذج المقارنة
- الرابط:
artificialanalysis.ai/models/gemini-4-neon - الوصف: قراءة بتاريخ 2026-11-19، المؤشر v5.0.1، وقسم FAQ يتضمّن أيضًا زمن أول رمز لكل مستوى
- الرابط:
-
جدول APIYI الشامل: الطُرز المتاحة على المنصة وأسعارها
- الرابط:
docs.apiyi.com/models.md - الوصف: الطُرز والأسعار تُعتمد وفقًا لقائمة الطُرز على المنصة
- الرابط:
المؤلف: فريق APIYI التقني
التواصل التقني: لأي استفسار حول تقدّم إتاحة Gemini 4 Neon أو حول الطُرز، يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لـ APIYI على apiyi.com