Note de l’auteur : la « rapidité » de Gemini 4 Neon peut se mesurer d’au moins trois façons. Cet article distingue le temps jusqu’au premier token, le débit de sortie par seconde et le temps nécessaire pour terminer une tâche, en précisant la source de chaque chiffre.
Gemini 4 Neon a été publié le 18 novembre 2026. Dans son billet de lancement, Sundar Pichai indique qu’il permet d’accomplir les tâches plus rapidement dans l’ingénierie logicielle complexe, le travail intellectuel et les processus scientifiques. Beaucoup de personnes ont lu cette phrase comme « le plus rapide dans tous les domaines ». En réalité, il existe au moins trois angles de mesure de la vitesse, et ils ne donnent pas le même classement.
Tous les chiffres de vitesse de cet article proviennent de la page du modèle Artificial Analysis et d’articles d’Artificial Analysis ; les scores proviennent des déclarations officielles et des fiches de modèle. Aucun n’a été mesuré par nous-mêmes. Les chiffres de sources et de méthodes différentes sont présentés côte à côte, sans calcul de moyenne et sans synthèse de nouveaux nombres.
L’essentiel : après avoir lu cet article, vous saurez distinguer le temps jusqu’au premier token, le débit de sortie par seconde et le temps par tâche de Gemini 4 Neon ; vous connaîtrez l’effet des quatre niveaux de réflexion sur la vitesse et les scores ; et vous saurez quel indicateur privilégier lors du choix d’un modèle.
Gemini 4 Neon : l’essentiel sur la vitesse
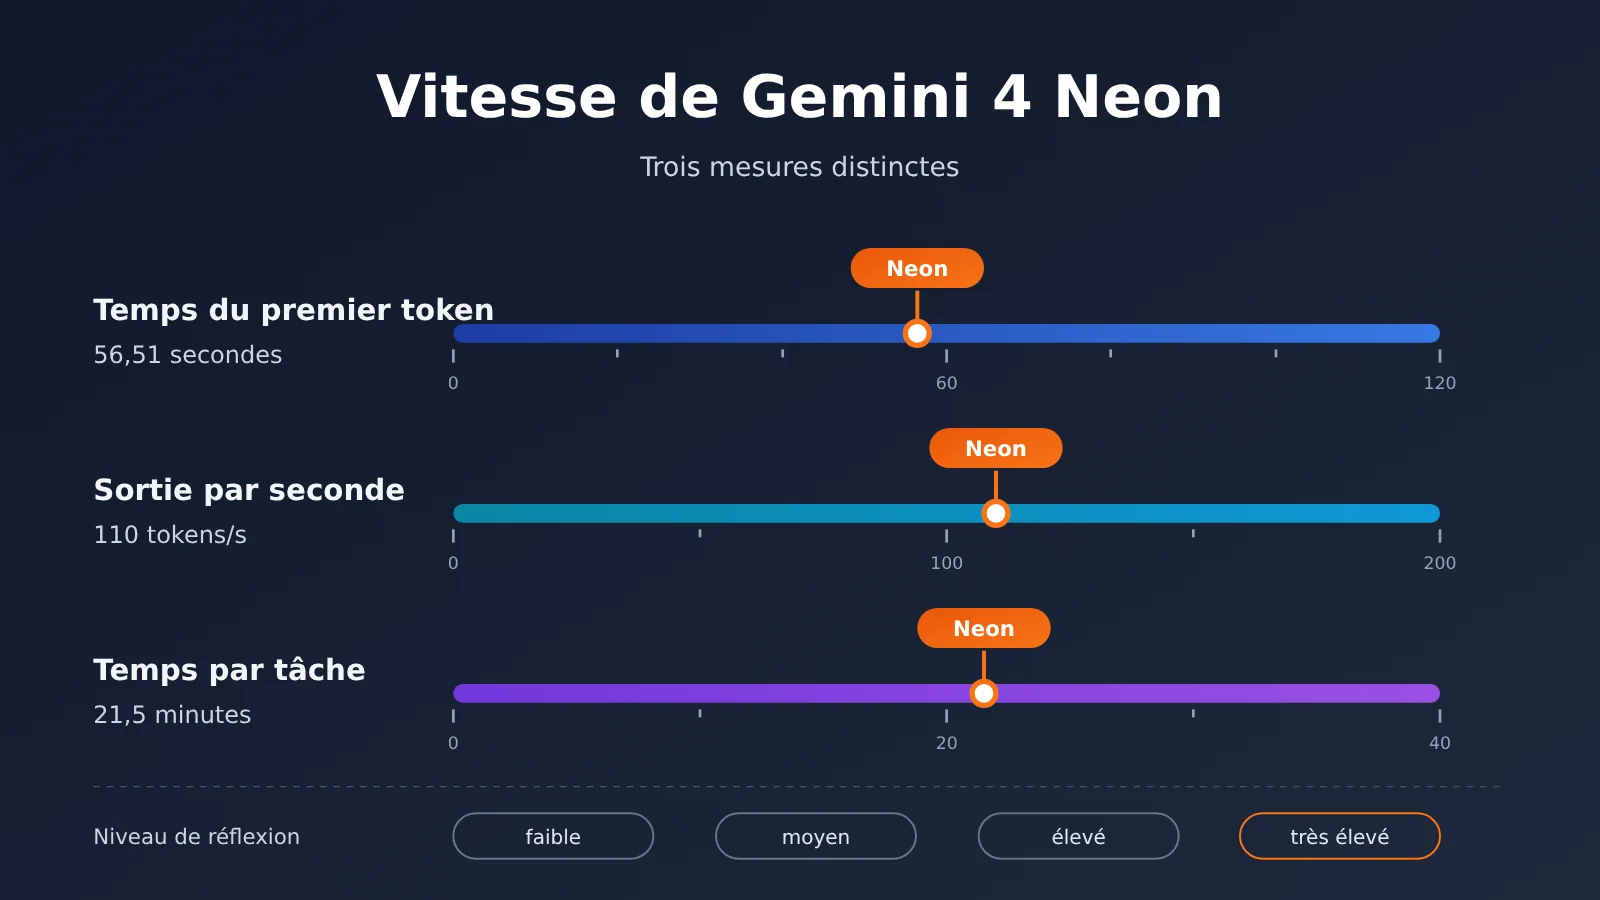
Commençons par bien distinguer trois indicateurs qu’on a vite fait de confondre. Dans le tableau ci-dessous, les valeurs de Neon correspondent au niveau xhigh et proviennent de la page modèle d’Artificial Analysis (consultée le 19/11/2026, indice v5.0.1).
| Indicateur | Signification | Valeur Gemini 4 Neon xhigh | Ce que ressent l’utilisateur |
|---|---|---|---|
| Temps jusqu’au premier token | L’attente entre l’envoi de la requête et l’apparition du premier token de réponse | 56,51 secondes | En interaction : « combien de temps avant que ça commence à écrire » |
| Tokens par seconde | Le nombre de tokens générés chaque seconde une fois la sortie lancée | 110 tokens/seconde | En streaming : « est-ce que ça défile vite » |
| Temps par tâche | Le temps moyen nécessaire pour traiter un exercice de l’indice | 21,5 minutes | Pour une tâche : « combien de temps avant la livraison » |
| Volume de sortie sur l’indice | Le nombre total de tokens produits sur l’ensemble de l’indice | 283 millions de tokens | L’autre moitié qui détermine le temps par tâche |
Pourquoi il faut regarder séparément les trois indicateurs de vitesse de Gemini 4 Neon
Le temps jusqu’au premier token est ce qui pèse le plus sur les interactions de type chat. Un modèle « raisonneur » doit d’abord boucler un raisonnement avant de cracher son premier token de réponse : le délai se compte donc souvent en secondes, parfois en minutes, et il est fortement corrélé au niveau de réflexion choisi.
Les tokens par seconde ne mesurent que le débit « une fois que ça a commencé à écrire », indépendamment de la quantité de texte que le modèle a à produire. Le temps par tâche, lui, dépend de deux choses en même temps : combien de tokens le modèle peut sortir par seconde, et combien de tokens l’exercice réclame au total. Un modèle peut afficher un débit très élevé et rester plus lent sur une tâche s’il a l’habitude de rédiger de très longs raisonnements. C’est exactement la situation de la comparaison, plus loin, entre Neon, GPT-6.2 Sol et GPT-6.2 Astra.
Fonctionnalités clés de Gemini 4 Neon : positionnement dans la famille et quatre niveaux de réflexion
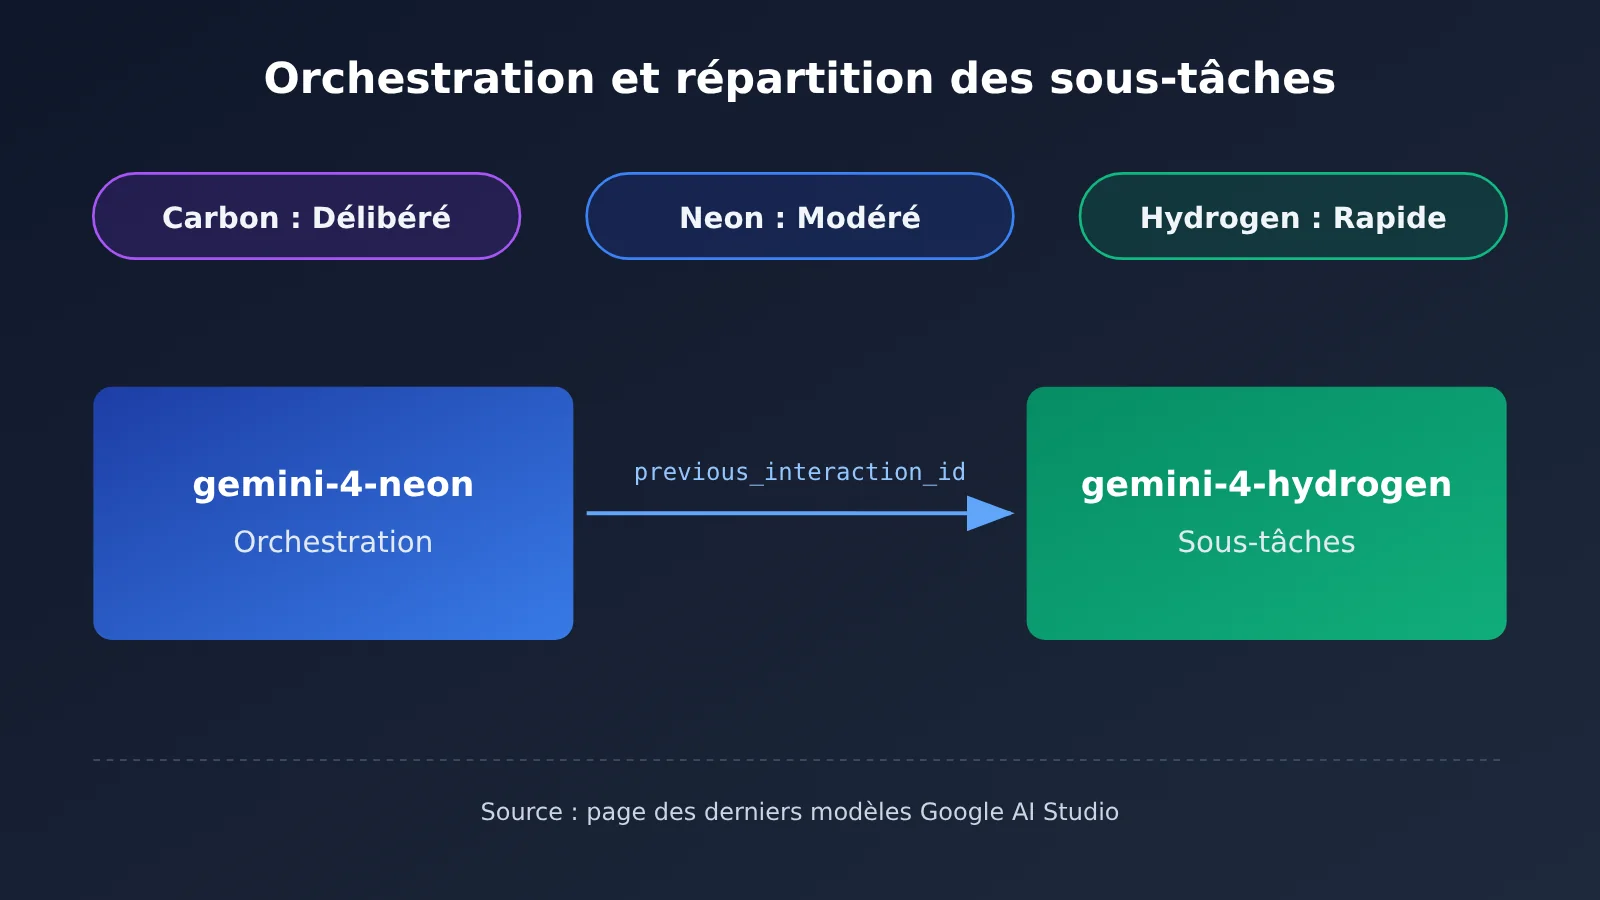
La dernière page de modèles de Google AI Studio attribue une étiquette de vitesse qualitative à chacun des trois modèles Gemini 4 : Carbon est « Deliberate », Neon « Moderate », Hydrogen « Fast ». Autrement dit, dans la classification officielle, Neon occupe le milieu de la famille, et c’est Hydrogen qui porte l’étiquette Fast. Le blog Google positionne lui aussi Carbon sur les tâches longues les plus difficiles, Hydrogen sur l’exécution rapide au quotidien, et Neon comme le compromis, destiné aux flux complexes à haute fréquence.
| Modèle | Étiquette de vitesse dans AI Studio | Niveaux de réflexion | Niveau par défaut | Position dans la famille (blog Google / guide développeur) |
|---|---|---|---|---|
| Gemini 4 Carbon | Deliberate | low, medium, high | medium | Tâches longues et complexes |
| Gemini 4 Neon | Moderate | low, medium, high, xhigh | high | Compromis, flux complexes à haute fréquence |
| Gemini 4 Hydrogen | Fast | Non détaillé dans les sources | Non détaillé dans les sources | Boucle rapide du quotidien |
Capacités et spécifications de Gemini 4 Neon
D’après la fiche modèle, Gemini 4 Neon est une adaptation de Gemini 4 Carbon, avec des connaissances arrêtées à mars 2026 ; en entrée, il accepte du texte, des images, de l’audio et de la vidéo, et sa fenêtre unifiée va jusqu’à 1 million de tokens. En sortie synchrone par défaut, 64 000 tokens maximum ; en décodage long en arrière-plan, jusqu’à 1 million de tokens. Le guide développeur de Google Cloud indique l’ID de modèle gemini-4-neon, avec un plafond unifié de 1048576 tokens, entrée et sortie comprises, la sortie incluant elle-même la réflexion, les appels de fonction et la réponse finale.
Côté capacités, l’Artificial Analysis Intelligence Index auto-déclaré par l’éditeur atteint 61 au niveau xhigh, soit la 3e place au classement général ; le blog reconnaît d’ailleurs qu’il reste derrière les modèles plus gros et plus lents. Le tableau comparatif de la fiche modèle ne comporte que trois colonnes : Neon, Claude Opus 5.5 et GPT-6.2 Sol. Les résultats non Gemini sont par défaut repris des déclarations de chaque éditeur : ce tableau est donc une synthèse officielle, et non une réévaluation faite le même jour par un même laboratoire. On y trouve aussi des lignes où Neon est distancé, par exemple sur Terminal-bench 4.1, où la précision ajustée (correction de triche) place Opus 5.5 à 65,8 %, au-dessus des 65,2 % de Neon.
Le guide développeur propose également un usage en orchestration : gemini-4-neon sert de contrôleur principal et transmet previous_interaction_id à gemini-4-hydrogen pour exécuter plus vite des sous-tâches. Si vous trouvez Neon trop lent, cette piste mérite davantage d’attention que de simplement baisser le niveau (c’est notre avis, pas une citation du guide).
Gemini 4 Neon : données de vitesse et analyse niveau par niveau des quatre modes de réflexion
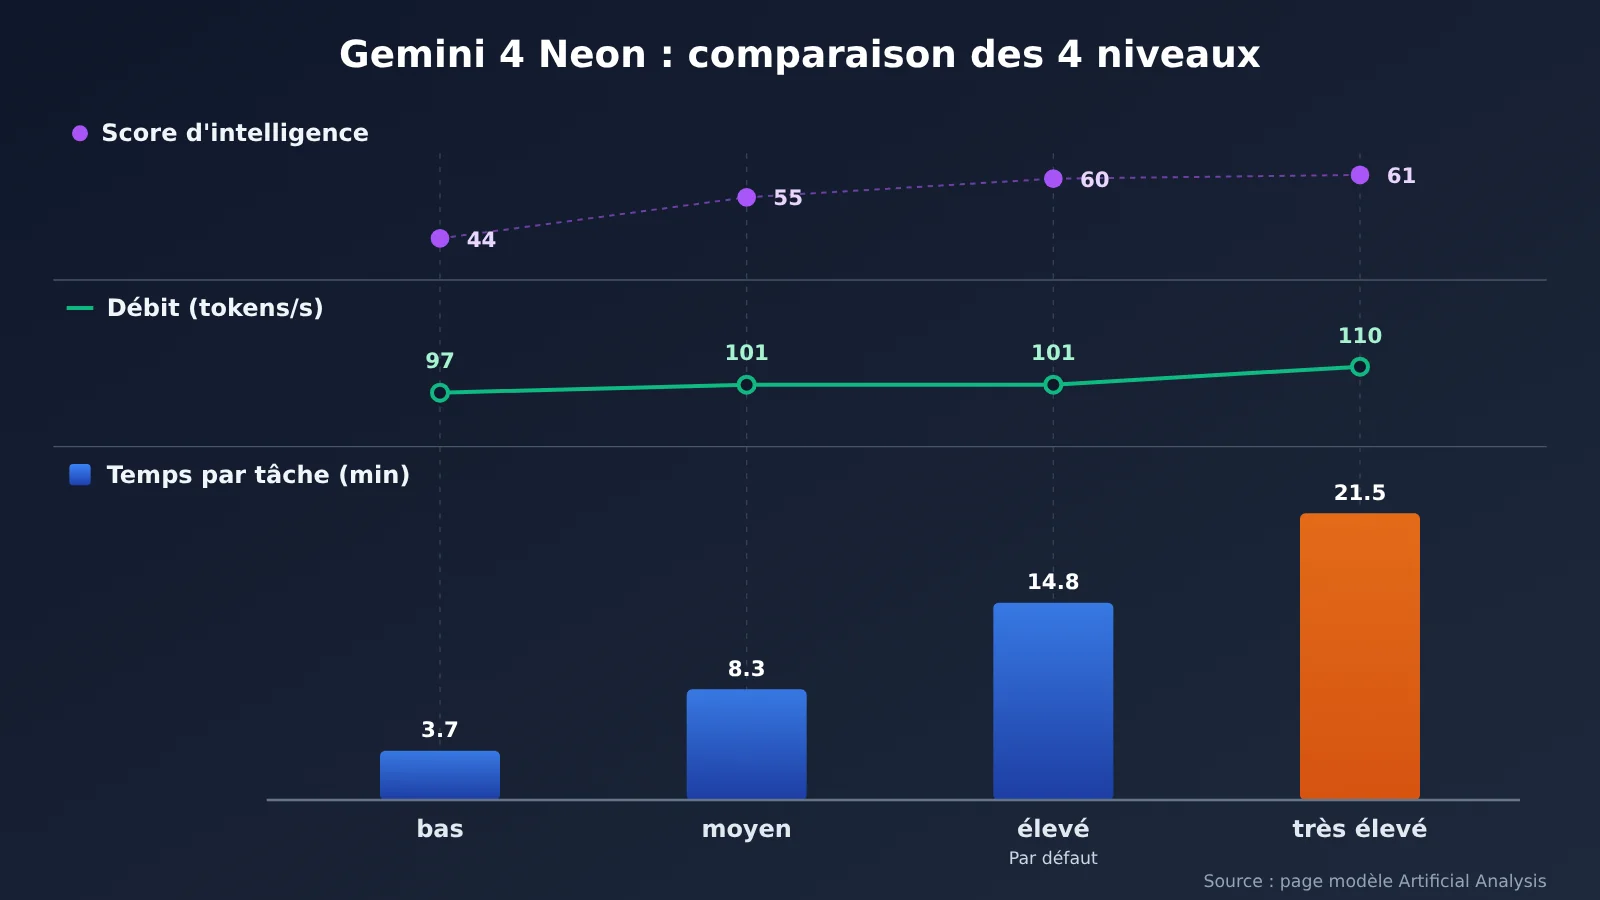
Le tableau ci-dessous vient de la page modèle d’Artificial Analysis. Un point à part pour le temps jusqu’au premier token, dans la colonne de droite : le tableau récapitulatif de la page ne donne que 56.51 secondes pour xhigh ; les valeurs de high, medium et low proviennent de la section FAQ de la même page, pas de la même colonne. Pensez à conserver cette source quand vous les citez.
| Niveau de réflexion | Score d’intelligence | Temps par tâche | Débit de sortie | Temps jusqu’au premier token (section FAQ de la page modèle) |
|---|---|---|---|---|
| xhigh | 61 | 21.5 minutes | 110 tokens/seconde | 56.51 secondes |
| high (par défaut) | 60 | 14.8 minutes | 101 tokens/seconde | 40.64 secondes |
| medium | 55 | 8.3 minutes | 101 tokens/seconde | 20.14 secondes |
| low | 44 | 3.7 minutes | 97 tokens/seconde | 13.93 secondes |
À la lecture de ce tableau, le débit de sortie des quatre niveaux ne fluctue qu’entre 97 et 110 tokens/seconde, alors que le temps par tâche passe de 3.7 à 21.5 minutes. Ce que l’on change en ajustant le niveau, c’est surtout « combien il faut réfléchir », pas « à quelle vitesse il écrit ». C’est une déduction tirée des chiffres du tableau ; la page du modèle ne le formule pas ainsi.
Le coût en score est tout aussi net. Passer du niveau high par défaut (60 points) à medium ne fait perdre que 5 points ; passer à low fait tomber à 44 points. xhigh ne gagne qu’un point par rapport à high, mais ajoute près de 7 minutes par tâche : le gain en vaut-il la peine ? Cela dépend de votre tâche.
Gemini 4 Neon produit plus de tokens par seconde : pourquoi une tâche peut-elle malgré tout durer plus longtemps ?
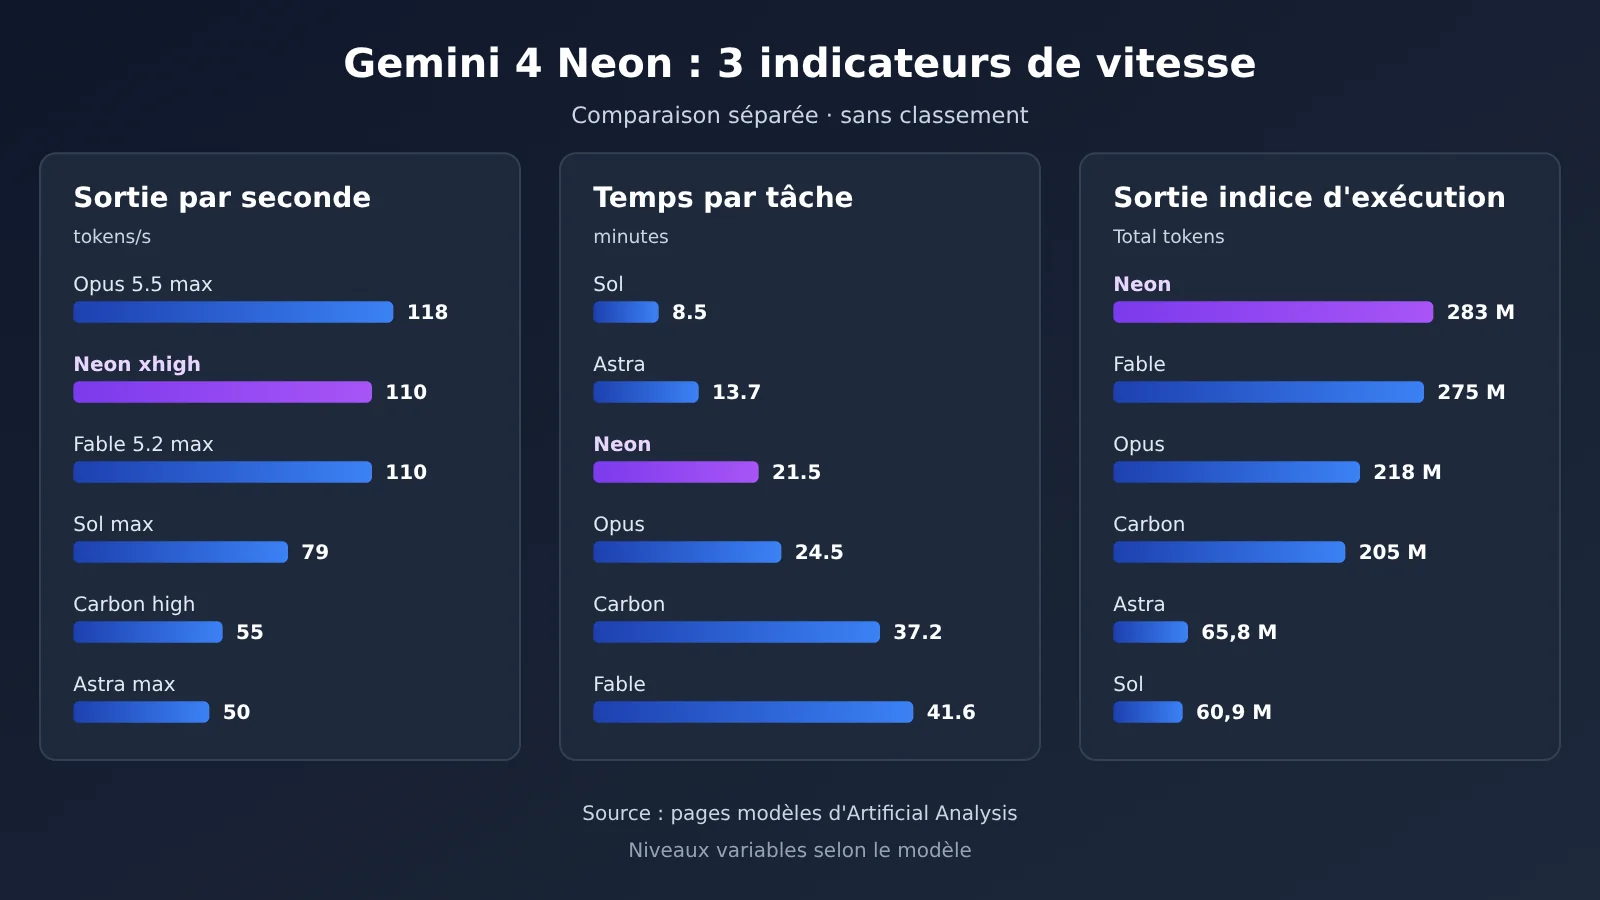
La page modèle d’Artificial Analysis indique que Neon en mode xhigh, sur l’ensemble de l’indice, génère 283 millions de tokens en sortie pour 8,12 milliards de tokens en entrée. Plus le volume de tokens produits est élevé, plus la durée totale s’allonge — même à 110 tokens par seconde. GPT-6.2 Astra, au niveau max, ne dépasse pas 50 tokens par seconde, mais sur l’indice il ne produit que 65,8 millions de tokens, ce qui donne 13,7 minutes par tâche. GPT-6.2 Sol, au niveau max, atteint 79 tokens par seconde avec 60,9 millions de tokens produits, soit 8,5 minutes par tâche.
Autrement dit, « produire plus de tokens par seconde » et « terminer la tâche plus tôt » sont deux choses distinctes. Si l’on compare Neon à ces deux modèles GPT, Neon affiche un débit de sortie supérieur tout en prenant plus de temps par tâche : la raison tient simplement au fait qu’il produit beaucoup plus de tokens.
Gemini 4 Neon comparé séparément aux modèles de référence
Tous les chiffres du tableau ci-dessous proviennent de la page de modèle d’Artificial Analysis. Les niveaux d’effort diffèrent selon les modèles (xhigh pour Neon, high pour Carbon, max pour les autres) : on peut seulement observer les relations relatives au sein d’une même colonne, sans les traiter comme une course à conditions égales.
| Modèle (niveau) | Score d’intelligence | Temps par tâche | Débit de sortie (tokens/s) | Temps jusqu’au premier token | Tokens de sortie pour l’exécution de l’indice |
|---|---|---|---|---|---|
| Gemini 4 Neon (xhigh) | 61 | 21,5 minutes | 110 | 56,51 secondes | 283 millions |
| Gemini 4 Carbon (high) | 60 | 37,2 minutes | 55 | 73,04 secondes | 205 millions |
| Claude Opus 5.5 (max) | 59 | 24,5 minutes | 118 | 335,85 secondes | 218 millions |
| Claude Fable 5.2 (max) | 65 | 41,6 minutes | 110 | 247,46 secondes | 275 millions |
| GPT-6.2 Astra (max) | 62 | 13,7 minutes | 50 | 197,65 secondes | 65,8 millions |
| GPT-6.2 Sol (max) | 57 | 8,5 minutes | 79 | 75,06 secondes | 60,9 millions |
Regardons les trois indicateurs un par un :
- Débit de sortie : Claude Opus 5.5 max atteint 118 tokens/s, contre 110 pour Neon xhigh ; Claude Fable 5.2 max est à 110, comme Neon.
- Temps par tâche : les 8,5 minutes de GPT-6.2 Sol max et les 13,7 minutes de GPT-6.2 Astra max sont toutes deux inférieures aux 21,5 minutes de Neon xhigh.
- Temps jusqu’au premier token : les 56,51 secondes de Neon xhigh sont la valeur la plus faible de ce tableau, mais comme les niveaux d’effort varient d’une ligne à l’autre, on ne peut pas en déduire qu’il est globalement en tête.
L’accélération de Neon par rapport à Carbon se lit sur deux bases. La page de modèle d’Artificial Analysis indique, pour Carbon high, 55 tokens/s et 37,2 minutes. L’article d’Artificial Analysis donne des ordres de grandeur : Neon met environ 21 minutes par tâche, soit environ 40 % de moins que les quelque 36 minutes de Carbon ; le gain vient d’un débit de sortie d’environ 110 contre environ 57 tokens/s, tandis que Neon produit environ 15 % de tokens de sortie en plus par tâche. Les deux séries de chiffres pour Carbon ne reposent pas sur la même base de mesure ; on ne les soustrait donc pas ici.
Comment démarrer rapidement : choix du niveau Gemini 4 Neon et méthode de mesure de vitesse
gemini-4-neon doit actuellement être appelé via les canaux officiels de Google. Les étapes ci-dessous se divisent en deux parties : d’abord comment choisir le niveau de Neon, puis comment mettre en place une procédure de mesure de vitesse avec les modèles Gemini 4 déjà disponibles sur APIYI, afin de pouvoir simplement changer l’ID du modèle lorsque Neon sera disponible.
Étape 1 : comprendre les quatre niveaux de réflexion de Neon. Le guide pour les développeurs de Google Cloud précise que gemini-4-neon ne dispose que des niveaux de réflexion low, medium, high et xhigh, avec high par défaut. Passer thinking_budget ou MINIMAL renvoie une erreur HTTP 400 ; c’est l’erreur la plus fréquente dans le code migré depuis l’ancienne version de Gemini.
Étape 2 : réduire le niveau selon les besoins de vitesse. Si vous trouvez le modèle lent, vous pouvez passer du niveau high par défaut à medium ou low. D’après la page du modèle sur Artificial Analysis, le temps par tâche passe de 14.8 minutes avec high à 8.3 minutes ou 3.7 minutes, tandis que le score d’intelligence passe de 61 avec xhigh (60 avec high par défaut) à 55 ou 44. La chute de score avec low est importante ; avant de réduire le niveau, mieux vaut d’abord vérifier sur un échantillon de vos propres tâches.
Étape 3 : préparer un compte APIYI et une clé API. Inscrivez-vous sur APIYI apiyi.com et obtenez une clé API, placez la clé dans une variable d’environnement (par exemple APIYI_API_KEY), et dans le code ne lisez que la variable d’environnement, sans jamais écrire la clé en clair.
Étape 4 : choisir le mode d’appel. Pour l’interface compatible OpenAI, renseignez https://api.apiyi.com/v1 comme base_url et indiquez gemini-4-carbon ou gemini-4-hydrogen comme nom de modèle parmi ceux déjà disponibles ; si vous passez par le protocole natif Gemini, utilisez l’adresse https://api.apiyi.com avec la version d’API v1beta.
Étape 5 : enregistrer trois indicateurs séparément. Activez la sortie en flux stream, puis notez séparément le moment où le premier token de réponse arrive, le nombre de tokens par seconde après le début de la sortie, et le temps total jusqu’à la fin de la tâche, ainsi que le nombre total de tokens générés cette fois. Ce n’est qu’avec le nombre de tokens de sortie que vous pourrez déterminer si la durée vient du fait que le modèle « écrit lentement » ou qu’il « écrit beaucoup ».
🚀 Conseil pour démarrer rapidement : il vaut mieux commencer par faire fonctionner la procédure de mesure de vitesse sur un modèle Gemini 4 déjà disponible. Avec une seule clé, APIYI couvre à la fois les séries Gemini, Claude et GPT ; le script qui enregistre les trois indicateurs, écrit une seule fois, permet de comparer plusieurs modèles côte à côte, et une fois Neon disponible, il suffira de modifier l’ID du modèle.
Tarification de Gemini 4 Neon et vérification des modèles sur APIYI
Le prix officiel de Gemini 4 Neon (page de tarification de Google AI Studio) est de 3 dollars par million de tokens en entrée et de 15 dollars par million de tokens en sortie.
Chez APIYI, nous avons vérifié deux sources : le tableau maître APIYI (docs.apiyi.com/models.md, page marquée comme mise à jour le 2026-11-16 09:39, UTC+8), et l’API de tarification interrogée le 2026-11-19 (api.apiyi.com/api/pricing, version shell-api-modelmak-v1, 285 modèles au total). Voici les modèles déjà disponibles que l’on peut comparer entre les deux sources, en dollars par million de tokens.
| ID du modèle | Entrée | Lecture cache | Sortie | Endpoint | Remarque (source) |
|---|---|---|---|---|---|
gemini-4-carbon |
2 | 0.1 | 10 | chat, gemini | correspond au prix de lancement de Google jusqu’au 2026-11-30 (tableau maître APIYI) |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | chat, gemini | tableau maître APIYI |
claude-opus-5-5 / claude-opus-5-5-thinking |
4 | 0.2 | 20 | chat, messages | tableau maître APIYI |
claude-fable-5-2 / claude-fable-5-2-thinking |
8 | 0.2 | 40 | chat, messages | tableau maître APIYI |
gpt-6.2-sol |
2 (3 au-delà de 272000) | 0.1 | 10 (environ 11.25 pour le palier haut de l’API de tarification) | responses (recommandé), chat | le tableau maître ne mentionne que le changement de palier d’entrée |
gpt-6.2-astra |
8 (16 au-delà de 272000) | 0.4 | 40 (environ 60 pour le palier haut de l’API de tarification) | responses, chat | le tableau maître ne mentionne que le changement de palier d’entrée |
Quelques détails méritent l’attention. Le prix affiché de gemini-4-carbon correspond bien au prix de lancement de Google, et non au tarif standard ultérieur de 4/20. Les noms de groupes ne s’écrivent pas tout à fait de la même façon dans les deux sources : pour les modèles Gemini, le tableau maître indique Default, SVIP, tandis que l’API de tarification indique default, svip ; pour les modèles Claude, le tableau maître indique ClaudeCode, Claude_Reverse, Claude_Enterprise, Default, SVIP, alors que l’API de tarification indique ClaudeCode, ClaudeCodeReverse, ClaudeOfficial, default, svip. Le tarif de sortie du palier haut des modèles GPT n’apparaît que dans l’API de tarification : celle-ci fait passer CompletionRatio de 5 à 3.75 au-delà de 272000 tokens.
gemini-4-neon n’est répertorié ni dans le tableau maître APIYI ni dans l’API de tarification ; il n’est pas encore disponible. Nous le mettrons en ligne dès que possible ; les modèles et les prix font foi selon la liste des modèles de la plateforme.
Analyse des avantages et inconvénients de Gemini 4 Neon
Avantages
- Débit de sortie supérieur aux modèles précédents de la famille : la page du modèle sur Artificial Analysis indique 110 tokens/s pour Neon xhigh, contre 55 tokens/s pour Carbon high.
- Attente du premier token relativement courte : 56.51 secondes pour le premier token de xhigh, la valeur la plus faible du tableau comparatif ci-dessus (niveaux différents, à titre indicatif seulement).
- Granularité fine des niveaux : quatre niveaux de réflexion, de 3.7 minutes pour low à 21.5 minutes pour xhigh, ce qui permet de choisir en fonction de la tâche.
- Spécifications complètes : la fiche du modèle liste les entrées texte, image, audio et vidéo, ainsi qu’une fenêtre unifiée de 1 million de tokens ; le guide du développeur précise que le cache implicite s’active automatiquement pour les préfixes partagés de plus de 4096 tokens.
Limites
- Trop de tokens en sortie : l’exécution génère 283 millions de tokens en sortie, ce qui rend une tâche unique en xhigh plus longue qu’avec Sol et Astra. La parade consiste à descendre d’un niveau, ou à confier les sous-tâches à Hydrogen.
- La qualification officielle n’est que Moderate : AI Studio a attribué le label Fast à Hydrogen ; pour les scénarios qui recherchent l’interaction la plus rapide, il faut d’abord essayer Hydrogen.
- Certaines configurations ne sont pas prises en charge : le guide du développeur précise que le cache de contexte explicite n’est pas pris en charge, et que
thinking_budgetavecMINIMALrenvoie une erreur400. - Pas de niveau gratuit : la page de tarification d’AI Studio indique que
gemini-4-neonn’a pas de niveau gratuit. - Des référentiels de mesure hétérogènes : le Coding Agent Index est de 58.6 sur le blog de Google et de 59 dans l’article d’Artificial Analysis ; les 12.8 % et 39.0 % de SWE-sweep proviennent de deux harness différents. Quand on lit les chiffres, il faut bien vérifier la source.
Questions fréquentes (FAQ)
Q1 : Gemini 4 Neon est-il le plus rapide de la famille Gemini 4 ?
D’après la classification de la page des modèles la plus récente de Google AI Studio, Hydrogen est « Fast », Neon « Moderate » et Carbon « Deliberate ». Quand la documentation officielle parle de « terminer plus vite », c’est essentiellement par rapport à Carbon.
Q2 : Combien de temps faut-il attendre pour le premier token avec Gemini 4 Neon ?
Le tableau récapitulatif de la page modèle d’Artificial Analysis donne 56.51 secondes pour le premier token en xhigh. La rubrique FAQ de la même page indique séparément 40.64 s en high, 20.14 s en medium et 13.93 s en low ; ces trois chiffres viennent de la rubrique FAQ, pas du tableau récapitulatif.
Q3 : Pourquoi Gemini 4 Neon sort-il 110 tokens par seconde et met-il quand même 21.5 minutes par tâche ?
Parce qu’il produit beaucoup de tokens. La page modèle d’Artificial Analysis note que Neon en xhigh génère 2.83 亿 tokens sur le benchmark d’indice, contre seulement 6090 万 pour Sol max et 6580 万 pour Astra max : ces deux derniers sont donc plus lents à la seconde, mais finissent leur tâche plus tôt.
Q4 : Quel niveau Gemini 4 Neon utilise-t-il par défaut ? Et comment régler pour aller plus vite ?
Le guide du développeur précise que la valeur par défaut est high. Pour aller plus vite, on peut descendre en medium ou low : d’après la page modèle d’Artificial Analysis, le temps par tâche passe alors à 8.3 minutes et 3.7 minutes respectivement, et le score d’intelligence chute de 61 en xhigh (60 en high) à 55 ou 44.
Q5 : Peut-on déjà appeler Gemini 4 Neon via APIYI ?
Au 2026-11-19, `gemini-4-neon` n’apparaît encore ni dans le tableau général ni dans l’interface de tarification d’APIYI : le modèle n’est pas encore disponible, mais nous le mettrons en ligne dès que possible. En attendant, vous pouvez vous inscrire sur apiyi.com et préparer votre procédure de test de vitesse avec `gemini-4-carbon` ou `gemini-4-hydrogen`, déjà disponibles ; l’adresse compatible OpenAI est la même que dans le démarrage rapide ci-dessus.
Q6 : Combien Gemini 4 Neon est-il moins cher que Carbon ?
Il y a trois comptes différents : le blog de Google annonce un coût par tâche inférieur de 32 % à celui de Carbon en high par défaut ; l’article d’Artificial Analysis parle d’environ 17 % de moins que le prix non remisé de Carbon ; la page modèle d’Artificial Analysis calcule 4.90 dollars par tâche pour Carbon en high au tarif de lancement. Ces trois bases de calcul diffèrent : impossible de les fusionner en un seul chiffre.
Q7 : Les scores de Gemini 4 Neon sont-ils directement comparables à ceux des concurrents ?
Il faut rester prudent. La fiche du modèle précise que les résultats non-Gemini proviennent par défaut des déclarations de chaque éditeur : c’est une compilation officielle, pas une re-mesure le même jour ; et la comparaison d’Artificial Analysis mélange les niveaux d’effort (xhigh, high et max ensemble).
Gemini 4 Neon — Points clés
- Trois mesures de vitesse : le temps jusqu’au premier token, les tokens par seconde et la durée d’une tâche sont indépendants les uns des autres, et leurs classements peuvent se contredire.
- Positionnement officiel intermédiaire : AI Studio classe Neon en « Moderate », alors que c’est Hydrogen qui est « Fast ».
- Données xhigh : la page modèle d’Artificial Analysis affiche 61 points, 21,5 minutes, 110 tokens/seconde et 56,51 secondes jusqu’au premier token.
- Le volume de sortie allonge la durée : 283 millions de tokens de sortie font que la durée d’une tâche de Neon dépasse celle de Sol et d’Astra.
- Pas le plus haut débit par seconde : les 118 tokens/seconde d’Opus 5.5 max dépassent les 110 de Neon.
- Rétrograder pour gagner en vitesse : medium 8,3 minutes et 55 points, low 3,7 minutes et 44 points, high par défaut.
- Disponibilité actuelle : APIYI ne propose pas encore Neon, mais vous pouvez déjà préparer votre protocole de mesure avec les modèles Gemini 4 déjà disponibles.
En résumé
Les conclusions essentielles sur la vitesse de Gemini 4 Neon :
- Nettement plus rapide que Carbon : les deux jeux de données d’Artificial Analysis montrent que le débit par seconde de Neon vaut environ le double de celui de Carbon, avec une durée de tâche bien plus courte.
- Pas en tête partout dès qu’on élargit le comparatif : le débit par seconde reste inférieur à Opus 5.5 max, et la durée d’une tâche dépasse celle de Sol max et d’Astra max.
- Le niveau est le principal levier : le débit par seconde varie peu entre les quatre niveaux, l’écart de durée venant surtout du nombre de tokens de réflexion.
Notre avis : pour les scénarios interactifs, regardez d’abord le temps jusqu’au premier token ; pour le traitement par lots, la durée d’une tâche ; pour l’expérience en streaming, concentrez-vous sur le débit par seconde. Savoir si Neon est « assez rapide » dépend de ce qui compte pour vous. Nous conseillons de commencer par mettre en place, via APIYI (apiyi.com), le protocole d’enregistrement de ces trois indicateurs avec les modèles Gemini 4 existants ; une fois Neon disponible, il suffira de changer de modèle pour faire la comparaison.
📚 Références
-
Post de publication de Sundar Pichai : lancement de Gemini 4 Neon et périmètre de disponibilité
- Lien :
x.com/sundarpichai/status/2123167780988125621 - Description : canal de publication et formulation officielle « terminer plus vite »
- Lien :
-
Blog Google « Introducing Gemini 4 Neon » : scores autodéclarés, tarifs et positionnement dans la famille
- Lien :
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Description : tous les chiffres sont des données autodéclarées par l’éditeur
- Lien :
-
Fiche modèle DeepMind : spécifications et tableau comparatif à trois colonnes
- Lien :
deepmind.google/models/model-cards/gemini-4-neon/ - Description : les résultats des modèles autres que Gemini proviennent par défaut des autodéclarations de chaque fournisseur
- Lien :
-
Guide développeur Google Cloud : ID de modèle, niveaux de réflexion et messages d’erreur
- Lien :
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Description : quatre niveaux de réflexion,
highpar défaut, conditions de déclenchement du HTTP 400
- Lien :
-
Pages tarifs et derniers modèles de Google AI Studio : prix officiels et caractérisation qualitative de la vitesse
- Lien :
aistudio.google.com/docs/pricing,aistudio.google.com/docs/latest-model - Description : les trois niveaux Deliberate, Moderate, Fast
- Lien :
-
Article d’Artificial Analysis : comparaison tierce entre Neon et Carbon
- Lien :
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Description : environ 21 minutes, environ 36 minutes, environ 57 tokens/seconde et autres valeurs approximatives
- Lien :
-
Page modèle d’Artificial Analysis : vitesses des quatre niveaux et données des modèles de référence
- Lien :
artificialanalysis.ai/models/gemini-4-neon - Description : consultation du 2026-11-19, indice v5.0.1, la section FAQ indique aussi le temps jusqu’au premier token pour chaque niveau
- Lien :
-
Tableau récapitulatif APIYI : modèles déjà disponibles et prix
- Lien :
docs.apiyi.com/models.md - Description : les modèles et les prix sont ceux du catalogue de la plateforme
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : pour l’avancement de la mise en ligne de Gemini 4 Neon et les questions sur les modèles, contactez-nous depuis la page d’accueil d’APIYI apiyi.com