Anmerkung des Autors: Auf Basis der offiziellen Google-Preise wird hier die Preisgestaltung von Gemini 4 Neon in ihre drei Kategorien – Eingabe, implizites Caching und Ausgabe – zerlegt. Dabei wird erklärt, dass Reasoning-Tokens zur Ausgabe zählen, dass es keine kostenlose Stufe gibt und dass explizites Caching nicht unterstützt wird. Außerdem gibt es ein Rechenbeispiel mit ganzzahligen Tokens und eine Methode zum Abgleich mit der Übersichtstabelle von APIYI.
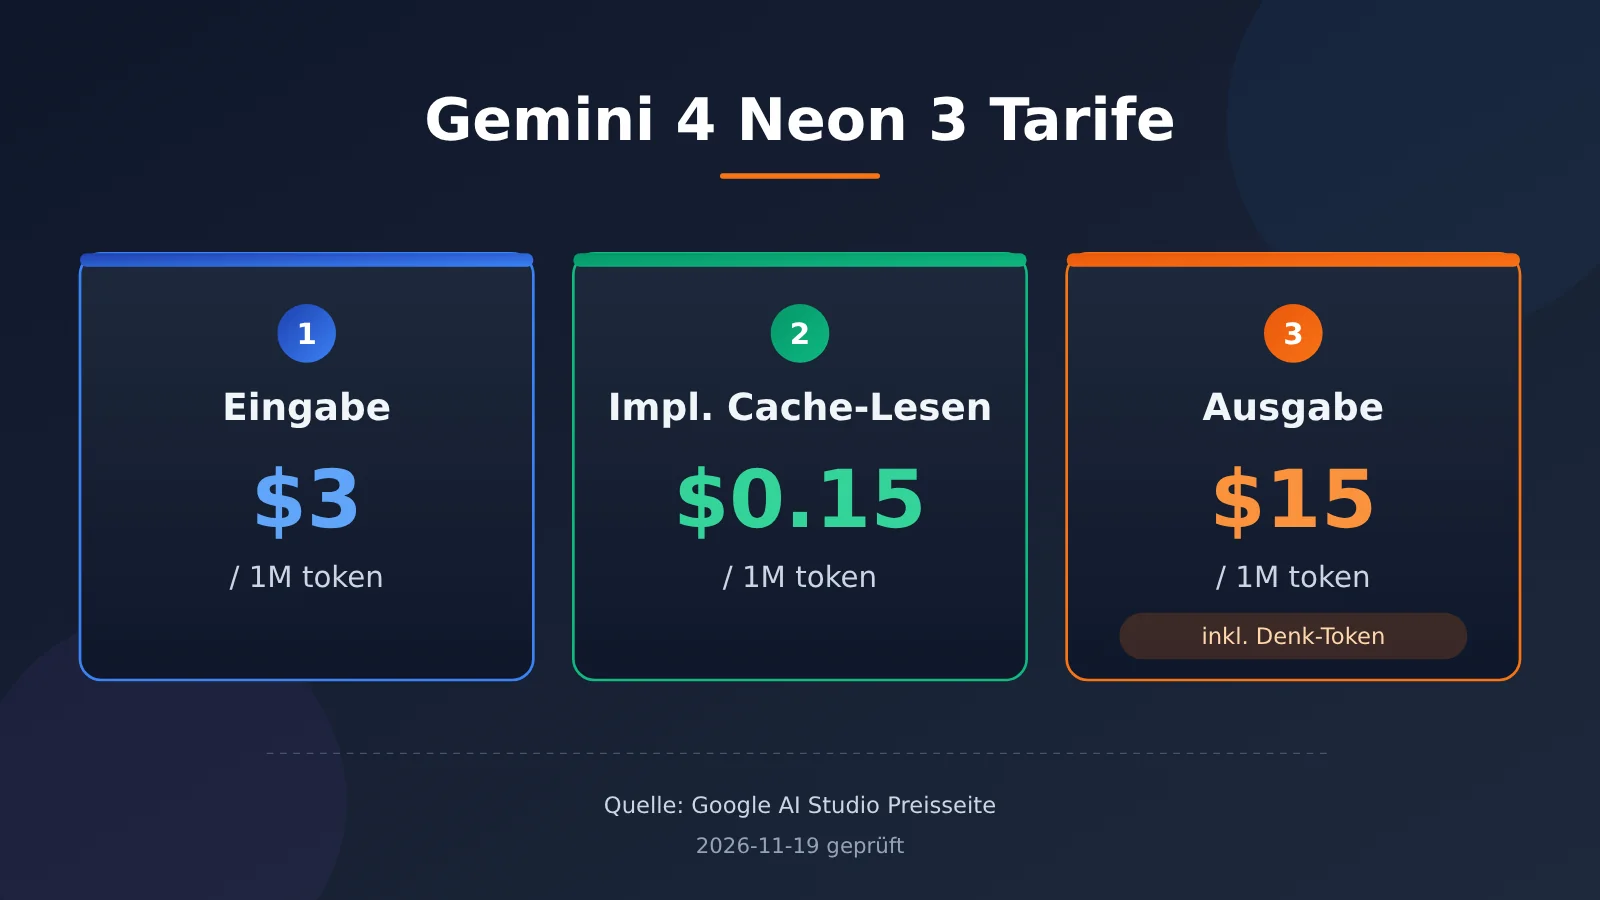
Nach der Veröffentlichung von Gemini 4 Neon am 18.11.2026 ist für viele Entwickler die erste Frage, wie viel ein einzelner Aufruf kostet. Die „Kosten pro Aufgabe“ in den Ranglisten sind ein gewichtetes Ergebnis aus dem Durchlauf eines gesamten Bewertungsindex – das ist etwas anderes als eine einzelne Anfrage auf Ihrer Rechnung. Dieser Artikel zerlegt die drei Kategorien der Gemini 4 Neon-Preisgestaltung: Eingabe 3 US-Dollar, Lesen aus dem impliziten Cache 0,15 US-Dollar, Ausgabe 15 US-Dollar – Kategorie für Kategorie – und erklärt, zu welcher Kategorie die Reasoning-Tokens gehören.
Die Preisinformationen in diesem Artikel stammen von der Preisseite von Google AI Studio, dem Google Cloud Developer Guide, der DeepMind-Modellkarte, Artikeln und Modellseiten von Artificial Analysis sowie der Übersichtstabelle und der Preis-API von APIYI. Stichtag der Datenprüfung ist der 19.11.2026; jede Zahl ist mit Quelle belegt, und wo die Bezugsgrößen nicht übereinstimmen, sind beide Varianten beibehalten.
Kernnutzen: Nach der Lektüre dieses Artikels können Sie mit Ihren eigenen Token-Zahlen per Formel die Kosten eines einzelnen Gemini 4 Neon-Aufrufs berechnen, wissen, in welcher Kategorie ein Cache-Treffer spart, und wissen, wie Sie in der Übersichtstabelle von APIYI apiyi.com die Regalpreise der Modelle derselben Familie nachschlagen.
Die wichtigsten Punkte zur Preisgestaltung von Gemini 4 Neon
Zuerst fassen wir die offiziell angegebenen Preisbedingungen in einer Tabelle zusammen. Die Preise und Cache-Regeln in der folgenden Tabelle stammen von der Preisseite von Google AI Studio und dem Entwicklerhandbuch von Google Cloud, die Obergrenzen für Kontext und Ausgabe aus dem Entwicklerhandbuch und der Modellkarte.
| Punkt | Offizielle Angabe | Was das für Ihre Rechnung bedeutet |
|---|---|---|
| Eingabe | 3,00 US-Dollar pro Million Token (Preisseite von AI Studio) | Eingabeaufforderungen, Dokumente und Verlaufsnachrichten werden alle zu diesem Satz abgerechnet |
| Zwischengespeicherte Eingabe | 0,15 US-Dollar pro Million Token, nur implizites Caching wird unterstützt (Preisseite von AI Studio) | Ein getroffener gemeinsamer Präfix wird mit 0,15 abgerechnet, das sind gegenüber 3 US-Dollar ein Rabatt von 95 % (Google-Blog, offizielle Angabe) |
| Ausgabe | 15,00 US-Dollar pro Million Token, inklusive Denk-Token (Preisseite von AI Studio) | Je tiefer das Nachdenken, desto größer dieser Posten |
| Kostenlose Stufe | Keine kostenlose Stufe (Preisseite von AI Studio) | Die Abrechnung beginnt ab dem ersten Aufruf |
| Explizites Caching | Explizites Kontext-Caching wird nicht unterstützt (Entwicklerhandbuch von Google Cloud) | Cache-Objekte können nicht manuell erstellt werden, man ist auf automatische Treffer angewiesen |
| Schwelle für implizites Caching | Gemeinsame Präfixe über 4096 Token greifen automatisch, dauerhaftes Caching ist standardmäßig aktiviert (Entwicklerhandbuch) | Kurze Eingabeaufforderungen kommen praktisch nicht in den Genuss des Cache-Preises |
| Kontext | Einheitliche Obergrenze von 1048576 Token, einschließlich Eingabe und Ausgabe (Entwicklerhandbuch); die Modellkarte gibt ein einheitliches Fenster von maximal 1 Million an | Bei langen Dokumenten wird der Eingabeanteil sehr hoch ausfallen |
Thinking-Token in der Preisgestaltung von Gemini 4 Neon
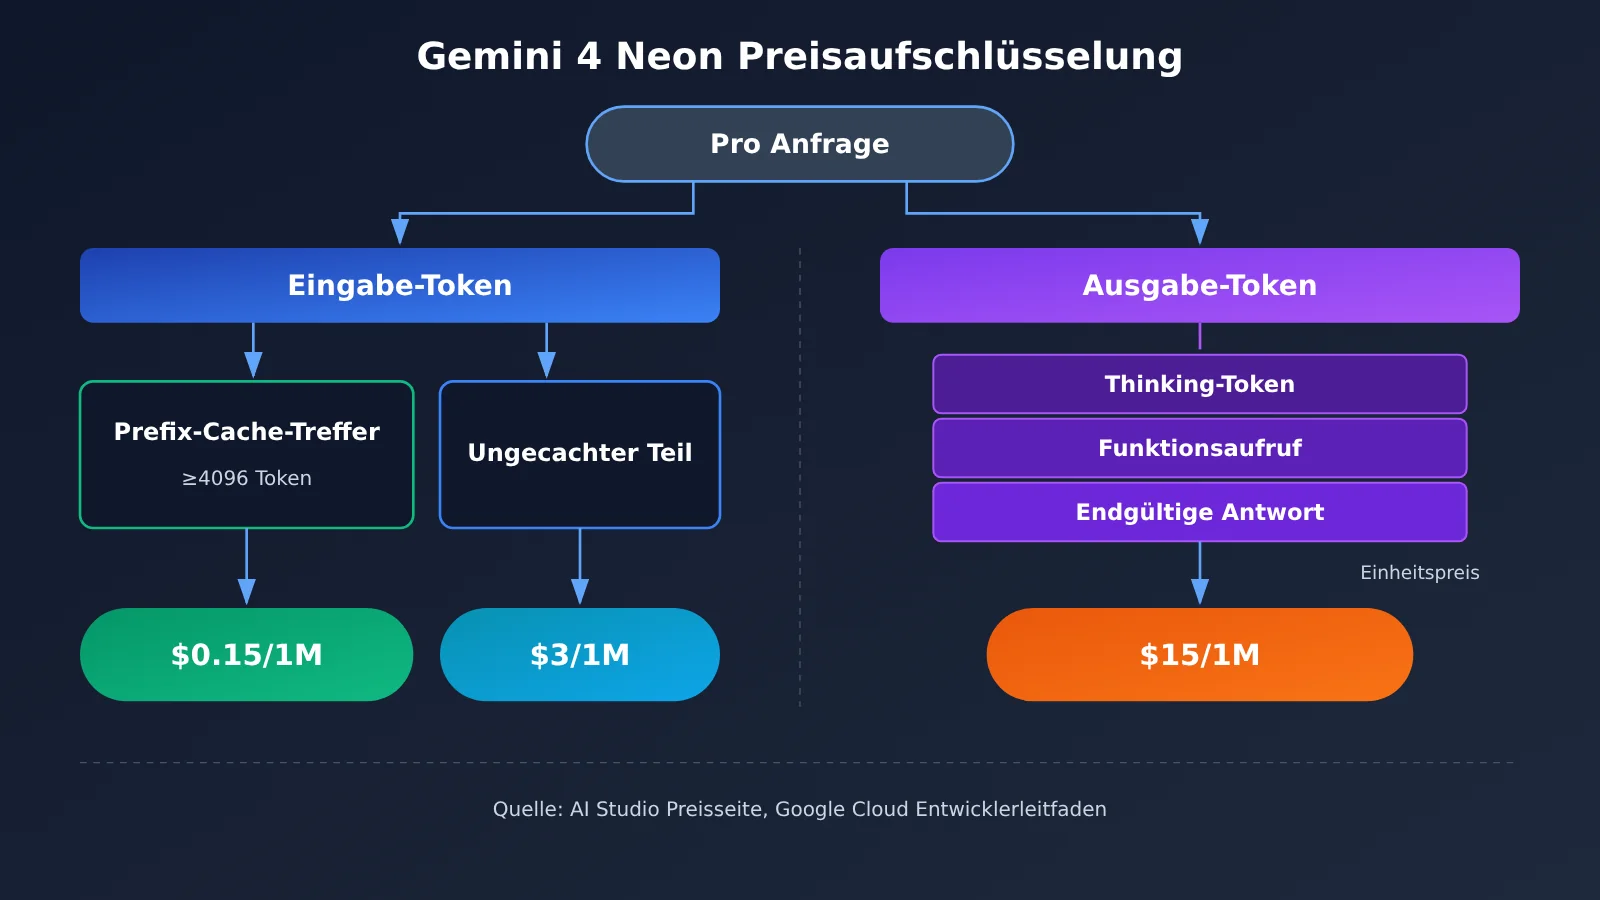
Der Entwicklerleitfaden von Google Cloud hält fest, dass die Ausgabe aus drei Teilen besteht: Thinking, Funktionsaufrufe und finale Antwort – wobei ein einzelnes Segment standardmäßig maximal 65536 Token umfasst. Auch die Preisseite von AI Studio rechnet die Thinking-Token in die 15-US-Dollar-Spalte für die Ausgabe ein. Die Anzahl der Ausgabe-Token, die man auf der Rechnung sieht, ist deshalb in der Regel deutlich größer als die Antwort, die man mit bloßem Auge wahrnimmt.
Bei Neon gibt es für das Denken nur vier Stufen: low, medium, high und xhigh, wobei high der Standardwert ist. Der Entwicklerleitfaden weist zudem darauf hin, dass die Übergabe von thinking_budget oder MINIMAL ein HTTP 400 zurückgibt. Der Google-Blog (offizielle Eigenauskunft) beschreibt es so: Je höher die Stufe, desto tiefer das Nachdenken und desto mehr Token – was sich direkt auf die Spalte für die Ausgabe auswirkt.
Implizites Caching in der Preisgestaltung von Gemini 4 Neon
Beim impliziten Caching geht es um den identischen Anfangsteil zwischen verschiedenen Anfragen, etwa eine feste System-Eingabeaufforderung, dasselbe lange Dokument oder dieselbe Sammlung von Tool-Definitionen. Die Schwelle laut Entwicklerleitfaden liegt bei einem gemeinsamen Präfix von über 4096 Token; ist sie erfüllt, wird automatisch zum Cache-Preis abgerechnet, ohne dass ein zusätzlicher API-Aufruf nötig ist.
Daraus ergibt sich ein sehr praktischer Schreibtipp: Stabile, unveränderliche Inhalte gehören an den Anfang der Nachricht, die sich jedes Mal ändernde Nutzerfrage ans Ende. Je länger und stabiler das Präfix, desto höher der Anteil, der mit 0.15 US-Dollar berechnet wird. Der Cache-Rabatt wirkt sich nur auf die Spalte für die Eingabe aus; die Spalte für die Ausgabe wird immer mit 15 US-Dollar berechnet.
Gemini 4 Neon Preisgestaltung und die Preisunterschiede zu Carbon und Hydrogen
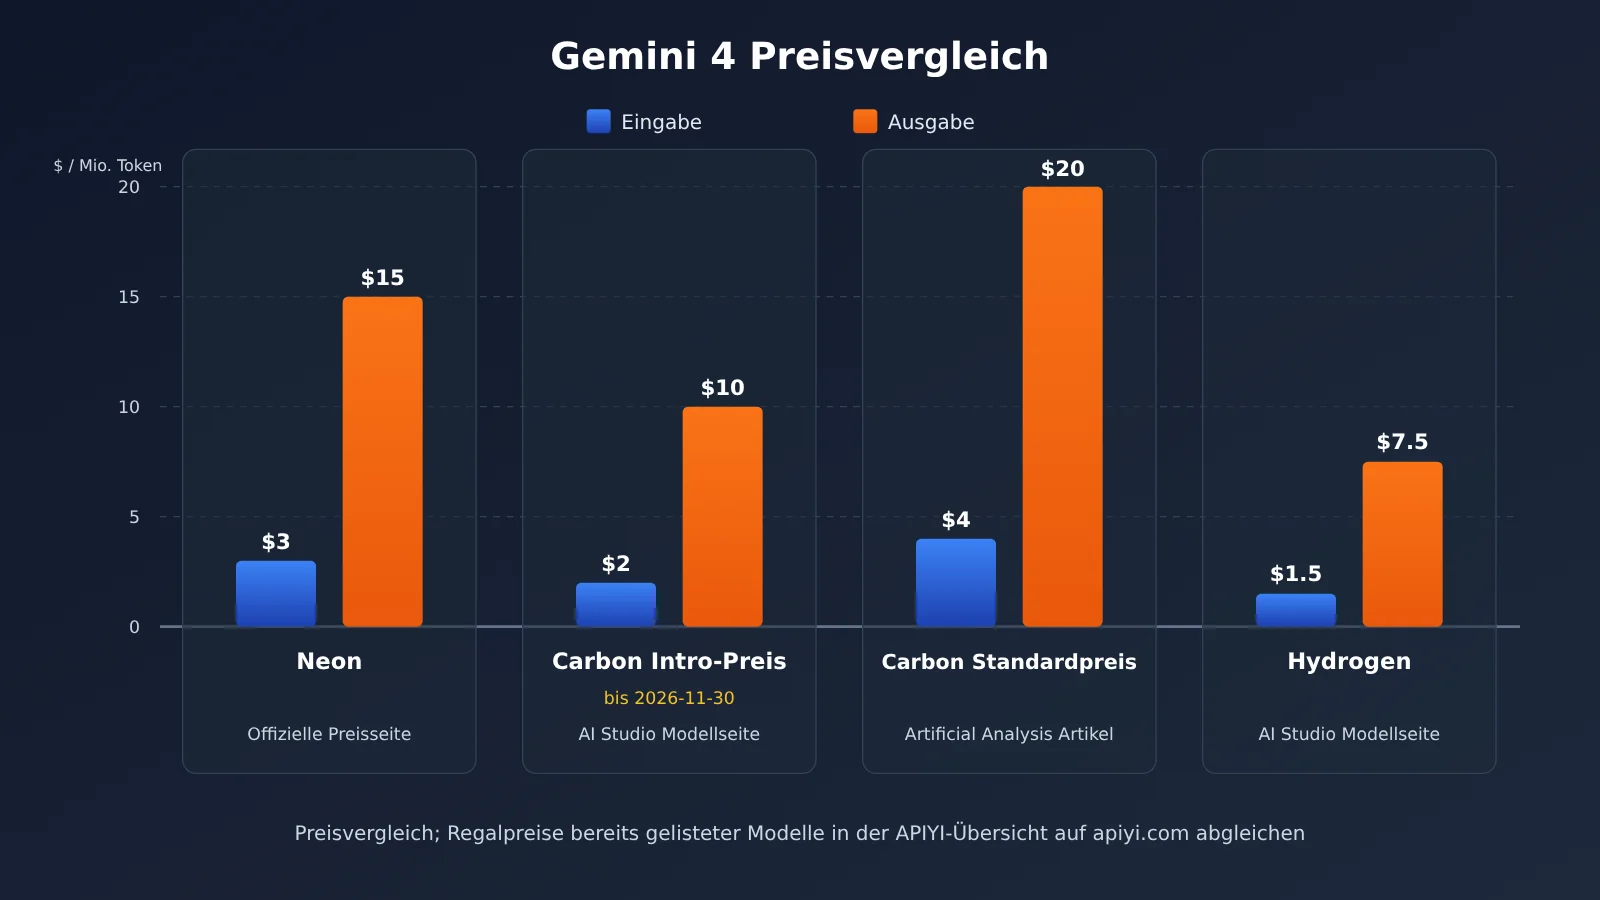
Neon liegt in der Familie zwischen Hydrogen und Carbon. Laut Google-Blog übernimmt Carbon die schwierigsten Langstreckenaufgaben, Hydrogen die alltägliche schnelle Ausführung, und Neon bildet den Kompromiss für hochfrequente, komplexe Abläufe. Die Stückpreise folgen dieser Reihenfolge, doch bei Carbon gibt es einen Einführungspreis und einen Standardpreis, die getrennt betrachtet werden müssen.
| Modell | Eingabe / 1M | Ausgabe / 1M | Preisbasis und Quelle |
|---|---|---|---|
| Gemini 4 Neon | 3,00 USD | 15,00 USD | AI Studio Preisseite, offizieller Listenpreis |
| Gemini 4 Carbon (Einführungspreis) | 2,00 USD | 10,00 USD | AI Studio Seite „Neueste Modelle“, gültig bis 2026-11-30 |
| Gemini 4 Carbon (Standardpreis) | 4 USD | 20 USD | Standardpreis laut Artificial-Analysis-Artikel |
| Gemini 4 Hydrogen | 1,50 USD | 7,50 USD | AI Studio Seite „Neueste Modelle“ |
Auf dieser Grundlage nennt der Artificial-Analysis-Artikel zwei Verhältnisse: Neon mit 3/15 liegt 25 % unter dem Carbon-Standardpreis von 4/20; gegenüber dem Carbon-Rabattpreis von 2/10, der bis zum 30. November gilt, ist Neon 50 % teurer. Beide Verhältnisse stimmen – der Unterschied liegt nur darin, welchen Carbon-Preis man zum Vergleich heranzieht.
Auch beim Cache-Rabatt gibt es zwei Angaben. Die Modellseite von Artificial Analysis nennt für Neon einen Cache-Rabatt von 95 %, für Carbon 90 %. In der APIYI-Übersichtstabelle beträgt das Cache-Lesen für gemini-4-carbon 0,1 USD, was 5 % der Eingabe von 2 USD entspricht. Diese beiden Zahlen stammen von unterschiedlichen Seiten; wir führen sie hier unverändert auf und vereinheitlichen sie nicht durch Umrechnung.
Gemini 4 Neon: Schnelleinstieg in die Preisberechnung
So gehen Sie in vier Schritten vor: Zuerst wenden Sie die drei offiziellen Preisansätze an, dann schätzen Sie ab, wie sich die Denkstufe auf die Ausgabe auswirkt, anschließend vergleichen Sie mit der APIYI-Übersichtstabelle die bereits gelisteten Modelle derselben Familie und prüfen zuletzt den Verfügbarkeitsstatus von Neon selbst.
Schritt 1: Mit den drei offiziellen Preisansätzen einen Aufruf berechnen
Die Formel ist einfach: Eingabekosten = nicht gecachte Eingabe-Token pro 1 Million × 3; Cache-Kosten = gecachte Eingabe-Token pro 1 Million × 0.15; Ausgabekosten = Ausgabe-Token (inklusive Denk-Token) pro 1 Million × 15. Die Summe der drei Beträge ergibt die Kosten für diese Anfrage.
- Beispiel ohne Cache: 1000000 Eingabe-Token, 100000 Ausgabe-Token. Eingabe 1000000 ÷ 1000000 × 3 = 3 US-Dollar, Ausgabe 100000 ÷ 1000000 × 15 = 1.5 US-Dollar, zusammen 4.5 US-Dollar.
- Beispiel mit Cache-Treffer: dieselben 1000000 Eingabe-Token, davon 800000 Token als gecachter gemeinsamer Präfix. Der Treffer-Teil 800000 ÷ 1000000 × 0.15 = 0.12 US-Dollar, die nicht gecachten 200000 Token ergeben 0.6 US-Dollar, die Ausgabe bleibt bei 1.5 US-Dollar, zusammen 2.22 US-Dollar.
- Gleiche Token-Menge, umgerechnet auf den Carbon-Einführungspreis: 1000000 × 2 plus 100000 × 10, zusammen 3 US-Dollar; mit dem Carbon-Standardpreis 4/20 zusammen 6 US-Dollar; mit Hydrogen 1.5/7.5 zusammen 2.25 US-Dollar.
Zu beachten ist: Bei derselben Aufgabe erzeugen verschiedene Modelle nicht dieselbe Token-Anzahl. Ein Artikel von Artificial Analysis erwähnt, dass Neon pro Aufgabe etwa 15 % mehr Ausgabe-Token erzeugt als Carbon. Ein Vergleich bei gleicher Token-Menge zeigt daher nur die Unterschiede bei den Stückpreisen; die tatsächliche Rechnung hängt zusätzlich vom jeweiligen Token-Verbrauch ab.
Schritt 2: Abschätzen, wie stark die Denkstufe das Ausgabebudget erhöht
Die Denkstufe bestimmt, wie groß das Ausgabebudget ist. Der Google-Blog (offizielle Angabe von Google selbst) sagt nur, dass höhere Stufen mehr Tokens bedeuten, nennt aber keine konkreten Tokenzahlen pro Stufe. Die Modellseite von Artificial Analysis gibt die Zeit pro Aufgabe an, die jede Stufe für den Index benötigt – das kann als Indiz dafür dienen, dass tieferes Denken einen längeren Prozess bedeutet.
| Denkstufe | Standardmäßig? | Zeit pro Aufgabe (Modellseite von Artificial Analysis) | Ausgabegeschwindigkeit |
|---|---|---|---|
low |
Nein | 3,7 Minuten | 97 Tokens/Sekunde |
medium |
Nein | 8,3 Minuten | 101 Tokens/Sekunde |
high |
Ja (Entwicklerleitfaden) | 14,8 Minuten | 101 Tokens/Sekunde |
xhigh |
Nein | 21,5 Minuten | 110 Tokens/Sekunde |
Im Rechenbeispiel aus Schritt 1: Wenn die Ausgabe durch eine höhere Denkstufe von 100000 Tokens auf 200000 Tokens steigt, wächst das Ausgabebudget von 1,5 US-Dollar auf 3 US-Dollar. Wie stark es tatsächlich steigt, hängt von deiner Aufgabe ab. Ich empfehle, die eigenen Eingabeaufforderungen mit mehreren Stufen zu testen und anhand des zurückgegebenen usage-Felds die Standardstufe festzulegen.
Schritt 3: In der APIYI-Übersichtstabelle mit Modellen derselben Familie abgleichen
Öffne die APIYI-Übersichtstabelle docs.apiyi.com/models.md (laut Seitenangabe aktualisiert am 2026-11-16 09:39, UTC+8) oder rufe die Preis-API api.apiyi.com/api/pricing ab (Abfrage vom 2026-11-19, Version shell-api-modelmak-v1, insgesamt 285 Modelle). Dort siehst du die Listenpreise der bereits gelisteten Modelle der Gemini-4-Familie.
| Modell-ID | Eingabe / 1M | Cache-Lesen / 1M | Ausgabe / 1M | Endpunkt | Verfügbare Plattform |
|---|---|---|---|---|---|
gemini-4-carbon |
2 US-Dollar | 0,1 US-Dollar | 10 US-Dollar | chat, gemini | APIYI apiyi.com |
gemini-4-hydrogen |
1,5 US-Dollar | 0,075 US-Dollar | 7,5 US-Dollar | chat, gemini | APIYI apiyi.com |
gemini-4-neon |
— | — | — | — | Weder in der Übersichtstabelle noch in der Preis-API gelistet |
In der APIYI-Übersichtstabelle sind die Werte 2/0,1/10 für gemini-4-carbon der aktuelle Listenpreis. Er entspricht dem Einführungspreis von Google bis zum 2026-11-30 und ist nicht dasselbe wie der Standardpreis 4/20. Bei den Gruppen nennt die Übersichtstabelle Default, SVIP, die Preis-API default, svip. Die Modellseite gibt außerdem ein Kontextfenster von 1048576, eine maximale Ausgabe von 65536 und einen Wissensstand bis 2026-03 an.
Die Preis-API drückt Preise in Multiplikatoren aus: model_ratio = 1 entspricht 2 US-Dollar Eingabe pro Million Tokens, completion_ratio = 5 bedeutet, dass die Ausgabe das Fünffache der Eingabe kostet. Nach dieser Umrechnung entsprechen einem Modell mit Eingabe 2 und Ausgabe 10 die Werte 1 und 5 – genau wie in der ersten Zeile der Übersichtstabelle.
Schritt 4: Verfügbarkeitsstatus von Gemini 4 Neon prüfen
gemini-4-neon taucht weder in der APIYI-Übersichtstabelle noch im Preis-Endpunkt auf, und es gibt auch keine eigene Modellseite. Das Modell ist derzeit noch nicht verfügbar – wir werden es so schnell wie möglich anbinden. Modell und Preis richten sich nach der Modellliste der Plattform.
In der Wartezeit kannst du die Aufrufkette schon mit dem verfügbaren gemini-4-carbon oder gemini-4-hydrogen durchspielen. Der Aufruf funktioniert so:
- OpenAI-kompatible Schnittstelle:
base_urlaufhttps://api.apiyi.com/v1setzen,modelmitgemini-4-carbonbefüllen. - Gemini-native Schnittstelle: Adresse
https://api.apiyi.com, API-Versionv1beta. - Den Schlüssel aus einer Umgebungsvariable lesen, zum Beispiel
api_key=os.environ["APIYI_API_KEY"]– niemals im Klartext in den Code schreiben. - Nach der Antwort die Anzahl der Input-Tokens, der Cache-Treffer und der Output-Tokens aus
usageauslesen und mit der Formel aus Schritt 1 die Kosten gegenprüfen.
🚀 Schnellstart: Nach der Registrierung bei APIYI apiyi.com bekommst du ein kostenloses Testkontingent. Bring zuerst mit
gemini-4-carbonden Aufruf vonhttps://api.apiyi.com/v1und dieusage-Statistik zum Laufen – sobald Neon verfügbar ist, musst du nur noch dasmodel-Feld ändern.
Die drei Rechnungen zur Preisgestaltung von Gemini 4 Neon
Neben dem Einzelpreis haben Google und Artificial Analysis jeweils auch einen Vergleich der „Kosten pro Aufgabe“ veröffentlicht. Diese Kennzahlen basieren auf unterschiedlichen Bezugsgrößen und lassen sich nicht ineinander umrechnen.
| Aussage | Zahl | Quelle und Bezugsgröße |
|---|---|---|
| Neon mit standardmäßigem high: Kosten pro Aufgabe niedriger als bei Carbon | 32 % | Google-Blog, offizielle Selbstauskunft; es wird nicht angegeben, ob für Carbon der Einführungspreis oder der Standardpreis zugrunde liegt |
| Neon xhigh: Kosten pro Aufgabe geringer als bei Carbon ohne Rabatt | ca. 17 % | Artificial-Analysis-Artikel; Carbon zum Standardpreis von 7,76 US-Dollar |
| Neon high im Vergleich zu Carbon high: Kosten pro Aufgabe | weniger als die Hälfte | Artificial-Analysis-Artikel; auf Basis des Carbon-Standardpreises |
| Carbon high: Kosten pro Aufgabe | 4,90 US-Dollar | Artificial-Analysis-Modellseite; auf Basis des aktuell auf der Seite angegebenen Einführungspreises |
Diese vier Zahlen stammen aus drei getrennten Rechnungen; sowohl die Stufen als auch die Preisbezugsgrößen für Carbon unterscheiden sich. In diesem Artikel mitteln wir 32 % und 17 % nicht und subtrahieren auch nicht 4,90 und 7,76 voneinander. Für dein Projekt ist es am zuverlässigsten, die Formel aus dem ersten Schritt mit der eigenen Token-Anzahl anzuwenden.
💡 Empfehlung zur Auswahl: Eine Preisliste pro Einheit sagt dir nur, wie viel ein Token kostet; wie viele Token eine Aufgabe tatsächlich verbraucht, musst du mit deinen eigenen Anfragen messen. Du kannst bei APIYI apiyi.com denselben Satz an Eingabeaufforderungen verwenden, um die bereits verfügbaren Modelle Carbon und Hydrogen getrennt aufzurufen, die usage zu protokollieren und anschließend die Kostenspanne für Neon zu schätzen.
Häufige Fragen (FAQ)
Q1: In welche Kategorien ist die Preisgestaltung von Gemini 4 Neon unterteilt?
Laut der Preisseite von Google AI Studio teilt sich Gemini 4 Neon in drei Kategorien: 3,00 US-Dollar pro Million Input-Token, 0,15 US-Dollar für gecachten Input und 15,00 US-Dollar für Output. Thinking-Token werden zur Output-Kategorie gerechnet, eine kostenlose Stufe gibt es nicht.
Q2: Wie wird der Cache von Gemini 4 Neon wirksam?
Der Entwicklerleitfaden von Google Cloud legt fest, dass nur implizites Caching unterstützt wird, das für gemeinsame Präfixe ab 4096 Token automatisch greift. Persistentes Caching ist standardmäßig aktiv, explizites Kontext-Caching wird nicht unterstützt. Wer die festen System-Eingabeaufforderungen und langen Dokumente an den Anfang der Nachricht stellt, erzielt eine höhere Trefferquote.
Q3: Sind die 6,44 US-Dollar in der Rangliste der Preis für eine einzelne Anfrage?
Die 6,44 US-Dollar sind die gewichteten Kosten pro Aufgabe, die Artificial Analysis im xhigh-Modus nach dem Durchlaufen seines Intelligenzindex ermittelt hat – ein solcher Index umfasst zahlreiche lange Aufgaben. Für einen einzelnen Chat oder eine einzelne API-Anfrage sollte man die offiziellen drei Kategorien auf Basis der eigenen Input-, Cache- und Output-Token-Zahlen heranziehen.
Q4: Um wie viel verteuert sich Gemini 4 Neon durch die Thinking-Stufen?
Die offizielle Seite nennt keine Token-Zahlen pro Stufe. Der Entwicklerleitfaden bestätigt die vier Stufen `low`, `medium`, `high` (Standard) und `xhigh`; im Google-Blog heißt es, dass höhere Stufen mehr Token bedeuten. Es empfiehlt sich, die Stufen an den eigenen Aufgaben durchzutesten und sich dabei nach den Output-Token in der Usage-Angabe zu richten.
Q5: Wie kann man über APIYI die Preise der Gemini-4-Familie prüfen und Modelle aufrufen?
Öffnen Sie die Gesamtübersicht `docs.apiyi.com/models.md` von APIYI apiyi.com oder fragen Sie die Preisschnittstelle ab – dort finden Sie `gemini-4-carbon` (2/0,1/10) und `gemini-4-hydrogen` (1,5/0,075/7,5). Beim Aufruf tragen Sie als OpenAI-kompatible Adresse `https://api.apiyi.com/v1` ein. `gemini-4-neon` ist noch nicht gelistet; wir werden dieses Modell so schnell wie möglich aufnehmen. Modellbezeichnungen und Preise richten sich nach der Modellliste der Plattform.
Q6: Wie ist der Carbon-Preis bei APIYI nach dem 30. November zu sehen?
Der aktuelle Regalpreis von Carbon in der APIYI-Gesamtübersicht (2/0,1/10) entspricht dem Einführungspreis von Google bis zum 2026-11-30. Die Gesamtübersicht enthält keine Angaben zu späteren Anpassungen; zu jenem Zeitpunkt richten Sie sich bitte nach den Echtzeitdaten der Gesamtübersicht auf APIYI apiyi.com und der Preisschnittstelle.
Q7: Welche Einschränkungen sollte man bei der Preisgestaltung von Gemini 4 Neon beachten?
Vor allem vier Punkte:
– **Keine kostenlose Stufe**: Die Preisseite von AI Studio legt fest, dass ab dem ersten Aufruf abgerechnet wird.
– **Kein explizites Caching**: Man kann sich nur auf das implizite Greifen bei Präfixen ab 4096 Token verlassen.
– **Thinking zählt zum Output**: Ein einzelner Abschnitt umfasst standardmäßig maximal 65536 Token, und Thinking beansprucht dieses Budget.
– **Parameterbeschränkung**: Die Übergabe von `thinking_budget` oder `MINIMAL` liefert HTTP `400`.
Q8: Warum steht auf manchen Seiten für Neon ein Mischpreis von 2,21 US-Dollar?
Das ist ein einheitlicher Preis, den die Modellseite von Artificial Analysis nach ihrem Mischkalkulationsansatz berechnet hat, um einen horizontalen Vergleich zu erleichtern. Die tatsächliche Abrechnung erfolgt weiterhin getrennt nach Input, Cache und Output in drei Kategorien; für die Berechnung der eigenen Kosten empfiehlt es sich, direkt die drei Kategorie-Einzelpreise zu verwenden.
Gemini 4 Neon – die wichtigsten Punkte zur Preisgestaltung
- Drei offizielle Tarifpositionen: Input 3 USD, Lesen aus dem impliziten Cache 0,15 USD, Output 15 USD – jeweils pro Million Token.
- Wohin die Denk-Tokens zählen: Denk-Tokens, Funktionsaufrufe und die finale Antwort werden alle der Output-Position zugerechnet.
- Cache-Regeln: Es gibt nur einen impliziten Cache; gemeinsame Präfixe ab 4096 Token greifen automatisch.
- Kein kostenloses Kontingent: Auf der Preisseite von AI Studio steht ausdrücklich, dass Neon kein kostenloses Kontingent hat.
- Rechenbeispiel mit runden Zahlen: 1 Mio Input plus 100.000 Output ergeben 4,5 USD; bei 800.000 Cache-Treffern sind es 2,22 USD.
- Carbon mit zwei Preislisten: Der Einführungspreis 2/10 gilt bis zum 30.11.2026, der Standardpreis 4/20 stammt aus dem Artikel von Artificial Analysis.
- Preise in der Übersicht prüfen: In der Gesamttabelle von APIYI (apiyi.com) die bereits gelisteten Preise für
gemini-4-carbonundgemini-4-hydrogenabgleichen.
Zusammenfassung
Die Kernpunkte der Preisgestaltung von Gemini 4 Neon:
- Drei Positionen getrennt rechnen: Nicht im Cache gefundener Input mit 3 USD, Cache-Treffer mit 0,15 USD, Output inklusive Denk-Tokens mit 15 USD.
- Die Denk-Stufe bestimmt die Output-Position: Standard ist
high; je höher die Stufe, desto mehr Output-Token und desto höher die Kosten. - Zahlen aus verschiedenen Quellen getrennt betrachten: Die 32 % von Google, die rund 17 % von Artificial Analysis und die 4,90 USD stammen aus drei unterschiedlichen Rechnungen. Kosten pro Aufgabe und die Abrechnung deiner einzelnen Anfrage musst du ebenfalls getrennt verstehen.
Wenn du deine eigenen Kosten schätzen willst, ist der direkteste Weg: mit einem echten Satz von Eingabeaufforderungen die Usage-Werte erzeugen und dann die drei Tarifpositionen darauf anwenden. gemini-4-neon ist bei APIYI derzeit noch nicht gelistet; wir werden dieses Modell so schnell wie möglich aufnehmen. Modellbezeichnungen und Preise richten sich nach der Modellliste der Plattform. Aktuell empfehlen wir, über APIYI (apiyi.com) zuerst mit den bereits gelisteten Carbon und Hydrogen die Kette zum Laufen zu bringen – sobald Neon online ist, musst du nur die Modell-ID ändern.
📚 Referenzen
-
Google AI Studio Preisseite und Seite der neuesten Modelle: Neon-Preise in drei Stufen, Erläuterungen zum kostenlosen Kontingent und zum Caching, Einführungspreis für Carbon und Preis für Hydrogen
- Link:
aistudio.google.com/docs/pricing - Link:
aistudio.google.com/docs/latest-model - Hinweis: Hauptquelle für die offiziellen Stückpreise in diesem Artikel
- Link:
-
Google Cloud Entwicklerleitfaden – Gemini 4 Neon: Modell-ID, Kontextlimit, Thinking-Stufen, Schwelle für implizites Caching
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Hinweis: Quelle für die Zusammensetzung der Ausgabe und die Parameterbeschränkungen
- Link:
-
Google Blog – Introducing Gemini 4 Neon: Ankündigungsinformationen und der offiziell selbst angegebene Kostenvergleich
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Hinweis: Quelle für den 95-%-Rabatt beim Caching und die um 32 % niedrigeren Kosten pro Aufgabe
- Link:
-
DeepMind Modellkarte – Gemini 4 Neon: Kontextfenster, Ausgabegrenze und Wissens-Cutoff
- Link:
deepmind.google/models/model-cards/gemini-4-neon - Hinweis: Referenz für die Modellspezifikationen
- Link:
-
Artificial Analysis Artikel und Modellseite: von Drittanbietern gemessene Kosten pro Aufgabe, Laufzeiten der einzelnen Stufen und Standardpreis für Carbon
- Link:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Link:
artificialanalysis.ai/models/gemini-4-neon - Hinweis: Artikel und Modellseite verwenden unterschiedliche Bezugsgrößen und sind beim Zitieren getrennt zu behandeln
- Link:
-
APIYI Gesamtübersicht und Preis-API: Listenpreise und Multiplikatoren der bereits verfügbaren Modelle
- Link:
docs.apiyi.com/models.md - Hinweis: Abfrage von Modellen und Preisen der Gemini-4-Familie
- Link:
Autor: APIYI Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI apiyi.com; weitere Integrationshinweise finden Sie im Dokumentationszentrum unter docs.apiyi.com