Catatan penulis: “Kecepatan” Gemini 4 Neon setidaknya bisa diukur dengan tiga cara. Artikel ini menguraikan secara terpisah waktu token pertama, output per detik, dan waktu untuk menyelesaikan satu soal, serta mencantumkan sumber setiap angka.
Gemini 4 Neon dirilis pada 2026-11-18. Postingan rilis Sundar Pichai menyebutkan bahwa model ini mampu menyelesaikan tugas lebih cepat dalam rekayasa perangkat lunak kompleks, pekerjaan pengetahuan, dan alur kerja ilmiah. Banyak orang yang membaca kalimat itu langsung memahaminya sebagai “tercepat secara menyeluruh”. Padahal, pengukuran kecepatan setidaknya memiliki tiga ukuran, dan peringkat yang dihasilkan dari masing-masing ukuran tidak konsisten.
Semua angka kecepatan dalam artikel ini berasal dari halaman model Artificial Analysis dan artikel Artificial Analysis; skor benchmark berasal dari laporan resmi dan kartu model; tidak ada satu pun yang kami jalankan sendiri. Angka dengan sumber dan ukuran berbeda akan disandingkan secara berdampingan, tidak dirata-rata, dan tidak digabung menjadi angka baru.
Nilai inti: Setelah membaca artikel ini, kamu bisa membedakan berapa waktu token pertama, output per detik, dan waktu per tugas Gemini 4 Neon; mengetahui pengaruh empat tingkat thinking terhadap kecepatan dan skor; serta mengetahui metrik mana yang sebaiknya dilihat saat memilih model.
Poin-poin inti kecepatan Gemini 4 Neon
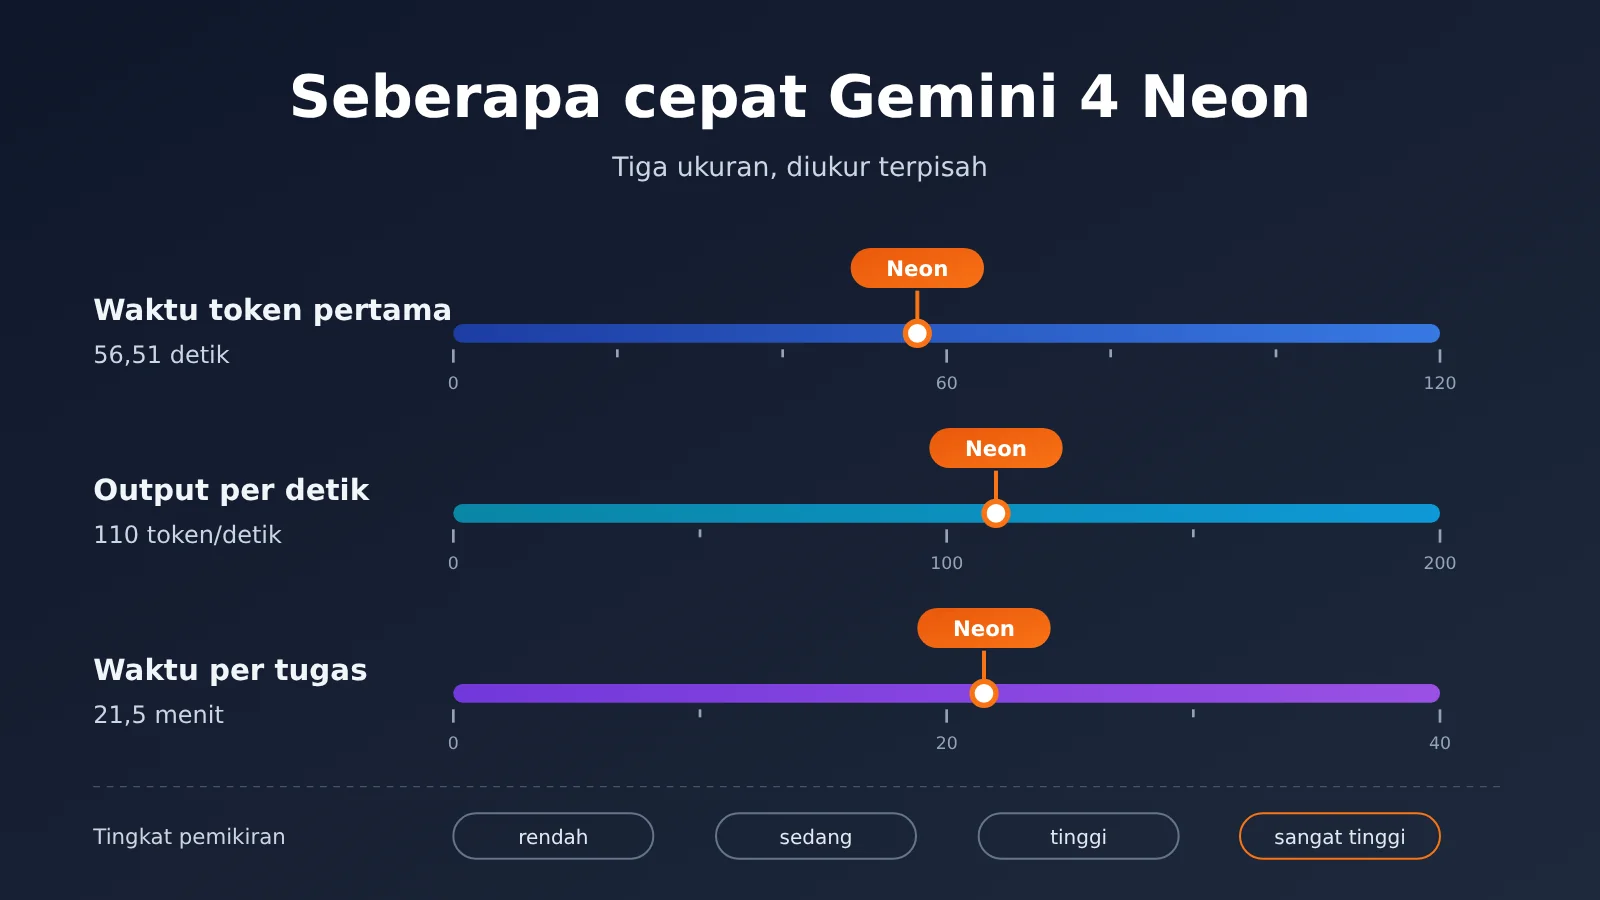
Pertama, pisahkan tiga metrik yang mudah tertukar. Nilai Neon pada tabel di bawah semuanya menggunakan tingkat xhigh, diambil dari halaman model Artificial Analysis (dibaca 2026-11-19, indeks v5.0.1).
| Metrik | Arti | Nilai Gemini 4 Neon xhigh | Kesan pengguna |
|---|---|---|---|
| Waktu token pertama | Waktu tunggu sejak permintaan dikirim hingga token jawaban pertama terlihat | 56.51 detik | Saat berinteraksi, “berapa lama macet sebelum mulai mengeluarkan teks” |
| Output per detik | Berapa token yang dihasilkan per detik setelah output dimulai | 110 token/detik | Seberapa cepat output streaming “mengalir” |
| Waktu per tugas | Rata-rata waktu untuk menyelesaikan satu soal dalam indeks | 21.5 menit | Berapa lama satu tugas “bisa diserahkan” |
| Volume output saat menjalankan indeks | Total token yang dihasilkan saat menjalankan seluruh rangkaian indeks | 283 juta token | Menentukan separuh lainnya dari waktu per tugas |
Mengapa tiga metrik kecepatan Gemini 4 Neon perlu dilihat secara terpisah
Waktu token pertama paling berdampak pada interaksi berbasis chat. Model yang mengandalkan penalaran harus menyelesaikan sebagian proses berpikir sebelum mengeluarkan token jawaban pertama, jadi waktu token pertama sering diukur dalam detik bahkan menit, dan sangat terkait dengan tingkat penalaran.
Output per detik hanya mengukur throughput “setelah mulai mengeluarkan teks”, tidak peduli seberapa banyak yang ingin disampaikan model. Waktu per tugas dipengaruhi dua hal sekaligus: berapa token yang bisa dihasilkan per detik, dan berapa total token yang perlu dihasilkan untuk soal tersebut. Model dengan output per detik tinggi tetap bisa lebih lambat menyelesaikan satu soal jika terbiasa menulis proses berpikir yang panjang. Perbandingan Neon dengan GPT-6.2 Sol dan GPT-6.2 Astra di bagian berikutnya menggambarkan situasi ini.
Fitur Utama Gemini 4 Neon: Posisi dalam Keluarga dan Empat Tingkat Penalaran
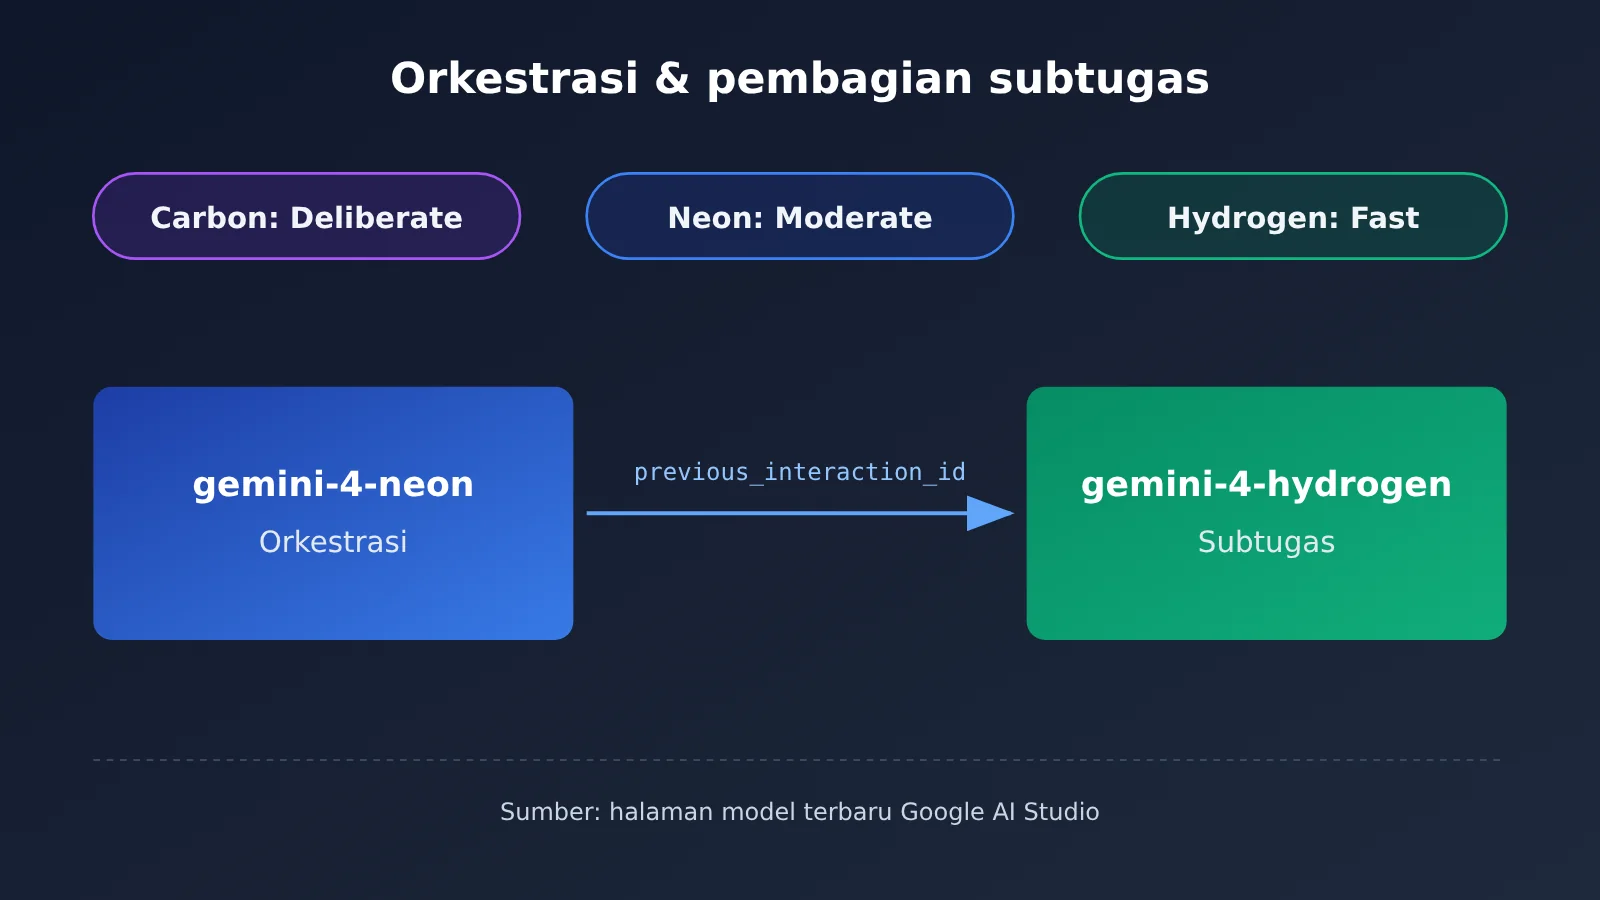
Halaman model terbaru Google AI Studio memberikan label kecepatan kualitatif untuk tiga model Gemini 4: Carbon adalah Deliberate, Neon adalah Moderate, Hydrogen adalah Fast. Artinya, dalam kualifikasi resmi mereka sendiri, Neon berada di tengah keluarga, sementara Hydrogen-lah yang diberi label Fast. Blog Google juga memposisikan Carbon untuk tugas jangka panjang yang paling sulit, Hydrogen untuk eksekusi cepat sehari-hari, dan Neon sebagai jalan tengah untuk alur kompleks yang berfrekuensi tinggi.
| Model | Kualifikasi kecepatan AI Studio | Tingkat penalaran | Tingkat default | Posisi dalam keluarga (Blog Google / panduan developer) |
|---|---|---|---|---|
| Gemini 4 Carbon | Deliberate | low, medium, high | medium | Tugas jangka panjang yang kompleks |
| Gemini 4 Neon | Moderate | low, medium, high, xhigh | high | Jalan tengah, alur kompleks berfrekuensi tinggi |
| Gemini 4 Hydrogen | Fast | Tidak dirinci dalam sumber | Tidak dirinci dalam sumber | Siklus cepat sehari-hari |
Kemampuan dan Spesifikasi Gemini 4 Neon
Menurut model card, Gemini 4 Neon diadaptasi dari Gemini 4 Carbon, dengan batas pengetahuan Maret 2026; input mendukung teks, gambar, audio, dan video, serta jendela konteks terpadu maksimum 1 juta token. Output sinkron default maksimum 64 ribu token, sedangkan decoding panjang di latar belakang maksimum 1 juta token. Panduan developer Google Cloud memberikan ID model gemini-4-neon, batas terpadu 1048576 token, mencakup input dan output; output tersebut juga mencakup penalaran, pemanggilan fungsi, dan respons akhir.
Dari sisi kemampuan, Artificial Analysis Intelligence Index yang dilaporkan sendiri oleh pihak resmi mencapai 61 pada tingkat xhigh, dengan peringkat keseluruhan ke-3; blog tersebut juga mengakui bahwa model ini tertinggal dari model yang lebih besar dan lebih lambat. Tabel perbandingan pada model card hanya memiliki tiga kolom: Neon, Claude Opus 5.5, dan GPT-6.2 Sol. Hasil non-Gemini secara default diambil dari laporan masing-masing penyedia, sehingga tabel itu merupakan rangkuman resmi, bukan pengujian ulang oleh laboratorium yang sama pada hari yang sama. Tabel itu juga memuat metrik tempat Neon tertinggal, misalnya pada Terminal-bench 4.1, akurasi setelah penyesuaian terkait kecurangan untuk Opus 5.5 adalah 65.8%, lebih tinggi daripada Neon sebesar 65.2%.
Panduan developer juga menyajikan satu pola orkestrasi: gunakan gemini-4-neon sebagai pengendali utama, lalu serahkan previous_interaction_id kepada gemini-4-hydrogen untuk menjalankan subtugas yang lebih cepat. Jika Anda merasa Neon kurang cepat, jalur ini lebih layak dipertimbangkan daripada terus-menerus menurunkan tingkat penalaran (ini penilaian kami, bukan kutipan langsung dari panduan).
Data kecepatan Gemini 4 Neon: membedah empat tingkat pemikiran satu per satu
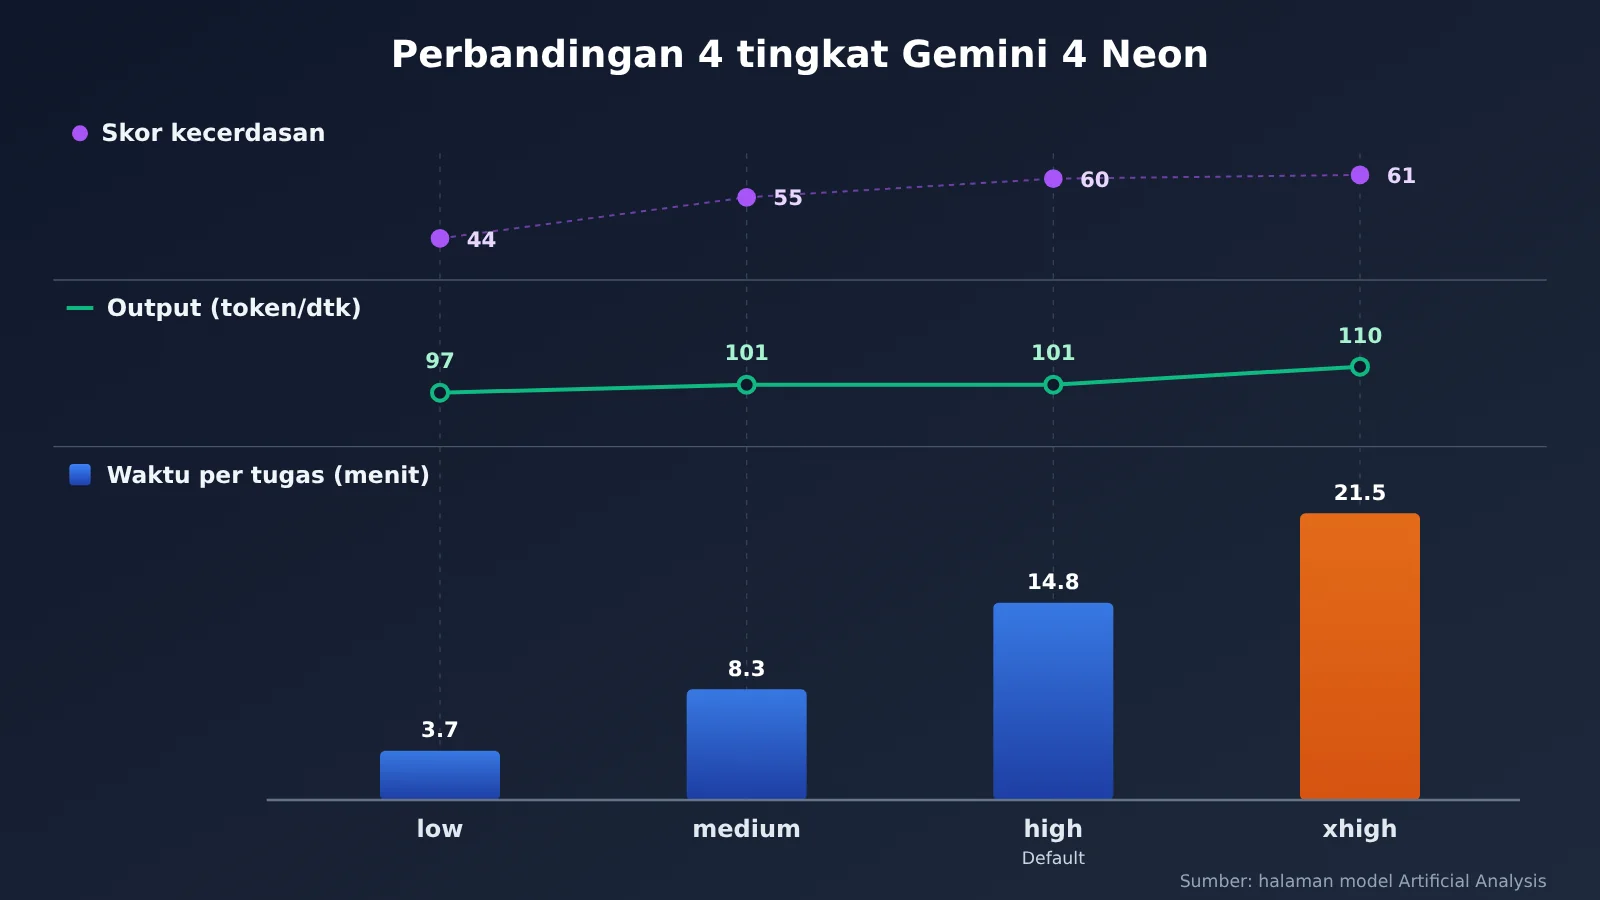
Tabel di bawah ini berasal dari halaman model Artificial Analysis. Kolom paling kanan, yaitu waktu token pertama, perlu dijelaskan tersendiri: tabel ringkasan di halaman tersebut hanya mencantumkan 56,51 detik untuk xhigh, sedangkan nilai waktu token pertama untuk tiga tingkat high, medium, dan low berasal dari kolom FAQ di halaman yang sama, bukan dari tabel ringkasan. Saat mengutip, mohon cantumkan sumber ini.
| Tingkat pemikiran | Skor kecerdasan | Waktu per tugas | Output per detik | Waktu token pertama (kolom FAQ halaman model) |
|---|---|---|---|---|
| xhigh | 61 | 21,5 menit | 110 token/detik | 56,51 detik |
| high (bawaan) | 60 | 14,8 menit | 101 token/detik | 40,64 detik |
| medium | 55 | 8,3 menit | 101 token/detik | 20,14 detik |
| low | 44 | 3,7 menit | 97 token/detik | 13,93 detik |
Dari tabel ini terlihat bahwa output per detik di keempat tingkat hanya berkisar antara 97 sampai 110 token/detik, sementara waktu per tugas justru melentang dari 3,7 menit hingga 21,5 menit. Yang terutama berubah saat mengubah tingkat adalah “berapa banyak yang perlu dipikirkan”, sedangkan pengaruhnya terhadap “seberapa cepat menulis per detik” tidak besar. Ini adalah inferensi dari angka-angka dalam tabel; halaman model sendiri tidak menyatakannya demikian.
Biaya skornya juga terlihat jelas. Dari high bawaan dengan 60 poin, turun ke medium hanya kehilangan 5 poin, sedangkan turun ke low akan jatuh ke 44 poin. xhigh hanya 1 poin lebih tinggi daripada high, tetapi waktu per tugasnya bertambah hampir 7 menit; apakah sepadan atau tidak bergantung pada tugas Anda.
Gemini 4 Neon lebih cepat per detik, mengapa menyelesaikan satu soal tetap bisa lebih lama
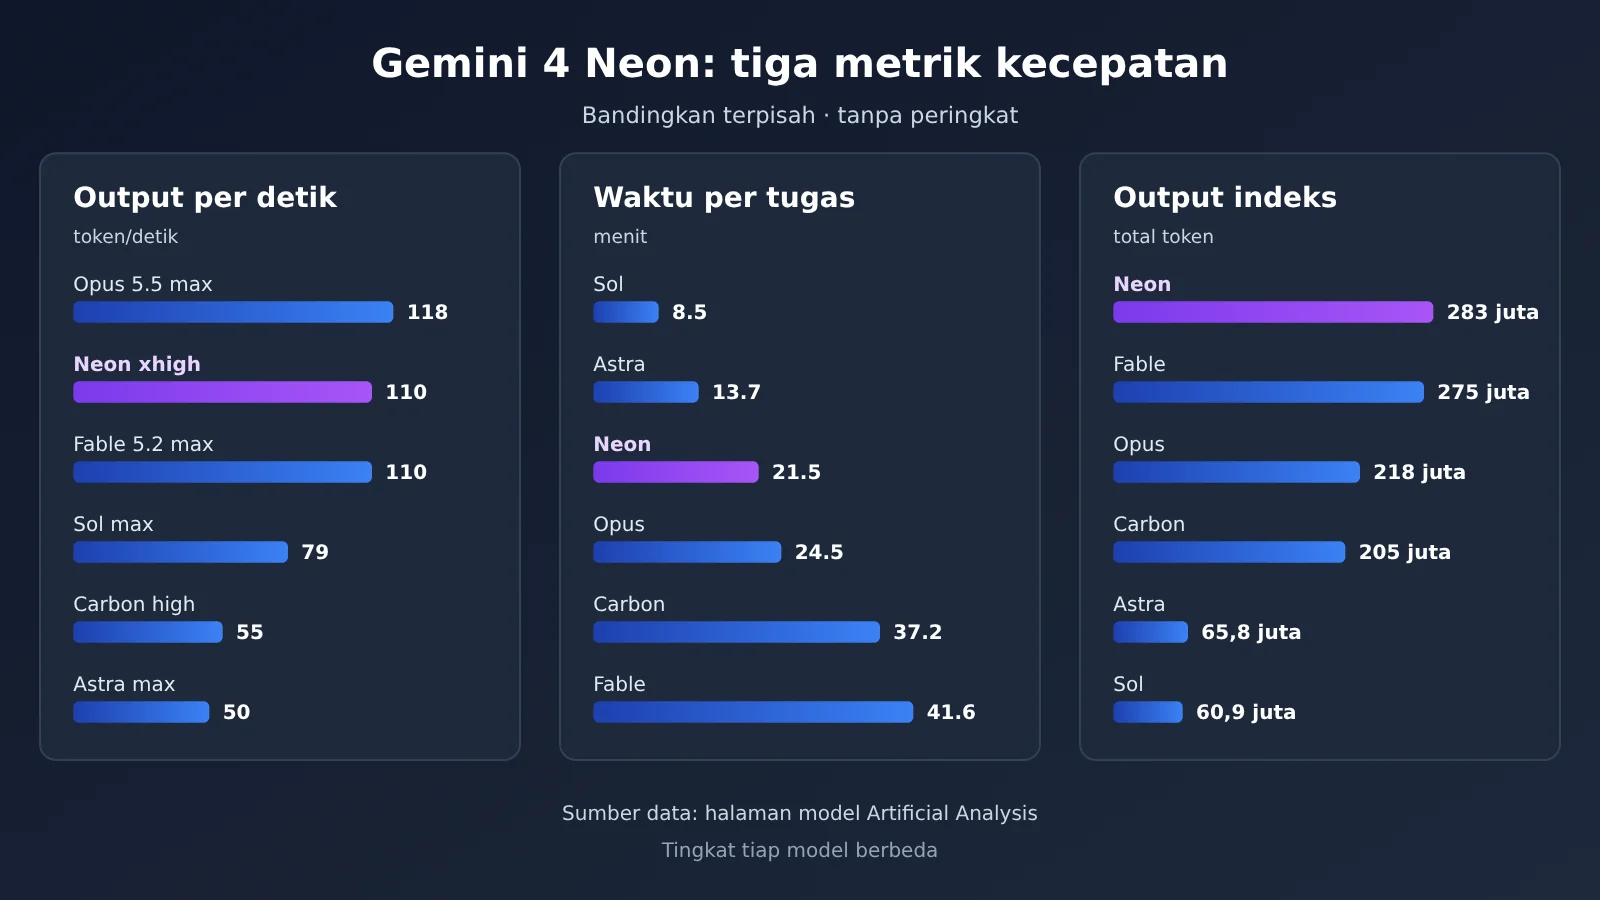
Halaman model Artificial Analysis mencatat bahwa Neon xhigh, saat menjalankan seluruh rangkaian indeks, menghasilkan total 283 juta token keluaran dengan 8,12 miliar token masukan. Semakin banyak token keluaran, bahkan pada kecepatan 110 token per detik, total waktu tetap akan memanjang. GPT-6.2 Astra pada tingkat max hanya 50 token per detik, tetapi saat menjalankan indeks hanya menghasilkan 65,8 juta token, dengan waktu per tugas 13,7 menit. GPT-6.2 Sol pada tingkat max 79 token per detik, menghasilkan 60,9 juta token, dan waktu per tugas 8,5 menit.
Jadi, “token keluaran per detik lebih tinggi” dan “tugas selesai lebih awal” adalah dua hal berbeda. Jika membandingkan Neon dengan kedua GPT ini, output per detik Neon lebih tinggi, tetapi waktu per tugasnya justru lebih lama; alasannya adalah Neon menghasilkan token jauh lebih banyak.
Membandingkan Gemini 4 Neon dengan model pembanding secara terpisah
Angka-angka pada tabel di bawah ini semuanya berasal dari halaman model Artificial Analysis. Tingkat tiap model berbeda (Neon memakai xhigh, Carbon memakai high, yang lain memakai max), jadi kita hanya bisa melihat hubungan relatif dalam kolom yang sama, bukan menganggapnya sebagai pertandingan dengan kondisi yang sama.
| Model (tingkat) | Skor kecerdasan | Waktu per tugas | Output per detik | Waktu token pertama | Token keluaran saat menjalankan indeks |
|---|---|---|---|---|---|
| Gemini 4 Neon (xhigh) | 61 | 21,5 menit | 110 | 56,51 detik | 283 juta |
| Gemini 4 Carbon (high) | 60 | 37,2 menit | 55 | 73,04 detik | 205 juta |
| Claude Opus 5.5 (max) | 59 | 24,5 menit | 118 | 335,85 detik | 218 juta |
| Claude Fable 5.2 (max) | 65 | 41,6 menit | 110 | 247,46 detik | 275 juta |
| GPT-6.2 Astra (max) | 62 | 13,7 menit | 50 | 197,65 detik | 65,8 juta |
| GPT-6.2 Sol (max) | 57 | 8,5 menit | 79 | 75,06 detik | 60,9 juta |
Ditilik dari ketiga metrik satu per satu:
- Output per detik: Claude Opus 5.5 max sebesar 118 token/detik, lebih tinggi daripada Neon xhigh yang 110; Claude Fable 5.2 max sama dengan Neon, yaitu 110.
- Waktu per tugas: GPT-6.2 Sol max 8,5 menit dan GPT-6.2 Astra max 13,7 menit, keduanya lebih singkat daripada Neon xhigh 21,5 menit.
- Waktu token pertama: 56,51 detik milik Neon xhigh adalah nilai terkecil di tabel ini, tetapi tingkat di setiap baris berbeda, jadi tidak bisa disimpulkan bahwa ia unggul secara keseluruhan.
Ada dua versi angka untuk peningkatan kecepatan Neon dibanding Carbon. Halaman model Artificial Analysis memberikan Carbon high 55 token/detik dan 37,2 menit. Artikel Artificial Analysis memberikan angka perkiraan: Neon sekitar 21 menit per tugas, sekitar 40% lebih singkat daripada Carbon yang sekitar 36 menit; percepatan berasal dari kecepatan output sekitar 110 berbanding sekitar 57 token/detik, sementara token keluaran per tugas Neon sekitar 15% lebih banyak. Dua kumpulan angka Carbon memiliki dasar pengukuran berbeda, jadi di sini tidak dikurangkan.
Cara cepat memulai: pemilihan tingkat Gemini 4 Neon dan metode pengujian kecepatan
gemini-4-neon saat ini harus dipanggil melalui kanal resmi Google. Langkah-langkah di bawah dibagi menjadi dua bagian: pertama jelaskan cara memilih tingkat Neon, lalu jelaskan cara menyiapkan alur pengujian kecepatan menggunakan model Gemini 4 yang sudah tersedia di APIYI, sehingga setelah Neon tersedia Anda hanya perlu mengganti ID model.
Langkah pertama: pahami empat tingkat penalaran Neon. Panduan developer Google Cloud menyatakan bahwa tingkat penalaran gemini-4-neon hanya low, medium, high, dan xhigh, dengan default high. Mengirim thinking_budget atau MINIMAL akan mengembalikan HTTP 400 — inilah hal yang paling mudah terlanggar oleh kode yang dimigrasikan dari Gemini versi lama.
Langkah kedua: turunkan tingkat sesuai kebutuhan kecepatan. Jika terasa lambat, Anda bisa menurunkan dari default high ke medium atau low. Menurut halaman model Artificial Analysis, waktu per tugas akan turun dari 14.8 menit pada high menjadi 8.3 menit atau 3.7 menit, sementara skor kecerdasan turun dari 61 pada xhigh (default high adalah 60) menjadi 55 atau 44. Penurunan skor pada low cukup besar, jadi sebelum menurunkan tingkat sebaiknya lakukan sampling dulu pada tugas Anda sendiri untuk memastikannya.
Langkah ketiga: siapkan akun dan Key APIYI. Daftar di APIYI apiyi.com dan dapatkan API Key, lalu simpan Key di variabel environment (misalnya APIYI_API_KEY). Dalam kode hanya baca dari variabel environment, jangan menuliskan teks polos.
Langkah keempat: pilih cara pemanggilan. Untuk antarmuka kompatibel OpenAI, isi base_url dengan https://api.apiyi.com/v1 dan nama model dengan gemini-4-carbon atau gemini-4-hydrogen yang sudah tersedia; jika menggunakan protokol native Gemini, gunakan alamat https://api.apiyi.com dengan versi api v1beta.
Langkah kelima: catat tiga metrik secara terpisah. Aktifkan output streaming stream, lalu catat secara terpisah waktu kedatangan token jawaban pertama, token/detik setelah output dimulai, dan total waktu hingga seluruh tugas selesai, kemudian catat juga jumlah token total output kali ini. Dengan mengetahui jumlah token output, Anda baru bisa menilai apakah durasi panjang disebabkan karena “menulis lambat” atau “menulis banyak”.
🚀 Saran memulai cepat: Alur pengujian kecepatan sebaiknya dijalankan terlebih dahulu pada model Gemini 4 yang sudah tersedia. APIYI menggunakan satu Key untuk mencakup seri Gemini, Claude, dan GPT sekaligus; skrip pencatatan tiga metrik cukup ditulis sekali untuk membandingkan beberapa model secara berdampingan, dan setelah Neon tersedia Anda hanya perlu mengubah ID model.
Harga Gemini 4 Neon dan Verifikasi Model APIYI
Harga resmi Gemini 4 Neon (halaman harga Google AI Studio) adalah 3 USD per juta token untuk input dan 15 USD per juta token untuk output.
Di APIYI, kami memeriksa dua sumber: tabel utama APIYI (docs.apiyi.com/models.md, halaman ditandai diperbarui pada 2026-11-16 09:39, UTC+8), serta antarmuka harga yang dikueri pada 2026-11-19 (api.apiyi.com/api/pricing, versi shell-api-modelmak-v1, total 285 model). Model yang sudah tersedia dan dapat dibandingkan di kedua sumber adalah sebagai berikut, dalam USD per juta token.
| ID Model | Input | Baca cache | Output | Endpoint | Catatan (sumber) |
|---|---|---|---|---|---|
gemini-4-carbon |
2 | 0.1 | 10 | chat, gemini | Sesuai harga perkenalan Google hingga 2026-11-30 (tabel utama APIYI) |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | chat, gemini | Tabel utama APIYI |
claude-opus-5-5 / claude-opus-5-5-thinking |
4 | 0.2 | 20 | chat, messages | Tabel utama APIYI |
claude-fable-5-2 / claude-fable-5-2-thinking |
8 | 0.2 | 40 | chat, messages | Tabel utama APIYI |
gpt-6.2-sol |
2 (di atas 272000 menjadi 3) | 0.1 | 10 (tingkat tinggi antarmuka harga sekitar 11.25) | responses (direkomendasikan), chat | Tabel utama hanya mencantumkan lompatan tarif input |
gpt-6.2-astra |
8 (di atas 272000 menjadi 16) | 0.4 | 40 (tingkat tinggi antarmuka harga sekitar 60) | responses, chat | Tabel utama hanya mencantumkan lompatan tarif input |
Beberapa detail perlu diperhatikan. Harga yang tertera untuk gemini-4-carbon sesuai dengan harga perkenalan Google, bukan harga standar 4/20 setelahnya. Penulisan nama grup di kedua sumber tidak sepenuhnya sama: untuk model Gemini, tabel utama menulis Default, SVIP, sedangkan antarmuka harga menulis default, svip; untuk model Claude, tabel utama menulis ClaudeCode, Claude_Reverse, Claude_Enterprise, Default, SVIP, sedangkan antarmuka harga menulis ClaudeCode, ClaudeCodeReverse, ClaudeOfficial, default, svip. Harga output tingkat tinggi untuk model GPT hanya tercermin di antarmuka harga; di antarmuka harga tersebut, CompletionRatio berubah dari 5 menjadi 3.75 saat melebihi 272000 token.
gemini-4-neon belum tercantum di tabel utama APIYI maupun antarmuka harga, jadi untuk sementara belum tersedia. Kami akan segera menghadirkan model ini; model dan harga mengikuti daftar model di platform.
Analisis Kelebihan dan Kekurangan Gemini 4 Neon
Kelebihan
- Output per detik lebih tinggi daripada model pendahulu di keluarga yang sama: halaman model Artificial Analysis menunjukkan Neon xhigh 110 token/detik, sedangkan Carbon high 55 token/detik.
- Waktu tunggu token pertama relatif singkat: token pertama xhigh 56.51 detik, nilai terkecil dalam tabel perbandingan di atas (tingkatnya berbeda, hanya sebagai referensi).
- Granularitas tingkat pemikiran cukup halus: empat tingkat pemikiran, dari low 3.7 menit hingga xhigh 21.5 menit, sehingga bisa dipilih sesuai tugas.
- Spesifikasi lengkap: kartu model mencantumkan input teks, gambar, audio, dan video serta jendela konteks terpadu 1 juta token; panduan pengembang menjelaskan bahwa caching implisit otomatis berlaku untuk prefix bersama di atas 4096 token.
Keterbatasan
- Token output cenderung lebih banyak: sekali menjalankan indeks menghasilkan 283 juta token output, sehingga waktu per tugas xhigh lebih lama daripada Sol dan Astra. Solusinya adalah menurunkan tingkat, atau menyerahkan subtugas ke Hydrogen.
- Klasifikasi resmi hanya Moderate: AI Studio memberikan label Fast kepada Hydrogen; skenario yang mengejar interaksi tercepat sebaiknya mencoba Hydrogen lebih dulu.
- Sebagian konfigurasi tidak didukung: panduan pengembang menyebutkan tidak mendukung caching konteks eksplisit;
thinking_budgetdanMINIMALakan menghasilkan400. - Tidak ada tier gratis: halaman harga AI Studio menyebutkan bahwa
gemini-4-neontidak memiliki tier gratis. - Metodologi pengukuran skor bercampur: Coding Agent Index di blog Google adalah 58.6, sedangkan di artikel Artificial Analysis adalah 59; SWE-sweep 12.8% dan 39.0% berasal dari dua harness berbeda. Saat membaca data, perhatikan sumbernya.
Pertanyaan Umum (FAQ)
Q1: Apakah Gemini 4 Neon yang tercepat di keluarga Gemini 4?
Berdasarkan klasifikasi di halaman model terbaru Google AI Studio, Hydrogen adalah Fast, Neon Moderate, dan Carbon Deliberate. Yang dimaksud “selesai lebih cepat” oleh pihak resmi terutama adalah dibandingkan dengan Carbon.
Q2: Berapa lama waktu tunggu token pertama Gemini 4 Neon?
Tabel ringkasan di halaman model Artificial Analysis menunjukkan token pertama untuk xhigh adalah 56.51 detik. Kolom FAQ di halaman yang sama menuliskan high 40.64 detik, medium 20.14 detik, dan low 13.93 detik. Angka untuk ketiga tingkat ini berasal dari kolom FAQ, bukan dari tabel ringkasan yang sama.
Q3: Mengapa Gemini 4 Neon menghasilkan 110 token per detik, tetapi satu tugas tetap memakan waktu 21.5 menit?
Karena jumlah token yang dihasilkan banyak. Halaman model Artificial Analysis mencatat bahwa Neon xhigh dalam pengujian indeks menghasilkan 283 juta token, sedangkan Sol max hanya 60.9 juta dan Astra max hanya 65.8 juta. Jadi dua model terakhir lebih lambat per detik, tetapi waktu per tugasnya lebih singkat.
Q4: Tingkat mana yang digunakan Gemini 4 Neon secara default? Bagaimana cara menyetelnya agar lebih cepat?
Panduan pengembang menyatakan bahwa default-nya adalah high. Jika ingin lebih cepat, Anda bisa menurunkannya ke medium atau low. Menurut halaman model Artificial Analysis, waktu per tugas masing-masing menjadi 8.3 menit dan 3.7 menit, dengan skor kecerdasan turun dari 61 pada xhigh (high adalah 60) menjadi 55 atau 44.
Q5: Apakah Gemini 4 Neon sudah bisa dipanggil melalui APIYI sekarang?
Per 2026-11-19, `gemini-4-neon` belum muncul di tabel utama dan endpoint harga APIYI, jadi belum tersedia. Kami akan segera menyediakannya. Untuk saat ini, Anda bisa mendaftar di apiyi.com, lalu menggunakan `gemini-4-carbon` atau `gemini-4-hydrogen` yang sudah tersedia untuk menyiapkan alur pengujian kecepatan. Alamat kompatibel OpenAI sama seperti panduan memulai cepat di atas.
Q6: Berapa lebih murah Gemini 4 Neon dibandingkan Carbon?
Di sini ada tiga dasar perhitungan: blog Google menyebut biaya per tugas default high 32% lebih rendah daripada Carbon; artikel Artificial Analysis menyebut sekitar 17% lebih rendah daripada harga non-diskon Carbon; halaman model Artificial Analysis menghitung Carbon high sebesar 4.90 dolar AS per tugas berdasarkan harga perkenalan. Ketiga dasar perhitungannya berbeda, jadi tidak bisa digabung menjadi satu angka.
Q7: Apakah skor benchmark Gemini 4 Neon bisa langsung dibandingkan dengan kompetitor?
Perlu hati-hati. Kartu model mencantumkan bahwa hasil non-Gemini secara default berasal dari laporan masing-masing vendor, merupakan rangkuman resmi, bukan pengujian ulang pada hari yang sama; perbandingan Artificial Analysis juga memiliki perbedaan tingkat (xhigh, high, dan max dicampur).
Poin-Poin Penting Gemini 4 Neon
- Kecepatan terbagi jadi tiga: waktu token pertama, output per detik, dan waktu per tugas masing-masing berdiri sendiri, sehingga peringkatnya bisa saling bertentangan.
- Penilaian resmi ada di tengah: AI Studio menandai Neon sebagai Moderate, sedangkan Hydroge yang Fast.
- Data xhigh: halaman model Artificial Analysis mencantumkan 61 poin, 21.5 menit, 110 token/detik, waktu token pertama 56.51 detik.
- Volume output memperpanjang durasi: 283 juta token output membuat waktu per tugas Neon lebih lama daripada Sol dan Astra.
- Output per detik bukan yang tertinggi: 118 token/detik milik Opus 5.5 max lebih tinggi daripada 110 milik Neon.
- Turunkan tingkat demi kecepatan: medium 8.3 menit dengan 55 poin, low 3.7 menit dengan 44 poin, default high.
- Status ketersediaan: APIYI belum menyediakan Neon, sementara ini Anda bisa memakai model Gemini 4 yang sudah tersedia untuk menyiapkan alur pengukuran kecepatan.
Kesimpulan
Kesimpulan inti soal kecepatan Gemini 4 Neon:
- Memang lebih cepat dibanding Carbon: kedua set data Artificial Analysis menunjukkan output per detik Neon sekitar dua kali Carbon, dengan waktu per tugas yang jelas lebih singkat.
- Dalam cakupan lebih luas tidak selalu unggul: output per detiknya lebih rendah daripada Opus 5.5 max, dan waktu per tugasnya lebih lama daripada Sol max dan Astra max.
- Tingkat (tier) adalah tombol utama: output per detik tidak banyak berubah di antara empat tingkat, selisih durasi terutama berasal dari banyaknya token berpikir.
Penilaian kami: untuk skenario interaktif, lihat dulu waktu token pertama; untuk pemrosesan batch, lihat waktu per tugas; dan untuk pengalaman streaming, baru fokus pada output per detik. Apakah Neon “cukup cepat” bergantung pada metrik mana yang Anda pedulikan. Saran kami, jalankan dulu alur pencatatan ketiga metrik lewat APIYI apiyi.com memakai model Gemini 4 yang sudah ada, sehingga begitu Neon tersedia Anda bisa langsung mengganti nama model untuk membandingkan.
📚 Referensi
-
Postingan Sundar Pichai: Peluncuran Gemini 4 Neon dan cakupan ketersediaannya
- Tautan:
x.com/sundarpichai/status/2123167780988125621 - Keterangan: saluran peluncuran dan pernyataan resmi soal “menyelesaikan pekerjaan lebih cepat”
- Tautan:
-
Blog Google “Introducing Gemini 4 Neon”: skor benchmark, harga, dan posisi dalam keluarga model versi laporan resmi sendiri
- Tautan:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Keterangan: semua angka merupakan laporan resmi Google sendiri
- Tautan:
-
Model card DeepMind: spesifikasi dan tabel perbandingan tiga kolom
- Tautan:
deepmind.google/models/model-cards/gemini-4-neon/ - Keterangan: hasil non-Gemini secara default berasal dari laporan masing-masing penyedia
- Tautan:
-
Panduan developer Google Cloud: ID model, tingkat thinking, dan penjelasan error
- Tautan:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Keterangan: empat tingkat thinking, default high, serta kondisi yang memicu HTTP 400
- Tautan:
-
Halaman harga dan model terbaru Google AI Studio: harga resmi dan deskripsi kualitatif kecepatan
- Tautan:
aistudio.google.com/docs/pricing,aistudio.google.com/docs/latest-model - Keterangan: tiga tingkat kualitatif Deliberate, Moderate, Fast
- Tautan:
-
Artikel Artificial Analysis: perbandingan pihak ketiga antara Neon dan Carbon
- Tautan:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Keterangan: angka perkiraan seperti sekitar 21 menit, sekitar 36 menit, dan sekitar 57 token/detik
- Tautan:
-
Halaman model Artificial Analysis: kecepatan empat tingkat dan data model pembanding
- Tautan:
artificialanalysis.ai/models/gemini-4-neon - Keterangan: dibaca pada 2026-11-19, indeks v5.0.1, kolom FAQ juga memuat waktu token pertama tiap tingkat
- Tautan:
-
Tabel utama APIYI: model yang sudah tersedia beserta harganya
- Tautan:
docs.apiyi.com/models.md - Keterangan: model dan harga mengacu pada daftar model di platform
- Tautan:
Penulis: Tim Teknis APIYI
Kontak teknis: Untuk progres ketersediaan Gemini 4 Neon dan pertanyaan seputar model, silakan hubungi kami lewat halaman utama APIYI di apiyi.com