Zusammenfassung: In den codegetriebenen Video-Aufgaben von VibeVideoBench liegt GPT-6 Astra bereits auf dem Niveau von Claude Opus 5.5 – mit etwas höherer Gesamtqualität und niedrigeren Kosten; Opus 5.5 liefert zuverlässiger; das nächste universelle Modell von OpenAI ist noch nicht erschienen, seine Videofähigkeiten müssen nach dem Release real getestet werden.
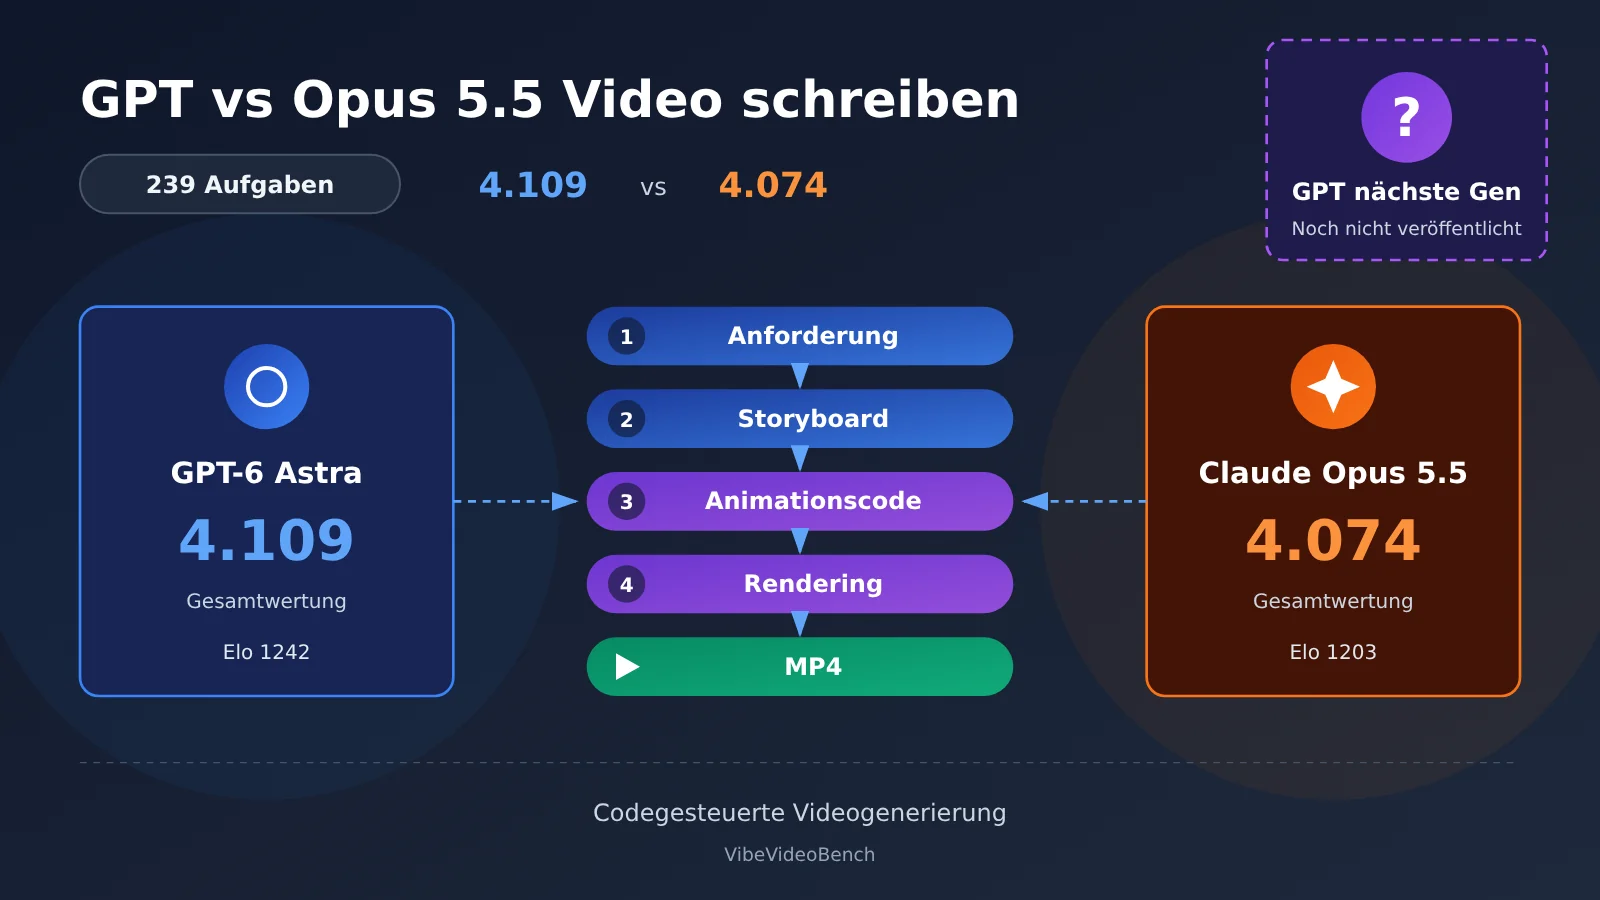
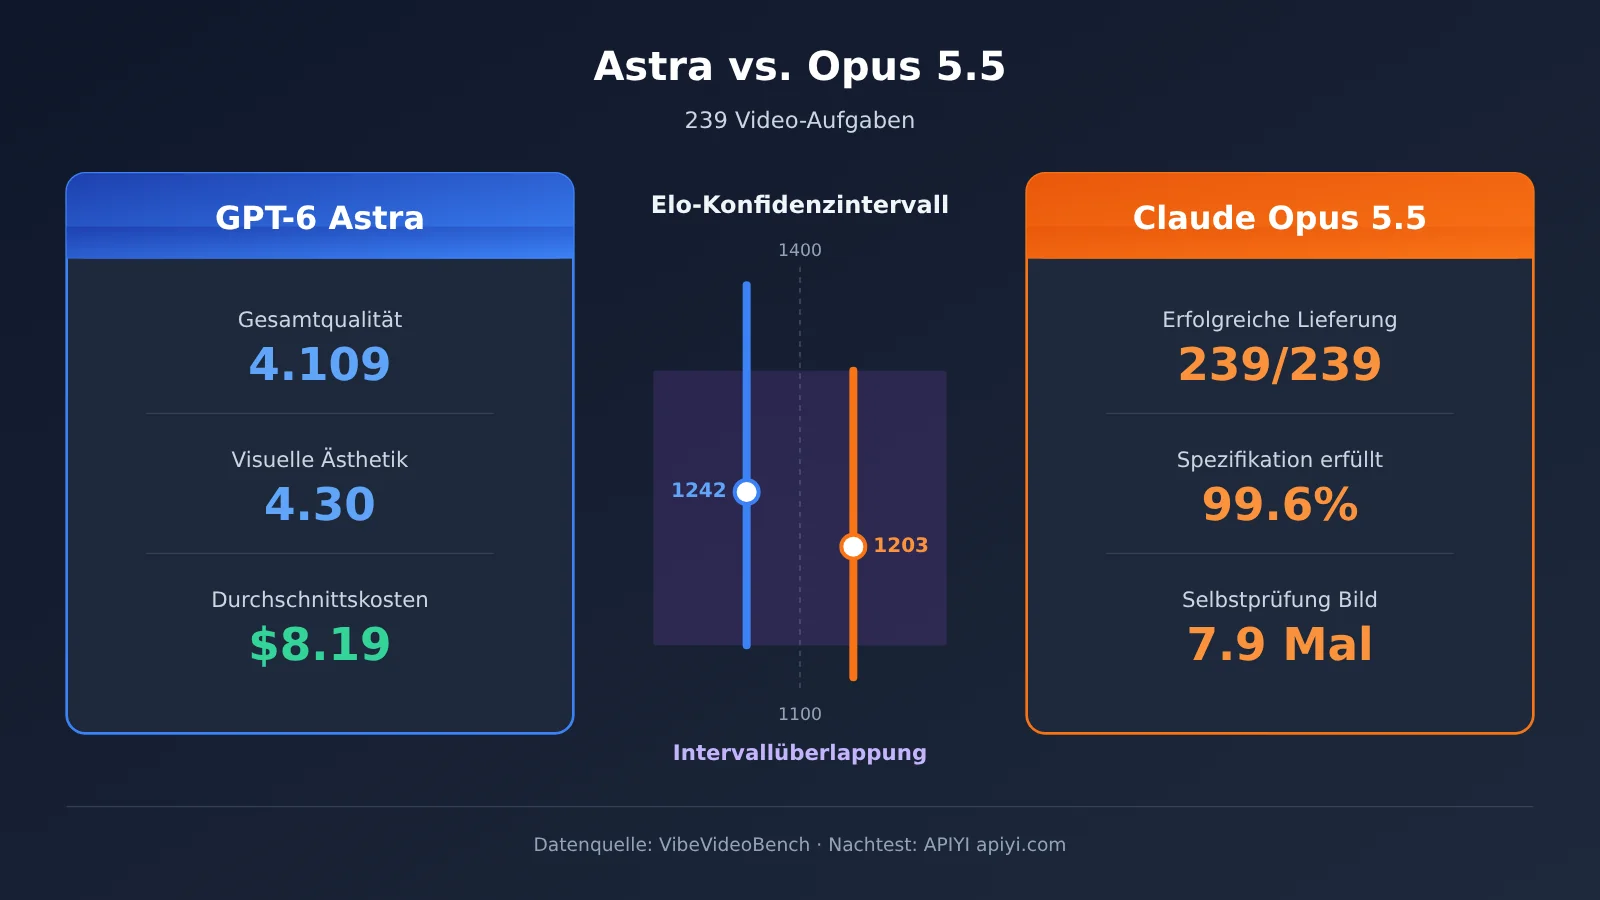
Fazit zuerst: Stand 15. November 2026 sind GPT-6 Astra und Claude Opus 5.5 auf dem Weg „Agent schreibt Code, ruft Rendering-Tools auf, liefert eine komplette MP4-Datei“ die beiden Systeme, die sich in VibeVideoBench am nächsten kommen. Astra erreicht einen Gesamtqualitäts-Score von 4,109, Opus 5.5 von 4,074; im menschlichen Blindtest liegen die Elo-Werte bei 1242 bzw. 1203 – statistisch nicht unterscheidbar. Opus 5.5 liefert alle 239 Aufgaben ab, mit einer strikten Erfolgsquote von 76,3 %, höher als Astras 74,5 %; Astra kostet pro Aufgabe durchschnittlich 8,19 US-Dollar an API-Kosten, etwa die Hälfte von Opus 5.5. OpenAI hat zwei Belege dafür veröffentlicht, dass interne Modelle deutlich stärker als Astra sind, doch Name, Veröffentlichungsdatum und videobezogene Ergebnisse der nächsten universellen GPT-Generation sind nicht bekannt. Die Antwort auf die Titelfrage lautet also: Das aktuelle GPT hat aufgeholt; ob die nächste Generation einen Abstand schaffen kann, entscheidet sich erst im Praxistest nach dem Release.
Was Sie erwartet: Der folgende Text grenzt zunächst den Evaluierungsumfang ab, zerlegt dann die Gesamtergebnisse, die Ergebnisse nach Kategorien, die menschlichen Präferenzen und die Kostendaten von VibeVideoBench und zeigt, woher die jeweiligen Stärken kommen; anschließend werden die öffentlichen Signale zu den internen Modellen von OpenAI und der Veröffentlichungsstatus der nächsten Generation zusammengefasst und die eigentlichen Engpässe von Video-Agenten analysiert; zum Schluss folgt eine direkt wiederverwendbare Vergleichsmethodik, mit der Sie nach dem Release eines neuen Modells beurteilen können, ob es sich lohnt, die bestehende Lösung zu ersetzen.
Zum Vorwissen: Begriffe, die Sie vor der Lektüre kennen sollten
| Begriff | Erklärung |
|---|---|
| Code-driven Video Generation | Codegesteuerte Videogenerierung: Die KI schreibt Animations- und Rendering-Programme und erzeugt am Ende eine MP4-Datei. |
| Native Video Generation | Native Videogenerierung: Das Modell erzeugt Videoinhalte direkt aus Text oder Bildern; bekannte Produkte sind Sora und Veo. |
| VibeVideoBench | Ein Benchmark, der speziell prüft, ob KI-Agenten selbstständig vollständige Videos erstellen können; veröffentlicht am 26. Oktober 2026. |
| Harness | Modell-Laufzeitumgebung mit Funktionen wie Codeausführung, Dateizugriff und Tool-Aufrufen, z. B. Codex CLI, Claude Code. |
| L1 / L2 / L3 | Die drei Bewertungsebenen: Prüfung der Programmabgabe, Prüfung jeder einzelnen Aufgabenanforderung und multimodale Bewertung der Videoqualität. |
| Strikte Aufgaben-Erfolgsrate | Anteil der Aufgaben, bei denen das Video erfolgreich abgeliefert wurde und alle Vorgaben erfüllt sind – strenger als eine reine Abgabequote. |
| Bradley–Terry Elo | Bewertungsmethode, die aus paarweisen menschlichen Vergleichen die relative Präferenz zwischen Modellen berechnet. |
| Multi-agent Orchestration | Mehrere Agenten arbeiten mit verteilten Rollen zusammen; anschließend werden die Ergebnisse zusammengeführt. |
| Render Pipeline | Video-Rendering-Pipeline: Bilderzeugung, Audiobearbeitung, Codierung und Zusammenführung bis zur finalen Ausgabe. |
| Remotion / FFmpeg | Ersteres erstellt Videoanimationen mit React-Code, Letzteres übernimmt die Audio- und Video-Codierung sowie die Zusammenführung. |
| ffprobe | Prüfwerkzeug aus dem FFmpeg-Paket, mit dem sich Auflösung, Bildrate, Dauer, Audiospuren und weitere Informationen eines Videos auslesen lassen. |
| Cache Hit | Cache-Trefferquote: Anteil des wiederholten Kontexts, der aus dem Cache gelesen wird; beeinflusst direkt die API-Kosten bei Aufgaben mit langer Laufzeit. |
| BenchCAD 2.0 | Engineering-Benchmark zur Prüfung, wie gut KI 3D-Bauteile rekonstruiert, mechanische Baugruppen konstruiert und PCB-Verbindungen erkennt. |
1 Zuerst das Fazit: GPT ist bei der Videokreation bereits in den Wettbewerbsbereich von Opus 5.5 vorgedrungen
1.1 Welche Variante des „Videoschreibens“ hier verglichen wird
Für die KI-Videokreation gibt es derzeit zwei Ansätze. Bei der nativen Videogenerierung gibt das Modell direkt fortlaufende Bildfolgen aus; sie eignet sich besonders für Charaktere, physikalische Bewegungen und Kamerasprache. Bei der codegesteuerten Videogenerierung agiert das Modell als Regisseur und Programmierer in einer Person: Es versteht die Anforderungen, schreibt Drehbuch und Storyboard, programmiert Animationen mit Remotion, Three.js, Cairo oder Blender, erzeugt per TTS den Off-Kommentar und setzt alles anschließend mit FFmpeg zusammen, um den fertigen Film zu prüfen.
Dieser Artikel behandelt den zweiten Ansatz: die Fähigkeit, über Agenten wie Codex CLI und Claude Code vollständige MP4-Dateien und editierbare Projekte abzuliefern. Dieser Ansatz eignet sich für Datenvisualisierung, Produktpräsentationen, Wissensvermittlung, animierte Infografiken und Markenwerbefilme. Zugleich ist er der Bereich, in dem GPT und Claude derzeit über einen eigenständigen Benchmark vergleichbar sind.
Die eigene native Videoproduktlinie von OpenAI hat sich verändert: Das Sora-Produkt wurde am 26. April 2026 eingestellt, das Sora-2-Modell und die Videos API wurden am 24. September abgeschaltet. In der offiziellen Ankündigung zur Einstellung heißt es, es gebe keine Eins-zu-eins-Ersatz-API. Das am 4. November veröffentlichte GPT-Image-2.6 unterstützt GIF-Animationen mit 2 bis 16 Frames und eignet sich für Sticker, Schleifenanimationen und Storyboard-Vorschauen; es gehört damit zu einem anderen Workflow als die vollständige MP4-Produktion. Die Fähigkeit der GPT-Familie, „Videos zu schreiben“, zeigt sich derzeit also vor allem auf dem codegesteuerten Weg.
1.2 Eine Antwort in einem Satz auf die Titelfrage
In VibeVideoBench liegt GPT-6 Astra sehr dicht bei Opus 5.5: Die Gesamtbewertung ist etwas höher, die Zuverlässigkeit der finalen Auslieferung etwas niedriger. Das nächste OpenAI-Modell zeigt technische Signale für weitere Verbesserungen, doch die veröffentlichten videobezogenen Benchmark-Ergebnisse nehmen weiterhin Astra als Referenz.
2 239 echte Videoaufgaben: Wer ist stärker – GPT-6 Astra oder Opus 5.5?
2.1 Wie VibeVideoBench die Videofähigkeiten von GPT und Opus 5.5 misst
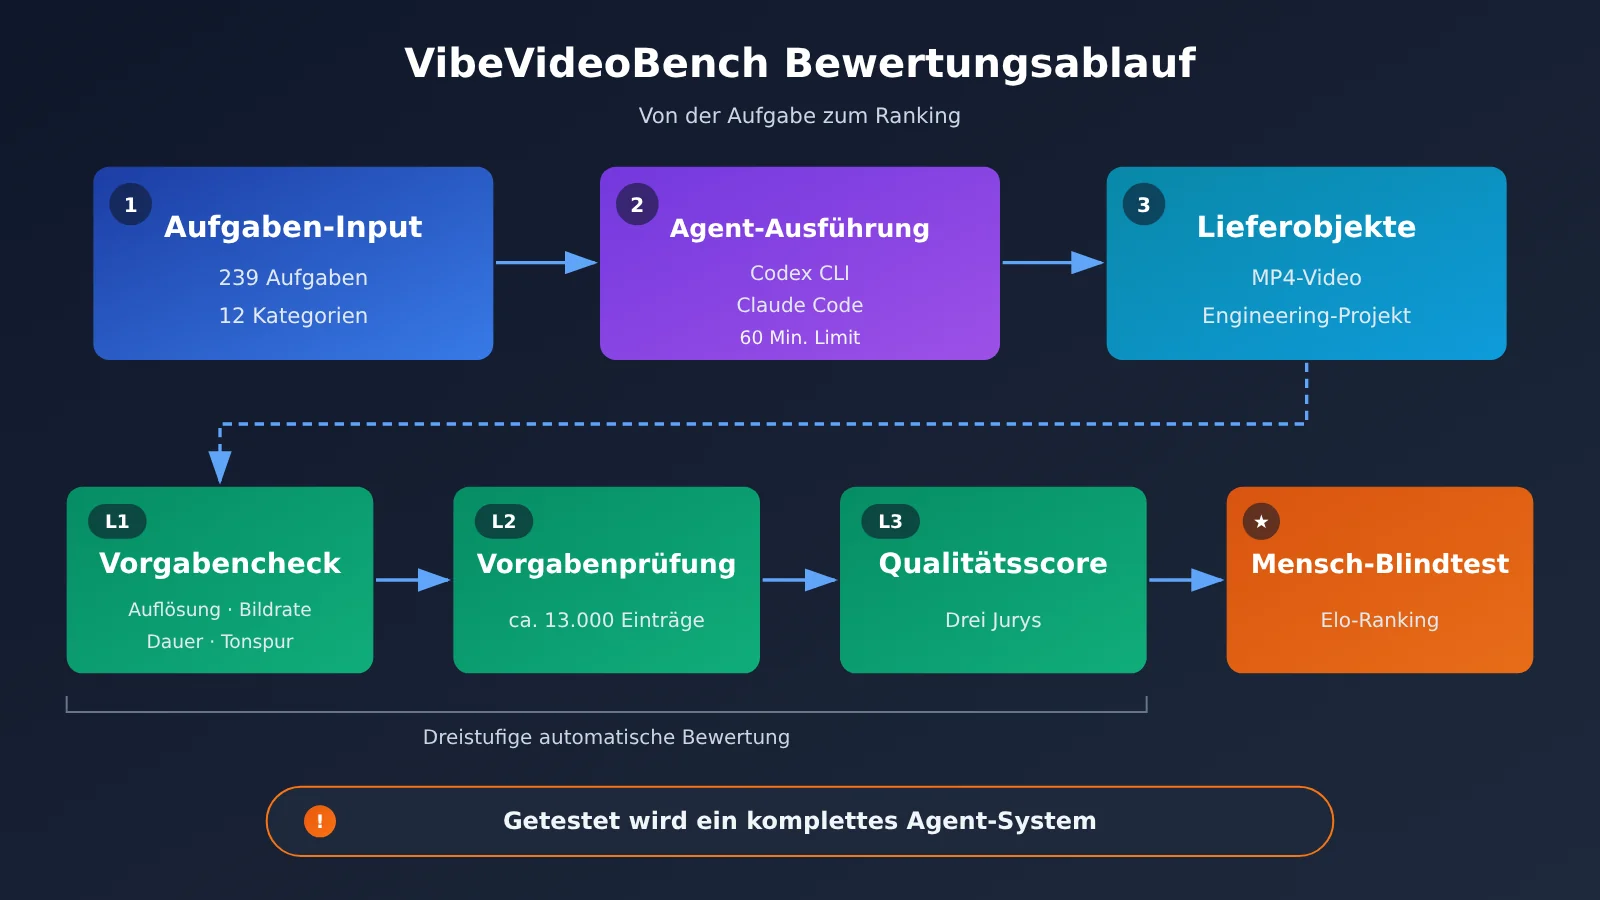
VibeVideoBench hat 239 echte Video-Produktionsaufgaben aus 12 Inhaltskategorien zusammengestellt und damit 9 Agent-Systeme in 2.151 Läufen getestet. Jede Aufgabe muss die KI selbstständig in einer Sandbox erledigen und dabei eine abspielbare MP4, ein Projekt, mit dem sich das Video erneut erzeugen lässt, sowie eine Produktionsdokumentation abliefern. Pro Aufgabe gelten 60 Minuten, alle Systeme arbeiten in ihrer eigenen nativen Entwicklungsumgebung mit der höchsten verfügbaren Reasoning-Stufe, und während des Laufs werden keine weiteren Anweisungen von Menschen eingespielt.
GPT-6 Astra läuft in der Codex CLI, Claude Opus 5.5 in Claude Code. Die übrigen getesteten Systeme sind Claude Sonnet 5.5, Gemini 4 Argon, DeepSeek V4.1 Flash, Kimi K3, GLM-5.3 Flash, GPT-5.6 Sol und Gemini 3.8 Flash. Die Bewertung erfolgt in drei Ebenen: L1 prüft, ob die MP4 überhaupt abgeliefert wurde und ob Spezifikationen wie Auflösung, Bildrate, Dauer und Tonspur passen; L2 verifiziert Punkt für Punkt die rund 13.000 Aufgabenanforderungen; L3 lässt drei multimodale Bewertungssysteme Bildqualität, Ästhetik, inhaltliche Logik, Bewegungsrhythmus und Audio-Synchronität beurteilen.
2.2 Vergleich der Gesamtergebnisse von GPT-6 Astra und Opus 5.5
| Kennzahl | GPT-6 Astra | Claude Opus 5.5 | Vorsprung |
|---|---|---|---|
| Erfolgreich gelieferte Videos | 238/239 | 239/239 | Opus |
| Video-Lieferquote | 99.6% | 100% | Opus |
| Spezifikationskonformität | 93.7% | 99.6% | Opus |
| Bestehensquote der Aufgabenanforderungen | 97.1% | 97.3% | Opus |
| Videoqualität | 4.08 | 3.99 | Astra |
| Visuelle Ästhetik | 4.30 | 4.19 | Astra |
| Inhaltliche Logik | 4.20 | 4.18 | Astra |
| Bewegung und Rhythmus | 3.95 | 3.95 | Gleichstand |
| Audioqualität und -synchronisation | 4.10 | 4.07 | Astra |
| Gesamtqualitätswert | 4.109 | 4.074 | Astra |
| Strikte Aufgaben-Erfolgsrate | 74.5% | 76.3% | Opus |
| Menschliche Präferenz (Elo) | 1242 | 1203 | Statistisch nicht unterscheidbar |
Die Daten stammen aus den gemittelten Ergebnissen dreier Bewertungsjurys, die Bewertungsskala reicht von 1 bis 5 Punkten. Beide Systeme liegen vor allen anderen getesteten Systemen.
Die Tabelle zeigt eine klare Arbeitsteilung: Astra hat einen leichten Vorsprung bei der Frage „sieht das fertige Video gut aus“ – 0.035 Punkte bei der Gesamtqualität und 0.11 Punkte bei der visuellen Ästhetik. Opus 5.5 ist zuverlässiger bei der Frage „lässt sich das Ergebnis überhaupt spezifikationsgerecht abliefern“ – die Spezifikationskonformität liegt um 5.9 Prozentpunkte höher, die strikte Aufgaben-Erfolgsrate um 1.8 Prozentpunkte. Der Abstand von 0.035 Punkten ist sehr klein; betrachtet man das Elo-Konfidenzintervall, bewegen sich beide im selben Leistungsband.
2.3 Vorteilsverteilung von GPT und Opus 5.5 bei verschiedenen Videotypen
| Videokategorie | Astra | Opus 5.5 | Führend |
|---|---|---|---|
| Marke und Marketing | 4.18 | 4.18 | Gleichstand |
| Produkt- und Funktionspräsentation | 4.20 | 4.24 | Opus |
| Musik- und soundgetrieben | 3.83 | 3.92 | Opus |
| Paper-Erklärung | 4.03 | 4.07 | Opus |
| Erklärung von Konzepten und Prozessen | 4.19 | 4.15 | Astra |
| Daten- und Faktenstorys | 4.14 | 4.01 | Astra |
| Visuelle Kunst | 3.94 | 3.91 | Astra |
| Spiele und Sport | 4.15 | 4.12 | Astra |
| Events und persönlicher Ausdruck | 4.03 | 3.93 | Astra |
| Storytelling und visuelle Komödie | 4.00 | 3.88 | Astra |
| Bau- und Fertigungsprozesse | 3.97 | 3.94 | Astra |
| Unterricht im Klassenzimmer | 4.47 | 4.45 | Astra |
Die Daten stammen aus Anhang E.4 der Arbeit; nicht gelieferte Videos wurden mit null Punkten gewertet.
Astra führt in 8 von 12 Kategorien. Die größten Abstände zeigen sich bei Daten- und Faktenstorys (0.13) sowie bei Storytelling und visueller Komödie (0.12). Opus 5.5 liegt bei Produktpräsentationen, musikgetriebenen Videos und Paper-Erklärungen vorn, wobei der Abstand bei musikgetriebenen Videos 0.09 beträgt. Musikbezogene Aufgaben stellen hohe Anforderungen an die Audio-Bild-Ausrichtung, Produktpräsentationen an Spezifikationen und Details – das passt zu der Richtung, in der Opus bei der Einhaltung von Spezifikationen Vorteile hat. In den meisten Kategorien liegen die Unterschiede innerhalb von 0.05 Punkten. Bei der Modellwahl zeigen sich bereits Unterschiede je nach Aufgabentyp, doch Unterschiede in einzelnen Kategorien sollten weiterhin anhand wiederholter Tests beurteilt werden.
2.4 Warum Opus 5.5 weiterhin wettbewerbsfähig ist
Der manuelle Blindtest berechnet Elo mithilfe des Bradley–Terry-Modells. Astra erreicht 1242 (95 %-Konfidenzintervall 1134–1387), Opus 1203 (1111–1327). Die Konfidenzintervalle für die Rangfolge liegen bei beiden Modellen jeweils bei 1–3; die im Paper angegebene Vergleichswahrscheinlichkeit beträgt P=0.69. Daraus folgt, dass sie statistisch nicht unterscheidbar sind. Zu beachten ist jedoch, dass der manuelle Test nur bereits gelieferte Videos bewertet und die Fähigkeit zur pünktlichen Lieferung nicht messen kann – und genau bei der Lieferung liegt eine Stärke von Opus.
Das Selbstprüfungsverhalten erklärt diesen Umstand. Pro Lauf sah Opus durchschnittlich 7.9 gerenderte Bilder an und setzte ffprobe 3.9-mal ein; bei Astra waren es 3.4 bzw. 2.1-mal. Opus prüft seine eigene Ausgabe häufiger, entdeckt Probleme und behebt sie – das resultiert in einer Lieferquote von 100 % und einer Spezifikationskonformität von 99.6 %. Anthropic positioniert Opus 5.5 als Agentic-Coding-Modell für lange Laufzeiten. In der Community gibt es zudem Nutzerberichte, wonach sie damit in rund 30 Minuten ein Promo-Video für eine iOS-App erstellt und automatisch ein vertikales 1080×1920-Nachrichtenvideo mit SRT-Untertiteln produziert haben; dabei handelt es sich um persönliche Einzelfälle, die als Nebenbeleg für die Vollständigkeit des Workflows dienen können.
2.5 Kosten für Videoprojekte: GPT-6 Astra hat den höheren Einzelpreis, kostet pro Projekt aber weniger
| Metrik | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|
| Standard-Eingabepreis (USD pro Million Token) | 10 | 4 |
| Standard-Ausgabepreis (USD pro Million Token) | 50 | 20 |
| Durchschnittliche Projektkosten | $8.19 | $15.38 |
| Median-Projektkosten | $7.88 | $10.19 |
| P90-Projektkosten | $11.88 | $31.22 |
| Durchschnittliche Ausgabe-Token | 61K | 130.7K |
| API-Aufrufe pro Projekt | 46 | 51 |
| Cache-Hit | 97% | 65% |
Der Standardpreis von Astra ist 2,5-mal so hoch wie der von Opus 5.5, die durchschnittlichen Projektkosten liegen aber rund 46,7 % niedriger. Dafür gibt es zwei Gründe: Astra gibt etwa 53,3 % weniger Token aus, und bei Astra liegt die Cache-Hit-Rate bei 97 %, während bei Opus etwa 76 % der Projektkosten aus Cache-Write stammen. Der Unterschied bei den P90-Kosten fällt noch deutlicher aus: Bei Opus schwanken die Kosten bei komplexen Aufgaben stärker. Die Studie weist außerdem darauf hin, dass ein höherer Token-Verbrauch allein keine entsprechende Qualitätssteigerung gebracht hat.
Diese Kostenzahlen sind Äquivalenzkosten, umgerechnet auf Basis der öffentlichen API-Preise. Personal- und Materialkosten für ein vollständiges kommerzielles Video sind darin nicht enthalten. Die offizielle Batch API von Opus 5.5 gewährt 50 % Rabatt auf Ein- und Ausgabe, sodass sich die Kostenstruktur bei der Offline-Massenproduktion verändert.
💰 Kostenoptimierung: Die Kosten pro Projekt eines Video-Agenten hängen stark von der Cache-Hit-Rate und der Ausgabelänge ab – wer nur auf den Einzelpreis schaut, liegt schnell daneben. Die Empfehlung: Bei APIYI apiyi.com dieselbe Aufgabe einmal mit beiden Modellen laufen lassen und nach dem „tatsächlichen Verbrauch pro fertigem Video“ kalkulieren, statt Listenpreise zu vergleichen.
3 Signale für den Fähigkeitssprung der nächsten GPT-Generation von OpenAI
3.1 Navier–Stokes-Forschung: das interne Modell ist deutlich stärker als GPT-6 Astra
Am 8. September 2026 veröffentlichte OpenAI Forschungsergebnisse zum Millennium-Preisproblem der Navier–Stokes-Gleichungen. Der offizielle Beitrag stellt ausdrücklich klar, dass das verwendete interne Modell deutlich leistungsfähiger ist als GPT-6 Astra, mit groß angelegtem Reinforcement Learning trainiert wurde und das Training zum Zeitpunkt der Ankündigung noch lief.
Der Umfang dieser Untersuchung ist eine direkte Demonstration der Multi-Agenten-Fähigkeiten: Rund 10.000 Agenten arbeiteten gleichzeitig, die Studie dauerte etwa 88 Stunden und erzeugte 2,7 Millionen Nachrichten sowie rund 130 Milliarden Output-Token. Die Agenten untersuchten in Gruppen verschiedene Versionen des Problems, die Gruppen tauschten Informationen untereinander aus, Codex führte die Zwischenergebnisse zusammen, und das System verlagerte die Ressourcen fortlaufend auf die vielversprechenderen Ansätze. Die abschließende formale Verifikation in Lean dauerte weitere 17 Stunden und wurde mit GPT-6 Astra durchgeführt.
Für die Videoproduktion ist hier weniger die mathematische Leistung relevant als vielmehr die Langfrist-Planung von Aufgaben und die Zusammenarbeit mehrerer Agenten. Ein komplexes Video erfordert ebenfalls die parallele Bearbeitung von Skript, Animation und Audio – und danach das Zusammenführen, Prüfen und Nacharbeiten.
3.2 BenchCAD 2.0: Engineering-Fähigkeit steigt von 0,594 auf 0,875
Am 3. November 2026 gab OpenAI in „Accelerating engineering for the physical world“ bekannt: Ein neueres internes Modell erreicht in BenchCAD 2.0 einen Durchschnittswert von 0,875, GPT-6 Astra kommt bei höchster Inferenzintensität auf 0,594 – eine relative Verbesserung von rund 47,3 %. Getestet wurden unter anderem die Rekonstruktion dreidimensionaler Bauteile, das Design mechanischer Baugruppen und die Erkennung von PCB-Verbindungen.
Diese beiden Belege sollten getrennt betrachtet werden. OpenAI hat nicht mitgeteilt, ob es sich bei dem in BenchCAD getesteten Modell und dem für die Navier–Stokes-Forschung verwendeten Modell um dasselbe handelt; auch Namen und Veröffentlichungsdatum wurden nicht genannt. BenchCAD ist ein von OpenAI selbst veröffentlichter Engineering-Test und ein Signal für Fortschritte beim räumlichen Verständnis und bei komplexem Ingenieurwissen – einen direkten Bezug zu Aufgaben der Videogenerierung gibt es nicht.
3.3 Wann die nächste GPT-Generation erscheint: der öffentliche Stand bis zum 15. November
| Datum | Öffentlicher Fortschritt |
|---|---|
| 2. November | Laut einem Bericht von The National sagte Altman auf der ADIPEC, für die mathematische Forschung sei ein kurz vor der Veröffentlichung stehendes GPT-Modell verwendet worden, wobei rund 10.000 Agenten etwa vier Tage lang zusammengearbeitet hätten; der Bericht vermerkt, dass diese Aussage nicht unabhängig überprüft wurde |
| 3. November | OpenAI veröffentlicht die BenchCAD-2.0-Daten des internen Modells |
| 4. November | The Information berichtet unter Berufung auf informierte Personen, OpenAI könnte bereits am 6. November eine neue Generation von Astra, Sol und einem Cybersicherheitsmodell vorstellen |
| 5. November | Das OpenAI-API-Changelog bestätigt die Veröffentlichung von GPT-6 Cyber, nicht aber einer neuen allgemeinen Generation von Astra oder Sol |
| 15. November | In der offiziellen Modellübersicht sind die allgemeinen Flaggschiffe weiterhin GPT-6 Astra, GPT-6.1 Sol, GPT-6.1 Terra und GPT-6 Luna |
Namen wie GPT-6.2 Astra oder GPT-6.2 Sol, die im Netz kursieren, sind derzeit nicht offiziell von OpenAI bestätigt. Zu beachten ist ebenso: VibeVideoBench testet GPT-6 Astra und GPT-5.6 Sol – die Ergebnisse von Astra lassen sich nicht ohne Weiteres auf GPT-6.1 Sol oder Terra übertragen.
4 Was der nächsten GPT-Generation noch fehlt, um Opus 5.5 in der Videokreation zu übertreffen
4.1 Der eigentliche Engpass von Video-Agenten: Zeitmanagement und Auslieferung
Von den insgesamt 2.151 Läufen in VibeVideoBench haben 224 kein abspielbares Video ausgeliefert. Davon entfielen 169 auf Zeitmanagement-Probleme: Das finale Rendering startete zu spät, lief zu langsam oder wurde gar nicht gestartet – rund 75 % aller Fehlschläge. Die Testumgebung war ein einheitlicher Docker-Container mit 8 CPU-Kernen, 32 GB RAM und ohne GPU; schon das Rendering selbst beansprucht beträchtlich viel Zeit.
Das zeigt: Wenn die Inferenzfähigkeit eines Modells steigt, muss sich das auch im Ausführungsrhythmus niederschlagen. Ein Modell mag die Animation noch so fein ausarbeiten – startet das Rendering erst in der 55. Minute, bleibt das Ergebnis bei null Punkten. Astra und Opus 5.5 sind in puncto Qualität bereits kaum noch zu unterscheiden; der Spielraum für die nächste GPT-Generation, sich abzusetzen, liegt vor allem auf der Auslieferungsseite.
4.2 Sieben Verbesserungspunkte der nächsten GPT-Generation im Video-Workflow
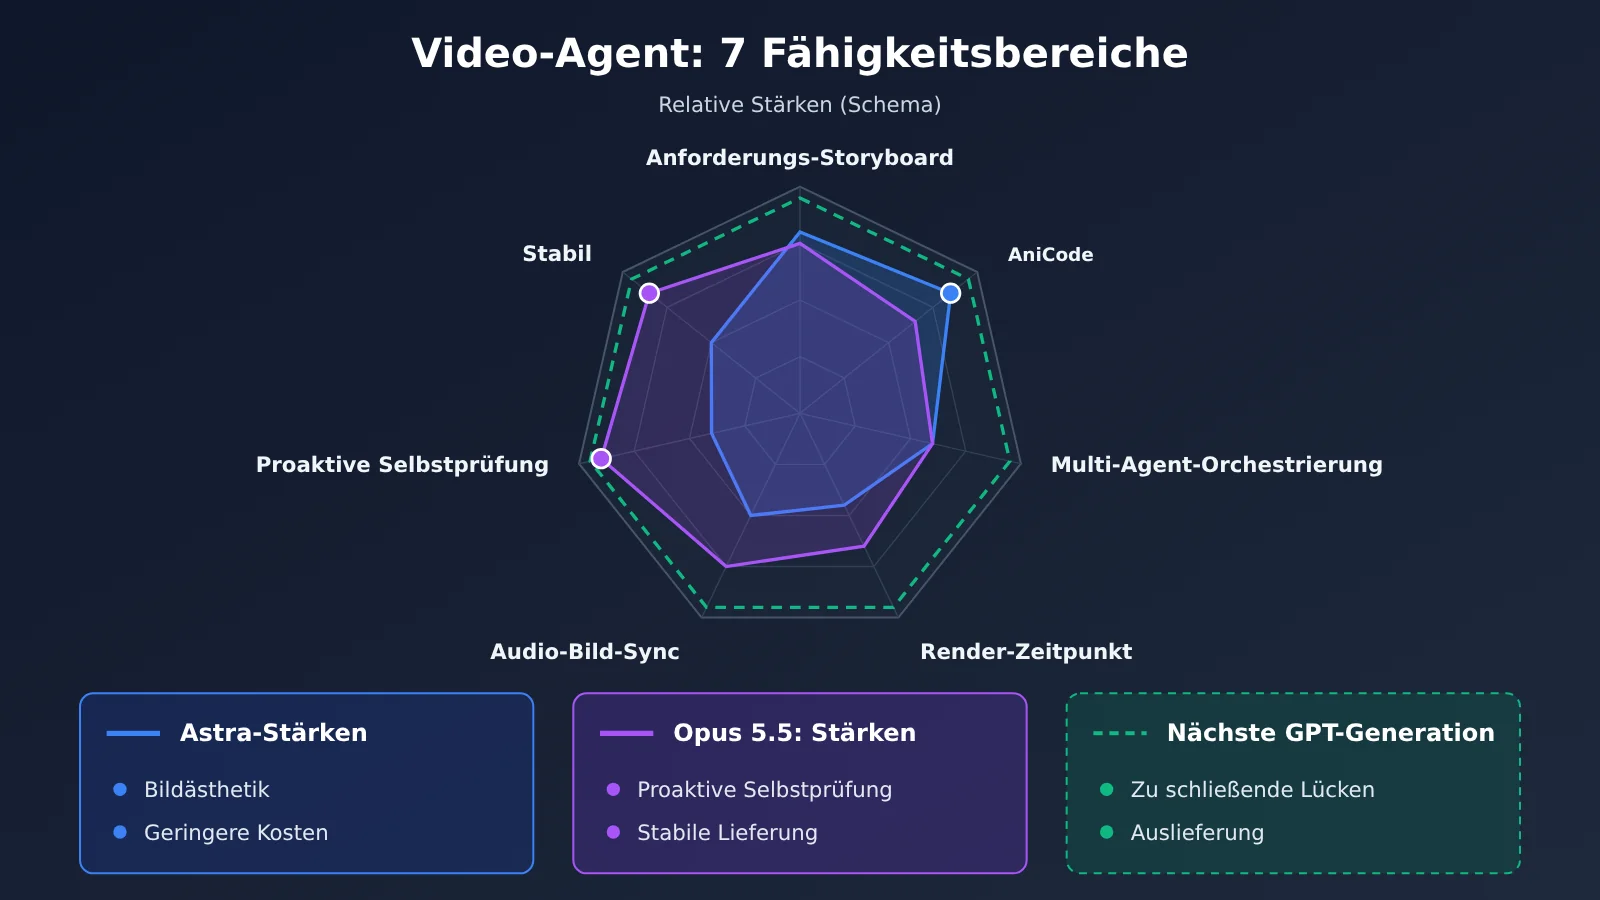
Aus den aktuellen Stärken und Schwächen beider Modelle ergibt sich: Soll das nächste Modell Opus 5.5 deutlich übertreffen, muss es sich in den folgenden Bereichen gleichzeitig verbessern:
- Anforderungs- und Storyboard-Verständnis: Thema, Zielgruppe und Stil präzise erfassen und die Anforderung in Szenenreihenfolge und Zeitachse aufschlüsseln.
- Komplexer Animationscode: Remotion, Three.js und Python-Animationen auf Anhieb korrekt schreiben, um Nacharbeit beim Rendern zu reduzieren.
- Multi-Agent-Orchestrierung: Skript, Animation und Audio parallelisieren; die Orchestrierungsfähigkeit, die die internen Modelle in der mathematischen Forschung gezeigt haben, muss auf solche Engineering-Aufgaben übertragen werden.
- Renderzeitpunkt: Ausreichend Zeit für das Rendering einplanen, um die Zeitmanagement-Probleme zu vermeiden, die etwa drei Viertel aller Fehlschläge ausmachen.
- Bild-Ton-Synchronisation: Erzähler, Soundeffekte und Bildrhythmus aufeinander abstimmen – hier liegt Opus bei musikgetriebenen Aufgaben vorn.
- Aktive Selbstprüfung: Opus sieht sich Bilder im Durchschnitt 7,9-mal an, Astra 3,4-mal; die Häufigkeit der Selbstprüfung korreliert direkt mit der Quote der Spezifikationserfüllung.
- Stabile Auslieferung: Vollständige MP4 plus editierbares Projekt, Spezifikation auf Anhieb erfüllt.
5 Wie man nach der Veröffentlichung des nächsten GPT überprüft, ob es Opus 5.5 wirklich übertrifft
5.1 Eine siebenstufige Vergleichstestmethode
Öffentliche Benchmarks laufen nur einmal, sind auf 60 Minuten begrenzt und bestehen überwiegend aus englischen Aufgaben (209 von 239 Aufgaben sind englisch). Chinesische Geschäftsszenarien müssen daher selbst nachgetestet werden. Die folgende Methode lässt sich am Tag der Veröffentlichung eines neuen Modells direkt wiederverwenden:
| Schritt | Vorgehen | Relevante Kennzahlen |
|---|---|---|
| 1 Fester Aufgabensatz | 10–20 echte geschäftliche Videoanforderungen auswählen, die Skript, Animation, Datenvisualisierung und Produktpräsentation abdecken | Aufgabenabdeckung |
| 2 Feste Umgebung | Einheitliche Toolchain (Remotion/FFmpeg-Version), Maschinenkonfiguration und Zeitlimit; Harness-Unterschiede separat dokumentieren | Vergleichbarkeit |
| 3 Test nach Abschnitten | Zuerst Storyboard und Animationscode einzeln über die API testen, dann den gesamten Ablauf in der Agent-Umgebung durchlaufen | Abschnittsbewertung |
| 4 Verbrauch erfassen | Laufzeit pro Durchlauf, Eingabe-/Ausgabe-Token, Cache-Treffer | Kosten pro Video |
| 5 Lieferprüfung | Mit ffprobe Auflösung, Bildrate, Dauer und Tonspur überprüfen | Lieferquote, Spezifikationserfüllungsrate |
| 6 Blindtests und Wiederholungen | Modellnamen ausblenden und paarweise vergleichen, jede Aufgabe mindestens dreimal durchführen | Präferenzgewinnrate, Varianz |
| 7 Gesamtbewertung | Qualität, Erfolgsquote, Änderungskosten und Kosten pro Video gewichtet | Finale Auswahlentscheidung |
Der dritte Schritt trennt die „Modellfähigkeit“ von der „Agent-Umgebungsfähigkeit“. VibeVideoBench testet ein vollständiges Agent-System, und auch Codex CLI und Claude Code unterscheiden sich voneinander. Wenn man die beiden Modelle über dieselbe OpenAI-kompatible Schnittstelle direkt aufruft, um Storyboards und Animationscode zu generieren, lässt sich der Einfluss des Harness zunächst ausblenden und der tatsächliche Unterschied zwischen den Modellen besser erkennen.
5.2 Codebeispiel für einen Vergleich auf Komponenten-Ebene mit einer einheitlichen Schnittstelle
Das folgende Minimalbeispiel ruft über dieselbe base_url zwei Modelle auf und erzeugt für dieselbe Videoanforderung ein Storyboard-Skript. Die Modellnamen richten sich nach der Modellliste der Plattform.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI einheitliche Schnittstelle: ein Key für GPT und Claude
)

prompt = "为一款记账 App 设计 30 秒竖屏宣传片:给出 6 个镜头的分镜、旁白和每个镜头的时长。"
for model in ["gpt-6-astra", "claude-opus-5-5"]:
    r = client.chat.completions.create(model=model, messages=[{"role": "user", "content": prompt}])
    print(model, r.usage.total_tokens, "\n", r.choices[0].message.content[:300])
Vollständiges Skript für den mehrstufigen Vergleichstest anzeigen (mit Laufzeit und Tokens)
import time
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitlicher Aufruf über APIYI – erleichtert Wechsel und Vergleich
)

MODELS = ["gpt-6-astra", "claude-opus-5-5"]  # richtet sich nach der Modellliste der Plattform; neue Modelle einfach anhängen
RUNS = 3  # Anzahl der Wiederholungen pro Aufgabe

TASKS = {
    "storyboard": "为一款记账 App 设计 30 秒竖屏宣传片,输出 6 个镜头的分镜、旁白和时长(JSON)。",
    "remotion": "用 Remotion 写一个 10 秒的柱状图增长动画组件,数据为 [12, 30, 45, 80],带标题与数值标签。",
    "data_story": "把“某城市 2020-2025 年新能源车渗透率从 5% 升至 48%”写成 45 秒数据故事视频的脚本和镜头说明。",
}

SYSTEM = "你是视频导演兼前端动画工程师,输出可直接用于代码驱动视频制作的内容。"


def run_once(model: str, prompt: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": prompt},
        ],
        max_tokens=4000,
    )
    return {
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": resp.usage.prompt_tokens,
        "completion_tokens": resp.usage.completion_tokens,
        "output": resp.choices[0].message.content,
    }


results = []
for task_name, prompt in TASKS.items():
    for model in MODELS:
        for i in range(RUNS):
            try:
                rec = run_once(model, prompt)
            except Exception as e:
                rec = {"error": str(e)}
            rec.update({"task": task_name, "model": model, "run": i + 1})
            results.append(rec)
            print(task_name, model, i + 1, rec.get("seconds"), rec.get("completion_tokens"))

# Ergebnisse speichern, Modellnamen entfernen und dann dem Review-Team für den Blindtest übergeben
with open("video_bench_results.json", "w", encoding="utf-8") as f:
    json.dump(results, f, ensure_ascii=False, indent=2)
🚀 Schnellstart: Für einen Vergleich auf Komponenten-Ebene müssen GPT und Claude parallel aufgerufen werden. Über APIYI apiyi.com lassen sich beide Modelle mit einem einzigen API-Schlüssel und einer OpenAI-kompatiblen Schnittstelle umschalten. Neue Nutzer erhalten ein kostenloses Testkontingent – sobald die nächste GPT-Generation live ist, genügt es, den Modellnamen in die Liste
MODELSaufzunehmen, und dieselbe Testsuite lässt sich erneut durchlaufen.
5.3 Hinweise zum End-to-End-Test
Nachdem die Teiltests bestanden sind, führe die vollständigen Videoaufgaben in Codex CLI und Claude Code aus und protokolliere die Lieferquote sowie die Ergebnisse der ffprobe-Prüfung. Der manuelle Blindtest bewertet nur bereits gelieferte Videos; die Lieferquote muss separat erfasst werden, sonst wiederholt man genau den blinden Fleck des manuellen Tests von VibeVideoBench. Wiederhole jede Aufgabe mindestens dreimal und bilde Mittelwert und Varianz, damit du ein einzelnes Laufergebnis nicht als stabile Leistung missverstehst.
6 Entscheidungshilfe: Wie du GPT und Opus 5.5 für Video-Szenarien auswählst
6.1 GPT-6 Astra oder Opus 5.5 je nach Szenario wählen
Auf Basis der Kategoriewerte und Lieferdaten von VibeVideoBench lässt sich derzeit folgende Aufteilung empfehlen:
- GPT-6 Astra bevorzugen: Daten- und Faktenstories, Erklärungen von Konzepten und Abläufen, Story- und Gaming-Videos; bei Massenproduktion und kostenempfindlichen Szenarien – durchschnittliche Aufgabenkosten von 8,19 US-Dollar, auch die P90-Kosten sind besser kontrollierbar.
- Claude Opus 5.5 bevorzugen: Produkt- und Funktionsvorführungen, musikgetriebene Videos, Paper-Erklärungen; kommerzielle Lieferungen mit harten Anforderungen an Spezifikation und Auslieferung, etwa feste Auflösung, feste Laufzeit und Werbematerial, das zwingend eine Tonspur enthalten muss.
- Brand-Marketing: Beide erzielen dieselbe Punktzahl von 4,18 – entscheide nach Kosten und der vorhandenen Toolchain im Team.
6.2 Auf die nächste GPT-Generation warten oder jetzt live gehen
Die beiden aktuellen Modelle liefern bereits stabil brauchbare Videos, der Betrieb muss also nicht auf die nächste Modellgeneration warten. Praktischer ist es, mit der Methode aus Abschnitt 5 ein eigenes Aufgaben-Set und eigene Baseline-Werte aufzubauen, am Tag der Veröffentlichung eines neuen Modells erneut zu testen und anhand der Daten über einen Wechsel zu entscheiden.
💡 Auswahltipp: Die Unterschiede zwischen beiden konzentrieren sich auf Lieferstabilität und Kostenstruktur; die endgültige Wahl hängt von deinem Videotyp und deinen Lieferanforderungen ab. Teste am besten über APIYI apiyi.com dieselbe Charge echter Aufgaben mit beiden Modellen – die einheitliche Schnittstelle erleichtert den direkten Vergleich und später den Wechsel auf ein neues Modell.
7 Fazit: Das Wettbewerbsziel der nächsten GPT-Generation ist längst nicht mehr nur, mit Opus 5.5 gleichzuziehen
7.1 Die Kernpunkte der Videofähigkeiten von GPT und Opus 5.5
- Aktueller Stand: GPT-6 Astra und Claude Opus 5.5 liegen bei codegesteuerten Videoaufgaben in VibeVideoBench gemeinsam in der Spitzengruppe – 4,109 gegenüber 4,074 bei der Gesamtqualität.
- Die Stärken von Astra: visuelle Ästhetik, höhere Werte in den meisten Inhaltskategorien und rund 46,7 % niedrigere durchschnittliche Aufgabenkosten.
- Die Stärken von Opus 5.5: 239 von 239 vollständig geliefert, 99,6 % Spezifikationskonformität und häufigere Selbstprüfungen.
- Menschliche Präferenz: 1242 zu 1203, die Konfidenzintervalle überschneiden sich – statistisch nicht unterscheidbar.
- Signal für die nächste Generation: Ein internes Modell erreicht in BenchCAD 2.0 einen Wert von 0,875 (Astra: 0,594) und zeigt die Fähigkeit zur Zusammenarbeit von Agenten im Zehntausender-Maßstab; Name, Veröffentlichungsdatum und Videowerte wurden nicht bekannt gegeben.
- Der eigentliche Engpass: Rund 75 % der fehlgeschlagenen Lieferungen gehen auf Zeitmanagement zurück – der Wettbewerb verschiebt sich von der Generierungsqualität hin zu Ausführung und Lieferung.
- So lässt sich das prüfen: mit festen Aufgaben, fester Umgebung, mehreren Blindtest-Runden und Abrechnung pro Einheit Videokosten – über APIYI apiyi.com lässt sich eine solche schrittweise Nachprüfung mit einer einheitlichen Schnittstelle durchführen.
7.2 Der Wettbewerb endet bei der vollständigen Produktionseffizienz
Zurück zum Titel: GPT hat zu Opus 5.5 aufgeschlossen. Das aktuelle Astra liegt bei Qualität und Kosten leicht vorn, Opus 5.5 bleibt bei der Zuverlässigkeit der Lieferung führend. Das interne OpenAI-Modell zeigt eine stärkere Allgemeinfähigkeit und mehr Potenzial für Multi-Agent-Ausführung; die nächste allgemeine GPT-Generation hat die Chance, die Videoproduktion weiter zu verbessern. Wie groß dieser Sprung ausfällt, beantworten erst unabhängige Tests nach der Veröffentlichung und deine eigenen Praxistests.
Der nächste Wettbewerb wird sich an der vollständigen Produktionseffizienz entscheiden: von der Erfassung einer Idee bis zu einem zuverlässigen, präzisen und nachträglich anpassbaren Video – wer schafft mit geringeren Kosten mehr Aufgaben. Es lohnt sich, jetzt mit APIYI apiyi.com eine eigene Baseline für Videoaufgaben aufzubauen, damit du neue Modelle direkt nach dem Start vergleichen kannst.
Referenzen
- Offizielle Benchmark-Website von VibeVideoBench: Rangliste der Video-Agenten und Qualitätswerte
- Link:
vibevideobench.github.io -
Beschreibung: Überblick über das Gesamtranking und das Benchmark-Design
-
VibeVideoBench-Paper: Methodik, Ergebnisse nach Kategorien, Kosten, menschliche Präferenzen und Fehlerursachen
- Link:
arxiv.org/abs/2610.35864 -
Beschreibung: Hauptquelle für die Tabellendaten dieses Artikels, die Ergebnisse nach Kategorien finden sich in Anhang E.4
-
Ankündigung von Anthropic Claude Opus 5.5: Positionierung des Modells und offizielle Fallbeispiele
- Link:
anthropic.com/claude-opus-5-5 -
Beschreibung: Offizielle Darstellung der Veränderungen bei Fähigkeiten und Kosten von Opus 5.5
-
OpenAI: On the Navier–Stokes Millennium Prize Problem: Interne Modelle und Multi-Agent-Forschung
- Link:
openai.com/index/navier-stokes-solution -
Beschreibung: Daten zu 10.000 parallelen Agenten, 88 Stunden Forschung und weiteren Punkten
-
OpenAI: Accelerating engineering for the physical world: Ergebnisse interner Modelle bei BenchCAD 2.0
- Link:
openai.com/index/accelerating-engineering-for-the-physical-world -
Beschreibung: Vergleich zwischen dem internen Modell mit 0,875 und GPT-6 Astra mit 0,594
-
OpenAI API Changelog und Modellkatalog: Überprüfung des Release-Verlaufs
- Link:
developers.openai.com/api/docs/changelog,developers.openai.com/api/docs/models -
Beschreibung: Release-Eintrag zu GPT-6 Cyber und aktuelle öffentliche Flaggschiffmodelle
-
OpenAI API Deprecations: Informationen zur Einstellung von Sora 2 und der Videos API
- Link:
developers.openai.com/api/docs/deprecations - Beschreibung: Aktueller Stand der nativen Videogenerierung
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI apiyi.com, um Erfahrungen mit Video-Agent-Tests auszutauschen. Weitere Integrationsunterlagen finden Sie im Dokumentationszentrum docs.apiyi.com