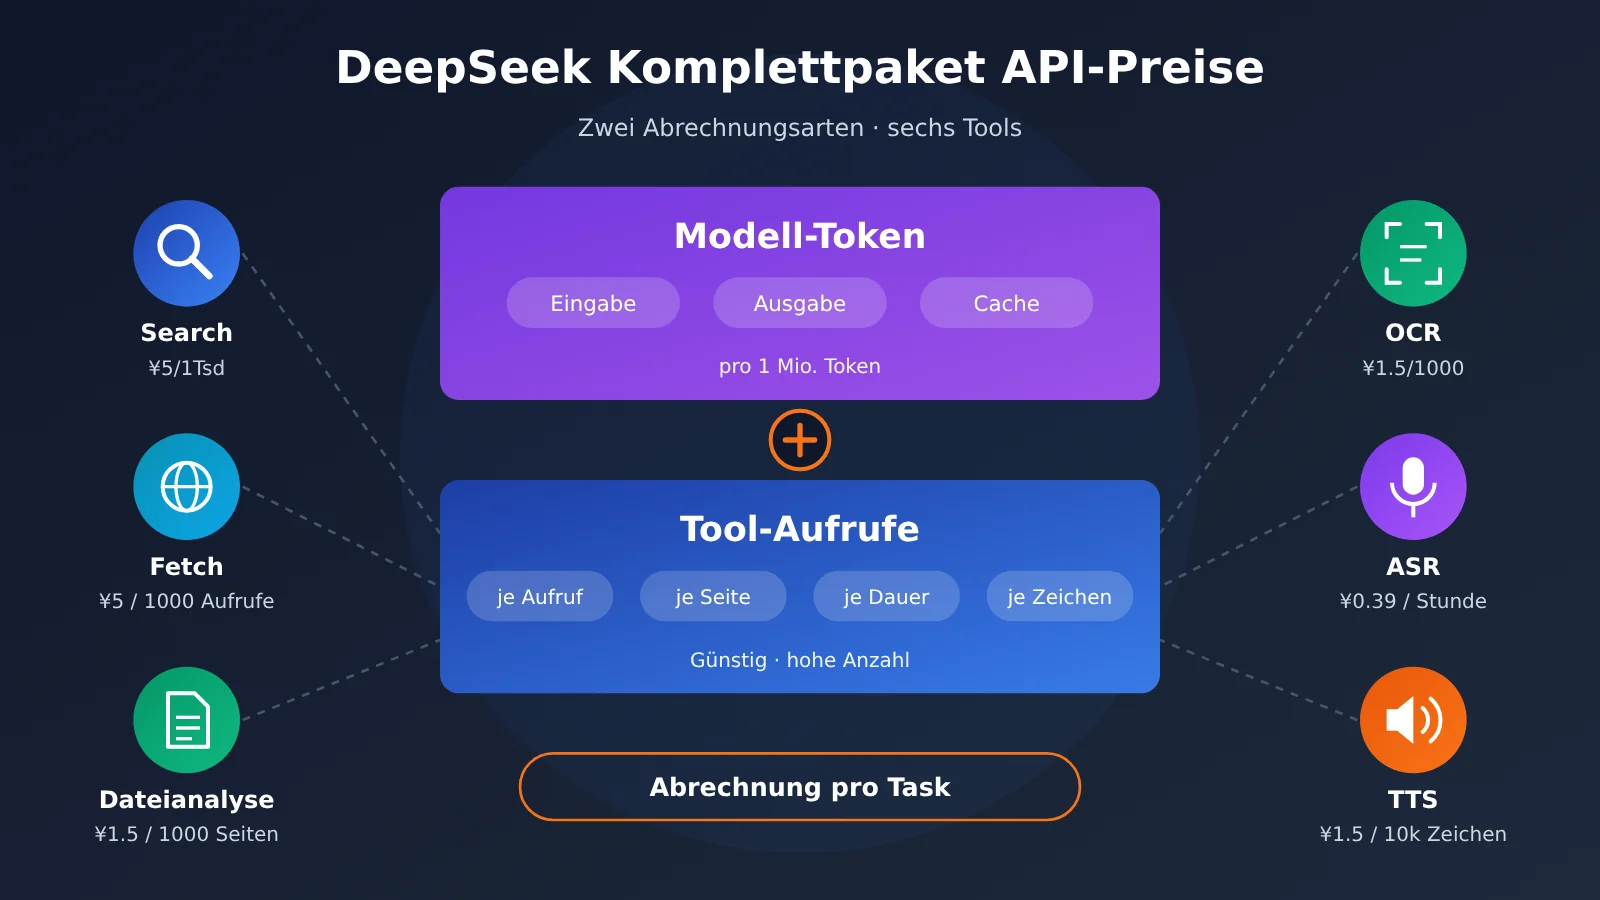
Zusammenfassung: Die DeepSeek-Komplettpaket-API rechnet Modell-Token und Tool-Aufrufe getrennt ab. Die vollständigen Kosten müssen nach Suchanzahl, Dateiseiten, Sprachverarbeitungsvolumen und Cache-Trefferquote einzeln berechnet werden.
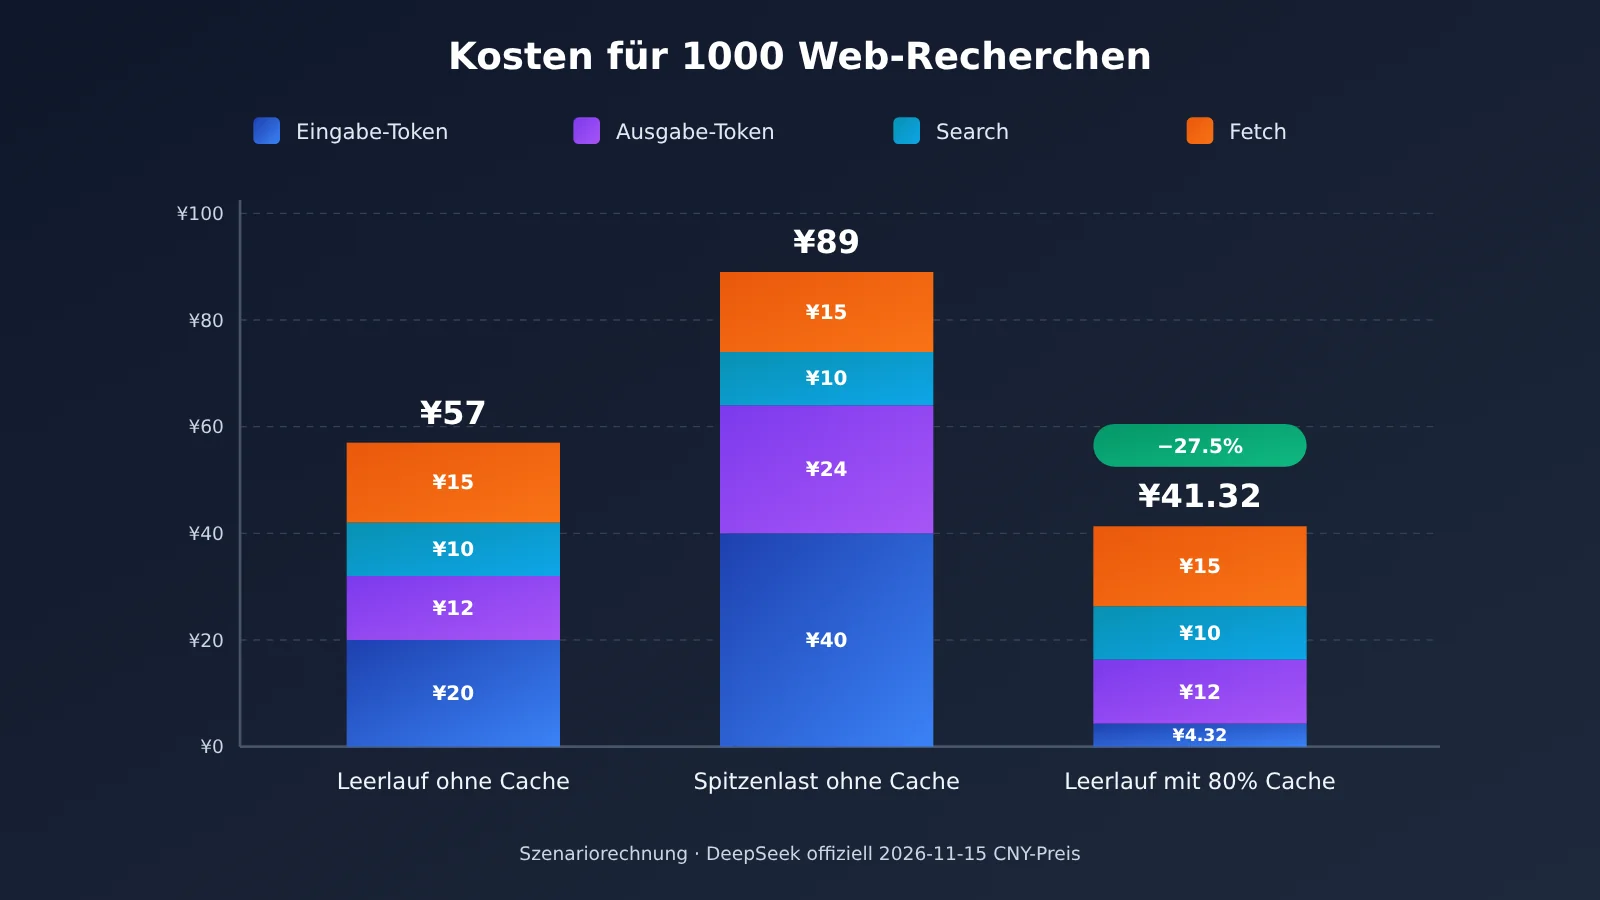
Fazit vorab: Laut der offiziellen chinesischen DeepSeek-Preisliste vom 15. November 2026 kosten Search und Fetch jeweils ¥5 pro 1000 erfolgreiche Anfragen, Dateiparsing und OCR jeweils ¥1.5 pro 1000 Seiten, ASR im Aktionszeitraum ¥0.39 pro Stunde und TTS im Aktionszeitraum ¥1.5 pro 10000 abgerechnete Zeichen. Die Stückpreise der Tools sind niedrig, doch die Rechnung für eine Web-Agent-Aufgabe wird in der Regel von den Modell-Token dominiert. Bei einer Forschungsaufgabe mit „2 Suchen, 3 Fetches, 20.000 Eingabe-Token und 3000 Ausgabe-Token“ kosten 1000 Aufgaben in der Nebenzeiten etwa ¥57, in Spitzenzeiten etwa ¥89; bei 80 % Cache-Trefferquote für Eingaben sinkt der Preis in der Nebenzeiten auf etwa ¥41.32. Deshalb sollte man Budgets in Einheiten von „vollständigen Aufgaben“ rechnen – der Preis einer einzelnen API-Anfrage ist nur einer der Bestandteile.
Im Folgenden wird zunächst die Abrechnungsstruktur von Modellkosten und Tool-Kosten aufgeschlüsselt. Danach werden die Stückpreise und Abrechnungseinheiten von Search, Fetch, Dateiparsing, OCR, ASR und TTS einzeln aufgeführt. Anschließend zeigen vier Szenarien mit festen Annahmen die vollständige Berechnung und erklären, wie Deep Search, Long-Context und Rate-Limits die Rechnung beeinflussen. Zum Schluss gibt es einen direkt wiederverwendbaren Code für ein Kostenprotokoll sowie einen Vergleich, wie man zwischen der integrierten Suche im Modell und den separaten Search-/Fetch-Schnittstellen auswählt.
Wissenswert: Abrechnungsbegriffe der DeepSeek-Komplettpaket-API
| Begriff | Erklärung |
|---|---|
| Token | Maßeinheit, die das Modell bei der Textverarbeitung verwendet; die Modellkosten werden pro Million Token berechnet |
| Input-Token | Alle Inhalte, die in das Kontextfenster des Modells gelangen und an der Inferenz teilnehmen, einschließlich Eingabeaufforderungen, Dateiinhalten und Suchergebnissen |
| Output-Token | Vom Modell generierte Inhalte; im Denkmodus zählt auch der Reasoning-Prozess als Output |
| Context Cache | Wiederverwendung eines zuvor verarbeiteten Kontexts, um die Kosten für wiederholte Eingaben zu senken |
| Cache Hit | Eingaben konnten erfolgreich aus dem Cache wiederverwendet werden und werden zum niedrigeren Preis für „Cache Hit“ abgerechnet |
| Stoßzeiten / Leerlaufzeiten | DeepSeek unterscheidet nach Pekinger Zeit zwei Preisstufen; der Leerlaufpreis beträgt die Hälfte des Spitzenpreises |
| Search API | Webseiten anhand von Keywords abfragen und strukturierte Suchergebnisse zurückgeben |
| Fetch API | Eine angegebene Webseite abrufen und den Haupttext zurückgeben |
| Modellintegrierte Suche | Im Dialog-Request wird ein Suchtool deklariert; das Modell entscheidet selbst über die Suche, und der Server führt sie aus |
| QPS | Anzahl der Anfragen, die pro Sekunde verarbeitet werden dürfen |
| OCR | Texterkennung aus Bildern oder Dokumenten |
| ASR | Spracherkennung in Text |
| TTS | Text in Sprache umwandeln |
| Abrechnungszeichen | Maßeinheit für TTS; chinesische Schriftzeichen zählen als 2 Abrechnungszeichen |
| Tool Usage | Abrechnungsnutzung, die durch den tatsächlichen Aufruf externer Tools durch das Modell oder Programm entsteht |
1 Wie wird die DeepSeek-Komplettpaket-API eigentlich abgerechnet?
1.1 Zwei Rechnungsarten bei der DeepSeek-Komplettpaket-API: Modellkosten und Tool-Kosten
Am 13. November 2026 hat DeepSeek die Funktionen hinter seiner App – Websuche, Deep-Thinking-Suche, Link-Lesen, Dateieingabe, OCR, ASR, TTS und Sicherheitsprüfung – als API verfügbar gemacht. Bei der Abrechnung werden diese Funktionen und die Modellinferenz separat berechnet. Das lässt sich in einer Formel zusammenfassen:
Gesamtkosten = Modell-Eingabekosten (Cache-Hit + Cache-Miss)
             + Modell-Ausgabekosten (inkl. Denk-Token)
             + Tool-Aufrufkosten (Search / Fetch / Bildsuche)
             + Kosten für Datei- und Sprachverarbeitung (analysierte Seiten / OCR-Seiten / Audiodauer / TTS-Zeichen)
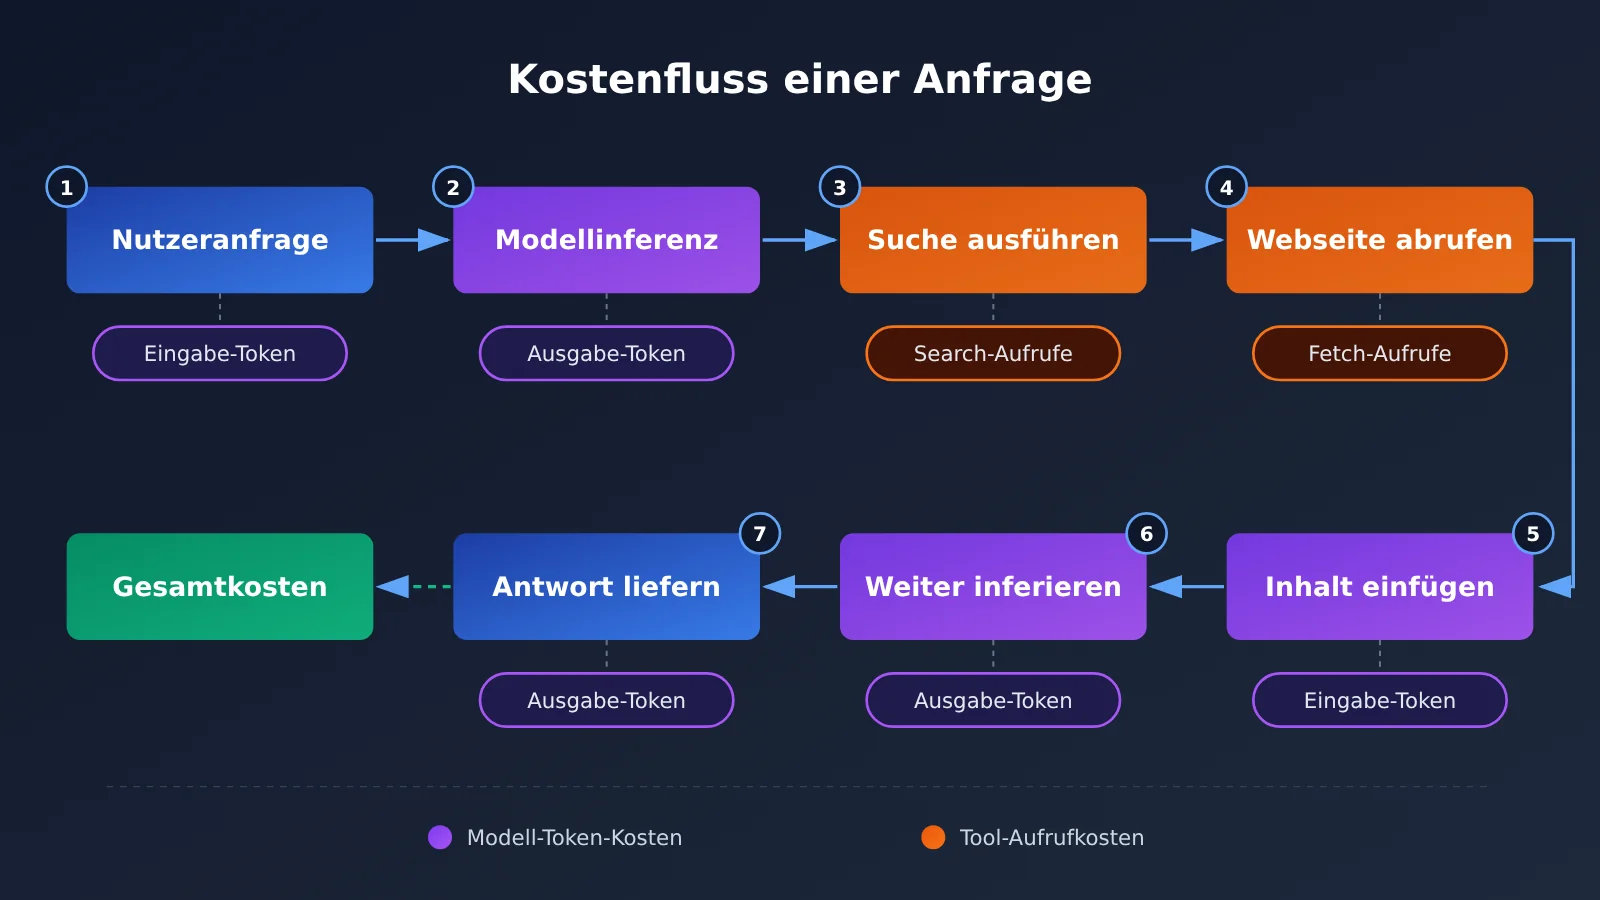
Bei einer einzelnen Frage-Antwort-Runde können alle oben genannten Kostenposten gleichzeitig anfallen. Wenn in einem Chat beispielsweise die Deep-Thinking-Suche aktiviert wird, generiert das Modell mehrfach Suchbegriffe, öffnet mehrere Webseiten und fügt die Webseiteninhalte anschließend in den Kontext ein, um die Inferenz fortzusetzen. Diese einzelne Anfrage verursacht sowohl Such- als auch Abrufkosten. Außerdem entstehen durch den in den Kontext gelangenden Webseitentext viele Eingabe-Token, und der Denkprozess wird zusätzlich als Ausgabe-Token gezählt.
1.2 Modellpreise von DeepSeek Flash und Pro
Die folgenden Preise stammen aus der offiziellen DeepSeek-Preis-Dokumentation vom 15. November 2026. Die Währung ist Renminbi (RMB), die Einheit ist pro Million Token.
| Modell | Cache-Hit (Off-Peak / Peak) | Cache-Miss (Off-Peak / Peak) | Ausgabe (Off-Peak / Peak) | Parallelitätslimit |
|---|---|---|---|---|
| DeepSeek-V4.1-Flash | ¥0.02 / ¥0.04 | ¥1 / ¥2 | ¥4 / ¥8 | 2500 |
| DeepSeek-V4-Pro | ¥0.15 / ¥0.30 | ¥4.5 / ¥9 | ¥13.5 / ¥27 | 500 |
Peak-Zeiten sind montags bis freitags von 09:00–12:00 und 14:00–18:00 Uhr Pekinger Zeit, ausgenommen chinesische gesetzliche Feiertage. Alle übrigen Zeiten (einschließlich der gesamten Wochenenden und gesetzlichen Feiertage) sind Off-Peak. Beide Modelle haben ein Kontextfenster von 1M und eine maximale Ausgabelänge von 384K; Flash unterstützt Bildverständnis, Pro nicht.
Die Modellwahl beeinflusst außerdem, welche Tools verfügbar sind. In dieser Ankündigung wird die vollständige Tool-Integration auf Chat-Ebene (Websuche, Deep-Thinking-Suche, Link-Lesen, Dateiparsing, Bildverständnis, Sicherheitsprüfung) von deepseek-flash (DeepSeek-V4.1-Flash) bereitgestellt. Wer Anwendungen mit integrierten Tools plant, sollte Flash als Basis für das Kostenmodell heranziehen.
2 Was kosten Search, Fetch, OCR, ASR und TTS im DeepSeek-API-Komplettpaket?
Die folgende Tabelle zeigt die offiziellen Preise der DeepSeek-Tools (Stand 15. November 2026, in Renminbi). „Listenpreis“ und „zeitlich begrenztes Angebot“ sind getrennt aufgeführt. Nach Ablauf des Aktionszeitraums müssen Sie wieder mit dem Listenpreis kalkulieren.
| Fähigkeit | Abrechnungseinheit | Listenpreis | Zeitlich begrenztes Angebot | Umgerechnet pro Einzelabruf / Einheit |
|---|---|---|---|---|
| Search-Suche | 1000 erfolgreiche Anfragen | ¥5 | ¥5 | ¥0.005 / Anfrage |
| Fetch-Webabruf | 1000 erfolgreiche Anfragen | ¥5 | ¥5 | ¥0.005 / Anfrage |
| Dateiparsing | 1000 Seiten | ¥1.5 | ¥1.5 | ¥0.0015 / Seite |
| OCR | 1000 Seiten | ¥1.5 | ¥1.5 | ¥0.0015 / Seite |
| ASR | 1 Stunde Audio | ¥0.78 | ¥0.39 | Weniger als 1 Sekunde wird als 1 Sekunde berechnet |
| TTS | 10000 abrechenbare Zeichen | ¥3 | ¥1.5 | Chinesische Schriftzeichen zählen als 2 Zeichen |
2.1 Abrechnung von DeepSeek Search und Fetch
Der eigenständige Search-Dienst wird nach erfolgreichen Anfragen abgerechnet: Als erfolgreich gilt nur eine Anfrage mit HTTP 200 und einem nicht leeren results-Array. Eine einzelne Anfrage kann 1—50 Ergebnisse zurückgeben (count steht standardmäßig auf 10). Ob 1 oder 50 Ergebnisse zurückkommen, kostet gleich viel. Daher ist es günstiger, mehrere Ergebnisse mit einer Anfrage abzurufen, als mehrere Anfragen mit jeweils wenigen Ergebnissen zu stellen. Beim eigenständigen Fetch müssen HTTP 200 und die erfolgreiche Rückgabe des Webseitentexts vorliegen; Fehler, Timeouts und Anfragen ohne Ergebnis werden nicht berechnet.
Die Abrechnungslogik der in das Modell integrierten Suche unterscheidet sich davon. Die integrierte Textsuche wird nach der tatsächlich ausgeführten Anzahl der Suchbegriffe abgerechnet: Enthält ein Tool-Aufruf drei Suchbegriffe, werden drei Einheiten berechnet. Die integrierte Bildsuche wird nach der Anzahl der zurückgegebenen Bilder und der markierten Bereiche abgerechnet; der integrierte Webabruf nach der Anzahl erfolgreich abgerufener Webseiten. Wenn Sie die Suche in einer Unterhaltung aktivieren, ist es daher normal, dass eine Frage-Antwort-Runde mehrere Suchkosten verursacht.
2.2 Seitenbasierte Abrechnung von Dateianalyse und OCR bei DeepSeek
Die Dateianalyse läuft über die Files API: Datei hochladen, serverseitig analysieren lassen, file_id zurückbekommen und diese file_id dann im Dialog referenzieren. Abgerechnet wird nach erfolgreich analysierten Seiten, und zwar ¥1.5 pro 1000 Seiten. Wird dieselbe bereits analysierte Datei später im Dialog erneut referenziert, fällt keine weitere Analysegebühr an – der Dateiinhalt wird jedoch jedes Mal, wenn er in den Kontext eingeht, als Eingabe-Token berechnet.
Auch der Analysemodus wirkt sich auf den Token-Verbrauch aus. text_recognition liefert dem Modell reinen Text, rich_layout_recognition schneidet Diagramme und Grafiken als Bilder aus und übergibt sie zusammen mit dem Text an das Modell. Das eignet sich für Finanzberichte und PPTs, erhöht aber die Bild-Token. XLSX-, CSV-, TXT-, MD-, JSON- und EPUB-Dateien lassen sich als user_data hochladen und in Markdown umwandeln; für solche Uploads wird keine Analysegebühr erhoben.
OCR ist eine eigenständige Schnittstelle (/v1/tools/ocr) und kostet ebenfalls ¥1.5 pro 1000 Seiten, abgerechnet nach erfolgreich erkannten Seiten. Fehler und Timeouts werden nicht berechnet. Die beiden Dienste sind unterschiedlich ausgerichtet: OCR extrahiert nur Text und Positionsinformationen, während die Dateianalyse das Ergebnis direkt in den Modellkontext einspeist, damit das Modell es versteht.
2.3 Sprachabrechnung für DeepSeek ASR und TTS
Der Listenpreis für ASR (/v1/tools/asr) liegt bei ¥0.78 pro Stunde Audio, aktuell gilt zeitlich begrenzt ein Rabatt von 50 %, also ¥0.39. Alles unter 1 Sekunde wird als 1 Sekunde abgerechnet. Das Verfahren arbeitet mit vollständigem Datei-Upload und nicht-streaming-basierter Erkennung, eine einzelne Audiodatei darf maximal 120 Sekunden lang und höchstens 8 MiB groß sein, unterstützt werden 16-bit PCM WAV und Ogg Opus, und pro Konto sind 50 parallele Vorgänge möglich. Lange Aufnahmen müssen vorher in Abschnitte geschnitten werden; der Rest unter 1 Sekunde am Ende jedes Abschnitts wird jeweils aufgerundet, und je feiner die Schnitte, desto stärker summiert sich dieser Aufschlag.
Der Listenpreis für TTS (/v1/tools/tts, das auch WebSocket-Streaming-Synthese unterstützt) beträgt ¥3 pro 10000 Abrechnungszeichen, der Aktionspreis liegt bei ¥1.5. Chinesische Schriftzeichen zählen als 2 Abrechnungszeichen, englische Buchstaben, Ziffern und Leerzeichen als 1, und pro Eingabe sind höchstens 10000 Abrechnungszeichen möglich. Umgerechnet entsprechen 100.000 Abrechnungszeichen ungefähr 50.000 chinesischen Schriftzeichen – für chinesische Inhalte muss man das Budget also zunächst verdoppeln.
3 Kostenschätzung für vier Szenarien der DeepSeek-All-in-One-API
Die folgenden vier Fälle basieren auf öffentlich bekannten Stückpreisen und festen Annahmen. Die Anzahl der Aufrufe und der Token-Verbrauch sind angenommene Werte. Es handelt sich um Szenarioberechnungen, die die Berechnungsmethode veranschaulichen; maßgeblich für die tatsächliche Rechnung sind die vom Server zurückgegebenen Abrechnungsfelder.
3.1 Szenario 1: 1.000 Rechercheaufgaben mit Internetzugriff (Nebenzeiten ¥57 / Spitzenzeiten ¥89)
Annahmen: Verwendung von DeepSeek-V4.1-Flash; pro Aufgabe 2 erfolgreiche Suchabfragen, 3 erfolgreiche Web-Fetches, 20.000 Eingabe-Token mit Cache-Miss und 3.000 Ausgabe-Token.
| Position | Berechnungsformel | Nebenzeiten (¥/Aufgabe) | Spitzenzeiten (¥/Aufgabe) |
|---|---|---|---|
| Eingabe-Token | 20.000 ÷ 1.000.000 × Stückpreis | 0,020 | 0,040 |
| Ausgabe-Token | 3.000 ÷ 1.000.000 × Stückpreis | 0,012 | 0,024 |
| Search | 2 × ¥0,005 | 0,010 | 0,010 |
| Fetch | 3 × ¥0,005 | 0,015 | 0,015 |
| Summe pro Aufgabe | — | 0,057 | 0,089 |
| Summe für 1.000 Aufgaben | Aufgabe × 1.000 | ¥57 | ¥89 |
In Spitzenzeiten verdoppeln sich die Token-Kosten des Modells, während die Preise für Search und Fetch gleich bleiben. Dadurch steigt die Gesamtrechnung von ¥57 auf ¥89 – ein Anstieg von rund 56 %. Bei dieser Aufgabe entfallen etwa 56 % der Nebenzeiten-Abrechnung auf die Modellkosten (¥32 / ¥57). Das zeigt: Der größte Kostenanteil eines Web-Agenten liegt weiterhin bei den Token. Batch-Aufgaben, die später ausgeführt werden können, in die Nebenzeiten zu verschieben, ist der direkteste Hebel zur Kostensenkung.
3.2 Szenario 2: Wie viel lässt sich durch eine Cache-Trefferrate von 80 % bei der Eingabe sparen?
Annahme: Bedingungen wie in Szenario 1 (Leerlaufzeit), aber von den 20000 Eingabe-Token treffen 16000 auf den Cache, 4000 nicht.
- Cache-Treffer bei der Eingabe: 16000 ÷ 1000000 × ¥0.02 = ¥0.00032
- Cache-Fehltreffer bei der Eingabe: 4000 ÷ 1000000 × ¥1 = ¥0.004
- Ausgabe: 3000 ÷ 1000000 × ¥4 = ¥0.012
- Suche + Abruf: ¥0.010 + ¥0.015 = ¥0.025
- Einzelkosten insgesamt ¥0.04132, bei 1000 Aufrufen insgesamt ¥41.32
Im Vergleich zu den ¥57 aus Szenario 1 werden ¥15.68 eingespart, also rund 27,5 %. Der Cache wirkt sich nur auf die Eingabekosten aus: Die Eingabe sinkt von ¥0.020 auf etwa ¥0.0043, während Ausgabe- und Werkzeugkosten völlig unverändert bleiben. Je höher die Cache-Trefferrate, desto näher kommt die Rechnung der Untergrenze aus „Ausgabe + Werkzeuge“; weitere Kostensenkungen erfordern dann eine Verringerung der Suchvorgänge und eine kürzere Ausgabelänge.
3.3 Szenario 3: Stapelverarbeitung von 5000 Seiten Unternehmensdokumenten
Annahme: Flash in Nebenzeiten; ein Dokument mit 5000 Seiten wird nur einmal geparst; die anschließende Analyse kommt auf insgesamt 10 Millionen Input-Token mit Cache-Miss und 1 Million Output-Token.
- Dateiparsing: 5000 ÷ 1000 × ¥1.5 = ¥7.50
- Modell-Input: 10000000 ÷ 1000000 × ¥1 = ¥10.00
- Modell-Output: 1000000 ÷ 1000000 × ¥4 = ¥4.00
- Gesamt ¥21.50
Die Parsing-Gebühr macht nur rund 35 % aus. Wenn dieselben Dateien in mehreren Gesprächsrunden immer wieder vollständig in den Kontext geschoben werden, vervielfacht sich die Zahl der Input-Token, während die Parsing-Gebühr nicht weiter steigt. Bei großen Dokumenten kommt es vor allem darauf an, zu steuern, wie oft Dateiinhalte in den Kontext gelangen.
3.4 Szenario 4: 10 Stunden Spracherkennung + TTS mit 100.000 abrechenbaren Zeichen
Annahme: Der aktuelle zeitlich begrenzte Halbpreis gilt; ASR für 10 Stunden Audio, TTS für 100000 abrechenbare Zeichen.
- ASR: 10 × ¥0.39 = ¥3.90
- TTS: 100000 ÷ 10000 × ¥1.5 = ¥15.00
- Gesamt ¥18.90
Diese Kosten decken nur den Sprachdienst ab. Wenn der transkribierte Text einem Dialogmodell zum Zusammenfassen oder für Fragen und Antworten übergeben wird, werden die Modell-Token separat berechnet. Zum Listenpreis kosten dieselben Mengen 10 × ¥0.78 + 10 × ¥3 = ¥37.80; nach Ende des Rabatts verdoppelt sich das Budget für Sprachdienste. Außerdem müssen 10 Stunden Audio bei einem Limit von 120 Sekunden in mindestens 300 Segmente aufgeteilt werden; die Ablaufsteuerung muss mit 50 gleichzeitigen Verarbeitungen erfolgen.
4 Welche Faktoren lassen die API-Rechnung des DeepSeek-Komplettpakets steigen
4.1 Tiefes Denken mit Suche: mehrere Suchbegriffe pro Ausführung
Die Tiefes-Denken-Suche kann bis zu etwa 20 Tool-Aufrufe tätigen, bevor sie antwortet – die Abrechnung summiert sich entsprechend der tatsächlichen Aktionen. Einige zentrale Regeln aus den offiziellen Abrechnungsdetails:
- Eine Search mit 3 Suchbegriffen, die alle Ergebnisse liefern, zählt als 3 Suchen
- Eine Bildersuche, die 3 Bilder zurückgibt, zählt als 3 Mal; markiert das Modell anschließend 2 Bereiche in den Bildern per Rahmen, kommen 2 weitere Zählungen hinzu
- Das erfolgreiche Öffnen einer Webseite, die einen Online-Abruf benötigt, zählt als 1 Fetch; wird dieselbe Seite erneut geöffnet, entstehen keine weiteren Kosten
- Ein
find_in_pageauf einer bereits geöffneten Seite wird nicht separat berechnet; eine Search ohne Ergebnisse wird nicht berechnet - Ist die Inhaltssicherheit des Modells aktiviert, können manche Webseiten selbst dann abgerechnet werden, wenn sie als
url_not_allowedoderunavailableangezeigt werden, sofern der Abruf im Hintergrund erfolgreich war
Für die Abrechnung sind die Felder server_tool_use.tool_search, tool_fetch und tool_image_search zu verwenden. web_search_requests und web_fetch_requests geben lediglich die Anzahl der zurückgegebenen Blöcke an und können fehlgeschlagene Anfragen enthalten – wer damit rechnet, überschätzt die Kosten.
4.2 Langer Kontext und wiederholte Dateieingaben
Suchergebnisse, Webseitentexte und bereits geparste Dateien landen alle im Kontext. Das Link-Lese-Tool berücksichtigt maximal die 10 verschiedenen URLs aus der letzten Nutzernachricht; werden mehrere Webseiten gleichzeitig gelesen, verkleinert sich der verfügbare Kontext pro Seite, die gesamte Eingabemenge bleibt aber beträchtlich. In langen Sitzungen wird bei jeder Runde die Historie mitgeführt, sodass die Eingabe-Token mit jeder Runde weiter anwachsen.
Es gibt drei Wege zur Kostensenkung: Zusammenfassungen und Kernfakten in der Anwendungsschicht speichern und in späteren Runden auf die Zusammenfassung verweisen; System-Prompt, gemeinsame Materialien und Workflow-Regeln an den Anfang des Kontexts stellen und stabil halten, um die Chance auf einen Cache-Treffer zu erhöhen; rich_layout_recognition nur dann einsetzen, wenn tatsächlich Diagramme betrachtet werden müssen.
4.3 Request-Ratenlimits bei Batch-Aufgaben
Das kontoweite Limit für die eigenständige Search liegt bei 100 QPS, für Fetch bei 25 QPS – das ist das gesamte Kontingent des Accounts, das sich mehrere API-Schlüssel teilen. Fetch unterliegt zusätzlich einem QPS-Limit auf Ebene der Ziel-Domain, sodass konzentriertes Abrufen derselben Website eher 429 auslöst. Empfehlungen zur Fehlerbehandlung:
- 408, 429, 5xx: nach exponentiellem Backoff erneut versuchen, Anfragen an dieselbe Domain streuen
- 402: unzureichendes Guthaben – zuerst den Kontostand klären
- Andere 4xx (z. B. Parameterfehler): Anfrage korrigieren und erneut senden, ein Wiederholen ohne Änderung bringt nichts
Fehlgeschlagene Anfragen werden nicht berechnet, ein Retry erhöht also nicht die Tool-Kosten, verlängert aber die Laufzeit der Aufgabe. Bei großen Batch-Aufgaben sollte die Fertigstellungszeit anhand der Fetch-Obergrenze von 25 QPS zurückgerechnet werden.
5 Wie man ein sinnvolles Kostenbudget für DeepSeek-Agenten entwirft
5.1 DeepSeek-Komplettpaket-API-Kostenprotokoll: Schnelleinstieg
In der Produktionsumgebung sollten mindestens getrennt erfasst werden: Eingaben mit Cache-Treffer, Eingaben ohne Cache-Treffer, Ausgabe-Tokens, Anzahl der Suchen, Anzahl der Fetch-Aufrufe, Anzahl der Bildsuchen, Anzahl der bei der Dokumentanalyse verarbeiteten Seiten, Audiodauer und die für TTS abgerechneten Zeichen. Die folgende Funktion liest das Feld usage direkt aus und berechnet die Kosten pro Aufruf; sie lässt sich nach jeder Anfrage ins Log schreiben.
# Kostenabschätzung für das DeepSeek-Komplettpaket (CNY, offizielle Preise vom 2026-11-15)
FLASH = {"cache_hit": 0.02, "cache_miss": 1.0, "output": 4.0}  # Nebenzeittarif ¥/Million Tokens
TOOL = {"search": 0.005, "fetch": 0.005, "image_search": 0.005}  # ¥/Aufruf

def estimate_cost(usage: dict, peak: bool = False) -> dict:
    k = 2 if peak else 1  # Spitzenpreis ist doppelt so hoch wie der Nebenzeittarif, Werkzeugpreise bleiben unverändert
    stu = usage.get("server_tool_use", {})
    model = (usage.get("cache_read_input_tokens", 0) * FLASH["cache_hit"]
             + usage.get("input_tokens", 0) * FLASH["cache_miss"]
             + usage.get("output_tokens", 0) * FLASH["output"]) / 1e6 * k
    tools = (stu.get("tool_search", 0) * TOOL["search"]
             + stu.get("tool_fetch", 0) * TOOL["fetch"]
             + stu.get("tool_image_search", 0) * TOOL["image_search"])
    return {"model": round(model, 5), "tools": round(tools, 5),
            "total": round(model + tools, 5)}

# Szenario 2 reproduzieren: 16000 Cache-Treffer + 4000 Cache-Fehltreffer + 3000 Ausgabe + 2 Suchen + 3 Abrufe
print(estimate_cost({"cache_read_input_tokens": 16000, "input_tokens": 4000,
                     "output_tokens": 3000,
                     "server_tool_use": {"tool_search": 2, "tool_fetch": 3}}))
# {'model': 0.01632, 'tools': 0.025, 'total': 0.04132}
Der Stückpreis für die Bildsuche wird hier wie der Suchpreis behandelt; vor dem Go-live bitte anhand der offiziellen Dokumentation prüfen. Bei den Budgetdimensionen eignet sich für Q&A-Produkte die Abrechnung „pro Nutzeranfrage“, während mehrstufige Agenten, Deep Research und Batch-Automatisierung besser „pro Aufgabenlebenszyklus“ abgerechnet werden – dabei werden alle Modellaufrufe und Werkzeugaufrufe innerhalb einer Aufgabe unter derselben task_id zusammengefasst.
5.2 Wann DeepSeek mit integrierter Suche wählen – und wann eigenständige Search-/Fetch-APIs
| Dimension | Integrierte Suche im Modell (deepseek_web_search / read_url) |
Eigenständige Search-/Fetch-API |
|---|---|---|
| Entwicklungsaufwand | Gering – Suche, Abruf und Zusammenbau des Kontexts übernimmt der Server | Höher – die Tool-Schleife muss selbst orchestriert werden |
| Ablaufkontrolle | Das Modell entscheidet, wie oft gesucht und welche Seiten gelesen werden | Entwickler steuern jeden einzelnen Aufruf präzise |
| Abrechnungsgrundlage | Nach Suchbegriffen, Anzahl der Bilder und erfolgreich abgerufenen Seiten | Nach erfolgreichen HTTP-Anfragen |
| Prognostizierbarkeit der Kosten | Schwankt deutlich, bei einer tiefen Suche bis zu etwa 20 Tool-Aufrufe | Hoch – die Anzahl der Aufrufe bestimmt der Code |
| Geeignete Szenarien | Dialog-Assistenten, schnelles Nachbilden einer App-Erfahrung | RAG, Massen-Datenerfassung, Agents mit festem Ablauf |
Wenn ein Dialogprodukt schnell live gehen soll, spart die integrierte Suche eine Menge Engineering-Arbeit. Sollen die Kosten pro Aufgabe in einem festen Bereich bleiben oder erst gefiltert und dann abgerufen werden, ist die eigenständige API die bessere Wahl. Beides lässt sich auch kombinieren: Im Hauptablauf des Dialogs kommen die integrierten Tools zum Einsatz, während im Hintergrund per eigenständiger API Batch-Daten nachgeladen werden.
5.3 DeepSeek Search / Fetch auf APIYI: Integration und Preise
APIYI hat am 21. Oktober 2026 die eigenständigen DeepSeek-Tool-Endpunkte deepseek-search und deepseek-fetch veröffentlicht. Die Schnittstellen lauten POST /v1/tools/search und POST /v1/tools/fetch. Sie verbrauchen keine Modell-Token, sondern werden nach der Anzahl erfolgreicher Aufrufe abgerechnet. Verfügbar sind sie in den Gruppen default und svip; Tokens der Gruppe ClaudeCode können sie nicht direkt aufrufen. Für die modellinterne Suche, die Clients wie DeepSeek Harness oder Claude Code nutzen, ist die Kompatibilitätsarbeit bei APIYI noch in Planung – aktuell verfügbar sind die eigenständigen Search / Fetch.
Die folgenden Preise stammen aus der APIYI-Dokumentation, angegeben in US-Dollar:
| Position | In der Dokumentation angegebener offizieller Preis | Preis auf APIYI | Effektiv nach 20 % Bonus | Effektiv nach 10 % Bonus |
|---|---|---|---|---|
| Search / 1000 Aufrufe | $0.75 | $0.90 | $0.75 | ca. $0.82 |
| Fetch / 1000 Aufrufe | $0.75 | $0.90 | $0.75 | ca. $0.82 |
Rechnet man mit dem Tool-Volumen aus Szenario 1 (1000 Search + 3000 Fetch), ergibt sich: Abrechnung auf der Plattform (1000 + 3000) ÷ 1000 × $0.90 = $3.60; wenn der 20-%-Bonus auf den gesamten Verbrauch angewendet wird, entspricht das $3.60 ÷ 1.20 = $3.00; mit 10-%-Bonus sind es etwa $3.27. DeepSeek rechnet offiziell in Renminbi ab. Für einen Vergleich der tatsächlichen Kosten müssen daher Währung, Wechselkurs und Aufladebedingungen vereinheitlicht werden. Maßgeblich ist letztlich der Preis, der in der Konsole des Kontos angezeigt wird.
Minimales Aufrufbeispiel (die Anforderungsfelder richten sich nach der APIYI-Dokumentation):
import requests

BASE_URL = "https://api.apiyi.com/v1"  # Einheitlicher APIYI-Endpunkt
headers = {"Authorization": "Bearer YOUR_API_KEY"}

resp = requests.post(f"{BASE_URL}/tools/search", headers=headers,
                     json={"model": "deepseek-search",
                           "query": "DeepSeek API 价格", "count": 10})
print(resp.json())
Vollständige Implementierung ansehen: erst suchen, dann abrufen, inklusive 429-Backoff-Retry und Zählung
import time
import requests

BASE_URL = "https://api.apiyi.com/v1"  # APIYI – OpenAI-kompatibler Einstiegspunkt
HEADERS = {"Authorization": "Bearer YOUR_API_KEY"}
RETRY_CODES = {408, 429, 500, 502, 503, 504}

def call_tool(path: str, payload: dict, max_retry: int = 4) -> dict | None:
    """Ruft die Tool-Schnittstelle auf; bei wiederholbaren Fehlern mit exponentiellem Backoff, fehlgeschlagene Anfragen werden nicht berechnet"""
    for i in range(max_retry):
        r = requests.post(f"{BASE_URL}{path}", headers=HEADERS,
                          json=payload, timeout=60)
        if r.status_code == 200:
            return r.json()
        if r.status_code == 402:
            raise RuntimeError("余额不足,请先充值")
        if r.status_code in RETRY_CODES:
            time.sleep(2 ** i)  # 1s, 2s, 4s, 8s
            continue
        raise ValueError(f"请求参数错误: {r.status_code} {r.text}")
    return None

def research(query: str, fetch_top: int = 3) -> dict:
    stats = {"search": 0, "fetch": 0}
    result = call_tool("/tools/search",
                       {"model": "deepseek-search", "query": query, "count": 10})
    items = (result or {}).get("results", [])
    if items:
        stats["search"] += 1  # Abgerechnet wird nur bei nicht-leeren Ergebnissen
    pages = []
    for item in items[:fetch_top]:  # Nur Seiten abrufen, deren Originaltext wirklich gelesen werden muss
        page = call_tool("/tools/fetch",
                         {"model": "deepseek-fetch", "url": item.get("url")})
        if page:
            stats["fetch"] += 1
            pages.append(page)
        time.sleep(0.05)  # Tempo drosseln, um das Fetch-Limit von 25 QPS und domainspezifische Ratenbegrenzungen zu vermeiden
    return {"pages": pages, "billing": stats}

if __name__ == "__main__":
    out = research("DeepSeek 全家桶 API 计费规则")
    print(out["billing"])  # zum Beispiel {'search': 1, 'fetch': 3}
🚀 Schnellstart: Registrieren Sie sich über APIYI auf apiyi.com und erhalten Sie ein Testkontingent. Bringen Sie zuerst Search / Fetch mit einer kleinen Anfragemenge zum Laufen und kalkulieren Sie anschließend anhand der tatsächlichen Aufrufzahlen im Log Ihr reguläres Budget.
Häufig gestellte Fragen (FAQ)
F1: Welche Kostenpositionen umfasst das DeepSeek-Komplettpaket-API?
Enthalten sind Modell-Token (Cache-Treffer-Eingabe, Cache-Fehltreffer-Eingabe, Ausgabe) sowie Tool-Gebühren (Search, Fetch, Bildsuche, Dateiparsing, OCR, ASR, TTS). Sicherheitsprüfungen und die seiteninterne Suche `find_in_page` sind in der öffentlichen Preistabelle nicht separat bepreist.
F2: Worin unterscheidet sich die Abrechnung der eigenständigen Search-API von der modellinternen Suche?
Bei der eigenständigen Search zählt jeder erfolgreiche HTTP-Request als 1 Aufruf – auch wenn 50 Ergebnisse zurückkommen, bleibt es bei 1. Die modellinterne Suche wird nach der tatsächlichen Anzahl der Suchbegriffe abgerechnet: Ein Aufruf mit 3 Suchbegriffen zählt als 3. Die integrierte Variante ist entwicklungsseitig bequemer, die eigenständige Variante lässt sich kostenmäßig besser steuern.
F3: Von wann stammen diese Preise, und können sich die zeitlich begrenzten Aktionen ändern?
Die Preise in diesem Artikel stammen aus der offiziellen chinesischen Preis-Dokumentation von DeepSeek, Stand 15. November 2026. ASR und TTS sind derzeit zeitlich begrenzt um 50 % reduziert; nach Ablauf liegen sie wieder bei ¥0,78 pro Stunde bzw. ¥3 pro 10000 abgerechnete Zeichen. Für die langfristige Budgetplanung sollten Sie daher einen Puffer zum Listenpreis einplanen.
F4: Verdoppelt sich die Rechnung in Stoßzeiten direkt?
Nur der Modell-Token-Anteil verdoppelt sich, die Tool-Preise gelten unabhängig von der Uhrzeit. In Szenario 1 steigt die Gesamtrechnung von ¥57 auf ¥89, also um rund 56 %. Je höher der Anteil der Tool-Kosten an einer Aufgabe ist, desto geringer fällt der Anstieg in Stoßzeiten aus.
F5: Wie rufe ich DeepSeek Search und Fetch schnell über die API auf?
1. Registrieren Sie sich bei APIYI auf apiyi.com und erstellen Sie ein Token für die Gruppe `default` oder `svip`
2. Setzen Sie die `base_url` auf `https://api.apiyi.com/v1`
3. Rufen Sie mit dem Code aus diesem Artikel `/tools/search` und `/tools/fetch` auf, die Modellnamen lauten `deepseek-search` bzw. `deepseek-fetch`
Mit demselben API-Schlüssel lassen sich auch die anderen gängigen Modelle auf der Plattform aufrufen – praktisch, um Suchergebnisse von verschiedenen Modellen vergleichen zu lassen.
F6: Wird bei wiederholten Fragen nach dem Dateiparsing erneut abgerechnet?
Die Parsing-Gebühr fällt nur einmal an; wird dieselbe `file_id` erneut referenziert, entsteht keine weitere Parsing-Gebühr. Allerdings wird der Dateiinhalt bei jedem Eintritt in den Kontext als Eingabe-Token abgerechnet. Bei großen Dateien mit vielen Fragerunden kommen die Hauptkosten daher aus den Eingabe-Token.
F7: Welche bekannten Einschränkungen hat das DeepSeek-Komplettpaket-API?
– Die vollständige Tool-Integration auf Gesprächsebene richtet sich derzeit an `deepseek-flash`
– Eigenständige Search: 100 QPS pro Konto, Fetch: 25 QPS, zusätzlich abhängig vom Rate-Limiting der Zieldomain
– ASR: maximal 120 Sekunden pro Segment, nicht-streaming; TTS: maximal 10000 abgerechnete Zeichen pro Aufruf, Sprechtempo lässt sich derzeit nicht anpassen
– Dateiparsing: maximal 100 MiB und 1000 Seiten pro Datei, maximal 20 referenzierte Dateien pro Request
F8: Kann APIYI alle neu veröffentlichten integrierten Tools von DeepSeek aufrufen?
Derzeit hat APIYI die eigenständigen Dienste `deepseek-search` und `deepseek-fetch` im Angebot, die sich in Agent- und RAG-Pipelines frei orchestrieren lassen. Die Kompatibilität der modellinternen Suche mit Clients wie Harness und Claude Code befindet sich noch in Planung; den Stand entnehmen Sie bitte der offiziellen Dokumentation von APIYI auf apiyi.com.
DeepSeek-Komplettpaket: API-Preise – die wichtigsten Erkenntnisse
- Abrechnungsstruktur: Modell-Token und Tool-Aufrufe werden getrennt abgerechnet; eine Aufgabe erzeugt gleichzeitig mehrere Kostenpositionen
- Tool-Einzelpreise: Search und Fetch je ¥5 / 1000 Aufrufe, Dateiparsing und OCR je ¥1.5 / 1000 Seiten
- Sprachpreise: ASR zeitlich begrenzt ¥0.39 / Stunde, TTS zeitlich begrenzt ¥1.5 / 10.000 abgerechnete Zeichen; chinesische Schriftzeichen zählen als 2 Zeichen
- Größter Kostenblock: Bei Rechercheaufgaben mit Internetzugriff machen Modell-Token meist mehr als die Hälfte aus; Nebenzeiten und Caching sind am effektivsten
- Cache-Effekt: Bei 80 % Eingabe-Trefferquote sinkt die Rechnung in Szenario 1 von ¥57 auf ¥41.32 – eine Ersparnis von rund 27.5 %
- Statistikbasis: Abgerechnet wird nach dem Feld
server_tool_use; Anzeigefelder können fehlgeschlagene Anfragen enthalten - Einstieg: Die eigenständigen Search-/Fetch-Endpunkte lassen sich bei APIYI apiyi.com mit einem einheitlichen Key testweise aufrufen
Zusammenfassung
Die Kernpunkte zu den Preisen der DeepSeek-Komplettpaket-API:
- Pro Aufgabe rechnen: Die Kosten einer Agent-Aufgabe = Eingabe + Ausgabe + Tools + Dateien/Sprache; der Preis einer einzelnen Anfrage spiegelt nur einen Teil davon wider
- Token dominieren die Rechnung: Die Tool-Einzelpreise sind niedrig; lange Kontextfenster, wiederholte Dateien und Denk-Ausgaben sind die Hauptursache für steigende Kosten
- Die Abrechnungsbasis bestimmt die Kontrollierbarkeit: Die integrierte Suche rechnet pro Suchbegriff ab und ist entwicklerfreundlich; eigenständige Schnittstellen rechnen pro Anfrage ab und liefern ein stabiles Budget
In der Praxis lassen Sie zunächst die Kostenfunktion aus diesem Artikel an einer kleinen Stichprobe laufen, um die tatsächlichen Abrechnungsfelder zu ermitteln, multiplizieren diese dann mit dem Geschäftsvolumen zum Budget und planen einen Puffer für das Auslaufen zeitlich begrenzter Angebote ein. Teams, die ihre Such- und Abrufprozesse selbst orchestrieren möchten, können über APIYI apiyi.com die eigenständigen DeepSeek-Search-/Fetch-Schnittstellen aufrufen und die tatsächlichen Preise aus der Konsole für einen Vergleich in derselben Währung heranziehen.
📚 Referenzen
- DeepSeek-Modelle und -Preise: offizielle Preisübersicht in Echtzeit
- Link:
api-docs.deepseek.com/zh-cn/quick_start/pricing -
Beschreibung: Token-Einzelpreise der Modelle, Haupt- und Nebenzeiten, Tool-Preise
-
DeepSeek-Webtools: technische Dokumentation zu integrierter Suche und Link-Lesen
- Link:
api-docs.deepseek.com/zh-cn/guides/web_tools -
Beschreibung: Abrechnungsdetails der tiefen Suche, Abrechnungsfeld
server_tool_use -
DeepSeek-Websuche und Crawling: eigenständige Search-/Fetch-Dokumentation
- Link:
api-docs.deepseek.com/zh-cn/guides/search -
Beschreibung: Definition einer erfolgreichen Anfrage, QPS-Limits, Behandlung von Fehlercodes
-
DeepSeek-Dateiparsing / OCR / ASR / TTS: technische Dokumentation der einzelnen Tools
- Link:
api-docs.deepseek.com/zh-cn/guides/document_parsing -
Beschreibung: Im selben Verzeichnis finden sich die Limits und Abrechnungseinheiten für ocr, asr und tts
-
Ankündigung der DeepSeek-Suite-APIs: veröffentlicht am 13. November 2026
- Link:
api-docs.deepseek.com/zh-cn/news/news261113 - Beschreibung: Liste der diesmal freigegebenen Funktionen und der unterstützten Modelle
Autor: APIYI-Technikerteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website. Die Schnittstellenparameter und aktuellen Preise für DeepSeek Search / Fetch finden Sie im Dokumentationszentrum von APIYI.