Résumé : L’API DeepSeek tout-en-un facture séparément les tokens du modèle et les appels d’outils. Le coût complet doit être calculé poste par poste selon le nombre de recherches, le nombre de pages de fichiers, le volume de traitement vocal et le taux de succès du cache.
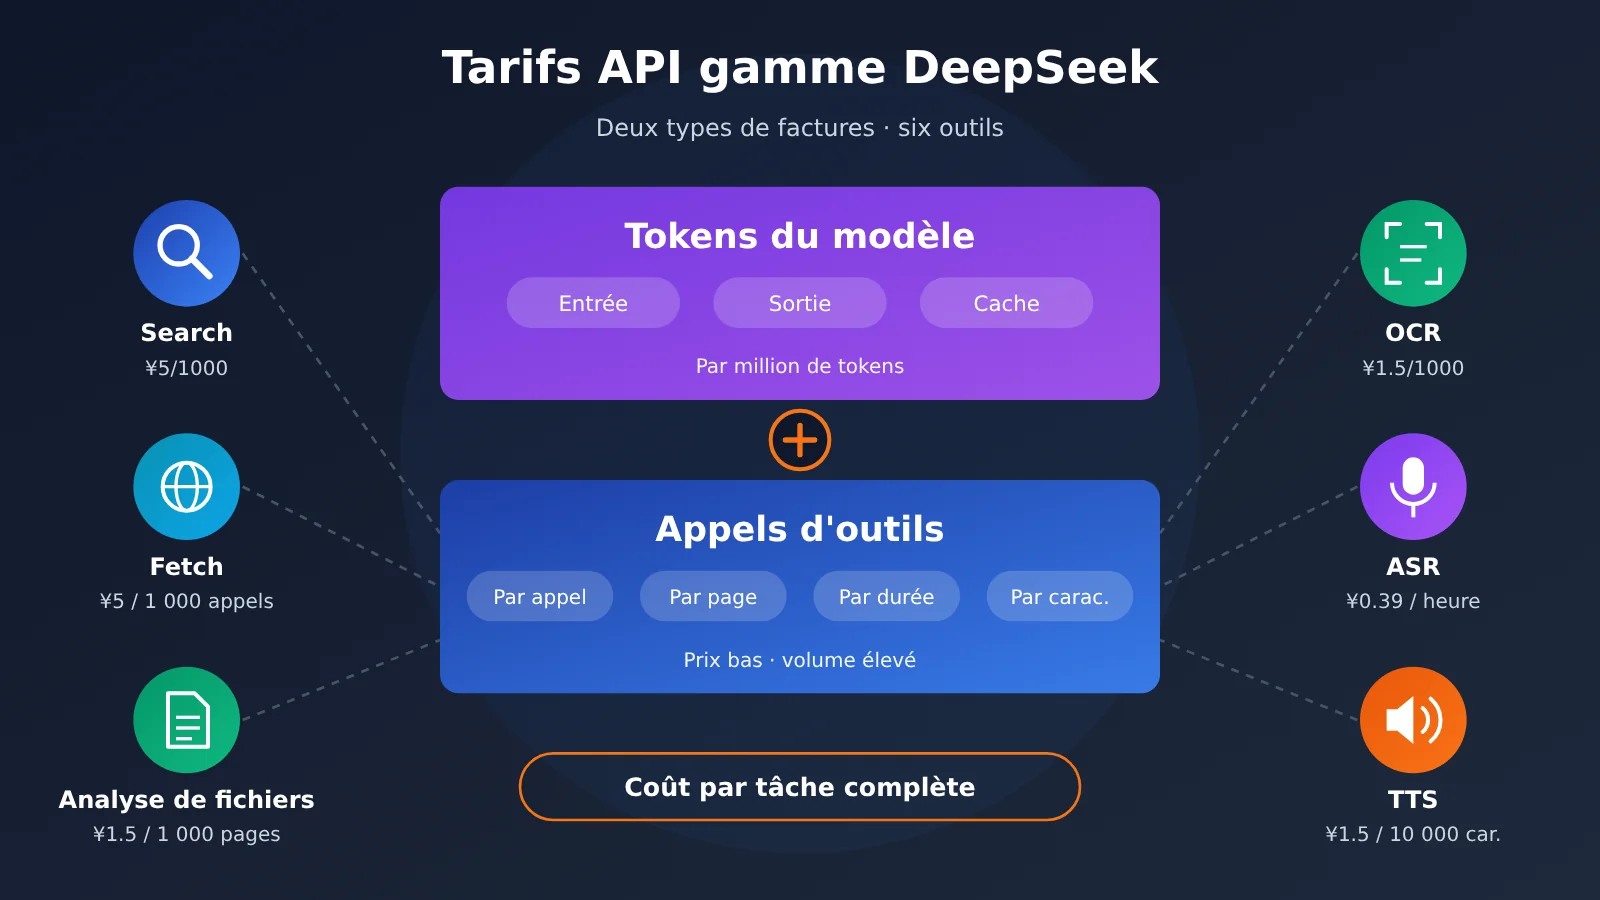
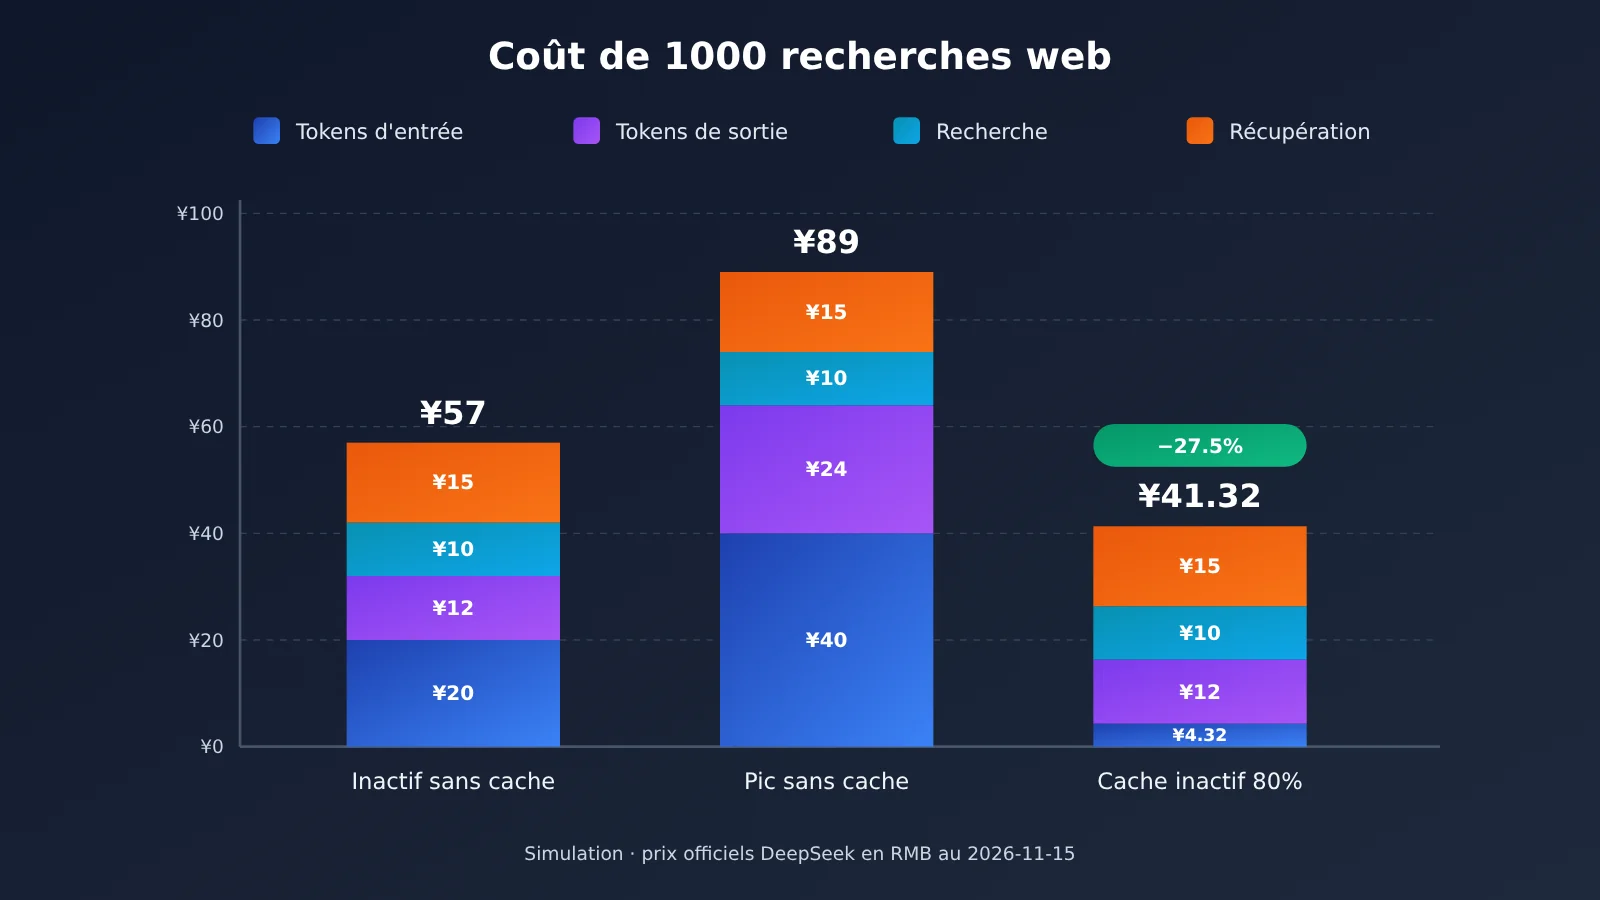
Conclusion en bref : selon la documentation tarifaire officielle chinoise de DeepSeek du 15 novembre 2026, Search et Fetch sont facturés 5 ¥ pour 1 000 requêtes réussies, l’analyse de fichiers et l’OCR 1,5 ¥ pour 1 000 pages, l’ASR 0,39 ¥ par heure (tarif temporaire) et la TTS 1,5 ¥ pour 10 000 caractères facturables (tarif temporaire). Le prix unitaire des outils est très bas, mais la facture d’une tâche d’agent connecté à Internet est généralement dominée par les tokens du modèle. D’après l’estimation d’une tâche de recherche de type « 2 recherches, 3 extractions, 20 000 tokens d’entrée, 3 000 tokens de sortie », 1 000 tâches coûtent environ 57 ¥ en heures creuses et environ 89 ¥ en heures de pointe ; avec un taux de succès du cache d’entrée de 80 %, on descend à environ 41,32 ¥ en heures creuses. Pour établir un budget, il faut donc raisonner en « tâche complète » : le prix d’une requête API isolée n’est qu’un poste parmi d’autres.
Dans la suite, nous décomposons d’abord la structure de facturation des frais liés au modèle et aux outils, puis nous listons un par un les prix unitaires et les unités de facturation de Search, Fetch, de l’analyse de fichiers, de l’OCR, de l’ASR et de la TTS. Nous utilisons ensuite 4 scénarios à hypothèses fixes pour dérouler le calcul complet, afin de montrer comment la recherche approfondie, le contexte long et les limites de débit influencent la facture. Enfin, nous fournissons un code de journalisation des coûts directement réutilisable et nous comparons la méthode de sélection entre la recherche intégrée au modèle et les interfaces Search / Fetch indépendantes.
À savoir : terminologie de facturation de l’API de la suite DeepSeek
| Terme | Explication |
|---|---|
| Token | Unité de mesure utilisée par le modèle pour traiter le texte ; les frais du modèle sont facturés par million de tokens |
| Token d’entrée | L’ensemble du contenu qui entre dans la fenêtre de contexte du modèle et participe à l’inférence, y compris l’invite, le contenu des fichiers et les résultats de recherche |
| Token de sortie | Le contenu généré par le modèle ; le processus de raisonnement en mode réflexion compte également dans la sortie |
| Context Cache | Réutilisation d’un contexte déjà traité auparavant, ce qui réduit le coût des entrées répétées |
| Cache Hit | Le contenu d’entrée réutilise avec succès le cache et est facturé à un prix unitaire inférieur, dit de « cache hit » |
| Heures de pointe / heures creuses | DeepSeek distingue deux niveaux de prix selon l’heure de Pékin ; le prix des heures creuses correspond à la moitié du prix de pointe |
| Search API | Interroge le web par mots-clés et renvoie des résultats de recherche structurés |
| Fetch API | Récupère une page web spécifiée et en renvoie le corps du texte |
| Recherche intégrée au modèle | Déclaration de l’outil de recherche dans une requête de conversation ; le modèle décide lui-même de lancer la recherche et le serveur l’exécute pour son compte |
| QPS | Nombre de requêtes traitées par seconde |
| OCR | Reconnaissance du texte à partir d’images ou de documents |
| ASR | Conversion de la parole en texte |
| TTS | Synthèse vocale à partir du texte |
| Caractère facturable | Unité de mesure de la TTS ; un caractère chinois compte pour 2 caractères facturables |
| Tool Usage | Volume facturable généré par l’appel effectif d’outils externes par le modèle ou le programme |
1 Comment l’API de la suite complète DeepSeek est-elle réellement facturée
1.1 Les deux types de facturation de l’API DeepSeek : frais de modèle et frais d’outils
Le 13 novembre 2026, DeepSeek a ouvert en API les capacités qui se cachent derrière son application : recherche web, recherche avec réflexion approfondie, lecture de liens, entrée de fichiers, OCR, ASR, TTS, vérification de sécurité, etc. Côté facturation, ces capacités et l’inférence du modèle sont comptabilisées séparément. On peut résumer la chose par une formule :
Coût total = frais d'entrée du modèle (cache hit + cache miss)
           + frais de sortie du modèle (y compris les tokens de réflexion)
           + frais d'appel des outils (Search / Fetch / recherche d'images)
           + frais de traitement des fichiers et de la voix (pages analysées / pages OCR / durée audio / caractères TTS)
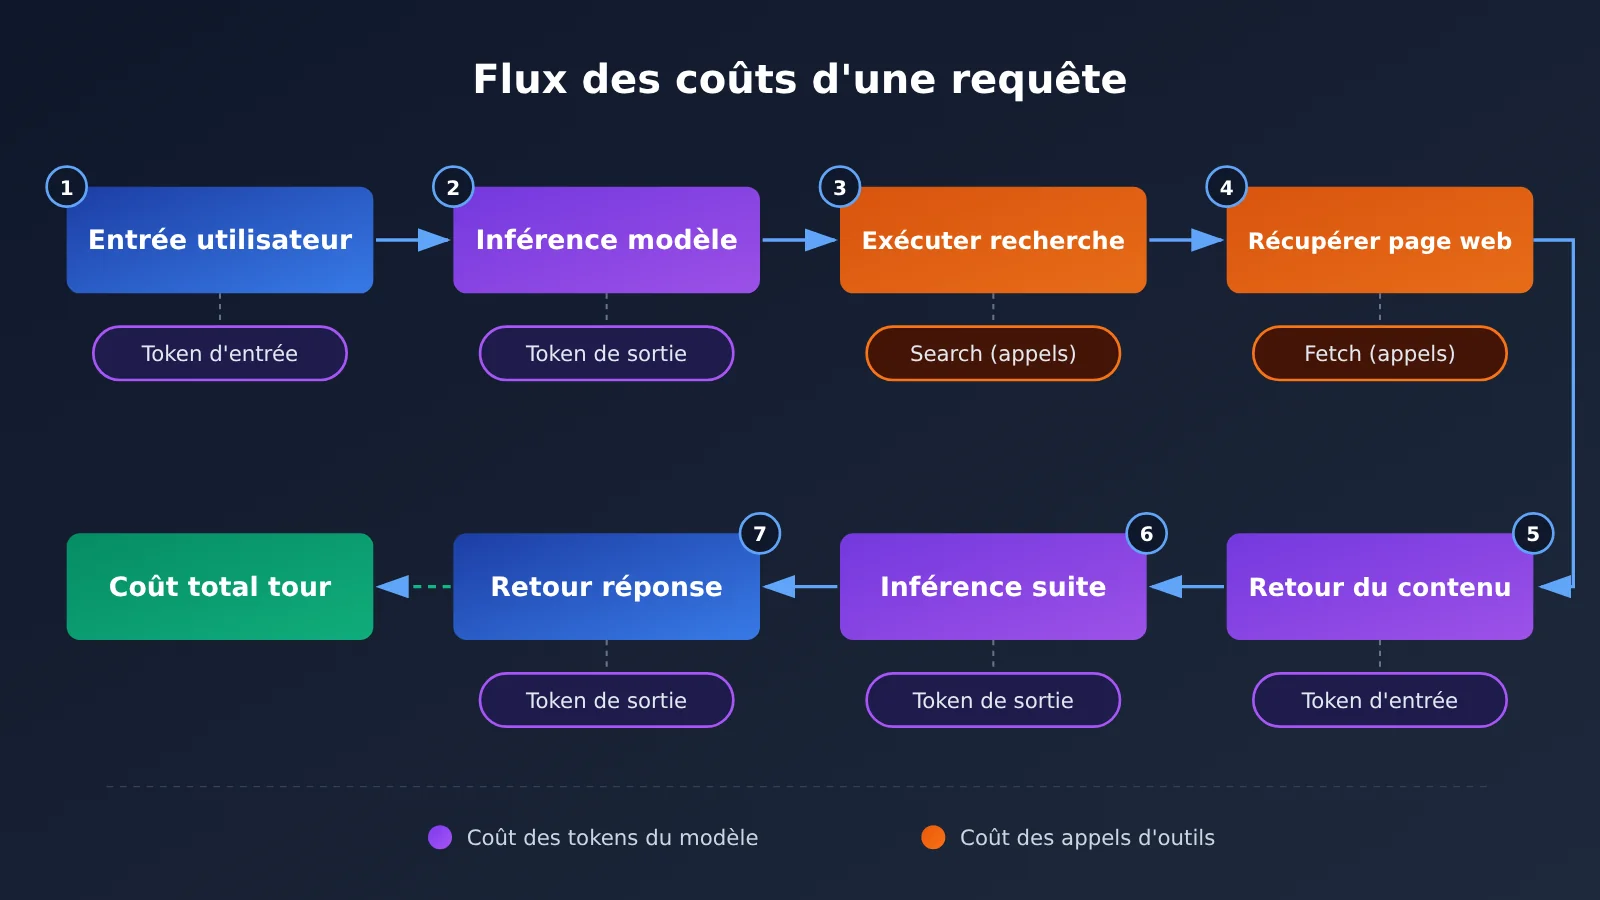
Une même requête peut engendrer simultanément chacun de ces postes de coût. Par exemple, si l’on active la recherche avec réflexion approfondie dans une conversation, le modèle génère plusieurs fois des termes de recherche, ouvre plusieurs pages web, puis insère leur contenu dans le contexte pour continuer à raisonner. Cette requête unique produit à la fois des frais de recherche et de récupération, une grande quantité de tokens d’entrée (le corps des pages web entre dans le contexte) et des tokens de sortie pour le processus de réflexion.
1.2 Les tarifs des modèles DeepSeek Flash et Pro
Voici les tarifs publiés dans la documentation tarifaire officielle de DeepSeek le 15 novembre 2026, en yuans, par million de tokens.
| Modèle | Cache hit (creux / pointe) | Cache miss (creux / pointe) | Sortie (creux / pointe) | Limite de concurrence |
|---|---|---|---|---|
| DeepSeek-V4.1-Flash | ¥0.02 / ¥0.04 | ¥1 / ¥2 | ¥4 / ¥8 | 2500 |
| DeepSeek-V4-Pro | ¥0.15 / ¥0.30 | ¥4.5 / ¥9 | ¥13.5 / ¥27 | 500 |
Les heures de pointe correspondent, heure de Pékin, du lundi au vendredi de 09:00 à 12:00 et de 14:00 à 18:00, hors jours fériés légaux chinois ; le reste du temps (y compris le week-end et les jours fériés toute la journée) est en heures creuses. Les deux modèles ont une fenêtre de contexte de 1M et une longueur de sortie maximale de 384K ; Flash prend en charge la compréhension d’images, Pro non.
Le choix du modèle influence aussi la disponibilité des outils. Dans cette annonce, l’intégration complète des outils au niveau conversation (recherche web, recherche avec réflexion approfondie, lecture de liens, analyse de fichiers, compréhension d’images, vérification de sécurité) repose sur deepseek-flash (DeepSeek-V4.1-Flash). Pour concevoir une application dotée d’outils intégrés, il faut donc bâtir son modèle de coûts sur Flash.
2 Combien coûtent Search, Fetch, OCR, ASR et TTS dans la suite API DeepSeek
Le tableau ci-dessous présente les tarifs officiels des outils DeepSeek (au 15 novembre 2026, en RMB). Le « tarif catalogue » et la « remise à durée limitée » sont indiqués séparément ; une fois la remise terminée, il faudra recalculer le budget sur la base du tarif catalogue.
| Capacité | Unité de facturation | Tarif catalogue | Remise à durée limitée | Conversion par appel / unité |
|---|---|---|---|---|
| Search (recherche) | 1000 requêtes réussies | ¥5 | ¥5 | ¥0.005 / requête |
| Fetch (récupération de pages web) | 1000 requêtes réussies | ¥5 | ¥5 | ¥0.005 / requête |
| Analyse de fichiers | 1000 pages | ¥1.5 | ¥1.5 | ¥0.0015 / page |
| OCR | 1000 pages | ¥1.5 | ¥1.5 | ¥0.0015 / page |
| ASR | 1 heure d’audio | ¥0.78 | ¥0.39 | moins d’une seconde comptée comme une seconde |
| TTS | 10 000 caractères facturables | ¥3 | ¥1.5 | un caractère chinois compte pour 2 caractères |
2.1 Mode de facturation de DeepSeek Search et Fetch
Le Search autonome est facturé à la requête réussie : seules les réponses HTTP 200 avec un tableau results non vide sont considérées comme réussies. Une requête peut renvoyer entre 1 et 50 résultats (count vaut 10 par défaut) ; le prix est le même pour 1 ou pour 50 résultats, donc mieux vaut récupérer beaucoup de résultats en une seule fois que multiplier les petites requêtes. Le Fetch autonome exige un HTTP 200 et le renvoi effectif du corps de la page ; les échecs, les timeouts et l’absence de résultats ne sont pas facturés.
La méthode de comptage de la recherche intégrée au modèle est différente. La recherche textuelle intégrée est facturée selon le nombre de requêtes réellement exécutées : un appel d’outil avec 3 termes de recherche compte pour 3. La recherche d’images intégrée est facturée selon le nombre d’images renvoyées et de zones sélectionnées ; la récupération de pages web intégrée est facturée selon le nombre de pages récupérées avec succès. Ainsi, lorsque la recherche est activée dans une conversation, il est normal qu’un tour de question-réponse génère plusieurs frais de recherche.
2.2 Tarification à la page pour l’analyse de fichiers et l’OCR de DeepSeek
L’analyse de fichiers passe par l’API Files : on téléverse le fichier, le serveur l’analyse et renvoie un file_id, qu’il suffit ensuite de référencer dans la conversation. La facturation se fait au nombre de pages analysées avec succès, à 1,5 ¥ pour 1000 pages. Si l’on référence à nouveau le même fichier déjà analysé dans une conversation, aucun frais d’analyse n’est facturé, mais chaque fois que son contenu entre dans le contexte, il est facturé comme des tokens d’entrée.
Le mode d’analyse influe lui aussi sur la consommation de tokens. text_recognition ne fournit au modèle que du texte brut, tandis que rich_layout_recognition découpe les graphiques en images et les transmet au modèle avec le texte : c’est adapté aux rapports financiers et aux présentations, mais cela augmente le nombre de tokens d’image. Les fichiers XLSX, CSV, TXT, MD, JSON, EPUB, etc. peuvent être téléversés en tant que user_data et convertis en Markdown ; ce type de téléversement n’engendre pas de frais d’analyse.
L’OCR est une interface indépendante (/v1/tools/ocr), également à 1,5 ¥ pour 1000 pages, facturée au nombre de pages reconnues avec succès — les échecs et les dépassements de délai ne sont pas facturés. Les deux ont des rôles bien distincts : l’OCR se contente d’extraire le texte et les informations de position, alors que l’analyse de fichiers envoie directement le résultat dans le contexte du modèle pour qu’il le comprenne.
2.3 Tarification de la voix pour l’ASR et le TTS de DeepSeek
L’ASR (/v1/tools/asr) est au tarif catalogue de 0,78 ¥ par heure d’audio, actuellement à moitié prix pour une durée limitée, soit 0,39 ¥, avec toute fraction inférieure à 1 seconde facturée comme 1 seconde. Il fonctionne par téléversement complet du fichier et reconnaissance non-streaming ; un audio individuel peut durer jusqu’à 120 secondes et peser jusqu’à 8 MiB, avec prise en charge du WAV PCM 16 bits et de l’Ogg Opus, et une concurrence de 50 par compte. Les longs enregistrements doivent d’abord être découpés en segments, et la fraction inférieure à 1 seconde à la fin de chaque segment est arrondie à la seconde supérieure : plus les segments sont petits, plus ces arrondis s’accumulent.
Le TTS (/v1/tools/tts, également disponible en synthèse streaming via WebSocket) est au tarif catalogue de 3 ¥ pour 10 000 caractères facturables, avec un prix promotionnel de 1,5 ¥. Les caractères chinois comptent pour 2 caractères facturables, les lettres latines, chiffres et espaces pour 1, avec un maximum de 10 000 caractères facturables par saisie. En conversion, 100 000 caractères facturables équivalent à environ 50 000 caractères chinois : pour du contenu en chinois, il faut donc multiplier le budget par 2 au départ.
3 Estimer les coûts de l’API de la suite complète DeepSeek dans quatre scénarios
Les quatre cas ci-dessous reposent sur des prix unitaires publics et des hypothèses fixes. Le nombre d’appels et la consommation de tokens sont des valeurs hypothétiques : il s’agit d’une estimation par scénario, qui illustre la méthode de calcul. La facture réelle est déterminée par les champs de facturation renvoyés par le serveur.
3.1 Scénario 1 : 1 000 tâches de recherche en ligne (heures creuses 57 ¥ / heures de pointe 89 ¥)
Hypothèses : utilisation de DeepSeek-V4.1-Flash ; pour chaque tâche, 2 requêtes de recherche réussies, 3 pages Web récupérées avec succès, 20 000 tokens d’entrée non mis en cache et 3 000 tokens de sortie.
| Poste | Formule de calcul | Heures creuses (¥/appel) | Heures de pointe (¥/appel) |
|---|---|---|---|
| Tokens d’entrée | 20 000 ÷ 1 000 000 × prix unitaire | 0,020 | 0,040 |
| Tokens de sortie | 3 000 ÷ 1 000 000 × prix unitaire | 0,012 | 0,024 |
| Search | 2 × 0,005 ¥ | 0,010 | 0,010 |
| Fetch | 3 × 0,005 ¥ | 0,015 | 0,015 |
| Total par appel | — | 0,057 | 0,089 |
| Total pour 1 000 appels | prix par appel × 1 000 | 57 ¥ | 89 ¥ |
Pendant les heures de pointe, le coût des tokens du modèle double, tandis que les prix de Search et Fetch restent inchangés. La facture totale passe donc de 57 ¥ à 89 ¥, soit une hausse d’environ 56 %. Dans cette tâche, les frais de modèle représentent environ 56 % de la facture en heures creuses (32 ¥ / 57 ¥), ce qui montre que le poste principal d’un agent connecté reste les tokens. Décaler vers les heures creuses les tâches par lots qui peuvent être exécutées plus tard est le moyen le plus direct de réduire les coûts.
3.2 Scénario 2 : combien peut-on économiser avec un taux de succès du cache d’entrée de 80 %
Hypothèse : mêmes conditions que le scénario 1 (période creuse), mais sur 20 000 tokens d’entrée, 16 000 touchent le cache et 4 000 non.
- Entrée avec cache : 16000 ÷ 1000000 × ¥0.02 = ¥0.00032
- Entrée sans cache : 4000 ÷ 1000000 × ¥1 = ¥0.004
- Sortie : 3000 ÷ 1000000 × ¥4 = ¥0.012
- Recherche + récupération : ¥0.010 + ¥0.015 = ¥0.025
- Total par appel ¥0.04132, total pour 1000 appels ¥41.32
Par rapport aux ¥57 du scénario 1, cela représente une économie de ¥15.68, soit environ 27.5 %. Le cache ne joue que sur le coût d’entrée : l’entrée passe de ¥0.020 à environ ¥0.0043, tandis que les coûts de sortie et d’outils restent totalement inchangés. Plus le taux de succès du cache est élevé, plus la facture se rapproche de la limite basse « sortie + outils » ; pour continuer à réduire les coûts à ce stade, il faut diminuer le nombre de recherches et contrôler la longueur de la sortie.
3.3 Scénario trois : traitement par lots de 5000 pages de documents d’entreprise
Hypothèse : période creuse de Flash ; les 5000 pages de documents ne sont analysées qu’une seule fois ; l’analyse ultérieure cumule 10 millions de Tokens d’entrée avec échec de cache et 1 million de Tokens de sortie.
- Analyse des fichiers : 5000 ÷ 1000 × ¥1.5 = ¥7.50
- Entrée modèle : 10000000 ÷ 1000000 × ¥1 = ¥10.00
- Sortie modèle : 1000000 ÷ 1000000 × ¥4 = ¥4.00
- Total ¥21.50
Les frais d’analyse ne représentent qu’environ 35 %. Si le même lot de fichiers est réinjecté en entier dans le contexte au fil de plusieurs tours de conversation, les Tokens d’entrée augmentent de façon exponentielle, alors que les frais d’analyse, eux, ne bougent plus. Dans les scénarios de gros documents, la clé consiste à maîtriser « le nombre de fois où le contenu du fichier entre dans le contexte ».
3.4 Scénario quatre : 10 heures de reconnaissance vocale + 100 000 caractères facturables TTS
Hypothèse : utilisation du tarif promotionnel actuel à -50 % ; ASR sur 10 heures d’audio, TTS avec 100 000 caractères facturables.
- ASR : 10 × ¥0.39 = ¥3.90
- TTS : 100000 ÷ 10000 × ¥1.5 = ¥15.00
- Total ¥18.90
Ce coût ne couvre que les services vocaux. Quand le texte transcrit est confié à un modèle de dialogue pour un résumé ou des questions-réponses, les Tokens du modèle sont facturés séparément. Au tarif catalogue, la même consommation reviendrait à 10 × ¥0.78 + 10 × ¥3 = ¥37.80 : une fois la promotion terminée, le budget vocal double. Par ailleurs, 10 heures d’audio, avec la limite de 120 secondes par segment, doivent être découpées en au moins 300 segments, ce qui demande une orchestration avec 50 tâches concurrentes.
4 Quels facteurs font grimper la facture API de la suite DeepSeek
4.1 La recherche en réflexion profonde exécute plusieurs termes de requête d’un coup
La recherche en réflexion profonde peut appeler jusqu’à une vingtaine d’outils avant de répondre, et la facturation s’accumule selon les actions réellement effectuées. Voici quelques règles clés tirées des conditions de facturation officielles :
- Une Search contenant 3 termes de requête, tous avec des résultats, compte pour 3 recherches
- Une recherche d’images qui renvoie 3 images compte pour 3 fois ; si le modèle sélectionne ensuite 2 zones dans l’image, cela ajoute 2 fois
- L’ouverture réussie d’une page web nécessitant une récupération en ligne compte pour 1 Fetch ; rouvrir la même page ne refacture pas
- L’exécution de
find_in_pagesur une page déjà ouverte n’est pas facturée séparément ; une Search sans résultat n’est pas facturée - Lorsque la sécurité de contenu du modèle est activée, certaines pages affichées comme
url_not_allowedouunavailablepeuvent tout de même être facturées si la récupération sous-jacente a bien abouti
Pour les statistiques, utilisez les champs de facturation server_tool_use.tool_search, tool_fetch, tool_image_search. web_search_requests et web_fetch_requests ne font qu’indiquer le nombre de blocs renvoyés et peuvent inclure des requêtes échouées ; les utiliser surestimerait les coûts.
4.2 Contexte long et entrées de fichiers répétées
Les résultats de recherche, le corps des pages web et les fichiers déjà analysés entrent dans le contexte. L’outil de lecture de liens prend en compte au maximum 10 URL différentes dans le dernier message utilisateur ; lors de la lecture simultanée de plusieurs pages, le contexte disponible par page diminue, mais le volume total d’entrée reste considérable. À chaque tour d’une longue conversation, l’historique est inclus, et les Token d’entrée augmentent avec le nombre de tours.
Trois méthodes pour réduire les coûts : enregistrer les résumés et les faits clés au niveau applicatif, puis les référencer dans les tours suivants ; placer le prompt système, les documents publics et les règles de workflow en tête du contexte et les garder stables pour augmenter les chances de cache hit ; n’utiliser rich_layout_recognition que lorsqu’il faut vraiment lire des graphiques.
4.3 Limites de débit des requêtes pour les tâches par lots
La limite au niveau du compte pour une Search indépendante est de 100 QPS, et de 25 QPS pour Fetch : c’est le quota de tout le compte, partagé par plusieurs clés API. Fetch est également soumis à une limite de QPS au niveau du domaine cible ; cibler intensivement le même site déclenche plus facilement un 429. Recommandations de gestion des erreurs :
- 408, 429, 5xx : réessayer après un backoff exponentiel, répartir les requêtes vers le même domaine
- 402 : solde insuffisant, traiter d’abord le solde du compte
- Autres 4xx (comme une erreur de paramètre) : corriger la requête avant de renvoyer, le retry est inutile
Les requêtes échouées ne sont pas facturées, donc le retry n’ajoute pas de frais d’outil, mais rallonge la durée de la tâche. Pour les tâches en gros lots, il faut déduire le temps de complétion à partir de la limite de 25 QPS pour Fetch.
5 Comment définir un budget de coûts raisonnable pour un agent DeepSeek
5.1 Journal des coûts de l’API de la suite complète DeepSeek : prise en main rapide
En production, il faut au minimum journaliser séparément : les tokens d’entrée en cache (cache hit), les tokens d’entrée hors cache (cache miss), les tokens de sortie, le nombre de Search, le nombre de Fetch, le nombre de recherches d’images, le nombre de pages de documents analysées, la durée audio et les caractères facturés pour la TTS. La fonction ci-dessous lit directement le champ usage et calcule le coût d’un appel ; il suffit de la brancher après chaque requête pour écrire le log.
# Estimation des coûts de la suite complète DeepSeek (yuan, tarifs officiels du 2026-11-15)
FLASH = {"cache_hit": 0.02, "cache_miss": 1.0, "output": 4.0}  # Période creuse ¥/million de tokens
TOOL = {"search": 0.005, "fetch": 0.005, "image_search": 0.005}  # ¥/appel

def estimate_cost(usage: dict, peak: bool = False) -> dict:
    k = 2 if peak else 1  # Le tarif en heures de pointe vaut le double de celui hors pointe ; le tarif des outils ne change pas
    stu = usage.get("server_tool_use", {})
    model = (usage.get("cache_read_input_tokens", 0) * FLASH["cache_hit"]
             + usage.get("input_tokens", 0) * FLASH["cache_miss"]
             + usage.get("output_tokens", 0) * FLASH["output"]) / 1e6 * k
    tools = (stu.get("tool_search", 0) * TOOL["search"]
             + stu.get("tool_fetch", 0) * TOOL["fetch"]
             + stu.get("tool_image_search", 0) * TOOL["image_search"])
    return {"model": round(model, 5), "tools": round(tools, 5),
            "total": round(model + tools, 5)}

# Reproduire le scénario 2 : 16000 en cache + 4000 hors cache + 3000 en sortie + 2 recherches + 3 récupérations
print(estimate_cost({"cache_read_input_tokens": 16000, "input_tokens": 4000,
                     "output_tokens": 3000,
                     "server_tool_use": {"tool_search": 2, "tool_fetch": 3}}))
# {'model': 0.01632, 'tools': 0.025, 'total': 0.04132}
Ici, le prix unitaire de la recherche d’images est traité comme celui de Search ; avant la mise en production, vérifiez-le dans la documentation officielle. Côté dimensions de budgétisation, les produits de questions-réponses gagnent à comptabiliser « par requête utilisateur », tandis que les agents multi-étapes, le Deep Research et l’automatisation par lots sont mieux servis par une comptabilisation « par cycle de vie de tâche » : on regroupe tous les appels de modèle et tous les appels d’outils d’une même tâche sous un seul task_id.
5.2 Quand choisir la recherche intégrée à DeepSeek, quand choisir les API Search / Fetch indépendantes
| Dimension | Recherche intégrée au modèle (deepseek_web_search / read_url) | API Search / Fetch indépendantes |
|---|---|---|
| Complexité de développement | Faible : le serveur se charge de la recherche, de la récupération et de l’assemblage du contexte | Plus élevée : il faut orchestrer soi-même la boucle d’outils |
| Contrôle du déroulement | C’est le modèle qui décide combien de recherches effectuer et quelles pages lire | Le développeur contrôle précisément chaque appel |
| Base de facturation | Selon le nombre de termes de requête, d’images et de pages récupérées avec succès | Selon le nombre de requêtes HTTP réussies |
| Prévisibilité des coûts | Forte variabilité ; une recherche approfondie peut atteindre environ 20 appels d’outils | Élevée : le nombre d’appels est déterminé par le code |
| Cas d’usage adaptés | Assistants conversationnels, reproduction rapide de l’expérience d’une application | RAG, collecte par lots, agents à déroulement fixe |
Quand il faut mettre rapidement en ligne un produit conversationnel, la recherche intégrée vous épargne une bonne part du travail d’ingénierie ; en revanche, si vous devez maintenir le coût d’une tâche dans une fourchette fixe, ou commencer par filtrer avant de récupérer, les API indépendantes sont plus indiquées. Les deux approches peuvent aussi se combiner : les outils intégrés pour le flux principal de la conversation, les API indépendantes pour compléter des données en arrière-plan par lots.
5.3 Intégration et tarifs de DeepSeek Search / Fetch sur APIYI
APIYI a mis en ligne le 21 octobre 2026 les interfaces d’outils autonomes DeepSeek deepseek-search et deepseek-fetch, exposées via POST /v1/tools/search et POST /v1/tools/fetch. Elles ne consomment pas de tokens du modèle : la facturation se fait au nombre d’appels réussis. Elles sont disponibles pour les groupes default et svip, mais les jetons du groupe ClaudeCode ne peuvent pas les appeler directement. Pour la recherche intégrée au modèle utilisée par des clients comme DeepSeek Harness ou Claude Code, le travail de compatibilité chez APIYI est encore au stade de la planification ; ce qui est disponible aujourd’hui, ce sont les Search / Fetch autonomes.
Voici les tarifs publiés dans la documentation APIYI, en dollars américains :
| Élément | Prix officiel indiqué dans la doc | Prix sur APIYI | Équivalent après bonus de 20 % | Équivalent après bonus de 10 % |
|---|---|---|---|---|
| Search / 1000 appels | $0.75 | $0.90 | $0.75 | environ $0.82 |
| Fetch / 1000 appels | $0.75 | $0.90 | $0.75 | environ $0.82 |
Si l’on reprend le volume d’outils du scénario 1 (1000 Search + 3000 Fetch) : la facturation sur le site donne (1000 + 3000) ÷ 1000 × $0.90 = $3.60 ; si le bonus de 20 % s’applique à l’ensemble des consommations, l’équivalent est $3.60 ÷ 1.20 = $3.00 ; avec un bonus de 10 %, on obtient environ $3.27. DeepSeek facture officiellement en yuans : pour comparer les coûts réels, il faut aligner la devise, le taux de change et les conditions de bonus de recharge. En dernier ressort, c’est le prix affiché dans la console de votre compte qui fait foi.
Exemple d’appel minimal (les champs de requête suivent la documentation APIYI) :
import requests

BASE_URL = "https://api.apiyi.com/v1"  # interface unifiée APIYI
headers = {"Authorization": "Bearer YOUR_API_KEY"}

resp = requests.post(f"{BASE_URL}/tools/search", headers=headers,
                     json={"model": "deepseek-search",
                           "query": "DeepSeek API 价格", "count": 10})
print(resp.json())
Voir l’implémentation complète : recherche puis récupération, avec backoff et nouvelle tentative sur 429, et comptage
import time
import requests

BASE_URL = "https://api.apiyi.com/v1"  # Point d'entrée compatible OpenAI d'APIYI
HEADERS = {"Authorization": "Bearer YOUR_API_KEY"}
RETRY_CODES = {408, 429, 500, 502, 503, 504}

def call_tool(path: str, payload: dict, max_retry: int = 4) -> dict | None:
    """Appelle l'interface de l'outil ; les erreurs réessayables sont soumises à un backoff exponentiel, les requêtes échouées ne sont pas facturées"""
    for i in range(max_retry):
        r = requests.post(f"{BASE_URL}{path}", headers=HEADERS,
                          json=payload, timeout=60)
        if r.status_code == 200:
            return r.json()
        if r.status_code == 402:
            raise RuntimeError("余额不足,请先充值")
        if r.status_code in RETRY_CODES:
            time.sleep(2 ** i)  # 1s, 2s, 4s, 8s
            continue
        raise ValueError(f"请求参数错误: {r.status_code} {r.text}")
    return None

def research(query: str, fetch_top: int = 3) -> dict:
    stats = {"search": 0, "fetch": 0}
    result = call_tool("/tools/search",
                       {"model": "deepseek-search", "query": query, "count": 10})
    items = (result or {}).get("results", [])
    if items:
        stats["search"] += 1  # Seuls les résultats non vides sont facturés
    pages = []
    for item in items[:fetch_top]:  # Ne récupérer que les pages dont il faut vraiment lire le contenu original
        page = call_tool("/tools/fetch",
                         {"model": "deepseek-fetch", "url": item.get("url")})
        if page:
            stats["fetch"] += 1
            pages.append(page)
        time.sleep(0.05)  # Contrôler le rythme pour éviter la limite de 25 QPS de Fetch et la limitation de débit au niveau du domaine
    return {"pages": pages, "billing": stats}

if __name__ == "__main__":
    out = research("DeepSeek 全家桶 API 计费规则")
    print(out["billing"])  # Par exemple {'search': 1, 'fetch': 3}
🚀 Démarrage rapide : inscrivez-vous sur APIYI apiyi.com pour obtenir un quota de test, validez d’abord Search / Fetch avec un petit lot de requêtes, puis estimez le budget définitif d’après le nombre réel d’appels dans les journaux.
FAQ – Questions fréquentes
Q1 : Quels sont les postes facturés dans l’API de l’offre complète DeepSeek ?
Elle comprend les tokens du modèle (entrée avec cache hit, entrée avec cache miss, sortie) et les frais d’outils (Search, Fetch, recherche d’images, analyse de fichiers, OCR, ASR, TTS). La validation de sécurité et la recherche dans la page `find_in_page` n’ont pas de tarif distinct dans la grille tarifaire publique.
Q2 : Quelle différence de facturation y a-t-il entre l’API Search autonome et la recherche intégrée au modèle ?
L’API Search autonome facture 1 fois par requête HTTP réussie : même si elle renvoie 50 résultats, cela ne compte que pour 1. La recherche intégrée au modèle facture selon le nombre réel de termes de requête : un appel contenant 3 termes compte pour 3. La méthode intégrée est plus simple à développer, la méthode autonome offre un coût plus maîtrisable.
Q3 : De quand datent ces prix, et les offres à durée limitée peuvent-elles évoluer ?
Les prix de cet article proviennent de la documentation tarifaire officielle en chinois de DeepSeek, à la date du 15 novembre 2026. L’ASR et le TTS bénéficient actuellement d’une promotion à moitié prix à durée limitée ; une fois terminée, ils reviendront respectivement à 0,78 ¥ de l’heure et à 3 ¥ pour 10 000 caractères facturés. Pour un budget à long terme, mieux vaut prévoir une marge en se basant sur le tarif catalogue.
Q4 : La facture double-t-elle directement aux heures de pointe ?
Seule la partie des tokens du modèle double ; les prix des outils ne varient pas selon l’horaire. Dans le scénario 1, la facture totale passe de 57 ¥ à 89 ¥, soit une hausse d’environ 56 %. Plus la part des frais d’outils est élevée dans une tâche, plus la hausse en heure de pointe est faible.
Q5 : Comment appeler rapidement DeepSeek Search et Fetch via l’API ?
1. S’inscrire sur APIYI apiyi.com et créer un jeton pour le groupe default ou svip
2. Définir `base_url` sur `https://api.apiyi.com/v1`
3. Utiliser le code de cet article pour appeler `/tools/search` et `/tools/fetch`, avec respectivement les noms de modèle `deepseek-search` et `deepseek-fetch`
Une même clé API permet aussi d’appeler d’autres modèles courants de la plateforme, ce qui est pratique pour confier les résultats de recherche à différents modèles et comparer leurs performances.
Q6 : Des questions répétées après l’analyse d’un fichier entraînent-elles des frais répétés ?
Les frais d’analyse ne sont facturés qu’une seule fois : réutiliser le même `file_id` ne génère plus de frais d’analyse. En revanche, le contenu du fichier est facturé en tokens d’entrée à chaque fois qu’il entre dans le contexte ; pour un gros fichier interrogé sur plusieurs tours, l’essentiel du coût vient des tokens d’entrée.
Q7 : Quelles sont les limitations connues de l’API de l’offre complète DeepSeek ?
– L’intégration complète des outils au niveau de la conversation cible actuellement `deepseek-flash`
– API Search autonome : 100 QPS au niveau du compte, Fetch : 25 QPS, avec en plus les limites de débit imposées par le domaine cible
– ASR : segment unique de 120 secondes maximum, en non-streaming ; TTS : 10 000 caractères facturés maximum par appel, réglage de la vitesse de parole pas encore pris en charge
– Analyse de fichiers : 100 MiB et 1000 pages maximum par fichier, 20 fichiers référencés maximum par requête
Q8 : APIYI peut-il appeler tous les nouveaux outils intégrés publiés par DeepSeek ?
Actuellement, APIYI propose déjà les API autonomes `deepseek-search` et `deepseek-fetch`, que vous pouvez orchestrer vous-même dans un Agent ou un RAG. La compatibilité de la recherche intégrée au modèle dans des clients comme Harness ou Claude Code est encore en cours de planification ; pour suivre les avancées, référez-vous à la documentation officielle d’APIYI apiyi.com.
Points clés à retenir sur les tarifs de la suite API DeepSeek
- Structure de facturation : les tokens du modèle et les appels d’outils sont facturés séparément ; une tâche génère en même temps plusieurs postes de coûts
- Prix unitaires des outils : Search et Fetch à ¥5 / 1000 appels chacun, analyse de fichiers et OCR à ¥1,5 / 1000 pages chacun
- Tarifs de la voix : ASR en offre limitée à ¥0,39 / heure, TTS en offre limitée à ¥1,5 / 10 000 caractères facturés, un caractère chinois comptant pour 2 caractères
- Le gros de la facture : dans les tâches de recherche avec accès réseau, les tokens du modèle représentent généralement plus de la moitié du total ; les plages creuses et le cache sont les leviers les plus efficaces
- Effet du cache : avec 80 % de hits en entrée, la facture du scénario 1 passe de ¥57 à ¥41,32, soit environ 27,5 % d’économie
- Base de calcul : on tient la comptabilité sur le champ de facturation
server_tool_use; les champs d’affichage peuvent inclure les requêtes échouées - Pour démarrer : les interfaces Search / Fetch autonomes peuvent être testées sur APIYI apiyi.com avec une clé unifiée
Conclusion
Les points essentiels des tarifs de la suite API DeepSeek :
- Raisonner par tâche : le coût d’une tâche Agent = entrée + sortie + outils + fichiers et voix ; le prix d’une seule requête ne reflète qu’un seul de ces postes
- Les tokens dominent la facture : les outils sont bon marché, ce sont le long contexte, les fichiers répétés et la sortie de réflexion qui font vraiment grimper la note
- La base de calcul détermine la maîtrise : la recherche intégrée est facturée par mot-clé de requête, ce qui facilite le développement ; l’interface autonome est facturée par requête, ce qui stabilise le budget
En pratique, commencez par exécuter la fonction de coût de cet article sur un petit échantillon pour obtenir les vrais champs de facturation, puis multipliez par le volume métier pour estimer le budget, en gardant une marge pour l’expiration des offres à durée limitée. Les équipes qui souhaitent orchestrer elles-mêmes leurs processus de recherche et de récupération peuvent appeler les interfaces DeepSeek Search / Fetch autonomes via APIYI apiyi.com, puis comparer à devise égale en se basant sur les prix réels affichés dans la console.
📚 Références
- Modèles et tarifs DeepSeek : documentation officielle des tarifs en temps réel
- Lien :
api-docs.deepseek.com/zh-cn/quick_start/pricing -
Description : prix unitaire des tokens du modèle, heures de pointe et heures creuses, tarifs des outils
-
Outils web DeepSeek : documentation technique de la recherche intégrée et de la lecture de liens
- Lien :
api-docs.deepseek.com/zh-cn/guides/web_tools -
Description : règles de facturation de la recherche approfondie, champ de facturation
server_tool_use -
Recherche et récupération web DeepSeek : documentation autonome Search / Fetch
- Lien :
api-docs.deepseek.com/zh-cn/guides/search -
Description : définition d’une requête réussie, limites QPS, gestion des codes d’erreur
-
Analyse de documents / OCR / ASR / TTS DeepSeek : documentation technique de chaque outil
- Lien :
api-docs.deepseek.com/zh-cn/guides/document_parsing -
Description : les limites et unités de facturation d’ocr, asr et tts sont disponibles dans le même répertoire
-
Annonce sur l’API des applications de la suite complète DeepSeek : publiée le 13 novembre 2026
- Lien :
api-docs.deepseek.com/zh-cn/news/news261113 - Description : liste des capacités ouvertes cette fois-ci et périmètre de prise en charge des modèles
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI. Les paramètres d’interface et les tarifs les plus récents de DeepSeek Search / Fetch sont disponibles dans le centre de documentation APIYI