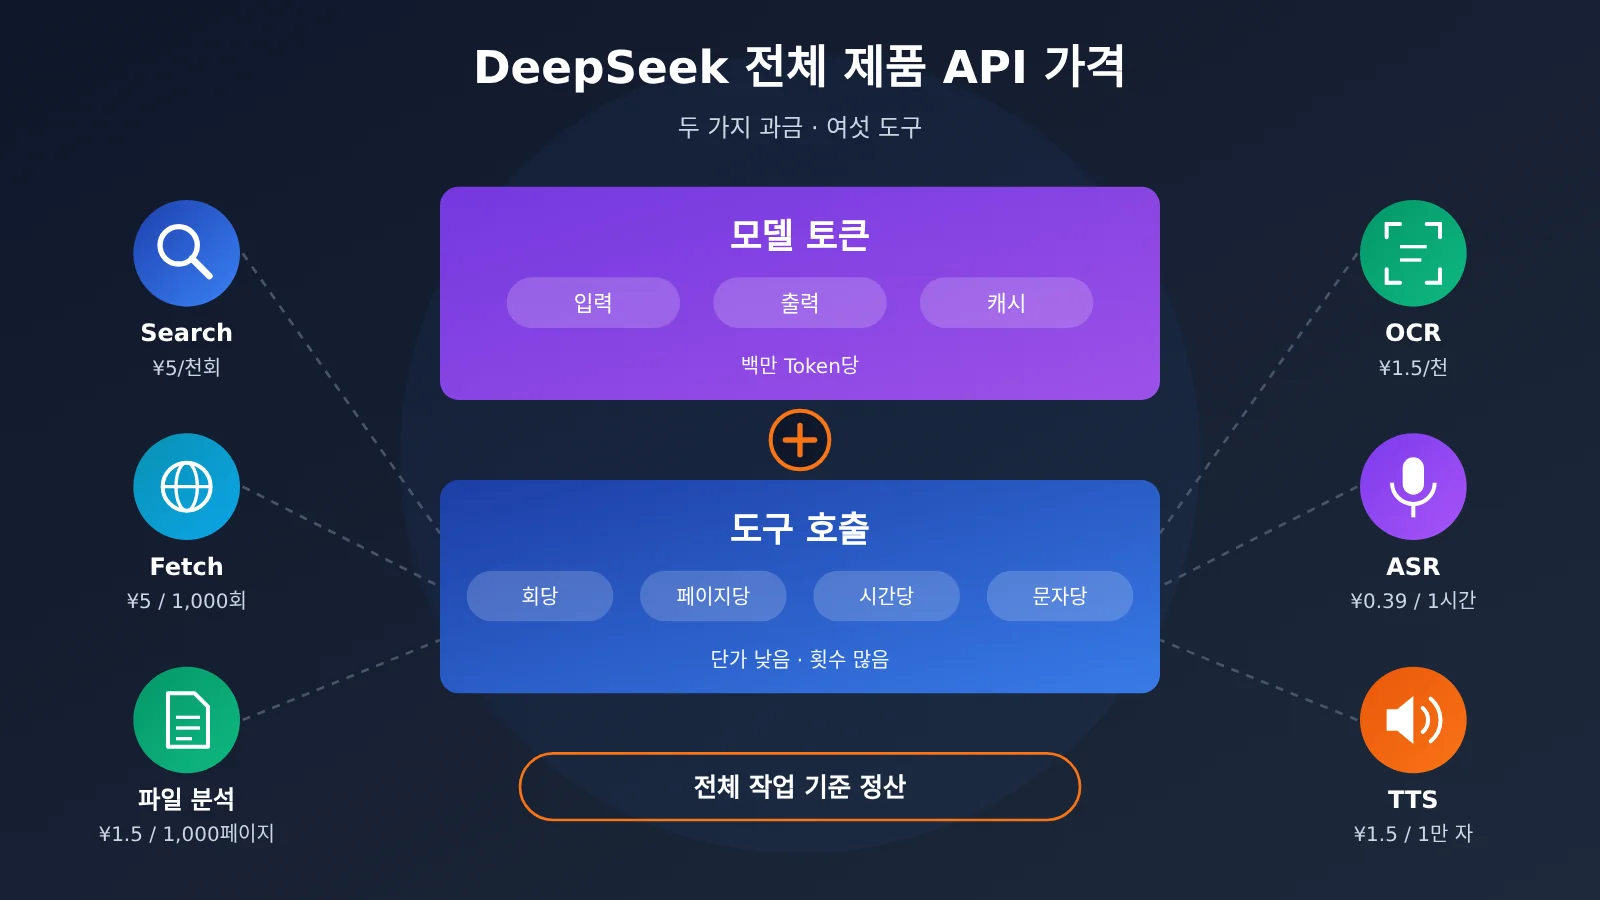
요약: DeepSeek 풀 패키지 API는 모델 Token과 도구 호출을 따로 과금해요. 전체 비용은 검색 횟수, 파일 페이지 수, 음성 처리량, 캐시 적중률을 항목별로 계산해야 해요.
결론부터 말하면: 2026년 11월 15일 기준 DeepSeek 공식 중국어 가격 문서에 따르면, Search와 Fetch는 모두 1000회 성공 요청당 ¥5, 파일 파싱과 OCR은 모두 1000페이지당 ¥1.5, ASR 기간 한정 가격은 시간당 ¥0.39, TTS 기간 한정 가격은 10000 과금 문자당 ¥1.5예요. 도구 단가는 매우 낮지만, 인터넷 연결 Agent 작업의 청구서는 보통 모델 Token이 주도를 해요. “검색 2회, 크롤링 3회, 입력 Token 2만 개, 출력 Token 3000개”인 리서치 작업으로 계산해 보면, 1000회 작업은 한가한 시간대에 약 ¥57, 피크 시간대에 약 ¥89이고, 입력 캐시 적중률이 80%일 때는 한가한 시간대에 약 ¥41.32까지 내려가요. 그래서 예산을 잡을 때는 “완전한 작업”을 단위로 계산해야 하고, 단일 API 요청의 가격은 그중 하나의 항목일 뿐이에요.
아래에서는 먼저 모델 비용과 도구 비용의 과금 구조를 나눠서 살펴보고, 이어서 Search, Fetch, 파일 파싱, OCR, ASR, TTS의 단가와 과금 단위를 항목별로 정리할게요. 그다음 4가지 고정 가정 시나리오로 전체 계산법을 시연하면서 딥 서치, 긴 컨텍스트, 속도 제한이 청구서에 어떻게 영향을 주는지 설명해요. 마지막으로 바로 재사용할 수 있는 비용 로그 코드를 드리고, 모델 내장 검색과 독립 Search / Fetch 인터페이스 중에서 어떻게 선택할지 비교해요.
알아두기: DeepSeek 풀 패키지 API 과금 용어
| 용어 | 설명 |
|---|---|
| Token | 모델이 텍스트를 처리할 때 쓰는 계량 단위로, 모델 비용은 100만 Token 기준으로 매겨져요 |
| 입력 Token | 모델 컨텍스트에 들어가 추론에 참여하는 모든 내용으로, 프롬프트, 파일 내용, 검색 결과가 포함돼요 |
| 출력 Token | 모델이 생성한 내용으로, 사고 모드의 추론 과정도 출력으로 계산돼요 |
| Context Cache | 이전에 처리했던 컨텍스트를 재사용해 중복 입력 비용을 줄이는 기능이에요 |
| Cache Hit | 입력 내용이 캐시를 성공적으로 재사용해 더 낮은 ‘캐시 히트’ 단가로 과금되는 경우예요 |
| 피크 / 한가한 시간대 | DeepSeek가 베이징 시간 기준으로 나눈 두 단계 가격으로, 한가한 시간대 가격은 피크 가격의 절반이에요 |
| Search API | 키워드로 웹페이지를 조회하고 구조화된 검색 결과를 반환해요 |
| Fetch API | 지정한 웹페이지를 가져와 본문 내용을 반환해요 |
| 모델 내장 검색 | 대화 요청에서 검색 도구를 선언하면 모델이 스스로 검색 여부를 결정하고 서버가 대신 실행해요 |
| QPS | 초당 허용되는 요청 수예요 |
| OCR | 이미지나 문서에서 텍스트를 인식해요 |
| ASR | 음성을 텍스트로 인식해요 |
| TTS | 텍스트를 음성으로 합성해요 |
| 과금 문자 | TTS의 계량 단위로, 중국어 한자는 2개의 과금 문자로 계산해요 |
| Tool Usage | 모델이나 프로그램이 실제로 외부 도구를 호출하면서 발생한 과금 사용량이에요 |
1 DeepSeek 풀 패키지 API는 도대체 어떻게 과금될까
1.1 DeepSeek 풀 패키지 API의 두 가지 청구서: 모델 비용과 도구 비용
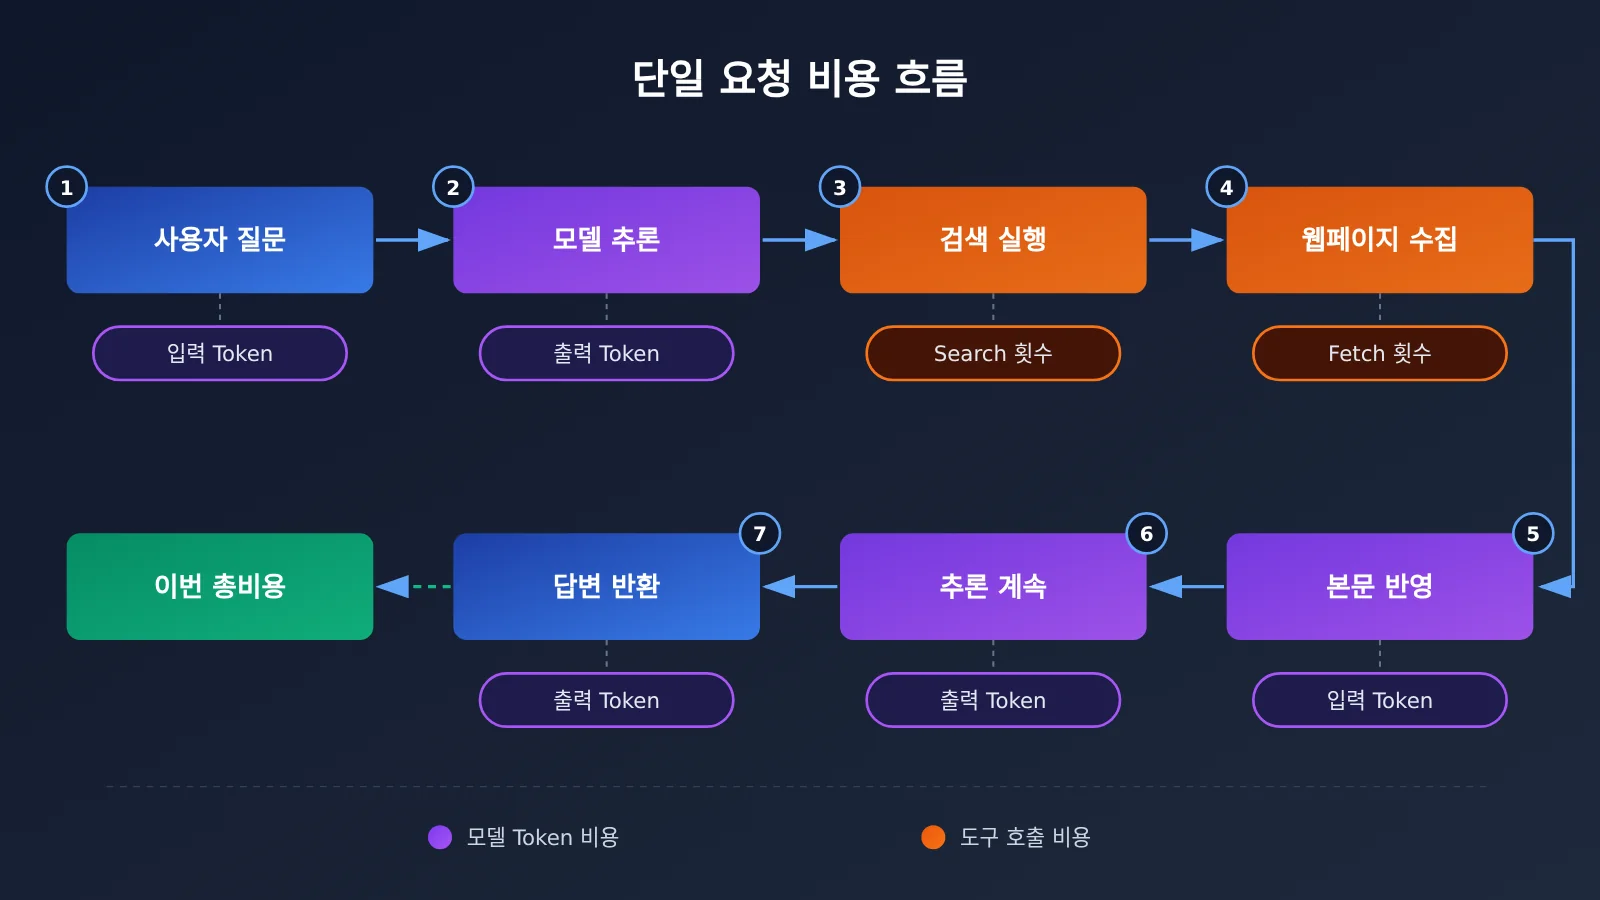
2026년 11월 13일, DeepSeek는 App 내부에서 동작하던 연동 검색, 심층 사고 검색, 링크 읽기, 파일 입력, OCR, ASR, TTS, 보안 검증 등의 기능을 API로 개방했어요. 과금에서는 이런 기능과 모델 추론을 각각 따로 계산해요. 하나의 공식으로 요약할 수 있어요:
총비용 = 모델 입력 비용 (캐시 적중 + 캐시 미적중)
       + 모델 출력 비용 (사고 토큰 포함)
       + 도구 호출 비용 (Search / Fetch / 이미지 검색)
       + 파일 및 음성 처리 비용 (파싱 페이지 수 / OCR 페이지 수 / 오디오 길이 / TTS 문자 수)
같은 한 번의 질의응답에서 위 항목들이 동시에 발생할 수 있어요. 예를 들어 대화 중에 심층 사고 검색을 켜면, 모델이 검색어를 여러 번 생성하고 여러 웹페이지를 연 뒤, 웹페이지 내용을 컨텍스트에 합쳐 계속 추론해요. 이 한 번의 요청은 검색과 크롤링 비용을 발생시키고, 웹페이지 본문이 컨텍스트에 들어가면서 대량의 입력 토큰도 발생하며, 사고 과정 역시 출력 토큰으로 계산돼요.
1.2 DeepSeek Flash와 Pro의 모델 가격
아래는 DeepSeek 공식 가격 문서가 2026년 11월 15일에 공개한 가격이며, 화폐 단위는 위안(CNY), 기준은 100만 토큰당이에요.
| 모델 | 캐시 적중 (유휴 / 피크) | 캐시 미적중 (유휴 / 피크) | 출력 (유휴 / 피크) | 동시 처리 제한 |
|---|---|---|---|---|
| DeepSeek-V4.1-Flash | ¥0.02 / ¥0.04 | ¥1 / ¥2 | ¥4 / ¥8 | 2500 |
| DeepSeek-V4-Pro | ¥0.15 / ¥0.30 | ¥4.5 / ¥9 | ¥13.5 / ¥27 | 500 |
피크 시간대는 베이징 시간 기준 월요일부터 금요일까지의 09:00—12:00과 14:00—18:00이며, 중국 법정 공휴일은 제외돼요. 그 외 시간(주말과 법정 공휴일 전일 포함)은 모두 유휴 시간대예요. 두 모델의 컨텍스트 길이는 모두 1M, 최대 출력 길이는 모두 384K예요. Flash는 이미지 이해를 지원하지만 Pro는 지원하지 않아요.
모델 선택은 도구 사용 가능 여부에도 영향을 줘요. 이번 공지에서 대화 수준의 완전한 도구 통합(연동 검색, 심층 사고 검색, 링크 읽기, 파일 파싱, 이미지 이해, 보안 검증)은 deepseek-flash(DeepSeek-V4.1-Flash)가 담당해요. 내장 도구가 필요한 애플리케이션을 기획할 때는 Flash를 기준으로 비용 모델을 구축해야 해요.
2 DeepSeek 풀 패키지 API에서 Search, Fetch, OCR, ASR, TTS는 각각 얼마일까
아래 표는 DeepSeek 공식 도구 가격이에요(2026년 11월 15일 기준, 위안화). ‘정가(刊例价)’와 ‘기간 한정 할인’을 따로 적었는데, 할인 기간이 끝나면 정가 기준으로 예산을 다시 잡아야 해요.
| 기능 | 과금 단위 | 정가 | 기간 한정 할인 | 1회 / 1단위 환산 |
|---|---|---|---|---|
| Search 검색 | 성공 요청 1000회 | ¥5 | ¥5 | ¥0.005 / 회 |
| Fetch 웹 페이지 크롤링 | 성공 요청 1000회 | ¥5 | ¥5 | ¥0.005 / 회 |
| 파일 파싱 | 1000페이지 | ¥1.5 | ¥1.5 | ¥0.0015 / 페이지 |
| OCR | 1000페이지 | ¥1.5 | ¥1.5 | ¥0.0015 / 페이지 |
| ASR | 오디오 1시간 | ¥0.78 | ¥0.39 | 1초 미만은 1초로 계산 |
| TTS | 과금 문자 10,000자 | ¥3 | ¥1.5 | 한자는 2자로 계산 |
2.1 DeepSeek Search와 Fetch의 과금 방식
독립형 Search는 성공한 요청을 기준으로 과금해요. HTTP 200이면서 results 배열이 비어 있지 않아야 성공으로 인정돼요. 요청 한 번에 결과를 1—50개까지 돌려받을 수 있고(count 기본값 10), 1개를 받든 50개를 받든 가격은 같아요. 그래서 여러 번 조금씩 요청하는 것보다 한 번에 많이 받아오는 편이 더 저렴해요. 독립형 Fetch는 HTTP 200과 함께 웹 페이지 본문이 정상 반환되어야 하고, 실패하거나 타임아웃이 나거나 결과가 없으면 과금하지 않아요.
모델 내장 검색은 집계 기준이 달라요. 내장 텍스트 검색은 실제로 실행된 쿼리 키워드 수로 과금해서, 도구 호출 한 번에 쿼리 키워드가 3개 들어가면 3회로 계산돼요. 내장 이미지 검색은 반환된 이미지 수와 선택 영역 수로, 내장 웹 크롤링은 성공적으로 가져온 웹 페이지 수로 과금해요. 그래서 대화에서 검색을 켜 두면 질문 한 번에 검색 비용이 여러 번 발생하는 건 정상이에요.
2.2 DeepSeek 파일 파싱과 OCR의 페이지별 과금
파일 파싱은 Files API로 진행해요. 파일을 업로드하면 서버가 파싱하고 file_id를 반환하며, 대화에서 file_id를 참조하면 돼요. 파싱은 성공적으로 파싱된 페이지 수를 기준으로 과금되며, 1000페이지당 ¥1.5예요. 이후 대화에서 같은 파싱 완료 파일을 다시 참조해도 파싱 비용은 더 받지 않지만, 파일 내용이 컨텍스트에 들어갈 때마다 입력 Token으로 과금돼요.
파싱 모드도 Token 사용량에 영향을 줘요. text_recognition은 모델에 순수 텍스트만 제공하고, rich_layout_recognition은 차트와 표를 이미지로 잘라 텍스트와 함께 모델에 넘겨요. 재무 보고서나 PPT에 적합하지만 이미지 Token이 늘어나요. XLSX, CSV, TXT, MD, JSON, EPUB 등의 파일은 user_data로 업로드해 Markdown으로 변환할 수 있으며, 이런 업로드에는 파싱 비용이 없어요.
OCR은 별도 인터페이스(/v1/tools/ocr)이며, 마찬가지로 1000페이지당 ¥1.5이고 성공적으로 인식된 페이지 수로 과금하며, 실패와 타임아웃은 과금하지 않아요. 둘은 역할이 달라요. OCR은 텍스트와 위치 정보 추출만 담당하고, 파일 파싱은 결과를 모델 컨텍스트에 바로 넣어 모델이 이해하게 해요.
2.3 DeepSeek ASR과 TTS의 음성 과금
ASR(/v1/tools/asr)의 정가는 오디오 1시간당 ¥0.78이고, 현재 한시 50% 할인가로 ¥0.39이며, 1초 미만은 1초로 과금해요. 전체 파일 업로드 방식의 비스트리밍 인식을 사용하며, 단일 오디오는 최대 120초, 최대 8 MiB이고, 16-bit PCM WAV와 Ogg Opus를 지원하며, 계정당 동시 50개까지 처리할 수 있어요. 긴 녹음은 먼저 잘라야 하는데, 각 구간 끝의 1초 미만은 각각 올림 처리되므로, 조각이 잘게 나뉠수록 올림이 더 많이 누적돼요.
TTS(/v1/tools/tts, WebSocket 스트리밍 합성도 지원)의 정가는 과금 문자 10000자당 ¥3이고, 한시 가격은 ¥1.5예요. 중국어 한자는 2개의 과금 문자로, 영어 알파벳·숫자·공백은 1개로 계산하며, 1회 최대 10000 과금 문자까지 입력할 수 있어요. 환산하면 10만 과금 문자는 약 5만 개의 한자에 해당하므로, 중국어 콘텐츠 예산은 먼저 2배로 잡아야 해요.
3 DeepSeek 풀 패키지 API 네 가지 시나리오 비용 추정
아래 4개 사례는 모두 공개 단가와 고정 가정을 바탕으로 계산했어요. 호출 횟수와 토큰 사용량은 가정값이라 상황별 추정치에 해당하며, 계산 방법을 보여주는 예시예요. 실제 청구 금액은 서버가 반환하는 과금 필드를 기준으로 해요.
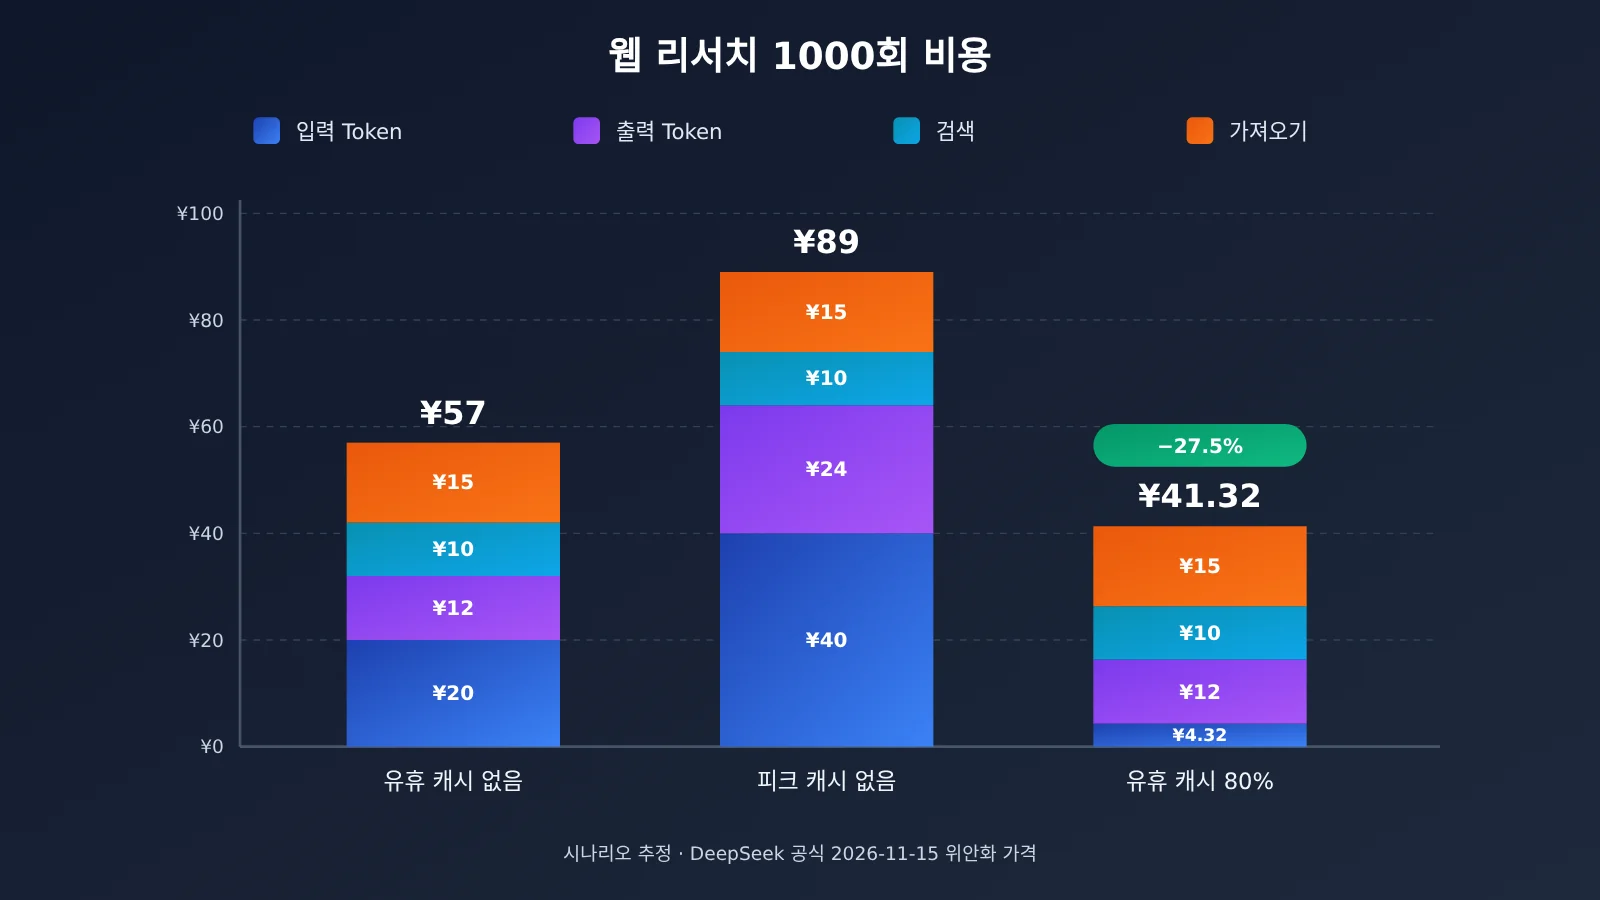
3.1 시나리오 1: 1000회 인터넷 연동 연구 작업 (한산한 시간대 ¥57 / 피크 시간대 ¥89)
가정: DeepSeek-V4.1-Flash 사용, 작업당 성공한 검색 쿼리 2개, 성공적으로 가져온 웹페이지 3개, 캐시 미스 입력 토큰 20000개, 출력 토큰 3000개.
| 항목 | 계산식 | 한산한 시간대(¥/회) | 피크 시간대(¥/회) |
|---|---|---|---|
| 입력 토큰 | 20000 ÷ 1000000 × 단가 | 0.020 | 0.040 |
| 출력 토큰 | 3000 ÷ 1000000 × 단가 | 0.012 | 0.024 |
| Search | 2 × ¥0.005 | 0.010 | 0.010 |
| Fetch | 3 × ¥0.005 | 0.015 | 0.015 |
| 회당 합계 | — | 0.057 | 0.089 |
| 1000회 합계 | 회당 × 1000 | ¥57 | ¥89 |
피크 시간대에는 모델 토큰 비용이 두 배가 되지만 Search와 Fetch 가격은 그대로라서, 총 청구 금액은 ¥57에서 ¥89로 약 56% 올라가요. 이 작업에서는 모델 비용이 한산한 시간대 청구 금액의 약 56%(¥32 / ¥57)를 차지해요. 즉, 인터넷 연동 에이전트에서도 비용의 큰 부분은 여전히 토큰이에요. 나중에 실행해도 되는 배치 작업을 한산한 시간대로 옮기는 것이 가장 직접적인 비용 절감 방법이에요.
3.2 시나리오 2: 입력 캐시 적중률 80%면 얼마나 절약될까
가정: 조건은 시나리오 1과 같아요(한가한 시간대). 다만 입력 Token 20,000개 중 16,000개는 캐시에 적중하고 4,000개는 적중하지 않아요.
- 캐시 적중 입력: 16000 ÷ 1000000 × ¥0.02 = ¥0.00032
- 캐시 미적중 입력: 4000 ÷ 1000000 × ¥1 = ¥0.004
- 출력: 3000 ÷ 1000000 × ¥4 = ¥0.012
- 검색 + 수집: ¥0.010 + ¥0.015 = ¥0.025
- 1회 합계 ¥0.04132, 1000회 합계 ¥41.32
시나리오 1의 ¥57와 비교하면 ¥15.68, 약 27.5% 절약돼요. 캐시는 입력 비용에만 적용돼요. 입력은 ¥0.020에서 약 ¥0.0043으로 줄지만 출력과 도구 비용은 전혀 변하지 않아요. 캐시 적중률이 높을수록 청구 금액은 “출력 + 도구”의 하한에 가까워져요. 이 지점에서 더 비용을 낮추려면 검색 횟수를 줄이고 출력 길이를 제어해야 해요.
3.3 시나리오 3: 기업 문서 5000페이지 배치 처리
가정: Flash 유휴 시간대이고, 5000페이지 문서는 한 번만 파싱하며, 이후 분석에서 누적 1000만 개의 캐�시 미스 입력 토큰과 100만 개의 출력 토큰이 발생해요.
- 파일 파싱: 5000 ÷ 1000 × ¥1.5 = ¥7.50
- 모델 입력: 10000000 ÷ 1000000 × ¥1 = ¥10.00
- 모델 출력: 1000000 ÷ 1000000 × ¥4 = ¥4.00
- 합계 ¥21.50
파싱 비용은 전체의 약 35%에 불과해요. 같은 파일 묶음을 여러 차례의 멀티턴 대화에서 매번 컨텍스트에 통째로 밀어 넣으면 입력 토큰은 몇 배로 늘어나지만 파싱 비용은 더 이상 증가하지 않아요. 대용량 문서 시나리오의 핵심은 “파일 내용이 컨텍스트에 들어가는 횟수”를 제어하는 거예요.
3.4 시나리오 4: 10시간 음성 인식 + 10만 과금 문자 TTS
가정: 현재의 한시적 50% 할인 가격을 사용하며, ASR은 10시간 오디오, TTS는 100000 과금 문자예요.
- ASR: 10 × ¥0.39 = ¥3.90
- TTS: 100000 ÷ 10000 × ¥1.5 = ¥15.00
- 합계 ¥18.90
이 비용에는 음성 서비스만 포함돼요. 전사 텍스트를 대화 모델에 넘겨 요약이나 질의응답을 할 때는 모델 토큰이 별도로 과금돼요. 정가로 계산하면 같은 사용량은 10 × ¥0.78 + 10 × ¥3 = ¥37.80이 되고, 할인이 끝나면 음성 예산은 두 배가 돼요. 또한 10시간 오디오는 120초 상한 기준으로 최소 300개 구간으로 잘라야 하므로, 50 동시성에 맞춰 스케줄링해야 해요.
4 DeepSeek 전체 제품군 API 청구서가 오르는 요인
4.1 딥씽킹 검색은 한 번에 여러 검색어를 실행해요
DeepSeek의 딥씽킹 검색은 최대 약 20회 도구를 호출한 뒤 답변하고, 과금은 실제 동작을 기준으로 누적돼요. 공식 과금 세부 규칙에서 중요한 몇 가지는 다음과 같아요.
- 한 번의 Search에 검색어 3개가 포함되고 모두 결과가 나오면 검색 3회로 계산해요.
- 이미지 검색이 이미지 3장을 반환하면 3회로 계산하고, 모델이 그중 2개 영역을 선택하면 추가로 2회 계산해요.
- 인터넷에서 가져와야 하는 웹페이지를 1개 성공적으로 열면 Fetch 1회로 계산하고, 같은 웹페이지를 다시 열어도 중복 과금하지 않아요.
- 이미 연 웹페이지에서
find_in_page를 실행해도 별도 과금은 없고, Search 결과가 없으면 과금하지 않아요. - 모델 콘텐츠 안전 기능을 켜면 일부 웹페이지가
url_not_allowed또는unavailable로 표시되더라도, 백엔드에서 이미 성공적으로 가져온 경우에는 과금될 수 있어요.
집계할 때는 과금 필드인 server_tool_use.tool_search, tool_fetch, tool_image_search를 사용해야 해요. web_search_requests와 web_fetch_requests는 반환된 블록 수만 보여 줄 뿐이고 실패한 요청이 포함될 수 있어서, 이 값을 기준으로 계산하면 비용을 과대 추정하게 돼요.
4.2 긴 컨텍스트와 반복되는 파일 입력
검색 결과, 웹페이지 본문, 파싱된 파일은 모두 컨텍스트에 들어가요. 링크 읽기 도구는 마지막 사용자 메시지에 있는 서로 다른 URL을 최대 10개까지 고려하며, 여러 웹페이지를 동시에 읽으면 페이지마다 사용할 수 있는 컨텍스트는 줄어들지만 총 입력량은 여전히 상당해요. 긴 세션은 매 턴마다 이전 내용을 함께 들고 가기 때문에 입력 토큰이 턴이 늘어날수록 누적돼요.
비용을 줄이는 방법은 세 가지예요. 애플리케이션 계층에서 요약과 핵심 사실을 저장하고 이후 턴에서 요약을 참조하세요. 시스템 프롬프트, 공용 자료, 워크플로 규칙을 컨텍스트 앞부분에 두고 안정적으로 유지해 캐시 적중 기회를 높이세요. 차트를 봐야 할 때만 rich_layout_recognition을 사용하세요.
4.3 배치 작업의 요청 속도 제한
독립 Search의 계정 수준 제한은 100 QPS, Fetch는 25 QPS이며, 이는 전체 계정에 적용되는 할당량으로 여러 API 키가 공유해요. Fetch는 대상 도메인 단위의 QPS 제한도 받기 때문에 같은 사이트를 집중적으로 크롤링하면 429가 발생하기 쉬워요. 오류 처리 권장 사항은 다음과 같아요.
- 408, 429, 5xx: 지수 백오프 후 재시도하고, 같은 도메인으로 가는 요청은 분산하세요.
- 402: 잔액 부족이므로 계정 잔액을 먼저 처리하세요.
- 기타 4xx(예: 파라미터 오류): 요청을 수정한 뒤 다시 보내세요. 재시도는 효과가 없어요.
실패한 요청은 과금되지 않으므로 재시도 자체는 도구 비용을 늘리지 않지만, 작업 시간을 길게 만들어요. 대량 배치 작업은 Fetch 상한인 25 QPS를 기준으로 완료 시간을 역산해야 해요.
5 DeepSeek Agent에 적합한 비용 예산을 설계하는 방법
5.1 DeepSeek 전체 제품군 API 비용 로그: 빠르게 시작하기
프로덕션 환경에서는 최소한 캐시 적중 입력, 캐시 미적중 입력, 출력 토큰, Search 횟수, Fetch 횟수, 이미지 검색 횟수, 문서 파싱 페이지 수, 오디오 길이, TTS 과금 문자 수를 각각 기록해야 해요. 아래 함수는 usage 필드를 직접 읽어 요청 한 건의 비용을 계산하므로, 각 요청이 끝난 직후에 연결해 로그를 남길 수 있어요.
# DeepSeek 전체 제품군 비용 추정(위안화, 2026-11-15 공식 가격)
FLASH = {"cache_hit": 0.02, "cache_miss": 1.0, "output": 4.0}  # 비수기 시간대 ¥/백만 토큰
TOOL = {"search": 0.005, "fetch": 0.005, "image_search": 0.005}  # ¥/회

def estimate_cost(usage: dict, peak: bool = False) -> dict:
    k = 2 if peak else 1  # 피크 가격은 비수기 가격의 두 배, 도구 가격은 동일
    stu = usage.get("server_tool_use", {})
    model = (usage.get("cache_read_input_tokens", 0) * FLASH["cache_hit"]
             + usage.get("input_tokens", 0) * FLASH["cache_miss"]
             + usage.get("output_tokens", 0) * FLASH["output"]) / 1e6 * k
    tools = (stu.get("tool_search", 0) * TOOL["search"]
             + stu.get("tool_fetch", 0) * TOOL["fetch"]
             + stu.get("tool_image_search", 0) * TOOL["image_search"])
    return {"model": round(model, 5), "tools": round(tools, 5),
            "total": round(model + tools, 5)}

# 시나리오 2 재현: 16000 적중 + 4000 미적중 + 3000 출력 + 2회 검색 + 3회 가져오기
print(estimate_cost({"cache_read_input_tokens": 16000, "input_tokens": 4000,
                     "output_tokens": 3000,
                     "server_tool_use": {"tool_search": 2, "tool_fetch": 3}}))
# {'model': 0.01632, 'tools': 0.025, 'total': 0.04132}
이미지 검색의 단가는 여기서 Search 단가로 처리했으니, 출시 전에 공식 문서를 확인해 주세요. 예산 관점에서는 질의응답 제품이 ‘사용자 요청 단위’로 비용을 기록하는 데 적합하고, 다단계 Agent, Deep Research, 배치 자동화는 ‘작업 생명주기 단위’로 기록하는 편이 더 적합해요. 한 작업 안의 모든 모델 호출과 도구 호출을 같은 task_id 아래에 집계하면 돼요.
5.2 언제 DeepSeek 내장 검색을 선택하고, 언제 독립 Search / Fetch 인터페이스를 선택할까
| 구분 | 모델 내장 검색(deepseek_web_search / read_url) | 독립 Search / Fetch API |
|---|---|---|
| 개발 복잡도 | 낮음. 검색, 크롤링, 컨텍스트 결합을 서버가 처리 | 높음. 도구 루프를 직접 구성해야 함 |
| 흐름 제어 | 모델이 검색 횟수와 읽을 페이지를 결정 | 개발자가 매 호출을 정밀하게 제어 |
| 과금 기준 | 질의어 개수, 이미지 개수, 성공적으로 크롤링한 페이지 수 기준 | 성공한 HTTP 요청 횟수 기준 |
| 비용 예측 가능성 | 변동 폭이 큼. 심층 검색 시 최대 약 20회 도구 호출 | 높음. 호출 횟수를 코드가 결정 |
| 적합한 시나리오 | 대화형 어시스턴트, App 경험을 빠르게 재현 | RAG, 대량 수집, 고정 흐름의 Agent |
대화형 제품을 빠르게 출시해야 할 때는 내장 검색이 상당한 엔지니어링 작업을 덜어줘요. 반대로 단일 작업 비용을 일정 범위 안으로 묶어두거나, 먼저 선별한 뒤 크롤링해야 한다면 독립 인터페이스가 더 적합해요. 둘을 조합할 수도 있어요. 대화 메인 흐름은 내장 도구를 쓰고, 백그라운드에서 데이터를 대량 보강할 때는 독립 인터페이스를 쓰는 식이죠.
5.3 APIYI에서의 DeepSeek Search / Fetch 연동과 가격
APIYI는 2026년 10월 21일에 DeepSeek 독립 도구 인터페이스인 deepseek-search와 deepseek-fetch를 출시했고, 엔드포인트는 POST /v1/tools/search와 POST /v1/tools/fetch예요. 이 인터페이스들은 모델 토큰을 소모하지 않고 성공한 호출 횟수를 기준으로 과금되며, default와 svip 그룹에서 사용할 수 있고 ClaudeCode 그룹의 토큰으로는 직접 호출할 수 없어요. DeepSeek Harness, Claude Code 같은 클라이언트가 호출하는 모델 내장 검색의 경우 APIYI의 호환 작업은 아직 후속 계획 단계에 있고, 현재 사용할 수 있는 건 독립형 Search / Fetch예요.
아래는 APIYI 문서에 공개된 가격이며, 통화는 미국 달러예요:
| 항목 | 문서 표기 공식가 | APIYI 사이트 내 가격 | 20% 추가 증정 후 환산 | 10% 추가 증정 후 환산 |
|---|---|---|---|---|
| Search / 1000회 | $0.75 | $0.90 | $0.75 | 약 $0.82 |
| Fetch / 1000회 | $0.75 | $0.90 | $0.75 | 약 $0.82 |
시나리오 1의 도구 사용량(Search 1000회 + Fetch 3000회)으로 계산해 보면, 사이트 내 과금은 (1000 + 3000) ÷ 1000 × $0.90 = $3.60이고, 20% 추가 증정이 전체 소비에 적용될 때 환산하면 $3.60 ÷ 1.20 = $3.00, 10% 증정일 때는 약 $3.27이에요. DeepSeek 공식은 위안화로 가격을 책정하기 때문에 실제 비용을 비교할 때는 통화와 환율, 충전 혜택 조건을 통일해야 하고, 최종적으로는 계정 콘솔에 표시되는 가격이 기준이에요.
아주 간단한 호출 예시예요(요청 필드는 APIYI 문서를 기준으로 해요):
import requests

BASE_URL = "https://api.apiyi.com/v1"  # APIYI 통합 인터페이스
headers = {"Authorization": "Bearer YOUR_API_KEY"}

resp = requests.post(f"{BASE_URL}/tools/search", headers=headers,
                     json={"model": "deepseek-search",
                           "query": "DeepSeek API 价格", "count": 10})
print(resp.json())
전체 구현 보기: 검색 후 크롤링, 429 백오프 재시도와 카운트 포함
import time
import requests

BASE_URL = "https://api.apiyi.com/v1"  # APIYI OpenAI 호환 엔드포인트
HEADERS = {"Authorization": "Bearer YOUR_API_KEY"}
RETRY_CODES = {408, 429, 500, 502, 503, 504}

def call_tool(path: str, payload: dict, max_retry: int = 4) -> dict | None:
    """도구 인터페이스를 호출해요. 재시도 가능한 오류는 지수 백오프로 다시 시도하고, 실패한 요청은 과금되지 않아요"""
    for i in range(max_retry):
        r = requests.post(f"{BASE_URL}{path}", headers=HEADERS,
                          json=payload, timeout=60)
        if r.status_code == 200:
            return r.json()
        if r.status_code == 402:
            raise RuntimeError("余额不足,请先充值")
        if r.status_code in RETRY_CODES:
            time.sleep(2 ** i)  # 1s, 2s, 4s, 8s
            continue
        raise ValueError(f"请求参数错误: {r.status_code} {r.text}")
    return None

def research(query: str, fetch_top: int = 3) -> dict:
    stats = {"search": 0, "fetch": 0}
    result = call_tool("/tools/search",
                       {"model": "deepseek-search", "query": query, "count": 10})
    items = (result or {}).get("results", [])
    if items:
        stats["search"] += 1  # 결과가 비어 있지 않을 때만 과금
    pages = []
    for item in items[:fetch_top]:  # 원문을 실제로 읽어야 하는 페이지만 크롤링
        page = call_tool("/tools/fetch",
                         {"model": "deepseek-fetch", "url": item.get("url")})
        if page:
            stats["fetch"] += 1
            pages.append(page)
        time.sleep(0.05)  # 속도 조절: Fetch의 25 QPS와 도메인 단위 레이트 리밋 회피
    return {"pages": pages, "billing": stats}

if __name__ == "__main__":
    out = research("DeepSeek 全家桶 API 计费规则")
    print(out["billing"])  # 예: {'search': 1, 'fetch': 3}
🚀 빠른 시작: APIYI apiyi.com에서 등록하면 테스트 크레딧을 받을 수 있어요. 먼저 소량 요청으로 Search / Fetch를 정상 동작시킨 뒤, 로그에 찍힌 실제 호출 횟수를 기준으로 정식 예산을 산정하세요.
자주 묻는 질문 FAQ
Q1: DeepSeek 풀 패키지 API에는 어떤 과금 항목이 포함되나요?
모델 Token(캐시 적중 입력, 캐시 미적중 입력, 출력)과 도구 비용(Search, Fetch, 이미지 검색, 파일 파싱, OCR, ASR, TTS)이 포함돼요. 안전 검증과 페이지 내 검색 `find_in_page`는 공개 가격표에 별도 가격으로 기재되어 있지 않아요.
Q2: 독립 Search API와 모델 내장 검색의 과금은 어떻게 다른가요?
독립 Search는 성공한 HTTP 요청 1건당 1회로 계산해서, 50건을 반환해도 1회로만 쳐요. 모델 내장 검색은 실제 조회어 개수로 과금되어서, 한 번 호출에 조회어 3개를 붙이면 3회로 계산돼요. 내장 방식은 개발이 더 간편하고, 독립 방식은 비용이 더 통제 가능해요.
Q3: 이 가격은 언제 기준이고, 한정 할인은 바뀔 수 있나요?
이 글의 가격은 DeepSeek 공식 중국어 가격 문서에서 가져왔고, 기준 시점은 2026년 11월 15일이에요. ASR과 TTS는 현재 한정 50% 할인 중이며, 종료되면 각각 시간당 ¥0.78, 과금 문자 10000자당 ¥3으로 돌아가요. 장기 예산은 정가 기준으로 여유를 두는 걸 권장해요.
Q4: 피크 시간대에는 청구서가 바로 두 배가 되나요?
모델 Token 부분만 두 배가 되고, 도구 가격은 시간대와 무관해요. 시나리오 1의 총 청구서는 ¥57에서 ¥89로 올라가며, 상승 폭은 약 56%예요. 도구 비용 비중이 높은 작업일수록 피크 시간대 상승 폭이 작아요.
Q5: API로 DeepSeek Search와 Fetch를 빠르게 호출하려면 어떻게 하나요?
1. APIYI apiyi.com에서 등록하고 default 또는 svip 그룹의 토큰을 생성하세요
2. base_url을 `https://api.apiyi.com/v1`로 설정하세요
3. 이 글의 코드로 `/tools/search`와 `/tools/fetch`를 요청하세요. 모델명은 각각 `deepseek-search`, `deepseek-fetch`예요
같은 API Key로 플랫폼의 다른 주요 모델도 호출할 수 있어서, 검색 결과를 여러 모델에 넘겨 효과를 비교하기 편해요.
Q6: 파일을 파싱한 뒤 반복 질문하면 요금이 중복 부과되나요?
파싱 비용은 한 번만 부과되고, 같은 `file_id`를 다시 참조해도 파싱 비용은 더 받지 않아요. 다만 파일 내용이 컨텍스트에 들어갈 때마다 입력 Token으로 과금되므로, 큰 파일을 여러 턴 질문할 때 주요 비용은 입력 Token에서 나와요.
Q7: DeepSeek 풀 패키지 API에는 어떤 알려진 제한이 있나요?
– 완전한 대화 단위 도구 통합은 현재 `deepseek-flash`를 대상으로 해요
– 독립 Search는 계정 단위 100 QPS, Fetch는 25 QPS이며, 대상 도메인 제한도 받아요
– ASR은 단일 구간 최대 120초, 비스트리밍 방식이에요. TTS는 1회 최대 과금 문자 10000자이며, 현재 속도 조절은 지원하지 않아요
– 파일 파싱은 단일 파일 최대 100 MiB, 1000페이지이며, 단일 요청에서 최대 20개 파일을 참조할 수 있어요
Q8: APIYI로 DeepSeek가 새로 출시한 모든 내장 도구를 호출할 수 있나요?
현재 APIYI에는 독립 `deepseek-search`와 `deepseek-fetch`가 출시되어 있어서, Agent나 RAG에서 직접 오케스트레이션할 수 있어요. Harness, Claude Code 등 클라이언트에서 모델 내장 검색의 호환 작업은 아직 계획 중이며, 진행 상황은 APIYI apiyi.com의 공식 문서를 기준으로 확인하세요.
DeepSeek 풀 패키지 API 가격 핵심 요약
- 과금 구조: 모델 Token과 도구 호출은 별도로 과금되며, 하나의 작업에서 여러 비용 항목이 동시에 발생해요
- 도구 단가: Search, Fetch는 각각 ¥5 / 1000회, 파일 파싱과 OCR은 각각 ¥1.5 / 1000페이지예요
- 음성 가격: ASR은 한정 기간 ¥0.39 / 시간, TTS는 한정 기간 ¥1.5 / 1만 과금 문자이며, 한자는 2문자로 계산해요
- 청구서의 큰 비중: 웹 검색 리서치 작업에서는 모델 Token이 보통 절반 이상을 차지하며, 유휴 시간대와 캐시가 가장 효과적이에요
- 캐시 효과: 입력 적중률이 80%일 때 시나리오 1의 청구서는 ¥57에서 ¥41.32로 내려가 약 27.5%를 절감해요
- 집계 기준:
server_tool_use과금 필드로 집계하며, 표시 필드에는 실패한 요청이 포함될 수 있어요 - 시작하는 방법: 독립 Search / Fetch는 APIYI apiyi.com에서 통합 Key로 호출해 테스트할 수 있어요
정리
DeepSeek 풀 패키지 API 가격의 핵심 포인트:
- 작업 단위로 계산: 하나의 Agent 작업 비용 = 입력 + 출력 + 도구 + 파일·음성 비용이고, 단일 요청 가격은 그중 한 항목만 반영해요
- Token이 청구서를 주도: 도구 단가는 낮고, 긴 컨텍스트, 반복 파일, 추론 출력이 비용 증가의 주된 원인이에요
- 집계 기준이 통제 가능성을 결정: 내장 검색은 검색어 기준으로 과금되어 개발하기 편하고, 독립 인터페이스는 요청 기준으로 과금되어 예산이 안정적이에요
실제 적용할 때는 먼저 이 글의 비용 함수로 작은 샘플에서 실제 과금 필드를 확인한 뒤 비즈니스 볼륨을 곱해 예산을 산출하고, 한정 기간 할인 종료에 대비해 여유분을 남겨 두세요. 검색과 가져오기 흐름을 직접 오케스트레이션해야 하는 팀은 APIYI apiyi.com을 통해 독립 DeepSeek Search / Fetch 인터페이스를 호출하고, 콘솔의 실제 가격과 함께 동일 통화 기준으로 비교해 보세요.
📚 참고 자료
- DeepSeek 모델 및 가격: 공식 실시간 가격 문서
- 링크:
api-docs.deepseek.com/zh-cn/quick_start/pricing -
설명: 모델 Token 단가, 피크 및 유휴 시간대, 도구 가격
-
DeepSeek 웹 연동 도구: 내장 검색 및 읽기 링크 기술 문서
- 링크:
api-docs.deepseek.com/zh-cn/guides/web_tools -
설명: 딥 서치 과금 세부 기준,
server_tool_use과금 필드 -
DeepSeek 웹 검색 및 크롤링: 독립 Search / Fetch 문서
- 링크:
api-docs.deepseek.com/zh-cn/guides/search -
설명: 성공 요청 정의, QPS 제한, 오류 코드 처리
-
DeepSeek 파일 파싱 / OCR / ASR / TTS: 각 도구 기술 문서
- 링크:
api-docs.deepseek.com/zh-cn/guides/document_parsing -
설명: 같은 디렉터리에서 ocr, asr, tts의 제한과 과금 단위를 확인할 수 있어요
-
DeepSeek 올인원 애플리케이션 API 공지: 2026년 11월 13일 발표
- 링크:
api-docs.deepseek.com/zh-cn/news/news261113 - 설명: 이번에 공개된 기능 목록과 모델 지원 범위
작성자: APIYI 기술 팀
기술 문의: APIYI 웹사이트 첫 페이지에서 저희에게 연락해 주세요. DeepSeek Search / Fetch의 인터페이스 파라미터와 최신 가격은 APIYI 문서 센터에서 확인하실 수 있어요.