Кратко: в API всей линейки DeepSeek токены модели и вызовы инструментов тарифицируются отдельно. Полную стоимость приходится складывать по пунктам: количество поисков, число страниц в файлах, объём обработанной речи и доля попаданий в кэш.
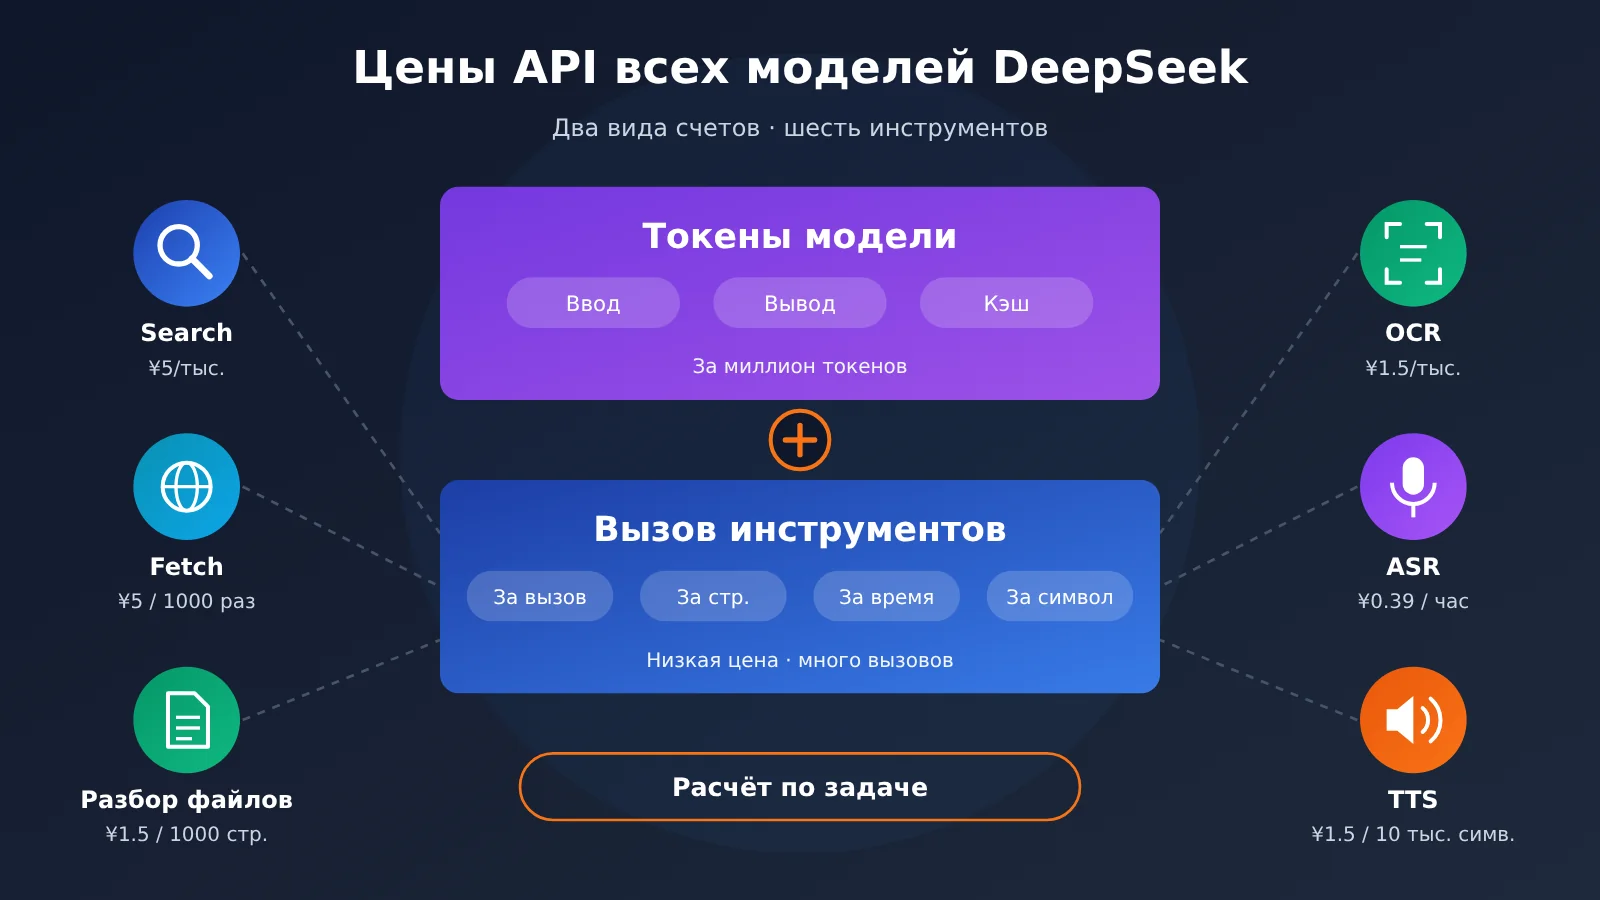
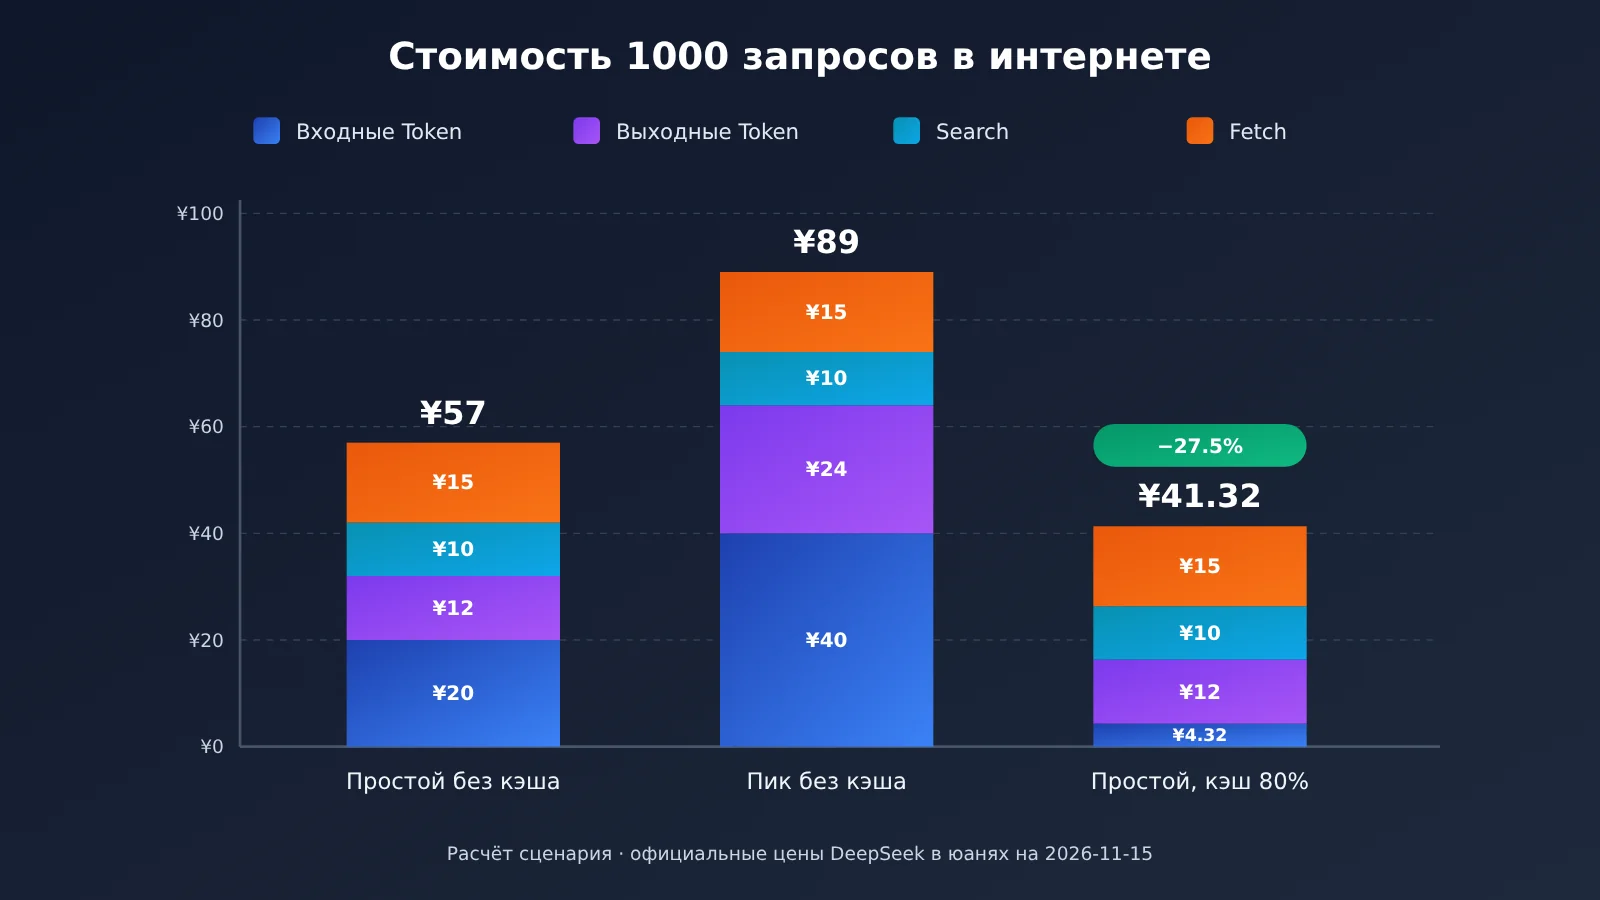
Сразу к делу: согласно официальному китайскому прайс-листу DeepSeek от 15 ноября 2026 года, Search и Fetch стоят по ¥5 за 1000 успешных запросов, разбор файлов и OCR — по ¥1.5 за 1000 страниц, ASR по акционной цене — ¥0.39 за час, TTS по акционной цене — ¥1.5 за 10 000 тарифицируемых символов. Цена за единицу вызова инструмента невелика, но счёт за задачу агента с выходом в интернет, как правило, определяют токены модели. Если взять исследовательскую задачу «2 поиска, 3 вызова Fetch, 20 000 входных токенов, 3000 выходных токенов», то 1000 таких задач в непиковые часы обойдутся примерно в ¥57, а в часы пик — около ¥89; при 80% попаданий в кэш входных данных стоимость в непиковые часы падает примерно до ¥41.32. Отсюда вывод: бюджет считают в единицах «полной задачи», а цена одного запроса к API — лишь одна из статей.
Дальше разберём структуру тарификации отдельно для модели и для инструментов, а затем по порядку перечислим единицы измерения и цены для Search, Fetch, разбора файлов, OCR, ASR и TTS. После этого на четырёх сценариях с фиксированными допущениями покажем полный расчёт и объясним, как на счёт влияют глубокий поиск, длинный контекст и ограничения скорости запросов. В конце дадим готовый код логирования затрат, который можно применять как есть, и сравним встроенный поиск модели с отдельными интерфейсами Search / Fetch — что и когда выбирать.
К сведению: термины тарификации API всей линейки DeepSeek
| Термин | Объяснение |
|---|---|
| Токен | Единица измерения, которой модель считает текст; стоимость считается за миллион токенов |
| Входные токены | Всё, что попадает в контекст модели и участвует в рассуждении: промпты, содержимое файлов, результаты поиска |
| Выходные токены | То, что генерирует модель; в режиме размышлений процесс рассуждения тоже учитывается как выход |
| Context Cache | Повторное использование уже обработанного контекста — снижает затраты на повторный ввод |
| Cache Hit | Входные данные успешно взяты из кэша и тарифицируются по более низкой цене «попадания в кэш» |
| Часы пик / непиковые часы | Два тарифа DeepSeek, различаемых по пекинскому времени; в непиковые часы цена вдвое ниже, чем в часы пик |
| Search API | Поиск по веб-страницам по ключевым словам с возвратом структурированных результатов |
| Fetch API | Загрузка указанной веб-страницы с возвратом её основного текста |
| Встроенный поиск модели | Инструмент поиска объявляется в запросе диалога; модель сама решает, когда искать, а сервер выполняет поиск за неё |
| QPS | Количество запросов, которые разрешено обрабатывать в секунду |
| OCR | Распознавание текста на изображениях или в документах |
| ASR | Преобразование речи в текст |
| TTS | Синтез речи из текста |
| Оплачиваемый символ | Единица измерения для TTS: один китайский иероглиф считается за 2 оплачиваемых символа |
| Tool Usage | Оплачиваемый объём, который возникает при фактическом вызове внешних инструментов моделью или программой |
1 Как на самом деле тарифицируется API семейства DeepSeek
1.1 Два вида счетов в API семейства DeepSeek: за модели и за инструменты
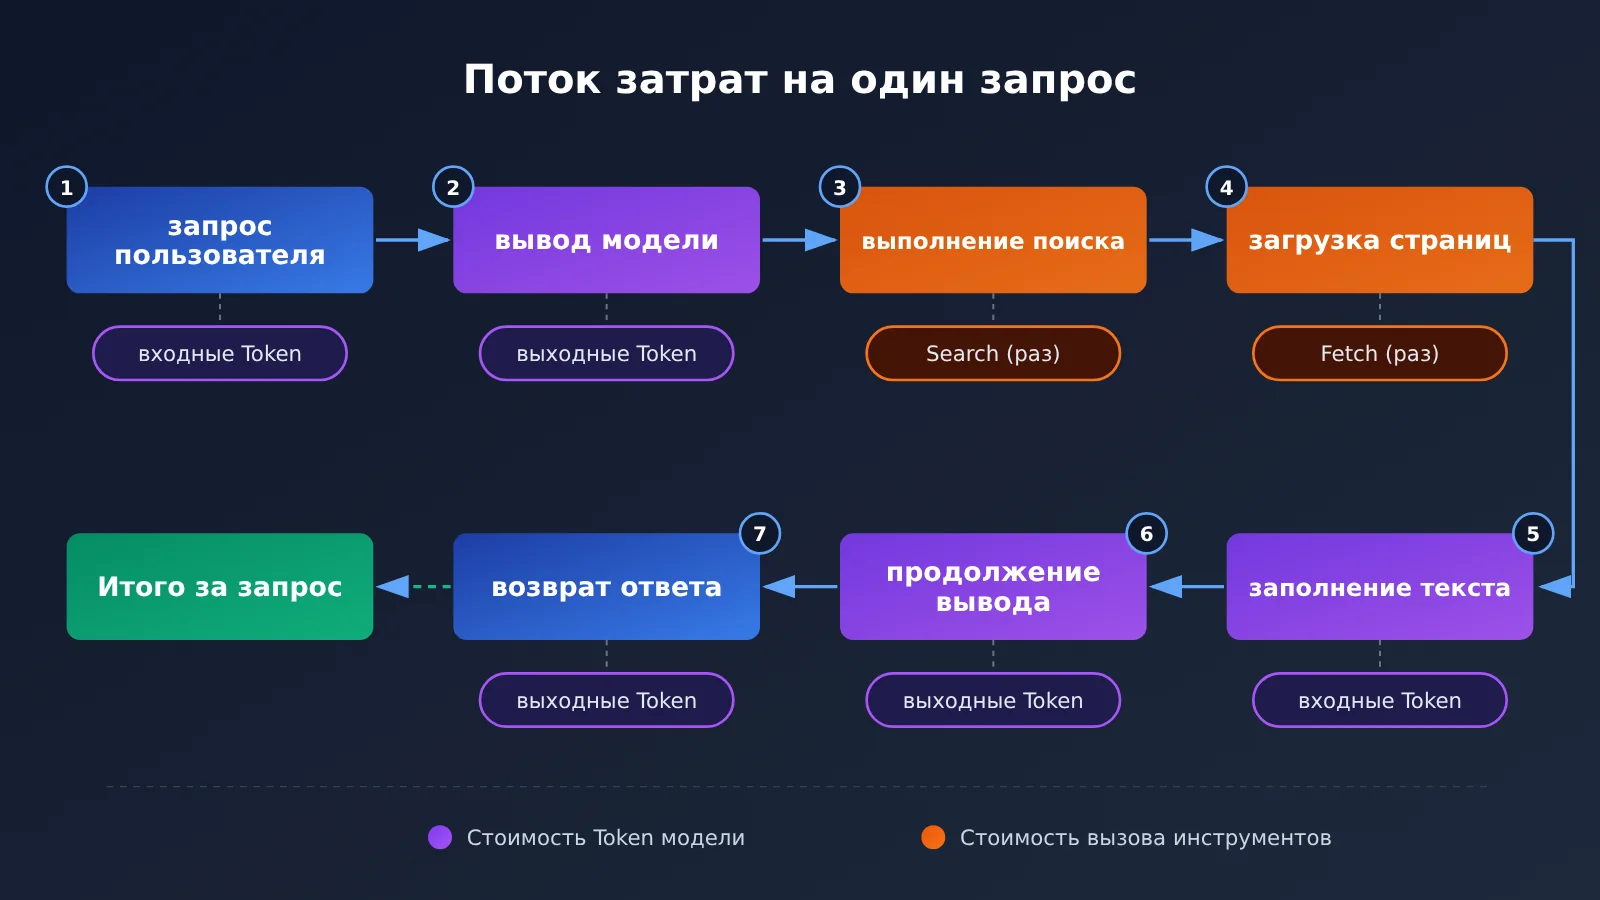
13 ноября 2026 года DeepSeek открыла через API возможности, которые стоят за приложением: поиск в интернете, поиск с глубоким размышлением, чтение ссылок, ввод файлов, OCR, ASR, TTS, проверка безопасности и прочее. В плане оплаты эти возможности и вывод модели считаются по отдельности. Всё можно описать одной формулой:
总费用 = 模型输入费用(缓存命中 + 缓存未命中)
       + 模型输出费用(含思考 Token)
       + 工具调用费用(Search / Fetch / 图片搜索)
       + 文件及语音处理费用(解析页数 / OCR 页数 / 音频时长 / TTS 字符)
В одном раунде диалога могут одновременно возникнуть все перечисленные статьи расходов. Например, если в диалоге включить поиск с глубоким размышлением, модель несколько раз генерирует поисковые запросы, открывает несколько веб-страниц, а затем подставляет их содержимое в контекст и продолжает рассуждение. Такой запрос даёт и расходы на поиск и загрузку страниц, и большое количество входных токенов, потому что текст веб-страниц попадает в контекст, а процесс размышления ещё и учитывается как выходные токены.
1.2 Цены моделей DeepSeek Flash и Pro
Ниже — цены из официальной документации DeepSeek, опубликованные 15 ноября 2026 года. Валюта — юань, единица — за миллион токенов.
| Модель | Попадание в кэш (непик / пик) | Промах кэша (непик / пик) | Вывод (непик / пик) | Ограничение параллелизма |
|---|---|---|---|---|
| DeepSeek-V4.1-Flash | ¥0.02 / ¥0.04 | ¥1 / ¥2 | ¥4 / ¥8 | 2500 |
| DeepSeek-V4-Pro | ¥0.15 / ¥0.30 | ¥4.5 / ¥9 | ¥13.5 / ¥27 | 500 |
Пиковые часы — с 09:00 до 12:00 и с 14:00 до 18:00 по пекинскому времени с понедельника по пятницу, кроме официальных праздников Китая; всё остальное время (включая выходные и праздничные дни целиком) — непиковый период. Контекстное окно у обеих моделей — 1M, максимальная длина вывода — 384K; Flash понимает изображения, Pro — нет.
Выбор модели влияет ещё и на доступность инструментов. В этом анонсе полный набор инструментов уровня диалога (поиск в интернете, поиск с глубоким размышлением, чтение ссылок, разбор файлов, понимание изображений, проверка безопасности) реализован в deepseek-flash (DeepSeek-V4.1-Flash). Планируя приложение со встроенными инструментами, модель затрат стоит строить исходя из Flash.
2. Сколько стоят Search, Fetch, OCR, ASR и TTS в полном наборе API DeepSeek
В таблице ниже — цены на официальные инструменты DeepSeek (на 15 ноября 2026 года, в юанях). «Цена по прайс-листу» и «временная скидка» указаны отдельно: после окончания акции бюджет придётся пересчитывать по цене из прайс-листа.
| Возможность | Единица тарификации | Цена по прайс-листу | Временная скидка | В пересчёте на один вызов / единицу |
|---|---|---|---|---|
| Search (поиск) | 1000 успешных запросов | ¥5 | ¥5 | ¥0.005 / вызов |
| Fetch (получение веб-страниц) | 1000 успешных запросов | ¥5 | ¥5 | ¥0.005 / вызов |
| Разбор файлов | 1000 страниц | ¥1.5 | ¥1.5 | ¥0.0015 / страница |
| OCR | 1000 страниц | ¥1.5 | ¥1.5 | ¥0.0015 / страница |
| ASR | 1 час аудио | ¥0.78 | ¥0.39 | менее 1 секунды считается как 1 секунда |
| TTS | 10000 оплачиваемых символов | ¥3 | ¥1.5 | китайский иероглиф считается за 2 символа |
2.1. Как тарифицируются DeepSeek Search и Fetch
Отдельный Search тарифицируется по успешным запросам: успехом считается только HTTP 200 при непустом массиве results. Один запрос может вернуть от 1 до 50 результатов (count по умолчанию 10); цена за 1 результат и за 50 результатов одинакова, поэтому забирать больше результатов за один запрос выгоднее, чем делать несколько запросов с небольшим количеством. Отдельный Fetch требует HTTP 200 и успешного возврата тела веб-страницы; ошибки, тайм-ауты и отсутствие результатов не оплачиваются.
У встроенного в модель поиска другая методика учёта. Встроенный текстовый поиск тарифицируется по фактическому количеству поисковых запросов: если один вызов инструмента содержит 3 поисковых запроса, это считается за 3 вызова. Встроенный поиск изображений тарифицируется по количеству возвращённых изображений и выделенных областей. Встроенное получение веб-страниц — по количеству успешно полученных страниц. Поэтому если включить поиск в диалоге, несколько списаний за поиск в рамках одного обмена вопрос-ответ — это нормально.
2.2 Постраничная оплата разбора файлов и OCR в DeepSeek
Разбор файлов выполняется через Files API: вы загружаете файл, сервер его разбирает и возвращает file_id, а в диалоге можно просто ссылаться на file_id. Плата берётся за успешно разобранные страницы — ¥1.5 за каждые 1000 страниц. Если позже в диалоге снова обратиться к тому же уже разобранному файлу, плата за разбор больше не взимается, но каждый раз, когда содержимое файла попадает в контекст, оно тарифицируется как входные токены.
Режим разбора тоже влияет на расход токенов. text_recognition передаёт модели только чистый текст, а rich_layout_recognition вырезает графики и таблицы в виде изображений и отправляет их модели вместе с текстом. Это подходит для финансовых отчётов и презентаций PowerPoint, но увеличивает количество токенов изображений. Файлы XLSX, CSV, TXT, MD, JSON, EPUB и т. п. можно загружать как user_data и преобразовывать в Markdown — за такие загрузки плата за разбор не взимается.
OCR — это отдельный интерфейс (/v1/tools/ocr). Он стоит столько же — ¥1.5 за каждые 1000 страниц — и тарифицируется по числу успешно распознанных страниц; ошибки и тайм-ауты не оплачиваются. Задачи у них разные: OCR отвечает только за извлечение текста и сведений о расположении, а разбор файлов сразу отправляет результат в контекст модели, чтобы она могла его понять.
2.3 Тарификация ASR и TTS в DeepSeek
ASR (/v1/tools/asr) по прайс-листу стоит ¥0.78 за час аудио, сейчас действует временная скидка 50%, то есть цена — ¥0.39. Неполная секунда считается за полную. Работает это так: файл загружается целиком, распознавание идёт не в потоковом режиме. Один аудиофайл — до 120 секунд и до 8 MiB, поддерживаются 16-bit PCM WAV и Ogg Opus, на один аккаунт — до 50 параллельных запросов. Длинные записи нужно сначала нарезать на фрагменты. Неполная секунда в конце каждого фрагмента округляется вверх отдельно, поэтому чем мельче нарезка, тем больше таких округлений накопится.
TTS (/v1/tools/tts, также поддерживает потоковый синтез через WebSocket) по прайс-листу стоит ¥3 за каждые 10 000 тарифицируемых символов, временная цена — ¥1.5. Китайский иероглиф считается за 2 тарифицируемых символа, а английская буква, цифра или пробел — за 1. За один запрос можно ввести не больше 10 000 тарифицируемых символов. Если пересчитать, 100 000 тарифицируемых символов — это примерно 50 000 китайских иероглифов, поэтому бюджет на китайский контент нужно сразу умножать на 2.
3 Оценка стоимости API семейства DeepSeek для четырёх сценариев
Все четыре примера ниже основаны на опубликованных ценах и фиксированных допущениях. Количество вызовов и расход токенов — это предположения; расчёты носят сценарный характер и показывают методику. Фактические счета формируются по полям тарификации, которые возвращает сервер.
3.1 Сценарий 1: 1000 исследовательских задач с доступом к интернету (¥57 в непиковое время / ¥89 в пиковое)
Допущения: используется DeepSeek-V4.1-Flash; на каждую задачу — 2 успешных поисковых запроса, 3 успешно загруженные веб-страницы, 20000 входных токенов с промахом кеша и 3000 выходных токенов.
| Пункт | Формула расчёта | Непиковое время (¥/задача) | Пиковое время (¥/задача) |
|---|---|---|---|
| Входные токены | 20000 ÷ 1000000 × цена за единицу | 0.020 | 0.040 |
| Выходные токены | 3000 ÷ 1000000 × цена за единицу | 0.012 | 0.024 |
| Search | 2 × ¥0.005 | 0.010 | 0.010 |
| Fetch | 3 × ¥0.005 | 0.015 | 0.015 |
| Итого за задачу | — | 0.057 | 0.089 |
| Итого за 1000 задач | за задачу × 1000 | ¥57 | ¥89 |
В пиковое время стоимость токенов модели удваивается, а цены Search и Fetch остаются прежними, поэтому общий счёт вырастает с ¥57 до ¥89 — примерно на 56%. В этом сценарии расходы на модель составляют около 56% счёта в непиковое время (¥32 / ¥57), то есть основная часть затрат агента с доступом к интернету по-прежнему приходится на токены. Самый простой способ снизить расходы — переносить пакетные задачи, которые можно выполнить позже, в непиковое время.
3.2 Сценарий второй: сколько экономит 80% попаданий в кэш входных данных
Допущение: условия те же, что в сценарии первом (непиковое время), но из 20 000 входных токенов 16 000 попадают в кэш, а 4 000 — нет.
- Входные токены с попаданием в кэш: 16000 ÷ 1000000 × ¥0.02 = ¥0.00032
- Входные токены без попадания в кэш: 4000 ÷ 1000000 × ¥1 = ¥0.004
- Выход: 3000 ÷ 1000000 × ¥4 = ¥0.012
- Поиск + извлечение: ¥0.010 + ¥0.015 = ¥0.025
- Итого за один вызов ¥0.04132, за 1000 вызовов — ¥41.32
По сравнению с ¥57 из сценария первого экономия составляет ¥15.68, то есть около 27.5%. Кэш влияет только на стоимость входных данных: вход подешевел с ¥0.020 примерно до ¥0.0043, а расходы на выход и инструменты совсем не изменились. Чем выше доля попаданий в кэш, тем ближе счёт к нижней границе «выход + инструменты» — и дальше снижать затраты можно уже только за счёт уменьшения числа поисковых запросов и контроля длины вывода.
3.3 Сценарий 3: пакетная обработка 5000 страниц корпоративных документов
Допущение: непиковое время Flash; 5000 страниц документов разбираются только один раз; при последующем анализе накапливается 10 млн входных токенов с промахами кеша и 1 млн выходных токенов.
- Разбор файлов: 5000 ÷ 1000 × ¥1.5 = ¥7.50
- Вход модели: 10000000 ÷ 1000000 × ¥1 = ¥10.00
- Выход модели: 1000000 ÷ 1000000 × ¥4 = ¥4.00
- Итого ¥21.50
Плата за разбор составляет лишь около 35%. Если одну и ту же партию файлов снова и снова целиком помещать в контекст в многораундовых диалогах, количество входных токенов вырастет кратно, а плата за разбор расти перестанет. В сценариях с большими документами ключ — контролировать, сколько раз содержимое файлов попадает в контекст.
3.4 Сценарий 4: 10 часов распознавания речи + 100 000 тарифицируемых символов TTS
Допущение: используются текущие временные цены со скидкой 50%; ASR — 10 часов аудио, TTS — 100 000 тарифицируемых символов.
- ASR: 10 × ¥0.39 = ¥3.90
- TTS: 100000 ÷ 10000 × ¥1.5 = ¥15.00
- Итого ¥18.90
Эта сумма покрывает только голосовые сервисы; когда транскрибированный текст передаётся диалоговой модели для суммаризации или ответов на вопросы, токены модели тарифицируются отдельно. По стандартным тарифам тот же объём составит 10 × ¥0.78 + 10 × ¥3 = ¥37.80; после окончания скидки бюджет на голосовые сервисы удвоится. Кроме того, 10 часов аудио при ограничении в 120 секунд придётся нарезать минимум на 300 фрагментов, а планировать обработку потребуется с параллелизмом 50.
4 Что заставляет счёт за API всего семейства DeepSeek расти
4.1 Поиск в режиме глубокого мышления выполняет несколько запросов за один раз
Поиск в режиме глубокого мышления может совершить до ~20 вызовов инструментов, прежде чем дать ответ, а оплата начисляется по фактическим действиям. Вот несколько ключевых правил из официальных условий тарификации:
- Если один Search содержит 3 поисковых запроса и по всем есть результаты, это считается как 3 поиска
- Если поиск по изображениям возвращает 3 картинки — это 3 раза; если модель затем выделяет рамками 2 области на изображении, это дополнительно 2 раза
- Успешное открытие 1 веб-страницы, которую нужно получить из сети, считается как 1 Fetch; повторное открытие той же страницы повторно не тарифицируется
- Выполнение
find_in_pageдля уже открытой страницы отдельно не тарифицируется; Search без результатов не тарифицируется - Когда включена защита контента модели, некоторые страницы могут отображаться как
url_not_allowedилиunavailable, но при этом базовый успешный fetch всё равно может быть тарифицирован
При подсчёте нужно использовать поля тарификации server_tool_use.tool_search, tool_fetch, tool_image_search. Поля web_search_requests и web_fetch_requests лишь показывают количество возвращённых блоков и могут включать неудачные запросы — если считать по ним, расходы будут завышены.
4.2 Длинный контекст и повторный ввод файлов
Результаты поиска, текст веб-страниц и разобранные файлы попадают в контекст. Инструмент чтения ссылок учитывает не более 10 разных URL из последнего сообщения пользователя; при одновременном чтении нескольких страниц доступный контекст на каждую страницу уменьшается, но общий объём входных данных всё равно остаётся внушительным. В длинных диалогах каждый раунд тянет за собой историю, и входные токены растут с каждым раундом.
Есть три способа снизить расходы: сохранять в приложении резюме и ключевые факты, а в последующих раундах ссылаться на резюме; помещать системный промпт, общие материалы и правила рабочего процесса в начало контекста и держать их стабильными, чтобы повысить шансы на попадание в кеш; использовать rich_layout_recognition только когда действительно нужно посмотреть на графики и схемы.
4.3 Ограничения скорости запросов для пакетных задач
Ограничение уровня аккаунта для отдельного Search — 100 QPS, для Fetch — 25 QPS; это квота на весь аккаунт, и её совместно используют несколько API-ключей. Fetch также ограничен по QPS на уровне целевого домена — при интенсивном сборе данных с одного сайта легче получить 429. Рекомендации по обработке ошибок:
- 408, 429, 5xx: повтор с экспоненциальной задержкой, запросы к одному домену разносить во времени
- 402: недостаточно средств — сначала пополните баланс аккаунта
- Остальные 4xx (например, ошибка параметров): исправьте запрос и только потом отправляйте; повтор не поможет
Неудачные запросы не тарифицируются, поэтому повтор сам по себе не увеличивает расходы на инструменты, но удлиняет время выполнения задачи. Для крупных пакетных задач время завершения следует рассчитывать исходя из верхнего предела Fetch в 25 QPS.
5 Как выстроить разумный бюджет затрат для DeepSeek Agent
5.1 Журнал затрат API полного набора DeepSeek: быстрый старт
В production-среде нужно как минимум раздельно фиксировать: входные данные с попаданием в кэш, входные данные с промахом кэша, выходные токены, число вызовов Search, число вызовов Fetch, число поисков изображений, число страниц разбора документов, длительность аудио, количество символов для расчёта TTS. Функция ниже напрямую читает поле usage и вычисляет стоимость одного обращения — её можно подключать после каждого запроса для записи в журнал.
# Оценка стоимости полного набора DeepSeek (юани, официальные цены на 2026-11-15)
FLASH = {"cache_hit": 0.02, "cache_miss": 1.0, "output": 4.0}  # непиковое время ¥/миллион токенов
TOOL = {"search": 0.005, "fetch": 0.005, "image_search": 0.005}  # ¥/раз

def estimate_cost(usage: dict, peak: bool = False) -> dict:
    k = 2 if peak else 1  # пиковая цена вдвое выше непиковой, цена инструментов не меняется
    stu = usage.get("server_tool_use", {})
    model = (usage.get("cache_read_input_tokens", 0) * FLASH["cache_hit"]
             + usage.get("input_tokens", 0) * FLASH["cache_miss"]
             + usage.get("output_tokens", 0) * FLASH["output"]) / 1e6 * k
    tools = (stu.get("tool_search", 0) * TOOL["search"]
             + stu.get("tool_fetch", 0) * TOOL["fetch"]
             + stu.get("tool_image_search", 0) * TOOL["image_search"])
    return {"model": round(model, 5), "tools": round(tools, 5),
            "total": round(model + tools, 5)}

# Воспроизведение сценария два: 16000 попаданий + 4000 промахов + 3000 на выход + 2 поиска + 3 загрузки
print(estimate_cost({"cache_read_input_tokens": 16000, "input_tokens": 4000,
                     "output_tokens": 3000,
                     "server_tool_use": {"tool_search": 2, "tool_fetch": 3}}))
# {'model': 0.01632, 'tools': 0.025, 'total': 0.04132}
Цену поиска изображений здесь обрабатываем как цену Search — перед запуском сверьтесь с официальной документацией. Что касается измерений бюджета: продуктам вопросов-ответов подходит учёт «по запросу пользователя», а многошаговым Agent, Deep Research и пакетной автоматизации больше подходит учёт «по жизненному циклу задачи» — все вызовы моделей и инструментов в рамках одной задачи агрегируются под одним task_id.
5.2 Когда выбирать встроенный поиск DeepSeek, а когда — отдельные интерфейсы Search / Fetch
| Критерий | Встроенный поиск модели (deepseek_web_search / read_url) | Отдельные Search / Fetch API |
|---|---|---|
| Сложность разработки | Низкая: сервер сам выполняет поиск, извлечение страниц и сборку контекста | Выше: цикл работы с инструментами нужно организовывать самостоятельно |
| Управление процессом | Модель решает, сколько раз искать и какие страницы читать | Разработчик точно контролирует каждый вызов |
| Принцип тарификации | По числу поисковых запросов, изображений и успешно извлечённых страниц | По числу успешных HTTP-запросов |
| Предсказуемость затрат | Заметно колеблется: при глубоком поиске — до ~20 вызовов инструментов | Высокая: число вызовов определяет код |
| Подходящие сценарии | Диалоговые ассистенты, быстрое воспроизведение опыта приложения | RAG, массовый сбор данных, агенты с фиксированным сценарием |
Когда нужно быстро выпустить диалоговый продукт, встроенный поиск избавляет от массы инженерной работы. Когда же затраты на одну задачу нужно уложить в фиксированный диапазон или сначала отфильтровать данные, а потом уже извлекать страницы, лучше подходят отдельные интерфейсы. Одно другому не мешает: основной диалоговый процесс может работать на встроенных инструментах, а фоновое пополнение данных — через отдельные API.
5.3 Подключение и цены DeepSeek Search / Fetch на APIYI
APIYI запустил 21 октября 2026 года отдельные инструментальные интерфейсы DeepSeek deepseek-search и deepseek-fetch, эндпоинты — POST /v1/tools/search и POST /v1/tools/fetch. Они не расходуют токены модели и тарифицируются по числу успешных вызовов; доступны в группах default и svip, а токены группы ClaudeCode не могут вызвать их напрямую. Что касается встроенного поиска в модели, который вызывают такие клиенты, как DeepSeek Harness и Claude Code, работа по совместимости в APIYI пока только в планах — сейчас доступны отдельные Search / Fetch.
Ниже приведены цены, опубликованные в документации APIYI, в долларах США:
| Пункт | Официальная цена по документации | Цена на сайте APIYI | Эквивалент с бонусом 20% | Эквивалент с бонусом 10% |
|---|---|---|---|---|
| Search / 1000 вызовов | $0.75 | $0.90 | $0.75 | около $0.82 |
| Fetch / 1000 вызовов | $0.75 | $0.90 | $0.75 | около $0.82 |
Если взять объём инструментов из первого сценария (1000 вызовов Search + 3000 вызовов Fetch): тарификация на сайте — (1000 + 3000) ÷ 1000 × $0.90 = $3.60; при бонусе 20% на все расходы эквивалент — $3.60 ÷ 1.20 = $3.00; при бонусе 10% — примерно $3.27. Официальный DeepSeek считает в юанях, поэтому при сравнении реальных затрат нужно приводить валюту, курс и условия бонусов за пополнение к единому виду; в конечном счёте ориентируйтесь на цену, отображаемую в консоли аккаунта.
Минимальный пример вызова (поля запроса — согласно документации APIYI):
import requests

BASE_URL = "https://api.apiyi.com/v1"  # Единый эндпоинт APIYI
headers = {"Authorization": "Bearer YOUR_API_KEY"}

resp = requests.post(f"{BASE_URL}/tools/search", headers=headers,
                     json={"model": "deepseek-search",
                           "query": "DeepSeek API 价格", "count": 10})
print(resp.json())
Полная реализация: сначала поиск, затем загрузка, с обработкой 429 (backoff) и подсчётом
import time
import requests

BASE_URL = "https://api.apiyi.com/v1"  # Совместимый с OpenAI вход APIYI
HEADERS = {"Authorization": "Bearer YOUR_API_KEY"}
RETRY_CODES = {408, 429, 500, 502, 503, 504}

def call_tool(path: str, payload: dict, max_retry: int = 4) -> dict | None:
    """Вызывает интерфейс инструмента; для повторяемых ошибок — экспоненциальная задержка, неудачные запросы не тарифицируются"""
    for i in range(max_retry):
        r = requests.post(f"{BASE_URL}{path}", headers=HEADERS,
                          json=payload, timeout=60)
        if r.status_code == 200:
            return r.json()
        if r.status_code == 402:
            raise RuntimeError("余额不足,请先充值")
        if r.status_code in RETRY_CODES:
            time.sleep(2 ** i)  # 1 с, 2 с, 4 с, 8 с
            continue
        raise ValueError(f"请求参数错误: {r.status_code} {r.text}")
    return None

def research(query: str, fetch_top: int = 3) -> dict:
    stats = {"search": 0, "fetch": 0}
    result = call_tool("/tools/search",
                       {"model": "deepseek-search", "query": query, "count": 10})
    items = (result or {}).get("results", [])
    if items:
        stats["search"] += 1  # тарифицируется только непустой результат
    pages = []
    for item in items[:fetch_top]:  # берём только страницы, где действительно нужно читать оригинал
        page = call_tool("/tools/fetch",
                         {"model": "deepseek-fetch", "url": item.get("url")})
        if page:
            stats["fetch"] += 1
            pages.append(page)
        time.sleep(0.05)  # сдерживаем темп, чтобы не упереться в 25 QPS у Fetch и лимиты на уровне домена
    return {"pages": pages, "billing": stats}

if __name__ == "__main__":
    out = research("DeepSeek 全家桶 API 计费规则")
    print(out["billing"])  # например {'search': 1, 'fetch': 3}
🚀 Быстрый старт: зарегистрируйтесь через APIYI на apiyi.com и получите тестовый лимит — сначала прогоните Search / Fetch небольшим пакетом запросов, а потом по фактическому числу вызовов в логах прикиньте бюджет на постоянную работу.
Частые вопросы (FAQ)
Q1: Из каких платных позиций состоит полный комплект DeepSeek API?
В него входят токены модели (входные с попаданием в кэш, входные без попадания в кэш, выходные) и стоимость инструментов (Search, Fetch, поиск по изображениям, разбор файлов, OCR, ASR, TTS). Проверка безопасности и поиск внутри страницы `find_in_page` в открытом прайс-листе отдельной строкой не указаны.
Q2: Чем отличается тарификация отдельного Search API и поиска, встроенного в модель?
Отдельный Search считается как 1 раз за успешный HTTP-запрос: даже если вернулось 50 результатов, это всё равно один раз. Встроенный в модель поиск тарифицируется по числу фактических поисковых запросов: если в одном вызове 3 поисковых запроса, это уже 3 раза. Встроенный вариант проще в разработке, отдельный — даёт больше контроля над расходами.
Q3: На какой момент указаны эти цены и могут ли измениться временные акции?
Цены в статье взяты из официального китайского документа DeepSeek с ценами, на момент 15 ноября 2026 года. На ASR и TTS сейчас действует временная скидка 50%, после её окончания они вернутся к ¥0.78 за час и ¥3 за 10 000 тарифицируемых символов соответственно. Для долгосрочного бюджета лучше закладывать запас по цене из прайс-листа.
Q4: Удвоится ли счёт в часы пик?
Удваивается только часть с токенами модели, цены на инструменты от времени суток не зависят. В первом сценарии общий счёт вырос с ¥57 до ¥89, то есть примерно на 56%. Чем выше доля расходов на инструменты в задаче, тем меньше рост в часы пик.
Q5: Как быстро вызывать DeepSeek Search и Fetch через API?
1. Зарегистрироваться на APIYI apiyi.com и создать токен группы default или svip
2. Указать в base_url адрес `https://api.apiyi.com/v1`
3. Использовать код из этой статьи для запросов к `/tools/search` и `/tools/fetch`; имена моделей — `deepseek-search` и `deepseek-fetch`
Один и тот же API Key можно использовать и для других популярных моделей платформы — удобно передавать результаты поиска разным моделям и сравнивать, как они справляются.
Q6: Будет ли повторная плата, если после разбора файла задавать вопросы по нему снова и снова?
Плата за разбор взимается один раз: при повторном обращении к тому же `file_id` разбор уже не тарифицируется. Но содержимое файла каждый раз попадает в контекст и оплачивается как входные токены — при большом файле и множестве вопросов основная стоимость идёт именно от входных токенов.
Q7: Какие известные ограничения есть у полного комплекта DeepSeek API?
— Полноценная интеграция инструментов на уровне диалога сейчас доступна для `deepseek-flash`
— Отдельный Search: 100 QPS на уровне аккаунта, Fetch: 25 QPS, плюс ограничения со стороны целевого домена
— ASR: один сегмент не длиннее 120 секунд, без потокового режима; TTS: не более 10 000 тарифицируемых символов за один раз, регулировка скорости речи пока не поддерживается
— Разбор файлов: максимум 100 MiB и 1000 страниц на файл, в одном запросе можно ссылаться не более чем на 20 файлов
Q8: Можно ли через APIYI вызывать все новые встроенные инструменты DeepSeek?
Сейчас на APIYI доступны отдельные `deepseek-search` и `deepseek-fetch` — их можно самостоятельно оркестрировать в Agent и RAG. Совместимость встроенного поиска модели с такими клиентами, как Harness и Claude Code, пока ещё в планах; о ходе работ следите в официальной документации APIYI на apiyi.com.
Цены на API всей линейки DeepSeek: ключевые выводы
- Структура биллинга: токены модели и вызовы инструментов оплачиваются отдельно, и одна задача одновременно порождает несколько статей расходов
- Цена за инструменты: Search и Fetch — по ¥5 за 1000 вызовов, разбор файлов и OCR — по ¥1.5 за 1000 страниц
- Цены на речь: ASR — ограниченное время ¥0.39 / час, TTS — ограниченное время ¥1.5 / 10 000 тарифицируемых символов, китайский иероглиф считается за 2 символа
- Основная часть счёта: в задачах интернет-исследований токены модели обычно занимают больше половины; наибольший эффект дают непиковые часы и кэш
- Эффект кэша: при 80% попаданий во входные данные счёт в первом сценарии падает с ¥57 до ¥41.32 — экономия около 27.5%
- Методика подсчёта: учёт ведётся по полю биллинга
server_tool_use; в отображаемых полях могут быть неудачные запросы - Как начать: отдельные Search / Fetch можно вызывать и тестировать на APIYI apiyi.com с единым ключом
Итоги
Ключевые моменты по ценам на API из набора DeepSeek:
- Считайте по задачам: стоимость одной задачи агента = ввод + вывод + инструменты + файлы и речь. Цена одного запроса отражает лишь одну из этих составляющих.
- Счёт определяют токены: у инструментов низкая цена за единицу, а рост расходов обеспечивают длинный контекст, повторяющиеся файлы и вывод в режиме рассуждения.
- Методика расчёта определяет управляемость: встроенный поиск тарифицируется по поисковым запросам — это удобно для разработки;独立ный интерфейс тарифицируется по запросам — бюджет стабильнее.
На практике сначала прогоните成本之道成本-функцию из этой статьи на небольшой выборке, чтобы получить реальные поля биллинга, затем умножьте их на объём бизнеса — так вы получите бюджет. И обязательно оставьте запас на случай, когда закончится действие ограниченного по времени предложения. Командам, которые самостоятельно выстраивают процессы поиска и извлечения данных, можно обращаться к отдельным интерфейсам DeepSeek Search / Fetch через APIYI apiyi.com: сверяйте с фактическими ценами в консоли и сравнивайте в одной валюте.
📚 Справочные материалы
- Модели и цены DeepSeek: актуальная официальная документация по ценам
- Ссылка:
api-docs.deepseek.com/zh-cn/quick_start/pricing -
Описание: цена за токен модели, пиковые и непиковые часы, стоимость инструментов
-
Инструменты веб-доступа DeepSeek: техническая документация по встроенному поиску и чтению ссылок
- Ссылка:
api-docs.deepseek.com/zh-cn/guides/web_tools -
Описание: детали биллинга глубокого поиска, поле биллинга
server_tool_use -
Веб-поиск и извлечение данных DeepSeek: документация отдельных Search / Fetch
- Ссылка:
api-docs.deepseek.com/zh-cn/guides/search -
Описание: определение успешного запроса, ограничения QPS, обработка кодов ошибок
-
Разбор файлов / OCR / ASR / TTS в DeepSeek: техническая документация по каждому инструменту
- Ссылка:
api-docs.deepseek.com/zh-cn/guides/document_parsing -
Описание: в том же разделе можно найти ограничения и единицы биллинга для ocr, asr, tts
-
Анонс API приложений из набора DeepSeek: опубликован 13 ноября 2026 года
- Ссылка:
api-docs.deepseek.com/zh-cn/news/news261113 - Описание: перечень открытых возможностей и поддерживаемые модели
Автор: Техническая команда APIYI
Обмен опытом: пишите нам через главную страницу сайта APIYI — параметры интерфейсов DeepSeek Search / Fetch и актуальные цены можно посмотреть в документационном центре APIYI