Anmerkung des Autors: Dieser Beitrag vergleicht Qwen4-Max und Claude Opus 5.5 anhand von vier Aufgabentypen – Terminal und Code-Repository, lange Office-Aufgaben, multimodale Langdokumente und Kosten – bei Benchmark-Ergebnissen, Spezifikationen, Cache-Preisen und Migrationskosten und gibt umsetzbare Empfehlungen für die Auswahl.
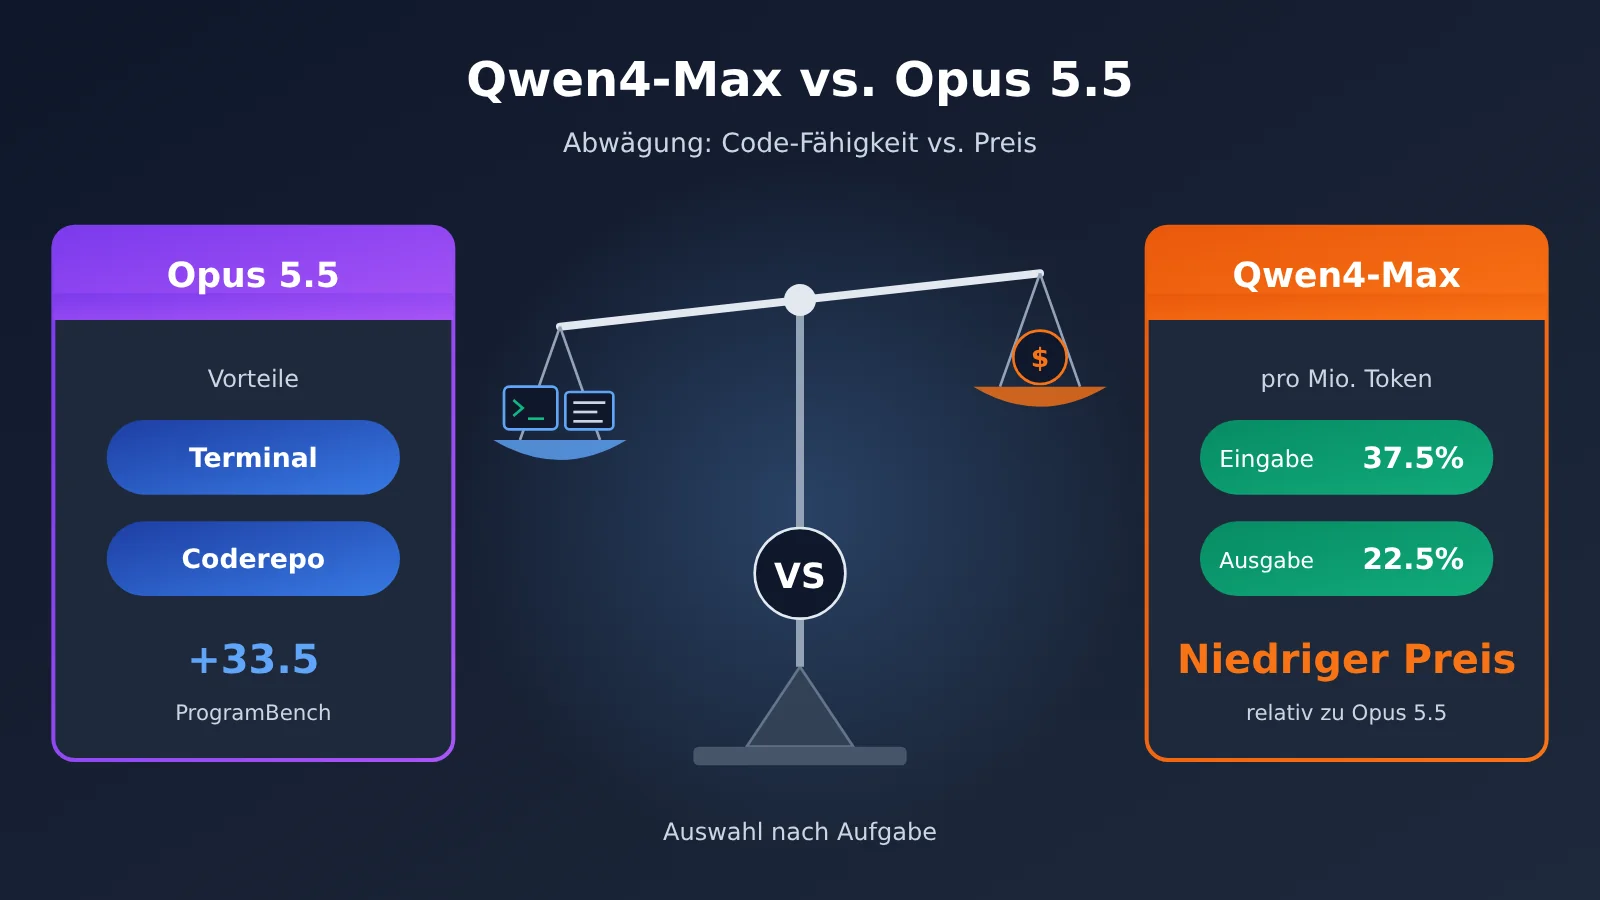
Wenn Ihr Team Claude Opus 5.5 bereits als Hauptmodell einsetzt und in Claude Code oder selbstgebauten Agents produktiv betreibt, dann bringt das am 2026-11-16 veröffentlichte Qwen4-Max Sie dazu, die Rechnung neu aufzumachen: Der Input-Preis beträgt nur 37.5% des Preises von Opus 5.5, der Output-Preis nur 22.5%.
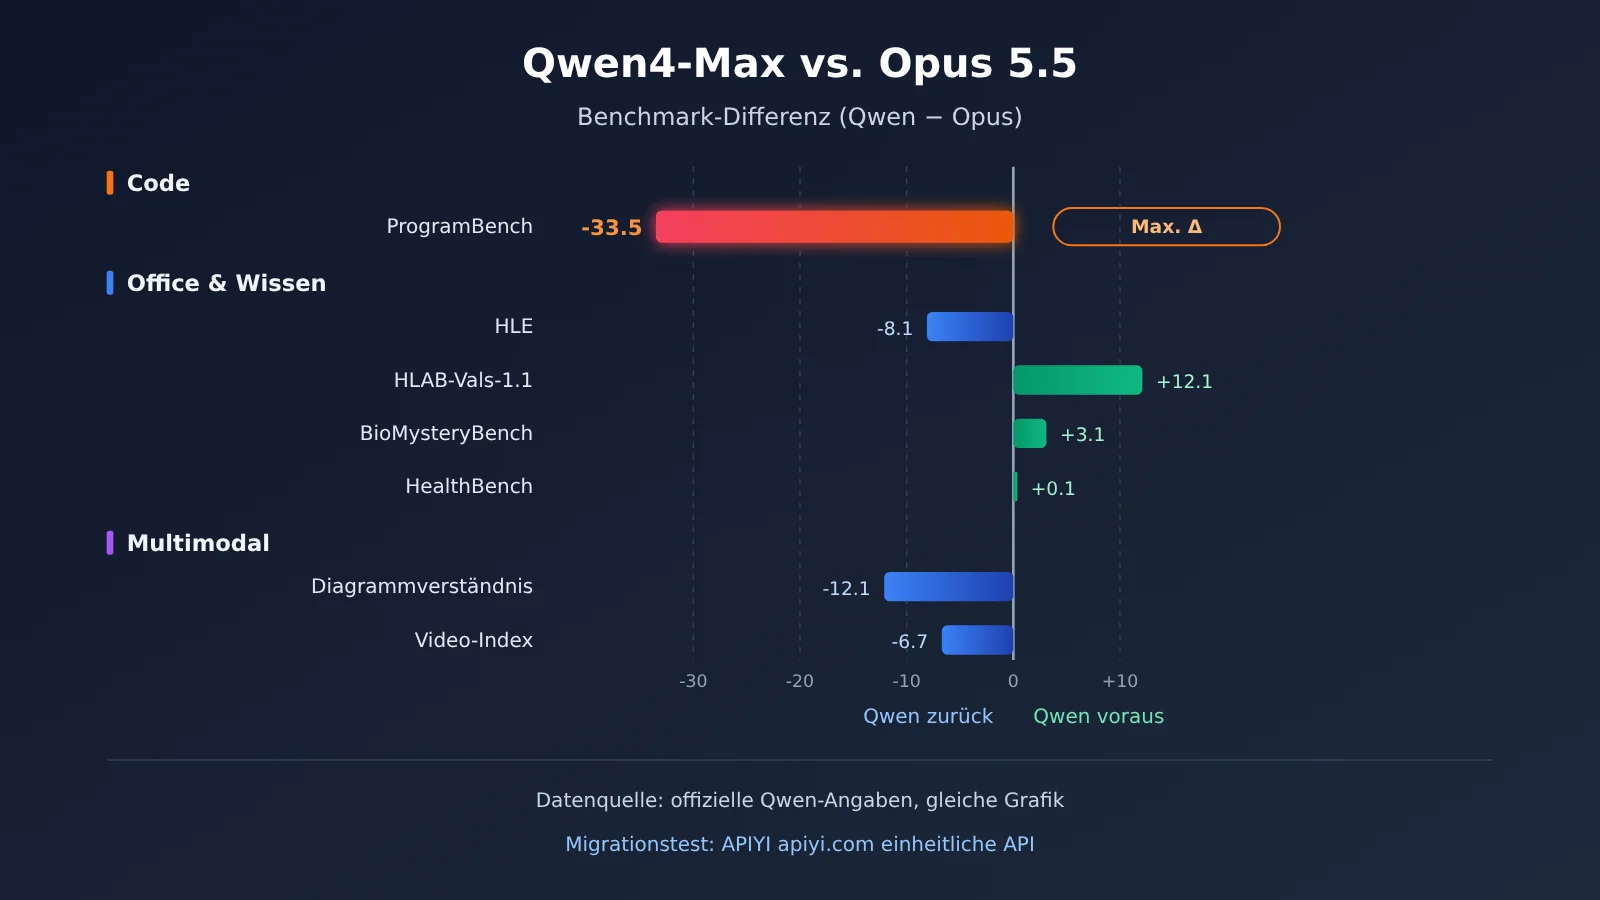
Zuerst das Fazit, ohne Kompromisse: Terminal-Operationen und Refactorings auf Repository-Ebene bleiben weiterhin bei Opus 5.5; Qwen4-Max liegt bei ProgramBench 33.5 Punkte zurück – das ist die größte Schwäche in diesem Vergleich. Workflow-Automatisierung, kostenempfindliche hochparallele Agents und Dokumentaufgaben mit sehr langen Ausgaben können vorrangig mit Qwen4-Max getestet werden; bei Office-Deliverables sowie Aufgaben zum Verständnis von Diagrammen und Videos bleibt Opus 5.5 deutlich im Vorteil.
Der zentrale Nutzen: Nach der Lektüre dieses Artikels erhalten Sie eine nach Aufgaben aufgeteilte Entscheidungstabelle und kennen die Unterschiede bei Cache-Preisen, Standard-Reasoning-Stufen und den tatsächlichen Migrationsschritten auf beiden Seiten.
Qwen4-Max vs. Opus 5.5: Die wichtigsten Unterschiede auf einen Blick
Klären wir zuerst, worauf die Zahlen beruhen. Die Werte in diesem Artikel stammen aus drei völlig unterschiedlichen Quellen und dürfen nicht vermischt gelesen werden:
- Von Qwen selbst gemeldeter Vergleich in derselben Grafik: Alibaba listet im Release-Blog in einer einzigen Grafik die Scores von Qwen4-Max und Opus 5.5 auf. Das ist ein vom Hersteller selbst durchgeführter Lauf, keine Nachbildung durch Dritte.
- Snapshot einer öffentlichen Rangliste, 14.11.2026: die Code-Arena-WebDev-Rangliste von arena.ai, basierend auf öffentlichen Stimmen.
- Originaltext der Anthropic-Dokumentation: Spezifikationen und Preise von Opus 5.5 stammen von der offiziellen Anthropic-Modellseite und der Preisseite.
Die folgende Tabelle fasst die Schlussfolgerungen des gesamten Artikels zusammen; die einzelnen Kapitel führen die Belege dann Schritt für Schritt aus.
| Aufgabentyp | Empfehlung | Ausschlaggebende Kennzahl | Begründung in einem Satz |
|---|---|---|---|
| Terminal-Bedienung und Refactoring auf Repository-Ebene | Opus 5.5 | Terminal-Bench 11,1 niedriger, ProgramBench 33,5 niedriger | Mehrstufige Befehlsketten und Änderungen am gesamten Repository sind die schwächste Disziplin von Qwen4-Max |
| Codierung für die Behebung einzelner Issues | Qwen4-Max: einen Versuch wert | DeepSWE 1,5 höher | Bei lokalen Fixes ist man gleichauf, der Preisvorteil ist deutlich |
| Office-Deliverables und lange Aufgaben | Opus 5.5 | AA-Briefcase 115 Elo niedriger, JobBench 6,9 niedriger | Der Qualitätsunterschied bei Dokumenten und Berichten ist spürbar |
| Workflow-Automatisierung | Qwen4-Max | AutomationBench 3,0 höher | Bei Prozessaufgaben mit klaren Regeln nicht schlechter – und günstiger |
| Diagramm- und Videoverständnis | Opus 5.5 | Chartography 12,1 niedriger, Video-Index 6,7 niedriger | Beim multimodalen Erfassen von Bildern gibt es weiterhin einen Abstand |
| Kostenempfindliche Agenten mit hoher Parallelität | Qwen4-Max | Eingabe 37,5 %, Ausgabe 22,5 % | Bei hohem Volumen vervielfacht sich der Unterschied auf der Rechnung |
Spezifikationsunterschiede zwischen Qwen4-Max und Opus 5.5
Auf Spezifikationsebene haben beide ein Kontextfenster von 1M, doch bei den Standardwerten für Ausgabe und Reasoning unterscheiden sie sich stark:
- Qwen4-Max: 2,4T Hauptmodell, 71B aktiviert, dazu 328B N-gram-Embedding; natives Sehen; maximale Ausgabe 393K, maximale Gedankenkette 262K; Standardwert für
reasoning_effortist high. - Opus 5.5 (Originaltext der Anthropic-Dokumentation): positioniert für langlaufende agentische Codierung und Wissensarbeit; maximale Ausgabe 128K; Standard-Effort medium; Wissensstand Juni 2026.
Der Punkt mit der Standardstufe wird leicht übersehen. Qwen4-Max startet standardmäßig auf high, und der Denkprozess wird als Ausgabe abgerechnet. Deshalb ist der Unterschied auf der tatsächlichen Rechnung meist kleiner als die 22,5 % im Listenpreis; im Preisabschnitt weiter unten gibt es dazu einen Beleg aus einer öffentlichen Rangliste.
Qwen4-Max im Vergleich zu Opus 5.5: Terminal- und Code-Repository-Aufgaben
Das ist der Teil, der bestehende Opus-Nutzer am meisten interessiert – und der Bereich, in dem Qwen4-Max am vorsichtigsten agieren sollte.
| Benchmark (Qwen-eigene Angabe, Vergleich im selben Diagramm) | Qwen4-Max | Opus 5.5 | Differenz |
|---|---|---|---|
| DeepSWE v1.1 | 75.7 | 74.2 | Qwen 1.5 höher |
| CodeArena WebDev Elo | 1750 | 1816 | Qwen 66 niedriger |
| Terminal-Bench 4.0 | 48.5 | 59.6 | Qwen 11.1 niedriger |
| ProgramBench | 31.5 | 65.0 | Qwen 33.5 niedriger |
Was die einzelnen Werte für die praktische Arbeit bedeuten:
- DeepSWE 1.5 Punkte höher: Bei Aufgaben wie einem gezielten Fix für ein vorgegebenes Issue steht Qwen4-Max bereits auf Augenhöhe mit Opus 5.5. Die 1.5 Punkte kann man im Grunde als Gleichstand werten – tauglich für risikoarme Bugfix-Warteschlangen.
- WebDev 66 Elo niedriger: Beim Gesamteindruck generierter Frontend-Seiten stimmen die Nutzer eher für Opus. Bei Landingpages und Komponenten-Prototypen ist der Unterschied mit bloßem Auge sichtbar.
- Terminal-Bench 11.1 Punkte niedriger: Bei der Fähigkeit, im Terminal nacheinander Befehle auszuführen, die Ausgabe zu lesen und dann den nächsten Schritt zu entscheiden, liegt Qwen4-Max deutlich zurück. Genau das ist der Alltag von Workflows à la Claude Code – ein Wechsel bedeutet mehr Hängenbleiben mittendrin oder mehr manuelle Eingriffe.
- ProgramBench 33.5 Punkte niedriger: Das ist die größte Schwachstelle in diesem Vergleich, der Wert liegt fast um die Hälfte niedriger. Für Aufgaben, bei denen Programme von Grund auf gebaut oder großflächig umgeschrieben werden, taugt Qwen4-Max derzeit nicht als Ersatz für Opus 5.5.
Auch die öffentlichen Ranglisten zeigen eine ähnliche Position. Laut Snapshot der öffentlichen Rangliste vom 2026-11-14 kommt arena.ai Code Arena WebDev auf insgesamt 1,007,405 Stimmen von 159 Modellen: Opus 5.5 (Max) liegt mit 1816 Punkten auf Platz 2, Qwen4-Max (xHigh) mit 1750 Punkten auf Platz 6 – Letzteres hat allerdings nur 1,814 Stimmen und ist noch als Preliminary markiert, die Platzierung wird also weiter schwanken.
Empfehlungen für Qwen4-Max im Code-Repository-Kontext
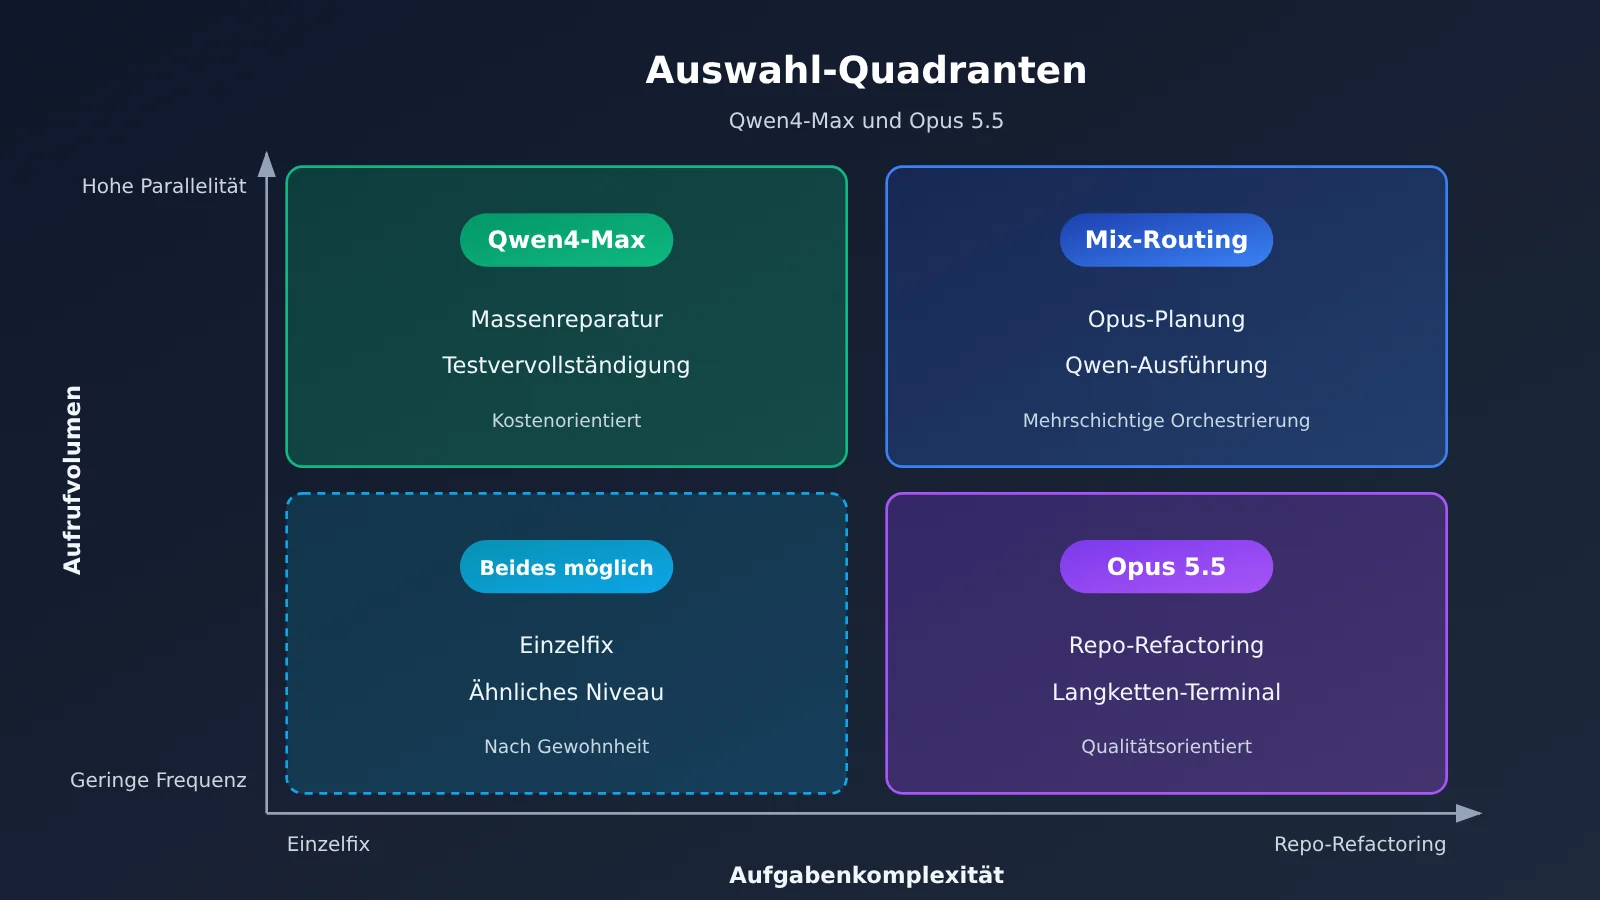
Wenn dein Agent überwiegend komplette Repository-Refactorings, modulübergreifende Migrationen oder langkettige Terminal-Operationen erledigt, solltest du bei Opus 5.5 bleiben. Wenn du die Aufgabe in zwei Ebenen aufteilst – „Planung + Ausführung“ – kannst du Opus 5.5 die Planung und die kritischen Änderungen überlassen und lokale Aufgaben wie Einzeldatei-Fixes oder das Ergänzen von Tests an Qwen4-Max auslagern.
Qwen4-Max vs. Opus 5.5: Büroarbeit und Langzeitaufgaben
Bei Büroarbeit und langlaufenden Agent-Aufgaben fallen die Ergebnisse deutlich differenzierter aus als beim Coding – hier gewinnt mal das eine, mal das andere Modell.
| Benchmark (von Qwen selbst gemeldete Werte, Vergleich in derselben Grafik) | Qwen4-Max | Opus 5.5 | Differenz |
|---|---|---|---|
| AA-Briefcase v1.1 Elo | 1686 | 1801 | Qwen 115 Punkte niedriger |
| JobBench | 68.5 | 75.4 | Qwen 6,9 niedriger |
| APEX-Agents v1.1 | 72.1 | 73.5 | Qwen 1,4 niedriger |
| AutomationBench-AA | 72.5 | 69.5 | Qwen 3,0 höher |
| AgentArena Net Improvement | 7.5 | 18.2 | Qwen 10,7 niedriger |
Auf die konkrete Arbeit übertragen heißt das:
- AA-Briefcase 115 Elo niedriger: Bei Büro-Deliverables wie Berichten, Konzepten und Tabellen sind die Ergebnisse von Opus 5.5 eher direkt übernehmbar – das ist der größte Unterschied im Büro-Umfeld.
- JobBench 6,9 niedriger: Bei der Gesamtbewertung realitätsnaher Job-Aufgaben liegt Opus weiter vorn, was bedeutet, dass bei der End-to-End-Ablieferung die Nacharbeitungsquote höher ausfallen dürfte.
- APEX-Agents 1,4 niedriger: Bei allgemeinen Agent-Aufgaben sind beide praktisch gleichauf; ein Modellwechsel bringt hier keinen spürbaren Unterschied im Erlebnis.
- AutomationBench 3,0 höher: Bei klar regelbasierten Prozessautomatisierungen ist Qwen4-Max dagegen stark – Formularverarbeitung, Datenübernahme und die Orchestrierung zeitgesteuerter Aufgaben eignen sich für eine vorrangige Migration.
- AgentArena Net Improvement 10,7 niedriger: Die Fähigkeit, sich über mehrere Iterationen hinweg kontinuierlich zu verbessern, ist schwächer. Je länger eine Aufgabe läuft und je mehr sie auf Selbstkorrektur des Modells angewiesen ist, desto stabiler ist Opus.
Außerdem sind die maximale Ausgabe von 393K Token und das Denkketten-Limit von 262K bei Qwen4-Max ein echter Vorteil für Langzeitaufgaben, die in einem Zug sehr lange Inhalte erzeugen müssen. Opus 5.5 hat eine maximale Ausgabe von 128K.
Qwen4-Max im Vergleich zu Opus 5.5: Chinesisch und multimodale lange Dokumente
Zunächst eine Klarstellung: Die Vergleichsgrafik in den Referenzmaterialien enthält keinen speziellen chinesischen Benchmark. Deshalb kann dieser Artikel nicht mit Zahlen beantworten, welches Modell bei Chinesisch besser ist. Wenn chinesische Qualität für Sie die zentrale Kennzahl ist, führen Sie bitte ein A/B mit Ihrem eigenen Sample-Set durch und verlassen Sie sich nicht auf Schlussfolgerungen aus zweiter Hand.
Zahlenmäßig belegen lassen sich multimodale und wissensbezogene Aufgaben:
| Benchmark (von Qwen offiziell selbst berichteter Vergleich im selben Diagramm) | Qwen4-Max | Opus 5.5 | Differenz |
|---|---|---|---|
| Chartography | 54.2 | 66.3 | Qwen 12.1 niedriger |
| Video-Index | 68.1 | 74.8 | Qwen 6.7 niedriger |
| Humanity’s Last Exam | 51.7 | 59.8 | Qwen 8.1 niedriger |
| HLAB-Vals-1.1 | 21.3 | 9.2 | Qwen 12.1 höher |
| BioMysteryBench | 85.0 | 81.9 | Qwen 3.1 höher |
| HealthBench Professional | 60.0 | 59.9 | nahezu gleichauf |
Was diese Zahlen praktisch bedeuten: Beim Lesen von Diagrammen und beim Extrahieren grafischer Daten aus Finanzberichten und Research-Berichten liegt Qwen4-Max um 12.1 Punkte zurück und neigt dazu, Achsen falsch zu lesen oder zu übersehen; auch beim Videoverständnis gibt es einen Abstand von 6.7 Punkten; bei schwierigen integrierten Wissensfragen (HLE) liegt es 8.1 Punkte zurück. Umgekehrt ist Qwen4-Max bei biologischem Schlussfolgern und medizinischen Fachfragen gleichauf oder sogar leicht überlegen, bei HLAB-Vals führt es mit 12.1 Punkten.
Bei Aufgaben mit langen Dokumenten muss man daher weiter differenzieren: Für textlastige Dokumente, die sehr lange Ausgaben erfordern, ist Qwen4-Max eine erste Kandidatenwahl; bei diagrammlastigen PDFs oder Materialien mit Videoinhalten sollte man weiterhin Opus 5.5 verwenden.
Qwen4-Max vs. Opus 5.5: Preis und Cache-Rechnung pro Million Token
Der Preis ist das stärkste Argument für Qwen4-Max. Die folgende Tabelle gibt alle Werte pro 1M Tokens an. Die offiziellen Preise stammen aus den Originaldokumenten von QwenCloud und Anthropic, die aktuellen APIYI-Preise aus docs.apiyi.com/models, Stand 2026-11-16.
| Abrechnungsposten ($/1M Tokens) | Qwen4-Max offiziell | Opus 5.5 offiziell | Qwen/Opus | APIYI qwen3.8-max |
APIYI claude-opus-5-5 |
|---|---|---|---|---|---|
| Eingabe | 1,5 | 4 | 37,5 % | 1,65 | 4 |
| Ausgabe | 4,5 | 20 | 22,5 % | 4,95 | 20 |
| Cache-Lesen | 0,075 | 0,20 | 37,5 % | 0,20625 | 0,2 |
| Cache-Schreiben (5 Minuten) | 1,875 | 5 | 37,5 % | gemäß Plattformliste | gemäß Plattformliste |
| Cache-Schreiben (1 Stunde) | 3 | 8 | 37,5 % | gemäß Plattformliste | gemäß Plattformliste |
Die Cache-Struktur beider Anbieter ist tatsächlich völlig gleich aufgebaut: Cache-Lesen kostet 5 % des Eingabepreises, Cache-Schreiben für 5 Minuten das 1,25-Fache des Eingabepreises und Cache-Schreiben für 1 Stunde das 2-Fache. Das heißt: Deine für Opus entwickelte Caching-Strategie kannst du unverändert auf Qwen4-Max übertragen, die Rechnung schrumpft proportional auf 37,5 %. Ein Detail solltest du dabei beachten: Bei APIYI kostet das Cache-Lesen von qwen3.8-max 12,5 % des Eingabepreises – ein anderes Verhältnis als bei Qwen4-Max offiziell. Bei einer Migration rechnest du also am besten für jedes Modell einzeln nach.
Eine konkrete Rechnung
Nehmen wir 100 Millionen Eingabe- plus 10 Millionen Ausgabe-Tokens: Qwen4-Max kommt auf rund $195 (150 + 45), Opus 5.5 auf rund $600 (400 + 200). Die Differenz beträgt etwa $405 – also zwei Drittel der Opus-Rechnung.
Doch Listenpreis ist nicht gleich Rechnungsbetrag. Der Snapshot der öffentlichen Rangliste, 2026-11-14 nennt Kosten pro Aufgabe (P50): Opus 5.5 (Max) $8,99, Qwen4-Max (xHigh) $4,18 – ein Verhältnis von etwa 46 %, nicht 22,5 % wie beim Listenpreis. Der Grund liegt in den unterschiedlichen Reasoning-Stufen: Qwen4-Max läuft standardmäßig auf „high“, die Gedankenkette wird als Ausgabe abgerechnet, wodurch mehr Tokens verbraucht werden. Wie viel du tatsächlich sparst, hängt von der Länge deiner Aufgaben und der Reasoning-Stufe ab – am besten einmal mit einem Replay deines eigenen Traffics durchmessen.
💰 Kostentipp: Wenn du Rechnungen vergleichst, erfasse alle vier Token-Kategorien – Eingabe, Ausgabe, Cache-Lesen und Cache-Schreiben – und nicht nur den Stückpreis. Mit APIYI (apiyi.com) rufst du beide Modelle parallel im selben Account auf, dann liegen die Nutzungsdetails an einer Stelle direkt nebeneinander.
Qwen4-Max vs. Opus 5.5: Entscheidungsempfehlung und Migration in drei Schritten
Einen Agent von Opus auf Qwen umzustellen, führt an drei Schritten nicht vorbei: Modell prüfen, Preise vergleichen, Protokoll abgleichen.
Schritt 1: Modell prüfen. Stand 2026-11-16 ist Qwen4-Max bei APIYI noch nicht gelistet – wir werden dieses Modell so bald wie möglich aufnehmen. Aktuell ist qwen3.8-max das stärkste Modell auf der Qwen-Seite. Auf der Opus-Seite stehen claude-opus-5-5 und zusätzlich claude-opus-5-5-thinking zur Verfügung, beide zum selben Preis. Maßgeblich für Modelle und Preise ist die Modellliste im Dokumentationszentrum von apiyi.com; bis Qwen4-Max verfügbar ist, lässt sich die Canary-Kette bereits mit qwen3.8-max aufsetzen.
Schritt 2: Preise vergleichen. Schätzen Sie nach der Methode aus dem vorigen Abschnitt die Kosten beider Seiten anhand einer Woche echten Traffics und vergleichen Sie erst, nachdem Sie die Reasoning-Stufen angeglichen haben. Die Modellliste von APIYI (apiyi.com) führt Eingabe, Ausgabe und Cache-Reads in einer einzigen Gesamttabelle – ideal als Datenquelle für Ihre Kalkulationstabelle.
Schritt 3: Protokoll abgleichen. APIYI bietet eine OpenAI-kompatible Schnittstelle mit dem Endpunkt https://api.apiyi.com/v1. Beim Modellwechsel ändern Sie nur das Feld model, zum Beispiel von claude-opus-5-5 auf qwen3.8-max; api_key und base_url bleiben unverändert. Zwei Dinge sollten Sie zusätzlich prüfen: Der Parameter für die Reasoning-Intensität heißt auf der Qwen-Seite reasoning_effort und steht standardmäßig auf high – wenn Sie ihn an das medium von Opus angleichen wollen, müssen Sie ihn explizit setzen. Auch Schreibdauer und Trefferregeln des Caches sollten Sie für das Zielmodell erneut verifizieren.
🎯 Canary-Empfehlung: Schalten Sie nicht den gesamten Agent auf einmal um. Besser ist es, den Traffic unter derselben
base_url(https://api.apiyi.com/v1) nach Aufgabentyp aufzuteilen: Migrieren Sie zuerst Automatisierungs- und lokale Reparaturaufgaben, während Terminal- und repoweite Aufgaben vorerst auf Opus 5.5 bleiben. Beobachten Sie zwei Wochen lang die Nacharbeitsquote, bevor Sie über den nächsten Schritt entscheiden.
Häufig gestellte Fragen (FAQ)
Q1: Was eignet sich besser als Coding-Agent – Qwen4-Max oder Opus 5.5?
Das hängt von der Granularität der Aufgabe ab. Bei der Behebung einzelner Issues (DeepSWE) liegen beide gleichauf, hier kannst du mit Qwen4-Max Geld sparen. Bei mehrstufigen Terminal-Operationen und Whole-Repo-Builds (Terminal-Bench, ProgramBench) liegt Opus 5.5 deutlich vorn, bei ProgramBench sogar mit 33,5 Punkten Unterschied – für solche Aufgaben also weiterhin Opus verwenden.
Q2: Lassen sich die Werte aus den Alibaba-Charts und die aus der Arena-Rangliste direkt vergleichen?
Nein, das ist kein einheitlicher Maßstab. Ersteres sind vom Qwen-Team selbst gemeldete Vergleichswerte auf demselben Bild, Letzteres ist ein Snapshot einer öffentlichen Rangliste (2026-11-14), und Qwen4-Max kommt dort auf nur 1.814 Stimmen und gilt weiterhin als „Preliminary“. Beide können sich gegenseitig als Trendreferenz dienen, sollten aber nicht zu einer Aussage im Sinne von „so und so viele Punkte voraus“ zusammengeführt werden.
Q3: Wie viel Geld spart der Wechsel zu Qwen4-Max tatsächlich?
Laut Listenpreis sparst du 62,5 % bei der Eingabe und 77,5 % bei der Ausgabe. In der öffentlichen Rangliste liegt das Verhältnis der Kosten pro Aufgabe (P50) aber bei etwa 46 %, weil Qwen4-Max standardmäßig eine höhere Reasoning-Stufe nutzt und mehr Denk-Token verbraucht. Die tatsächliche Ersparnis musst du mit einem Replay deines eigenen Traffics messen.
Q4: Kann ich Qwen4-Max derzeit über APIYI aufrufen?
Im Moment noch nicht, Qwen4-Max ist noch nicht gelistet, wir werden es so bald wie möglich aufnehmen. Aktuell kannst du mit `qwen3.8-max` die Migrationskette aufbauen, nach der Aufnahme musst du nur das Feld `model` ändern. Den Modellstatus entnimm bitte der Modellliste auf APIYI apiyi.com.
Q5: Wie viel Code muss ich ändern, um von Opus auf Qwen umzusteigen?
Wenn du bereits die OpenAI-kompatible Schnittstelle nutzt: `base_url` auf `https://api.apiyi.com/v1` zeigen lassen, danach nur noch den Modellnamen ändern und bei Bedarf `reasoning_effort` setzen. Nach der Registrierung bei APIYI apiyi.com kannst du mit dem kostenlosen Testguthaben für neue Nutzer erst einmal eine Vergleichsrunde laufen lassen.
Q6: Welche bekannten Einschränkungen hat Qwen4-Max?
Terminal-Arbeit und Whole-Repo-Coding sind die größten Schwächen, beim Diagrammverständnis liegen 12,1 Punkte Rückstand, bei Office-Deliverables ist der Elo 115 Punkte niedriger, und auch die Fähigkeit zur mehrrundigen Selbstverbesserung ist eher schwach. Außerdem sind alle Vergleichswerte Herstellerangaben, es gibt noch keine Reproduktion durch Dritte, und für die Chinesisch-Fähigkeiten fehlen spezifische Benchmark-Daten.
Qwen4-Max im Vergleich zu Opus 5.5: Die wichtigsten Erkenntnisse
- Größte Schwachstelle: 33,5 Punkte weniger bei ProgramBench – für vollständige Repository-Builds und Refactorings weiterhin Opus 5.5 einsetzen.
- Gleichstand: DeepSWE, APEX-Agents und HealthBench sind nahezu gleichauf; diese Aufgaben können bevorzugt auf Qwen4-Max verlagert werden.
- Qwen-Vorteile: Workflow-Automatisierung, biomedizinisches Reasoning, extrem lange Ausgaben mit 393K.
- Preisstruktur: Input 37,5 %, Output 22,5 %; die Anteile der vier Cache-Positionen sind exakt wie bei Opus strukturiert.
- Tatsächlicher Kostenunterschied: Die Standard-Reasoning-Stufe ist high; die Kostenquote bei öffentlichen Leaderboard-Aufgaben liegt im Vergleich zu Opus bei rund 46 %.
- Migrationspfad: Bei APIYI apiyi.com zunächst
qwen3.8-maxüber denselben Endpunkt laufen lassen und nach Verfügbarkeit von Qwen4-Max direkt ersetzen.
Fazit
Die Entscheidung zwischen Qwen4-Max und Opus 5.5 lässt sich in drei Punkten zusammenfassen:
- Terminal und Code-Repositories bleiben bei Opus 5.5: Die Unterschiede bei Terminal-Bench und ProgramBench sind so groß, dass die Preisdifferenz die Nacharbeitskosten nicht aufwiegt.
- Automatisierung und hochparallele Workloads gehen an Qwen4-Max: Bei Aufgaben, bei denen die Leistung gleichauf liegt oder Qwen vorne ist, sind 30 bis 50 % der Rechnung ein reiner Gewinn.
- Nach Aufgaben routen statt pauschal zu ersetzen: Eine einheitliche Schnittstelle und Routing nach Aufgabentyp sind der risikoärmste Migrationsweg.
Wir empfehlen, zunächst bei APIYI apiyi.com mit qwen3.8-max und claude-opus-5-5 einen eigenen Task-Replay durchzuführen und die endgültige Umstiegsentscheidung erst nach Verfügbarkeit von Qwen4-Max zu treffen.
📚 Referenzen
- Qwen4-Max Release-Blog: Modellspezifikationen und offizielle selbstberichtete Benchmarks im Vergleich
- Link:
qwen.ai/blog?id=qwen4-max -
Beschreibung: Enthält Architekturparameter, Kontext- und Ausgabegrenzen sowie Vergleichs-Scores in derselben Grafik
-
Anthropic Modellübersicht: Spezifikationen zu Opus 5.5
- Link:
platform.claude.com/docs/en/about-claude/models/overview.md -
Beschreibung: Kontextfenster, maximale Ausgabe, Standard-Effort und Wissens-Cutoff
-
Anthropic Preisseite: Ein- und Ausgabepreise sowie Cache-Preise für Opus 5.5
- Link:
platform.claude.com/docs/en/about-claude/pricing.md -
Beschreibung: Inklusive Preise für 5-Minuten- und 1-Stunden-Cache-Schreibvorgänge
-
APIYI Modellliste: Aktuelle Preise und verfügbare Modelle auf der Plattform
- Link:
docs.apiyi.com/models - Beschreibung: Vor der Migration Modellverfügbarkeit und Preise prüfen
Autor: APIYI Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI apiyi.com – weitere Integrationsunterlagen finden Sie im Dokumentationszentrum docs.apiyi.com