ملاحظة الكاتب: يتساوى النموذجان في السعر خلال ساعات الذروة، لكن لكل منهما مهام يتقنها أكثر. نستعرض في هذا المقال أربعة جداول للمواصفات والأسعار ونتائج الاختبارات وتوزيع المهام، لتحديد النموذج الأنسب لكل مهمة.
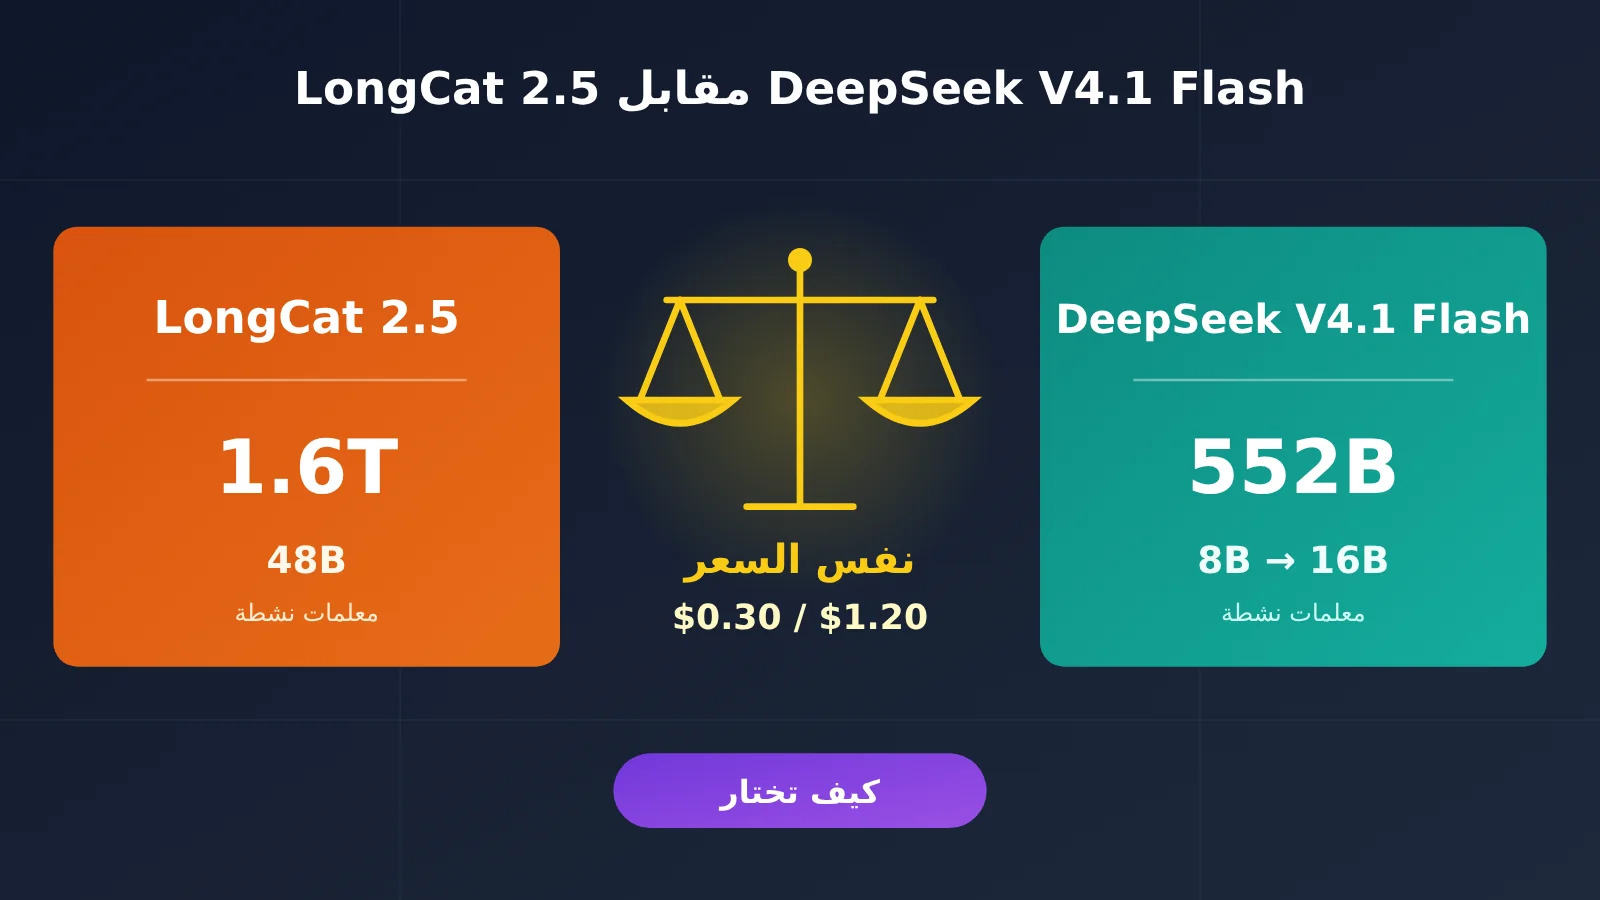
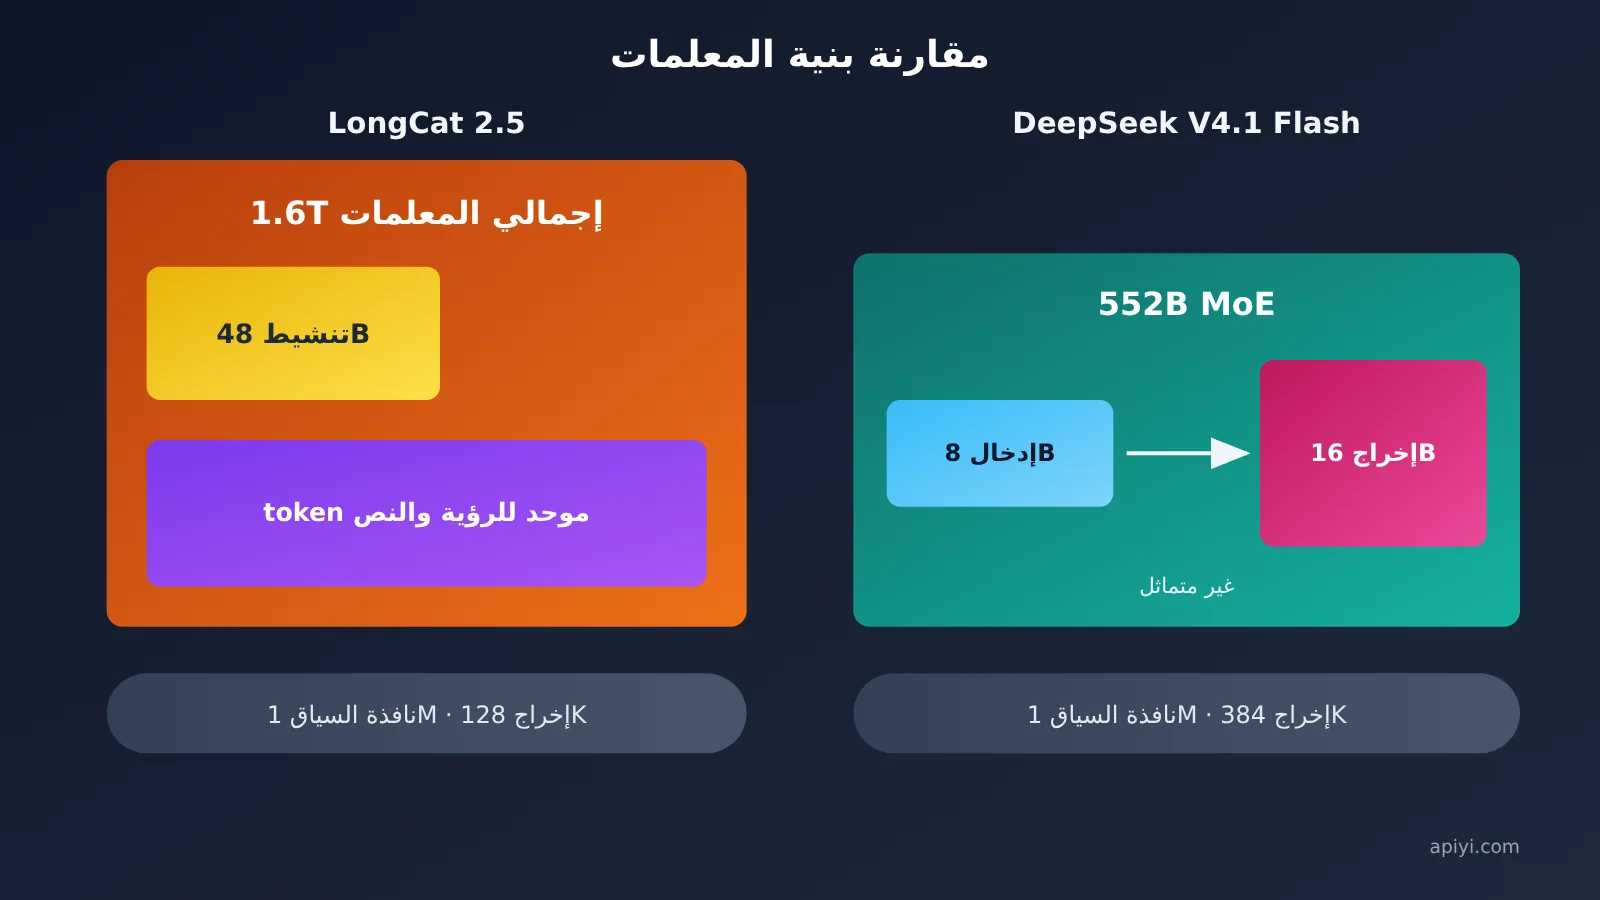
السعر في ساعات الذروة متطابق تمامًا: الإدخال $0.30، والمدخلات المخزنة مؤقتًا $0.006، والإخراج $1.20، لكل مليون رمز (token). الفرق يكمن في المهام التي يتفوق فيها كل نموذج، لذا يعتمد الاختيار على طبيعة عملك. LongCat 2.5 نموذج متعدد الوسائط بطبيعته، يضم 1.6 تريليون معامل إجمالًا، ويُفعّل نحو 48 مليار معامل لكل رمز. أما DeepSeek V4.1 Flash فهو نموذج بمزيج خبراء غير متماثل (MoE)، يضم 552 مليار معامل، ويُفعّل 8 مليارات عند الإدخال و16 مليارًا عند الإخراج، وقد أُتيحت أوزانه كمصدر مفتوح.
هذه ليست مقالة توفيقية تكتفي بالقول إن «لكل نموذج مزاياه». جميع الأرقام أدناه مأخوذة من المدونات الرسمية والتقارير التقنية وصفحات الأسعار الخاصة بالنموذجين. وأجرى كل فريق اختباراته بنفسه، لذلك نستخدم نتائج الأداء للمقارنة المرجعية بين الاختبارات المتماثلة فقط، من دون ترتيب شامل أو ادعاء إجراء اختبارات عملية لم ننفذها.
الفائدة الأساسية: بعد قراءة المقال، ستتمكن من مقارنة مهام مشروعك واحدةً تلو الأخرى، وتحديد النموذج الأساسي والنموذج المكمّل، ثم حساب مقدار التوفير الممكن عند نقل المهام الدفعية إلى ساعات خارج الذروة.
LongCat 2.5 مقابل DeepSeek V4.1 Flash: بطاقة تعريف لكل نموذج
الخلاصة أولًا: يحتوي LongCat 2.5 على عدد أكبر من المعلمات، ويُفعّل عددًا أكبر منها في كل مرة. أما DeepSeek V4.1 Flash فهو أصغر حجمًا، ويُفعّل عددًا أقل من المعلمات، كما يتيح حدًا أعلى للإخراج ويمكن تنزيل أوزانه مباشرة. تبلغ نافذة السياق في كليهما 1M. وتتوقف المفاضلة بينهما أساسًا على ثلاثة عوامل: الحد الأقصى للإخراج، وهو 128K مقابل 384K، وإتاحة الأوزان مفتوحة المصدر، وعدد المعلمات المُفعّلة.
| البُعد | LongCat 2.5 | DeepSeek V4.1 Flash |
|---|---|---|
| إجمالي المعلمات | 1.6T (1.6 تريليون) | 552B |
| المعلمات المُفعّلة | نحو 48B لكل رمز | 8B للإدخال و16B للإخراج |
| البنية | نموذج متعدد الوسائط أصيل موجّه للوكلاء، يعالج الصور والنصوص برموز موحّدة | مزيج الخبراء (MoE)، ببنية Causal-Encoder-Decoder غير متناظرة |
| طول السياق | 1M | 1M |
| الحد الأقصى للإخراج | 128K | 384K |
| الدعم البصري الأصيل | مدعوم، وتُمثَّل الإشارات البصرية برموز منفصلة متعددة المستويات | مدعوم (Vision) |
| إتاحة الأوزان مفتوحة المصدر | لم تُنشر الأوزان؛ وتظهر عبارة «ترقبوا» على GitHub وHuggingFace | مفتوحة المصدر؛ نُشرت الأوزان على HuggingFace مع تقرير تقني |
| التحكم في التفكير | تحققت نتائج التقييم الرسمي مع تفعيل التفكير (thinking) | وضع التفكير مُفعّل افتراضيًا، ويمكن ضبط مستواه عبر reasoning_effort |
أبرز عناصر بنية LongCat 2.5
صُمم LongCat 2.5 بوضوح لمهام الوكلاء طويلة الأمد. وبالمقارنة مع الإصدار 2.0، ركّز على تعزيز فهم الصور الأصلي وبرمجة الوكلاء. في الجانب البصري، تُحوَّل الصور إلى تمثيلات منفصلة بدقتها الأصلية باستخدام SAE+RVQ، ثم تُعالَج مسبقًا خارج وقت التشغيل لتحويلها إلى رموز بصرية، قبل تدريبها مع النموذج الأساسي. ويستخدم النموذج مجموعة الرموز نفسها لمعالجة الصور والنصوص، ولذلك يوصف بأنه متعدد الوسائط أصليًا.
في التدريب، يعتمد LongCat 2.5 بكثافة على بيانات مسارات طويلة الأمد والتعلم المعزز طويل الأمد واسع النطاق. وتذكر المدونة الرسمية عدة تفاصيل: تحويل مسارات فشل الوكلاء الفعليين إلى مهام قابلة للتحقق؛ واستخدام الاستكمال الجزئي للمسارات (partial rollout) في التعلم المعزز غير المتزامن، مع استبعاد مجموعات العينات التي تكون إجاباتها كلها صحيحة أو كلها خاطئة، لأنها تنتج تدرجًا صفريًا؛ وفرض عقوبات على التفكير المتكرر واستدعاءات الأدوات المتكررة. هذه النقطة الأخيرة مهمة لمن يطورون الوكلاء، إذ تقلل دوران النموذج في حلقات استدعاء الأدوات وهدر الرموز.
أما على مستوى هندسة الاستدلال، فمقارنةً بـ W8A8 INT8، يرفع W4A4 معدل معالجة مرحلة التهيئة المسبقة (prefill) بنسبة 43.3%، ومعدل معالجة مرحلة فك الترميز (decode) بنسبة 42.77%، ويخفض زمن إنتاج أول رمز (TTFT) بنسبة 15.91%، والزمن لكل رمز ناتج (TPOT) بنسبة 19.72%. وفي جانب التدريب، يتيح التقسيم المزدوج باستخدام FSDP معدل معالجة للتدريب الخاضع للإشراف (SFT) على التسلسلات الطويلة، لكل بطاقة، أعلى بنسبة 86% من خط الأساس باستخدام DDP. تشير هذه الأرقام إلى أن نموذجًا بحجم 1.6 تريليون قد خضع لضغط مخصص على جانب الخادم، لكن الجهة المطورة لم تعلن حدود معدل الطلبات.
أبرز ملامح بنية DeepSeek V4.1 Flash
يُعد DeepSeek V4.1 Flash أصغر نموذج في سلسلة البنية الجديدة. وتكمن ميزته في عدم التماثل بين المدخلات والمخرجات: فهو يفعّل 8B من المعلمات فقط عند قراءة المدخلات، و16B عند توليد المخرجات. وفي سيناريوهات الوكلاء، تكون المدخلات عادةً أكثر بكثير من المخرجات، كما في قراءة مستودعات الشفرة والسجلات ونتائج الأدوات. ويساعد هذا التصميم على خفض حجم العمليات الحسابية اللازمة للقراءة.
أما من ناحية التكلفة، فالتغيير أكبر. فقد تقلّص حجم ذاكرة KV Cache في الجيل الجديد بشكل كبير، وانخفضت متطلبات ذاكرة HBM إلى ربع ما كانت عليه في الجيل السابق، ومتطلبات SSD إلى الثُمن. وبالمقارنة مع الجيل الأول، تقلّص حجم KV Cache بمقدار 437 مرة إجمالًا. وهناك تغيير آخر جدير بالانتباه: بعد الساعة 12:00 يوم 2026-09-14، ستُوجَّه الطلبات المرسلة إلى deepseek-v4-pro إلى V4.1 Flash، وتُحاسَب وفق سعر Flash، ويستمر هذا الترتيب حتى إطلاق V4.1 Pro. لذا، فإن المشاريع التي لا تزال تستخدم اسم النموذج القديم تستدعي فعليًا نموذج Flash.
مقارنة أسعار LongCat 2.5 وDeepSeek V4.1 Flash: السعر متساوٍ في أوقات الذروة فقط
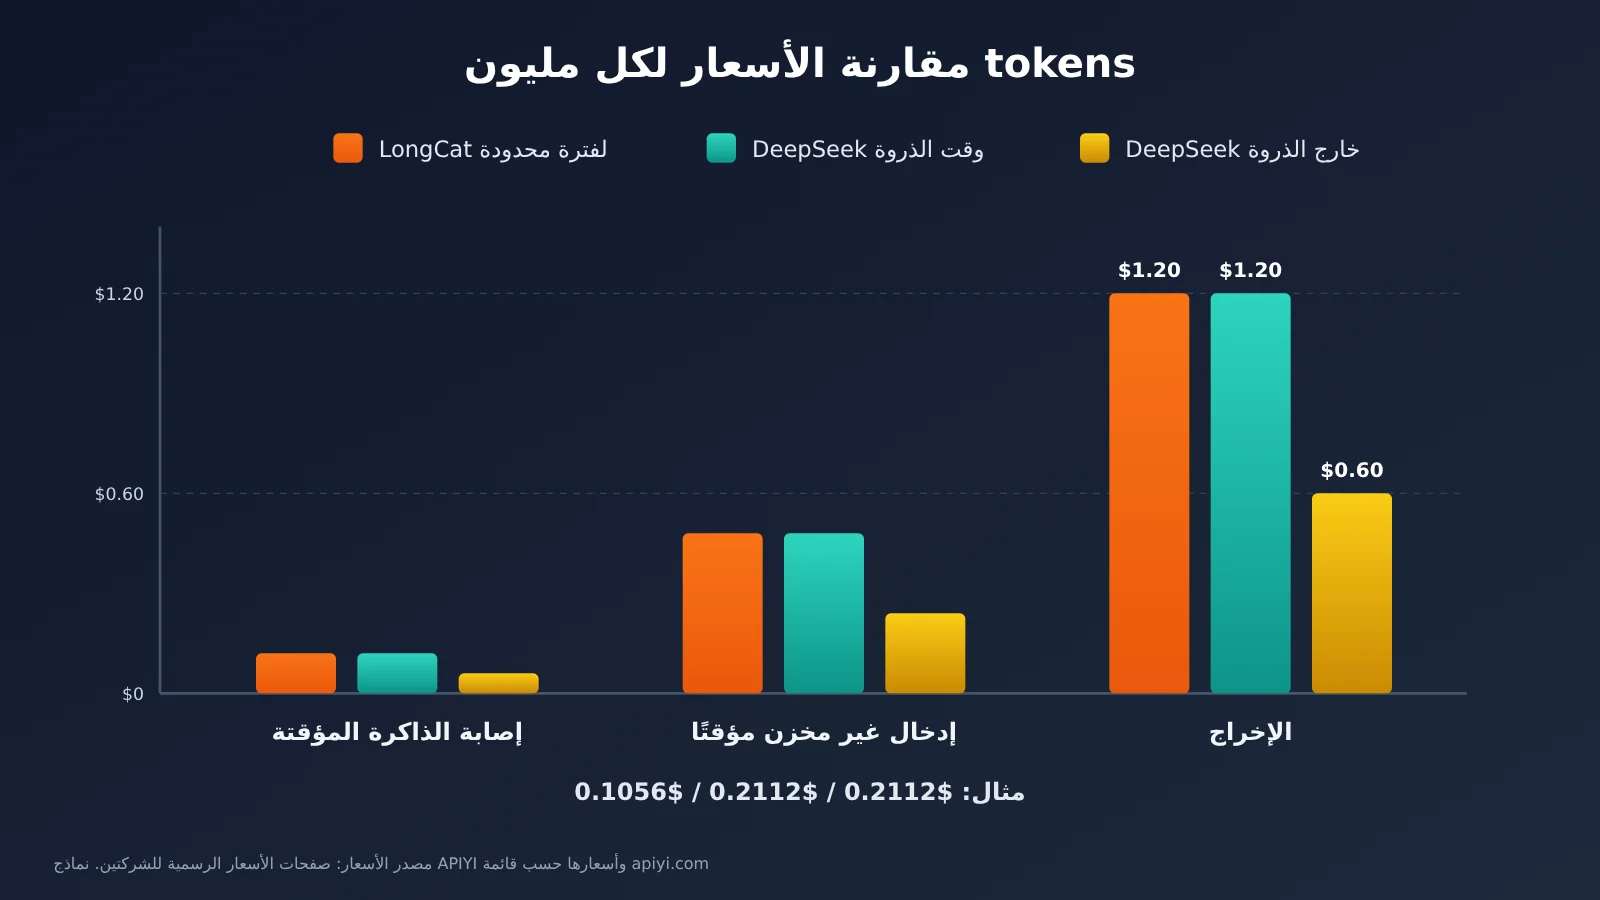
الخلاصة: سعر LongCat 2.5 المخفّض لفترة محدودة يطابق سعر DeepSeek V4.1 Flash في أوقات الذروة في كل بند. أما خارج أوقات الذروة، فيقدّم DeepSeek خصمًا بنسبة 50%، فتكلّف المهمة نفسها نصف المبلغ. لذلك، لا تصح عبارة «السعر نفسه» إلا خلال ساعات الذروة في أيام العمل.
| لكل مليون رمز (بالدولار) | LongCat 2.5 (خصم لفترة محدودة) | DeepSeek في الذروة | DeepSeek خارج الذروة |
|---|---|---|---|
| الإدخال المطابق لذاكرة التخزين المؤقت | $0.006 | $0.006 | $0.003 |
| الإدخال غير المطابق لذاكرة التخزين المؤقت | $0.30 | $0.30 | $0.15 |
| الإخراج | $1.20 | $1.20 | $0.60 |
لنحسب التكلفة. افترض أن مهمة وكيل ذكاء اصطناعي تستهلك 500 ألف رمز إدخال، منها 300 ألف غير مطابقة لذاكرة التخزين المؤقت و200 ألف مطابقة، إضافة إلى 100 ألف رمز إخراج:
- LongCat 2.5 (خصم لفترة محدودة): 0.3×0.30 + 0.2×0.006 + 0.1×1.20 = $0.2112
- DeepSeek في الذروة: الحساب نفسه، $0.2112
- DeepSeek خارج الذروة: 0.3×0.15 + 0.2×0.003 + 0.1×0.60 = $0.1056
الفارق في المهمة الواحدة نحو 10 سنتات، وقد يبدو ضئيلًا. لكن عند تنفيذ 1000 مهمة بالحجم نفسه يوميًا، تبلغ التكلفة $211.2 لكل من LongCat وDeepSeek في وقت الذروة، مقابل $105.6 لـDeepSeek خارج الذروة. وعلى مدار شهر، يصبح الفارق ملحوظًا للفرق التي تنفّذ المهام على دفعات.
تكون أوقات الذروة لدى DeepSeek في أيام العمل من 09:00 إلى 12:00 ومن 14:00 إلى 18:00 بتوقيت بكين، أي من الاثنين إلى الجمعة من 01:00 إلى 04:00 ومن 06:00 إلى 10:00 بتوقيت UTC، باستثناء العطلات الرسمية في الصين. وتُعد بقية الأوقات خارج الذروة بنصف السعر، بما فيها وقت الظهيرة والمساء والفجر في أيام العمل، وطوال أيام عطلة نهاية الأسبوع والعطلات الرسمية. بعبارة أخرى، من أصل 168 ساعة في الأسبوع، لا تشغل الذروة سوى 7 ساعات يوميًا في أيام العمل.
هناك أيضًا بعض التفاصيل الجديرة بالانتباه في فوترة LongCat 2.5:
- لا تُحتسب الرسوم إلا عند استجابة HTTP 200؛ أما الاستجابات 401 و403 و429 و500 فلا تُحتسب عليها رسوم، لذا لا تكلّف محاولات إعادة الإرسال الفاشلة شيئًا.
- باقات الرصيد متاحة للبيع بكميات محدودة يوميًا في 10:00 و16:00 و21:00 و23:00 بتوقيت بكين. صلاحيتها 30 يومًا، ويمكن استرداد المبلغ الكامل للجزء غير المستهلك؛ ولا تُخصم الرموز المطابقة لذاكرة التخزين المؤقت من الباقة.
- الرصيد المجاني: يحصل المستخدمون الجدد على 10 ملايين رمز، والمستخدمون الحاليون على 5 ملايين رمز، تُضاف تلقائيًا. ولا تستهلك الرموز المطابقة لذاكرة التخزين المؤقت من الرصيد المجاني.
- الأسعار المذكورة هي خصم لفترة محدودة، ويجب الرجوع إلى صفحة الأسعار الرسمية لمعرفة أي تعديلات لاحقة.
أما لدى DeepSeek، فتُحتسب رسوم واجهتَي API للبحث عبر الإنترنت وجلب صفحات الويب بشكل منفصل، بسعر $0.75 لكل 1000 طلب ناجح، سواء للبحث أو الجلب. إذا كان وكيلك يتصل بالإنترنت باستمرار، فاحسب هذه التكلفة بشكل منفصل ضمن الميزانية.
💰 تنبيه بشأن التكلفة: إذا استدعيت DeepSeek V4.1 Flash عبر APIYI apiyi.com، فستُحسب التكلفة وفق قائمة النماذج على المنصة، وقد لا تطابق الأسعار الرسمية لأوقات الذروة وخارجها. للحصول على تقدير أدق، شغّل دفعة صغيرة من المهام عبر لوحة تحكم المنصة وراجع الفاتورة قبل اختيار خطة التنفيذ على نطاق واسع.
مقارنة النتائج الرسمية لـ LongCat 2.5 وDeepSeek V4.1 Flash
الخلاصة: يقل الفارق بين النموذجين عن 3 نقاط في معظم معايير تقييم الوكلاء، لذا فهما متقاربان في المستوى إجمالًا. يتقدم LongCat 2.5 في Terminal Bench v4.0 وProgram Bench وJobBench وتوليد المحتوى ثلاثي الأبعاد؛ بينما يتقدم DeepSeek V4.1 Flash في DeepSWE وNL2Repo وAutomationBench، وبفارق أكبر.
| معيار التقييم | LongCat 2.5 | DeepSeek V4.1 Flash |
|---|---|---|
| Terminal Bench v2.1 | 88.4 | 90.6 |
| Terminal Bench v4.0 | 38.5 | 31.2 |
| Program Bench | 25.5 | 20.3 |
| DeepSWE v1.1 | 64.6 | 74.2 |
| NL2Repo | 60.5 | 65.4 |
| BrowseComp | 91.9 | 91.5 |
| HLE w/tools | 63.1 | 63.9 |
| AutomationBench | 51.8 | 54.8 |
| MCP Atlas | 83.1 | 84.4 |
| JobBench | 65.4 | 63.2 |
| 3DCodeBench(تحويل النص إلى محتوى ثلاثي الأبعاد) | 55.4 | 53.3 |
| Vision2Web | 78.6 | 79.2 |
توضيح منهجية التقييم (قراءة ضرورية): الأرقام من اختبارات رسمية أجرتها كل شركة بنفسها. استخدمت LongCat 2.5 إطار الاختبار الخاص بها، مع تفعيل التفكير وضبط temperature=1.0 وtop_p=0.95. أما معظم أرقام DeepSeek فمأخوذة من تقريرها التقني المنشور، باستخدام إطار الاختبار الخاص بها ومستوى الاستدلال Max. تختلف أطر الاختبار وتواريخ التقييم ومستويات الاستدلال بين الطرفين، لذا يصلح الجدول للمقارنة التقريبية بين نموذجين من المستوى نفسه، ولا يمثل ترتيبًا لهما.
كيف نقرأ نتائج الاختبارات؟
أكبر فارقين في النتائج جاءا في اتجاهين متعاكسين. في Terminal Bench v4.0، تفوق LongCat 2.5 على DeepSeek بفارق 7.3 نقاط، مسجلًا 38.5 مقابل 31.2. أما في DeepSWE v1.1، فتفوق DeepSeek بفارق 9.6 نقاط، مسجلًا 74.2 مقابل 64.6. يقيس الاختبار الأول مهام الطرفية الأطول والأكثر صعوبة، بينما يقيس الثاني إصلاح الأخطاء في مستودعات برمجية حقيقية. وهنا تتضح نقاط قوة كل نموذج: أحدهما بارع في عمليات الطرفية متعددة الخطوات، والآخر في إجراء تعديلات دقيقة على قواعد شيفرة قائمة.
في الإصدار الأقدم Terminal Bench v2.1، تفوق DeepSeek بفارق 2.2 نقطة، ما يشير إلى أن أفضلية LongCat تظهر عندما ترتفع الصعوبة. وفي Program Bench، تفوق LongCat بفارق 5.2 نقاط، بينما تفوق DeepSeek في NL2Repo بفارق 4.9 نقاط. يقيس NL2Repo توليد مستودع كامل انطلاقًا من وصف باللغة الطبيعية، وهو أقرب إلى القدرة الهندسية على «بناء مشروع من الصفر».
الفروق في الاختبارات المتعلقة بالرؤية صغيرة. ففي Vision2Web، تفوق DeepSeek بفارق 0.6 نقطة، وفي 3DCodeBench تفوق LongCat بفارق 2.1 نقطة. أما في جدول النتائج الرسمي، فسجل LongCat في CharXiv-RQ w/tools نتيجة 90.2 مقابل 87.7، بينما سجل DeepSeek في MathVision w/tools نتيجة 97.4 مقابل 96.5. وإذا نظرنا إلى الفهم البصري وحده، فالنموذجان متقاربان. وتكمن أفضلية LongCat أساسًا في الجمع بين الفهم البصري وتوليد المحتوى ثلاثي الأبعاد والصفحات التفاعلية. ومن بين العروض التوضيحية الرسمية الثمانية محاكاة للسوائل في الوقت الفعلي، وعرض تفاعلي لقطع أثرية ثلاثية الأبعاد، ونموذج مصغر لمدينة، وأصول لمشاهد مصغرة؛ وهو ما يوضح اتجاه التركيز.
أما في BrowseComp وHLE w/tools وMCP Atlas، فجميع الفروق لا تتجاوز 1.3 نقطة. لذلك يمكن اعتبار النموذجين متعادلين في قدرات الوكيل العامة، مثل البحث عبر الإنترنت واستدعاء أدوات MCP.
مستوى الاستدلال في DeepSeek أداة للتحكم في التكلفة
يقدّم القسم 5.3.3 من التقرير التقني لـ DeepSeek بيانات مفيدة عمليًا. عند رفع مستوى جهد الاستدلال من 25 إلى 100، ارتفع متوسط Pass@1 عبر 8 اختبارات معيارية للاستدلال من 67.1% إلى 76.3%، وارتفعت نتيجة DeepSWE v1.1 من 66.0 إلى 74.2، مقابل زيادة رموز الإخراج إلى نحو 2.5 ضعف.
المستوى 60–80 يقترب بالفعل من دقة المستوى الأقصى، فيما يستهلك أقل من نصف ميزانية الرموز اللازمة له. أما رفع المستوى إلى 100 فيزيد طول مسار عمل الوكيل بمقدار إضافي يتراوح بين 1.6 و1.8 ضعف، مقابل تحسّن هامشي فقط.
انتبه أيضًا إلى أن القيمة الافتراضية لـ reasoning_effort في واجهة DeepSeek API هي high، بينما تحققت النتائج الرسمية على مستوى Max. ولإعادة إنتاج الدرجات الواردة في عمود DeepSeek في الجدول أعلاه، يجب ضبط القيمة صراحةً على max. استخدم المستوى المتوسط للمهام اليومية، واحتفظ بالمستوى الأقصى للمهام الأصعب. تُعد رموز الإخراج البند الأعلى تكلفة في فواتير الشركتين ($1.20)، لذا يؤثر اختيار هذا المستوى مباشرةً في تكلفة الاستخدام.
LongCat 2.5 مقابل DeepSeek V4.1 Flash: كيف توزّع المهام بينهما؟
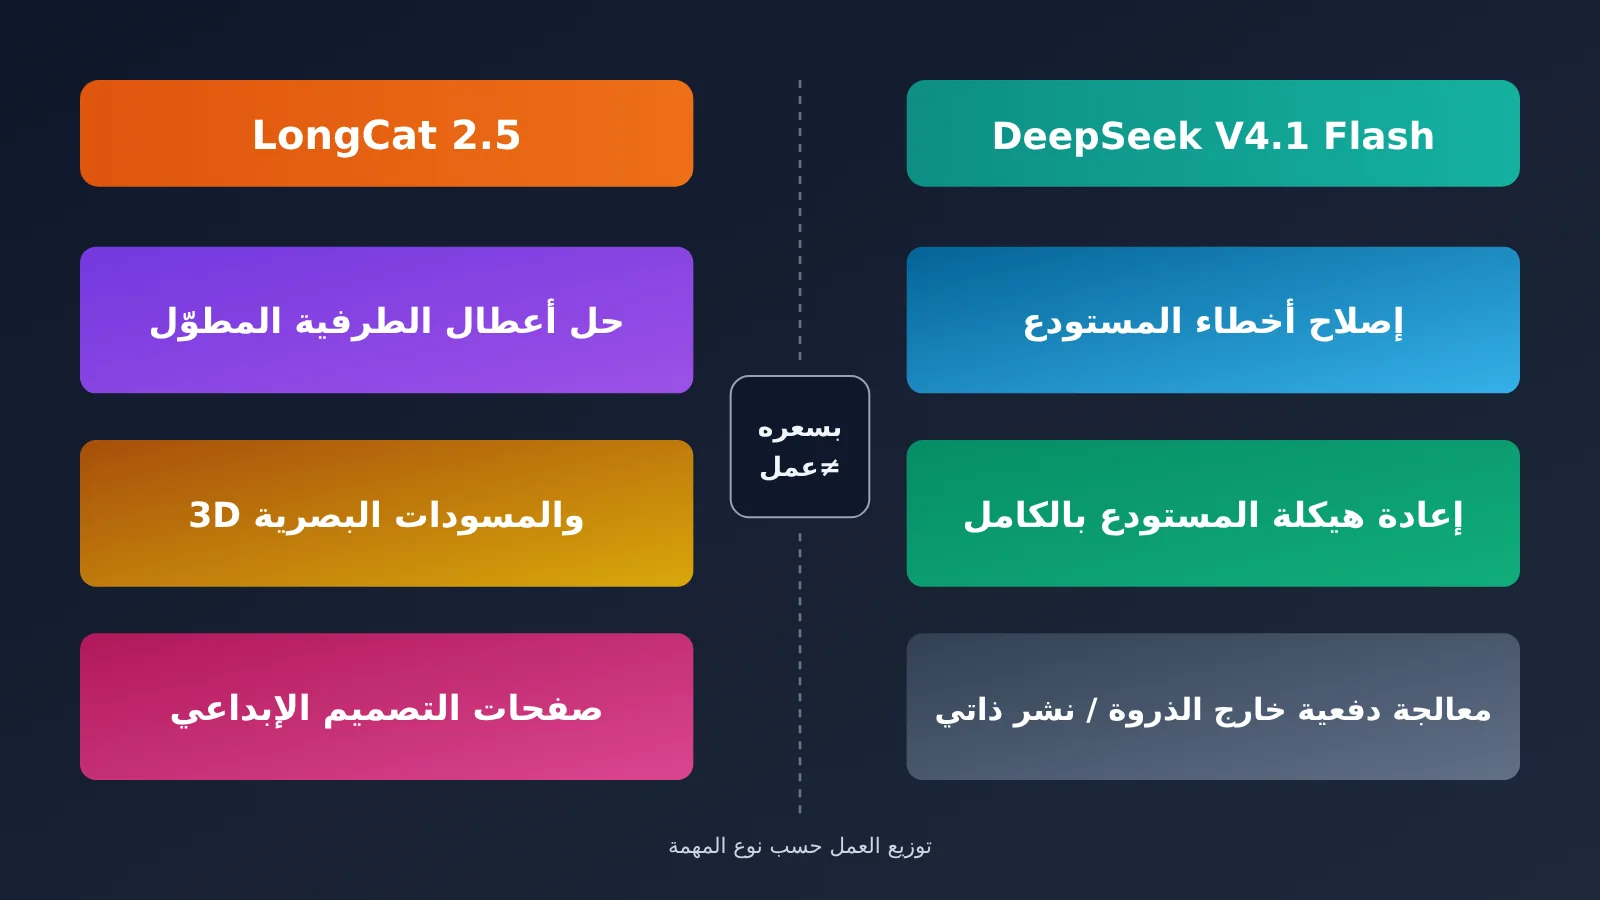
الخلاصة: السعر نفسه، لكن لكل نموذج مهامه. اختر LongCat 2.5 لمهام الطرفية الطويلة والتصميم المرئي وثلاثي الأبعاد وصفحات التصميم الإبداعية؛ واختر DeepSeek V4.1 Flash لتعديل الشفرة في المستودعات الفعلية وإصلاح الأخطاء وأتمتة سير العمل والسيناريوهات التي تتطلب النشر الذاتي.
| أكثر ملاءمة لـ LongCat 2.5 | أكثر ملاءمة لـ DeepSeek V4.1 Flash |
|---|---|
| استكشاف أخطاء الطرفية على مراحل طويلة: تسجيل الدخول إلى الخادم، وفحص السجلات، وتعديل الإعدادات، وإعادة التشغيل للتحقق (أعلى بـ 7.3 نقاط في Terminal Bench v4.0) | إصلاح الأخطاء في المستودعات الفعلية: قراءة وصف المشكلة، وتحديد الملف، وإجراء التعديلات واجتياز الاختبارات (أعلى بـ 9.6 نقاط في DeepSWE) |
| الأصول ثلاثية الأبعاد والتصميمات المرئية: توليد مشاهد ثلاثية الأبعاد من النص وصفحات عرض تفاعلية (55.4 في 3DCodeBench) | إعادة هيكلة مستودع كامل وإنشاء مستودع من الصفر: توليد مشروع متعدد الملفات بناءً على وصف المتطلبات (أعلى بـ 4.9 نقاط في NL2Repo) |
| صفحات التصميم الإبداعية: دعوات الفعاليات وصفحات الألوان المنسّقة وتقارير تصور البيانات (من مجالات العرض الرسمية) | أتمتة سير العمل والمعالجة المجمّعة: المعالجة الليلية وتنظيف البيانات وإنشاء التقارير (أعلى بـ 3.0 نقاط في AutomationBench، ونصف السعر خارج أوقات الذروة) |
| بناء البرامج على نمط مسائل البرمجة والمهام المهنية الشاملة (متقدم في Program Bench وJobBench) | الحاجة إلى النشر الذاتي أو الخاص: الأوزان متاحة كمصدر مفتوح على HuggingFace؛ ومخرجات طويلة في طلب واحد (حتى 384K) |
لماذا تختار LongCat 2.5؟
أكثر ما يميز LongCat 2.5 هو أداؤه في Terminal Bench. ففي الإصدار v2.1 كان متأخرًا بـ2.2 نقطة، لكنه تصدّر في v4.0 بفارق 7.3 نقاط، ما يشير إلى أن أفضليته النسبية تزداد كلما طالت المهمة وصعبت. ويتوافق ذلك مع تدريبه المكثف على مسارات مهام طويلة، وفرض عقوبات على استدعاءات الأدوات المتكررة. إذا كان وكيلك ينفّذ عشرات الخطوات المتتالية في الطرفية، فقد يستحق LongCat 2.5 أن تجرّبه أولًا.
السبب الثاني هو المهام التي تجمع بين الفهم البصري والتوليد. فدعمه الأصلي للوسائط المتعددة وتدريبه على مهام النمذجة ثلاثية الأبعاد والصفحات التفاعلية يجعلان منه خيارًا أنسب لمهام مثل إنشاء تصميم انطلاقًا من صورة أو توليد مجسم ثلاثي الأبعاد من وصف نصي. كما يحصل المستخدمون الجدد على 10 ملايين token مجانًا، ولا يُخصم استخدام ذاكرة التخزين المؤقت من الرصيد المجاني، ما يجعل تكلفة التجربة الأولية منخفضة.
لماذا تختار DeepSeek V4.1 Flash؟
أبرز رقم لصالح DeepSeek V4.1 Flash هو نتيجته البالغة 74.2 في DeepSWE، وهو أكبر فارق ضمن الاختبارات المشتركة بين النموذجين. ومن أكثر مهام البرمجة اليومية شيوعًا تعديل التعليمات البرمجية في مستودع موجود، وهذا تحديدًا من نقاط قوته. ويبلغ الحد الأقصى للمخرجات 384K، أي ثلاثة أضعاف الحد لدى LongCat، ما يقلل احتمال اقتطاع المخرجات عند توليد ملفات طويلة أو تعديلات برمجية كبيرة.
السبب الثالث هو هيكل التكلفة. فالسعر ينخفض إلى النصف خارج أوقات الذروة، ومع إمكانية ضبط مستوى الاستدلال، تمنح هاتان الميزتان معًا مرونة أكبر بكثير في تكلفة المهام الدفعية مقارنة بسعر LongCat الثابت لفترة محدودة. وتذكر الوثائق الرسمية أيضًا أن الحد الأقصى للطلبات المتزامنة هو 2500، ما يوفر رقمًا واضحًا يمكن الاعتماد عليه عند التخطيط لمعدل معالجة الطلبات. ويمكن للفرق التي تحتاج إلى نشر خاص تنزيل أوزان النموذج مباشرة، لكن التوضيح الرسمي يشير إلى أن النشر واسع النطاق يتطلب موارد في حدود 2000 بطاقة GPU، لذا ينبغي للفرق الصغيرة تقييم العتاد قبل النشر الذاتي.
💡 نصيحة للاختيار: الجدول يساعدك على تضييق الخيارات فقط، أما القرار النهائي فيعتمد على مهامك. اختر من مشروعك 10 إلى 20 مهمة تمثيلية، وشغّلها على النموذجين، ثم قارن معدل النجاح واستهلاك الـtoken. ولتجربة DeepSeek V4.1 Flash، يمكنك البدء بالوصول إليه عبر APIYI على apiyi.com، دون الحاجة إلى إنشاء حساب منفصل.
كيفية دمج LongCat 2.5 وDeepSeek V4.1 Flash
الخلاصة: يدعم كلا النموذجين تنسيقي واجهة API الخاصين بـ OpenAI وAnthropic. ولربط أي منهما بـ Claude Code، يكفي تعديل بضعة متغيرات بيئة في ~/.claude/settings.json. كما يدعم DeepSeek واجهة Responses API.
دمج LongCat 2.5
- تنسيق OpenAI (أي مكتبة OpenAI SDK): اضبط
base_urlعلىhttps://api.longcat.ai/openai، واسم النموذج علىLongCat-2.5. - تنسيق Anthropic (مكتبة Anthropic SDK): اضبط
base_urlعلىhttps://api.longcat.ai/anthropic. - Claude Code (عدّل حقل
envفي~/.claude/settings.json): يجب ضبط المتغيرات الأربعة: - اضبط
ANTHROPIC_AUTH_TOKENعلى مفتاح LongCat الخاص بك - اضبط
ANTHROPIC_BASE_URLعلىhttps://api.longcat.ai/anthropic - اضبط
ANTHROPIC_MODELعلىLongCat-2.5 - اضبط
CLAUDE_CODE_MAX_OUTPUT_TOKENSعلى131072 - التعامل مع حدود معدل الطلبات (في شفرة الاستدعاء الخاصة بك): عند تجاوز الحد، تُعاد الاستجابة 429 (
rate_limit_exceeded، وretry_afterبقيمة 60)، وتوصي الجهة الرسمية بالتراجع الأسي. لا تذكر الوثائق أرقام RPM أو TPM، ولا تُحتسب رسوم على الاستجابة 429.
دمج DeepSeek V4.1 Flash
- تنسيق OpenAI (أي مكتبة OpenAI SDK): اضبط اسم النموذج على
deepseek-flash. لا يزال الاسمان القديمانdeepseek-v4-flashوdeepseek-v4-flash-vision-expصالحين للاستخدام؛ وتُوجّه طلباتهما إلى V4.1-Flash-1017 وتُحتسب بسعر Flash. - Claude Code (عدّل حقل
envفي~/.claude/settings.json): - اضبط
ANTHROPIC_AUTH_TOKENعلى مفتاح DeepSeek الخاص بك - اضبط
ANTHROPIC_BASE_URLعلىhttps://api.deepseek.com/anthropic - اضبط
ANTHROPIC_MODELعلىdeepseek-flash - مستوى الاستدلال (ضمن معلمات طلب OpenAI SDK): اضبط
reasoning_effortعلى المستوى المتوسط للمهام اليومية، واستخدمmaxللمسائل الصعبة. - أدوات جاهزة: WorkBuddy، بما فيها CodeBuddy، وOpenCode أدوات شريكة رسمية تدعم النموذج بالكامل.
استدعاء النماذج عبر APIYI من مكان واحد
إذا كنت تريد تشغيل عدة نماذج للمقارنة بينها، فيكفيك حساب واحد ومفتاح API واحد على APIYI للتبديل بينها، دون الحاجة إلى إنشاء حساب منفصل لدى كل مزود.
- إعداد OpenAI SDK (في شفرة مشروعك): اضبط
base_urlعلىhttps://api.apiyi.com/v1، وapi_keyعلى المفتاح الذي تنشئه من لوحة تحكم APIYI. - اسم النموذج (للتبديل ضمن معلمة الطلب نفسها): استخدم
deepseek-v4.1-flashأوdeepseek-v4.1-flash-1017لـ DeepSeek V4.1 Flash، وتُحتسب الرسوم وفق قائمة نماذج المنصة. - اختبار المقارنة (بالشفرة نفسها): غيّر معلمة
modelفقط لتشغيل مجموعة المهام نفسها على نماذج المنصة الأخرى ومقارنة النتائج، مع إبقاءbase_urlعلىhttps://api.apiyi.com/v1.
تعتمد النماذج والأسعار على قائمة نماذج المنصة. لم يُتح LongCat-2.5 على APIYI بعد، ومن المقرر طرحه قريبًا. حتى ذلك الحين، استخدم نقطة الاتصال الرسمية لـ LongCat 2.5، ويمكنك إدارة DeepSeek عبر APIYI على apiyi.com.
🚀 ابدأ بسرعة: يحصل المستخدمون الجدد على رصيد مجاني للاختبار عند التسجيل في APIYI على apiyi.com. ابدأ بدمج DeepSeek V4.1 Flash في مشروع OpenAI SDK الحالي؛ يكفي تغيير سطر
base_urlلتشغيله.
الأسئلة الشائعة حول مقارنة LongCat 2.5 وDeepSeek V4.1 Flash
س1: هل الأسعار متساوية حقًا؟
تتساوى الأسعار فقط خلال أوقات الذروة لدى DeepSeek. سعر LongCat 2.5 المخفّض لفترة محدودة هو $0.30 / $0.006 / $1.20، وهو مطابق لسعر DeepSeek في أوقات الذروة لكل بند. أما خارج أوقات الذروة، فتُخفّض أسعار DeepSeek جميعها بنسبة 50%، وتشمل هذه الأوقات كل ما عدا فترتَي 09:00-12:00 و14:00-18:00 في أيام العمل. كذلك فإن سعر LongCat مخفّض لفترة محدودة وقد يتغير لاحقًا.
س2: هل يوضح جدول الاختبارات أي النموذجين أقوى؟
لا يمكن ترتيب النموذجين مباشرةً بناءً عليه. فالنتائج صادرة عن اختبارات أجرتها كل شركة بنفسها، وتختلف بيئات الاختبار وتواريخه ومستويات الاستدلال، كما أن نتائج DeepSeek المعروضة هي لمستوى Max. من الأفضل النظر إلى الاختبارات التي يظهر فيها فارق كبير: يتقدم LongCat بمقدار 7.3 نقاط في Terminal Bench v4.0، بينما يتقدم DeepSeek بمقدار 9.6 نقاط في DeepSWE. أما الفروق التي لا تتجاوز نقطة أو نقطتين، فيمكن اعتبارها تعادلًا.
س3: متى سيصبح LongCat 2.5 مفتوح المصدر؟
لم تعلن الشركة جدولًا زمنيًا. حاليًا، تظهر عبارة «ترقبوا المزيد» على كل من GitHub وHuggingFace، ولم تُنشر الأوزان بعد. بالنسبة إلى المشاريع التي تتطلب النشر الذاتي، لا يتوفر حاليًا سوى DeepSeek V4.1 Flash، إذ نُشرت أوزانه وتقريره التقني.
س4: هل يمكن استدعاء النموذجين عبر APIYI؟
حاليًا، يمكن استدعاء DeepSeek V4.1 Flash فقط، باسمَي النموذج `deepseek-v4.1-flash` و`deepseek-v4.1-flash-1017`، وفق أسعار قائمة النماذج على المنصة. لم تضف APIYI نموذج LongCat-2.5 بعد، لكنها ستوفره في أقرب وقت. تُعتمد أسماء النماذج وأسعارها وفق القائمة على منصة APIYI عبر apiyi.com.
س5: كيف يمكن خفض تكلفة المهام المجمّعة؟
عند استخدام DeepSeek، استفد من خيارين معًا: أولًا، جدولة المهام خارج أوقات الذروة لخفض سعر الوحدة إلى النصف؛ وثانيًا، ضبط reasoning_effort على مستوى متوسط. يوضح التقرير أن المستوى 60-80 يقترب من دقة المستوى الأقصى، مع ميزانية رموز أقل من نصف ميزانيته. كما أن سعر الاستفادة من ذاكرة التخزين المؤقت لا يتجاوز 1/50 من السعر عند عدم الاستفادة منها. ويمكن تحسين معدل الاستفادة بوضع موجه النظام الثابت وتعريفات الأدوات في بداية الطلب.
الخلاصة: كيف تختار بين LongCat 2.5 وDeepSeek V4.1 Flash؟
الخلاصة واضحة: السعر متشابه، لكن لكل نموذج نقاط قوته. وزّع المهام بينهما، وشغّل المهام الدفعية خارج أوقات الذروة.
- الحجم: يبلغ حجم LongCat 1.6T مع تفعيل 48B، مقابل 552B في DeepSeek مع تفعيل 8B للإدخال و16B للإخراج. ونافذة السياق في كليهما 1M.
- الحد الأقصى للإخراج: يدعم LongCat حتى 128K، وDeepSeek حتى 384K. اختر DeepSeek للمهام التي تتطلب مخرجات طويلة.
- السعر: سعر LongCat لفترة محدودة يساوي سعر DeepSeek في أوقات الذروة؛ وسعر DeepSeek خارج الذروة هو النصف. في المثال الحسابي: $0.2112 مقابل $0.1056.
- نتائج الاختبارات: يتقدم LongCat بمقدار 7.3 نقاط في المهام الطويلة عبر الطرفية، بينما يتقدم DeepSeek بمقدار 9.6 نقاط في إصلاح الأخطاء داخل مستودعات الشفرة. ويتعادلان في معظم الاختبارات الأخرى.
- المصدر المفتوح: DeepSeek مفتوح المصدر، بينما لم يُتح LongCat أوزان النموذج.
- التكامل: يدعم كلاهما تنسيقي OpenAI وAnthropic، ويمكن التبديل في Claude Code بتغيير متغيرات البيئة فقط.
الخلاصة العملية: اختر نموذجًا أساسيًا وفقًا لجدول توزيع المهام، واستخدم الآخر عند الحاجة؛ وحاول تشغيل المهام الدفعية خارج أوقات الذروة. بالنسبة إلى DeepSeek V4.1 Flash، يمكنك استخدام APIYI على apiyi.com لاختباره على نطاق صغير عبر واجهة موحدة، ثم تحديد النموذج الأساسي.
📚 المراجع
- مدونة LongCat-2.5 الرسمية: مكانة النموذج وبنيته وتفاصيل التدريب والجوانب الهندسية
- الرابط:
longcat.ai/blog/longcat-2.5 -
التفاصيل: حجم المعلمات، وآلية التعامل مع الرموز البصرية، وبيانات الاستدلال بتقنية W4A4، وجداول التقييم الرسمية
-
وثائق منصة LongCat المفتوحة: الأسعار ونقاط النهاية والتكامل مع Claude Code
- الرابط:
longcat.ai/platform/docs -
التفاصيل: الأسعار المخفضة لفترة محدودة، والتعامل مع الخطأ 429، وباقات الرصيد وقواعد الرصيد المجاني
-
إعلان إطلاق DeepSeek V4.1 Flash: البنية والمصدر المفتوح وتغييرات API
- الرابط:
deepseek.com/news/deepseek-v4-1-flash -
التفاصيل: بنية MoE غير المتماثلة، وضغط KV Cache، وإرشادات الانتقال إلى اسم النموذج الجديد
-
صفحة أسعار DeepSeek API: أسعار أوقات الذروة وخارجها وحدود التزامن
- الرابط:
api-docs.deepseek.com/quick_start/pricing -
التفاصيل: تعريف فترات الذروة وخارجها، وحد التزامن البالغ 2500، والفوترة المستقلة للبحث وجلب المحتوى
-
مستودع أوزان DeepSeek-V4.1-Flash: الأوزان مفتوحة المصدر والتقرير التقني
- الرابط:
huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash - التفاصيل: نتائج الاختبارات في الجدول 3 وتحليل مستويات الاستدلال في القسم 5.3.3
الكاتب: الفريق التقني في APIYI
التواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لـ APIYI على apiyi.com، ولمزيد من موارد التكامل يمكنكم زيارة مركز الوثائق على docs.apiyi.com