ملاحظة المؤلف: نحلّل كيف توصّل Claude إلى مصدر بذور منحنيات NIST الإهليلجية، ونوضح حدود هذا الاستنتاج، ثم نقدم 3 استخدامات لوكلاء الذكاء الاصطناعي يمكن للباحثين تطبيقها مباشرة، مع الشيفرة وطرق ضبط التكاليف.
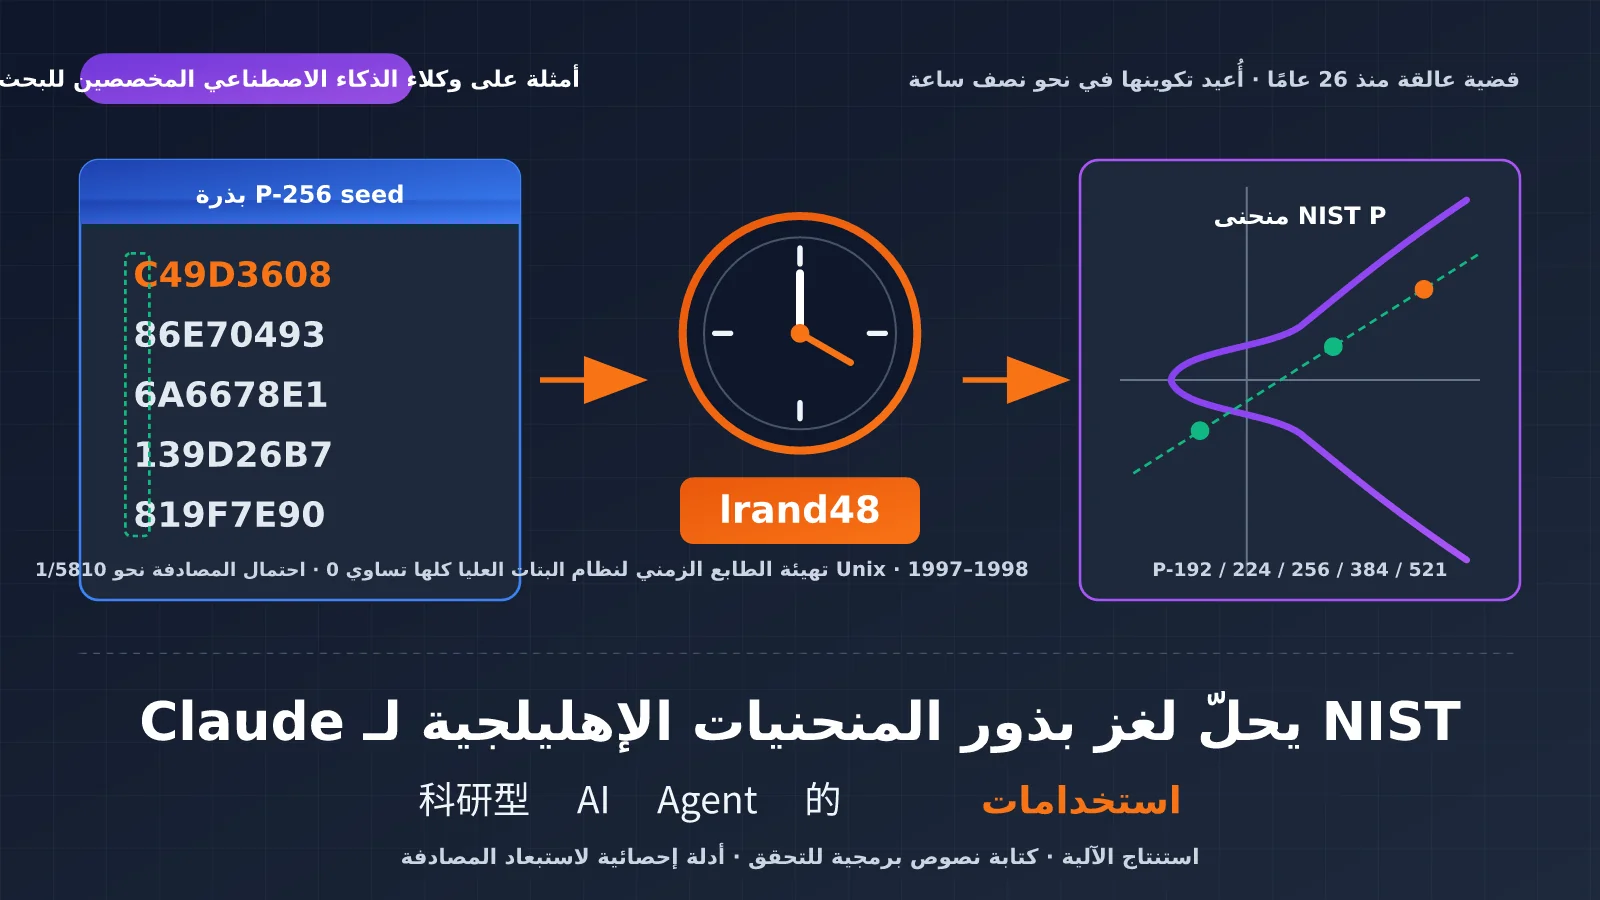
في 17 أكتوبر 2026، نشر فريق Anthropic Frontier Red Team دراسة أفادت بأن نموذجًا بحثيًا داخليًا استنتج، من دون أي توجيه، كيفية توليد بذور المنحنيات الخمسة NIST P-192 وP-224 وP-256 وP-384 وP-521 في غضون نحو نصف ساعة. لم تُمرر هذه البذور عبر أي خوارزمية تجزئة؛ بل كانت مخرجات مولّد الأرقام شبه العشوائية lrand48 المضمّن في مكتبات C منذ تسعينيات القرن الماضي، وقد استُخدمت طوابع زمن Unix قيمًا ابتدائية له. ولم يتضمن المنشور الرسمي لحساب @AnthropicAI سوى عبارة واحدة: «إنها مجرد طوابع زمنية». وقد حصد نحو 855 ألف مشاهدة.
هذا ليس اختراقًا للتشفير ولا ثغرة جديدة. تكمن أهمية هذه الحالة للباحثين في طريقة عمل Claude: استنباط الآلية، وكتابة شيفرة للتحقق منها، واستخدام الأدلة الإحصائية لاستبعاد المصادفة. ويمكن تطبيق هذا المسار مباشرة على أبحاثك.
الفائدة الأساسية: بعد قراءة هذا المقال، ستعرف ما الذي تثبته هذه الحالة وما الذي لا تثبته، وستحصل على 3 مسارات عمل لوكلاء ذكاء اصطناعي بحثية يمكنك استخدامها فورًا، مع خطوات تنفيذ وشيفرة قابلة للتشغيل لكل منها.
كيف كشف Claude سرّ بذور منحنيات NIST الإهليلجية: أبرز النقاط
| النقطة | التوضيح | أهميتها للباحثين |
|---|---|---|
| خلفية اللغز | اعتمدت NIST خوارزمية ECDSA في المعيار FIPS 186-2 عام 2000. وقدّمت NSA بذور المنحنيات من دون توضيح مصدرها | مسألة استعصت على الحل 26 عامًا، ويمكن أن تكون اختبارًا لقدرات الذكاء الاصطناعي على الاستدلال |
| الخلاصة | جاءت البذور من مخرجات lrand48، بعد تهيئته بطابع زمني يقع بين مايو 1997 وأبريل 1998 |
يمكن لأي شخص إعادة إنتاج النتيجة والتحقق منها، بتكلفة منخفضة |
| المنهج الأساسي | استنتاج طريقة كتابة البرنامج، ثم بناء أداة مسح خاصة، وتحديد النمط باستخدام الخصائص الإحصائية، ثم استعادة الحالة | يمكن تطبيق هذه الخطوات على مهام مثل تحليل البيانات التجريبية والنمذجة العكسية |
| الدلالات الأمنية | لا يشكل هذا ثغرة، ولا حاجة إلى تغيير الإعدادات أو الانتقال إلى إعدادات أخرى | ينبغي وصف النتيجة بدقة عند الاستشهاد بها في مراجعة أو تقرير، من دون مبالغة |
| مسائل عالقة | لم يُكشف عن بذرة B-163، وما تزال طريقة إنشاء نقطة الأساس G للمنحنيات من P-224 إلى P-521 غير واضحة | لنتائج الذكاء الاصطناعي حدود أيضًا، وينبغي توثيق المسائل التي لم تُحل |
سرّ بذور منحنيات NIST الإهليلجية: ما الذي تثبته هذه الحادثة؟
ينشر معيار ECDSA بذرة لكل منحنى، ويُستخدم تجزؤ البذرة لتحديد معامل المنحنى b. وبذرة P-256 هي C49D3608 86E70493 6A6678E1 139D26B7 819F7E90. ولأن مصدرها لم يُوضَّح قط، ظل المجتمع يخشى أن تكون NSA قد اختارت عمدًا معلمات تنطوي على نقاط ضعف. وقد كتب Koblitz وMenezes مراجعة بعنوان «A Riddle Wrapped in an Enigma»، كما رصد Filippo Valsorda مكافأة قدرها 36864 دولارًا لحل اللغز. وشاع لفترة أن Jerry Solinas أنشأ البذور باستخدام تجزئة جملة مازحة، لكن ثبت لاحقًا أن هذا الادعاء غير صحيح.
تتمثل الفائدة العملية لهذه النتيجة في أنها تعزز الثقة بهذه المنحنيات. فقد أُنشئت البذور باستخدام مولّد أرقام شبه عشوائية عادي، جرى تهيئته بالساعة، ولم يترك ذلك مجالًا للاختيار البشري المتعمد؛ ويمكن لأي شخص إعادة إنتاج النتيجة. ويشير النص الأصلي أيضًا إلى تجاوز عدد قليل من المنحنيات المرشحة الصالحة للاستخدام، من دون معرفة السبب، لكن عددها ضئيل ولا يوحي بأن الهدف كان اختيار منحنيات ضعيفة. وستُتبرع أموال المكافأة إلى Internet Security Research Group.
عند الاستشهاد بهذه الحادثة في ورقة بحثية أو اجتماع مجموعة بحثية، يمكن صياغة الخلاصة بدقة على النحو الآتي: «أعاد الذكاء الاصطناعي بناء طريقة إنشاء معلمة تاريخية، وجعل إعادة إنتاجها ممكنة». ولا تكتبوا: «اخترق الذكاء الاصطناعي المنحنيات الإهليلجية».
تفصيل خطوات Claude الأربع لاستنتاج البذور
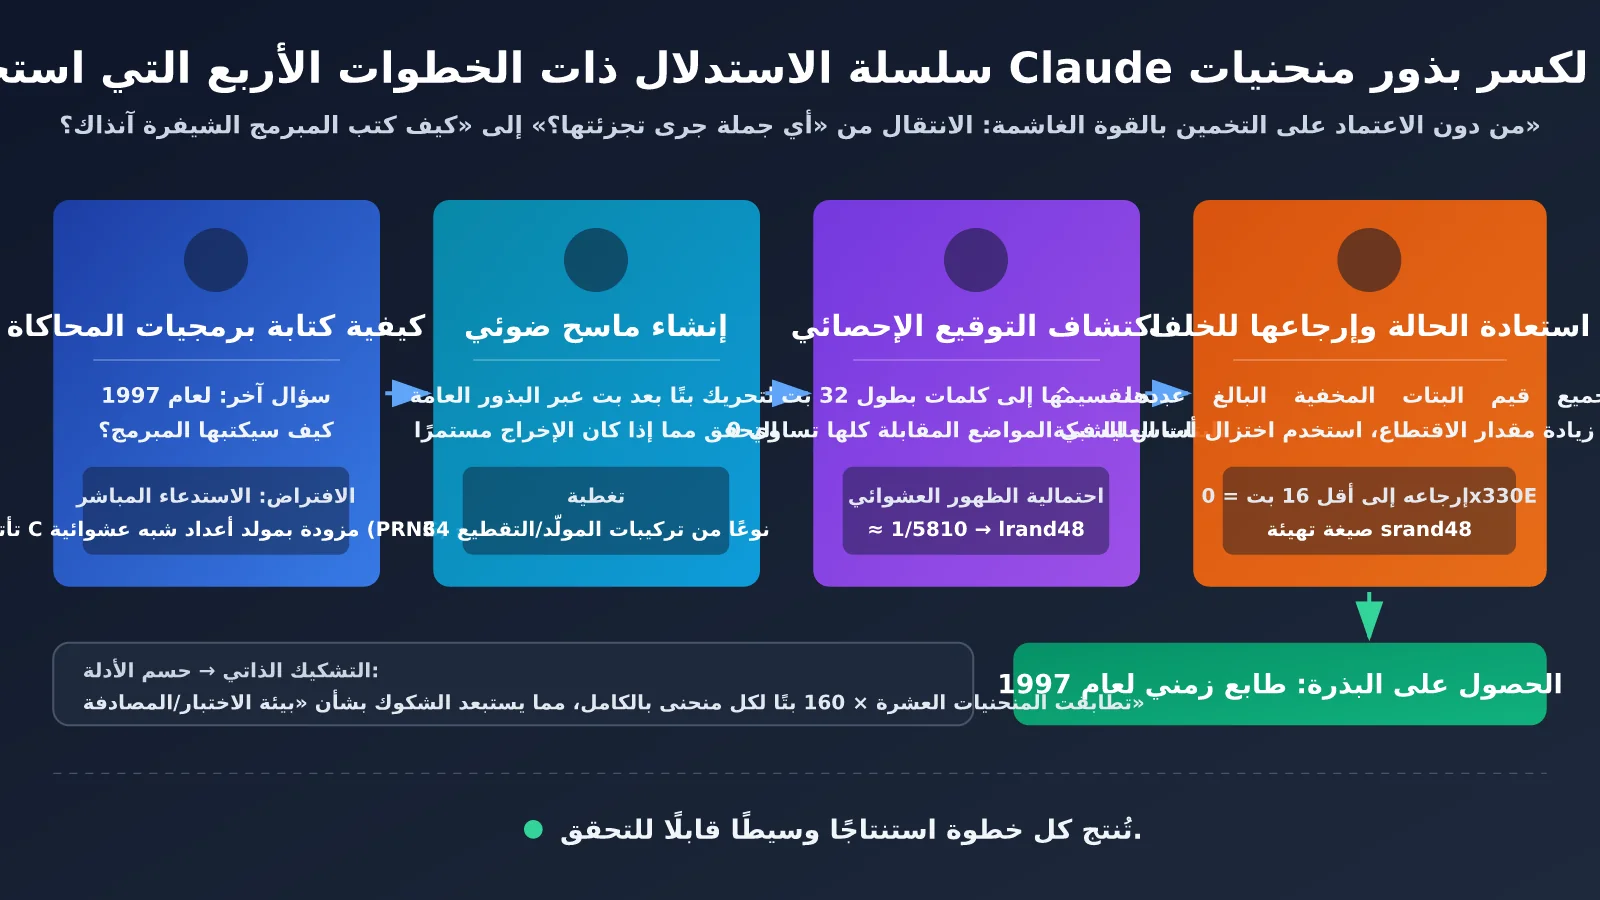
لم يعتمد الاستدلال هذه المرة على التخمين العشوائي، بل اتبع سلسلة استدلال يمكن التحقق من كل خطوة فيها:
- إعادة صياغة السؤال: بدلًا من تخمين «أي جملة جرى تجزئتها؟»، جرى استنتاج الطريقة الأرجح التي كان سيكتب بها مبرمجو إنشاء المنحنيات عام 1997. وخلص التحليل إلى أنهم على الأرجح استخدموا مولّد الأرقام العشوائية المضمّن في مكتبة C.
- كتابة أداة مسح: تحريك نافذة بتًا بتًا عبر البذور المنشورة، واختبار ما إذا كانت المقاطع المتجاورة تشبه مخرجات متتالية لمولّد من مولّدات تسعينيات القرن الماضي. وشمل الفحص 34 توليفة من المولّدات والمقاطع.
- البحث عن بصمة إحصائية: بعد تقسيم البذور إلى كلمات من 32 بتًا، تبيّن أن البتات العليا في المواضع المقابلة كلها أصفار. واحتمال ظهور ذلك عشوائيًا يبلغ نحو 1/5810. ويتوافق هذا مع خاصية
lrand48التي لا تُرجع إلا أعلى 31 بتًا من حالة ذات 48 بتًا. - استعادة الحالة وإرجاعها إلى الوراء: تجربة الاحتمالات الـ 2^17 للبتات السبعة عشر المخفية، ثم التحقق باستخدام الكلمات اللاحقة. وبالنسبة إلى البذور التي تفتقد مزيدًا من البتات، استُخدم تقليل أساس الشبكة بخوارزمية LLL لإيجاد الحل. بعد ذلك، أُرجعت الحالة إلى الوراء حتى ظهرت هيئة التهيئة الخاصة بـ
srand48، أي أن قيمة البتات الستة عشر الدنيا تساوي 0x330E.
ومن التفاصيل اللافتة خلال الاستدلال أن النموذج شكّ للحظة في ما إذا كان يعمل داخل بيئة اختبار، ثم استبعد هذا الاحتمال بالاستناد إلى أن «10 منحنيات، كل منها 160 بتًا، تطابقت بالكامل؛ ومن المستحيل أن يكون ذلك مصادفة». وهذا الأسلوب، أي «التشكيك أولًا ثم حسم الأمر بالأدلة»، هو بالضبط ما تحتاج إليه الوكلاء البحثية.
دليل سريع للبدء باستخدام وكيل ذكاء اصطناعي للبحث العلمي: استدعاء النماذج الرائدة بمفتاح واحد
قبل البدء، تأكّد من عمل مسار استدعاء API. توفّر APIYI واجهة متوافقة مع OpenAI، ويمكنك باستخدام مفتاح واحد استدعاء claude-opus-5-5، أو التبديل إلى النماذج الرائدة من عائلتي GPT وGemini لإجراء تحقق متقاطع.
لا حاجة إلى تكرار خطوات الربط هنا؛ يمكنك الرجوع مباشرةً إلى دليل البدء السريع الرسمي من APIYI على: docs.apiyi.com/getting-started. أنشئ مفتاحًا في لوحة التحكم وفقًا للدليل، واحصل على base_url (https://api.apiyi.com/v1)، ثم استخدم المثال الوارد في الدليل للتأكد من أن الاتصال يعمل. يُرجى الرجوع إلى لوحة التحكم للاطلاع على طريقة الفوترة والنماذج المتاحة.
تشترك الاستخدامات الثلاثة الواردة لاحقًا في غلاف صغير؛ احفظه باسم research_client.py. وتقتصر مهمته على أمرين: اختيار النموذج بحسب المرحلة، واحتساب استخدام الرموز للتحكم في التكلفة.
# research_client.py
import os
from openai import OpenAI

client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1")
CHEAP = os.environ.get("CHEAP_MODEL", "claude-opus-5-5")  # 填控制台里的轻量模型名
FLAGSHIP = "claude-opus-5-5"
USAGE = {"prompt": 0, "completion": 0, "calls": 0}


def chat(messages, stage="draft", max_tokens=2048, temperature=0.2):
    """stage='draft' 走便宜模型;stage='verify' 走旗舰模型。"""
    r = client.chat.completions.create(model=FLAGSHIP if stage == "verify" else CHEAP,
        messages=messages, max_tokens=max_tokens, temperature=temperature)
    USAGE["prompt"] += r.usage.prompt_tokens
    USAGE["completion"] += r.usage.completion_tokens
    USAGE["calls"] += 1
    return r.choices[0].message.content


def ask(prompt, stage="draft", system=None, max_tokens=2048):
    msgs = ([{"role": "system", "content": system}] if system else []) + [{"role": "user", "content": prompt}]
    return chat(msgs, stage=stage, max_tokens=max_tokens)


def report():
    print(f"累计调用 {USAGE['calls']} 次,prompt={USAGE['prompt']},completion={USAGE['completion']}")
التحكم في تكلفة وكيل الذكاء الاصطناعي للبحث العلمي: ابدأ بنموذج منخفض التكلفة، واستعن بنموذج رائد للتحقق الحاسم
غالبًا ما تتطلب المهام البحثية جولات متعددة من التكرار. وإذا استخدمت نموذجًا رائدًا طوال الوقت منذ البداية، فستُستهلك الحصة في معالجة مشكلات منخفضة القيمة، مثل أخطاء التنسيق وفشل تحليل JSON. ومن الأنسب توزيع النماذج بحسب مراحل العمل:
| المرحلة | النموذج الموصى به | معيار التقييم | قيمة max_tokens المعتادة |
|---|---|---|---|
| تصحيح سير العمل (تنسيق الموجه والتحليل والمقيّم) | نموذج خفيف ومنخفض التكلفة | يعمل المسار من البداية إلى النهاية دون أخطاء | 512-1024 |
| توليد الفرضيات (سرد الآليات المحتملة) | يُفضّل نموذج خفيف، ويمكن الانتقال إلى نموذج رائد إذا لم تكن التغطية كافية | تغطي قائمة الاحتمالات الفرضيات الشائعة التي تعرفها | 1024-2048 |
| استنباط الآليات والتحقق الحاسم | claude-opus-5-5 | ستُدرج النتيجة في ورقة بحثية أو ستؤثر في استثمار الجهد في التجارب اللاحقة | 2048-4096 |
| التحقق المتقاطع | التبديل إلى نموذج رائد آخر باستخدام المفتاح نفسه | يتوصل نموذجان بصورة مستقلة إلى النتيجة نفسها | 2048 |
يمكنك الاسترشاد بقاعدة بسيطة عند التطبيق: استخدم نموذجًا منخفض التكلفة عند تشغيل السكربت للمرة الأولى، ونموذجًا رائدًا عند اعتماد النتيجة للمرة الأولى.
استخدام وكيل الذكاء الاصطناعي للبحث العلمي — الأول: استنباط الآليات أولًا، ثم التحقق منها
تتوافق هذه الخطوة مع أسلوب Claude القائم على «تغيير السؤال»: بدلًا من تخمين الإجابة مباشرةً، استنبط أولًا الآلية التي أنتجت البيانات، ثم اختبرها باستخدام البيانات. ويناسب هذا الأسلوب حالات مثل ظهور أنماط غير متوقعة في بيانات التجربة، أو الحاجة إلى استنتاج كيفية توليد بيانات تاريخية، أو تعذّر العثور على مصدر المعلمات عند إعادة إنتاج ورقة بحثية.
خطوات العمل
- صِف الظاهرة فقط، من دون تقديم تخمينات: قدّم للنموذج البيانات المرصودة والقيود المعروفة والخلفية التاريخية، ولا تكتب «أظن أن السبب هو كذا»، كي لا توجّه استنتاجاته مسبقًا.
- اطلب منه سرد الآليات والتنبؤات القابلة للدحض: أرفق بكل آلية مرشحة تنبؤًا يوضح السمة التي ينبغي أن تظهر في البيانات إذا كانت الآلية صحيحة.
- رتّب الآليات بحسب تكلفة التحقق: اطلب من النموذج ترتيبها من الأقل إلى الأعلى من حيث الوقت اللازم للتحقق، وابدأ بالخيارات الأقل تكلفة.
- اطلب من النموذج الرائد مراجعة الترتيب: يمكنك استخدام نموذج منخفض التكلفة لإنشاء القائمة الأولية، ثم إسناد الترتيب النهائي والاستنباط إلى claude-opus-5-5.
قالب الموجه
from research_client import ask, report

PROMPT = """你是一名严谨的研究助理。下面是一组观测数据和背景,不包含任何关于成因的线索。

【观测】
{observation}

【背景约束】
{context}

请完成:
1. 推演“产生这组数据的过程最可能怎么实现”,至少列出 5 个候选机制;
2. 每个机制给出一条可证伪预测:若成立,数据中必然出现的可检验特征;
3. 估计验证每条预测的成本(低/中/高),按成本升序输出;
4. 指出你最不确定的环节。
输出为 Markdown 表格 + 简短说明。"""

draft = ask(PROMPT.format(
    observation="NIST P-256 种子:C49D3608 86E70493 6A6678E1 139D26B7 819F7E90",
    context="1997-1998 年由政府机构用软件生成;官方未公布生成方法;常见猜测为短语哈希但未被证实",
), stage="draft")

final = ask("请审查并修正以下候选机制列表,删除无法证伪的条目,重新排序:\n" + draft,
            stage="verify", max_tokens=3000)
print(final)
report()
يمكنك تقييم جودة هذه الخطوة وفق معيارين: هل لكل آلية تنبؤ قابل للدحض؟ وهل يمكن إنجاز التحقق الأول في أقل من ساعة؟ إذا لم يتحقق أيٌّ من الشرطين، فاطلب من النموذج إعادة الصياغة.
الاستخدام الثاني لوكلاء الذكاء الاصطناعي للبحث العلمي: جعل النموذج يكتب نصوصًا برمجية للمسح والتحقق
تتوافق هذه الخطوة مع أسلوب Claude في كتابة أداة مسح تغطي 34 تركيبة من المولّدات والتقسيمات. الفكرة الأساسية هي تحويل «يبدو مشابهًا» إلى «من غير المرجح إحصائيًا أن يكون ذلك محض مصادفة». ويمكن استخدام هذا الأسلوب في مهام مثل مسح المعلمات، واكتشاف الإشارات، والبحث عن بنى خفية في البيانات.
خطوات العمل
- أعطِ النموذج التنبؤ الأقل تكلفةً للتحقق من بين تنبؤات الاستخدام الأول، واطلب منه كتابة أداة مسح تعتمد على المكتبة القياسية فقط.
- اطلب من الأداة تشغيل مجموعة ضابطة عشوائية أيضًا، مع إخراج «معدل التطابق في البيانات الحقيقية» و«معدل التطابق في البيانات العشوائية».
- شغّل الأداة محليًا بنفسك؛ يقتصر دور النموذج على كتابة الشفرة، ولا يتولى الإبلاغ عن النتائج.
- إذا كانت النتائج دالّة، اطلب من النموذج الرائد كتابة أداة أكثر صرامة لاستعادة الحالة أو الملاءمة.
مثال: إعادة إنتاج توقيع إحصائي من نوع «كل البتات العليا تساوي 0»
يوضح البرنامج التالي مبدأ التوقيع في هذه الحالة. تُعيد lrand48 البتات الـ31 العليا من حالة ذات 48 بتًا، لذا يكون البت الأعلى دائمًا 0 عند وضع القيمة في كلمة من 32 بتًا. أما في البيانات العشوائية الحقيقية، فاحتمال أن يكون البت الأعلى لكل كلمة مساويًا لـ0 لا يتجاوز النصف.
import os

def lrand48_stream(seed32, n):
    x = (seed32 << 16) | 0x330E          # تهيئة srand48: البتات الـ16 الدنيا ثابتة عند 0x330E
    out = []
    for _ in range(n):
        x = (0x5DEECE66D * x + 0xB) % 2**48
        out.append(x >> 17)               # لا تُعيد lrand48 سوى البتات الـ31 العليا
    return out

def top_bit_zero_ratio(words):
    return sum(1 for w in words if w >> 31 == 0) / len(words)

lr = lrand48_stream(870000000, 20)        # طابع زمني من Unix يعود إلى نحو عام 1997
rnd = [int.from_bytes(os.urandom(4), "big") for _ in range(20)]
print("lrand48 最高位为 0 的比例:", top_bit_zero_ratio(lr))   # 恒为 1.0
print("真随机  最高位为 0 的比例:", top_bit_zero_ratio(rnd))  # 约 0.5 上下波动
التحقق من النتيجة النهائية باستخدام الشفرة الرسمية
تتضمن صفحة أبحاث Anthropic شفرة لإعادة الإنتاج منشورة بموجب ترخيص CC0. ووفقًا للتعليمات الرسمية، ينبغي أن تُخرج مجموعة المعلمات التالية البذرة الواردة في معيار P-256:
from datetime import datetime, timezone

def unix(when):
    return int(datetime.fromisoformat(when).replace(tzinfo=timezone.utc).timestamp())

def candidate(t, n, per, shift, width):
    x, out = (t << 16) | 0x330E, ""
    for i in range(per * n):
        x = (0x5DEECE66D * x + 0xB) % 2**48
        if i >= per * (n - 1):
            out += "%0*X" % (width, x >> shift)
    return out

seed = candidate(unix("1997-08-16 01:52:34"), 1842, 20, 40, 2)
print(seed)
print("与标准一致:", seed == "C49D360886E704936A6678E1139D26B7819F7E90")
يفعل البرنامج ما يلي: يهيّئ lrand48 باستخدام الطابع الزمني، ثم يجمع كل 20 قيمة ناتجة لتكوين بذرة مرشحة من 20 بايتًا. والبذرة المرشحة رقم 1842 هي البذرة الواردة في المعيار. يمكن إجراء التحقق كاملًا على حاسوب محمول عادي في أقل من ثانية. إن «تكلفة طرح الفرضية مرتفعة، بينما تكلفة التحقق من النتيجة منخفضة» هو الهيكل الأمثل لمثل هذه المهام البحثية.
الاستخدام الثالث لوكلاء الذكاء الاصطناعي للبحث العلمي: إضافة مُقيِّم آلي والتكرار حتى استقرار النتيجة
يعتمد الاستخدامان السابقان على الإنسان لتقييم النتائج، أما الاستخدام الثالث فيُسند التقييم إلى برنامج. تكتب مُقيِّمًا، ويقدّم النموذج حلًا في كل جولة، ثم يعيد المُقيِّم الدرجة والعينات التي أخفق فيها النموذج. وبناءً على ذلك، يعدّل النموذج الحل ويكرّر العملية إلى أن تتوقف الدرجة عن التحسن. يناسب هذا الأسلوب مهامًا مثل قواعد استخراج البيانات، وملاءمة صيغ الدوال، والبحث عن معلمات التجارب، عندما يكون للمهمة معيار تقييم واضح.
خطوات العمل
- اكتب المُقيِّم قبل اختيار النموذج: يجب أن يكون المُقيِّم برنامجًا حتميًا، وألا يعتمد على تقييم النموذج لنفسه.
- قسّم البيانات إلى مجموعة تطوير ومجموعة محجوبة: استخدم مجموعة التطوير وحدها لتقديم الملاحظات، ثم تحقّق من فرط التكيّف باستخدام المجموعة المحجوبة.
- قيّد صيغة الإجابة: اطلب من النموذج إخراج بيانات بصيغة JSON أو تعبيرات نمطية، بدلًا من تنفيذ الشفرة التي يولّدها مباشرةً. وإذا كان لا بد من تنفيذها، فشغّلها في بيئة معزولة.
- حدّد شروط التوقف: أوقف العملية عند تحقق أحد الشروط التالية: الحصول على الدرجة الكاملة، أو عدم التحسن لجولتين متتاليتين، أو بلوغ الحد الأقصى لعدد الجولات.
- اختبر سير العمل بنموذج منخفض التكلفة، ثم استخدم نموذجًا رائدًا للتجربة الفعلية.
مثال: تكرار تحسين تعبير نمطي لاستخراج المعلمات من سجلات التجارب
import json, re
from research_client import chat, report

DEV = [
    ("样品A在 350 ℃ 退火 2 小时后测得电导率 4.1 S/m。", {"temp_c": 350, "hours": 2, "cond": 4.1}),
    ("退火温度 420°C,保温 1.5 h,电导率为 12.3 S/m。", {"temp_c": 420, "hours": 1.5, "cond": 12.3}),
    ("B组:300摄氏度下处理 3 小时,σ=0.85 S/m。", {"temp_c": 300, "hours": 3, "cond": 0.85}),
    ("在450 ℃条件下退火4h,测得电导率 20 S/m。", {"temp_c": 450, "hours": 4, "cond": 20}),
]
HOLDOUT = [
    ("样品E 380 ℃ 退火 2.5 小时,电导率 7.6 S/m。", {"temp_c": 380, "hours": 2.5, "cond": 7.6}),
    ("C组于 500°C 保温 0.5 h,σ = 33.1 S/m。", {"temp_c": 500, "hours": 0.5, "cond": 33.1}),
]
FIELDS = ["temp_c", "hours", "cond"]

def score(patterns, data):
    hit, fails = 0, []
    for idx, (text, label) in enumerate(data):
        for f in FIELDS:
            try:
                m = re.search(patterns.get(f, "(?!)"), text)
                ok = m is not None and abs(float(m.group(1)) - label[f]) < 1e-9
            except (re.error, IndexError, ValueError, TypeError):
                ok = False
            hit += ok
            if not ok:
                fails.append(f"样本{idx} 字段{f} 抽取失败:{text}")
    return hit / (len(data) * len(FIELDS)), fails

def parse_json(text):
    return json.loads(text[text.find("{"): text.rfind("}") + 1])

messages = [{"role": "user", "content":
    "为下列实验记录写 Python 正则,抽取 temp_c、hours、cond 三个字段,每个正则恰好一个捕获组,捕获纯数字。"
    "只输出 JSON,例如 {\"temp_c\": \"...\", \"hours\": \"...\", \"cond\": \"...\"},注意转义反斜杠。\n"
    + "\n".join(t for t, _ in DEV)}]

best, stale, patterns = -1.0, 0, {}
for rnd in range(6):
    reply = chat(messages, stage="draft", max_tokens=800)   # بعد نجاح الاختبار، غيّر stage إلى "verify"
    try:
        patterns = parse_json(reply)
        s, fails = score(patterns, DEV)
    except (ValueError, json.JSONDecodeError):
        s, fails = 0.0, ["输出不是合法 JSON"]
    print(f"第 {rnd + 1} 轮 开发集得分 {s:.2f}")
    if s >= 1.0:
        break
    stale = stale + 1 if s <= best else 0
    best = max(best, s)
    if stale >= 2:
        break
    messages += [{"role": "assistant", "content": reply},
                 {"role": "user", "content": "以下抽取失败,请修改正则后重新输出完整 JSON:\n" + "\n".join(fails)}]

print("留出集得分:", score(patterns, HOLDOUT)[0])
report()
انتبه جيدًا إلى أن الحصول على الدرجة الكاملة في مجموعة التطوير، مع انخفاض واضح في النتيجة على المجموعة المحجوبة، يعني أن النموذج «يحفظ الإجابات». في هذه الحالة، ينبغي توسيع مجموعة التطوير بدلًا من مواصلة التكرار.
مقارنة بين 3 استخدامات لوكلاء الذكاء الاصطناعي للبحث العلمي
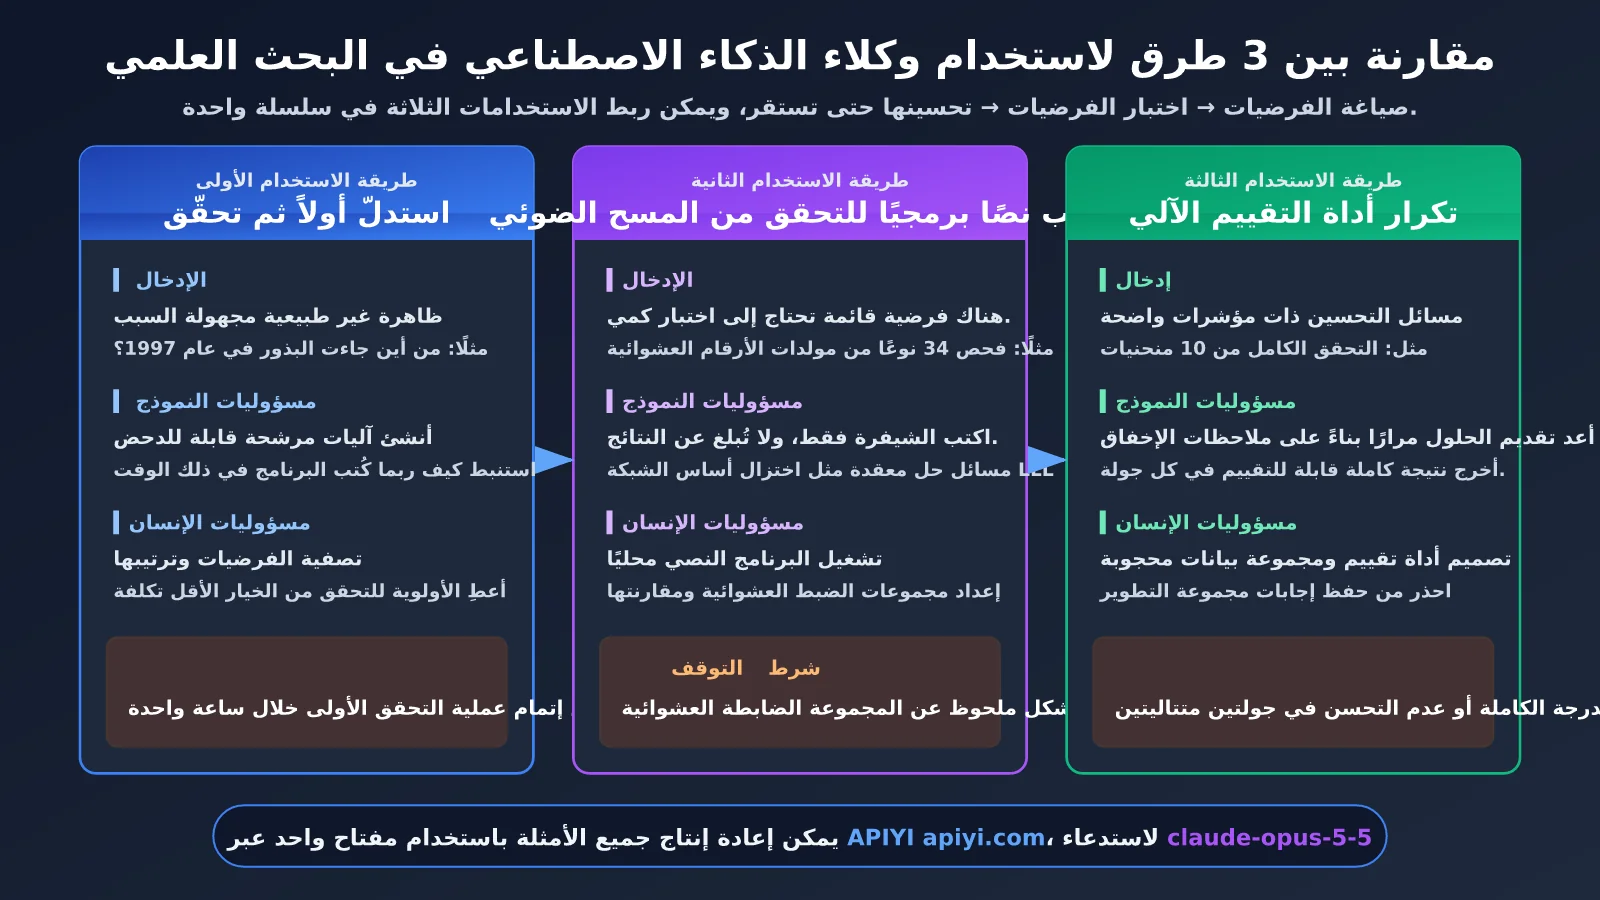
| البُعد | الاستخدام الأول: استنباط الآلية | الاستخدام الثاني: كتابة أداة للمسح والتحقق | الاستخدام الثالث: التكرار باستخدام مُقيِّم آلي |
|---|---|---|---|
| المرحلة المقابلة في الحالة | استنباط طريقة كتابة البرنامج عام 1997 | مسح 34 مولّدًا والعثور على توقيع إحصائي | التحقق الكامل من 10 منحنيات بعد استعادة الحالة |
| المهام المناسبة | حالات شاذة مجهولة السبب، أو استنتاجات عكسية | وجود فرضية مسبقة والحاجة إلى اختبارها كميًا | مسائل التحسين ذات معايير التقييم الواضحة |
| دور النموذج | توليد آليات مرشحة قابلة للتفنيد | كتابة الشفرة دون الإبلاغ عن النتائج | تقديم حلول متكررة |
| دور الإنسان | فرز الفرضيات وترتيبها | تشغيل البرنامج محليًا ومراجعة المجموعة الضابطة | تصميم المُقيِّم ومجموعة البيانات المحجوبة |
| متى يُستعان بالنموذج الرائد | الاستدلال النهائي وترتيب الفرضيات | كتابة أدوات الحل المعقدة، مثل LLL | جولات التجربة الفعلية |
| شروط التوقف | إمكانية التحقق من أول فرضية خلال ساعة | وجود فرق دال عن المجموعة الضابطة العشوائية | الدرجة الكاملة أو عدم التحسن لجولتين متتاليتين |
| طريقة الاستدعاء | واجهة موحدة عبر APIYI apiyi.com | كما سبق | كما سبق |
يمكن الجمع بين الاستخدامات الثلاثة: ينتج الاستخدام الأول فرضية، ويختبرها الاستخدام الثاني، ثم يصقل الاستخدام الثالث الحلول التي اجتازت التحقق حتى تصبح مستقرة.
لماذا تتطلب المهام البحثية من نوع Claude استخدام نموذج رائد؟
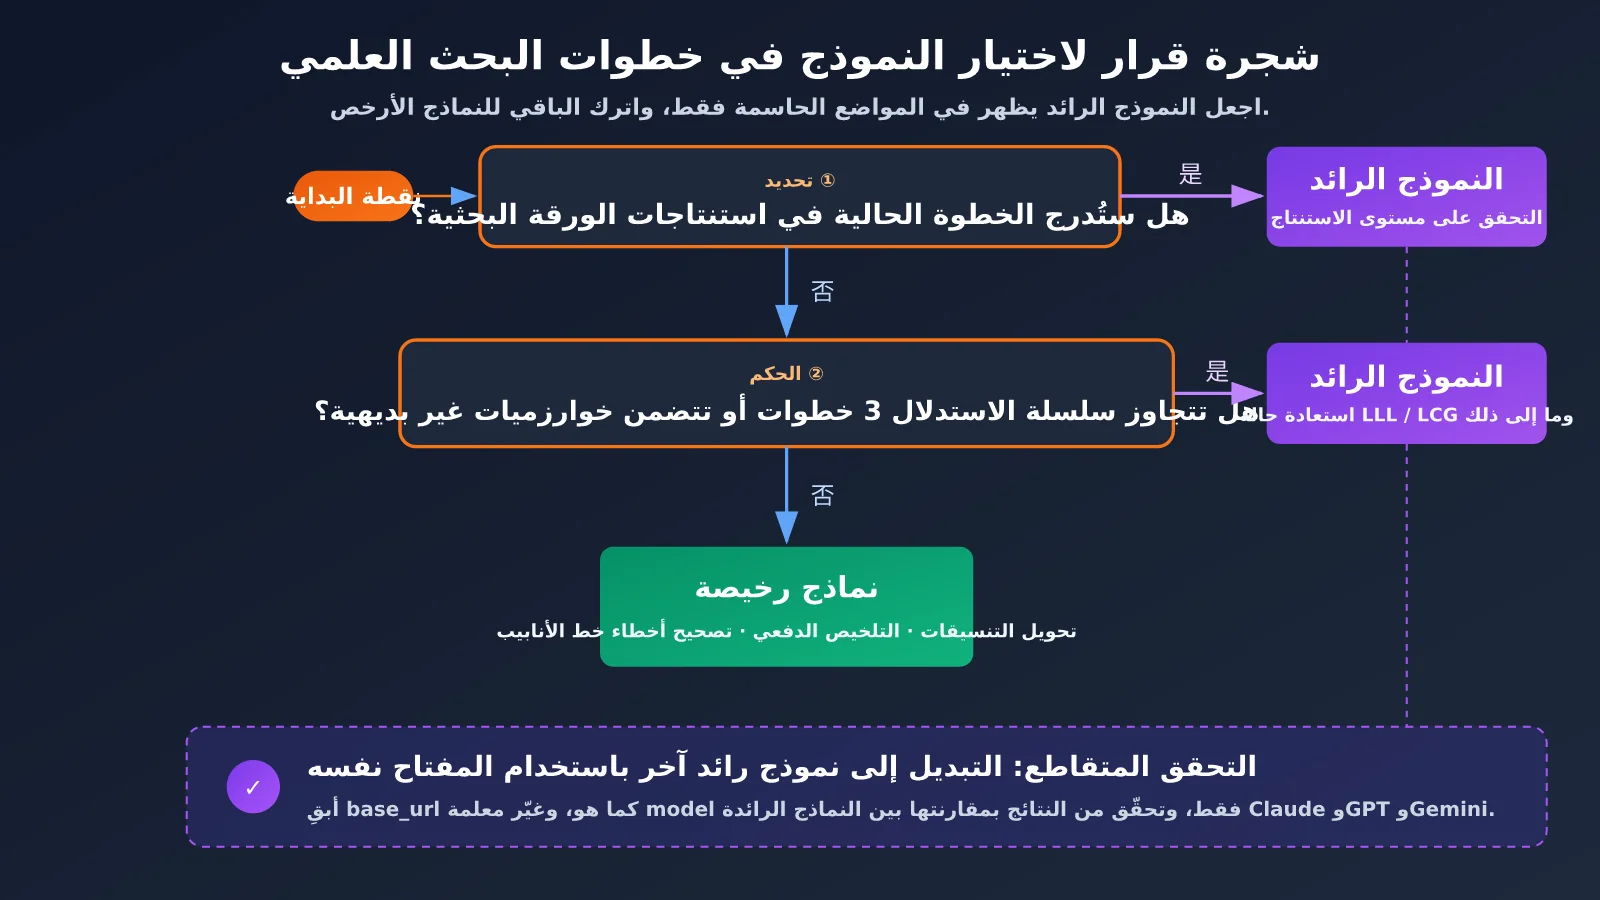
لا تحتاج كل خطوات البحث إلى نموذج رائد، لكن هناك مهام لا يمكن إنجازها تقريبًا عند استخدام نموذج أصغر. يساعدك الجدول التالي على اتخاذ القرار:
| معيار التقييم | متى يُنصح باستخدام نموذج رائد؟ | السبب |
|---|---|---|
| تتطلب ربط أفكار من مجالات مختلفة | مثل الانتقال من «بذرة المنحنى» إلى «تفاصيل تنفيذ مكتبات C في التسعينيات» | غالبًا ما يظل النموذج الأصغر عند سطح المشكلة، فيواصل مثلًا تخمين عبارات |
| تتجاوز سلسلة الاستدلال 3 خطوات، وتعتمد كل خطوة على سابقتها | مثل الاستنتاج ← المسح ← التوقيع ← استعادة الحالة | أي خطأ في خطوة وسيطة سيؤدي إلى انحراف بقية الخطوات |
| تتطلب التشكيك في الذات | مثل التساؤل: «هل أختبر بيئة الاختبار؟» | من الأرجح أن يبحث النموذج الرائد من تلقاء نفسه عن أمثلة مضادة |
| تتضمن خوارزمية غير بسيطة | مثل اختزال أساس الشبكة بخوارزمية LLL أو استعادة حالة LCG مبتور | تتوقف صحة التحقق مباشرةً على مدى صحة الشيفرة |
| ستُدرج النتيجة في ورقة بحثية أو ستحدد الاستثمار في تجربة | أي نتيجة ستُنشر خارجيًا | تكلفة الخطأ أعلى بكثير من تكلفة الاستدعاء |
في المقابل، تكفي النماذج الأرخص لمهام مثل تحويل التنسيقات، والتلخيص على نطاق واسع، وتصحيح أخطاء مسار عمل مقيّم النتائج. جوهر ضبط التكاليف ليس تقليل استخدام النماذج الرائدة، بل حصر استخدامها في المواضع الواردة في الجدول أعلاه.
الأسئلة الشائعة
س1: هل تمكّن Claude من كسر منحنيات NIST الإهليلجية؟
لا. أعاد Claude استنتاج طريقة توليد البذرة، التي جاءت من `lrand48` بعد تهيئته بطابع زمني. هذه ليست طريقة هجوم جديدة ولا تُعد ثغرة، ولا يحتاج المستخدمون إلى تغيير إعداداتهم أو ترحيلها. بل إن هذه النتيجة تشير إلى أن البذور لم تُنتقَ يدويًا.
س2: ما الفرق بين هذه الطريقة والبحث الشامل التقليدي؟
يجرّب البحث الشامل جميع الاحتمالات ضمن فضاء فرضيات ثابت. أما Claude فغيّر فضاء الفرضيات أولًا، منتقلًا من سؤال «ما العبارة التي جرى تجزئتها؟» إلى «ما مولّد الأرقام العشوائية المستخدم؟»، ثم أجرى بحثًا شاملًا محدودًا (2^17 من البتات المخفية). كانت الخطوة الأولى هي العامل الحاسم في نجاح العملية.
س3: متى نُشر هذا البحث؟ وما المسائل التي لا تزال عالقة؟
نُشرت صفحة أبحاث Anthropic ومنشور @AnthropicAI في 17 أكتوبر 2026. وحتى الآن، لم تُستعد بذرة B-163، ولا تزال طريقة توليد نقطة الأساس G للمنحنيات من P-224 إلى P-521 غير معروفة. كذلك، جرى تجاوز عدد قليل من المنحنيات المرشحة، ولا يُعرف السبب.
س4: ما المجالات البحثية التي تناسبها هذه الاستخدامات الثلاثة؟
– **تتبّع أسباب الشذوذ التجريبي**: عند ظهور آثار دورية زائفة في بيانات الأجهزة، استخدم الطريقة الأولى لاستنتاج كيفية تنفيذ برنامج جمع البيانات.
– **إعادة إنتاج الأبحاث المنشورة سابقًا**: عند غياب بعض المعلمات، استخدم الطريقة الثانية لفحص مجموعات المعلمات المرشحة.
– **استخراج البيانات وتنظيفها**: استخدم الطريقة الثالثة مع أداة تقييم، وكرّر العملية للوصول إلى قواعد مستقرة.
س5: كيف أستخدم مفتاحًا واحدًا لاستدعاء عدة نماذج رائدة وإجراء تحقق متبادل بينها؟
سجّل في APIYI apiyi.com وأنشئ مفتاحًا، ثم اضبط `base_url` على `https://api.apiyi.com/v1`. بعد ذلك، يكفي تغيير المعلمة `model` للتبديل بين claude-opus-5-5 والنماذج الرائدة من عائلتي GPT وGemini. راجع قائمة النماذج في لوحة التحكم لمعرفة الأسماء المتاحة.
س6: ما القيود المعروفة لوكلاء الذكاء الاصطناعي البحثيين؟
– قد يختلق النموذج آليات تبدو معقولة؛ لذلك يجب أن يقترن كل استنتاج بنص برمجي للتحقق يمكن تشغيله محليًا.
– قد تؤدي مراجعة النتائج وتكرارها باستخدام أداة التقييم إلى فرط التكيّف مع مجموعة التطوير؛ لذا يجب الاحتفاظ بمجموعة بيانات للتحقق المستقل.
– تتراكم تكلفة الاستدعاءات المتعددة، لذا ابدأ بنموذج منخفض التكلفة لاختبار سير العمل، وسجّل الاستخدام. ويمكن الاطلاع على تفاصيل الفوترة في لوحة تحكم APIYI apiyi.com.
أبرز النقاط حول وكلاء الذكاء الاصطناعي البحثيين
- حدود الاستنتاج: استعاد Claude مصدر البذور، ولم يكتشف ثغرة تشفيرية؛ بل إن موثوقية المنحنيات ازدادت.
- الخطوة الحاسمة: تغيير فضاء الفرضيات أكثر فاعلية من زيادة القدرة الحاسوبية ضمن الفضاء القديم.
- التحقق أولًا: يتولى النموذج كتابة النصوص البرمجية، ويتولى الإنسان تشغيلها، مع مقارنتها دائمًا بخط أساس عشوائي.
- حلقة التقييم: استخدم تقييمًا حتميًا ومجموعة بيانات للتحقق المستقل، وأوقف التكرار عندما تستقر النتيجة.
- تقسيم الأدوار بين النماذج: استخدم النماذج منخفضة التكلفة لاختبار سير العمل، واقصر استخدام النماذج الرائدة على الاستدلال والتحقق في المراحل الحاسمة.
- طريقة البدء: استخدم مفتاحًا واحدًا عبر APIYI apiyi.com لاستدعاء claude-opus-5-5، ثم بدّل إلى نماذج أخرى لإجراء تحقق متبادل.
الخلاصة
تتمثل أبرز الدروس التي يمكن للباحثين استخلاصها من حل Claude لغز بذرة المنحنى الإهليلجي لدى NIST في ثلاث نقاط:
- استنتج الآلية أولًا: ابدأ بالسؤال «كيف أُنتجت البيانات؟» بدلًا من تخمين الإجابة مباشرة.
- دع الشيفرة تتحدث: أرفق بكل فرضية شيفرة قابلة للتشغيل للتحقق منها، إلى جانب مقارنة عشوائية.
- أنشئ حلقة مغلقة للتقييم: أسند الحكم إلى برنامج حتمي، وكرّر العملية حتى تستقر النتائج، ثم استخدم مجموعة بيانات محجوبة للتحقق من فرط التكيّف.
يبقى ضبط التكلفة شرطًا أساسيًا: ابدأ بتشغيل سير العمل باستخدام نموذج منخفض التكلفة، ثم انتقل إلى نموذج رائد عند التعامل مع استنتاجات الأبحاث والخوارزميات المعقدة. ننصح باستخدام APIYI على apiyi.com لتشغيل شيفرة المقالة كاملة؛ ابدأ بالتحقق من بذرة P-256 باستخدام شيفرة إعادة الإنتاج الرسمية، ثم طبّق الطرق الثلاث على موضوعك البحثي.
قراءات ذات صلة
- 📘 كيفية استدعاء نماذج Claude باستخدام OpenAI SDK – تعرّف على اختلافات المعاملات في الواجهات المتوافقة
- 📊 ممارسات ضبط تكلفة استدعاء واجهات API لنماذج اللغة الكبيرة – تعرّف على إحصاءات الاستخدام والتنبيهات عند تجاوز الميزانية
- 🚀 إعداد سير عمل للتحقق المتبادل بين نماذج متعددة – دع النماذج الرائدة المختلفة تراجع الاستنتاجات بعضها بعضًا
📚 مراجع
- صفحة أبحاث فريق الاختبار الأحمر Frontier من Anthropic: بحث حول مصادر بذور منحنيات ECDSA
- الرابط:
www.anthropic.com/research/ecdsa-curve-origins -
نبذة: مصدر أولي يتضمن المنهجية كاملة، والأسئلة التي لم تُحسم، وشيفرة لإعادة التجربة بترخيص CC0
-
منشور رسمي من @AnthropicAI على X (2026-10-17): «إنها مجرد طوابع زمنية».
- الرابط:
x.com/AnthropicAI -
نبذة: إعلان رسمي يمكن من خلاله الاطلاع على نقاشات المجتمع
-
مركز توثيق APIYI: شرح استدعاء واجهات متوافقة مع OpenAI
- الرابط:
docs.apiyi.com - نبذة: إعداد
base_url، وقوائم النماذج، ومعلومات الفوترة
الكاتب: الفريق التقني في APIYI
للتواصل التقني: يسعدنا أن تشاركوا في التعليقات طرق استخدامكم لوكلاء الذكاء الاصطناعي في الأبحاث العلمية. للاطلاع على مزيد من معلومات التكامل، تفضلوا بزيارة مركز توثيق APIYI علىdocs.apiyi.com.