ملاحظة الكاتب: نستعرض لماذا لا يعتمد LongCat-2.5 على سياق بحجم 1M وحده، بل يعزّز قدرة الوكيل على إكمال المشروع بأكمله عبر ستة مسارات تدريبية، ونلخّص الأساليب الهندسية التي يمكن للمطورين الاستفادة منها.
واجه معظم مطوري وكلاء الذكاء الاصطناعي مواقف كهذه: يتوقف التنفيذ بخطأ في منتصف المهمة، ويكرر الوكيل محاولة تنفيذ الأمر الخاطئ نفسه، ثم يقدم ملخصًا يبدو شاملًا لكنه يغفل بعض المخرجات الأساسية. ركّزت Meituan، التي أطلقت LongCat-2.5 رسميًا في 2026-11-02، على قدرة الوكيل على إكمال المشروع بأكمله على مدى طويل، بدلًا من الاكتفاء بالتأكيد على نافذة سياق بحجم 1M.
هذا ليس مقالًا ترويجيًا عن مواصفات النموذج. فقد كشفت المدونة التقنية لشركة Meituan عن تصميم التدريب بالتعلم المعزز للمهام طويلة المدى، كما أجرت جهة مستقلة اختبارًا عمليًا لمهام طويلة في يوم إطلاق الإصدار الرسمي. سنميّز في هذا المقال بين ثلاثة أنواع من المعلومات: تصميم التدريب الرسمي، ونتائج الاختبارات المعيارية الرسمية، والتجربة العملية لطرف ثالث، مع توضيح ما يمكن لكل منها إثباته وما لا يمكنه إثباته.
الفائدة الأساسية: بعد قراءة هذا المقال، ستفهم لماذا لا تضمن نافذة سياق بمليون Token نجاح المشروع، وما الأساليب التي يستخدمها LongCat-2.5 لتعزيز قدرته على إنجاز المهام طويلة المدى، وكيف تطبق هذه الأفكار في هندسة الوكلاء الخاصة بك.
نظرة سريعة على LongCat-2.5
LongCat-2.5 هو نموذج لغة كبير متعدد الوسائط بطبيعته، أصدره فريق LongCat في Meituan للمهام طويلة الأمد التي تنفذها الوكلاء الأذكياء (Long-Horizon Agentic Tasks). ويعتمد على LongCat-2.0، مع إضافة المزيد من مسارات المهام طويلة الأمد، لتعزيز قدرته على تطوير قواعد الشفرة المعقدة وبناء مشاريع متكاملة.
| البند | التفاصيل |
|---|---|
| تاريخ الإصدار | إتاحة النسخة التجريبية في 2026-09-25، وإصدار النسخة النهائية في 2026-11-02 |
| الجهة المصدرة | فريق LongCat في Meituan |
| حجم النموذج | 1.6T من المعلمات إجمالًا، مع تنشيط متناثر بتقنية MoE، يُفعّل نحو 48B لكل رمز |
| نافذة السياق | 1,048,576 رمزًا (نحو 1M)، تشمل المدخلات والمخرجات |
| المجالات الأساسية | الوكلاء للمهام طويلة الأمد، والبرمجة باستخدام الوكلاء، والبرمجة المرئية، واستدعاء الأدوات متعدد الخطوات |
| حالة الإتاحة | الموقع الرسمي وواجهة API متاحان، ولم تتأكد بعد إتاحة أوزان النسخة النهائية |
تجدر الإشارة إلى أنه حتى 2026-11-03، كانت APIYI قد نشرت مقالًا تعريفيًا عن LongCat-2.5، وأوضحت حينها أن النموذج لم يكن متاحًا بعد على المنصة، مع وجود خطط لإضافته لاحقًا. لمعرفة النماذج المتاحة للاستدعاء فعليًا، يُرجى الرجوع إلى قائمة النماذج المحدّثة على apiyi.com. تستخدم أمثلة الشفرة في هذا المقال صيغة عامة متوافقة مع OpenAI، ويمكن تطبيقها على أي نموذج متاح على المنصة.
لماذا لا تكفي نافذة سياق بمليون Token لإنجاز مهام الوكلاء طويلة المدى؟
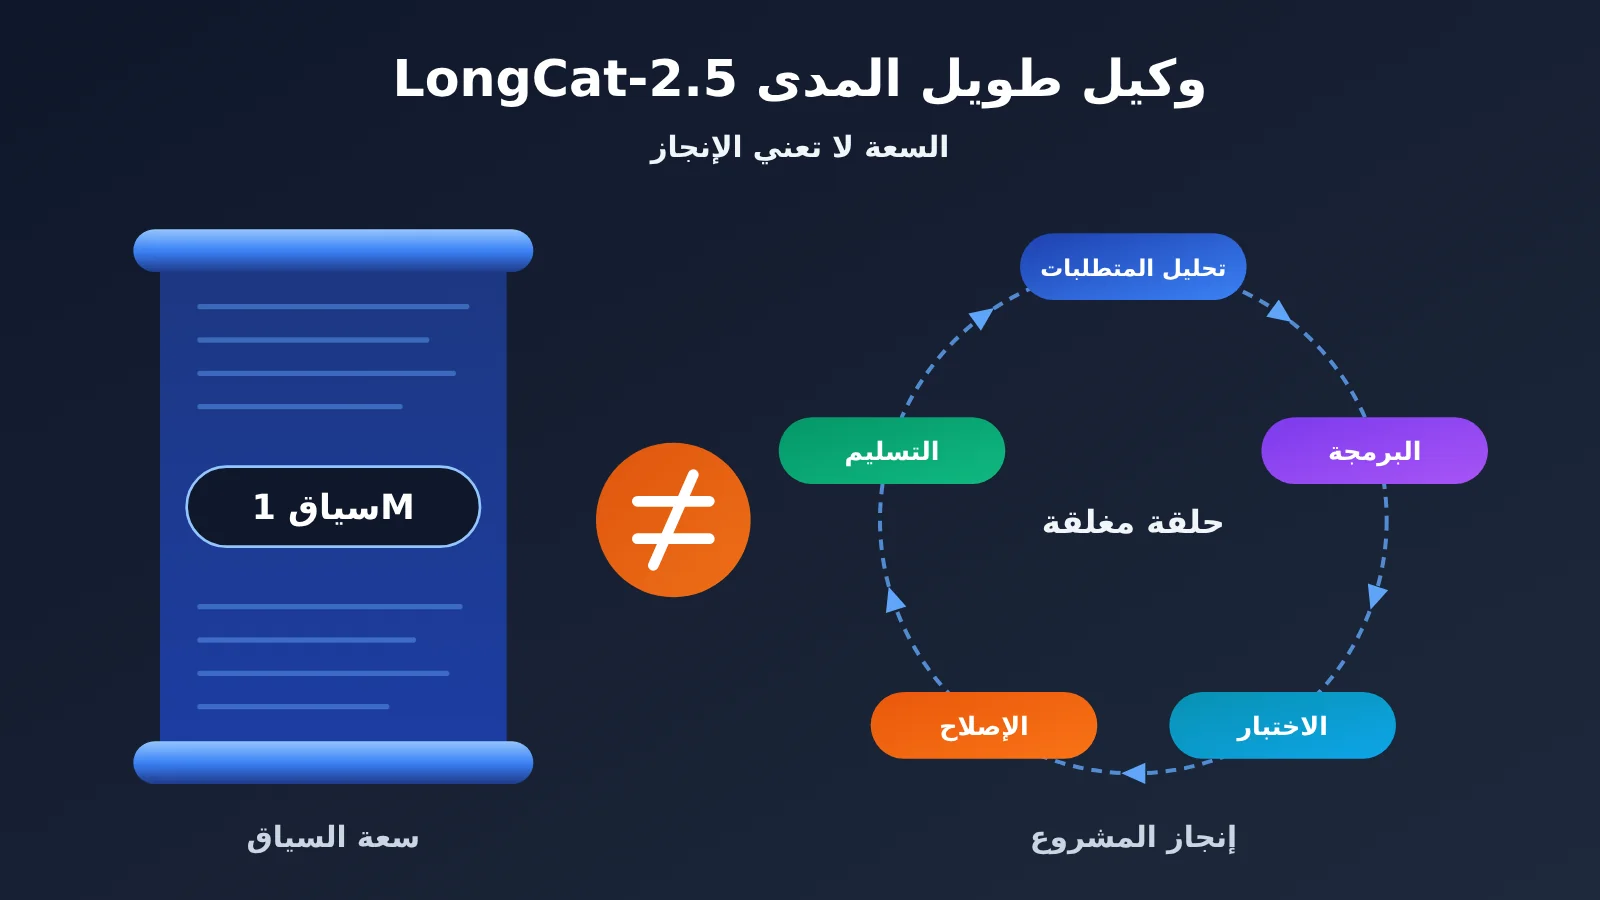
يشير السياق الطويل (Long Context) إلى إجمالي عدد الرموز (Token) التي يمكن أن يستوعبها الطلب الواحد. وتعني نافذة بسعة 1M أن النموذج يستطيع قراءة مزيد من الشيفرة المصدرية والوثائق والرسائل السابقة دفعة واحدة، وهو ما يساعد فعلًا على فهم المستودعات الكبيرة. لكن هذا الرقم وحده لا يعني أن «البحث في المستندات الطويلة سيكون دقيقًا دائمًا»، أو أن «استدعاءات الأدوات ستنجح باستمرار»، أو أن «الملفات الناتجة ستكون صحيحة بالضرورة».
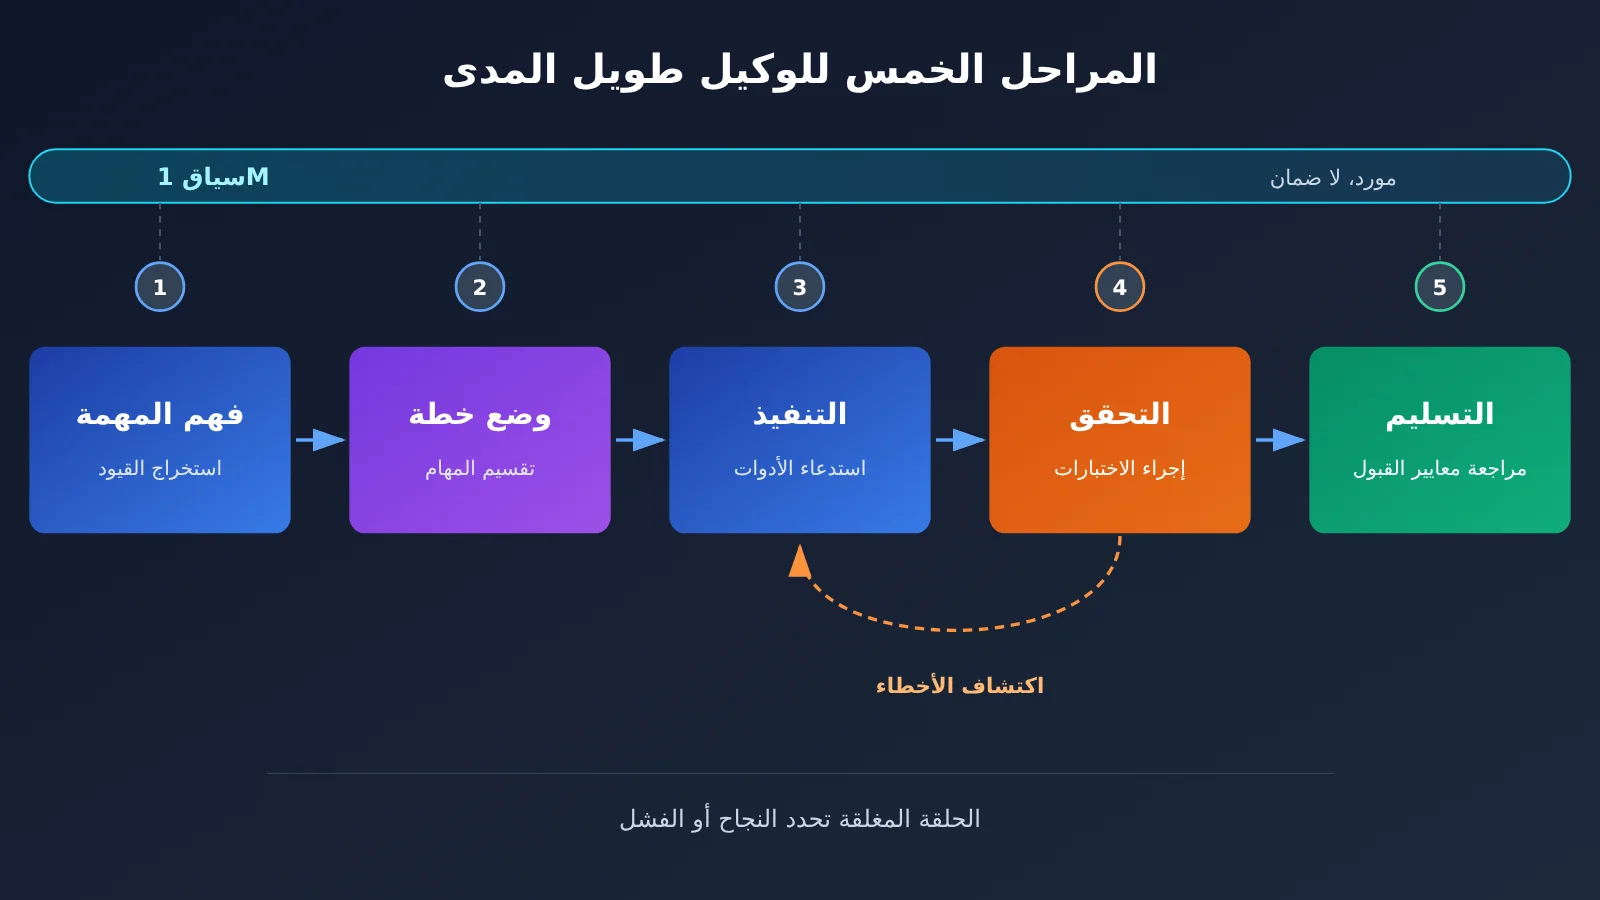
أما الوكيل طويل المدى (Long-Horizon Agent)، فهو مسألة مختلفة. إذ يتطلب من النموذج تنفيذ خطوات متعددة ومترابطة باستمرار في بيئة خارجية: قراءة المستودع، وكتابة الشيفرة، واستدعاء الأدوات، وتشغيل الاختبارات، واكتشاف الأخطاء وإصلاحها، ثم إعادة التحقق والتسليم. وإذا أخفقت أي خطوة، فقد تُبنى الخطوات التالية على حالة غير صحيحة.
| جانب المقارنة | قدرة السياق الطويل | قدرة الوكيل طويل المدى |
|---|---|---|
| الجوهر | سعة الطلب الواحد | موثوقية التنفيذ المستمر عبر خطوات متعددة |
| طريقة القياس | عدد رموز Token التي يمكن استيعابها | ما إذا كانت المهمة تستوفي معايير القبول في النهاية |
| المتطلبات الأساسية | آلية الانتباه والتدريب على النصوص الطويلة | التخطيط، واستدعاء الأدوات، والاستفادة من ملاحظات الأخطاء، وتحديد وقت التوقف |
| الإخفاق المعتاد | إغفال معلومات عند البحث في نص طويل | الانحراف عن الهدف، وتكرار الاستدعاءات، وإغفال التسليم |
| العلاقة بنجاح المشروع | أحد الموارد الضرورية | عامل أكثر تأثيرًا في النجاح أو الفشل |
بعبارة أخرى، يحدد السياق «حجم طاولة العمل»، بينما تحدد القدرة على العمل طويل المدى «إمكانية إنجاز المهمة». فمهما كانت الطاولة كبيرة، سيظل المشروع عرضة للفشل في منتصف الطريق إذا لم يعرف النموذج كيف يغيّر خطته عند فشل الاختبارات، أو نسي القيود الأصلية. وهذا هو السبب الجوهري وراء تركيز LongCat-2.5 في التدريب على المهام طويلة المدى.
تغيّر نتائج LongCat-2.5 في معايير تقييم الوكلاء للمهام طويلة الأمد
نشرت Meituan مقارنة بين LongCat-2.5 والجيل السابق عبر عدة معايير لتقييم الوكلاء في المهام طويلة الأمد. الأرقام في الجدول من الإعلان الرسمي، وعمود التحسن يوضح فارق الدرجات، وليس نسبة التحسن المئوية.
| معيار التقييم | LongCat-2.0 | LongCat-2.5 | التحسن | ما الذي يقيسه؟ |
|---|---|---|---|---|
| Terminal Bench v2.1 | 70.8 | 88.4 | +17.6 | إنجاز مهام تشغيلية حقيقية في بيئة الطرفية |
| Terminal Bench v4.0 | 3.0 | 38.5 | +35.5 | مهام أطول وأكثر صعوبة في الطرفية |
| DeepSWE v1.1 | 9.7 | 64.6 | +54.9 | مهام هندسة البرمجيات طويلة الأمد |
| Program Bench Almost Resolved | 2.5 | 25.5 | +23.0 | مدى الاقتراب من إكمال بناء البرنامج |
| NL2Repo | 40.9 | 60.5 | +19.6 | إنشاء مستودع انطلاقًا من متطلبات باللغة الطبيعية |
| MCP Atlas | 61.8 | 83.1 | +21.3 | استدعاء أدوات متعددة |
| JobBench | 44.4 | 65.4 | +21.0 | المخرجات الاحترافية للمهام المهنية |
التحسن في هذه النتائج واضح، لكن ينبغي مراعاة بعض الحدود عند تفسيرها. فقد قفزت نتيجة DeepSWE من 9.7 إلى 64.6، لكنها لا تزال أقل من نتيجة GPT-5.6-Sol البالغة 72.7 في المقارنة الرسمية. أما نتيجة Terminal Bench v4.0 البالغة 38.5 فتتجاوز نتيجة GPT-5.6-Sol البالغة 37.3 بفارق طفيف، لكنها تقل عن نتيجة Claude Opus 5 البالغة 53.9 بمقدار 15.4 نقطة، ما يشير إلى أن حل مهام الطرفية الصعبة لا يزال بعيد المنال.
ظروف التقييم مهمة أيضًا. يستخدم Terminal Bench إطار Claude Code Harness، ويستخدم DeepSWE إطار mini-swe-agent، بينما يستخدم JobBench أسلوب LLM-as-Judge للتقييم؛ لذا ترتبط النتائج بأطر التنفيذ المحددة. وفي الجدول الرسمي، تأتي بعض نتائج النماذج المنافسة من تقارير منشورة، بينما اختبرت Meituan بعضها بنفسها، لذلك لا يمكن اعتبار الجدول ترتيبًا مستقلًا أُجري في ظروف موحدة. كما أن المعيار الداخلي LongCat AppDev (47.7 → 73.7) لا يتيح إعادة إنتاج نتائجه بصورة علنية.
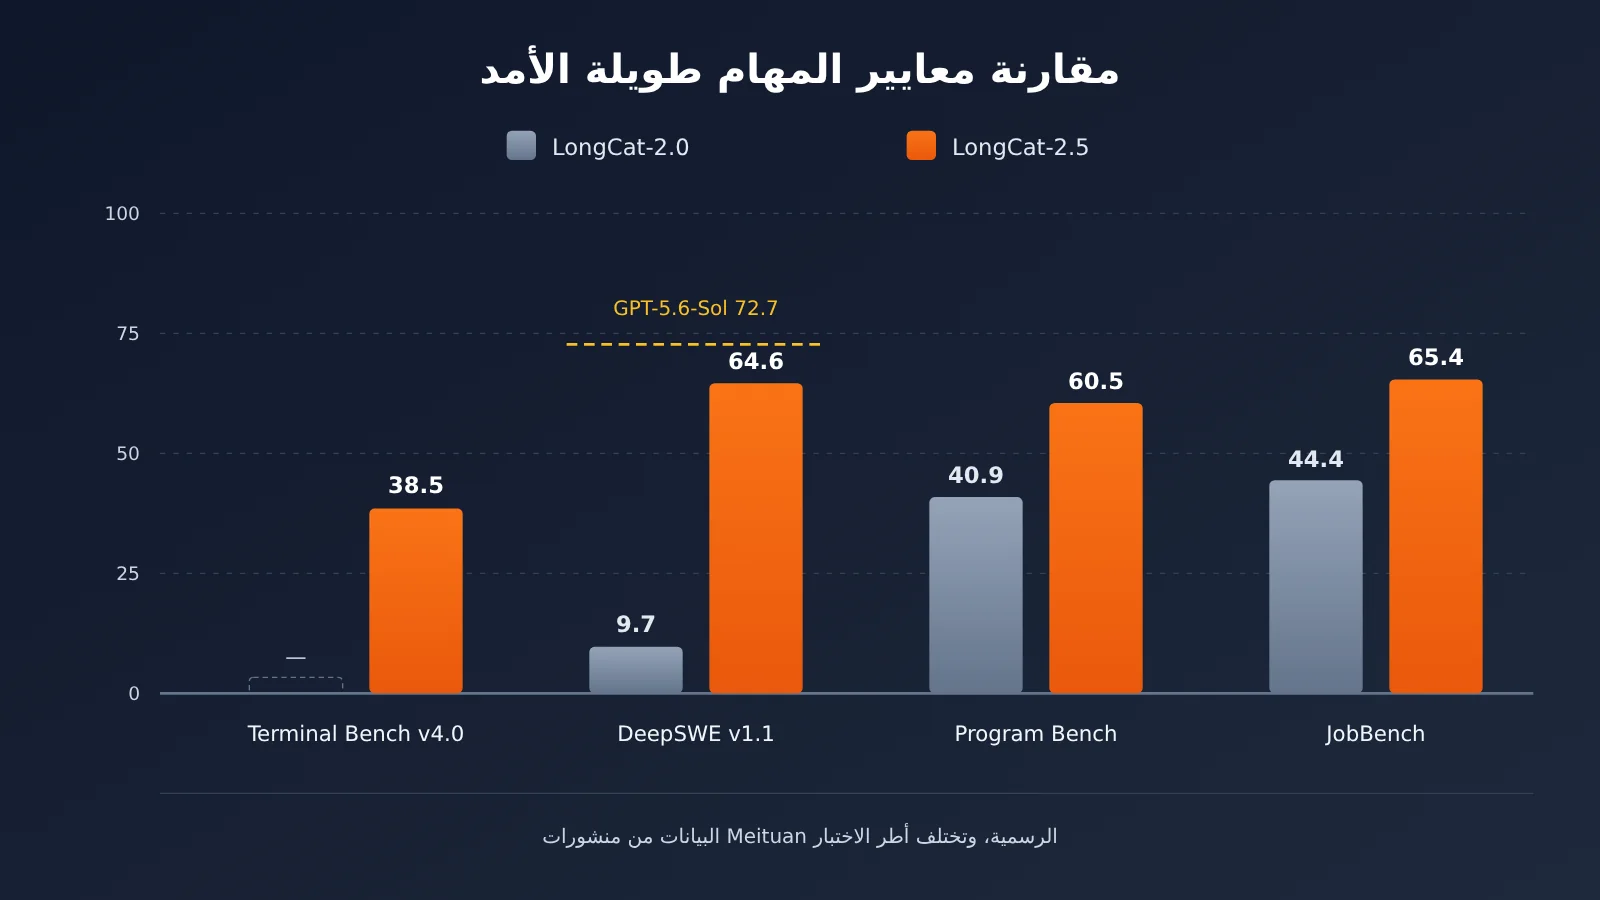
📊 ملاحظة حول المقارنة: لا تعكس معايير التقييم سوى الأداء ضمن إطار محدد، لذلك يبقى من الضروري اختبار النموذج على مهامك الخاصة. يمكنك استخدام APIYI عبر apiyi.com لمقارنة عدة نماذج متاحة باستخدام مجموعة نصوص المهام نفسها، ثم الاستعانة بالنتائج الرسمية لاختيار النموذج المناسب.
كيف يُدرَّب LongCat-2.5 على إنجاز مشروع كامل كوكيل ذكي
يمكن تلخيص أساليب التدريب على المهام طويلة المدى التي كشفت عنها مدونة Meituan التقنية في 6 محاور. ولفهمها، من المفيد النظر إلى نوع الإخفاق الفعلي في المهام الطويلة الذي يعالجه كل محور.
بيئات المهام الواقعية في LongCat-2.5 والتحقق باستخدام F2P/P2P
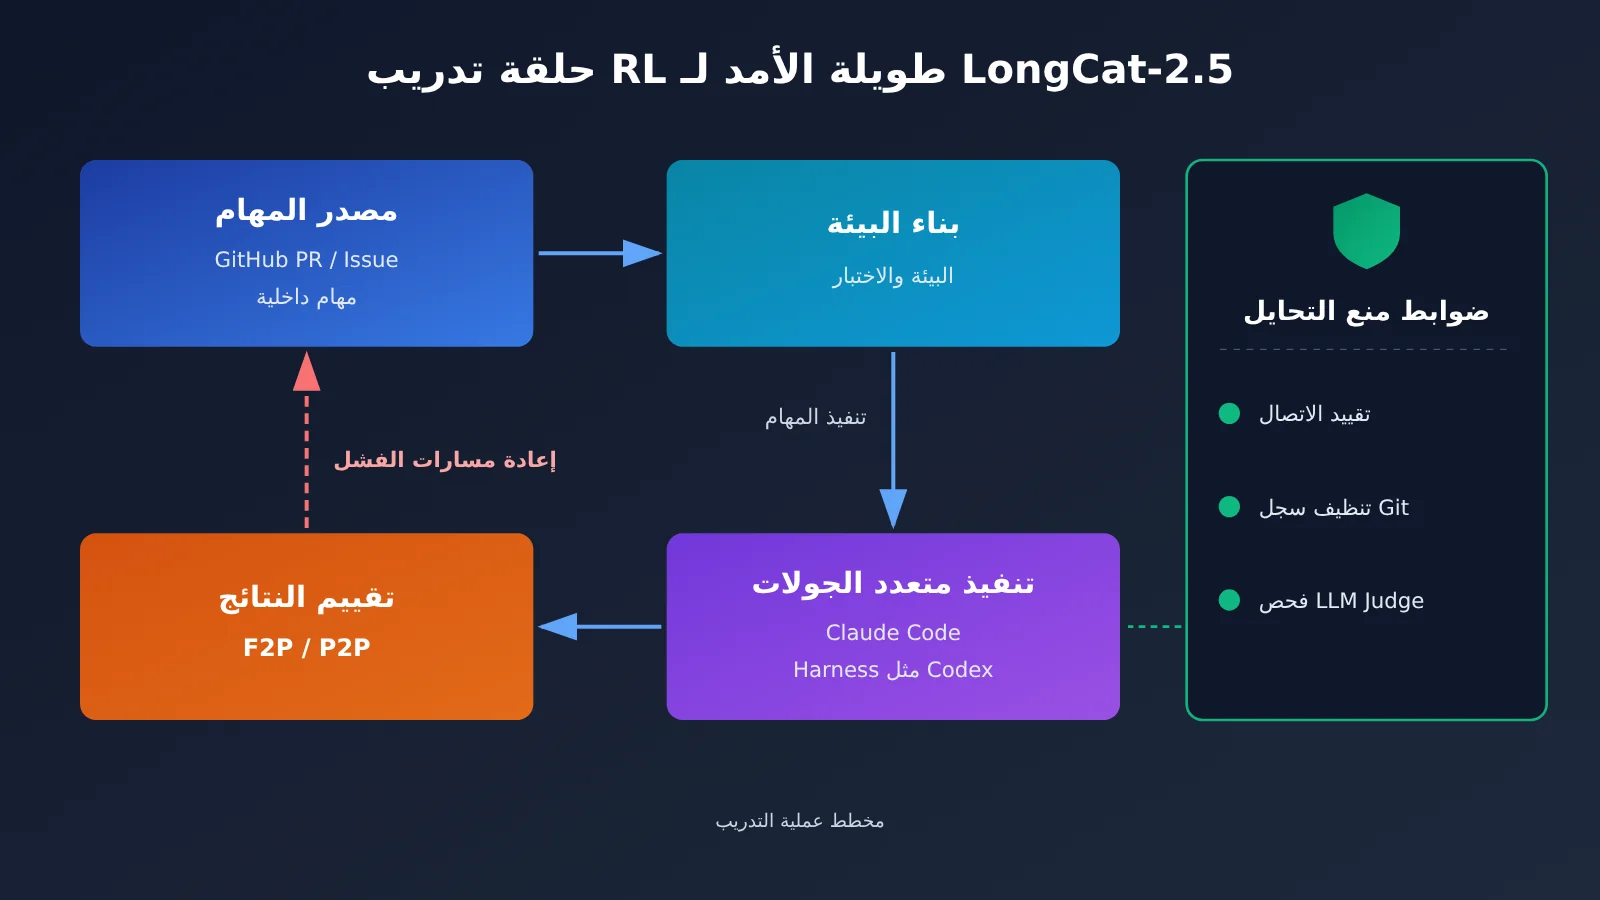
تأتي بيانات التدريب من طلبات السحب (PR) والقضايا المرتبطة بها في مستودعات GitHub العامة، ومن مهام برمجية حقيقية داخل Meituan. تبدأ العملية باختيار المهام، ثم استخدام وكيل ذكي لوضع التسميات تلقائيًا، وإعداد بيئة الشفرة، وإنشاء اختبارات قابلة للتشغيل. بعد ذلك ينفّذ النموذج المهمة، ويُحكم على نجاحه في حل المشكلة بناءً على نتائج التنفيذ الفعلية. وخلافًا لتزويد النموذج بكميات كبيرة من نصوص الشفرة فحسب، يتيح هذا الأسلوب الحصول على نتيجة واضحة: هل نجح التنفيذ فعلًا أم لا؟
يعتمد التحقق على نوعين من الاختبارات: يتحقق F2P (Fail-to-Pass) مما إذا كانت الاختبارات التي أخفقت سابقًا تنجح بعد الإصلاح، بينما يتحقق P2P (Pass-to-Pass) مما إذا كانت الاختبارات التي نجحت سابقًا لا تزال تنجح. يمنع الأول الاكتفاء بإصلاح لا يحل المشكلة، ويمنع الثاني إصلاح شيء على حساب إفساد أشياء أخرى. وتستخدم Meituan أيضًا مسارات التدريب ومعدلات النجاح لمراجعة النتائج الإيجابية والسلبية الكاذبة في الاختبارات نفسها. لكن فعالية هذا النهج تظل مرتبطة بمدى اكتمال تغطية حالات الاختبار للمتطلبات.
تعلّم LongCat-2.5 من مسارات الفشل وPartial Rollout غير المتزامن
أعاد فريق LongCat صياغة مسارات فشل الوكلاء الفعليين في صورة مهام قابلة للتكرار والتحقق، بهدف تحديد جوانب القصور في قدراتهم وإضافة بيئات تدريبية تعالجها. يشبه ذلك جمع «الأسئلة التي أُجيب عنها خطأ» في دفتر للمراجعة، بدلًا من التعلّم من الحالات الناجحة فقط. ولا تكشف المعلومات المنشورة عن عدد مسارات الفشل أو معدلات تصحيح كل نوع من الأخطاء.
تتفاوت مدة المهام الطويلة تفاوتًا كبيرًا، وقد يؤدي مسار معقد واحد إلى إبطاء دفعة التدريب بأكملها. وتعتمد آلية Partial Rollout غير المتزامن على أخذ عينات من مهام متعددة بالتوازي، ثم إيقاف المسارات غير المكتملة وحفظها عند اكتمال الدفعة، لاستئنافها في الجولة التالية. وفي الوقت نفسه، تُستبعد مجموعات العينات التي تنجح جميعها أو تفشل جميعها، لأنها لا توفر تدرجات مفيدة.
لكن هذا يعني أن رموز Token في المسار الواحد قد تأتي من إصدارات للنموذج في مراحل تدريب مختلفة. وللحد من الانحياز الناتج عن ذلك، يلجأ الفريق إلى قصّ فروق logprob وضبط مساهمة التدرجات وفق الفروق المتراكمة سابقًا. تحسّن هذه التقنية كفاءة التدريب، لكنها لا تعني بالضرورة تحسّن سرعة تنفيذ المهام لدى المستخدمين بالنسبة نفسها.
حماية LongCat-2.5 من استغلال المكافآت والتدريب عبر أطر Harness متعددة
يشير استغلال المكافآت (Reward Hacking) إلى استغلال النموذج ثغرات في تصميم المكافأة للحصول على درجة عالية دون إنجاز المهمة فعليًا، مثل الاطلاع خلسة على الإجابة أو التحايل على الاختبارات. تشمل إجراءات Meituan تقييد الاتصال بالإنترنت في بيئة التدريب، وتنظيف سجل Git وذاكرة التخزين المؤقت للملفات، واستخدام نموذج لغوي للحكم (LLM Judge) لفحص مسارات التنفيذ، وفرض عقوبات على التفكير المتكرر واستدعاء الأدوات بشكل متكرر والتفكير المفرط. هذه إجراءات للحد من المخاطر، ولا تعني أن المشكلة قد حُلّت بالكامل.
يشير Harness إلى النظام المحيط الذي ينظّم تنفيذ النموذج للمهام، بما في ذلك الأدوات وإدارة السياق وقواعد دورة تنفيذ المهمة. أضاف LongCat-2.5 عددًا قليلًا من عينات التكيّف مع الأطر في مرحلة البداية الباردة، ودمج أطرًا وأنواع مهام مختلفة مثل Claude Code وCodex في مرحلة التعلم المعزز (RL). يقلل ذلك خطر التكيّف مع قالب موجه واحد فقط، لكنه لا يضمن تطابق السلوك تمامًا بين إصدارات الأدوات المختلفة.
| طريقة التدريب | المشكلة الواقعية التي تعالجها | الحدود المعروفة |
|---|---|---|
| بيئات مهام حقيقية | الاكتفاء بكتابة الشفرة دون القدرة على تشغيلها بنجاح في البيئة | تعتمد على جودة بناء البيئة |
| التحقق باستخدام F2P / P2P | إنجاز المهمة ظاهريًا مع إدخال أخطاء تراجعية | محدود بتغطية الاختبارات |
| التعلم من مسارات الفشل | تكرار الأخطاء من النوع نفسه | لم يُعلن عدد المسارات أو معدل تصحيح الأخطاء |
| Partial Rollout غير المتزامن | انخفاض كفاءة التدريب على المهام الطويلة | لا يعني تسريع الاستدلال |
| الحماية من استغلال المكافآت | النجاح الوهمي عبر التحايل | لم يُدّعَ حل المشكلة بالكامل |
| التدريب المختلط عبر أطر Harness | فشل النموذج عند تغيير إطار Agent | لا يضمن الاتساق بين الإصدارات |
اختبار مستقل: لماذا ينجز LongCat-2.5 بعض المهام الطويلة جزئيًا؟
بعيدًا عن تصميم التدريب الرسمي واختبارات الأداء المعيارية، تقدم الاختبارات المستقلة زاوية أخرى للنظر. في 2026-11-02، ربطت TOKRACE الإصدار الرسمي من LongCat-2.5 بـ Claude Code، واستخدمته مع أدوات مثل Blender والمتصفح لإنجاز 15 مهمة إبداعية.
ومن الحالات الناجحة تصميم رف كتب بمعلمات قابلة للتعديل: جاء الإصداران، أحدهما بعرض 0.8 متر وثلاث خانات، والآخر بعرض 1 متر وأربع خانات، مطابقين للأبعاد المطلوبة وسماكة الألواح البالغة 18mm. كما سُلّمت ست صور من زوايا مختلفة، واستغرقت العملية نحو 36 دقيقة و47 طلبًا. لكن مهام أخرى كشفت أنماطًا شائعة من الإخفاق في المهام طويلة الأمد:
- أخطاء في البنية ووحدات القياس: تطلّب مخفّض سرعة كوكبي قياسًا قدره 140mm، لكن المشروع المُنشأ استخدم 140m، ولم يُسلَّم الفيديو.
- تسليم جزئي: في مهمة استغرقت 60 دقيقة لتصميم فناء معبد صيني، سُلّمت ثلاث صور نهائية فقط، مع غياب بعض اللقطات والفيديو.
- مشكلات في العلاقات المكانية: ظهر في نموذج شقة من غرفتي نوم أبواب ونوافذ بلا فتحات، وتداخل بين سرير وقاطع داخلي.
- انقطاع التنفيذ طويل الأمد: لم يكتمل فيديو تعليمي عن الرياضيات بعد تكرار انتهاء مهلة الطلبات.
توضح هذه الحالات أن تقييم المهام الطويلة لا يقتصر على التحقق من وجود مخرجات، بل يتطلب مراجعة جميع المتطلبات بندًا بندًا. وتجدر الإشارة أيضًا إلى أن الاختبار فرض حدودًا على عدد الطلبات أو الوقت أو ميزانية التنفيذ، لذلك لا يمكن إرجاع كل ما لم يُسلَّم إلى قصور في قدرات النموذج. كما أن هذا الاختبار ليس تجربة مقارنة صارمة بين النماذج.
تحليل أثر نهج التدريب على المهام طويلة الأمد في LongCat-2.5
الأثر على مطوري الوكلاء
- تغيّر معايير الاختيار: عند تقييم النماذج، تتراجع أهمية طول نافذة السياق، بينما تستحق نتائج الاختبارات المعيارية للمهام طويلة الأمد ومعدل إنجاز المهام الواقعية اهتمامًا أكبر.
- لا غنى عن التحقق: حتى لو دُرّب النموذج باستخدام F2P/P2P، فلا يزال من الضروري إجراء اختبارات وتقييمات قبول خاصة بك في بيئة الإنتاج، وقد أثبتت الاختبارات المستقلة ذلك.
- تصميم إطار التنفيذ (Harness) لا يقل أهمية: ترتبط النتائج بقوة بإطار التنفيذ؛ فقد تختلف نتائج النموذج نفسه كثيرًا عند استخدام دورة مختلفة لتنفيذ المهام.
الأثر على قطاع نماذج اللغة الكبيرة
- تحوّل التركيز في التدريب إلى «العملية»: يمتد التدريب من توليد الشفرة في جولة واحدة إلى إنجاز مشاريع كاملة ومهام هندسية متعددة الخطوات، لتصبح القدرة على بناء بيئات التعلم المعزز مجالًا جديدًا للمنافسة.
- اهتمام أكبر بمنهجيات التقييم: أصلح Terminal-Bench 2.1 نحو 28 مهمة من أصل 89 مقارنةً بالإصدار 2.0، ما يوضح أن إصدار الاختبار نفسه يؤثر بشكل ملحوظ في النتائج. لذا يحتاج القطاع إلى توضيح أكثر شفافية لظروف التقييم.
تصميم نظام Agent للمهام طويلة الأمد بالاستفادة من نهج LongCat-2.5
تقدم طريقة تدريب LongCat-2.5 درسًا مباشرًا لمطوري التطبيقات: إذا كان النموذج يُدرَّب على «التحقق المرحلي، والتعافي من الفشل، ومنع التحايل»، فمن المفيد تضمين هذه الآليات صراحةً في نظام Agent أيضًا. التوصيات الهندسية التالية مستمدة من أساليب التدريب المنشورة، وليست وظائف أعلنت الجهة المطورة رسميًا عن تنفيذها.
| الآلية الهندسية | فكرة التدريب المقابلة | طريقة التطبيق |
|---|---|---|
| التحقق المرحلي | التحقق بأسلوب F2P | تشغيل برنامج الفحص بعد انتهاء كل مهمة فرعية |
| الحماية من التراجع | التحقق بأسلوب P2P | تشغيل مجموعة اختبارات التراجع الكاملة بعد كل تعديل |
| تسجيل حالات الفشل | التعلم من مسارات الفشل | كتابة رسائل الخطأ في ملف التقدم وإدراجها في الجولة التالية |
| الحد الأقصى للميزانية | معاقبة الاستدعاءات المتكررة | تحديد الحد الأقصى للجولات، والمهلة الزمنية، وعدد استدعاءات الأدوات |
| قبول المخرجات | منع التحايل على المكافأة (Reward Hacking) | فحص الملفات الفعلية بدلًا من الاكتفاء بملخص النموذج |
فيما يلي مثال مبسط لحلقة Agent تتحقق من كل مرحلة، ويوضح تسجيل التقدم، وإعادة تمرير حالات الفشل، وتحديد سقف للميزانية:
import json, subprocess, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI المتوافقة مع OpenAI
)
MODEL = "gpt-4o-mini"  # استخدم معرّف النموذج المتاح فعليًا في قائمة نماذج المنصة
MAX_ROUNDS = 8         # سقف الميزانية لمنع الحلقات اللانهائية

def run_check(cmd: str) -> tuple[bool, str]:
    r = subprocess.run(cmd, shell=True, capture_output=True, text=True, timeout=300)
    return r.returncode == 0, (r.stdout + r.stderr)[-2000:]

def run_stage(stage: dict, progress: dict) -> bool:
    failures = []
    for i in range(MAX_ROUNDS):
        prompt = (f"阶段目标:{stage['goal']}\n"
                  f"已完成阶段:{progress['done']}\n"
                  f"历史失败(请避免重复):{failures[-3:]}")
        resp = client.chat.completions.create(
            model=MODEL, messages=[{"role": "user", "content": prompt}])
        # حُذفت هنا خطوة تحليل مخرجات النموذج وكتابتها في ملفات الشفرة
        ok, log = run_check(stage["check"])          # التحقق المرحلي، على غرار F2P
        reg_ok, reg_log = run_check("pytest -q")     # اختبار التراجع، على غرار P2P
        if ok and reg_ok:
            progress["done"].append(stage["name"])
            return True
        failures.append(log if not ok else reg_log)
    progress["blocked"] = stage["name"]
    return False

progress = {"done": [], "blocked": None}
stages = [{"name": "api", "goal": "实现用户接口", "check": "pytest tests/test_api.py -q"}]
for s in stages:
    if not run_stage(s, progress):
        break
json.dump(progress, open("progress.json", "w"), ensure_ascii=False)
تكمن أهمية هذا الهيكل في أن لكل مرحلة أمر قبول قابلًا للتنفيذ، وأن سجلات الفشل تُعاد إلى موجه الجولة التالية، وأن التقدم يُكتب في ملف بدلًا من بقائه في السياق فقط. وحتى عندما تكون نافذة السياق كبيرة بما يكفي، فإن حفظ التقدم والقيود خارجيًا كحالة منظَّمة يقلل بدرجة ملحوظة خطر الانحراف عن الهدف أثناء تنفيذ المهام الطويلة.
🚀 نصيحة للبدء سريعًا: عند بناء نموذج أولي لوكيل، يمكنك الحصول على رصيد تجريبي عبر APIYI apiyi.com، ثم استخدام مفتاح API واحد للتبديل بين نماذج مختلفة وتشغيل دورة التحقق المرحلية الموضحة أعلاه، لمعرفة أي نموذج ينجز مهمتك بأكبر قدر من الاكتمال.
إذا كان مشروعك يتطلب موثوقية عالية، يمكنك أيضًا اعتماد «التحقق المتبادل»: اطلب من نموذج آخر مراجعة الناتج النهائي مقابل قائمة المتطلبات، بندًا بندًا. وبفضل الواجهة الموحدة من APIYI apiyi.com، يمكنك استدعاء نموذج التنفيذ ونموذج المراجعة من الشفرة نفسها، مع سهولة التبديل بينهما.
الأسئلة الشائعة FAQ
س1: هل تعني نافذة السياق بحجم 1M في LongCat-2.5 أنه قادر على إنجاز مشاريع كبيرة؟
ليس بالضرورة. تمثل نافذة السياق بحجم 1M سعة الطلب الواحد، بما في ذلك المدخلات والمخرجات، وتتيح للنموذج قراءة المزيد من الشيفرة والوثائق. لكن إنجاز المشروع يعتمد أيضًا على التخطيط واستدعاء الأدوات وإصلاح الأخطاء والتحقق من المخرجات، وهي جوانب دُرّب LongCat-2.5 عليها تحديدًا باستخدام التعلم المعزز للمهام طويلة الأمد.
س2: كيف يقارن LongCat-2.5 مع GPT-5.6-Sol وClaude Opus 5 في المهام طويلة الأمد؟
وفقًا للجدول الرسمي، يتفوق LongCat-2.5 قليلًا على GPT-5.6-Sol في BrowseComp بنتيجة 91.9، وفي Terminal Bench v4.0 بنتيجة 38.5. لكنه سجل 64.6 في DeepSWE، مقابل 72.7 لـ GPT-5.6-Sol، كما تقل نتيجته في Terminal Bench v4.0 بمقدار 15.4 نقطة عن Claude Opus 5. وتختلف أطر الاختبار، لذا لا ينبغي اعتبار النتائج ترتيبًا موحدًا.
س3: متى صدر الإصدار النهائي من LongCat-2.5؟ وهل أُتيحت أوزان النموذج كمصدر مفتوح؟
أُطلق إصدار Preview على منصة API في 2026-09-25، وصدر الإصدار النهائي في 2026-11-02. الموقع الرسمي وواجهة API متاحان بالفعل، لكن حتى 2026-11-03 لم يكن نشر أوزان الإصدار النهائي مؤكدًا. وأفاد الفريق الرسمي بأنها ستُتاح لاحقًا على GitHub وHugging Face.
س4: هل يمكن الآن استدعاء LongCat-2.5 عبر APIYI؟
وفقًا للإعلان المنشور في 2026-11-02، لم يكن LongCat-2.5 متاحًا على APIYI آنذاك، وكان من المخطط إضافته لاحقًا. للاطلاع على حالة توفره الحالية، راجع قائمة النماذج على APIYI عبر apiyi.com. في غضون ذلك، يمكنك استخدام النماذج المتاحة على المنصة لبناء أطر عمل للوكلاء تتضمن التحقق المرحلي وإعادة تغذية حالات الفشل، ثم استبدال معرّف النموذج فقط عند إتاحته.
س5: كيف أختبر قدرات النموذج كوكيل في المهام طويلة الأمد بتكلفة منخفضة؟
يُنصح بإعداد 3-5 مهام متعددة الخطوات قريبة من احتياجات عملك، مع نصوص برمجية للتحقق الآلي من قبول النتائج. سجّل لكل نموذج معدل التسليم الكامل ومتوسط عدد الجولات وأنواع الإخفاقات. وبفضل واجهة API المتوافقة مع OpenAI لدى APIYI عبر apiyi.com، يمكنك مقارنة عدة نماذج باستخدام مفتاح API واحد والنصوص البرمجية نفسها. ويحصل المستخدمون الجدد أيضًا على رصيد اختبار مجاني للتقييم الأولي.
س6: ما أوجه القصور المعروفة في قدرات LongCat-2.5 على المهام طويلة الأمد؟
رُصدت في اختبارات أجرتها جهات مستقلة مشكلات مثل أخطاء وحدات القياس والعلاقات المكانية، وعدم تسليم الفيديو، وانقطاع الطلب بسبب انتهاء المهلة. ولم يعلن الفريق الرسمي أن مشكلة التحايل على المكافأة (Reward Hacking) قد حُلّت بالكامل، كما لم يُكشف عن حجم مسارات الفشل أو معدل تصحيحها. ولا تزال الأبعاد الهندسية ودقة المعلومات واكتمال المخرجات تتطلب تحققًا بشريًا.
أبرز النقاط حول قدرات LongCat-2.5 في مهام الوكلاء طويلة الأمد
- سعة السياق لا تعني إنجاز المهمة: مليون رمز هو حجم نافذة السياق، لا معدل نجاح المشاريع. وتتطلب القدرة على إنجاز المهام طويلة الأمد تدريبًا منفصلًا.
- التدريب في بيئات حقيقية: تُبنى بيئات قابلة للتنفيذ انطلاقًا من طلبات السحب والمشكلات على GitHub والمهام الداخلية، للحصول على تغذية راجعة.
- التحقق بنوعين من الاختبارات: يتحقق F2P من حل المشكلة، بينما يكشف P2P ما إذا كان الحل قد تسبب في تراجع وظائف قائمة.
- التعلم من الإخفاقات: تُعاد صياغة مسارات إخفاق الوكلاء الفعلية في صورة مهام تدريبية قابلة للتحقق.
- قراءة النتائج في سياقها: ترتبط نتائج الاختبارات المعيارية ارتباطًا وثيقًا ببيئة الاختبار (Harness)، ولا تزال الاختبارات المستقلة تكشف عن مخرجات غير مكتملة.
- تصميم النظام الهندسي بالتوازي: لا غنى عن التحقق المرحلي، وتسجيل الإخفاقات، وتحديد سقف للميزانية، ومعايير قبول المخرجات. ويمكن الاستعانة بـ APIYI على apiyi.com لمقارنة النماذج والتحقق من أدائها.
الخلاصة
أبرز ما يشير إليه إصدار LongCat-2.5 ليس مجرد ظهور نموذج آخر بنافذة سياق تبلغ مليون رمز، بل انتقال محور التدريب من «كم يستطيع النموذج أن يقرأ؟» إلى «هل يستطيع إنجاز المشروع كاملًا؟»:
- تعريف أدق للمشكلة: تحدث معظم إخفاقات الوكلاء في المهام طويلة الأمد أثناء التنفيذ والتحقق والتسليم، لا بسبب نقص السياق.
- أساليب تدريب تستهدف المشكلات الفعلية: تعالج بيئات المهام الحقيقية، واختبارات F2P/P2P، ومسارات الإخفاق، والتنفيذ الجزئي (Partial Rollout)، ومنع استغلال الثغرات، والتدريب عبر بيئات اختبار مختلفة، أنواعًا متباينة من الإخفاقات الواقعية.
- وضوح حدود الأدلة: تظهر النتائج الرسمية تحسنًا ملحوظًا، لكن الفجوة مع النماذج الرائدة ما زالت قائمة. كما تشير الاختبارات المستقلة إلى أن التسليم الكامل لا يزال بحاجة إلى مراجعة بشرية.
بالنسبة للمطورين، يتمثل النهج الأكثر واقعية في تطبيق الأفكار نفسها على أنظمة الوكلاء الخاصة بهم، وقياس أداء النماذج وفق معايير قبول قابلة للتنفيذ، بدلًا من الاكتفاء بالنظر إلى المعاملات ولوحات التصنيف. ويمكن استخدام APIYI على apiyi.com لمقارنة النماذج والتحقق من أدائها على مهام حقيقية عبر واجهة موحدة، قبل تحديد مزيج النماذج المناسب لبيئة الإنتاج.
📚 المراجع
- فريق Meituan التقني – المقال التقني عن LongCat-2.5: شرح مفصل لأساليب تدريب الوكلاء على المهام طويلة المدى
- الرابط:
tech.meituan.com/2026/11/02/Meituan-LongCat-2.5.html -
الوصف: المصدر الأصلي لتصميمات التدريب مثل F2P/P2P وPartial Rollout ومنع استغلال دالة المكافأة (Reward Hacking)
-
مدونة LongCat الرسمية: بيانات المعايير وطرق التقييم
- الرابط:
longcat.ai/blog/longcat-2.5 -
الوصف: جدول التقييم الكامل، وإطار تشغيل الوكيل (Harness) وإعدادات المعلمات لكل معيار
-
وثائق معلمات نموذج LongCat: شرح معلمات السياق والمخرجات
- الرابط:
longcat.ai/platform/docs/zh/api/model-params -
الوصف: معلمات الاستدعاء، مثل طول السياق و
max_tokensوميزانية التفكير -
Terminal-Bench: معيار لتقييم وكلاء سطر الأوامر
- الرابط:
tbench.ai -
الوصف: لفهم ارتباط النتائج بإطار تشغيل الوكيل واختلافات الإصدارات
-
DeepSWE: معيار لتقييم وكلاء هندسة البرمجيات في المهام طويلة المدى
- الرابط:
deepswe.datacurve.ai -
الوصف: تصميم اختبار يضم 113 مهمة أصلية و91 مستودعًا مفتوح المصدر
-
TOKRACE – سجل الاختبارات العملية لـ LongCat-2.5: اختبار مستقل يضم 15 مهمة إبداعية
- الرابط:
tokrace.com/zh-CN/guides/longcat-2-5-release - الوصف: حالات واقعية، منها إنجاز المهام الطويلة جزئيًا وأخطاء الوحدات
الكاتب: فريق APIYI التقني
للتواصل التقني: تفضلوا بزيارة الصفحة الرئيسية لـ APIYI على apiyi.com للتواصل معنا وتبادل الخبرات حول التطبيقات الهندسية للوكلاء في المهام طويلة المدى واختيار النماذج.