작성자 주: LongCat-2.5가 1M 컨텍스트에만 의존하지 않고 6가지 학습 방향을 통해 장기 실행 Agent의 프로젝트 완수 능력을 강화한 이유를 살펴보고, 개발자가 참고할 만한 엔지니어링 방법을 정리해요.
AI Agent를 개발해 봤다면 이런 상황을 겪어본 적 있을 거예요. 작업 도중 오류가 발생하자 Agent가 같은 잘못된 명령을 반복하고, 결국 완성도 높아 보이는 요약을 내놓지만 정작 중요한 결과물 몇 개는 빠져 있는 경우죠. 메이퇀이 2026-11-02에 정식 출시한 LongCat-2.5는 1M 컨텍스트 윈도우를 강조하는 데 그치지 않고 장기 실행 Agent가 프로젝트 전체를 완수하는 능력에 초점을 맞췄어요.
이 글은 단순한 모델 사양 홍보가 아니에요. 메이퇀 기술 블로그는 장기 실행 강화학습의 구체적인 학습 설계를 공개했고, 제3자도 정식 출시 당일 장기 작업을 실험했어요. 이 글에서는 공식 학습 설계, 공식 벤치마크 성적, 제3자의 실제 사용 경험을 구분하고, 각각 무엇을 입증할 수 있고 무엇은 입증할 수 없는지 설명해요.
핵심 내용: 이 글을 읽으면 100만 Token 컨텍스트가 곧 프로젝트 성공률을 뜻하지 않는 이유와 LongCat-2.5가 장기 작업 능력을 보완하는 방법, 그리고 이러한 아이디어를 자신의 Agent 엔지니어링에 적용하는 방법을 이해할 수 있어요.
LongCat-2.5 핵심 정보 한눈에 보기
LongCat-2.5는 메이퇀 LongCat 팀이 출시한 네이티브 멀티모달 대규모 언어 모델로, 장기 에이전트 작업(Long-Horizon Agentic Tasks)에 초점을 맞췄어요. LongCat-2.0을 기반으로 장기 작업 궤적을 추가해 복잡한 코드베이스 개발과 완전한 프로젝트 구축 능력을 강화했어요.
| 항목 | 상세 정보 |
|---|---|
| 출시일 | 2026-09-25 Preview 출시, 2026-11-02 정식 버전 출시 |
| 출시 주체 | 메이퇀 LongCat 팀 |
| 모델 규모 | 전체 파라미터 1.6T, MoE 희소 활성화 방식으로 토큰당 약 48B 활성화 |
| 컨텍스트 윈도우 | 1,048,576 Tokens(약 1M), 입력과 출력 포함 |
| 핵심 분야 | 장기 에이전트, 에이전틱 코딩, 비주얼 프로그래밍, 다단계 도구 호출 |
| 공개 현황 | 공식 웹사이트와 API 이용 가능, 정식 버전 가중치 공개 여부는 아직 미확인 |
참고로 2026-11-03 기준, APIYI는 LongCat-2.5 관련 소개 글을 공개했지만 당시에는 플랫폼에 아직 출시되지 않았으며 추후 연동할 계획이라고 밝혔어요. 실제로 호출할 수 있는 모델은 APIYI apiyi.com의 실시간 모델 목록을 확인해 주세요. 이 글의 코드 예제는 일반적인 OpenAI 호환 형식을 사용하므로 연동된 모든 모델에 적용할 수 있어요.
100만 Token 컨텍스트만으로는 장기 Agent 작업을 완수하기 어려운 이유
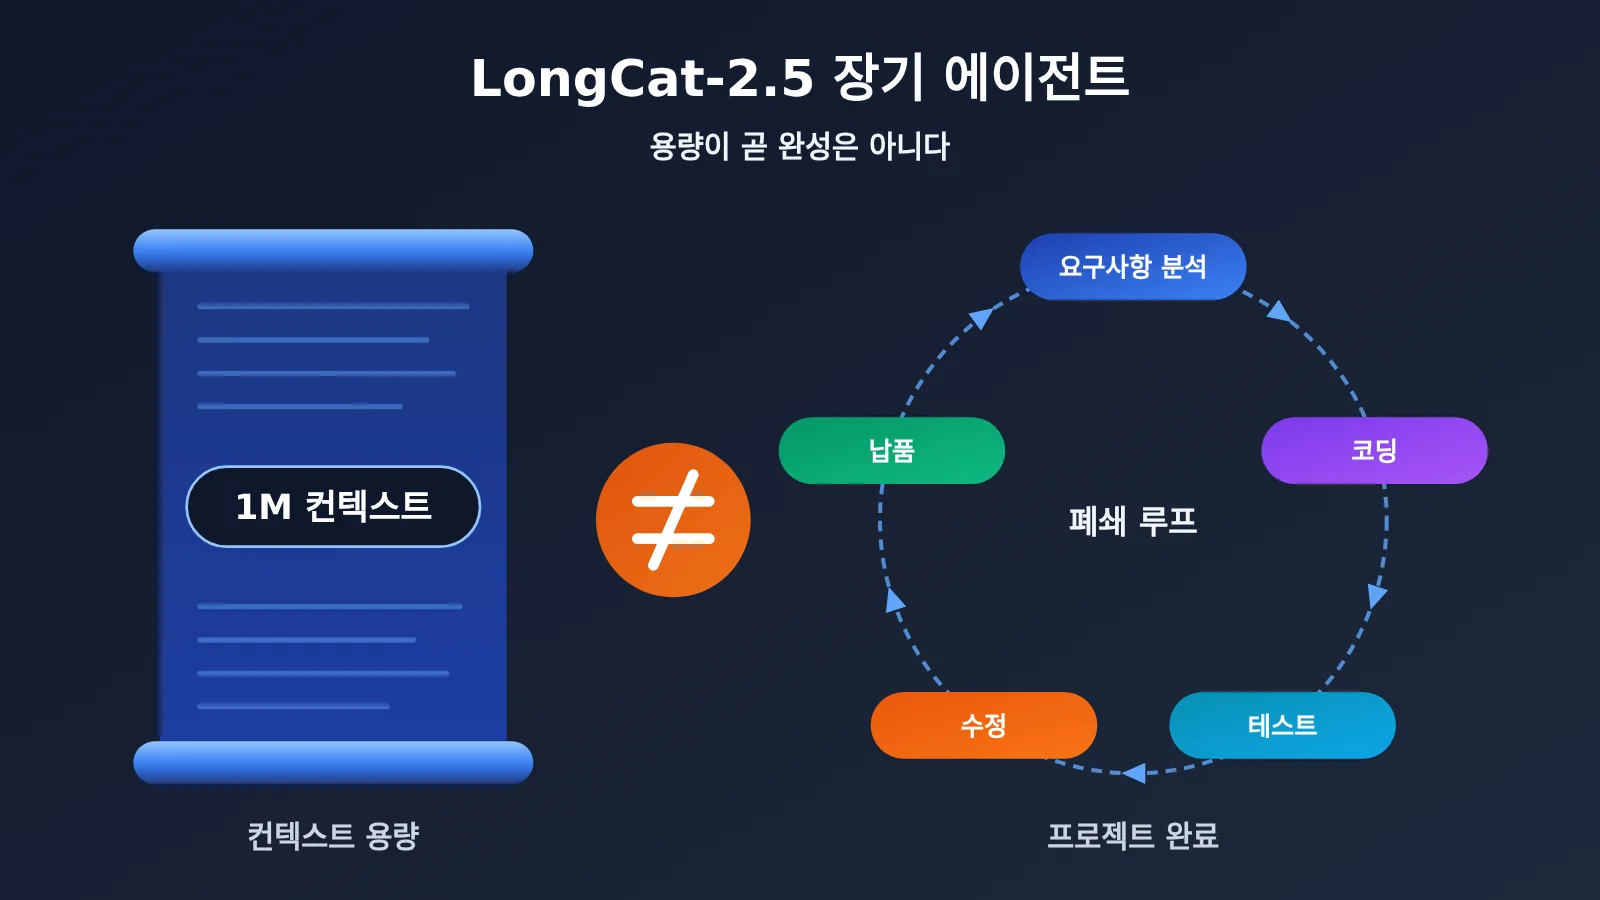
긴 컨텍스트(Long Context)는 한 번의 요청에 담을 수 있는 Token의 총량을 뜻해요. 1M 컨텍스트 윈도우가 있으면 모델이 소스 코드, 문서, 대화 기록을 한 번에 더 많이 읽을 수 있어 대규모 저장소를 이해하는 데 도움이 돼요. 하지만 이 수치만으로 “긴 문서에서 항상 정확하게 검색한다”, “도구 호출이 계속 성공한다”, “출력 파일이 반드시 올바르다”고 결론 내릴 수는 없어요.
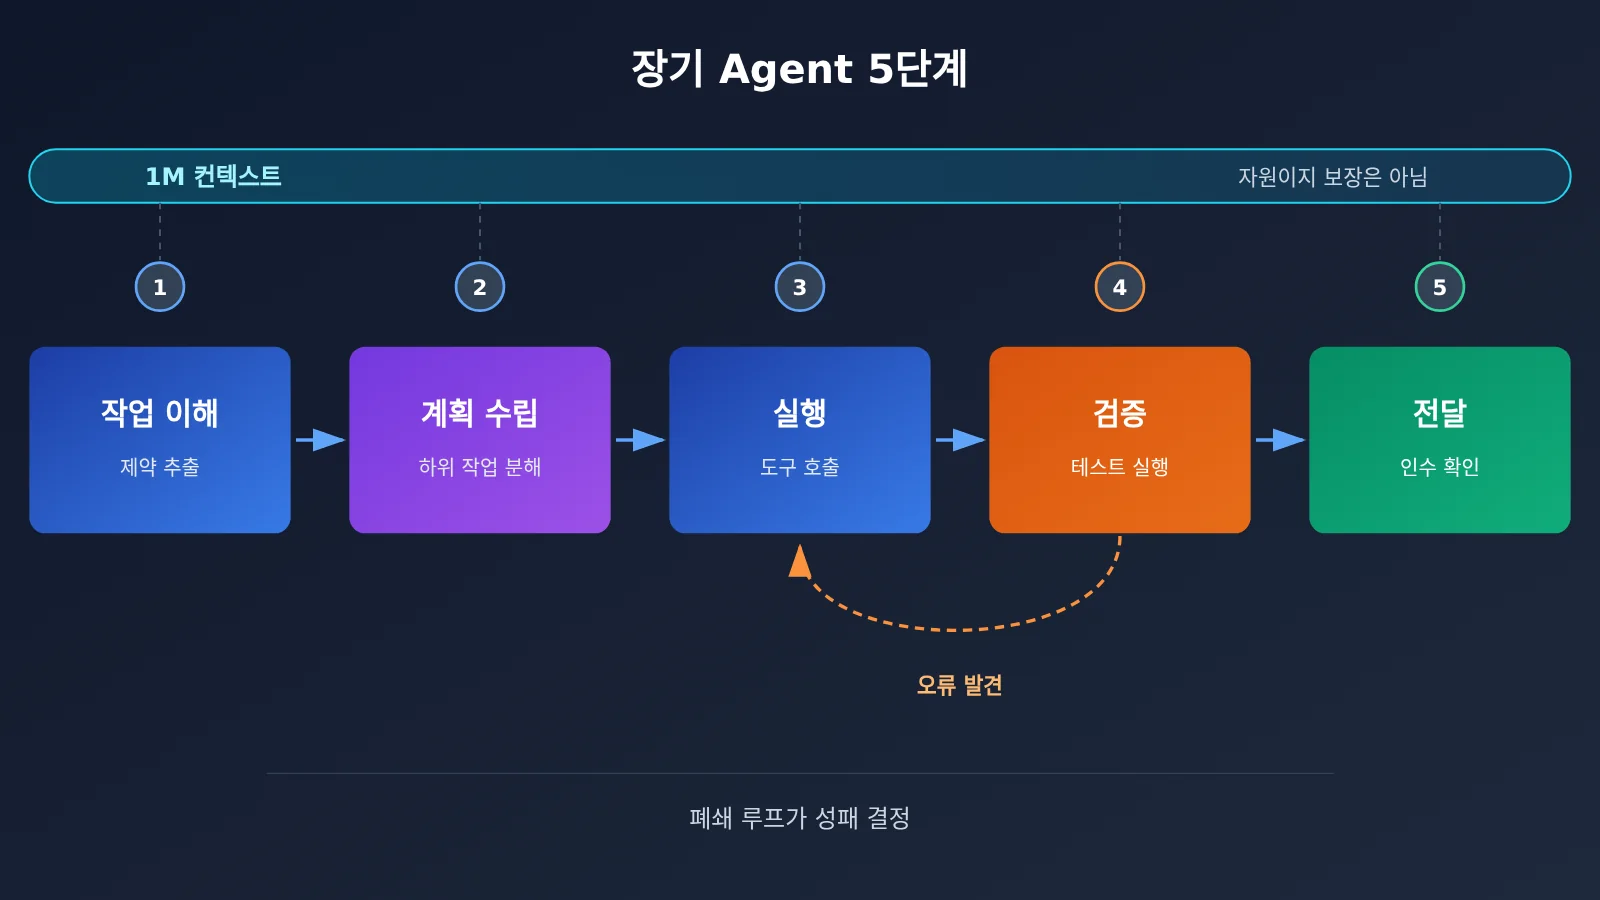
장기 에이전트(Long-Horizon Agent)는 다른 차원의 문제예요. 저장소 읽기, 코드 작성, 도구 호출, 테스트 실행, 오류 발견과 수정, 재검증, 최종 결과물 전달처럼 서로 의존하는 여러 단계를 외부 환경에서 지속적으로 수행해야 해요. 어느 한 단계에서 오류가 발생하면 이후 단계가 모두 잘못된 상태를 바탕으로 진행될 수 있어요.
| 비교 항목 | 긴 컨텍스트 능력 | 장기 Agent 능력 |
|---|---|---|
| 본질 | 단일 요청의 용량 | 여러 단계를 지속적으로 수행하는 신뢰성 |
| 측정 방식 | 얼마나 많은 Token을 담을 수 있는가 | 최종 결과가 검수 기준을 통과하는가 |
| 핵심 요소 | 어텐션 메커니즘과 긴 텍스트 학습 | 계획 수립, 도구 호출, 오류 피드백 활용, 종료 판단 |
| 대표적인 실패 | 긴 문서에서 검색 결과 누락 | 작업 중 목표 이탈, 반복 호출, 결과물 전달 누락 |
| 프로젝트 성공과의 관계 | 필요한 자원 중 하나 | 성공 여부에 더 직접적인 영향 |
다시 말해 컨텍스트는 “작업대가 얼마나 넓은가”이고, 장기 작업 능력은 “일을 끝까지 해낼 수 있는가”예요. 작업대가 아무리 넓어도 모델이 테스트 실패에 맞춰 계획을 조정하지 못하거나 처음의 제약 조건을 잊으면 프로젝트는 중간에 실패할 수 있어요. LongCat-2.5가 장기 작업 학습에 중점을 둔 근본적인 이유도 여기에 있어요.
LongCat-2.5 장기 수행 에이전트 벤치마크 성적 변화
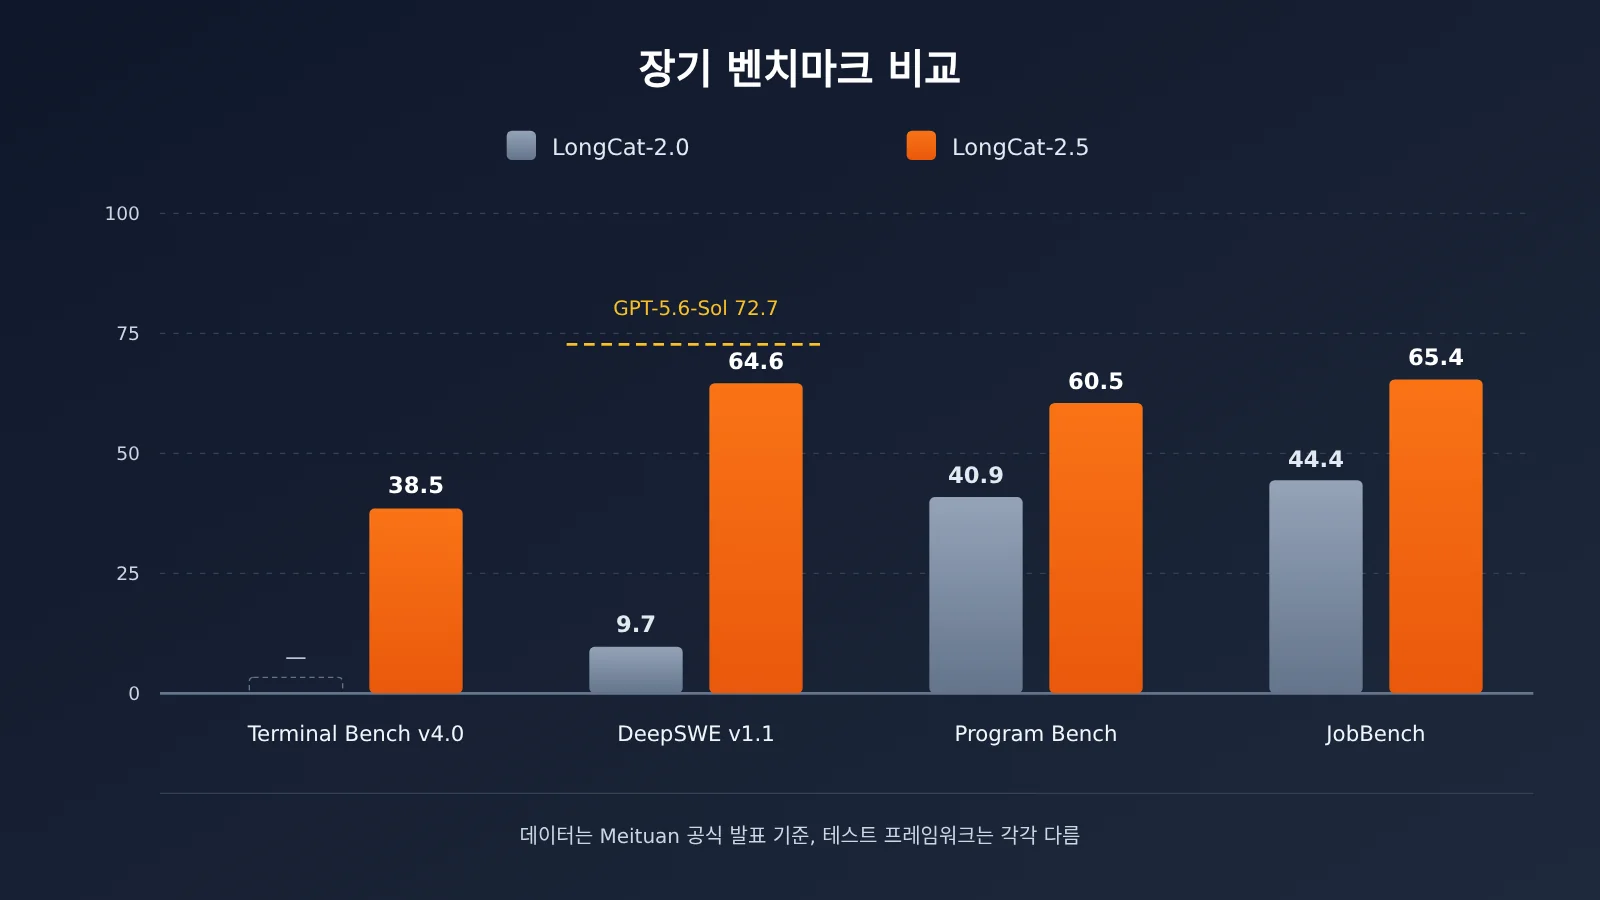
메이퇀은 여러 장기 수행 에이전트 벤치마크에서 LongCat-2.5와 이전 세대를 비교한 결과를 공개했어요. 아래 수치는 공식 발표 자료에서 가져왔으며, 향상 폭은 상대적 백분율이 아닌 점수 차이예요.
| Benchmark | LongCat-2.0 | LongCat-2.5 | 향상 폭 | 평가 항목 |
|---|---|---|---|---|
| Terminal Bench v2.1 | 70.8 | 88.4 | +17.6 | 터미널 환경에서 실제 작업 수행 |
| Terminal Bench v4.0 | 3.0 | 38.5 | +35.5 | 난도가 더 높은 장기 터미널 작업 |
| DeepSWE v1.1 | 9.7 | 64.6 | +54.9 | 장기 소프트웨어 엔지니어링 작업 |
| Program Bench Almost Resolved | 2.5 | 25.5 | +23.0 | 프로그램 구축 작업의 완료 근접도 |
| NL2Repo | 40.9 | 60.5 | +19.6 | 자연어 요구사항으로 저장소 생성 |
| MCP Atlas | 61.8 | 83.1 | +21.3 | 다중 도구 호출 |
| JobBench | 44.4 | 65.4 | +21.0 | 직무별 전문 산출물 |
향상 폭은 뚜렷하지만, 해석할 때는 몇 가지 한계를 고려해야 해요. DeepSWE 점수는 9.7에서 64.6으로 뛰었지만, 공식 비교에서 GPT-5.6-Sol의 72.7에는 여전히 못 미쳐요. Terminal Bench v4.0의 38.5는 GPT-5.6-Sol의 37.3보다 약간 높지만 Claude Opus 5의 53.9보다는 15.4점 낮아요. 어려운 터미널 작업은 아직 완전히 해결되지 않았다는 뜻이에요.
평가 조건도 중요해요. Terminal Bench는 Claude Code Harness, DeepSWE는 mini-swe-agent를 사용하고, JobBench는 LLM-as-Judge 방식으로 채점해요. 따라서 점수는 각각의 실행 프레임워크에 영향을 받아요. 공식 표의 경쟁 모델 성적은 일부는 공개 보고서에서 가져왔고 일부는 메이퇀이 직접 측정했으므로, 동일한 조건의 독립적인 순위표로 볼 수 없어요. 내부 벤치마크인 LongCat AppDev(47.7 → 73.7)도 공개적으로 재현할 수 없어요.
📊 비교 참고사항: 벤치마크는 특정 프레임워크에서의 성능만 보여주므로, 최종적으로는 직접 수행할 작업에서 검증해야 해요. APIYI apiyi.com에서 동일한 작업 스크립트로 연결된 여러 모델을 비교하고, 공식 성적도 함께 고려해 모델을 선택할 수 있어요.
LongCat-2.5는 Agent가 프로젝트 전체를 완수하도록 어떻게 훈련할까요?
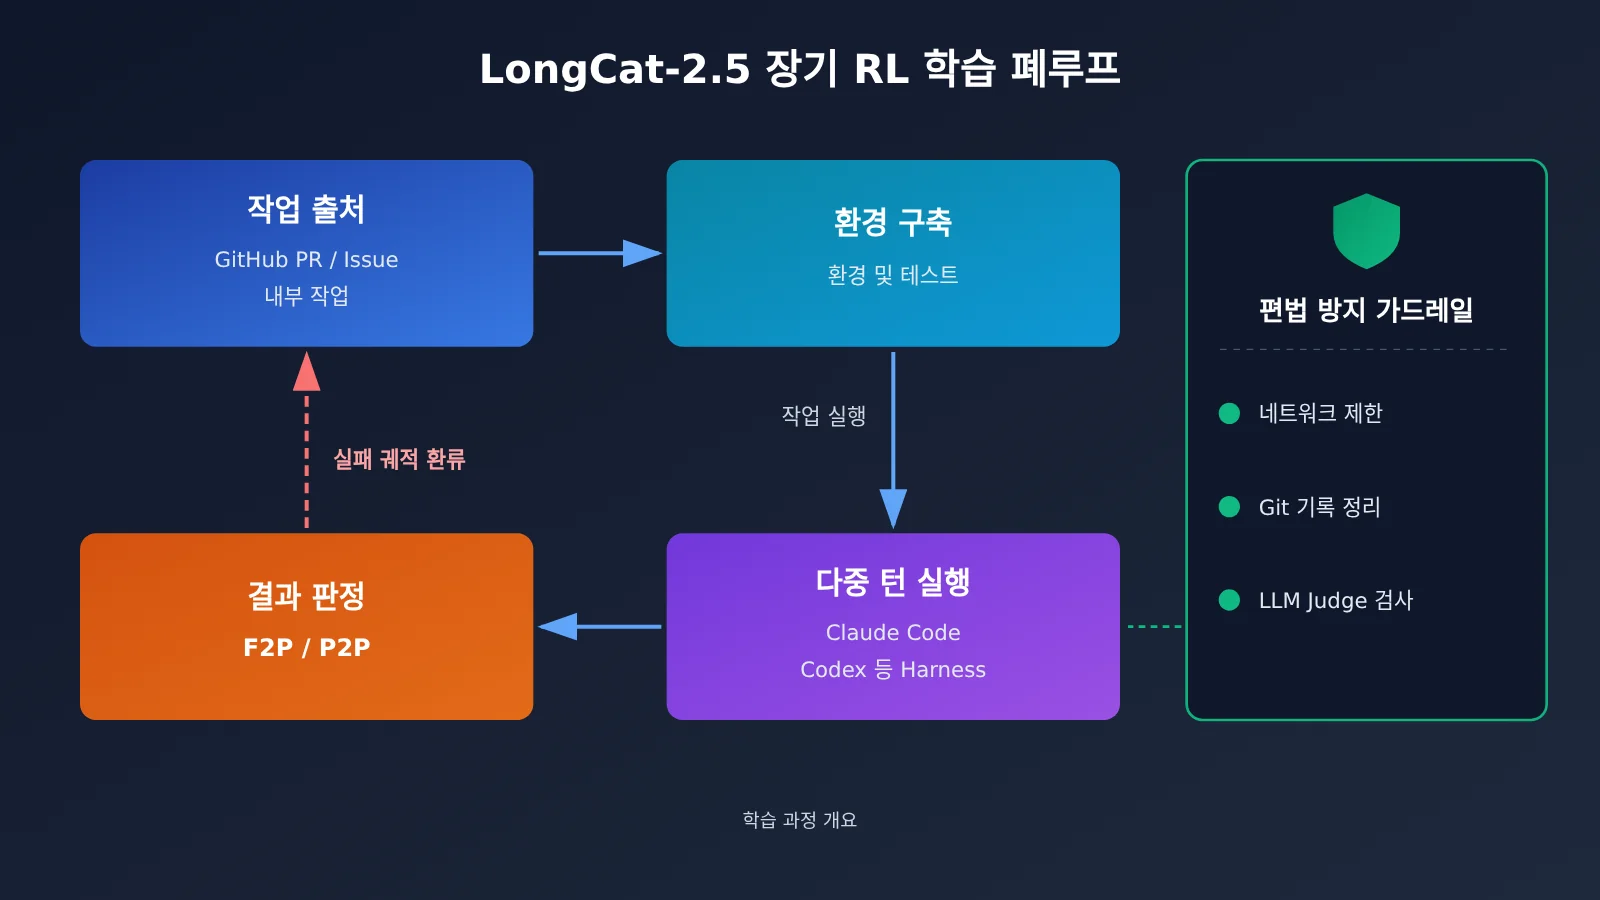
메이퇀 기술 블로그에서 공개한 장기 작업 훈련 방식은 6가지 방향으로 정리할 수 있어요. 각 방식이 긴 작업에서 발생하는 어떤 실제 실패에 대응하는지 살펴보는 것이 핵심이에요.
LongCat-2.5의 실제 작업 환경과 F2P/P2P 검증
훈련 데이터는 GitHub 공개 저장소의 PR과 관련 Issue, 메이퇀 내부의 실제 코드 작업에서 가져와요. 작업을 선별하고 Agent로 자동 라벨링한 뒤, 코드 환경을 구축하고 실행 가능한 테스트를 합성해요. 이후 모델이 작업을 수행하도록 하고 실제 실행 결과를 바탕으로 문제 해결 여부를 판단해요. 코드 텍스트를 대량으로 입력하는 방식과 달리, 실제로 실행이 성공했는지 피드백을 얻을 수 있어요.
검증에는 두 종류의 테스트를 사용해요. F2P(Fail-to-Pass)는 원래 실패하던 테스트가 수정 후 통과하는지 확인하고, P2P(Pass-to-Pass)는 원래 통과하던 테스트가 여전히 통과하는지 확인해요. 전자는 문제를 제대로 해결했는지, 후자는 하나를 고치면서 다른 부분을 망가뜨리지 않았는지 확인해요. 메이퇀은 훈련 궤적과 통과율을 바탕으로 테스트 자체의 거짓 양성과 거짓 음성도 역으로 점검해요. 다만 효과는 테스트 케이스가 요구사항을 얼마나 빠짐없이 다루는지에 따라 달라져요.
LongCat-2.5 실패 궤적 학습과 비동기 Partial Rollout
공식 자료에 따르면, 실제 에이전트의 실패 궤적을 재현하고 검증할 수 있는 작업으로 재구성해 부족한 능력을 파악하고 학습 환경을 보강해요. 성공 사례만 학습하는 대신 ‘틀린 문제’를 오답 노트에 모으는 셈이에요. 다만 공개 자료에는 실패 궤적의 수와 오류 유형별 수정률이 나와 있지 않아요.
장시간 작업은 소요 시간의 편차가 매우 커서, 복잡한 궤적 하나가 전체 학습 배치를 지연시킬 수 있어요. 비동기 Partial Rollout은 여러 작업을 병렬로 샘플링하다가 배치가 채워지면 완료되지 않은 궤적을 중단하고 저장해 다음 라운드에서 이어가는 방식이에요. 동시에 전부 성공하거나 전부 실패해 유효한 그래디언트를 제공하지 못하는 샘플 그룹은 걸러내요.
이 방식에서는 한 궤적의 토큰이 서로 다른 학습 단계의 모델에서 생성될 수 있어요. 공식 자료에 따르면 logprob 차이를 클리핑하고, 과거부터 누적된 차이에 따라 그래디언트 기여도를 조정해 편향을 제어해요. 이 기술은 학습 효율을 개선하는 것이므로, 사용자 측 작업 실행 속도도 같은 비율로 빨라진다고 볼 수는 없어요.
LongCat-2.5의 Reward Hacking 방지와 크로스 Harness 학습
Reward Hacking은 모델이 답을 몰래 보거나 테스트를 우회하는 등 보상 설계의 허점을 이용해 실제로 작업을 완수하지 않고도 높은 점수를 얻는 것을 말해요. 메이퇀은 학습 환경의 네트워크 연결을 제한하고, Git 이력과 파일 캐시를 정리하며, LLM Judge로 궤적을 검사해요. 반복적인 사고, 반복적인 도구 호출, 과도한 사고에도 페널티를 부과해요. 다만 이는 위험을 통제하기 위한 수단이지, 문제가 완전히 해결됐다는 뜻은 아니에요.
Harness는 도구, 컨텍스트 관리, 작업 반복 규칙 등 모델의 작업 수행을 구성하는 주변 시스템이에요. LongCat-2.5는 콜드 스타트 단계에서 소량의 프레임워크 적응 샘플을 추가하고, RL 단계에서는 Claude Code, Codex 등 다양한 프레임워크와 작업 유형을 섞어 학습해요. 이를 통해 특정 프롬프트 템플릿에만 적응할 위험을 낮추지만, 도구 버전이 달라도 동작이 완전히 같다고 보장하지는 않아요.
| 학습 방법 | 해결하려는 현실 문제 | 알려진 한계 |
|---|---|---|
| 실제 작업 환경 | 코드만 작성하고 환경에서 실행하지 못하는 문제 | 환경 구성의 품질에 의존 |
| F2P / P2P 검증 | 겉으로는 완료했지만 회귀 오류를 일으키는 문제 | 테스트 커버리지의 제약을 받음 |
| 실패 궤적 학습 | 같은 유형의 오류가 반복되는 문제 | 궤적 수와 수정률은 공개되지 않음 |
| 비동기 Partial Rollout | 장시간 작업의 낮은 학습 효율 | 추론 속도 향상을 뜻하지 않음 |
| Reward Hacking 방지 | 편법으로 얻은 가짜 성공 | 완전한 해결을 주장하지 않음 |
| 크로스 Harness 혼합 학습 | Agent 프레임워크가 바뀌면 제대로 동작하지 않는 문제 | 버전 간 일관성을 보장하지 않음 |
서드파티 실측: LongCat-2.5는 왜 긴 작업을 일부만 완료할까?
공식 학습 설계와 벤치마크 외에도 서드파티 실측을 통해 다른 관점에서 살펴볼 수 있어요. TOKRACE는 2026-11-02에 정식 버전 LongCat-2.5를 Claude Code에 연결하고 Blender, 브라우저 등의 도구와 함께 15개 창작 작업을 수행했어요.
성공 사례는 파라미터 기반 책장이었어요. 0.8미터 3칸과 1미터 4칸 두 버전 모두 크기와 18mm 판재 두께가 요구사항에 맞았고, 여섯 장의 시점별 이미지도 제공했어요. 과정에는 약 36분과 47회의 요청이 들었어요. 반면 다른 작업에서는 긴 작업에서 흔히 나타나는 실패 양상이 드러났어요.
- 구조와 단위 오류: 유성 감속기의 요구 크기는 140mm였지만, 생성된 프로젝트에는 140m가 사용됐고 영상도 제공되지 않았어요.
- 부분 납품: 중국식 사찰 안뜰 작업은 60분 동안 최종 이미지 세 장만 제공했고, 일부 장면과 영상은 빠졌어요.
- 공간 관계 문제: 침실 두 개짜리 주거 모델에서 문과 창문 자리에 구멍이 없거나 침대가 칸막이와 겹치는 문제가 나타났어요.
- 장시간 실행 중단: 수학 지식 설명 영상 작업은 요청이 연속으로 타임아웃되면서 완료되지 못했어요.
이 사례들은 긴 작업에서 단순히 “결과물이 나왔는가”만 볼 게 아니라 모든 요구사항을 하나씩 확인해야 한다는 점을 보여줘요. 다만 테스트에는 요청 횟수, 시간 또는 실행 예산 제한이 있었으므로 모든 미완료를 모델의 능력 부족으로 돌릴 수는 없어요. 엄격한 모델 비교 실험도 아니었어요.
LongCat-2.5 장기 실행 학습 방식의 영향 분석
Agent 개발자에게 미치는 영향
- 모델 선정 기준의 변화: 모델을 평가할 때 컨텍스트 길이의 비중은 줄어들고 있어요. 장기 실행 벤치마크와 실제 작업의 완전한 완료율에 더 주목할 필요가 있어요.
- 검증은 필수: F2P/P2P 학습을 거친 모델이라도 프로덕션 환경에서는 자체 테스트와 검수가 필요해요. 제3자의 실측 결과도 이를 뒷받침해요.
- Harness 설계도 중요: 점수는 실행 프레임워크와 밀접하게 연관돼 있어요. 같은 모델이라도 작업 루프를 바꾸면 결과가 크게 달라질 수 있어요.
대규모 언어 모델 업계에 미치는 영향
- 학습의 무게중심이 ‘과정’으로 이동: 단일 턴 코드 생성에서 전체 프로젝트와 다단계 엔지니어링 작업으로 범위가 넓어지면서, 강화학습 환경을 구축하는 능력이 새로운 경쟁 요소로 떠오르고 있어요.
- 평가 방법에 대한 관심 증가: Terminal-Bench 2.1은 2.0 대비 89개 작업 중 28개를 수정했어요. 평가 버전 자체가 결과에 큰 영향을 미칠 수 있는 만큼, 업계에는 더 투명한 평가 조건 설명이 필요해요.
LongCat-2.5의 아이디어를 활용한 장기 실행 Agent 설계
LongCat-2.5의 학습 방식은 애플리케이션 개발자에게 명확한 시사점을 줍니다. 모델이 “단계별 검증, 실패 복구, 편법 방지”를 학습하듯, 엔지니어링 측면에서도 이런 메커니즘을 Agent 시스템에 명시적으로 구현해야 해요. 아래 내용은 공개된 학습 방식에서 도출한 엔지니어링 제안이며, 공식적으로 구현되었다고 발표된 기능은 아닙니다.
| 엔지니어링 메커니즘 | 대응하는 학습 아이디어 | 구현 방식 |
|---|---|---|
| 단계별 검증 | F2P 검증 | 각 하위 작업이 끝날 때마다 검사 스크립트 실행 |
| 회귀 방지 | P2P 검증 | 수정할 때마다 전체 회귀 테스트 실행 |
| 실패 기록 | 실패 궤적 학습 | 오류 정보를 진행 상황 파일에 기록하고 다음 반복에 반영 |
| 예산 상한 | 반복 호출 페널티 | 최대 반복 횟수, 타임아웃, 도구 호출 횟수 제한 |
| 결과물 검수 | Reward Hacking 방지 | 모델의 요약만 보지 않고 실제 파일 확인 |
다음은 진행 상황 기록, 실패 정보 재입력, 예산 상한을 보여주는 최소한의 단계별 검증 Agent 루프 예제입니다.
import json, subprocess, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)
MODEL = "gpt-4o-mini"  # 플랫폼의 모델 목록에서 실제 사용 가능한 모델 ID를 기준으로 설정
MAX_ROUNDS = 8         # 무한 루프를 방지하기 위한 예산 상한

def run_check(cmd: str) -> tuple[bool, str]:
    r = subprocess.run(cmd, shell=True, capture_output=True, text=True, timeout=300)
    return r.returncode == 0, (r.stdout + r.stderr)[-2000:]

def run_stage(stage: dict, progress: dict) -> bool:
    failures = []
    for i in range(MAX_ROUNDS):
        prompt = (f"阶段目标:{stage['goal']}\n"
                  f"已完成阶段:{progress['done']}\n"
                  f"历史失败(请避免重复):{failures[-3:]}")
        resp = client.chat.completions.create(
            model=MODEL, messages=[{"role": "user", "content": prompt}])
        # 생략: 모델 출력을 파싱하고 코드 파일에 쓰기
        ok, log = run_check(stage["check"])          # 단계별 검증(F2P 유사)
        reg_ok, reg_log = run_check("pytest -q")     # 회귀 테스트(P2P 유사)
        if ok and reg_ok:
            progress["done"].append(stage["name"])
            return True
        failures.append(log if not ok else reg_log)
    progress["blocked"] = stage["name"]
    return False

progress = {"done": [], "blocked": None}
stages = [{"name": "api", "goal": "实现用户接口", "check": "pytest tests/test_api.py -q"}]
for s in stages:
    if not run_stage(s, progress):
        break
json.dump(progress, open("progress.json", "w"), ensure_ascii=False)
이 구조의 핵심은 각 단계에 실행 가능한 검수 명령이 있고, 실패 로그를 다음 반복의 프롬프트에 반영하며, 진행 상황을 컨텍스트에만 두지 않고 파일에 기록한다는 점이에요. 컨텍스트가 충분히 길더라도 진행 상황과 제약 조건을 구조화된 상태로 외부에 저장하면 긴 작업 도중 목표에서 벗어날 위험을 크게 줄일 수 있어요.
🚀 빠른 시작 팁: Agent 프로토타입을 만들 때 APIYI apiyi.com에서 테스트 크레딧을 받아 보세요. 하나의 API 키로 여러 모델을 바꿔 가며 위의 단계별 검증 루프를 실행하면, 어떤 모델이 작업 결과물을 가장 완성도 높게 제공하는지 확인할 수 있어요.
프로젝트에 높은 신뢰성이 필요하다면 “교차 검수”도 도입할 수 있어요. 다른 모델이 최종 결과물을 요구사항 목록과 하나씩 대조하는 방식입니다. APIYI apiyi.com의 통합 인터페이스를 이용하면 실행 모델과 검수 모델을 같은 코드에서 호출할 수 있어 전환 비용이 낮아요.
자주 묻는 질문 FAQ
Q1: LongCat-2.5의 1M 컨텍스트로 대형 프로젝트를 완수할 수 있나요?
그렇게 단정할 수는 없어요. 1M 컨텍스트는 입력과 출력을 합친 단일 요청 용량으로, 모델이 더 많은 코드와 문서를 읽을 수 있게 해줘요. 프로젝트 완수에는 계획 수립, 도구 호출, 오류 수정, 결과물 검증도 필요해요. LongCat-2.5가 장기 강화학습으로 집중 훈련한 부분이 바로 이런 능력이에요.
Q2: LongCat-2.5는 장기 작업에서 GPT-5.6-Sol, Claude Opus 5와 얼마나 차이가 나나요?
공식 표에 따르면 LongCat-2.5는 BrowseComp(91.9)와 Terminal Bench v4.0(38.5)에서 GPT-5.6-Sol보다 약간 높아요. 하지만 DeepSWE 점수는 64.6으로 GPT-5.6-Sol의 72.7보다 낮고, Terminal Bench v4.0에서도 Claude Opus 5보다 15.4점 낮아요. 테스트 프레임워크가 각각 달라 통합 순위로 보기는 어려워요.
Q3: LongCat-2.5 정식 버전은 언제 출시됐나요? 가중치는 오픈소스로 공개됐나요?
Preview 버전은 2026-09-25에 API 플랫폼에 출시됐고, 정식 버전은 2026-11-02에 발표됐어요. 공식 웹사이트와 API는 이용할 수 있지만, 2026-11-03 기준 정식 버전의 모델 가중치 공개는 아직 확인되지 않았어요. 공식 발표에 따르면 GitHub와 Hugging Face에 추후 공개될 예정이에요.
Q4: 지금 APIYI를 통해 LongCat-2.5를 호출할 수 있나요?
2026-11-02 공개 안내에 따르면 당시 LongCat-2.5는 APIYI에 아직 출시되지 않았으며, 추후 연동될 예정이에요. 현재 이용 가능 여부는 APIYI apiyi.com의 모델 목록을 확인해 주세요. 그동안 플랫폼에서 제공하는 모델로 단계별 검증, 실패 결과 재입력 등의 Agent 프레임워크를 구축해 두면, 모델 출시 후 모델 ID만 교체하면 돼요.
Q5: 모델의 장기 Agent 능력을 저렴하게 검증하려면 어떻게 해야 하나요?
실제 업무와 비슷하고 자동 검증 스크립트가 포함된 다단계 작업 3~5개를 준비해 보세요. 각 모델의 결과물 완전 납품률, 평균 작업 횟수, 실패 유형을 기록하면 돼요. APIYI apiyi.com의 OpenAI 호환 인터페이스를 이용하면 API 키 하나로 같은 스크립트에서 여러 모델을 비교할 수 있어요. 신규 사용자에게는 초기 검증에 쓸 수 있는 무료 테스트 크레딧도 제공돼요.
Q6: LongCat-2.5의 장기 작업 능력에는 어떤 한계가 알려져 있나요?
제3자 실측에서 치수 단위 오류, 공간 관계 오류, 동영상 미납품, 요청 시간 초과로 인한 중단 등이 발견됐어요. 공식적으로도 Reward Hacking이 완전히 해결됐다고 밝히지 않았으며, 실패 궤적의 규모와 수정률도 공개되지 않았어요. 엔지니어링 치수, 지식의 정확성, 결과물의 완전성은 여전히 사람이 검증해야 해요.
LongCat-2.5 장기 수행 Agent 핵심 요약 Key Takeaways
- 컨텍스트≠완성도: 1M Token은 처리 용량이지 프로젝트 성공률이 아니에요. 장기 수행 능력은 별도로 훈련해야 해요.
- 실제 환경에서 훈련: GitHub PR, Issue와 내부 태스크를 바탕으로 실행 가능한 환경을 구성해 피드백을 얻어요.
- 양방향 테스트로 검증: F2P는 문제 해결 여부를, P2P는 회귀 발생 여부를 확인해요.
- 실패에서 학습: 실제 Agent의 실패 궤적을 검증 가능한 훈련 태스크로 재구성해요.
- 성과는 조건과 함께 확인: 벤치마크는 Harness에 크게 좌우되며, 제3자 실측에서는 산출물 누락 사례도 있었어요.
- 엔지니어링 설계도 병행: 단계별 검증, 실패 기록, 예산 상한, 산출물 인수 검증이 모두 필요해요. APIYI apiyi.com을 활용해 여러 모델을 비교 검증할 수도 있어요.
정리
LongCat-2.5 출시가 보여준 가장 큰 변화는 또 하나의 백만 Token 윈도우가 등장했다는 점이 아니에요. 훈련의 중심이 “얼마나 긴 내용을 읽을 수 있나”에서 “프로젝트 전체를 끝까지 완수할 수 있나”로 옮겨가고 있다는 점이에요.
- 더 정확한 문제 정의: 장기 수행 Agent의 실패는 컨텍스트 부족보다 실행, 검증, 산출물 제출 단계에서 주로 발생해요.
- 목적에 맞춘 훈련 방법: 실제 태스크 환경, F2P/P2P, 실패 궤적, Partial Rollout, 편법 방지, 크로스 Harness는 각각 현실에서 발생하는 실패 유형에 대응해요.
- 근거의 한계도 명확히: 공식 성적은 눈에 띄게 향상됐지만 최상위 모델과는 여전히 차이가 있어요. 제3자 실측에서도 산출물을 빠짐없이 제출하려면 사람이 확인해야 한다는 점이 드러났어요.
개발자에게 더 실용적인 방법은 같은 접근법을 자신의 Agent 시스템에 적용하고, 파라미터와 순위표만 보는 대신 실행 가능한 인수 기준으로 모델을 평가하는 거예요. APIYI apiyi.com에서 통합 인터페이스로 실제 태스크를 비교 검증한 뒤, 프로덕션 환경에 사용할 모델 조합을 결정하는 것을 추천해요.
📚 참고 자료
- 메이퇀 기술팀 – LongCat-2.5 기술 문서: 장기 실행 Agent 학습 방법 상세 설명
- 링크:
tech.meituan.com/2026/11/02/Meituan-LongCat-2.5.html -
설명: F2P/P2P, Partial Rollout, Reward Hacking 방지 등 학습 설계의 원본 자료
-
LongCat 공식 블로그: 벤치마크 데이터와 평가 방법
- 링크:
longcat.ai/blog/longcat-2.5 -
설명: 전체 평가표와 각 벤치마크의 Harness 및 파라미터 설정
-
LongCat 모델 파라미터 문서: 컨텍스트 및 출력 파라미터 설명
- 링크:
longcat.ai/platform/docs/zh/api/model-params -
설명: 컨텍스트 길이, max_tokens, 사고 예산 등 호출 파라미터
-
Terminal-Bench: 터미널 Agent 벤치마크
- 링크:
tbench.ai -
설명: 점수와 Agent Harness의 관계 및 버전별 차이
-
DeepSWE: 장기 실행 소프트웨어 엔지니어링 Agent 벤치마크
- 링크:
deepswe.datacurve.ai -
설명: 113개 자체 제작 작업과 91개 오픈소스 저장소를 활용한 테스트 설계
-
TOKRACE – LongCat-2.5 실측 기록: 15개 창작 작업에 대한 제3자 테스트
- 링크:
tokrace.com/zh-CN/guides/longcat-2-5-release - 설명: 장기 작업의 부분 완료, 단위 오류 등 실제 사례
작성자: APIYI 기술팀
기술 교류: APIYI 홈페이지 apiyi.com을 방문해 문의해 주세요. 장기 실행 Agent 엔지니어링과 멀티 모델 선택 경험을 함께 나눌 수 있어요.