Note de l’auteur : pourquoi LongCat-2.5 ne mise-t-il pas uniquement sur son contexte de 1M, mais renforce-t-il aussi, selon six axes d’entraînement, la capacité des agents à mener un projet à terme ? Cet article présente également les méthodes d’ingénierie dont les développeurs peuvent s’inspirer.
La plupart des développeurs qui ont travaillé sur des agents IA ont déjà rencontré ce genre de situation : une tâche échoue en cours de route, l’agent réessaie plusieurs fois la même commande erronée, puis fournit un résumé qui semble complet, mais oublie plusieurs livrables essentiels. Avec LongCat-2.5, officiellement lancé par Meituan le 2026-11-02, l’accent est mis sur la capacité des agents à mener un projet à terme, plutôt que sur la seule fenêtre de contexte de 1M.
Ce n’est pas un argumentaire commercial sur les paramètres du modèle. Le blog technique de Meituan a dévoilé les détails de l’entraînement par renforcement pour les tâches de longue durée, et des tiers ont testé le modèle sur ce type de tâches le jour même de sa sortie officielle. Nous distinguerons trois types d’informations : la conception officielle de l’entraînement, les résultats officiels aux benchmarks et les retours d’expérience de tiers. Nous verrons aussi ce que chacun permet — ou non — de démontrer.
À retenir : à la fin de cet article, vous comprendrez pourquoi un contexte d’un million de tokens ne garantit pas la réussite d’un projet, comment LongCat-2.5 renforce ses capacités sur les tâches de longue durée et comment appliquer ces idées à vos propres agents.
LongCat-2.5 : l’essentiel en bref
LongCat-2.5 est un grand modèle de langage nativement multimodal publié par l’équipe LongCat de Meituan. Il est conçu pour les tâches agentiques de longue durée (Long-Horizon Agentic Tasks). Par rapport à LongCat-2.0, il intègre davantage de trajectoires de tâches longues et renforce surtout ses capacités de développement sur des bases de code complexes et de création de projets complets.
| Information | Détails |
|---|---|
| Date de publication | Preview disponible le 2026-09-25, version finale publiée le 2026-11-02 |
| Éditeur | Équipe LongCat de Meituan |
| Taille du modèle | 1,6 billion de paramètres au total, activation parcimonieuse MoE, environ 48 milliards de paramètres activés par token |
| Fenêtre de contexte | 1 048 576 tokens (environ 1 million), entrée et sortie comprises |
| Axes principaux | Agents longue durée, Agentic Coding, programmation visuelle, appels d’outils en plusieurs étapes |
| Disponibilité | Site officiel et API accessibles ; la publication des poids de la version finale n’a pas encore été confirmée |
À noter : au 2026-11-03, APIYI avait déjà publié un article présentant LongCat-2.5, tout en précisant que le modèle n’était pas encore disponible sur sa plateforme et que son intégration était prévue ultérieurement. Pour connaître les modèles effectivement utilisables, consultez la liste à jour sur APIYI, apiyi.com. Les exemples de code de cet article utilisent une syntaxe générique compatible avec OpenAI et peuvent être adaptés à tout modèle déjà disponible.
Pourquoi une fenêtre de contexte d’un million de tokens ne suffit pas aux tâches d’agent à long horizon
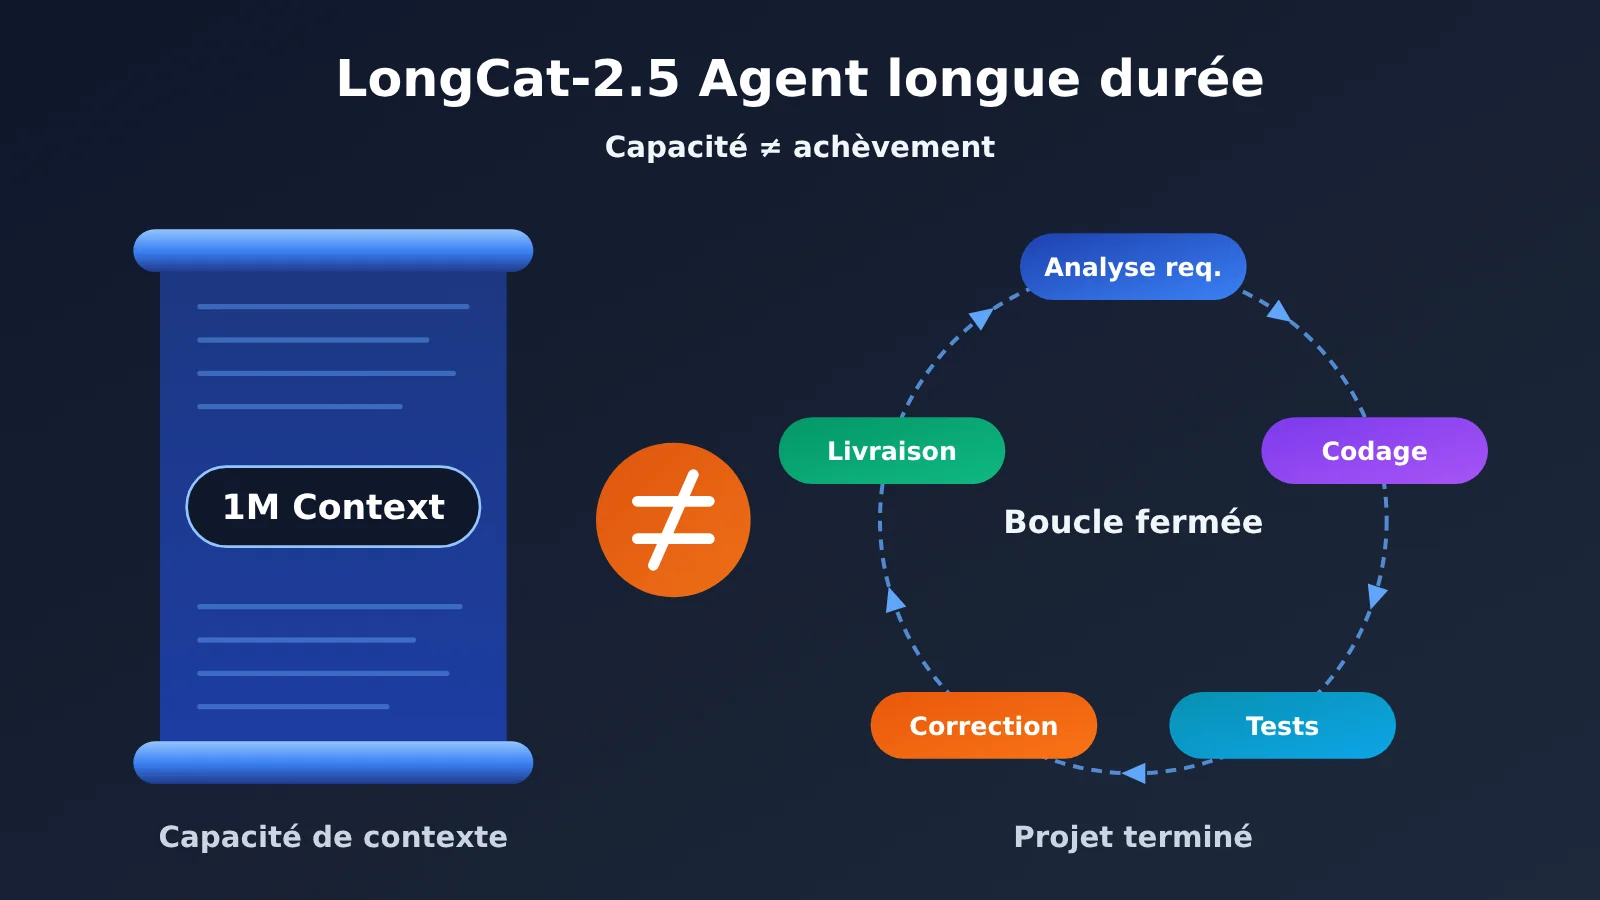
La fenêtre de contexte (Long Context) désigne le nombre total de tokens qu’une requête peut contenir. Une fenêtre de 1M permet au modèle de lire davantage de code source, de documents et de messages historiques en une seule fois, ce qui aide à comprendre les grands dépôts de code. Mais ce seul chiffre ne garantit ni une recherche toujours exacte dans les longs documents, ni des appels d’outils systématiquement réussis, ni des fichiers de sortie forcément corrects.
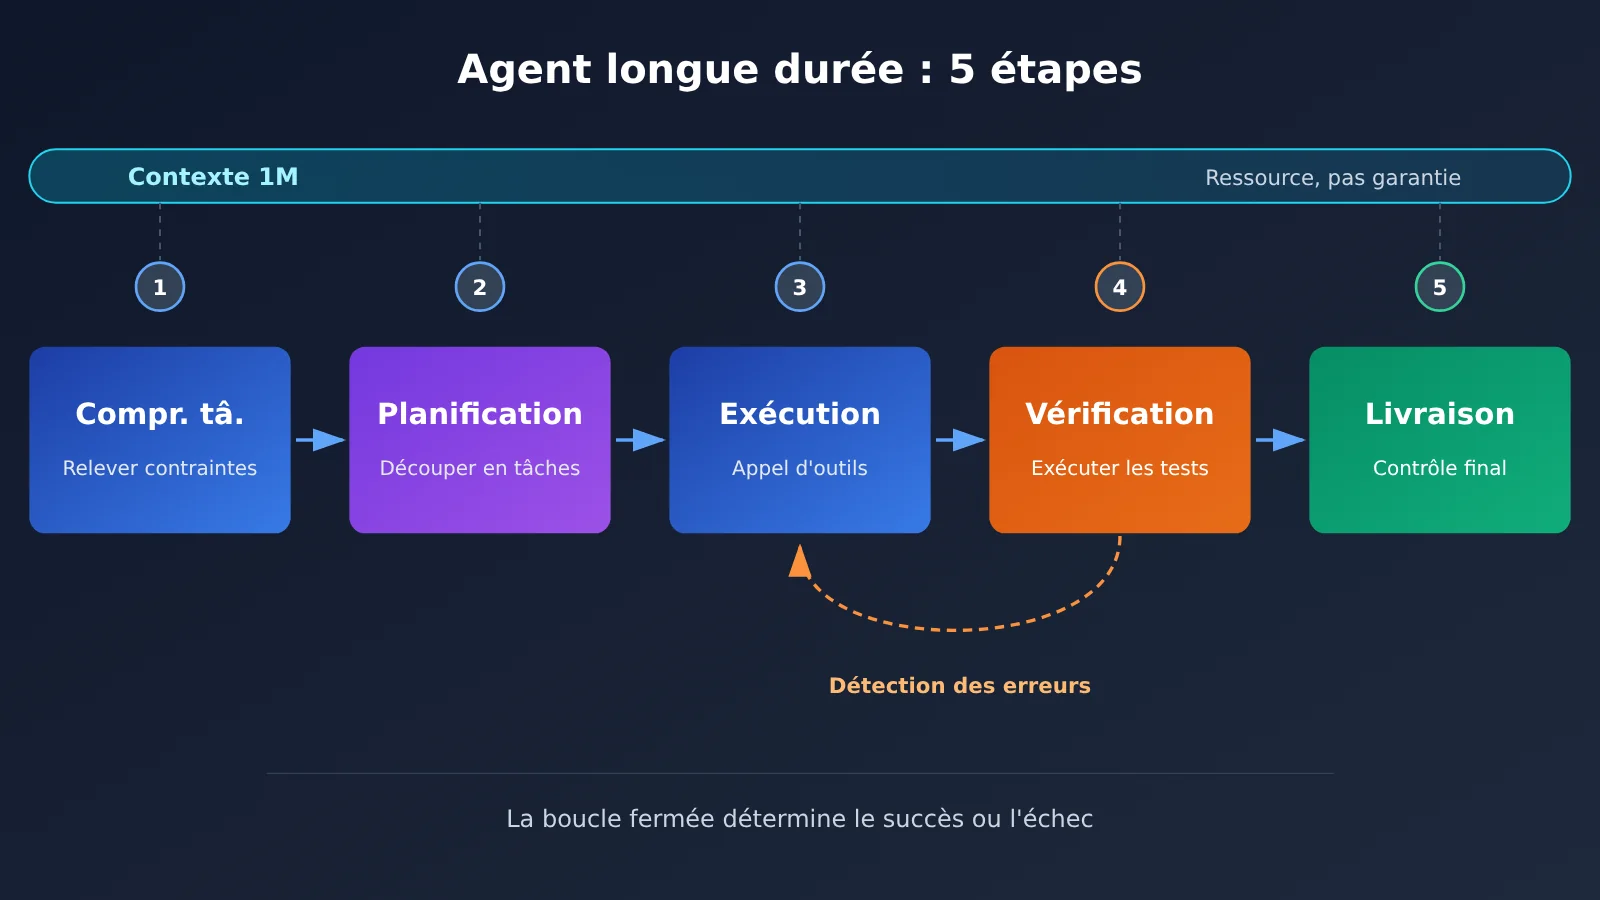
Un agent à long horizon (Long-Horizon Agent), c’est autre chose. Il doit exécuter dans un environnement externe plusieurs étapes interdépendantes : lire un dépôt, écrire du code, appeler des outils, lancer des tests, repérer les erreurs, les corriger, vérifier à nouveau, puis livrer le résultat. Si une étape échoue, les suivantes risquent de s’appuyer sur un état erroné.
| Dimension | Capacité de contexte long | Capacité d’agent à long horizon |
|---|---|---|
| Nature | Capacité d’une requête unique | Fiabilité de l’exécution sur plusieurs étapes |
| Mesure | Nombre de tokens pris en charge | Validation finale de la tâche |
| Dépendances clés | Mécanisme d’attention et entraînement sur des textes longs | Planification, appels d’outils, exploitation des retours d’erreur, décision de terminer |
| Échecs typiques | Informations manquées lors d’une recherche dans un texte long | Perte de l’objectif en cours de route, appels répétés, livrables manquants |
| Lien avec la réussite du projet | Une ressource nécessaire parmi d’autres | Un facteur plus directement déterminant |
En bref, la fenêtre de contexte représente « la taille de l’établi », tandis que la capacité à long horizon indique si l’agent peut « mener le travail à bien ». Même avec un grand établi, le projet peut échouer en cours de route si le modèle ne sait pas adapter son approche après l’échec d’un test ou s’il oublie les contraintes initiales. C’est aussi la raison fondamentale pour laquelle LongCat-2.5 met l’accent sur l’entraînement aux tâches à long horizon.
LongCat-2.5 : évolution des scores sur les benchmarks d’agents à long horizon
Meituan a publié une comparaison entre LongCat-2.5 et la génération précédente sur plusieurs benchmarks d’agents à long horizon. Les chiffres du tableau proviennent de la publication officielle. La colonne « Gain » indique la différence de score, et non une hausse relative en pourcentage.
| Benchmark | LongCat-2.0 | LongCat-2.5 | Gain | Ce qui est évalué |
|---|---|---|---|---|
| Terminal Bench v2.1 | 70.8 | 88.4 | +17.6 | Réalisation de tâches concrètes dans un terminal |
| Terminal Bench v4.0 | 3.0 | 38.5 | +35.5 | Tâches longues et plus difficiles dans un terminal |
| DeepSWE v1.1 | 9.7 | 64.6 | +54.9 | Tâches de génie logiciel à long horizon |
| Program Bench Almost Resolved | 2.5 | 25.5 | +23.0 | Niveau d’achèvement de la construction d’un programme |
| NL2Repo | 40.9 | 60.5 | +19.6 | Génération d’un dépôt à partir de besoins exprimés en langage naturel |
| MCP Atlas | 61.8 | 83.1 | +21.3 | Appels à plusieurs outils |
| JobBench | 44.4 | 65.4 | +21.0 | Livrables professionnels liés à des tâches métiers |
La progression est nette, mais quelques limites sont à garder en tête. Sur DeepSWE, le score passe de 9.7 à 64.6, tout en restant inférieur aux 72.7 de GPT-5.6-Sol dans la comparaison officielle. Sur Terminal Bench v4.0, le score de 38.5 dépasse légèrement les 37.3 de GPT-5.6-Sol, mais reste 15.4 points sous les 53.9 de Claude Opus 5. Les tâches difficiles en terminal sont donc loin d’être résolues.
Les conditions d’évaluation comptent aussi. Terminal Bench utilise Claude Code Harness, DeepSWE utilise mini-swe-agent et JobBench s’appuie sur une évaluation LLM-as-Judge : chaque score dépend donc de son cadre d’exécution. Dans le tableau officiel, certains résultats des modèles concurrents proviennent de rapports publics, tandis que d’autres ont été mesurés par Meituan. On ne peut donc pas les considérer comme un classement indépendant établi dans des conditions uniformes. Le benchmark interne LongCat AppDev (47.7 → 73.7) ne peut pas non plus être reproduit publiquement.
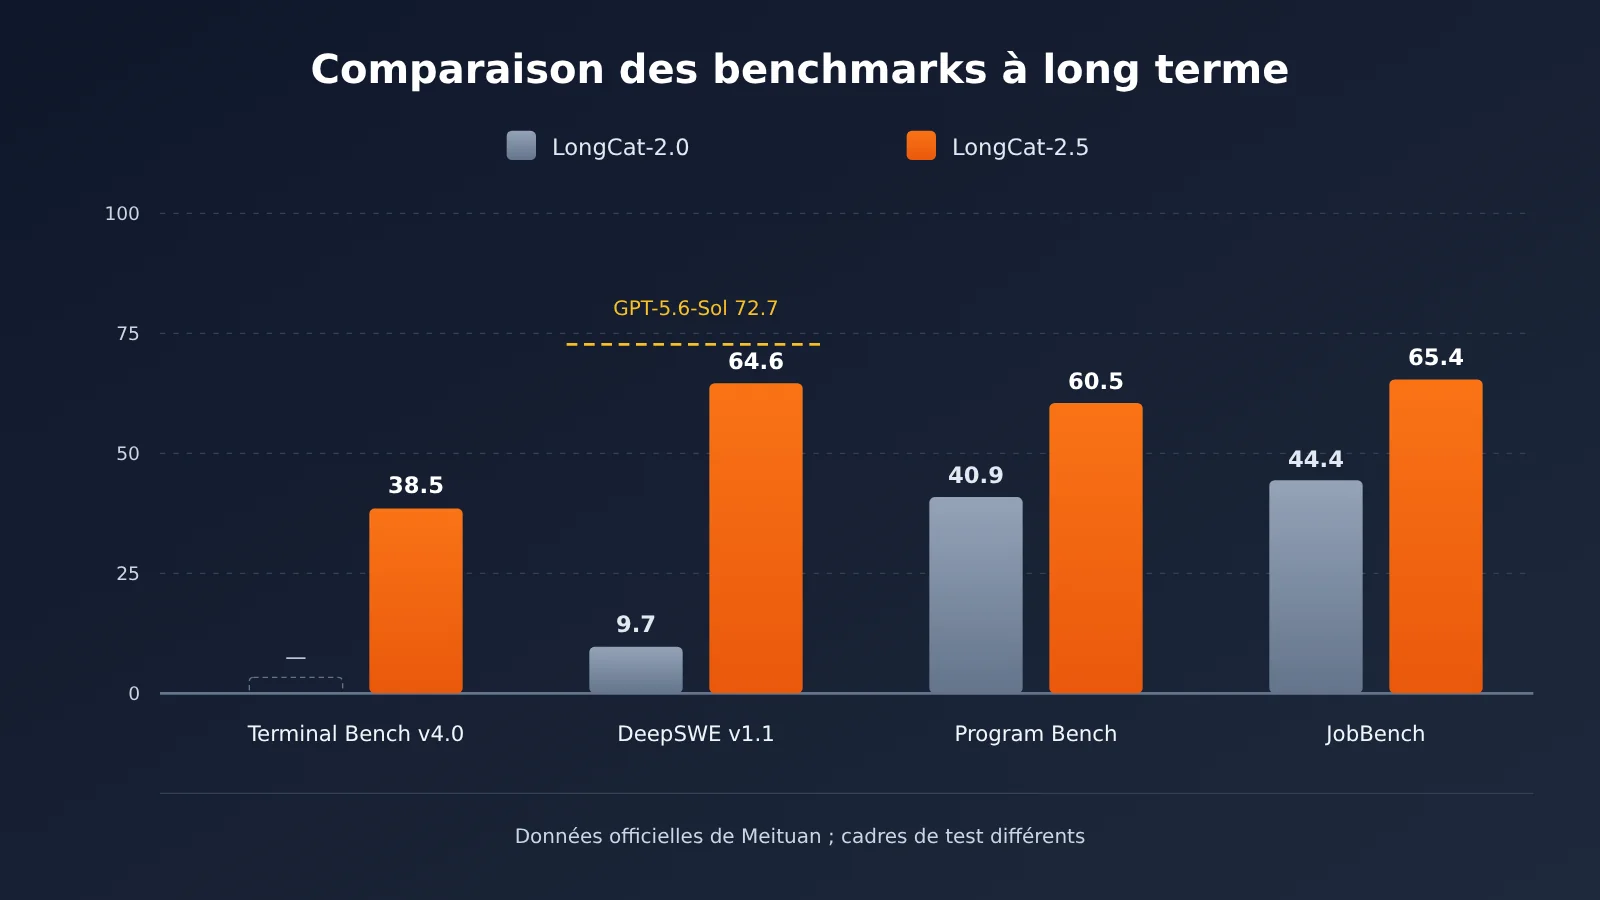
📊 À propos de la comparaison : un benchmark ne reflète que les performances dans un cadre donné. Il faut toujours vérifier les résultats sur ses propres tâches. Avec APIYI apiyi.com, vous pouvez comparer plusieurs modèles disponibles à l’aide d’un même jeu de scripts, puis tenir compte des scores officiels pour faire votre choix.
Comment LongCat-2.5 apprend aux agents à mener un projet de bout en bout
La méthode d’entraînement aux tâches de longue durée présentée sur le blog technique de Meituan se décline en six axes. Pour les comprendre, il faut voir à quel type d’échec concret chacun répond.
LongCat-2.5 : environnements réels et validation F2P/P2P
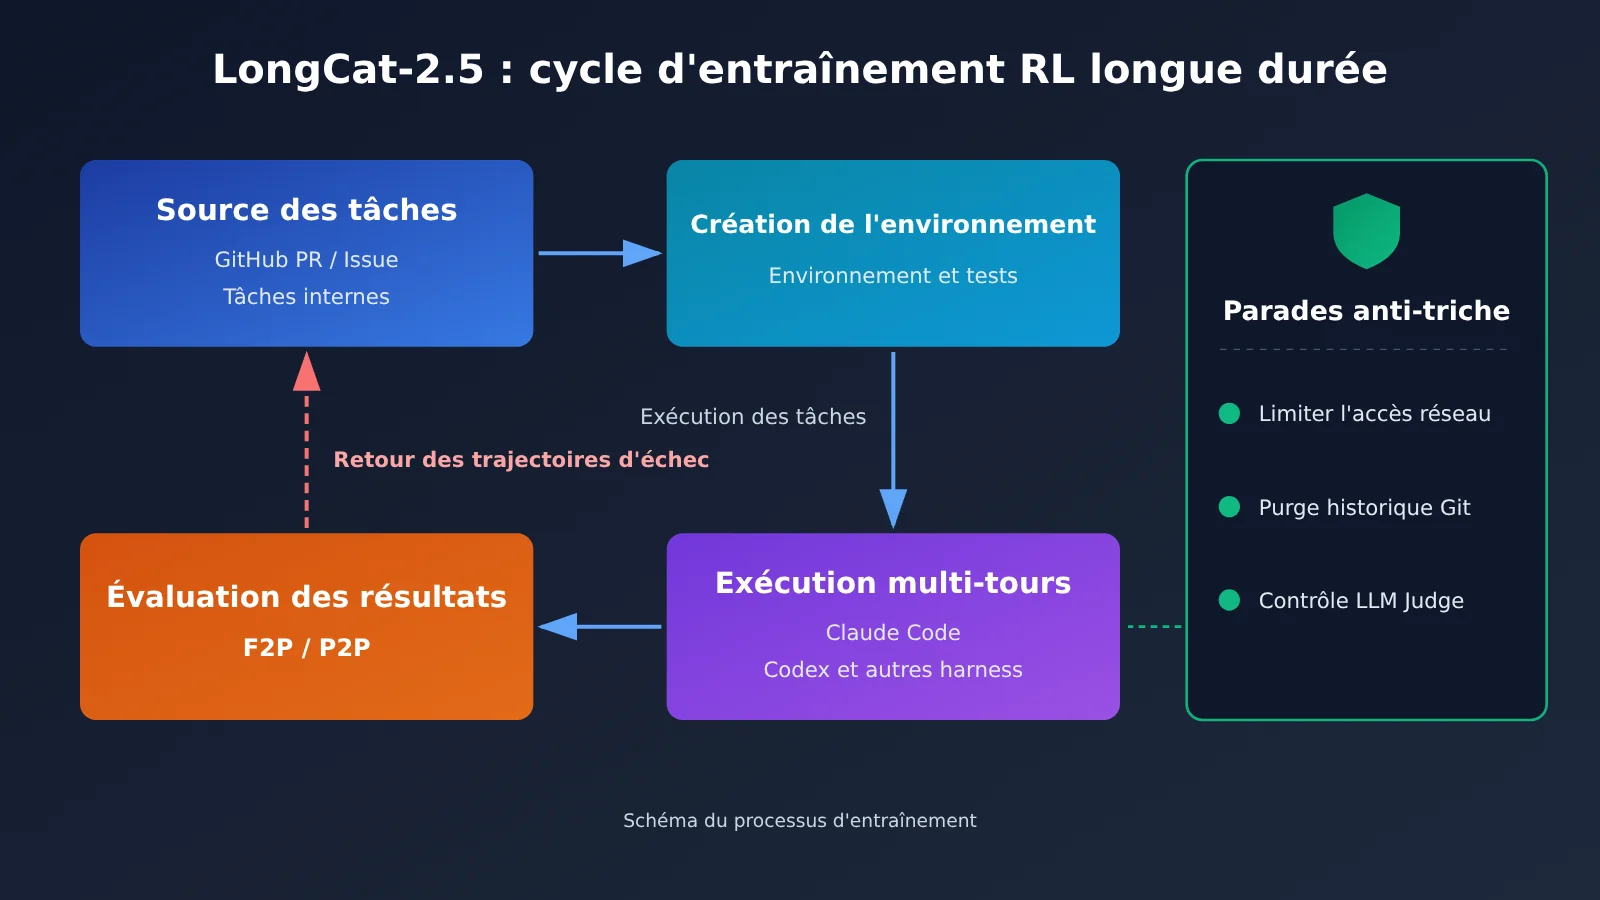
Les données d’entraînement proviennent de pull requests (PR) et d’issues associées de dépôts GitHub publics, ainsi que de véritables tâches de développement internes à Meituan. Le processus consiste à sélectionner les tâches, les annoter automatiquement à l’aide d’un agent, préparer l’environnement de code et générer des tests exécutables. Le modèle passe ensuite à l’action, et les résultats de son exécution permettent de déterminer s’il a résolu le problème. Contrairement à un entraînement fondé uniquement sur de grandes quantités de code, cette approche fournit un retour concret sur le fonctionnement réel de la solution.
La validation repose sur deux types de tests : F2P (Fail-to-Pass) vérifie que les tests initialement en échec passent après la correction, tandis que P2P (Pass-to-Pass) vérifie que ceux qui passaient déjà continuent de passer. Le premier évite de laisser le problème non résolu ; le second limite les régressions. Meituan utilise aussi les traces d’entraînement et les taux de réussite pour repérer les faux positifs et les faux négatifs dans les tests eux-mêmes. L’efficacité de cette approche dépend toutefois de la couverture des exigences par les cas de test.
LongCat-2.5 : apprentissage à partir des trajectoires d’échec et Partial Rollout asynchrone
L’équipe de LongCat transforme les trajectoires d’échec d’Agents réels en tâches reproductibles et vérifiables, afin de repérer les lacunes du modèle et d’enrichir ses environnements d’entraînement. C’est un peu comme tenir un carnet de ses erreurs, plutôt que d’apprendre uniquement à partir des réussites. Les informations publiques ne précisent ni le nombre de trajectoires d’échec ni le taux de correction de chaque type d’erreur.
La durée des tâches longues varie énormément : une seule trajectoire complexe peut ralentir tout un lot d’entraînement. Le Partial Rollout asynchrone échantillonne plusieurs tâches en parallèle. Dès que le lot est complet, les trajectoires inachevées sont interrompues et sauvegardées, puis reprises au tour suivant. Les groupes d’échantillons entièrement réussis ou entièrement échoués, qui ne fournissent pas de gradient utile, sont également filtrés. Cette méthode pose un problème : les tokens d’une même trajectoire peuvent provenir de différentes étapes d’entraînement du modèle. Pour limiter le biais, l’équipe tronque les écarts de logprob et ajuste la contribution au gradient en fonction des écarts cumulés. Cette technique améliore l’efficacité de l’entraînement, mais ne permet pas de conclure que les tâches des utilisateurs s’exécutent proportionnellement plus vite.
LongCat-2.5 : prévention du Reward Hacking et entraînement sur plusieurs Harness
Le Reward Hacking consiste, pour un modèle, à exploiter les failles du système de récompense pour obtenir un bon score sans réellement accomplir la tâche, par exemple en consultant les réponses ou en contournant les tests. Parmi les mesures prises par Meituan figurent la restriction de l’accès réseau dans les environnements d’entraînement, le nettoyage de l’historique Git et des caches de fichiers, l’examen des trajectoires par un LLM Judge, ainsi que des pénalités pour les réflexions répétitives, les appels d’outils répétés et la réflexion excessive. Ces mesures réduisent les risques, mais ne signifient pas que le problème est entièrement résolu.
Un Harness est le système périphérique qui organise l’exécution des tâches par le modèle : outils, gestion du contexte et règles de la boucle d’exécution. Lors de la phase de démarrage à froid, LongCat-2.5 intègre un petit nombre d’exemples d’adaptation aux frameworks. Pendant la phase de RL, il combine différents frameworks, comme Claude Code et Codex, et différents types de tâches. Cela réduit le risque que le modèle ne s’adapte qu’à un seul modèle d’invite, sans garantir un comportement parfaitement identique entre les versions des outils.
| Méthode d’entraînement | Problème concret visé | Limite connue |
|---|---|---|
| Environnements de tâches réelles | Savoir écrire du code sans réussir à le faire fonctionner dans l’environnement | Dépend de la qualité de construction des environnements |
| Vérification F2P / P2P | Accomplissement apparent de la tâche avec introduction de régressions | Limitée par la couverture des tests |
| Apprentissage à partir des trajectoires d’échec | Répétition des mêmes types d’erreurs | Nombre de trajectoires et taux de correction non publiés |
| Partial Rollout asynchrone | Faible efficacité de l’entraînement sur les tâches longues | Ne signifie pas une accélération de l’inférence |
| Prévention du Reward Hacking | Fausses réussites obtenues en exploitant les failles | Résolution complète non revendiquée |
| Entraînement mixte sur plusieurs Harness | Perte d’efficacité lors du changement de framework d’Agent | Ne garantit pas un comportement identique entre les versions |
Test indépendant : pourquoi LongCat-2.5 ne termine-t-il que partiellement certaines tâches longues ?
Au-delà de la conception de l’entraînement et des benchmarks officiels, les tests indépendants offrent un autre point de vue. Le 2 novembre 2026, TOKRACE a intégré la version finale de LongCat-2.5 à Claude Code pour réaliser 15 tâches créatives avec Blender, un navigateur et d’autres outils.
Parmi les réussites figure une étagère paramétrique : les deux versions, l’une de 0,8 mètre avec trois compartiments et l’autre d’un mètre avec quatre compartiments, respectaient les dimensions et l’épaisseur de panneau demandée de 18 mm. Six vues ont également été livrées, en environ 36 minutes et 47 requêtes. D’autres tâches ont toutefois révélé des problèmes typiques sur la durée :
- Erreurs de structure et d’unité : un réducteur planétaire devait mesurer 140 mm, mais le projet généré utilisait 140 m. La vidéo n’a pas non plus été livrée.
- Livraison partielle : pour une cour de temple chinois, seules trois images finales ont été livrées au terme d’une tâche de 60 minutes. Certains plans et la vidéo manquaient.
- Problèmes de relations spatiales : dans un modèle d’appartement de deux chambres, les ouvertures des portes et des fenêtres n’étaient pas percées, et un lit chevauchait une cloison.
- Interruption d’une tâche longue : une vidéo pédagogique sur les mathématiques n’a pas été terminée après plusieurs expirations de délai consécutives.
Ces exemples montrent que, pour les tâches longues, il ne suffit pas de vérifier si un résultat a été produit : il faut contrôler chaque exigence. Il faut aussi noter que les tests imposaient des limites de requêtes, de temps ou d’exécution. On ne peut donc pas attribuer tous les livrables manquants à une insuffisance du modèle ; il ne s’agit pas non plus d’une comparaison rigoureuse entre modèles.
Analyse de l’impact de l’approche d’entraînement longue durée de LongCat-2.5
Impact pour les développeurs d’agents
- Les critères de sélection évoluent : la longueur du contexte pèse moins dans l’évaluation d’un modèle. Les benchmarks de tâches longues et le taux de réalisation complète des tâches réelles méritent davantage d’attention.
- La validation reste indispensable : même si le modèle a été entraîné avec F2P/P2P, il faut toujours mettre en place ses propres tests et critères de validation en production. Des essais indépendants l’ont déjà montré.
- La conception du harness est tout aussi importante : les scores dépendent fortement du cadre d’exécution. Avec une autre boucle de tâches, un même modèle peut obtenir des résultats très différents.
Impact pour le secteur des grands modèles de langage
- L’entraînement se concentre davantage sur le « processus » : il ne s’agit plus seulement de générer du code en un tour, mais aussi de mener à bien des projets complets et des tâches d’ingénierie en plusieurs étapes. La capacité à construire des environnements d’apprentissage par renforcement devient un nouveau facteur de différenciation.
- Les méthodes d’évaluation retiennent davantage l’attention : Terminal-Bench 2.1 a corrigé 28 des 89 tâches par rapport à la version 2.0. Cela montre que la version du test peut elle-même modifier sensiblement les résultats : le secteur a besoin de plus de transparence sur les conditions d’évaluation.
Concevoir un agent pour les tâches longues en s’inspirant de LongCat-2.5
Les méthodes d’entraînement de LongCat-2.5 offrent une leçon directe aux développeurs d’applications : puisque l’entraînement du modèle mise sur la validation par étapes, la récupération après échec et la prévention des stratégies de contournement, ces mécanismes devraient aussi être intégrés explicitement au système d’agent. Les conseils ci-dessous découlent des méthodes d’entraînement publiques : il ne s’agit pas de fonctionnalités que l’équipe officielle affirme avoir implémentées.
| Mécanisme d’ingénierie | Principe d’entraînement correspondant | Mise en œuvre |
|---|---|---|
| Validation par étapes | Validation F2P | Exécuter un script de vérification à la fin de chaque sous-tâche |
| Protection contre les régressions | Validation P2P | Exécuter toute la suite de tests de régression après chaque modification |
| Enregistrement des échecs | Apprentissage à partir des trajectoires d’échec | Consigner les erreurs dans un fichier de progression et les réinjecter au tour suivant |
| Limite de budget | Pénalisation des appels répétés | Limiter le nombre maximal de tours, la durée d’exécution et le nombre d’appels aux outils |
| Validation des livrables | Prévention du reward hacking | Vérifier les fichiers réels plutôt que de se fier au seul résumé du modèle |
Voici un exemple minimaliste de boucle d’agent avec validation par étapes. Il illustre le suivi de progression, la réinjection des échecs et la limite de budget :
import json, subprocess, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface APIYI compatible avec OpenAI
)
MODEL = "gpt-4o-mini"  # Utiliser l'ID d'un modèle effectivement disponible dans la liste de la plateforme
MAX_ROUNDS = 8         # Limite de budget pour éviter les boucles infinies

def run_check(cmd: str) -> tuple[bool, str]:
    r = subprocess.run(cmd, shell=True, capture_output=True, text=True, timeout=300)
    return r.returncode == 0, (r.stdout + r.stderr)[-2000:]

def run_stage(stage: dict, progress: dict) -> bool:
    failures = []
    for i in range(MAX_ROUNDS):
        prompt = (f"阶段目标:{stage['goal']}\n"
                  f"已完成阶段:{progress['done']}\n"
                  f"历史失败(请避免重复):{failures[-3:]}")
        resp = client.chat.completions.create(
            model=MODEL, messages=[{"role": "user", "content": prompt}])
        # Étape omise ici : analyser la sortie du modèle et l'écrire dans des fichiers de code
        ok, log = run_check(stage["check"])          # Validation de l'étape (similaire à F2P)
        reg_ok, reg_log = run_check("pytest -q")     # Tests de régression (similaires à P2P)
        if ok and reg_ok:
            progress["done"].append(stage["name"])
            return True
        failures.append(log if not ok else reg_log)
    progress["blocked"] = stage["name"]
    return False

progress = {"done": [], "blocked": None}
stages = [{"name": "api", "goal": "实现用户接口", "check": "pytest tests/test_api.py -q"}]
for s in stages:
    if not run_stage(s, progress):
        break
json.dump(progress, open("progress.json", "w"), ensure_ascii=False)
L’essentiel de cette structure : chaque étape dispose d’une commande de validation exécutable, les journaux d’échec sont réinjectés dans l’invite suivante et la progression est enregistrée dans un fichier, au lieu de rester uniquement dans le contexte. Même avec un contexte suffisamment long, conserver la progression et les contraintes dans un état structuré externe peut réduire considérablement le risque de s’écarter de l’objectif au cours d’une tâche longue.
🚀 Pour démarrer rapidement : lors de la création d’un prototype d’agent, vous pouvez obtenir du crédit de test auprès d’APIYI sur apiyi.com, puis utiliser la même clé API pour exécuter la boucle de validation ci-dessus avec différents modèles. Vous pourrez ainsi voir lequel livre le résultat le plus complet pour votre tâche.
Si votre projet exige une grande fiabilité, vous pouvez aussi mettre en place une « vérification croisée » : un autre modèle contrôle le livrable final point par point, à partir de la liste des exigences. Grâce à l’interface unifiée d’APIYI apiyi.com, le modèle chargé de l’exécution et celui chargé de la vérification peuvent être appelés depuis le même code, ce qui facilite le passage de l’un à l’autre.
Questions fréquentes (FAQ)
Q1 : La fenêtre de contexte de 1M de LongCat-2.5 lui permet-elle de mener à bien de grands projets ?
Pas nécessairement. La fenêtre de contexte de 1M correspond à la capacité d’une requête, entrées et sorties comprises. Elle permet au modèle de lire davantage de code et de documentation. Mais mener un projet à bien dépend aussi de la planification, de l’utilisation d’outils, de la correction des erreurs et de la vérification des livrables. Ce sont précisément les aspects pour lesquels LongCat-2.5 a été entraîné par apprentissage par renforcement sur des tâches de longue durée.
Q2 : Comment LongCat-2.5 se compare-t-il à GPT-5.6-Sol et à Claude Opus 5 sur les tâches de longue durée ?
Selon le tableau officiel, LongCat-2.5 dépasse légèrement GPT-5.6-Sol sur BrowseComp (91.9) et Terminal Bench v4.0 (38.5). En revanche, son score DeepSWE de 64.6 est inférieur aux 72.7 de GPT-5.6-Sol, et son score Terminal Bench v4.0 est inférieur de 15.4 points à celui de Claude Opus 5. Les protocoles de test étant différents, il serait trompeur d’y voir un classement unique.
Q3 : Quand la version définitive de LongCat-2.5 a-t-elle été publiée ? Ses poids sont-ils open source ?
La version Preview est arrivée sur la plateforme API le 2026-09-25, puis la version définitive a été publiée le 2026-11-02. Le site officiel et l’API sont accessibles, mais au 2026-11-03, la publication des poids de la version définitive n’avait pas encore été confirmée. L’équipe officielle a indiqué qu’ils seraient disponibles ultérieurement sur GitHub et Hugging Face.
Q4 : Peut-on utiliser LongCat-2.5 via APIYI dès maintenant ?
Selon les informations publiques du 2026-11-02, LongCat-2.5 n’était pas encore disponible sur APIYI, mais son intégration était prévue. Pour connaître sa disponibilité, consultez la liste des modèles sur APIYI apiyi.com. En attendant, vous pouvez utiliser les modèles déjà disponibles sur la plateforme pour construire un framework d’agent avec validation par étapes et réinjection des échecs. Une fois le modèle disponible, il suffira de remplacer son ID.
Q5 : Comment évaluer à faible coût les capacités d’un modèle en tant qu’agent sur des tâches de longue durée ?
Préparez 3-5 tâches à plusieurs étapes, proches de vos besoins métier et accompagnées de scripts de validation automatique. Relevez pour chaque modèle le taux de livraison complète, le nombre moyen de tours et les types d’échecs. Avec l’interface compatible OpenAI d’APIYI apiyi.com, une seule clé API suffit pour comparer plusieurs modèles dans les mêmes scripts. Les nouveaux utilisateurs disposent aussi d’un crédit de test gratuit pour une première évaluation.
Q6 : Quelles sont les limites connues de LongCat-2.5 sur les tâches de longue durée ?
Des tests indépendants ont révélé des erreurs d’unités de mesure et de relations spatiales, des vidéos non livrées ainsi que des interruptions dues à des délais d’attente dépassés. L’équipe officielle n’a pas non plus affirmé que le problème du Reward Hacking était entièrement résolu, et ni le volume des trajectoires d’échec ni leur taux de correction n’ont été publiés. Les dimensions techniques, l’exactitude des informations et l’exhaustivité des livrables nécessitent toujours une vérification humaine.
LongCat-2.5 : points clés sur les agents longue durée
- Contexte ≠ accomplissement : un million de tokens représente une capacité, pas un taux de réussite. Les compétences nécessaires aux tâches longues doivent être entraînées séparément.
- Entraînement en environnement réel : des environnements exécutables sont créés à partir de PR et d’issues GitHub ainsi que de tâches internes pour recueillir du feedback.
- Validation dans les deux sens : F2P vérifie que le problème est résolu, P2P qu’aucune régression n’a été introduite.
- Apprentissage à partir des échecs : les trajectoires d’échec réelles des agents sont reconstruites en tâches d’entraînement vérifiables.
- Des résultats à replacer dans leur contexte : les benchmarks dépendent fortement du harness utilisé, et des essais tiers révèlent encore des livrables manquants.
- Une conception adaptée côté ingénierie : validation par étape, suivi des échecs, plafonnement du budget et vérification des livrables sont indispensables. APIYI apiyi.com peut aider à comparer et valider plusieurs modèles.
En résumé
Le principal signal envoyé par la sortie de LongCat-2.5 n’est pas l’arrivée d’une nouvelle fenêtre de contexte d’un million de tokens. C’est plutôt le déplacement des priorités d’entraînement : on ne cherche plus seulement à savoir « combien le modèle peut lire », mais aussi « s’il peut mener un projet à terme ».
- Une définition plus précise du problème : les agents longue durée échouent souvent pendant l’exécution, la validation ou la livraison, plutôt que par manque de contexte.
- Des méthodes d’entraînement ciblées : environnements de tâches réelles, F2P/P2P, trajectoires d’échec, Partial Rollout, prévention des stratégies opportunistes et entraînement sur plusieurs harnesses répondent chacun à une catégorie d’échecs observés.
- Des résultats à interpréter avec prudence : les scores officiels progressent nettement, mais un écart subsiste avec les meilleurs modèles. Les essais tiers montrent aussi que la livraison complète exige encore une vérification humaine.
Pour les développeurs, l’approche la plus pragmatique consiste à appliquer les mêmes principes à leurs propres systèmes d’agents et à évaluer les modèles selon des critères de validation exécutables, plutôt que de se fier uniquement aux paramètres et aux classements. APIYI apiyi.com permet de comparer les modèles sur des tâches réelles via une interface unifiée avant de choisir ceux à combiner en production.
📚 Références
- Équipe technique de Meituan – Article technique sur LongCat-2.5 : présentation détaillée des méthodes d’entraînement des agents sur des tâches longues
- Lien :
tech.meituan.com/2026/11/02/Meituan-LongCat-2.5.html -
Description : source originale des méthodes d’entraînement F2P/P2P, Partial Rollout et de prévention du Reward Hacking
-
Blog officiel de LongCat : résultats des benchmarks et méthodes d’évaluation
- Lien :
longcat.ai/blog/longcat-2.5 -
Description : tableaux d’évaluation complets, harness et paramètres utilisés pour chaque benchmark
-
Documentation des paramètres du modèle LongCat : paramètres de contexte et de sortie
- Lien :
longcat.ai/platform/docs/zh/api/model-params -
Description : paramètres d’invocation, notamment la longueur du contexte, max_tokens et le budget de réflexion
-
Terminal-Bench : benchmark pour agents en terminal
- Lien :
tbench.ai -
Description : relation entre les scores et le harness de l’agent, ainsi que les différences entre versions
-
DeepSWE : benchmark pour agents de génie logiciel sur des tâches longues
- Lien :
deepswe.datacurve.ai -
Description : conception des tests comprenant 113 tâches originales et 91 dépôts open source
-
TOKRACE – Compte rendu des tests de LongCat-2.5 : tests indépendants sur 15 tâches créatives
- Lien :
tokrace.com/zh-CN/guides/longcat-2-5-release - Description : cas concrets de tâches longues partiellement terminées et d’erreurs d’unités
Auteur : équipe technique APIYI
Échanges techniques : rendez-vous sur la page d’accueil d’APIYI, apiyi.com, pour nous contacter et échanger sur les pratiques d’ingénierie des agents sur des tâches longues et le choix entre plusieurs modèles.