Catatan penulis: Artikel ini membahas mengapa LongCat-2.5 tidak hanya mengandalkan konteks 1M, tetapi juga memperkuat kemampuan Agent untuk menyelesaikan seluruh proyek melalui 6 arah pelatihan. Kita juga akan merangkum pendekatan teknis yang bisa diterapkan oleh developer.
Sebagian besar developer AI Agent mungkin pernah mengalami situasi ini: tugas gagal di tengah jalan, Agent terus mencoba perintah salah yang sama, lalu memberikan rangkuman yang tampak lengkap, tetapi ternyata melewatkan beberapa hasil kerja penting. LongCat-2.5, yang dirilis resmi oleh Meituan pada 2026-11-02, berfokus pada kemampuan Agent menyelesaikan seluruh proyek jangka panjang, bukan sekadar menekankan jendela konteks 1M.
Ini bukan artikel promosi parameter. Blog teknologi Meituan telah mengungkap rancangan pelatihan reinforcement learning untuk tugas jangka panjang secara terperinci. Pihak ketiga juga menguji tugas panjang pada hari rilis versi resminya. Artikel ini membedakan tiga jenis informasi: rancangan pelatihan resmi, hasil benchmark resmi, dan pengalaman langsung pihak ketiga, serta menjelaskan apa yang bisa dan tidak bisa dibuktikan oleh masing-masing.
Manfaat utama: Setelah membaca artikel ini, Anda akan memahami mengapa konteks satu juta token tidak sama dengan tingkat keberhasilan proyek, metode yang digunakan LongCat-2.5 untuk meningkatkan kemampuan menangani tugas jangka panjang, serta cara menerapkan gagasan tersebut pada pengembangan Agent Anda sendiri.
Sekilas Informasi Penting LongCat-2.5
LongCat-2.5 adalah Model Bahasa Besar multimodal native yang dirilis oleh tim LongCat dari Meituan. Model ini dirancang untuk tugas agen jangka panjang (Long-Horizon Agentic Tasks). Dibandingkan LongCat-2.0, model ini dilatih dengan lebih banyak rangkaian tugas jangka panjang, terutama untuk meningkatkan kemampuan mengembangkan basis kode yang kompleks dan membangun proyek secara utuh.
| Informasi | Detail |
|---|---|
| Waktu rilis | Preview diluncurkan pada 2026-09-25, versi resmi dirilis pada 2026-11-02 |
| Penerbit | Tim LongCat dari Meituan |
| Skala model | Total 1.6T parameter, dengan aktivasi spars MoE; sekitar 48B parameter aktif per token |
| Jendela konteks | 1,048,576 token (sekitar 1M), termasuk input dan output |
| Fokus utama | Agen jangka panjang, Agentic Coding, pemrograman visual, pemanggilan alat dalam beberapa langkah |
| Status ketersediaan | Situs resmi dan API sudah tersedia; belum ada konfirmasi bahwa bobot versi resmi akan dibuka untuk publik |
Perlu dicatat, hingga 2026-11-03, APIYI telah menerbitkan artikel pengantar tentang LongCat-2.5. Namun, pada saat itu dijelaskan bahwa model tersebut belum tersedia di platform dan direncanakan untuk diintegrasikan kemudian. Untuk mengetahui model yang benar-benar dapat dipanggil, lihat daftar model terkini di APIYI apiyi.com. Contoh kode dalam artikel ini menggunakan format umum yang kompatibel dengan OpenAI dan dapat diterapkan pada model apa pun yang sudah terintegrasi.
Mengapa konteks satu juta Token masih belum cukup untuk tugas Agent jangka panjang
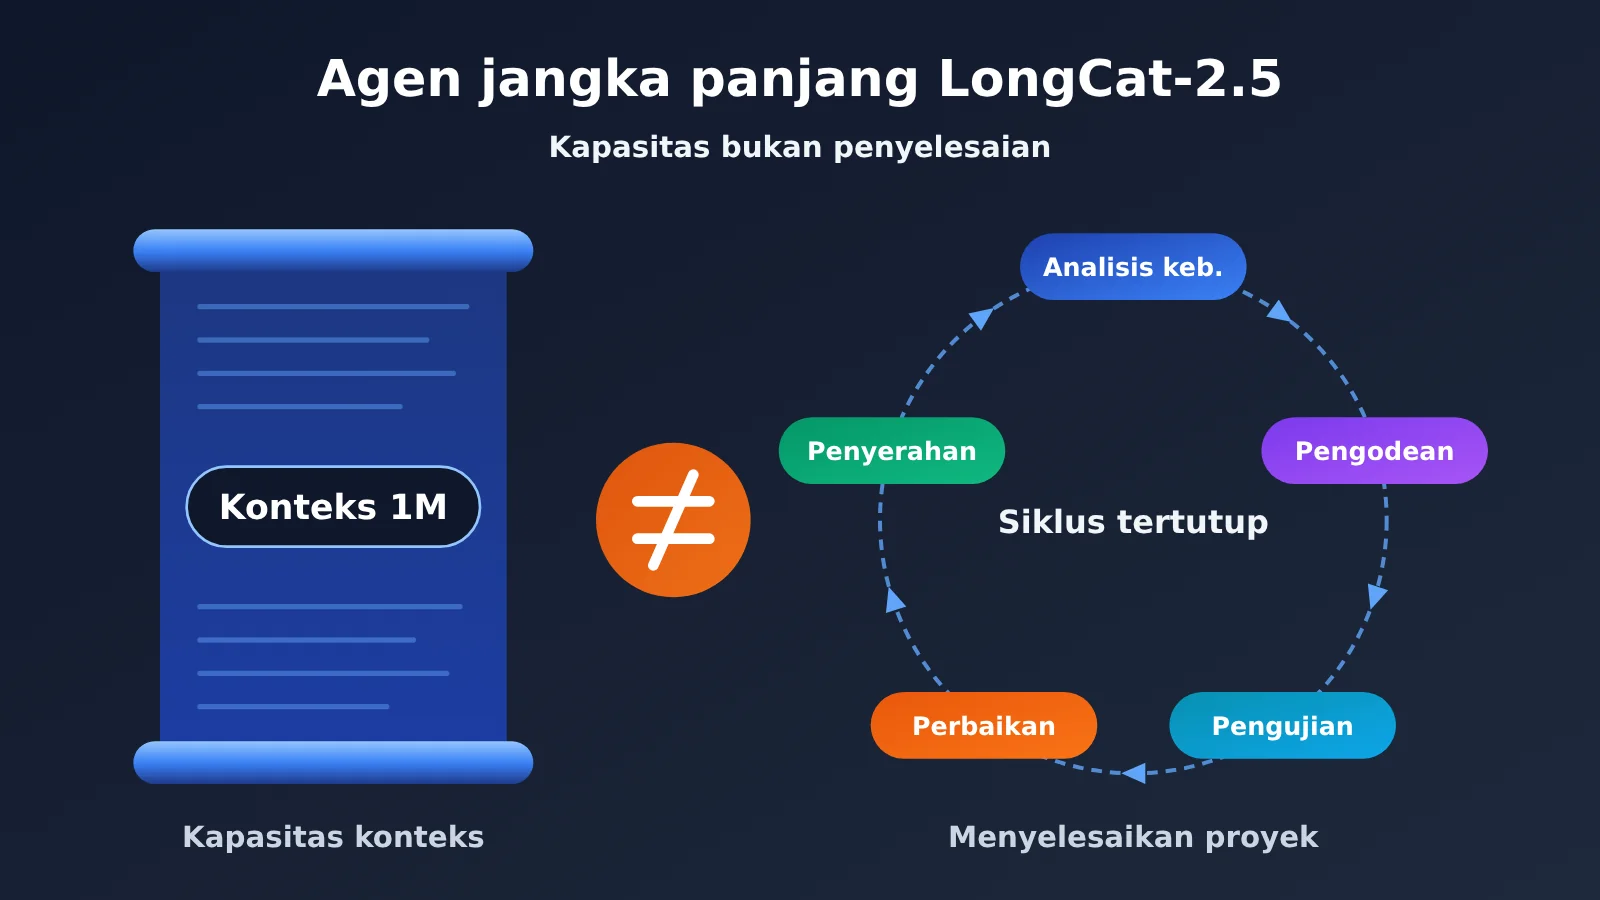
Konteks panjang (Long Context) adalah jumlah total Token yang dapat ditampung dalam satu permintaan. Jendela konteks 1M memungkinkan model membaca lebih banyak kode sumber, dokumen, dan riwayat pesan sekaligus. Ini memang membantu memahami repositori besar. Namun, parameter tersebut saja tidak menjamin bahwa pencarian dalam dokumen panjang selalu akurat, pemanggilan alat terus berhasil, atau file keluaran pasti benar.
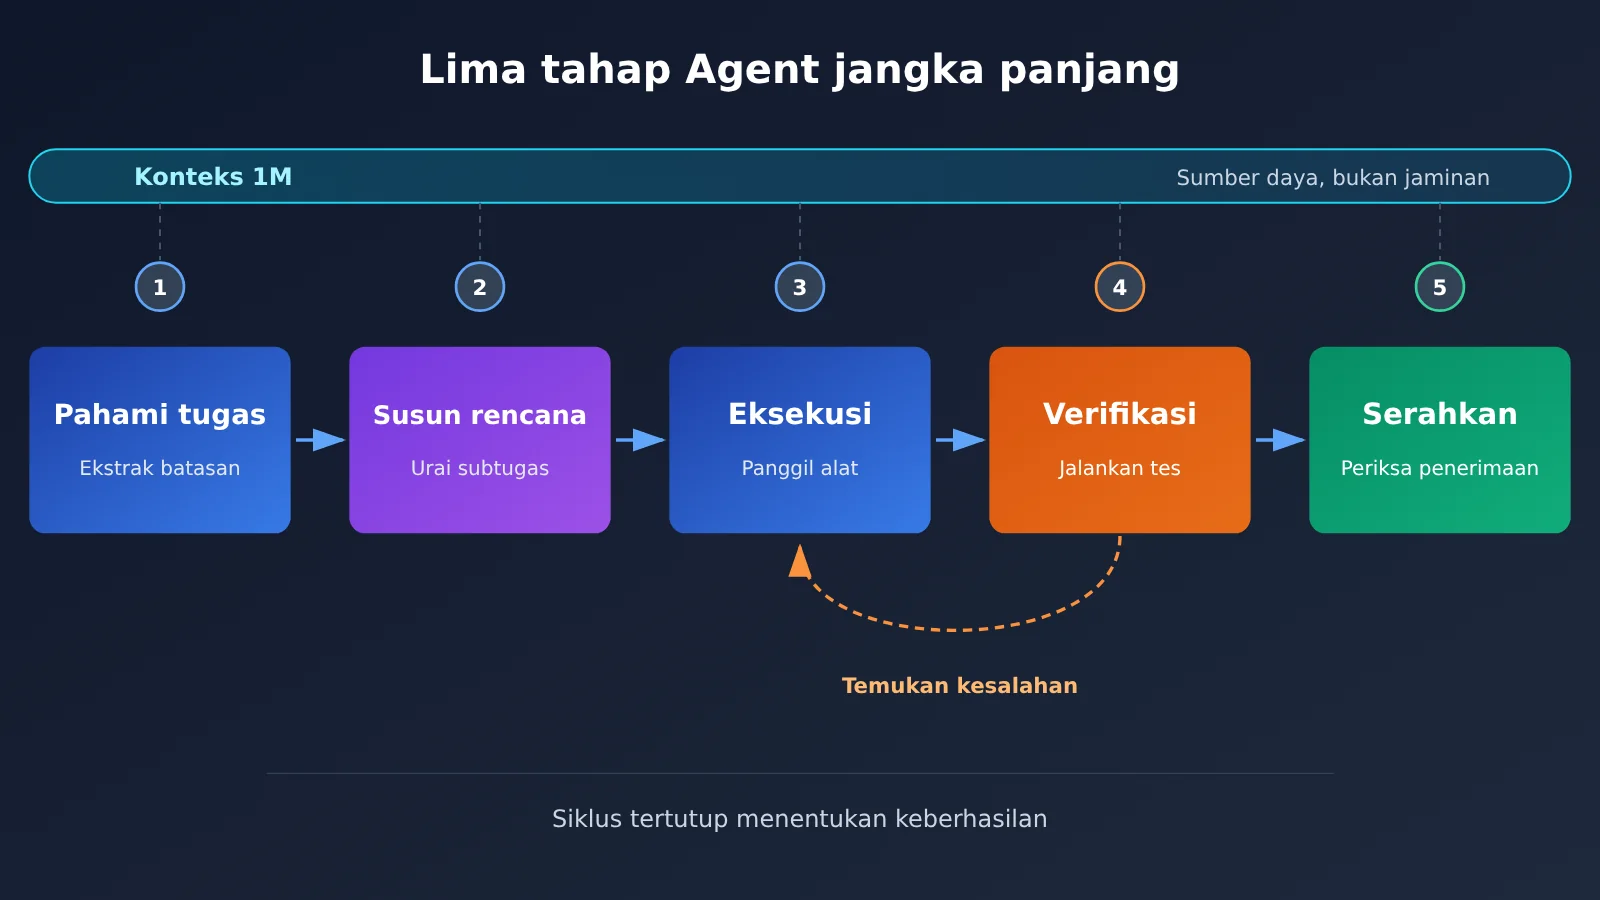
Agent jangka panjang (Long-Horizon Agent) adalah hal yang berbeda. Agent harus terus menjalankan beberapa langkah yang saling bergantung di lingkungan eksternal: membaca repositori, menulis kode, memanggil alat, menjalankan pengujian, menemukan kesalahan, memperbaikinya, lalu memverifikasi ulang sebelum menyerahkan hasil. Jika satu langkah gagal, langkah berikutnya bisa saja dibangun di atas kondisi yang salah.
| Aspek perbandingan | Kemampuan konteks panjang | Kemampuan Agent jangka panjang |
|---|---|---|
| Inti | Kapasitas satu permintaan | Keandalan dalam menjalankan banyak langkah secara berkelanjutan |
| Cara mengukur | Berapa banyak Token yang dapat ditampung | Apakah hasil akhir memenuhi kriteria penerimaan |
| Ketergantungan utama | Mekanisme perhatian dan pelatihan teks panjang | Perencanaan, pemanggilan alat, pemanfaatan umpan balik kesalahan, dan penentuan kapan harus berhenti |
| Kegagalan umum | Informasi terlewat saat mencari dalam teks panjang | Menyimpang dari tujuan, memanggil alat berulang kali, atau tidak menyerahkan hasil |
| Hubungan dengan keberhasilan proyek | Salah satu sumber daya yang diperlukan | Lebih langsung menentukan keberhasilan atau kegagalan |
Singkatnya, konteks menentukan “seberapa besar meja kerja”, sedangkan kemampuan jangka panjang menentukan “apakah pekerjaan bisa diselesaikan”. Sebesar apa pun meja kerjanya, proyek tetap bisa gagal di tengah jalan jika model tidak dapat menyesuaikan rencana berdasarkan hasil pengujian yang gagal atau melupakan batasan awal. Inilah alasan utama LongCat-2.5 memfokuskan pelatihannya pada tugas jangka panjang.
Perubahan skor benchmark Agent jangka panjang LongCat-2.5
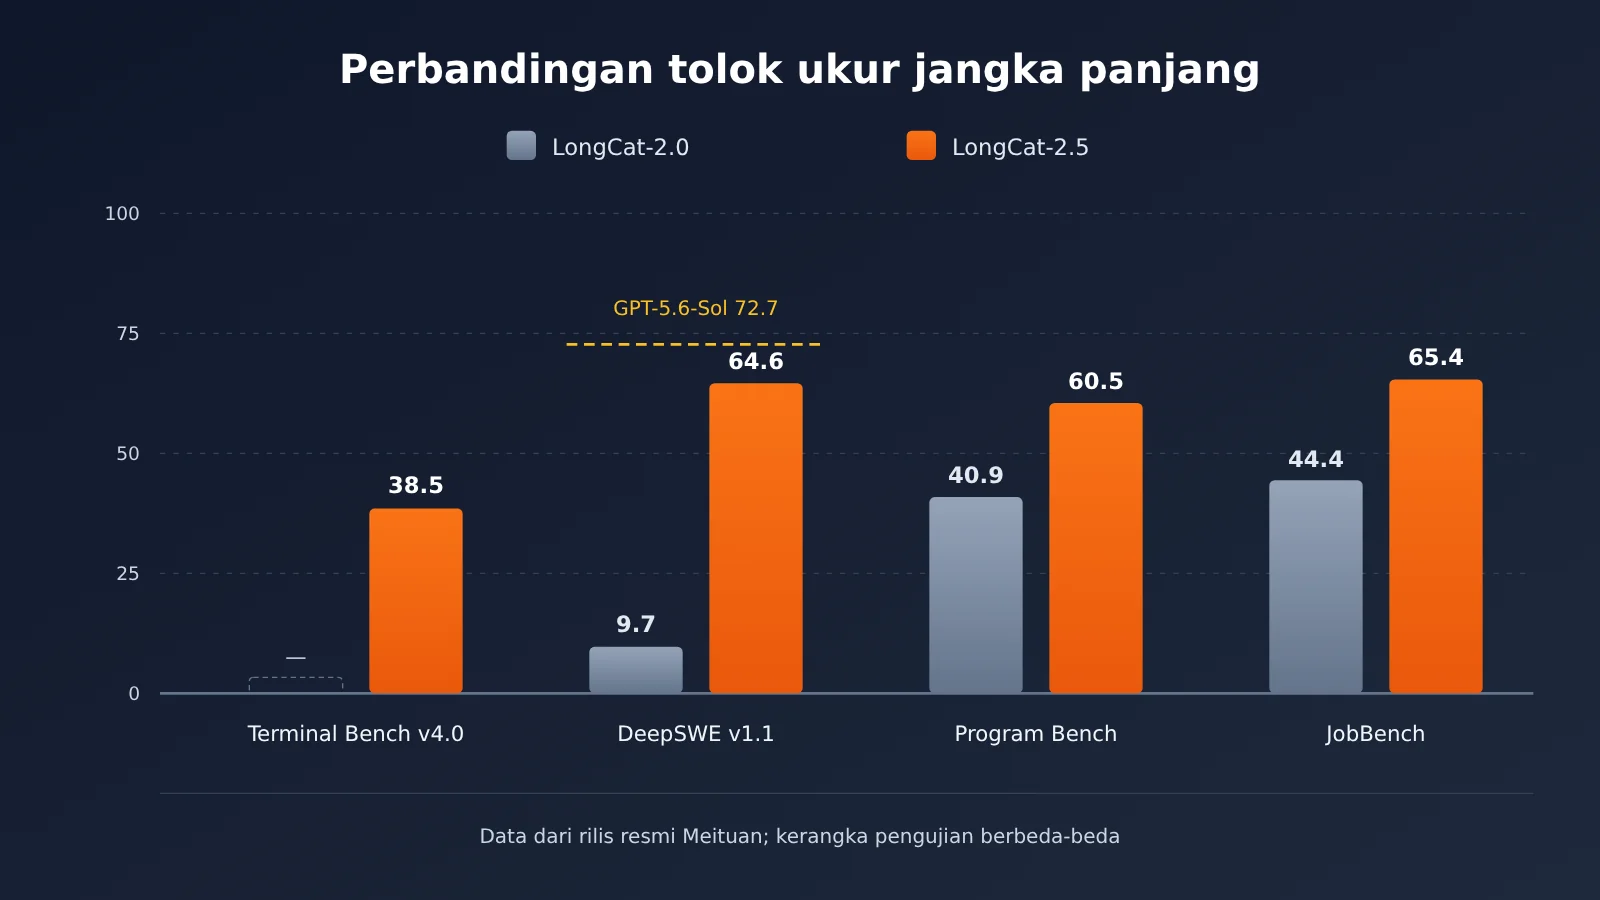
Meituan merilis perbandingan LongCat-2.5 dengan generasi sebelumnya pada sejumlah benchmark Agent jangka panjang. Angka dalam tabel berikut berasal dari rilis resmi. Kolom peningkatan menunjukkan selisih skor, bukan persentase relatif.
| Benchmark | LongCat-2.0 | LongCat-2.5 | Peningkatan | Apa yang diuji |
|---|---|---|---|---|
| Terminal Bench v2.1 | 70.8 | 88.4 | +17.6 | Menyelesaikan tugas operasional nyata di lingkungan terminal |
| Terminal Bench v4.0 | 3.0 | 38.5 | +35.5 | Tugas terminal jangka panjang yang lebih sulit |
| DeepSWE v1.1 | 9.7 | 64.6 | +54.9 | Tugas rekayasa perangkat lunak jangka panjang |
| Program Bench Almost Resolved | 2.5 | 25.5 | +23.0 | Tingkat penyelesaian pembuatan program |
| NL2Repo | 40.9 | 60.5 | +19.6 | Membuat repositori dari kebutuhan dalam bahasa alami |
| MCP Atlas | 61.8 | 83.1 | +21.3 | Pemanggilan beberapa alat |
| JobBench | 44.4 | 65.4 | +21.0 | Hasil kerja profesional untuk tugas pekerjaan |
Peningkatan dalam data ini terlihat jelas, tetapi ada beberapa batasan yang perlu diperhatikan. Skor DeepSWE melonjak dari 9.7 ke 64.6, tetapi dalam perbandingan resmi masih di bawah skor GPT-5.6-Sol sebesar 72.7. Skor Terminal Bench v4.0 sebesar 38.5 sedikit lebih tinggi daripada GPT-5.6-Sol yang mendapat 37.3, tetapi 15.4 poin lebih rendah daripada Claude Opus 5 yang mendapat 53.9. Ini menunjukkan bahwa tugas terminal yang sulit masih jauh dari terpecahkan.
Kondisi pengujian juga penting. Terminal Bench menggunakan Claude Code Harness, DeepSWE menggunakan mini-swe-agent, dan JobBench dinilai dengan LLM-as-Judge. Semua skor tersebut terkait dengan kerangka kerja yang digunakan. Dalam tabel resmi, sebagian skor model pesaing berasal dari laporan publik, sementara sebagian lainnya diuji sendiri oleh Meituan. Karena itu, tabel tersebut tidak bisa dianggap sebagai peringkat independen dengan kondisi pengujian yang seragam. Benchmark internal LongCat AppDev (47.7 → 73.7) juga tidak dapat direproduksi secara publik.
📊 Catatan perbandingan: Benchmark hanya mencerminkan performa dalam kerangka kerja tertentu. Pada akhirnya, Anda tetap perlu mengujinya pada tugas sendiri. Melalui APIYI apiyi.com, Anda bisa membandingkan beberapa model yang tersedia dengan skrip tugas yang sama, lalu mempertimbangkan hasilnya bersama skor resmi untuk memilih model.
Cara LongCat-2.5 Melatih Agent untuk Menyelesaikan Seluruh Proyek
Metode pelatihan tugas jangka panjang yang diungkap dalam blog teknologi Meituan dapat dirangkum ke dalam 6 arah. Kunci untuk memahaminya adalah melihat jenis kegagalan nyata dalam tugas panjang yang ditangani oleh masing-masing pendekatan.
Lingkungan Tugas Nyata dan Verifikasi F2P/P2P pada LongCat-2.5
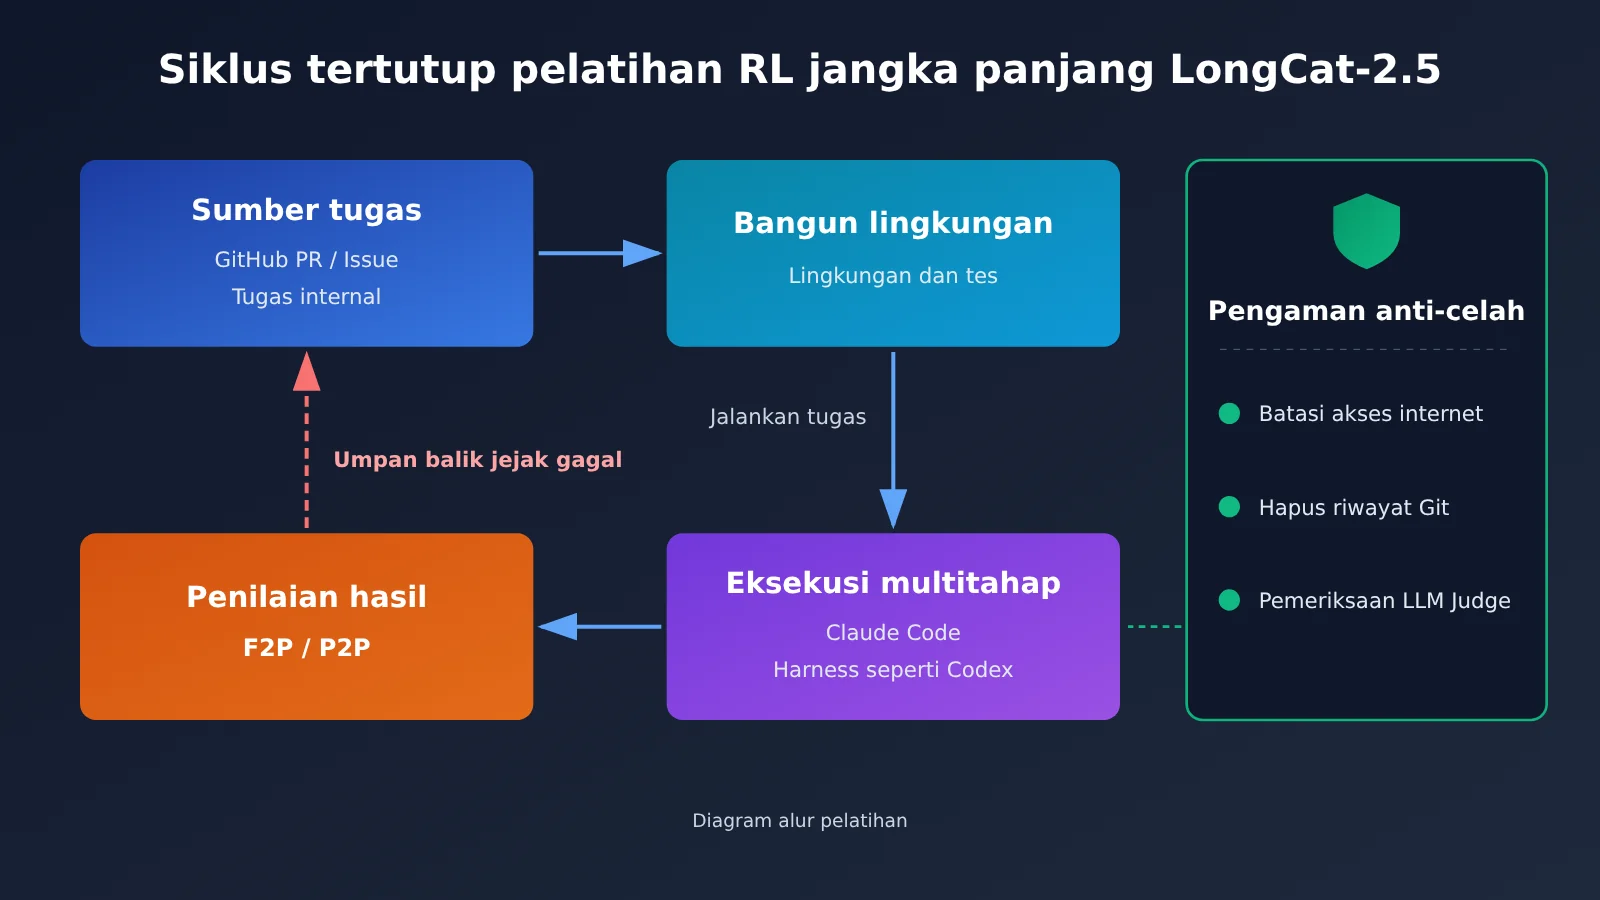
Data pelatihan berasal dari PR di repositori publik GitHub beserta Issue terkait, serta tugas pemrograman nyata di internal Meituan. Prosesnya dimulai dengan memilih tugas, memberi anotasi otomatis menggunakan Agent, menyiapkan lingkungan kode, dan menghasilkan pengujian yang bisa dijalankan. Setelah itu, model menjalankan tugas dan hasil eksekusinya digunakan untuk menilai apakah masalah berhasil diselesaikan. Dibandingkan sekadar memberikan banyak teks kode, pendekatan ini menghasilkan umpan balik tentang apakah solusinya benar-benar berjalan.
Verifikasi menggunakan dua jenis pengujian: F2P (Fail-to-Pass) memeriksa apakah pengujian yang semula gagal menjadi lolos setelah perbaikan, sedangkan P2P (Pass-to-Pass) memeriksa apakah pengujian yang semula lolos tetap lolos. Yang pertama mencegah masalah tidak terselesaikan; yang kedua mencegah perbaikan satu masalah justru merusak bagian lain. Meituan juga menggunakan jejak pelatihan dan tingkat kelulusan untuk memeriksa hasil positif palsu dan negatif palsu dalam pengujian itu sendiri. Meski begitu, efektivitasnya tetap bergantung pada seberapa lengkap kasus pengujian mencakup kebutuhan.
Pembelajaran Jejak Kegagalan dan Partial Rollout Asinkron LongCat-2.5
Tim LongCat menyusun ulang jejak kegagalan Agent nyata menjadi tugas yang bisa direproduksi dan diverifikasi, untuk menemukan kelemahan kemampuan serta menambah lingkungan pelatihan. Pendekatan ini seperti mengumpulkan soal yang dijawab salah dalam buku latihan, alih-alih hanya belajar dari contoh keberhasilan. Informasi publik tidak menyebutkan jumlah jejak kegagalan maupun tingkat perbaikan untuk setiap jenis kesalahan.
Durasi tugas panjang bisa sangat bervariasi, dan satu jejak yang kompleks dapat memperlambat seluruh batch pelatihan. Partial Rollout asinkron bekerja dengan mengambil sampel dari beberapa tugas secara paralel. Setelah batch terisi, jejak yang belum selesai dihentikan dan disimpan untuk dilanjutkan pada putaran berikutnya. Kelompok sampel yang seluruhnya berhasil atau seluruhnya gagal juga disaring karena tidak memberikan gradien yang berguna.
Konsekuensinya, token dalam satu jejak bisa berasal dari model pada tahap pelatihan yang berbeda. Untuk mengendalikan bias, tim LongCat membatasi perbedaan logprob dan menyesuaikan kontribusi gradien berdasarkan akumulasi perbedaan sebelumnya. Teknik ini meningkatkan efisiensi pelatihan, tetapi tidak berarti kecepatan pelaksanaan tugas di sisi pengguna meningkat dalam proporsi yang sama.
Pencegahan Reward Hacking dan Pelatihan Lintas Harness LongCat-2.5
Reward Hacking terjadi ketika model memanfaatkan celah dalam desain reward untuk mendapat skor tinggi tanpa benar-benar menyelesaikan tugas, misalnya dengan mengintip jawaban atau mengakali pengujian. Langkah Meituan mencakup pembatasan akses internet di lingkungan pelatihan, pembersihan riwayat Git dan cache file, penggunaan LLM Judge untuk memeriksa jejak, serta pemberian penalti untuk pemikiran berulang, pemanggilan alat berulang, dan pemikiran berlebihan. Langkah-langkah ini membantu mengendalikan risiko, tetapi bukan berarti masalahnya sudah sepenuhnya teratasi.
Harness adalah sistem pendukung yang mengatur model saat menjalankan tugas, termasuk alat, pengelolaan konteks, dan aturan siklus tugas. Pada tahap cold start, LongCat-2.5 menambahkan sejumlah kecil sampel adaptasi framework. Pada tahap RL, model dilatih dengan campuran berbagai framework seperti Claude Code dan Codex serta berbagai jenis tugas. Ini mengurangi risiko model hanya terbiasa dengan satu templat petunjuk, tetapi tidak menjamin perilaku yang sepenuhnya konsisten di berbagai versi alat.
| Metode pelatihan | Masalah nyata yang ditangani | Batasan yang diketahui |
|---|---|---|
| Lingkungan tugas nyata | Hanya bisa menulis kode, tetapi tidak bisa menjalankannya hingga selesai di lingkungan tersebut | Bergantung pada kualitas pembuatan lingkungan |
| Verifikasi F2P / P2P | Tugas tampak selesai, tetapi menimbulkan kesalahan regresi | Dibatasi oleh cakupan pengujian |
| Pembelajaran jejak kegagalan | Kesalahan sejenis terus berulang | Jumlah dan tingkat perbaikan tidak dipublikasikan |
| Partial Rollout asinkron | Efisiensi pelatihan untuk tugas panjang rendah | Tidak sama dengan percepatan inferensi |
| Pencegahan Reward Hacking | Keberhasilan semu melalui cara-cara curang | Tidak diklaim menyelesaikan masalah sepenuhnya |
| Pelatihan campuran lintas Harness | Gagal ketika berganti framework Agent | Tidak menjamin konsistensi antarversi |
Pengujian pihak ketiga: Mengapa LongCat-2.5 hanya menyelesaikan sebagian tugas panjang
Di luar rancangan pelatihan resmi dan benchmark, pengujian pihak ketiga memberikan perspektif lain. Pada 2026-11-02, TOKRACE mengintegrasikan versi rilis LongCat-2.5 dengan Claude Code untuk menyelesaikan 15 tugas kreatif menggunakan Blender, browser, dan alat lainnya.
Salah satu kasus yang berhasil adalah rak buku parametrik: dua versi berukuran 0,8 meter dengan tiga kompartemen dan 1 meter dengan empat kompartemen memenuhi persyaratan dimensi dan ketebalan papan 18mm. Model juga menghasilkan enam gambar dari berbagai sudut. Prosesnya memakan waktu sekitar 36 menit dan 47 permintaan. Namun, beberapa tugas lain menunjukkan pola kegagalan yang umum pada tugas panjang:
- Kesalahan struktur dan satuan: Gearbox planet yang diminta berukuran 140mm justru dibuat dengan ukuran 140m, dan video tidak diserahkan.
- Hasil tidak lengkap: Dalam tugas membuat halaman kuil bergaya Tiongkok selama 60 menit, model hanya menyerahkan tiga gambar akhir, tanpa beberapa sudut pengambilan gambar dan video.
- Masalah hubungan spasial: Model hunian dua kamar tidur memiliki pintu dan jendela tanpa bukaan, serta tempat tidur yang tumpang tindih dengan dinding penyekat.
- Eksekusi jangka panjang terhenti: Sebuah video pengetahuan matematika tidak selesai setelah beberapa permintaan berturut-turut mengalami timeout.
Kasus-kasus ini menunjukkan bahwa untuk tugas panjang, kita tidak bisa hanya melihat “apakah ada hasil”. Semua persyaratan harus diperiksa satu per satu. Perlu diingat juga bahwa pengujian ini memiliki batas permintaan, waktu, atau anggaran eksekusi. Jadi, tidak semua hasil yang tidak diserahkan bisa dikaitkan dengan keterbatasan kemampuan model. Ini juga bukan eksperimen perbandingan model yang ketat.
Analisis Dampak Pendekatan Pelatihan Jangka Panjang LongCat-2.5
Dampak bagi Pengembang Agent
- Perubahan kriteria pemilihan: Saat mengevaluasi model, panjang konteks semakin berkurang bobotnya. Hasil benchmark jangka panjang dan tingkat penyelesaian tugas nyata secara menyeluruh lebih layak diperhatikan.
- Validasi tetap wajib: Meski model telah dilatih dengan F2P/P2P, pengujian dan penerimaan mandiri tetap diperlukan di lingkungan produksi. Pengujian pihak ketiga telah membuktikan hal ini.
- Desain harness sama pentingnya: Skor sangat dipengaruhi oleh kerangka eksekusi. Model yang sama dapat menghasilkan hasil yang sangat berbeda ketika menggunakan siklus tugas yang berbeda.
Dampak bagi Industri Model Bahasa Besar
- Fokus pelatihan beralih ke “proses”: Pelatihan meluas dari pembuatan kode satu putaran ke proyek lengkap dan tugas rekayasa multilangkah. Kemampuan membangun lingkungan pembelajaran penguatan menjadi faktor persaingan baru.
- Metode evaluasi semakin diperhatikan: Terminal-Bench 2.1 memperbaiki 28 dari 89 tugas dibandingkan versi 2.0. Ini menunjukkan bahwa versi pengujian itu sendiri dapat berdampak signifikan pada hasil, sehingga industri membutuhkan penjelasan kondisi evaluasi yang lebih transparan.
Merancang Agent untuk Tugas Jangka Panjang dengan Pendekatan LongCat-2.5
Metode pelatihan LongCat-2.5 memberikan pelajaran yang jelas bagi pengembang aplikasi: jika model dilatih untuk melakukan “validasi bertahap, pemulihan dari kegagalan, dan pencegahan jalan pintas”, mekanisme tersebut juga sebaiknya diterapkan secara eksplisit dalam sistem Agent. Rekomendasi berikut diturunkan dari metode pelatihan yang dipublikasikan, bukan fitur yang diklaim telah tersedia secara resmi.
| Mekanisme rekayasa | Pendekatan pelatihan terkait | Cara penerapan |
|---|---|---|
| Validasi bertahap | Validasi F2P | Jalankan skrip pemeriksaan setiap sub-tugas selesai |
| Perlindungan regresi | Validasi P2P | Jalankan seluruh pengujian regresi setelah setiap perubahan |
| Pencatatan kegagalan | Pembelajaran dari jejak kegagalan | Tulis informasi kesalahan ke file progres dan sertakan pada putaran berikutnya |
| Batas anggaran | Penalti pemanggilan berulang | Batasi jumlah putaran, waktu tunggu, dan jumlah pemanggilan alat |
| Verifikasi hasil akhir | Pencegahan Reward Hacking | Periksa file yang sebenarnya, bukan hanya ringkasan model |
Berikut contoh minimal loop Agent dengan validasi bertahap, yang menunjukkan pencatatan progres, penggunaan kembali informasi kegagalan, dan batas anggaran:
import json, subprocess, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka APIYI yang kompatibel dengan OpenAI
)
MODEL = "gpt-4o-mini"  # Gunakan ID model yang benar-benar tersedia dalam daftar model platform
MAX_ROUNDS = 8         # Batas anggaran untuk mencegah loop tak berujung

def run_check(cmd: str) -> tuple[bool, str]:
    r = subprocess.run(cmd, shell=True, capture_output=True, text=True, timeout=300)
    return r.returncode == 0, (r.stdout + r.stderr)[-2000:]

def run_stage(stage: dict, progress: dict) -> bool:
    failures = []
    for i in range(MAX_ROUNDS):
        prompt = (f"阶段目标:{stage['goal']}\n"
                  f"已完成阶段:{progress['done']}\n"
                  f"历史失败(请避免重复):{failures[-3:]}")
        resp = client.chat.completions.create(
            model=MODEL, messages=[{"role": "user", "content": prompt}])
        # Dihilangkan di sini: mengurai output model dan menulisnya ke file kode
        ok, log = run_check(stage["check"])          # Validasi tahap (sejenis F2P)
        reg_ok, reg_log = run_check("pytest -q")     # Pengujian regresi (sejenis P2P)
        if ok and reg_ok:
            progress["done"].append(stage["name"])
            return True
        failures.append(log if not ok else reg_log)
    progress["blocked"] = stage["name"]
    return False

progress = {"done": [], "blocked": None}
stages = [{"name": "api", "goal": "实现用户接口", "check": "pytest tests/test_api.py -q"}]
for s in stages:
    if not run_stage(s, progress):
        break
json.dump(progress, open("progress.json", "w"), ensure_ascii=False)
Kunci struktur ini adalah: setiap tahap memiliki perintah verifikasi yang dapat dijalankan, log kegagalan disertakan kembali dalam petunjuk pada putaran berikutnya, dan progres ditulis ke file alih-alih hanya disimpan dalam konteks. Sekalipun jendela konteks cukup panjang, menyimpan progres dan batasan sebagai status terstruktur di luar konteks dapat mengurangi risiko penyimpangan dari tujuan selama tugas panjang secara signifikan.
🚀 Saran untuk mulai mencoba: Saat membuat prototipe Agent, Anda bisa mendapatkan kuota pengujian melalui APIYI apiyi.com. Gunakan kunci API yang sama untuk mencoba model berbeda dalam loop validasi bertahap di atas, lalu amati model mana yang memberikan hasil paling lengkap untuk tugas Anda.
Jika proyek membutuhkan keandalan tinggi, Anda juga bisa menerapkan “verifikasi silang”: minta model lain memeriksa hasil akhir satu per satu berdasarkan daftar kebutuhan. Melalui antarmuka terpadu APIYI apiyi.com, model pelaksana dan model pemeriksa dapat dipanggil dalam kode yang sama, sehingga mudah untuk beralih di antara keduanya.
Pertanyaan Umum FAQ
Q1: Apakah konteks 1M LongCat-2.5 berarti model ini mampu menyelesaikan proyek besar?
Tidak bisa langsung disamakan. Konteks 1M adalah kapasitas satu permintaan, termasuk input dan output. Kapasitas ini memungkinkan model membaca lebih banyak kode dan dokumen. Penyelesaian proyek juga bergantung pada perencanaan, pemanggilan alat, perbaikan kesalahan, dan pemeriksaan hasil akhir. Aspek-aspek inilah yang secara khusus dilatih pada LongCat-2.5 melalui pembelajaran penguatan untuk tugas jangka panjang.
Q2: Bagaimana perbandingan kemampuan LongCat-2.5 dengan GPT-5.6-Sol dan Claude Opus 5 dalam tugas jangka panjang?
Menurut tabel resmi, LongCat-2.5 sedikit lebih unggul daripada GPT-5.6-Sol pada BrowseComp (91.9) dan Terminal Bench v4.0 (38.5). Namun, skor DeepSWE-nya sebesar 64.6 lebih rendah daripada 72.7 milik GPT-5.6-Sol, sedangkan skor Terminal Bench v4.0-nya juga 15.4 poin lebih rendah daripada Claude Opus 5. Karena kerangka setiap pengujian berbeda, hasil ini tidak sebaiknya dianggap sebagai satu peringkat terpadu.
Q3: Kapan versi final LongCat-2.5 dirilis? Apakah bobotnya sudah bersifat sumber terbuka?
Versi Preview tersedia di platform API pada 2026-09-25, sedangkan versi final dirilis pada 2026-11-02. Situs web resmi dan API sudah tersedia, tetapi hingga 2026-11-03, belum ada konfirmasi bahwa bobot model versi final telah dibuka untuk publik. Pihak resmi menyatakan bahwa bobot tersebut akan tersedia di GitHub dan Hugging Face kemudian.
Q4: Apakah LongCat-2.5 sudah bisa dipanggil melalui APIYI?
Berdasarkan informasi publik pada 2026-11-02, LongCat-2.5 saat itu belum tersedia di APIYI dan direncanakan untuk ditambahkan kemudian. Untuk status ketersediaan terbaru, silakan periksa daftar model APIYI di apiyi.com. Sementara itu, Anda bisa menggunakan model yang sudah tersedia di platform untuk membangun kerangka Agent, seperti validasi per tahap dan pemberian kembali hasil kegagalan ke model. Setelah LongCat-2.5 tersedia, Anda hanya perlu mengganti ID model.
Q5: Bagaimana cara menguji kemampuan Agent suatu model untuk tugas jangka panjang dengan biaya rendah?
Siapkan 3–5 tugas bertahap yang sesuai dengan kebutuhan bisnis Anda dan dilengkapi skrip verifikasi otomatis. Catat tingkat penyelesaian penuh, rata-rata jumlah putaran, dan jenis kegagalan setiap model. Dengan antarmuka APIYI di apiyi.com yang kompatibel dengan OpenAI, satu kunci API cukup untuk membandingkan beberapa model dalam skrip yang sama. Pengguna baru juga mendapat kuota uji gratis untuk validasi awal.
Q6: Apa saja keterbatasan kemampuan jangka panjang LongCat-2.5 yang sudah diketahui?
Pengujian pihak ketiga menemukan masalah seperti kesalahan satuan dimensi, kesalahan hubungan spasial, video yang tidak diserahkan, dan proses yang terhenti karena waktu tunggu permintaan habis. Pihak resmi juga belum menyatakan bahwa Reward Hacking telah sepenuhnya teratasi, sementara jumlah rekam jejak kegagalan dan tingkat perbaikannya belum dipublikasikan. Dimensi teknis, keakuratan informasi, dan kelengkapan hasil akhir masih perlu diverifikasi secara manual.
Poin Utama Agent Jangka Panjang LongCat-2.5
- Konteks ≠ penyelesaian: 1 juta token adalah kapasitas, bukan tingkat keberhasilan proyek. Kemampuan bekerja jangka panjang perlu dilatih secara terpisah.
- Pelatihan di lingkungan nyata: Lingkungan yang dapat dieksekusi dibangun dari PR dan issue GitHub serta tugas internal untuk memperoleh umpan balik.
- Validasi lewat dua jenis pengujian: F2P memeriksa apakah masalah sudah teratasi, sedangkan P2P memeriksa apakah ada regresi.
- Belajar dari kegagalan: Jejak kegagalan Agent dalam tugas nyata diolah menjadi tugas pelatihan yang dapat diverifikasi.
- Hasil perlu dilihat sesuai kondisinya: Benchmark sangat bergantung pada Harness, dan pengujian pihak ketiga masih menemukan hasil yang tidak diserahkan.
- Desain teknis juga harus disiapkan: Validasi tiap tahap, pencatatan kegagalan, batas anggaran, dan pemeriksaan hasil akhir semuanya penting. APIYI apiyi.com dapat membantu membandingkan dan memvalidasi beberapa model.
Kesimpulan
Sinyal terbesar dari peluncuran LongCat-2.5 bukanlah hadirnya satu lagi jendela konteks sejuta token, melainkan pergeseran fokus pelatihan dari “seberapa banyak yang bisa dibaca” menjadi “bisakah seluruh proyek diselesaikan”:
- Definisi masalah lebih tepat: Kegagalan Agent jangka panjang lebih sering terjadi pada tahap eksekusi, validasi, dan penyerahan hasil, bukan karena konteks tidak cukup.
- Metode pelatihan lebih terarah: Lingkungan tugas nyata, F2P/P2P, jejak kegagalan, Partial Rollout, pencegahan jalan pintas, dan pelatihan lintas Harness masing-masing menyasar jenis kegagalan yang berbeda di dunia nyata.
- Batas bukti perlu jelas: Hasil resmi menunjukkan peningkatan yang signifikan, tetapi masih ada jarak dengan model terdepan. Pengujian pihak ketiga juga menunjukkan bahwa penyerahan hasil secara lengkap masih memerlukan pemeriksaan manusia.
Bagi developer, langkah yang lebih praktis adalah menerapkan pendekatan serupa pada sistem Agent sendiri dan mengukur model dengan kriteria penerimaan yang dapat dijalankan, bukan hanya melihat parameter dan papan peringkat. Gunakan APIYI apiyi.com untuk membandingkan dan memvalidasi model pada tugas nyata melalui satu antarmuka, lalu tentukan kombinasi model untuk lingkungan produksi.
📚 Referensi
- Tim Teknologi Meituan – Artikel Teknis LongCat-2.5:Penjelasan metode pelatihan Agent untuk tugas jangka panjang
- Tautan:
tech.meituan.com/2026/11/02/Meituan-LongCat-2.5.html -
Keterangan:Sumber asli desain pelatihan seperti F2P/P2P, Partial Rollout, dan pencegahan Reward Hacking
-
Blog Resmi LongCat:Data benchmark dan metode evaluasi
- Tautan:
longcat.ai/blog/longcat-2.5 -
Keterangan:Tabel evaluasi lengkap serta pengaturan Harness dan parameter untuk setiap benchmark
-
Dokumentasi Parameter Model LongCat:Penjelasan parameter konteks dan output
- Tautan:
longcat.ai/platform/docs/zh/api/model-params -
Keterangan:Parameter pemanggilan seperti panjang konteks, max_tokens, dan anggaran berpikir
-
Terminal-Bench:Benchmark Agent terminal
- Tautan:
tbench.ai -
Keterangan:Memahami keterkaitan skor dengan Agent Harness serta perbedaan antarversi
-
DeepSWE:Benchmark Agent untuk rekayasa perangkat lunak jangka panjang
- Tautan:
deepswe.datacurve.ai -
Keterangan:Desain pengujian dengan 113 tugas orisinal dan 91 repositori sumber terbuka
-
TOKRACE – Catatan Pengujian LongCat-2.5:Pengujian pihak ketiga pada 15 tugas kreatif
- Tautan:
tokrace.com/zh-CN/guides/longcat-2-5-release - Keterangan:Kasus nyata seperti tugas panjang yang hanya selesai sebagian dan kesalahan satuan
Penulis:Tim Teknologi APIYI
Diskusi teknis:Kunjungi halaman utama APIYI di apiyi.com untuk menghubungi kami dan berbagi pengalaman tentang praktik rekayasa Agent jangka panjang serta pemilihan model