Nota del autor: Analizamos por qué LongCat-2.5 no depende solo de un contexto de 1M, sino que refuerza, mediante seis líneas de entrenamiento, la capacidad de los agentes de largo recorrido para completar proyectos enteros. También repasamos métodos de ingeniería que los desarrolladores pueden aplicar.
Si has desarrollado agentes de IA, seguramente te suenan estas situaciones: una tarea falla a mitad de camino, el agente intenta una y otra vez el mismo comando erróneo y termina entregando un resumen que parece completo, pero omite varios entregables clave. Con LongCat-2.5, lanzado oficialmente por Meituan el 2 de noviembre de 2026, el foco está en la capacidad de los agentes de largo recorrido para completar proyectos enteros, no solo en seguir destacando su ventana de contexto de 1M.
Este no es un artículo promocional sobre parámetros. El blog técnico de Meituan ya ha detallado el diseño de entrenamiento con aprendizaje por refuerzo para tareas de largo recorrido, y terceros también probaron el modelo en tareas largas el día de su lanzamiento oficial. Aquí distinguiremos tres tipos de información: el diseño oficial de entrenamiento, los resultados oficiales de benchmarks y la experiencia práctica de terceros. También explicaremos qué puede demostrar cada uno y qué no.
Qué te llevarás: al terminar, entenderás por qué un contexto de un millón de tokens no equivale a completar un proyecto con éxito, qué métodos usa LongCat-2.5 para mejorar en tareas de largo recorrido y cómo aplicar esas ideas a tus propios proyectos de agentes.
LongCat-2.5: datos clave de un vistazo
LongCat-2.5 es un Modelo de Lenguaje Grande multimodal nativo desarrollado por el equipo LongCat de Meituan y orientado a tareas de agentes de larga duración (Long-Horizon Agentic Tasks). Sobre la base de LongCat-2.0, incorpora más trayectorias de tareas de larga duración y refuerza especialmente el desarrollo en bases de código complejas y la creación de proyectos completos.
| Información | Detalles |
|---|---|
| Fecha de lanzamiento | Preview disponible desde el 2026-09-25; versión oficial publicada el 2026-11-02 |
| Desarrollador | Equipo LongCat de Meituan |
| Tamaño del modelo | 1.6T de parámetros totales, con activación dispersa MoE; aproximadamente 48B activos por token |
| Ventana de contexto | 1,048,576 tokens (aproximadamente 1M), incluidos entrada y salida |
| Áreas principales | Agentes de larga duración, Agentic Coding, programación visual y llamadas a herramientas en varios pasos |
| Disponibilidad | La web oficial y la API ya están disponibles; aún no se ha confirmado si los pesos de la versión oficial serán públicos |
Es importante aclarar que, hasta el 2026-11-03, APIYI ya había publicado un artículo de presentación de LongCat-2.5. Sin embargo, en ese momento señaló que el modelo aún no estaba disponible en la plataforma y que planeaba incorporarlo más adelante. Para saber qué modelos se pueden invocar, consulta la lista actualizada en APIYI, apiyi.com. Los ejemplos de código de este artículo usan una sintaxis genérica compatible con OpenAI y pueden adaptarse a cualquier modelo que ya esté integrado.
Por qué un contexto de un millón de tokens no basta para completar tareas de agentes de largo recorrido
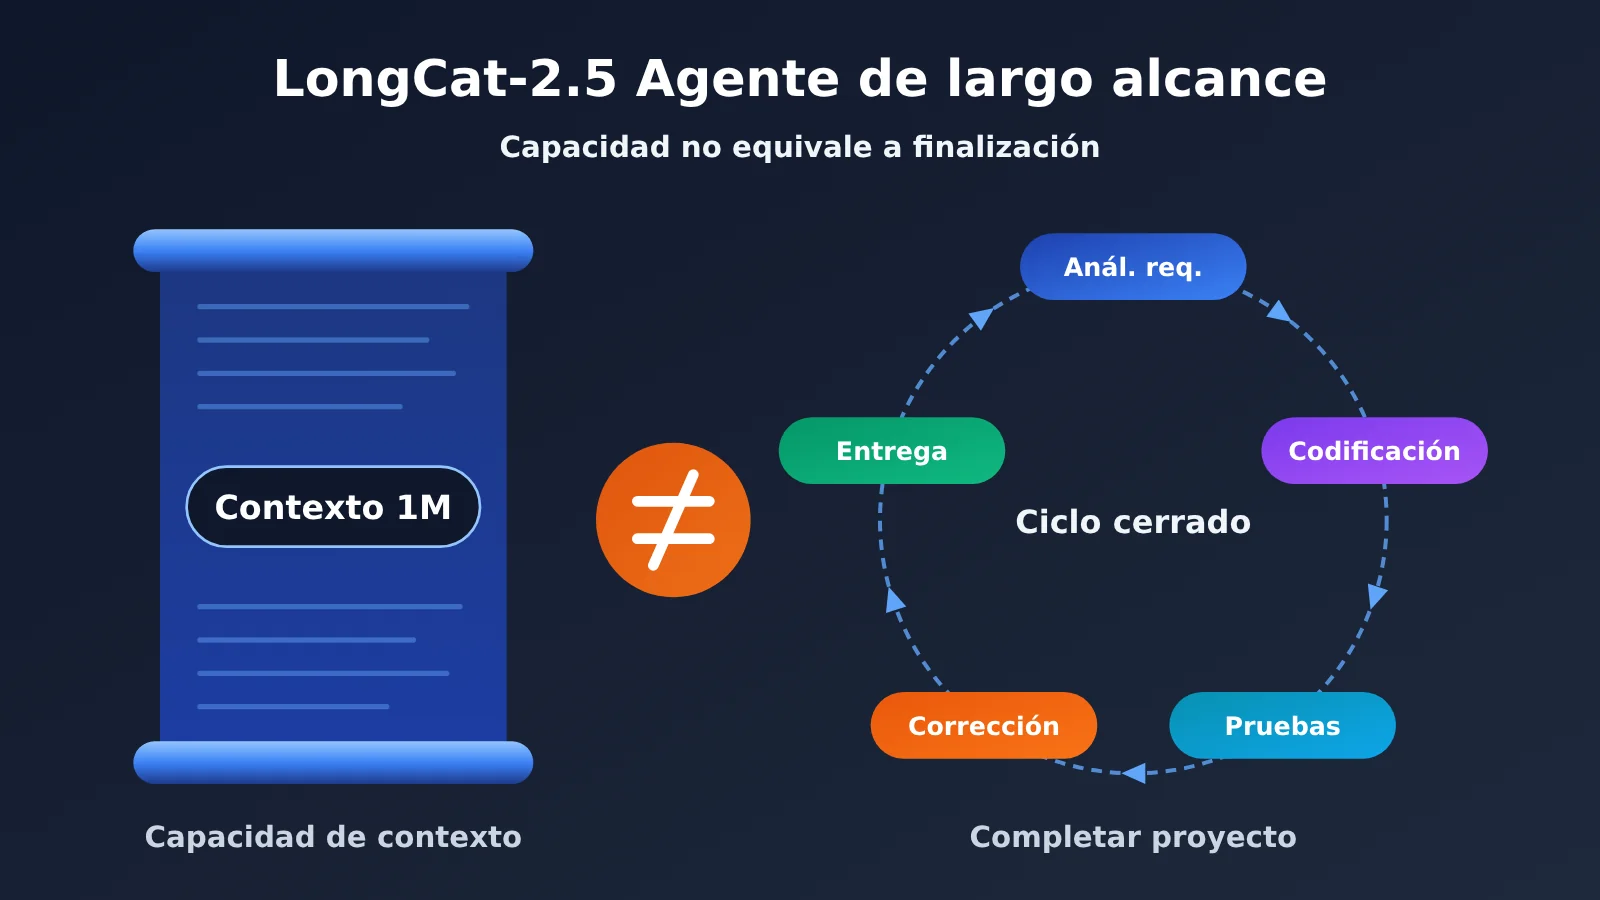
El contexto largo (Long Context) es la cantidad total de tokens que caben en una sola solicitud. Una ventana de 1M permite al modelo leer de una vez más código fuente, documentos y mensajes anteriores, lo que sin duda ayuda a comprender repositorios grandes. Pero ese dato, por sí solo, no garantiza que «la búsqueda en documentos largos sea siempre precisa», que «las llamadas a herramientas funcionen de forma continua» ni que «los archivos generados sean correctos».
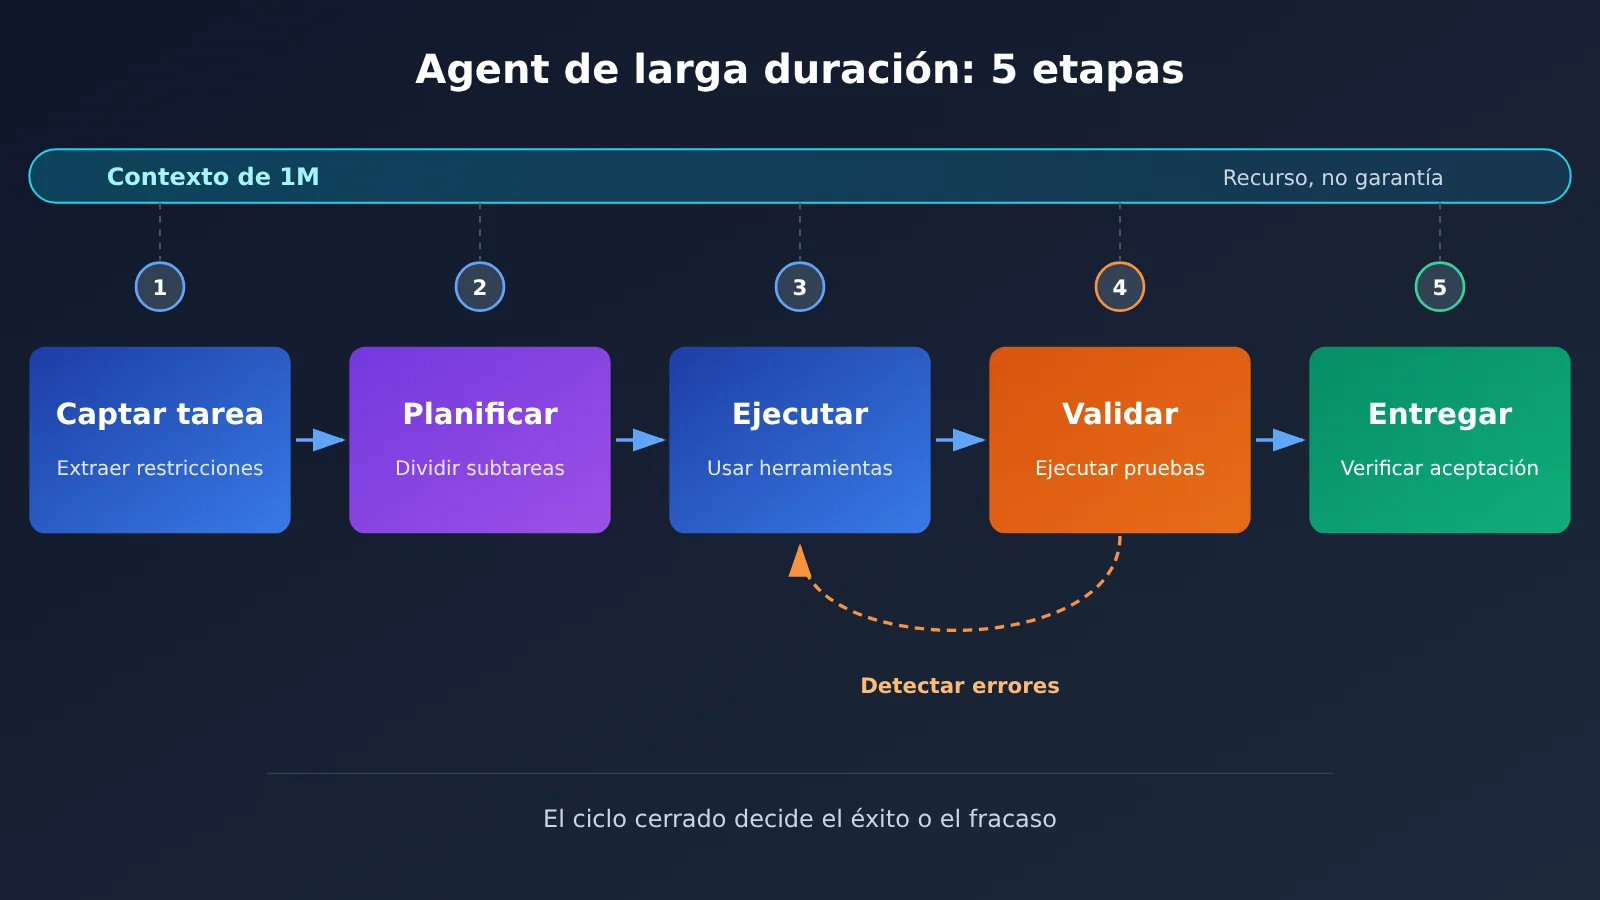
Un agente de largo recorrido (Long-Horizon Agent) es otra cosa. Requiere que el modelo ejecute de forma sostenida varios pasos interdependientes en un entorno externo: leer el repositorio, escribir código, llamar a herramientas, ejecutar pruebas, detectar errores, corregirlos, volver a verificar y, finalmente, entregar el resultado. Si falla cualquiera de esos pasos, los siguientes pueden basarse en un estado incorrecto.
| Dimensión | Capacidad de contexto largo | Capacidad de un agente de largo recorrido |
|---|---|---|
| Esencia | Capacidad de una sola solicitud | Fiabilidad de la ejecución sostenida en varios pasos |
| Medición | Cuántos tokens caben | Si la tarea final cumple los criterios de aceptación |
| Dependencias clave | Mecanismo de atención y entrenamiento con textos largos | Planificación, llamadas a herramientas, aprovechamiento de los errores y decisión de cuándo terminar |
| Fallo típico | Omisiones al buscar en textos largos | Desviarse del objetivo, repetir llamadas u olvidar entregables |
| Relación con el éxito del proyecto | Uno de los recursos necesarios | Determina el éxito o el fracaso de forma más directa |
Dicho de otro modo, el contexto indica «qué tan grande es la mesa de trabajo»; la capacidad de largo recorrido indica «si se puede terminar el trabajo». Por muy grande que sea la mesa, si el modelo no sabe ajustar su plan cuando fallan las pruebas o si olvida las restricciones iniciales, el proyecto puede quedarse a medio camino. Esa es también la razón principal por la que LongCat-2.5 centra su entrenamiento en tareas de largo recorrido.
Evolución de LongCat-2.5 en benchmarks de agentes para tareas de larga duración
Meituan publicó una comparativa entre LongCat-2.5 y su generación anterior en varios benchmarks de agentes para tareas de larga duración. Los valores de la tabla proceden del anuncio oficial; la columna de mejora indica la diferencia de puntuación, no un porcentaje relativo.
| Benchmark | LongCat-2.0 | LongCat-2.5 | Mejora | Qué mide |
|---|---|---|---|---|
| Terminal Bench v2.1 | 70.8 | 88.4 | +17.6 | Ejecución de tareas reales en un entorno de terminal |
| Terminal Bench v4.0 | 3.0 | 38.5 | +35.5 | Tareas largas y más difíciles en terminal |
| DeepSWE v1.1 | 9.7 | 64.6 | +54.9 | Tareas de ingeniería de software de larga duración |
| Program Bench Almost Resolved | 2.5 | 25.5 | +23.0 | Grado de avance en la construcción de programas |
| NL2Repo | 40.9 | 60.5 | +19.6 | Generación de repositorios a partir de requisitos en lenguaje natural |
| MCP Atlas | 61.8 | 83.1 | +21.3 | Uso de múltiples herramientas |
| JobBench | 44.4 | 65.4 | +21.0 | Entregables profesionales para tareas laborales |
La mejora es evidente, pero conviene tener en cuenta algunos límites al interpretar los datos. DeepSWE pasa de 9.7 a 64.6, aunque en la comparación oficial sigue por debajo de los 72.7 de GPT-5.6-Sol. En Terminal Bench v4.0, la puntuación de 38.5 supera ligeramente los 37.3 de GPT-5.6-Sol, pero queda 15.4 puntos por debajo de los 53.9 de Claude Opus 5. Esto indica que las tareas difíciles en terminal están lejos de estar resueltas.
Las condiciones de evaluación también importan. Terminal Bench utiliza Claude Code Harness, DeepSWE usa mini-swe-agent y JobBench se puntúa mediante LLM-as-Judge. Por tanto, las puntuaciones dependen de cada marco de ejecución. En la tabla oficial, algunos resultados de modelos competidores proceden de informes públicos y otros de pruebas realizadas por la propia Meituan, así que no deben considerarse una clasificación independiente bajo condiciones uniformes. El benchmark interno LongCat AppDev (47.7 → 73.7) tampoco puede reproducirse públicamente.
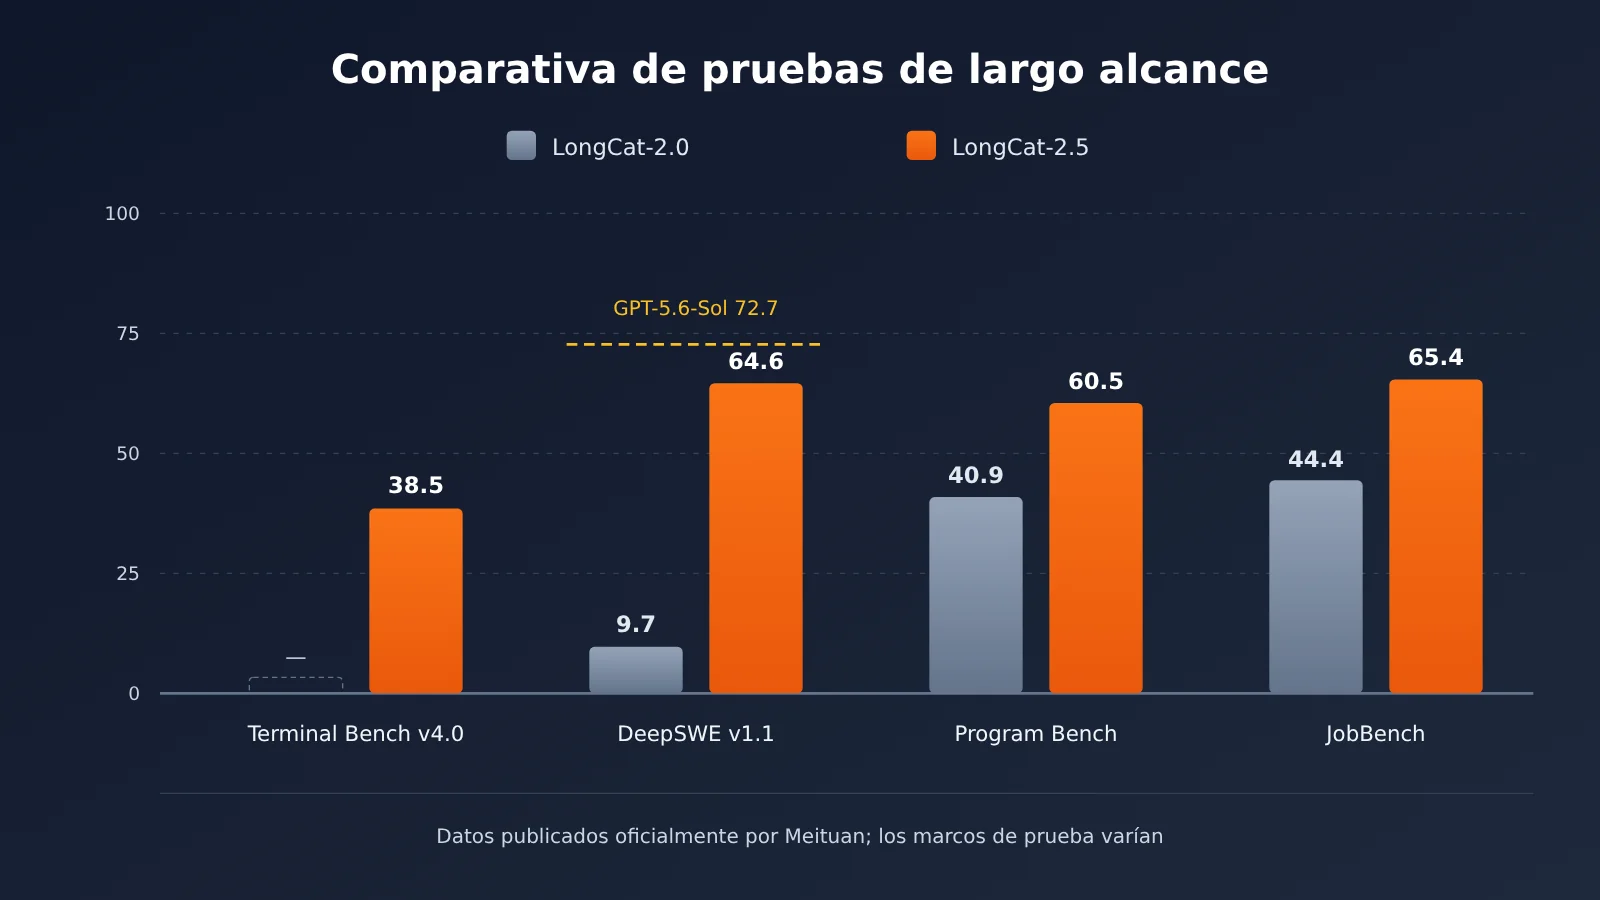
📊 Nota sobre la comparación: Los benchmarks solo reflejan el rendimiento en marcos concretos; al final, hay que validar los resultados con las propias tareas. Puedes usar APIYI apiyi.com para comparar varios modelos disponibles con el mismo conjunto de scripts de prueba y combinar esos resultados con las puntuaciones oficiales para elegir un modelo.
Cómo se entrena a LongCat-2.5 para que un agente complete un proyecto entero
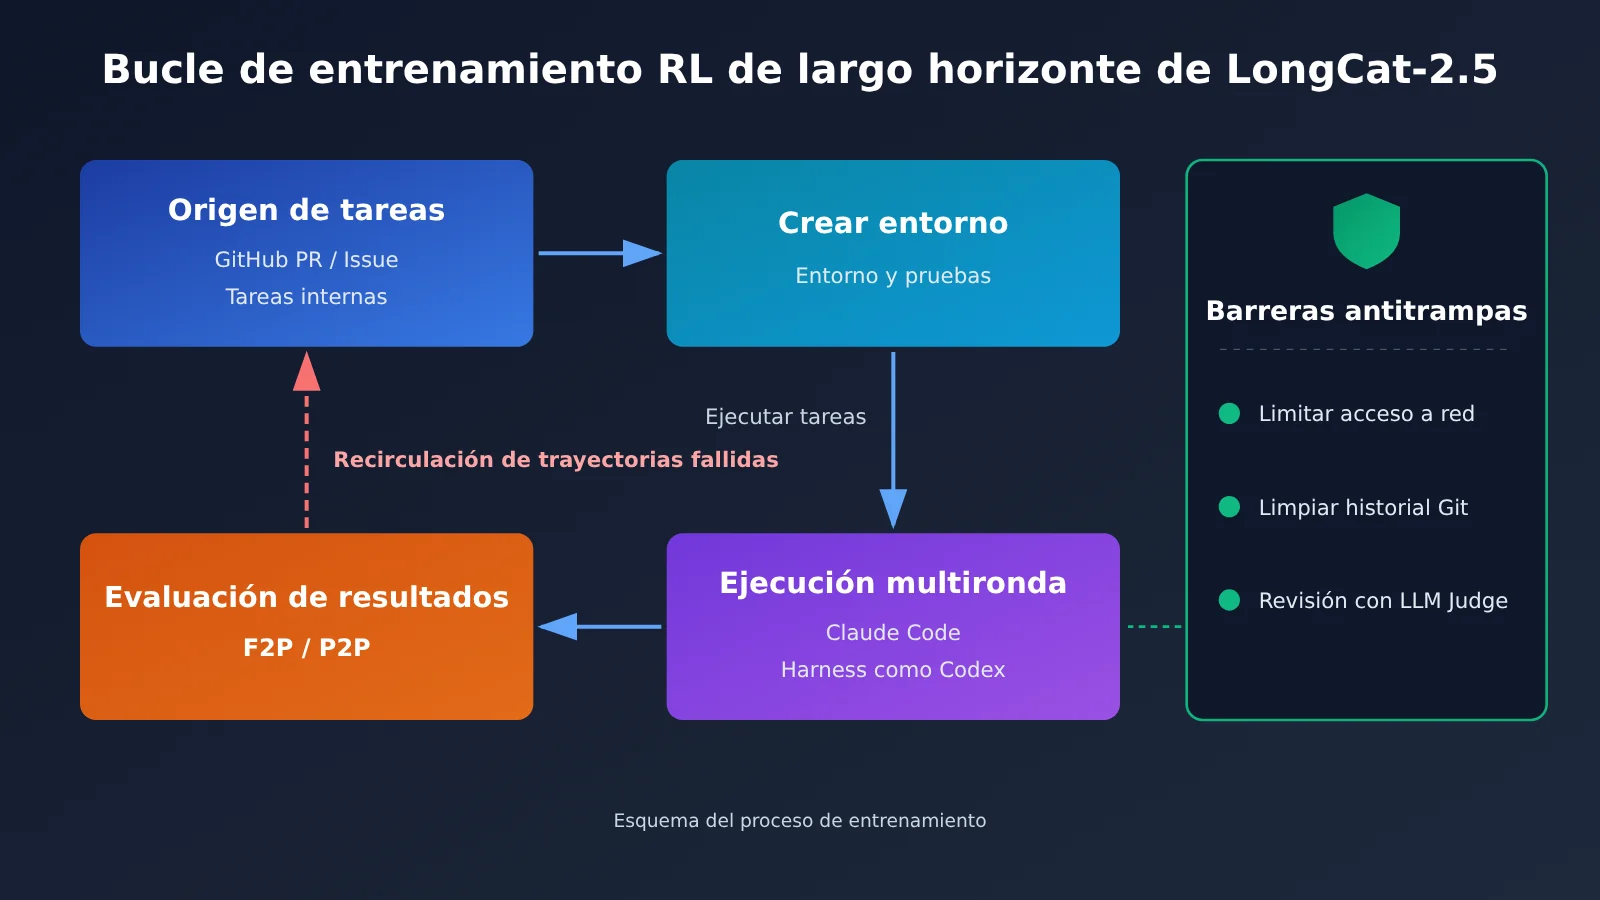
Los métodos de entrenamiento para tareas largas que describe el blog técnico de Meituan se pueden agrupar en 6 líneas de trabajo. Para entenderlos, conviene ver qué tipo de fallo real en una tarea larga aborda cada una.
Entornos de tareas reales y validación F2P/P2P en LongCat-2.5
Los datos de entrenamiento proceden de PR e issues asociados de repositorios públicos de GitHub, así como de tareas reales de programación internas de Meituan. El proceso consiste en seleccionar tareas, usar un agente para etiquetarlas automáticamente, crear el entorno de código y generar pruebas ejecutables. Después, el modelo realiza la tarea y se evalúa si resolvió el problema según los resultados de la ejecución. A diferencia de limitarse a alimentar al modelo con grandes cantidades de texto de código, este método permite obtener una respuesta sobre si realmente funcionó.
Para la validación se utilizan dos tipos de pruebas: F2P (Fail-to-Pass) comprueba si las pruebas que antes fallaban pasan tras la corrección; P2P (Pass-to-Pass) verifica si las que ya pasaban siguen pasando. La primera ayuda a evitar que el problema quede sin resolver; la segunda, que al corregir algo se rompan otras cosas. Meituan también utiliza las trayectorias de entrenamiento y las tasas de aprobación para detectar falsos positivos y falsos negativos en las propias pruebas. Aun así, la eficacia depende de hasta qué punto los casos de prueba cubran todos los requisitos.
Aprendizaje de trayectorias fallidas y Partial Rollout asíncrono en LongCat-2.5
El equipo reconstruye las trayectorias fallidas de agentes reales como tareas reproducibles y verificables para detectar carencias y ampliar los entornos de entrenamiento. Es como guardar los ejercicios que salieron mal para aprender de ellos, en vez de estudiar solo los casos de éxito. La información pública no especifica cuántas trayectorias fallidas se usaron ni la tasa de corrección de cada tipo de error.
La duración de las tareas largas varía enormemente: una trayectoria compleja puede retrasar todo un lote de entrenamiento. El Partial Rollout asíncrono funciona así: se muestrean varias tareas en paralelo y, cuando se completa el lote, se interrumpen y guardan las trayectorias inacabadas para retomarlas en la siguiente ronda. También se filtran los grupos de muestras en los que todas tuvieron éxito o todas fallaron, pues no aportan gradientes útiles. Esto plantea un problema: los tokens de una misma trayectoria pueden proceder de distintas etapas del modelo. Para controlar el sesgo, el equipo recorta las diferencias de logprob y ajusta la contribución al gradiente según la diferencia acumulada históricamente. Esta técnica mejora la eficiencia del entrenamiento, pero no permite concluir que las tareas del usuario se ejecuten proporcionalmente más rápido.
Prevención del Reward Hacking y entrenamiento entre distintos Harness en LongCat-2.5
El Reward Hacking ocurre cuando el modelo aprovecha lagunas en el diseño de la recompensa para obtener una puntuación alta sin completar realmente la tarea, por ejemplo, mirando la respuesta o eludiendo las pruebas. Entre las medidas de Meituan están restringir el acceso a Internet en el entorno de entrenamiento, limpiar el historial de Git y las cachés de archivos, usar un LLM Judge para revisar las trayectorias y penalizar el razonamiento repetitivo, las llamadas repetidas a herramientas y el razonamiento excesivo. Son medidas para controlar el riesgo; no significan que el problema esté totalmente resuelto.
Un Harness es el sistema que organiza la ejecución de tareas por parte del modelo, incluidas las herramientas, la gestión del contexto y las reglas del ciclo de tareas. LongCat-2.5 incorpora una pequeña cantidad de muestras de adaptación a distintos frameworks durante el arranque en frío y, en la fase de RL, combina frameworks como Claude Code y Codex con distintos tipos de tareas. Esto reduce el riesgo de que el modelo solo se adapte a una plantilla de indicación, aunque no garantiza un comportamiento idéntico entre distintas versiones de las herramientas.
| Método de entrenamiento | Problema real que aborda | Límites conocidos |
|---|---|---|
| Entornos de tareas reales | Saber escribir código, pero no ejecutarlo correctamente en el entorno | Depende de la calidad con que se construya el entorno |
| Verificación F2P / P2P | Completar tareas solo en apariencia e introducir errores de regresión | Limitada por la cobertura de las pruebas |
| Aprendizaje de trayectorias fallidas | Repetición del mismo tipo de errores | No se han publicado el número de trayectorias ni la tasa de corrección |
| Partial Rollout asíncrono | Baja eficiencia del entrenamiento con tareas largas | No equivale a acelerar la inferencia |
| Prevención del Reward Hacking | Éxitos falsos obtenidos mediante atajos | No se afirma que el problema esté completamente resuelto |
| Entrenamiento mixto entre distintos Harness | Fallos al cambiar de framework de agentes | No garantiza consistencia entre versiones |
Prueba independiente: por qué LongCat-2.5 completa algunas tareas largas solo parcialmente
Más allá del diseño de entrenamiento oficial y los benchmarks, las pruebas independientes ofrecen otra perspectiva. El 2 de noviembre de 2026, TOKRACE integró la versión oficial de LongCat-2.5 en Claude Code y lo utilizó junto con herramientas como Blender y un navegador para realizar 15 tareas creativas.
Un caso exitoso fue una estantería paramétrica: las dimensiones de las dos versiones, una de 0.8 metros con tres compartimentos y otra de 1 metro con cuatro, así como el grosor de 18mm de los tableros, cumplían los requisitos. También se entregaron seis imágenes desde distintos ángulos. El proceso duró unos 36 minutos y requirió 47 solicitudes. Sin embargo, otras tareas revelaron fallos típicos de la ejecución prolongada:
- Errores estructurales y de unidades: se pidió un reductor planetario de 140mm, pero el proyecto generado utilizó 140m y no se entregó el video.
- Entrega parcial: en una tarea de 60 minutos para crear un patio de templo chino, solo se entregaron tres imágenes finales; faltaron algunas tomas y el video.
- Problemas de relaciones espaciales: en un modelo de vivienda de dos dormitorios, las puertas y ventanas no tenían aberturas en las paredes, y la cama se superponía con un tabique.
- Interrupción durante una ejecución prolongada: un video educativo de matemáticas quedó sin terminar tras varias solicitudes consecutivas que agotaron el tiempo de espera.
Estos casos muestran que, en las tareas largas, no basta con comprobar si «se ha generado algo»: hay que verificar cada requisito. También conviene tener en cuenta que la prueba establecía límites de solicitudes, tiempo o presupuesto de ejecución, por lo que no se puede atribuir todo lo que no se entregó a una falta de capacidad del modelo. Tampoco se trató de un experimento comparativo riguroso entre modelos.
Análisis del impacto del enfoque de entrenamiento de largo recorrido de LongCat-2.5
Impacto para los desarrolladores de agentes
- Cambian los criterios de elección: al evaluar modelos, la longitud del contexto pierde peso. Conviene prestar más atención a los benchmarks de tareas de largo recorrido y a la tasa de finalización de tareas reales.
- La validación sigue siendo indispensable: aunque el modelo se haya entrenado con F2P/P2P, en producción sigue siendo necesario crear pruebas y criterios de aceptación propios. Las pruebas independientes ya lo han demostrado.
- El diseño del harness también es clave: las puntuaciones dependen mucho del entorno de ejecución. Un mismo modelo puede obtener resultados muy diferentes con otro ciclo de tareas.
Impacto para la industria de los Modelos de Lenguaje Grande
- El entrenamiento se centra en el «proceso»: el enfoque pasa de generar código en un solo turno a completar proyectos y tareas de ingeniería de varios pasos. La capacidad de crear entornos de aprendizaje por refuerzo se convierte en un nuevo factor competitivo.
- Los métodos de evaluación cobran importancia: Terminal-Bench 2.1 corrigió 28 de las 89 tareas de la versión 2.0. Esto demuestra que la propia versión de la prueba puede afectar considerablemente los resultados, por lo que la industria necesita explicar con más transparencia las condiciones de evaluación.
Diseñar agentes para tareas largas inspirándose en LongCat-2.5
El método de entrenamiento de LongCat-2.5 deja una lección clara para quienes desarrollan aplicaciones: si el modelo se entrena para validar etapas, recuperarse de fallos y evitar atajos, conviene incorporar esos mismos mecanismos de forma explícita al sistema de agentes. Las siguientes son recomendaciones de ingeniería basadas en los métodos de entrenamiento publicados, no funciones que se haya afirmado oficialmente que ya están implementadas.
| Mecanismo de ingeniería | Idea de entrenamiento correspondiente | Implementación |
|---|---|---|
| Validación por etapas | Validación F2P | Ejecutar un script de comprobación al terminar cada subtarea |
| Protección contra regresiones | Validación P2P | Ejecutar todas las pruebas de regresión después de cada cambio |
| Registro de fallos | Aprendizaje de trayectorias fallidas | Escribir los errores en el archivo de progreso e incorporarlos a la siguiente ronda |
| Límite de recursos | Penalización por llamadas repetidas | Limitar el número máximo de rondas, el tiempo de espera y las llamadas a herramientas |
| Aceptación de la entrega | Prevención del Reward Hacking | Revisar los archivos reales, en lugar de confiar solo en el resumen del modelo |
Este ejemplo mínimo de un bucle de agente con validación por etapas muestra cómo registrar el progreso, incorporar los fallos a la siguiente ronda y establecer un límite de recursos:
import json, subprocess, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz de APIYI compatible con OpenAI
)
MODEL = "gpt-4o-mini"  # Usar un ID de modelo disponible en la lista de la plataforma
MAX_ROUNDS = 8         # Límite de recursos para evitar bucles infinitos

def run_check(cmd: str) -> tuple[bool, str]:
    r = subprocess.run(cmd, shell=True, capture_output=True, text=True, timeout=300)
    return r.returncode == 0, (r.stdout + r.stderr)[-2000:]

def run_stage(stage: dict, progress: dict) -> bool:
    failures = []
    for i in range(MAX_ROUNDS):
        prompt = (f"阶段目标:{stage['goal']}\n"
                  f"已完成阶段:{progress['done']}\n"
                  f"历史失败(请避免重复):{failures[-3:]}")
        resp = client.chat.completions.create(
            model=MODEL, messages=[{"role": "user", "content": prompt}])
        # Se omite: analizar la salida del modelo y escribirla en los archivos de código
        ok, log = run_check(stage["check"])          # Validación de etapa (similar a F2P)
        reg_ok, reg_log = run_check("pytest -q")     # Prueba de regresión (similar a P2P)
        if ok and reg_ok:
            progress["done"].append(stage["name"])
            return True
        failures.append(log if not ok else reg_log)
    progress["blocked"] = stage["name"]
    return False

progress = {"done": [], "blocked": None}
stages = [{"name": "api", "goal": "实现用户接口", "check": "pytest tests/test_api.py -q"}]
for s in stages:
    if not run_stage(s, progress):
        break
json.dump(progress, open("progress.json", "w"), ensure_ascii=False)
La clave de esta estructura es que cada etapa tiene un comando de aceptación ejecutable, los registros de fallos se incorporan a la indicación de la siguiente ronda y el progreso se guarda en un archivo, en lugar de permanecer solo en el contexto. Incluso con una ventana de contexto amplia, guardar el progreso y las restricciones fuera de ella como estado estructurado puede reducir considerablemente el riesgo de desviarse del objetivo durante una tarea larga.
🚀 Para empezar rápido: al crear un prototipo de agente, puedes obtener crédito de prueba en APIYI apiyi.com y usar la misma clave API para ejecutar el bucle de validación por etapas con distintos modelos. Así podrás observar cuál entrega los resultados más completos para tu tarea.
Si el proyecto exige una alta fiabilidad, también puedes incorporar una «validación cruzada»: otro modelo comprueba el resultado final contra cada punto de la lista de requisitos. Con la interfaz unificada de APIYI apiyi.com, puedes invocar el modelo ejecutor y el modelo de validación desde el mismo código, con muy poco esfuerzo de cambio.
Preguntas frecuentes FAQ
Q1: ¿La ventana de contexto de 1M de LongCat-2.5 significa que puede completar proyectos grandes?
No necesariamente. El contexto de 1M es la capacidad de una sola solicitud, que incluye tanto la entrada como la salida, y permite al modelo leer más código y documentación. Completar un proyecto también requiere planificación, invocación de herramientas, corrección de errores y verificación de entregables. Estas son precisamente las capacidades para las que LongCat-2.5 se ha entrenado mediante aprendizaje por refuerzo en tareas de largo recorrido.
Q2: ¿Cómo se compara LongCat-2.5 con GPT-5.6-Sol y Claude Opus 5 en tareas de largo recorrido?
Según la tabla oficial, LongCat-2.5 supera ligeramente a GPT-5.6-Sol en BrowseComp (91.9) y Terminal Bench v4.0 (38.5). Sin embargo, su puntuación de 64.6 en DeepSWE queda por debajo del 72.7 de GPT-5.6-Sol, y en Terminal Bench v4.0 obtiene 15.4 puntos menos que Claude Opus 5. Como cada prueba utiliza un marco de evaluación diferente, no conviene interpretarlas como una clasificación única.
Q3: ¿Cuándo se lanzó la versión final de LongCat-2.5? ¿Sus pesos son de código abierto?
La versión Preview llegó a la plataforma API el 2026-09-25 y la versión final se lanzó el 2026-11-02. La página web oficial y la API ya están disponibles, pero hasta el 2026-11-03 no se había confirmado la publicación de los pesos de la versión final. Según el equipo oficial, llegarán más adelante a GitHub y Hugging Face.
Q4: ¿Ya se puede utilizar LongCat-2.5 a través de APIYI?
Según la información pública del 2026-11-02, LongCat-2.5 aún no estaba disponible en APIYI, aunque se planeaba integrarlo más adelante. Para consultar su disponibilidad actual, revisa la lista de modelos de APIYI en apiyi.com. Mientras tanto, puedes usar los modelos ya integrados en la plataforma para crear un marco de agentes con verificación por etapas y retroalimentación de fallos. Cuando el modelo esté disponible, solo tendrás que sustituir su ID.
Q5: ¿Cómo se puede evaluar a bajo costo la capacidad de un modelo como agente en tareas de largo recorrido?
Te recomendamos preparar entre 3 y 5 tareas de varios pasos, cercanas a las necesidades de tu negocio y con scripts de aceptación automática. Registra la tasa de entregas completas, el promedio de turnos y los tipos de fallo de cada modelo. Con la interfaz compatible con OpenAI de APIYI, en apiyi.com, basta una clave API para comparar varios modelos con los mismos scripts. Los usuarios nuevos también cuentan con crédito gratuito para realizar pruebas preliminares.
Q6: ¿Qué limitaciones conocidas tiene LongCat-2.5 en tareas de largo recorrido?
En pruebas realizadas por terceros se detectaron errores en unidades de medida y relaciones espaciales, videos que no se entregaron e interrupciones por agotamiento del tiempo de espera. El equipo oficial tampoco ha afirmado que el problema de la manipulación de recompensas (Reward Hacking) esté completamente resuelto, y aún no se han publicado el volumen de trayectorias fallidas ni su tasa de corrección. Las dimensiones técnicas, la precisión de la información y la integridad de los entregables siguen requiriendo verificación humana.
LongCat-2.5: puntos clave para agentes de largo recorrido
- Contexto ≠ capacidad de completar tareas: 1M de tokens es una medida de capacidad, no de éxito en un proyecto. La capacidad de trabajar a largo plazo requiere entrenamiento específico.
- Entrenamiento en entornos reales: se crean entornos ejecutables a partir de PR, Issues y tareas internas de GitHub para obtener retroalimentación.
- Verificación en dos sentidos: F2P comprueba si se resolvió el problema; P2P verifica que no se hayan introducido regresiones.
- Aprendizaje a partir de fallos: las trayectorias fallidas de agentes reales se reconstruyen como tareas de entrenamiento verificables.
- Los resultados dependen de las condiciones: los benchmarks están estrechamente ligados al harness, y las pruebas independientes aún detectan entregables omitidos.
- Diseño coordinado de la ingeniería: hacen falta validación por etapas, registro de fallos, límites de presupuesto y criterios de aceptación. APIYI apiyi.com puede ayudar a comparar y validar varios modelos.
Resumen
La señal más importante del lanzamiento de LongCat-2.5 no es otra ventana de contexto de un millón de tokens, sino el cambio de enfoque en el entrenamiento: de «cuánto puede leer» a «si puede completar un proyecto entero»:
- Una definición más precisa del problema: los agentes de largo recorrido suelen fallar durante la ejecución, la verificación y la entrega, más que por falta de contexto.
- Métodos de entrenamiento específicos: los entornos de tareas reales, F2P/P2P, las trayectorias fallidas, Partial Rollout, las medidas contra los atajos y el trabajo con distintos harnesses abordan cada uno un tipo de fallo real.
- Los límites de la evidencia deben estar claros: los resultados oficiales muestran avances notables, pero todavía hay distancia respecto a los modelos líderes. Las pruebas independientes también indican que la entrega completa sigue requiriendo supervisión humana.
Para los desarrolladores, lo más práctico es aplicar estas mismas ideas a sus propios sistemas de agentes y medir los modelos con criterios de aceptación ejecutables, en lugar de fijarse solo en los parámetros y las clasificaciones. Una opción es usar APIYI apiyi.com para comparar y validar modelos con una interfaz unificada sobre tareas reales, antes de decidir qué combinación utilizar en producción.
📚 Referencias
- Equipo técnico de Meituan – Artículo técnico sobre LongCat-2.5: explicación detallada de los métodos de entrenamiento para agentes de larga duración
- Enlace:
tech.meituan.com/2026/11/02/Meituan-LongCat-2.5.html -
Descripción: fuente original de los diseños de entrenamiento F2P/P2P, Partial Rollout y prevención de Reward Hacking
-
Blog oficial de LongCat: datos de benchmarks y métodos de evaluación
- Enlace:
longcat.ai/blog/longcat-2.5 -
Descripción: tabla completa de evaluaciones, con el harness y los parámetros de cada benchmark
-
Documentación de parámetros del modelo LongCat: parámetros de contexto y salida
- Enlace:
longcat.ai/platform/docs/zh/api/model-params -
Descripción: parámetros de invocación como la longitud del contexto, max_tokens y el presupuesto de razonamiento
-
Terminal-Bench: benchmark para agentes de terminal
- Enlace:
tbench.ai -
Descripción: relación entre las puntuaciones y el harness del agente, y diferencias entre versiones
-
DeepSWE: benchmark para agentes de ingeniería de software que realizan tareas de larga duración
- Enlace:
deepswe.datacurve.ai -
Descripción: diseño de pruebas con 113 tareas originales y 91 repositorios de código abierto
-
TOKRACE – Registro de pruebas de LongCat-2.5: evaluación independiente con 15 tareas creativas
- Enlace:
tokrace.com/zh-CN/guides/longcat-2-5-release - Descripción: casos reales de tareas largas completadas parcialmente, errores de unidades y otros problemas
Autor: Equipo técnico de APIYI
Intercambio técnico: Visita la página principal de APIYI en apiyi.com para contactarnos e intercambiar experiencias sobre ingeniería de agentes de larga duración y selección de modelos