著者注:LongCat-2.5 がなぜ 1M コンテキストだけに頼らず、6 つの訓練方向から長期タスクに取り組む Agent のプロジェクト完遂能力を強化しているのかを解説し、開発者が参考にできるエンジニアリング手法を整理します。
AI Agent を開発したことのある方なら、こんな経験があるのではないでしょうか。タスクの途中でエラーが発生し、Agent は同じ間違ったコマンドを繰り返し試します。最後には一見よくまとまった報告を返すものの、実際には重要な成果物がいくつか抜けています。美団が 2026-11-02 に正式リリースした LongCat-2.5 は、1M のコンテキストウィンドウを強調するだけでなく、長期タスクに取り組む Agent がプロジェクトを最後まで完遂することに重点を置いています。
この記事はパラメータを宣伝するものではありません。美団の技術ブログでは、長期タスクに向けた強化学習の具体的な訓練設計が公開されており、正式版のリリース当日には第三者による長期タスクの実測も行われました。この記事では、公式の訓練設計、公式のベンチマーク結果、第三者による実際の使用体験という 3 種類の情報を区別し、それぞれから何が分かり、何が分からないのかを説明します。
この記事で分かること:100 万 Token のコンテキストがプロジェクトの成功率に直結しない理由、LongCat-2.5 が長期タスクへの対応力を補うために用いた手法、そしてその考え方を自分の Agent 開発に生かす方法を理解できます。
LongCat-2.5 の基本情報
LongCat-2.5 は、美団(Meituan)の LongCat チームが発表した、長期的なエージェントタスク(Long-Horizon Agentic Tasks)向けのネイティブマルチモーダル大規模言語モデルです。LongCat-2.0 をベースに、長期タスクの実行軌跡をさらに取り入れ、複雑なコードベースの開発やプロジェクト全体の構築能力を重点的に強化しています。
| 項目 | 詳細 |
|---|---|
| リリース日 | 2026-09-25 にプレビュー版、2026-11-02 に正式版を公開 |
| 開発元 | 美団 LongCat チーム |
| モデル規模 | 総パラメータ数 1.6T、MoE によるスパース活性化で、トークンあたり約 48B を活性化 |
| コンテキストウィンドウ | 1,048,576 Tokens(約 1M)、入力と出力の合計 |
| 主な用途 | 長期エージェント、Agentic Coding、ビジュアルプログラミング、複数ステップのツール呼び出し |
| 公開状況 | 公式ウェブサイトと API は利用可能。正式版の重みの公開は未確認 |
なお、2026-11-03 時点で、APIYI は LongCat-2.5 の紹介記事を公開していますが、当時はプラットフォーム上でまだ利用できず、今後対応予定と説明していました。実際に呼び出せるモデルは、APIYI(apiyi.com)の最新モデル一覧をご確認ください。この記事のコード例は汎用的な OpenAI 互換の形式を使用しており、対応済みのどのモデルにも応用できます。
100万Tokenのコンテキストでも長期Agentタスクには不十分な理由
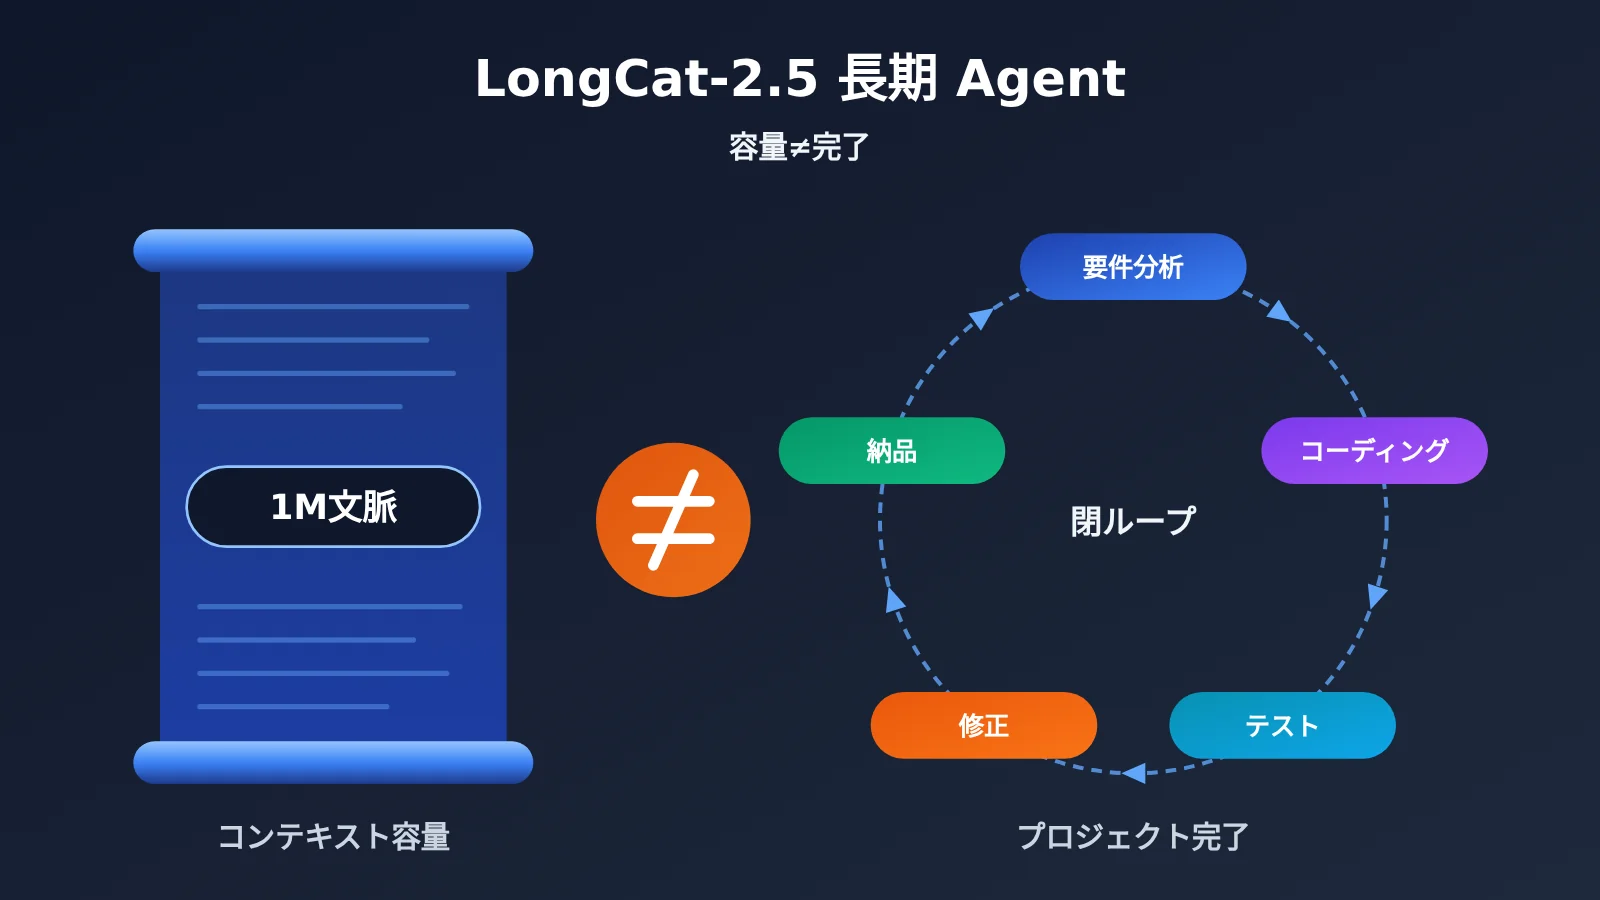
長いコンテキスト(Long Context)とは、1回のリクエストで扱えるTokenの総量が大きいことを指します。1Mのコンテキストウィンドウがあれば、モデルはより多くのソースコードやドキュメント、過去のメッセージを一度に読み込めるため、大規模なリポジトリの理解に役立ちます。ただし、この数値だけで「長文から常に正確に情報を検索できる」「ツール呼び出しが安定して成功する」「出力ファイルが必ず正しい」とは言えません。
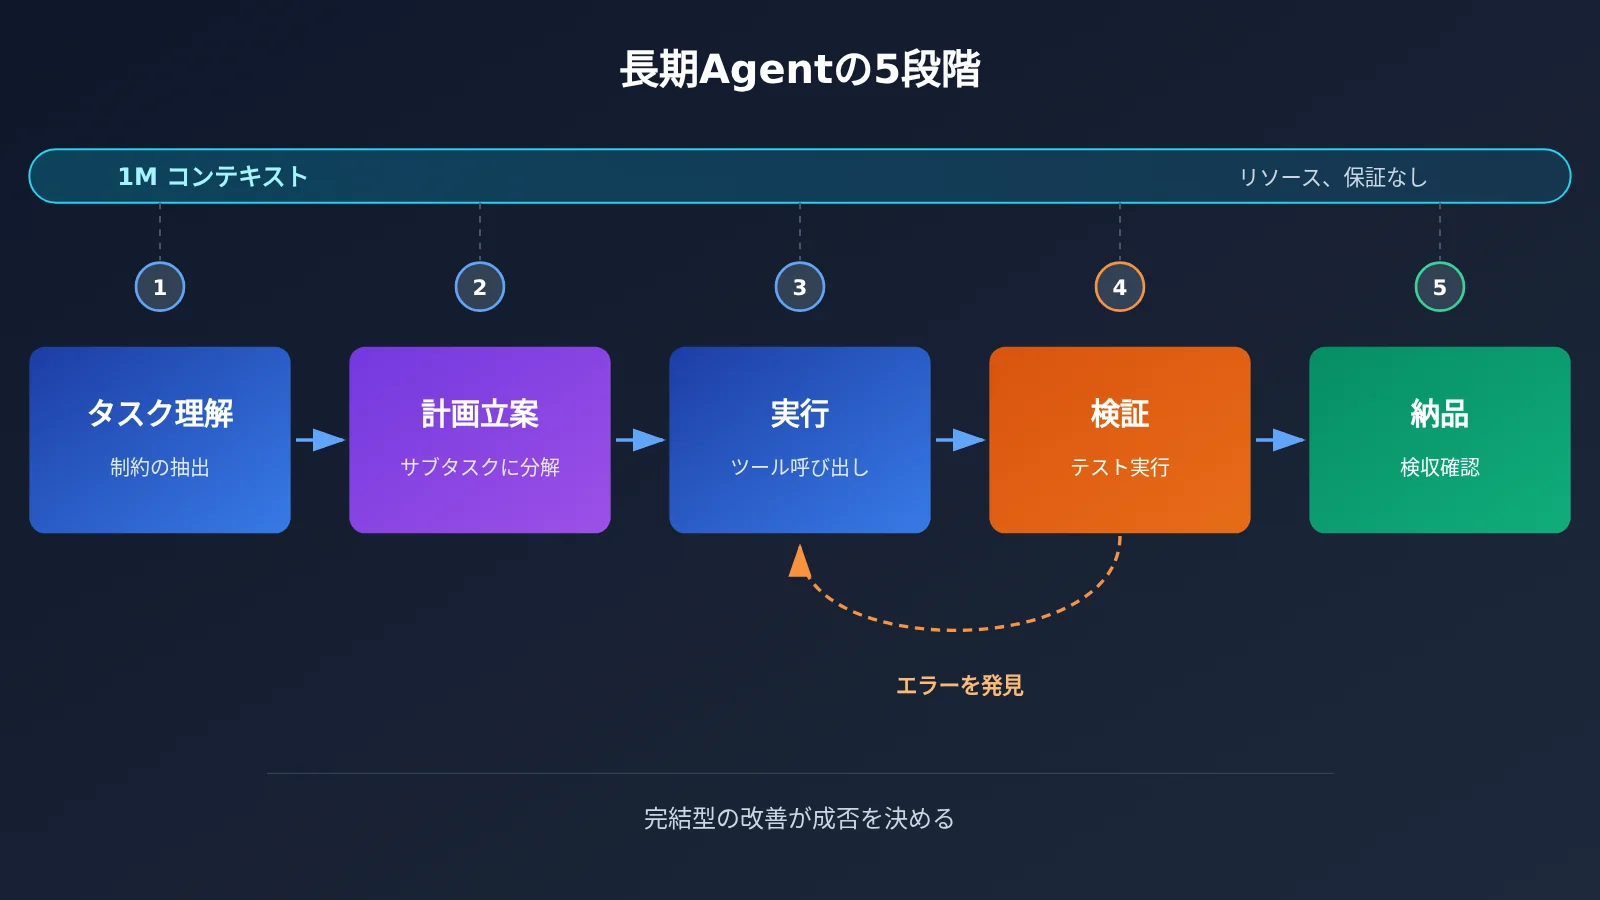
長期的に動作するAgent(Long-Horizon Agent)は、また別の能力を必要とします。外部環境で、相互に依存する複数のステップを継続的に実行しなければなりません。リポジトリの読み取り、コードの作成、ツールの呼び出し、テストの実行、エラーの発見と修正、再検証を経て、最後に成果物を納品します。どこか一つで間違えると、その後のステップが誤った状態を前提に進む可能性があります。
| 比較項目 | 長いコンテキストを扱う能力 | 長期Agentとしての能力 |
|---|---|---|
| 本質 | 1回のリクエストで扱える容量 | 複数ステップを継続して実行する信頼性 |
| 評価方法 | どれだけのTokenを収められるか | 最終的にタスクの受け入れ基準を満たすか |
| 主な依存要素 | 注意機構と長文の学習 | 計画、ツール呼び出し、エラーフィードバックの活用、終了判断 |
| 典型的な失敗 | 長文からの情報検索での見落とし | 途中での目標からの逸脱、呼び出しの繰り返し、成果物の納品漏れ |
| プロジェクトの成功との関係 | 必要なリソースの一つ | 成否をより直接的に左右する |
言い換えると、コンテキストは「作業台の広さ」、長期タスクを遂行する能力は「仕事を最後までやり遂げられるか」です。作業台がいくら広くても、モデルがテストの失敗に応じて方針を調整できなかったり、当初の制約条件を忘れたりすれば、プロジェクトは途中で失敗してしまいます。LongCat-2.5が長期タスクの学習に重点を置いているのも、このためです。
LongCat-2.5の長期タスク向けエージェントベンチマークのスコア変化
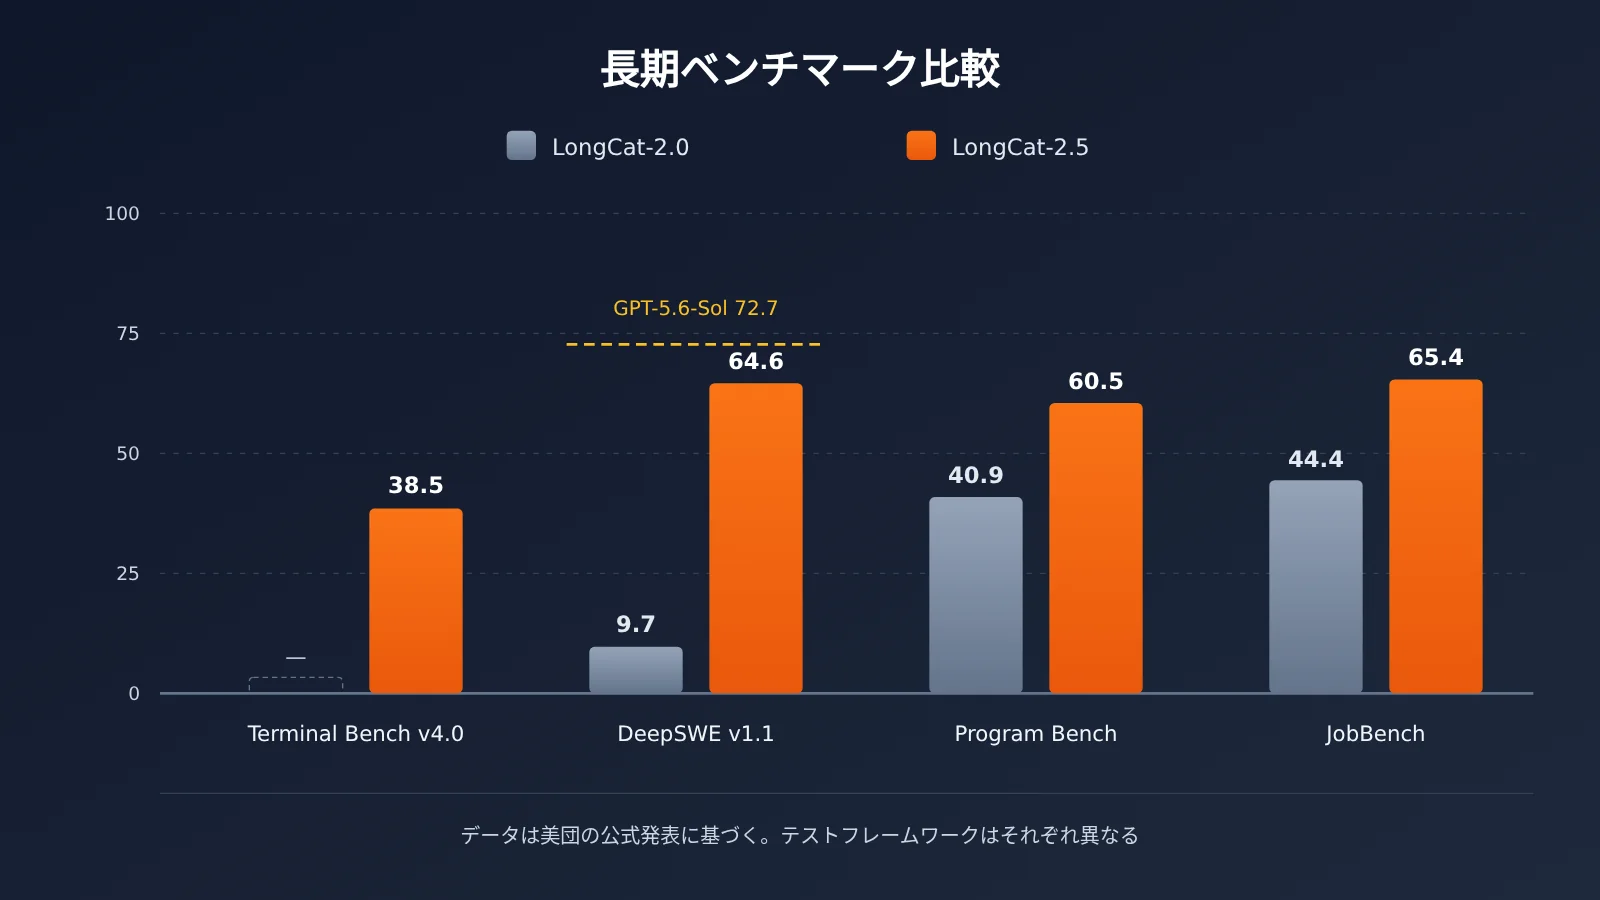
美団は、LongCat-2.5と前世代モデルを複数の長期タスク向けエージェントベンチマークで比較した結果を公開しました。下表の数値は公式発表に基づいています。向上幅はスコアの差であり、相対的な増加率ではありません。
| ベンチマーク | LongCat-2.0 | LongCat-2.5 | 向上幅 | 測定内容 |
|---|---|---|---|---|
| Terminal Bench v2.1 | 70.8 | 88.4 | +17.6 | ターミナル環境で実際の操作タスクを完了する能力 |
| Terminal Bench v4.0 | 3.0 | 38.5 | +35.5 | より難度の高いターミナルでの長期タスク |
| DeepSWE v1.1 | 9.7 | 64.6 | +54.9 | 長期的なソフトウェアエンジニアリングタスク |
| Program Bench Almost Resolved | 2.5 | 25.5 | +23.0 | プログラム構築の完成に近づく度合い |
| NL2Repo | 40.9 | 60.5 | +19.6 | 自然言語の要件からリポジトリを生成する能力 |
| MCP Atlas | 61.8 | 83.1 | +21.3 | 複数のツールの呼び出し |
| JobBench | 44.4 | 65.4 | +21.0 | 業務タスクにおける専門的な成果物 |
これらのデータからは大幅な進歩が見られますが、解釈にはいくつか注意が必要です。DeepSWEは9.7から64.6へと大きく伸びたものの、公式比較ではGPT-5.6-Solの72.7を下回っています。Terminal Bench v4.0の38.5はGPT-5.6-Solの37.3をわずかに上回る一方、Claude Opus 5の53.9より15.4ポイント低く、難しいターミナルタスクの解決にはまだ道のりがあることがわかります。
評価条件も重要です。Terminal BenchはClaude Code Harness、DeepSWEはmini-swe-agentを使用し、JobBenchはLLM-as-Judgeで採点しています。いずれのスコアも、それぞれの実行・評価フレームワークに依存します。公式表の競合モデルの成績には、公開レポートに基づくものと美団が独自に測定したものが混在しており、同一条件下で実施された独立したランキングとは見なせません。社内ベンチマークのLongCat AppDev(47.7 → 73.7)も、公開された形では再現できません。
📊 比較について:ベンチマークが示すのは特定のフレームワーク下での性能に限られるため、最終的には自分のタスクで検証する必要があります。APIYI apiyi.comを通じて、接続済みの複数モデルを同じタスクスクリプトで比較し、公式スコアとあわせてモデル選定の判断に役立てられます。
LongCat-2.5 はどのように Agent を訓練し、プロジェクト全体を完遂させるのか
美団(Meituan)の技術ブログで紹介された長期タスク向けの訓練手法は、6つの方向性にまとめられます。それぞれが長期タスクで実際に起こるどのような失敗に対応しているかを見ることが、理解の鍵です。
LongCat-2.5 の実タスク環境と F2P/P2P 検証
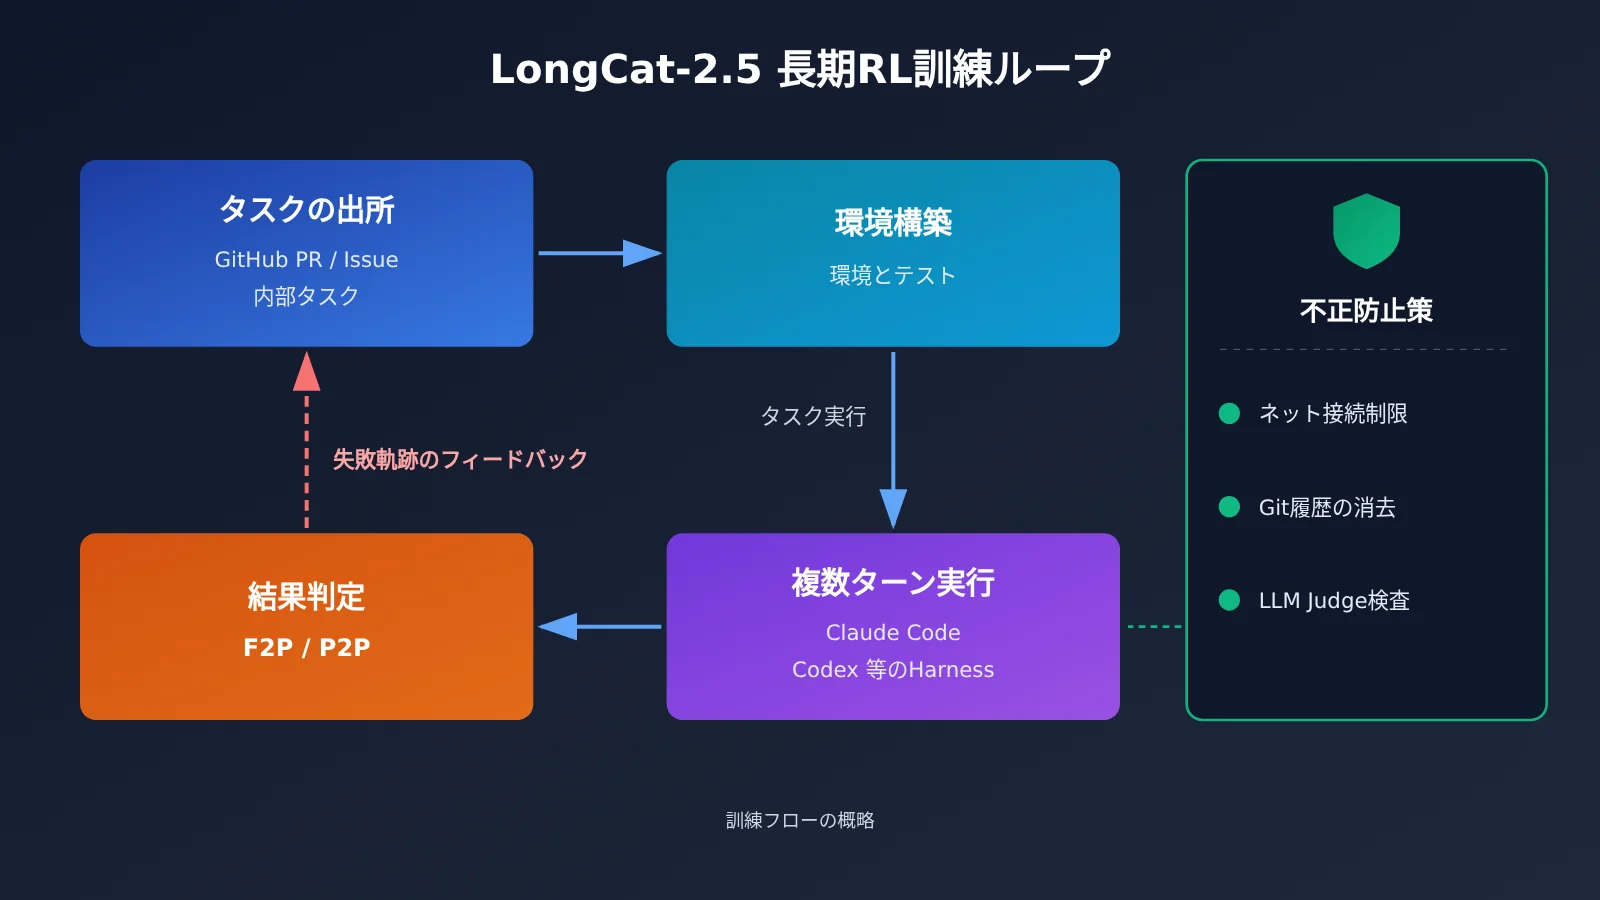
訓練データには、GitHub の公開リポジトリにある PR と関連 Issue、および美団社内の実際のコーディングタスクを使用します。タスクを選別し、Agent で自動アノテーションを行い、コードの実行環境を構築して、実行可能なテストを生成します。そのうえでモデルにタスクを実行させ、実際の実行結果から問題が解決されたかを判断します。大量のコードテキストを与えるだけの場合と比べ、「実際に動いたかどうか」というフィードバックを得られます。
検証には2種類のテストを使います。F2P(Fail-to-Pass)は、もともと失敗していたテストが修正後に通るかを確認し、P2P(Pass-to-Pass)は、もともと通っていたテストが引き続き通るかを確認します。前者は「問題が解決されていない」状態を、後者は「1つ直して2つ壊す」事態を防ぐためのものです。美団ではさらに、訓練時の実行軌跡とテストの通過率を使って、テスト自体の偽陽性・偽陰性も検証しています。ただし、その効果はテストケースが要件をどの程度網羅しているかに左右されます。
LongCat-2.5 の失敗軌跡学習と非同期 Partial Rollout
開発元は、実際の Agent の失敗軌跡を、再現・検証可能なタスクとして再構成し、能力の弱点を特定するとともに、訓練環境の拡充に役立てています。これは、成功例だけを学ぶのではなく、「間違えた問題」を集めて復習するようなものです。公開資料では、失敗軌跡の数やエラーの種類ごとの修正率は明らかにされていません。
長時間タスクの所要時間には大きなばらつきがあり、複雑な軌跡が1つあるだけで訓練バッチ全体が遅くなることがあります。非同期 Partial Rollout では、複数のタスクを並行してサンプリングし、バッチがそろった時点で未完了の軌跡を中断・保存して、次のラウンドで再開します。同時に、すべて成功またはすべて失敗した、有効な勾配を得られないサンプルグループを除外します。
この方法では、同じ軌跡のトークンが異なる訓練段階のモデルから生成される可能性があります。開発元は、logprob の差をクリッピングし、過去の累積差に応じて勾配への寄与を調整することで、偏りを抑えています。この技術が改善するのは訓練効率であり、ユーザー側のタスク実行速度が同じ割合で向上するとは限りません。
LongCat-2.5 の Reward Hacking 対策とクロス Harness 訓練
Reward Hacking とは、モデルが報酬設計の抜け穴を突いて高得点を得る一方、タスクを実際には達成していない状態を指します。例えば、答えを盗み見たり、テストを回避したりする行為です。美団(Meituan)は、訓練環境でのネットワーク接続の制限、Git 履歴やファイルキャッシュの削除、LLM Judge による軌跡のチェックに加え、思考やツール呼び出しの繰り返し、過度な思考にペナルティを課しています。これらはリスクを抑えるための対策であり、問題が完全に解決されたことを意味するものではありません。
Harness とは、モデルによるタスク実行を支える周辺システムで、ツール、コンテキスト管理、タスクループのルールなどが含まれます。LongCat-2.5 は、コールドスタート段階で少量のフレームワーク適応サンプルを加え、RL 段階では Claude Code や Codex などの異なるフレームワークとタスクの種類を混ぜて訓練しています。これにより、単一のプロンプトテンプレートにしか適応できないリスクを低減していますが、異なるバージョンのツールで動作が完全に一致することは保証できません。
| 訓練方法 | 解決する現実的な課題 | 分かっている限界 |
|---|---|---|
| 実タスク環境 | コードは書けても環境内で実行を完了できない | 環境構築の品質に依存する |
| F2P / P2P 検証 | 表面的には完了しても、デグレードを引き起こす | テストのカバレッジに制約される |
| 失敗軌跡学習 | 同じ種類のエラーが繰り返し発生する | 件数と修正率は非公開 |
| 非同期 Partial Rollout | 長時間タスクの訓練効率が低い | 推論の高速化を意味しない |
| Reward Hacking 対策 | 抜け道を利用した見かけ上の成功 | 完全な解決は宣言されていない |
| クロス Harness 混合訓練 | Agent フレームワークを変えると機能しなくなる | バージョン間の一貫性は保証されない |
第三者テスト:LongCat-2.5 の長時間タスクが一部未完了に終わった理由
公式の学習設計やベンチマークとは別に、第三者による実測からも異なる視点が得られます。TOKRACE は 2026-11-02、正式版 LongCat-2.5 を Claude Code に接続し、Blender やブラウザなどのツールと組み合わせて15件の制作タスクを実施しました。
成功例は、パラメトリックな本棚の制作です。幅0.8メートル・3区画と幅1メートル・4区画の2バージョンで、寸法と18mmの板厚はいずれも要件を満たし、6枚の視点画像も納品されました。所要時間は約36分、リクエスト数は47回でした。一方、ほかのタスクでは、長時間にわたる作業で典型的な失敗パターンが見られました。
- 構造や単位の誤り:遊星減速機は140mmという指定だったにもかかわらず、生成されたプロジェクトでは140mが使われ、動画も納品されませんでした。
- 一部のみの納品:中国式寺院の中庭を制作する60分のタスクでは、最終画像3枚のみが納品され、一部のカットと動画が不足していました。
- 空間関係の問題:2ベッドルームのモデルでは、ドアや窓の開口部がない、ベッドと間仕切り壁が重なるといった問題が発生しました。
- 長時間の実行中断:数学の解説動画を制作するタスクは、リクエストのタイムアウトが続き、未完了に終わりました。
これらの事例が示すのは、長時間タスクでは「何かが出力されたか」だけでなく、すべての要件を一つずつ確認する必要があるということです。また、このテストにはリクエスト数、時間、実行予算の制限が設けられていたため、未納品の原因をすべてモデルの能力不足に帰することはできません。厳密なモデル比較実験でもない点に注意が必要です。
LongCat-2.5の長期タスク向けトレーニング手法の影響分析
Agent開発者への影響
- 選定基準の変化:モデルの評価では、コンテキスト長の重要度が下がり、長期タスクのベンチマークや実際のタスクを最後まで完了できる割合に、より注目する必要があります。
- 検証は省略できない:モデルがF2P/P2Pトレーニングを受けていても、本番環境では独自のテストと受け入れ検証が必要です。第三者による実測でも、この点が示されています。
- Harnessの設計も重要:スコアは実行フレームワークと密接に関係します。同じモデルでも、タスクループを変えると結果が大きく異なる場合があります。
大規模言語モデル業界への影響
- トレーニングの重点が「プロセス」へ:単一ターンのコード生成から、プロジェクト全体や複数ステップのエンジニアリングタスクへと対象が広がり、強化学習環境を構築する能力が新たな競争ポイントになります。
- 評価方法への関心が高まる:Terminal-Bench 2.1では、2.0の89タスクのうち28タスクが修正されました。これは、テストのバージョン自体が結果に大きく影響することを示しており、業界には評価条件のより透明な説明が求められます。
LongCat-2.5 の考え方を参考に長期タスク向け Agent を設計する
LongCat-2.5 の学習方法は、アプリケーション開発者にわかりやすいヒントを与えてくれます。モデル側で「段階的な検証、失敗からの復旧、抜け道の防止」を学習しているなら、エンジニアリング側でもこれらの仕組みを Agent システムに明示的に組み込むべきです。以下は、公開されている学習方法から導いたエンジニアリング上の提案であり、公式に実装済みとされている機能ではありません。
| エンジニアリングの仕組み | 対応する学習の考え方 | 実装方法 |
|---|---|---|
| 段階的な検証 | F2P 検証 | 各サブタスクの終了時にチェックスクリプトを実行する |
| 回帰の防止 | P2P 検証 | 変更のたびに全体の回帰テストを実行する |
| 失敗の記録 | 失敗軌跡からの学習 | エラー情報を進捗ファイルに書き込み、次の試行に引き継ぐ |
| 予算の上限 | 繰り返し呼び出しへのペナルティ | 最大試行回数、タイムアウト、ツールの呼び出し回数を制限する |
| 成果物の検収 | Reward Hacking の防止 | モデルの要約だけでなく、実際のファイルを確認する |
以下は、進捗の記録、失敗情報のフィードバック、予算の上限を示す、最小限の段階検証 Agent ループの例です。
import json, subprocess, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の OpenAI 互換インターフェース
)
MODEL = "gpt-4o-mini"  # プラットフォームのモデル一覧で実際に利用可能なモデル ID を指定
MAX_ROUNDS = 8         # 予算の上限。無限ループを防止

def run_check(cmd: str) -> tuple[bool, str]:
    r = subprocess.run(cmd, shell=True, capture_output=True, text=True, timeout=300)
    return r.returncode == 0, (r.stdout + r.stderr)[-2000:]

def run_stage(stage: dict, progress: dict) -> bool:
    failures = []
    for i in range(MAX_ROUNDS):
        prompt = (f"阶段目标:{stage['goal']}\n"
                  f"已完成阶段:{progress['done']}\n"
                  f"历史失败(请避免重复):{failures[-3:]}")
        resp = client.chat.completions.create(
            model=MODEL, messages=[{"role": "user", "content": prompt}])
        # ここでは省略:モデルの出力を解析してコードファイルに書き込む
        ok, log = run_check(stage["check"])          # 段階検証(F2P 相当)
        reg_ok, reg_log = run_check("pytest -q")     # 回帰テスト(P2P 相当)
        if ok and reg_ok:
            progress["done"].append(stage["name"])
            return True
        failures.append(log if not ok else reg_log)
    progress["blocked"] = stage["name"]
    return False

progress = {"done": [], "blocked": None}
stages = [{"name": "api", "goal": "实现用户接口", "check": "pytest tests/test_api.py -q"}]
for s in stages:
    if not run_stage(s, progress):
        break
json.dump(progress, open("progress.json", "w"), ensure_ascii=False)
この構造のポイントは、各段階に実行可能な検収コマンドを設け、失敗ログを次のプロンプトにフィードバックし、進捗をコンテキスト内だけでなくファイルにも書き込むことです。コンテキストが十分に長い場合でも、進捗や制約を構造化された状態として外部に保存すれば、長期タスクの途中で目標から逸脱するリスクを大きく減らせます。
🚀 手軽に始めるには:Agent のプロトタイプを構築する際は、まず APIYI apiyi.com でテスト用の利用枠を取得し、同じ APIキーで異なるモデルを切り替えながら上記の段階検証ループを実行してみましょう。自分のタスクでどのモデルが最も完成度の高い成果を出せるか確認できます。
プロジェクトに高い信頼性が求められる場合は、「相互検収」を導入することもできます。別のモデルに、最終成果物が要件リストを満たしているか一項目ずつ確認させる方法です。APIYI apiyi.com の統一インターフェースを使えば、実行用モデルと検収用モデルを同じコードから呼び出せるため、切り替えの手間もほとんどかかりません。
よくある質問 FAQ
Q1:LongCat-2.5 の 1M コンテキストがあれば、大規模なプロジェクトも完成できますか?
必ずしもそうとは限りません。1M コンテキストは、入力と出力を合わせた1回のリクエストの容量を指し、より多くのコードやドキュメントをモデルに読み込ませることができます。プロジェクトの完成には、計画立案、ツール呼び出し、エラー修正、成果物の確認も必要です。これらは、LongCat-2.5 が長期タスク向けの強化学習で重点的に訓練した部分です。
Q2:LongCat-2.5 と GPT-5.6-Sol、Claude Opus 5 の長期タスクにおける差はどのくらいですか?
公式の表によると、LongCat-2.5 は BrowseComp(91.9)と Terminal Bench v4.0(38.5)で GPT-5.6-Sol をわずかに上回っています。一方、DeepSWE では 64.6 と GPT-5.6-Sol の 72.7 を下回り、Terminal Bench v4.0 でも Claude Opus 5 より 15.4 ポイント低い結果です。各テストの評価方法は異なるため、総合的な順位として捉えるべきではありません。
Q3:LongCat-2.5 の正式版はいつ公開されましたか?モデルの重みはオープンソース化されていますか?
Preview 版は 2026-09-25 に API プラットフォームで提供が始まり、正式版は 2026-11-02 にリリースされました。公式ウェブサイトと API は利用可能ですが、2026-11-03 時点では正式版のモデルの重みが公開されたことは確認されていません。公式は、GitHub と Hugging Face で後日公開するとしています。
Q4:現在、APIYI を通じて LongCat-2.5 を呼び出せますか?
2026-11-02 の公開情報によると、その時点では LongCat-2.5 はまだ APIYI で提供されておらず、今後対応する予定でした。提供状況の詳細は、APIYI apiyi.com のモデル一覧をご確認ください。それまでは、プラットフォームで利用可能なモデルを使って、段階ごとの検証や失敗結果のフィードバックなどを行う Agent フレームワークを構築できます。モデルの提供開始後は、モデル ID を置き換えるだけで利用できます。
Q5:モデルの長期タスクにおける Agent 能力を低コストで検証するには?
自社の業務に近く、自動検収スクリプトを備えた複数ステップのタスクを 3-5 個用意し、各モデルの成果物の完全な納品率、平均ターン数、失敗の種類を記録することをおすすめします。APIYI apiyi.com の OpenAI 互換インターフェースを使えば、1つの APIキーで同じスクリプト内で複数のモデルを比較できます。新規ユーザーには、初期検証に使える無料テスト枠も用意されています。
Q6:LongCat-2.5 の長期タスク能力には、どのような既知の課題がありますか?
第三者による実測では、寸法の単位や空間関係の誤り、動画の未納品、リクエストのタイムアウトによる中断などが報告されています。公式も Reward Hacking が完全に解決されたとは表明しておらず、失敗した実行履歴の規模や修正率も公開されていません。設計寸法、知識の正確性、成果物の完全性については、引き続き人による確認が必要です。
LongCat-2.5 長期タスク向けAgentの要点 Key Takeaways
- コンテキストの長さ≠タスクの完了度:100万Tokenは処理容量を示すもので、プロジェクトの成功率ではありません。長期タスクを遂行する能力には、別途トレーニングが必要です。
- 実環境でのトレーニング:GitHubのPRやIssue、社内タスクから実行可能な環境を構築し、フィードバックを得ます。
- 2種類のテストで検証:F2Pで問題が解決されたかを、P2Pでリグレッションが発生していないかを確認します。
- 失敗から学ぶ:実際のAgentの失敗軌跡を、検証可能なトレーニングタスクに再構成します。
- 成績は条件を確認:ベンチマークの結果はHarnessに大きく左右されます。第三者による実測では、成果物の納品漏れも見られました。
- システム設計も並行して進める:各段階での検証、失敗の記録、予算の上限設定、成果物の受け入れ検査は、いずれも欠かせません。APIYI apiyi.comを活用して、複数のモデルを比較検証することもできます。
まとめ
LongCat-2.5のリリースが示す最大の変化は、100万Tokenのコンテキストウィンドウを持つモデルがまた一つ増えたことではありません。トレーニングの重点が「どれだけ長い内容を読めるか」から「プロジェクト全体を最後までやり遂げられるか」へと移っていることです。
- 問題の定義がより正確に:長期タスクを担うAgentの失敗は、コンテキストの不足よりも、実行・検証・納品の段階で多く発生します。
- 課題に対応したトレーニング手法:実タスク環境、F2P/P2P、失敗軌跡、Partial Rollout、抜け道対策、複数のHarnessへの対応は、それぞれ現実の失敗に対応しています。
- 結果の適用範囲を明確に:公式の成績は大きく向上したものの、トップクラスのモデルとはなお差があります。第三者による実測でも、成果物を漏れなく納品するには、引き続き人間の確認が必要であることが示されています。
開発者にとっては、同じ考え方を自分たちのAgentシステムに取り入れ、パラメータやランキングだけでなく、実行可能な受け入れ基準でモデルを評価するのが現実的です。APIYI apiyi.comの統一インターフェースを使って実際のタスクで比較検証し、そのうえで本番環境に導入するモデルの組み合わせを決めることをおすすめします。
📚 参考資料
- 美団技術チーム – LongCat-2.5 技術記事:長期タスクを遂行する Agent の訓練方法の詳細
- リンク:
tech.meituan.com/2026/11/02/Meituan-LongCat-2.5.html -
概要:F2P/P2P、Partial Rollout、Reward Hacking 対策などの訓練設計に関する一次資料
-
LongCat 公式ブログ:ベンチマークデータと評価方法
- リンク:
longcat.ai/blog/longcat-2.5 -
概要:評価結果の全表と、各ベンチマークの Harness およびパラメータ設定
-
LongCat モデルパラメータドキュメント:コンテキストと出力パラメータの説明
- リンク:
longcat.ai/platform/docs/zh/api/model-params -
概要:コンテキスト長、max_tokens、思考予算などの呼び出しパラメータ
-
Terminal-Bench:ターミナル Agent のベンチマーク
- リンク:
tbench.ai -
概要:スコアと Agent Harness の関係、およびバージョンによる違いを理解するための資料
-
DeepSWE:長期タスクを対象としたソフトウェアエンジニアリング Agent のベンチマーク
- リンク:
deepswe.datacurve.ai -
概要:113 件のオリジナルタスクと 91 個のオープンソースリポジトリを用いたテスト設計
-
TOKRACE – LongCat-2.5 実測記録:15 件の創作タスクに関する第三者テスト
- リンク:
tokrace.com/zh-CN/guides/longcat-2-5-release - 概要:長時間タスクの部分的な完了や単位の間違いなど、実際の事例
著者:APIYI 技術チーム
技術交流:長期タスクを扱う Agent の開発・運用や、複数モデルの選定経験についての情報交換は、APIYI のホームページ apiyi.com からお気軽にお問い合わせください