作者注:解讀 LongCat-2.5 爲什麼不只依賴 1M 上下文,而是從 6 個訓練方向強化長程 Agent 完成整個項目的能力,並梳理開發者可以借鑑的工程方法。
做過 AI Agent 的開發者大多遇到過這些情況:任務跑到一半報錯,Agent 反覆嘗試同一個錯誤命令,最後給出一份看起來很完整的總結,實際卻漏掉了幾個關鍵交付物。美團在 2026-11-02 正式發佈的 LongCat-2.5 把重點放在了 長程 Agent 完成整個項目 上,而不只是繼續強調 1M 上下文窗口。
這不是一篇參數宣傳稿。美團技術博客已經披露了長程強化學習的具體訓練設計,第三方也在正式版發佈當天做了長任務實測。本文會區分三類信息:官方訓練設計、官方 Benchmark 成績、第三方實際體驗,並說明它們各自能證明什麼、不能證明什麼。
核心價值:讀完本文,你將理解爲什麼百萬 Token 上下文不等於項目成功率,LongCat-2.5 用哪些方法補齊長程任務能力,以及如何把這些思路用到自己的 Agent 工程中。
LongCat-2.5 核心信息速覽
LongCat-2.5 是美團 LongCat 團隊發佈的原生多模態大模型,定位是面向長程智能體任務(Long-Horizon Agentic Tasks)。它在 LongCat-2.0 基礎上加入了更多長程任務軌跡,重點強化複雜代碼庫開發和完整項目構建能力。
| 信息項 | 詳情 |
|---|---|
| 發佈時間 | 2026-09-25 上線 Preview,2026-11-02 正式版發佈 |
| 發佈方 | 美團 LongCat 團隊 |
| 模型規模 | 總參數 1.6T,MoE 稀疏激活,每 Token 約激活 48B |
| 上下文窗口 | 1,048,576 Tokens(約 1M),包含輸入與輸出 |
| 核心方向 | 長程 Agent、Agentic Coding、視覺編程、多步驟工具調用 |
| 開放狀態 | 官方網頁與 API 已開放,正式版權重尚未確認公開 |
需要特別說明的是,截至 2026-11-03,API易 已發佈過 LongCat-2.5 的相關介紹文章,但當時說明該模型尚未在平臺上線、計劃後續接入。實際可調用的模型請以 API易 apiyi.com 的實時模型列表爲準,本文的代碼示例使用通用的 OpenAI 兼容寫法,可以套用到任何已接入的模型上。
爲什麼百萬 Token 上下文還不夠完成長程 Agent 任務
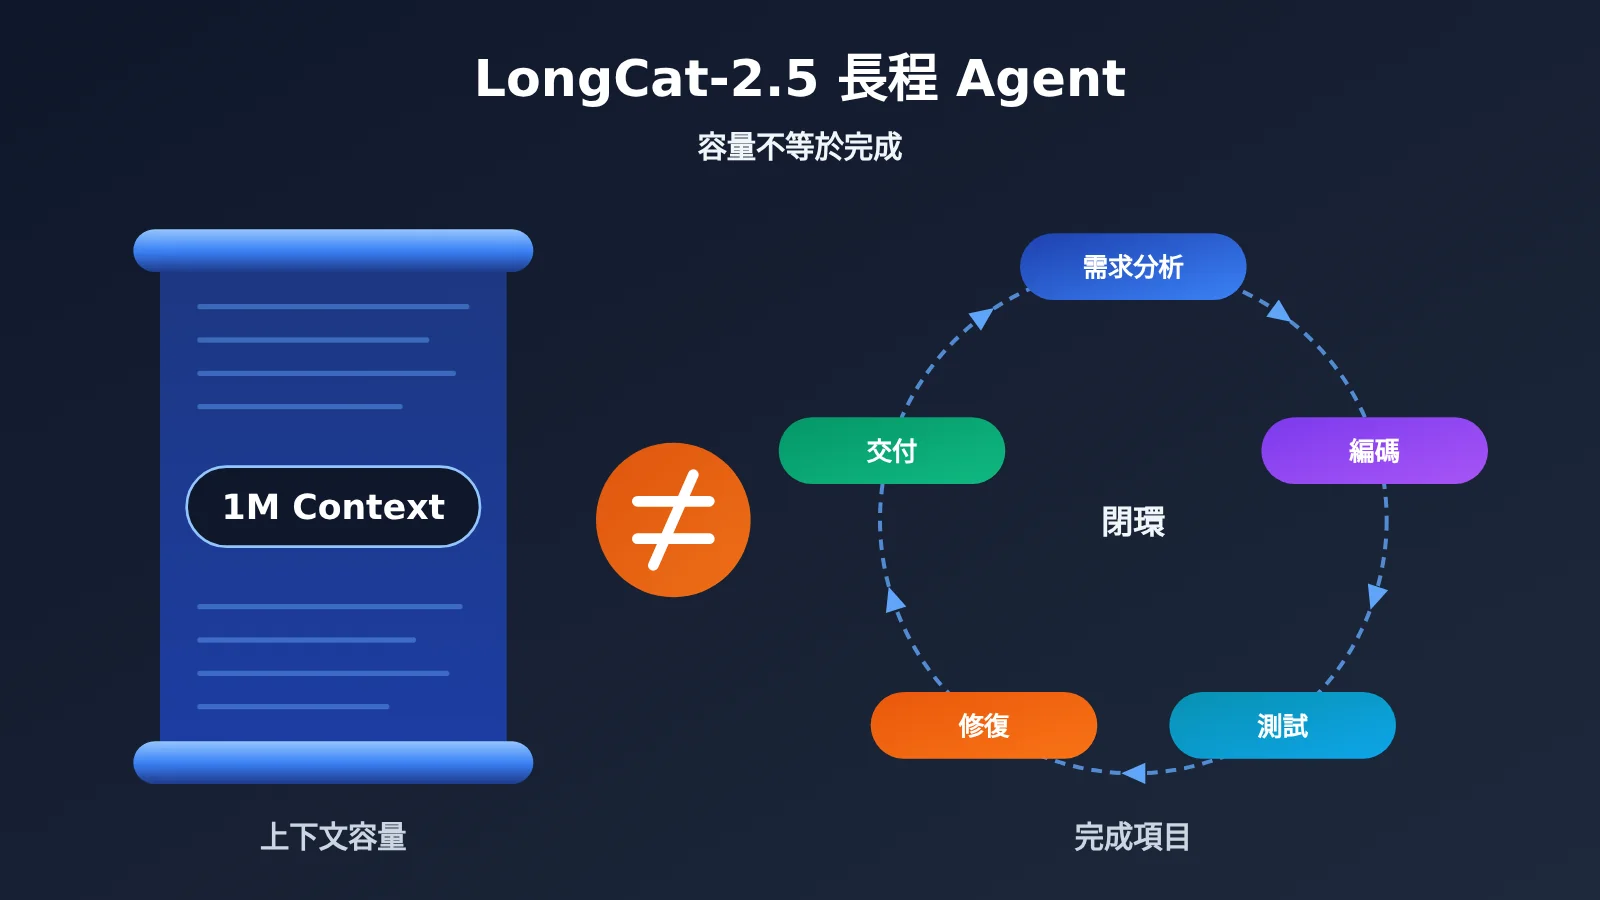
長上下文(Long Context)指單次請求能容納的 Token 總量。1M 窗口意味着模型可以一次讀進更多源代碼、文檔和歷史消息,這對大型倉庫的理解確實有幫助。但僅憑這個參數,推不出“長文檔檢索始終準確”“工具調用持續成功”“輸出文件一定正確”這些結論。
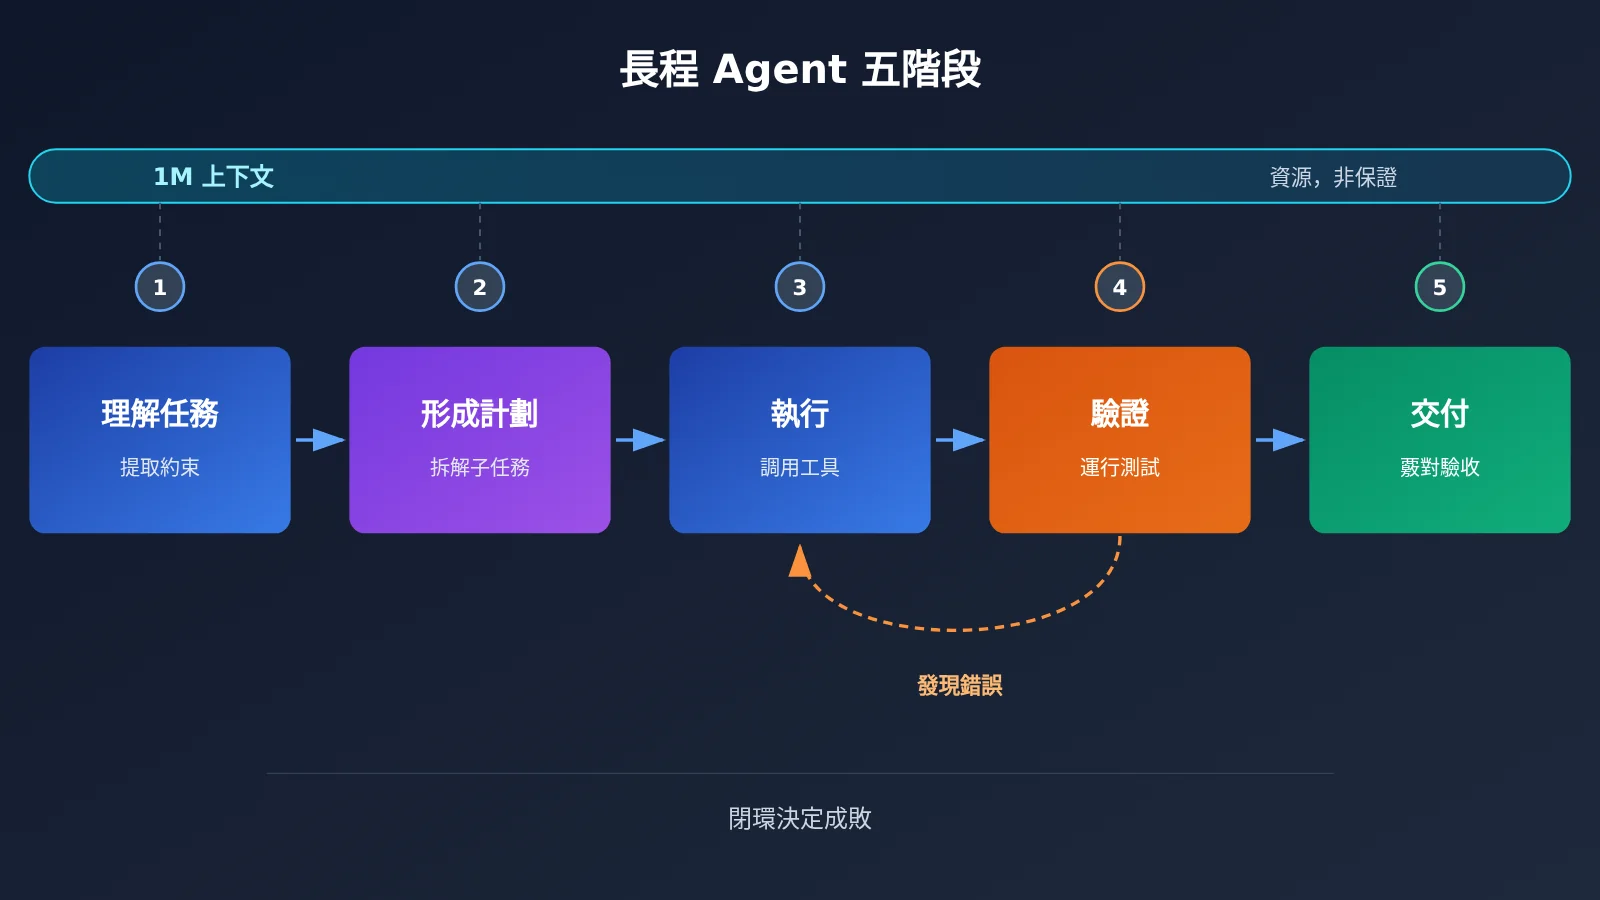
長程智能體(Long-Horizon Agent)是另一回事。它要求模型在外部環境中持續執行多個相互依賴的步驟:讀取倉庫、編寫代碼、調用工具、運行測試、發現錯誤、修復、再驗證,最後交付。任何一環出錯,後續步驟都可能建立在錯誤狀態之上。
| 對比維度 | 長上下文能力 | 長程 Agent 能力 |
|---|---|---|
| 本質 | 單次請求的容量 | 多步驟持續執行的可靠性 |
| 衡量方式 | 能放進多少 Token | 任務最終是否通過驗收 |
| 關鍵依賴 | 注意力機制與長文本訓練 | 規劃、工具調用、錯誤反饋利用、終止判斷 |
| 典型失敗 | 長文中檢索遺漏 | 中途偏離目標、重複調用、漏交付 |
| 與項目成功的關係 | 必要資源之一 | 更直接決定成敗 |
換句話說,上下文是“工作臺有多大”,長程能力是“能不能把活幹完”。工作臺再大,如果模型不會根據測試失敗調整方案,或者忘記了最初的約束條件,項目依然會在半路失敗。這也是 LongCat-2.5 把訓練重點放在長程任務上的根本原因。
LongCat-2.5 長程 Agent 基準成績變化
美團公佈了 LongCat-2.5 與上一代在多個長程 Agent 基準上的對比。下表數值來自官方發佈,提升欄是分數差值,不是相對百分比。
| Benchmark | LongCat-2.0 | LongCat-2.5 | 提升 | 測什麼 |
|---|---|---|---|---|
| Terminal Bench v2.1 | 70.8 | 88.4 | +17.6 | 終端環境中完成真實操作任務 |
| Terminal Bench v4.0 | 3.0 | 38.5 | +35.5 | 更難的終端長任務 |
| DeepSWE v1.1 | 9.7 | 64.6 | +54.9 | 長程軟件工程任務 |
| Program Bench Almost Resolved | 2.5 | 25.5 | +23.0 | 程序構建接近完成度 |
| NL2Repo | 40.9 | 60.5 | +19.6 | 從自然語言需求生成倉庫 |
| MCP Atlas | 61.8 | 83.1 | +21.3 | 多工具調用 |
| JobBench | 44.4 | 65.4 | +21.0 | 職業任務專業交付物 |
這組數據的進步幅度很明顯,但解讀時要保留幾條邊界。DeepSWE 從 9.7 躍升到 64.6,在官方比較中仍低於 GPT-5.6-Sol 的 72.7;Terminal Bench v4.0 的 38.5 略高於 GPT-5.6-Sol 的 37.3,卻比 Claude Opus 5 的 53.9 低 15.4 分,說明困難終端任務遠未被解決。
評測條件同樣重要。Terminal Bench 使用 Claude Code Harness,DeepSWE 使用 mini-swe-agent,JobBench 使用 LLM-as-Judge 評分,分數都和具體執行框架綁定。官方表格中部分競品成績來自公開報告,部分由美團自測,不能當作統一條件下的獨立排行榜。內部基準 LongCat AppDev(47.7 → 73.7)也不具備公開可復現性。
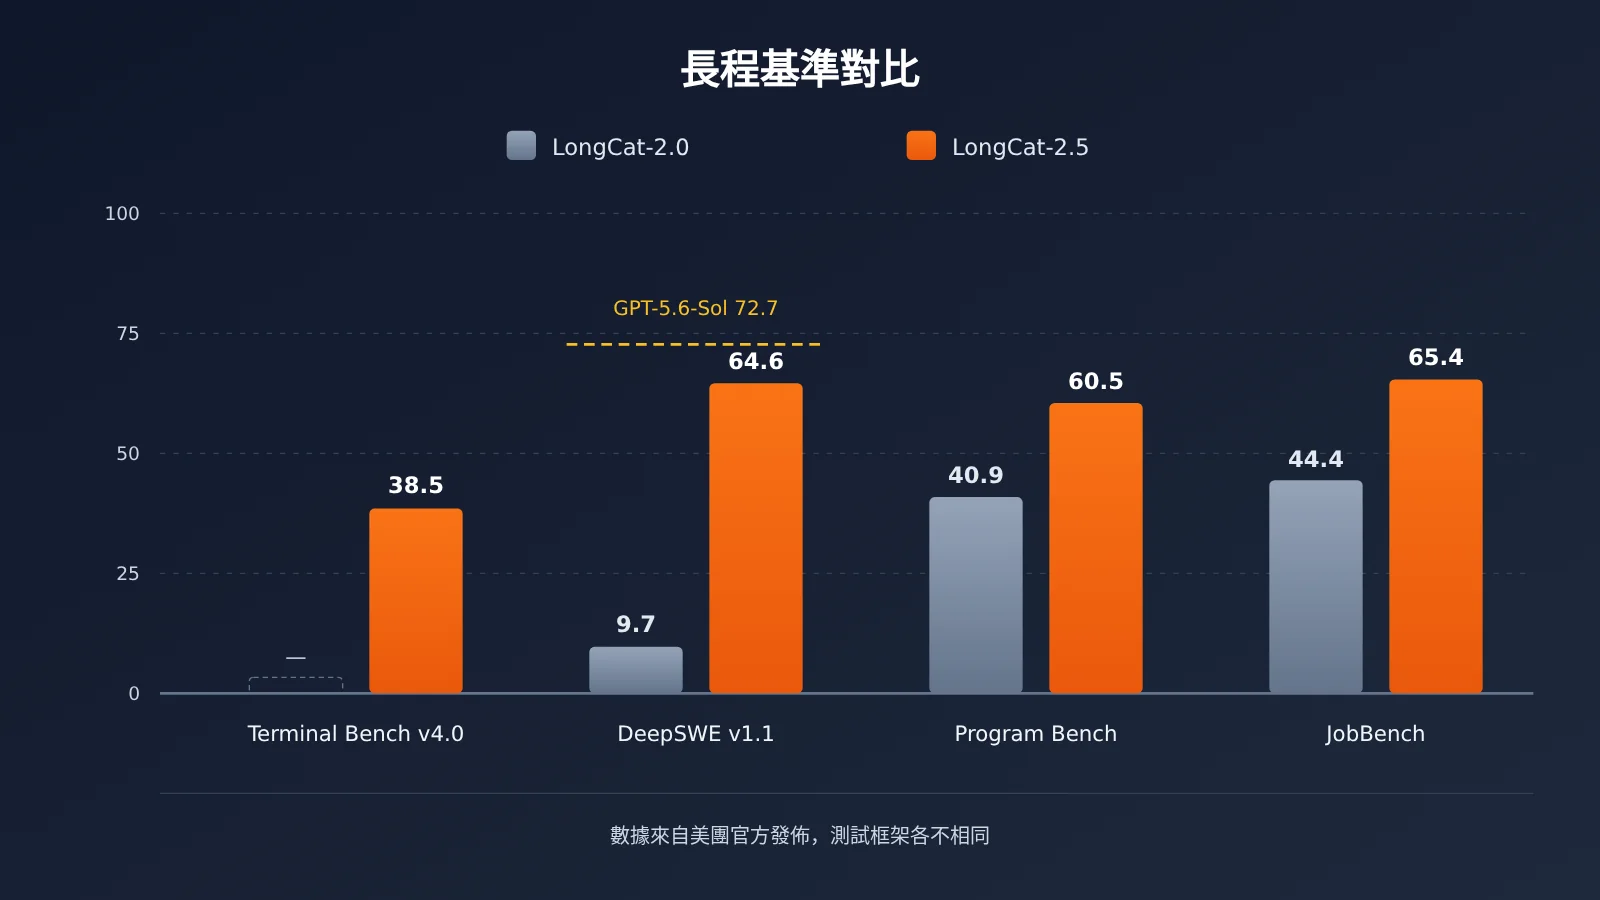
📊 對比說明:Benchmark 只能反映特定框架下的表現,最終仍要在自己的任務上驗證。可以通過 API易 apiyi.com 用同一套任務腳本對比多個已接入模型,再結合官方成績做選型判斷。
LongCat-2.5 如何訓練 Agent 完成整個項目
美團技術博客披露的長程訓練方法可以歸納爲 6 個方向。理解它們的關鍵,是看每一項分別對應長任務中的哪種真實失敗。
LongCat-2.5 真實任務環境與 F2P/P2P 驗證
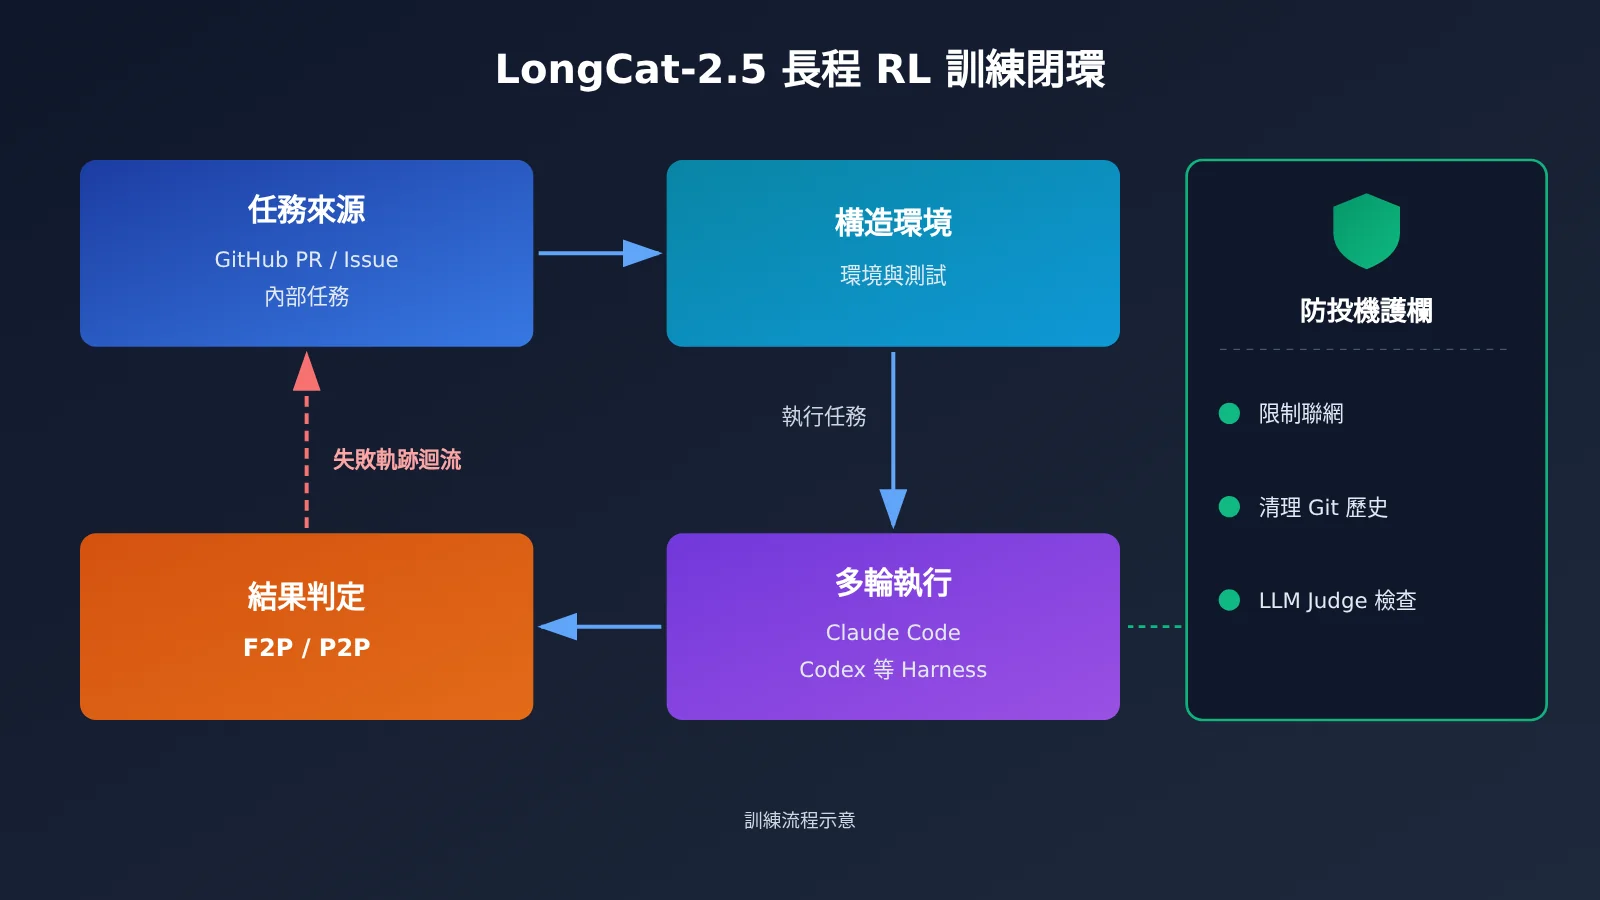
訓練數據來自 GitHub 公開倉庫的 PR 與關聯 Issue,以及美團內部真實代碼任務。流程是篩選任務、用 Agent 自動標註、構造代碼環境、合成可運行測試,再讓模型執行,根據實際執行結果判斷是否解決問題。和單純喂大量代碼文本相比,這種方式能拿到“到底跑沒跑通”的反饋。
驗證上採用兩類測試:F2P(Fail-to-Pass)檢查原本失敗的測試是否修復後通過,P2P(Pass-to-Pass)檢查原本通過的測試是否依然通過。前者防止“沒解決問題”,後者防止“修一個壞兩個”。美團還會用訓練軌跡和通過率反查測試本身的假陽性、假陰性。不過效果仍取決於測試用例覆蓋需求的完整程度。
LongCat-2.5 失敗軌跡學習與異步 Partial Rollout
官方把真實 Agent 的失敗軌跡重新構造成可復現、可驗證的任務,用來定位能力短板並補充訓練環境。這相當於把“做錯的題”收集成錯題本,而不是隻學成功案例。公開資料沒有給出失敗軌跡的數量和各類錯誤的修正率。
長任務耗時差異極大,一條複雜軌跡可能拖慢整個訓練批次。異步 Partial Rollout 的做法是:多任務並行採樣,湊齊批次後中斷並保存未完成的軌跡,下一輪繼續;同時過濾全部成功或全部失敗、無法提供有效梯度的樣本組。由此帶來的問題是同一條軌跡的 Token 可能來自不同階段的模型,官方通過裁剪 logprob 差異、按歷史累計差異調整梯度貢獻來控制偏差。這項技術改善的是訓練效率,不能推出用戶側任務執行速度同比例提升。
LongCat-2.5 防 Reward Hacking 與跨 Harness 訓練
Reward Hacking 指模型鑽獎勵設計的空子拿高分,卻沒有真正完成任務,比如偷看答案或繞過測試。美團的措施包括訓練環境限制聯網、清理 Git 歷史與文件緩存、用 LLM Judge 檢查軌跡,並對重複思考、重複調用工具、過度思考施加懲罰。這些是風險控制手段,並不代表問題已被徹底解決。
Harness 是組織模型執行任務的外圍系統,包括工具、上下文管理和任務循環規則。LongCat-2.5 在冷啓動階段加入少量框架適配樣本,在 RL 階段混合 Claude Code、Codex 等不同框架和任務類型,降低只適應單一提示模板的風險,但無法保證不同版本工具中行爲完全一致。
| 訓練方法 | 解決的現實問題 | 已知邊界 |
|---|---|---|
| 真實任務環境 | 只會寫代碼、不會跑通環境 | 依賴環境構造質量 |
| F2P / P2P 驗證 | 表面完成、引入迴歸錯誤 | 受測試覆蓋率限制 |
| 失敗軌跡學習 | 同類錯誤反覆出現 | 未公佈數量與修正率 |
| 異步 Partial Rollout | 長任務訓練效率低 | 不等於推理提速 |
| 防 Reward Hacking | 投機取巧的虛假成功 | 未宣稱徹底解決 |
| 跨 Harness 混合訓練 | 換個 Agent 框架就失效 | 不保證跨版本一致 |
第三方實測:LongCat-2.5 長任務爲何會部分完成
官方訓練設計和 Benchmark 之外,第三方實測提供了另一個視角。TOKRACE 在 2026-11-02 將正式版 LongCat-2.5 接入 Claude Code,配合 Blender、瀏覽器等工具完成 15 項創作任務。
成功的案例是參數化書架:0.8 米三格與 1 米四格兩個版本的尺寸、18mm 板厚都符合要求,並交付了六張視角圖,過程約 36 分鐘、47 次請求。但另一些任務暴露了典型的長程失效模式:
- 結構與單位錯誤:行星減速器要求 140mm,生成工程卻用了 140m,且未交付視頻。
- 部分交付:中式寺廟庭院在 60 分鐘任務中只交付了三張最終圖,缺少部分鏡頭和視頻。
- 空間關係問題:兩居室模型出現門窗未開洞、牀與隔牆重疊等問題。
- 長期執行中斷:一項數學知識視頻在連續請求超時後未完成。
這些案例說明,長任務不能只看“有沒有產出”,必須逐項覈對全部要求。同時要注意,測試中設置了請求、時間或執行預算限制,不能把所有未交付都歸因於模型能力不足;這也不是嚴格的模型對照實驗。
LongCat-2.5 長程訓練思路的影響分析
對 Agent 開發者的影響
- 選型標準變化:評估模型時,上下文長度的權重在下降,長程基準和真實任務的完整交付率更值得關注。
- 驗證不可省略:即便模型經過 F2P/P2P 訓練,生產環境中仍要自建測試與驗收,第三方實測已經證明這一點。
- Harness 設計同樣關鍵:分數與執行框架強相關,同一模型換一套任務循環,結果可能差別很大。
對大模型行業的影響
- 訓練重心轉向“過程”:從單輪代碼生成擴展到完整項目和多步驟工程任務,強化學習環境的構造能力成爲新的競爭點。
- 評測方法更受關注:Terminal-Bench 2.1 相比 2.0 修復過 89 項任務中的 28 項,說明測試版本本身會顯著影響結果,行業需要更透明的評測條件說明。
借鑑 LongCat-2.5 思路設計長程 Agent 工程
LongCat-2.5 的訓練方法給應用開發者的啓發很直接:模型側在訓練“階段驗證、失敗恢復、防投機”,工程側也應該把這些機制顯式寫進 Agent 系統。以下是基於公開訓練方法引出的工程建議,不是官方聲稱已實現的功能。
| 工程機制 | 對應訓練思路 | 落地方式 |
|---|---|---|
| 階段驗證 | F2P 驗證 | 每個子任務結束即運行檢查腳本 |
| 迴歸保護 | P2P 驗證 | 每次修改後跑全量回歸測試 |
| 失敗記錄 | 失敗軌跡學習 | 把錯誤信息寫入進度文件,下一輪帶入 |
| 預算上限 | 重複調用懲罰 | 限制最大輪次、超時和工具調用次數 |
| 交付驗收 | 防 Reward Hacking | 檢查真實文件,而不是隻看模型總結 |
下面是一個最小化的階段驗證 Agent 循環示例,演示進度記錄、失敗回灌和預算上限:
import json, subprocess, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)
MODEL = "gpt-4o-mini"  # 以平臺模型列表中實際可用的模型 ID 爲準
MAX_ROUNDS = 8         # 預算上限,防止死循環

def run_check(cmd: str) -> tuple[bool, str]:
    r = subprocess.run(cmd, shell=True, capture_output=True, text=True, timeout=300)
    return r.returncode == 0, (r.stdout + r.stderr)[-2000:]

def run_stage(stage: dict, progress: dict) -> bool:
    failures = []
    for i in range(MAX_ROUNDS):
        prompt = (f"階段目標:{stage['goal']}\n"
                  f"已完成階段:{progress['done']}\n"
                  f"歷史失敗(請避免重複):{failures[-3:]}")
        resp = client.chat.completions.create(
            model=MODEL, messages=[{"role": "user", "content": prompt}])
        # 此處省略:解析模型輸出並寫入代碼文件
        ok, log = run_check(stage["check"])          # 階段驗證(類 F2P)
        reg_ok, reg_log = run_check("pytest -q")     # 迴歸測試(類 P2P)
        if ok and reg_ok:
            progress["done"].append(stage["name"])
            return True
        failures.append(log if not ok else reg_log)
    progress["blocked"] = stage["name"]
    return False

progress = {"done": [], "blocked": None}
stages = [{"name": "api", "goal": "實現用戶接口", "check": "pytest tests/test_api.py -q"}]
for s in stages:
    if not run_stage(s, progress):
        break
json.dump(progress, open("progress.json", "w"), ensure_ascii=False)
這個結構的關鍵在於:每個階段都有可執行的驗收命令,失敗日誌會回灌到下一輪提示中,進度寫入文件而不是隻存在上下文裏。即使上下文足夠長,把進度和約束外置成結構化狀態,也能顯著降低長任務中途偏離目標的風險。
🚀 快速上手建議:搭建 Agent 原型時,可以先通過 API易 apiyi.com 獲取測試額度,用同一個 API Key 切換不同模型跑上面的階段驗證循環,觀察哪個模型在你的任務上交付最完整。
如果項目對可靠性要求高,還可以引入“交叉驗收”:由另一個模型對最終產物逐條覈對需求清單。通過 API易 apiyi.com 的統一接口,執行模型和驗收模型可以在同一套代碼裏調用,切換成本很低。
常見問題 FAQ
Q1:LongCat-2.5 的 1M 上下文意味着能完成大型項目嗎?
不能直接畫等號。1M 上下文是單次請求的容量,包含輸入與輸出,它讓模型能讀入更多代碼和文檔。完成項目還依賴規劃、工具調用、錯誤修復和交付檢查,這正是 LongCat-2.5 用長程強化學習專門訓練的部分。
Q2:LongCat-2.5 與 GPT-5.6-Sol、Claude Opus 5 在長程任務上差距如何?
按官方表格,LongCat-2.5 在 BrowseComp(91.9)、Terminal Bench v4.0(38.5)上略高於 GPT-5.6-Sol,但 DeepSWE 64.6 低於 GPT-5.6-Sol 的 72.7,Terminal Bench v4.0 也比 Claude Opus 5 低 15.4 分。各項測試框架不同,不宜視爲統一排行。
Q3:LongCat-2.5 正式版什麼時候發佈?權重開源了嗎?
Preview 版於 2026-09-25 上線 API 平臺,正式版於 2026-11-02 發佈。官方網頁和 API 已開放,但截至 2026-11-03,正式版模型權重尚未確認公開,官方表示 GitHub 與 Hugging Face 後續上線。
Q4:現在能通過 API易 調用 LongCat-2.5 嗎?
根據 2026-11-02 的公開說明,當時 LongCat-2.5 尚未在 API易 上線,計劃後續接入。具體供應狀態請以 API易 apiyi.com 模型列表爲準。在此期間,可以先用平臺上已接入的模型搭建階段驗證、失敗回灌等 Agent 框架,模型上線後只需替換模型 ID。
Q5:如何低成本驗證一個模型的長程 Agent 能力?
建議準備 3-5 個貼近自身業務、帶自動驗收腳本的多步驟任務,記錄每個模型的完整交付率、平均輪次和失敗類型。藉助 API易 apiyi.com 的 OpenAI 兼容接口,一個 API Key 即可在同一套腳本里對比多個模型,新用戶還有免費測試額度可用於初步驗證。
Q6:LongCat-2.5 的長程能力有哪些已知不足?
第三方實測中出現過尺寸單位錯誤、空間關係錯誤、視頻未交付和請求超時中斷等問題。官方也未宣稱 Reward Hacking 已徹底解決,失敗軌跡的規模與修正率尚未公開。工程尺寸、知識準確性和交付完整性仍需人工驗證。
LongCat-2.5 長程 Agent 核心要點 Key Takeaways
- 上下文≠完成度:1M Token 是容量,不是項目成功率,長程能力需要單獨訓練。
- 真實環境訓練:從 GitHub PR、Issue 和內部任務構造可執行環境獲取反饋。
- 雙向測試驗證:F2P 查問題是否解決,P2P 查是否引入迴歸。
- 從失敗中學習:真實 Agent 失敗軌跡被重構爲可驗證訓練任務。
- 成績需看條件:Benchmark 與 Harness 強綁定,第三方實測仍有漏交付。
- 工程側同步設計:階段驗證、失敗記錄、預算上限和交付驗收缺一不可,可藉助 API易 apiyi.com 多模型對比驗證。
總結
LongCat-2.5 發佈帶來的最大信號,不是又一個百萬 Token 窗口,而是訓練重心從“能讀多長”轉向“能不能把整個項目做完”:
- 問題定義更準確:長程 Agent 失敗多發生在執行、驗證和交付環節,而不是上下文不夠。
- 訓練方法有針對性:真實任務環境、F2P/P2P、失敗軌跡、Partial Rollout、防投機和跨 Harness,各自對應一類現實失敗。
- 證據邊界要清楚:官方成績進步明顯,但與頂尖模型仍有差距,第三方實測也顯示完整交付仍需人工把關。
對開發者而言,更務實的做法是把同樣的思路落到自己的 Agent 系統裏,用可執行的驗收標準衡量模型,而不是隻看參數和榜單。推薦通過 API易 apiyi.com 用統一接口在真實任務上對比驗證,再決定生產環境的模型組合。
📚 參考資料
- 美團技術團隊 – LongCat-2.5 技術文章:長程 Agent 訓練方法詳解
- 鏈接:
tech.meituan.com/2026/11/02/Meituan-LongCat-2.5.html -
說明:F2P/P2P、Partial Rollout、防 Reward Hacking 等訓練設計的原始出處
-
LongCat 官方博客:Benchmark 數據與評測方法
- 鏈接:
longcat.ai/blog/longcat-2.5 -
說明:完整評測表及各基準的 Harness 與參數設置
-
LongCat 模型參數文檔:上下文與輸出參數說明
- 鏈接:
longcat.ai/platform/docs/zh/api/model-params -
說明:上下文長度、max_tokens、思考預算等調用參數
-
Terminal-Bench:終端 Agent 基準
- 鏈接:
tbench.ai -
說明:瞭解分數與 Agent Harness 的綁定關係及版本差異
-
DeepSWE:長程軟件工程 Agent 基準
- 鏈接:
deepswe.datacurve.ai -
說明:113 個原創任務、91 個開源倉庫的測試設計
-
TOKRACE – LongCat-2.5 實測記錄:15 項創作任務第三方測試
- 鏈接:
tokrace.com/zh-CN/guides/longcat-2-5-release - 說明:長任務部分完成、單位錯誤等真實案例
作者:APIYI 技術團隊
技術交流:歡迎訪問 API易 apiyi.com 首頁聯繫我們,交流長程 Agent 工程實踐與多模型選型經驗