ملاحظة المؤلف: استنادًا إلى مجموعة اختبارات لإعادة بناء الموقع الرسمي لـ Agrumea Farm، تقارن هذه المقالة بين Gemini 4 Carbon وClaude Opus 5.5 وGPT-6 Astra من ثلاثة جوانب: مدى الدقة في استنساخ التصميم، ومتطلبات التفاعل، والزمن مع تكلفة API المكافئة. كما تقدّم طريقة لاختيار النموذج حسب السيناريو ولإعادة الاختبار بنفسك.
ماذا يحدث لو سلّمت الموقع الرسمي لعلامة تجارية واحدة إلى ثلاثة من أقوى النماذج وطلبت من كل منها إعادة بنائه؟ كم سيكون الفرق بين النتائج؟ في 11 نوفمبر 2026 نشر الكاتب المستقل Pat Simmons (صاحب AI for Mortals) مجموعة اختبارات من هذا النوع. طلب من Gemini 4 Carbon وClaude Opus 5.5 وGPT-6 Astra إعادة بناء الموقع الرسمي للعلامة الإيطالية للأغذية Agrumea Farm، ونشر الأعمال الناتجة ولقطات الشاشة والموجّهات وأوقات التشغيل وتكلفة API المكافئة.
هذه ليست مقارنة وسطية تقول إن لكل نموذج ميزاته. في هذه المهمة كان الفائز في كل جانب واضحًا: Carbon هو الأقل تكلفة، وAstra هو الأسرع، وOpus حصل على تقييم جودة أعلى من كاتب الاختبار. وتجدر الإشارة إلى أن كل نموذج جُرّب مرة واحدة فقط، وأن بيئات الأدوات وتواريخ الاختبار كانت مختلفة، ولذلك لا يصح تعميم هذه النتائج كترتيب ينطبق على كل سيناريوهات تطوير المواقع.
القيمة الأساسية: بعد قراءة هذه المقالة ستعرف مزايا كل واحد من مسارات العمل الثلاثة («نموذج + أداة») من حيث النتيجة والسرعة والتكلفة، وستتمكن من استخدام الطريقة المعروضة هنا لإعادة التحقق في مشاريعك الخاصة.
لنرَ أولًا شكل الموقع الأصلي: كيف أُجري اختبار الاستنساخ على Carbon وOpus وAstra بمهمة واحدة
نبدأ بشروط الاختبار ثم ننتقل إلى النتائج. قيمة هذه المجموعة من الاختبارات أنها استخدمت «الموقع نفسه والموجه نفسه وهدف التطوير نفسه»، لكنها تقارن سير عمل كاملًا، ولا تعزل النموذج وحده كما يحدث في المختبر.
| عنصر الاختبار | الإعداد المحدد | تأثيره على الاستنتاج |
|---|---|---|
| موضوع الاختبار | الموقع الرسمي لـ Agrumea Farm (النسخة الإنجليزية) | المقارنة تقيس القدرة على إعادة إنتاج التصميم، لا الذوق الإبداعي الأصيل |
| متطلبات المهمة | إعادة إنتاج بنية الصفحة والأسلوب البصري، وشريط عرض ثلاثي الأبعاد للعلب المعدنية، والتمرير والسحب، وحركة التحميل، وحركة التحويم، والانتقالات بين الصفحات | التفاعل مؤشر جودة إلى جانب لقطات الشاشة الثابتة |
| أحجام الفحص | سطح المكتب 1440×900، والجوال 390×844 | يجب مراعاة التخطيط المتجاوب في الحالتين |
| طريقة التحقق | قراءة الأنماط عبر المتصفح وإجراء تحقق بصري، لضمان أن الموقع يعمل | قدرة النموذج على فحص عمله ذاتيًا في المتصفح تؤثر في النتيجة النهائية |
| بيئة الأدوات | Carbon عبر Google Antigravity، وOpus عبر Claude Code، وAstra عبر Codex، وجميعها بإعدادات استدلال عالية | النتيجة حصيلة تضافر النموذج وسلسلة الأدوات معًا |
| عدد مرات التشغيل وتاريخه | كل نموذج شُغّل مرة واحدة فقط؛ Opus وAstra في 6 نوفمبر، وCarbon من 10 إلى 11 نوفمبر | احتمال التذبذب في التشغيل الواحد واختلاف البيئات |
ثلاثة شروط أساسية لاختبار Carbon وOpus وAstra
الشرط الأول أن المهمة «استنساخ» وليست «تصميمًا حرًّا». كان على النماذج الثلاثة أن تلتزم بلغة التصميم الخاصة بالعلامة التجارية الأصلية، لذلك ينصبّ التركيز على دقة الاستنساخ والتفاصيل ومستوى الإتمام. أما إذا كنت تريد تصميم هوية بصرية أصلية من الصفر، فلا تصلح هذه الاختبارات إلا مرجعًا عامًا.
الشرط الثاني هو أسلوب احتساب التكلفة. جميع المبالغ المذكورة في النص حسبها مؤلف التقييم من أسعار النماذج وسجلات الاستخدام، وهي تكلفة API مكافئة، وليست المبالغ المخصومة فعليًا من باقات الاشتراك. فإذا شغّلت المهمة نفسها بأداة تعمل باشتراك شهري، فسيختلف شكل الفاتورة تمامًا.
الشرط الثالث أن التقييم يضم في الواقع أربعة نماذج. أضاف المؤلف أيضًا Claude Fable 5.2، الذي حصل على المركز الأول في التقييم الشخصي. لذا فإن «المركز الثاني والثالث والرابع» المذكورة أدناه هي ترتيبات بين أربعة نماذج.
ملاحظة على الصور: لقطات الشاشة الأولى للأعمال الثلاثة المذكورة في هذا المقال مصدرها AI for Mortals / Pat Simmons، بتاريخ النشر 2026-11-11، وهي تقابل على الترتيب أعمال الاستنساخ الخاصة بـ Gemini 4 Carbon وClaude Opus 5.5 وGPT-6 Astra.
الجولة الأولى: من أعاد تصميم الموقع بشكل أفضل، Carbon أم Opus أم Astra؟
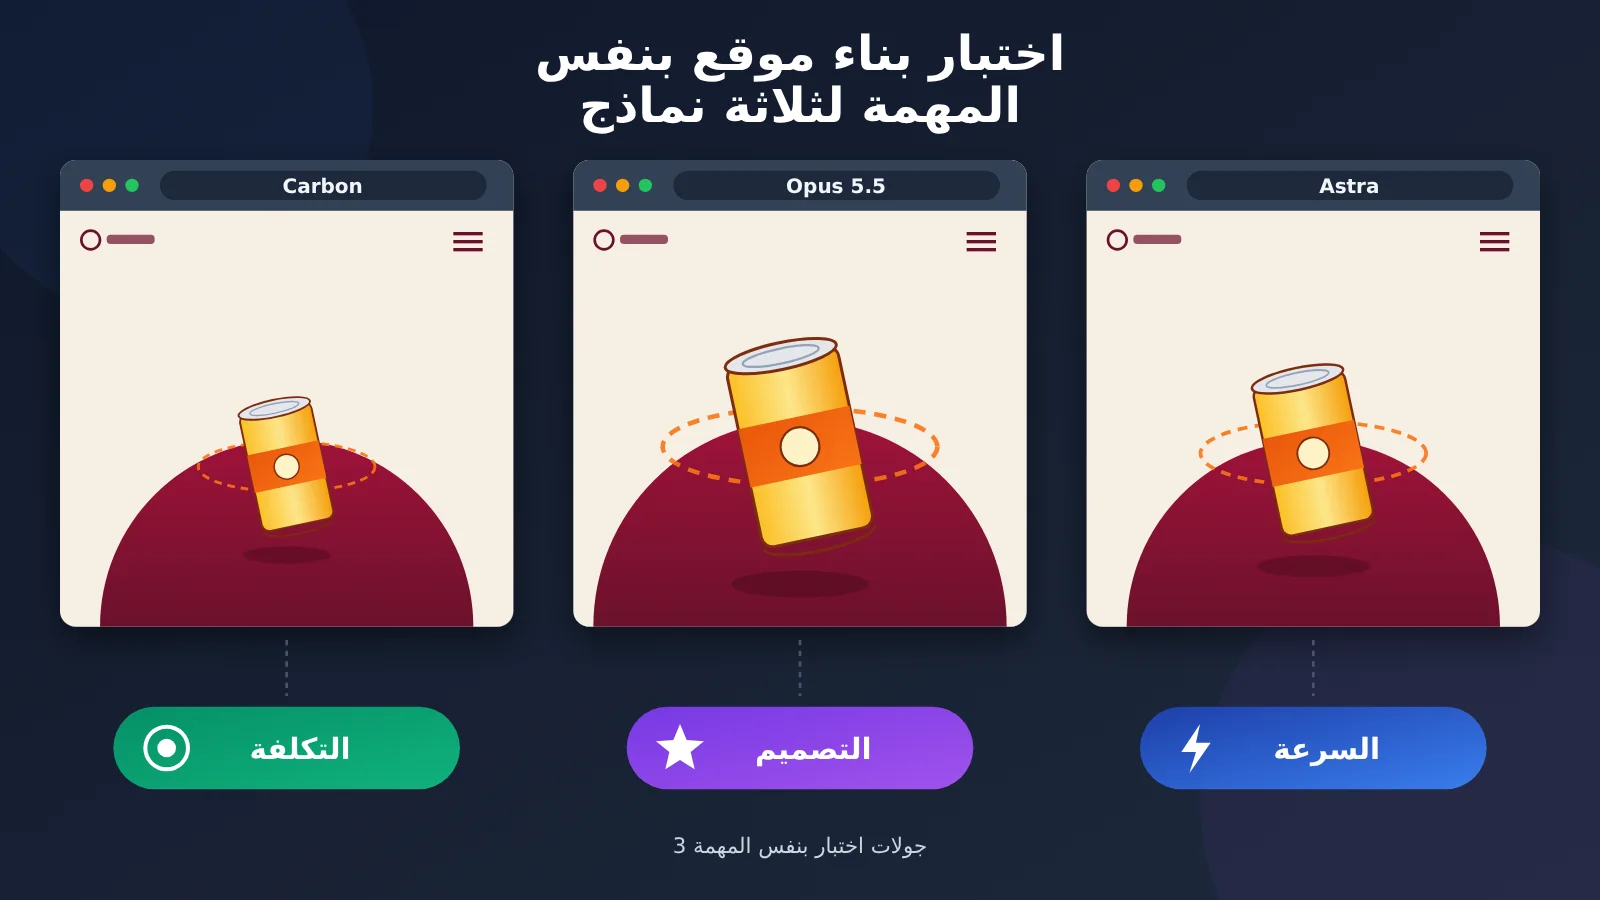
لنبدأ بالصورة نفسها. من لقطات الشاشة المنشورة للشاشة الأولى، نجد أن الأعمال الثلاثة التقطت العناصر الأساسية للموقع الأصلي: خلفية بيج فاتحة، وعلب أطعمة معلقة في الهواء، وخلفية مقوسة بلون أحمر عنابي، ونصًا برتقاليًا يلتف حولها، إضافةً إلى شعار العلامة التجارية وزر تبديل اللغة وزر القائمة في أعلى الصفحة. بمعنى آخر، لم يقدّم أي منها قالبًا عامًّا بعيدًا عن الأصل، وإنما تركّز الفرق في النِّسَب وتدرّج الطبقات وتفاصيل التنفيذ.
الصور أدناه مرتبة من الأعلى إلى الأسفل: عمل opus5.5، ثم astra، ثم carbon.
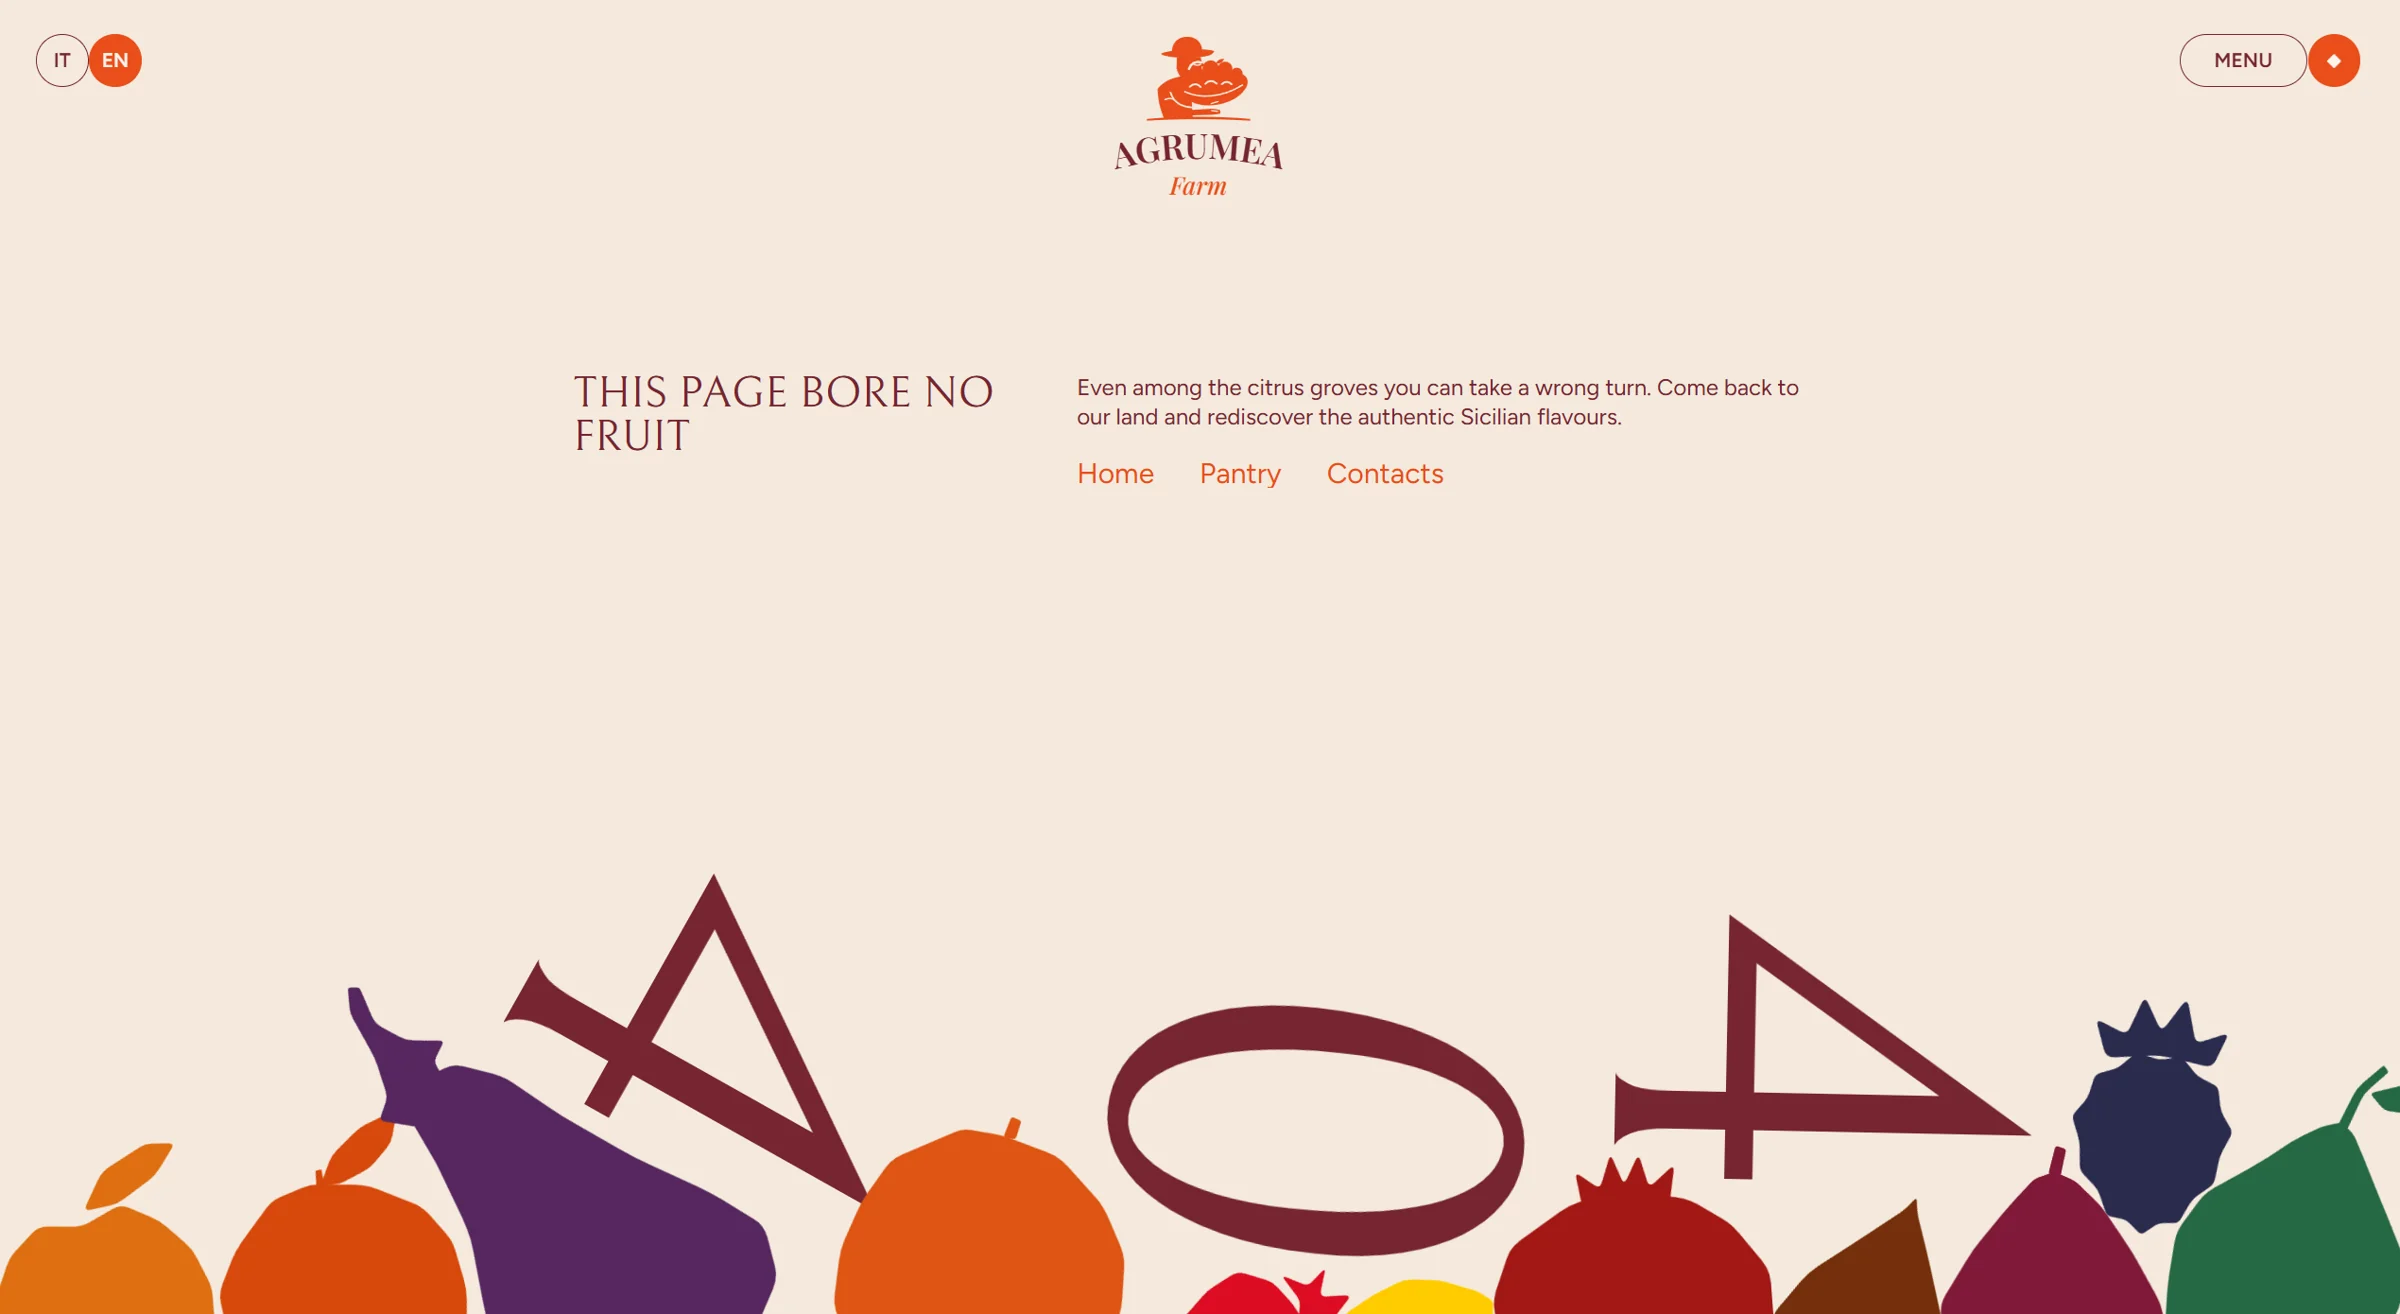
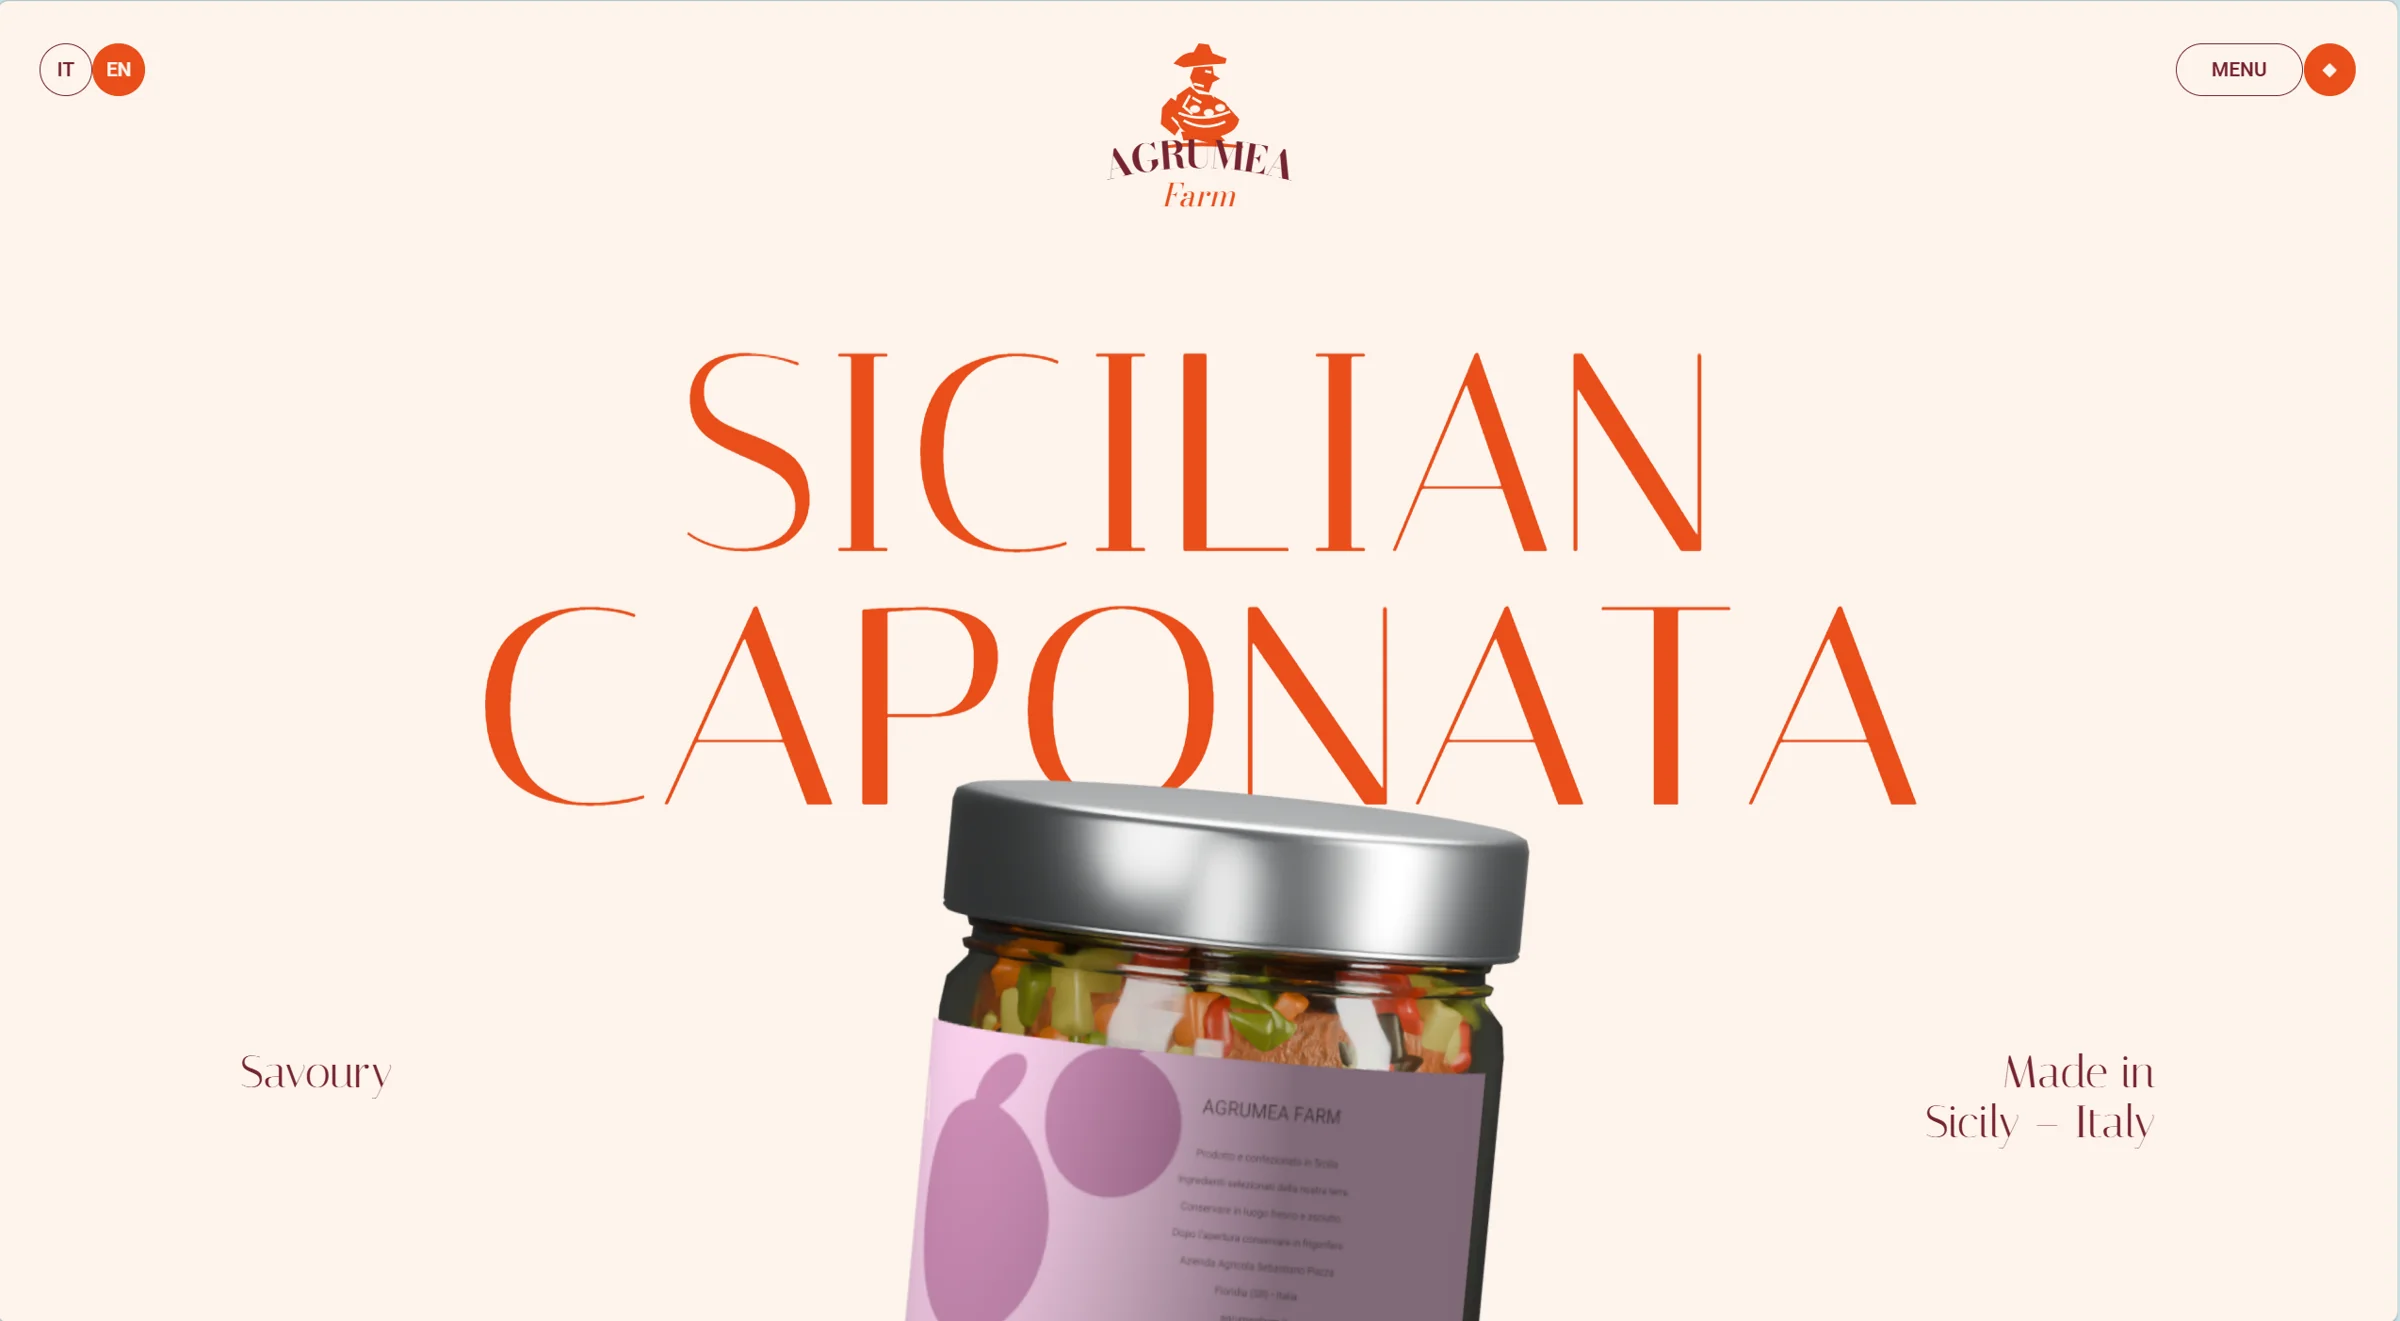
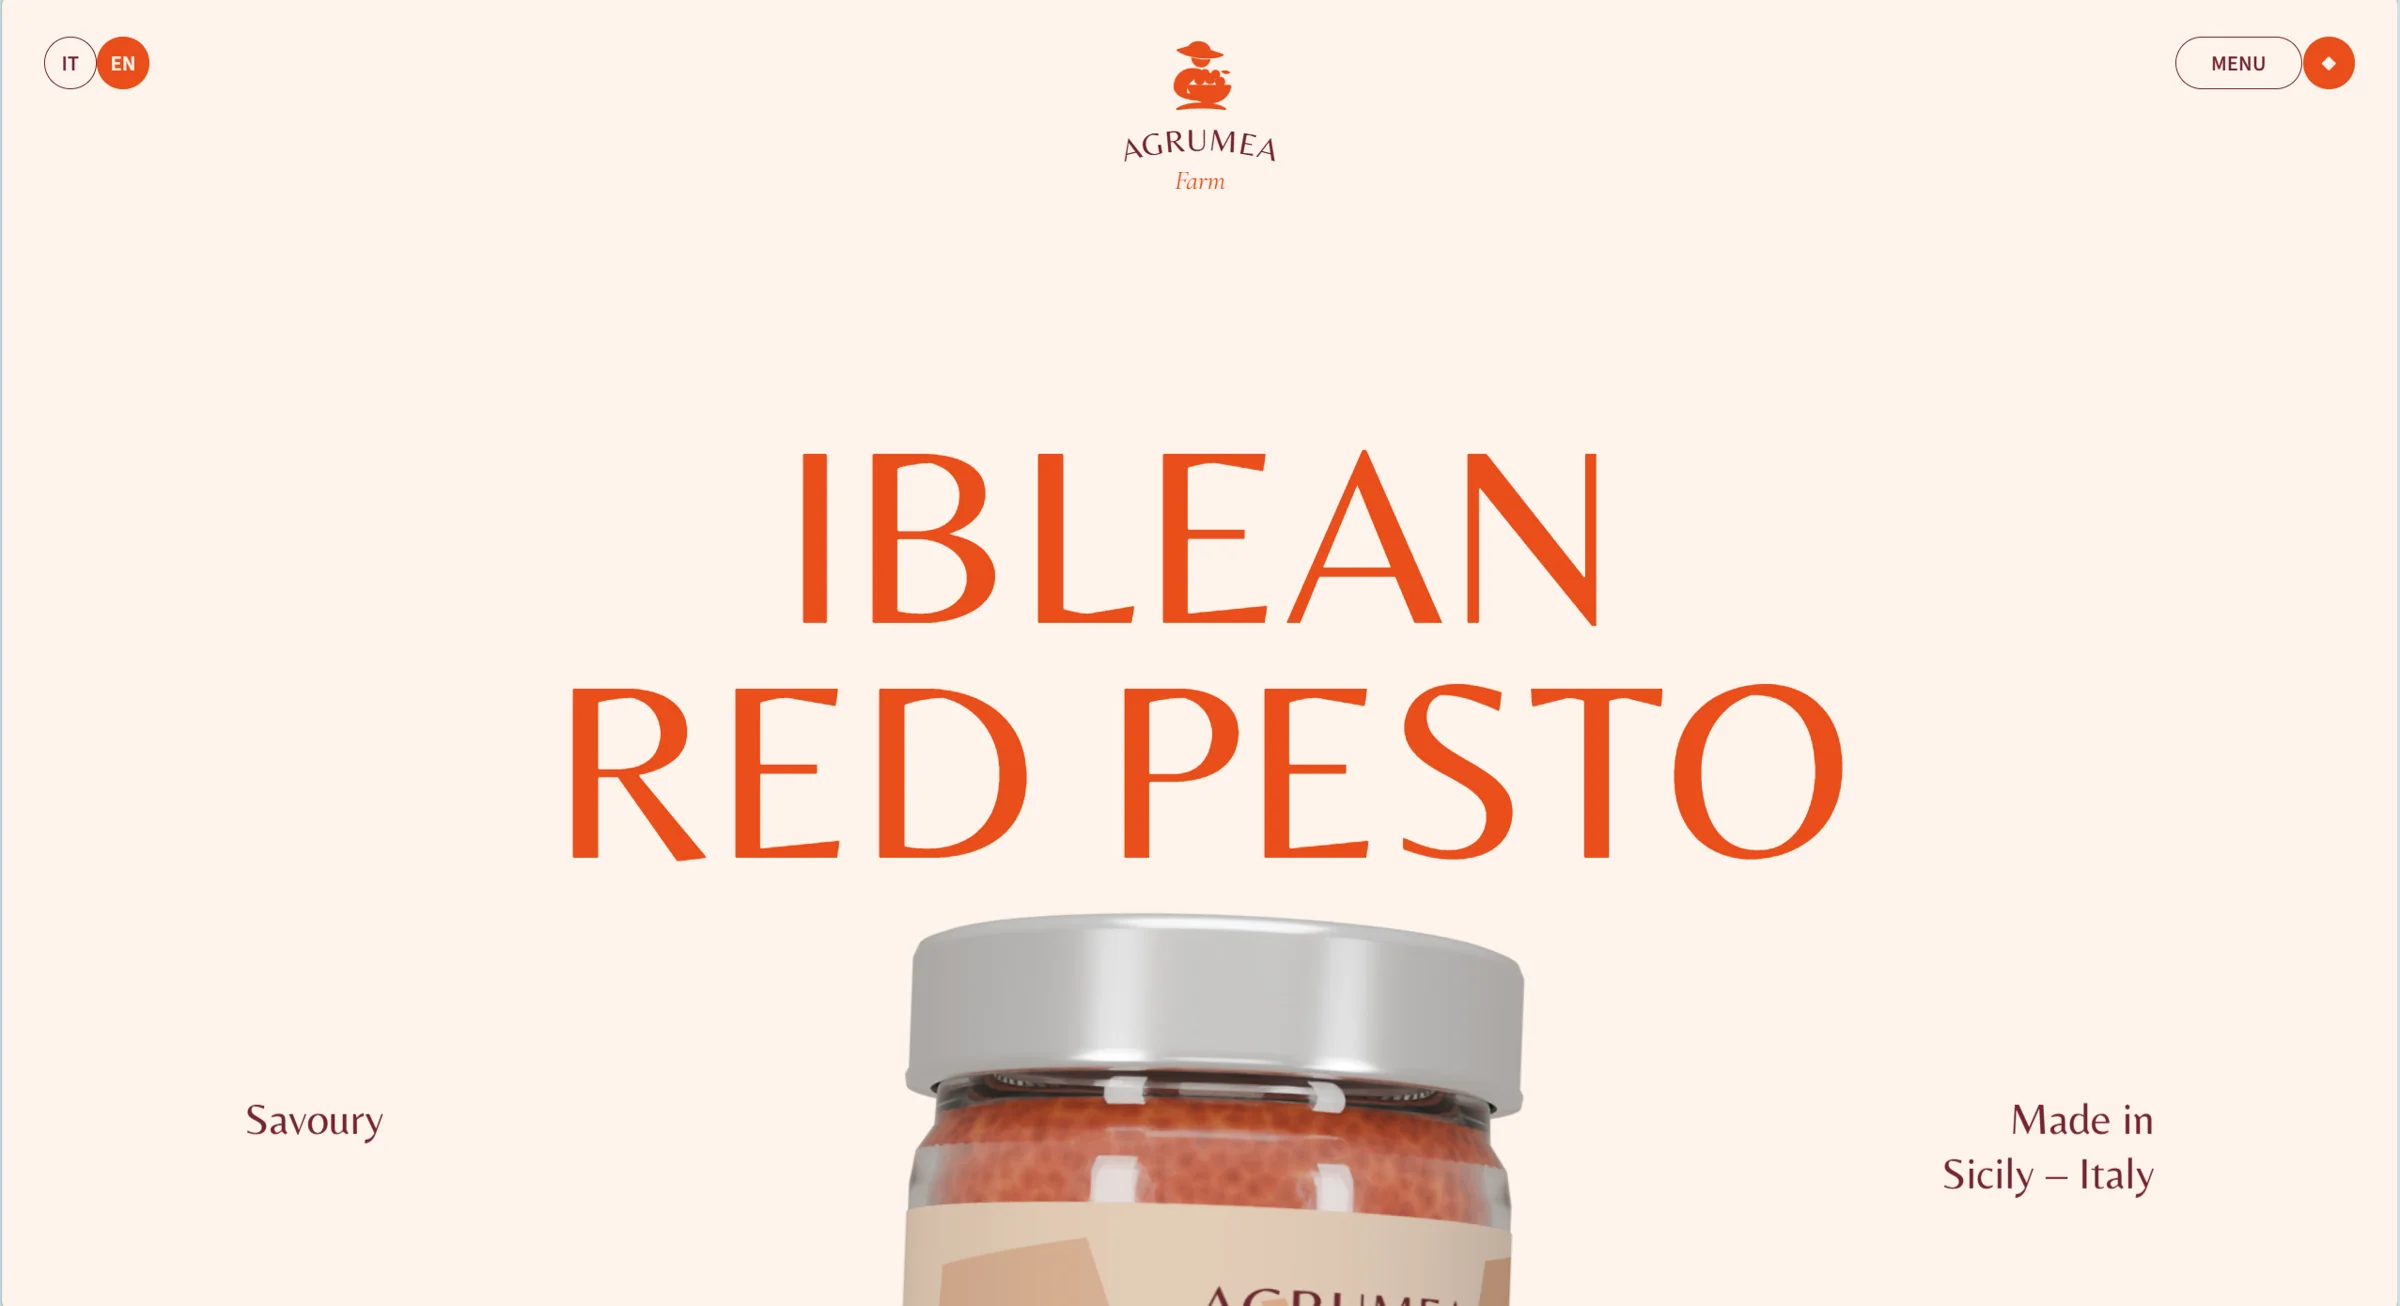
| جانب المقارنة | Gemini 4 Carbon | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| تكوين الشاشة الأولى | مساحات فارغة أكثر، والمظهر العام متباعد | العنصر الرئيسي (المنتج) أكبر حجمًا، وتأثيره البصري قوي | توزيع مكتمل، والمظهر العام أكثر إحكامًا |
| نسبة العلبة | العلبة المركزية أصغر نسبيًا | العلبة بارزة وهي مركز النظر بلا منازع | مركز النظر واضح |
| الخلفية وتدرج الطبقات | الخلفية المقوسة مستعادة | تداخل العلبة مع منحنى الخلفية أكثر بروزًا | طبقات مكتملة |
| الملصقات والنصوص | بعض تفاصيل الملصقات والنصوص أضعف | الملصقات والخطوط أغنى في التنفيذ | ملصق العلبة يحمل زخرفة رسومية واضحة |
| ترتيب الكاتب الشخصي (بين أربعة نماذج) | الرابع | الثاني | الثالث |
لماذا حظي Opus بتقدير أكبر في استعادة التصميم
علينا أولًا أن نفصل بين نوعين من المعلومات: الصفوف الأربعة الأولى من الجدول تعتمد على ملاحظات بصرية من لقطات الشاشة المنشورة، أما الصف الأخير فهو الترتيب الذاتي لكاتب التقييم. من بين النماذج الثلاثة المحددة، كان الكاتب أكثر رضًا عن Opus، يليه Astra، ثم Carbon في المرتبة الأخيرة.
يبدو من لقطات الشاشة أن ميزة Opus تكمن أساسًا في «العلاقة بين العناصر الرئيسية والثانوية» في موقع العلامة التجارية. فالمنتج هو جوهر الشاشة الأولى في موقع أي علامة تجارية للأغذية، وقد جعل Opus العلبة أكبر، وأظهر تراكبًا واضحًا بينها وبين المنحنى ذي اللون الأحمر الداكن (لون النبيذ)، كما بدت نصوص الملصق أوضح. أما تخطيط Carbon المتّسع فليس خاطئًا في ذاته، لكن العلبة فيه أصغر وبعض تفاصيل النصوص أضعف، وهذا يضعه في موقف أقل ملاءمة عندما يكون معيار التقييم هو «دقة الاستعادة».
أما Astra فيأتي أداؤه في منزلة وسطى بين الاثنين. تركيبته البصرية مكتملة ومركز الاهتمام فيها واضح، والطابع الزخرفي لملصق العلبة قوي نسبيًا، لكن التصميم العام أكثر ازدحامًا. وفي مهام الاستنساخ، يكون «التشابه مع الموقع الأصلي» أهم من «مدى جمال التصميم»، وهذا ما يفسّر لماذا بدت الأعمال الثلاثة جيدة، ومع ذلك جاء الترتيب بينها متفاوتًا بوضوح.
الجولة الثانية: لماذا لا تكفي لقطات الشاشة للحكم على تفاعلات Carbon وOpus وAstra
أكبر فرق بين الموقع ومخطط التصميم أن الموقع يجب أن “يتحرك”. فالمهمة الأصلية طلبت صراحةً إعادة بناء دوّار ثلاثي الأبعاد لعلب المنتج، وتفاعلات التمرير والسحب، وحركة شاشة التحميل، وحركات التحويم، والانتقالات بين الصفحات. هذه القدرات بالكاد تظهر في لقطة شاشة ثابتة، ومع ذلك فهي التي تحدد تجربة المستخدم فور فتح الموقع.
لذلك لا تثبت لقطات الشاشة سوى التخطيط والتفاصيل البصرية، ولا تثبت أن الوظائف التفاعلية نُفِّذت بالكامل. وللتأكد من أن العلبة ثلاثية الأبعاد تُسحب بسلاسة، وأن استجابة التحويم طبيعية، وأن العناصر لا تنزاح على الجوال، عليك فتح صفحات الأعمال الثلاث المنشورة وتجربتها بنفسك. لا يتعامل هذا المقال مع لقطات الشاشة على أنها نتيجة اختبار تفاعلي، ولا يضيف من عنده تقييمات للتفاعل لم يقدمها صاحب العمل الأصلي.
وتوضح هذه الجولة أيضًا الفرق بين تطوير صفحات الويب وتوليد الصور الثابتة. فقد يرسم النموذج شاشة أولى جميلة، لكن كتابة دوّار ثلاثي الأبعاد وحركات مرتبطة بالتمرير وتخطيط متجاوب في شفرة قابلة للتشغيل أمر مختلف، إذ يجب أيضًا مراعاة ترتيب التحميل والأداء والمظهر على الأحجام المختلفة. ولهذا اشترط التقييم “قراءة الأنماط عبر المتصفح وإجراء تحقق بصري”، حتى يتحول “انتهت الكتابة” إلى “يعمل فعلًا”.
في المشاريع الفعلية، يمكنك فحص أي موقع ولّده الذكاء الاصطناعي بالترتيب التالي:
- افتح الصفحة أولًا بمقاسين: 1440×900 و390×844، وتأكد من أن التخطيط لا يفيض ولا تتداخل عناصره.
- جرّب السحب والتمرير والتحويم والانتقال بين الصفحات واحدًا تلو الآخر، ولاحظ هل الحركة متقطعة أو معطلة.
- افتح وحدة تحكم المتصفح، وابحث عن أخطاء أو موارد فشل تحميلها أو حركات تدور في حلقة لا نهائية.
- أخيرًا، قارن الموقع شاشةً بشاشة مع الموقع الأصلي أو مخطط التصميم، وسجّل الفروق البصرية.
الجولة الثالثة: كم يبلغ الفرق في التكلفة والزمن بين Carbon وOpus وAstra؟
هذه الجولة تُبرز الفرق بين مسارات العمل الثلاثة أكثر من غيرها. جميع الأرقام أدناه مأخوذة من التقييم الأصلي، والتكلفة فيها هي التكلفة المكافئة بحسب أسعار API.
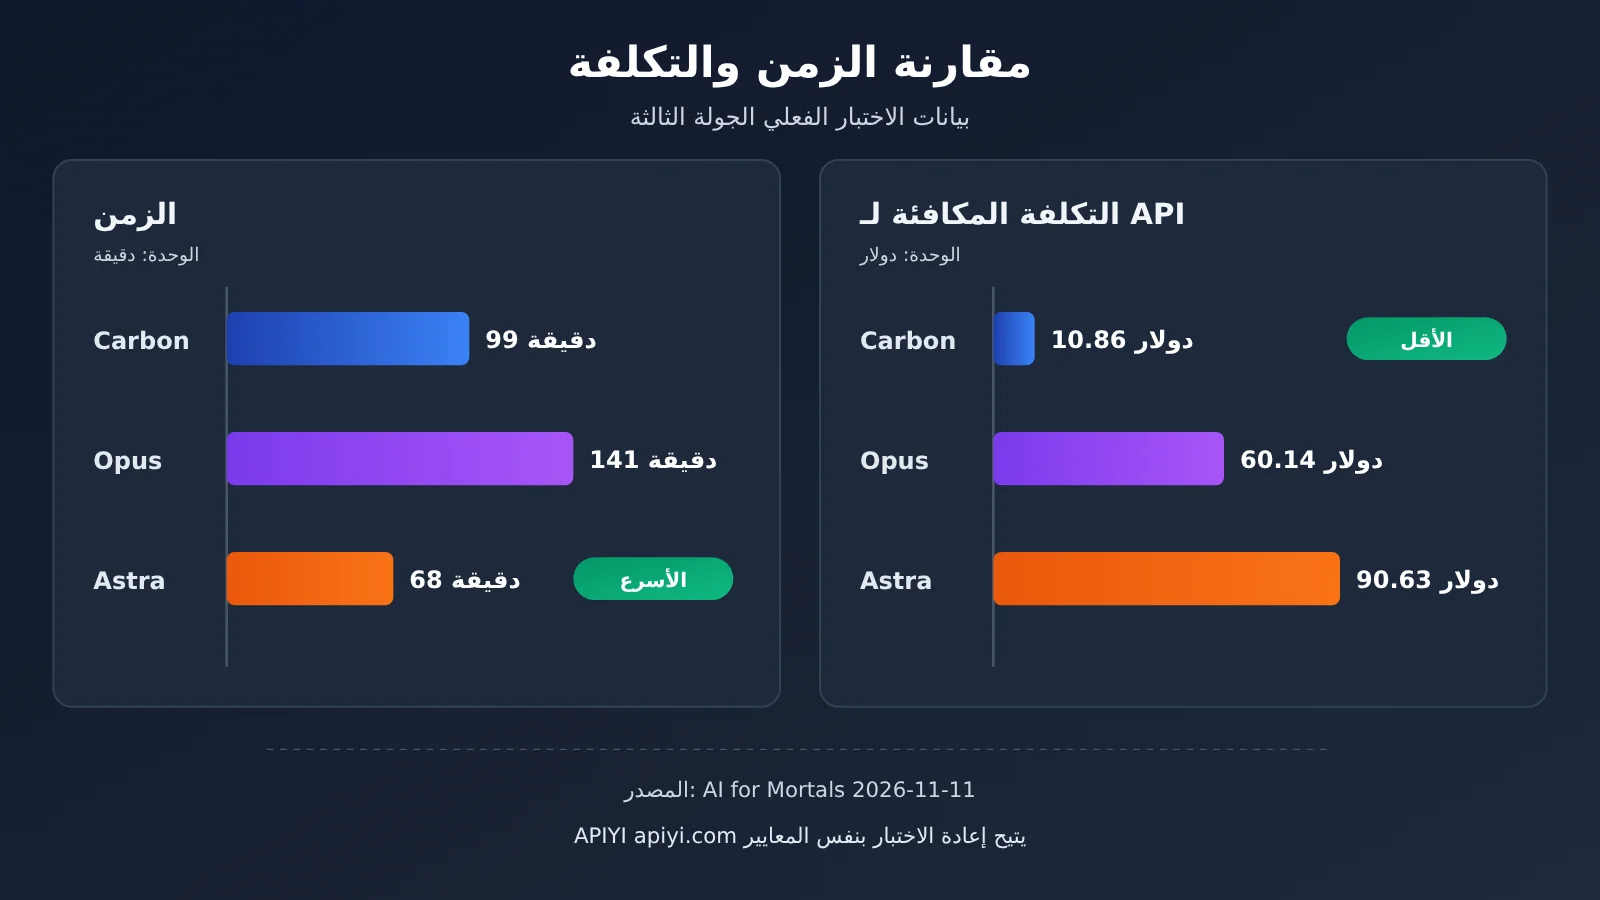
| المؤشر | Gemini 4 Carbon | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| الزمن | 99 دقيقة | 141 دقيقة | 68 دقيقة (الأسرع) |
| التكلفة المكافئة بحسب أسعار API | 10.86 دولار (الأقل) | 60.14 دولار | 90.63 دولار |
| رموز الإدخال (Tokens) | 27.7 مليون | 197.9 مليون | 70.4 مليون |
| رموز الإخراج (Tokens) | 430 ألفًا | 483 ألفًا | 211 ألفًا |
| التكلفة المكافئة لكل دقيقة (تقديري) | نحو 0.11 دولار | نحو 0.43 دولار | نحو 1.33 دولار |
| ترتيب الكاتب الشخصي (بين أربعة نماذج) | الرابع | الثاني | الثالث |
قراءة أعمق لبيانات التكلفة: Carbon وOpus وAstra
تبلغ التكلفة المكافئة لنموذج Carbon نحو 18% من تكلفة Opus ونحو 12% من تكلفة Astra. فإذا كان أسلوب عملك يقوم على التجربة والخطأ بكثرة وتكرار المحاولات، فسيتضخم هذا الفرق باستمرار عبر المهام متعددة الجولات. أما Astra فأنجز المهمة في 68 دقيقة، أي أقل من نصف زمن Opus، وهو مناسب للحالات التي تهمّك فيها سرعة التسليم. وجاء Opus الأطول زمنًا وبتكلفة متوسطة، لكنه قدّم العمل الذي كان الكاتب الأكثر رضًا عنه بين الثلاثة.
هناك ملاحظة في الجدول قد تفوت القارئ: رموز الإدخال عند الثلاثة أكبر بكثير من رموز الإخراج. فبحسب أرقام الجدول، تبلغ نسبة الإدخال إلى الإخراج نحو 64:1 عند Carbon، ونحو 410:1 عند Opus، ونحو 334:1 عند Astra. ويرتبط هذا بطبيعة التطوير بأسلوب الوكلاء (Agent)، إذ يعيد النموذج في كل جولة قراءة الشيفرة والأنماط وحالة الصفحة وغيرها من السياق، بينما لا تشكل الشيفرة التي «يكتبها» فعليًا إلا جزءًا صغيرًا. ووصول مدخلات Opus إلى قرابة 200 مليون يدل على أنه أجرى ذهابًا وإيابًا كثيفًا مع السياق في هذه المهمة.
ونقطة أخرى تستحق الانتباه: عدد الرموز (Tokens) لا يتناسب طرديًا مع التكلفة. فرموز الإدخال عند Astra لا تتجاوز ثلث ما عند Opus تقريبًا، ومع ذلك فتكلفته المكافئة أعلى. وهذا يعني أن سعر الوحدة وطريقة احتساب التخزين المؤقت وغيرها من العوامل مهمة بالقدر نفسه. لذلك لا يكفي عند تقييم التكلفة أن تنظر إلى من استخدم رموزًا أقل، بل احسب التكلفة وفق قواعد التسعير الفعلية لكل نموذج. ولن أخوض هنا في الأسعار التفصيلية، فارجع إلى صفحات الأسعار الرسمية لدى كل شركة للاطلاع على الأرقام المعتمدة.
لماذا تختلف نتائج Carbon وOpus وAstra مع الموجه نفسه؟
عند تشغيل الموجه نفسه والحصول على ثلاث نتائج مختلفة، فالسبب لا يعود إلى النموذج وحده. في هذه الاختبارات عمل كل نموذج داخل أداة التطوير الخاصة به، وتشارك أربعة عوامل في تحديد العمل النهائي: قدرات النموذج، وطريقة استدعاء الأدوات، وآلية الفحص الذاتي عبر المتصفح، وإدارة السياق.
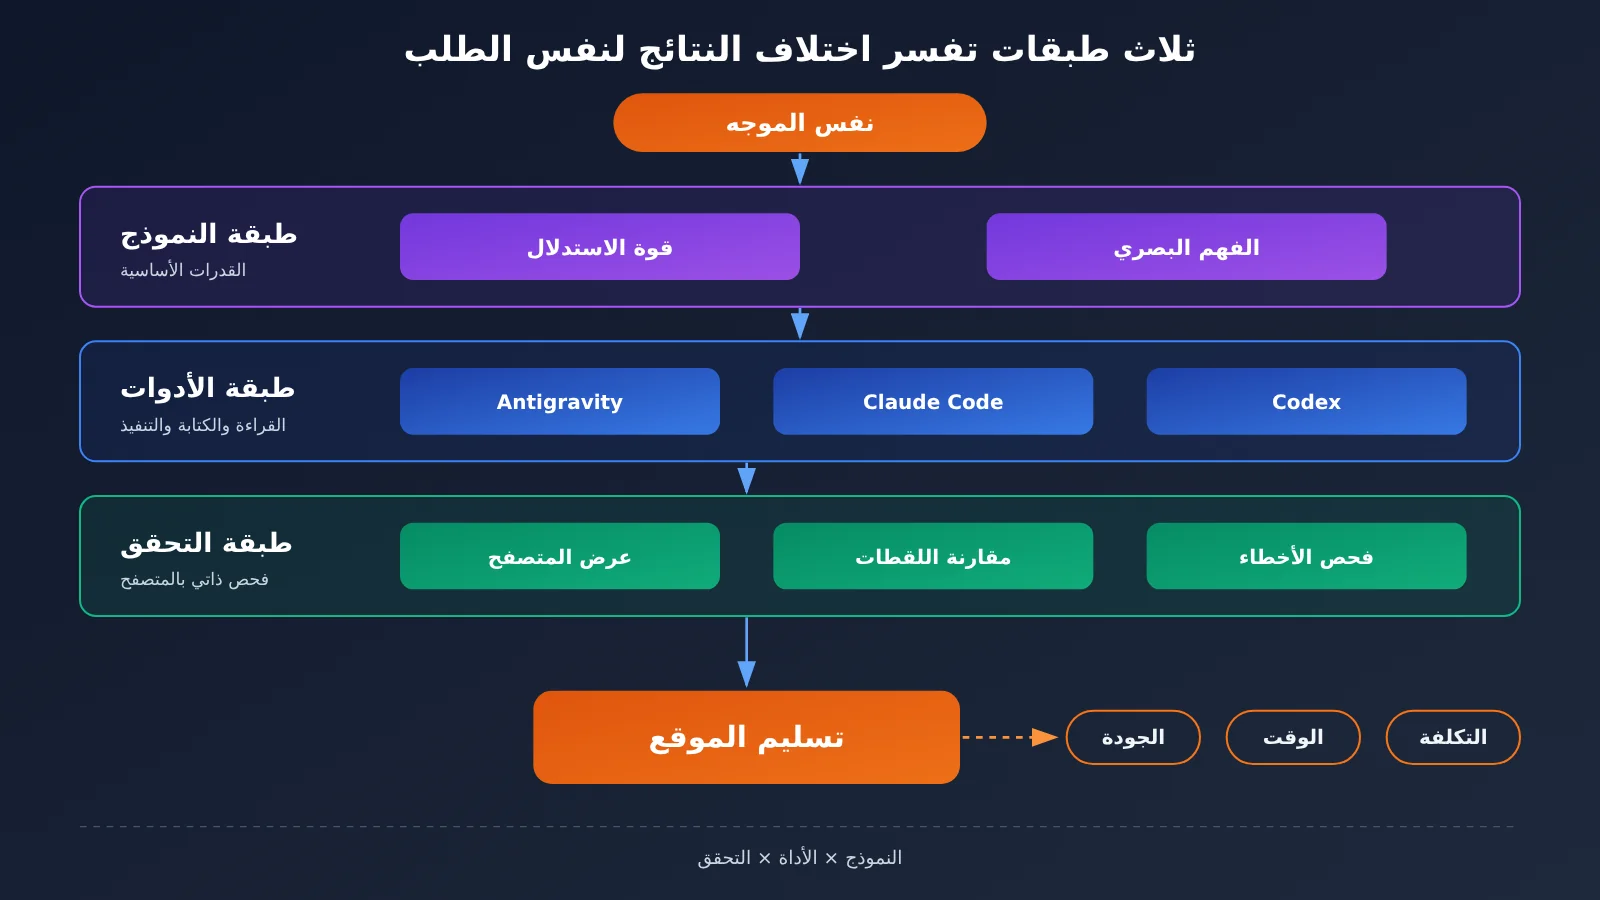
من خلال المواد الرسمية، تركّز كل شركة من الشركات الثلاث على جانب مختلف في تطوير الويب:
- Google (Carbon + Antigravity): تركّز على تصميم الواجهات الأمامية، والتحقق عبر المتصفح، والمؤثرات الحركية، ومحتوى 3D المعقد، والتطوير بواسطة عدة وكلاء. ومن الأمثلة الرسمية إعادة تصميم Google Merchandise Store بموجهين فقط، وإنشاء تجربة تفاعلية ثلاثية الأبعاد باستخدام Three.js.
- OpenAI (Astra + Codex): يبرز التعريف الرسمي بـ Astra قدرته على تطوير المواقع والتطبيقات والألعاب، وكذلك سير عمل يشغّل فحوص جودة الواجهة الأمامية بعد التوليد.
- Anthropic (Opus + Claude Code): لا تقدّم المواد الرسمية مقارنة على المهمة نفسها. لكن اختبارًا من طرف ثالث أجرته Proofyard/Woofocus في 24 أكتوبر 2026 استخدم Opus 5.5 لإنجاز النسخة الأولى من تصميم الصفحة الرئيسية لاستوديو أثاث وتعديلها، وبلغت التكلفة 4.34 دولار وفق أسعار API. هذا الاختبار ليس مقارنة مباشرة مع Carbon وAstra المذكورين في هذا المقال.
كيف نقرأ بيانات قوائم الترتيب لـ Carbon وOpus وAstra
إلى جانب الاختبار العملي الفردي، يمكن الاطلاع على قوائم الترتيب التي تجمع نتائج مهام متعددة. جميع البيانات في الجدول أدناه مؤرّخة بتاريخ جمعها. وتعتمد درجات Elo على منهجية الاختبار في كل منصة، لذلك لا تصح المقارنة المباشرة بين قائمة وأخرى.
| قائمة الترتيب (التاريخ) | نوع الاختبار | Claude Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|
| Arena WebDev (2026-11-10) | تصويت على مواجهات تطوير الويب | 1814 (Max) | 1764 (Max) | 1768 (High، ترتيب أولي) |
| قائمة DesignArena الشاملة للوكلاء (2026-11-11) | الواجهات الأمامية، والتطوير الشامل، والألعاب، والجوال، والمستندات المكتبية وغيرها | 1440 (High)، المرتبة 1 | 1385 (Max)، المرتبة 3 | 1291، المرتبة 7 |
تقدّم Opus في القائمتين معًا، وهذا يتوافق مع الترتيب الذاتي للكاتب في اختبار إعادة بناء الموقع هنا. أما Carbon فهو قريب جدًا من Astra في قائمة WebDev، لكنه يتراجع في قائمة DesignArena الشاملة الأوسع نطاقًا. وهذا يعني أن “تطوير صفحة ويب واحدة” و”مهام التصميم المعقدة للوكلاء” بعدان مختلفان من القدرات، لذا ينبغي اختيار النموذج بما يناسب نوع مهمتك.
كيف تعيد اختبار Carbon وOpus وAstra بنفسك عبر API
نتائج الاختبار الواحد التي ينشرها الآخرون تصلح نقطة بداية فقط، أما الأساس الأكثر موثوقية فهو أن تجرّب النماذج على مهامك أنت. يرسل المثال التالي الموجّه نفسه إلى عدة نماذج بالتتابع عبر واجهة متوافقة مع OpenAI، ويسجّل زمن التنفيذ واستهلاك الـ Token. وتجدر الإشارة إلى أن هذا الاختبار يقيس مرحلة توليد الشفرة البرمجية مباشرةً من النموذج فقط، ولا يشمل استدعاءات الأدوات المتعددة الجولات ولا الفحص الذاتي عبر المتصفح، كما جرى في التقييم الأصلي مع Antigravity وClaude Code وCodex.
مثال مبسّط
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI المتوافقة مع OpenAI
)

resp = client.chat.completions.create(
    model="your-model-id",  # يُعتمد الاسم الفعلي الوارد في قائمة نماذج المنصة
    messages=[{"role": "user", "content": "输出一个单文件 HTML 食品品牌官网首屏,米白背景、居中悬浮产品罐头、酒红色弧形背景"}]
)
print(resp.choices[0].message.content[:500])
print(resp.usage)  # عرض رموز (Token) الإدخال والإخراج
عرض السكربت الكامل لإعادة اختبار عدة نماذج بالمهمة نفسها
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # مفتاح واحد لاستدعاء نماذج عدة شركات
)

# تُعتمد معرّفات النماذج من قائمة نماذج المنصة؛ وحدة السعر هي "دولار أمريكي / مليون Token"، فاملأها وفق صفحة الأسعار الرسمية
MODELS = {
    "model-a": {"input_price": 0.0, "output_price": 0.0},
    "model-b": {"input_price": 0.0, "output_price": 0.0},
    "model-c": {"input_price": 0.0, "output_price": 0.0},
}

PROMPT = """请复刻一个食品品牌官网首屏,输出单文件 HTML:
1. 米白色背景,中央悬浮产品罐头,酒红色弧形背景,橙色环绕文字;
2. 顶部包含品牌标志、语言切换和菜单按钮;
3. 罐头支持鼠标拖动旋转,悬停时有缩放反馈;
4. 同时适配 1440x900 和 390x844 两种尺寸。
只输出完整代码。"""

def run(model: str, price: dict) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": PROMPT}],
    )
    elapsed = time.time() - start
    usage = resp.usage
    cost = (usage.prompt_tokens * price["input_price"]
            + usage.completion_tokens * price["output_price"]) / 1_000_000
    html = resp.choices[0].message.content
    with open(f"{model}.html", "w", encoding="utf-8") as f:
        f.write(html)
    return {
        "model": model,
        "seconds": round(elapsed, 1),
        "input_tokens": usage.prompt_tokens,
        "output_tokens": usage.completion_tokens,
        "api_equivalent_cost": round(cost, 4),
    }

if __name__ == "__main__":
    for name, price in MODELS.items():
        try:
            print(run(name, price))
        except Exception as e:
            print(name, "调用失败:", e)
بعد انتهاء تشغيل السكربت، سيُنشأ ملف HTML لكل نموذج. بعد ذلك افحص في المتصفح التخطيط والتفاعل وأخطاء وحدة التحكم (Console) واحدًا تلو الآخر، وفق قائمة الخطوات الأربع الواردة في الجولة الثانية، ثم قارن النتائج مع زمن التنفيذ والتكلفة المكافئة لتكوّن حكمك. ولتقليل أثر التذبذب في النتائج، يُنصح بتشغيل كل نموذج ثلاث مرات على الأقل.
🚀 نصيحة للبدء السريع: عند إجراء مقارنة على المهمة نفسها، يكون أكثر ما يستنزف الوقت هو التقديم على مفاتيح API من عدة مزوّدين وملاءمة كل SDK على حدة. نوصي بإنجاز هذه الخطوة عبر APIYI على apiyi.com، إذ يكفي مفتاح API واحد لاستدعاء نماذج OpenAI وClaude وGemini وغيرها من النماذج الرئيسية، والواجهة متوافقة مع OpenAI، كما يحصل المستخدمون الجدد على رصيد تجريبي مجاني، وهو مناسب لتجربة عملية المقارنة أولًا على عيّنة صغيرة.
توصيات الاستخدام: متى تختار Carbon أو Opus أو Astra؟
بالجمع بين هذا الاختبار وبيانات التصنيفات، يمكنك إجراء فرز أولي بحسب هدف التطوير. يوضّح عمود «الأساس» في الجدول التالي نوع المصدر قدر الإمكان، لتحكم بنفسك على قيمة كل مرجع.
| هدف التطوير | الخيار الأول | الأساس | طريقة التحقق المقترحة |
|---|---|---|---|
| حساسية للتكلفة مع حاجة إلى كثير من الاستكشاف والتكرار | Gemini 4 Carbon | أقل تكلفة مكافئة لاستدعاء API في هذا الاختبار (بيانات قياس فعلية) | مقارنة التكلفة التراكمية عبر عدة جولات من المهام الصغيرة |
| الاهتمام بدقة إعادة إنتاج التصميم والتفاعلات المعقدة ودرجة الاكتمال العالية | Claude Opus 5.5 | الأفضل بين الثلاثة بحسب تقييم الكاتب الشخصي، ومتصدّر في التصنيفين | مراجعة دقة التطابق شاشة بشاشة، واختبار التفاعلات |
| الاهتمام بسرعة الإنجاز وكفاءة التنفيذ | GPT-6 Astra | الأقل زمنًا في هذا الاختبار (بيانات قياس فعلية) | قياس الزمن على المهمة نفسها + مراجعة الجودة |
| عدم التأكد من الخيار الأنسب والرغبة في تكوين فكرة أولية | إعادة اختبار الثلاثة على عيّنة صغيرة من المهمة نفسها | اختبار واحد لا يكفي للوصول إلى استنتاج | مقارنة جماعية عبر واجهة APIYI الموحّدة على apiyi.com |
متى تختار Carbon؟
- مرحلة استكشاف النماذج الأولية: عندما تحتاج إلى تجربة عدة تصاميم للصفحات بسرعة، فانخفاض تكلفة المحاولة الواحدة يعني أنك تستطيع تشغيل جولات أكثر.
- المشاريع الشخصية أو الفرق ذات الميزانية المحدودة: إذا كانت الجودة مقبولة، فسيكون الفرق في تكاليف الاستدعاء على المدى الطويل واضحًا جدًا.
- التطوير الأساسي مع مراجعة بشرية: ابدأ بـ Carbon للحصول على النسخة الأولى، ثم يتولى شخص أو نموذج آخر فحص اللمسات الأخيرة.
متى تختار Opus؟
- المواقع الرسمية للعلامات التجارية وصفحات الهبوط التسويقية: حين تكون متطلبات دقة التصميم والتفاصيل عالية، فتكلفة إعادة العمل أعلى من تكلفة الاستدعاء.
- الصفحات ذات التفاعلات المعقدة: عند كثرة العروض ثلاثية الأبعاد والسحب والحركات المرتبطة بالتمرير، تصبح درجة الاكتمال النهائية هي الأهم.
متى تختار Astra؟
- ضيق مدة التسليم: عندما تحتاج إلى صفحة كاملة قابلة للتشغيل في وقت قصير.
- الاهتمام بعملية ضمان الجودة (QA) للواجهة الأمامية: تؤكد الجهة المطوّرة على فحص الجودة بعد التوليد، ما يجعله مناسبًا لإسناد مرحلة القبول إلى سير العمل.
💡 نصيحة للاختيار: ما قدّمه هذا الاختبار هو ملاحظات مقارنة من سير عمل حقيقي، وليس ترتيبًا مطلقًا. والمعيار النهائي ينبغي أن يكون: أي خيار نجح فعلًا في إنجاز مهمتك أنت، وكم كلّف من مال ووقت. ننصحك بإجراء اختبار مصغّر آخر عبر APIYI على apiyi.com باستخدام الموجّه نفسه، ثم تقرر النموذج الرئيسي بعد ذلك.
الأسئلة الشائعة (FAQ)
س1: ما الذي يقيسه اختبار Carbon وOpus وAstra على موقع واحد؟
يقيس قدرة ثلاث منظومات عمل، كل منها يجمع «نموذجًا + أداة تطوير»، على إعادة بناء الموقع الرسمي لـ Agrumea Farm. يشمل ذلك بنية الصفحة، والأسلوب البصري، ودوّار العلب ثلاثي الأبعاد، والتمرير والسحب، وحركات التحميل والتمرير فوق العناصر، والانتقال بين الصفحات، والتصميم المتجاوب. المعيار هنا هو دقة استنساخ التصميم، وليس الذوق الإبداعي.
س2: لماذا جاء Carbon في المرتبة الأخيرة عند صاحب التقييم رغم أنه الأرخص؟
التكلفة والجودة بعدان مستقلان. يستهلك Carbon أقل عدد من رموز الإدخال (Tokens) وتكلفته المكافئة هي الأدنى. لكن لقطات الشاشة تُظهر أن نسبة العلب فيه أصغر من الأصل، وأن بعض تفاصيل النصوص أضعف، فلم يتفوق بمعيار «دقة الاستنساخ». الرخص لا يعني الرداءة، لكن صاحب التقييم فضّل في مهمة الاستنساخ هذه اكتمال العمل الذي قدّمه Opus.
س3: متى أُجري هذا الاختبار؟ وهل ستتقادم نتائجه؟
نُشر التقييم في 11 نوفمبر 2026. أُنجز اختبارا Opus وAstra في 6 نوفمبر، واختبار Carbon بين 10 و11 نوفمبر، وهو ما يوافق توسيع إتاحة Carbon في 10 نوفمبر. تتطور النماذج والأدوات بسرعة، لذا الأفضل التعامل مع الاستنتاجات بوصفها مرجعًا للمرحلة الحالية فقط.
س4: ما الفرق بين التكلفة المكافئة عبر API ورسوم الاشتراك؟
التكلفة المكافئة عبر API تقدير مبني على عدد الرموز المستخدمة وسعر الوحدة في API، وهي تعكس الاستهلاك الفعلي للنموذج. أما رسوم الاشتراك فهي سعر شهري يُحسب وفق الحصة وقواعد تجديدها. في المهمة نفسها قد تستهلك الأداة ذات الاشتراك الشهري جزءًا من الحصة فقط، بينما يولّد الاستدعاء بالاستهلاك فاتورة مباشرة. عند الاختيار، احسب التكلفة وفق طريقة الفوترة التي ستعتمدها فعليًا.
س5: كيف أقارن بسرعة نتائج تطوير الويب بين هذه الأنواع الثلاثة من النماذج عبر API؟
يمكنك اتباع سكربت إعادة الاختبار الوارد في هذا المقال:
1. سجّل في APIYI عبر apiyi.com واحصل على مفتاح API ورصيد اختبار مجاني.
2. اضبط `base_url` على `https://api.apiyi.com/v1`، وتأكد من أسماء النماذج التي تريد مقارنتها في قائمة النماذج على المنصة.
3. استدعِ النماذج واحدًا تلو الآخر بالموجه نفسه، وسجّل زمن التنفيذ واستهلاك الرموز (Tokens)، ثم افحص الصفحات الناتجة في المتصفح.
س6: هل يمكن لاستدعاء API واحد أن يعيد إنتاج نتائج التقييم الأصلي؟
لا، ليس بالكامل. جرى التقييم الأصلي داخل Antigravity وClaude Code وCodex، وتضمّن عدة جولات من قراءة الملفات وكتابتها وفحصًا ذاتيًا عبر المتصفح، واستغرق كل اختبار أكثر من ساعة. الاستدعاء الواحد يقيس فقط قدرة النموذج على توليد الشفرة مباشرة، ويناسب الفرز الأولي. أما لتقريب النتيجة من الاختبار الأصلي فتحتاج إلى بناء مسار عمل لوكيل (Agent) يتضمن التحقق عبر المتصفح.
س7: ما حدود هذا الاختبار؟
هناك ثلاث نقاط رئيسية: كل نموذج لم يُشغَّل إلا مرة واحدة، ولذلك قد تكون النتائج مجرد صدفة؛ كما اختلفت بيئات الأدوات وتواريخ الاختبار بين النماذج الثلاثة، فلا يمكن عزل أداء النموذج نفسه؛ والترتيب يعكس تقييم الكاتب الشخصي. وإضافةً إلى ذلك، لا تثبت لقطات الشاشة الثابتة أن التفاعلات نُفِّذت بالكامل. لذلك يصلح الاختبار مثالًا مرجعيًا، لكنه لا يصلح تصنيفًا عامًا يُعتمد عليه مباشرة.
أبرز النقاط حول Carbon وOpus وAstra (Key Takeaways)
- طبيعة الاختبار: مهمة واحدة هي استنساخ موقع رسمي، شُغِّلت فيها مسارات العمل الثلاثة مرة واحدة لكل منها. هذه مقارنة جانبية من واقع الاستخدام الفعلي.
- دقة استنساخ التصميم: يرى الكاتب أن Opus الأفضل بين الثلاثة، يليه Astra، ثم Carbon في المرتبة الأخيرة.
- السرعة: كان Astra الأسرع، إذ استغرق 68 دقيقة، أي نحو نصف الوقت الذي استغرقه Opus.
- التكلفة: بلغت تكلفة Carbon المكافئة 10.86 دولارًا، أي نحو 18% من تكلفة Opus و12% من تكلفة Astra.
- هيكل التكلفة: يعتمد تطوير الوكلاء (Agents) في الغالب على رموز الإدخال (Tokens)، ولذلك يتحدد حجم الفاتورة أيضًا بسعر الوحدة وقواعد التخزين المؤقت.
- مرجع التصنيفات: يتصدر Opus التصنيف العام في Arena WebDev وDesignArena، لكن معايير القياس تختلف من تصنيف إلى آخر.
- طريقة البدء: عبر APIYI (apiyi.com) يمكنك استخدام مفتاح واحد لإعادة اختبار النماذج على المهمة نفسها بعينة صغيرة، ثم تحديد النموذج الأساسي الذي ستعتمد عليه.
الخلاصة
خرجنا من مقارنة Carbon وOpus وAstra على موقع واحد بثلاث نتائج رئيسية:
- الجودة: في مهمة استنساخ الموقع هذه، نال عمل Opus أعلى تقييم من كاتب التقييم، إذ برز فيه المنتج الرئيسي وظهر التسلسل البصري بين العناصر بوضوح أكبر.
- السرعة: أنهى Astra المهمة في 68 دقيقة فقط، وهذا يناسب المشاريع التي تضيق فيها مواعيد التسليم.
- التكلفة: تكلفة Carbon المكافئة عبر API أقل بكثير من تكلفة النموذجين الآخرين، وهو خيار مناسب للتجارب المتكررة والميزانيات المحدودة.
النماذج الثلاثة كلها قادرة اليوم على إنجاز تطوير ويب عالي الجودة. الفرق بينها هو في المفاضلة بين دقة المطابقة البصرية، وتنفيذ التفاعلات، والوقت المستغرق، والتكلفة. بدلًا من البحث عن النموذج الأقوى على الإطلاق، حدّد هدفك من التطوير أولًا، ثم جرّب النماذج فعليًا على المهمة نفسها. يمكنك عبر APIYI على apiyi.com إعادة الاختبار على عدة نماذج من خلال واجهة موحدة، وأن تجعل الأعمال التي نجحت فعلًا مع تكلفتها الحقيقية أساسًا لقرار الاختيار.
📚 المراجع
- Gemini 4 Carbon: No-Hype Full Review & Testing: تقييم أجراه Pat Simmons / AI for Mortals، أعاد فيه بناء الموقع نفسه لاختبار النماذج، بتاريخ 2026-11-11
- الرابط:
aiformortals.co/blog/gemini-4-carbon-review -
ملاحظة: المصدر الرئيسي لإعدادات الاختبار في هذا المقال، ولبيانات المدة المستغرقة وعدد الرموز (Tokens) والتكلفة المكافئة عبر API
-
صفحات الأعمال الثلاثة المُعاد بناؤها: الأعمال المنشورة لكل من Carbon وOpus 5.5 وAstra
- الروابط:
aiformortals.co/builds/agrumea-clone-gemini-4-carbon،aiformortals.co/builds/agrumea-clone-opus-5-5،aiformortals.co/builds/agrumea-clone-gpt-6-astra -
ملاحظة: يمكنك فتحها في المتصفح وتجربة التفاعلات بنفسك
-
الموقع الرسمي لـ Agrumea Farm: الموقع الأصلي الذي جرى عليه الاختبار
- الرابط:
agrumeafarm.it/en -
ملاحظة: يُستخدم للمقارنة ومعرفة مدى دقة إعادة البناء
-
لوحة Arena WebDev: لوحة تصنيف تعتمد على تصويت المواجهات في تطوير الويب
- الرابط:
arena.ai/leaderboard/code/webdev -
ملاحظة: يعتمد المقال على بيانات 2026-11-10
-
لوحة DesignArena: لوحة تصنيف شاملة للتصميم بأسلوب الوكلاء (Agentic)
- الرابط:
designarena.ai/leaderboard -
ملاحظة: يعتمد المقال على بيانات 2026-11-11، وهي تغطي أنواعًا متعددة من مهام التصميم
-
مدونة Google الرسمية: إعلان إتاحة Gemini 4 Carbon
- الرابط:
blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/ -
ملاحظة: يوضح الموقع الرسمي لـ Carbon في تصميم الواجهات الأمامية والتحقق عبر المتصفح
-
التعريف الرسمي من OpenAI: GPT-6 Astra
- الرابط:
openai.com/index/gpt-6-astra/ -
ملاحظة: يشرح سير عمل Astra في تطوير الويب وفحص جودة الواجهات الأمامية (QA)
-
اختبار Woofocus: مقارنة بين نماذج Claude المختلفة في تصميم الويب، بتاريخ 2026-10-24
- الرابط:
app.woofocus.com/blog/best-claude-model-for-web-design - ملاحظة: مرجع إضافي لمهام التصميم والتعديل مع Opus 5.5، وليس مقارنة مباشرة بين النماذج الثلاثة
المؤلف: فريق APIYI التقني
للتواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI، وللمزيد من مواد الربط والتكامل يمكنكم زيارة مركز التوثيق docs.apiyi.com