ملاحظة الكاتب: بعد أن أصبح بوسع الهواتف والمتصفحات توليد الكلام محليًا، هل ما زلنا بحاجة إلى واجهات API الصوتية السحابية؟ يقدّم هذا المقال حكمًا من أربعة أبعاد: العمل دون اتصال، والخصوصية، وجودة الصوت مع النصوص الطويلة، وتحديد النموذج مع الفوترة الموحدة.
أصبحت أنظمة الهواتف والمتصفحات قادرة أكثر فأكثر على قراءة النص بصوت عالٍ محليًا. لذلك صار سؤال هل نحتفظ بواجهة API الصوتية السحابية بعد وصول الصوت على الجهاز؟ سؤالًا لا يستطيع أي فريق يبني منتجًا صوتيًا تجاهله. يرى البعض أن الأفضل الانتقال إلى الحل المحلي بالكامل لتوفير تكاليف الاستدعاء، ويخشى آخرون أن تعجز الأصوات المحلية عن حمل منتج رسمي.
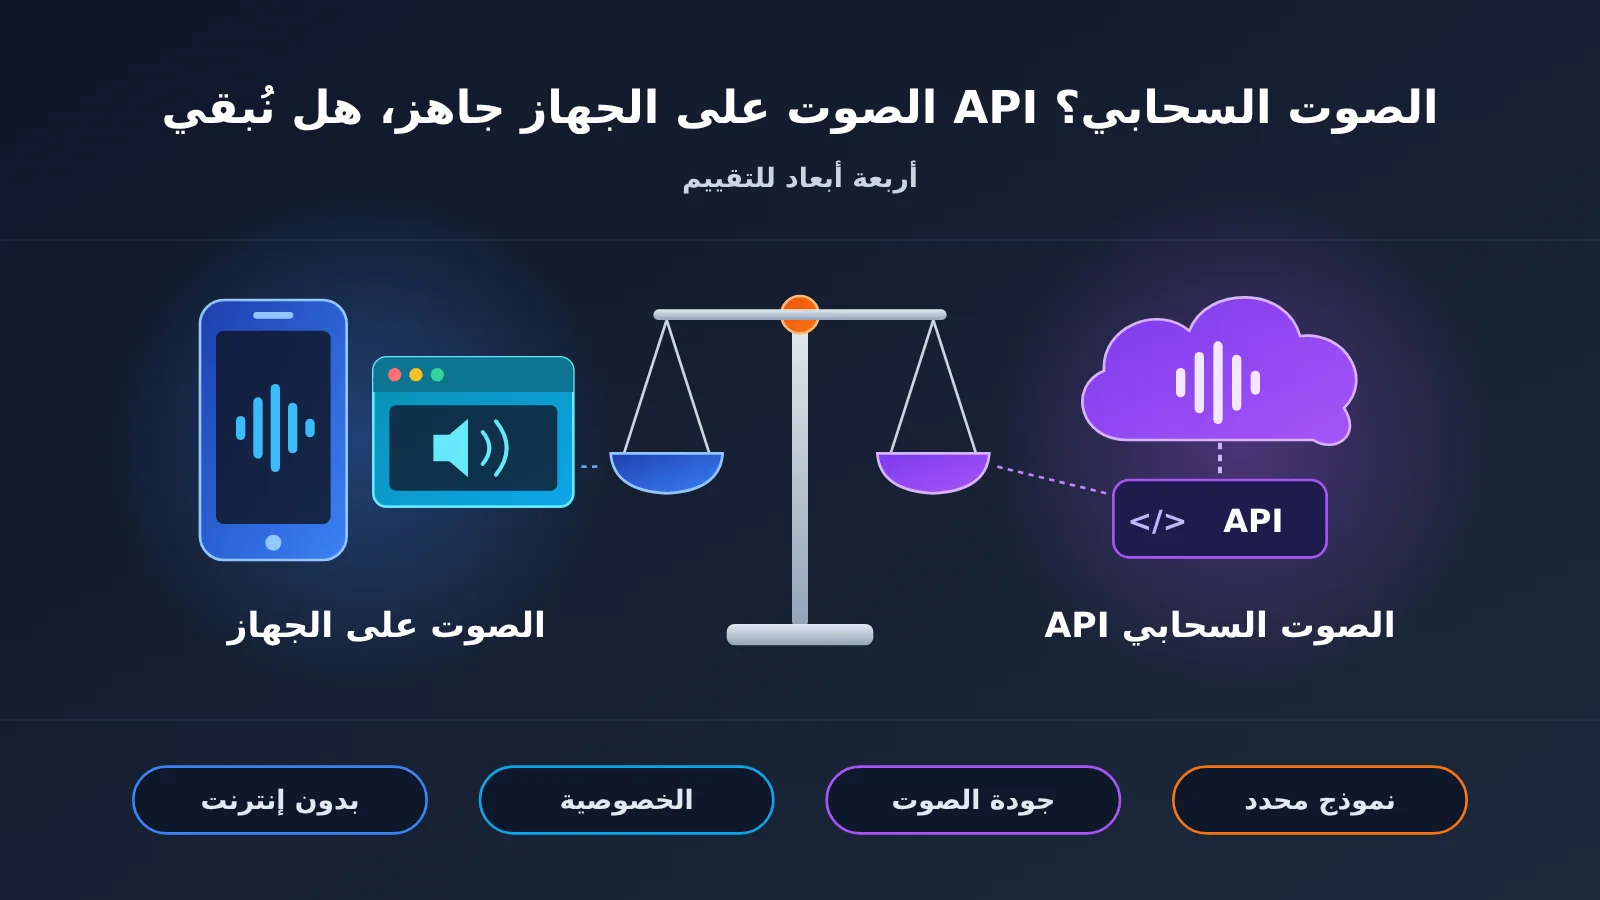
ليس هذا اختيارًا بين خيارين لا ثالث لهما. لكل من الجهاز والسحابة حدوده، والقرار يعتمد على ما إذا كان منتجك يحتاج إلى العمل دون اتصال، ومدى حساسيته للخصوصية، وما يتطلبه من جودة صوت ودعم للنصوص الطويلة، وهل يجب أن يستخدم نموذجًا محددًا بعينه.
القيمة الأساسية: بعد قراءة هذا المقال ستتمكن من الحكم، بُعدًا بعد بُعد، على كيفية توزيع العمل بين الجهاز والسحابة في منتجك، دون حلول جاهزة تُطبَّق على الجميع.
الصوت على الجهاز وصل: ملخص سريع للمعلومات الأساسية
لنفصل أولًا بين ما يمكن تأكيده وما لا يزال مجهولًا. الاتجاه العام للصوت على الجهاز واضح، لكن لا توجد أرقام عامة قابلة للمقارنة عن زمن الاستجابة وجودة الصوت لأي نموذج محلي بعينه. لذلك لا يخمّن هذا المقال، ويصنّف هذه البيانات “غير معروفة”.
| البند | التفاصيل |
|---|---|
| ما الذي تغيّر | صار بإمكان نظام الهاتف والمتصفح تحويل النص إلى كلام محليًا دون اتصال بالإنترنت |
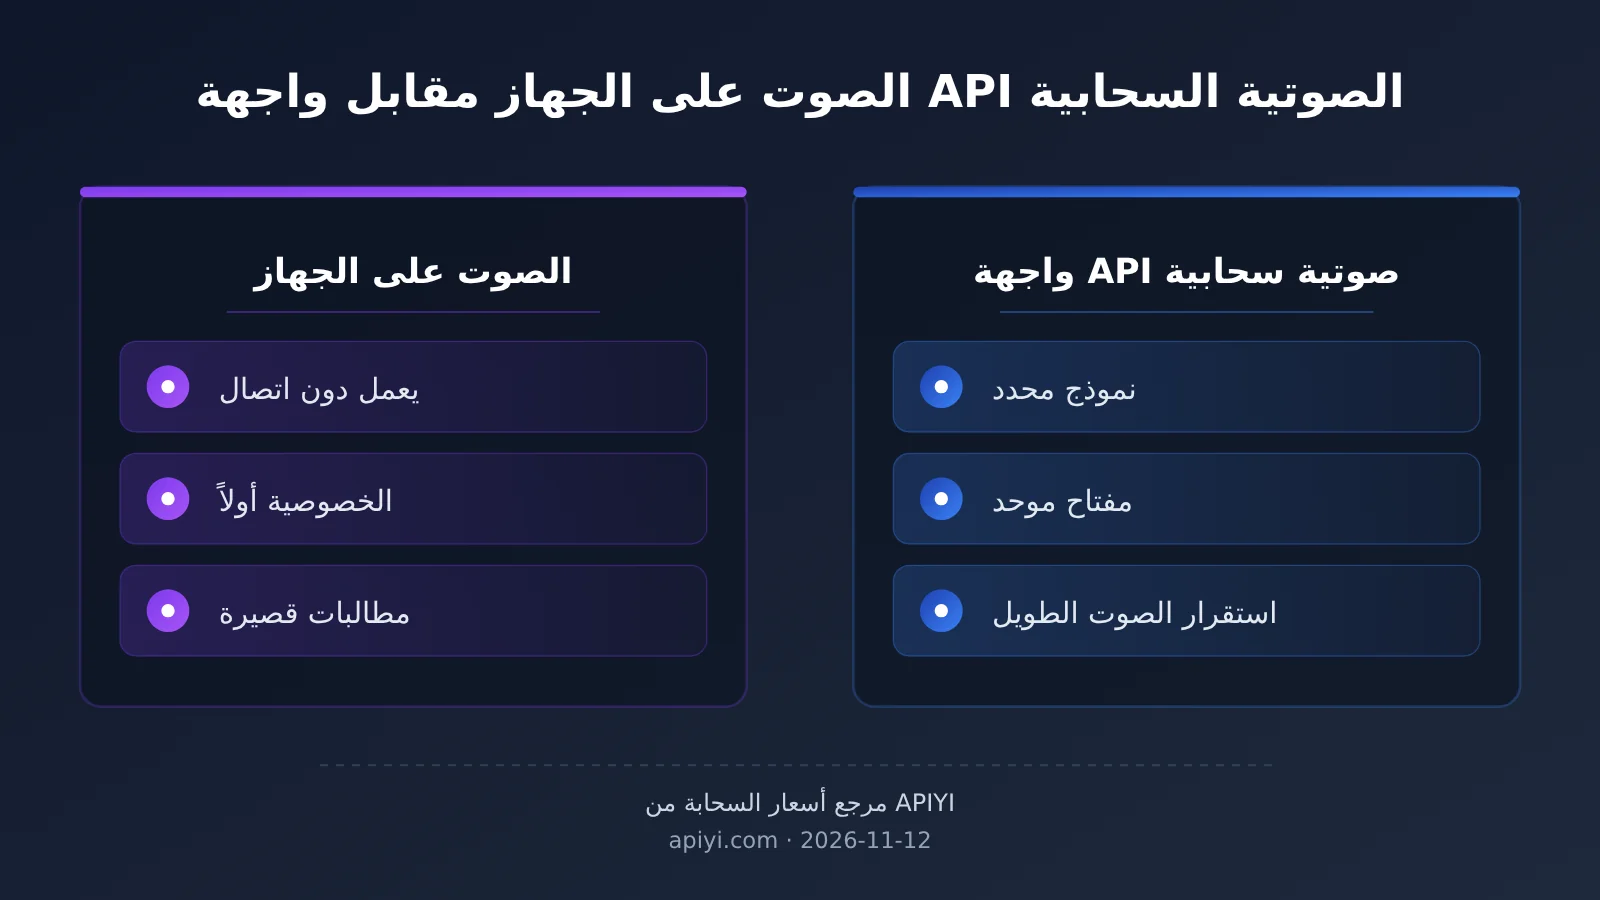
| نقاط قوة الجهاز | يعمل دون اتصال، والبيانات لا تغادر الجهاز، ومناسب للجمل القصيرة |
| المجهول على الجهاز | لا توجد بيانات عامة موحدة عن زمن الاستجابة وتقييم جودة الصوت لكل حل على الجهاز، لذا نعدّها غير معروفة |
| نقاط قوة السحابة | يمكن تحديد نموذج بعينه، ومشاركة مفتاح API واحد مع نماذج النصوص، وثبات أفضل مع الكلام الطويل |
| النماذج السحابية المتاحة | حتى 2026-11-12 لا تزال قائمة أسعار APIYI تتضمن tts-1 وtts-1-hd وgpt-realtime-2.1 وgpt-realtime-2.1-mini |
| الفئات المتأثرة | فرق المنتجات التي تبني ميزات الإعلان الصوتي والمساعدات الصوتية والمحادثات الصوتية الفورية |
ما الذي يستطيع الصوت على الجهاز فعله، وما الذي لا يضمنه
أوضح فائدة للصوت على الجهاز هي أن الصوت يعمل حتى دون شبكة. تنبيهات الملاحة، وأدوات مساعدة القراءة، والأصوات القصيرة داخل التطبيقات سيناريوهات تتميز بجمل قصيرة وتكرار عالٍ، والتوليد المحلي يكفيها ويوفر رحلة شبكة كاملة. وبقاء البيانات على الجهاز يخفف كثيرًا من ضغط الامتثال للمنتجات التي تتعامل مع نصوص حساسة كالصحة والمال.
لكن الأصوات والجودة التي يقدمها الصوت على الجهاز تعتمد على جهاز المستخدم نفسه. فالمنتج الواحد قد ينطق بصوت مختلف تمامًا على هواتف من علامات تجارية مختلفة أو إصدارات نظام مختلفة، ويصعب على المطوّر ضمان تجربة متسقة. أما مقدار بطء أي نموذج على الجهاز مقارنةً بالسحابة، أو مقدار تراجع جودة صوته، فلا توجد حاليًا أرقام عامة موثوقة عنه. لذا ينبغي أن يستند الحكم إلى عيّنات من الأجهزة الحقيقية لمنتجك.
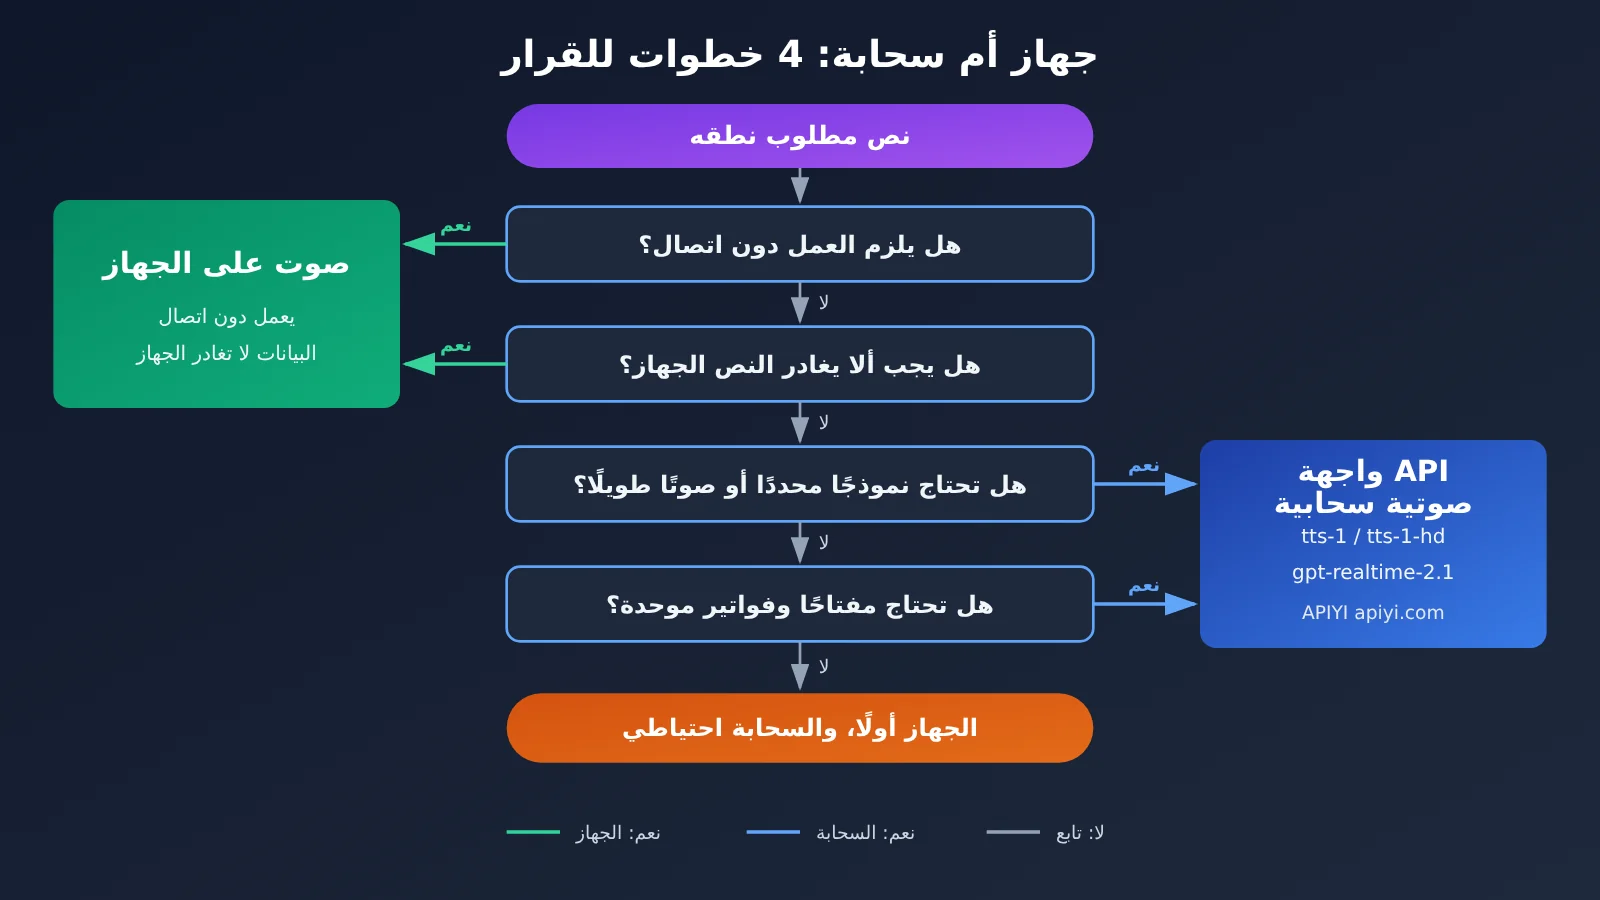
كيف توزّع الأدوار بين الصوت على الجهاز وواجهة API الصوتية السحابية
تقسيم المسألة إلى 4 أبعاد أنفع من الجدل حول “هل نُبقي السحابة أم لا”. يوضح الجدول التالي الطرف الأنسب في كل بُعد، والسؤال الذي تطرحه على نفسك عند اتخاذ القرار.
| بُعد القرار | الأنسب للصوت على الجهاز | الأنسب لواجهة API الصوتية السحابية | السؤال الذي تطرحه عند القرار |
|---|---|---|---|
| العمل دون اتصال | يجب أن يصدر الصوت بلا شبكة أو مع شبكة ضعيفة | المستخدمون متصلون بالإنترنت في الغالب | هل يجب أن يواصل المنتج النطق عند انقطاع الشبكة؟ |
| الخصوصية | نصوص حساسة لا يُسمح بخروجها من الجهاز | يمكن رفع النص ومعالجته | هل تمنع متطلبات الامتثال خروج البيانات من الجهاز الطرفي؟ |
| جودة الصوت والنصوص الطويلة | جمل قصيرة ونغمات تنبيه، ولا حاجة إلى جودة صوت عالية | قراءة نصوص طويلة، وحاجة إلى اتساق عالٍ في timbre الصوت | هل يمكن قبول أن تنطق الأجهزة المختلفة بأصوات مختلفة؟ |
| تحديد النموذج وتوحيد الفوترة | لا حاجة إلى ذلك | يلزم تثبيت نموذج بعينه واستخدام مفتاح واحد مع نموذج النص | هل تحتاج إلى نموذج محدد مثل tts-1-hd أو gpt-realtime-2.1؟ |
العمل دون اتصال والخصوصية: ميدان الصوت على الجهاز
إذا كان منتجك يُستخدم كثيرًا في المترو أو المناطق الجبلية أو على متن الطائرات، فالعمل دون اتصال شرط أساسي، ويجب أن يتولى الصوت على الجهاز الجزء الأكبر من النطق. وبالمثل، إذا كانت سياسة العمل تمنع رفع النصوص التي يدخلها المستخدم، فالصوت على الجهاز هو الخيار الوحيد تقريبًا. في هذين البُعدين يكون دور واجهة API الصوتية السحابية أقرب إلى “تحسين عند توفر الشبكة” منه إلى دور أساسي.
الجودة والنصوص الطويلة وتحديد النموذج: ميدان واجهة API الصوتية السحابية
متى احتاج المنتج إلى صوت موحّد يعبّر عن هوية العلامة، أو إلى قراءة مقالات طويلة بثبات، أو إلى محادثة صوتية فورية، يصعب الاستغناء عن السحابة. فهي تتيح تحديد النموذج صراحةً، مثل استخدام tts-1 للنطق العادي، وtts-1-hd لجودة صوت أعلى، وgpt-realtime-2.1 أو gpt-realtime-2.1-mini للمحادثة الفورية، فيسمع جميع المستخدمين مخرجات النموذج نفسه.
ثمة نقطة أخرى كثيرًا ما تُهمَل، وهي إدارة الفواتير والمفاتيح. فإلى جانب الصوت، تستدعي معظم المنتجات نموذج لغة كبيرًا للنصوص من أجل الفهم أو التلخيص أو توليد الحوار. وإذا استخدم الصوت والنص مفتاح API نفسه وفاتورة واحدة، تصبح عمليات التشغيل ومطابقة الحسابات أبسط بكثير.
كيف تربط واجهة API الصوتية السحابية: أبقِ قناة مستقرة
حتى لو قررت أن تعتمد على المعالجة داخل الجهاز في المقام الأول، يُستحسن أن تُبقي قناة سحابية احتياطية، تعمل كشبكة أمان وكوسيلة لتحسين الجودة. يعتمد APIYI واجهة متوافقة مع OpenAI، لذلك يشبه الربط تقريبًا استخدام الحزمة البرمجية الرسمية (SDK)، وكل ما عليك هو استبدال base_url.
يمكن تلخيص خطوات الربط على النحو التالي:
- تهيئة العميل:
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1") - استدعاء تحويل النص إلى كلام:
client.audio.speech.create(model="tts-1", voice="alloy", input="您的订单已发货") - إذا احتجت إلى جودة صوت أعلى، فاستبدل قيمة model بـ
tts-1-hdواترك بقية المعاملات كما هي - يشير النموذج النصي أيضًا إلى
https://api.apiyi.com/v1، ويشترك الصوت والنص في مفتاح API نفسه
أما المحادثة الصوتية الفورية (سلسلة gpt-realtime-2.1) فتختلف طريقة الاتصال بها عن طلبات HTTP العادية، وتُرجع معاملات الربط التفصيلية إلى ما ورد في مركز وثائق APIYI.
| النموذج | النوع | الاستخدام النموذجي | المنصة المتاحة |
|---|---|---|---|
| tts-1 | تحويل النص إلى كلام | الإعلانات الصوتية العادية، قراءة الإشعارات | APIYI apiyi.com |
| tts-1-hd | تحويل النص إلى كلام (جودة عالية) | قراءة النصوص الطويلة، الأصوات الخاصة بالعلامة التجارية | APIYI |
| gpt-realtime-2.1 | محادثة صوتية فورية | المساعدات الصوتية، التفاعل الفوري | APIYI |
| gpt-realtime-2.1-mini | محادثة صوتية فورية (خفيف) | السيناريوهات الفورية الأكثر حساسية للتكلفة | APIYI |
🚀 ابدأ بسرعة: إذا كنت تقيّم ما إذا كان الأفضل الإبقاء على الصوت السحابي، فسجّل أولًا في APIYI apiyi.com، واستفد من رصيد الاختبار المجاني للمستخدمين الجدد، ثم مرّر النص نفسه إلى tts-1 وtts-1-hd، وقارن النتيجة بالقراءة المحلية على الجهاز، لتعرف هل الفرق في الجودة يستحق أن تدفع مقابله.
تأثير انتشار الصوت على الجهاز
التأثير على المطورين
- تحوّل البنية من خيار واحد إلى بنية هجينة: تحتاج وحدة الصوت إلى طبقة توجيه تقرر، بحسب حالة الشبكة وحساسية النص وطوله، هل تعمل على الجهاز أم في السحابة
- ارتفاع تكلفة الاختبار: يعتمد الأداء على الجهاز على جهاز المستخدم، لذا يلزم اختبار عيّنات من أجهزة ومتصفحات مختلفة، بينما يكون ناتج السحابة متسقًا نسبيًا
- أصبح منطق الاحتياط ضروريًا: عند فشل السحابة يُخفَّض الأداء إلى الجهاز، وعند تعذّر الجهاز يُعاد التوجيه إلى السحابة، فيكون كل مسار نسخة احتياطية للآخر
التأثير على بنية المنتج
أكثر طرق تطبيق البنية الهجينة شيوعًا هي تحديد قناة افتراضية وقناة احتياطية لكل نوع من مهام الصوت. يمكنك اعتماد الجدول التالي نقطة بداية للتصميم.
| مهمة الصوت | القناة الافتراضية | القناة الاحتياطية | السبب |
|---|---|---|---|
| التنبيهات القصيرة وإرشادات الملاحة الصوتية | الصوت على الجهاز | السحابة tts-1 | الجمل القصيرة تكفيها المعالجة المحلية، ويجب أن تعمل دون اتصال |
| قراءة النصوص الحساسة | الصوت على الجهاز | لا يُخفَّض إلى السحابة | يجب ألا تغادر البيانات الجهاز |
| المقالات الطويلة والمحتوى الصوتي | السحابة tts-1-hd | الصوت على الجهاز | اتساق الصوت واستقرار أكبر في المقاطع الطويلة |
| المحادثة الصوتية الفورية | السحابة gpt-realtime-2.1 | gpt-realtime-2.1-mini | يلزم تحديد النموذج، والتفاعل الفوري يعتمد على السحابة |
التأثير على حساب التكاليف
لا يُحتسب الصوت على الجهاز بحسب عدد الاستدعاءات، وهذا ما يدفع كثيرًا من الفرق إلى التفكير في نقل الصوت كله إلى الجهاز. لكن انتبه: قد يتحول ما توفره من رسوم الاستدعاء إلى تكاليف تكييف واختبار، وإلى خسارة مستخدمين بسبب تراجع التجربة على الأجهزة منخفضة المواصفات. الأسلوب الأنسب هو نقل الجمل القصيرة عالية التكرار فقط إلى الجهاز، وترك المهام الحساسة للجودة على السحابة. بهذا ينخفض حجم الاستدعاءات السحابية تلقائيًا دون أن تتأثر التجربة الأساسية.
الأسئلة الشائعة FAQ
س1: بعد اعتماد الصوت على الجهاز، هل يمكنني إيقاف واجهة API الصوتية السحابية مباشرة؟
لا ننصح بذلك في أغلب المنتجات. فالمعالجة على الجهاز تحل مشكلتي العمل دون اتصال والخصوصية، لكن اختيار نموذج بعينه، وثبات الأداء مع المقاطع الصوتية الطويلة، واتساق الصوت تظل كلها معتمدة على السحابة. الأسلم أن يكون الجهاز هو الخيار الأساسي، وأن تعمل السحابة كخيار احتياطي ومُحسِّن للنتائج.
س2: ما الفرق في جودة الصوت وزمن الاستجابة بين الصوت على الجهاز وواجهة API الصوتية السحابية؟
لا توجد حاليًا أرقام تقييم عامة وموحدة يمكن الاستشهاد بها، كما يختلف أداء كل حل على الجهاز باختلاف الجهاز نفسه، لذلك نتعامل مع هذه النقطة على أنها غير معروفة. نقترح أن تجرّب الاستماع إلى عينات على عدة أجهزة يستخدمها مستخدموك المستهدفون كثيرًا، ثم تقارنها بمخرجات tts-1 وtts-1-hd السحابيَّين.
س3: ما نماذج الصوت السحابية التي لا يزال بإمكاني استدعاؤها حتى الآن؟
حتى 2026-11-12، لا تزال قائمة أسعار APIYI تتضمن tts-1 وtts-1-hd، إضافةً إلى نموذجي الصوت الفوري gpt-realtime-2.1 وgpt-realtime-2.1-mini. قد تتغير قائمة النماذج في أي وقت، فالمرجع هو قائمة الأسعار الحالية على المنصة.
س4: كيف أستدعي نماذج الصوت والنصوص معًا بمفتاح واحد؟
احصل على مفتاح API واحد من APIYI عبر apiyi.com، واضبط base_url على `https://api.apiyi.com/v1`. بعد ذلك تمر كل الطلبات من نقطة دخول واحدة: تحويل النص إلى كلام، والصوت الفوري، ونماذج النصوص مثل GPT وClaude وGemini. وتُجمع الفواتير في حساب واحد، فيسهل عليك مطابقة الاستهلاك بحسب الاستخدام.
س5: ماذا أفعل إذا فشل الاستدعاء السحابي في البنية الهجينة؟
أضف طبقة تراجع في موجّه الصوت (voice routing). فإذا انتهت مهلة الطلب السحابي أو ظهر خطأ، يمكن إسناد الجمل القصيرة غير الحساسة إلى القراءة على الجهاز، أما المقاطع الصوتية الطويلة فيمكن أن تطلب من المستخدم إعادة المحاولة لاحقًا. وفي سيناريوهات المحادثة الفورية يمكنك التبديل بين gpt-realtime-2.1 وgpt-realtime-2.1-mini.
أهم النقاط: الصوت على الجهاز مقابل واجهات API الصوتية السحابية Key Takeaways
- ليست مفاضلة بين خيارين: الصوت على الجهاز وواجهات API الصوتية السحابية يتقاسمان العمل، وتُوزَّع المهام على كل قناة بحسب طبيعتها
- الجهاز يتولى العمل دون اتصال والخصوصية: يعمل بلا شبكة، وتبقى البيانات داخل الجهاز، ويناسب الجمل القصيرة ونغمات التنبيه
- السحابة تتولى الجودة والاتساق: الصوت الطويل، وأصوات العلامة التجارية، والمحادثة الفورية ما زالت تحتاج إلى نماذج سحابية
- تحديد نموذج بعينه لا يتم إلا عبر السحابة: لتثبيت tts-1-hd أو gpt-realtime-2.1 لا بد من استخدام API
- أداء الجهاز غير معروف: حيث لا توجد أرقام منشورة، فالمرجع هو قياساتك على أجهزتك أنت
- مفتاح موحّد يخفّف عبء التشغيل: عبر APIYI (apiyi.com) يمكن لنماذج الصوت والنص أن تشترك في مفتاح API واحد وفاتورة واحدة
الخلاصة
بعد أن أصبح الصوت على الجهاز متاحًا، هل ما زلنا بحاجة إلى واجهات API الصوتية السحابية؟ يعتمد الجواب على أربعة أبعاد:
- العمل دون اتصال: المهام التي يجب أن تعمل بلا إنترنت تُسند إلى الصوت على الجهاز
- الخصوصية: المهام التي لا يجوز أن يغادر نصها الجهاز تعمل على الجهاز فقط
- جودة الصوت والصوت الطويل: المهام التي تتطلب اتساقًا واستقرارًا تبقى في السحابة
- تحديد النموذج والفاتورة الموحّدة: المهام التي تحتاج إلى تثبيت نموذج محدد، أو إلى مشاركة مفتاح واحد مع نماذج النص، تواصل استخدام واجهة API السحابية
الخلاصة واضحة: الجهاز يحل مشكلتي العمل دون اتصال والخصوصية، أما تحديد النموذج والفاتورة الموحّدة فيبقيان من نصيب السحابة. نقترح أن تنقل الجمل القصيرة كثيرة الاستخدام إلى الجهاز أولًا، وأن تُبقي الصوت الطويل والمحادثة الفورية في السحابة. ويمكنك عبر APIYI (apiyi.com) استدعاء سلاسل tts-1 وtts-1-hd وgpt-realtime-2.1 من مكان واحد، ثم تجربتها بالرصيد المجاني للاختبار والتحقق من النتائج قبل أن تقرر نسبة كل قناة.
📚 المراجع
- مركز وثائق APIYI: شرح تركيب الكلام والاتصال بالكلام الفوري
- الرابط:
docs.apiyi.com -
الوصف: اطّلع على معاملات الاستدعاء وطرق الربط الخاصة بنماذج مثل tts-1 وgpt-realtime-2.1
-
مركز مساعدة APIYI: دروس استخدام المنصة والأسئلة الشائعة
- الرابط:
help.apiyi.com - الوصف: مناسب للرجوع إليه عند أول ربط، ويشمل طلب المفتاح (Key) والفوترة وقائمة النماذج
المؤلف: فريق APIYI التقني
للتواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI على apiyi.com، ويمكنكم الاطلاع على مزيد من المواد في مركز الوثائق docs.apiyi.com