
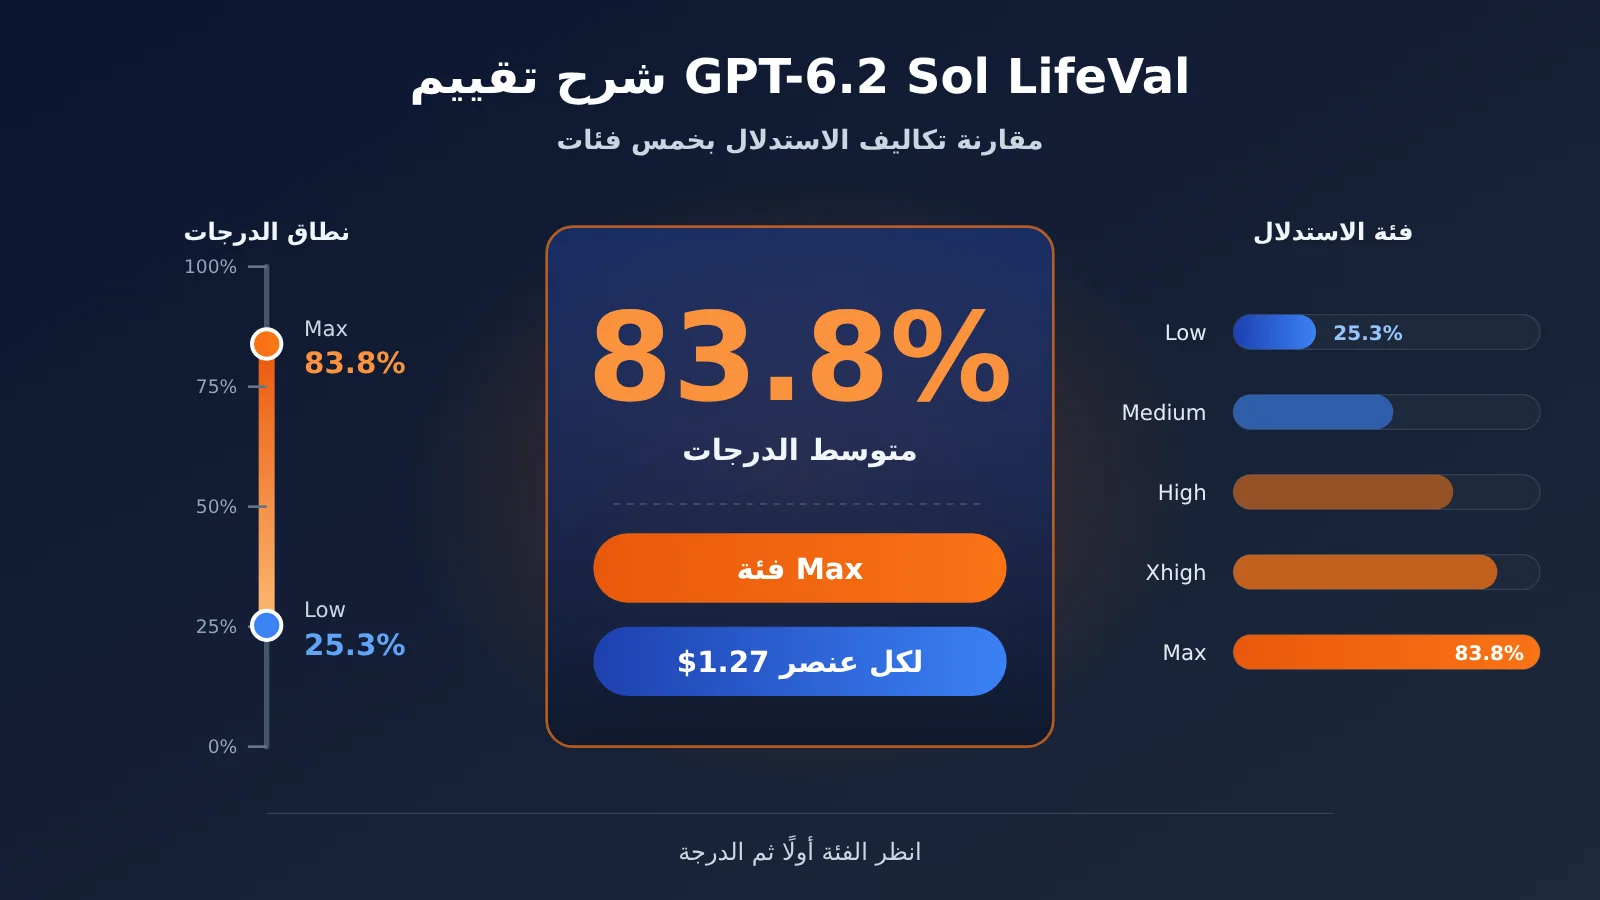
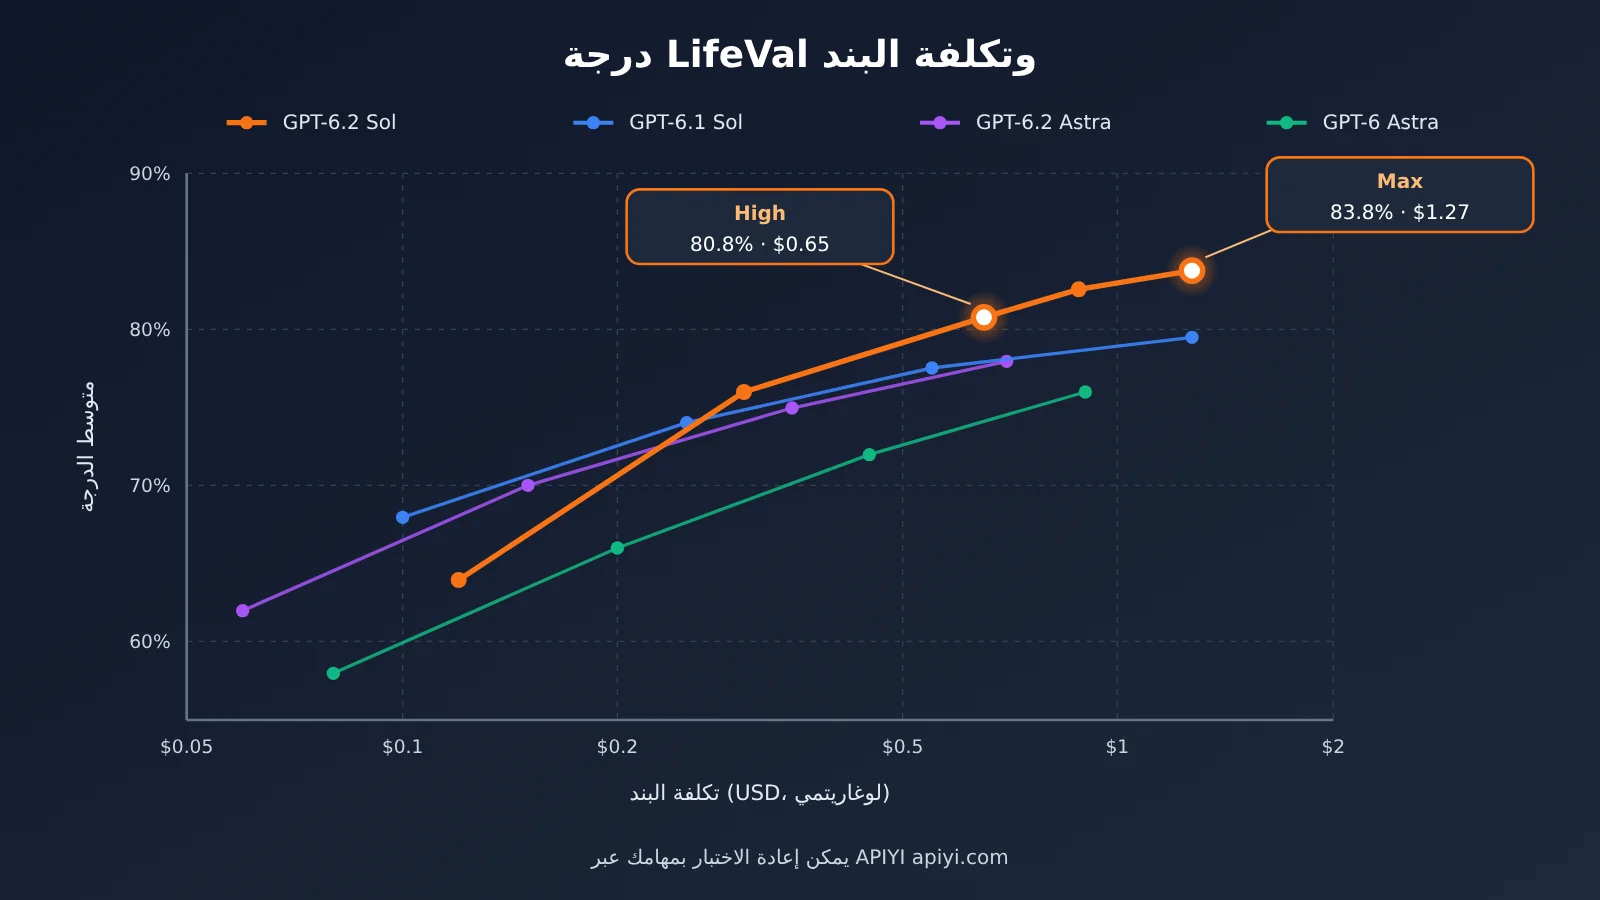
83.8% لا تعني «إنجاز 83.8% من المهام بالكامل»، بل هي متوسط درجة LifeVal التي سجّلها GPT-6.2 Sol في مستوى الاستدلال Max. تُحتسب هذه الدرجة بمنح نقاط لكل مهمة وفق معايير التقييم الخاصة بها، ثم تُجمع، ويقابلها متوسط تكلفة للمهمة الواحدة يبلغ $1.27. أما النموذج نفسه في مستوى Low فيبلغ متوسط درجته 25.3% فقط، وفي مستوى High يبلغ المتوسط 80.8% بتكلفة $0.65 للمهمة. لذلك، عند الحديث عن أداء GPT-6.2 Sol في LifeVal، لا بد أولاً من تحديد المستوى المقصود.
الخلاصة: ما تنشره القوائم الرسمية هو «مزيج من الدرجات والتكاليف في مهام وبيئات محددة»، وليس ترتيباً عاماً يمكن نقله كما هو إلى منتجك. وفي بيانات LifeVal هذه، يُعدّ مستوى High نقطة البداية الجديرة بالاختبار أولاً. أما المستوى الذي ستستخدمه فعلاً، فيجب أن تحدده بمهامك أنت، وبمعايير قبول تعتمد على النواتج والحالة الفعلية.
ماذا ستستفيد من قراءة هذا المقال؟
- ما المهام التي يقيسها LifeVal، وكيف ينبغي التعبير عن 83.8% تعبيراً صحيحاً.
- درجات وتكاليف مستويات الاستدلال الخمسة في GPT-6.2 Sol، والمقارنة مع GPT-6.1 Sol وGPT-6 Astra وGPT-6.2 Astra في المستوى نفسه.
- كيف يمكن أن يكون حديث الجهات الرسمية عن «تكلفة نحو السُّبع» و«الانخفاض الكبير في مستوى Low» صحيحين في الوقت نفسه.
- كيف نستعير منهجية القبول في LifeVal لتصميم مهام تقييم قابلة لإعادة الاختبار لمساعدينا اليوميين.
الفهرس: يشرح جدول To Know أولاً المصطلحات التقييمية التي سنحتاجها لاحقاً، وتوضح نظرة التأثير السريعة ما ينبغي أن يهتم به المستخدم العادي والمطوّر كلٌّ على حدة. أما قسم الحقائق الموضوعية فيعرض بالترتيب مصدر مهام LifeVal وطريقة احتساب الدرجات، ثم بيانات المستويات في الرسم المنشور في 17 نوفمبر. ويبدأ قسم التحليل والاستنتاج بتفكيك مقامات عدة مقارنات، ثم يقدّم نموذجاً للقبول يمكن إعادة كتابته مباشرة لمساعد الطريق والمواعيد، ويشرح حدود الانتقال.
ما يجب معرفته: المفاهيم الأساسية لفهم تقييم LifeVal للنموذج GPT-6.2 Sol
| المفهوم | شرح مختصر |
|---|---|
| LifeVal | معيار تستخدمه OpenAI لقياس أداء مساعد الذكاء الاصطناعي في إنجاز مهام رقمية يومية مخصصة |
| السياق المخصص | معلومات مثل تفضيلات المستخدم والسجلات السابقة والظروف الخاصة بالمهمة، وهي تغيّر ما يُعد «إجابة مقبولة» |
| قواعد التقييم | تقسيم إنجاز المهمة إلى مجموعة من المتطلبات القابلة للتحقق بندًا بندًا |
| بيئة مضبوطة | بيئة تقييم تُضبط فيها التطبيقات والبيانات والحالة الابتدائية مسبقًا، لتسهيل التحقق من نتائج الإجراءات |
| فرق حالة الخادم الخلفي | تغيّر حالة التطبيق المسجّل قبل الاختبار وبعده، ويُستخدم للتأكد من أن عمليات الأدوات قد طُبقت فعلًا |
| متوسط قيمة المكافأة | مؤشر مجمّع لدرجات كل مهمة وفق قواعد التقييم؛ والنسب المئوية في مخطط النشر هي هذا النوع من «متوسط الدرجات» |
| شدة الاستدلال | درجة تتحكم في مقدار الاستدلال الذي يخصصه النموذج؛ يقارن هذا المقال بين المستويات Low وMedium وHigh وXhigh وMax |
| تكلفة العنصر الواحد | متوسط تكلفة كل مهمة في مخطط التقييم، ويتغير تبعًا لاستخدام النموذج وأسعاره |
نظرة سريعة على تأثير GPT-6.2 Sol LifeVal
- المستخدم العادي: حين ترى “83.8%”، فَهِمها على أنها “متوسط الدرجات في مجموعة من المهام اليومية لمستخدمين ناطقين بالإنجليزية الأمريكية”، وليست معدل نجاح. كذلك انتبه إلى أن الفارق بين مستويات الاستدلال المختلفة للنموذج الواحد كبير جدًا، وأن تجربة المنتج تتحدد بالمستوى الذي يختاره مطور التطبيق.
- مدير المنتج: مستوى Low هو الأقل سعرًا، لكن درجاته هذه المرة في LifeVal متأخرة بفارق كبير عن مستوى Low في Sol من الجيل السابق. وإذا أُعيد استخدام إعدادات المستويات من النسخة القديمة عند الترقية، فقد نقع في حالة “تغيير النموذج إلى الأحدث يجعل النتائج أسوأ”.
- مطور API: ما يستحق الاقتباس هو تصميم القبول في LifeVal، أي تقييم التسليمات وحالة البيئة والإجابة كلًّا على حدة. واستخدام نفس دفعة المهام الخاصة بك للمقارنة الأفقية بين مستويات Low وMedium وHigh أكثر موثوقية من الاقتباس المباشر لأرقام لوحات التصنيف.
حقائق موضوعية: ما المهام التي تستخدمها GPT-6.2 Sol LifeVal لاختبار النموذج
نشأة LifeVal والخط الزمني للإصدار
LifeVal هو تقييم من OpenAI لقياس مهام الوكيل اليومية المخصصة. تاريخ صفحة البحث لدى OpenAI هو 2 نوفمبر 2026، وتاريخ الورقة البحثية المرافقة هو 3 نوفمبر. وفي 17 نوفمبر، أصدرت OpenAI نموذجي GPT-6.2 Astra وGPT-6.2 Sol، وأرفقت في صفحة الإصدار مخطط LifeVal يعرض درجات الفئات الخاصة بالنماذج الجديدة (معرّف المخطط lifeval-v2).
استُمد توزيع المهام في الورقة من دراسات استخدام الوقت في الولايات المتحدة وعدد من البلدان، واستند أيضًا إلى استطلاع حول الاستعداد للدفع شمل جمهورًا أمريكيًا، واختُصرت الأنشطة اليومية في النهاية إلى 148 فئة. واستخدمت تجارب الورقة 169 مهمة. يجدر بالذكر أن النماذج التي قيّمتها الورقة نفسها لا تتجاوز GPT-6 Astra، أما أرقام فئات سلسلة GPT-6.2 فقد ظهرت فقط في الرسم الرسمي الذي نُشر لاحقًا.
وفقًا للتوصيف الرسمي، يستهدف Sol المهام اليومية عالية التكرار، والبرمجة الروتينية، والوكلاء متعددي الخطوات القابلين للتوسع، بينما يستهدف Astra مهام الاستدلال الأكثر صعوبة والمخرجات المهنية. ويتوافق هذا التوصيف مع “مهام المساعد اليومية” التي يقيسها LifeVal.
تصميم مهام LifeVal: المتطلب نفسه، وإجابات مقبولة تختلف باختلاف المستخدم
تتميز LifeVal بالطابع الشخصي. فمثلاً عند مقارنة المدارس بعد الانتقال، تختلف الإجابة المقبولة باختلاف عمر الأطفال ومسار التنقل وتفضيلات المنطقة التعليمية. وكذلك عند البحث عن سكن بموازنة بين الميزانية وزمن التنقل، فإن الحد الأعلى للميزانية ومدة التنقل المقبولة تحددان مباشرةً أي العروض العقارية تُعد نتائج مقبولة.
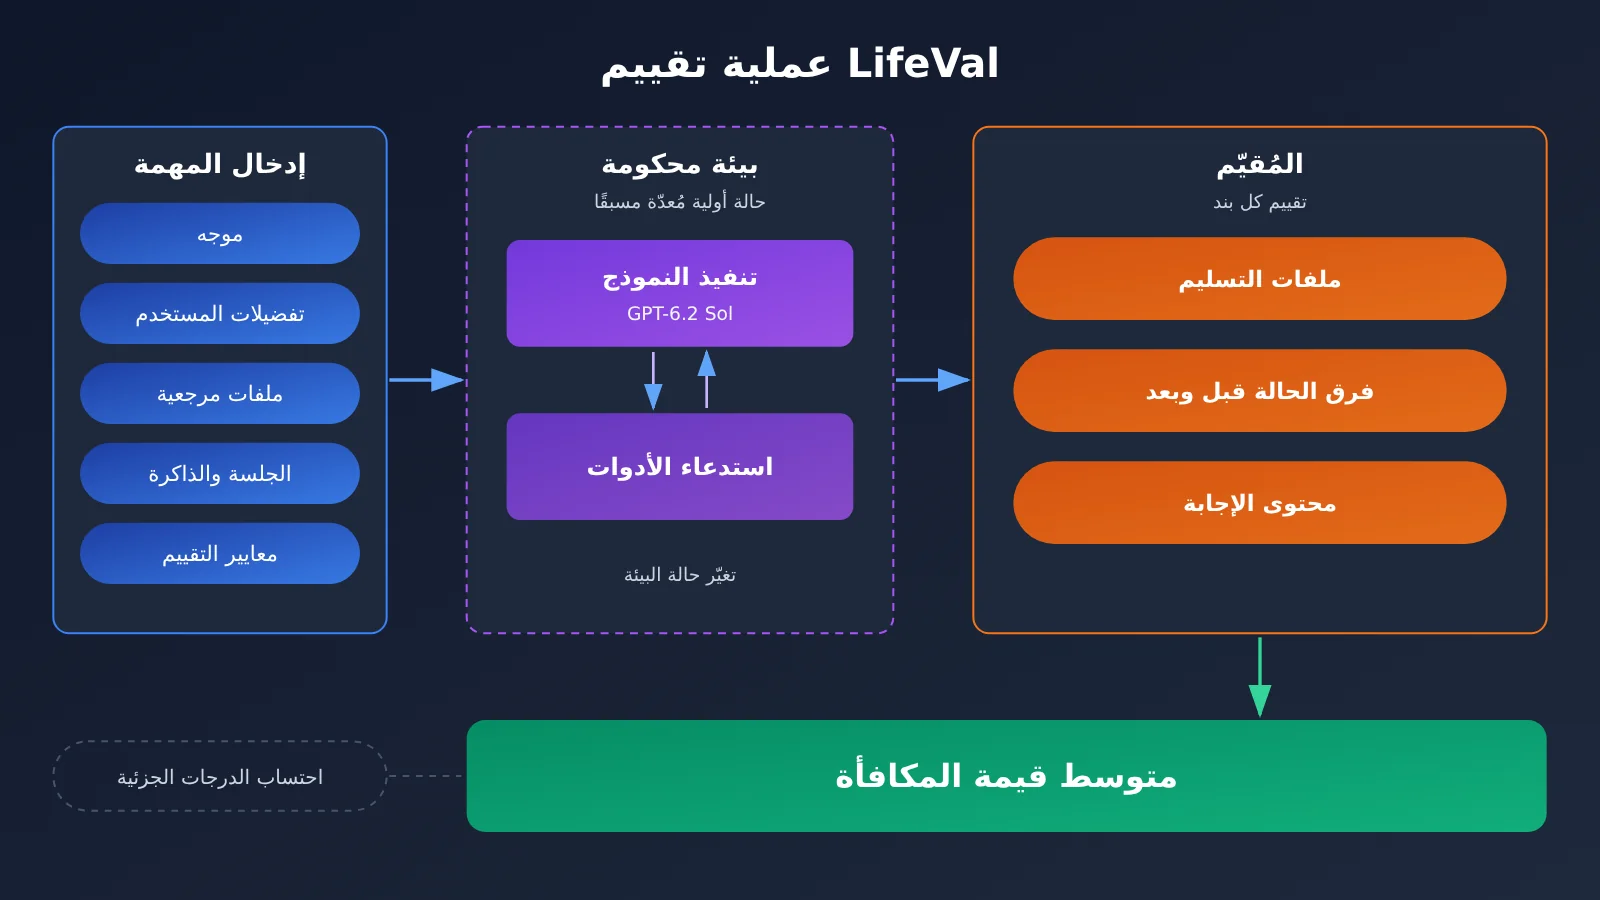
وفقًا لمنهجية الورقة، تتضمن كل مهمة موجهًا وتفضيلات المستخدم وملفات مرجعية وجلسات وذاكرة ذات صلة ومعايير تقييم، إضافة إلى بيئة مضبوطة جاهزة بحالة مُهيأة مسبقًا. وبعد انتهاء التنفيذ، يستطيع المقيّم التحقق من ثلاثة أشياء: الملفات التي سلّمها النموذج، والحالة قبل وبعد للبيئة التي تعمل عليها الأدوات، وإجابة النموذج؛ ثم يمنح درجات منفصلة بحسب كل متطلب من متطلبات المهمة.
لماذا يمكن القول فقط إن 83.8% هي «متوسط الدرجة»
المحور الرأسي في رسم نتائج الورقة البحثية يمثل متوسط قيمة المكافأة. لذلك يجب التعبير عن 83.8% على أنها «متوسط الدرجة»، ولا يجوز كتابتها على أنها «83.8% من المهام تم تنفيذها بنجاح كامل». فالمهمة قد تحقق جزءًا فقط من بنود التقييم، ومع ذلك تساهم بجزء من الدرجة.
كما ذكرت الورقة عدة قيود: فبعض المعلومات في البيئة غير المتصلة وفي صفحات الويب المخزنة مؤقتًا ما زالت تتغير مع الوقت، وعينة المشاركين تتكون أساسًا من مستخدمين ناطقين بالإنجليزية وموجهين نحو السوق الأمريكية. وهذا يعني أن الدرجات لا يمكن تعميمها مباشرة على مناطق أخرى أو لغات أخرى أو منظومات تطبيقات أخرى.
رسم إصدار GPT-6.2 Sol LifeVal: الدرجات الخمس وتكلفة البند الواحد
يُقرأ الجدول التالي من البيانات العامة لرسم LifeVal التفاعلي المنشور في صفحة إصدار OpenAI بتاريخ 17 نوفمبر 2026. كل خلية تعرض «متوسط الدرجة / متوسط تكلفة كل مهمة (USD)»، وهي بيانات تقييم عامة أعلنتها OpenAI بنفسها، وليست قياسات مستقلة من جهة خارجية.
| النموذج | Low | Medium | High | Xhigh | Max |
|---|---|---|---|---|---|
| GPT-6.2 Sol | 25.3% / $0.089 | 70.3% / $0.38 | 80.8% / $0.65 | 82.6% / $0.88 | 83.8% / $1.27 |
| GPT-6.1 Sol | 66.8% / $0.52 | 75.5% / $0.73 | 77.1% / $0.88 | 77.8% / $0.96 | 79.5% / $1.27 |
| GPT-6.2 Astra | 46.3% / $0.59 | 78.9% / $1.56 | 83.1% / $2.41 | 83.7% / $2.94 | 86.1% / $4.23 |
| GPT-6 Astra | 67.5% / $3.51 | 74.3% / $5.30 | 76.0% / $6.52 | 77.5% / $6.94 | 79.8% / $9.04 |
يقول نص الإعلان الرسمي: في LifeVal، سجلت Sol درجة أعلى من GPT-6 Astra وبتكلفة تقارب سُبع تكلفته. وهنا تكون جهة المقارنة هي الطراز الرائد من الجيل السابق GPT-6 Astra، وليس GPT-6.2 Astra من الجيل نفسه. أما المجموعة الأخرى من المقارنات في الإعلان، وهي الخاصة بـ FrontierCode 2.0، فهي التي تستخدم GPT-6.2 Astra، فلا تخلط بين نتيجتي المجموعتين عند القراءة.
📌 ملاحظة عن أساس البيانات: «تكلفة البند الواحد» في الجدول هي متوسط من رسم التقييم الرسمي، وتتأثر بطول المدخلات وطول المخرجات واستخدام الأدوات في ذلك التقييم. أما تكلفة مهمتك الخاصة فتحتاج إلى إعادة قياسها بطلبات حقيقية، ويمكنك عبر APIYI apiyi.com أن تشغّل بمفتاح API واحد مختلف مستويات Sol بالترتيب، ثم تقارن الفاتورة مباشرة.
معلومات الوصول إلى API الخاصة بنموذج GPT-6.2 Sol
معرّف نموذج API هو gpt-6.2-sol، ويمكن استدعاؤه عبر Responses وChat Completions. استدعاء الدوال والأدوات المدمجة يسلك مسار Responses، وكلا نقطتي النهاية لا تقبلان مستوى الاستدلال none. السعر القياسي الرسمي للسياق القصير (Standard) هو 2.00 دولار للإدخال و10.00 دولارات للإخراج (دولار أمريكي / مليون توكن، ويشمل الإخراج توكنات الاستدلال)، وهو السعر نفسه المطبّق على GPT-6.1 Sol.
اعتبارًا من 20 نوفمبر 2026، أصبحت القائمة العامة للنماذج وواجهة التسعير في APIYI تُدرجان gpt-6.2-sol، مع تحديد مدخلي responses وchat. تسعير الفئة القصيرة متطابق مع السعر الرسمي، أما المجموعات المتاحة فعليًا ونطاق المعاملات والفوترة فتخضع لإعدادات APIYI الحالية على apiyi.com ولبيانات فاتورتك.
تحليل وتقييم: كيف يتحقق «سُبع التكلفة» وتراجع Low في LifeVal لنموذج GPT-6.2 Sol في الوقت نفسه
أولاً: توحيد أطراف المقارنة والمقام
قد يقرأ المرء من الرسم البياني نفسه انطباعين متضادين: «تقدّم كبير» و«تراجع واضح»، والسبب الجذري هو اختلاف أطراف المقارنة والفئة. جميع الفروق والنسب في الجدول أدناه محسوبة اعتماداً على القيم المعلنة رسمياً.
| مجموعة المقارنة | قيم الطرفين | فرق الدرجات | علاقة التكلفة |
|---|---|---|---|
| 6.2 Sol Max مقابل الجيل السابق الرائد GPT-6 Astra Max | 83.8%/$1.27 مقابل 79.8%/$9.04 | +4.0 نقطة مئوية | نحو 14.0%، أي «حوالي السُبع» |
| 6.2 Sol Max مقابل 6.1 Sol Max | 83.8%/$1.27 مقابل 79.5%/$1.27 | +4.3 نقطة مئوية | التكلفة نفسها |
| 6.2 Sol Low مقابل 6.1 Sol Low | 25.3%/$0.089 مقابل 66.8%/$0.52 | −41.5 نقطة مئوية | التكلفة أقل، لكن الدرجات تراجعت بشدة |
| 6.2 Sol Medium مقابل 6.1 Sol Medium | 70.3%/$0.38 مقابل 75.5%/$0.73 | −5.2 نقطة مئوية | التكلفة نحو النصف |
| 6.2 Sol High مقابل 6.1 Sol Max | 80.8%/$0.65 مقابل 79.5%/$1.27 | +1.3 نقطة مئوية | نحو النصف |
| 6.2 Sol Max مقابل 6.2 Astra Max | 83.8%/$1.27 مقابل 86.1%/$4.23 | −2.3 نقطة مئوية | نحو 30% |
في هذه الأرقام، تصف «النقطة المئوية» فرق متوسط الدرجات، بينما تصف «نسبة التكلفة» نسبة متوسط التكلفة لكل عنصر، ولا يمكن تحويل إحداهما إلى الأخرى. عبارة «السُبع» لا تنطبق إلا على مجموعة «6.2 Sol Max مقابل GPT-6 Astra Max». أما إذا قارنّا مع GPT-6.2 Astra في الفترة نفسها، فإن Sol في فئة Max تكون أقل بـ 2.3 نقطة مئوية.
💡 تلميح لاختيار النموذج: قد يكون الفرق بين فئتين ضمن النموذج نفسه أكبر من الفرق بين نموذجين مختلفين. نوصي أولاً بتشغيل جولة مقارنة بين الفئات على APIYI apiyi.com باستخدام مجموعة مهام ثابتة، ثم تحديد الفئة الافتراضية، بدلاً من إعادة استخدام إعدادات فئة النموذج القديم مباشرة.
إشارات فئة Low: الترقية لا تعني «الاستبدال الأعمى»
بلغت فئة Low في 6.2 Sol نسبة 25.3% فقط في LifeVal، أي أقل بـ 41.5 نقطة مئوية من 6.1 Sol Low. تشير مواد الإصدار الرسمية إلى أن Sol يستهلك عددًا أقل من رموز الخروج (output tokens) في عدة مهام، وأن متوسط التكلفة لكل مهمة في فئة Low يبلغ $0.089 فقط. من المعقول افتراض أن الاستدلال المنخفض لا يكفي لتغطية قيود التفضيلات وعمليات الأدوات في المهام الشخصية متعددة الخطوات. لكن هذا مجرد افتراض؛ فلم تقدّم الجهات الرسمية تفسيرًا لتراجع فئة Low.
بالنسبة لفرق المنتجات، التأثير مباشر. إذا كان تطبيقك يستخدم سابقًا فئة Low على 6.1 Sol لتقليل التكلفة، فإن مجرد تبديل معرّف النموذج دون تعديل الفئة قد يؤدي إلى انخفاض واضح في جودة المهام اليومية المعقدة. في المقابل، سجّلت فئة Max أعلى بـ 4.3 نقطة مئوية من الجيل السابق Sol عند التكلفة نفسها لكل مهمة، ما يشير إلى أن السقف الأعلى للنموذج الجديد قد ارتفع فعلًا.
لماذا تُعد فئة High الخيار الأول للاختبار في هذا التقييم
من High إلى Xhigh ثم إلى Max في 6.2 Sol، بلغت الزيادات المتتالية 1.8 و1.2 نقطة مئوية فقط، بينما ارتفع متوسط التكلفة لكل مهمة بـ $0.23 و$0.39 على التوالي. حققت فئة High نسبة 80.8% بتكلفة $0.65، وهي أعلى من فئة Max في 6.1 Sol وفئة Max في GPT-6 Astra. وبالنظر إلى LifeVal وحدها، تُعد High نقطة البداية «الأكثر توازنًا بين الجودة والتكلفة».
غير أن هذا الحكم يقوم على ثلاثة شروط: أن يكون توزيع المهام قريبًا من LifeVal، وأن تكون اللغة وبيئة التطبيق قريبة من سيناريوهات مستخدمي الإنجليزية الأمريكية، وأن يكون هيكل التكلفة قريبًا من نسبة الإدخال إلى الإخراج في هذا التقييم. إذا اختل أي شرط منها، فقد تتغير النتيجة. عمليًا، الأسلم أن تبدأ من High، ثم تحدد بناءً على معدل تحقيق أهداف مهامك الخاصة ما إذا كنت ستنزل إلى Medium أو تصعد إلى Xhigh أو Max.
التحليل والتقييم: تحقق من مساعدك GPT-6.2 Sol بمنهجية LifeVal
بناء مهمة رحلة عائلية منخفضة المخاطر
أكثر ما يستحق الاقتباس من LifeVal ليس الدرجات نفسها، بل أسلوب «التحقق حسب المخرجات والحالة». فيما يلي مثال على رحلة عائلية: نُسلّم المساعد مسبقًا ثلاثة قيود صارمة، وهي نقطة الانطلاق والوجهة، وظروف التنقل الخالية من العوائق، وسقف الميزانية، ثم نطلب منه تسليم حلول مرشحة مصحوبة بمسارات قابلة للتحقق، إلى جانب مسودة جدول زمني قابلة للتعديل.
| بند التقييم | طريقة الفحص | هل يمكن أتمتته |
|---|---|---|
| هل تحقق قيد المواقع؟ | تطابق نقطة البداية والنهاية في الخطة مع المُدخل | قابل للفحص آليًا |
| هل تحققت ظروف إمكانية الوصول؟ | يغطي وصف المسار متطلبات إمكانية الوصول بشكل صريح | آلي جزئيًا، يحتاج إلى فحص بشري بالعينة |
| هل بقيت الميزانية ضمن الحد؟ | تحليل المبالغ الواردة في الخطة ومقارنتها بالسقف الأعلى | قابل للفحص آليًا |
| هل تدعم الروابط المعلومات؟ | الرابط متاح للوصول ومحتواه متوافق مع الخطة | يتطلب مراجعة بشرية |
| هل ملف مسودة الجدول الزمني موجود؟ | فحص الحالة قبل وبعد لملف الإخراج أو إدخال التقويم | قابل للفحص آليًا |
| هل يستفسر عند غياب معلومات أساسية؟ | حذف معلومات مثل التاريخ عن قصد، وملاحظة ما إذا كان يسأل من تلقاء نفسه | يتطلب حكمًا بشريًا |
تقابل هذه البنود مسارات التحقق الثلاثة في LifeVal: المخرجات (مسودة الجدول الزمني)، وتغيّر الحالة (هل كُتب الملف أو الإدخال فعلاً)، وجودة الإجابة (تحقق القيود والاستفسار التلقائي). شغّل المجموعة نفسها من المهام على Low وMedium وHigh، ثم قرر المستوى الابتدائي بناءً على نسبة تحقق الشروط والتكلفة معًا.
مثال مبسّط: استدعاء GPT-6.2 Sol وتسجيل استهلاك الاستدلال
يستدعي المثال التالي النموذج gpt-6.2-sol عبر واجهة Responses، ويقرأ في الوقت نفسه رموز الإخراج وما تتضمنه من رموز الاستدلال، ما يسهّل حساب تكلفة كل بند لاحقًا.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI المتوافقة مع OpenAI
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "high"},
    input="请为我规划周六的家庭出行:从家到市立博物馆,需全程无障碍,交通预算不超过 200 元,并给出日程草稿。"
)
print(resp.output_text)
print(resp.usage.output_tokens, resp.usage.output_tokens_details.reasoning_tokens)
عرض سكربت مقارنة المستويات (Low / Medium / High)
import re
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # مفتاح واحد يكفي لمقارنة عدة مستويات
)

# أسعار Standard للسياق القصير، بالدولار الأمريكي لكل مليون رمز (الإخراج يشمل رموز الاستدلال)
PRICE_IN, PRICE_OUT = 2.00, 10.00

TASKS = [
    {
        "prompt": "从家到市立博物馆,周六上午出发,全程无障碍,交通预算不超过 200 元。"
                  "请给出带路线说明的候选方案,并输出一份日程草稿。",
        "budget": 200,
        "must_include": ["无障碍", "博物馆"],
    },
    {
        # التاريخ ناقص عن قصد، لاختبار ما إذا كان النموذج يبادر بالسؤال
        "prompt": "帮我安排一次带老人去公园的出行,预算 100 元以内,需要无障碍路线。",
        "budget": 100,
        "must_include": ["无障碍"],
        "expect_question": True,
    },
]

def check(task, text):
    """يمنح الدرجة بندًا بندًا وفق معايير التقييم، ويعيد درجة بين 0 و1"""
    items = []
    items += [kw in text for kw in task["must_include"]]
    amounts = [float(x) for x in re.findall(r"(\d+(?:\.\d+)?)\s*元", text)]
    items.append(bool(amounts) and max(amounts) <= task["budget"])
    if task.get("expect_question"):
        items.append("?" in text or "?" in text)
    return sum(items) / len(items)

for effort in ["low", "medium", "high"]:
    scores, cost = [], 0.0
    for task in TASKS:
        resp = client.responses.create(
            model="gpt-6.2-sol",
            reasoning={"effort": effort},
            input=task["prompt"],
        )
        u = resp.usage
        cost += u.input_tokens / 1e6 * PRICE_IN + u.output_tokens / 1e6 * PRICE_OUT
        scores.append(check(task, resp.output_text))
    print(f"{effort:>6}: 平均得分 {sum(scores)/len(scores):.1%}, "
          f"平均单项费用 ${cost/len(TASKS):.4f}")
الفحوص التلقائية في السكربت لا تغطي إلا بنود التقييم القابلة للتحقق آليًا، أما صحة الروابط وجودة الأسئلة التوضيحية فما زالت تحتاج إلى مراجعة بشرية على عيّنة. وأما قيم معاملات مستويات الاستدلال (خصوصًا السلاسل النصية المقابلة لـ Xhigh وMax) فيُرجى اعتماد وثائق المنصة الرسمية الحالية ووصف المعاملات في القناة المستخدمة.
🚀 البدء السريع: سجّل عبر APIYI apiyi.com لتحصل على رصيد اختبار مجاني. توفر المنصة واجهة متوافقة مع OpenAI، ويكفي أن تستبدل المفتاح في السكربت أعلاه ليعمل مباشرة، وهو مناسب لتنفيذ جولة قبول على عينة صغيرة قبل الاختيار الرسمي للفئة.
حدود نقل استنتاجات GPT-6.2 Sol LifeVal
عند نقل استنتاجات LifeVal إلى منتجك الخاص، عليك أن تضع في الحسبان ثلاثة اختلافات على الأقل. الأول هو اللغة والمنطقة: عينة الورقة البحثية يغلب عليها مستخدمون من الإنجليزية الأمريكية، أما في السياق الصيني فمنظومة تطبيقات الخرائط والدفع والتقويم مختلفة تمامًا. الثاني هو البيئة: يعمل LifeVal في بيئة خاضعة للتحكم وفي صفحات ويب مخزَّنة مؤقتًا، بينما يصطدم المنتج الحقيقي بتقلبات الشبكة وفشل ترخيص الأدوات واختلاف حالات الحساب. الثالث هو هيكل التكلفة: التكلفة الرسمية للبند الواحد تقابلها نسبة المدخلات والمخرجات في ذلك التقييم، والطلبات ذات السياق الطويل التي تتجاوز 272K من المدخلات تنتقل كليًا إلى فئة سعرية أعلى، وقد تكون تكلفة البند الواحد بعيدة جدًا عن الأرقام في الجدول.
لذا فإن الاستخدام الأكثر منطقية هو: تعامل مع الجداول الرسمية كأساس «لتضييق نطاق المرشحين»، ومجموعة مهامك الخاصة كأساس «للقرار النهائي». وفي حالة المساعد اليومي المعقّد، يمكنك أولاً بناء خط أساس بفئة High، ثم اختبار ما إذا كانت Medium قادرة على الحفاظ على القيود الصارمة الأساسية، وما إذا كانت Xhigh أو Max تقلّلان بشكل واضح من إعادة العمل اليدوي، ثم احكم بمعدل الإنجاز الفعلي وبالفاتورة.
وبعد أن تصبح مجموعة مهامك ومعايير التقييم وفحوصات البيئة جاهزة، يصبح ترقية النموذج ليس «تغيير النموذج بناءً على لوحة الترتيب»، بل عملية هندسية قابلة لإعادة الاختبار في كل مرة. وعندما تحتاج إلى المقارنة المتكررة بين عدة نماذج وفئات، يمكنك الاستعانة بالواجهة الموحدة لـ APIYI apiyi.com لوضع GPT-6.2 Sol وGPT-6.2 Astra وغيرهما داخل مجموعة واحدة من سكربتات القبول وتشغيلها.
المراجع
-
إعلان إصدار OpenAI GPT-6.2 Astra و Sol (مع مخطط تصنيفات LifeVal)
- الرابط:
openai.com/zh-Hans-CN/index/introducing-gpt-6-2-astra-sol - الوصف: صدر في 2026-11-17، وهو مصدر بيانات التصنيفات في هذا المقال
- الرابط:
-
صفحة بحث LifeVal والورقة البحثية
- الرابط:
openai.com/index/lifeval،cdn.openai.com/pdf/lifeval.pdf - الوصف: مصدر المهام، وطريقة التقييم، وشرح القيود (الورقة §3–§5)
- الرابط:
-
بطاقة نموذج GPT-6.2 Sol والتسعير الرسمي
- الرابط:
developers.openai.com/api/docs/models/gpt-6.2-sol - الوصف: مواصفات نافذة السياق، وقواعد حساب تكلفة السياق القصير والطويل، والحدود
- الرابط:
-
جدول نماذج APIYI الشامل
- الرابط:
docs.apiyi.com/models.md - الوصف: النماذج المعلنة علنًا، ونقاط الدخول، ومعلومات التسعير
- الرابط:
المؤلف: فريق APIYI التقني
للتواصل التقني: يسعدنا تواصلكم معنا عبر الموقع الرسمي لـ APIYI على apiyi.com، ولمزيد من مواد التكامل يمكنكم زيارة مركز الوثائق docs.apiyi.com









