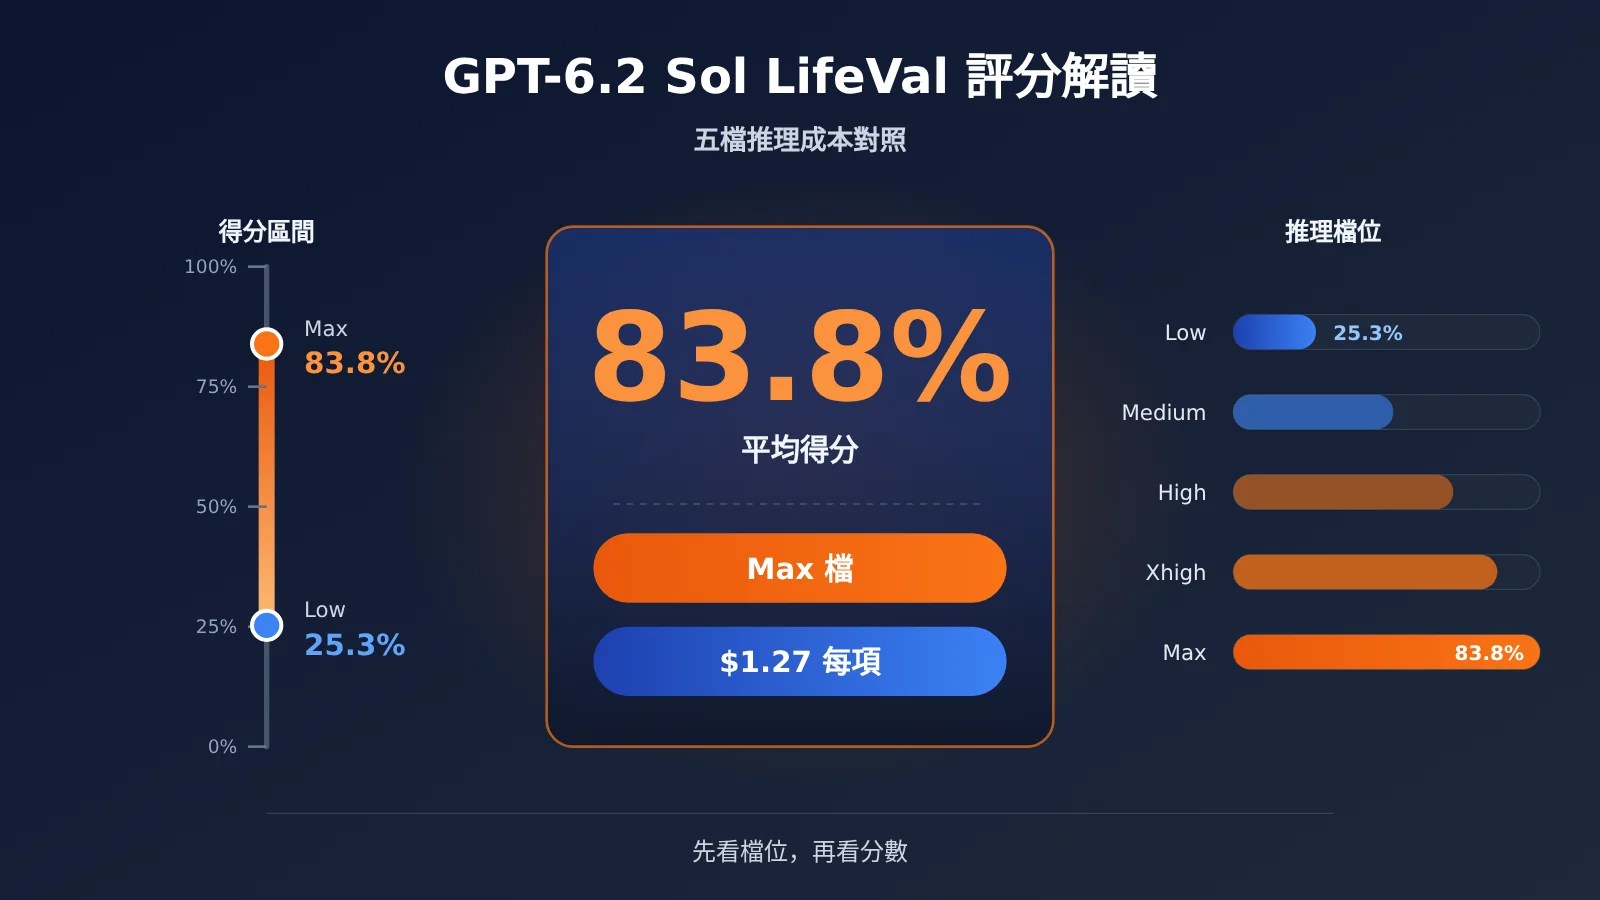
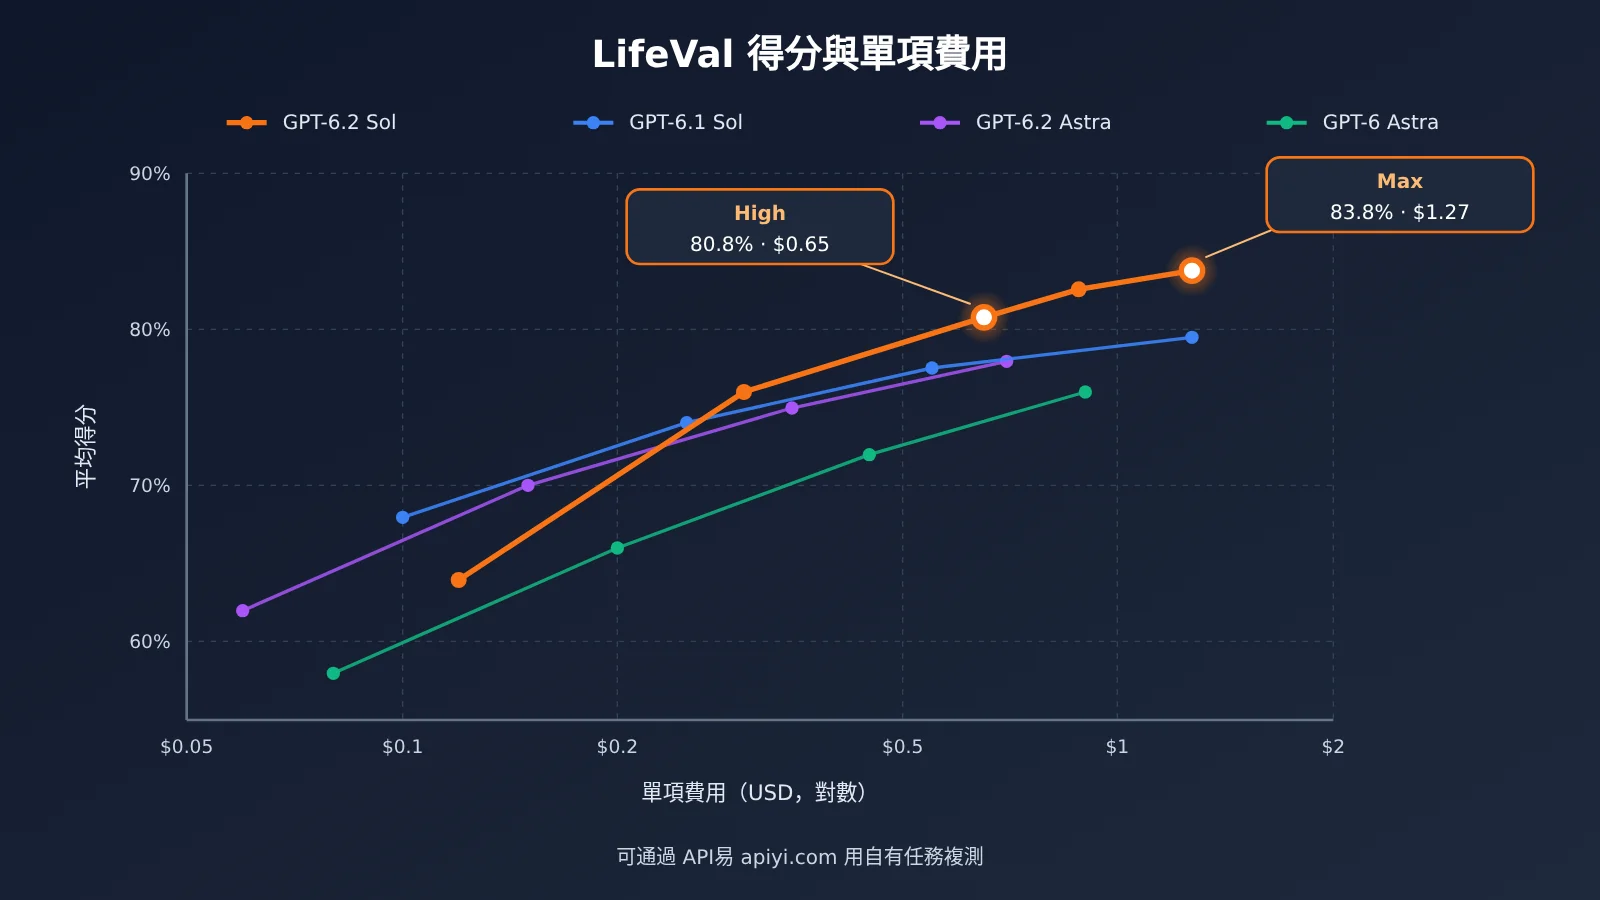
83.8% 不是“83.8% 的任務全部完成”,而是 GPT-6.2 Sol 在 Max 推理檔下的 LifeVal 平均得分。 這一分數按每項任務的評分細則逐項給分後彙總,對應的平均單項費用爲 $1.27。同一個模型換到 Low 檔,平均得分只有 25.3%;換到 High 檔,平均得分爲 80.8%,單項費用爲 $0.65。所以討論 GPT-6.2 Sol 的 LifeVal 表現時,必須先說清是哪一檔。
結論是:官方榜單給出的是“特定任務與特定環境下的分數和成本組合”,不是一個可以直接搬到你產品裏的總排名。在 LifeVal 這組數據中,High 檔是值得優先測試的起點。最終用哪一檔,仍要用你自己的任務、按產物和真實狀態來驗收。
您讀完此文能瞭解到什麼?
- LifeVal 測的是什麼任務,83.8% 應該怎樣正確表述。
- GPT-6.2 Sol 五個推理檔位的得分與費用,以及和 GPT-6.1 Sol、GPT-6 Astra、GPT-6.2 Astra 的同檔對照。
- 官方所說“成本約七分之一”與“Low 檔大幅下滑”爲什麼能同時成立。
- 如何借鑑 LifeVal 的驗收方法,爲自己的日常助理設計可複測的評估任務。
索引:To Know 表格先解釋後文需要用到的評測術語,影響速覽則分別說明普通用戶和開發者各自應關注什麼。客觀事實部分依次交代 LifeVal 的任務來源與計分方式,以及 11 月 17 日發佈圖中的分檔數據。分析判斷部分先拆解幾組比較的分母,再給出一個可直接改寫的路線與日程助理驗收樣例,並說明遷移邊界。
To Know:理解 GPT-6.2 Sol LifeVal 評分的關鍵概念
| 概念 | 簡要解釋 |
|---|---|
| LifeVal | OpenAI 用於衡量 AI 助理完成個性化日常數字任務表現的基準 |
| 個性化上下文 | 用戶偏好、歷史資料、任務特定條件等會改變“合格答案”的信息 |
| 評分細則 | 把一項任務的完成度拆成若干可逐項驗收的要求 |
| 受控環境 | 預先設置好應用、數據和起始狀態的評測環境,便於覈對動作結果 |
| 後端狀態差異 | 測試前後記錄的應用狀態變化,用來確認工具操作是否真的生效 |
| 平均獎勵值 | 各任務按評分細則得分後的彙總指標,發佈圖中的百分比即此類“平均得分” |
| 推理強度 | 控制模型推理投入的檔位,本文對照 Low、Medium、High、Xhigh、Max |
| 單項成本 | 評測圖中平均每項任務的費用,隨模型用量與費率變化 |
GPT-6.2 Sol LifeVal 影響速覽
- 普通用戶:看到“83.8%”時,把它理解爲“在一組美國英語用戶日常任務上的平均得分”,而不是成功率。另外要注意,同一個模型在不同推理檔下差距很大,產品體驗取決於應用方選了哪一檔。
- 產品經理:Low 檔的價格最低,但這次在 LifeVal 中得分大幅落後於上一代 Sol 的 Low 檔。沿用舊版本的檔位配置做升級,可能出現“換了新模型反而變差”的情況。
- API 開發者:值得借鑑的是 LifeVal 的驗收設計,即對交付物、環境狀態和回答分別評分。用同一批自有任務橫向比較 Low、Medium、High 檔,比直接引用榜單數字更可靠。
客觀事實:GPT-6.2 Sol LifeVal 用什麼任務測模型
LifeVal 的來源與發佈時間線
LifeVal 是 OpenAI 用於測量個性化日常代理任務的評測。OpenAI 研究頁日期爲 2026 年 11 月 2 日,配套論文日期爲 11 月 3 日。11 月 17 日,OpenAI 發佈 GPT-6.2 Astra 和 GPT-6.2 Sol,並在發佈頁中附上了包含新模型分檔成績的 LifeVal 圖表(圖表標識 lifeval-v2)。
論文的任務分佈來自美國及多國的時間使用研究,並參考了一項面向美國人羣的付費意願調查,最終把日常活動整理爲 148 類。論文實驗使用 169 項任務。需要注意的是,論文本身評測的模型截止到 GPT-6 Astra,GPT-6.2 系列的分檔數字只出現在後來的官方發佈圖裏。
按官方定位,Sol 面向高頻日常工作、常規編程和可規模化的多步驟 Agent,Astra 面向更困難的推理和專業交付。這一定位與 LifeVal 測量的“日常助理任務”是對得上的。
LifeVal 的任務設計:同一需求,因人而異的合格答案
LifeVal 的特點是“個性化”。以搬家後比較學校爲例,有孩子年齡、通勤路線、學區偏好不同的用戶,合格答案就不一樣。再如在預算和通勤時間之間權衡找房,預算上限和可接受通勤時長會直接決定哪些房源算是合格結果。
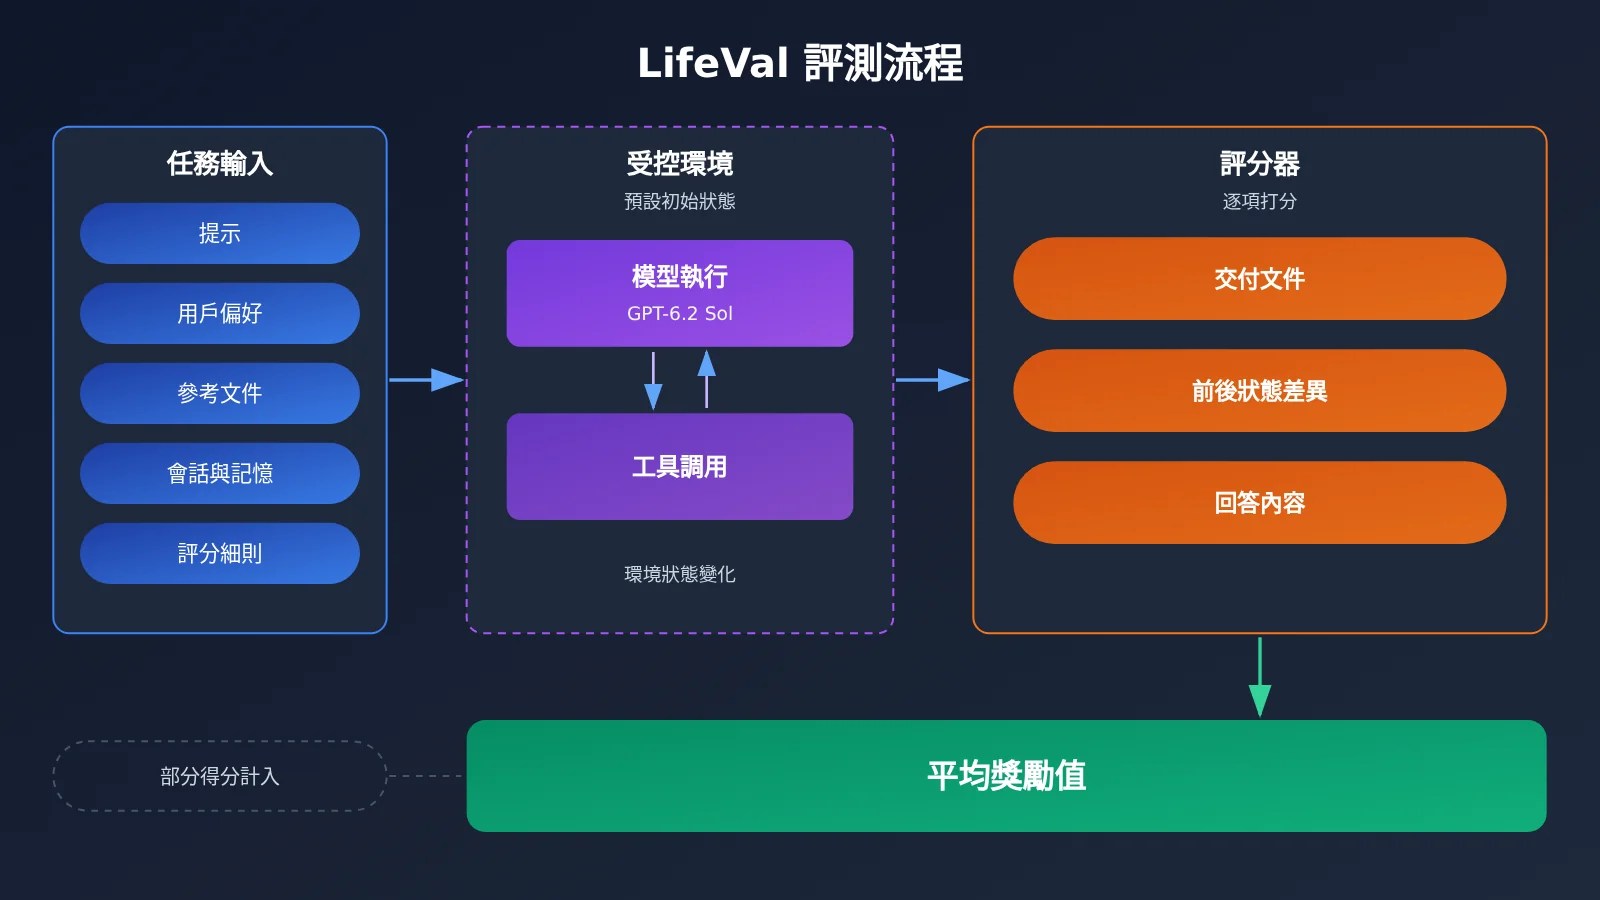
按論文口徑,每項任務都帶有提示、用戶偏好、參考文件、相關會話與記憶、評分細則,以及一個預先設置狀態的受控環境。執行結束後,評分器可以覈對三類東西:模型交付的文件、工具所操作環境的前後狀態,以及模型的回答,然後按任務的各項要求分別給分。
爲什麼 83.8% 只能說“平均得分”
論文結果圖的縱軸是平均獎勵值。因此,83.8% 應表述爲“平均得分”,不能寫成“83.8% 的任務被完整執行成功”。一項任務即使只滿足了部分評分項,也會貢獻部分分數。
論文還交代了幾項限制:離線環境和緩存網頁中仍有部分會隨時間變化的信息,樣本人羣以面向美國、使用英語的用戶爲主。這意味着分數不能直接推廣到其他地區、其他語言或其他應用生態。
GPT-6.2 Sol LifeVal 發佈圖:五檔得分與單項費用
下表讀取自 2026 年 11 月 17 日 OpenAI 發佈頁中的 LifeVal 交互圖公開數據。每格爲“平均得分 / 平均每項任務費用(USD)”,屬於 OpenAI 自報的公開評測數據,並非獨立機構實測。
| 模型 | Low | Medium | High | Xhigh | Max |
|---|---|---|---|---|---|
| GPT-6.2 Sol | 25.3% / $0.089 | 70.3% / $0.38 | 80.8% / $0.65 | 82.6% / $0.88 | 83.8% / $1.27 |
| GPT-6.1 Sol | 66.8% / $0.52 | 75.5% / $0.73 | 77.1% / $0.88 | 77.8% / $0.96 | 79.5% / $1.27 |
| GPT-6.2 Astra | 46.3% / $0.59 | 78.9% / $1.56 | 83.1% / $2.41 | 83.7% / $2.94 | 86.1% / $4.23 |
| GPT-6 Astra | 67.5% / $3.51 | 74.3% / $5.30 | 76.0% / $6.52 | 77.5% / $6.94 | 79.8% / $9.04 |
發佈公告正文的說法是:在 LifeVal 中,Sol 得分高於 GPT-6 Astra,成本約爲後者的七分之一。這裏的比較對象是上一代旗艦 GPT-6 Astra,不是同期的 GPT-6.2 Astra。公告中另一組 FrontierCode 2.0 的比較才使用 GPT-6.2 Astra,閱讀時不要把兩組結論混在一起。
📌 數據口徑提示:表中“單項費用”是官方評測圖的平均值,受該評測的輸入長度、輸出長度和工具使用影響。你自己的任務成本需要用真實請求複測,可以通過 API易 apiyi.com 用同一個 Key 依次跑 Sol 的不同檔位,直接對比賬單。
GPT-6.2 Sol 的 API 接入信息
API 模型 ID 爲 gpt-6.2-sol,可通過 Responses 和 Chat Completions 調用,函數調用與內置工具走 Responses 路徑,兩個端點都不接受 none 推理檔位。官方短上下文 Standard 標價爲輸入 $2.00、輸出 $10.00(USD / 百萬 token,輸出已包含推理 token),與 GPT-6.1 Sol 相同。
截至 2026 年 11 月 20 日,API易公開模型總表與定價接口均已列出 gpt-6.2-sol,標註 responses 與 chat 入口。短檔計價與官方一致,實際可用分組、參數範圍和出賬以 API易 apiyi.com 當前配置及賬單爲準。
分析判斷:GPT-6.2 Sol LifeVal 中“七分之一成本”與 Low 下滑怎樣同時成立
先把比較對象和分母對齊
同一張圖能讀出“大幅進步”和“明顯退步”兩種印象,根本原因是比較對象和檔位不同。下表的差值與比例均根據官方公示值計算。
| 比較組 | 雙方數值 | 得分差 | 費用關係 |
|---|---|---|---|
| 6.2 Sol Max vs 上一代旗艦 GPT-6 Astra Max | 83.8%/$1.27 vs 79.8%/$9.04 | +4.0 個百分點 | 約 14.0%,即“約七分之一” |
| 6.2 Sol Max vs 6.1 Sol Max | 83.8%/$1.27 vs 79.5%/$1.27 | +4.3 個百分點 | 費用相同 |
| 6.2 Sol Low vs 6.1 Sol Low | 25.3%/$0.089 vs 66.8%/$0.52 | −41.5 個百分點 | 費用更低,但得分大幅下滑 |
| 6.2 Sol Medium vs 6.1 Sol Medium | 70.3%/$0.38 vs 75.5%/$0.73 | −5.2 個百分點 | 費用約爲一半 |
| 6.2 Sol High vs 6.1 Sol Max | 80.8%/$0.65 vs 79.5%/$1.27 | +1.3 個百分點 | 約爲一半 |
| 6.2 Sol Max vs 6.2 Astra Max | 83.8%/$1.27 vs 86.1%/$4.23 | −2.3 個百分點 | 約 30% |
這些數字中,“百分點”描述的是平均得分之差,“費用比例”描述的是平均單項費用之比,兩者不能互相換算。“七分之一”只在“6.2 Sol Max 對 GPT-6 Astra Max”這一組裏成立。如果換成同期的 GPT-6.2 Astra,Sol 在 Max 檔反而低 2.3 個百分點。
💡 選型提示:同一模型、不同檔位的差距可能大於不同模型之間的差距。建議先在 API易 apiyi.com 上用固定任務集跑一輪分檔對比,再決定默認檔位,不要直接沿用舊模型的檔位配置。
Low 檔的信號:升級不能“無腦替換”
6.2 Sol 的 Low 檔在 LifeVal 中只有 25.3%,比 6.1 Sol Low 低 41.5 個百分點。官方發佈資料提到 Sol 在若干任務上消耗的輸出 token 更少,Low 檔的平均單項費用也只有 $0.089。一個合理的推測是:在個性化多步驟任務上,低推理投入不足以覆蓋偏好約束和工具操作。這只是推測,官方沒有對 Low 檔下滑給出解釋。
對產品團隊來說,影響很直接。如果你的應用此前在 6.1 Sol 上爲了省錢使用 Low 檔,直接切換模型 ID 而不調整檔位,複雜日常任務的質量可能明顯下降。相反,Max 檔在相同單項費用下比上一代 Sol 高出 4.3 個百分點,說明新模型的上限確實提升了。
爲什麼 High 是本評測裏值得優先測試的檔
6.2 Sol 從 High 到 Xhigh 再到 Max,相鄰提升分別只有 1.8 和 1.2 個百分點,平均單項費用卻依次上漲 $0.23 和 $0.39。High 檔以 $0.65 拿到 80.8%,已經高於 6.1 Sol 的 Max 檔和 GPT-6 Astra 的 Max 檔。僅就 LifeVal 而言,High 是“質量與成本較平衡”的起點。
不過,這一判斷有三個前提:任務分佈接近 LifeVal,語言與應用環境接近美國英語用戶場景,成本結構接近該評測的輸入輸出比例。任何一點不滿足,結論都可能改變。實踐中更穩妥的做法是從 High 起步,再根據自有任務的達標率,決定是否下探到 Medium 或上調到 Xhigh、Max。
分析判斷:用 LifeVal 思路驗收你自己的 GPT-6.2 Sol 助理
構造一個低風險的家庭行程任務
LifeVal 最值得借鑑的不是分數本身,而是“按產物和狀態驗收”的方法。下面是一個家庭行程樣例:預先給助理三條硬約束,分別是出發與目的地點、無障礙出行條件、預算上限,要求它交付帶可覈實路線的候選方案,以及一份可編輯的日程草稿。
| 評分項 | 覈對方式 | 可否自動化 |
|---|---|---|
| 地點約束是否滿足 | 方案中的起終點與輸入一致 | 可自動覈對 |
| 無障礙條件是否滿足 | 路線說明明確覆蓋無障礙要求 | 部分自動,需人工抽查 |
| 預算是否不超限 | 解析方案中的金額並與上限比較 | 可自動覈對 |
| 鏈接能否支撐信息 | 鏈接可訪問且內容與方案一致 | 需人工查看 |
| 日程草稿文件是否存在 | 檢查輸出文件或日曆條目的前後狀態 | 可自動覈對 |
| 關鍵信息缺失時是否詢問 | 故意省略日期等信息,看是否主動追問 | 需人工判斷 |
這套評分項對應 LifeVal 的三路驗收:交付物(日程草稿)、狀態變化(文件或條目是否真的寫入),以及回答質量(約束滿足與主動追問)。用同一批任務分別跑 Low、Medium、High,再結合達標率和費用決定初始檔位。
極簡示例:調用 GPT-6.2 Sol 並記錄推理用量
下面的示例通過 Responses 接口調用 gpt-6.2-sol,同時讀取輸出 token 與其中的推理 token,方便後續覈算單項成本。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "high"},
    input="請爲我規劃週六的家庭出行:從家到市立博物館,需全程無障礙,交通預算不超過 200 元,並給出日程草稿。"
)
print(resp.output_text)
print(resp.usage.output_tokens, resp.usage.output_tokens_details.reasoning_tokens)
查看分檔對比腳本(Low / Medium / High)
import re
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 一個 Key 即可對比多個檔位
)

# 短上下文 Standard 標價,USD / 百萬 token(輸出已含推理 token)
PRICE_IN, PRICE_OUT = 2.00, 10.00

TASKS = [
    {
        "prompt": "從家到市立博物館,週六上午出發,全程無障礙,交通預算不超過 200 元。"
                  "請給出帶路線說明的候選方案,並輸出一份日程草稿。",
        "budget": 200,
        "must_include": ["無障礙", "博物館"],
    },
    {
        # 故意缺少日期,檢驗是否主動追問
        "prompt": "幫我安排一次帶老人去公園的出行,預算 100 元以內,需要無障礙路線。",
        "budget": 100,
        "must_include": ["無障礙"],
        "expect_question": True,
    },
]

def check(task, text):
    """按評分細則逐項打分,返回 0~1 的得分"""
    items = []
    items += [kw in text for kw in task["must_include"]]
    amounts = [float(x) for x in re.findall(r"(\d+(?:\.\d+)?)\s*元", text)]
    items.append(bool(amounts) and max(amounts) <= task["budget"])
    if task.get("expect_question"):
        items.append("?" in text or "?" in text)
    return sum(items) / len(items)

for effort in ["low", "medium", "high"]:
    scores, cost = [], 0.0
    for task in TASKS:
        resp = client.responses.create(
            model="gpt-6.2-sol",
            reasoning={"effort": effort},
            input=task["prompt"],
        )
        u = resp.usage
        cost += u.input_tokens / 1e6 * PRICE_IN + u.output_tokens / 1e6 * PRICE_OUT
        scores.append(check(task, resp.output_text))
    print(f"{effort:>6}: 平均得分 {sum(scores)/len(scores):.1%}, "
          f"平均單項費用 ${cost/len(TASKS):.4f}")
腳本中的自動檢查只覆蓋“可機器覈對”的評分項,鏈接真實性和追問質量仍需人工抽查。推理檔位的參數取值(尤其是 Xhigh、Max 對應的字符串)請以官方當前文檔和所用渠道的參數說明爲準。
🚀 快速開始:通過 API易 apiyi.com 註冊即可獲得免費測試額度。平臺提供 OpenAI 兼容接口,上面的腳本只需替換 Key 就能跑通,適合在正式選檔前先做一輪小樣本驗收。
GPT-6.2 Sol LifeVal 結論的遷移邊界
把 LifeVal 的結論遷到自己的產品,至少要考慮三處差異。第一是語言與地區:論文樣本以美國英語用戶爲主,中文場景下的地圖、支付、日曆應用生態完全不同。第二是環境:LifeVal 在受控環境和緩存網頁裏運行,真實產品會遇到網絡波動、工具授權失敗和賬戶狀態差異。第三是成本結構:官方單項費用對應的是該評測的輸入輸出比例,長上下文請求超過 272K 輸入後會整體切到更高費率,單項成本可能與圖表差距很大。
因此,比較合理的使用方式是:把官方圖表當作“縮小候選範圍”的依據,把自有任務集當作“最終決策”的依據。對於複雜日常助理,可以先用 High 檔建立基線,再分別測試 Medium 是否能守住關鍵硬約束、Xhigh 或 Max 能否明顯減少人工返工,用實際達標率和賬單說話。
當你的任務集、評分細則和環境檢查都準備好之後,模型升級就不再是“看榜單換模型”,而是每次都能複測的工程流程。需要在多個模型和檔位之間反覆對比時,可以藉助 API易 apiyi.com 的統一接口,把 GPT-6.2 Sol、GPT-6.2 Astra 等放進同一套驗收腳本里運行。
參考資料
-
OpenAI GPT-6.2 Astra 與 Sol 發佈公告(含 LifeVal 分檔圖表)
- 鏈接:
openai.com/zh-Hans-CN/index/introducing-gpt-6-2-astra-sol - 說明: 2026-11-17 發佈,本文分檔數據來源
- 鏈接:
-
LifeVal 研究頁與論文
- 鏈接:
openai.com/index/lifeval、cdn.openai.com/pdf/lifeval.pdf - 說明: 任務來源、評分方式與限制說明(論文 §3–§5)
- 鏈接:
-
GPT-6.2 Sol 模型卡與官方定價
- 鏈接:
developers.openai.com/api/docs/models/gpt-6.2-sol - 說明: 上下文規格、長短上下文計費規則與限額
- 鏈接:
-
API易 模型總表
- 鏈接:
docs.apiyi.com/models.md - 說明: 公開掛牌模型、入口與計價信息
- 鏈接:
作者: API易 技術團隊
技術交流: 歡迎在 API易 官網 apiyi.com 聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心