ملاحظة المؤلف: نفصل مقارنة Gemini 4 Neon وGPT-6.2 Sol إلى ثلاثة محاور — البرمجة، والرسوم البيانية، والسياق الطويل — ثم نتحقق من تكلفة المهمة الواحدة وزمن التنفيذ، ومن سعر الوحدة الرسمي وسعر الرف في APIYI، مع إسناد كل رقم إلى مصدره.
تتعامل فرق كثيرة مع GPT-6.2 Sol على أنه الفئة الأرخص. صدر Gemini 4 Neon في 2026-11-18، وتمنح صفحة النموذج على Artificial Analysis درجة ذكاء قدرها 61، بينما يأتي Sol عند 57. وتحديد المهام التي تقع فيها هذه الفروق الأربعة هو ما يحدد قيمتها بالنسبة لعبء عملك. تستعرض هذه المقالة البرمجة والرسوم البيانية والسياق الطويل كلًا على حدة، ثم تفصل تكلفة المهمة الواحدة وسعر الوحدة في حسابين منفصلين.
كل رقم في المقال يحمل وسم مصدره: تقرير رسمي ذاتي، أو بطاقة النموذج، أو صفحة النموذج على Artificial Analysis، أو مقال Artificial Analysis، أو الجدول الإجمالي في APIYI، أو واجهة التسعير. والأرقام التي تختلف بين منهجيتين نُبقيها متجاورة، دون أخذ متوسط أو تركيب رقم جديد.
القيمة الأساسية: بعد القراءة ستكون قادرًا على توضيح البنود التي تظهر فيها النقاط الإضافية التي يحققها Neon، والبند الذي يتفوق فيه Sol فعلاً، ومقدار الفرق بينهما في تكلفة المهمة الواحدة والوقت المستغرق، وكيفية استدعاء gpt-6.2-sol المتاح على APIYI.
نظرة سريعة على الفروق الأساسية بين Gemini 4 Neon وGPT-6.2 Sol
لنضع الأسطر السبعة الأهم جنبًا إلى جنب أولاً. انتبه إلى الفئة: درجة Neon البالغة 61 على صفحة نموذج Artificial Analysis مأخوذة من فئة xhigh، ودرجة Sol البالغة 57 مأخوذة من فئة max، وكلا الدرجتين هي الأعلى على صفحته، لكن اسم الفئة ومعناها مختلفان.
| بُعد المقارنة | Gemini 4 Neon | GPT-6.2 Sol | المصدر |
|---|---|---|---|
| درجة الذكاء الشاملة | 61 (xhigh) | 57 (max) | صفحة نموذج Artificial Analysis |
| البرمجة: Terminal-bench 4.1 (الدقة بعد تعديل الغش) | 65.2% | 61.5% | بطاقة النموذج |
| الرسوم البيانية: Chartography | 73.5% | 75.1% | بطاقة النموذج |
| السياق الطويل: GraphWalks (من 256k إلى 1M، F1 الخاص بـ BFS) | 95.2% | 80.1% | بطاقة النموذج |
| تكلفة المهمة الواحدة | 6.44 دولار | 1.01 دولار | صفحة نموذج Artificial Analysis |
| زمن المهمة الواحدة | 21.5 دقيقة | 8.5 دقيقة | صفحة نموذج Artificial Analysis |
| السعر المعلن (الإدخال/الإخراج، لكل مليون token) | 3 / 15 دولار | 2 / 10 دولار | المعلن رسميًا / صفحة نموذج Artificial Analysis |
ثلاثة ضوابط قبل قراءة جدول المقارنة بين Gemini 4 Neon وGPT-6.2 Sol
الأول هو طبيعة بطاقة النموذج. جدول المقارنة في بطاقة نموذج DeepMind يحتوي على ثلاثة أعمدة فقط: Gemini 4 Neon وClaude Opus 5.5 وGPT-6.2 Sol، ويوضح ملف PDF التوضيحي للتقييم المصاحب أن نتائج النماذج غير Gemini تأتي افتراضيًا من التصريحات الذاتية لكل جهة. لذلك فإن عمود Sol في بطاقة النموذج هو أرقام رسمية جمعتها Google، وليس إعادة اختبار أجراه المختبر نفسه في اليوم نفسه.
الثاني هو اتساق درجة الذكاء. الرقم 61 متسق في مدونة Google (المعلن رسميًا) وفي بطاقة النموذج (سطر AA Index v5.0.1 يكتب 61 / 59 / 57) وفي صفحة نموذج Artificial Analysis، كما أن درجة Sol البالغة 57 متسقة أيضًا في بطاقة النموذج وصفحة نموذج Artificial Analysis. أما مؤشرات البرمجة فليست بهذا الانتظام، وسنتناولها بشكل منفصل أدناه.
الثالث هو معيار التكلفة. تكلفة المهمة الواحدة في Artificial Analysis هي المبلغ الذي يُوزَّع على كل مهمة بعد تشغيل المجموعة الكاملة للمؤشرات، وهي تتأثر بسعر الوحدة وعدد tokens الإخراج في آن واحد. هذا الرقم وسعر الاستدعاء الواحد الذي تحسبه المنصة حسب token هما حسابان منفصلان، ولا يمكن أن يحلا محل بعضهما.
مقارنة قدرات البرمجة بين Gemini 4 Neon وGPT-6.2 Sol
في مجال البرمجة، من بين البنود الخمسة التي ذكرتها بطاقة النموذج، يتفوق Neon على Sol في كل بند تتوفر له بيانات، لكن حجم الفارق متفاوت جدًا. الجدول أدناه مأخوذ بالكامل من بطاقة النموذج، وأرقام Sol فيه تُصنَّف وفق ملاحظات التقييم على أنها مصرَّح بها من OpenAI نفسها.
| بند البرمجة (بطاقة النموذج) | Gemini 4 Neon | GPT-6.2 Sol | الفارق |
|---|---|---|---|
| CursorBench 4.1 | 65.4% | لا توجد بيانات | لا يمكن المقارنة |
| Terminal-bench 4.1 (بعد تعديل الغش) | 65.2% | 61.5% | 3.7 نقطة مئوية |
| FrontierCode 2.0 | 46.2% | 43.8% | 2.4 نقطة مئوية |
| SWE-sweep (harness المزوّد) | 39.0% | 8.3% | 30.7 نقطة مئوية |
| SWE-sweep (harness mini-SWE) | 12.8% | 11.6% | 1.2 نقطة مئوية |
يجب قراءة الـ harnessين في SWE-sweep بشكل منفصل
SWE-sweep هو البند الأكثر عرضة للقراءة الخاطئة. نسبة Neon البالغة 39.0% تأتي من harness الخاص بالمزوّد Google Antigravity، وعند الانتقال إلى harness mini-SWE الموحّد تصبح 12.8%. ويصف blog Google (المصرَّح به رسميًا) الفارق بين 12.8 و39.0 بأنه فتحٌ يتيحه الـ harness، لذا فهذه المجموعة من الأرقام توضح تأثير التركيبة “النموذج + سلسلة الأدوات”.
وتحت نفس harness mini-SWE، يحصل Neon على 12.8% مقابل 11.6% لـ Sol، أي فارق 1.2 نقطة مئوية فقط. أما Sol فيسجّل 8.3% تحت harness مزوّده الخاص، وهو ما يقل عن نتيجته في mini-SWE. إذا كان وكيل البرمجة لديك لا يعمل داخل Antigravity، فإن صف mini-SWE أقرب إلى الظروف التي يمكنك إعادة إنتاجها.
الرقمان في Coding Agent Index
يذكر blog Google (المصرَّح به رسميًا) أن Neon يحصل على 58.6 في Artificial Analysis Coding Agent Index، ويقول إنه الأول إجمالًا. بينما تقول مقالة Artificial Analysis إن Neon xhigh على Antigravity CLI يسجل 59. الرقمان من مصدرين مختلفين، ونحتفظ بهما هنا دون دمجهما. ولا توجد في المواد المرجعية درجة Sol على هذا المؤشر، لذا لا يمكن مقارنة النموذجين في هذا البند. كذلك فإن نسبة 46.2% في FrontierCode 2.0 قُدِّرت، وفق التصريح الرسمي، على المستوى الافتراضي high.
مقارنة قدرات المخططات بين Gemini 4 Neon و GPT-6.2 Sol
المخططات هي المجال الذي يتفوق فيه Sol من بين المجالات الثلاثة. في سطر Chartography على بطاقة النموذج، سجّل Neon نسبة 73.5% مقابل 75.1% لـSol، أي أن Sol أعلى بـ1.6 نقطة مئوية. والرقم الذي نشرته مدونة Google (بيانات رسمية معلنة من الجهة نفسها) لـNeon هو أيضًا 73.5%، أي أن الرقمين متطابقان.
وفي LVBench، الذي يندرج أيضًا ضمن الفهم متعدد الوسائط، تشير بطاقة النموذج إلى نسبة 89.0% لـNeon و87.6% لـSol، أي أن Neon أعلى بـ1.4 نقطة مئوية في هذا المجال. الاتجاهان متعاكسان والفارق في كل منهما ليس كبيرًا، لذلك يصعب تلخيص إجابة سؤال “أيهما أقوى في المخططات والمهام البصرية” في جملة واحدة؛ فالأمر يعتمد على ما إذا كانت مهمتك أقرب إلى قراءة المخططات أم إلى مشاهدة مقاطع الفيديو الطويلة.
أما من ناحية وسائط الإدخال، فتوضح بطاقة النموذج أن Neon يقبل النصوص والصور والصوت والفيديو. ولم تقدّم المواد المرجعية قائمة بوسائط الإدخال الخاصة بـSol، لذا إذا كانت سير عملك تعتمد على إدخال الصوت أو الفيديو، فعليك أولًا التحقق من دعم Sol في وثائق OpenAI الرسمية.
مقارنة السياق الطويل بين Gemini 4 Neon وGPT-6.2 Sol
في بند السياق الطويل، تعتمد هذه المقالة على بيانات GraphWalks الواردة في بطاقة النموذج فقط. عند تنفيذ اجتياز BFS في النطاق من 256k إلى 1M token، بلغت درجة F1 لدى Neon نسبة 95.2%، ولدى Sol نسبة 80.1%، أي بفارق 15.1 نقطة مئوية، وهو أكبر فرق بين البنود الثلاثة.
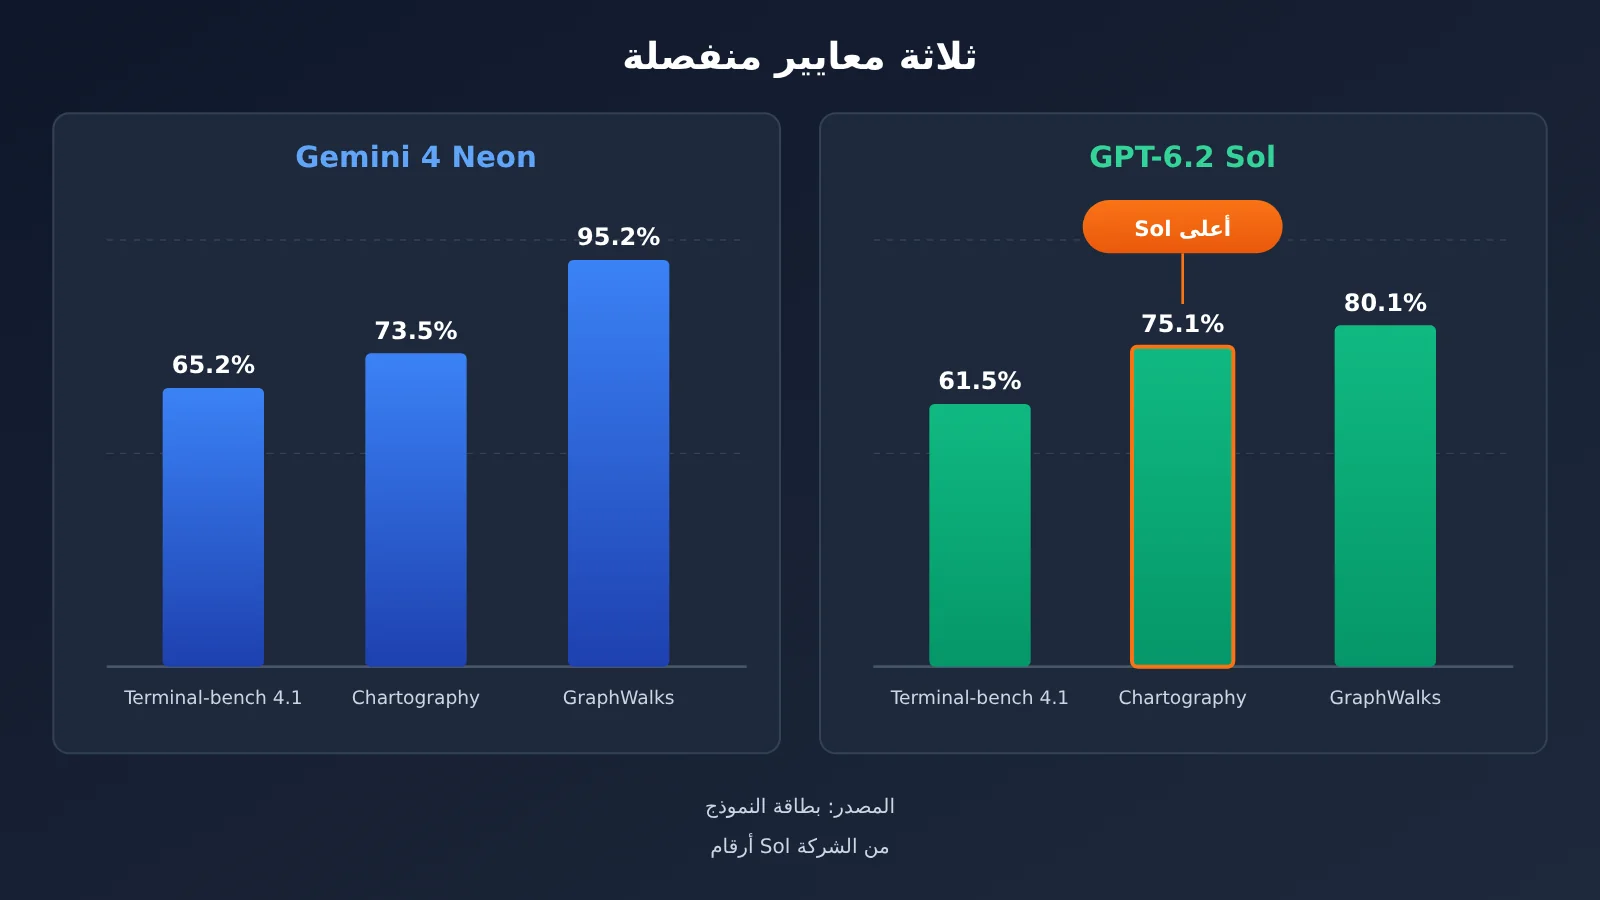
📊 شرح الرسم البياني: جميع الأرقام في الشكل أعلاه مأخوذة من بطاقة النموذج، وعمود Sol يُعدّ — وفق ملاحظات التقييم — بيانات أعلنتها الجهة المصنّعة بنفسها. وإذا أردت التحقق من أداء Sol على مستنداتك الطويلة، يمكنك إرسال طلب
gpt-6.2-solمباشرةً عبر APIYI على apiyi.com وباستخدام المفتاح نفسه.
معاملات السياق الطويل في Gemini 4 Neon
مواصفات نافذة Neon موثّقة بالكامل. تذكر بطاقة النموذج أن النافذة الموحدة تصل إلى مليون token كحد أقصى، وأن الإخراج المتزامن الافتراضي يصل إلى 64 ألف token، وأن فك الترميز الطويل في الخلفية يصل إلى مليون. ويقدّم دليل مطوّري Google Cloud القيم الدقيقة: الحد الأعلى الموحّد 1048576 token، ويشمل الإدخال والإخراج معًا، كما يشمل الإخراج بدوره التفكير واستدعاء الدوال والرد النهائي؛ أما المقطع الواحد فالحد الافتراضي له 65536، ويمكن أن يصل فك الترميز الطويل إلى 1048576 ناقص الإدخال.
أما التخزين المؤقت، فيوضّح دليل المطوّرين أن Neon لا يدعم التخزين المؤقت الصريح للسياق. والتخزين المؤقت الضمني يُفعّل تلقائيًا للبادئات المشتركة التي تتجاوز 4096 token، والتخزين المؤقت الدائم مفعّل افتراضيًا. وفي سيناريوهات تكرار طرح الأسئلة على مستند طويل، يعني ذلك أن عليك إبقاء البادئة المشتركة ثابتة لتستفيد من سعر التخزين المؤقت البالغ 0.15 دولار والمذكور في صفحة تسعير AI Studio.
معلومات السياق الطويل في GPT-6.2 Sol
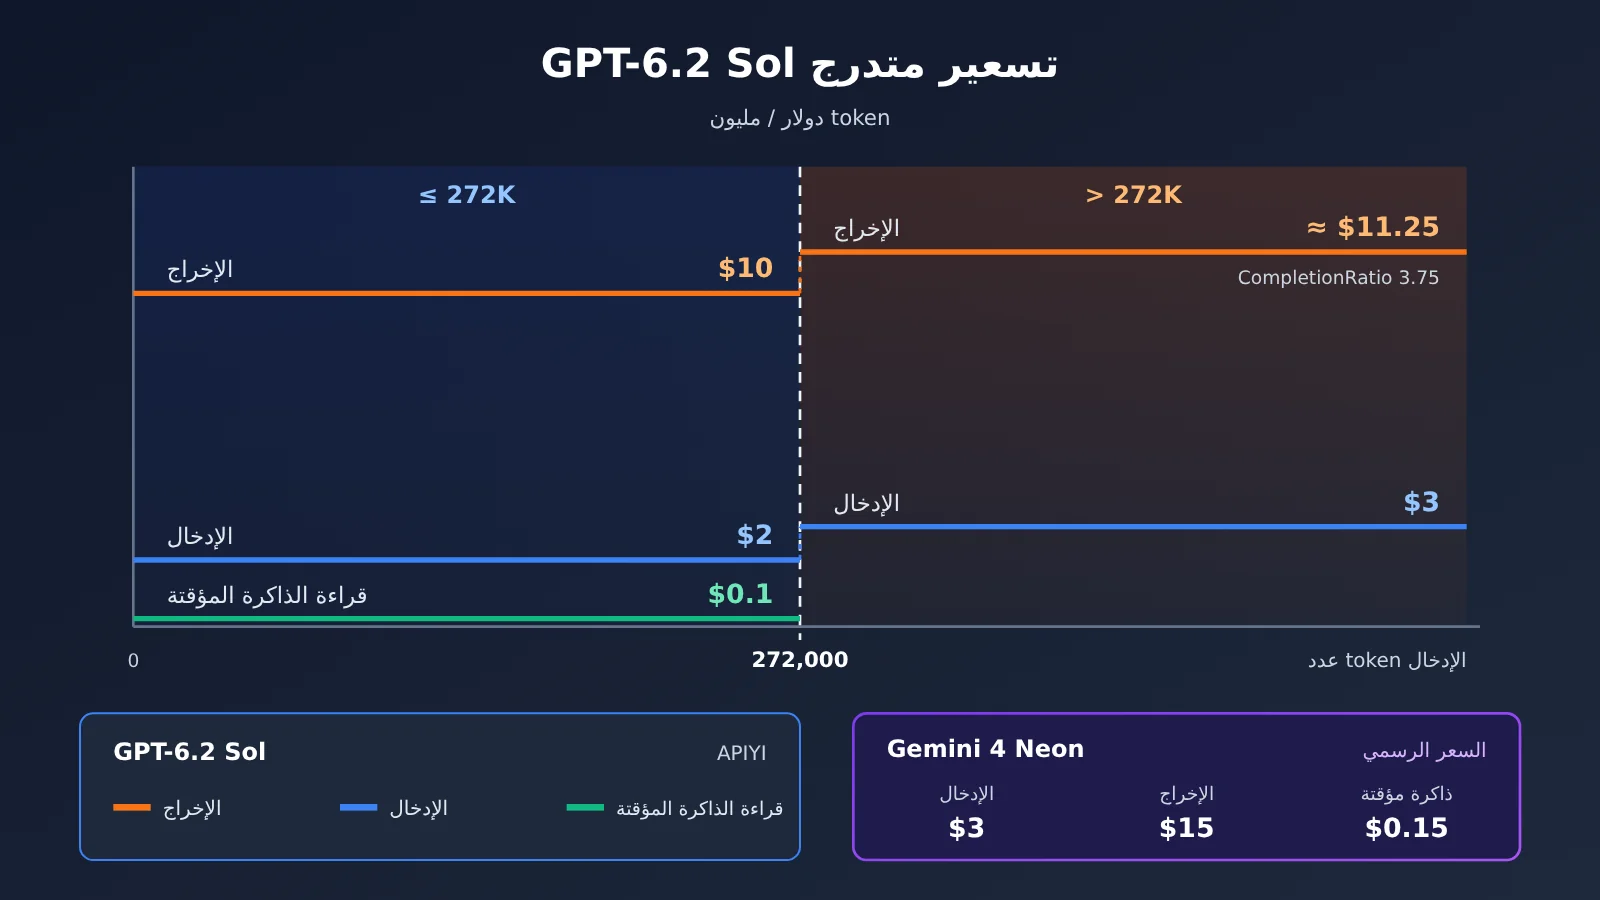
لا تقدّم المواد المرجعية حدًّا أعلى لنافذة السياق في Sol، ولن تعقد هذه المقالة مقارنة بين أحجام النوافذ. وما يمكن تأكيده هو الفوترة: يُظهر الجدول الإجمالي في APIYI أن gpt-6.2-sol ينتقل إلى شريحة سعرية أخرى بعد تجاوز الإدخال 272000 token، وسيُفصّل ذلك في قسم الأسعار أدناه. وفي مهام السياق الطويل، يؤثر هذا الحد مباشرةً في بنية فاتورتك.
مقارنة التكلفة والوقت بين Gemini 4 Neon وGPT-6.2 Sol
الفارق في تكلفة المهمة الواحدة أكبر بكثير من الفارق في سعر الوحدة. تعرض صفحة نموذج Artificial Analysis تكلفة 6.44 دولار للمهمة الواحدة عند Neon xhigh، مقابل 1.01 دولار لـ Sol max، أي نحو 6.4 أضعاف. بينما نسبة سعر الإدخال المعلن بينهما 3 إلى 2، ونسبة سعر الإخراج 15 إلى 10، وكلتاهما تعادل 1.5 ضعف.
الجزء الإضافي يأتي من حجم الإخراج. وفي الصفحة نفسها، أنتج Neon xhigh عند تشغيل المؤشر 283 مليون توكن، بينما أنتج Sol max 60.9 مليون توكن، أي نحو 4.6 أضعاف. ارتفاع سعر الوحدة بمقدار النصف مع حجم إخراج أكبر عدة مرات؛ هذان العاملان مجتمعان ينتجان نتيجة 6.44 مقابل 1.01.
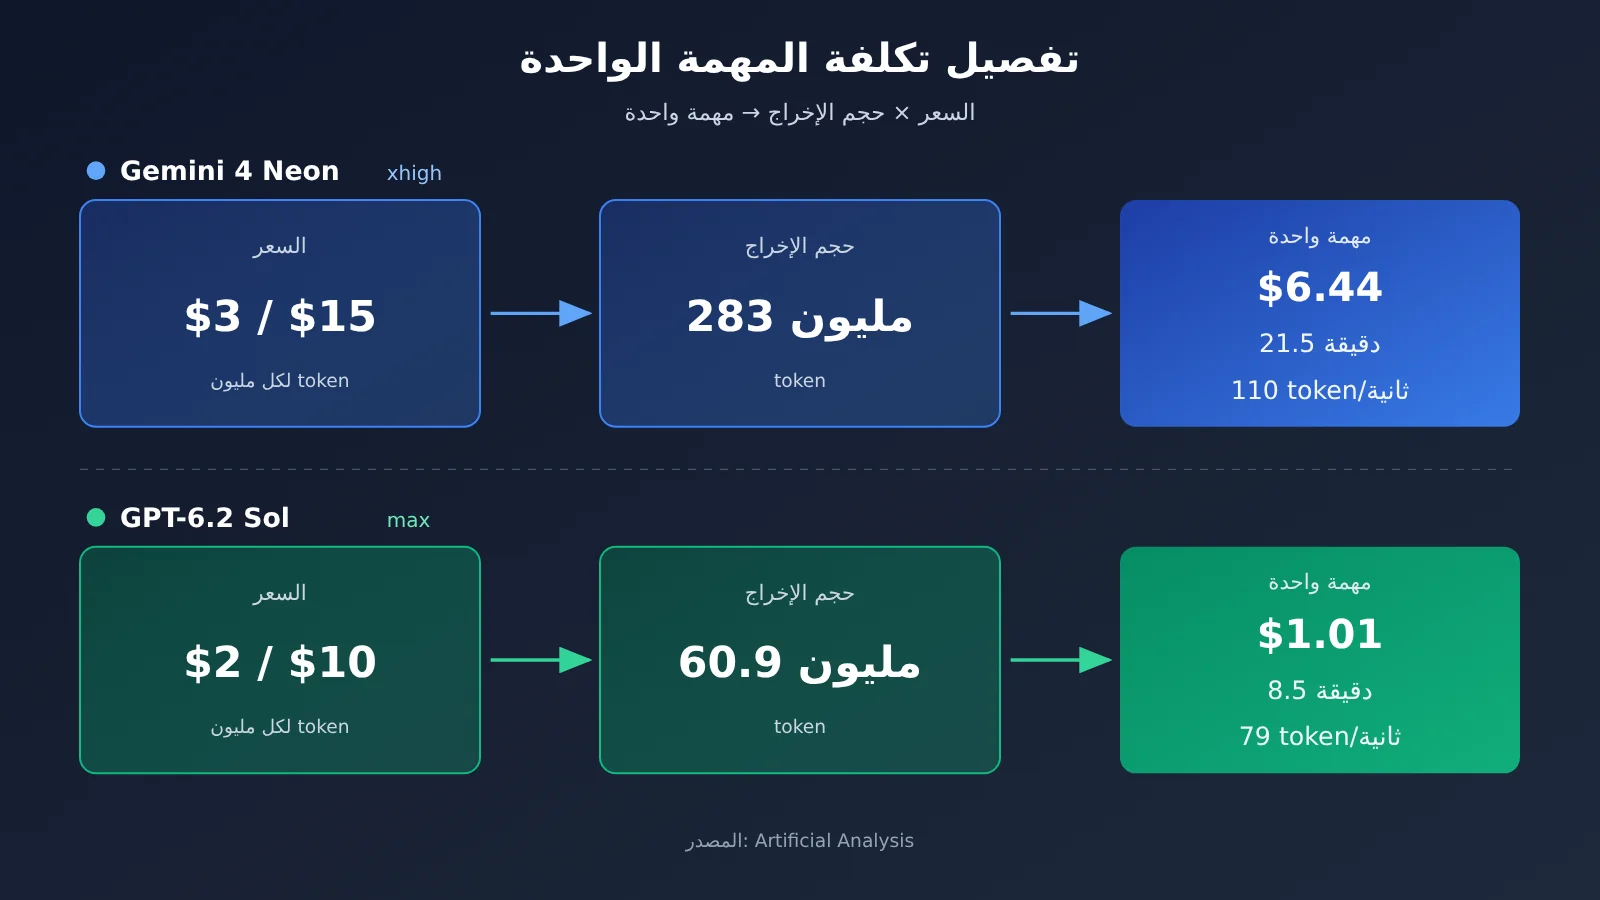
وينطبق المنطق نفسه على الوقت. سرعة الإخراج لدى Neon xhigh تبلغ نحو 110 توكن/ثانية، وهي أعلى من 79 توكن/ثانية لدى Sol max، لكن حجم الإخراج أكبر، لذا يأتي زمن المهمة الواحدة 21.5 دقيقة مقابل 8.5 دقيقة. أما زمن أول توكن في الإجابة، فهو 56.51 ثانية لـ Neon xhigh و75.06 ثانية لـ Sol max، أي إن Neon أسرع في هذا البند.
درجة الذكاء وزمن المهمة الواحدة حسب المستوى
لكلا النموذجين عدة مستويات تفكير، والجدول التالي مأخوذ من صفحة النموذج على Artificial Analysis. تكلفة المهمة الواحدة لا تظهر إلا في صف أعلى مستوى، بينما تعرض الصفحة للمستويات الأخرى الدرجة والزمن والسرعة.
| المستوى | درجة ذكاء Neon | زمن مهمة Neon | سرعة إخراج Neon | درجة ذكاء Sol | زمن مهمة Sol | سرعة إخراج Sol |
|---|---|---|---|---|---|---|
| max | لا يوجد هذا المستوى | — | — | 57 | 8.5 دقيقة | 79 توكن/ثانية |
| xhigh | 61 | 21.5 دقيقة | 110 توكن/ثانية | 56 | 5.3 دقيقة | 76 توكن/ثانية |
| high | 60 | 14.8 دقيقة | 101 توكن/ثانية | 55 | 4.6 دقيقة | 73 توكن/ثانية |
| medium | 55 | 8.3 دقيقة | 101 توكن/ثانية | 53 | 3.2 دقيقة | 70 توكن/ثانية |
| low | 44 | 3.7 دقيقة | 97 توكن/ثانية | 41 | 1.5 دقيقة | 65 توكن/ثانية |
يمكن قراءة هذا الجدول بطريقتين. بحسب المستويات التي تحمل الاسم نفسه، يسجل Neon في مستوى high درجة 60 مقابل 55 لـ Sol، بزمن 14.8 دقيقة مقابل 4.6 دقيقة. وبحسب الزمن، يقترب زمن Neon في medium البالغ 8.3 دقيقة من زمن Sol في max البالغ 8.5 دقيقة، بينما الدرجة 55 مقابل 57. المستوى الافتراضي في Neon هو high (هذا ما تذكره أدلة المطورين وأحدث صفحة نموذج في AI Studio)، وهو أيضاً الصف الذي تتخذه تكاملات كثيرة افتراضياً. أما زمن أول توكن في المستويات الثلاثة الأخيرة من Neon فمسجل بشكل منفصل في الأسئلة الشائعة بصفحة النموذج: high 40.64 ثانية، medium 20.14 ثانية، low 13.93 ثانية، وهذه الأرقام ترد في خانة مختلفة عن الجدول الملخص.
مقارنة الأسعار بين Gemini 4 Neon وGPT-6.2 Sol: سعر الوحدة الرسمي وأسعار رفوف APIYI
ينقسم سعر الوحدة إلى طبقتين: السعر المعلن على صفحات مزود النموذج أو الأطراف الثالثة، وسعر الرف على APIYI (apiyi.com).
| البند | Gemini 4 Neon | GPT-6.2 Sol |
|---|---|---|
| سعر الإدخال المعلن (لكل مليون توكن) | 3.00 دولار (تصريح رسمي / صفحة الأسعار في AI Studio) | 2.00 دولار (صفحة النموذج في Artificial Analysis) |
| سعر الإخراج المعلن (لكل مليون توكن) | 15.00 دولار، شاملًا توكنات التفكير | 10.00 دولار |
| التخزين المؤقت | 0.15 دولار، للتخزين المؤقت الضمني فقط | خصم 95% على التخزين المؤقت (صفحة النموذج في Artificial Analysis) |
| الطبقة المجانية | لا توجد (صفحة الأسعار في AI Studio) | لم تذكرها المصادر المرجعية |
| معرّف النموذج في APIYI | لم يُطرح بعد | gpt-6.2-sol |
| الطبقة الأولى في APIYI (من 0 إلى 272000 توكن إدخال) | — | إدخال 2 / قراءة من التخزين المؤقت 0.1 / إخراج 10 دولارات |
| الطبقة العالية في APIYI (أكثر من 272000 توكن إدخال) | — | إدخال 3 دولارات؛ والإخراج عبر واجهة التسعير نحو 11.25 دولار |
| نقاط النهاية في APIYI | — | responses (موصى به)، chat |
| المنصات المتاحة | قنوات رسمية مثل Gemini API في Google AI Studio وغيرها | APIYI apiyi.com وغيرها |
لم يظهر gemini-4-neon بعد في الجدول الإجمالي ولا في واجهة التسعير لدى APIYI، فهو غير مطروح حاليًا، وسنطرح هذا النموذج في أقرب وقت ممكن؛ ويُعتمد الطراز والسعر على قائمة الطرازات في المنصة.
تفاصيل انتقال الشرائح السعرية للنموذج gpt-6.2-sol على APIYI
الجدول الإجمالي في APIYI (الصفحة مُعلَّمة بأن آخر تحديث لها 2026-11-16 09:39، بتوقيت UTC+8) يذكر أن gpt-6.2-sol في الشريحة الأولى بسعر إدخال 2 دولار، وقراءة من الكاش 0.1 دولار، وإخراج 10 دولارات، وهو ما يطابق السعر 2/10 المعلن على صفحة النموذج في Artificial Analysis. وعند تجاوز 272000 توكن في الإدخال، فإن نص الجدول الإجمالي يكتفي بالقول إن سعر الإدخال يقفز من 2 دولار إلى 3 دولارات.
أما واجهة التسعير التي جرى الاستعلام عنها في 2026-11-19 (الإصدار shell-api-modelmak-v1، وتضم 285 نموذجًا) فتعطي معلومات أكثر اكتمالًا. في الواجهة، model_ratio بقيمة 1 تعني إدخالًا بسعر 2 دولار لكل مليون توكن، وcompletion_ratio بقيمة 5 تعني أن الإخراج خمسة أضعاف الإدخال؛ وبعد تجاوز 272000 توكن يتغيّر CompletionRatio من 5 إلى 3.75، أي إنه بحساب إدخال بـ 3 دولارات يصبح الإخراج نحو 11.25 دولار لكل مليون توكن، وليس مستمرًا في الحساب على 10 دولارات.
أسماء المجموعات تختلف قليلًا في الموضعين: الجدول الإجمالي يكتب CodexResponses وCodex_Reverse وDefault وSVIP، بينما واجهة التسعير تكتب CodexResponses وCodexReverse وdefault وsvip. ومن الجدير التأكيد مرة أخرى أن رقم 1.01 دولار في Artificial Analysis هو تكلفة تشغيل المؤشر موزَّعة على كل مهمة، وليس هو نفسه تكلفة التوكنات الفعلية التي ينتجها استدعاء واحد على المنصة.
مقارنة سيناريوهات Gemini 4 Neon وGPT-6.2 Sol
فيما يلي الأرقام الأكثر ارتباطًا بكل نوع من المهام، لمساعدتك على مطابقة نتائج التقييم مع أحمال العمل لديك. أي النموذجين أنسب يعتمد على توزيع مهامك وميزانيتك؛ هذه مقارنة فقط، وليست حكمًا نهائيًا.
أرقام مرتبطة بوكلاء البرمجة
- التشغيل داخل Google Antigravity: انظر إلى سطر harness الخاص بالمورّد في SWE-sweep: Neon 39.0% وSol 8.3%، مع تذكّر أن Google نفسها تنسب هذا الفارق إلى harness.
- التشغيل داخل harness عام: انظر إلى سطر mini-SWE: 12.8% مقابل 11.6%، وإلى Terminal-bench 4.1: 65.2% مقابل 61.5%.
- التعديلات الصغيرة المتكررة: زمن المهمة الواحدة أكثر أهمية هنا؛ يمكنك مقارنة الأزمنة ضمن النطاق نفسه من الدرجات في جدول الشرائح.
أرقام مرتبطة بالرسوم البيانية والمستندات الطويلة
- الأسئلة والأجوبة على صور التقارير المالية ولقطات لوحات المعلومات: Chartography يمنح Sol 75.1% وNeon 73.5%، أي أن اتجاه هذه النتيجة معاكس للدرجة الإجمالية.
- التنقل في هياكل رسومية أو مستندات بحجم مئات الآلاف من tokens: GraphWalks يمنح Neon 95.2% وSol 80.1%، مع ضرورة احتساب انتقال Sol إلى شريحة تسعير أعلى في APIYI عند تجاوز 272000 token.
- فهم الفيديوهات الطويلة: LVBench يمنح Neon 89.0% وSol 87.6%، كما تنص بطاقة النموذج على أن Neon يدعم إدخال الفيديو.
توصيات الاختيار بين Gemini 4 Neon وGPT-6.2 Sol: راجع وضعك أولًا ثم اختر
قبل اختيار النموذج، يُفضّل أن تتحقق من حالتك بالترتيب التالي، بدلًا من اتخاذ القرار مباشرة بناءً على 61 مقابل 57.
- احسب نسبة كل من المهام البرمجية والرسوم البيانية والسياق الطويل في مهامك، ثم قارن كل فئة بالجداول الفرعية الثلاثة أعلاه.
- قدّر متوسط حجم المخرجات لكل مهمة. تشير بيانات Artificial Analysis إلى أن فرق تكلفة المهمة الواحدة بين النموذجين يأتي أساسًا من حجم المخرجات؛ وكلما كانت مخرجاتك أطول، ظهر هذا الفرق بشكل أوضح.
- تأكد مما إذا كان طول الإدخال سيتجاوز 272000 token. بعد تجاوزه، سيتغير سعر الإدخال والإخراج لـ
gpt-6.2-solفي APIYI. - تأكد من مستوى التفكير. يدعم Neon أربعة مستويات فقط: low وmedium وhigh وxhigh؛ وإذا مررت
thinking_budgetأوMINIMALفسيعيد HTTP400(دليل المطور). - شغّل مجموعة صغيرة من المقارنات على مجموعة العينات الخاصة بك، وسجّل الدرجات والوقت المستغرق وعدد tokens المستخدمة.
💡 توصية الاختيار: لكل من النموذجين نقاط قوة وضعف في البنود الفرعية، والقرار النهائي يعتمد على توزيع مهامك وميزانيتك. نوصي أولًا بالاتصال بـ
gpt-6.2-solالمتاح على APIYI عبر apiyi.com، وتسجيل عدد tokens والوقت المستغرق على عيناتك، ثم بعد إتاحة Neon استخدم السكريبت نفسه لإجراء المقارنة.
كيفية استدعاء GPT-6.2 Sol بسرعة عبر APIYI
نقطة النهاية الموصى بها من APIYI للنموذج gpt-6.2-sol هي responses، أما base_url المتوافقة مع OpenAI فهي https://api.apiyi.com/v1. لا يتطلب الربط سوى أربع خطوات:
- تحضير المفتاح: أنشئ مفتاح API من لوحة تحكم المنصة واكتبه في متغيّر البيئة
APIYI_API_KEY، واجعل الكود يقرأه من متغيّر البيئة فقط دون كتابته صراحةً. - تحديد عنوان الطلب: نقطة نهاية Responses هي
POST https://api.apiyi.com/v1/responses، مع ترويسات الطلبAuthorization: Bearer $APIYI_API_KEYوContent-Type: application/json. - بناء جسم الطلب: أصغر جسم طلب هو
{"model": "gpt-6.2-sol", "input": "لخّص المخططات البيانية الثلاثة الواردة في هذا التقرير الربع سنوي"}. - الاستدعاء عبر OpenAI SDK: هيّئ
OpenAI(base_url="https://api.apiyi.com/v1", api_key=os.environ["APIYI_API_KEY"])، ثم استدعِclient.responses.create(model="gpt-6.2-sol", input=...)، واقرأ النتيجة منoutput_textفي الكائن المُعاد.
وإذا كان كودك الحالي مبنيًّا على Chat Completions، فيمكنك إرسال معرّف النموذج نفسه إلى نقطة نهاية chat، بمسار /v1/chat/completions. أما بروتوكول Gemini الأصلي فيعمل عبر https://api.apiyi.com مع إصدار v1beta، وهو مناسب لطرازات Gemini المتاحة على المنصة.
عند اختبار السياق الطويل، يُنصح بتسجيل عدد رموز (tokens) الإدخال لكل طلب في السجلات، حتى يسهل تحديد ما إذا كنت قد تجاوزت حدّ الانتقال عند 272000. أما القيم الفعلية لمعامل مستوى التفكير، فارجع فيها إلى وثائق OpenAI الرسمية وصفحة الطراز على المنصة.
🚀 بداية سريعة: يمكن للمستخدمين الجدد الحصول على رصيد تجريبي مجاني من APIYI على apiyi.com، واستخدام مفتاح واحد لاستدعاء النماذج المتاحة مثل OpenAI وClaude وGemini في الوقت نفسه. ابدأ بتشغيل مسار responses للنموذج
gpt-6.2-solحتى يكتمل، وبعدها لا تحتاج عند تبديل الطراز سوى إلى تغيير الحقلmodel.
الأسئلة الشائعة
س1: ما هو موقع كل من Gemini 4 Neon وGPT-6.2 Sol؟
Neon مُشتقّ من Gemini 4 Carbon (بطاقة النموذج)، ويضعه دليل مطوّري Google في مرتبة وسطى بين Hydrogen (الدورة اليومية السريعة) وCarbon (المهام الطويلة المعقّدة). أما GPT-6.2 Sol فقد سُعّر على صفحة النموذج في Artificial Analysis عند 2/10 دولار، بدرجة ذكاء قصوى 57 في أعلى فئة max.
س2: أين تظهر بوضوح نقاط Neon الأربع الإضافية مقارنةً بـ Sol؟
من البنود الفرعية في بطاقة النموذج، يقع أكبر فرق في GraphWalks للسياق الطويل (95.2% مقابل 80.1%) وفي SWE-sweep ضمن harness الخاص بالمورّد (39.0% مقابل 8.3%). أما بند الرسم البياني Chartography فـ Sol يتقدّم فيه (75.1% مقابل 73.5%).
س3: متى صدر Gemini 4 Neon، وفي أي القنوات يتوفّر؟
تاريخ النشر في مدوّنة Google هو 2026-11-18. وبحسب منشور الإطلاق من Sundar Pichai، أُطلق في اليوم نفسه عبر Gemini API في Google AI Studio، وGemini for business، وGoogle Antigravity في النسختين المدفوعتين Google AI Pro وUltra، وتطبيق Gemini في نسختي Pro وUltra، ومعرّف النموذج هو `gemini-4-neon`.
س4: هل يمكن اعتبار 1.01 دولار للمهمة الواحدة في Sol ميزانية استدعاء؟
هذا الرقم هو تكلفة توزّعها Artificial Analysis على كل مهمة بعد تشغيل مجموعة المؤشرات كاملة، وقد أنتج Sol max في ذلك الاختبار 60.9 مليون token. أما تكلفتك الفعلية فتتوقف على عدد tokens المدخلة والمخرجة لديك وعلى فئة التسعير، وننصح بالتقدير يدويًا وفق الفئة الأولى في جدول APIYI الإجمالي عند 2 / 0.1 / 10 دولار، مع الانتباه إلى انتقال الفئة عند تجاوز 272000 token.
س5: كيف أستدعي هذين النموذجين سريعًا عبر API؟
أصبح `gpt-6.2-sol` متاحًا على APIYI؛ سجّل في apiyi.com واستلم رصيد التجربة، ثم اضبط base_url على `https://api.apiyi.com/v1` واستدعِ نقطة النهاية `responses`. أما `gemini-4-neon` فغير موجود حاليًا لا في الجدول الإجمالي ولا في واجهة التسعير، أي أنه لم يُطرح بعد، وسنعمل على طرحه في أقرب وقت؛ والمعرّف والسعر معتمدًا على قائمة النماذج في المنصّة.
س6: ما القيود التي تعتري بيانات هذه المقارنة؟
هناك ثلاثة قيود أساسية:
– **المنهجية**: درجات Sol في بطاقة النموذج تُعدّ وفق توضيحات التقييم إقرارًا ذاتيًا من المورّد، وليست إعادة اختبار في اليوم نفسه.
– **الفئة**: أعلى فئة لـ Neon في Artificial Analysis هي xhigh، وأعلى فئة لـ Sol هي max، أي أن الفئتين غير متطابقتين تمامًا.
– **تفاوت الأرقام**: Coding Agent Index يظهر في مدوّنة Google بقيمة 58.6 وفي مقال Artificial Analysis بقيمة 59؛ وWebExploitBench v1.2 مكتوب في المدوّنة 51.26% وفي بطاقة النموذج 51.3%، وقد أُبقيت الأرقام كما هي في هذا المقال.
Gemini 4 Neon وGPT-6.2 Sol: أبرز النقاط
- النتيجة الإجمالية: على صفحة النموذج في Artificial Analysis، حصل Neon xhigh على 61 نقطة، وحصل Sol max على 57 نقطة.
- البرمجة: سجّل Terminal-bench 4.1 في بطاقة النموذج 65.2% مقابل 61.5%، أما الفرق في SWE-sweep فيعتمد على harness المستخدم.
- المخططات البيانية: يتقدم Sol في Chartography بنسبة 75.1% مقابل 73.5%.
- السياق الطويل: على GraphWalks من 256k إلى 1M، بلغ F1 نسبة 95.2% مقابل 80.1%، وهو أكبر فرق.
- التكلفة والوقت: لكل مهمة 6.44 مقابل 1.01 دولار، و21.5 مقابل 8.5 دقيقة، والسبب الرئيسي أن حجم المخرجات يختلف عدة أضعاف.
- سعر الوحدة: Neon بسعر 3/15 دولارًا، وSol بسعر 2/10 دولارات؛ وعلى APIYI، ينتقل
gpt-6.2-solإلى شريحة سعرية أعلى بعد تجاوز 272000 token من الإدخال.
الخلاصة
عند تحليل الفروقات بين Gemini 4 Neon وGPT-6.2 Sol، تصبح أوضح بكثير مما تبدو عند النظر إلى النتيجة الإجمالية وحدها:
- البرمجة: يتقدم Neon في البنود التي تتوفر لها بيانات في بطاقة النموذج، لكن الفرق لا يزيد على 1.2 نقطة مئوية ضمن إعداد mini-SWE harness نفسه.
- المخططات البيانية: يتقدم Sol في Chartography، بينما يتقدم Neon قليلًا في LVBench.
- السياق الطويل: يتقدم Neon على GraphWalks بفارق 15.1 نقطة مئوية، وهو أوضح فرق بين البنود الثلاثة.
- التكلفة: يفصل بينهما في سعر الوحدة فارق قدره 1.5 مرة، وتختلف تكلفة المهمة الواحدة بنحو 6.4 مرة، والسبب في هذا الاتساع هو عدد tokens الإخراج.
ويعود اختيار أحدهما إلى توزيع مهامك وطول مخرجاتك. نوصي بأن تبدأ بربط gpt-6.2-sol عبر APIYI على apiyi.com، وأن تسجّل الاستخدام والوقت على عينات حقيقية، ثم بعد إطلاق Neon تستخدم سير العمل نفسه لإكمال المقارنة.
📚 المراجع
-
مدونة Google: Introducing Gemini 4 Neon: الإصدار الرسمي والتقييمات المعلنة ذاتيًا
- الرابط:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - الوصف: النتائج الإجمالية والبرمجة والعلوم وتحديد السعر جميعها معلنة ذاتيًا من الشركة
- الرابط:
-
بطاقة نموذج DeepMind Gemini 4 Neon: مصدر جدول المقارنة ثلاثي الأعمدة
- الرابط:
deepmind.google/models/model-cards/gemini-4-neon - الوصف: بيانات تفصيلية لكل بند مثل Chartography وGraphWalks وSWE-sweep وغيرها
- الرابط:
-
دليل مطوري Google Cloud Gemini 4 Neon: النافذة ومستويات التفكير وقواعد التخزين المؤقت
- الرابط:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - الوصف: الحد الأقصى الموحد 1048576 token، وقواعد HTTP 400، وشرح التخزين المؤقت الضمني
- الرابط:
-
صفحة أسعار Google AI Studio: سعر الوحدة الرسمي لنموذج Neon
- الرابط:
aistudio.google.com/docs/pricing - الوصف: الإدخال 3، والإخراج 15، والتخزين المؤقت 0.15 دولار لكل مليون token
- الرابط:
-
صفحة نموذج Artificial Analysis: بيانات فئات Neon وSol
- الرابط:
artificialanalysis.ai/models/gemini-4-neon،artificialanalysis.ai/models/gpt-6-2-sol - الوصف: درجة الذكاء، وتكلفة المهمة الواحدة، والوقت، وسرعة الإخراج
- الرابط:
-
مقال Artificial Analysis: قراءة قياسات Neon من طرف ثالث
- الرابط:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - الوصف: بيانات مثل Coding Agent Index 59 وغيرها
- الرابط:
-
جدول APIYI الإجمالي وواجهة الأسعار: الطرازات المتاحة والأسعار المتدرجة
- الرابط:
docs.apiyi.com/models.md،api.apiyi.com/api/pricing - الوصف: الفئة الأولى لـ
gpt-6.2-solوقاعدة الانتقال عند 272000 token
- الرابط:
المؤلف: فريق APIYI التقني
للتواصل التقني: مرحبًا بكم للتواصل معنا عبر الصفحة الرئيسية لموقع APIYI، ولمزيد من الطرازات وتعليمات الوصول يمكنكم زيارة مركز وثائق docs.apiyi.com