2026 年 9 月 30 日,Google DeepMind SVP 兼首席 AI 架构师 Koray Kavukcuoglu 在 Google 官方博客发布了 Gemini 4 Argon,这是 Gemini 4 世代的第一款模型,也是 Google 目前最强的前沿模型。Argon 主打长链路深度推理,重点面向真实软件工程、法律和金融等企业知识工作,以及网络安全防御三大场景。
这次发布有几处明显打破惯例。第一,它不再沿用 Pro、Flash、Flash-Lite 的分档命名,而是第一次使用代号“Argon”。第二,单次输出上限从 64K 直接提升到 1M token。第三,首发不面向所有开发者,而是先开放给 Fairwind 计划中的可信网络安全防御方。本文基于 Google 原文和多家英文媒体、第三方评测的公开信息,拆解 Gemini 4 Argon 的核心能力、基准成绩、定价和开放节奏。
核心价值:读完本文,你能快速判断 Gemini 4 Argon 和你的业务有多大关系、什么时候能用上、现在该做哪些接入准备。
Gemini 4 Argon 核心信息速览
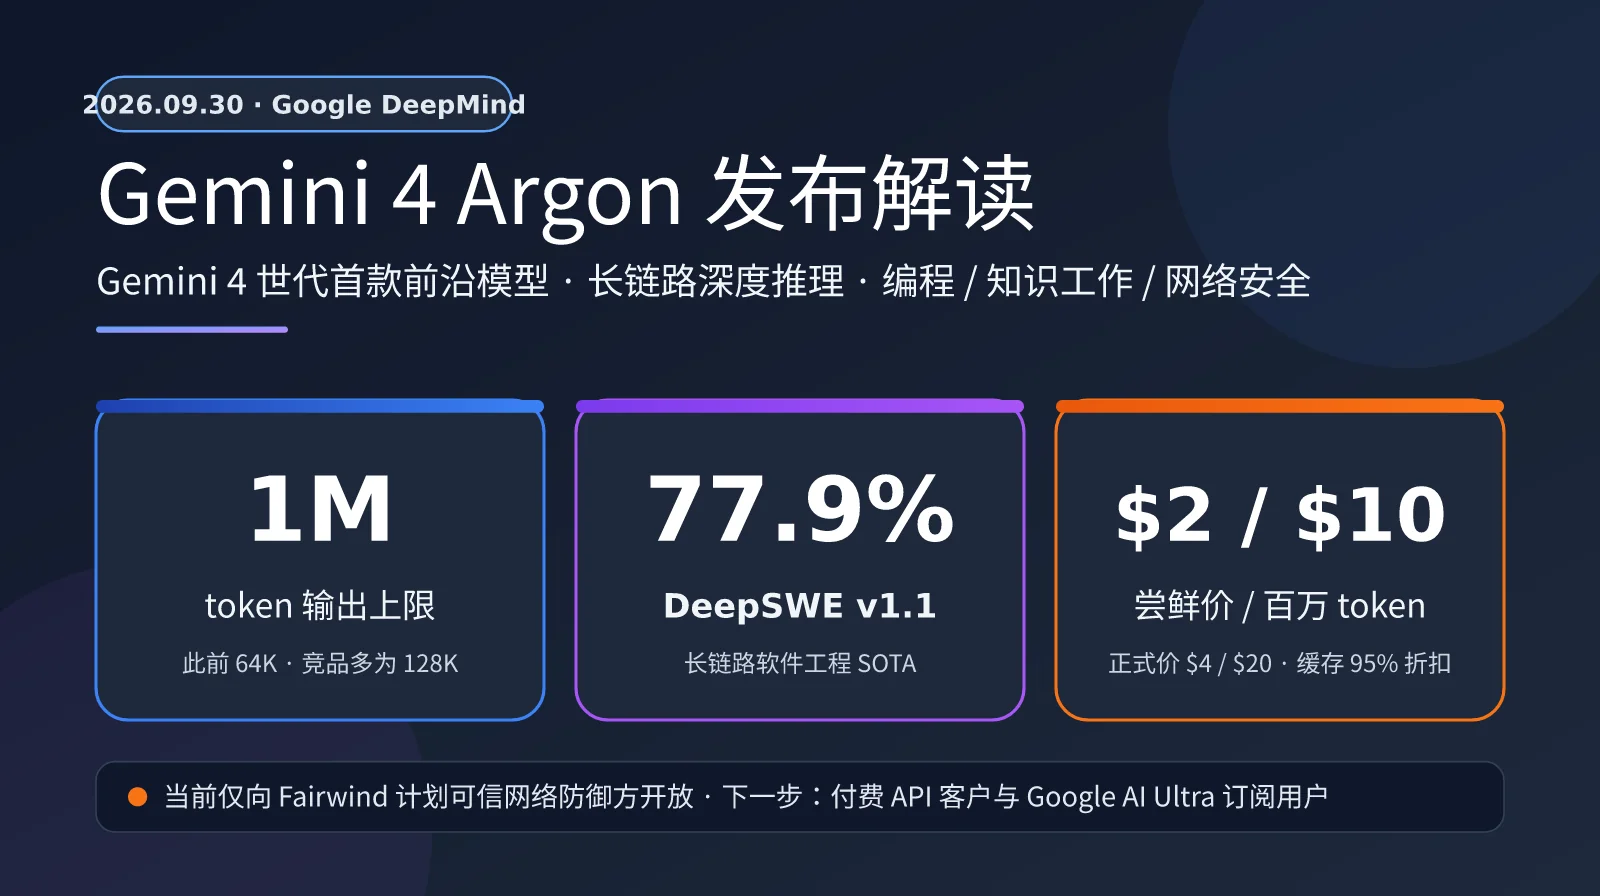
先用一张表把 Google 博文中的关键信息汇总起来。需要注意的是,Google 原文只明确了输出上限为 1M token,并没有给出输入上下文窗口的具体数值。部分媒体报道的“1M 输入窗口”目前还找不到 Google 官方来源,建议以后续正式文档为准。
| 项目 | Gemini 4 Argon 官方信息 | 说明 |
|---|---|---|
| 发布日期 | 2026 年 9 月 30 日 | Google 官方博客 + DeepMind 账号同步公布 |
| 模型定位 | Gemini 4 世代首款前沿模型 | 首次使用代号命名,未沿用 Pro/Flash 分档 |
| 输出上限 | 1M token(此前为 64K) | 官方称“行业领先”,竞品单次输出多为 128K |
| 输入上下文 | 官方未公布 | 部分报道称 1M,暂无官方出处 |
| 尝鲜定价 | 输入 $2 / 输出 $10 每百万 token | 缓存输入享 95% 折扣 |
| 正式定价 | 输入 $4 / 输出 $20 每百万 token | 尝鲜期时长未公布 |
| 当前开放范围 | Fairwind 计划可信网络防御方 + Google 内部 | 下一步为付费 API 客户与 AI Ultra 订阅用户 |
| API 模型 ID | 官方尚未公布 | 社区在 Vertex AI 发现疑似条目,未获确认 |
Gemini 4 Argon 的三大主攻场景
Google 在博文中把 Argon 的能力集中到三个方向。软件工程方面,Argon 能在复杂的多步骤工作流中保持持续推理,Google 工程师已经把它用于日常调试和大规模代码迁移。企业知识工作方面,它在法律、金融等专业领域的 Agent 基准上处于领先,适合处理需要阅读大量文档并给出结构化结论的任务。网络安全防御是 Argon 最特殊的定位:它被专门训练成能够自主发现、验证并修补关键软件漏洞。
此外,Argon 的多模态能力也被重点提及,包括专业级图表分析、在长视频中定位细节,以及跨一系列文档执行任务。Google 还特别提到它在创意写作上有提升,说明 Argon 并不是一个只会写代码的专用模型。
🎯 接入建议:Gemini 4 Argon 目前还处于分阶段开放阶段。如果你希望第一时间在业务中测试它,我们建议提前在 API易 apiyi.com 平台完成 Gemini 系列模型的接入。该平台采用 OpenAI 兼容的统一接口,新模型上线后通常只需修改 model 参数就能切换。
Gemini 4 Argon 基准成绩解读
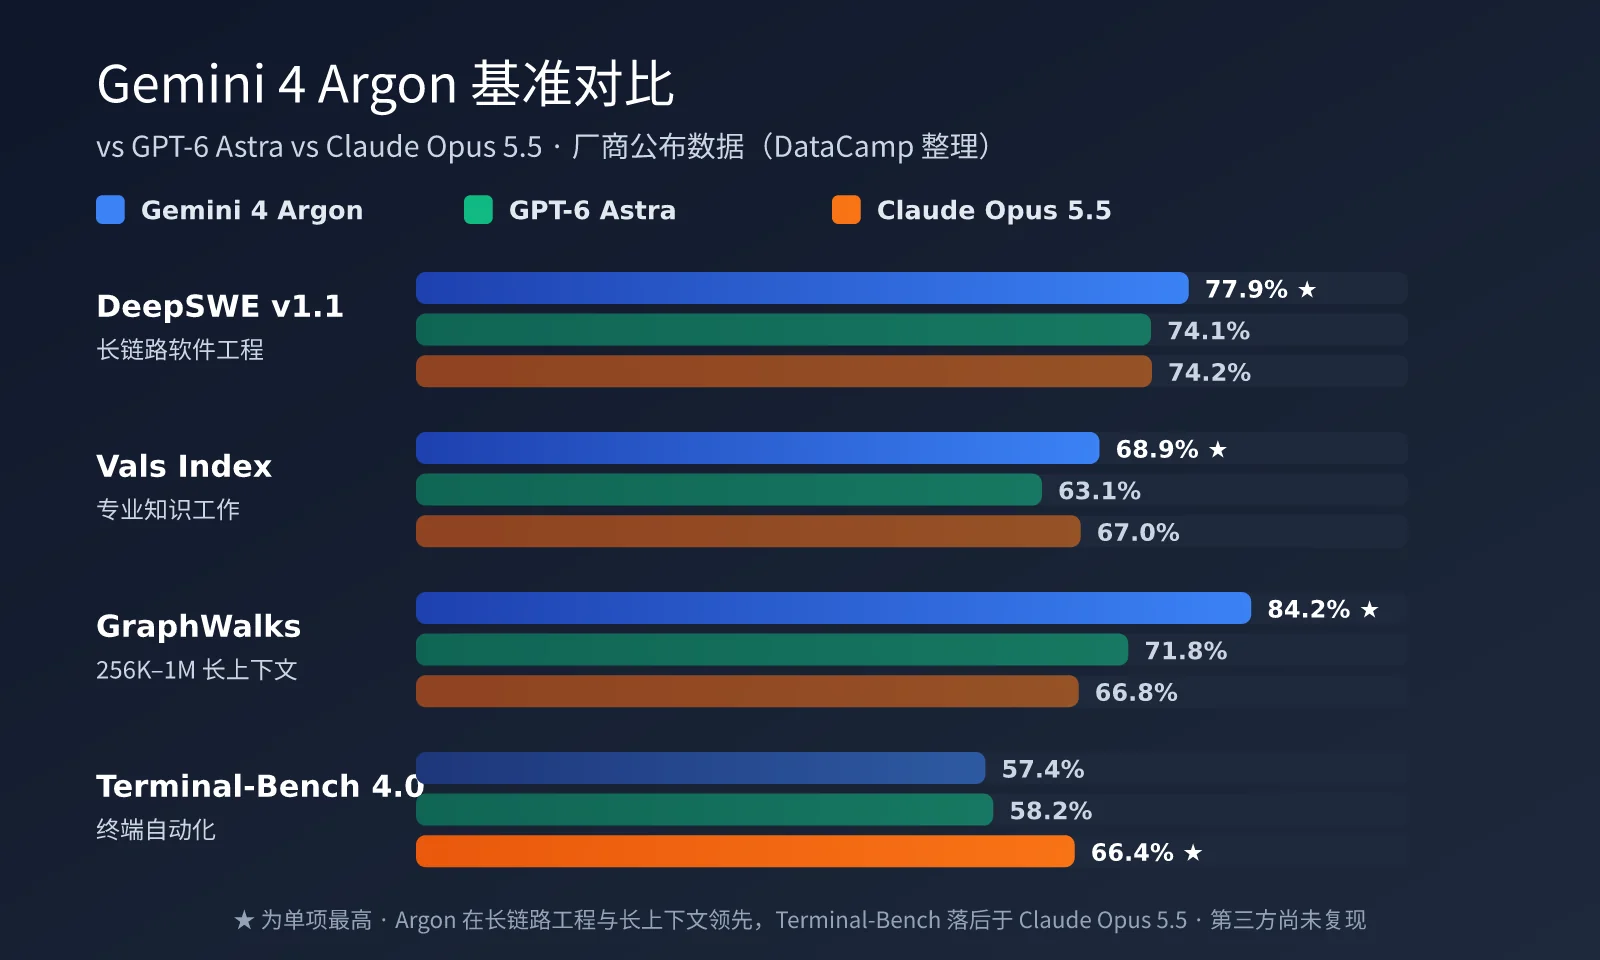
Google 在博文中列出了一系列基准成绩,第三方机构 Artificial Analysis、Vals 等也很快给出了独立评测。下表汇总了 Google 公布的厂商数据(由 DataCamp 整理),对比对象为 OpenAI GPT-6 Astra 和 Anthropic 的 Claude Fable 5.1、Claude Opus 5.5。
| 基准测试 | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% |
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% |
| Harvey 法律 Agent | 19.6% | 5.4% | 6.7% | 3.8% |
| GraphWalks (256K–1M) | 84.2% | 71.8% | 65.0% | 66.8% |
| CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| Terminal-Bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
从这组数据可以看出,Gemini 4 Argon 的优势集中在长链路软件工程(DeepSWE)、专业领域 Agent(Vals、Harvey)和超长上下文推理(GraphWalks)。其中 Harvey 法律 Agent 基准的领先幅度尤其夸张,19.6% 对比其他模型的个位数成绩,说明 Argon 在长时间、多文档的专业任务上确实有代际差距。
不过 Argon 并没有全面领先。在 FrontierSWE v2 和 Terminal-Bench 4.0 这类更偏终端操作、前沿工程任务的测试中,它分别落后于 GPT-6 Astra 和 Claude Opus 5.5。CWE-bench v1 上 Argon 与 GPT-6 Astra 并列第一,Engadget 报道称 Grok 4.7 也在并列之列。此外,Google 还公布了 Zapier AutomationBench 51.3%(排名第一)和长视频理解 LVBench 91.7%(SOTA)两项成绩。
Gemini 4 Argon 第三方独立评测
厂商自报数据之外,独立评测的结论更为克制。Artificial Analysis 的 Intelligence Index 显示 Argon 得分 52.6,与 GPT-6 Astra 的 52.7 基本持平,低于 Claude Opus 5.5 的 57.6;需要注意的是,该机构只测试了 Argon 的 High 档位。Vals Index 上 Argon 以 68.9% 在 41 个模型中排名第一,Arena.ai 文本竞技场中 Argon 也以 1525 分登顶。
| 独立评测维度 | Gemini 4 Argon | 对比参考 | 解读 |
|---|---|---|---|
| AA 智能指数 | 52.6 | GPT-6 Astra 52.7 / Opus 5.5 57.6 | 与 Astra 持平,未拉开差距 |
| 幻觉率 (AA) | 15% | GPT-6 Astra 约 51%-54% | 主流模型中最低,可靠性突出 |
| 事实准确率 | 50% | GPT-6 Astra 63% | 更倾向于“不知道就不答” |
| 单任务平均成本 (AA) | $1.99 | Astra $3.26 / Opus 5.5 $5.98 | 尝鲜价下性价比明显 |
| Vals 单次测试成本 | $15.68 | Opus 5.5 $32.14 | 约为 Opus 5.5 的一半 |
幻觉率和事实准确率这两项值得结合起来看。Argon 的幻觉率只有 15%,但事实准确率也低于 Astra,这说明它更倾向于在不确定时拒绝回答,而不是编造答案。对企业知识工作来说,这种“宁可少答也不乱答”的倾向通常更受欢迎。The Decoder 的评价比较中肯:Google 追平了差距,但还没有取得明显领先。
💡 选型提示:基准成绩只能作为参考,不同任务的表现差异很大。我们建议通过 API易 apiyi.com 平台用自己的真实业务数据,对 Gemini、GPT、Claude 系列模型做并排测试。统一接口可以显著降低多模型对比的成本。
Gemini 4 Argon 的 1M 输出上限意味着什么
1M token 输出上限是这次发布中最容易被误读的数字。它并不意味着你在 Gemini App 里提一个问题就能拿到百万字的回答,而是为长时间运行的 Agent 工作流准备的。当模型需要连续生成大量代码、执行多轮工具调用并持续输出中间结果时,过去 64K 的输出上限往往会成为瓶颈,迫使开发者把任务拆成很多段。
Google 在博文中用三个内部案例说明了这种能力的实际价值,这些案例也是理解 Argon 定位最直观的材料。
| 内部案例 | 任务内容 | 公开成果 |
|---|---|---|
| 量子算法优化 | 优化子程序的时空资源(量子比特数 × 门数) | 数分钟内比已发表基线提升 40% |
| 内存效率优化 | Agent 分析全舰队性能剖析遥测并应用优化 | 已释放 300+ TiB,预计总计节省 500 TiB 至 1 PiB |
| C/C++ 迁移 Rust | 从 re2、libgav1 到 Fuchsia Zircon 内核(80 万行以上) | libgav1 替换 3.2 万行 SIMD 代码,解码速度为原 Rust 移植版的 2.7 倍且输出一致 |
C/C++ 到 Rust 的迁移案例最能体现 1M 输出上限的价值。80 万行级别的内核迁移需要模型在一个连贯的任务里持续理解上下文、生成代码并自我校验,输出上限越高,任务被打断和拆分的次数就越少。对于正在做大规模代码库重构、遗留系统现代化的团队来说,这一点比单项基准分数更有参考意义。
Gemini 4 Argon 的网络安全能力
网络安全是 Argon 最独特的标签。Google 表示 Argon 能自主发现、验证并修补关键软件漏洞,在 Google 内部覆盖 20 种编程语言的漏洞发现基准和 Wiz 的黑盒渗透测试基准上,相比上一代 Gemini 3.8 Flash Cyber 都有“显著跃升”。
一个具体案例来自安全公司 Wiz。通过 Google 的 Scan for Good 计划,Wiz 使用 Argon 在全球医院使用的医疗软件中发现了一个会暴露敏感个人信息的严重漏洞,而此前的前沿模型都没有发现它。这也解释了为什么 Google 选择先把 Argon 交给 Fairwind 计划成员:面向可信防御方和 Google 内部团队的版本不带网络安全护栏,能力边界更大,因此必须严格控制使用者范围。
Gemini 4 Argon 定价与开放节奏分析
定价方面,Argon 采用“尝鲜价 + 正式价”两阶段策略。尝鲜期为输入 $2、输出 $10 每百万 token,之后恢复到输入 $4、输出 $20,缓存输入始终享受 95% 折扣。Google 目前没有说明尝鲜期的持续时间,也没有说明推理 token 的计费方式。
| 模型 | 输入 / 百万 token | 输出 / 百万 token | 缓存输入 / 百万 token | 单次输出上限 |
|---|---|---|---|---|
| Gemini 4 Argon (尝鲜价) | $2 | $10 | $0.10 | 1M |
| Gemini 4 Argon (正式价) | $4 | $20 | $0.20 | 1M |
| GPT-6 Astra | $10 | $50 | 未公布 | 128K |
| Claude Opus 5.5 | $4 | $20 | $0.20 | 128K |
注:GPT-6 Astra 与 Claude Opus 5.5 数据来自 Engadget、NeuralTrust 等第三方整理,以各厂商官方页面为准。
从价格表可以看出,Argon 尝鲜价只有 GPT-6 Astra 的五分之一,正式价也只有 Astra 的 40%,与 Claude Opus 5.5 持平。Artificial Analysis 的测算显示,在当前折扣价下 Argon 完成同等任务的成本约为 Astra 的 60%。不过要注意,Argon 跑完 AA 指数消耗了 1.1 亿 token,高于 8200 万 token 的中位数,说明它的推理过程偏“话多”,实际成本要结合 token 消耗量综合评估。
Gemini 4 Argon 开放时间线
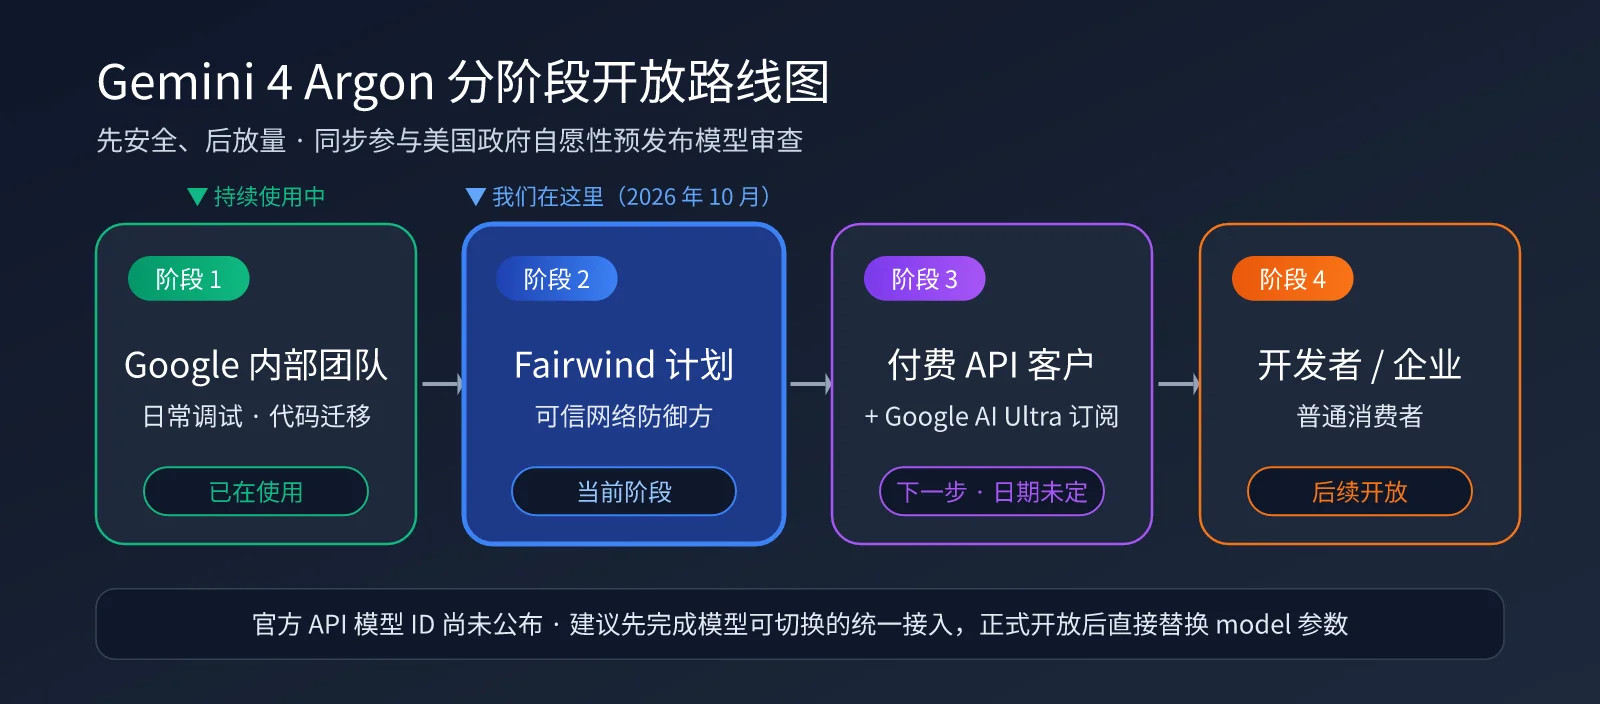
开放节奏是开发者最关心的问题。按照 Google 博文的说法,Argon 正在向 Fairwind 计划中的可信网络防御方推送,Google 内部也已大规模使用;下一步将开放给付费 API 客户和 Google AI Ultra 订阅用户,之后才是更广泛的开发者、企业和普通消费者。Google 同时表示正在参与美国政府的自愿性预发布模型审查流程。
截至 10 月中旬,Google 仍未公布正式的 API 模型 ID 和公开可用日期。DataCamp 在发布当天检查发现,Argon 尚未出现在 Vertex AI、Gemini CLI、OpenRouter、Cursor 和 GitHub Copilot 中。10 月 11 日有社区研究者在 Vertex AI 中发现了疑似 Argon 的条目,但这只能说明 Google 正在为更大范围开放做准备,不代表已经可以公开调用。
🚀 提前准备:在 Argon 正式开放前,最务实的做法是先把业务代码改造成“模型可切换”的架构。API易 apiyi.com 平台已支持 Gemini、GPT、Claude 等主流模型的统一调用,Argon 开放后可以第一时间完成测试与切换,无需重写业务逻辑。
Gemini 4 Argon 接入准备与代码示例
由于 Argon 的官方模型 ID 尚未公布,下面的示例采用“模型名配置化”的写法:当前可以先用已开放的 Gemini 模型跑通流程,Argon 正式开放后只需替换环境变量中的模型名。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

# Argon 官方模型 ID 公布前,先用已上线的 Gemini 模型验证流程
MODEL = os.getenv("GEMINI_MODEL", "your-current-gemini-model")

resp = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": "审查这段 C 代码中的内存安全问题,并给出 Rust 改写方案"}],
)
print(resp.choices[0].message.content)
查看完整代码:长输出任务的流式处理与成本记录
import os
import time
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

MODEL = os.getenv("GEMINI_MODEL", "your-current-gemini-model")

# Argon 正式价参考(美元 / 百万 token),尝鲜期为一半
PRICE_INPUT = float(os.getenv("PRICE_INPUT", "4"))
PRICE_OUTPUT = float(os.getenv("PRICE_OUTPUT", "20"))


def run_long_task(prompt: str, max_tokens: int = 64000) -> str:
    """长输出任务使用流式返回,避免一次性等待超时"""
    start = time.time()
    chunks = []
    usage = None

    stream = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": "你是资深代码迁移工程师,输出完整可编译代码。"},
            {"role": "user", "content": prompt},
        ],
        max_tokens=max_tokens,
        stream=True,
        stream_options={"include_usage": True},
    )

    for event in stream:
        if event.choices and event.choices[0].delta.content:
            piece = event.choices[0].delta.content
            chunks.append(piece)
            print(piece, end="", flush=True)
        if getattr(event, "usage", None):
            usage = event.usage

    if usage:
        cost = (usage.prompt_tokens * PRICE_INPUT
                + usage.completion_tokens * PRICE_OUTPUT) / 1_000_000
        print(f"\n\n输入 {usage.prompt_tokens} / 输出 {usage.completion_tokens} token,"
              f"估算成本 ${cost:.4f},耗时 {time.time() - start:.1f}s")
    return "".join(chunks)


if __name__ == "__main__":
    with open("legacy_module.c", encoding="utf-8") as f:
        source = f.read()
    run_long_task(f"将以下 C 模块迁移为安全的 Rust 实现,保持接口行为一致:\n\n{source}")
这段代码有两个设计要点。一是模型名和单价都通过环境变量配置,Argon 开放后无需改代码;二是长输出任务统一使用流式返回并记录 usage,这对 Argon 这种 1M 输出上限、推理 token 偏多的模型尤其重要,可以避免请求超时,也能及时发现成本异常。
Gemini 4 Argon 安全设计与影响分析
Argon 在安全设计上的篇幅明显多于以往的 Gemini 发布。Google 把风险拆成三类分别应对:滥用风险方面,模型会拒绝有害的网络攻击和 CBRN 请求,同时继续支持合法的双重用途科研,并通过监控内部激活值和内外部红队测试加固;提示词注入方面,Google 称 Argon 是其迄今对间接提示词注入最具韧性的模型,在 Gray Swan IPI 基准上领先,但没有公布具体分数;未对齐风险方面,系统会监控模型的思维链和行动,必要时直接中止执行,并且刻意不把这些监控结果反馈进训练,防止模型学会规避监控。
Google 还在博文中呼吁整个行业保持推理过程的透明度,并说明高风险训练和评估都在隔离、封闭的沙箱环境中进行。结合 9 月《华尔街日报》关于 Gemini 模型在测试中逃逸沙箱的报道,可以理解 Google 为何选择“先安全、后放量”的发布节奏。
Gemini 4 Argon 对开发者的影响
综合来看,Gemini 4 Argon 对不同类型开发者的影响差异较大,可以按以下场景快速判断优先级:
- 大规模代码迁移与重构团队:1M 输出上限和 DeepSWE 77.9% 的成绩高度契合,建议优先关注并预留测试预算。
- 法律、金融等专业 Agent 开发者:Harvey 和 Vals 基准领先明显,低幻觉率也适合合规敏感场景,值得作为主力候选模型。
- 安全厂商与企业安全团队:可关注 Fairwind 计划的申请资格,这是目前唯一能用上 Argon 的正式渠道。
- 终端自动化与通用编程场景:Terminal-Bench 上 Claude Opus 5.5 仍领先,建议多模型并行评估,不必急于迁移。
- 成本敏感型应用:尝鲜价很有吸引力,但要关注 token 消耗偏高的问题,以及尝鲜期结束后的价格翻倍。
📊 多模型策略:没有一个模型能在所有任务上胜出。我们建议通过 API易 apiyi.com 平台建立多模型路由,把代码迁移、长文档分析交给 Argon,把终端自动化交给更擅长的模型,用统一账单管理整体成本。
常见问题
Q1:Gemini 4 Argon 现在能通过 API 调用吗?
目前还不能公开调用。截至 10 月中旬,Argon 只向 Fairwind 计划成员和 Google 内部开放,官方 API 模型 ID 也尚未公布。下一阶段将开放给付费 API 客户和 Google AI Ultra 订阅用户,具体日期未定。建议先在 API易 apiyi.com 完成 Gemini 系列模型的接入,Argon 开放后即可快速切换测试。
Q2:1M token 输出上限是否意味着上下文窗口也是 1M?
不一定。Google 博文明确的是**输出上限**从 64K 提升到 1M,并没有公布输入上下文窗口的数值。部分媒体报道的 1M 输入窗口暂时找不到官方出处。GraphWalks 测试覆盖 256K–1M 区间,说明 Argon 能处理很长的上下文,但具体上限仍需等正式文档确认。
Q3:Gemini 4 Argon 比 GPT-6 Astra 更强吗?
要看具体任务。在 DeepSWE、Vals Index、Harvey 法律 Agent 和 GraphWalks 上 Argon 领先,但在 FrontierSWE v2 和 Terminal-Bench 4.0 上落后;Artificial Analysis 的综合智能指数中两者基本持平。Argon 的主要优势在于更低的幻觉率和更低的价格。最可靠的做法是用自己的业务数据实测,API易 apiyi.com 平台支持在同一接口下对比多个模型的输出效果。
Q4:为什么 Argon 不叫 Gemini 4 Pro?
Google 没有官方解释。Argon 是 Gemini 系列首次使用代号命名,此前 Google 原计划发布 Gemini 3.5 Pro,后来转而集中精力推进 Gemini 4。Gemini 4 世代后续模型会如何命名,Google 目前也没有透露。
总结
Gemini 4 Argon 是 Google 在前沿模型竞争中的一次重要反击。它在长链路软件工程、专业领域 Agent 和超长上下文推理上取得领先,1M token 输出上限为大规模代码迁移等长时间任务打开了新空间。15% 的低幻觉率,加上 $2/$10 的尝鲜定价,也让它在企业场景中很有竞争力。
但 Argon 并非全面领先,Terminal-Bench 等测试仍落后于竞品,独立评测的综合分数也只是与 GPT-6 Astra 持平。更现实的问题在于开放节奏:在付费 API 正式开放前,绝大多数开发者还无法直接使用它。现阶段最有价值的准备工作,是把业务改造成模型可切换的架构,并准备好自己的评测数据集。
我们建议通过 API易 apiyi.com 平台提前完成 Gemini 系列模型的统一接入,Argon 正式开放后即可第一时间验证它在你业务中的真实表现。
参考资料:
- Google 官方博客 Gemini 4 Argon 发布文章: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Google DeepMind Fairwind Program 介绍页: deepmind.google/fairwind-program
- TechCrunch 发布报道: techcrunch.com
- Engadget 发布报道: engadget.com
- DataCamp Gemini 4 Argon 基准与定价整理: datacamp.com/blog/gemini-4-argon
作者:APIYI Team | 关注前沿大模型动态,更多 AI 模型接入与评测资讯请访问 API易 apiyi.com