作者注:已经在 API易 用 Responses 的 image_generation 做“边聊边出图”的开发者,迁移到独立 Images API 后,可以按本文的方法保留连续改图。
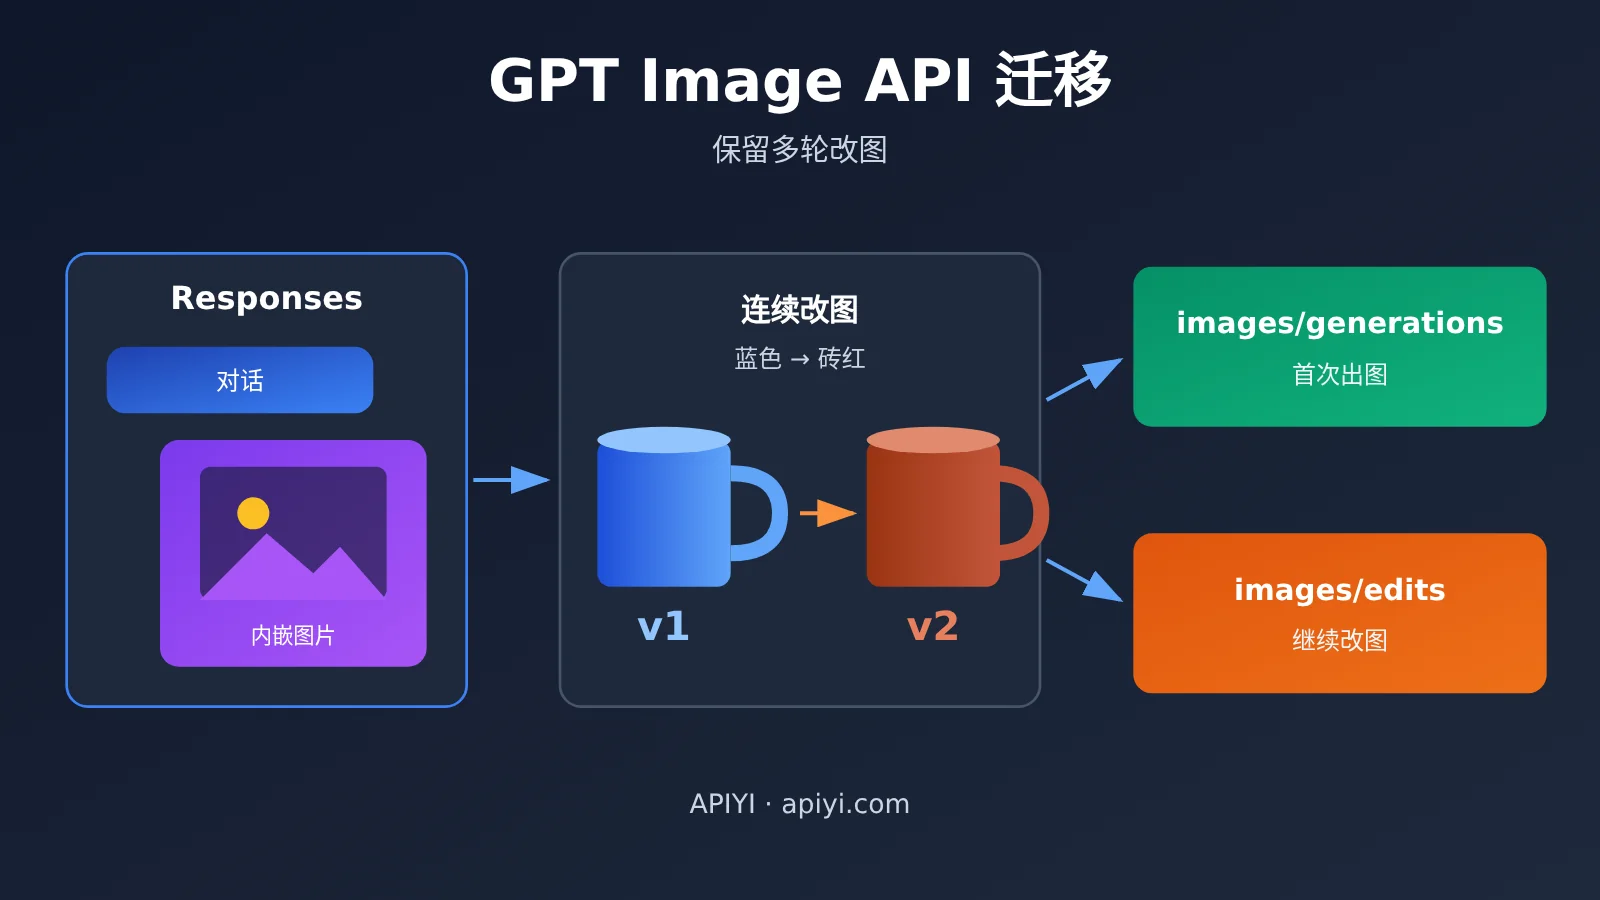
结论先行:只迁移出图这一段,原有的文字对话不用动。以前靠 previous_response_id 隐式接上的“上一张图”,现在由你的应用自己保存,并在每次改图时明确选中,作为原图上传给 POST /v1/images/edits。这样做之后,多轮改图的效果不变,变的只是“上一张图”由谁来记住。
这条结论成立的前提,是 API易 在 2026-11-21 22:30(北京时间)发布的文档更新。五款官转图像模型改为推荐走两条独立图片端点。OpenAI 并没有停用 Responses,站内的文字对话也照常可用。下文所有接口、字段和计费口径都来自 API易 apiyi.com 文档和 OpenAI 官方图像生成指南。代码属于文档示例,不代表实测结果。
GPT Image API 迁移知识地图与索引
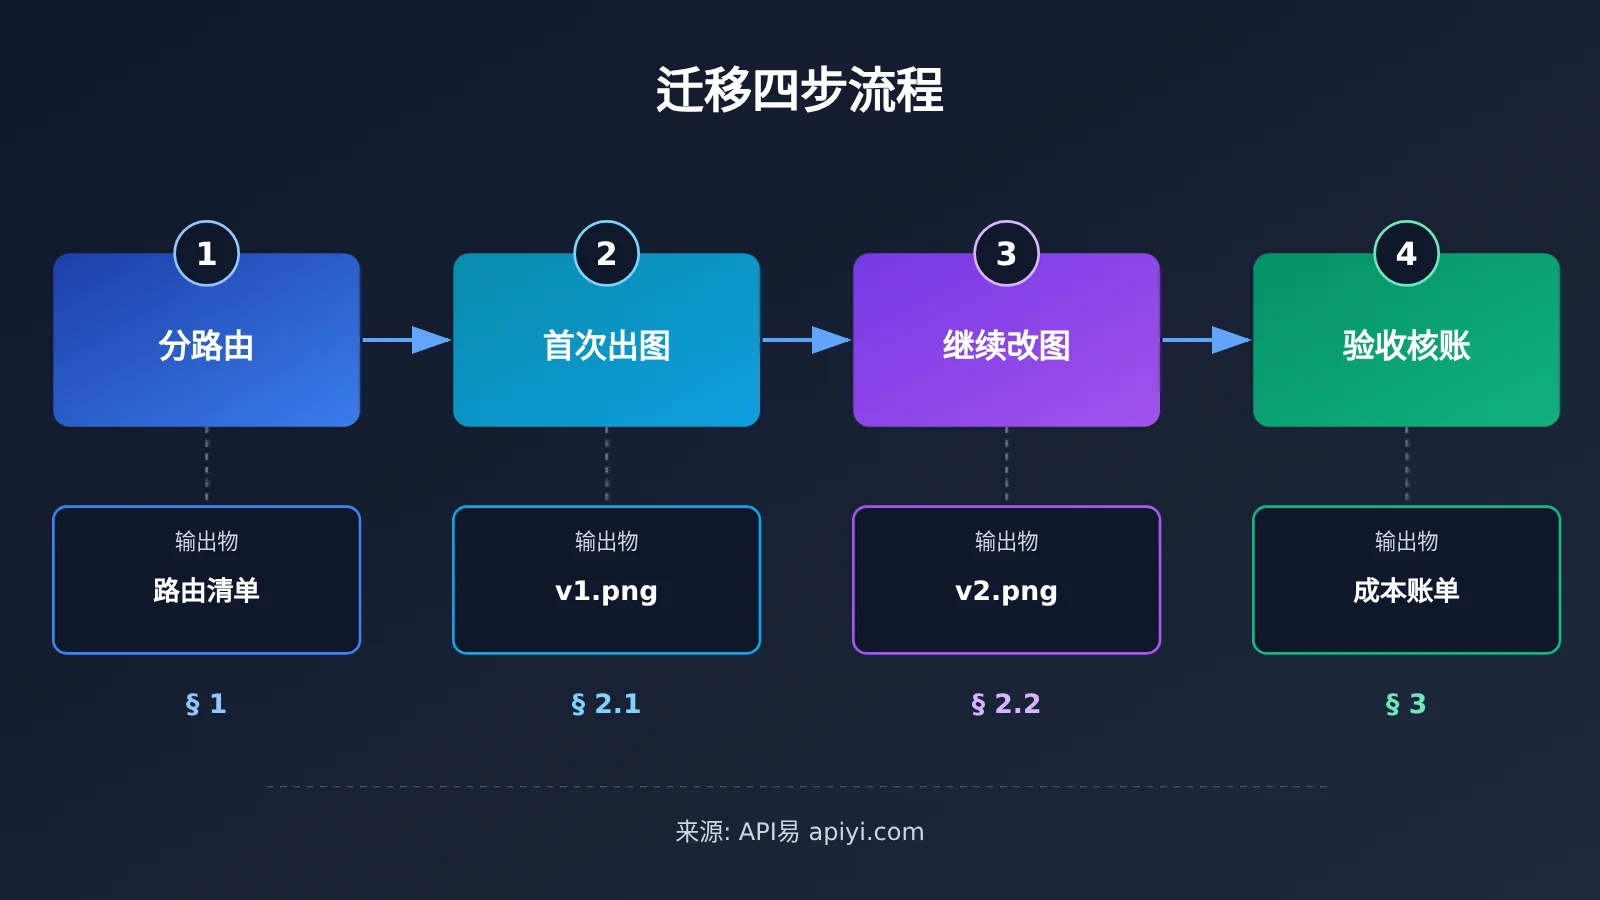
整个迁移按四步推进,每一步的输出就是下一步的输入:
辨认旧调用并分路由 (第1节)
   └─> 输出: 每个请求该走对话、generations 还是 edits
生成并存下第一张图 (第2.1节)
   └─> 输出: 已校验的 v1.png + 资产记录
把选中的原图交给编辑接口 (第2.2节)
   └─> 输出: v2.png + parent_asset_id 关联
验收和核账 (第3节)
   └─> 输出: 可用图片列表 + 每张验收图成本
| 步骤 | 依赖什么 | 为什么排在这里 | 目标 |
|---|---|---|---|
| 1 分路由 | 现有代码里的调用清单 | 先确定改哪里,才不会误改文字对话 | 只把出图请求切到 Images API |
| 2.1 首次出图 | 第 1 步确定的 generations 路由 | 后续改图需要一张真实保存的原图 | 得到校验过的 v1 并入库 |
| 2.2 继续改图 | 第 2.1 步保存的 v1 文件 | 独立端点不认 previous_response_id,只认你上传的图 |
得到 v2,并记下父子关系 |
| 3 验收核账 | 第 2 步的图片与控制台日志 | 只有验收通过的图才计入成本分母 | 可交付图片 + 可解释的账单 |
阅读顺序建议:第 1 节必读;第 2 节按代码顺序跟着做;第 3 节在上线前或出现断连、账单疑问时查阅。
To Know:GPT Image API 迁移术语
| 术语 | 简明解释 |
|---|---|
| 官转 | API易 提供的官方转发通道模型,本文指五款图像模型 ID |
| image_generation | Responses API 里的图片生成工具,旧链路通过它边聊边出图 |
| previous_response_id | Responses 用来延续上一轮上下文的参数,独立 Images 请求不接收 |
| multipart | 表单上传格式,/images/edits 用它传真实图片二进制 |
| b64_json | 独立图片端点返回图片的字段,内容是 base64 编码的图片 |
| parent_asset_id | 应用自行记录的“这张图由哪张图改来”的关联字段 |
1 哪些 GPT Image API 调用需要从 Responses 迁移
1.1 GPT Image API 11/21 动态的范围与五款官转
这次文档更新涉及以下五个官转模型 ID:
gpt-image-2.6-sunburstgpt-image-2.6-flaregpt-image-2.5-sunburstgpt-image-2.5-flaregpt-image-2
对应的两条独立图片端点分别是 POST /v1/images/generations(JSON 请求体)和 POST /v1/images/edits(multipart 表单)。API易 不推荐继续用 Responses 的 image_generation 链路出图,原因有两个:一是供应不稳定,二是会产生额外的工具费。另外,Chat Completions 不支持用这五款官转图像模型出图,旧代码里如果有这种用法,也要一起归到迁移清单里。
需要说明的是,这次调整只影响出图。OpenAI 没有停用 Responses,API易 站内的文字对话也没有停用。所以迁移范围只限于“请求里调用了图片工具或图像模型”的那部分代码。五款模型之间怎么选,属于另一个话题,可以查看 API易 apiyi.com 帮助中心的模型选型文章,本文不展开。
1.2 GPT Image API 文字对话、首次出图与继续改图的路由
API易 的 FAQ 给出的组合方式是:对话模型负责判断用户意图,应用再单独调用 Images API 并自己管理图片。按这个思路,原来一个 Responses 请求包办的三件事,可以拆成三条路由:
| 用户意图 | 新路由 | 请求格式 | 图片来源 |
|---|---|---|---|
| 纯文字聊天、问答 | 保持原有文字对话接口 | 不变 | 无 |
| 第一次出图 | POST /v1/images/generations |
JSON | 仅 prompt |
| 在某张图上继续改 | POST /v1/images/edits |
multipart | 应用上传已选中的原图 |
在原生 Responses 里,延续改图可以通过 previous_response_id 实现,也可以直接传入图片。独立的 Images 请求不接收 previous_response_id,这就是“多轮改图”需要由应用接管的根本原因。模型不再替你记住上一张图,你得把那张图的文件交给它。
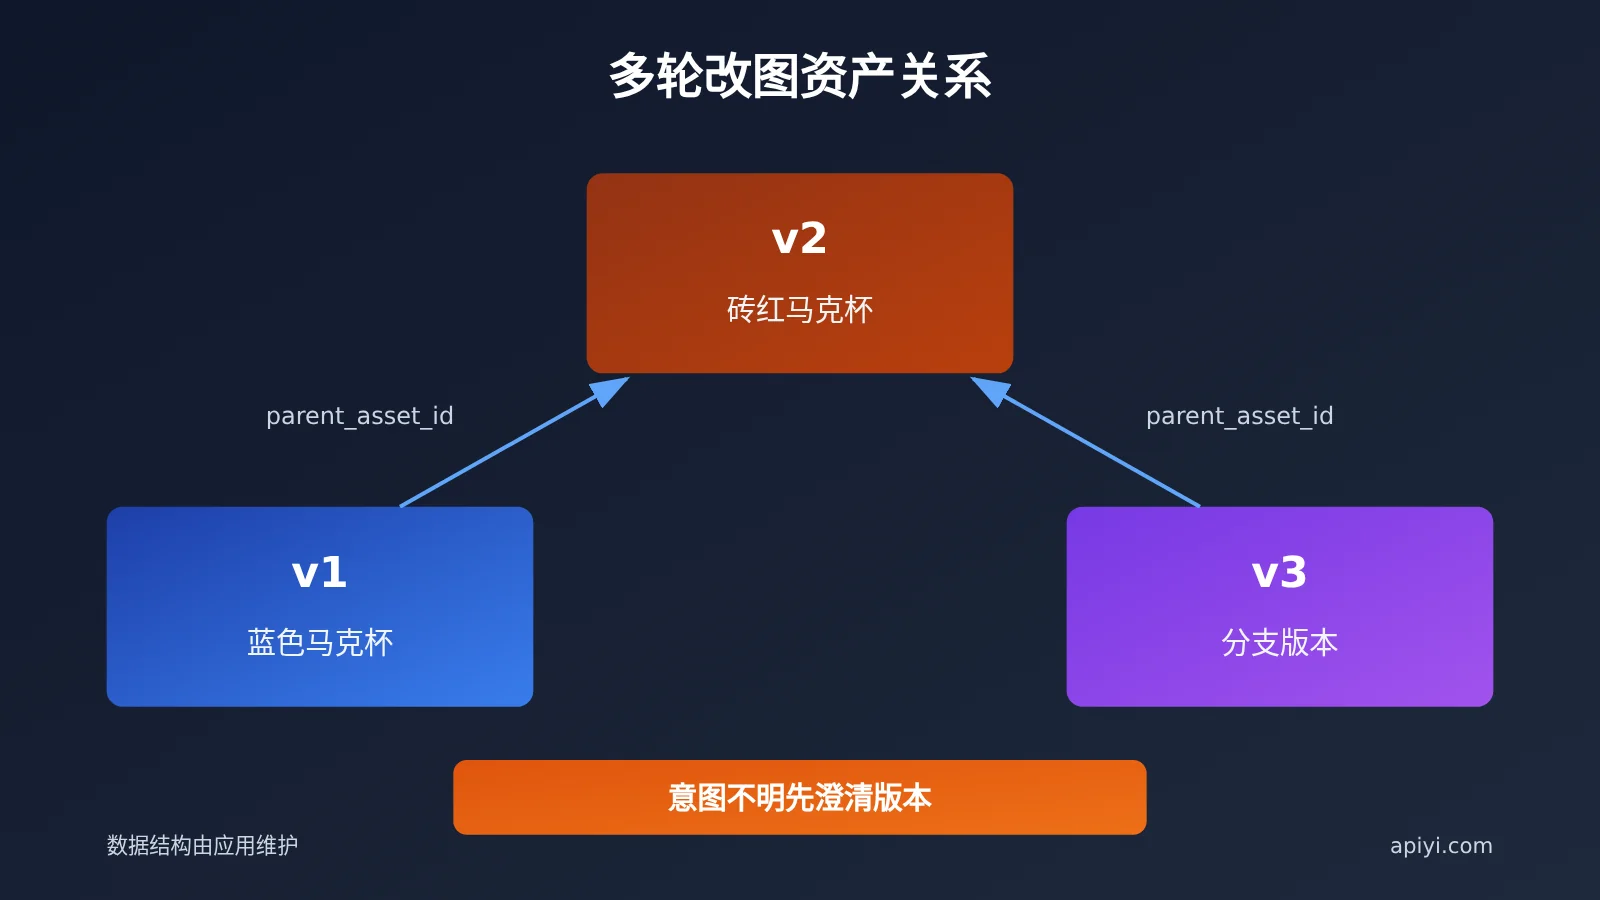
如果用户说“再红一点”,但会话里已经有 v1、v2、v3 好几版,应用无法确定指的是哪一版,这时应该先向用户确认,不要猜。默认用最新一版看起来省事,但一旦用户其实想回到 v2 重新改,就会白白多一次扣费,还会把用户搞糊涂。
响应解析也要跟着改:
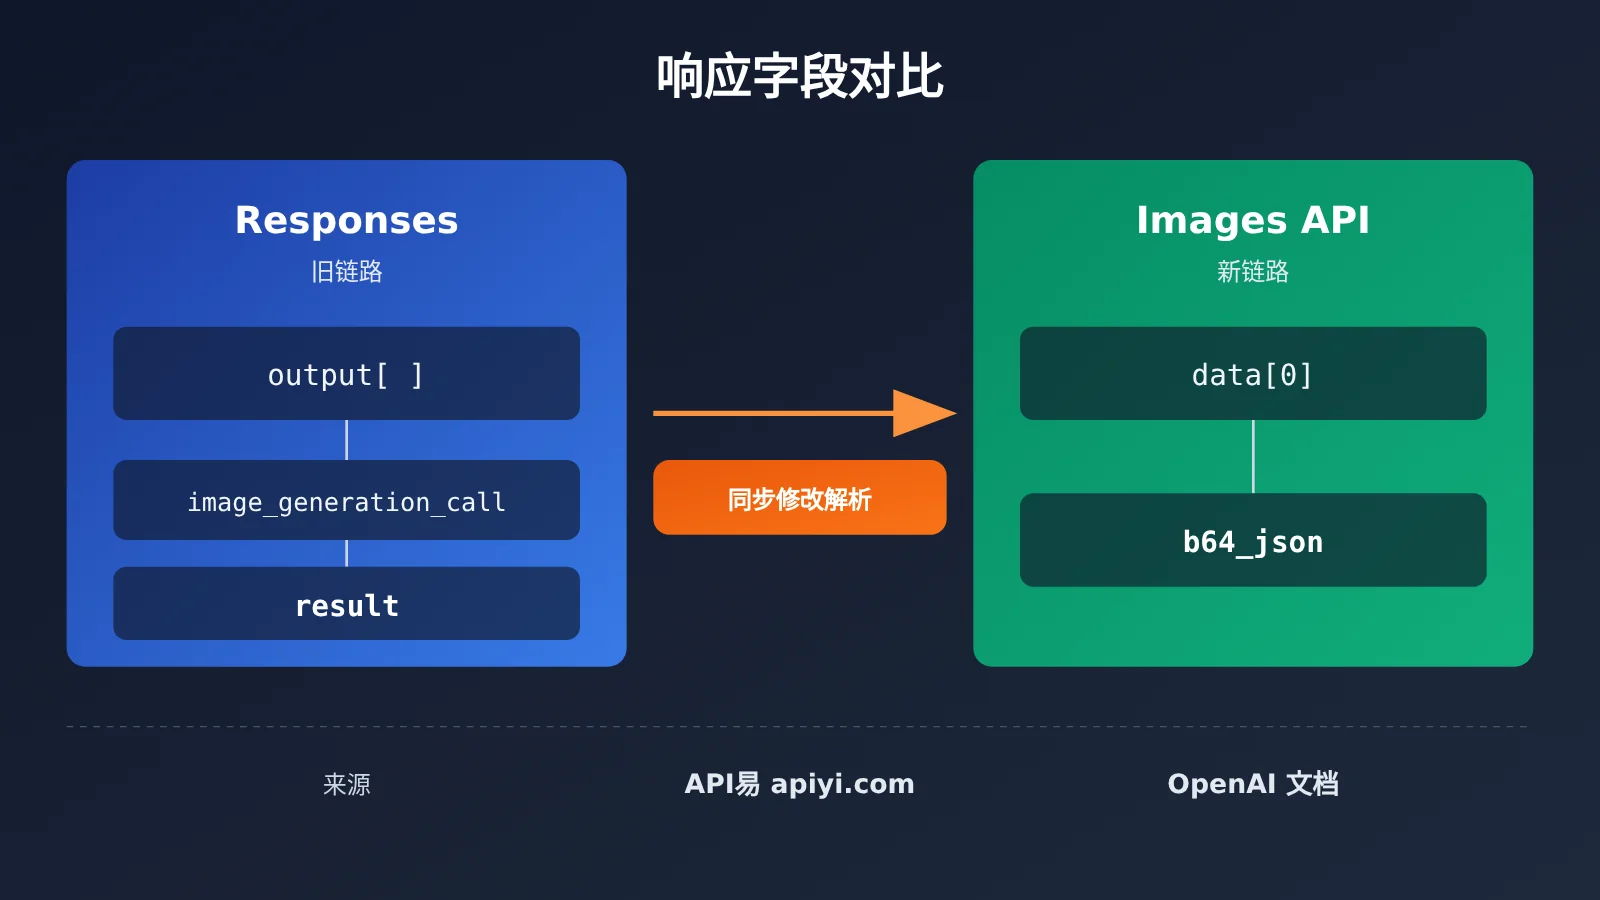
| 链路 | 图片在响应中的位置 | 上下文延续方式 |
|---|---|---|
| Responses + image_generation | output 中 type=image_generation_call 那一项的 result |
previous_response_id 或传图 |
| 独立 Images API | data[0].b64_json |
应用上传已选原图 |
2 GPT Image API 如何续改上一张图
下面用一个两轮的例子说明完整流程。第一轮生成一只蓝色马克杯,第二轮只把杯身改成砖红色。参数沿用 API易 文档示例:模型 gpt-image-2.5-sunburst,尺寸 1024x1024,quality=medium,output_format=png。令牌从环境变量 APIYI_KEY 读取,以 Bearer 方式传入。
2.1 GPT Image API 生成并校验蓝色马克杯 PNG
第一轮调用 generations 端点,提示词描述的是:浅灰背景,蓝色陶瓷马克杯居中,把手朝右,柔和侧光,画面里没有文字。拿到响应后按以下顺序处理:
- 调用
raise_for_status(),先排除 HTTP 层面的失败。 - 对
b64_json做严格 base64 解码,解不开就算失败。 - 用 Pillow 打开并调用
load(),确认文件真的能解码成图片。 - 确认格式是 PNG、尺寸是 1024×1024,然后保存为
v1.png。 - 在应用里登记这份资产,后续改图从这里取原图。
第 3 步不能省。open() 只读取文件头,图片数据有没有截断,要等到 load() 才会暴露出来。
2.2 GPT Image API 上传已选原图,仅把杯身改砖红
第二轮调用 edits 端点。data 里传 model、prompt、size、quality、output_format,files 里用 image[] 字段上传 v1.png 的真实二进制。提示词的意思是:只把杯身改成砖红色,杯形、把手、构图、光线和背景都保持不变。
这一步有几个容易出错的地方:
- 不要传
response_format。 - 不要手写
Content-Type。requests 会自动生成带 boundary 的 multipart 头,手写反而会把 boundary 弄丢。 - 不要把 base64 字符串当作文件上传,上传的必须是图片的原始字节。
改完后用同样的方式解码、校验,保存为 v2.png。v1 要保留,同时在资产记录里写上 parent_asset_id = v1。这条父子关系,就是新架构下的“多轮上下文”。还要注意,这是生成式编辑,模型会尽量保留其他区域,但不保证除杯身以外的像素逐一相同。
以下是最小完整示例(文档示例,未在本文中实测):
import base64
import io
import os
import uuid

import requests
from PIL import Image

BASE_URL = "https://api.apiyi.com/v1"  # API易 unified endpoint
API_KEY = os.environ["APIYI_KEY"]
HEADERS = {"Authorization": f"Bearer {API_KEY}"}
MODEL = "gpt-image-2.5-sunburst"
SIZE = "1024x1024"
# Example mid-range timeout; tune for your network and quality. No auto retry.
TIMEOUT = (10, 360)

assets = {}  # asset_id -> {"path": ..., "parent_asset_id": ...}


def decode_and_check(resp, path):
    resp.raise_for_status()
    item = resp.json()["data"][0]
    b64 = item.get("b64_json")
    if not b64:
        raise ValueError("no b64_json in response, check body before any resend")
    raw = base64.b64decode(b64, validate=True)
    img = Image.open(io.BytesIO(raw))
    img.load()
    if img.format != "PNG" or img.size != (1024, 1024):
        raise ValueError(f"unexpected image: {img.format} {img.size}")
    with open(path, "wb") as f:
        f.write(raw)
    return path


def save_asset(path, parent_asset_id=None):
    asset_id = str(uuid.uuid4())
    assets[asset_id] = {"path": path, "parent_asset_id": parent_asset_id}
    return asset_id


# Round 1: text-to-image via JSON
gen_resp = requests.post(
    f"{BASE_URL}/images/generations",
    headers=HEADERS,
    json={
        "model": MODEL,
        "prompt": (
            "Light gray background, a blue ceramic mug centered, "
            "handle facing right, soft side lighting, no text."
        ),
        "size": SIZE,
        "quality": "medium",
        "output_format": "png",
    },
    timeout=TIMEOUT,
)
v1_id = save_asset(decode_and_check(gen_resp, "v1.png"))

# Round 2: edit the explicitly selected original via multipart
selected_id = v1_id  # if the user's target version is unclear, ask first
with open(assets[selected_id]["path"], "rb") as f:
    edit_resp = requests.post(
        f"{BASE_URL}/images/edits",
        headers=HEADERS,  # no manual Content-Type; requests sets the boundary
        data={
            "model": MODEL,
            "prompt": (
                "Change only the mug body to brick red. Keep the mug shape, "
                "handle, composition, lighting and background unchanged."
            ),
            "size": SIZE,
            "quality": "medium",
            "output_format": "png",
        },
        files={"image[]": ("v1.png", f, "image/png")},
        timeout=TIMEOUT,
    )
v2_id = save_asset(decode_and_check(edit_resp, "v2.png"), parent_asset_id=selected_id)
print(assets)
示例里 timeout=(10, 360) 只是文档中的中档设置,实际取值要结合你的网络链路和画质档位来定。示例也刻意没有写自动重试,原因见 3.2 节。
🚀 快速验证:把
APIYI_KEY设为你在 API易 apiyi.com 控制台创建的令牌,上面的脚本就能跑完两轮流程。新用户可以先用免费测试额度确认路由和解析逻辑,再切换生产流量。
3 GPT Image API 迁移后怎么验收并核账
3.1 GPT Image API 图片验收的四道关
只有四道关全部通过,一张图才能在应用里标记为“可用”:
- HTTP 成功:
raise_for_status()没有抛出异常。 - 可解码:严格 base64 解码成功,Pillow
load()成功。 - 规格正确:格式和尺寸与请求一致,本例是 PNG、1024×1024。
- 视觉改动确实发生:v2 的杯身确实变成了砖红色,杯形、把手、构图和背景基本保持。
第 4 关需要人工检查或单独的审核环节,因为 HTTP 状态码看不出模型有没有改对。只通过前三关的图,最多算“技术上有效”,还不能交付。如果响应里根本没有图片,应该先检查响应内容再决定是否重试,这个问题在帮助中心有专门的文章讨论,本文不重复。
3.2 GPT Image API 旧工具费与每张验收图成本
迁移前后,账单口径是不同的:
| 项目 | 旧 Responses image_generation 链路 | 独立 Images API |
|---|---|---|
| 额外费用 | 约 $0.20 的 API易 图片工具额外调用费 | 无此项工具费 |
| 该数字的含义 | 仅指这笔额外工具费,不是整单价格,也不是 OpenAI 的通用价格 | 按量计费 |
| 适合的比较方式 | 按“每张验收图成本”比较 | 按“每张验收图成本”比较 |
不要只拿单价对比,建议统一用下面这个公式:
每张验收图成本 = 相关实际扣费(含所需文本调用、已扣费的失败请求和重试)÷ 验收通过的图片数
分子要把所有相关扣费都算进去,包括判断意图的对话调用、已扣费的失败请求和重试。分母只计入通过 3.1 节四道关的图。如果一张通过的图都没有,就不要计算单张成本,因为这时的结论应该是“流程有问题”,而不是“单价很高”。迁移能省多少钱,取决于你的重试率和验收通过率,本文不给具体比例。
核账的数据来自控制台消费日志,其中消费记录的 type=2。如果读取的是 quota 字段,按平台文档用 quota ÷ 500000 换算成金额。
断连的处理要特别注意。独立图片端点是同步返回的,连接中途断开时,这次请求可能已经扣费,而且无法通过 request ID 找回图片。正确的顺序是:先到 API易 apiyi.com 控制台的消费日志确认这次请求是否扣费,再决定要不要补发。这也是示例代码没有写自动重试的原因,自动重试很容易在断连时造成重复扣费。如果遇到限流或者需要切换通道,可以参考帮助中心关于通道选择与 429 降级的文章。
迁移完成的检验标准很直接:文字对话照常可用;首轮出图稳定返回可以通过四道关的 v1;每次改图都能在资产记录里查到明确的 parent_asset_id;控制台日志里每一笔图片扣费都能对应到一张验收图、一次已知的失败,或者一次有记录的补发。这几项都满足后,就可以把剩余的 Responses 出图流量切到 Images API。需要多模型对照测试时,API易 apiyi.com 提供统一的 OpenAI 兼容接口,换模型时只需修改 MODEL 一个参数。
参考资料
-
API易 文档更新:官转图像模型改走 Images API
- 链接:
docs.apiyi.com/live/2026-11/gpt-image-official-relay-images-api - 说明:五款官转 ID、两条独立端点和不推荐旧链路的原因
- 链接:
-
API易 FAQ:一个 API 里同时处理文字与图片
- 链接:
docs.apiyi.com/faq/text-and-image-in-one-api - 说明:对话模型判断意图、应用单独调用 Images API 的组合方式
- 链接:
-
OpenAI 图像生成指南
- 链接:
developers.openai.com/api/docs/guides/image-generation - 说明:Responses 的延续编辑方式与响应结构
- 链接:
-
API易 GPT Image 2 文生图 / 图片编辑
- 链接:
docs.apiyi.com/api-capabilities/gpt-image-2/text-to-image - 链接:
docs.apiyi.com/api-capabilities/gpt-image-2/image-edit - 说明:请求参数、multipart 上传与解码校验示例
- 链接:
-
API易 Responses 图片工具 / 图片 API 最佳实践 / 日志查询
- 链接:
docs.apiyi.com/api-capabilities/gpt-image-2/responses-image-tool - 链接:
docs.apiyi.com/api-capabilities/image-api-best-practices - 链接:
docs.apiyi.com/api-capabilities/log-query - 说明:工具费口径、断连处理与消费日志换算
- 链接:
作者: APIYI 技术团队
技术交流: 迁移中遇到路由或账单问题,欢迎通过 API易 apiyi.com 首页联系我们,更多接口细节可查阅 docs.apiyi.com 文档中心