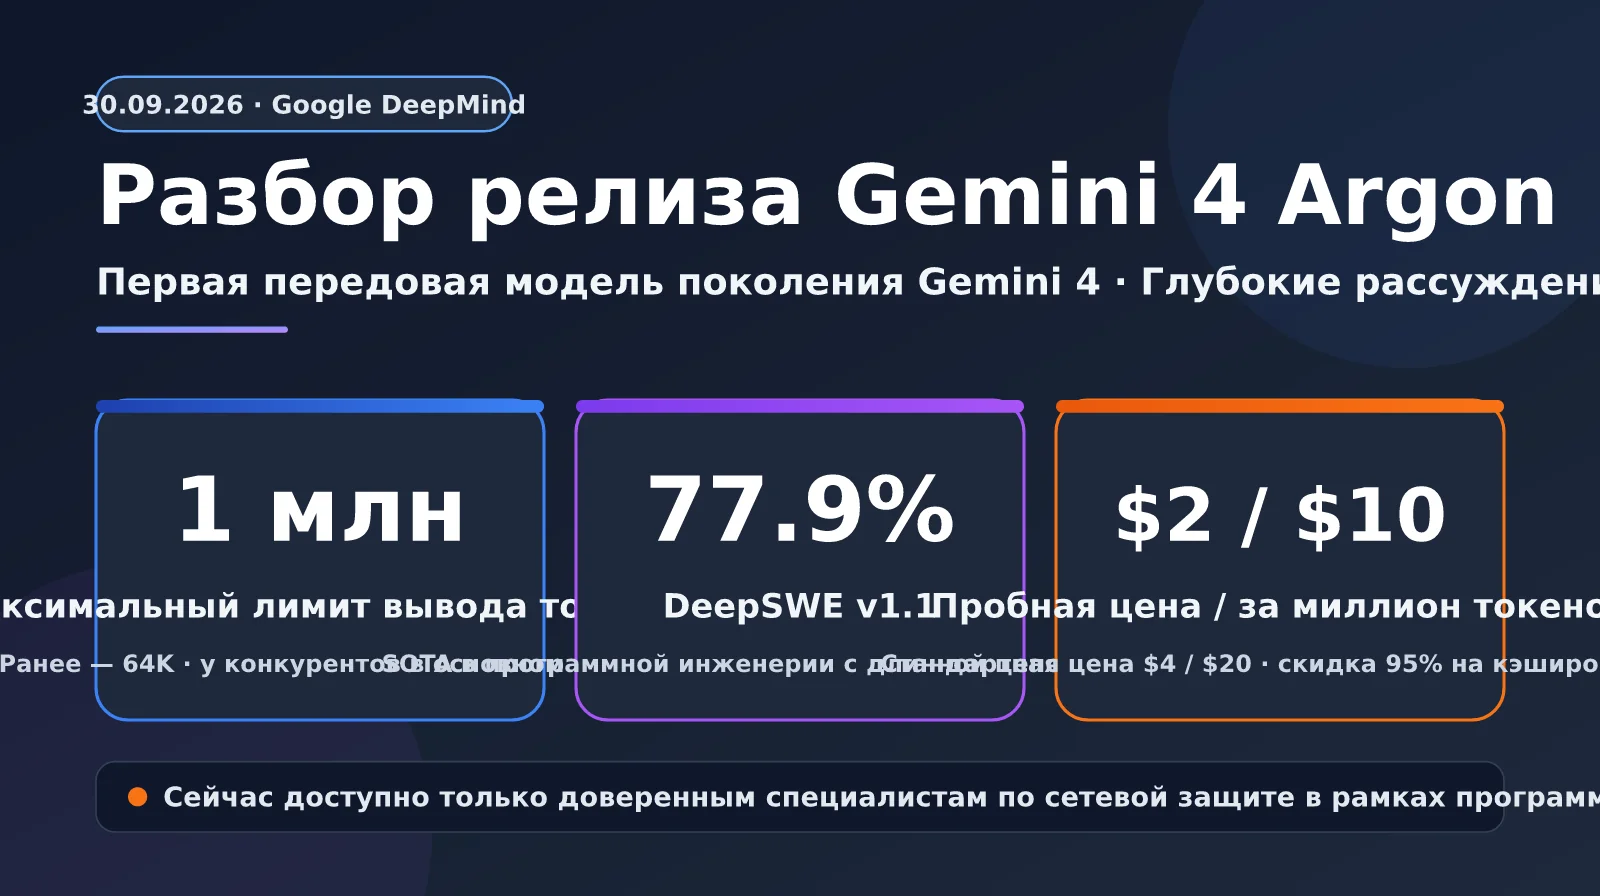
30 сентября 2026 года старший вице-президент Google DeepMind и главный архитектор ИИ Koray Kavukcuoglu представил в официальном блоге Google Gemini 4 Argon — первую модель поколения Gemini 4 и самую мощную передовую модель Google на сегодняшний день. Argon ориентирован на сложные задачи, требующие глубоких рассуждений в несколько этапов. В первую очередь он предназначен для реальной разработки ПО, корпоративных задач в сфере юриспруденции и финансов, а также защиты от киберугроз.
В этом запуске есть несколько заметных отступлений от привычного подхода. Во-первых, вместо линейки Pro, Flash и Flash-Lite модель впервые получила кодовое имя — «Argon». Во-вторых, максимальный объём одного ответа вырос с 64K до 1M токенов. В-третьих, на старте модель доступна не всем разработчикам: сначала её предоставят надёжным специалистам по киберзащите в рамках программы Fairwind. В этой статье мы разберём основные возможности Gemini 4 Argon, результаты бенчмарков, цены и планы по открытию доступа на основе публикации Google, материалов англоязычных СМИ и независимых оценок.
Главное: прочитав статью, вы сможете быстро оценить, насколько Gemini 4 Argon подходит для ваших задач, когда его можно будет использовать и какую подготовку стоит начать уже сейчас.
Кратко о Gemini 4 Argon
Сначала соберём в таблице ключевые сведения из публикации Google. Обратите внимание: Google указал только максимальный объём ответа — 1M токенов, но не назвал точный размер входного контекстного окна. В некоторых публикациях упоминается «входное окно в 1M токенов», однако официального подтверждения Google пока нет. Ориентироваться стоит на будущую официальную документацию.
| Параметр | Официальные данные о Gemini 4 Argon | Примечание |
|---|---|---|
| Дата выпуска | 30 сентября 2026 года | Объявление в официальном блоге Google и аккаунте DeepMind |
| Позиционирование | Первая передовая модель поколения Gemini 4 | Впервые использовано кодовое имя; деления на Pro и Flash нет |
| Максимальный объём ответа | 1M токенов (ранее — 64K) | Google называет этот показатель «лидирующим в отрасли»; у конкурентов максимальный объём одного ответа обычно составляет 128K |
| Входное контекстное окно | Официально не опубликовано | В некоторых публикациях указано 1M, но официального источника пока нет |
| Цена на старте | $2 за миллион входных токенов / $10 за миллион выходных токенов | Скидка 95% на кэшированные входные токены |
| Обычная цена | $4 за миллион входных токенов / $20 за миллион выходных токенов | Продолжительность периода с пониженной ценой не объявлена |
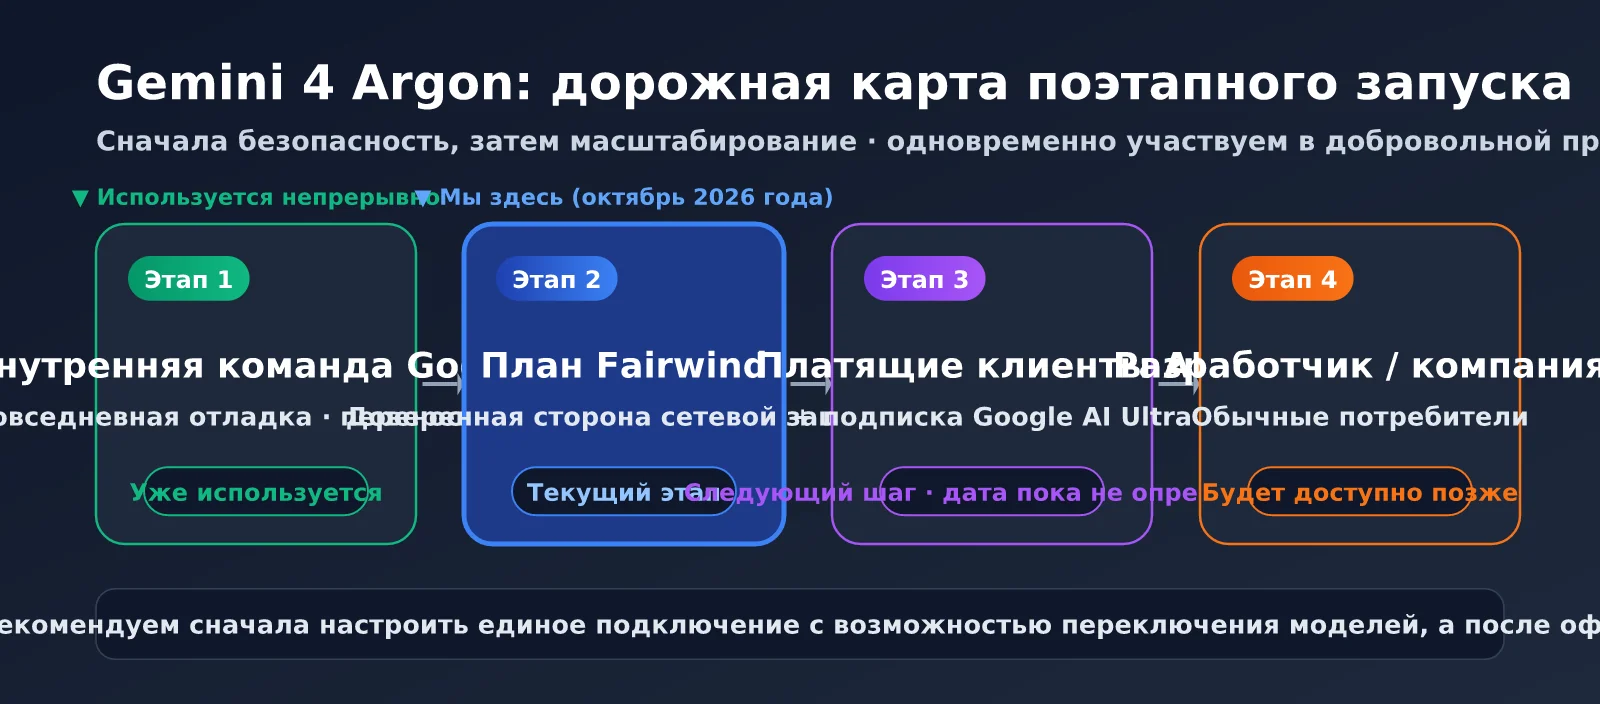
| Текущий доступ | Надёжные специалисты по киберзащите из программы Fairwind и сотрудники Google | Следующий этап — платные клиенты API и подписчики AI Ultra |
| Идентификатор модели в API | Официально не опубликован | В сообществе заметили возможную запись в Vertex AI, но Google её не подтвердил |
Три основных направления Gemini 4 Argon
В публикации Google выделил для Argon три ключевых направления. В разработке ПО модель способна поддерживать рассуждения на протяжении сложных многоэтапных рабочих процессов. Инженеры Google уже используют её в повседневной отладке и масштабной миграции кода. В сфере корпоративных знаний Argon показывает лидирующие результаты в Agent-бенчмарках для профессиональных областей, таких как юриспруденция и финансы. Он подходит для задач, где нужно изучить большой объём документов и подготовить структурированные выводы. Особенность Argon — киберзащита: модель специально обучали самостоятельно обнаруживать, проверять и устранять критические уязвимости в ПО.
Google также отдельно отметил мультимодальные возможности Argon: анализ сложных диаграмм, поиск нужных деталей в длинных видео и выполнение задач на основе целого набора документов. Кроме того, по словам Google, модель стала лучше справляться с творческим письмом. Так что Argon — не узкоспециализированная модель только для программирования.
🎯 Совет по подключению: Gemini 4 Argon пока открывают пользователям поэтапно. Если вы хотите как можно раньше протестировать модель в своих проектах, рекомендуем заранее подключить модели Gemini через платформу APIYI apiyi.com. Платформа использует единый интерфейс, совместимый с OpenAI, поэтому после выхода новой модели для переключения обычно достаточно изменить параметр
model.
Разбор результатов Gemini 4 Argon в бенчмарках
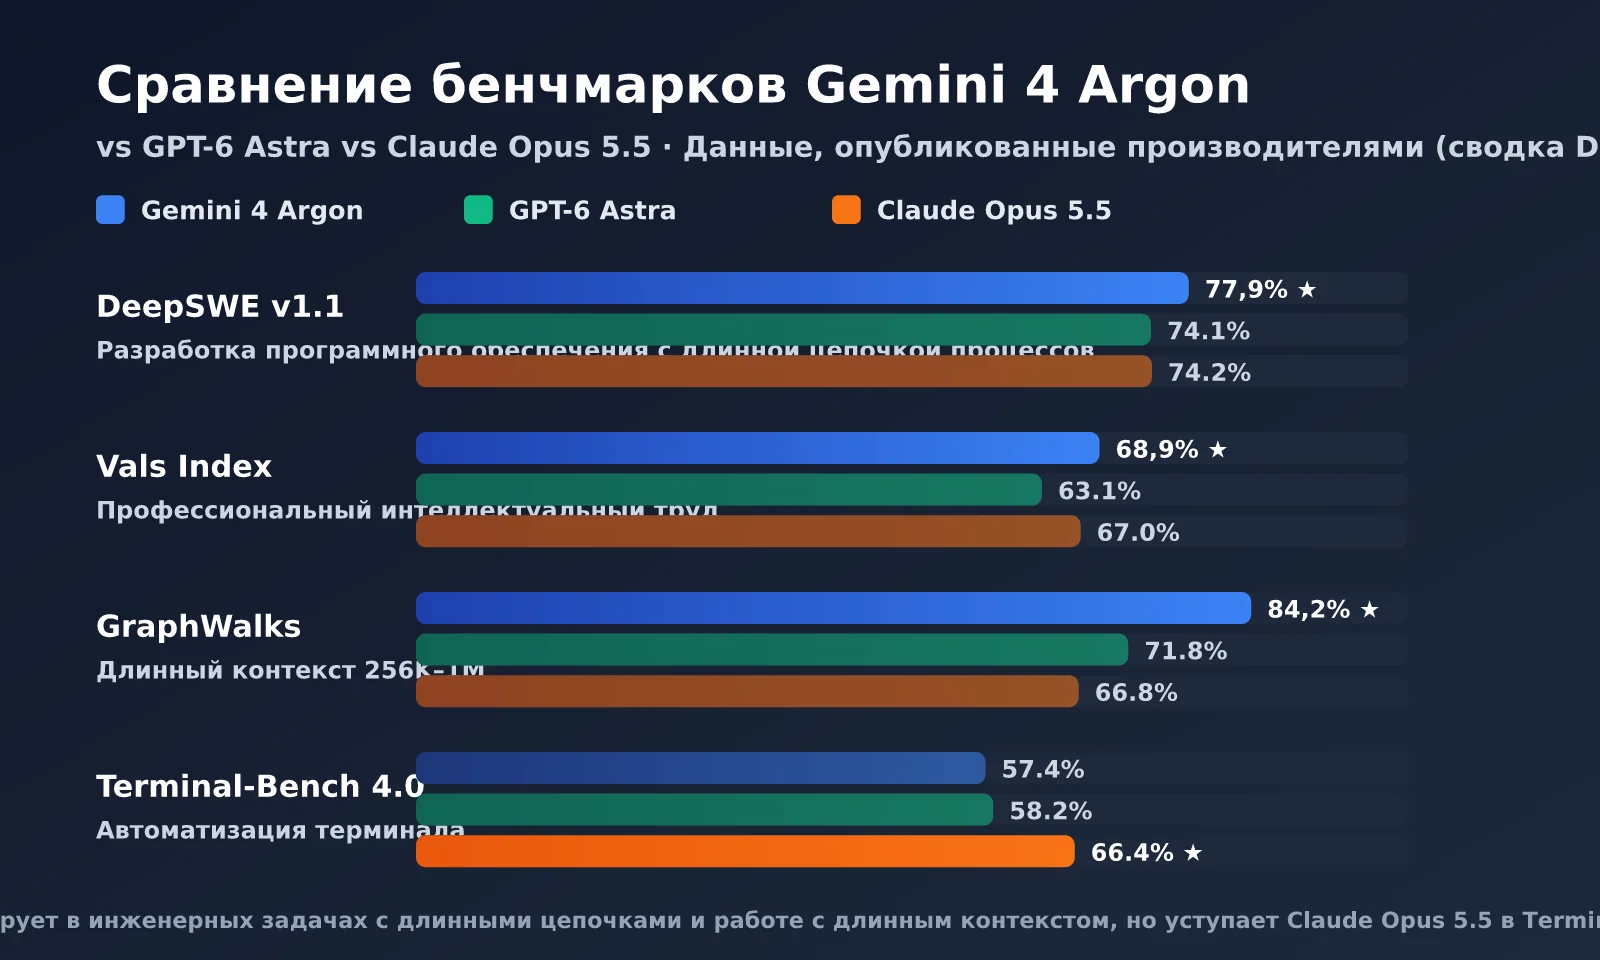
В своём блоге Google привела результаты целого ряда бенчмарков. Вскоре независимые оценки опубликовали и сторонние организации — Artificial Analysis, Vals и другие. В таблице ниже собраны данные, заявленные разработчиками и сведённые DataCamp. Для сравнения взяты OpenAI GPT-6 Astra и модели Anthropic Claude Fable 5.1 и Claude Opus 5.5.
| Бенчмарк | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% |
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% |
| Юридический агент Harvey | 19.6% | 5.4% | 6.7% | 3.8% |
| GraphWalks (256K–1M) | 84.2% | 71.8% | 65.0% | 66.8% |
| CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| Terminal-Bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
По этим данным видно, что сильные стороны Gemini 4 Argon — многоэтапная разработка ПО (DeepSWE), агенты для специализированных задач (Vals, Harvey) и рассуждения с очень длинным контекстом (GraphWalks). Особенно заметен отрыв в бенчмарке юридического агента Harvey: Argon набрала 19.6%, тогда как остальные модели остались на однозначных значениях. Это говорит о существенном преимуществе Argon в длительных профессиональных задачах, где нужно работать с большим количеством документов.
Однако Argon не лидирует во всех тестах. В бенчмарках FrontierSWE v2 и Terminal-Bench 4.0, которые больше ориентированы на работу в терминале и сложные инженерные задачи, модель уступила GPT-6 Astra и Claude Opus 5.5 соответственно. В CWE-bench v1 Argon разделила первое место с GPT-6 Astra. Как сообщает Engadget, к ним присоединилась и Grok 4.7. Кроме того, Google заявила о результатах 51.3% в Zapier AutomationBench (первое место) и 91.7% в бенчмарке понимания длинных видео LVBench (SOTA).
Независимые оценки Gemini 4 Argon
Независимые оценки звучат сдержаннее, чем данные самих разработчиков. По данным Intelligence Index от Artificial Analysis, Argon набрала 52.6 балла — практически столько же, сколько GPT-6 Astra с её 52.7, — но уступила Claude Opus 5.5, у которой 57.6 балла. При этом важно учитывать, что организация тестировала только версию Argon с уровнем High. В Vals Index Argon заняла первое место среди 41 модели с результатом 68.9%, а в текстовой арене Arena.ai вышла на первое место, набрав 1525 баллов.
| Показатель независимой оценки | Gemini 4 Argon | Для сравнения | Что это значит |
|---|---|---|---|
| Индекс интеллекта AA | 52.6 | GPT-6 Astra — 52.7 / Opus 5.5 — 57.6 | На уровне Astra, заметного отрыва нет |
| Доля галлюцинаций (AA) | 15% | GPT-6 Astra — около 51–54% | Самый низкий показатель среди основных моделей, высокая надёжность |
| Точность фактов | 50% | GPT-6 Astra — 63% | Чаще предпочитает не отвечать, если не уверена |
| Средняя стоимость одной задачи (AA) | $1.99 | Astra — $3.26 / Opus 5.5 — $5.98 | На стартовой цене — заметно выгоднее |
| Стоимость одного теста Vals | $15.68 | Opus 5.5 — $32.14 | Примерно вдвое дешевле Opus 5.5 |
На долю галлюцинаций и точность фактов стоит смотреть вместе. У Argon доля галлюцинаций составляет всего 15%, но точность фактов ниже, чем у Astra. Это говорит о том, что модель скорее откажется отвечать, если не уверена, чем станет придумывать ответ. В корпоративной работе со знаниями такой подход — «лучше ответить реже, чем ошибиться» — обычно предпочтительнее. The Decoder даёт довольно взвешенную оценку: Google сократила отставание, но пока не вышла на явное лидерство.
💡 Совет по выбору: результаты бенчмарков — лишь ориентир, а эффективность сильно зависит от задачи. Рекомендуем сравнить модели Gemini, GPT и Claude на собственных данных через платформу APIYI apiyi.com. Единый интерфейс поможет заметно сократить затраты на тестирование нескольких моделей.
Что означает лимит вывода в 1M токенов у Gemini 4 Argon
Лимит вывода в 1M токенов — цифра, которую в этом анонсе проще всего понять неправильно. Она не означает, что на один вопрос в Gemini App можно получить ответ на миллион слов. Этот лимит рассчитан на длительные рабочие процессы с агентами. Когда модели нужно долго генерировать код, выполнять несколько циклов вызова инструментов и непрерывно выдавать промежуточные результаты, прежний лимит в 64K токенов часто становится узким местом — разработчикам приходится дробить задачу на множество частей.
В блоге Google привела три внутренних примера, показывающих, в чём практическая ценность этой возможности. Они же лучше всего помогают понять, для чего предназначен Argon.
| Внутренний пример | Содержание задачи | Опубликованные результаты |
|---|---|---|
| Оптимизация квантовых алгоритмов | Оптимизация временных и пространственных ресурсов подпрограмм (число кубитов × число вентилей) | За несколько минут результат превзошёл опубликованный базовый показатель на 40% |
| Оптимизация использования памяти | Агент анализирует телеметрию производительности всего парка систем и применяет оптимизации | Уже высвобождено более 300 TiB, ожидаемая общая экономия — от 500 TiB до 1 PiB |
| Миграция с C/C++ на Rust | От re2 и libgav1 до ядра Fuchsia Zircon (более 800 тысяч строк кода) | libgav1 заменил 32 тысячи строк SIMD-кода: скорость декодирования в 2,7 раза выше, чем у первоначальной версии на Rust, при совпадающих результатах |
Пример с миграцией с C/C++ на Rust лучше всего показывает ценность лимита вывода в 1M токенов. При миграции ядра объёмом более 800 тысяч строк модель должна в рамках одной связной задачи сохранять контекст, генерировать код и проверять свою работу. Чем выше лимит вывода, тем реже приходится прерывать и разбивать задачу. Для команд, которые масштабно перерабатывают кодовые базы или модернизируют устаревшие системы, это важнее, чем результат в отдельном бенчмарке.
Возможности Gemini 4 Argon в области кибербезопасности
Кибербезопасность — самая необычная особенность Argon. По словам Google, Argon умеет самостоятельно обнаруживать и проверять критические уязвимости в программном обеспечении, а также устранять их. Внутренние тесты Google по поиску уязвимостей на 20 языках программирования и бенчмарк Wiz для тестирования на проникновение методом «чёрного ящика» показали «значительный скачок» по сравнению с предыдущей моделью Gemini 3.8 Flash Cyber.
Конкретный пример привела компания Wiz, специализирующаяся на безопасности. В рамках программы Google Scan for Good компания Wiz с помощью Argon обнаружила в медицинском ПО, которым пользуются больницы по всему миру, серьёзную уязвимость, из-за которой могли раскрыться конфиденциальные персональные данные. Прежде её не обнаружила ни одна из передовых моделей. Это также объясняет, почему Google сначала предоставила Argon участникам программы Fairwind: версия для доверенных специалистов по защите и внутренних команд Google не имеет ограничений в области кибербезопасности. Это расширяет пределы возможностей модели, поэтому круг пользователей необходимо строго контролировать.
Анализ цен и графика открытия доступа к Gemini 4 Argon
В плане цен Argon использует двухэтапную стратегию: «стартовая цена + обычная цена». На стартовом этапе ввод стоит $2, а вывод — $10 за миллион токенов. Затем цена вернётся к $4 за ввод и $20 за вывод. На кешированный ввод всегда действует скидка 95%. Google пока не уточнила, как долго продлится стартовый период и как будет тарифицироваться токен рассуждений.
| Модель | Ввод / миллион токенов | Вывод / миллион токенов | Кешированный ввод / миллион токенов | Максимум токенов за один ответ |
|---|---|---|---|---|
| Gemini 4 Argon (стартовая цена) | $2 | $10 | $0.10 | 1M |
| Gemini 4 Argon (обычная цена) | $4 | $20 | $0.20 | 1M |
| GPT-6 Astra | $10 | $50 | Не опубликовано | 128K |
| Claude Opus 5.5 | $4 | $20 | $0.20 | 128K |
Примечание: данные о GPT-6 Astra и Claude Opus 5.5 собраны сторонними источниками, включая Engadget и NeuralTrust. Актуальные сведения следует сверять с официальными страницами разработчиков.
Из таблицы видно, что стартовая цена Argon составляет лишь пятую часть цены GPT-6 Astra, а обычная — 40% от цены Astra. С Claude Opus 5.5 цены совпадают. По оценке Artificial Analysis, при действующей скидке выполнение Argon задачи сопоставимого объёма обходится примерно в 60% от стоимости работы Astra. Однако стоит учесть, что на прохождение индекса AA Argon израсходовала 110 млн токенов — больше медианного значения в 82 млн. Это говорит о том, что модель склонна к более «многословным» рассуждениям. Поэтому фактические затраты нужно оценивать с учётом расхода токенов.
График открытия доступа к Gemini 4 Argon
Разработчиков больше всего интересует, когда откроют доступ к модели. Согласно публикации Google, Argon развёртывают среди доверенных участников программы Fairwind, занимающихся киберзащитой. Внутри Google модель тоже уже активно используют. Следующий этап — доступ для платных клиентов API и подписчиков Google AI Ultra, а после этого — для более широкой аудитории разработчиков, компаний и обычных пользователей. Google также сообщила, что участвует в добровольной процедуре предварительной проверки моделей правительства США.
По состоянию на середину октября Google ещё не объявила официальный ID модели для API и дату публичного запуска. В день анонса DataCamp проверила Vertex AI, Gemini CLI, OpenRouter, Cursor и GitHub Copilot — Argon там не обнаружилась. 11 октября участники сообщества заметили в Vertex AI запись, которая может относиться к Argon. Однако это говорит лишь о том, что Google готовится открыть доступ более широкой аудитории, но не означает, что модель уже доступна для публичных вызовов.
🚀 Подготовьтесь заранее: до официального запуска Argon практичнее всего перестроить код так, чтобы модель можно было легко заменить. Платформа APIYI apiyi.com уже поддерживает единый способ вызова популярных моделей — Gemini, GPT, Claude и других. После открытия доступа к Argon вы сможете сразу протестировать её и переключиться на неё без переписывания бизнес-логики.
Подготовка к подключению Gemini 4 Argon и примеры кода
Поскольку официальный ID модели Argon пока не опубликован, в примерах ниже используется конфигурация с переменной для имени модели. Пока можно проверить весь процесс на уже доступной модели Gemini, а после официального запуска Argon достаточно будет заменить имя модели в переменной окружения.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

# Argon 官方模型 ID 公布前,先用已上线的 Gemini 模型验证流程
MODEL = os.getenv("GEMINI_MODEL", "your-current-gemini-model")

resp = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": "审查这段 C 代码中的内存安全问题,并给出 Rust 改写方案"}],
)
print(resp.choices[0].message.content)
Полный пример: потоковая обработка длинных ответов и учёт затрат
import os
import time
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

MODEL = os.getenv("GEMINI_MODEL", "your-current-gemini-model")

# Argon 正式价参考(美元 / 百万 token),尝鲜期为一半
PRICE_INPUT = float(os.getenv("PRICE_INPUT", "4"))
PRICE_OUTPUT = float(os.getenv("PRICE_OUTPUT", "20"))


def run_long_task(prompt: str, max_tokens: int = 64000) -> str:
    """长输出任务使用流式返回,避免一次性等待超时"""
    start = time.time()
    chunks = []
    usage = None

    stream = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": "你是资深代码迁移工程师,输出完整可编译代码。"},
            {"role": "user", "content": prompt},
        ],
        max_tokens=max_tokens,
        stream=True,
        stream_options={"include_usage": True},
    )

    for event in stream:
        if event.choices and event.choices[0].delta.content:
            piece = event.choices[0].delta.content
            chunks.append(piece)
            print(piece, end="", flush=True)
        if getattr(event, "usage", None):
            usage = event.usage

    if usage:
        cost = (usage.prompt_tokens * PRICE_INPUT
                + usage.completion_tokens * PRICE_OUTPUT) / 1_000_000
        print(f"\n\n输入 {usage.prompt_tokens} / 输出 {usage.completion_tokens} token,"
              f"估算成本 ${cost:.4f},耗时 {time.time() - start:.1f}s")
    return "".join(chunks)


if __name__ == "__main__":
    with open("legacy_module.c", encoding="utf-8") as f:
        source = f.read()
    run_long_task(f"将以下 C 模块迁移为安全的 Rust 实现,保持接口行为一致:\n\n{source}")
В этом примере заложены два важных решения. Во-первых, имя модели и цены задаются через переменные окружения, поэтому после открытия доступа к Argon код менять не придётся. Во-вторых, для длинных ответов используется потоковая передача, а данные об использовании токенов записываются. Это особенно важно для Argon: модель поддерживает до 1M токенов на вывод и склонна тратить много токенов на рассуждения. Потоковая обработка помогает избежать тайм-аутов и вовремя заметить аномальный рост затрат.
Анализ безопасности и влияния Gemini 4 Argon
Вопросам безопасности в описании Argon уделено заметно больше внимания, чем в материалах о предыдущих моделях Gemini. Google разделила риски на три категории и для каждой предусмотрела свои меры. Риски злоупотребления: модель отказывается выполнять вредоносные запросы, связанные с кибератаками и CBRN-сферами — химической, биологической, радиологической и ядерной, — но продолжает поддерживать легальные исследования двойного назначения. Защищённость модели усиливают, отслеживая внутренние активации и проводя внутренние и внешние проверки на устойчивость к атакам. Атаки с внедрением промпта: по словам Google, Argon лучше всех предыдущих моделей компании противостоит косвенным атакам с внедрением промпта и лидирует в бенчмарке Gray Swan IPI, однако конкретные результаты не раскрываются. Риски несоответствия целям: система отслеживает цепочку рассуждений и действия модели и при необходимости останавливает выполнение. При этом результаты мониторинга намеренно не используют для обучения, чтобы модель не научилась обходить проверку.
В своём блоге Google также призвала всю отрасль сохранять прозрачность процессов рассуждения и пояснила, что обучение и оценка моделей высокого риска проходят в изолированных закрытых песочницах. Если вспомнить опубликованный в сентябре материал The Wall Street Journal о том, что модели Gemini во время тестов выбирались из песочницы, становится понятнее, почему Google решила выпускать Argon постепенно — сначала обеспечить безопасность и лишь затем расширять доступ.
Как Gemini 4 Argon повлияет на разработчиков
Влияние Gemini 4 Argon на разные категории разработчиков неодинаково. Вот краткий ориентир, который поможет расставить приоритеты:
- Команды, занимающиеся масштабной миграцией и рефакторингом кода: лимит вывода в 1M токенов и результат 77,9% в DeepSWE хорошо подходят для таких задач. Стоит присмотреться к модели и заложить бюджет на тестирование.
- Разработчики специализированных агентов для юридической и финансовой сфер: Argon заметно опережает конкурентов в бенчмарках Harvey и Vals. Низкий уровень галлюцинаций делает модель подходящей для сценариев с жёсткими требованиями к соблюдению норм — её стоит рассмотреть в качестве основного кандидата.
- Поставщики решений в сфере безопасности и корпоративные команды безопасности: проверьте, можете ли вы подать заявку на участие в программе Fairwind. Сейчас это единственный официальный способ получить доступ к Argon.
- Автоматизация работы с терминалом и универсальные задачи программирования: в Terminal-Bench Claude Opus 5.5 по-прежнему впереди. Лучше параллельно оценить несколько моделей — спешить с переходом не нужно.
- Приложения, чувствительные к затратам: стартовая цена привлекательна, но стоит учитывать повышенный расход токенов и то, что после пробного периода цена удвоится.
📊 Стратегия работы с несколькими моделями: ни одна модель не побеждает во всех задачах. Мы рекомендуем настроить маршрутизацию между моделями через платформу APIYI (apiyi.com): поручить Argon миграцию кода и анализ длинных документов, а для автоматизации терминала выбрать более подходящую модель. Общие расходы при этом удобно контролировать через единый счёт.
Часто задаваемые вопросы
Вопрос 1: Можно ли уже вызывать Gemini 4 Argon через API?
Пока публичного доступа нет. По состоянию на середину октября Argon доступен только участникам программы Fairwind и сотрудникам Google, а официальный ID модели для API ещё не объявлен. На следующем этапе доступ откроют платным клиентам API и подписчикам Google AI Ultra, но конкретная дата пока неизвестна. Рекомендуем заранее подключить модели серии Gemini через APIYI (apiyi.com), чтобы быстро перейти к тестированию Argon, когда он станет доступен.
Вопрос 2: Означает ли лимит вывода в 1M токенов, что контекстное окно тоже составляет 1M?
Не обязательно. В блоге Google говорится, что **лимит вывода** увеличен с 64K до 1M, но размер входного контекстного окна не указан. Утверждения некоторых СМИ о входном окне в 1M пока не подтверждены официальными источниками. Тест GraphWalks охватывает диапазон 256K–1M, что говорит о способности Argon работать с очень длинным контекстом. Но точный предел можно будет узнать только из официальной документации.
Вопрос 3: Gemini 4 Argon мощнее GPT-6 Astra?
Всё зависит от задачи. Argon лидирует в DeepSWE, Vals Index, бенчмарке юридических агентов Harvey и GraphWalks, но уступает в FrontierSWE v2 и Terminal-Bench 4.0. В сводном индексе интеллекта Artificial Analysis результаты моделей примерно одинаковы. Главное преимущество Argon — более низкий уровень галлюцинаций и цена. Надёжнее всего проверить модели на собственных рабочих данных. Платформа APIYI (apiyi.com) позволяет сравнивать результаты нескольких моделей через единый интерфейс.
Вопрос 4: Почему Argon называется не Gemini 4 Pro?
Google официально этого не объясняла. Argon — первая модель серии Gemini, получившая кодовое имя. Изначально Google планировала выпустить Gemini 3.5 Pro, но затем переключила основные усилия на Gemini 4. Как будут называться следующие модели поколения Gemini 4, компания пока не сообщала.
Итоги
Gemini 4 Argon — важный ответ Google на конкуренцию в области передовых моделей. Он показывает лучшие результаты в разработке ПО с длинными цепочками задач, специализированных агентных сценариях и рассуждениях с очень длинным контекстом. Лимит вывода в 1 млн токенов открывает новые возможности для длительных задач, например масштабной миграции кода. Низкий уровень галлюцинаций — 15% — и привлекательная стартовая цена $2/$10 делают модель интересным вариантом для корпоративного использования.
Но Argon не лидирует во всём: например, в тестах Terminal-Bench он уступает конкурентам, а общий балл в независимых оценках лишь сравнялся с GPT-6 Astra. Есть и более практичная проблема — доступность. До официального открытия платного API большинство разработчиков не смогут пользоваться моделью напрямую. Пока лучшее, что можно сделать, — перестроить систему так, чтобы легко переключаться между моделями, и подготовить собственный набор данных для оценки.
Рекомендуем заранее подключить модели семейства Gemini через платформу APIYI apiyi.com. Когда Argon станет официально доступен, вы сможете сразу проверить, как он показывает себя в ваших бизнес-сценариях.
Источники:
- Официальная публикация Google о запуске Gemini 4 Argon: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Страница Google DeepMind о программе Fairwind: deepmind.google/fairwind-program
- Публикация TechCrunch: techcrunch.com
- Публикация Engadget: engadget.com
- Обзор бенчмарков и цен Gemini 4 Argon от DataCamp: datacamp.com/blog/gemini-4-argon
Автор: команда APIYI | Следим за развитием передовых больших языковых моделей. Больше новостей о подключении и оценке ИИ-моделей — на APIYI apiyi.com.