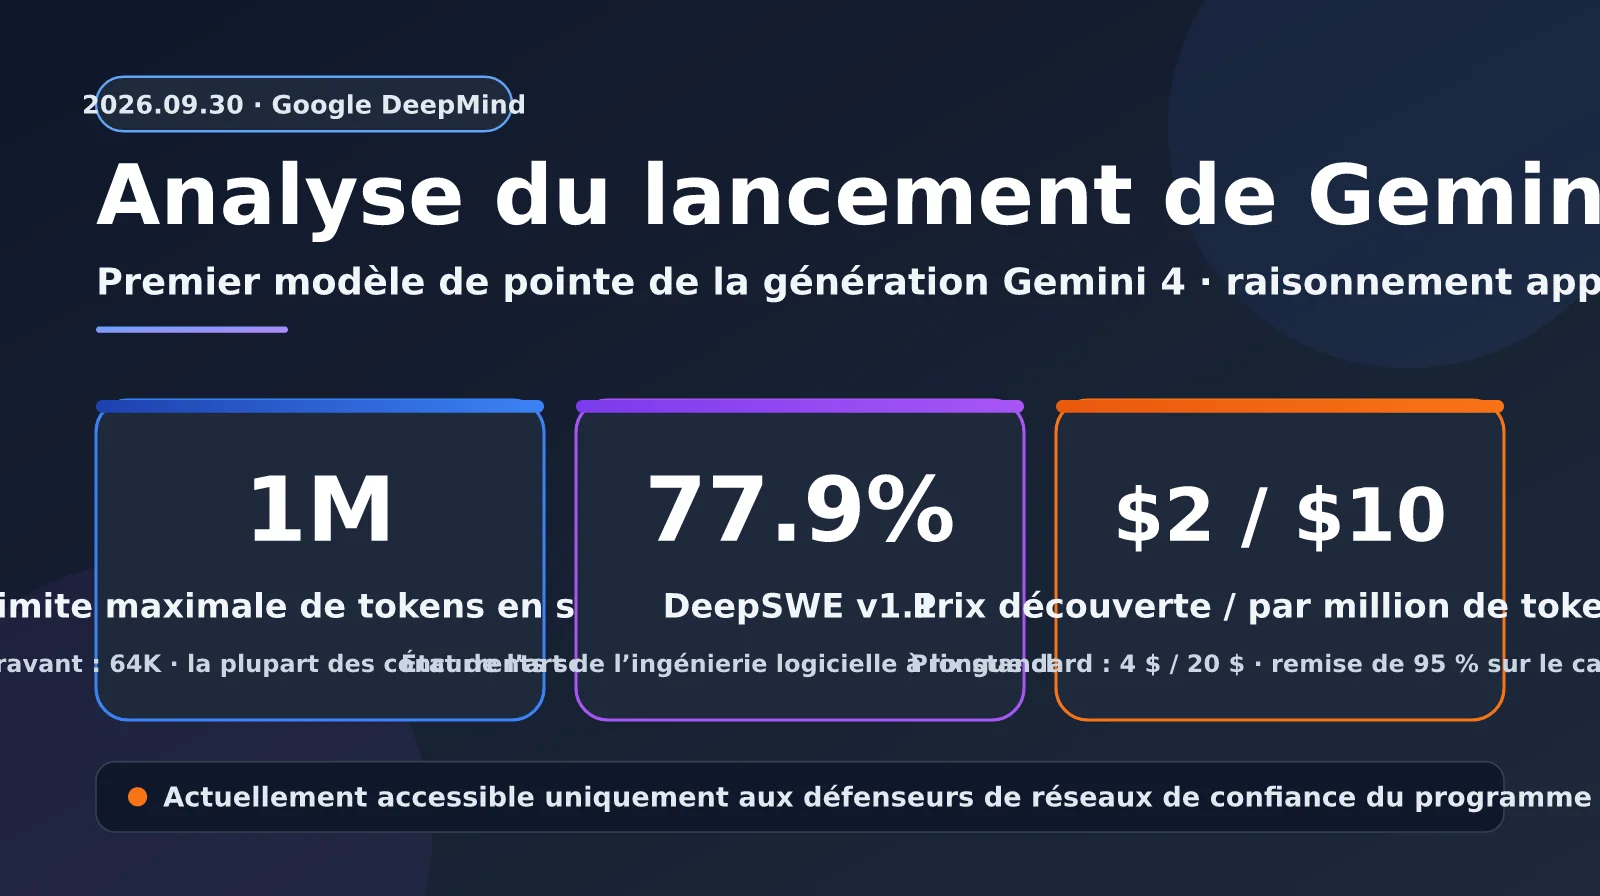
Le 30 septembre 2026, Koray Kavukcuoglu, vice-président senior et architecte en chef de l’IA chez Google DeepMind, a présenté Gemini 4 Argon sur le blog officiel de Google. Premier modèle de la génération Gemini 4, c’est aussi le modèle d’IA de pointe le plus puissant de Google à ce jour. Argon mise sur le raisonnement approfondi en plusieurs étapes et cible trois grands domaines : le génie logiciel en conditions réelles, les tâches de connaissance en entreprise — notamment dans les secteurs juridique et financier — et la défense en cybersécurité.
Cette annonce rompt avec plusieurs habitudes. D’abord, Google abandonne pour la première fois la nomenclature Pro, Flash et Flash-Lite au profit du nom de code « Argon ». Ensuite, la limite de sortie passe directement de 64 000 à un million de jetons. Enfin, le modèle n’est pas lancé auprès de tous les développeurs : il est d’abord réservé aux acteurs de confiance de la défense en cybersécurité participant au programme Fairwind. Cet article s’appuie sur la publication originale de Google, ainsi que sur les informations publiques de plusieurs médias anglophones et évaluations indépendantes, pour examiner les capacités clés de Gemini 4 Argon, ses résultats aux tests de référence, ses tarifs et son calendrier de disponibilité.
L’essentiel : à la fin de cet article, vous saurez rapidement dans quelle mesure Gemini 4 Argon peut être utile à votre activité, quand vous pourrez y accéder et quelles préparations effectuer dès maintenant pour l’intégrer.
Gemini 4 Argon : les informations essentielles
Commençons par résumer dans un tableau les points clés de la publication de Google. À noter : la source officielle précise uniquement la limite de sortie, fixée à un million de jetons, sans indiquer la taille de la fenêtre de contexte d’entrée. Certains médias évoquent une « fenêtre d’entrée d’un million de jetons », mais aucune source officielle de Google ne le confirme pour l’instant. Mieux vaut attendre la documentation officielle.
| Élément | Informations officielles sur Gemini 4 Argon | Remarques |
|---|---|---|
| Date de publication | 30 septembre 2026 | Annonce simultanée sur le blog officiel de Google et le compte DeepMind |
| Positionnement du modèle | Premier modèle de pointe de la génération Gemini 4 | Premier modèle nommé par un nom de code, sans les catégories Pro/Flash |
| Limite de sortie | 1 million de jetons (contre 64 000 auparavant) | Google la décrit comme « leader du secteur » ; les concurrents plafonnent généralement à 128 000 jetons par sortie |
| Fenêtre de contexte d’entrée | Non communiquée officiellement | Certains articles parlent d’un million de jetons, sans source officielle à l’appui |
| Tarif de lancement | 2 $ par million de jetons en entrée / 10 $ en sortie | Les jetons d’entrée mis en cache bénéficient d’une remise de 95 % |
| Tarif standard | 4 $ par million de jetons en entrée / 20 $ en sortie | La durée de la période de lancement n’a pas été précisée |
| Disponibilité actuelle | Acteurs de confiance de la défense en cybersécurité du programme Fairwind et équipes internes de Google | Les prochains concernés seront les clients payants de l’API et les abonnés AI Ultra |
| ID du modèle API | Pas encore communiqué officiellement | La communauté a repéré une entrée potentielle dans Vertex AI, sans confirmation |
Les trois grands domaines ciblés par Gemini 4 Argon
Dans sa publication, Google met en avant trois domaines d’application pour Argon. En génie logiciel, Argon peut raisonner de manière soutenue dans des flux de travail complexes comportant plusieurs étapes. Les ingénieurs de Google l’utilisent déjà au quotidien pour le débogage et les migrations de code à grande échelle. Pour les tâches de connaissance en entreprise, le modèle se démarque dans les évaluations d’agents spécialisés, notamment dans les secteurs juridique et financier. Il convient aux tâches qui nécessitent d’analyser un grand nombre de documents et d’en tirer des conclusions structurées. Enfin, la défense en cybersécurité est la particularité d’Argon : le modèle a été spécialement entraîné pour détecter, vérifier et corriger de manière autonome des vulnérabilités logicielles critiques.
Google souligne également les capacités multimodales d’Argon : analyse de graphiques de niveau professionnel, repérage de détails dans de longues vidéos et exécution de tâches à partir d’un ensemble de documents. Google mentionne aussi des progrès en écriture créative, ce qui montre qu’Argon n’est pas un modèle spécialisé uniquement dans le code.
🎯 Conseil d’intégration : Gemini 4 Argon n’est pas encore disponible pour tous et son déploiement se fait par étapes. Si vous souhaitez le tester rapidement dans votre activité, nous vous conseillons de préparer dès maintenant l’intégration des modèles Gemini sur la plateforme APIYI, apiyi.com. Elle propose une interface unifiée compatible avec OpenAI ; lors du lancement d’un nouveau modèle, il suffit généralement de modifier le paramètre
modelpour basculer dessus.
Interprétation des résultats de Gemini 4 Argon aux benchmarks
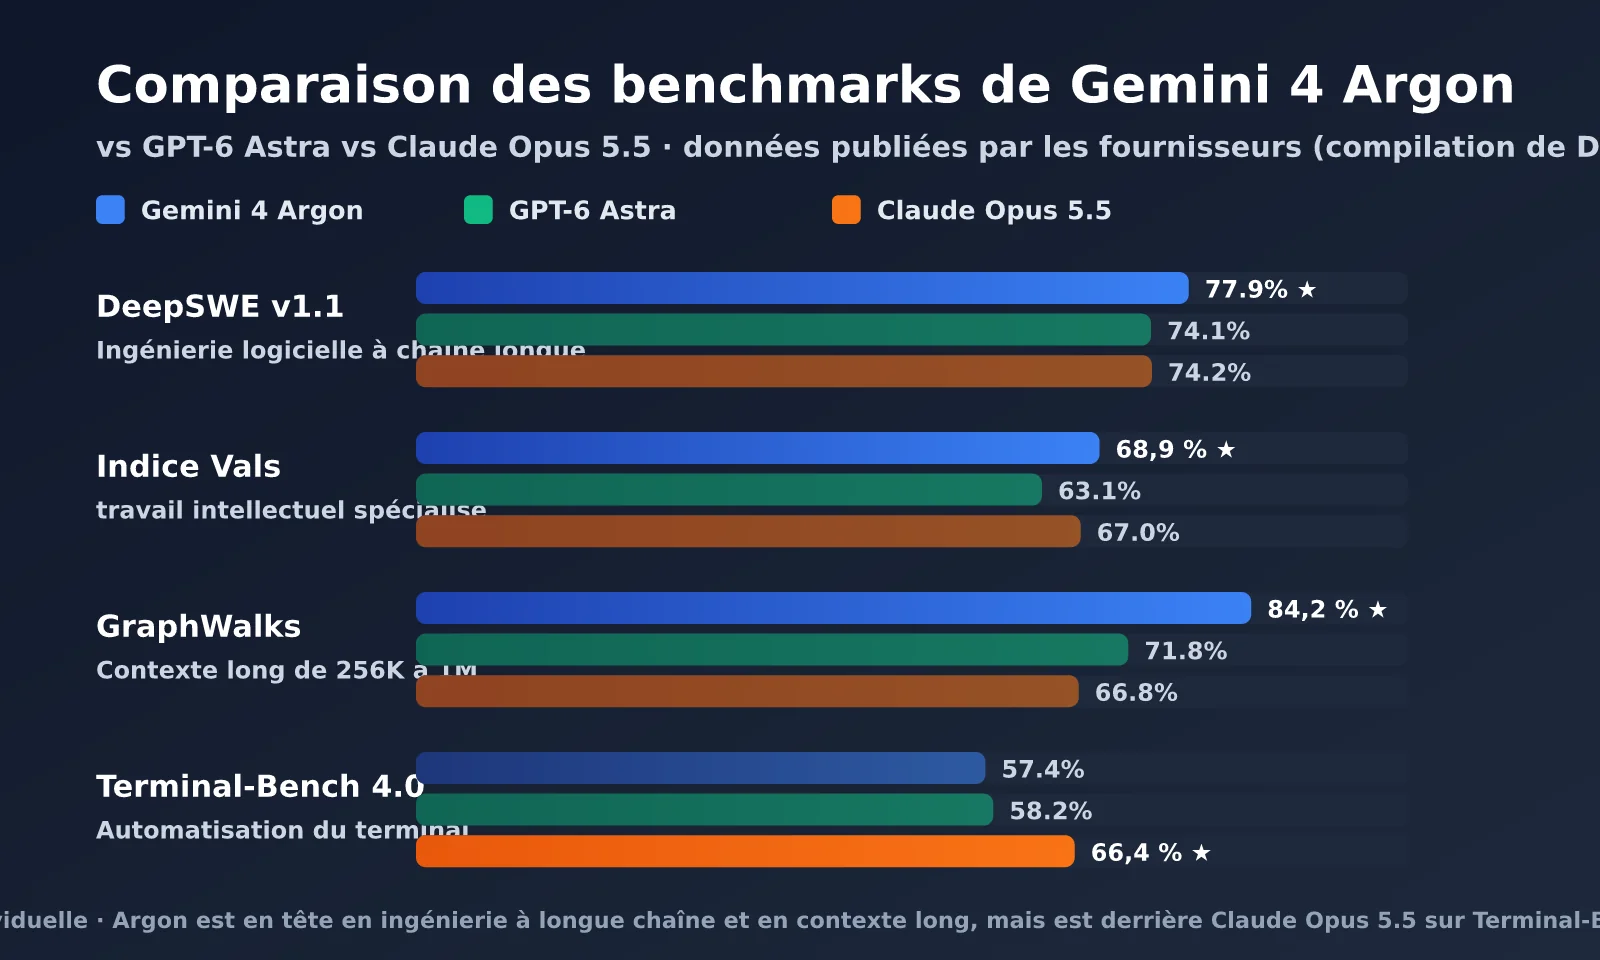
Dans son article de blog, Google présente une série de résultats aux benchmarks. Des organismes tiers comme Artificial Analysis et Vals ont rapidement publié leurs propres évaluations indépendantes. Le tableau ci-dessous récapitule les données communiquées par Google et compilées par DataCamp, en les comparant à celles d’OpenAI GPT-6 Astra et des modèles Claude Fable 5.1 et Claude Opus 5.5 d’Anthropic.
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| DeepSWE v1.1 | 77.9 % | 74.1 % | 67.4 % | 74.2 % |
| Vals Index | 68.9 % | 63.1 % | 65.8 % | 67.0 % |
| Agent juridique Harvey | 19.6 % | 5.4 % | 6.7 % | 3.8 % |
| GraphWalks (256K–1M) | 84.2 % | 71.8 % | 65.0 % | 66.8 % |
| CWE-bench v1 | 68.0 % | 68.0 % | 58.0 % | 67.0 % |
| FrontierSWE v2 | 55.0 % | 65.5 % | 56.3 % | 62.3 % |
| Terminal-Bench 4.0 | 57.4 % | 58.2 % | 57.9 % | 66.4 % |
Ces résultats montrent que Gemini 4 Argon se distingue surtout dans les tâches de génie logiciel à longue chaîne d’exécution (DeepSWE), les agents spécialisés (Vals, Harvey) et le raisonnement sur un contexte très long (GraphWalks). Son avance sur le benchmark de l’agent juridique Harvey est particulièrement marquée : avec 19.6 %, il devance largement les autres modèles, qui restent sous la barre des 10 %. Cela témoigne d’un écart de génération dans les tâches spécialisées, longues et impliquant de nombreux documents.
Argon n’est toutefois pas en tête partout. Sur FrontierSWE v2 et Terminal-Bench 4.0, des tests davantage axés sur les opérations en ligne de commande et les tâches d’ingénierie de pointe, il est respectivement devancé par GPT-6 Astra et Claude Opus 5.5. Sur CWE-bench v1, Argon et GPT-6 Astra arrivent à égalité. Selon Engadget, Grok 4.7 partage également la première place. Google a aussi annoncé des résultats de 51.3 % sur Zapier AutomationBench (première place) et de 91.7 % sur LVBench, un benchmark de compréhension des vidéos longues (SOTA).
Évaluations indépendantes de Gemini 4 Argon
Les conclusions des évaluations indépendantes sont plus nuancées que les données publiées par le fabricant. L’Intelligence Index d’Artificial Analysis attribue à Argon un score de 52.6, pratiquement à égalité avec les 52.7 de GPT-6 Astra, mais inférieur aux 57.6 de Claude Opus 5.5. À noter que cet organisme n’a testé qu’Argon en configuration High. Sur le Vals Index, Argon arrive premier parmi 41 modèles avec un score de 68.9 %. Il prend également la tête du classement textuel d’Arena.ai avec 1 525 points.
| Dimension de l’évaluation indépendante | Gemini 4 Argon | Comparaison | Interprétation |
|---|---|---|---|
| Indice d’intelligence AA | 52.6 | GPT-6 Astra : 52.7 / Opus 5.5 : 57.6 | À égalité avec Astra, sans creuser l’écart |
| Taux d’hallucination (AA) | 15 % | GPT-6 Astra : environ 51–54 % | Le plus bas parmi les modèles grand public ; fiabilité remarquable |
| Exactitude factuelle | 50 % | GPT-6 Astra : 63 % | Tendance à répondre « je ne sais pas » plutôt qu’à se risquer |
| Coût moyen par tâche (AA) | 1,99 $ | Astra : 3,26 $ / Opus 5.5 : 5,98 $ | Un rapport qualité-prix intéressant au tarif de lancement |
| Coût d’une évaluation Vals | 15,68 $ | Opus 5.5 : 32,14 $ | Environ deux fois moins cher qu’Opus 5.5 |
Il faut considérer ensemble le taux d’hallucination et l’exactitude factuelle. Argon n’affiche qu’un taux d’hallucination de 15 %, mais son exactitude factuelle est également inférieure à celle d’Astra. Cela indique qu’en cas d’incertitude, il préfère s’abstenir plutôt que d’inventer une réponse. Pour les tâches de gestion des connaissances en entreprise, cette tendance à « répondre moins, mais sans dire n’importe quoi » est généralement appréciée. Le jugement de The Decoder est assez juste : Google a comblé une partie de l’écart, sans pour autant prendre une avance nette.
💡 Conseil pour choisir un modèle : les résultats aux benchmarks ne sont qu’un indicateur, et les performances varient beaucoup selon les tâches. Nous vous conseillons de tester côte à côte les modèles Gemini, GPT et Claude avec vos propres données métier sur la plateforme APIYI apiyi.com. Une interface unifiée permet de réduire considérablement le coût de comparaison entre plusieurs modèles.
Ce que signifie la limite de sortie de 1M de Gemini 4 Argon
La limite de sortie de 1M de tokens est le chiffre le plus facile à mal interpréter dans cette annonce. Elle ne signifie pas qu’une simple question posée dans Gemini App peut produire une réponse d’un million de mots. Elle est conçue pour les workflows d’agents de longue durée. Quand un modèle doit générer du code en continu, enchaîner de nombreux appels à des outils et produire des résultats intermédiaires, la limite de sortie de 64K devenait souvent un goulot d’étranglement, obligeant les développeurs à découper les tâches en de nombreuses étapes.
Dans son article de blog, Google présente trois cas d’usage internes qui illustrent concrètement l’intérêt de cette capacité et aident à comprendre le positionnement d’Argon.
| Cas d’usage interne | Contenu de la tâche | Résultat publié |
|---|---|---|
| Optimisation d’algorithmes quantiques | Optimiser les ressources d’espace et de temps des sous-programmes (nombre de qubits × nombre de portes) | Gain de 40 % par rapport aux références publiées, en quelques minutes |
| Optimisation de l’efficacité mémoire | Un agent analyse les données de télémétrie du profilage des performances de toute la flotte et applique des optimisations | Plus de 300 TiB déjà libérés, pour des économies totales estimées entre 500 TiB et 1 PiB |
| Migration de C/C++ vers Rust | De re2 et libgav1 jusqu’au noyau Fuchsia Zircon (plus de 800 000 lignes) | libgav1 remplace 32 000 lignes de code SIMD : la vitesse de décodage est 2,7 fois supérieure à celle du portage Rust d’origine, avec des résultats identiques |
La migration de C/C++ vers Rust est le cas qui illustre le mieux l’intérêt de la limite de sortie de 1M. Migrer un noyau de plus de 800 000 lignes exige que le modèle comprenne le contexte, génère du code et le vérifie en continu, dans le cadre d’une tâche cohérente. Plus la limite de sortie est élevée, moins la tâche doit être interrompue et découpée. Pour les équipes qui refondent de grands dépôts de code ou modernisent des systèmes hérités, cet aspect est plus parlant que le score obtenu à un benchmark isolé.
Les capacités d’Argon de Gemini 4 en cybersécurité
La cybersécurité est la caractéristique la plus distinctive d’Argon. Google indique qu’Argon peut découvrir, vérifier et corriger de manière autonome des vulnérabilités critiques dans des logiciels. Sur les benchmarks internes de Google portant sur la détection de vulnérabilités dans 20 langages de programmation et sur le benchmark de tests d’intrusion en boîte noire de Wiz, Argon affiche une « progression significative » par rapport à la génération précédente, Gemini 3.8 Flash Cyber.
Un exemple concret vient de l’entreprise de sécurité Wiz. Dans le cadre du programme Scan for Good de Google, Wiz a utilisé Argon pour découvrir une vulnérabilité grave dans un logiciel médical utilisé par des hôpitaux du monde entier, qui exposait des informations personnelles sensibles. Aucun des modèles de pointe précédents ne l’avait détectée. Cela explique aussi pourquoi Google a choisi de confier Argon en premier aux membres du programme Fairwind : la version destinée aux défenseurs de confiance et aux équipes internes de Google n’est pas dotée de garde-fous en matière de cybersécurité. Ses capacités sont donc moins restreintes, ce qui impose de contrôler strictement qui peut l’utiliser.
Tarifs de Gemini 4 Argon et calendrier de déploiement
Côté tarifs, Argon adopte une stratégie en deux étapes : un tarif de lancement, puis un tarif standard. Pendant la période de lancement, le prix est de 2 $ par million de tokens en entrée et de 10 $ en sortie. Il passera ensuite à 4 $ en entrée et 20 $ en sortie. Les tokens d’entrée mis en cache bénéficient en permanence d’une réduction de 95 %. Google n’a pas précisé la durée de la période de lancement ni le mode de facturation des tokens de raisonnement.
| Modèle | Entrée / million de tokens | Sortie / million de tokens | Entrée mise en cache / million de tokens | Limite de sortie par requête |
|---|---|---|---|---|
| Gemini 4 Argon (tarif de lancement) | 2 $ | 10 $ | 0,10 $ | 1M |
| Gemini 4 Argon (tarif standard) | 4 $ | 20 $ | 0,20 $ | 1M |
| GPT-6 Astra | 10 $ | 50 $ | Non publié | 128K |
| Claude Opus 5.5 | 4 $ | 20 $ | 0,20 $ | 128K |
Remarque : les données de GPT-6 Astra et de Claude Opus 5.5 proviennent de compilations tierces, notamment d’Engadget et de NeuralTrust. Consultez les pages officielles des fournisseurs pour obtenir les informations les plus récentes.
Le tableau montre qu’au tarif de lancement, Argon coûte cinq fois moins cher que GPT-6 Astra. Même au tarif standard, il revient à 40 % du prix d’Astra et au même prix que Claude Opus 5.5. Selon les estimations d’Artificial Analysis, au tarif réduit actuel, Argon réalise une tâche équivalente pour environ 60 % du coût d’Astra. Il faut toutefois noter qu’Argon a consommé 110 millions de tokens pour exécuter l’indice AA, contre une médiane de 82 millions. Son processus de raisonnement est donc plutôt « bavard » : pour estimer le coût réel, il faut aussi tenir compte du nombre de tokens consommés.
Calendrier de déploiement de Gemini 4 Argon
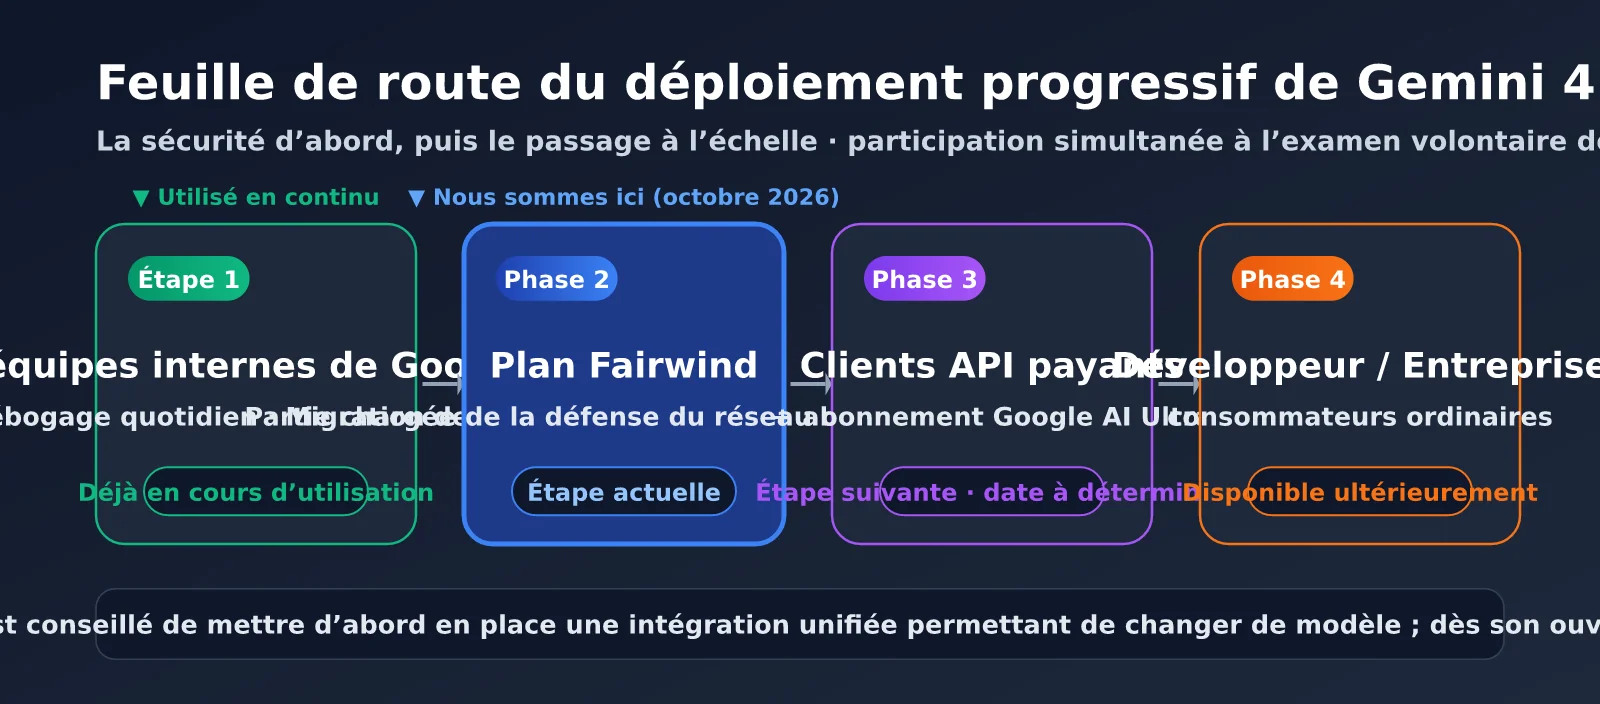
Le calendrier de déploiement est la principale préoccupation des développeurs. Selon l’article de blog de Google, Argon est en cours de déploiement auprès des défenseurs de réseaux de confiance participant au programme Fairwind, et il est déjà largement utilisé en interne chez Google. Il sera ensuite proposé aux clients API payants et aux abonnés Google AI Ultra, avant d’être accessible plus largement aux développeurs, aux entreprises et au grand public. Google indique également participer au processus volontaire d’examen des modèles avant leur publication, mené par le gouvernement américain.
À la mi-octobre, Google n’avait toujours pas annoncé l’ID officiel du modèle pour l’API ni de date de disponibilité publique. Le jour de la sortie, DataCamp a constaté qu’Argon n’était pas encore disponible sur Vertex AI, Gemini CLI, OpenRouter, Cursor ou GitHub Copilot. Le 11 octobre, un chercheur de la communauté a repéré une entrée qui pourrait correspondre à Argon dans Vertex AI. Cela indique seulement que Google prépare un déploiement plus large : le modèle n’est pas nécessairement déjà accessible au public.
🚀 Anticipez : avant l’ouverture officielle d’Argon, le plus pragmatique est de faire évoluer votre code pour pouvoir changer de modèle facilement. La plateforme APIYI apiyi.com permet déjà d’utiliser les principaux modèles de Gemini, GPT et Claude depuis une interface unifiée. Dès qu’Argon sera disponible, vous pourrez le tester et basculer rapidement, sans réécrire la logique métier.
Préparer l’intégration de Gemini 4 Argon : exemple de code
Comme l’ID officiel du modèle Argon n’a pas encore été annoncé, l’exemple ci-dessous permet de configurer le nom du modèle. Vous pouvez commencer par tester le flux avec un modèle Gemini déjà disponible, puis remplacer le nom dans la variable d’environnement lorsque Argon sera officiellement ouvert.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

# Argon 官方模型 ID 公布前,先用已上线的 Gemini 模型验证流程
MODEL = os.getenv("GEMINI_MODEL", "your-current-gemini-model")

resp = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": "审查这段 C 代码中的内存安全问题,并给出 Rust 改写方案"}],
)
print(resp.choices[0].message.content)
Afficher le code complet : traitement en flux des tâches à longue sortie et suivi des coûts
import os
import time
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

MODEL = os.getenv("GEMINI_MODEL", "your-current-gemini-model")

# Argon 正式价参考(美元 / 百万 token),尝鲜期为一半
PRICE_INPUT = float(os.getenv("PRICE_INPUT", "4"))
PRICE_OUTPUT = float(os.getenv("PRICE_OUTPUT", "20"))


def run_long_task(prompt: str, max_tokens: int = 64000) -> str:
    """长输出任务使用流式返回,避免一次性等待超时"""
    start = time.time()
    chunks = []
    usage = None

    stream = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": "你是资深代码迁移工程师,输出完整可编译代码。"},
            {"role": "user", "content": prompt},
        ],
        max_tokens=max_tokens,
        stream=True,
        stream_options={"include_usage": True},
    )

    for event in stream:
        if event.choices and event.choices[0].delta.content:
            piece = event.choices[0].delta.content
            chunks.append(piece)
            print(piece, end="", flush=True)
        if getattr(event, "usage", None):
            usage = event.usage

    if usage:
        cost = (usage.prompt_tokens * PRICE_INPUT
                + usage.completion_tokens * PRICE_OUTPUT) / 1_000_000
        print(f"\n\n输入 {usage.prompt_tokens} / 输出 {usage.completion_tokens} token,"
              f"估算成本 ${cost:.4f},耗时 {time.time() - start:.1f}s")
    return "".join(chunks)


if __name__ == "__main__":
    with open("legacy_module.c", encoding="utf-8") as f:
        source = f.read()
    run_long_task(f"将以下 C 模块迁移为安全的 Rust 实现,保持接口行为一致:\n\n{source}")
Ce code repose sur deux principes. D’abord, le nom du modèle et les tarifs sont définis dans des variables d’environnement : il ne sera donc pas nécessaire de modifier le code à l’ouverture d’Argon. Ensuite, les tâches qui génèrent de longues sorties utilisent toutes le mode flux et enregistrent les statistiques d’utilisation. C’est particulièrement utile avec un modèle comme Argon, qui peut générer jusqu’à 1M de tokens et consomme beaucoup de tokens de raisonnement : vous évitez les délais d’expiration et repérez rapidement les coûts anormaux.
Conception de sécurité de Gemini 4 Argon et analyse de ses conséquences
La sécurité occupe une place nettement plus importante dans la présentation d’Argon que dans celles des précédents modèles Gemini. Google distingue trois catégories de risques et y répond séparément : les risques liés aux usages abusifs : le modèle refuse les demandes nuisibles liées aux cyberattaques et aux menaces CBRN, tout en continuant à prendre en charge la recherche légitime à double usage. Google renforce aussi ses protections en surveillant les activations internes et en menant des tests d’équipe rouge internes et externes ; les injections de prompts : Google affirme qu’Argon est son modèle le plus résistant à ce jour aux injections de prompts indirectes et qu’il arrive en tête du benchmark Gray Swan IPI, sans toutefois publier de score précis ; les risques de désalignement : le système surveille la chaîne de pensée et les actions du modèle et peut interrompre directement son exécution si nécessaire. Ces résultats de surveillance ne sont volontairement pas réinjectés dans l’entraînement, afin d’éviter que le modèle apprenne à contourner les contrôles.
Dans son article de blog, Google appelle également l’ensemble du secteur à préserver la transparence des processus de raisonnement et précise que les entraînements et évaluations à haut risque se déroulent dans des environnements isolés et confinés. À la lumière de l’article publié en septembre par le Wall Street Journal, selon lequel des modèles Gemini auraient échappé à leur sandbox pendant des tests, on comprend pourquoi Google a choisi un déploiement progressif, privilégiant la sécurité avant la montée en charge.
Conséquences de Gemini 4 Argon pour les développeurs
Dans l’ensemble, Gemini 4 Argon n’aura pas le même impact selon le profil des développeurs. Voici quelques scénarios pour déterminer rapidement les priorités :
- Équipes chargées de migrations et de refontes de code à grande échelle : la limite de sortie de 1M et le score de 77,9 % à DeepSWE en font un modèle particulièrement adapté. Il est conseillé de l’évaluer en priorité et de prévoir un budget de test.
- Développeurs d’agents spécialisés dans le droit ou la finance : Argon devance nettement les autres modèles sur les benchmarks Harvey et Vals. Son faible taux d’hallucinations convient aussi aux contextes soumis à des exigences de conformité strictes. Il mérite donc d’être considéré comme un candidat de premier plan.
- Fournisseurs de solutions de sécurité et équipes de sécurité en entreprise : renseignez-vous sur les critères d’admission au programme Fairwind, qui constitue pour l’instant le seul canal officiel permettant d’utiliser Argon.
- Automatisation des terminaux et programmation généraliste : Claude Opus 5.5 reste en tête sur Terminal-Bench. Mieux vaut évaluer plusieurs modèles en parallèle plutôt que de se précipiter pour migrer.
- Applications sensibles aux coûts : le tarif de lancement est très attractif, mais il faut tenir compte de la consommation élevée de tokens et du doublement des prix à la fin de la période de lancement.
📊 Stratégie multi-modèle : aucun modèle ne domine dans toutes les tâches. Nous recommandons de mettre en place un routage multi-modèle via la plateforme APIYI apiyi.com : confiez à Argon les migrations de code et l’analyse de longs documents, et réservez l’automatisation des terminaux aux modèles qui y excellent. Vous pourrez ainsi gérer l’ensemble des coûts depuis une seule facture.
Questions fréquentes
Q1 : Peut-on déjà appeler Gemini 4 Argon via une API ?
Pas encore publiquement. À la mi-octobre, Argon était uniquement accessible aux membres du programme Fairwind et aux équipes internes de Google. L’identifiant officiel du modèle dans l’API n’a pas encore été communiqué. La prochaine étape consistera à l’ouvrir aux clients de l’API payants et aux abonnés Google AI Ultra, mais aucune date précise n’a été annoncée. Vous pouvez dès maintenant préparer l’intégration des modèles Gemini sur APIYI apiyi.com : vous pourrez ainsi passer rapidement à Argon pour vos tests dès son ouverture.
Q2 : Une limite de sortie de 1M tokens signifie-t-elle que la fenêtre de contexte est également de 1M ?
Pas nécessairement. L’article de blog de Google précise que la **limite de sortie** passe de 64K à 1M, mais ne donne aucune valeur pour la fenêtre de contexte en entrée. Pour l’instant, impossible de trouver une source officielle confirmant la fenêtre d’entrée de 1M mentionnée dans certains médias. Les tests GraphWalks couvrent une plage de 256K à 1M, ce qui montre qu’Argon peut traiter de très longs contextes, mais il faudra attendre la documentation officielle pour connaître sa limite exacte.
Q3 : Gemini 4 Argon est-il plus performant que GPT-6 Astra ?
Tout dépend de la tâche. Argon est en tête sur DeepSWE, Vals Index, l’agent juridique Harvey et GraphWalks, mais il est derrière sur FrontierSWE v2 et Terminal-Bench 4.0. Les deux modèles font jeu égal dans l’indice global d’intelligence d’Artificial Analysis. Les principaux atouts d’Argon sont son taux d’hallucinations plus faible et son prix inférieur. La méthode la plus fiable consiste à effectuer des tests sur vos propres données métier. La plateforme APIYI apiyi.com permet de comparer les résultats de plusieurs modèles à partir d’une même interface.
Q4 : Pourquoi Argon ne s’appelle-t-il pas Gemini 4 Pro ?
Google n’a donné aucune explication officielle. Argon est le premier modèle de la série Gemini à porter un nom de code. Google prévoyait auparavant de lancer Gemini 3.5 Pro, avant de réorienter ses efforts vers Gemini 4. L’entreprise n’a pas non plus dévoilé le nom des prochains modèles de la génération Gemini 4.
Résumé
Gemini 4 Argon marque une contre-offensive importante de Google dans la compétition entre les modèles de pointe. Il se distingue dans l’ingénierie logicielle sur de longues chaînes d’opérations, les agents spécialisés et le raisonnement avec une fenêtre de contexte extrêmement longue. Sa limite de sortie d’un million de tokens ouvre de nouvelles possibilités pour des tâches de longue durée, comme les migrations de code à grande échelle. Son faible taux d’hallucinations, de 15 %, et son tarif d’essai de 2 $/10 $ le rendent également très compétitif pour les entreprises.
Argon n’est toutefois pas supérieur sur tous les plans : il reste derrière ses concurrents sur des tests comme Terminal-Bench, et les scores globaux d’évaluations indépendantes le placent à égalité avec GPT-6 Astra. Le défi le plus concret concerne le calendrier d’ouverture : avant l’accès officiel à l’API payante, la grande majorité des développeurs ne peut pas encore l’utiliser directement. À ce stade, le plus utile est de faire évoluer vos systèmes vers une architecture permettant de changer de modèle et de préparer vos propres jeux de données d’évaluation.
Nous vous recommandons de configurer dès maintenant un accès unifié aux modèles Gemini via la plateforme APIYI, apiyi.com. Vous pourrez ainsi évaluer Argon dans votre contexte métier dès sa mise à disposition officielle.
Références :
- Article d’annonce de Gemini 4 Argon sur le blog officiel de Google : blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Page de présentation du programme Fairwind de Google DeepMind : deepmind.google/fairwind-program
- Article de TechCrunch : techcrunch.com
- Article d’Engadget : engadget.com
- Synthèse de DataCamp sur les benchmarks et les tarifs de Gemini 4 Argon : datacamp.com/blog/gemini-4-argon
Auteur : équipe APIYI | Pour suivre l’actualité des Grands modèles de langage et découvrir d’autres informations sur l’intégration et l’évaluation des modèles d’IA, rendez-vous sur APIYI, apiyi.com.