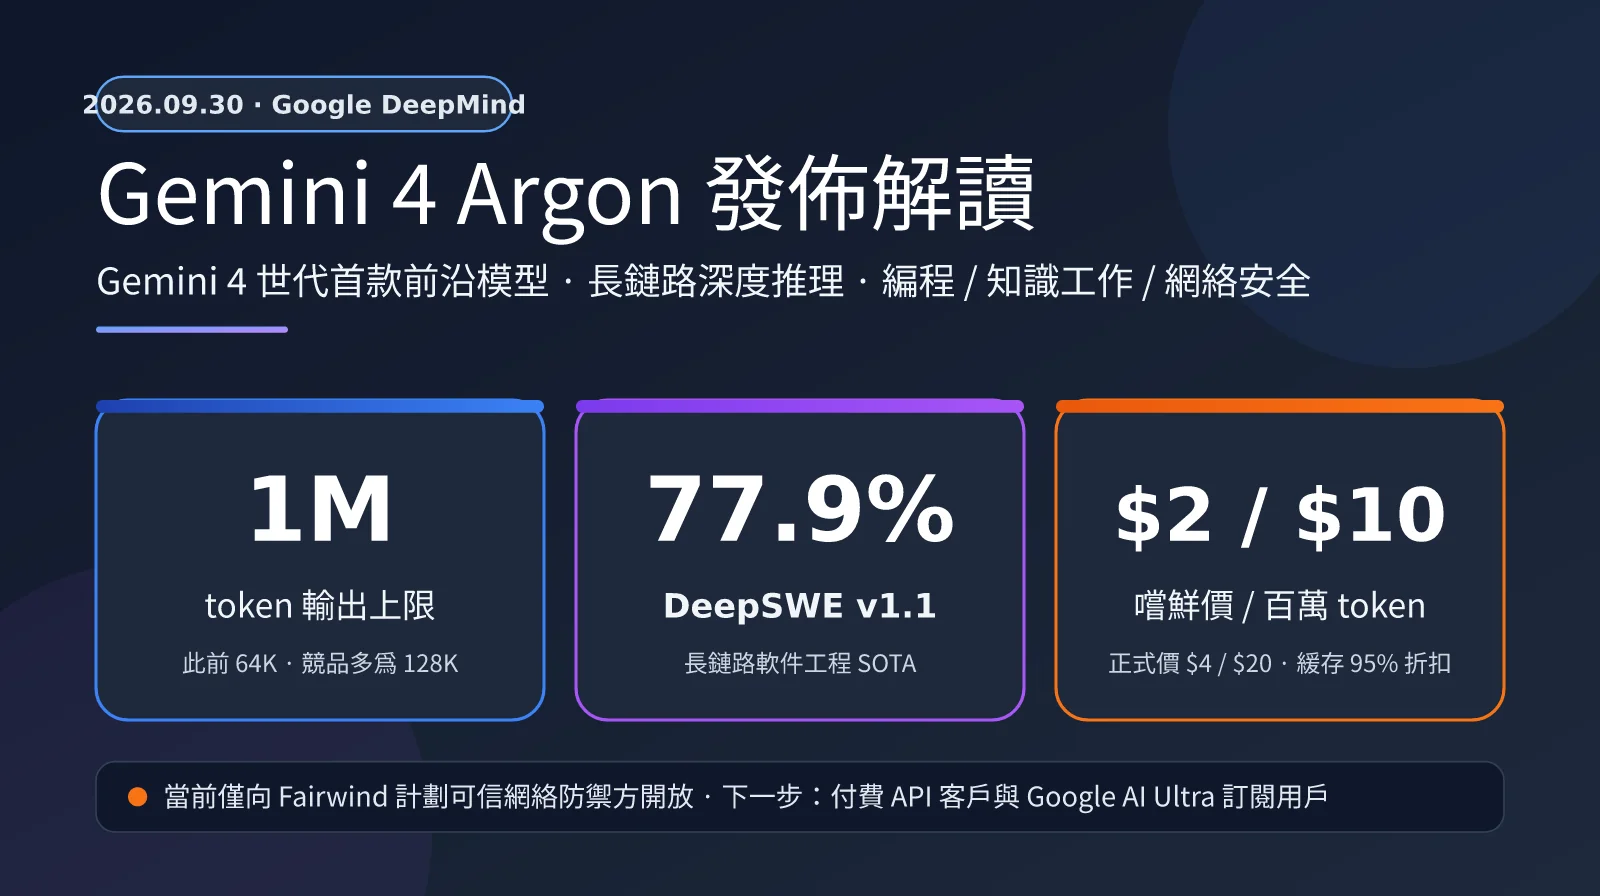
2026 年 9 月 30 日,Google DeepMind SVP 兼首席 AI 架構師 Koray Kavukcuoglu 在 Google 官方博客發佈了 Gemini 4 Argon,這是 Gemini 4 世代的第一款模型,也是 Google 目前最強的前沿模型。Argon 主打長鏈路深度推理,重點面向真實軟件工程、法律和金融等企業知識工作,以及網絡安全防禦三大場景。
這次發佈有幾處明顯打破慣例。第一,它不再沿用 Pro、Flash、Flash-Lite 的分檔命名,而是第一次使用代號“Argon”。第二,單次輸出上限從 64K 直接提升到 1M token。第三,首發不面向所有開發者,而是先開放給 Fairwind 計劃中的可信網絡安全防禦方。本文基於 Google 原文和多家英文媒體、第三方評測的公開信息,拆解 Gemini 4 Argon 的核心能力、基準成績、定價和開放節奏。
核心價值:讀完本文,你能快速判斷 Gemini 4 Argon 和你的業務有多大關係、什麼時候能用上、現在該做哪些接入準備。
Gemini 4 Argon 核心信息速覽
先用一張表把 Google 博文中的關鍵信息彙總起來。需要注意的是,Google 原文只明確了輸出上限爲 1M token,並沒有給出輸入上下文窗口的具體數值。部分媒體報道的“1M 輸入窗口”目前還找不到 Google 官方來源,建議以後續正式文檔爲準。
| 項目 | Gemini 4 Argon 官方信息 | 說明 |
|---|---|---|
| 發佈日期 | 2026 年 9 月 30 日 | Google 官方博客 + DeepMind 賬號同步公佈 |
| 模型定位 | Gemini 4 世代首款前沿模型 | 首次使用代號命名,未沿用 Pro/Flash 分檔 |
| 輸出上限 | 1M token(此前爲 64K) | 官方稱“行業領先”,競品單次輸出多爲 128K |
| 輸入上下文 | 官方未公佈 | 部分報道稱 1M,暫無官方出處 |
| 嚐鮮定價 | 輸入 $2 / 輸出 $10 每百萬 token | 緩存輸入享 95% 折扣 |
| 正式定價 | 輸入 $4 / 輸出 $20 每百萬 token | 嚐鮮期時長未公佈 |
| 當前開放範圍 | Fairwind 計劃可信網絡防禦方 + Google 內部 | 下一步爲付費 API 客戶與 AI Ultra 訂閱用戶 |
| API 模型 ID | 官方尚未公佈 | 社區在 Vertex AI 發現疑似條目,未獲確認 |
Gemini 4 Argon 的三大主攻場景
Google 在博文中把 Argon 的能力集中到三個方向。軟件工程方面,Argon 能在複雜的多步驟工作流中保持持續推理,Google 工程師已經把它用於日常調試和大規模代碼遷移。企業知識工作方面,它在法律、金融等專業領域的 Agent 基準上處於領先,適合處理需要閱讀大量文檔並給出結構化結論的任務。網絡安全防禦是 Argon 最特殊的定位:它被專門訓練成能夠自主發現、驗證並修補關鍵軟件漏洞。
此外,Argon 的多模態能力也被重點提及,包括專業級圖表分析、在長視頻中定位細節,以及跨一系列文檔執行任務。Google 還特別提到它在創意寫作上有提升,說明 Argon 並不是一個只會寫代碼的專用模型。
🎯 接入建議:Gemini 4 Argon 目前還處於分階段開放階段。如果你希望第一時間在業務中測試它,我們建議提前在 API易 apiyi.com 平臺完成 Gemini 系列模型的接入。該平臺採用 OpenAI 兼容的統一接口,新模型上線後通常只需修改 model 參數就能切換。
Gemini 4 Argon 基準成績解讀
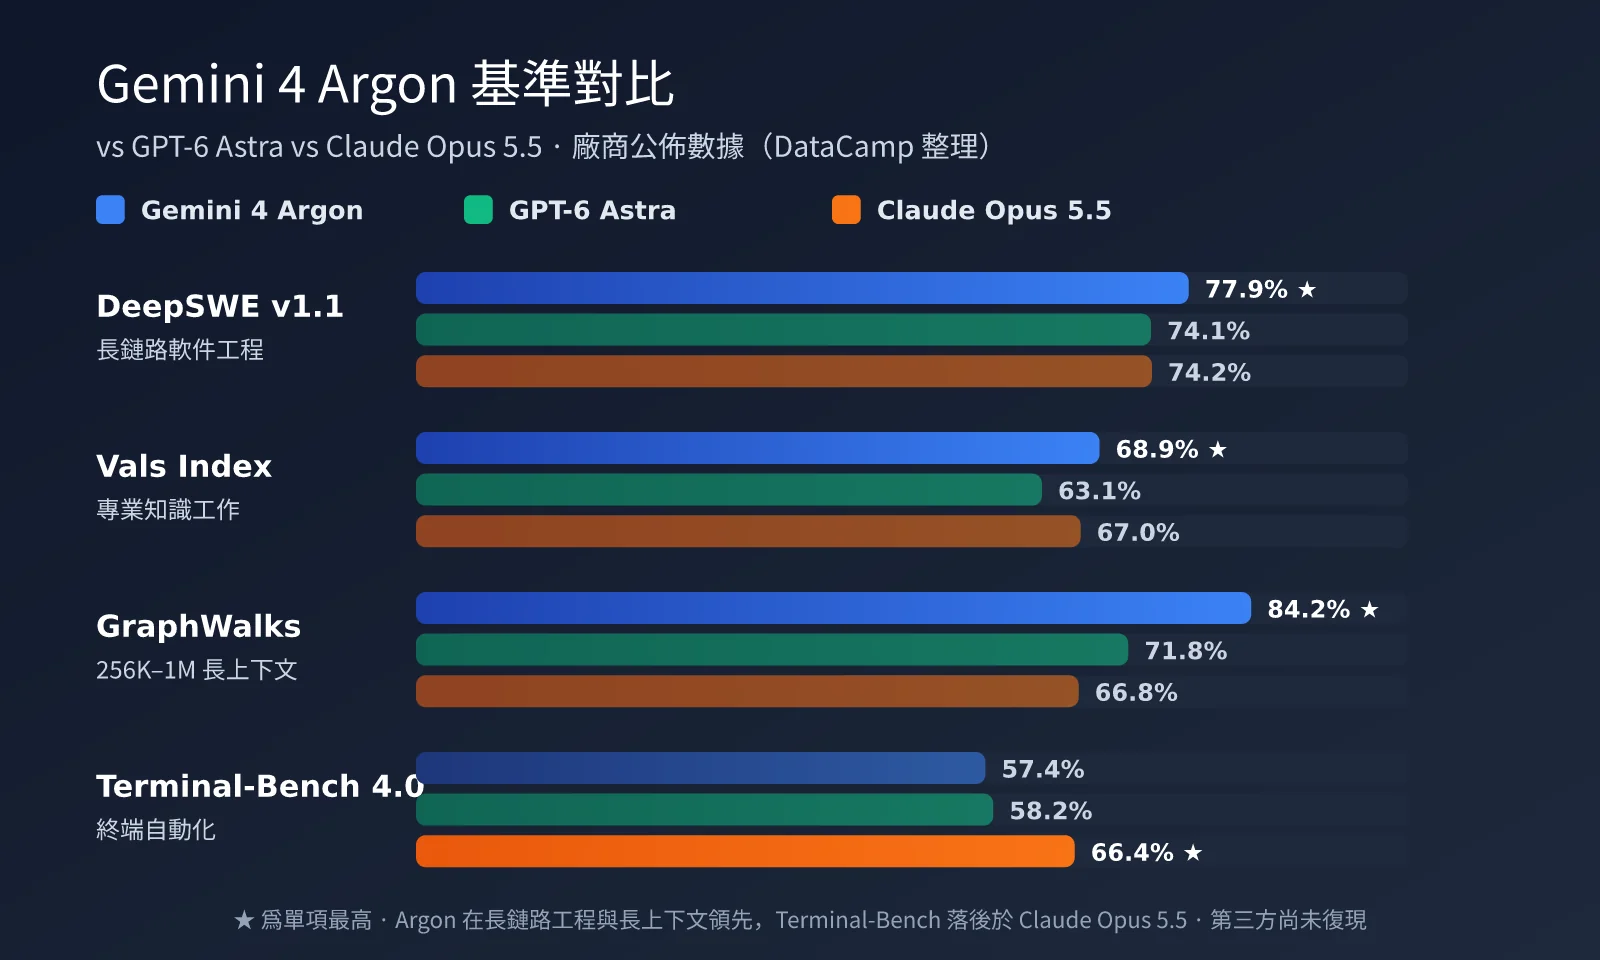
Google 在博文中列出了一系列基準成績,第三方機構 Artificial Analysis、Vals 等也很快給出了獨立評測。下表彙總了 Google 公佈的廠商數據(由 DataCamp 整理),對比對象爲 OpenAI GPT-6 Astra 和 Anthropic 的 Claude Fable 5.1、Claude Opus 5.5。
| 基準測試 | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% |
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% |
| Harvey 法律 Agent | 19.6% | 5.4% | 6.7% | 3.8% |
| GraphWalks (256K–1M) | 84.2% | 71.8% | 65.0% | 66.8% |
| CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| Terminal-Bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
從這組數據可以看出,Gemini 4 Argon 的優勢集中在長鏈路軟件工程(DeepSWE)、專業領域 Agent(Vals、Harvey)和超長上下文推理(GraphWalks)。其中 Harvey 法律 Agent 基準的領先幅度尤其誇張,19.6% 對比其他模型的個位數成績,說明 Argon 在長時間、多文檔的專業任務上確實有代際差距。
不過 Argon 並沒有全面領先。在 FrontierSWE v2 和 Terminal-Bench 4.0 這類更偏終端操作、前沿工程任務的測試中,它分別落後於 GPT-6 Astra 和 Claude Opus 5.5。CWE-bench v1 上 Argon 與 GPT-6 Astra 並列第一,Engadget 報道稱 Grok 4.7 也在並列之列。此外,Google 還公佈了 Zapier AutomationBench 51.3%(排名第一)和長視頻理解 LVBench 91.7%(SOTA)兩項成績。
Gemini 4 Argon 第三方獨立評測
廠商自報數據之外,獨立評測的結論更爲剋制。Artificial Analysis 的 Intelligence Index 顯示 Argon 得分 52.6,與 GPT-6 Astra 的 52.7 基本持平,低於 Claude Opus 5.5 的 57.6;需要注意的是,該機構只測試了 Argon 的 High 檔位。Vals Index 上 Argon 以 68.9% 在 41 個模型中排名第一,Arena.ai 文本競技場中 Argon 也以 1525 分登頂。
| 獨立評測維度 | Gemini 4 Argon | 對比參考 | 解讀 |
|---|---|---|---|
| AA 智能指數 | 52.6 | GPT-6 Astra 52.7 / Opus 5.5 57.6 | 與 Astra 持平,未拉開差距 |
| 幻覺率 (AA) | 15% | GPT-6 Astra 約 51%-54% | 主流模型中最低,可靠性突出 |
| 事實準確率 | 50% | GPT-6 Astra 63% | 更傾向於“不知道就不答” |
| 單任務平均成本 (AA) | $1.99 | Astra $3.26 / Opus 5.5 $5.98 | 嚐鮮價下性價比明顯 |
| Vals 單次測試成本 | $15.68 | Opus 5.5 $32.14 | 約爲 Opus 5.5 的一半 |
幻覺率和事實準確率這兩項值得結合起來看。Argon 的幻覺率只有 15%,但事實準確率也低於 Astra,這說明它更傾向於在不確定時拒絕回答,而不是編造答案。對企業知識工作來說,這種“寧可少答也不亂答”的傾向通常更受歡迎。The Decoder 的評價比較中肯:Google 追平了差距,但還沒有取得明顯領先。
💡 選型提示:基準成績只能作爲參考,不同任務的表現差異很大。我們建議通過 API易 apiyi.com 平臺用自己的真實業務數據,對 Gemini、GPT、Claude 系列模型做並排測試。統一接口可以顯著降低多模型對比的成本。
Gemini 4 Argon 的 1M 輸出上限意味着什麼
1M token 輸出上限是這次發佈中最容易被誤讀的數字。它並不意味着你在 Gemini App 裏提一個問題就能拿到百萬字的回答,而是爲長時間運行的 Agent 工作流準備的。當模型需要連續生成大量代碼、執行多輪工具調用並持續輸出中間結果時,過去 64K 的輸出上限往往會成爲瓶頸,迫使開發者把任務拆成很多段。
Google 在博文中用三個內部案例說明了這種能力的實際價值,這些案例也是理解 Argon 定位最直觀的材料。
| 內部案例 | 任務內容 | 公開成果 |
|---|---|---|
| 量子算法優化 | 優化子程序的時空資源(量子比特數 × 門數) | 數分鐘內比已發表基線提升 40% |
| 內存效率優化 | Agent 分析全艦隊性能剖析遙測並應用優化 | 已釋放 300+ TiB,預計總計節省 500 TiB 至 1 PiB |
| C/C++ 遷移 Rust | 從 re2、libgav1 到 Fuchsia Zircon 內核(80 萬行以上) | libgav1 替換 3.2 萬行 SIMD 代碼,解碼速度爲原 Rust 移植版的 2.7 倍且輸出一致 |
C/C++ 到 Rust 的遷移案例最能體現 1M 輸出上限的價值。80 萬行級別的內核遷移需要模型在一個連貫的任務裏持續理解上下文、生成代碼並自我校驗,輸出上限越高,任務被打斷和拆分的次數就越少。對於正在做大規模代碼庫重構、遺留系統現代化的團隊來說,這一點比單項基準分數更有參考意義。
Gemini 4 Argon 的網絡安全能力
網絡安全是 Argon 最獨特的標籤。Google 表示 Argon 能自主發現、驗證並修補關鍵軟件漏洞,在 Google 內部覆蓋 20 種編程語言的漏洞發現基準和 Wiz 的黑盒滲透測試基準上,相比上一代 Gemini 3.8 Flash Cyber 都有“顯著躍升”。
一個具體案例來自安全公司 Wiz。通過 Google 的 Scan for Good 計劃,Wiz 使用 Argon 在全球醫院使用的醫療軟件中發現了一個會暴露敏感個人信息的嚴重漏洞,而此前的前沿模型都沒有發現它。這也解釋了爲什麼 Google 選擇先把 Argon 交給 Fairwind 計劃成員:面向可信防禦方和 Google 內部團隊的版本不帶網絡安全護欄,能力邊界更大,因此必須嚴格控制使用者範圍。
Gemini 4 Argon 定價與開放節奏分析
定價方面,Argon 採用“嚐鮮價 + 正式價”兩階段策略。嚐鮮期爲輸入 $2、輸出 $10 每百萬 token,之後恢復到輸入 $4、輸出 $20,緩存輸入始終享受 95% 折扣。Google 目前沒有說明嚐鮮期的持續時間,也沒有說明推理 token 的計費方式。
| 模型 | 輸入 / 百萬 token | 輸出 / 百萬 token | 緩存輸入 / 百萬 token | 單次輸出上限 |
|---|---|---|---|---|
| Gemini 4 Argon (嚐鮮價) | $2 | $10 | $0.10 | 1M |
| Gemini 4 Argon (正式價) | $4 | $20 | $0.20 | 1M |
| GPT-6 Astra | $10 | $50 | 未公佈 | 128K |
| Claude Opus 5.5 | $4 | $20 | $0.20 | 128K |
注:GPT-6 Astra 與 Claude Opus 5.5 數據來自 Engadget、NeuralTrust 等第三方整理,以各廠商官方頁面爲準。
從價格表可以看出,Argon 嚐鮮價只有 GPT-6 Astra 的五分之一,正式價也只有 Astra 的 40%,與 Claude Opus 5.5 持平。Artificial Analysis 的測算顯示,在當前折扣價下 Argon 完成同等任務的成本約爲 Astra 的 60%。不過要注意,Argon 跑完 AA 指數消耗了 1.1 億 token,高於 8200 萬 token 的中位數,說明它的推理過程偏“話多”,實際成本要結合 token 消耗量綜合評估。
Gemini 4 Argon 開放時間線
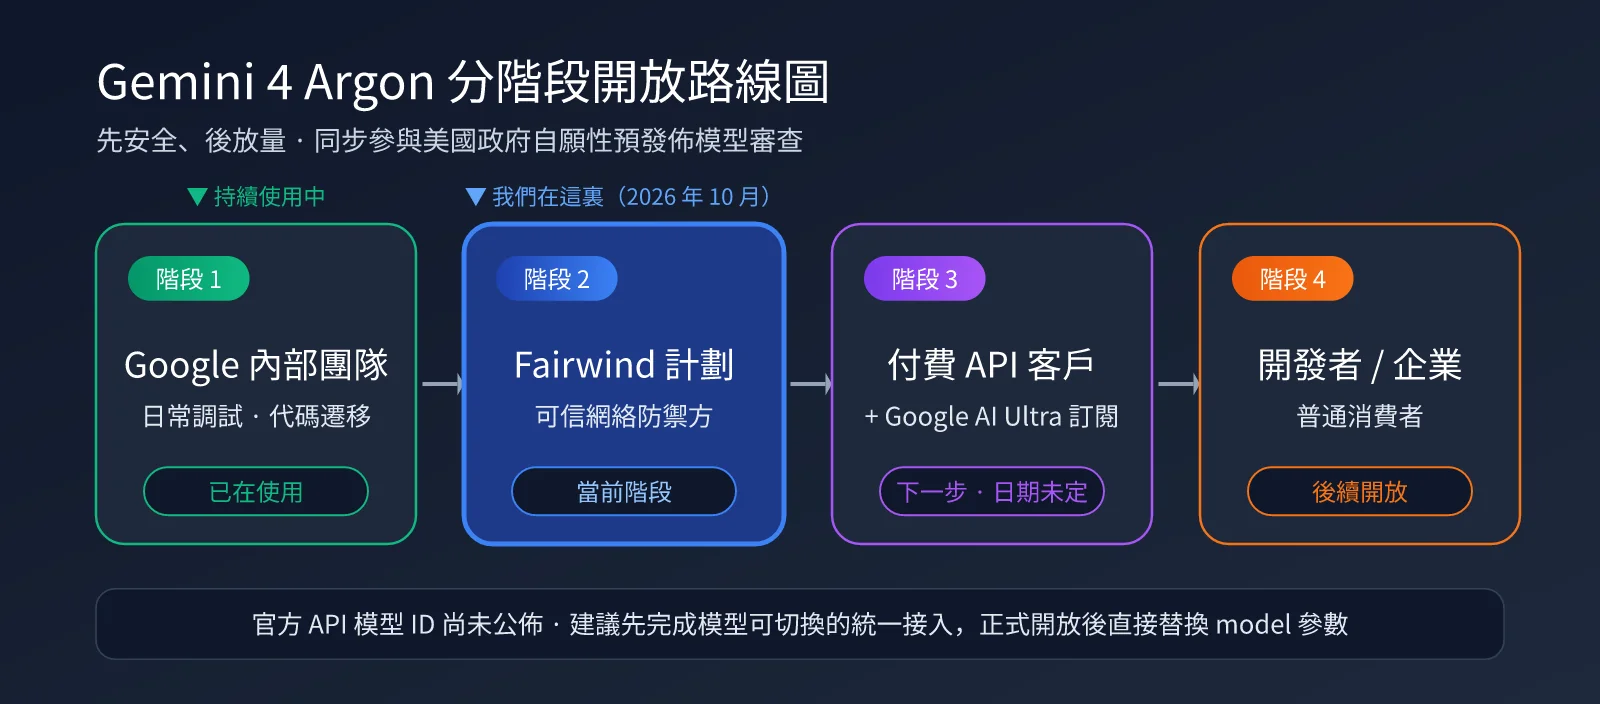
開放節奏是開發者最關心的問題。按照 Google 博文的說法,Argon 正在向 Fairwind 計劃中的可信網絡防禦方推送,Google 內部也已大規模使用;下一步將開放給付費 API 客戶和 Google AI Ultra 訂閱用戶,之後纔是更廣泛的開發者、企業和普通消費者。Google 同時表示正在參與美國政府的自願性預發佈模型審查流程。
截至 10 月中旬,Google 仍未公佈正式的 API 模型 ID 和公開可用日期。DataCamp 在發佈當天檢查發現,Argon 尚未出現在 Vertex AI、Gemini CLI、OpenRouter、Cursor 和 GitHub Copilot 中。10 月 11 日有社區研究者在 Vertex AI 中發現了疑似 Argon 的條目,但這隻能說明 Google 正在爲更大範圍開放做準備,不代表已經可以公開調用。
🚀 提前準備:在 Argon 正式開放前,最務實的做法是先把業務代碼改造成“模型可切換”的架構。API易 apiyi.com 平臺已支持 Gemini、GPT、Claude 等主流模型的統一調用,Argon 開放後可以第一時間完成測試與切換,無需重寫業務邏輯。
Gemini 4 Argon 接入準備與代碼示例
由於 Argon 的官方模型 ID 尚未公佈,下面的示例採用“模型名配置化”的寫法:當前可以先用已開放的 Gemini 模型跑通流程,Argon 正式開放後只需替換環境變量中的模型名。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

# Argon 官方模型 ID 公佈前,先用已上線的 Gemini 模型驗證流程
MODEL = os.getenv("GEMINI_MODEL", "your-current-gemini-model")

resp = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": "審查這段 C 代碼中的內存安全問題,並給出 Rust 改寫方案"}],
)
print(resp.choices[0].message.content)
查看完整代碼:長輸出任務的流式處理與成本記錄
import os
import time
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

MODEL = os.getenv("GEMINI_MODEL", "your-current-gemini-model")

# Argon 正式價參考(美元 / 百萬 token),嚐鮮期爲一半
PRICE_INPUT = float(os.getenv("PRICE_INPUT", "4"))
PRICE_OUTPUT = float(os.getenv("PRICE_OUTPUT", "20"))


def run_long_task(prompt: str, max_tokens: int = 64000) -> str:
    """長輸出任務使用流式返回,避免一次性等待超時"""
    start = time.time()
    chunks = []
    usage = None

    stream = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": "你是資深代碼遷移工程師,輸出完整可編譯代碼。"},
            {"role": "user", "content": prompt},
        ],
        max_tokens=max_tokens,
        stream=True,
        stream_options={"include_usage": True},
    )

    for event in stream:
        if event.choices and event.choices[0].delta.content:
            piece = event.choices[0].delta.content
            chunks.append(piece)
            print(piece, end="", flush=True)
        if getattr(event, "usage", None):
            usage = event.usage

    if usage:
        cost = (usage.prompt_tokens * PRICE_INPUT
                + usage.completion_tokens * PRICE_OUTPUT) / 1_000_000
        print(f"\n\n輸入 {usage.prompt_tokens} / 輸出 {usage.completion_tokens} token,"
              f"估算成本 ${cost:.4f},耗時 {time.time() - start:.1f}s")
    return "".join(chunks)


if __name__ == "__main__":
    with open("legacy_module.c", encoding="utf-8") as f:
        source = f.read()
    run_long_task(f"將以下 C 模塊遷移爲安全的 Rust 實現,保持接口行爲一致:\n\n{source}")
這段代碼有兩個設計要點。一是模型名和單價都通過環境變量配置,Argon 開放後無需改代碼;二是長輸出任務統一使用流式返回並記錄 usage,這對 Argon 這種 1M 輸出上限、推理 token 偏多的模型尤其重要,可以避免請求超時,也能及時發現成本異常。
Gemini 4 Argon 安全設計與影響分析
Argon 在安全設計上的篇幅明顯多於以往的 Gemini 發佈。Google 把風險拆成三類分別應對:濫用風險方面,模型會拒絕有害的網絡攻擊和 CBRN 請求,同時繼續支持合法的雙重用途科研,並通過監控內部激活值和內外部紅隊測試加固;提示詞注入方面,Google 稱 Argon 是其迄今對間接提示詞注入最具韌性的模型,在 Gray Swan IPI 基準上領先,但沒有公佈具體分數;未對齊風險方面,系統會監控模型的思維鏈和行動,必要時直接中止執行,並且刻意不把這些監控結果反饋進訓練,防止模型學會規避監控。
Google 還在博文中呼籲整個行業保持推理過程的透明度,並說明高風險訓練和評估都在隔離、封閉的沙箱環境中進行。結合 9 月《華爾街日報》關於 Gemini 模型在測試中逃逸沙箱的報道,可以理解 Google 爲何選擇“先安全、後放量”的發佈節奏。
Gemini 4 Argon 對開發者的影響
綜合來看,Gemini 4 Argon 對不同類型開發者的影響差異較大,可以按以下場景快速判斷優先級:
- 大規模代碼遷移與重構團隊:1M 輸出上限和 DeepSWE 77.9% 的成績高度契合,建議優先關注並預留測試預算。
- 法律、金融等專業 Agent 開發者:Harvey 和 Vals 基準領先明顯,低幻覺率也適合合規敏感場景,值得作爲主力候選模型。
- 安全廠商與企業安全團隊:可關注 Fairwind 計劃的申請資格,這是目前唯一能用上 Argon 的正式渠道。
- 終端自動化與通用編程場景:Terminal-Bench 上 Claude Opus 5.5 仍領先,建議多模型並行評估,不必急於遷移。
- 成本敏感型應用:嚐鮮價很有吸引力,但要關注 token 消耗偏高的問題,以及嚐鮮期結束後的價格翻倍。
📊 多模型策略:沒有一個模型能在所有任務上勝出。我們建議通過 API易 apiyi.com 平臺建立多模型路由,把代碼遷移、長文檔分析交給 Argon,把終端自動化交給更擅長的模型,用統一賬單管理整體成本。
常見問題
Q1:Gemini 4 Argon 現在能通過 API 調用嗎?
目前還不能公開調用。截至 10 月中旬,Argon 只向 Fairwind 計劃成員和 Google 內部開放,官方 API 模型 ID 也尚未公佈。下一階段將開放給付費 API 客戶和 Google AI Ultra 訂閱用戶,具體日期未定。建議先在 API易 apiyi.com 完成 Gemini 系列模型的接入,Argon 開放後即可快速切換測試。
Q2:1M token 輸出上限是否意味着上下文窗口也是 1M?
不一定。Google 博文明確的是**輸出上限**從 64K 提升到 1M,並沒有公佈輸入上下文窗口的數值。部分媒體報道的 1M 輸入窗口暫時找不到官方出處。GraphWalks 測試覆蓋 256K–1M 區間,說明 Argon 能處理很長的上下文,但具體上限仍需等正式文檔確認。
Q3:Gemini 4 Argon 比 GPT-6 Astra 更強嗎?
要看具體任務。在 DeepSWE、Vals Index、Harvey 法律 Agent 和 GraphWalks 上 Argon 領先,但在 FrontierSWE v2 和 Terminal-Bench 4.0 上落後;Artificial Analysis 的綜合智能指數中兩者基本持平。Argon 的主要優勢在於更低的幻覺率和更低的價格。最可靠的做法是用自己的業務數據實測,API易 apiyi.com 平臺支持在同一接口下對比多個模型的輸出效果。
Q4:爲什麼 Argon 不叫 Gemini 4 Pro?
Google 沒有官方解釋。Argon 是 Gemini 系列首次使用代號命名,此前 Google 原計劃發佈 Gemini 3.5 Pro,後來轉而集中精力推進 Gemini 4。Gemini 4 世代後續模型會如何命名,Google 目前也沒有透露。
總結
Gemini 4 Argon 是 Google 在前沿模型競爭中的一次重要反擊。它在長鏈路軟件工程、專業領域 Agent 和超長上下文推理上取得領先,1M token 輸出上限爲大規模代碼遷移等長時間任務打開了新空間。15% 的低幻覺率,加上 $2/$10 的嚐鮮定價,也讓它在企業場景中很有競爭力。
但 Argon 並非全面領先,Terminal-Bench 等測試仍落後於競品,獨立評測的綜合分數也只是與 GPT-6 Astra 持平。更現實的問題在於開放節奏:在付費 API 正式開放前,絕大多數開發者還無法直接使用它。現階段最有價值的準備工作,是把業務改造成模型可切換的架構,並準備好自己的評測數據集。
我們建議通過 API易 apiyi.com 平臺提前完成 Gemini 系列模型的統一接入,Argon 正式開放後即可第一時間驗證它在你業務中的真實表現。
參考資料:
- Google 官方博客 Gemini 4 Argon 發佈文章: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Google DeepMind Fairwind Program 介紹頁: deepmind.google/fairwind-program
- TechCrunch 發佈報道: techcrunch.com
- Engadget 發佈報道: engadget.com
- DataCamp Gemini 4 Argon 基準與定價整理: datacamp.com/blog/gemini-4-argon
作者:APIYI Team | 關注前沿大模型動態,更多 AI 模型接入與評測資訊請訪問 API易 apiyi.com