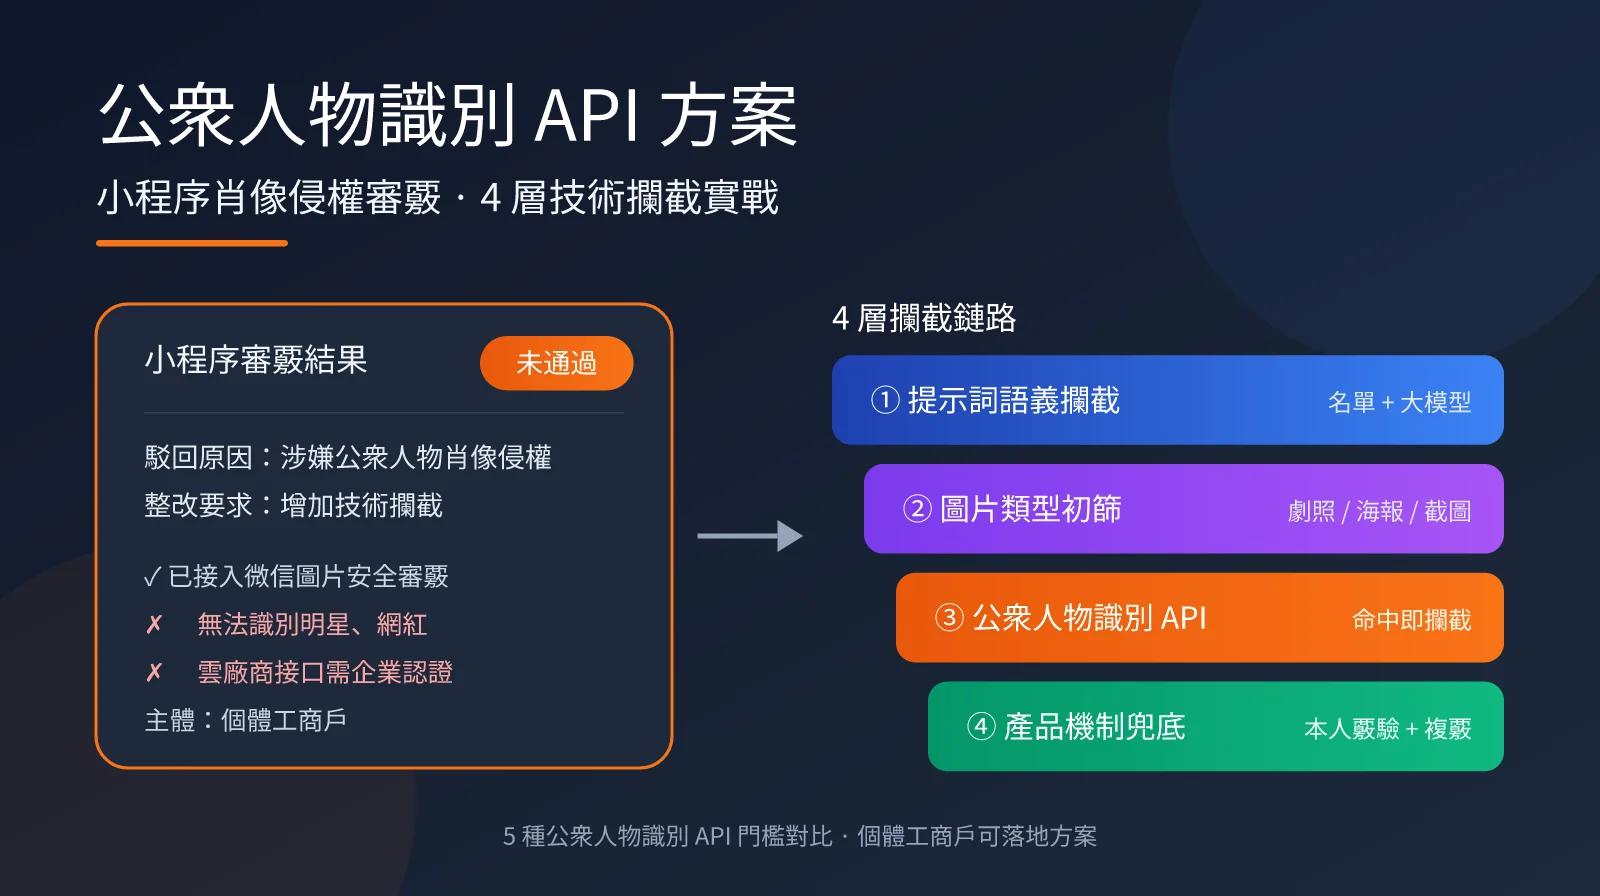
最近一位做 AI 圖片小程序的開發者在羣裏求助:小程序審覈卡在公衆人物肖像侵權問題上,微信要求“增加技術攔截”。他已經接入了微信圖片安全審覈,但這個接口識別不了明星和網紅;阿里雲有現成的明星識別接口,卻要求企業認證,而他們是個體工商戶。
這類問題在 AI 寫真、換臉、頭像生成、海報設計類小程序裏非常普遍。審覈人員關心的不是“你有沒有接內容安全接口”,而是“用戶能不能用你的產品生成或傳播某位公衆人物的肖像”。只要攔截鏈路上有一個環節缺失,就可能反覆被駁回。
本文圍繞公衆人物識別 API 展開,先說清楚微信內容安全接口的能力邊界,再對比 5 種主流公衆人物識別 API 的接入門檻,最後給出一套個體工商戶也能落地的 4 層技術攔截方案。
核心價值:讀完本文,你能明確知道該選哪個公衆人物識別 API、怎麼組合攔截鏈路,以及提交審覈時如何把技術方案講清楚。
公衆人物識別 API 爲什麼成了小程序審覈的硬門檻
微信對 AI 生成類、圖片編輯類小程序的審覈越來越嚴格,背後有明確的監管依據。《互聯網信息服務深度合成管理規定》自 2023 年 1 月 10 日起施行,要求提供人臉、人聲等生物識別信息編輯功能的服務方,提示使用者告知被編輯的個人並取得其單獨同意。2025 年 9 月 1 日起施行的《人工智能生成合成內容標識辦法》又進一步要求對 AI 生成內容做顯式和隱式標識。
在這個背景下,平臺最擔心的是“明星臉”被濫用:用戶上傳某位演員的劇照做 AI 寫真、用網紅照片換臉、輸入明星名字生成“同款”圖片。這些行爲都可能構成肖像權侵權,而小程序作爲服務提供方需要承擔“技術攔截”義務。因此審覈反饋裏的“增加技術攔截”,本質是要求你在用戶上傳和生成兩個環節都具備識別公衆人物的能力。
微信內容安全接口的能力邊界
很多開發者的第一反應是接微信官方的內容安全接口,但它解決的是另一類問題。下表對比了微信接口能覆蓋的範圍和肖像侵權場景真正需要的能力。
| 檢測維度 | 微信 msgSecCheck / mediaCheckAsync | 肖像侵權攔截實際需要 |
|---|---|---|
| 色情、低俗 | ✅ 支持 | 需要 |
| 時政敏感 | ✅ 支持(部分涉政人物) | 需要 |
| 暴恐、違法、辱罵 | ✅ 支持 | 需要 |
| 娛樂明星識別 | ❌ 不返回人物身份 | 核心需求 |
| 網紅、主播識別 | ❌ 不支持 | 核心需求 |
| 提示詞中的明星名字 | ⚠️ 僅判斷文本違規,不判斷肖像意圖 | 核心需求 |
微信 msgSecCheck 用於文本檢測,mediaCheckAsync 用於圖片和音頻的異步檢測,主要識別色情、時政、暴恐、辱罵等違規內容,它們並不會告訴你“這張圖裏是哪位明星”。所以僅接入微信接口,在審覈人員眼裏只完成了“通用內容安全”,並沒有完成“公衆人物肖像攔截”。
🎯 技術建議:公衆人物識別 API 只是攔截鏈路中的一環,文本提示詞側的攔截往往更關鍵、也更便宜。我們建議通過 API易 apiyi.com 平臺調用大模型做提示詞語義審覈,它兼容 OpenAI 接口格式,個人開發者也能直接註冊使用,便於快速補齊這一層。
5 種公衆人物識別 API 方案對比
爲了避免信息失真,下面的方案均基於各廠商英文官方文檔整理。需要提前說明的是,公衆人物識別屬於人臉識別範疇,幾乎所有大廠都對它設置了訪問門檻,這正是個體工商戶感到“無路可走”的原因。
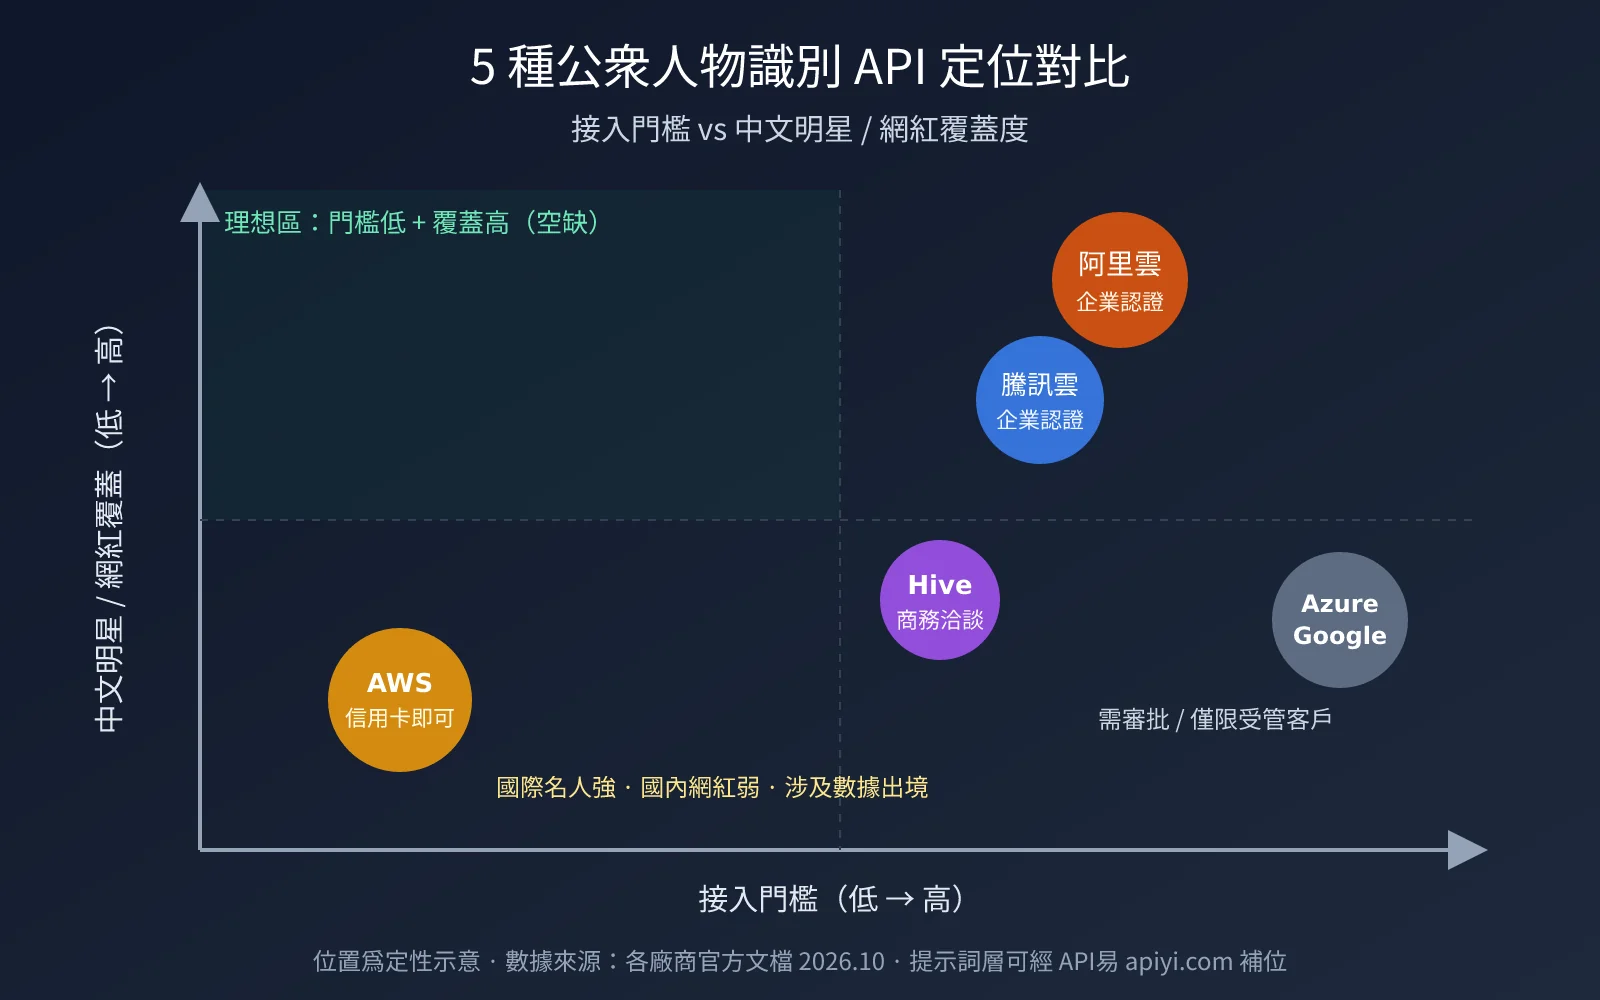
公衆人物識別 API 門檻與能力一覽
| 方案 | 接口能力 | 接入門檻 | 中文明星/網紅覆蓋 | 計費參考 |
|---|---|---|---|---|
| 阿里雲視覺智能 / 內容安全 | 明星識別 DetectCelebrity;圖片審覈增強版可通過 infoType=publicFigure 返回公衆人物名稱和位置 |
據開發者反饋需企業實名認證 | 高 | 按調用量計費 |
| 騰訊雲圖片內容安全 IMS | 返回違規標籤與二級標籤,部分場景可返回人物名稱 | 企業認證(個體工商戶可嘗試營業執照認證) | 中高 | 按調用量計費 |
| AWS Rekognition | RecognizeCelebrities 單圖最多識別 64 位名人,返回姓名、ID、置信度和參考鏈接 |
海外賬號綁定信用卡即可,無需審批 | 國際名人強,國內網紅弱 | 首個 100 萬張每張 $0.001 |
| Hive Celebrity Recognition | 覆蓋 5 萬+ 政治人物、運動員、宗教領袖和明星 | 需申請 API Key,偏企業商務 | 中 | 官網未公開 |
| Azure / Google Cloud Vision | 名人識別 | Azure 自 2022 年 6 月起僅對受管客戶開放;Google 僅限通過人工審覈的媒體娛樂客戶 | 中 | 需審批 |
從表中可以看出,門檻最低的是 AWS Rekognition,但它的名人庫以國際影視、體育、政商人物爲主,對國內網紅、主播覆蓋有限。而且人臉屬於《個人信息保護法》中的敏感個人信息,把用戶上傳的照片發送到境外服務,還會涉及數據出境合規問題,這一點在提交審覈材料時也需要考慮。
個體工商戶的現實選擇
先澄清一個容易被誤解的點:在國內主流雲廠商的實名體系裏,持有營業執照的個體工商戶通常可以走“企業認證”通道,只是部分高敏感接口還會疊加額外的資質審覈。所以“個體工商戶不是企業”並不完全成立,建議先聯繫阿里雲或騰訊雲客服確認具體接口的開通條件。
如果確認無法開通,那就需要換一個思路:不把所有壓力壓在“識別出是誰”這一步,而是通過多層攔截讓公衆人物肖像根本進不了生成鏈路。審覈人員看重的是攔截效果和機制完整性,而不是你用了哪家的公衆人物識別 API。
公衆人物識別 4 層技術攔截架構
下面這套架構的設計原則是“前置攔截、逐層收緊”。越靠前的層越便宜、越快,越靠後的層越精準、越貴,大部分風險請求在前兩層就會被攔下。
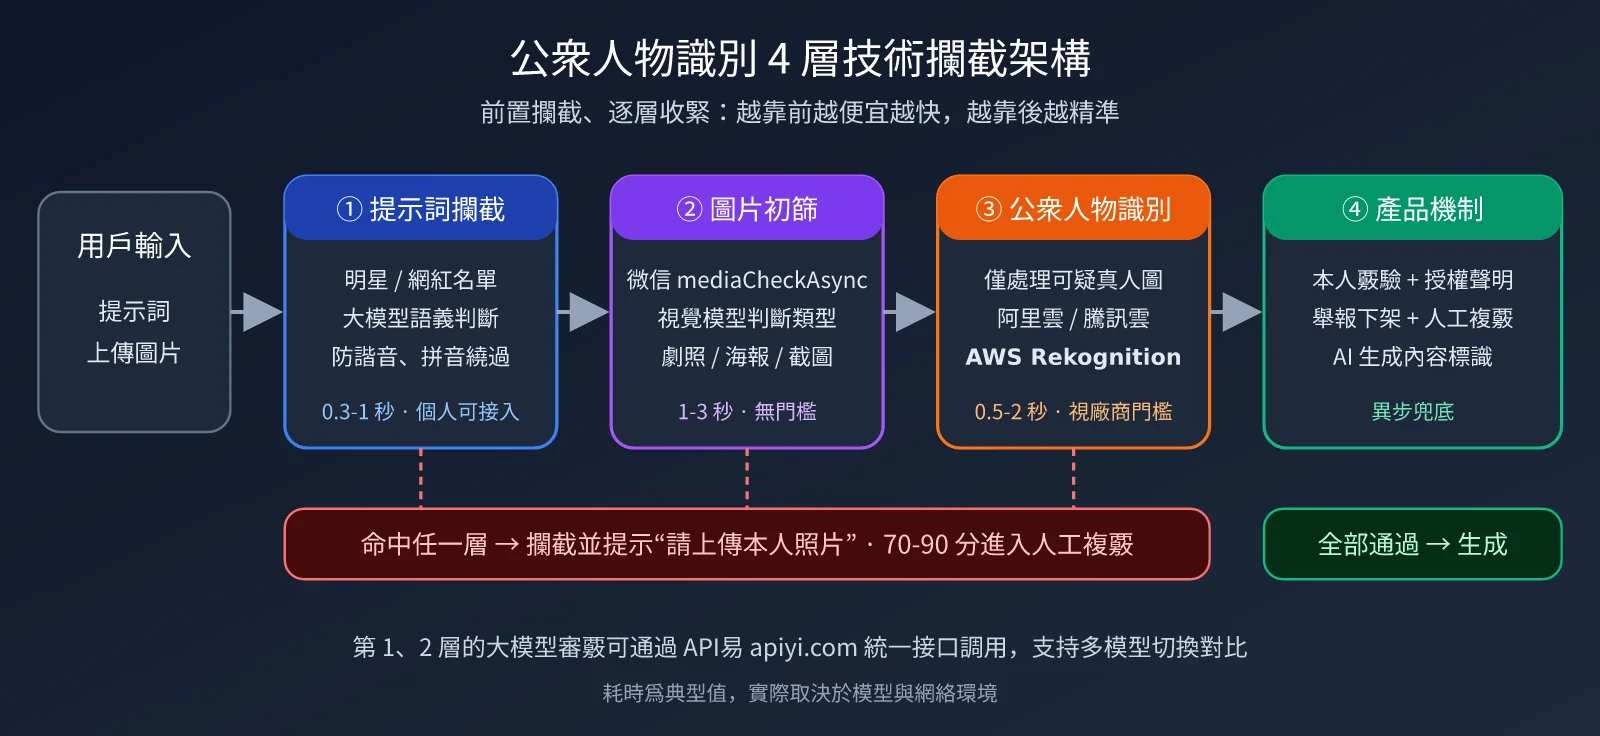
4 層攔截的職責劃分
| 層級 | 攔截對象 | 實現方式 | 典型耗時 | 門檻 |
|---|---|---|---|---|
| 第 1 層 提示詞攔截 | “生成某明星寫真”“換成某網紅的臉” | 關鍵詞名單 + 大模型語義判斷 | 0.3-1 秒 | 無,個人可接入 |
| 第 2 層 圖片初篩 | 劇照、海報、雜誌封面、直播截圖 | 微信 mediaCheckAsync + 視覺大模型判斷圖片類型 | 1-3 秒 | 無 |
| 第 3 層 公衆人物識別 API | 已知公衆人物的真實照片 | 阿里雲 / 騰訊雲 / AWS Rekognition | 0.5-2 秒 | 視廠商而定 |
| 第 4 層 產品機制 | 漏網內容與爭議內容 | 授權聲明、舉報下架、人工複覈、AI 標識 | 異步 | 無 |
第 1 層是性價比最高的一層。對於 AI 生成類小程序,大量侵權請求都來自提示詞,例如直接輸入明星名字或“像某某一樣的臉”。僅靠關鍵詞名單很容易被諧音、拼音、縮寫繞過,用大模型做語義判斷能顯著提高召回率。
第 2 層的思路是“不識別是誰,只識別是什麼”。視覺大模型通常會拒絕說出照片中真人的身份,OpenAI 也明確限制了 GPT-4o 識別真實人物的能力,但判斷一張圖是不是“影視劇照、明星海報、雜誌封面、帶臺標的直播截圖”完全在它的能力範圍內。這類圖片本身就是高風險信號,可以直接攔截或轉入第 3 層。
第 1 層:提示詞語義攔截代碼示例
下面是一個極簡示例,用大模型判斷提示詞是否涉及真實公衆人物。模型返回結構化 JSON,後端據此決定放行或攔截。
import json
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")  # API易 統一接口

def check_prompt(prompt: str) -> dict:
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        response_format={"type": "json_object"},
        messages=[
            {"role": "system", "content": "判斷用戶提示詞是否要求生成、模仿或替換真實公衆人物(明星、網紅、主播、政治人物、運動員)的肖像。"
             "只輸出 JSON:{\"risk\": true/false, \"names\": [], \"reason\": \"\"}"},
            {"role": "user", "content": prompt},
        ],
    )
    return json.loads(resp.choices[0].message.content)

print(check_prompt("幫我生成一張和那個唱《青花瓷》的歌手同款的寫真"))
這個示例裏,提示詞沒有直接出現人名,關鍵詞名單無法命中,但大模型能通過語義推斷出指向具體歌手,從而判定爲高風險。
📦 展開查看完整版:提示詞 + 圖片雙層攔截
import base64, json
import boto3
from openai import OpenAI

llm = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")  # API易 統一接口
rek = boto3.client("rekognition", region_name="ap-southeast-1")

BLOCK_NAMES = {"示例明星A", "示例網紅B"}  # 本地名單,命中直接攔截

def llm_json(messages):
    resp = llm.chat.completions.create(
        model="gpt-4o-mini",
        response_format={"type": "json_object"},
        messages=messages,
    )
    return json.loads(resp.choices[0].message.content)

def layer1_prompt(prompt: str) -> bool:
    if any(n in prompt for n in BLOCK_NAMES):
        return True
    r = llm_json([
        {"role": "system", "content": "判斷提示詞是否涉及真實公衆人物肖像,只輸出 JSON:{\"risk\": bool}"},
        {"role": "user", "content": prompt},
    ])
    return r.get("risk", False)

def layer2_image(img_bytes: bytes) -> str:
    """不識別身份,只判斷圖片類型,返回 block / suspect / pass"""
    b64 = base64.b64encode(img_bytes).decode()
    r = llm_json([
        {"role": "system", "content": "不要識別人物身份。只判斷圖片類型,輸出 JSON:"
         "{\"type\": \"selfie|film_still|poster|magazine|live_screenshot|non_human|other\", \"real_person\": bool}"},
        {"role": "user", "content": [
            {"type": "image_url", "image_url": {"url": f"data:image/jpeg;base64,{b64}"}},
        ]},
    ])
    if r.get("type") in {"film_still", "poster", "magazine", "live_screenshot"}:
        return "block"
    return "suspect" if r.get("real_person") else "pass"

def layer3_celebrity(img_bytes: bytes, threshold: float = 90.0) -> bool:
    res = rek.recognize_celebrities(Image={"Bytes": img_bytes})
    return any(c["MatchConfidence"] >= threshold for c in res["CelebrityFaces"])

def moderate(prompt: str, img_bytes: bytes | None) -> str:
    if layer1_prompt(prompt):
        return "blocked: prompt"
    if img_bytes:
        verdict = layer2_image(img_bytes)
        if verdict == "block":
            return "blocked: image_type"
        if verdict == "suspect" and layer3_celebrity(img_bytes):
            return "blocked: public_figure"
    return "pass"
完整版中,第 3 層只對第 2 層判定爲“真人照片”的圖片調用,既節省公衆人物識別 API 的費用,也減少了需要外發的人臉數據量。如果你已經開通了阿里雲或騰訊雲的接口,只需要把 layer3_celebrity 替換爲對應 SDK 調用即可。
🚀 快速開始:第 1 層和第 2 層都依賴大模型,建議先用 API易 apiyi.com 獲取測試額度,拿 100 條真實用戶提示詞和圖片跑一遍,統計攔截率和誤殺率後再上線。同一套代碼可以切換 GPT、Gemini、Claude 等多種模型對比效果。
公衆人物識別結果的閾值與處置策略
識別結果不是簡單的“是”或“否”,置信度閾值直接決定誤殺率和漏放率。Hive 官方文檔給出的參考是:真實照片建議閾值 0.85,AI 生成內容建議 0.9。AWS Rekognition 返回的 MatchConfidence 爲 0-100 區間,可以按同樣思路設置。
| 置信度區間 | 處置動作 | 用戶提示 | 說明 |
|---|---|---|---|
| ≥ 90 | 直接攔截 | “圖片疑似包含公衆人物肖像,請上傳本人照片” | 高置信命中,誤殺概率低 |
| 70-90 | 攔截並進入人工複覈隊列 | “圖片審覈中,請稍候” | 撞臉、角度遮擋常落在此區間 |
| 檢測到人臉但未匹配 | 放行,保留日誌 | 無 | 普通用戶的正常照片 |
| 未檢測到人臉 | 放行 | 無 | 風景、寵物、物品等 |
對 AI 寫真類產品,更穩妥的做法是疊加“本人覈驗”:要求用戶先上傳一張自拍作爲基準,後續上傳的照片必須與基準人臉相似度達標才允許生成。這樣即使公衆人物識別 API 覆蓋不到某位小衆網紅,也能從機制上杜絕“用別人的臉”。
💡 選擇建議:如果你的業務以國內網紅、主播爲主要風險來源,任何海外公衆人物識別 API 的覆蓋都不夠,應把重心放在第 1 層提示詞攔截和“本人覈驗”機制上。第 1 層的大模型調用可以通過 API易 apiyi.com 接入,成本通常只有圖片識別的幾分之一。
提交審覈時如何描述公衆人物攔截方案
技術做好了,還要讓審覈人員看得懂。建議在審覈備註或補充材料中按以下結構說明:
- 攔截鏈路:說明提示詞、圖片上傳、生成結果三個環節分別接入了哪些檢測能力。
- 公衆人物識別能力:寫清使用的公衆人物識別 API 或替代方案,以及命中後的處置動作。
- 產品機制:用戶協議中的肖像授權條款、上傳前的“僅限本人照片”確認彈窗、舉報入口和下架時效。
- AI 內容標識:生成圖片添加“AI 生成”顯式標識,並在文件元數據中寫入隱式標識。
- 測試證據:附上用明星照片、明星名字提示詞測試被攔截的截圖或錄屏。
其中第 5 點最有說服力。審覈人員往往會直接用明星照片測試,如果你的錄屏能展示“上傳明星劇照 → 被攔截”“輸入明星名字 → 被攔截”,通過率會明顯提升。
公衆人物識別 API 常見問題
Q1:只用大模型能完全替代公衆人物識別 API 嗎?
不能完全替代。主流視覺大模型出於隱私政策通常會拒絕說出照片中真人的身份,而且即使能識別也不穩定,不適合做確定性的身份判斷。大模型最適合做提示詞語義攔截和圖片類型判斷,身份識別仍建議交給專門的公衆人物識別 API。可以通過 API易 apiyi.com 用同一批樣本測試不同模型的攔截效果,再決定分工。
Q2:AWS Rekognition 能識別國內明星嗎?
能識別部分知名度較高的華語影視明星和體育明星,但對國內網紅、主播、短視頻達人的覆蓋明顯不足。另外它是境外服務,處理人臉這類敏感個人信息需要評估數據出境合規,建議只對第 2 層篩出的可疑圖片調用,並在隱私政策中如實告知。
Q3:個體工商戶一定無法開通阿里雲明星識別嗎?
不一定。個體工商戶持營業執照通常可以完成雲廠商的企業認證,但部分接口會追加資質審覈。建議直接提交工單詢問具體接口的開通條件,同時準備騰訊雲作爲備選。
Q4:提示詞攔截的大模型調用成本高嗎?
很低。一次提示詞審覈通常只消耗幾百個 token,使用輕量模型時單次成本遠低於一次圖片識別。通過 API易 apiyi.com 調用還可以按量計費,適合審覈量波動較大的小程序。
Q5:攔截做了還是被駁回怎麼辦?
先確認駁回原因是否還有“存量內容”問題,例如小程序內的示例圖、模板圖是否本身就使用了明星照片。很多開發者技術攔截做完了,卻因爲首頁的示例效果圖用了明星形象而再次被駁回,這部分需要全部替換爲自有版權或 AI 生成的虛擬人像。
總結
小程序因公衆人物肖像侵權被要求“增加技術攔截”,核心不是找到一個萬能的公衆人物識別 API,而是建立一條完整的攔截鏈路。微信內容安全接口只覆蓋通用違規,識別不了明星網紅;阿里雲、騰訊雲的公衆人物識別能力最貼合國內場景,但需要企業認證;AWS Rekognition 門檻最低但對國內網紅覆蓋有限,並且涉及數據出境;Azure 和 Google 則基本不對普通開發者開放。
對個體工商戶來說,最務實的路徑是:先確認能否用營業執照完成雲廠商企業認證,同時立刻上線提示詞語義攔截和圖片類型初篩這兩層,再疊加本人覈驗、授權聲明和人工複覈機制,最後用測試錄屏向審覈人員證明攔截有效。
推薦通過 API易 apiyi.com 快速搭建第 1 層和第 2 層的大模型審覈能力,用真實樣本驗證攔截率後再提交審覈。
作者:APIYI Team,專注 AI 大模型 API 應用落地,更多技術方案與測試額度可訪問 API易 apiyi.com 獲取。