Примечание автора: если hit rate кэша промптов Claude внезапно упал до 0 или счёт никак не снижается — diagnostics за три шага покажет, где именно разошёлся префикс, а usage подскажет, действительно ли кэш сработал. Здесь же расскажу, как проверить это самому при работе через прокси APIYI. (Если у вас такая проблема — дочитайте и отправьте статью своему агенту, пусть разбирается.)
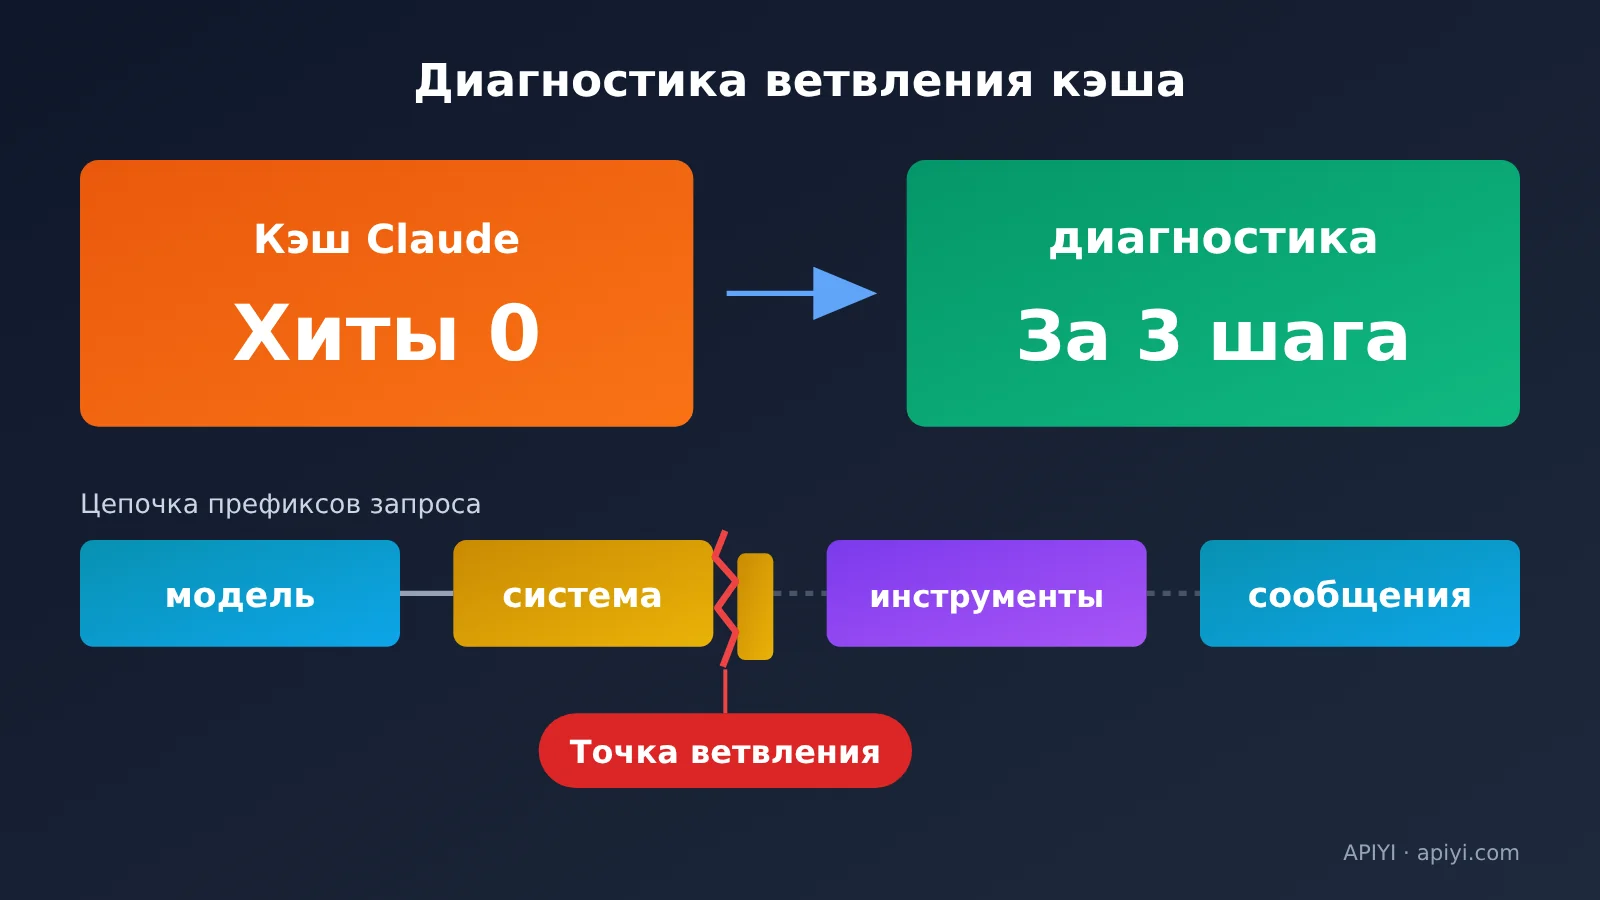
Промах кэша — не магия, API сам скажет, с какого места префикс пошёл вразнос. Достаточно передать обратно id ответа из предыдущего раунда — и вы увидите, где случилось первое расхождение: в model, system, tools или messages.
Это не разбор очередного релиза. Статья для разработчиков, которые уже используют кэширование промптов Claude, но внезапно получили нулевой hit rate или не могут сбить счёт. Каждый шаг диагностики расписан так, чтобы было понятно, что именно вы увидите на этом шаге.
Главное: после прочтения вы сможете найти причину промаха кэша за три запроса. Ещё разберётесь, что показывают diagnostics, а что — usage, и какие два поля сверять между собой при работе через прокси.
Ключевые моменты диагностики кэша Claude (diagnostics)
Сначала в двух словах, что это такое: вы передаёте id ответа из предыдущего раунда, и API сравнивает два запроса, указывая, где именно произошло первое расхождение — в model, system, tools или messages. Раньше, когда кэш тихо переставал работать, вы видели только, что usage.cache_read_input_tokens стал равен 0, и не понимали, какая именно часть запроса изменилась.
| Пункт | Что это | Зачем вам |
|---|---|---|
| Переключатель | Отпечаток сохраняется, только если в корне тела запроса есть объект diagnostics |
Не нужно менять бизнес-логику — достаточно добавить одно поле |
| Способ сравнения | В previous_message_id передаётся id ответа предыдущего раунда |
Сразу показывает первый разошедшийся сегмент |
| Поле с выводом | cache_miss_reason возвращает один из шести типов |
Для каждого типа понятно, что именно исправлять |
| Совместно с метрикой | Смотреть вместе с usage.cache_read_input_tokens |
Чтобы не спутать «расхождений нет» с «ничего не сработало» |
| Где доступно | Только в официальном Claude API | Через другие каналы придётся проверять по usage самостоятельно |
Хронология диагностики кэша Claude
Функция вышла в мае 2026 года в бете — тогда требовался заголовок anthropic-beta: cache-diagnosis-2026-04-07. В сентябре правила один раз ужесточили: отпечаток сохраняется только для запросов, где явно передан объект diagnostics; запросы только с заголовком не записываются.
23 сентября функция стала общедоступной: cache-diagnosis-2026-04-07 больше не нужен, а запросы со старым заголовком продолжают работать. Теперь в ответе POST /v1/messages поле diagnostics присутствует всегда, а если диагностика не включена, его значение — null. Так что null в этом поле вовсе не означает, что с интерфейсом что-то не так.
В отпечатке хранятся только хеши и оценка числа токенов — исходный текст промпта не сохраняется. Индексируется он по response id, область действия ограничена текущей организацией и текущим workspace, срок хранения небольшой.
3 шага диагностики кэш-хитов Claude через diagnostics
Ниже — три шага, расписанные по официальному описанию полей. Если вы вызываете модель через APIYI, то для нативного интерфейса Messages в base_url указывайте https://api.apiyi.com/v1, а путь запроса — /v1/messages. Но имейте в виду: в разделе с реальными тестами ниже будет показано, как diagnostics на самом деле отвечает в сценарии с прокси-сервисом.
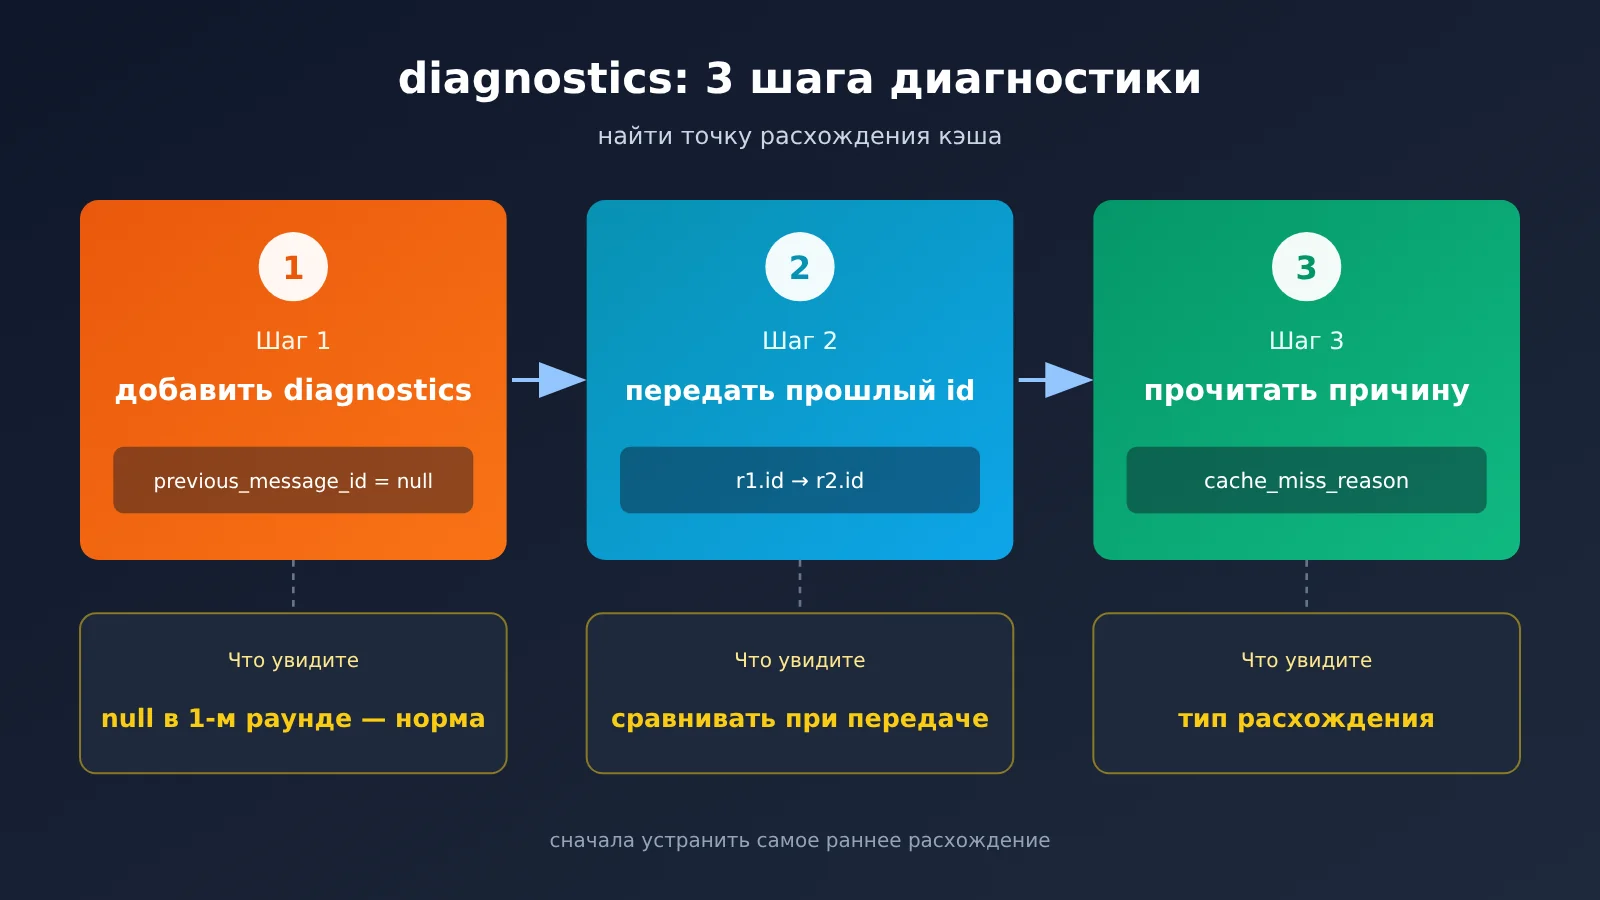
Шаг 1. Добавляем объект diagnostics на верхний уровень запроса
diagnostics — это единственный переключатель: запрос без него не сохраняет отпечаток, и сравнивать потом будет нечего. В первом раунде сравнивать не с чем, поэтому в previous_message_id передаём null — это значит «начинаем запись с этого раунда».
- В заголовках оставляем обычную версию:
anthropic-version: 2023-06-01 - После выхода из беты больше не нужно передавать:
anthropic-beta: cache-diagnosis-2026-04-07 - На верхнем уровне тела запроса добавляем:
"diagnostics": {"previous_message_id": null} - В блоке system, который нужно кэшировать, как обычно ставим точку кэширования:
"cache_control": {"type": "ephemeral"} - Что увидите: в ответе
diagnosticsравенnull,cache_read_input_tokensобычно 0, аcache_creation_input_tokensбольше 0
null в первом раунде — это не провал. В этом раунде идёт запись кэша, сравнивать просто не с чем, так что искать проблему здесь не нужно.
Шаг 2: в каждом следующем раунде передавайте id ответа предыдущего раунда
Начиная со второго раунда, подставляйте id ответа предыдущего раунда в previous_message_id. Самая частая ошибка — указать diagnostics только в первом раунде, а дальше про него забыть. Тогда запрос, на который ссылается следующий раунд, окажется незаписанным, и в ответ придёт previous_message_not_found.
- Тело запроса второго раунда:
"diagnostics": {"previous_message_id": "<id ответа первого раунда>"} - Тело запроса третьего раунда:
"diagnostics": {"previous_message_id": "<id ответа второго раунда>"} - Правило для цикла: в первом раунде передаём
null, во втором —r1.id, в третьем —r2.idи так далее - При потоковом вызове результат появляется в событии
message_start, а id точно так же передаётся из раунда в раунд - Что вы увидите: если интервал между соседними раундами достаточно короткий и оба идут в одном workspace, в ответе начнут появляться результаты сравнения
Шаг 3: читаем cache_miss_reason и исправляем по таблице соответствия
У diagnostics есть три варианта значения — прежде чем читать, разберитесь, какой из них перед вами:
null: в запросе не былоdiagnostics; либоprevious_message_idравенnull; либо сравнение уже завершено и расхождений не найдено{"cache_miss_reason": null}: сравнение ещё идёт — ответ стартовал слишком быстро, поэтому в этом раунде вывода нет, смотрите следующийcache_miss_reason— это объект: вывод уже есть, внутри лежат тип ветвления и детали- Что вы увидите: получив тип, правьте по таблице из следующего раздела, сначала самое раннее расхождение, потому что показывается только первая точка ветвления, а проблемы дальше могут быть ею заслонены
🚀 Быстрый старт: если хочется сначала убедиться, что ваш префикс кеша вообще записывается и попадает в кеш, можно в APIYI apiyi.com с одним и тем же ключом переключиться между разными моделями Claude и прогнать два раунда для сравнения — главное посмотреть, сходятся ли в
usageдва числа: запись в кеш и чтение из кеша.
Шесть типов cache_miss_reason и где их исправлять
Получив cache_miss_reason, найдите в таблице ниже, что именно нужно править:
| Тип | Что означает | Что менять |
|---|---|---|
model_changed |
Модель отличается от предыдущего хода — например, её подменили маршрутизация, A/B-тест или fallback. Кеш изолирован по модели | Зафиксировать одну модель на всё время жизни кешируемого диалога |
system_changed |
Изменился system. Чаще всего туда вставляют метку времени, ID запроса и прочие значения, которые каждый раз разные | Сделать system байт-в-байт стабильной константой, а динамические данные перенести в первое user-сообщение после точки разрыва |
tools_changed |
Инструменты добавили, удалили, поменяли их порядок, либо сериализация input_schema нестабильна |
Отправлять каждый ход один и тот же список инструментов в фиксированном порядке, а при сериализации сортировать ключи |
messages_changed |
Изменились, переупорядочились или удалились более ранние сообщения вместо добавления в конец | Только дописывать историю в конец; содержимое assistant и результаты инструментов возвращать как есть |
previous_message_not_found |
Не найден соответствующий отпечаток, это не значит, что запрос изменился | Передавать diagnostics каждый ход, не выходить за пределы workspace и не делать слишком больших пауз |
unavailable |
В этом ходе диагностику получить не удалось: например, разошлись наборы tool_choice, thinking, context_management, output_config, output_format или beta header, либо диалог оказался слишком длинным |
Держать эти параметры неизменными на всём протяжении жизни одного кешируемого диалога |
У четырёх типов *_changed дополнительно приходит cache_missed_input_tokens — сколько примерно кешируемых входных токенов потеряно после точки расхождения. Число считается по длине в байтах, по нему можно судить только о порядке величины, это не сумма в счёте, и иногда оно бывает даже больше usage.input_tokens.
Если смотреть только на diagnostics, можно ошибиться: как оценивать попадание в кэш Claude по usage
diagnostics отвечает на вопрос «изменился ли мой запрос», а usage.cache_read_input_tokens — «было ли попадание в кэш». Это разные вопросы, и если смотреть только на один из них, легко прийти к неверному выводу.
| Результат diagnostics | Прочитано токенов из кэша | Вывод | Что делать |
|---|---|---|---|
null |
Высокое | Префикс стабилен, кэш сработал | Ничего делать не нужно |
null |
Низкое или 0 | Запрос не изменился, но кэш уже истёк | Сократите интервал между запросами или перейдите на TTL 1 час |
*_changed |
Низкое | Запрос изменился, поэтому кэш не сработал | Исправьте по таблице из предыдущего раздела |
*_changed |
Высокое | Изменение произошло ближе к концу, ранние контрольные точки кэша всё ещё попадают | Исправить стоит, но влияние небольшое |
Подчеркну ещё раз: null не значит, что ничего не работает — это может быть как раз лучший результат. Есть несколько случаев, когда эта таблица не применяется: первый раунд, cache_miss_reason равен null (сравнение ещё идёт), а также previous_message_not_found и unavailable. В этих ситуациях валидного сравнения вообще нет.
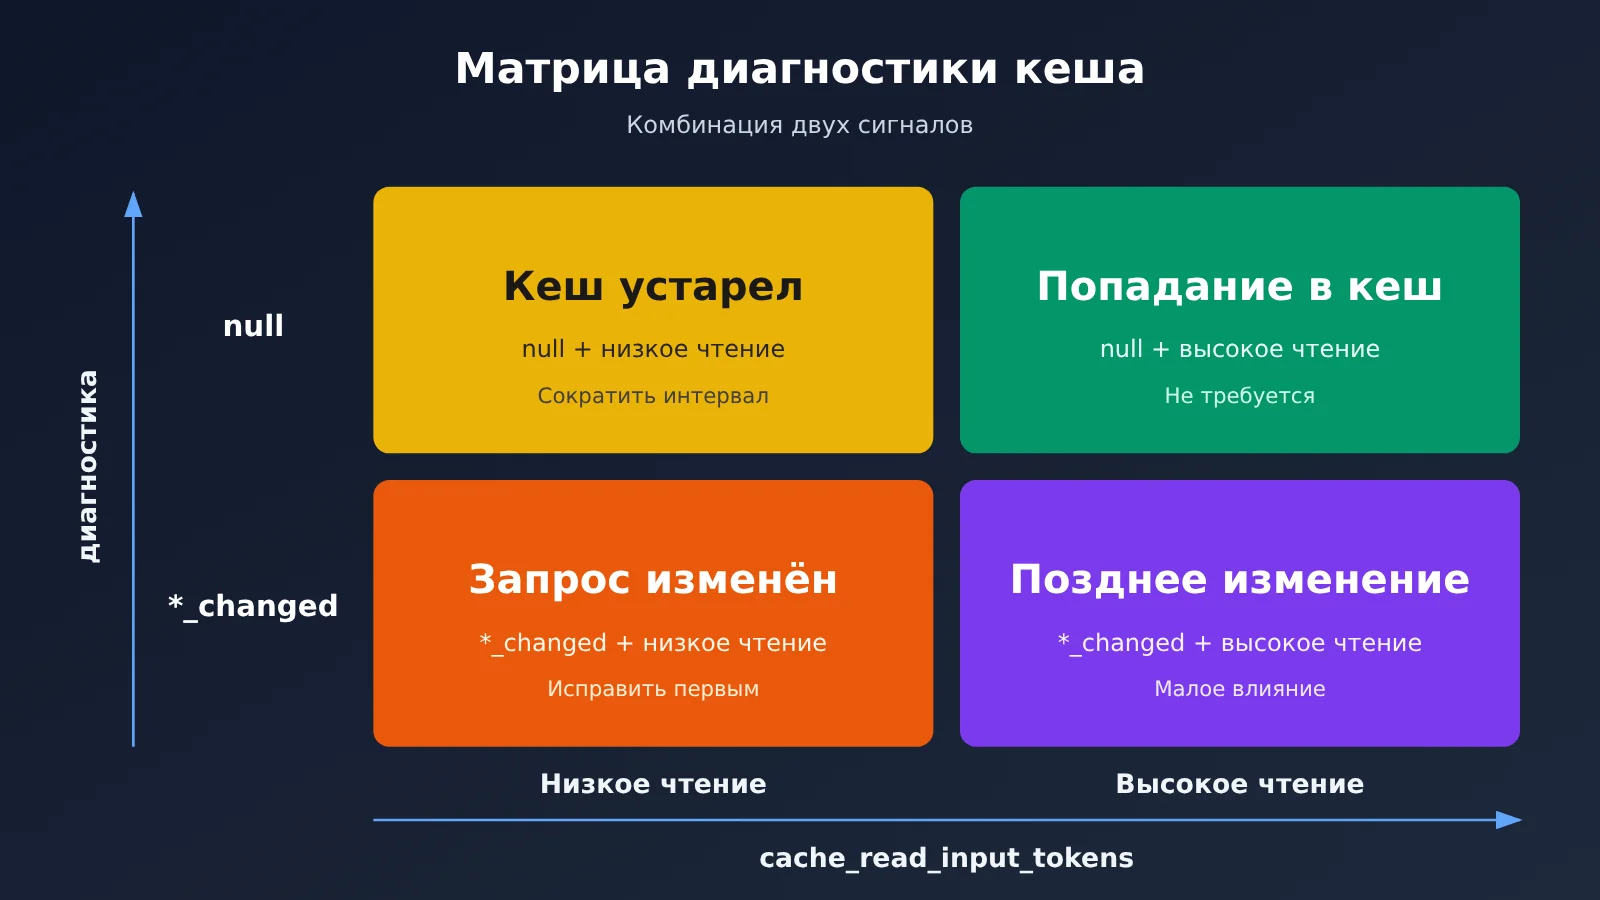
Если вы ещё не поняли, какой раунд попадает в какую ячейку, отправьте один и тот же запрос два раза подряд на APIYI apiyi.com, запишите цифры чтения и записи кэша для каждого раунда, а затем последовательно исключайте варианты по матрице выше.
Частые причины низкого процента попаданий в кэш Claude: три жёстких условия
Очень часто низкий процент попаданий объясняется вовсе не тем, что запрос изменился, а тем, что кэш изначально не записался. Если не выполнено хотя бы одно из трёх условий ниже, кэш просто не сработает:
- Нужно явно указать
cache_control: его можно поставить на конкретный блок контента, чтобы задать явную контрольную точку, либо разместитьcache_controlна верхнем уровне запроса — тогда система сама поставит точку на последнем кэшируемом блоке. Если content — это просто строка без блоков, к которым можно прицепить маркер, кэширования не будет никогда. - Длина должна достигать минимальной кэшируемой длины: в Claude API для Sonnet 5.5 и Opus 5.5 это 512 токенов. Если префикс короче, кэш молча игнорируется — и ошибки при этом тоже не будет.
- Префикс должен совпадать побайтово: история только дописывается, system и tools остаются неизменными. Стоит измениться хоть чему-то — пробелу, порядку полей JSON, метке времени — и это уже считается новым префиксом.
В документации APIYI по кэшированию указаны ещё два жёстких ограничения: в одном запросе не может быть больше 4 контрольных точек cache_control, и каждая точка откатывается назад не дальше чем на 20 последних content block. В длинном многоходовом диалоге, если поставить маркер только на последнее сообщение, он не покроет всю историю.
TTL тоже часто упускают из виду. По умолчанию это 5 минут, и каждое попадание продлевает срок, но отсчёт идёт от запроса, в котором кэш был записан или прочитан, а не от момента окончания ответа. Если потоковый ответ генерировался 4 минуты, следующий запрос нужно отправить примерно в течение минуты. Если нужен более длинный интервал, укажите в cache_control значение "ttl": "1h".
Сколько стоит падение доли кэш-попаданий Claude до нуля
Сначала цены — в долларах США за миллион токенов. Данные на 25.10.2026; актуальные значения смотрите в консоли:
| Модель | Вход | Выход | Чтение кэша | Запись 5 мин | Запись 1 ч |
|---|---|---|---|---|---|
| Claude Sonnet 5.5 | $2 | $10 | $0.10 | $2.50 | $4 |
| Claude Opus 5.5 | $4 | $20 | $0.20 | $5 | $8 |
| Claude Haiku 5.5 (до 100 тыс. токенов) | $0.1 | $0.5 | $0.01 | $0.125 | $0.20 |
| Claude Haiku 5.5 (свыше 100 тыс. токенов) | $0.50 | $2.50 | $0.05 | $0.625 | $1 |
Множители нужно смотреть отдельно. В руководстве APIYI по кэшированию общая формула такая: попадание — 0,1×, запись на 5 минут — 1,25×, запись на 1 час — 2×. У Sonnet 5.5 после официального обновления 7 октября чтение кэша подешевело с $0.20 до $0.10 и стало 0,05× от базовой цены входа; цена записи не изменилась.
Это не общее снижение цен для всех моделей: у Sonnet 5 чтение кэша по-прежнему $0.20. Поэтому не считайте Sonnet 5.5 по 0,1×; конкретную модель и цену сверяйте со списком моделей на платформе.
Точку окупаемости считаем по общему правилу платформы — 0,1×: при TTL 5 минут кэш окупается уже на втором обращении (1,25 + 0,1 = 1,35 против 2,0 без кэша); при TTL 1 час — на третьем (2 + 0,2 = 2,2 против 3,0).
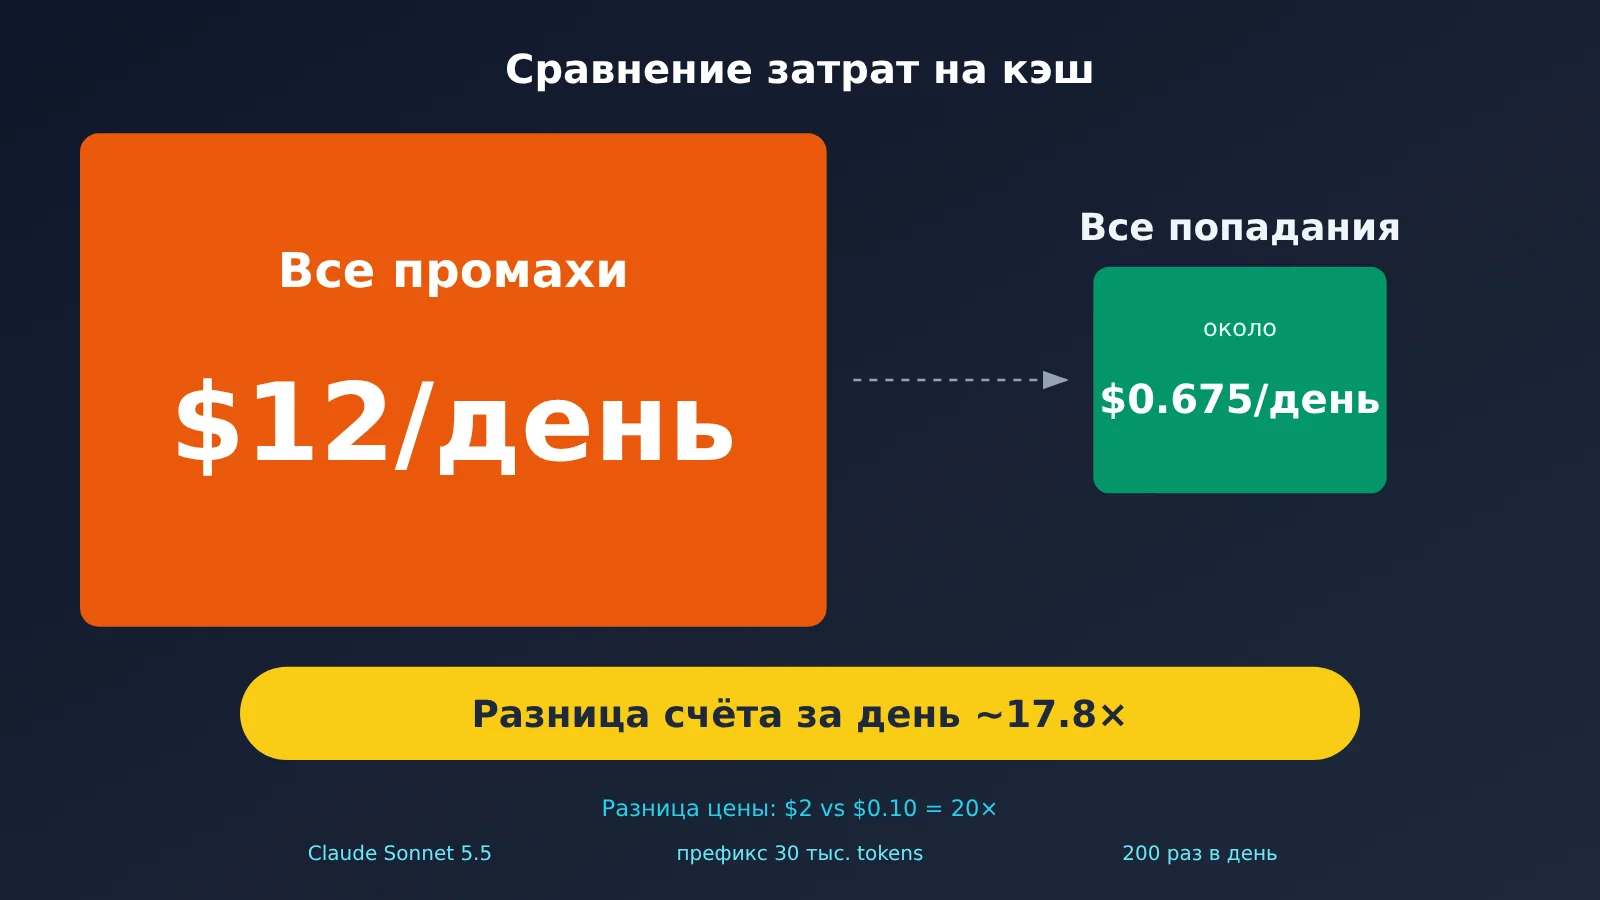
Ещё один расчёт. Sonnet 5.5, фиксированный префикс 30 000 токенов, 200 запросов в день, все укладываются в TTL 5 минут:
- Все запросы попадают в кэш: 200 × 30 000 × $0.10/млн = $0.60, плюс одна запись $0.075, итого около $0.675/день
- Все промахи: 200 × 30 000 × $2/млн = $12/день
Счёт за день отличается примерно в 17,8 раза — и это не разница в цене за токен. Цена за токен: $2 против $0.10, разница в 20 раз. Если перейти на TTL 1 час, одна запись будет стоить $0.12, а цена попадания не изменится. Когда интервалы между запросами часто превышают 5 минут, сравните: что ниже — доплата за такую запись или стоимость повторного пересоздания префикса.
Как проверить долю попаданий в кэш Claude при работе через APIYI
Сначала о результатах. 26.10.2026 мы провели замер на APIYI: прогнали два раунда на Claude Sonnet 5.5 — в первом раунде запись в кэш 2523, чтение 0; во втором, после отправки того же запроса без изменений, чтение из кэша 2523, запись 0. Количество токенов сходится полностью. Claude Opus 5.5 с длинным префиксом тоже пишет в кэш и тоже попадает.
Но поля diagnostics в ответе нет. Ни в нестриминговом вызове, ни в message_start при стриминге. Мы отправили запрос ещё раз с beta-заголовком и специально изменили system, чтобы вызвать реальный промах (чтение 0, запись 2526) — поля в ответе всё равно не было. Все запросы вернули 200, ошибок нет. Верхний канал на уровне прокси — не обязательно официальный Claude API, поэтому в схеме с прокси приходится в основном сравнивать два поля из usage между собой.
| Что видно при самопроверке | Что это значит |
|---|---|
cache_read_input_tokens этого раунда в точности равен cache_creation_input_tokens предыдущего |
Префикс попал в кэш целиком |
| Чтение в этом раунде заметно меньше записи в предыдущем | Попал только более ранний участок, что-то в середине изменилось |
| Запись всегда 0 | Маркер не поставлен, длина недостаточная или используется формат, совместимый с OpenAI |
| Во втором раунде снова идёт запись, а чтение 0 | Префикс изменился — проверьте метки времени, UUID и порядок сериализации |
Отдельно обратите внимание: кэш работает только в нативном /v1/messages. Если вызывать Claude через формат, совместимый с OpenAI, /v1/chat/completions, то кэш не будет тарифицироваться ни при каких параметрах.
💡 Совет по диагностике: APIYI (apiyi.com) передаёт
cache_controlнаверх без изменений и так же без изменений возвращает оба поля кэша в ответе — код не нужно дополнительно адаптировать под прокси. Достаточно завести лог-алерт на правило «чтение в этом раунде = запись в предыдущем», и он заменит большую часть ручной диагностики.
Ограничения диагностики кэша Claude (diagnostics)
diagnostics не решает все проблемы — прежде чем пользоваться, разберитесь с её границами:
- Доступна только в официальном Claude API; у Claude, размещённого на Amazon Bedrock и Google Cloud, её нет
- Отпечатки хранятся недолго, поэтому запросы нужно отправлять несколько раундов подряд с короткими интервалами
- Оба запроса должны относиться к одной организации и одному workspace — это можно сверить по заголовку ответа
anthropic-workspace-id - В длинных диалогах, если изменение спрятано глубоко в списке сообщений, может вернуться только
unavailable - Это механизм best-effort: если результат не получен, запрос не блокируется и не завершается ошибкой
Частые вопросы (FAQ)
Q1: Почему diagnostics всегда null?
Три варианта: объект `diagnostics` не передан; сейчас первый раунд и `previous_message_id` равен `null`; сравнение завершено и расхождений нет. Судить стоит вместе с показателями кэша: высокие значения чтения — всё в порядке, нулевое чтение — скорее всего, кэш истёк. Если работаете через прокси, поле может вообще не возвращаться — тогда проверяйте по usage.
Q2: previous_message_not_found означает, что запрос изменился?
Нет. Это лишь значит, что не найден соответствующий отпечаток. Типичные причины три: в прошлом раунде не было `diagnostics`; прошлый раунд шёл из другого workspace; или интервал оказался слишком большим. Передавайте `diagnostics` в каждом раунде и сократите интервал — и всё заработает.
Q3: Диагностика оплачивается отдельно?
В официальной документации «плата за диагностику» не выделена отдельной строкой — она тарифицируется вместе с обычными запросами Messages. Явного указания, что наценки нет, в документации тоже нет, так что ориентируйтесь на счёт и консоль.
Q4: Можно ли пользоваться этой диагностикой через прокси?
В наших тестах в APIYI поле `diagnostics` не возвращалось, но запись в кэш и попадания работали нормально. Тогда можно судить по правилу «чтение в этом раунде точно равно записи в прошлом раунде». Как подключаться — смотрите в документации по тарификации кэша на APIYI apiyi.com.
Q5: Указал cache_control, но в кэш ни разу не записалось — почему?
Проверьте три момента: является ли `content` обычной строкой; достигает ли префикс 512 tokens (для Sonnet 5.5 и Opus 5.5); не используется ли формат, совместимый с OpenAI. Если хотя бы одно условие не выполнено, кэш молча пропускается.
Q6: Проблем несколько сразу — что чинить первым?
Сначала то, что показывает `cache_miss_reason`. Он сообщает только о самой ранней точке расхождения; исправьте её и прогоните ещё один раунд — тогда проявятся проблемы, которые были замаскированы. Если на APIYI apiyi.com повторно воспроизводить один и тот же запрос, можно довольно быстро отсеивать их по одной.
Ключевые моменты диагностики кэша Claude
- Что такое diagnostics: передаёте id ответа предыдущего раунда, чтобы найти первый разветвляющийся сегмент префикса
- Как включить:
diagnosticsна верхнем уровне; в первом раунде передаётеnull, затем — обязательно в каждом раунде - Что значит
null: в первом раунде или когда расхождений нет — тожеnull; сам по себе он не является сигналом сбоя - Как делать вывод: смотреть
diagnosticsвместе сcache_read_input_tokens— только так можно прийти к заключению - Жёсткие условия: явная маркировка, достижение 512 tokens, побайтово одинаковый префикс
- Разница в стоимости: префикс на 30 тысяч токенов при 200 вызовах в день — итоговый счёт за день отличается примерно в 17,8 раза
- Самопроверка через прокси: на APIYI apiyi.com смотреть, «равно ли чтение текущего раунда записи предыдущего»
Итог
Диагностику попаданий в кэш Claude можно свести к трём вещам:
- Найти развилку: каждый раунд передавать
diagnostics, читатьcache_miss_reasonи сначала исправлять самое раннее обнаруженное место - Сверять данные: смотреть
diagnosticsи usage одновременно —nullне означает, что всё не работает - Соблюдать жёсткие условия: расставить метки, выйти на нужную длину, историю только дописывать, system и tools держать стабильными
Если в вашей цепочке вызовов diagnostics недоступны, постройте самопроверку по двум полям из usage. Рекомендую сначала на APIYI apiyi.com проверить цифры чтения и записи кэша на двух раундах запросов, а затем выводить в продакшен.
📚 Справочные материалы
- Официальная документация Claude: Cache diagnostics — поля диагностики, шесть типов и матрица решений
- Ссылка:
platform.claude.com -
Пояснение: поля, временная шкала и ограничения diagnostics в этой статье приводятся согласно данному документу
-
Официальная документация Claude: Prompt caching — правила кеширования, TTL, минимальная длина и цены
- Ссылка:
platform.claude.com -
Пояснение: отсюда взяты минимальная кешируемая длина и официальная таблица цен
-
Список моделей APIYI: цены на вход, выход и чтение кеша для моделей Claude
- Ссылка:
docs.apiyi.com/models -
Пояснение: данные о ценах обновлены 2026-10-25
-
Руководство APIYI по биллингу кеширования Claude Prompt Caching: коэффициенты, точка окупаемости и критерии самопроверки
- Ссылка:
docs.apiyi.com/api-capabilities/claude-prompt-caching - Пояснение: основа для диагностики в сценариях с прокси
Автор: техническая команда APIYI
Для связи: пишите нам через главную страницу сайта APIYI — там же можно обсудить технические вопросы; больше материалов ищите в документационном центре docs.apiyi.com