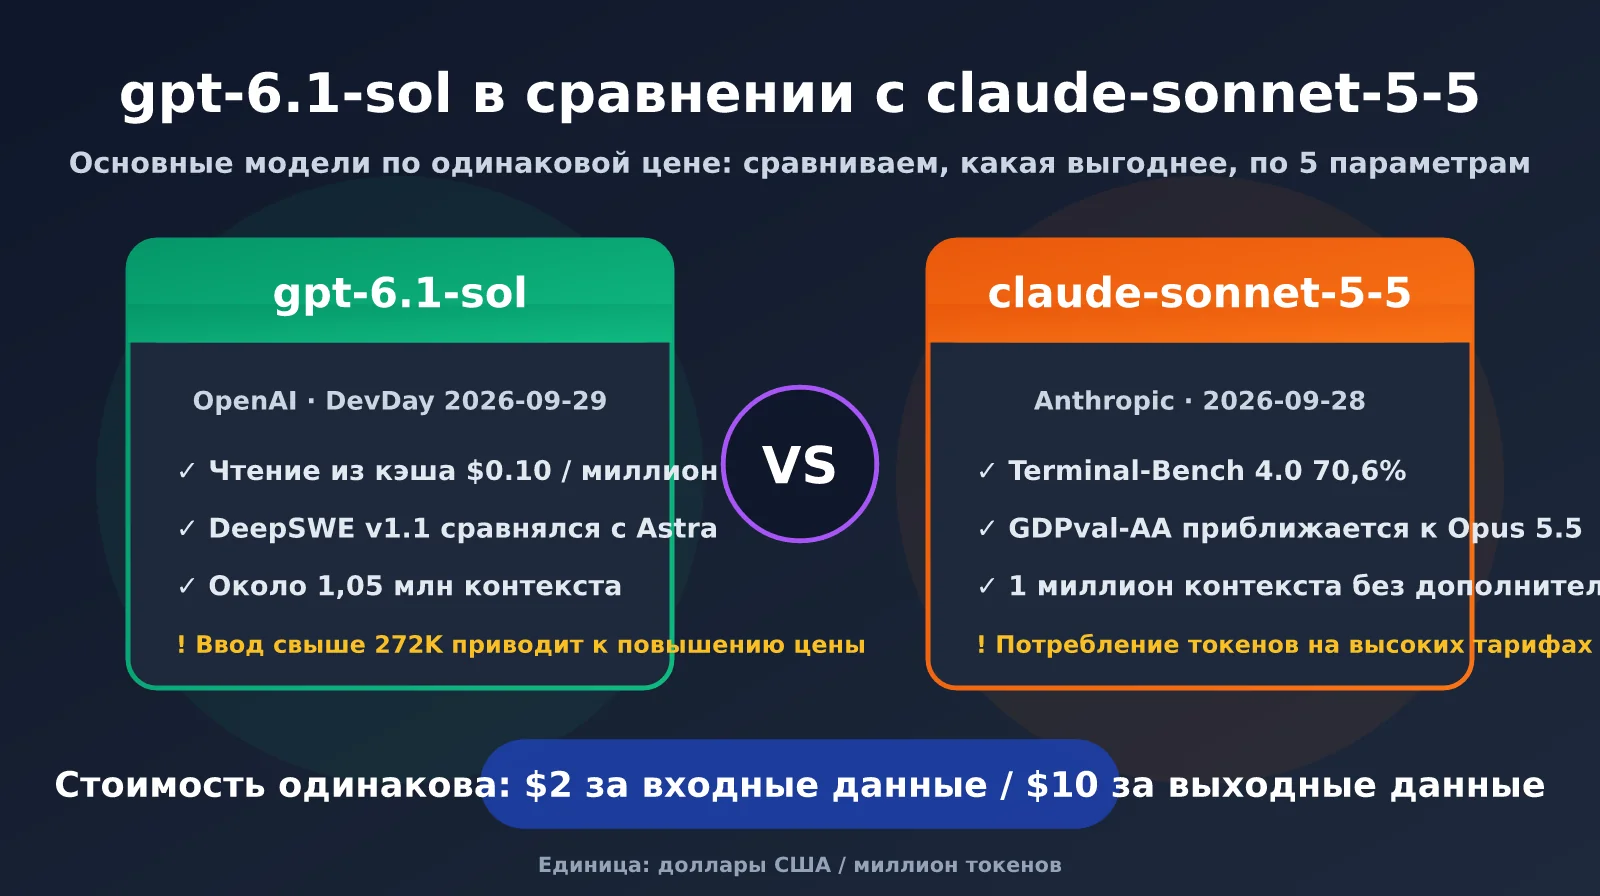
28 сентября Anthropic выпустила claude-sonnet-5-5, а уже на следующий день OpenAI представила gpt-6.1-sol на DevDay. Новые основные модели от обеих компаний вышли практически одновременно — и с абсолютно одинаковым прайсом: $2 за входящие и $10 за исходящие токены на миллион. Первая реакция многих разработчиков: «обе стали дешевле, можно брать любую». Но в реальной эксплуатации разница в стоимости одной задачи, тарификации длинного контекста и работе агентов оказывается куда заметнее, чем следует из прайс-листа. В этой статье разберём по 5 критериям реальные различия между gpt-6.1-sol и claude-sonnet-5-5, чтобы вы могли отбросить предпочтения к бренду и ограничения доступности аккаунтов — и выбирать модель рационально, под конкретный сценарий.
Главная польза: после статьи вы будете чётко понимать, какую модель — gpt-6.1-sol или claude-sonnet-5-5 — выбирать и как их сочетать в сценариях программных агентов, офисных документов, поиска по длинному контексту и высоконагруженной пакетной обработки.
Краткий обзор ключевых параметров gpt-6.1-sol и claude-sonnet-5-5
Для начала уточним распространённое заблуждение: строго говоря, ценники обеих моделей не снизились. claude-sonnet-5-5 сохранила тариф Sonnet 5 — $2/$10, а стоимость gpt-6.1-sol тоже осталась такой же, как у предыдущей gpt-6-sol. Разговоры об «удешевлении» связаны с двумя факторами. Во-первых, возможности флагманского уровня стали доступны в ценовом сегменте основных моделей: gpt-6.1-sol стоит в пять раз дешевле gpt-6-astra, а claude-sonnet-5-5 — вдвое дешевле Opus 5.5. Во-вторых, снижаются скрытые затраты: цена кешированного ввода у gpt-6.1-sol сократилась вдвое, с $0,20 до $0,10, а claude-sonnet-5-5 благодаря меньшему числу вызовов инструментов может уменьшить стоимость одной задачи примерно на 30%.
| Параметр | gpt-6.1-sol | claude-sonnet-5-5 |
|---|---|---|
| Дата выпуска | 29.09.2026 (DevDay) | 28.09.2026 |
| ID модели | gpt-6.1-sol |
claude-sonnet-5-5 |
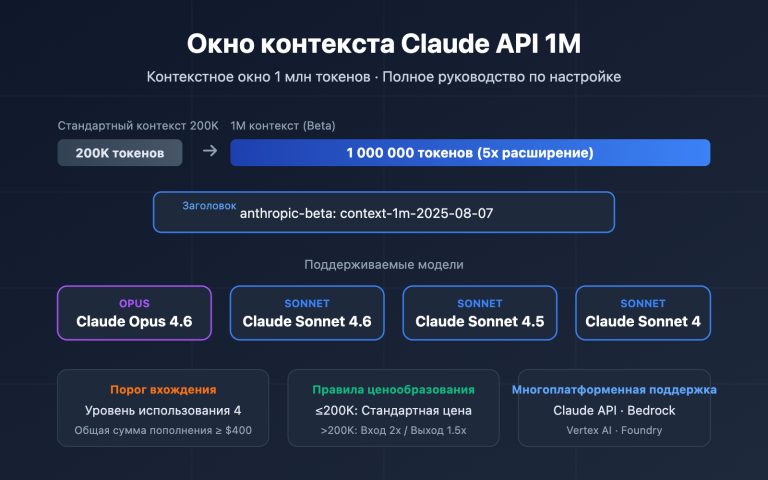
| Контекстное окно | около 1,05 млн токенов | 1 млн токенов |
| Максимальный вывод | 128K | 128K (до 300K в тестовой версии Batch) |
| Уровни рассуждений | low / medium (по умолчанию) / high / xhigh / max | low / medium / high (по умолчанию в API) / xhigh / max |
| Режим размышлений | можно настраивать по уровню | адаптивное рассуждение, отключить нельзя |
| Флагманская модель линейки | gpt-6-astra ($10/$50) | Claude Opus 5.5 ($4/$20) |
| Доступные платформы | APIYI apiyi.com, официальный API OpenAI | APIYI apiyi.com, официальный API Anthropic |
Из таблицы видна важная разница: у моделей разные уровни рассуждений по умолчанию. Для gpt-6.1-sol установлен medium, а API claude-sonnet-5-5 по умолчанию использует high. Если сравнивать модели с настройками по умолчанию, Sonnet фактически будет «думать» на один уровень глубже — поэтому расход токенов и задержка не окажутся в равных условиях. Для честного сравнения рекомендуем явно задавать одинаковый reasoning_effort с обеих сторон.
🎯 Рекомендация для тестирования: сравнивая две модели, обязательно фиксируйте одинаковый уровень рассуждений и промпт. Рекомендуем через APIYI apiyi.com вызывать gpt-6.1-sol и claude-sonnet-5-5 с одним API-ключом: для A/B-теста достаточно менять только параметр
model. Так вы исключите влияние различий между аккаунтами и сетями.
5 ключевых различий между gpt-6.1-sol и claude-sonnet-5-5
Различие 1: агентное программирование — claude-sonnet-5-5 лидирует в задачах с терминалом
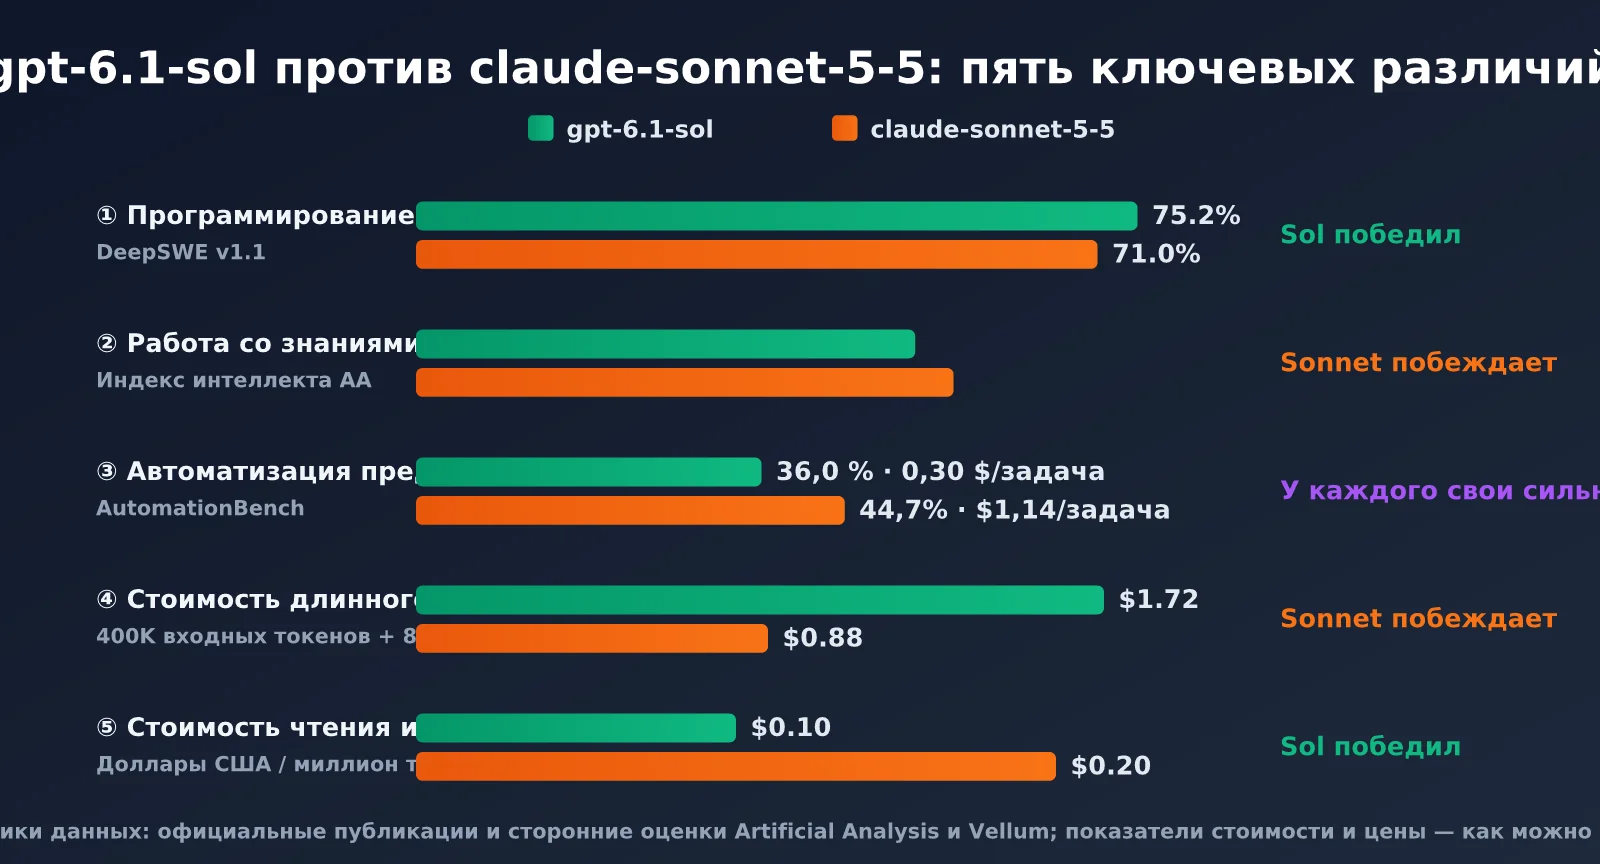
Программирование — область, где конкуренция между этими моделями особенно острая. Однако опубликованные компаниями бенчмарки пересекаются не полностью, поэтому их стоит рассматривать по отдельности. Официальный результат claude-sonnet-5-5 в Terminal-Bench 4.0 составляет 70,6% — огромный скачок по сравнению с 10,3% у Sonnet 5. Модель даже обошла Opus 5.5 с его 66,4%. Независимое повторное тестирование Artificial Analysis показало 64%: это также выше результатов Opus 5.5 и gpt-6-astra, набравшего 60%. В SWE-Bench Pro модель получила 81,3%, а в CursorBench 4.0 — 55,5%, уступив только Opus 5.5.
У gpt-6.1-sol OpenAI делает акцент на результате 75,2% в DeepSWE v1.1. Это чуть выше 74,8% у gpt-6-astra, при этом стоимость одной задачи составляет около $1,50 — менее одной пятой от стоимости Astra. В сторонних сводках claude-sonnet-5-5 набирает в этом бенчмарке 71,0%. Иными словами, для агентного программирования с управлением через терминал доказательства преимущества claude-sonnet-5-5 убедительнее, а в задачах программной инженерии на уровне репозитория gpt-6.1-sol выгоднее по соотношению цены и качества.
Различие 2: работа со знаниями — claude-sonnet-5-5 почти догоняет Opus
В офисных задачах, связанных с обработкой знаний, claude-sonnet-5-5 показывает очень сильные результаты. В GDPval-AA v2.1 модель набрала 1844 балла — практически вровень с Opus 5.5, у которой 1846. В AA-Briefcase результат составил 1811, что тоже совсем рядом с Opus. В индексе интеллекта Artificial Analysis claude-sonnet-5-5 с 56 баллами занимает второе место, отставая от Opus 5.5 всего на 2 балла; у gpt-6.1-sol (max) — 52 балла.
У gpt-6.1-sol, в свою очередь, есть преимущество в анализе документов. В бенчмарке GDP.pdf она получила 32,0% — почти столько же, сколько gpt-6-astra с 32,2%, и больше, чем Opus 5.5 с 28,8%. Стоимость одной задачи — около $0,38. В бенчмарке автоматизации корпоративных процессов AutomationBench claude-sonnet-5-5 лидирует с 44,7% против 36,0% у gpt-6.1-sol, однако одна задача у первой модели стоит примерно $1,14, а у второй — лишь $0,30.
Различие 3: управление компьютером — обе модели уже пригодны для практики
В задачах Computer Use gpt-6.1-sol набирает 71,4% в OSWorld 2.0 — всего на 2,1 процентного пункта меньше, чем gpt-6-astra с 73,5%. Стоимость одной задачи составляет около $1,30. claude-sonnet-5-5 получила 80,1% в OSWorld 2.1, приблизившись к Opus 5.5 с 81,8%.
Важно учитывать, что у OSWorld 2.0 и 2.1 разные тестовые наборы, поэтому напрямую сопоставлять эти показатели нельзя. Но можно уверенно сказать, что обе модели уже способны стабильно работать с настольными приложениями.
Различие 4: тарификация длинного контекста — у gpt-6.1-sol есть скрытый порог
Это самый легко упускаемый из виду пункт — и одновременно один из самых важных для итогового счёта. gpt-6.1-sol поддерживает контекст примерно в 1,05 млн токенов, но если вход одной операции превышает 272 тыс. токенов, весь вход и кэш в этом запросе тарифицируются с коэффициентом 2×, а вывод — с коэффициентом 1,5×.
У claude-sonnet-5-5 контекстное окно в 1 млн токенов не предполагает наценки за длинный контекст: на всём диапазоне действуют стандартные тарифы. Если в вашем сценарии в контекст регулярно отправляются целые руководства или полный кодовый репозиторий, одно это различие может изменить выбор модели.
Различие 5: эффективность по токенам и кэширование — gpt-6.1-sol экономнее
Стоимость чтения кэша у gpt-6.1-sol составляет $0,10 против $0,20 у claude-sonnet-5-5 — то есть вдвое дешевле. Это особенно заметно в агентных циклах, где префикс запроса многократно повторяется.
С другой стороны, claude-sonnet-5-5 на высоких уровнях рассуждений расходует много токенов. По данным Artificial Analysis, в режиме max модель выводит около 193 тыс. токенов на задачу — это максимальное значение среди протестированных моделей. Независимые тесты также показали, что стандартный API-режим high потребляет почти вдвое больше выходных токенов, чем medium, хотя заметного прироста качества не даёт.
| Бенчмарк / показатель | gpt-6.1-sol | claude-sonnet-5-5 | Победитель |
|---|---|---|---|
| Terminal-Bench 4.0 (официальные данные) | Не опубликовано | 70,6% | claude-sonnet-5-5 |
| DeepSWE v1.1 | 75,2% | 71,0% | gpt-6.1-sol |
| GDPval-AA v2.1 | Не опубликовано (у предыдущей gpt-6-sol — 1487) | 1844 | claude-sonnet-5-5 |
| Анализ документов GDP.pdf | 32,0% | Не опубликовано | gpt-6.1-sol |
| AutomationBench | 36,0% (около $0,30 за задачу) | 44,7% (около $1,14 за задачу) | По качеству — Sonnet, по стоимости — Sol |
| Индекс интеллекта AA | 52 | 56 | claude-sonnet-5-5 |
| Стоимость чтения кэша | $0,10 / млн | $0,20 / млн | gpt-6.1-sol |
💡 Примечание о данных: приведённые бенчмарки основаны на официальных публикациях OpenAI и Anthropic, а также независимых оценках Artificial Analysis, Vellum и других площадок. Версии тестов и уровни рассуждений у разных источников отличаются. Лучше всего прогнать сравнительный тест на собственных реальных задачах — он будет полезнее любого рейтинга.
Сравнение реальной стоимости gpt-6.1-sol и claude-sonnet-5-5
Одинаковая заявленная цена не означает одинаковый счёт. Ниже оценим стоимость одного запроса для трёх типичных нагрузок — без учёта записи в кэш и по официальным тарифам. Так сразу станет понятно, откуда берётся разница.
| Сценарий нагрузки | Состав запроса | gpt-6.1-sol | claude-sonnet-5-5 |
|---|---|---|---|
| Цикл агента (высокая доля кэша) | 100K входных токенов (90% попадает в кэш) + 5K выходных | около $0.079 | около $0.088 |
| Обычный диалог | 5K входных + 1K выходных токенов | около $0.020 | около $0.020 |
| Поиск в сверхдлинном контексте | 400K входных токенов (без кэша) + 8K выходных | около $1.72 (с надбавкой) | около $0.88 |
| Пакетная обработка (Batch) | 50% от заявленной цены | $1 / $5 | $1 / $5 |
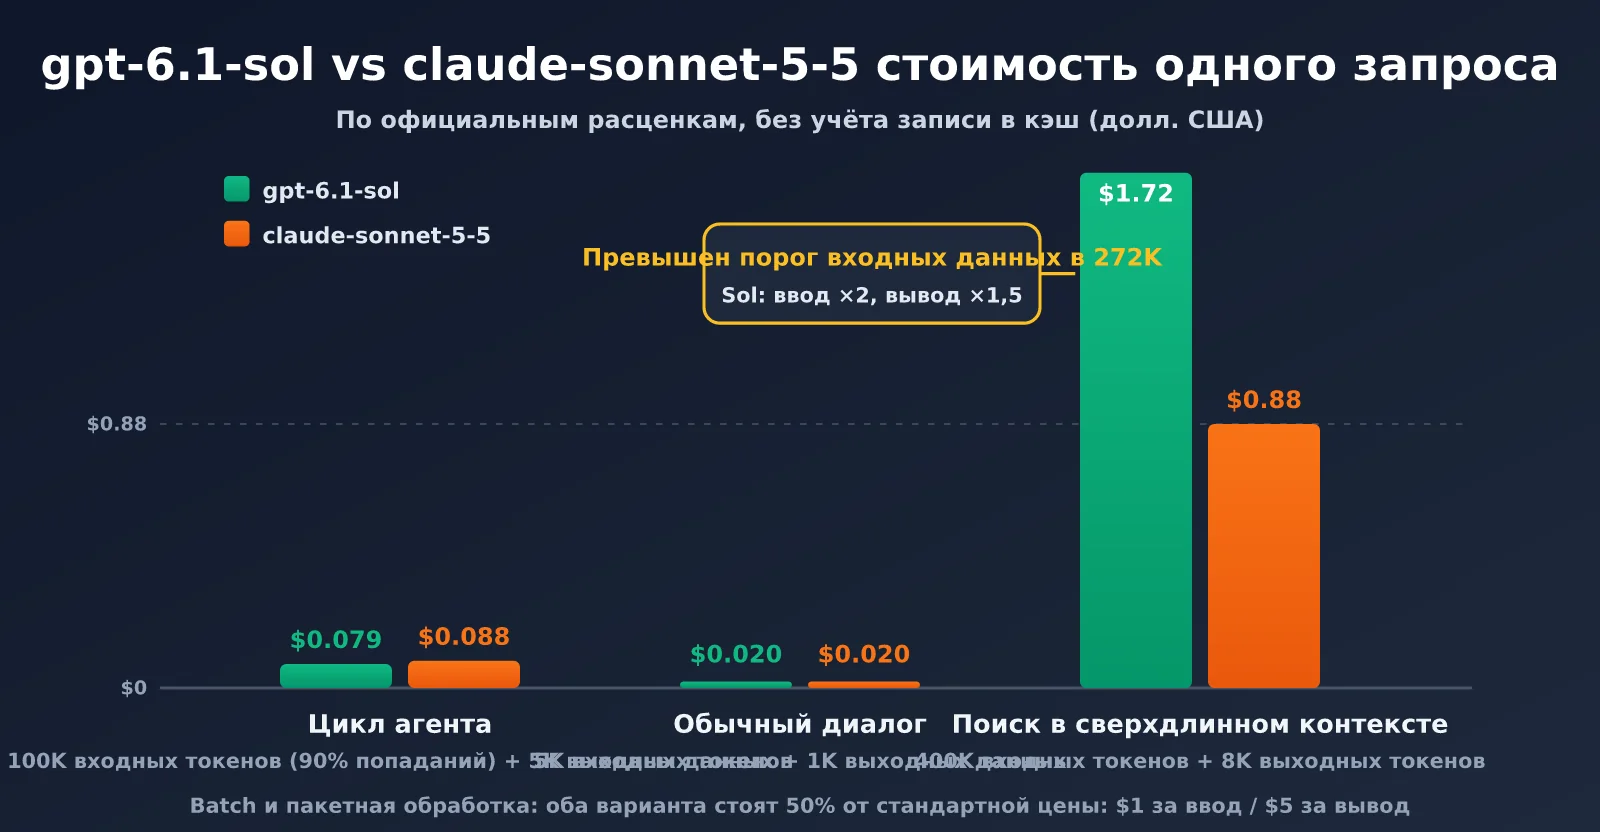
Вывод довольно очевиден: в циклах агентов с часто повторяющимися префиксами gpt-6.1-sol выигрывает примерно 10% за счёт более дешёвого чтения из кэша. В обычных диалогах модели стоят практически одинаково. Но если вход одного запроса превышает 272K токенов, claude-sonnet-5-5 обходится примерно вдвое дешевле gpt-6.1-sol.
Нужно также учитывать эффективность расхода токенов. Если claude-sonnet-5-5 работает в режиме high или max, фактическое число выходных токенов может удвоиться и нивелировать его преимущество на длинном контексте. Поэтому для эффективной работы с Sonnet особенно важно контролировать уровень рассуждений.
Быстрое сравнение моделей на одном и том же коде
Через OpenAI-совместимый интерфейс достаточно изменить параметр model, чтобы протестировать обе модели в одинаковых условиях. Вот минимальный пример:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Единый интерфейс APIYI: обе модели используют один Key
)

for model in ["gpt-6.1-sol", "claude-sonnet-5-5"]:
    resp = client.chat.completions.create(
        model=model,
        reasoning_effort="medium",  # Фиксируем одинаковый уровень для честного сравнения
        messages=[{"role": "user", "content": "Добавь модульные тесты для этой функции:def add(a, b): return a + b"}],
    )
    print(model, resp.usage.total_tokens, resp.choices[0].message.content[:200])
Развернуть: полный скрипт сравнения со статистикой времени и стоимости
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Единый интерфейс APIYI
)

# Цены за миллион токенов: входные, чтение из кэша, выходные
PRICES = {
    "gpt-6.1-sol": (2.0, 0.10, 10.0),
    "claude-sonnet-5-5": (2.0, 0.20, 10.0),
}

def run(model: str, prompt: str, effort: str = "medium"):
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        reasoning_effort=effort,
        messages=[{"role": "user", "content": prompt}],
    )
    elapsed = time.time() - start
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p_in, p_cache, p_out = PRICES[model]
    cost = ((u.prompt_tokens - cached) * p_in + cached * p_cache
            + u.completion_tokens * p_out) / 1_000_000
    return elapsed, u.prompt_tokens, u.completion_tokens, cost

tasks = [
    "Реализуй на Python LRU-кэш со временем жизни записей и напиши тесты",
    "Прочитай требования ниже и предложи структуру таблиц базы данных и индексы: заказы, пользователи, купоны",
]

for task in tasks:
    for model in PRICES:
        t, i, o, c = run(model, task)
        print(f"{model:<20} {t:>6.1f}s  in={i:<6} out={o:<6} ${c:.4f}")
🚀 Быстрый старт: если у вас ещё нет аккаунта Anthropic или регистрацию осложняют зарубежные платежи и проверка номера телефона, можно зарегистрироваться в APIYI на apiyi.com и получить тестовый баланс. Один Key позволит вызывать и gpt-6.1-sol, и claude-sonnet-5-5 — без необходимости отдельно заводить аккаунты у двух официальных провайдеров.
Рекомендации по выбору сценариев для gpt-6.1-sol и claude-sonnet-5-5
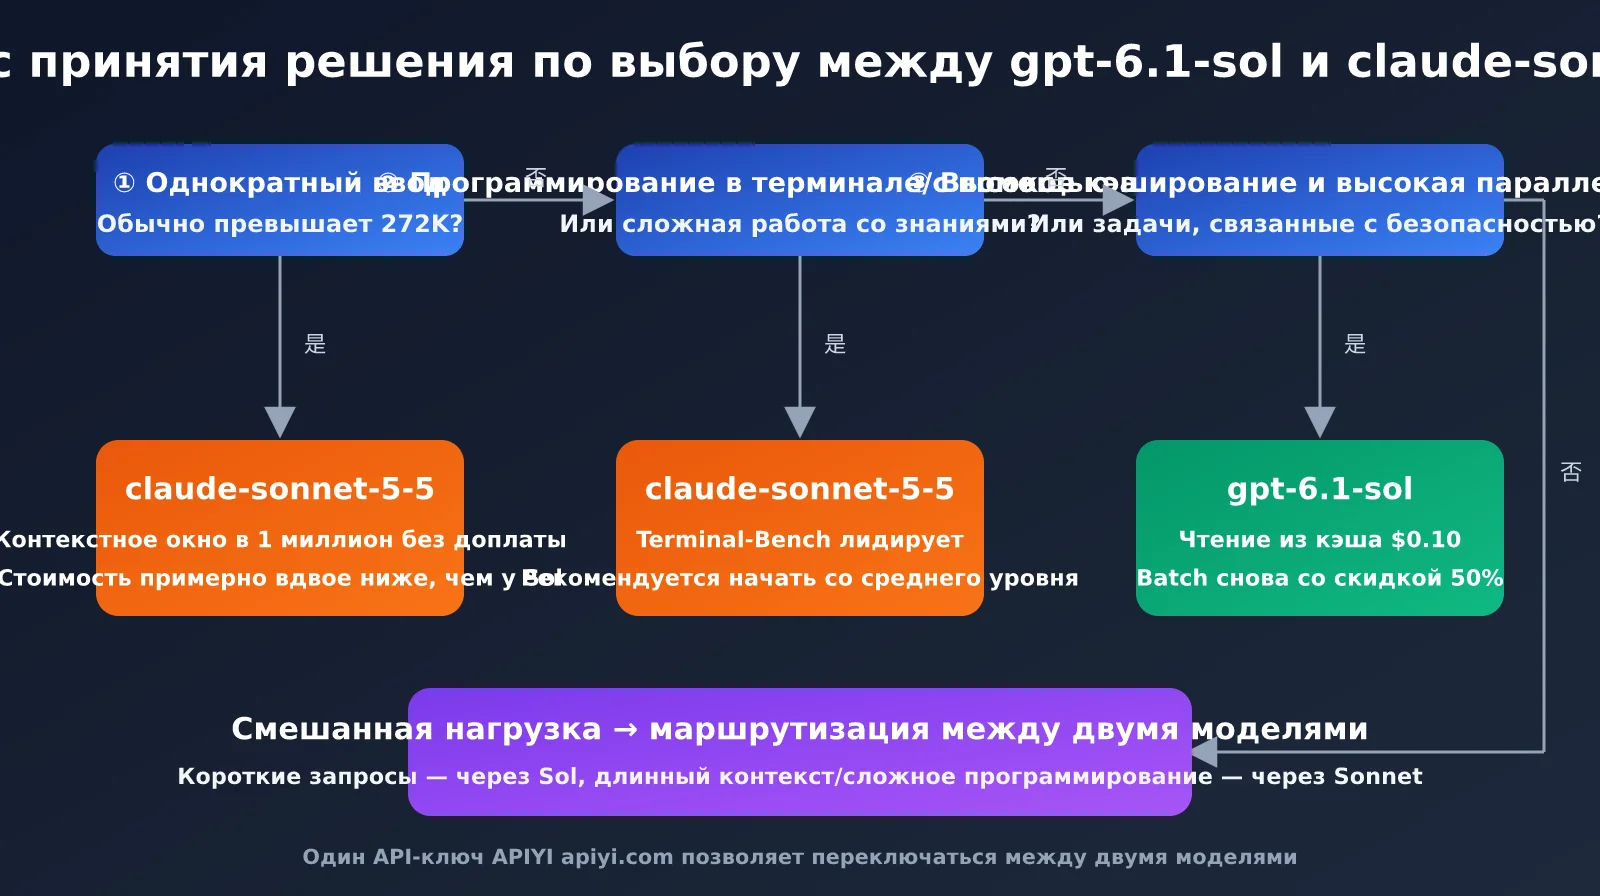
У разных задач разные приоритеты по качеству, стоимости и задержке. Ниже — рекомендации для распространённых сценариев.
| Бизнес-сценарий | Рекомендуемая модель | Основная причина |
|---|---|---|
| Агент для программирования с управлением через терминал (вроде Claude Code) | claude-sonnet-5-5 | Лидер в Terminal-Bench 4.0, требуется меньше вызовов инструментов |
| Исправление кода на уровне репозитория, рабочие процессы Codex | gpt-6.1-sol | В DeepSWE достигает уровня Astra, стоимость одной задачи — около $1,50 |
| Анализ очень длинных документов / всего репозитория (>272K) | claude-sonnet-5-5 | Нет наценки за длинный контекст, стоимость примерно вдвое ниже Sol |
| Высоконагруженная поддержка, RAG-вопросы и ответы (с активным кэшированием) | gpt-6.1-sol | Чтение из кэша стоит $0,10: чем больше повторно используется префикс, тем выше экономия |
| Подготовка отчётов, таблицы и офисные задачи, работа со знаниями | claude-sonnet-5-5 | В GDPval-AA почти сравнялась с Opus 5.5 |
| Разбор PDF-документов, извлечение информации | gpt-6.1-sol | В GDP.pdf достигает уровня Astra, одна задача стоит около $0,38 |
| Исследования безопасности, помощь в пентесте | gpt-6.1-sol | В Sonnet 5.5 встроены меры защиты в сфере кибербезопасности, поэтому доля отказов выше |
Типичные сценарии для выбора gpt-6.1-sol
gpt-6.1-sol лучше всего подходит для задач, чувствительных к стоимости, с большим потоком запросов и высокой повторяемостью префиксов. Например, это интеллектуальная поддержка клиентов, ответы по базе знаний и пакетная очистка данных. В таких системах системный промпт и контекст, полученный через поиск, многократно используются повторно, поэтому стоимость чтения из кэша в $0,10 заметно усиливает преимущество.
У модели также заметно снизился уровень галлюцинаций: на низком уровне рассуждений доля фактических ошибок уменьшилась с 11,4% у предыдущего поколения до 7,7%. Поэтому для массовой обработки несложных задач хорошо подойдут уровни low или medium.
Кроме того, OpenAI вскоре выпустит для gpt-6.1-sol режим Ultrafast: скорость генерации в нём достигает примерно 300 токенов в секунду. Он стоит в 6 раз дороже стандартного режима, но может быть хорошим вариантом для продуктов с интерактивным взаимодействием в реальном времени.
Типичные сценарии для выбора claude-sonnet-5-5
claude-sonnet-5-5 больше подходит для задач, где важны сложность, сверхдлинный контекст и высокая вероятность успешного выполнения с первой попытки. В агентных сценариях модели обычно достаточно около 3 вызовов инструментов, чтобы сделать работу, на которую Sonnet 5 требуется 12–13 вызовов. Скорость вывода также более чем на 30% выше, чем у предыдущего поколения.
Для юридической проверки, миграции кодовой базы или написания длинных отчётов, когда нужно загрузить в контекст большой объём материалов за один раз, особенно полезно контекстное окно в 1 миллион токенов без дополнительной платы.
Стоит учитывать, что в claude-sonnet-5-5 по сравнению с Sonnet 5 есть несколько несовместимых изменений API: режим рассуждений нельзя отключить, а принудительный выбор инструмента через tool_choice: "tool" был удалён. Если старый код зависит от этого поведения, обязательно проведите регрессионное тестирование перед миграцией.
🎯 Совет по архитектуре: не обязательно выбирать только одну из двух моделей. Рекомендуем настроить простой роутинг моделей через APIYI apiyi.com: короткие запросы и трафик с активным кэшированием направлять в gpt-6.1-sol, а задачи со сверхдлинным контекстом и сложное программирование — в claude-sonnet-5-5. Переключение выполняется по необходимости через единый OpenAI-совместимый интерфейс.
Рекомендации по выбору между gpt-6.1-sol и claude-sonnet-5-5
Сведём предыдущий анализ к набору практических шагов:
- Сначала оцените длину входных данных: если типичный запрос превышает 272K токенов, в приоритете claude-sonnet-5-5. В остальных случаях переходите к следующему шагу.
- Затем определите тип задач: для программирования в терминале и агентных сценариев, а также сложной интеллектуальной работы лучше подходит claude-sonnet-5-5; для исправления кода на уровне репозитория и разбора PDF — gpt-6.1-sol.
- После этого посмотрите на структуру трафика: в системах с высоким процентом попаданий в кэш и большой параллельностью ценовое преимущество gpt-6.1-sol растёт вместе с масштабом.
- В конце настройте уровень рассуждений: независимо от выбранной модели начинайте тестирование с уровня medium. Для claude-sonnet-5-5 особенно важно не использовать сразу API-уровень high по умолчанию — расход токенов может вырасти вдвое.
| Ваш приоритет | Основной выбор | Альтернативная стратегия |
|---|---|---|
| Качество важнее бюджета | claude-sonnet-5-5 (medium/high) | Для самых сложных задач переходите на Opus 5.5 |
| Минимальная стоимость при огромном трафике | gpt-6.1-sol (low/medium) | Нереалтаймовые задачи отправляйте через Batch со скидкой 50% |
| Скорость и интерактивный режим | gpt-6.1-sol (после выхода Ultrafast) | claude-sonnet-5-5 на уровне low |
| Стабильность без единой точки отказа | Маршрутизация между двумя моделями | При ограничении запросов у одной модели автоматически переключайтесь на другую |
Что касается предпочтений к бренду и доступности, они не должны определять технический выбор. У официальных аккаунтов Claude действительно более строгие требования к региону, способам оплаты и другим условиям, из-за чего порог входа выше. Но это вопрос уровня интеграции, а не возможностей модели. Если передать интеграционный слой единой API-платформе, выбирать модель можно исключительно по качеству выполнения задач и стоимости.
Частые вопросы
Q1: gpt-6.1-sol и claude-sonnet-5-5 действительно стали дешевле?
На уровне прайс-листа ничего не изменилось: обе модели по-прежнему стоят $2/$10. Реальное «снижение цены» в другом: gpt-6.1-sol предлагает возможности, близкие к gpt-6-astra, за одну пятую стоимости, а цена чтения из кэша снизилась с $0.20 до $0.10. claude-sonnet-5-5, в свою очередь, обеспечивает уровень, близкий к Opus 5.5, за половину его стоимости и может сократить стоимость одной задачи примерно на 30% благодаря меньшему числу вызовов инструментов. Поэтому при сравнении стоит смотреть не на цену токена, а на полную стоимость выполнения задачи.
Q2: Как вызвать claude-sonnet-5-5 без аккаунта Anthropic?
Официальный аккаунт Anthropic предъявляет требования к региону регистрации, номеру телефона и способу оплаты. Индивидуальные разработчики и команды из Китая часто сталкиваются с ограничениями уже на этом этапе. Простое решение — вызывать модель через APIYI apiyi.com. Платформа предоставляет OpenAI-совместимый интерфейс: достаточно указать base_url как https://api.apiyi.com/v1, а в model задать claude-sonnet-5-5. Остальной код приложения менять не потребуется.
Q3: Можно ли без опасений использовать все 1,05 млн токенов контекстного окна gpt-6.1-sol?
Можно, но нужно учитывать тарификацию. Если вход одного запроса превышает 272K токенов, цена входных токенов и кэшированных данных для всего запроса удваивается, а стоимость выходных токенов увеличивается в 1,5 раза. Если вашему продукту действительно нужен сверхдлинный контекст, сначала стоит применить поиск и сжатие данных либо направлять такие запросы в claude-sonnet-5-5, где нет надбавки за длинный контекст.
Q4: Почему claude-sonnet-5-5 иногда обходится дороже, чем ожидалось?
Основная причина — уровень рассуждений. По умолчанию API использует уровень high, а режим размышлений нельзя отключить. На простых задачах это может приводить к большому числу ненужных токенов рассуждений. Независимые тесты показывают, что на уровне medium расход токенов сопоставим с Sonnet 5, при этом качество выше. Поэтому для повседневных задач рекомендуется явно задавать medium.
Q5: Какую модель выбрать именно для программирования?
Если вы в основном используете терминальных агентов, например Claude Code, для многоэтапной разработки, результаты claude-sonnet-5-5 в Terminal-Bench выглядят убедительнее. Если же основная работа — исправление дефектов на уровне репозитория и использование в рабочих процессах Codex, gpt-6.1-sol достигает уровня gpt-6-astra при меньшей стоимости одной задачи. Если возможности команды позволяют, самый надёжный подход — подключить обе модели и распределять запросы по типу задач.
Итоги
У gpt-6.1-sol и claude-sonnet-5-5 нет безусловного победителя. claude-sonnet-5-5 сильнее в агентном программировании, работе со знаниями и интеллектуальном индексе, а контекстное окно в 1 млн токенов доступно без доплаты. gpt-6.1-sol, в свою очередь, выгоднее по стоимости кэширования, исправлению кода на уровне репозитория, разбору документов и цене отдельных задач. Он хорошо подходит для крупных производственных нагрузок с высокой повторяемостью запросов. Базовые цены у моделей одинаковые, но итоговую сумму в счёте определяют три фактора: длина входных данных, процент попаданий в кэш и выбранный уровень рассуждений.
На практике можно действовать в три шага: сначала определить основную модель с помощью процесса выбора из этой статьи; затем запустить A/B-тест на реальных задачах с помощью сравнительного скрипта, зафиксировав одинаковый уровень рассуждений; и наконец настроить маршрутизацию между двумя моделями по типам задач, чтобы каждый запрос обрабатывался наиболее выгодной моделью.
Если вы хотите не проходить отдельные процессы регистрации в официальных сервисах Anthropic и OpenAI, можно вызывать gpt-6.1-sol и claude-sonnet-5-5 через APIYI apiyi.com. Платформа совместима с форматом OpenAI API: одного API-ключа достаточно, чтобы свободно переключаться между этими двумя моделями. Это особенно удобно для тестирования вариантов и настройки маршрутизации между несколькими моделями в production-среде.
Источники:
— Официальный анонс OpenAI: GPT-6.1 Sol — openai.com/index/introducing-gpt-6-1-sol
— Официальный анонс Anthropic: Claude Sonnet 5.5 — anthropic.com/claude-sonnet-5-5
— Оценка интеллектуального индекса Artificial Analysis: artificialanalysis.ai
— Разбор бенчмарков GPT-6.1 Sol от Vellum: vellum.ai/blog
— Материал The Decoder о Claude Sonnet 5.5: the-decoder.com
Об авторах: техническая команда APIYI, специализирующаяся на подключении API Больших языковых моделей и инженерных практиках. Будем рады обсудить через APIYI apiyi.com выбор между gpt-6.1-sol и claude-sonnet-5-5, а также оптимизацию затрат.