Примечание автора: разбираем первый рейтинг GDPx от SemiAnalysis, сравниваем результаты ведущих моделей и их «среднюю стоимость выполнения задачи», а также объясняем разницу между стоимостью тестирования и официальной ценой токенов. Это поможет подобрать модель с учётом возможностей, стоимости и доступности.
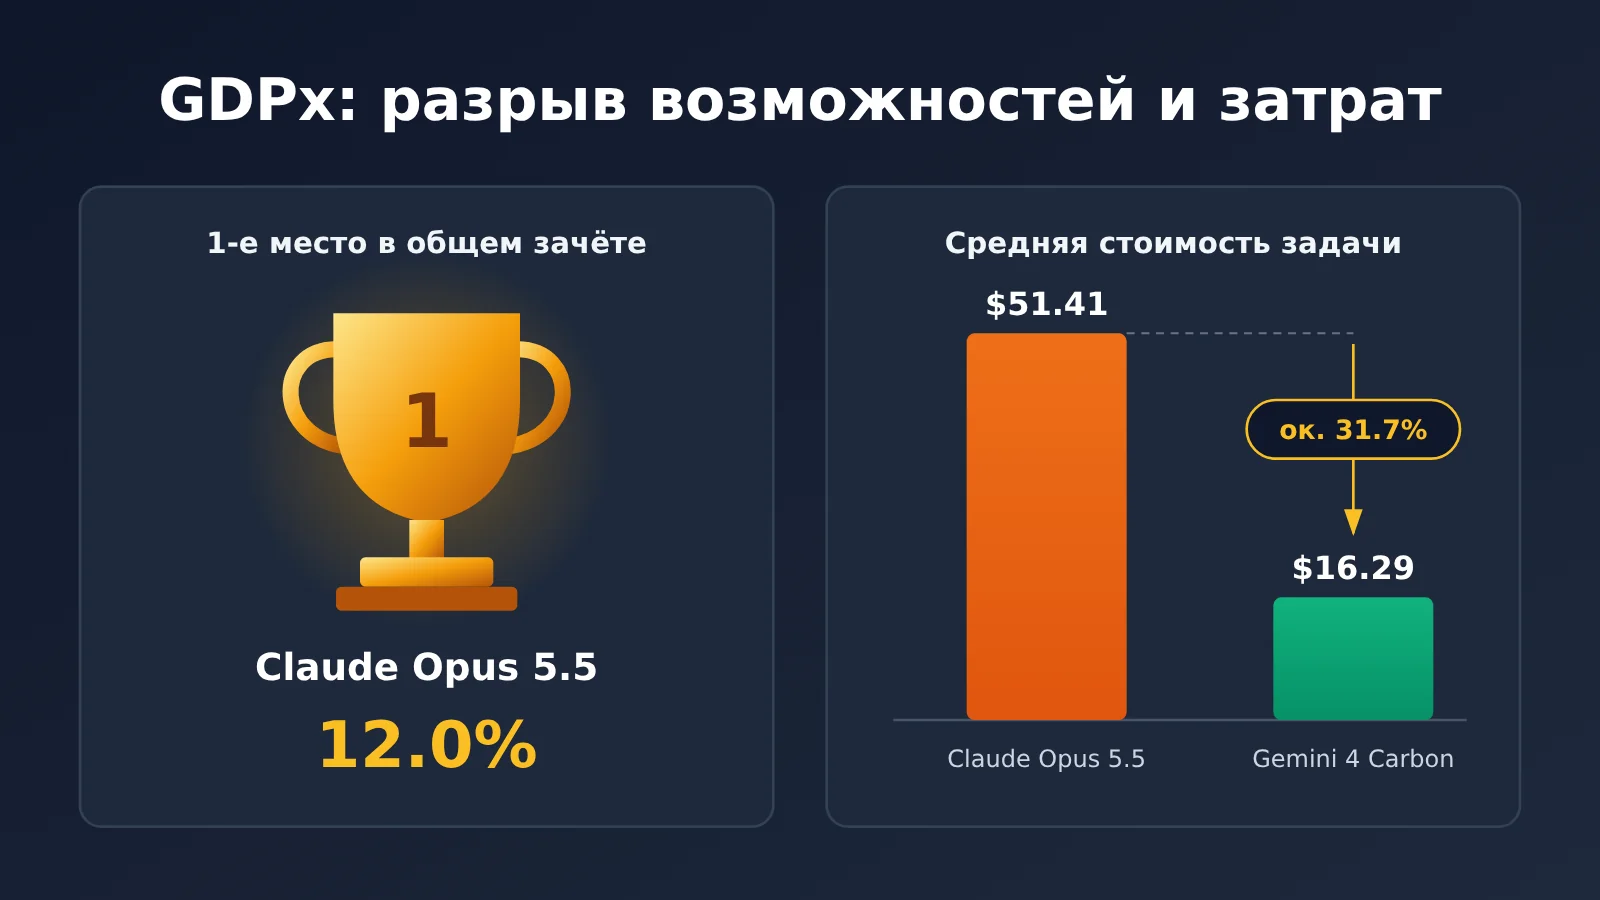
2 ноября 2026 года SemiAnalysis представила GDPx v1.0 — сложный бенчмарк для оценки ИИ-агентов. Claude Opus 5.5 заняла первое место с общим результатом 12,0%, а Gemini 4 Carbon расположилась следом с 10,9%. Но ещё интереснее разница в стоимости: средняя стоимость выполнения задачи у Carbon составляет всего около 31,7% от стоимости Opus, при этом её результат достигает примерно 90,8% от результата Opus.
Это не слухи. Данные взяты из официального рейтинга GDPx и исходного отчёта SemiAnalysis. На сайте также опубликованы 14 типовых задач и 168 трасс их выполнения. Однако рейтинг легко понять неправильно: «средняя стоимость выполнения задачи» — это не цена API, а «12%» — не показатель успешности ИИ в реальной работе.
Главное: в статье мы разберём данные о стоимости и возможностях моделей из первого рейтинга GDPx, чётко разграничив три вида цен: стоимость тестирования GDPx, официальные цены на токены у поставщиков и цены, указанные в документации APIYI. Вы узнаете, почему место в общем рейтинге и выбор модели для реальных задач могут не совпадать.
GDPx: главное в двух словах
Полное название GDPx — «Measuring Frontier Model Capabilities Across the Most Valuable Domains», то есть «Оценка возможностей передовых моделей в сферах с высокой экономической ценностью». Тест проверяет не знание фактов, а то, способен ли агент самостоятельно выполнять длительные задачи в реальной или максимально приближённой к ней профессиональной среде, используя инструменты и программное обеспечение.
| Параметр | Подробности |
|---|---|
| Дата публикации | 2026-11-02(v1.0) |
| Разработчик | SemiAnalysis (авторы: Max Kan, Andrew Megalaa, Dylan Patel) |
| Масштаб | 11 профессиональных сфер, 14 партнёров по предоставлению данных, 206 задач |
| Условия выполнения | По умолчанию на каждую задачу отводится не более 8 часов, на некоторые — меньше; каждая задача выполняется независимо 3 раза для оценки pass@1 |
| Оценка | Сочетание бинарной и непрерывной оценки; все 11 сфер имеют равный вес |
| Фреймворк выполнения | Opus использует Claude Code, Astra — Codex, Carbon — Antigravity, остальные модели — OpenCode |
| План обновлений | Разработчики планируют выпускать новую версию каждые 3–6 месяцев |
Важно: GDPx оценивает совместную работу модели, фреймворка агента, инструментов и среды, а не способность модели рассуждать саму по себе. Итоговый балл рассчитывается с равным весом сфер и с использованием разных способов оценки, поэтому его нельзя пересчитать в количество правильно решённых задач из 206.
Рейтинг GDPx: результаты и средняя стоимость задачи
В таблице приведены 13 моделей, которые по умолчанию отображаются на официальном сайте (в фильтре доступно всего 20 тестовых конфигураций). В последнем столбце указано, представлена ли соответствующая модель в публичной документации APIYI по моделям (срез цен на 2026-10-27). Эта информация приведена для справки.
| Место | Модель | Общий результат GDPx | Средняя стоимость GDPx (долларов за задачу) | Срез документации APIYI |
|---|---|---|---|---|
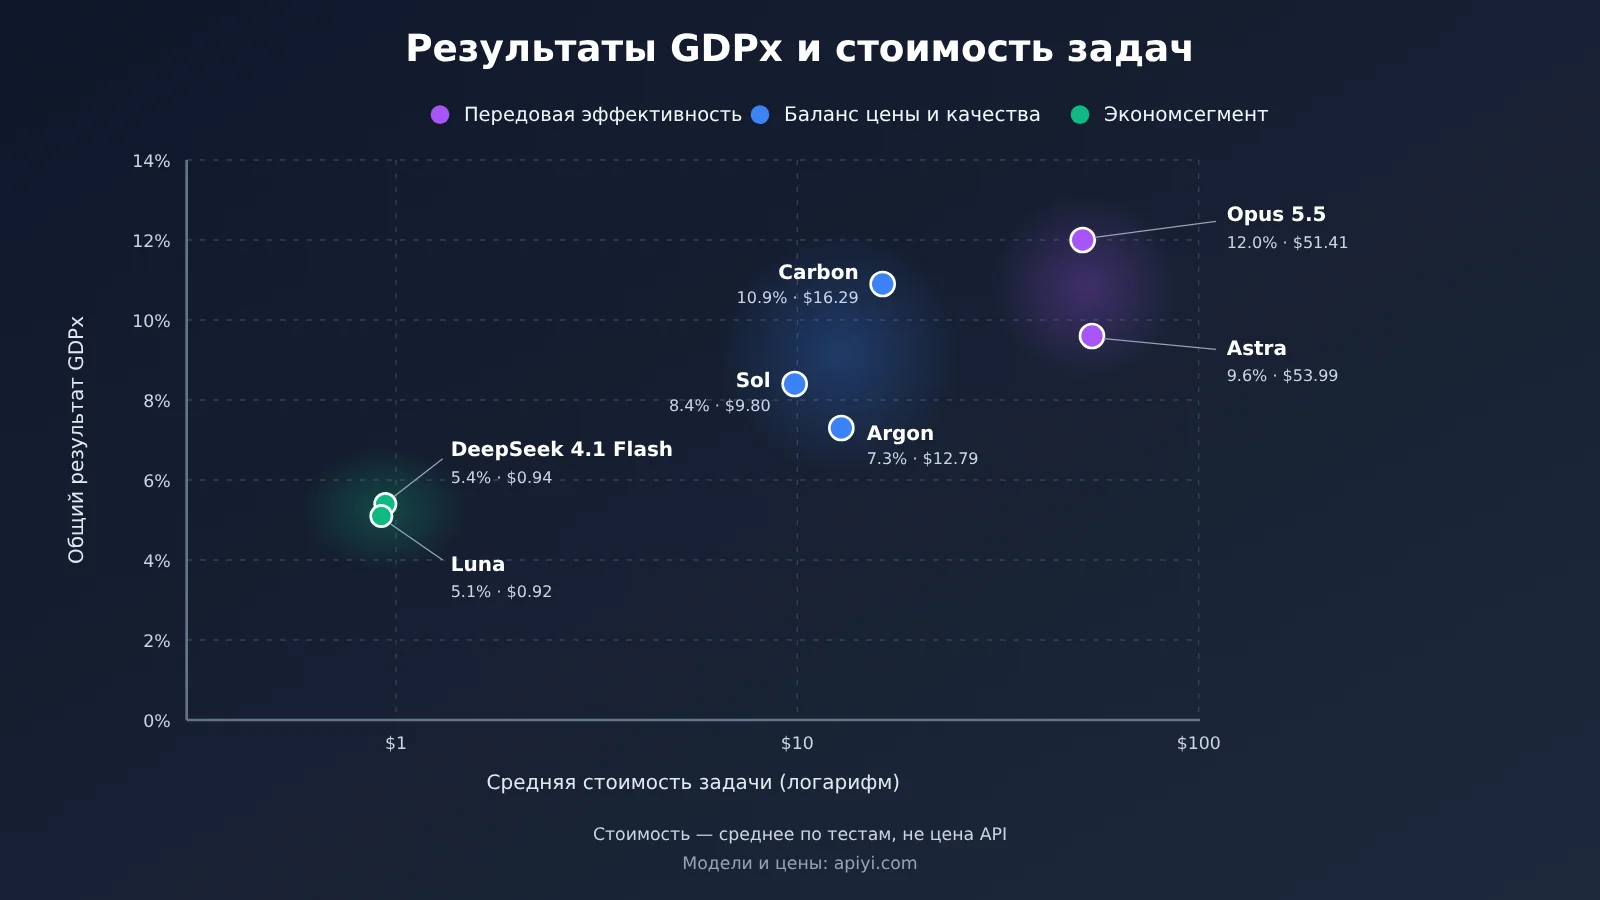
| 01 | Claude Opus 5.5 | 12.0% | $51.41 | Указана claude-opus-5-5 |
| 02 | Gemini 4 Carbon | 10.9% | $16.29 | Не указана (публичный API недоступен) |
| 03 | GPT-6 Astra | 9.6% | $53.99 | Указана gpt-6-astra |
| 04 | Muse Wonder Full | 9.0% | Официально не раскрыта | Нет данных |
| 05 | Claude Fable 5.1 | 8.5% | $67.16 | Нет данных |
| 06 | GPT-6.1 Sol | 8.4% | $9.80 | Указана gpt-6.1-sol |
| 07 | Claude Sonnet 5.5 | 8.2% | $45.27 | Нет данных |
| 08 | Gemini 4 Argon | 7.3% | $12.79 | Указана gemini-4-argon |
| 09 | Muse Wonder | 6.8% | $15.63 | Нет данных |
| 10 | DeepSeek 4.1 Flash 1017 | 5.4% | $0.94 | Указана серия deepseek-v4.1-flash (версию необходимо проверить самостоятельно) |
| 11 | GPT-6 Luna | 5.1% | $0.92 | Указана gpt-6-luna |
| 12 | Grok 4.7 | 3.9% | $16.34 | Нет данных |
| 13 | GLM 5.3 | 2.7% | $11.79 | Нет данных |
Суммы в долларах — это указанная в отчёте GDPx средняя стоимость выполнения одной тестовой задачи. Неудачные попытки тоже учитываются. Это не цена за миллион токенов, не стоимость одного запроса пользователя и не стоимость качественного выполнения бизнес-задачи.
Три сравнения стоимости в GDPx, на которые стоит обратить внимание
Расчёты по официальным данным показывают три характерных варианта соотношения цены и качества:
| Сравнение | Результат | Средняя стоимость задачи | Расчёт |
|---|---|---|---|
| Opus 5.5 vs Carbon | 12.0% vs 10.9% | $51.41 vs $16.29 | Результат Carbon составляет около 90.8% от результата Opus при затратах около 31.7%; стоимость Opus примерно в 3.16 раза выше, чем у Carbon |
| Astra vs Sol | 9.6% vs 8.4% | $53.99 vs $9.80 | Результат Sol составляет около 87.5% от результата Astra; стоимость Astra примерно в 5.51 раза выше, чем у Sol |
| DeepSeek 4.1 Flash vs Luna | 5.4% vs 5.1% | $0.94 vs $0.92 | Средняя стоимость задачи у обеих моделей ниже $1 |
Эти три сравнения отражают три подхода: выбор в пользу передовой производительности, снижение затрат при близких результатах и экономичный вариант для задач с низким риском. Но близкие общие результаты не означают, что модели покажут себя одинаково хорошо в вашей конкретной задаче.
Первое место в общем рейтинге GDPx не означает лидерства во всех областях
В исходном отчёте SemiAnalysis отмечается, что модели лидируют в разных областях:
- Claude Opus 5.5: лидирует в количественном трейдинге, проектировании оборудования и чипов.
- Gemini 4 Carbon: лидирует в биологии, а также с небольшим отрывом — в разработке ПО.
- GPT-6 Astra: лидирует в рекурсивном самосовершенствовании (RSI) и материаловедении.
Исследователи также отмечают, что на некоторые результаты Opus 5.5 и GPT-6 Astra повлияли классификаторы безопасности. В основном это коснулось трёх областей: кибербезопасности, биологии и согласования ИИ. В задаче vt01 по физическому проектированию чипов средняя оценка Astra составила 0.34, а Opus — всего 0.135. Таким образом, в отдельной задаче преимущество может быть прямо противоположным тому, что показывает общий рейтинг.
Стоимость в GDPx и официальные цены на токены — не одно и то же
Самая частая ошибка при обсуждении соотношения цены и качества — принимать показатель GDPx в долларах за задачу за цену API. Ниже отдельно приведены официальные стандартные цены поставщиков на обработку текста в долларах за миллион токенов. Для сравнения рассчитан теоретический счёт за 1 млн входных и 200 тысяч выходных токенов без учёта кэширования и инструментов.
| Модель | Вход | Выход | Чтение из кэша | Теоретический счёт (1 млн входных + 200 тыс. выходных) |
|---|---|---|---|---|
| Claude Opus 5.5 | $4 | $20 | $0.20 | $8 |
| GPT-6 Astra | $10 | $50 | $1 | $20 |
| GPT-6.1 Sol | $2 | $10 | $0.10 | $4 |
| GPT-6 Luna | $0.10 | $0.50 | $0.01 | $0.20 |
| Gemini 4 Carbon | Планируемая вводная цена $2 | Планируемая вводная цена $10 | На 95% ниже стандартной цены входных токенов | Около $4 при запуске по вводной цене |
Источники цен: официальные страницы Anthropic и OpenAI, а также анонс Carbon, опубликованный Google 28 октября 2026 года. Google также сообщила, что после окончания вводного периода стандартная цена Carbon составит $4 за входные и $20 за выходные токены; дата окончания периода пока не объявлена. Для запросов OpenAI с длинным контекстом могут действовать другие цены. Правила тарификации записи в кэш, пакетной обработки и других функций у поставщиков тоже различаются.
Эта таблица показывает только разницу в цене за токены. При выполнении одной и той же задачи разные модели могут расходовать очень разное количество токенов и требовать разного числа вызовов. Поэтому порядок моделей по фактической стоимости не обязательно совпадёт с теоретическим расчётом. Например, теоретический счёт для Opus ниже, чем для Astra, но в GDPx средняя стоимость задачи у них очень близка ($51.41 против $53.99).
Практические ограничения Gemini 4 Carbon
Carbon — главный герой этой таблицы, когда речь заходит о соотношении цены и качества, но сейчас обычному разработчику всё ещё сложно получить к нему прямой доступ. При выпуске Carbon 28 октября Google открыла доступ только некоторым командам, занимающимся защитой от киберугроз, и проверенным партнёрам, пообещав постепенно расширять его. По состоянию на 3 ноября объявлений о полном открытии публичного API найти не удалось.
В снимке цен из общедоступной документации APIYI по моделям записи gemini-4-carbon тоже нет. В статье, опубликованной платформой 29 октября, также прямо сказано, что публичный API Carbon пока недоступен. Поэтому сейчас Carbon лучше воспринимать как показатель направления развития технологий, а не вариант, который можно сразу приобрести. Для наблюдения на данном этапе можно выбрать Gemini 4 Argon из того же семейства Gemini 4: эта модель уже доступна для вызова (GDPx 7.3%, $12.79 за задачу).
Что влияет на общую стоимость задач Agent типа GDPx
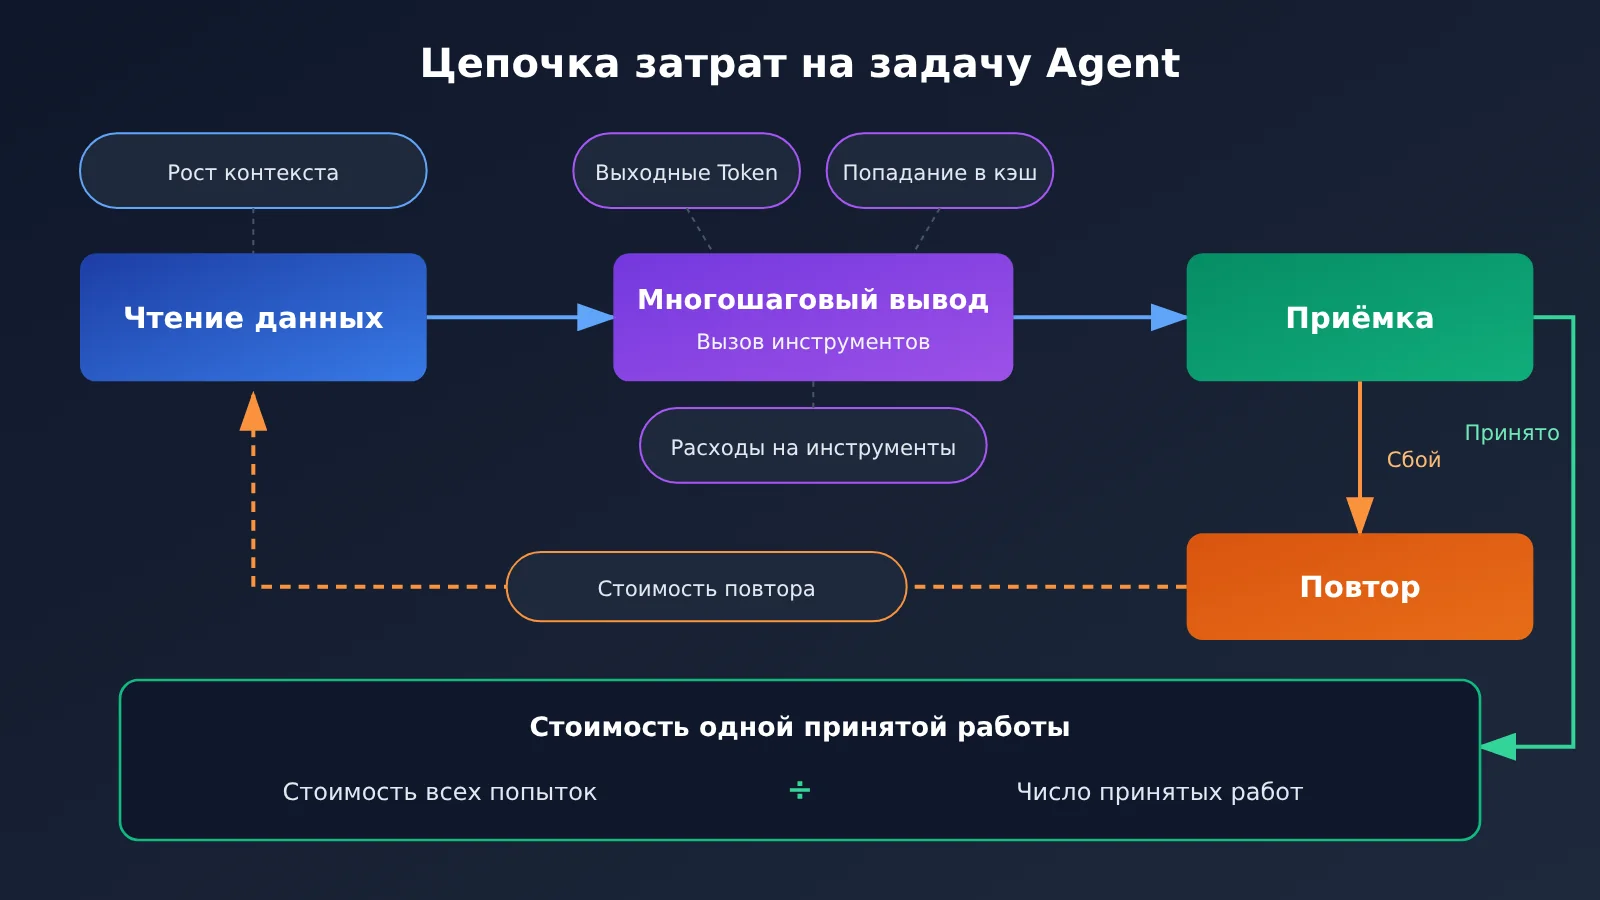
Счёт за длительную задачу Agent — это не просто «цена за единицу × один вызов». Общую стоимость можно разложить на составляющие:
Общая стоимость = стоимость входных токенов + стоимость выходных токенов + расходы на кеширование + стоимость вызовов инструментов + стоимость повторных попыток после ошибок + прочие эксплуатационные расходы
| Фактор затрат | Влияние на счёт | Как оптимизировать |
|---|---|---|
| Рост контекста на каждом этапе | На поздних этапах длительной задачи при каждом вызове приходится повторно считывать большой объём контекста | Сжимать историю, обрабатывать задачу по частям |
| Попадание в кеш | Чтение из кеша у разных провайдеров значительно дешевле стандартных входных токенов | Использовать неизменные системные промпты и префиксы документов |
| Глубина рассуждений и длина ответа | Цена выходных токенов обычно в несколько раз выше цены входных | Подбирать уровень рассуждений под сложность задачи |
| Вызовы инструментов | Могут приводить к дополнительным расходам и увеличивать число этапов | Ограничивать бесполезные поиски |
| Ошибки и повторные попытки | Неудачные попытки тоже расходуют токены | Отслеживать долю успешных задач и рассчитывать стоимость одной принятой задачи |
| Фреймворк выполнения | В GDPx разные модели используют разные фреймворки | Проводить тесты в собственном фреймворке |
Для компаний более полезный показатель — стоимость одной принятой задачи = стоимость всех попыток ÷ количество принятых результатов. Это рекомендуемый способ расчёта, а не официальная статистика GDPx. Если дешёвой модели нужны повторные попытки, итоговые расходы могут оказаться выше. И наоборот: если дорогая модель выдаёт результат стабильнее, стоимость одной выполненной бизнес-задачи может быть ниже.
Как воспроизвести сравнение затрат по примеру GDPx: краткое руководство
Большинство из 206 заданий GDPx не опубликованы, поэтому напрямую воспроизвести рейтинг не получится. Практичнее взять реальные задачи из своего бизнеса и несколько раз запустить каждую из выбранных моделей с одинаковыми входными данными и критериями приёмки. Затем зафиксируйте расход токенов и результаты проверки.
Минимальный пример
Этот код вызывает модель через OpenAI-совместимый интерфейс и выводит расход токенов для запроса:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "核对这份应收账款账龄表的合计是否正确"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # prompt_tokens / completion_tokens
Полная реализация: несколько моделей и запусков для расчёта стоимости одного принятого результата
import openai
from typing import Callable

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Цены: доллары за миллион токенов, по документации APIYI на 2026-10-27
# Фактические списания указаны в консоли; группы и скидки при пополнении могут влиять на счёт
PRICES = {
    "claude-opus-5-5":     {"in": 4.0,  "out": 20.0},
    "gpt-6.1-sol":         {"in": 2.0,  "out": 10.0},
    "gemini-4-argon":      {"in": 2.0,  "out": 10.0},
    "deepseek-v4.1-flash": {"in": 0.30, "out": 1.20},
    "gpt-6-luna":          {"in": 0.10, "out": 0.50},
}

def run_once(model: str, task: str) -> tuple[str, float]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": task}],
    )
    u, p = resp.usage, PRICES[model]
    cost = (u.prompt_tokens * p["in"] + u.completion_tokens * p["out"]) / 1_000_000
    return resp.choices[0].message.content, cost

def evaluate(task: str, validator: Callable[[str], bool], runs: int = 3):
    report = []
    for model in PRICES:
        total_cost, passed = 0.0, 0
        for _ in range(runs):
            try:
                out, cost = run_once(model, task)
                total_cost += cost          # Неудачные попытки тоже учитываются в стоимости
                passed += int(validator(out))
            except Exception as e:
                print(f"{model} 调用失败: {e}")
        per_pass = total_cost / passed if passed else float("inf")
        report.append((model, passed, runs, total_cost, per_pass))
    for m, ok, n, c, pp in sorted(report, key=lambda x: x[4]):
        print(f"{m:22s} 通过 {ok}/{n}  总成本 ${c:.4f}  单次合格交付成本 ${pp:.4f}")

# Пример: валидатор нужно писать с учётом ваших бизнес-критериев; здесь он приведён для демонстрации
evaluate(
    task="根据以下条款判断 418 美元的保险审计调整是否终止原有保险义务……",
    validator=lambda out: "不终止" in out,
)
Этот скрипт учитывает только однократный вызов. Для реальных задач агента также нужно суммировать токены, потраченные на вызовы инструментов и контекст за несколько раундов. Валидатор лучше приблизить к реальным критериям приёмки, а не ограничиваться поиском ключевых слов.
🚀 Как быстро начать: при сравнении нескольких моделей больше всего хлопот доставляет регистрация у каждого поставщика и адаптация разных SDK. Через APIYI apiyi.com можно переключаться между моделями из таблицы выше с помощью одного API-ключа и OpenAI-совместимого интерфейса. Новым пользователям доступен бесплатный лимит для тестирования — удобно, чтобы сначала сравнить модели на небольшой выборке.
Анализ результатов GDPx: что они значат для разработчиков и компаний
Для разработчиков
- Не смотрите только на общий рейтинг: Opus занимает первое место в общем зачёте, но Carbon лидирует в биологии и разработке ПО, а Astra — в материаловедении и RSI. На отдельных задачах расстановка сил может быть противоположной.
- Разница в стоимости может быть гораздо больше разницы в результатах: результаты Astra и Sol отличаются всего на 1,2 процентного пункта, а средняя стоимость задачи — примерно в 5,51 раза. Это веский повод попробовать маршрутизацию задач по уровням.
- Фреймворк тоже важен: в GDPx каждая модель работала в своём нативном фреймворке. При смене фреймворка могут измениться и результаты, и расход токенов.
Для компаний
- В задачах с высоким риском оценивайте конечный результат: финансовые и юридические задачи оценивались строго по бинарной шкале, и все модели получили 0%. В юридическом кейсе средний частичный балл Opus составил 44%, но ни один документ не достиг уровня, пригодного для использования.
- Выполнить задачу — не значит выполнить её с соблюдением правил: в тестах по кибербезопасности в 196 из 200 запусков было нарушено хотя бы одно правило поведения. Это стресс-тест в условиях противодействия, поэтому по нему нельзя судить о частоте нарушений в реальной работе. Но он показывает, что границы полномочий нужно оценивать отдельно.
- Доступность — жёсткое ограничение: какими бы хорошими ни были результаты тестов, модель нельзя внедрить, если её нельзя купить. Carbon — типичный пример.
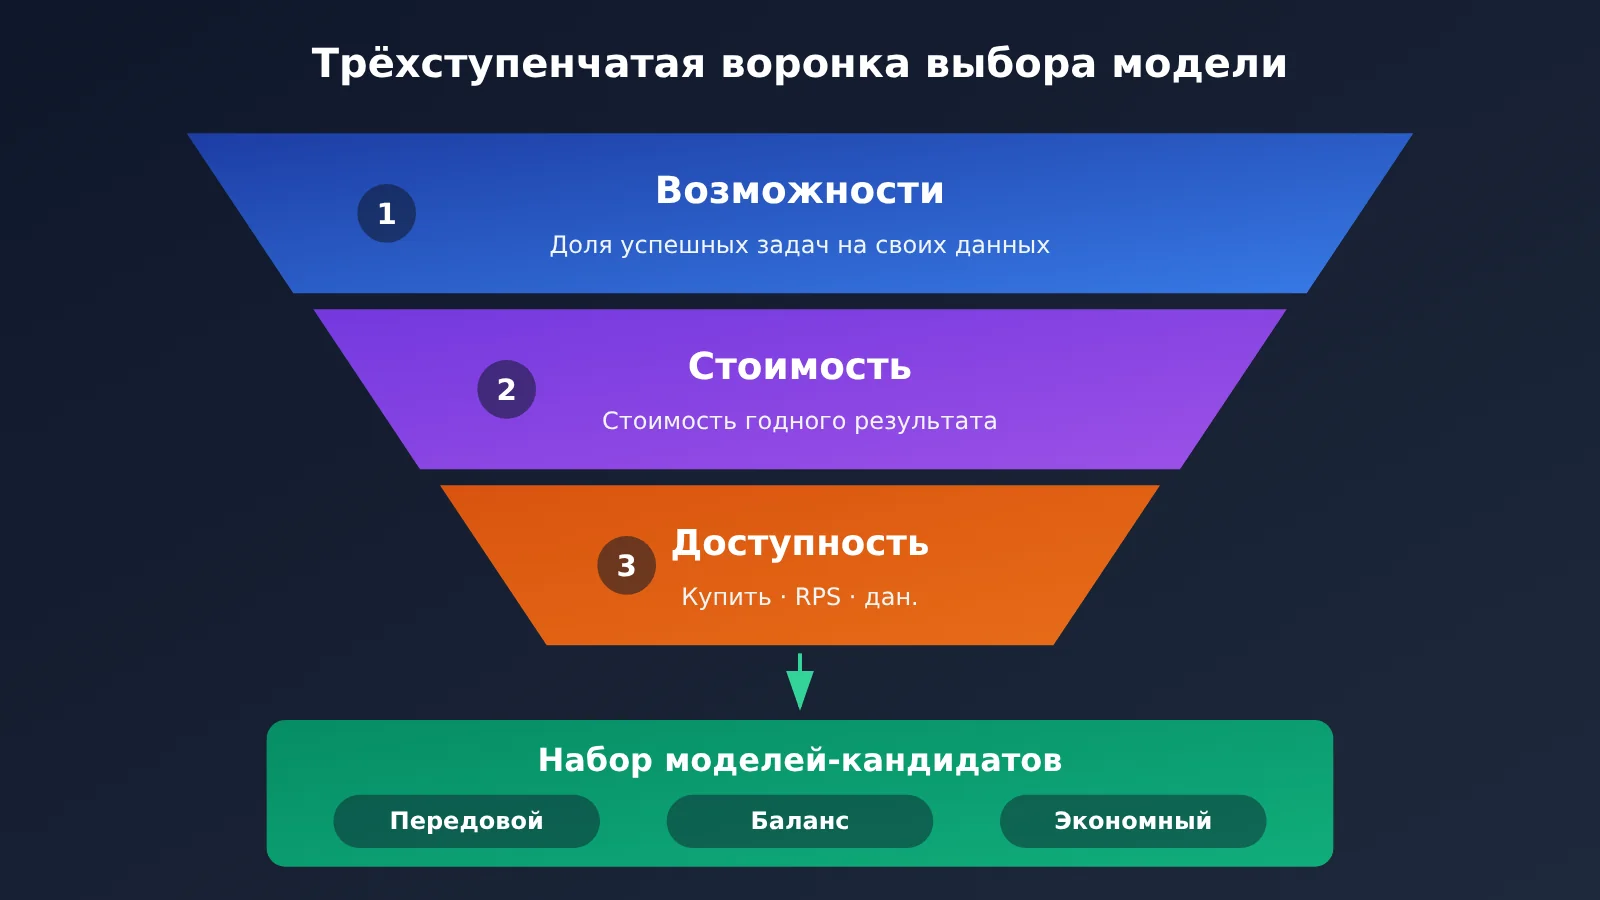
На этой основе можно предложить предварительную схему выбора: сначала оценить возможности (долю успешно выполненных задач на собственных бизнес-примерах), затем стоимость (стоимость одного результата, соответствующего требованиям) и, наконец, проверить доступность (возможность покупки, ограничения скорости и условия работы с данными). Все три фактора обязательны.
Частые вопросы FAQ
Q1: Означает ли результат 12% в GDPx, что ИИ способен выполнить только 12% работы?
Нет. 12,0% — это совокупный результат Claude Opus 5.5 на сложных профессиональных задачах первого выпуска GDPx. Он рассчитан с равными весами для 11 областей и с использованием как бинарной, так и непрерывной оценки. Это не средний показатель успешности ИИ в реальной работе, и его нельзя пересчитать в количество правильно выполненных задач.
Q2: Выполнение каждой задачи с Gemini 4 Carbon стоит всего 16,29 доллара?
Нет. $16.29 — это средняя стоимость выполнения одной задачи в тесте GDPx. Она зависит от расхода токенов, числа вызовов, используемых инструментов и фреймворка выполнения и не является тарифом Google. Объявленная стартовая цена Carbon составляет $2 за миллион входных токенов и $10 за миллион выходных, но пока модель ещё не стала широко доступна обычным разработчикам.
Q3: Можно ли сейчас вызывать Gemini 4 Carbon через API?
По состоянию на 2026-11-03 Google открыла доступ к Carbon только некоторым партнёрам в сфере безопасности и пока не объявила дату общего доступа. В публичной документации моделей APIYI apiyi.com записи gemini-4-carbon тоже нет. Пока можно выстроить процесс тестирования на уже доступных моделях, например Gemini 4 Argon, а после открытия доступа добавить Carbon к сравнению.
Q4: Чем GDPx отличается от GDPval от OpenAI?
GDPval был представлен в сентябре 2025 года, охватывает 9 отраслей и 44 профессии и ориентирован на создание готового результата за один проход на основе предоставленных материалов. GDPx сосредоточен на длительном выполнении задач агентами в 11 высокозначимых областях: по умолчанию на задачу отводится до 8 часов, а особое внимание уделяется взаимодействию с инструментами и исследованию среды. Сложность задач и методы оценки различаются, поэтому напрямую сравнивать результаты нельзя.
Q5: Как быстро сравнить реальную стоимость нескольких моделей?
Рекомендуем провести небольшой тест на собственных рабочих задачах:
1. Зарегистрируйтесь на APIYI apiyi.com и получите API-ключ и бесплатный лимит для тестирования
2. Используйте полный код из этой статьи, задав для base_url значение `https://api.apiyi.com/v1`
3. Запустите каждую модель-кандидата не менее 3 раз, записывая расход токенов и результаты приёмки
4. Рассчитайте стоимость одного результата, прошедшего приёмку, и сверьтесь со списаниями в консоли в реальном времени
Q6: Какие ограничения есть у самого GDPx?
GDPx опубликовал только 14 репрезентативных задач и 168 траекторий выполнения, остальные задачи остаются закрытыми. Пока ни одна независимая организация полностью не воспроизвела результаты рейтинга. Выбор областей отражает собственное мнение исследовательской организации, а Ethan Mollick и другие исследователи также отмечают отсутствие базового уровня для сравнения с человеком. Бинарная оценка в 0% может скрывать различия в способности частично выполнять задачи. Надёжнее использовать GDPx как важный ориентир, а не как готовый ответ при выборе модели для закупки.
GDPx: главное о соотношении цены и качества Key Takeaways
- Рейтинг: в GDPx v1.0 лидирует Opus 5.5 с результатом 12,0%, за ним идут Carbon с 10,9% и Astra с 9,6%
- Разница в стоимости: результат Carbon составляет около 90,8% от результата Opus, а средняя стоимость задачи — лишь около 31,7%
- Важное различие: показатель $/task в GDPx — это средняя стоимость выполнения задачи при тестировании, а не официальная цена токенов
- Различия по областям: первое место в общем рейтинге не означает лидерства во всех областях; на отдельных задачах расклад может быть противоположным
- Доступность: публичный API Carbon пока доступен не всем, поэтому модель нельзя считать готовым к использованию вариантом
- Как выбирать модель: оценивайте стоимость одного результата, прошедшего приёмку. Для сравнения на небольшой выборке можно использовать единый интерфейс APIYI apiyi.com
Итоги
Первый рейтинг GDPx выявил заметную разницу в соотношении цены и качества ведущих AI-моделей:
- Возможности: Claude Opus 5.5 лидирует в общем рейтинге, но у каждой модели свои сильные стороны. В задачах с высоким риском до самостоятельного выполнения без участия человека ещё далеко.
- Стоимость: сравнение пар Carbon и Opus, а также Sol и Astra показывает, что за близкими результатами может скрываться разница в стоимости в несколько раз.
- Доступность: напрямую вызывать Carbon пока сложно, поэтому даже отличный результат в тестах имеет смысл только при условии, что модель можно внедрить.
GDPx помогает сориентироваться при выборе, но не заменяет тестирование на собственных бизнес-задачах. Надёжнее всего выбрать несколько моделей — передовых, сбалансированных и экономичных — и провести по несколько тестовых прогонов на реальных задачах с едиными критериями приёмки. Затем сравните стоимость одного результата, прошедшего приёмку. Для такого тестирования нескольких моделей рекомендуем APIYI apiyi.com: все модели можно проверить с одним ключом. Актуальные цены указаны в консоли.
📚 Источники
- Оригинальный отчёт SemiAnalysis GDPx: методика бенчмарка, результаты по областям и разбор примеров
- Ссылка:
newsletter.semianalysis.com/p/gdpx-measuring-frontier-model-capabilities -
Описание: ведущие модели в каждой области и анализ типичных ошибок
-
Официальный рейтинг GDPx: общие результаты и средняя стоимость выполнения задачи
- Ссылка:
gdpx.semianalysis.com -
Описание: источник данных рейтинга в этой статье; трассировки выполнения доступны на странице
/rollouts -
Анонс Google Gemini 4 Carbon: доступность и планируемые цены API
- Ссылка:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon -
Описание: стартовые и стандартные цены Carbon, а также ограничения доступа
-
Страница цен OpenAI API: официальная стоимость токенов для серии GPT-6
- Ссылка:
developers.openai.com/api/docs/pricing -
Описание: обратите внимание на особые цены для запросов с длинным контекстом
-
Общая таблица цен на модели APIYI: модели, представленные на платформе, и снимок цен
- Ссылка:
docs.apiyi.com/models - Описание: снимок на 2026-10-27; актуальная стоимость списаний указана в консоли
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами через официальный сайт APIYI. Дополнительные материалы по подключению моделей доступны в центре документации docs.apiyi.com