Примечание автора: в первом раунде оценки GDPx ни одна модель не прошла задания в области финансов и права целиком по строгому бинарному критерию. В этой статье мы разберём конкретные ошибки из двух опубликованных кейсов и объясним, почему «умеет считать и писать договоры» ещё не значит «может сдать качественный результат».
2 ноября 2026 года SemiAnalysis представила GDPx v1.0 — бенчмарк сложных профессиональных задач. Из 11 областей в финансах и праве ни одна из протестированных моделей не прошла задания полностью по изначальному бинарному критерию. Чтобы показать различия между моделями, исследовательской группе пришлось использовать «средний частичный балл».
Это не эмоциональный вывод в духе «ИИ ни на что не годится». Некоторые модели набрали в юридическом кейсе в среднем 44% баллов, а в финансовом выполнили около половины проверок при приёмке. Главный вопрос здесь в другом: почему результат, наполовину выполненный правильно, всё равно нельзя сдавать?
Что вы узнаете: какие суммы, показатели неудач и критерии оценки фигурируют в финансовой задаче Bellwood-QoE и задаче по внесению поправок в устав при инвестиционном раунде B. Это также поможет чётче разграничить способность ИИ помогать в работе и способность самостоятельно отвечать за конечный результат.
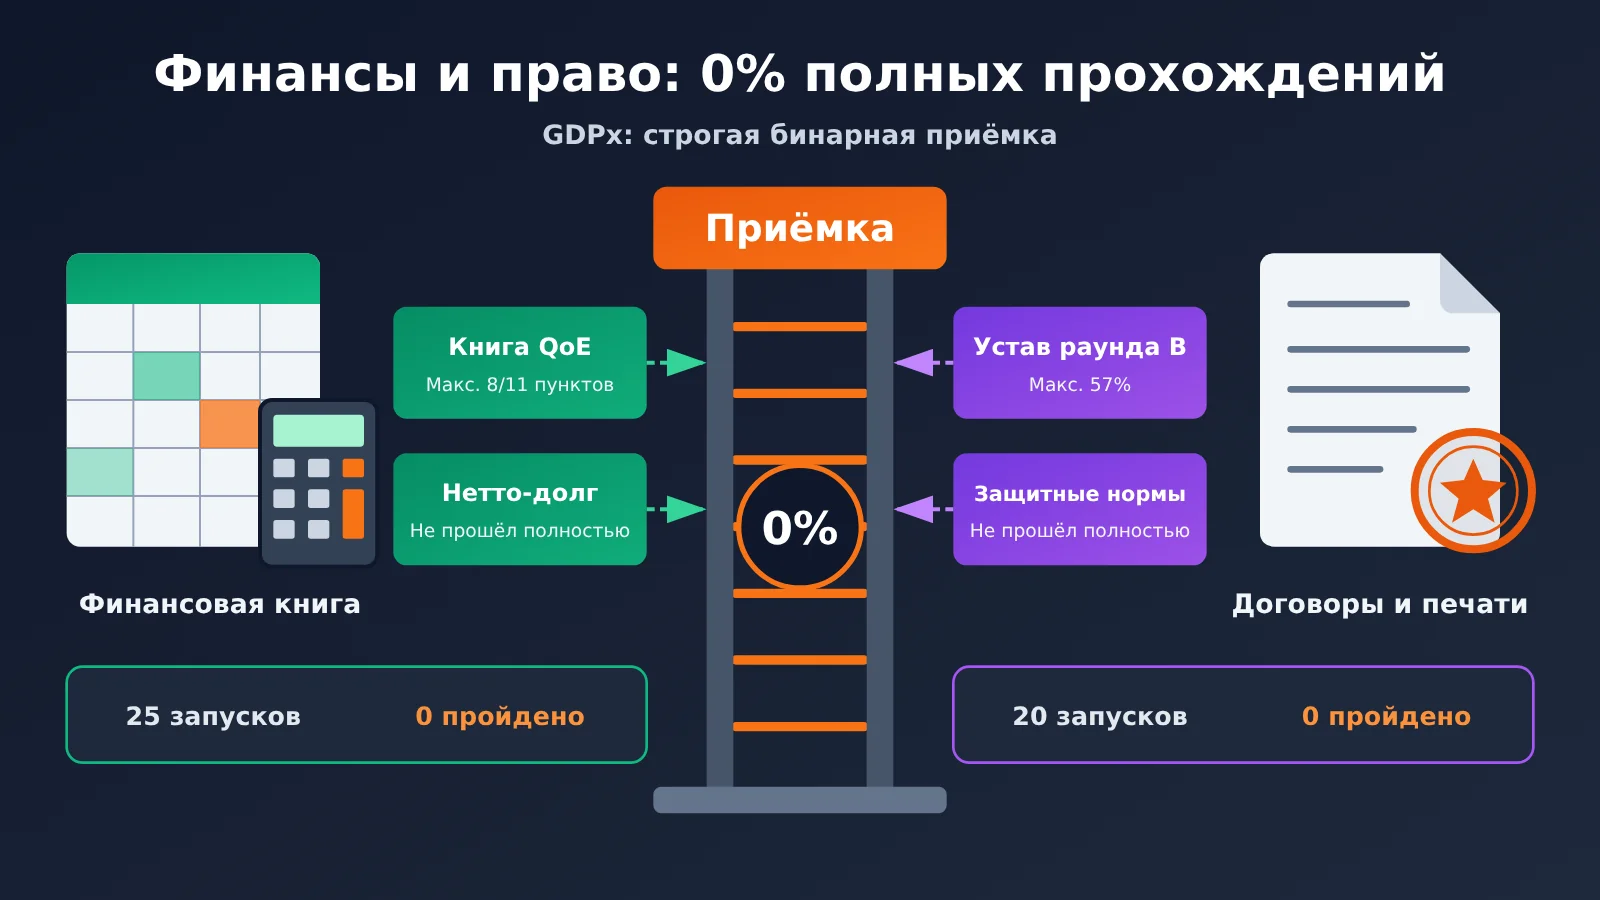
Финансовые и юридические задачи: ни одного полного прохождения
Первый выпуск GDPx охватывает 11 профессиональных областей и 206 задач. По умолчанию на каждую задачу отводится до 8 часов. Тест оценивает работу всей связки: «модель + агентный фреймворк + инструменты + рабочая среда». Claude Opus 5.5, занявшая первое место в общем рейтинге, набрала всего 12,0%. На этом фоне особенно выделяются две области — финансы и право.
| Показатель | Финансы | Право |
|---|---|---|
| Количество задач | 24 | 20 |
| Профильный партнёр | Living Context | Chakra |
| Публичный кейс | Bellwood-QoE (рабочая книга для анализа качества прибыли) | quillon-series-b-redline (поправки к уставу для раунда B) |
| Количество запусков публичного кейса | 25 отобранных запусков | 20 запусков для 4 моделей |
| Количество полных прохождений | 0 | 0 |
| Оценка по строгому бинарному критерию | 0% | 0% |
| Частичные результаты | В лучшем запуске пройдено 8 из 11 проверок | В среднем 18%, лучший отдельный результат — 57% |
При чтении таблицы стоит учесть два момента. Во-первых, бинарная оценка 0% не означает, что результаты всех запусков бесполезны: частичные баллы явно отличались от нуля. Во-вторых, 25 и 20 запусков в таблице относятся к тестированию отдельных публичных кейсов. Это не общее количество запусков для всех 24 финансовых или 20 юридических задач.
Почему финансовые и юридические задачи проверяют так строго
В обеих областях результат работы — не просто совет, а файл, который можно сразу использовать в реальной сделке. При комплексной проверке перед слиянием или поглощением либо на переговорах о финансировании ошибка в расчёте чистого долга или защитное положение, которое можно обойти, способны сделать весь документ непригодным для работы. Поэтому GDPx применяет строгие критерии приёмки, близкие к требованиям профессиональной практики. Это и объясняет появление результата 0%.
Пример финансовой задачи: как Bellwood-QoE заставил ИИ верно посчитать цифры, но не справиться с итоговой работой
Контекст сделки и требования к задаче
Living Context превращает опыт реальных сделок в анонимизированную тестовую среду. В этом сценарии фонд прямых инвестиций Bannock Capital приобретает около 62% акций Haverly Snack Company за примерно 880 млн долларов; сделка также предусматривает условное вознаграждение. Среда содержит около 4000 анонимизированных документов: главную бухгалтерскую книгу, банковские выписки, данные по зарплатам, анализ дебиторской задолженности по срокам, договорную переписку, документы по сделке, таблицы исторических корректировок и рабочие материалы разных консультантов.
Модели нужно продолжить работу над незавершённой книгой анализа качества прибыли (QoE). Она должна определить, какие данные уже верны, исправить ошибки в цифрах и классификации, сохранив правильные записи и структуру расчётов. Кроме того, ей нужно проверить корректировки EBITDA, сверить данные по оборотному капиталу за 12 месяцев, разобраться с методикой расчёта чистого долга, подкрепить каждую корректировку документами и обеспечить согласованность ссылок между таблицами. Результатом должна стать сама исправленная книга.
Результаты тестирования Bellwood-QoE
| Модель | Среднее число пройденных проверок из 11 | Полностью пройдено |
|---|---|---|
| GPT-6.1 Sol | 5.6 | Нет |
| Claude Opus 5.5 | 5.4 | Нет |
| GPT-6 Astra | 5.4 | Нет |
| GLM 5.3 | Менее 2 | Нет |
| Grok 4.7 | Менее 2 | Нет |
| Лучший отдельный запуск | 8 | Нет |
Самые сильные модели в среднем проходили около половины проверок, а в лучшем отдельном запуске удалось пройти 8. Но если среди оставшихся проверок обнаруживается критическая финансовая ошибка, всю рабочую книгу нельзя сдавать. Три типа ошибок ниже показывают, в чём проблема.
Финансовая ошибка первая: корректировке на 418 долларов придали слишком широкий смысл
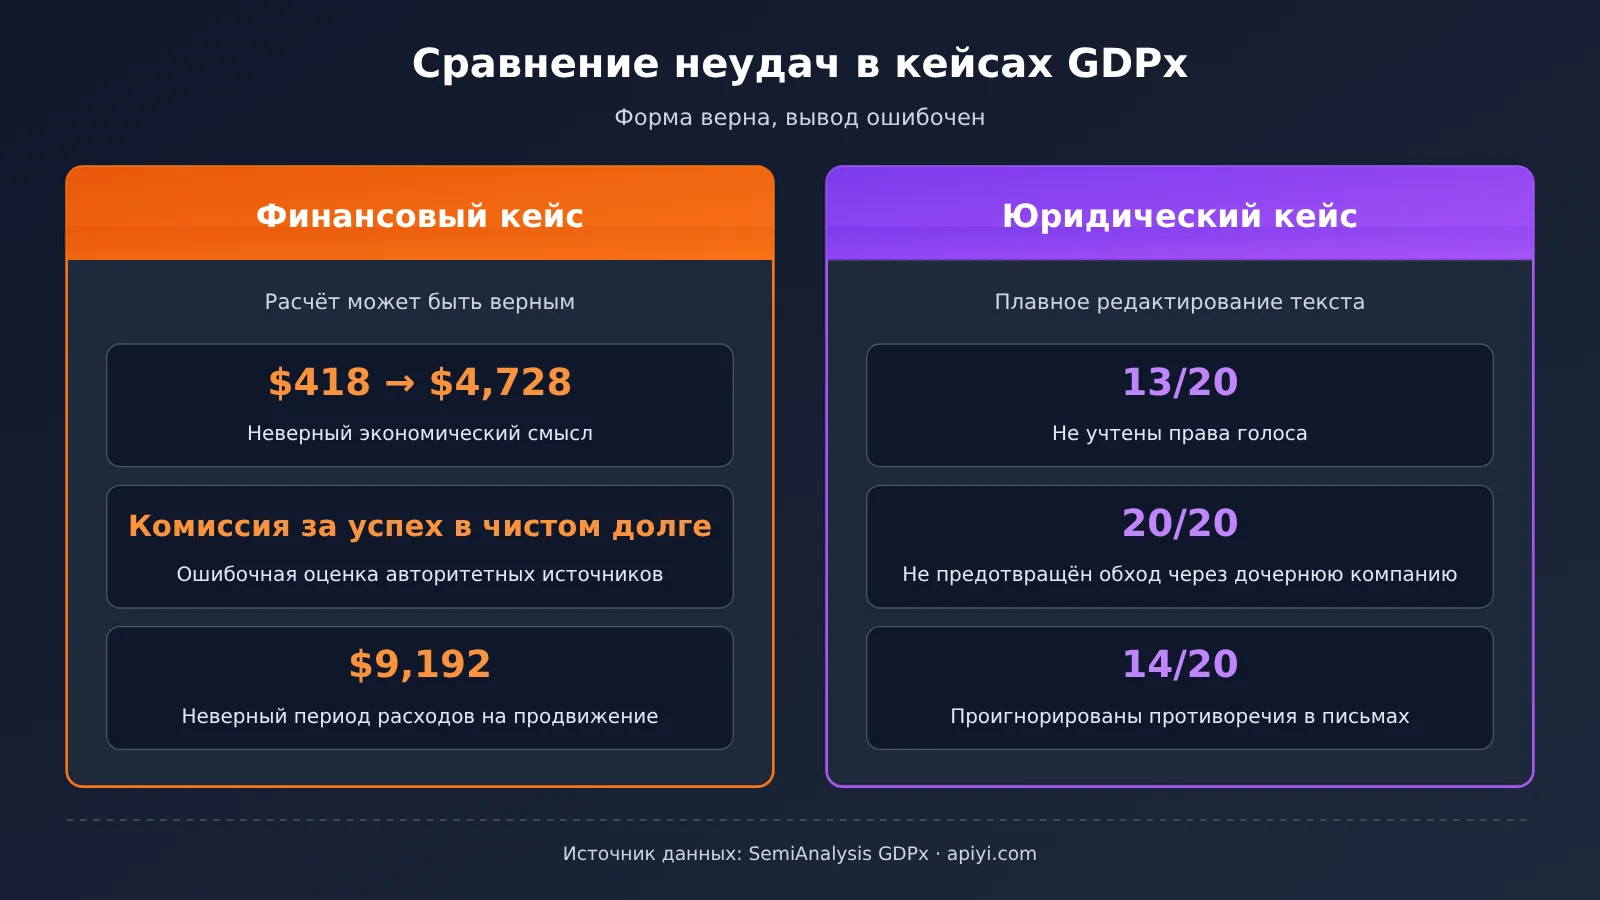
По корректировке на 418 долларов, начисленной по результатам страхового аудита, платить уже не требовалось. Однако некоторые модели решили, что это означает прекращение всех прежних обязательств по страховому полису от несчастных случаев на производстве. В результате EBITDA за последние 12 месяцев была занижена на 4728 долларов. Такая ошибка возникла в 10 из 15 соответствующих запусков Opus, Astra и Sol.
Это не ошибка умножения. Модели распространили бухгалтерский и юридический смысл конкретной корректировки на все прежние обязательства по страхованию. Отклонение в 4728 долларов стало следствием такой ошибочной трактовки, а не результатом умножения 418 долларов на какой-либо коэффициент. Такую ошибку сложно обнаружить повторной проверкой вычислений: сами формулы могут быть верными.
Ошибка в финансовом анализе № 2: расходы на сделку включили в чистый долг
В 15 запусках вознаграждение банкира за успешное завершение сделки включили в чистый долг, хотя договор купли-продажи прямо предусматривал, что его нужно учитывать отдельно как расходы на сделку. Модель нашла эту сумму и правильно выполнила арифметические действия, но не применила обязательный порядок учета, установленный договором.
Так проявляется разница между «данные есть» и «данные правильно классифицированы». В сделках M&A чистый долг обычно влияет на сумму, которую фактически платит покупатель, поэтому последствия ошибки выходят за рамки таблицы.
Ошибка в финансовом анализе № 3: пропущенные корректировки расходов
Исследователи обнаружили и ряд менее заметных проблем:
- В 17 запусках вознаграждение членов семьи, которые фактически не работали, по-прежнему считалось обычным операционным расходом компании;
- В большинстве запусков не были выявлены личные расходы владельца, указанные только в примечаниях к главной книге;
- В 10 из 15 запусков самой сильной модели была пропущена корректировка исторических расходов на продвижение в размере 9192 долларов: расходы, относящиеся к другому периоду, включили в текущие 12 месяцев.
Эти ошибки затрагивают одновременно учетный период, характер расходов, источники подтверждений и экономическую суть сделки. Смысл анализа качества прибыли как раз в том, чтобы исключить подобные статьи, которые «выглядят как операционные расходы, но на самом деле ими не являются». Если их пропустить, EBITDA не отразит реальную способность компании зарабатывать.
Кейс из юридической практики: почему все 20 вариантов правок устава для раунда B оказались непригодны
Требования задачи
В задаче quillon-series-b-redline ИИ представлял интересы ведущего инвестора раунда B и должен был внести правки в подготовленный к подписанию устав компании. Среди исходных материалов были подписанный перечень условий инвестирования, таблица структуры капитала, письмо клиента, проект устава и другие документы по сделке. Критерий успеха — защитить законные интересы инвестора, не меняя без оснований уже согласованные коммерческие условия. Это задача на юридическую оценку с сопоставлением нескольких документов, а не на стилистическую правку текста.
Результаты юридического кейса и три ключевые ошибки
| Показатель | Результат |
|---|---|
| Полностью соответствуют критериям пригодности | 0/20 запусков |
| Средний частичный балл | 18% |
| Частичный балл по моделям | Opus 5.5 — 44%, GPT-6 Astra — 25%, Gemini 4 Argon — 2%, GLM 5.3 — 0,5% |
| Лучший частичный балл за один запуск | 57% (Opus 5.5) |
| Не выявлена возможность отменить защитное положение голосованием акционеров | 13/20 запусков |
| Не предотвращён обход ограничений через дочерние компании | 20/20 запусков |
| Не выявлено противоречие между письмом клиента и согласованным перечнем условий сделки | 14/20 запусков |
Важно уточнить: 18% — это средний частичный балл запусков в рамках данного кейса, а не общий показатель GDPx для юридической сферы.
Ошибка первая: читать положения, но не считать голоса. В 13 запусках модели не обнаружили, что у остальных акционеров достаточно голосов, чтобы отменить защитное положение, необходимое ведущему инвестору. То, что защитное положение записано в уставе, ещё не означает, что оно надёжно. Чтобы понять, можно ли его отменить, нужно рассчитать голоса с учётом структуры владения акциями.
Ошибка вторая: править формулировки, но не искать пути обхода. Во всех 20 запусках модели не смогли эффективно предотвратить обход компанией уставных ограничений по защите инвесторов через дочерние компании. Положение связывает саму компанию, но если оно не распространяется на дочерние структуры, бизнес-операции можно проводить через другое юридическое лицо. Понять буквальный смысл положения — не то же самое, что выявить реальные способы его обхода.
Ошибка третья: считать письмо окончательным соглашением. В 14 запусках модели напрямую приняли желаемые условия из письма клиента, не указав, что они противоречат уже подписанному перечню условий сделки. Внести такие изменения — всё равно что в одностороннем порядке пересмотреть согласованные условия. Правильный подход — выявить противоречие и предупредить пользователя, а не принимать все его пожелания без проверки.
Как контролируется надёжность юридической оценки
Система оценки Chakra устроена так: юристы формулируют требования, критерии калибруются на корректных, некорректных и частично правильных примерах, спорные решения проверяются вручную, а модели-оценщики проходят проверку на предвзятость. Каждый результат оценивается пять раз; также отслеживается согласованность оценок по каждому критерию приёмки. Однако всё это — внутренний контроль качества, описанный партнёром. Это не означает, что независимая организация уже подтвердила отсутствие ошибок в оценках.
Общая причина ошибок в финансовых и юридических задачах: дело не в тексте, а в суждениях
Living Context выделяет четыре распространённых типа ошибок в финансовых задачах. Они во многом совпадают с тем, что наблюдалось в юридических примерах:
| Тип ошибки | Проявление в финансовом примере | Аналог в юридическом примере | Практический вывод |
|---|---|---|---|
| Неверная оценка авторитетности документов | Модель доверяет старой таблице, где цифры указаны наиболее чётко, и игнорирует подписанное соглашение | Ставит письмо клиента выше списка условий | Сначала установите приоритет документов по их юридической силе |
| Упущение последствий второго порядка | Расчёт выполнен, но влияние на налоги, долг и обязательства по сделке не учтено | Защитное положение изменено, но влияние на структуру голосования не просчитано | Для каждого изменения проверяйте последующие последствия |
| Проверка формул без проверки допущений | Арифметику перепроверяют, но исходная бизнес-предпосылка неверна | Формулировки точны, но путь через дочерние компании не учтён | Проверять предпосылки важнее, чем вычисления |
| Нарушение исходной структуры при правках | Формулы заменяются фиксированными числами, связи между таблицами разрываются | Изменяются уже согласованные коммерческие условия | Результат должен быть исправлен правильно — без новых повреждений |
Это типы ошибок, обобщённые исследовательской командой, а не универсальные показатели частоты ошибок для всех финансовых моделей компаний или юридических документов. Общий вывод таков: главная сложность часто не в создании текста, а в выборе источников, профессиональных суждениях, неявных ограничениях, согласованности между документами и итоговой приёмке. Чем более гладко отвечает модель, тем легче упустить эти проблемы.
Анализ влияния ИИ в финансах и юриспруденции: как отличить помощь от самостоятельной сдачи результата
Что это значит для руководителей ИИ-направлений и разработчиков в компаниях
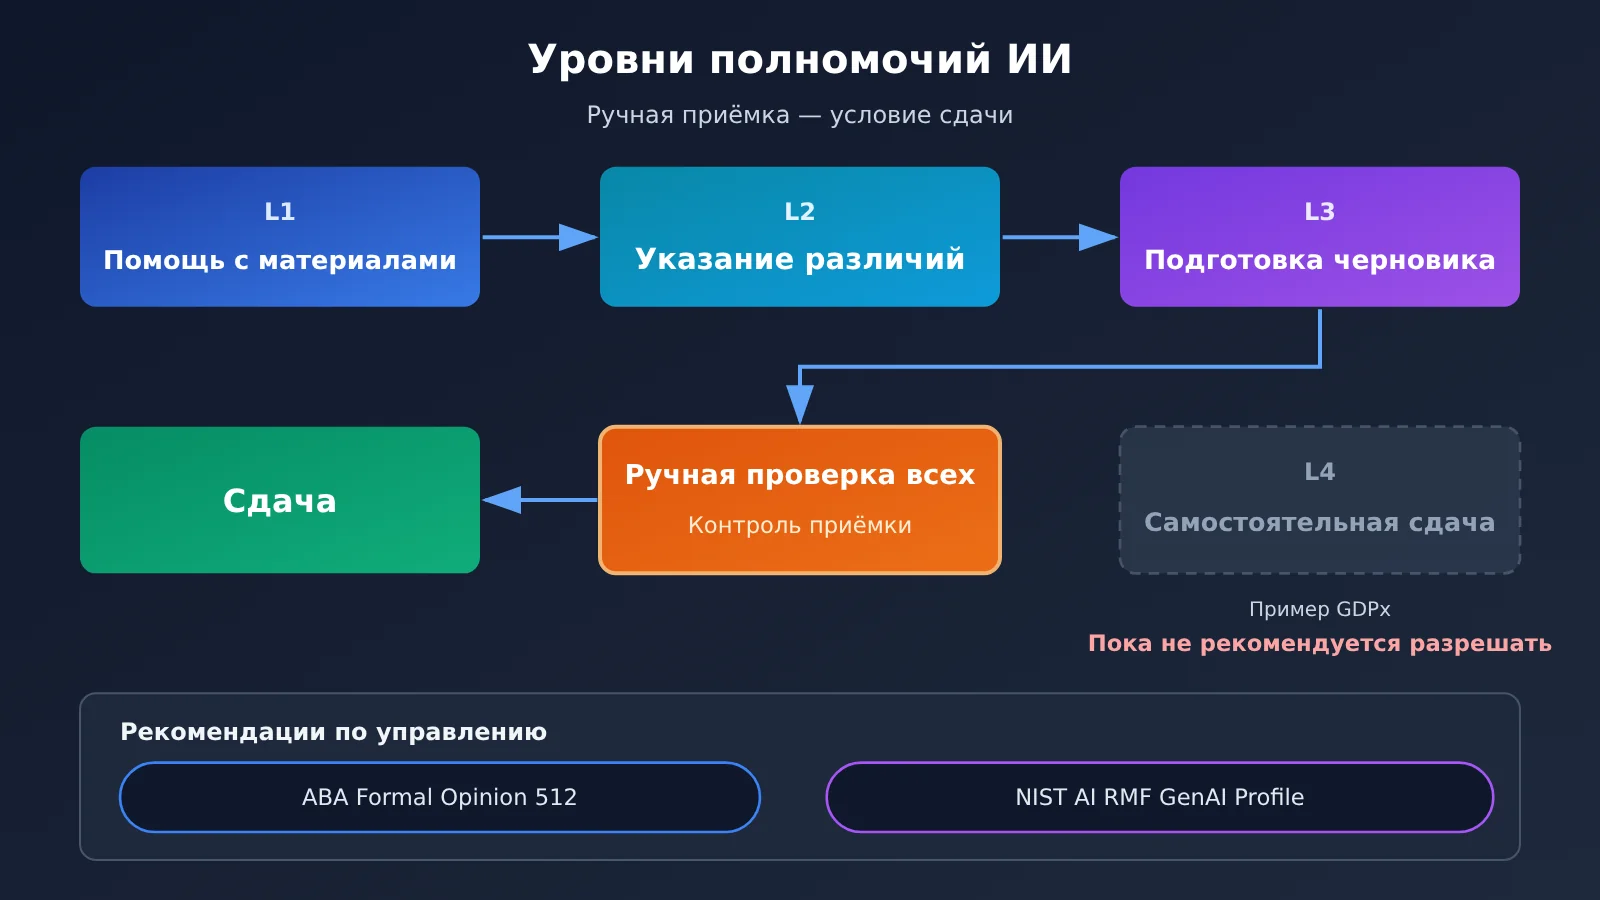
GDPx не ставит под сомнение ценность ИИ как помощника в профессиональной работе. Частичные баллы показывают, что модели уже способны выполнять часть требований приёмки. Но исследование не даёт оснований оценить, сколько времени или денег экономит работа с участием человека, поэтому напрямую переводить выводы по кейсам в ROI не стоит. Практичнее предоставлять ИИ полномочия с учётом уровня риска. За основу можно взять таблицу:
| Уровень полномочий | Типичные задачи | Роль человека | Приёмка |
|---|---|---|---|
| L1. Помощь с материалами | Первичная整理 материалов, проверка аномалий в данных | Выборочная проверка | Результат используется только как ориентир |
| L2. Выявление расхождений | Указание различий в условиях и данных, составление списка противоречий | Проверка каждого пункта | Специалист определяет, действительно ли есть расхождения |
| L3. Подготовка черновика | Черновик изменений в рабочей книге, черновик правок к уставу в формате redline | Полная проверка | Приёмка по каждому пункту чек-листа |
| L4. Самостоятельная сдача результата | Непосредственное подписание или подача документов внешним сторонам | — | Кейсы GDPx показывают, что пока такие полномочия предоставлять не стоит |
Такая градация согласуется с направлением внешних рекомендаций. В документе Formal Opinion 512, опубликованном 29 июля 2024 года, Американская ассоциация юристов (ABA) указывает, что при использовании генеративного ИИ юристы по-прежнему должны соблюдать требования к профессиональной компетентности, конфиденциальности информации клиентов, коммуникации, надзору и обоснованности гонораров. Им также необходимо понимать возможности и ограничения инструмента и не принимать его результаты без проверки. Документ NIST AI RMF Generative AI Profile, опубликованный 26 июля 2024 года, также подчёркивает, что организации должны организовывать человеческий надзор, оценку, документирование и управление с учётом условий применения. При этом рекомендации ABA относятся к профессиональной этике юристов в США, а документ NIST не является результатом тестирования GDPx. Оба источника можно использовать лишь в качестве ориентиров при работе в других областях.
Создаём через API помощника для выявления противоречий
Одна из самых частых ошибок в юридических кейсах GDPx — не заметить противоречие между письмом клиента и подписанными условиями. Задачи на поиск расхождений и формулирование вопросов хорошо подходят для помощи уровня L2, при условии что результаты используются лишь как подсказки для проверки человеком. В примере ниже модель сопоставляет два текста и перечисляет противоречия и вопросы, требующие ручной проверки:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс APIYI
)

resp = client.chat.completions.create(
    model="claude-sonnet-4-20250514",
    messages=[{"role": "user", "content": "对照【已签署条款清单】与【客户邮件】,只列出冲突项和需人工确认的问题,不要直接修改条款。\n条款清单:...\n客户邮件:..."}]
)
print(resp.choices[0].message.content)
Посмотреть полный код реализации (перекрёстная проверка несколькими моделями + контрольный список для человека)
import openai
from typing import List, Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Один ключ для вызова моделей разных поставщиков
)

SYSTEM = (
    "你是交易文件审查助手。你的输出只作为专业人员的审查线索,"
    "必须遵守:1) 已签署文件效力优先于邮件和旧表格;"
    "2) 发现冲突时提示,不得自行改写商业条款;"
    "3) 每条结论标注依据的文件名和段落;"
    "4) 无法确认的事项明确写'需人工确认'。"
)

CHECKS = [
    "客户邮件中的要求是否与已签署条款清单冲突",
    "结合股权结构,其他股东能否凭投票权移除保护条款",
    "保护条款是否覆盖子公司,是否存在绕行路径",
]

def review(docs: str, models: List[str]) -> Dict[str, str]:
    """Получить подсказки для проверки от нескольких моделей, чтобы специалист мог сопоставить их ответы"""
    prompt = "请逐项检查:\n" + "\n".join(f"- {c}" for c in CHECKS) + f"\n\n材料:\n{docs}"
    results = {}
    for m in models:
        try:
            r = client.chat.completions.create(
                model=m,
                messages=[{"role": "system", "content": SYSTEM},
                          {"role": "user", "content": prompt}],
                temperature=0
            )
            results[m] = r.choices[0].message.content
        except Exception as e:
            results[m] = f"调用失败: {e}"
    return results

if __name__ == "__main__":
    out = review("条款清单:...\n股权结构表:...\n客户邮件:...\n章程草稿:...",
                 ["claude-sonnet-4-20250514", "gpt-4o"])
    for model, text in out.items():
        print(f"===== {model} =====\n{text}\n")
    # Окончательное решение о принятии результатов принимает юрист или финансовый специалист, проверяя каждый пункт по контрольному списку
🚀 Как быстро начать: при построении такого вспомогательного процесса можно сначала подключить несколько популярных моделей через APIYI apiyi.com с помощью одного API-ключа и сравнить, насколько хорошо они выявляют конфликты в ваших обезличенных примерах. Новые пользователи могут провести небольшую проверку в рамках бесплатного тестового лимита, а затем решить, стоит ли запускать пилотный проект.
Влияние на финансовые и юридические технологии
Результаты GDPx напоминают: при оценке профессиональных AI-продуктов недостаточно смотреть, насколько гладко проходит диалог с моделью. Важно, сможет ли итоговый результат пройти профессиональную приёмку. Для поставщиков конкурентоспособность продукта будет всё больше зависеть от таких технических деталей, как «приоритет авторитетных документов», «уведомления о конфликтах», «сохранение исходной структуры формул» и «отслеживание источников доказательств». Заказчикам же стоит самостоятельно тестировать продукты на задачах, близких к их реальной работе. GDPx также опубликовал лишь часть задач и журналов выполнения, поэтому необходимы дополнительные независимые проверки и воспроизведение результатов.
💡 Совет по выбору: производительность моделей заметно различается в разных областях, поэтому единый общий рейтинг не отражает их пригодность для ваших задач. Через единый интерфейс APIYI apiyi.com можно параллельно протестировать несколько моделей на собственных задачах, записывая как частичные результаты, так и прохождение ключевых проверок. Не ориентируйтесь только на средний балл. Доступность конкретных моделей уточняйте в актуальном списке платформы.
Частые вопросы FAQ
Q1: «Полный провал» финансовых и юридических задач означает, что AI вообще ничего не сделал правильно?
Нет. Результат 0% получен при строгой бинарной оценке: ни одно выполнение не удовлетворило всем ключевым требованиям. В финансовом кейсе лучшее отдельное выполнение прошло 8 из 11 проверок, а в юридическом средний частичный балл Opus 5.5 составил 44%. Частичное выполнение и соответствующая требованиям работа оцениваются по разным стандартам.
Q2: Почему AI может правильно посчитать, но всё равно получить неверный результат?
Потому что ошибка часто кроется в бизнес-предпосылках, а не в самих расчётах. Например, корректировку в связи с освобождением от выплаты на 418 долларов ошибочно истолковали как прекращение обязательств по всему страховому полису. В результате EBITDA занизили на 4728 долларов. А сумму вознаграждения банкира за успешное завершение сделки нашли правильно, но отнесли к чистому долгу. Повторная проверка арифметики такие ошибки не выявит.
Q3: Можно ли распространить выводы GDPx на все финансовые и юридические приложения AI?
Нет. Результаты получены на определённых сложных задачах и по конкретным правилам оценки. Причины ошибок, выявленные в этих кейсах, тоже нельзя считать выводом обо всей отрасли. Менее сложные приложения или приложения с участием человека нужно оценивать отдельно.
Q4: Какие финансовые и юридические задачи сейчас разумно поручать AI?
Среди подходящих направлений — предварительная систематизация материалов, выявление расхождений в условиях и данных, подготовка черновиков, проверка аномальных данных и помощь в составлении проверочных списков. Пригодность для конкретной задачи нужно тестировать отдельно с учётом уровня риска и профессиональных критериев приёмки.
Q5: Как с минимальными затратами проверить работу модели на своих бизнес-задачах?
Можно действовать так:
1. Подготовьте несколько обезличенных реальных примеров и составьте для каждого подробный проверочный список;
2. Зарегистрируйтесь на APIYI apiyi.com, получите API-ключ и воспользуйтесь бесплатным тестовым лимитом;
3. Установите для base_url в коде из этой статьи значение `https://api.apiyi.com/v1` и вызовите несколько моделей параллельно;
4. Отдельно зафиксируйте частичные баллы и результаты проверки ключевых пунктов, а окончательную оценку доверьте специалисту.
Q6: Можно ли ориентироваться на стоимость задач из отчёта GDPx при оценке цен на API?
Нет. Суммы в долларах в GDPx — это средняя стоимость одной задачи в условиях проведения бенчмарка, а не единые тарифы какой-либо платформы. Фактические расходы зависят от актуальных цен выбранной платформы и вашего объёма вызовов. Детализацию оплаты по фактическому использованию можно посмотреть в консоли APIYI apiyi.com.
Оценка AI в финансовых и юридических задачах: главное
- Ни одна модель не прошла строгую приёмку: по бинарному критерию ни одна модель полностью не справилась с задачами GDPx в финансовой и юридической областях.
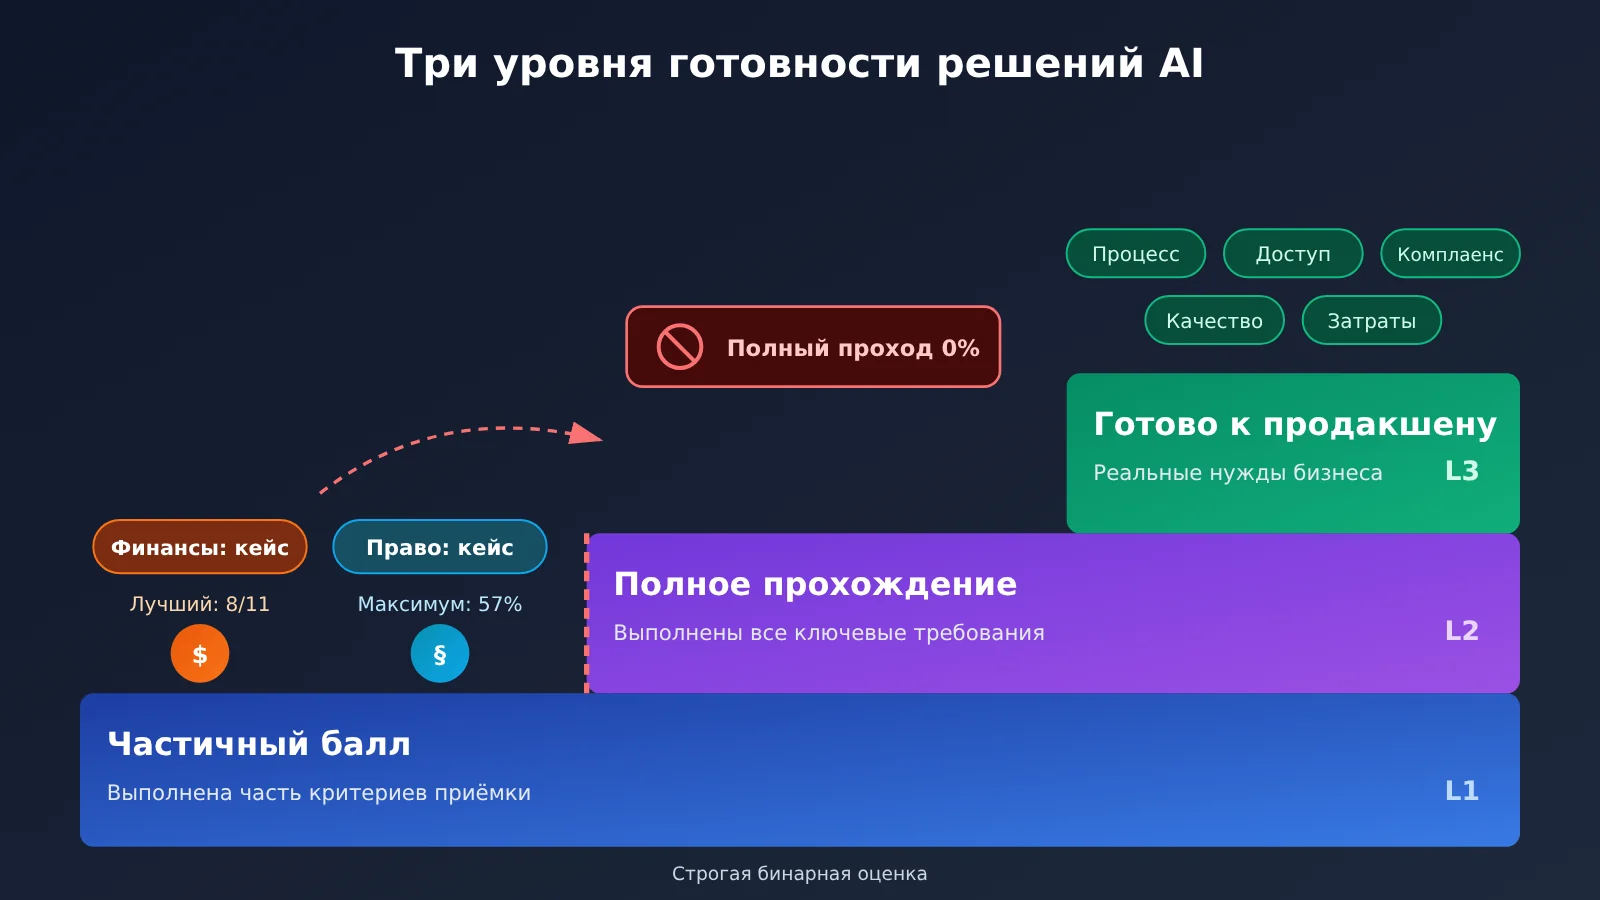
- Частичные результаты были ненулевыми: лучший результат в финансовом кейсе — 8 из 11 проверок за один запуск, а в юридическом — 57% за один запуск.
- Ошибка была в суждении, а не в расчётах: неверная интерпретация корректировки на 418 долларов привела к занижению EBITDA на 4728 долларов.
- Приоритет источников имеет значение: в 14 из 20 запусков модель поставила письмо клиента выше подписанного перечня условий.
- Неявные ограничения учесть сложнее всего: ни в одном из 20 запусков не удалось предотвратить риск обхода ограничений через дочернюю компанию.
- Три понятия нельзя смешивать: частичный результат, полное прохождение проверки и готовность к промышленному использованию нужно оценивать отдельно.
- Сначала помощь, затем пилот: через единый интерфейс APIYI apiyi.com можно провести поэтапную проверку нескольких моделей на собственных примерах.
Итоги
Главные выводы из финансовых и юридических задач GDPx можно свести к трём пунктам:
- Гладкий результат — ещё не качественный: даже если расчёты в таблице верны, а условия изложены складно, модель может ошибиться в оценке экономической сути, структуры прав и противоречий между документами;
- Профессиональный результат требует суждения: главные сложности — оценка авторитетности источников, последствий второго порядка, неявных ограничений и согласованности документов;
- Полномочия нужно распределять поэтапно, а критерии приёмки — определять заранее: следуя подходам ABA и NIST, стоит сохранить проверку человеком и использовать AI как помощника и инструмент для подготовки первых черновиков.
AI уже способен выполнять часть полезной работы в сложных профессиональных задачах, но до самостоятельной подготовки результатов, за которые можно нести ответственность, ему ещё далеко. Если вы оцениваете AI-решения для финансовых или юридических сценариев, сравните через APIYI apiyi.com частичные результаты нескольких моделей и долю прохождения ключевых проверок на собственных рабочих примерах. Это поможет определить границы полномочий AI.
📚 Источники
- Оригинальный отчёт SemiAnalysis GDPx: разделы о финансах и праве, примеры и типичные ошибки
- Ссылка:
newsletter.semianalysis.com/p/gdpx-measuring-frontier-model-capabilities -
Описание: первоисточник данных по кейсам Bellwood-QoE и quillon-series-b-redline
-
Описание областей GDPx и открытые записи выполнения: количество задач, партнёры и записи действий агентов
- Ссылки:
gdpx.semianalysis.com/domains,gdpx.semianalysis.com/rollouts -
Описание: здесь можно посмотреть, как выполнялись некоторые общедоступные задачи
-
Пресс-релиз об ABA Formal Opinion 512: рекомендации по профессиональной этике для юристов, использующих генеративный ИИ
- Ссылка:
americanbar.org/news/abanews/aba-news-archives/2024/07/aba-issues-first-ethics-guidance-ai-tools/ -
Описание: относится к юридической профессии в США и может служить ориентиром для принципов проверки человеком
-
Профиль генеративного ИИ NIST AI RMF: система управления рисками генеративного ИИ
- Ссылка:
nist.gov/publications/artificial-intelligence-risk-management-framework-generative-artificial-intelligence - Описание: межотраслевой источник по вопросам надзора со стороны человека, оценки и мер управления
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами на главной странице сайта APIYI. Дополнительные материалы по подключению доступны в центре документации docs.apiyi.com