作者注:解读 SemiAnalysis 发布的 GDPx 首期榜单,对比顶尖模型的得分和“平均任务成本”,并区分评测成本和官方 Token 价格,帮助你从能力、成本、可用性三个角度初步选型。
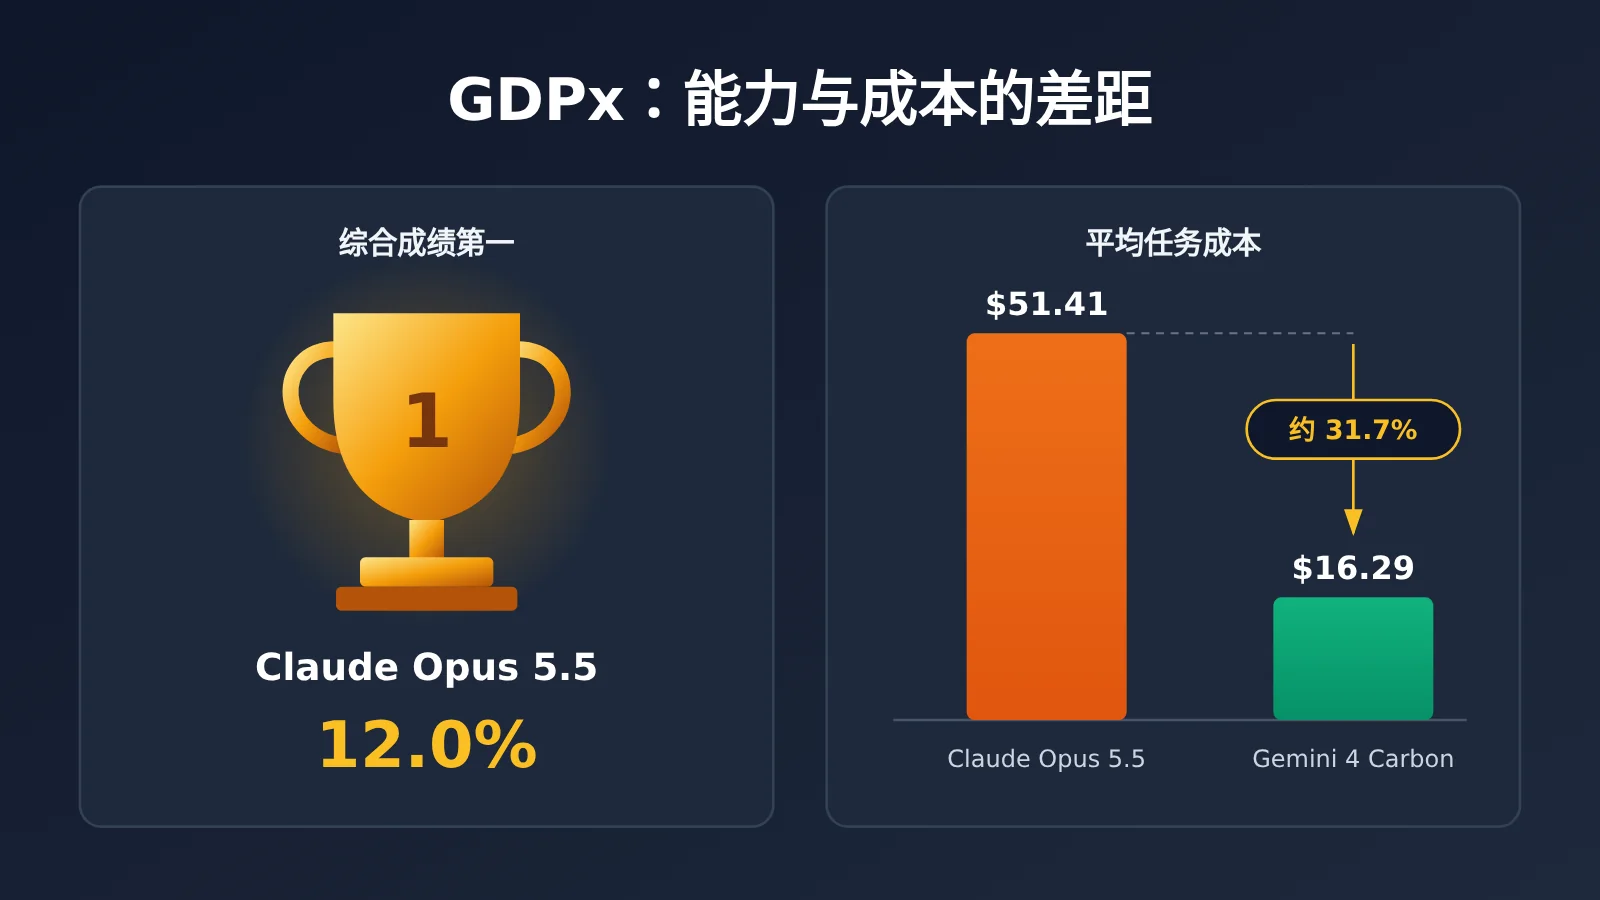
2026 年 11 月 2 日,SemiAnalysis 发布高难度 Agent 基准 GDPx v1.0。Claude Opus 5.5 以 12.0% 的综合成绩排名第一,Gemini 4 Carbon 以 10.9% 紧随其后。更值得关注的是成本:Carbon 的平均任务成本只有 Opus 的约 31.7%,成绩却达到 Opus 的约 90.8%。
这不是坊间传言。上述数据来自 GDPx 官方排行榜和 SemiAnalysis 的原始报告,官网同时公开了 14 个代表性任务、共 168 条执行轨迹。不过,这份排行榜很容易被误读。“平均任务成本”不是 API 价格,“12%”也不是 AI 在现实工作中的成功率。
核心价值:本文梳理 GDPx 首期榜单中的成本与能力数据,严格区分三种价格口径:GDPx 评测成本、厂商官方 Token 价格和 API易 文档标价。读完后,你能理解为什么综合排名和真实采购选择可能并不一致。
GDPx 核心信息速览
GDPx 的全称是“Measuring Frontier Model Capabilities Across the Most Valuable Domains”,意思是“衡量前沿模型在高经济价值领域的能力”。它不考知识问答,测的是 Agent 能否在真实或高仿真的专业环境里,借助工具和软件,独立完成长周期任务。
| 信息项 | 详情 |
|---|---|
| 发布时间 | 2026-11-02(v1.0) |
| 发布方 | SemiAnalysis(作者 Max Kan、Andrew Megalaa、Dylan Patel) |
| 任务规模 | 11 个专业领域、14 家数据合作方、206 项任务 |
| 运行条件 | 默认每项任务 8 小时上限,部分任务更短;每项任务独立运行 3 次,用于估计 pass@1 |
| 评分方式 | 二元评分与连续评分混用,11 个领域等权 |
| 执行框架 | Opus 用 Claude Code,Astra 用 Codex,Carbon 用 Antigravity,其余模型用 OpenCode |
| 更新计划 | 官方计划每 3 至 6 个月发布一次新版本 |
需要特别注意的是,GDPx 测的是“模型 + Agent 框架 + 工具 + 环境”的整体表现,不是模型的纯推理能力。综合分数来自领域等权和混合评分,不能换算成“206 道题答对了多少道”。
GDPx 排行榜:得分与平均任务成本
下表列出官网默认显示的 13 个模型(筛选器中实际共有 20 种测试配置)。最后一列标注 API易 公开模型文档(2026-10-27 价格快照)中是否列出对应型号,仅供查找参考。
| 排名 | 模型 | GDPx 综合成绩 | GDPx 平均成本(美元/任务) | API易 文档快照 |
|---|---|---|---|---|
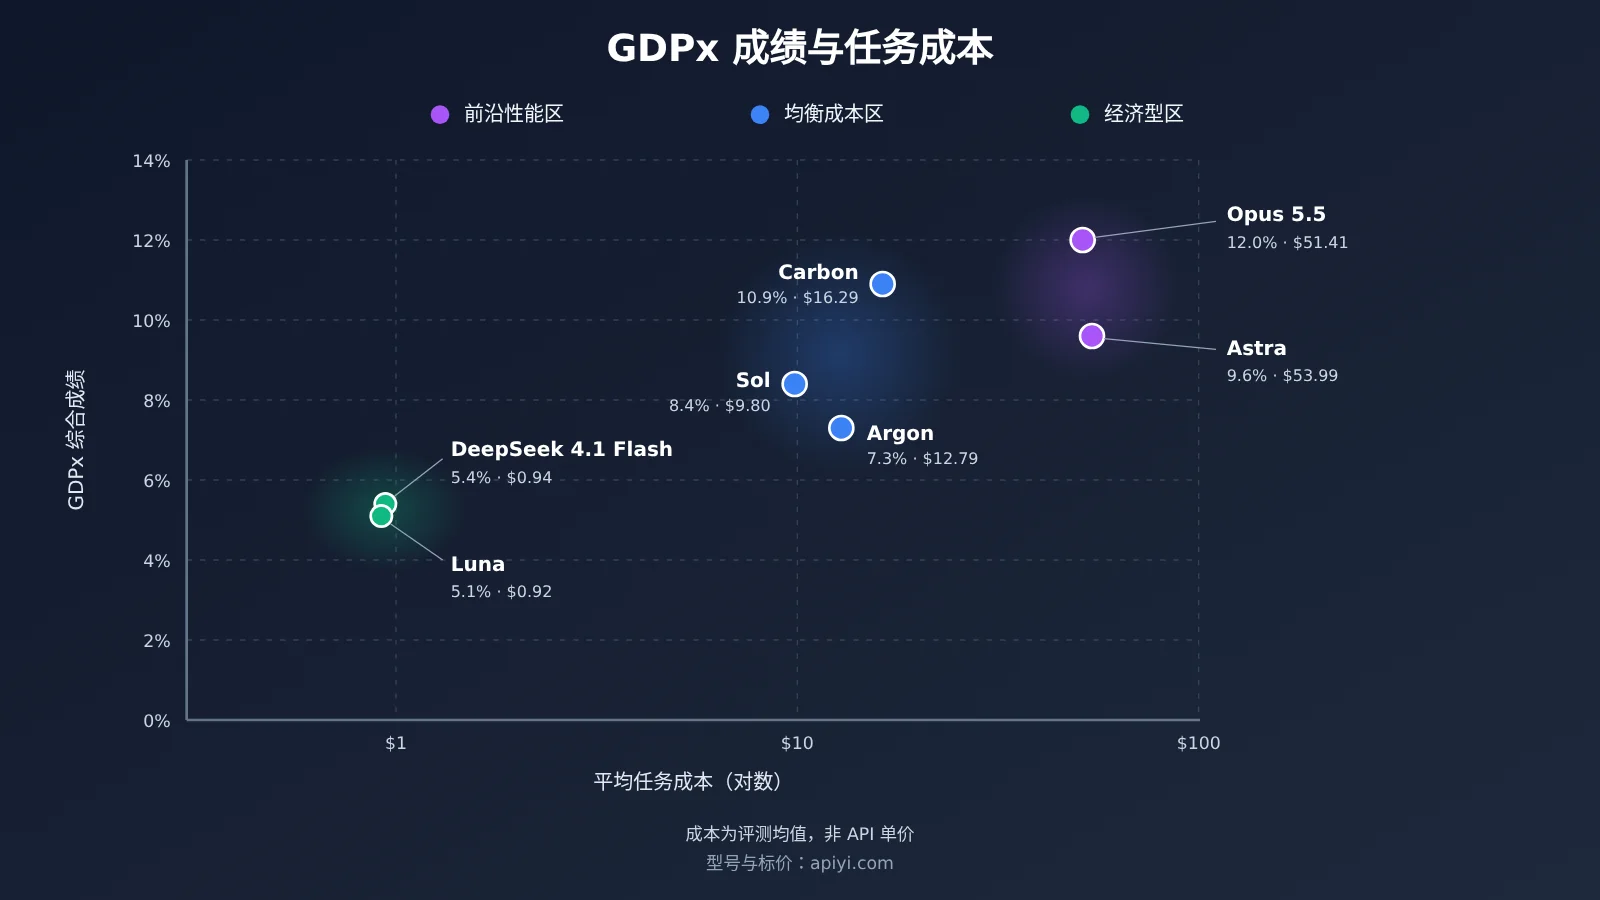
| 01 | Claude Opus 5.5 | 12.0% | $51.41 | 已列出 claude-opus-5-5 |
| 02 | Gemini 4 Carbon | 10.9% | $16.29 | 未列出(未开放公开 API) |
| 03 | GPT-6 Astra | 9.6% | $53.99 | 已列出 gpt-6-astra |
| 04 | Muse Wonder Full | 9.0% | 官方未公开 | 资料未覆盖 |
| 05 | Claude Fable 5.1 | 8.5% | $67.16 | 资料未覆盖 |
| 06 | GPT-6.1 Sol | 8.4% | $9.80 | 已列出 gpt-6.1-sol |
| 07 | Claude Sonnet 5.5 | 8.2% | $45.27 | 资料未覆盖 |
| 08 | Gemini 4 Argon | 7.3% | $12.79 | 已列出 gemini-4-argon |
| 09 | Muse Wonder | 6.8% | $15.63 | 资料未覆盖 |
| 10 | DeepSeek 4.1 Flash 1017 | 5.4% | $0.94 | 列出 deepseek-v4.1-flash 系列(版本需自行核对) |
| 11 | GPT-6 Luna | 5.1% | $0.92 | 已列出 gpt-6-luna |
| 12 | Grok 4.7 | 3.9% | $16.34 | 资料未覆盖 |
| 13 | GLM 5.3 | 2.7% | $11.79 | 资料未覆盖 |
这里的美元金额是 GDPx 报告的每项评测任务的平均运行成本,失败的执行同样会被计入。它不是每百万 Token 的单价,不是用户每次提问的费用,也不是完成一项合格业务的成本。
GDPx 中值得关注的三组成本对照
按照官方数据计算,可以看出三种典型的“性价比形态”:
| 对照组 | 成绩 | 平均任务成本 | 计算结果 |
|---|---|---|---|
| Opus 5.5 vs Carbon | 12.0% vs 10.9% | $51.41 vs $16.29 | Carbon 成绩约为 Opus 的 90.8%,成本约为 31.7%;Opus 成本约为 Carbon 的 3.16 倍 |
| Astra vs Sol | 9.6% vs 8.4% | $53.99 vs $9.80 | Sol 成绩约为 Astra 的 87.5%;Astra 成本约为 Sol 的 5.51 倍 |
| DeepSeek 4.1 Flash vs Luna | 5.4% vs 5.1% | $0.94 vs $0.92 | 两者平均任务成本都低于 $1 |
这三组分别对应三种选择:追求前沿性能、在接近的成绩下压低成本,以及面向低风险任务的经济型方案。但综合成绩接近,并不代表在你的具体任务上表现也接近。
GDPx 显示综合第一并不等于各领域第一
SemiAnalysis 的原始报告指出,各模型的领先领域不同:
- Claude Opus 5.5:在量化交易、硬件设计、芯片设计领域领先。
- Gemini 4 Carbon:在生物学领域领先,在软件工程领域也以较小优势领先。
- GPT-6 Astra:在递归自我改进(RSI)和材料科学领域领先。
研究方还说明,Opus 5.5 和 GPT-6 Astra 的部分成绩受到安全分类器影响,主要集中在网络安全、生物学和 AI 对齐三个领域。在芯片物理设计案例 vt01 中,Astra 的平均评分为 0.34,Opus 只有 0.135,单个任务的差距方向可能和总榜完全相反。
GDPx 成本与官方 Token 价格不是一回事
性价比讨论里最常见的错误,是把 GDPx 的 $/task 当成 API 报价。下面把厂商官方公开的标准文本价格单独列出(单位:美元/百万 Token),并按“100 万输入 + 20 万输出、不计缓存和工具费用”的假设计算一笔理论账单。
| 模型 | 输入 | 输出 | 缓存读取 | 理论账单(100 万入 + 20 万出) |
|---|---|---|---|---|
| Claude Opus 5.5 | $4 | $20 | $0.20 | $8 |
| GPT-6 Astra | $10 | $50 | $1 | $20 |
| GPT-6.1 Sol | $2 | $10 | $0.10 | $4 |
| GPT-6 Luna | $0.10 | $0.50 | $0.01 | $0.20 |
| Gemini 4 Carbon | 计划介绍价 $2 | 计划介绍价 $10 | 比标准输入低 95% | 若按介绍价开放约 $4 |
价格来源:Anthropic 和 OpenAI 的官方价格页,以及 Google 于 2026-10-28 发布的 Carbon 公告。Google 还预告,介绍期结束后 Carbon 标准价为输入 $4、输出 $20,结束日期尚未公布。OpenAI 的长上下文请求可能适用不同价格,各家在缓存写入、批处理等方面的计费规则也不一致。
这张表只能说明“单价”的差异。同样一项任务,不同模型消耗的 Token 数量和调用轮次可能差别很大,所以实际账单的排序未必和理论账单一致。比如 Opus 的理论账单低于 Astra,在 GDPx 中两者的平均任务成本却很接近($51.41 vs $53.99)。
Gemini 4 Carbon 的现实限制
Carbon 是这份榜单里“性价比故事”的主角,但它目前尚难被普通开发者直接调用。Google 在 10 月 28 日发布 Carbon 时,只向部分网络安全防御团队和经过审核的合作伙伴开放,并表示会逐步扩大访问范围。截至 11 月 3 日,尚未找到全面开放公开 API 的公告。
API易 公开模型文档的价格快照中同样没有 gemini-4-carbon 条目,平台 10 月 29 日发布的说明文章也明确表示 Carbon 尚未开放公开 API。所以,Carbon 在当前阶段更适合当作“技术风向标”,而不是可以立刻下单的采购选项。同属 Gemini 4 家族、已可调用的 Gemini 4 Argon(GDPx 7.3%,$12.79/任务)可以作为现阶段的观察对象。
影响 GDPx 类 Agent 任务总成本的因素
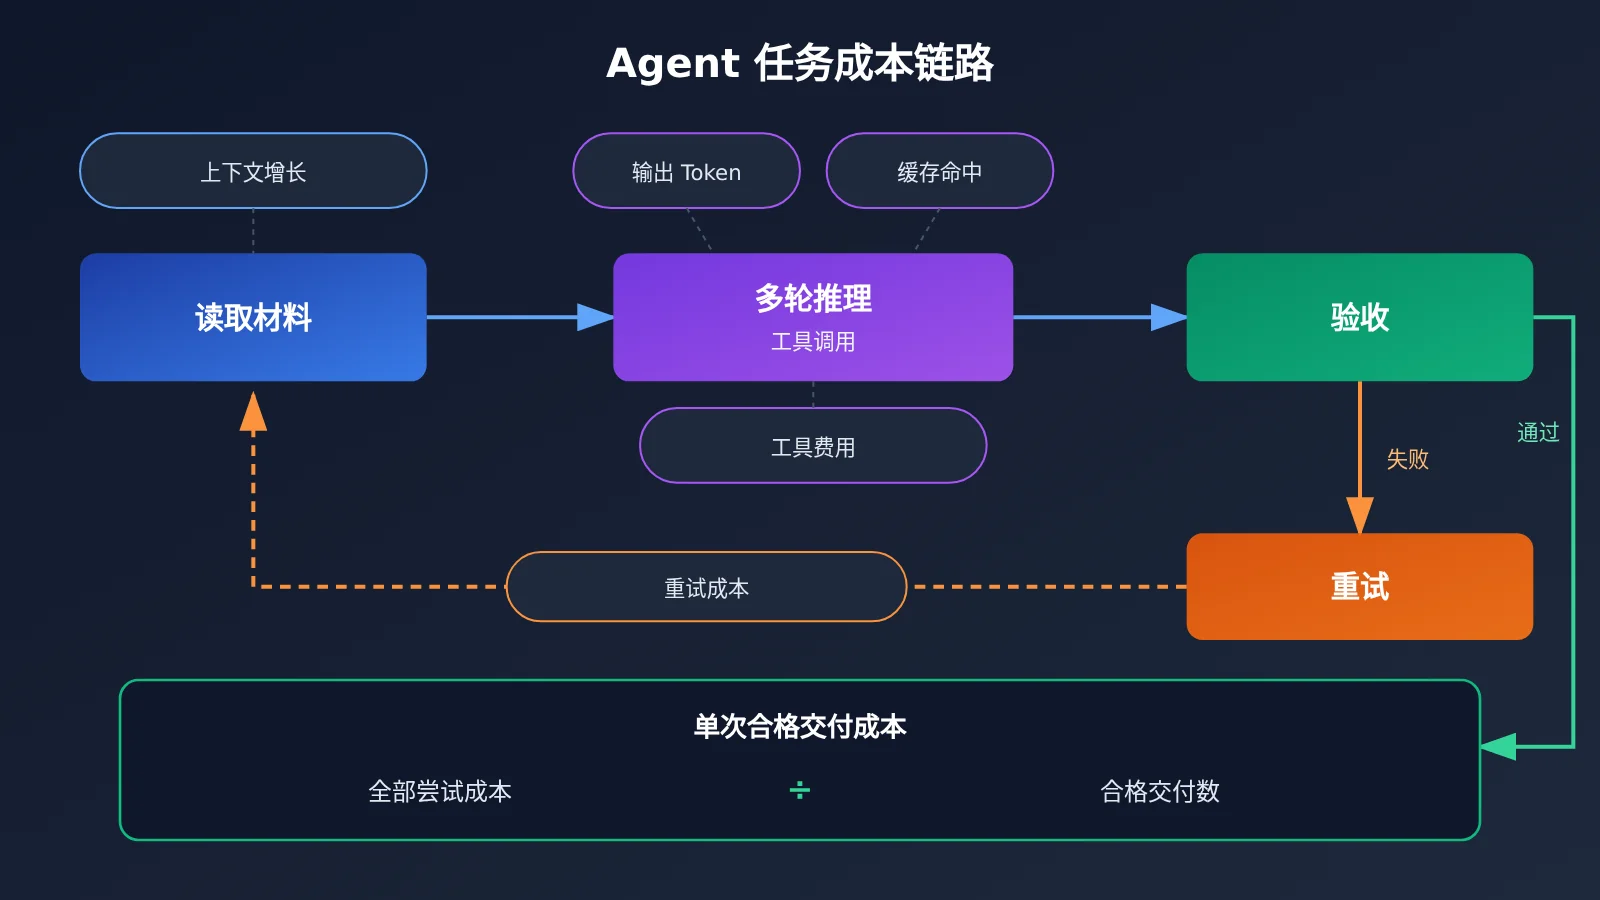
长流程 Agent 的账单不是“单价 × 一次调用”这么简单。可以把总成本拆解为:
总成本 = 输入 Token 费用 + 输出 Token 费用 + 缓存相关费用 + 工具调用费用 + 失败重试成本 + 其他运行成本
| 成本因素 | 对账单的影响 | 优化思路 |
|---|---|---|
| 多轮上下文增长 | 长任务后期每轮都要重复读取大量上下文 | 压缩历史、分段处理 |
| 缓存命中 | 各家缓存读取价格远低于标准输入 | 固定系统提示和文档前缀 |
| 推理强度与输出长度 | 输出单价通常是输入的数倍 | 按任务难度调整推理档位 |
| 工具调用 | 可能产生额外费用,也会增加轮次 | 限制无效探索 |
| 失败与重试 | 失败执行同样消耗 Token | 统计成功率,计算单次合格交付成本 |
| 执行框架 | GDPx 中各模型使用的框架不同 | 在自己的框架下实测 |
对企业来说,更有参考意义的指标是单次合格交付成本 = 全部尝试成本 ÷ 合格交付数量。这是一种建议性的计算方法,不是 GDPx 官方给出的统计。便宜模型如果需要反复重试,最终成本可能反而更高;贵的模型如果交付更稳定,单位业务成本反而可能更低。
如何复现 GDPx 式的成本对比:快速上手
GDPx 的 206 项任务大部分不公开,你也无法直接复现榜单。更实际的做法是:用自己业务中的真实任务,在同样的输入和验收标准下,让几个候选模型各跑几次,记录 Token 用量和是否通过验收。
极简示例
下面的代码通过 OpenAI 兼容接口调用一个模型,并读取本次请求的 Token 用量:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "核对这份应收账款账龄表的合计是否正确"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # prompt_tokens / completion_tokens
查看完整实现:多模型 × 多次运行,计算单次合格交付成本
import openai
from typing import Callable

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 单价:美元/百万 Token,参考 API易 文档 2026-10-27 快照
# 实际扣费以控制台为准,分组和充值优惠可能影响账单
PRICES = {
    "claude-opus-5-5":     {"in": 4.0,  "out": 20.0},
    "gpt-6.1-sol":         {"in": 2.0,  "out": 10.0},
    "gemini-4-argon":      {"in": 2.0,  "out": 10.0},
    "deepseek-v4.1-flash": {"in": 0.30, "out": 1.20},
    "gpt-6-luna":          {"in": 0.10, "out": 0.50},
}

def run_once(model: str, task: str) -> tuple[str, float]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": task}],
    )
    u, p = resp.usage, PRICES[model]
    cost = (u.prompt_tokens * p["in"] + u.completion_tokens * p["out"]) / 1_000_000
    return resp.choices[0].message.content, cost

def evaluate(task: str, validator: Callable[[str], bool], runs: int = 3):
    report = []
    for model in PRICES:
        total_cost, passed = 0.0, 0
        for _ in range(runs):
            try:
                out, cost = run_once(model, task)
                total_cost += cost          # 失败的尝试同样计入成本
                passed += int(validator(out))
            except Exception as e:
                print(f"{model} 调用失败: {e}")
        per_pass = total_cost / passed if passed else float("inf")
        report.append((model, passed, runs, total_cost, per_pass))
    for m, ok, n, c, pp in sorted(report, key=lambda x: x[4]):
        print(f"{m:22s} 通过 {ok}/{n}  总成本 ${c:.4f}  单次合格交付成本 ${pp:.4f}")

# 示例:验收器应该按你的业务标准编写,这里只是演示
evaluate(
    task="根据以下条款判断 418 美元的保险审计调整是否终止原有保险义务……",
    validator=lambda out: "不终止" in out,
)
这个脚本只覆盖单轮调用。真正的 Agent 任务还应把工具调用和多轮上下文的 Token 一并累加,验收器也应尽量贴近真实的交付标准,而不是简单的关键词匹配。
🚀 快速上手建议:做多模型对比时,最麻烦的是为每家厂商分别开通账号、适配不同 SDK。通过 API易 apiyi.com 可以用一个 API Key 和 OpenAI 兼容接口切换上表中已列出的模型,新用户有免费测试额度,适合先跑一轮小样本对比。
GDPx 影响分析:对开发者和企业选型意味着什么
对开发者的影响
- 不要只看综合排名:Opus 综合第一,但 Carbon 在生物学和软件工程领先,Astra 在材料科学和 RSI 领先,单任务差距可能和总榜方向相反。
- 成本差距可能远大于成绩差距:Astra 与 Sol 的成绩只差 1.2 个百分点,平均任务成本却相差约 5.51 倍,非常值得做分层路由的尝试。
- 框架同样重要:GDPx 中各模型使用了各自的原生框架,换一个框架,成绩和 Token 消耗都可能变化。
对企业的影响
- 高风险任务看最终交付:金融和法律任务按严格二元评分,所有模型都是 0%。在法律案例中,Opus 平均部分得分为 44%,但没有一份文件达到可用标准。
- 完成任务不等于合规完成:网络安全测试的 200 次执行中,196 次至少违反一项行为规则。这是高压对抗测试,不能推断现实中的违规率,但说明授权边界需要单独评估。
- 可用性是硬约束:评测表现再好,买不到也无法上线,Carbon 就是典型例子。
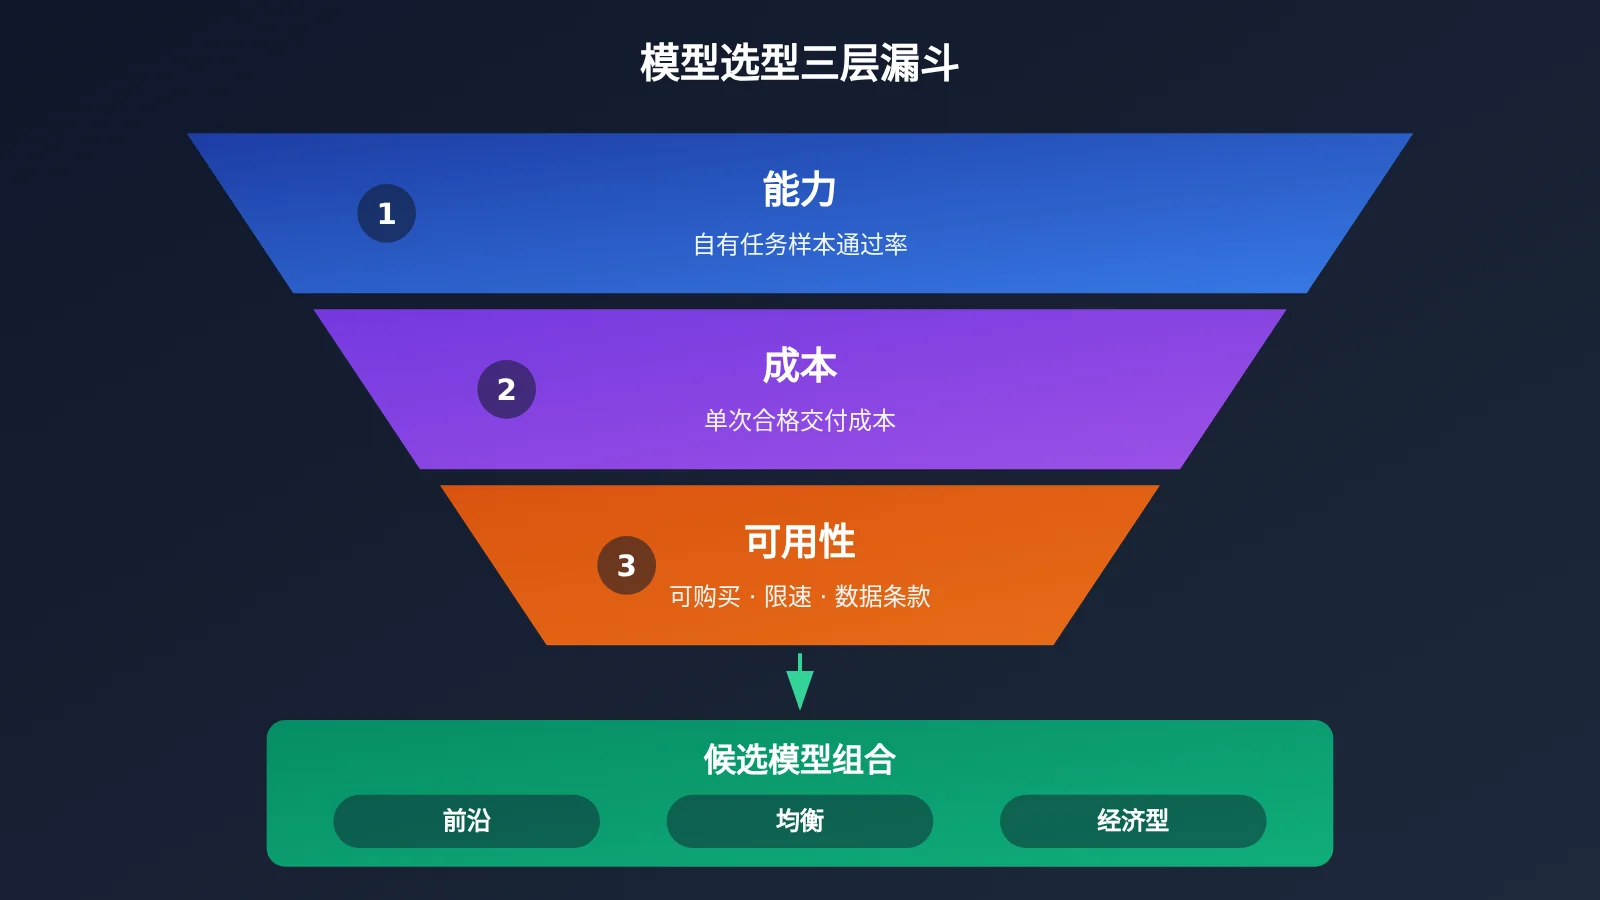
由此可以总结出一个初步选型框架:先看能力(在自己的业务样本上的通过率),再看成本(单次合格交付成本),最后核对可用性(能否购买、速率限制、数据条款)。三者缺一不可。
常见问题 FAQ
Q1:GDPx 中 12% 的成绩是不是说 AI 只能完成 12% 的工作?
不是。12.0% 是 Claude Opus 5.5 在 GDPx 首期高难度专业任务上的综合成绩,由 11 个领域等权、二元评分与连续评分混合计算得出。它不是 AI 在现实工作中的平均成功率,也不能换算成答对题目的数量。
Q2:Gemini 4 Carbon 每项任务只要 16.29 美元吗?
不是。$16.29 是 GDPx 报告的平均评测任务运行成本,受 Token 用量、调用轮次、工具和执行框架影响,不是 Google 的收费标准。Carbon 公布的计划介绍价是输入 $2、输出 $10 每百万 Token,但目前尚未向普通开发者全面开放。
Q3:现在能通过 API 调用 Gemini 4 Carbon 吗?
截至 2026-11-03,Google 仅向部分安全防护合作伙伴开放 Carbon,尚未公布全面开放的日期。API易 apiyi.com 的公开模型文档中也没有 gemini-4-carbon 条目。现阶段可以先在 Gemini 4 Argon 等已开放的模型上搭建评测流程,等 Carbon 开放后再加入对比。
Q4:GDPx 和 OpenAI 的 GDPval 有什么区别?
GDPval 于 2025 年 9 月发布,覆盖 9 个行业、44 个职业,侧重根据给定资料一次性产出交付成果。GDPx 聚焦 11 个高价值领域的长流程 Agent 执行,任务默认最长 8 小时,强调工具交互和环境探索。两者的任务难度、评分方法不同,分数不能直接比较。
Q5:如何快速对比多个模型的真实成本?
建议用自己的业务任务做小样本测试:
1. 在 API易 apiyi.com 注册并获取 API Key 与免费测试额度
2. 使用本文的完整代码,把 base_url 设为 `https://api.apiyi.com/v1`
3. 为每个候选模型运行至少 3 次,记录 Token 用量与验收结果
4. 计算单次合格交付成本,同时参考控制台的实时扣费
Q6:GDPx 本身有哪些局限?
GDPx 只公开了 14 个代表性任务和 168 条执行轨迹,其余任务保持私有,目前还没有独立机构完整复现榜单。领域选择体现的是研究机构自己的判断,Ethan Mollick 等研究者也指出它缺少人类基准,0% 的二元评分可能掩盖部分完成能力上的差异。把它当作重要参考,而不是采购结论,会更稳妥。
GDPx 性价比核心要点 Key Takeaways
- 排名事实:GDPx v1.0 中 Opus 5.5 以 12.0% 居首,Carbon 10.9%,Astra 9.6%
- 成本差距:Carbon 的成绩约为 Opus 的 90.8%,平均任务成本只有约 31.7%
- 口径区分:GDPx 的 $/task 是评测运行均值,不等于官方 Token 价格
- 领域差异:综合第一不代表每个领域都第一,单任务差距可能和总榜相反
- 可用性约束:Carbon 尚未全面开放公开 API,暂时无法作为现货选项
- 选型方法:以单次合格交付成本衡量,可借助 API易 apiyi.com 统一接口做小样本对比
总结
GDPx 首期榜单揭示了顶尖 AI 模型之间明显的性价比差距:
- 能力:Claude Opus 5.5 综合领先,但各模型的优势领域不同,高风险任务距离独立交付仍有很大距离。
- 成本:Carbon 与 Opus、Sol 与 Astra 两组对照说明,接近的成绩背后可能是数倍的成本差异。
- 可用性:Carbon 目前尚难直接调用,再好的评测成绩也要以能否上线为前提。
GDPx 只能为选型指明方向,不能替代你在自己业务上的实测。比较稳妥的做法是挑选几个前沿、均衡和经济型模型,用真实任务和统一验收标准各跑几轮,比较它们的单次合格交付成本。推荐通过 API易 apiyi.com 用一个 Key 完成这类多模型测试,具体价格以控制台实时显示为准。
📚 参考资料
- SemiAnalysis GDPx 原始报告:基准方法、领域结果与案例分析
- 链接:
newsletter.semianalysis.com/p/gdpx-measuring-frontier-model-capabilities -
说明:包含各领域领先模型和失败模式分析
-
GDPx 官方排行榜:综合成绩与平均任务成本
- 链接:
gdpx.semianalysis.com -
说明:本文排行榜数据来源,执行轨迹见
/rollouts页面 -
Google Gemini 4 Carbon 发布公告:开放范围与计划 API 价格
- 链接:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon -
说明:Carbon 介绍价、标准价与访问限制
-
OpenAI API 价格页:GPT-6 系列官方 Token 单价
- 链接:
developers.openai.com/api/docs/pricing -
说明:注意长上下文请求的特殊价格
-
API易 模型价格总表:平台已列出的模型与标价快照
- 链接:
docs.apiyi.com/models - 说明:2026-10-27 快照,实际扣费以控制台为准
作者:API易 技术团队
技术交流:欢迎通过 API易 官网联系我们,更多模型接入资料可访问 docs.apiyi.com 文档中心