Примечание автора: сравниваем Gemini 4 Argon и Carbon по глубине рассуждений, скорости ответа и стоимости задач, чтобы разработчики могли выбирать модель под сложность конкретной задачи.
Google выпустила Gemini 4 Argon 13 октября 2026 года, 28 октября впервые анонсировала Gemini 4 Carbon, а 10 ноября открыла Carbon для разработчиков, компаний и обычных пользователей. Первая реакция многих разработчиков: «Carbon — это что, апгрейд, который заменит Argon?» В статье сравниваем Gemini 4 Argon и Carbon по пяти параметрам: глубина рассуждений, задержка ответа, стоимость задач, сценарии применения и уровни рассуждения.
Это не тот случай, когда «чем мощнее, тем лучше». В официальной документации Google для разработчиков прямо сказано: Argon по-прежнему рекомендуется для большинства инженерных задач и работы со знаниями, а Carbon рассчитан на задачи, где нужны более глубокие рассуждения и более долгие циклы проверки. Основной источник в статье — официальная документация Google. Для сторонних данных мы указываем версию теста и уровень рассуждения.
Главная ценность: после прочтения вы поймёте, какие задачи стоит отдавать Argon, какие оправданно доверить Carbon и как с помощью Thinking Level управлять балансом качества, скорости и стоимости.
Семь терминов, которые нужно знать перед сравнением Gemini 4 Argon и Carbon
Когда сравниваешь две reasoning-модели, несколько понятий легко перепутать. Давайте сначала разведём их по местам, чтобы потом не неверно прочитать цифры:
- Уровень рассуждений (Thinking Level): настройка, которая определяет, сколько усилий модель тратит на «обдумывание». У Carbon есть три уровня: LOW, MEDIUM и HIGH.
- Токены рассуждений: токены, которые модель генерирует, пока «думает». Тарифицируются как выходные токены.
- Стоимость задачи: сумма за все вызовы модели, понадобившиеся для выполнения задачи. Это не то же самое, что цена одного запроса.
- Задержка рассуждений: время от получения запроса до появления результата. В этой статье мы в основном смотрим на задержку до первого токена ответа.
- Чтение из кэша: способ тарификации, при котором повторно используется уже загруженный входной контекст. Стоит заметно дешевле обычных входных токенов.
- Агент (Agent): интеллектуальный агент, который через инструменты выполняет многошаговые задачи, например пишет код, запускает тесты, а потом исправляет ошибки.
- Бенчмарк: способ оценить и сравнить модели на фиксированном наборе задач. Выводы справедливы только для конкретной конфигурации теста.
Зачем Google выпустила сразу две модели: Gemini 4 Argon и Carbon
Согласно карточке модели Carbon от Google DeepMind, Gemini 4 Carbon построена на базе Gemini 4 Argon. То есть у моделей общий фундамент, а Carbon — это версия, которую дополнительно усилили для сложных рассуждений, комплексной разработки ПО, долгих агентных сценариев, научных исследований и защиты в сфере кибербезопасности. Важная оговорка: Google не раскрывает число параметров Carbon и не публикует различий во внутренней вычислительной архитектуре двух моделей. Поэтому утверждения вроде «Carbon в несколько раз больше Argon» ничем не подкреплены.
Раз Carbon сильнее, почему бы просто не заменить им Argon? Дело в том, что модели решают разные задачи. Для повседневной разработки функций и частых правок кода важнее скорость отклика и расход токенов на каждом шаге. А для проектирования архитектуры, поиска первопричин сбоев на стыке подсистем и научных доказательств важнее, чтобы модель могла снова и снова выдвигать гипотезы, проверять их и корректировать. В рекомендациях для разработчиков Google тоже говорит не о замене, а о разделении ролей: Argon берёт на себя большую часть повседневной инженерной работы, а Carbon — более трудные и долгие задачи на рассуждение.
Это разделение видно и в собственных продуктах Google. В превью-функции мультиагентной работы /swarm в Antigravity Google советует поручать Carbon общее проектирование архитектуры, координацию задач и проверку безопасности, а обычную реализацию кода и параллельные правки файлов отдавать более быстрым и лёгким моделям. В потребительских подписках всё так же: в Google AI Pro основной моделью доступна Argon, а Carbon входит только в подписку Ultra.
Ключевые различия Gemini 4 Argon и Carbon: сколько «думает» модель за один шаг
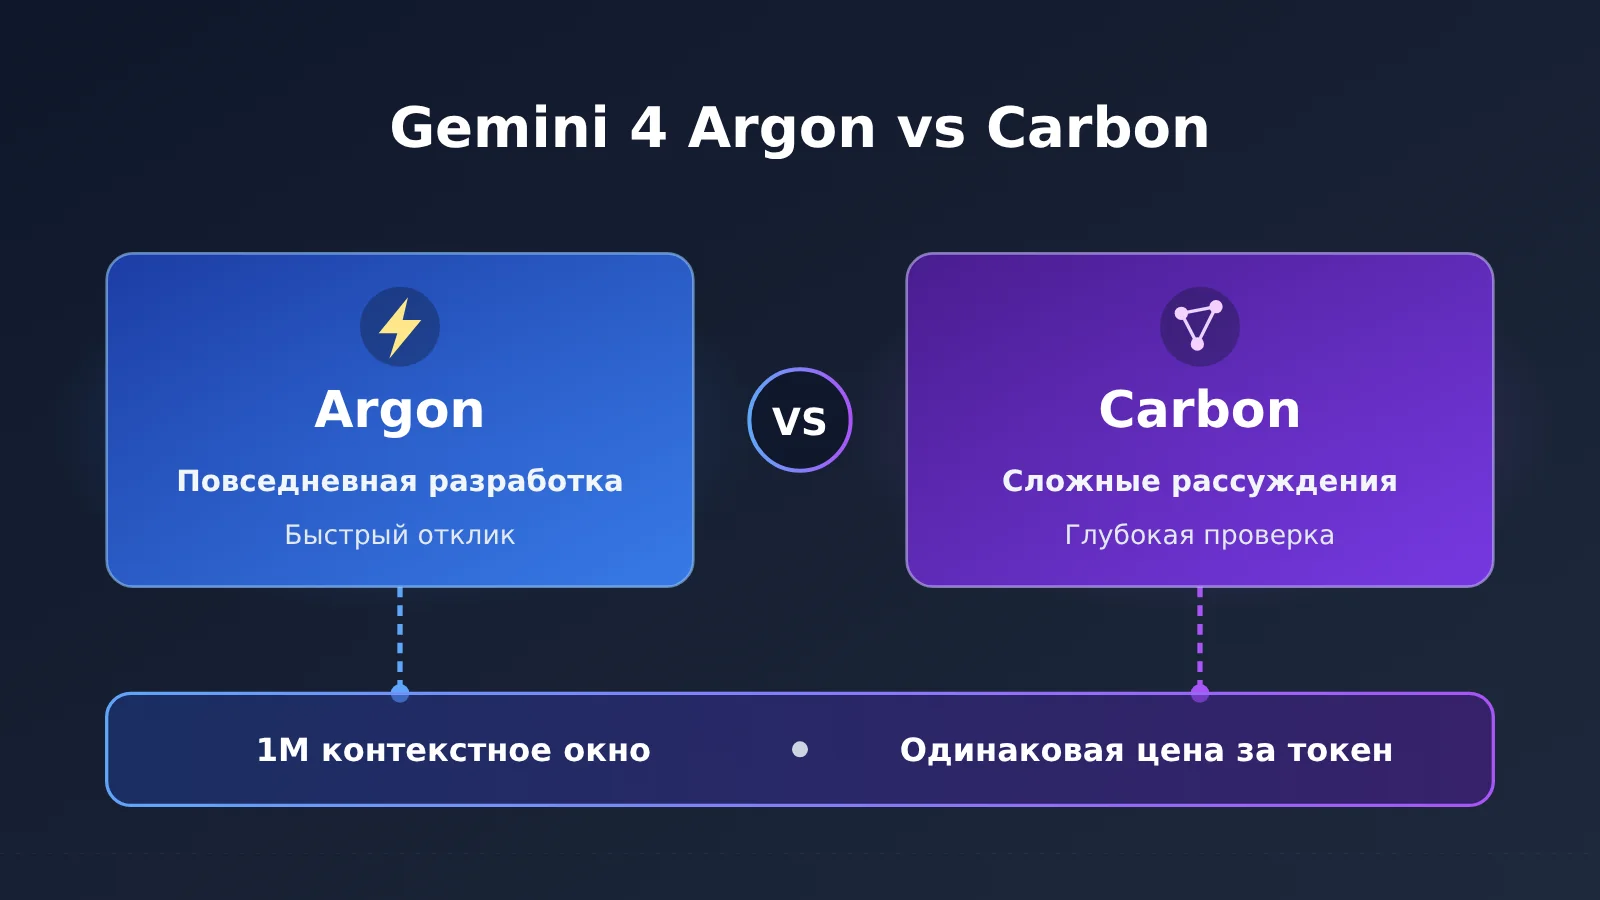
В разделе «Choosing between Carbon and Argon» руководства для разработчиков по Carbon Google объясняет разницу максимально прямо. Carbon тратит на каждом шаге больше токенов на рассуждение, чтобы тщательнее исследовать задачу и проверить собственную работу. Argon отвечает быстрее и расходует за шаг меньше токенов, поэтому лучше подходит для интерактивного программирования и повседневной разработки функциональности. У обеих моделей общее унифицированное контекстное окно на 1M токенов (1 048 576 токенов, входные и выходные токены считаются вместе), общие встроенные инструменты и одинаковая цена за токен.
| Критерий сравнения | Gemini 4 Argon | Gemini 4 Carbon | Что лучше подходит |
|---|---|---|---|
| Позиционирование | Производительная и эффективная модель общего назначения для рассуждений | Модель для более глубоких рассуждений в сложных задачах | Зависит от задачи |
| Токены на рассуждение за шаг | Относительно немного | На каждом шаге больше | Argon экономичнее |
| Скорость ответа | Выше | Ниже на сложных задачах | Argon |
| Интерактивная разработка | Подходит лучше | Можно использовать для особенно трудных задач | Argon |
| Повседневная разработка функциональности | Рекомендуется | Обычно не нужна | Argon |
| Проектирование архитектуры, поиск первопричин | Справляется | Лучше для очень сложных задач и глубокого расследования | Carbon |
| Научные доказательства, аудит безопасности | Справляется / поддерживается | Лучше для сложных рассуждений и верификации | Carbon |
| Контекст и цена за токен | Общий контекст 1M, цена та же | Общий контекст 1M, цена та же | Паритет |
Из таблицы видно, что граница между Gemini 4 Argon и Carbon проходит не по принципу «может или не может», а по принципу «стоит ли думать дольше». Argon тоже справится с проектированием архитектуры и поиском первопричин. Но когда задача настолько сложна, что нужно пройти несколько циклов «гипотеза — проверка», Carbon готов потратить больше токенов на рассуждение и получить более надёжный результат.
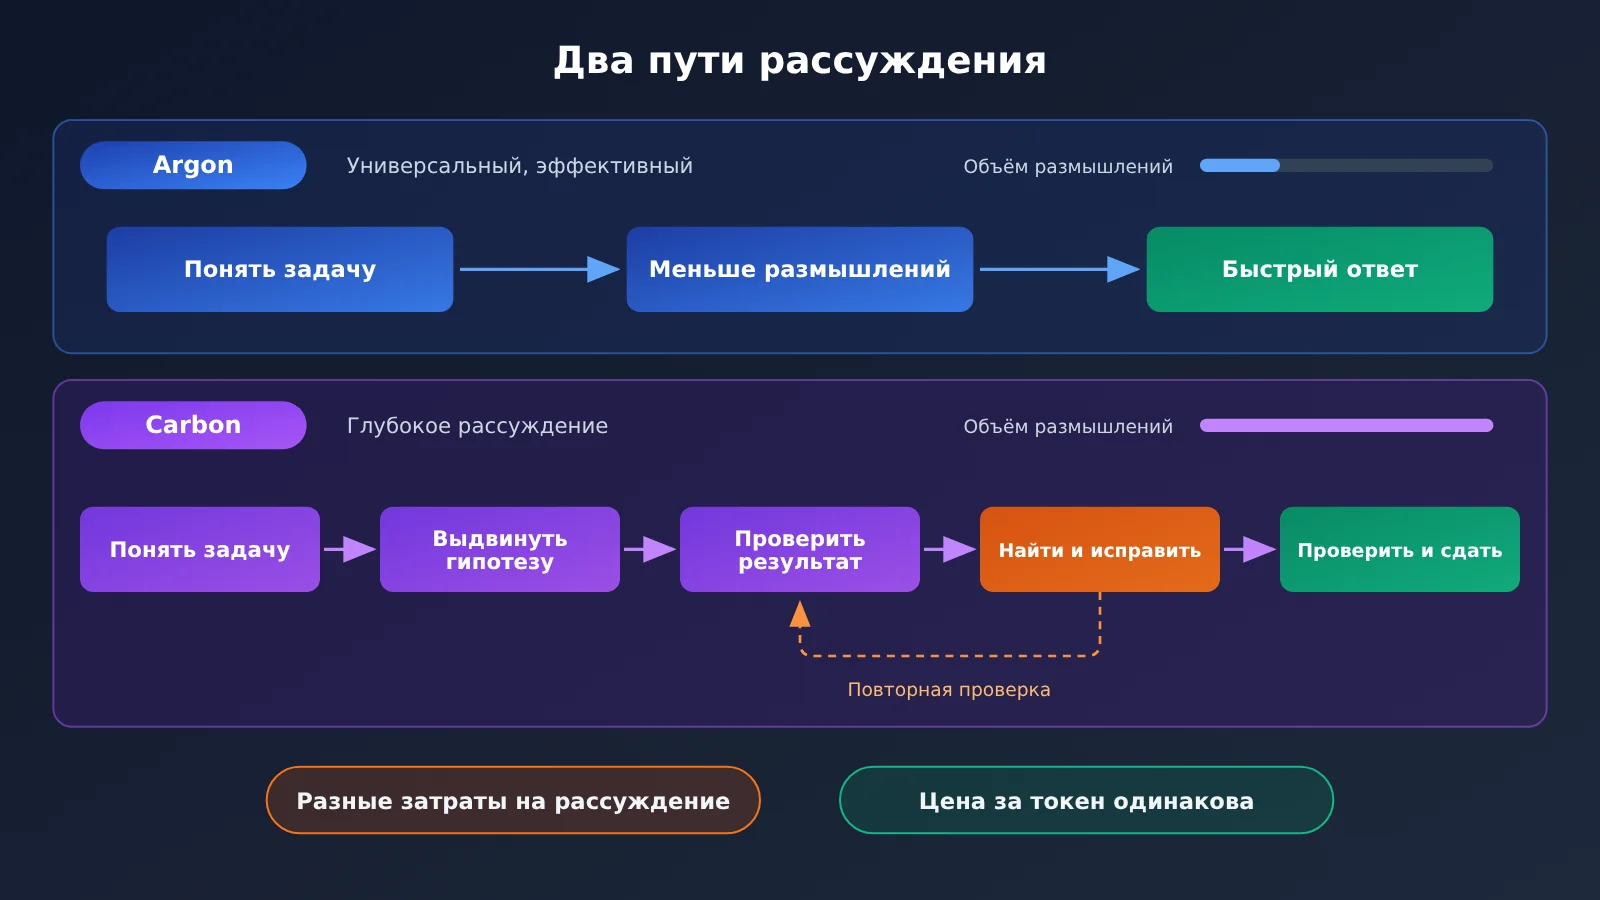
Работа Carbon больше похожа на полноценный замкнутый цикл выполнения: понять цель и ограничения, разбить задачу на части, составить план, вызвать инструменты, проверить промежуточные результаты, обнаружить ошибки, исправить их, перепроверить и только потом сдать результат. Этот цикл даёт Carbon преимущество в длительных задачах, а заодно объясняет, почему первого ответа приходится ждать дольше.
Независимое сравнение Gemini 4 Argon и Carbon на бенчмарках
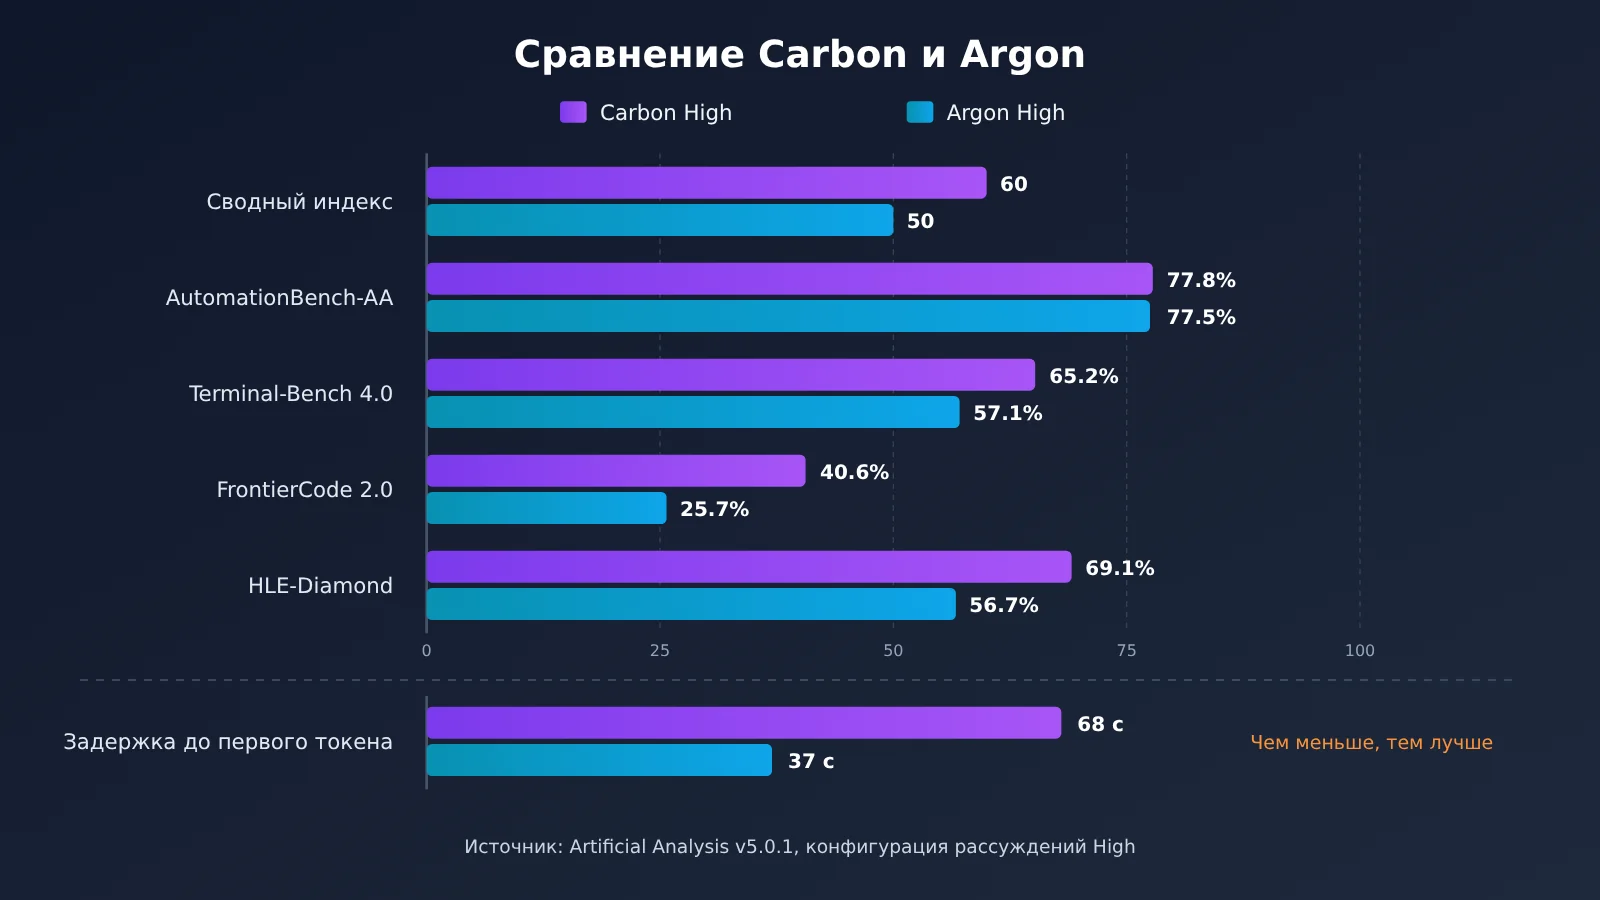
Заявления разработчиков стоит проверять независимыми данными. В Intelligence Index v5.0.1 от Artificial Analysis есть страница с прямым сравнением Carbon и Argon. Все цифры ниже получены в конфигурации High для рассуждений.
| Показатель (AA v5.0.1, High) | Carbon High | Argon High | Разница |
|---|---|---|---|
| Сводный индекс способностей | 60 | 50 | Carbon +10 |
| AutomationBench-AA | 77,8% | 77,5% | Практически на равных |
| Terminal-Bench 4.0 | 65,2% | 57,1% | Carbon впереди |
| FrontierCode 2.0 | 40,6% | 25,7% | Carbon заметно впереди |
| AA-Omniscience (оценка надёжности знаний) | 54 | 46 | Carbon впереди |
| HLE-Diamond | 69,1% | 56,7% | Carbon впереди |
| Стоимость одной задачи | $7,76 | $9,95 | У Carbon ниже |
| Время на одну задачу | 25,6 мин | 28,9 мин | У Carbon короче |
| Задержка до первого токена ответа | около 68 с | около 37 с | Argon быстрее |
Что здесь стоит отметить:
- Больше всего модели расходятся на сложной инженерии и сложных рассуждениях. На FrontierCode 2.0 Carbon впереди почти на 15 процентных пунктов, на HLE-Diamond — примерно на 12, на Terminal-Bench 4.0 — примерно на 8.
- На рутинных задачах автоматизации разница минимальна. В AutomationBench-AA разрыв всего 0,3 п. п. Значит, для процессных автоматических задач Argon вполне хватает.
- Надёжность знаний выросла. В AA-Omniscience счёт 54 против 46. Кроме того, в модельной карточке Google по Agentic Honesty Benchmark у Carbon 92%, у Argon — 70%.
- Argon заметно быстрее выдаёт первый ответ. Около 37 секунд против примерно 68: это прямая цена того, что Carbon тратит больше ресурсов на рассуждения.
Официальная модельная карточка Google (оценка датирована октябрём 2026 года, как правило, Pass@1 с максимально доступным уровнем рассуждений) показывает ту же тенденцию. На SWE-sweep у Carbon 9,6%, у Argon 4,3%. На GraphWalks (256k–1M, BFS F1) Carbon набирает 96,2%, Argon — 84,2%. На Terminal-Bench Science 0.1 это 64,8% против 52,9%. Но у официальной карточки и Artificial Analysis разные методики и разные моменты замеров, поэтому смешивать их в одном рейтинге не стоит. Ещё одна оговорка: на странице модели Carbon время на задачу в режиме High указано как 24,9 минуты, а на странице сравнения — 25,6 минуты. В этой статье в таблице использованы данные со страницы сравнения.
Бенчмарки — это ещё не всё. В мультимодальном тесте MKA для оценки знаний в профессиональных задачах, который совместно выпустили Google DeepMind и Artificial Analysis, ни одна модель не лидирует во всех 10 отраслях: Argon впереди в науке, а Carbon — в здравоохранении. Так что более высокий общий балл Carbon не означает, что он лучше Argon в каждой конкретной области.
💡 Пояснение к сравнению: бенчмарк показывает результат только на фиксированном наборе задач. Чтобы понять, нужен ли Carbon для вашего сценария, надёжнее всего прогнать обе модели на собственных реальных задачах. Через APIYI (apiyi.com) можно переключаться между двумя моделями с одним и тем же API-ключом и одним и тем же OpenAI-совместимым кодом, так что небольшое сравнительное тестирование настроить просто.
Почему Gemini 4 Carbon тратит больше токенов за раунд, но не обязательно обходится дороже
Это самое частое недопонимание. У Gemini 4 Argon и Carbon одинаковая цена за токен. До 30 ноября 2026 года действует стартовая цена: 2 доллара за миллион входных токенов и 10 долларов за миллион выходных. С 1 декабря цены поднимутся до 4 и 20 долларов соответственно. Кэшированный ввод стоит на 95% дешевле обычного. Токены рассуждений входят в выходные токены и оплачиваются как они, поэтому, если Carbon «думает» дольше в каждом раунде, счёт за один раунд обычно получается выше.
Но счёт за задачу — это не счёт за раунд. В сравнении Artificial Analysis v5.0.1 при конфигурации High средняя стоимость задачи у Carbon составила 7,76 доллара, а у Argon — 9,95. Получается, Carbon дешевле примерно на 22%, да ещё и справляется почти на 3 минуты быстрее. Разумное объяснение такое: итоговая цена задачи зависит от того, сколько раундов потребовалось, сколько было лишних шагов и сколько раз пришлось переделывать работу. Если Carbon больше думает в начале и меньше ошибается, то на повторные попытки и исправления уходит меньше раундов.
| Конфигурация (AA v5.0.1) | Общий балл | Стоимость задачи | Время на задачу | Задержка первого ответа |
|---|---|---|---|---|
| Carbon Low | 54 | $7.19 | 22,3 мин | 12,37 с |
| Carbon Medium | 58 | $6.59 | 23,3 мин | 23,16 с |
| Carbon High | 60 | $7.76 | 24,9 мин | 67,54 с |
| Argon High | 50 | $9.95 | 28,9 мин | около 37 с |
В этих данных есть ещё одна неочевидная деталь: у Carbon Medium стоимость задачи ниже, чем у Low. Чем ниже уровень рассуждений, тем дешевле каждый раунд, но для завершения задачи может понадобиться больше раундов. Впрочем, нужно чётко понимать границы такого сравнения:
- Эти суммы — средняя стоимость одной задачи в данной системе оценки. Они посчитаны по стандартным ценам 4/20 долларов и не равны цене обычного API-запроса. Если считать по стартовым ценам, при том же расходе токенов выйдет примерно вдвое дешевле.
- Время вроде 24,9 минуты — это взвешенная длительность задач в агентных тестах. Это не значит, что на обычный вопрос придётся ждать 25 минут.
- Вывод справедлив только для задач набора AA Index. Если ваша задача простая и решается за один-два раунда, преимущество Argon или более низких уровней рассуждений в стоимости одного раунда напрямую превратится в меньший счёт.
💰 Совет по затратам: при оценке моделей фиксируйте общее количество токенов и общее время на выполнение одной задачи, а не просто сравнивайте цены за токен. APIYI (apiyi.com) работает с оплатой по факту использования, а в консоли можно посмотреть детализацию каждого вызова. Это удобно, чтобы посчитать, сколько на самом деле стоит задача на Argon и на Carbon в вашем проекте.
Когда выбирать Gemini 4 Argon, а когда Carbon
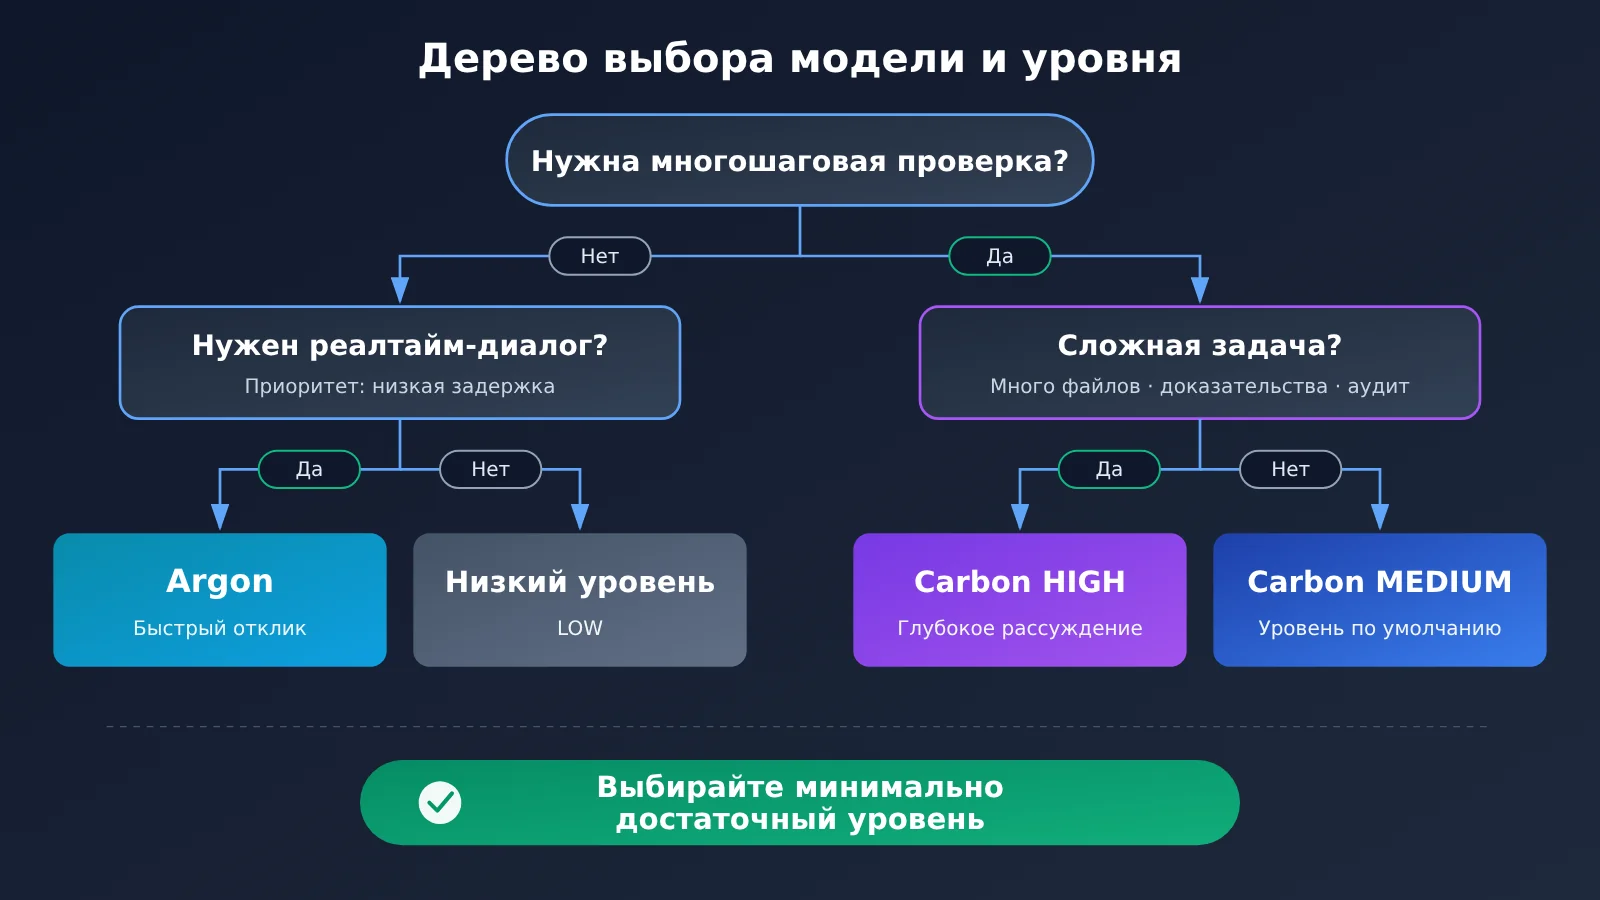
Если сопоставить официальное позиционирование Google с данными выше, задачи можно разделить по сложности. Главный принцип такой: сначала спросите себя, стоит ли задача более глубоких рассуждений, и только потом выбирайте модель и уровень.
| Тип задачи | Рекомендуемая модель | Рекомендуемый уровень | Почему |
|---|---|---|---|
| Повседневная разработка функциональности, обычные правки кода | Argon | По умолчанию или средний | Быстро отвечает, низкие затраты на один раунд, подходит для частого взаимодействия |
| Интерактивное программирование, помощь в IDE в реальном времени | Argon | Средний | Задержка до первого ответа заметно ниже |
| Сложные проекты из множества файлов, проектирование архитектуры | Carbon | HIGH | Заметный отрыв на FrontierCode и Terminal-Bench |
| Глубокий поиск первопричины на стыке подсистем | Carbon | MEDIUM / HIGH | Нужно перебирать несколько гипотез и многократно проверять |
| Сложные научные рассуждения, формальные доказательства | Carbon | HIGH | Официально формальные доказательства отнесены к сценариям для HIGH |
| Аудит безопасности, поиск уязвимостей | Carbon | HIGH | По официальному позиционированию лучше подходит для сложного аудита |
| Простая классификация, суммаризация, извлечение метаданных | Низкий уровень рассуждений | LOW | Важна стоимость, глубокие рассуждения не нужны |
Когда выбирать Gemini 4 Argon
- Разработка с частым взаимодействием: написать одну функцию, поправить стили, дописать тесты — разница между ожиданием в 37 и в 68 секунд ощущается очень сильно.
- Обычная работа со знаниями и автоматизация: на AutomationBench-AA обе модели показывают почти одинаковый результат, так что платить за разницу нет смысла.
- Работа со знаниями в научных областях: в тесте MKA Argon лидирует в научных доменах, поэтому его стоит попробовать в первую очередь.
Когда выбирать Gemini 4 Carbon
- Долгие агентные задачи, которые работают в фоне: задержка до первого ответа не так важна, важнее сделать всё правильно с первого раза.
- Сложная разработка и архитектурные решения: миграции на множество файлов, рефакторинг систем, аудит сложного кода.
- Задачи, где важна проверяемость результата: научные рассуждения, аудит безопасности, аналитические отчёты, требующие самопроверки.
Первые отзывы сообщества подтверждают такое разделение. На Hacker News и Reddit одни разработчики считают, что Carbon находит проблемы, которые пропускают другие модели, а другие жалуются на слишком долгое ожидание первого ответа и быстрый расход квоты. Один пользователь Reddit с помощью Carbon Medium перенёс на Go библиотеку из 230 файлов, и она заработала с первого запуска. Но автор сам оговаривается: выборка — всего 4 этапа, это не контролируемый эксперимент, так что рассматривать пример стоит только как ориентир.
Как управлять качеством, скоростью и стоимостью Gemini 4 Carbon с помощью Thinking Level
Carbon поддерживает три уровня рассуждения: LOW, MEDIUM и HIGH. Публичная модель gemini-4-carbon по умолчанию работает на MEDIUM. Официально рекомендованное разделение по задачам такое: LOW подходит для классификации, суммаризации и извлечения метаданных; MEDIUM — для обычного кода, вызова инструментов, вопросов и ответов по документам и анализа видео; HIGH — для программной инженерии с несколькими файлами, проектирования архитектуры, формальных доказательств и поиска уязвимостей.
У MEDIUM по умолчанию есть веские основания. В AA v5.0.1 Carbon Medium набирает 58 баллов — всего на 2 балла меньше, чем High. При этом стоимость задачи у него самая низкая, а задержка до первого ответа примерно втрое меньше, чем у High. В тесте на фактическую надёжность AA-Omniscience доля выдуманных ответов у Medium составляет 4,2%, у High — 11,4%, у Low — 20,0% (это показатель конкретного теста, а не универсальная частота галлюцинаций). Google тоже советует разработчикам протестировать разные уровни и выбирать самый низкий уровень, который удовлетворяет требованиям к качеству, а не включать HIGH по умолчанию.
При вызове модели учитывайте несколько технических ограничений Carbon:
thinking_budgetне поддерживается — при его использовании вернётся HTTP 400;- уровень MINIMAL не поддерживается;
- параметры
temperature,top_pиtop_kигнорируются; - явное контекстное кэширование (Context Caching) не поддерживается, но если общий префикс промпта достигает 4096 токенов и больше, срабатывает автоматическое неявное кэширование.
Минимальный пример
Ниже — вызов Gemini 4 Carbon через OpenAI-совместимый интерфейс. Хватит чуть больше 10 строк кода:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Единый интерфейс APIYI
)

response = client.chat.completions.create(
    model="gemini-4-carbon",  # ID модели смотрите в списке моделей на платформе
    messages=[{"role": "user", "content": "分析这段服务超时日志的可能根因"}]
)
print(response.choices[0].message.content)
Полный код: маршрутизация между Argon и Carbon по сложности задачи
import time
import openai
from typing import Literal

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Названия моделей приведены для примера, актуальные ID смотрите в списке моделей на платформе
ARGON_MODEL = "gemini-4-argon"
CARBON_MODEL = "gemini-4-carbon"

Difficulty = Literal["simple", "daily", "complex", "extreme"]

def route(difficulty: Difficulty) -> tuple[str, str]:
    """Возвращает (модель, уровень рассуждений) в зависимости от сложности задачи"""
    if difficulty == "simple":
        return CARBON_MODEL, "low"      # Классификация, суммаризация, извлечение метаданных
    if difficulty == "daily":
        return ARGON_MODEL, "medium"    # Повседневная разработка, частые взаимодействия
    if difficulty == "complex":
        return CARBON_MODEL, "medium"   # Поиск первопричин, обычные агентные задачи
    return CARBON_MODEL, "high"         # Многофайловые проекты, доказательства, аудит безопасности

def run_task(prompt: str, difficulty: Difficulty) -> dict:
    model, effort = route(difficulty)
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        # Как именно сопоставляется параметр уровня рассуждений — смотрите в документации платформы;
        # Carbon не поддерживает thinking_budget, при его передаче вернётся ошибка 400
        reasoning_effort=effort,
    )
    usage = resp.usage
    return {
        "model": model,
        "effort": effort,
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,  # Включая токены размышлений
        "answer": resp.choices[0].message.content,
    }

if __name__ == "__main__":
    result = run_task("为订单服务设计分库分表迁移方案,并列出验证步骤", "extreme")
    print(result["model"], result["effort"], result["seconds"], "s")
    print("输出 Token:", result["completion_tokens"])
🚀 Как быстро начать: зарегистрируйтесь на APIYI (apiyi.com) и получите бесплатный тестовый лимит. Затем прогоните одну и ту же пачку реальных задач через разные уровни Argon и Carbon с помощью функции маршрутизации выше и запишите время выполнения и
completion_tokens. Для всех сравнений хватит одного API-ключа — подключать несколько SDK по отдельности не нужно.
Рекомендации по выбору между Gemini 4 Argon и Carbon
Если запомнить только одно правило: по умолчанию берите Argon, а на Carbon переходите, когда задача действительно требует глубокого обдумывания. На практике это делается в три шага:
- Настройте правила маршрутизации: разбейте задачи по таблице сценариев выше на четыре категории — простые, повседневные, сложные и очень сложные. Повседневные задачи по умолчанию отправляйте в Argon.
- Проведите сравнение на небольшой выборке: возьмите из каждой категории 10–20 реальных задач и сравните Argon и Carbon на каждом уровне по доле успешных прохождений, общему числу токенов и суммарному времени выполнения.
- Выбирайте уровень по стоимости задачи: берите самый низкий уровень, который дотягивает до нужного качества, и периодически перепроверяйте выбор — модели, цены и рейтинги могут обновиться.
Для мультиагентных систем можно взять за основу подход Google /swarm: пусть Carbon занимается планированием, координацией и ревью, а Argon или более лёгкие модели берут на себя массовое выполнение. Так вы используете глубокое рассуждение Carbon, но не заставляете каждый этап платить за его задержку.
💡 Совет по выбору: цена за токен у обеих моделей одинаковая, так что разницу создаёт структура ваших задач. Мы рекомендуем подключить Argon и Carbon одновременно через OpenAI-совместимый интерфейс на APIYI (apiyi.com) и переключаться между ними маршрутизацией на уровне кода. Тогда при изменении стратегии бизнес-логику переписывать не придётся.
Часто задаваемые вопросы (FAQ)
Q1: Как связаны Gemini 4 Argon и Carbon?
Согласно карточке модели от Google DeepMind, Gemini 4 Carbon построена на базе Gemini 4 Argon. Обе относятся к одной линейке рассуждающих моделей Gemini 4: у них общее контекстное окно в 1M токенов и встроенные инструменты. Carbon на каждом шаге тратит больше токенов на размышления: исследует варианты и проверяет результат. Argon же делает упор на скорость ответа и эффективность за один проход. Google не раскрывает, чем отличаются параметры и архитектура двух моделей.
Q2: Carbon полностью заменит Argon?
Нет. Google прямо говорит, что Argon по-прежнему оптимален для большинства инженерных задач и задач, связанных со знаниями, а Carbon подходит для более сложных и долгих задач. В AutomationBench-AA модели показывают почти одинаковый результат, а в MKA Argon лидирует в научных областях. Так что во многих сценариях Argon остаётся конкурентоспособной.
Q3: Цена у двух моделей одинаковая? Когда она изменится?
Документация для разработчиков Google показывает, что цена за токен у обеих моделей одинакова. Стартовая цена — 2/10 долларов за миллион входных/выходных токенов, она действует до 30 ноября 2026 года. С 1 декабря цена поднимется до 4/20 долларов. Токены размышлений учитываются как выходные, поэтому одинаковая цена за токен не означает одинаковую стоимость выполнения задачи.
Q4: Carbon долго выдаёт первый ответ. Подойдёт ли она для чат-приложения?
Для сценариев, где важна скорость отклика, не очень. По данным AA v5.0.1, задержка до первого токена ответа у Carbon High составляет около 68 секунд, у Argon High — около 37 секунд, у Carbon Low — около 12 секунд. Для интерактивной работы в реальном времени лучше брать Argon, а Carbon — для сложной фоновой аналитики и долгих задач Agent.
Q5: Как быстро сравнить Argon и Carbon через API?
Рекомендуем использовать платформу-агрегатор API с поддержкой нескольких моделей:
1. Зайдите на APIYI (apiyi.com), зарегистрируйтесь и получите API-ключ и бесплатный тестовый лимит;
2. Укажите в коде `base_url` равным `https://api.apiyi.com/v1`;
3. Меняйте только параметр `model` — так можно переключаться между двумя моделями, а затем сравнить их с учётом уровней рассуждения.
Q6: Можно ли пользоваться Carbon без подписки Google AI Ultra?
Можно. Подписка Ultra определяет лишь то, можно ли напрямую выбрать Carbon в потребительских продуктах (например, в приложении Gemini), а AI Pro в основном включает Argon. Разработчики могут вызывать Carbon через платный тариф Gemini API, покупать Ultra для этого не нужно. Учтите, что у официального API Carbon от Google нет бесплатного уровня.
Q7: Какие у Carbon известные ограничения?
В карточке модели указано: возможны галлюцинации, высокие уровни рассуждения могут расходовать много токенов, ответ может быть медленным или завершиться по тайм-ауту, срок актуальности знаний — март 2026 года, а защита от Prompt Injection всё ещё требует доработки. Кроме того, `thinking_budget` не поддерживается, а параметры сэмплирования игнорируются, так что при переносе старого кода это нужно проверить.
Gemini 4 Argon и Carbon: ключевые выводы (Key Takeaways)
- Как они соотносятся: Carbon построена на базе Argon. Модели дополняют друг друга и делят задачи между собой, так что это не «старшая и младшая версии».
- Главное отличие: Carbon думает дольше на каждом шаге и тщательнее всё проверяет. Argon отвечает быстрее и тратит меньше ресурсов за один ход.
- Результаты в бенчмарках: в AA v5.0.1 при конфигурации High Carbon набирает в сумме 60 баллов, Argon — 50.
- Что на самом деле со стоимостью: цена за токен у моделей одинаковая, но в задачах AA Carbon High обходится дешевле Argon High в пересчёте на одну задачу.
- Как выбрать уровень: по умолчанию Carbon работает на MEDIUM. Выбирайте LOW, MEDIUM или HIGH по принципу «минимального уровня, которого хватает».
- Как начать: через APIYI (apiyi.com) можно протестировать обе модели на одном и том же коде, совместимом с OpenAI.
Итоги
Разницу между Gemini 4 Argon и Carbon можно свести к трём пунктам:
- Разный объём рассуждений. Argon отвечает за эффективность, а Carbon тратит больше токенов на размышления и берёт самые сложные задачи на рассуждение.
- Задержку и стоимость нужно оценивать по отдельности. Первый ответ у Carbon приходит медленнее, но в некоторых тестах полная стоимость задачи у неё может оказаться ниже.
- Выбирать нужно по сложности задачи. Для повседневной разработки берите Argon, а сложные инженерные задачи, научные рассуждения и аудит безопасности отдавайте Carbon.
Не стоит гонять все запросы на максимальном уровне рассуждений. Сначала на реальных задачах определите для каждого типа работы тот самый «достаточный уровень» — именно это помогает держать под контролем качество, скорость и стоимость. Проверить, как обе модели покажут себя на вашем бизнесе, быстрее всего через APIYI (apiyi.com): платформа поддерживает оплату по факту использования и единый интерфейс для разных моделей.
📚 Справочные материалы
- Gemini 4 Carbon Model Card: официальная карточка модели от Google DeepMind
- Ссылка:
deepmind.google/models/model-cards/gemini-4-carbon -
Описание: Carbon построена на базе Argon; спецификации контекста, официальные тесты и известные ограничения
-
Choosing between Carbon and Argon: документация для разработчиков Google AI Studio
- Ссылка:
aistudio.google.com/docs/whats-new-gemini-4-carbon -
Описание: чем официально различаются позиции двух моделей и какой Thinking Level выбрать
-
Gemini 4 Carbon Developer Guide: руководство для разработчиков Google Cloud
- Ссылка:
docs.cloud.google.cn/gemini-enterprise-agent-platform/models/guides/gemini-4-carbon -
Описание: уровни рассуждения, ограничения параметров API и особенности длинного декодирования
-
Цены Gemini API: Google AI for Developers
- Ссылка:
ai.google.dev/gemini-api/docs/pricing -
Описание: цена на старте, декабрьское изменение цен, правила тарификации кэша и токенов размышления
-
Gemini 4 Carbon vs Gemini 4 Argon: страница сравнения от Artificial Analysis
- Ссылка:
artificialanalysis.ai/zh/models/comparisons/gemini-4-carbon-vs-gemini-4-argon -
Описание: сравнение возможностей, стоимости и задержки в конфигурации AA Index v5.0.1 High
-
MKA — бенчмарк мультимодальной работы со знаниями: Artificial Analysis
- Ссылка:
artificialanalysis.ai/zh/evaluations/mka - Описание: лидирующие модели по отраслям и данные о стоимости задач
Автор: техническая команда APIYI
Обратная связь: пишите нам на главной странице сайта APIYI. Больше материалов по подключению моделей — в центре документации docs.apiyi.com